

content unificada para crear tareas.
Proceso de solicitud
Para usar la API de generación de video MiniMax H3, primero ve a la consola de Ace Data Cloud para obtener tu API Token y guardarlo como respaldo. Si aún no has iniciado sesión o te has registrado, se te redirigirá automáticamente a la página de inicio de sesión para invitarte a registrarte e iniciar sesión; al finalizar, volverás automáticamente a la página actual.
Un único API Token permite llamar a todos los servicios de la plataforma, sin necesidad de solicitar uno por separado para cada servicio. La primera solicitud incluirá créditos gratuitos para que puedas probarlo sin costo; cuando los créditos sean insuficientes, puedes recargar saldo general en la consola.
📘 Documentación completa: API de generación de video MiniMax H3 →Se recomienda guardar el Token como una variable de entorno, no escribirlo en el código fuente ni confirmarlo en el repositorio de versiones:
Resumen de la interfaz
- Base URL:
https://api.acedata.cloud - Endpoint:
POST /minimax/videos - Método de autenticación:llevar
authorization: Bearer {token}en el HTTP Header - Encabezados de solicitud:
accept: application/jsoncontent-type: application/json
- Modelo (model):
MiniMax-H3 - Estructura de entrada:texto, imágenes, videos y audio se pasan de forma unificada mediante
content - Modo de salida:por defecto espera de forma síncrona a que finalice la generación y devuelve el
taskcompleto; al pasarasync: trueocallback_url, devuelve inmediatamentetask_idytrace_id - Consulta de resultados:obtén el estado y el video final mediante la API de consulta de tareas MiniMax H3
- Callback asíncrono:opcional, recibe el resultado final de la tarea mediante
callback_url
action para seleccionar el modo de generación; la interfaz determinará automáticamente el uso según los tipos de materiales y role en content.
Escenarios adecuados
Flujo de llamada
Cuando no se pasaasync por defecto, /minimax/videos esperará a que finalice la generación y devolverá directamente el task completo. Cuando necesites liberar la conexión inmediatamente, pasa async: true o callback_url:
- Guarda
task_idytrace_idde la respuesta inmediata. - Cuando no haya callback configurado, llama a
/minimax/tasksaproximadamente cada 10 segundos para consultar. - Cuando
task.statuscambie asucceeded, obtén el video desdetask.content.url. - Cuando el estado sea
failedocancelled, detén el sondeo y leetask.error.
Parámetros de solicitud de nivel superior
Las reglas de
ratio dependen del flujo de trabajo:
- Generación de video a partir de texto:obligatorio y no puede ser
adaptive. - Video de fotograma inicial, fotograma final o inicial y final:la relación de aspecto la determina la imagen de entrada; se recomienda omitirlo o pasar
adaptive. - Generación de video con referencias multimodales:puede omitirse, el valor predeterminado es
adaptive; también puedes especificar explícitamente una proporción fija.
prompt, image_urls, audio_urls, messages y first_frame_image. Cuando recibas errores relacionados con este tipo de parámetros, elimina los campos antiguos y migra a content; por ejemplo, cambia "prompt": "一只猫挥手" por "content": [{"type": "text", "text": "一只猫挥手"}]。No envíes simultáneamente los dos formatos, nuevo y antiguo.
Parámetros de elementos de contenido content
Cada elemento de contenido debe tenertype, y los demás campos se determinan según el tipo:
Las direcciones de medios admiten tres formas:
- URL HTTPS de acceso público, recomendada para archivos grandes.
mm_file://{file_id}, hace referencia a archivos ya cargados o a resultados existentes.- URI de datos Base64 del tipo de medio correspondiente. Base64 aumenta el tamaño aproximadamente en un tercio; asegúrate de que todo el cuerpo de la solicitud no supere los 64 MB.
Especificaciones de materiales y límites de cantidad
Images, videos, and audio in multimodal reference scenarios total no more than 12 files. First/last frame scenarios and reference material scenarios are mutually exclusive: once
reference_image, reference_video, or reference_audio is used, first_frame or last_frame can no longer be used, and vice versa.
Production-level capability showcase
The following are not concept images or placeholder materials, but real reference inputs and actual video outputs from official MiniMax H3 production-level capability samples. The three groups of cases respectively cover brand shorts, live-action narratives, and fashion e-commerce, suitable for evaluating the model’s most critical capabilities in commercial production.
Here, “face capability” refers to character appearance consistency, facial details, and performance control in video generation, not identity recognition, face comparison, or face-swapping interfaces.
High-end brand short: unifying characters, products, and brand assets
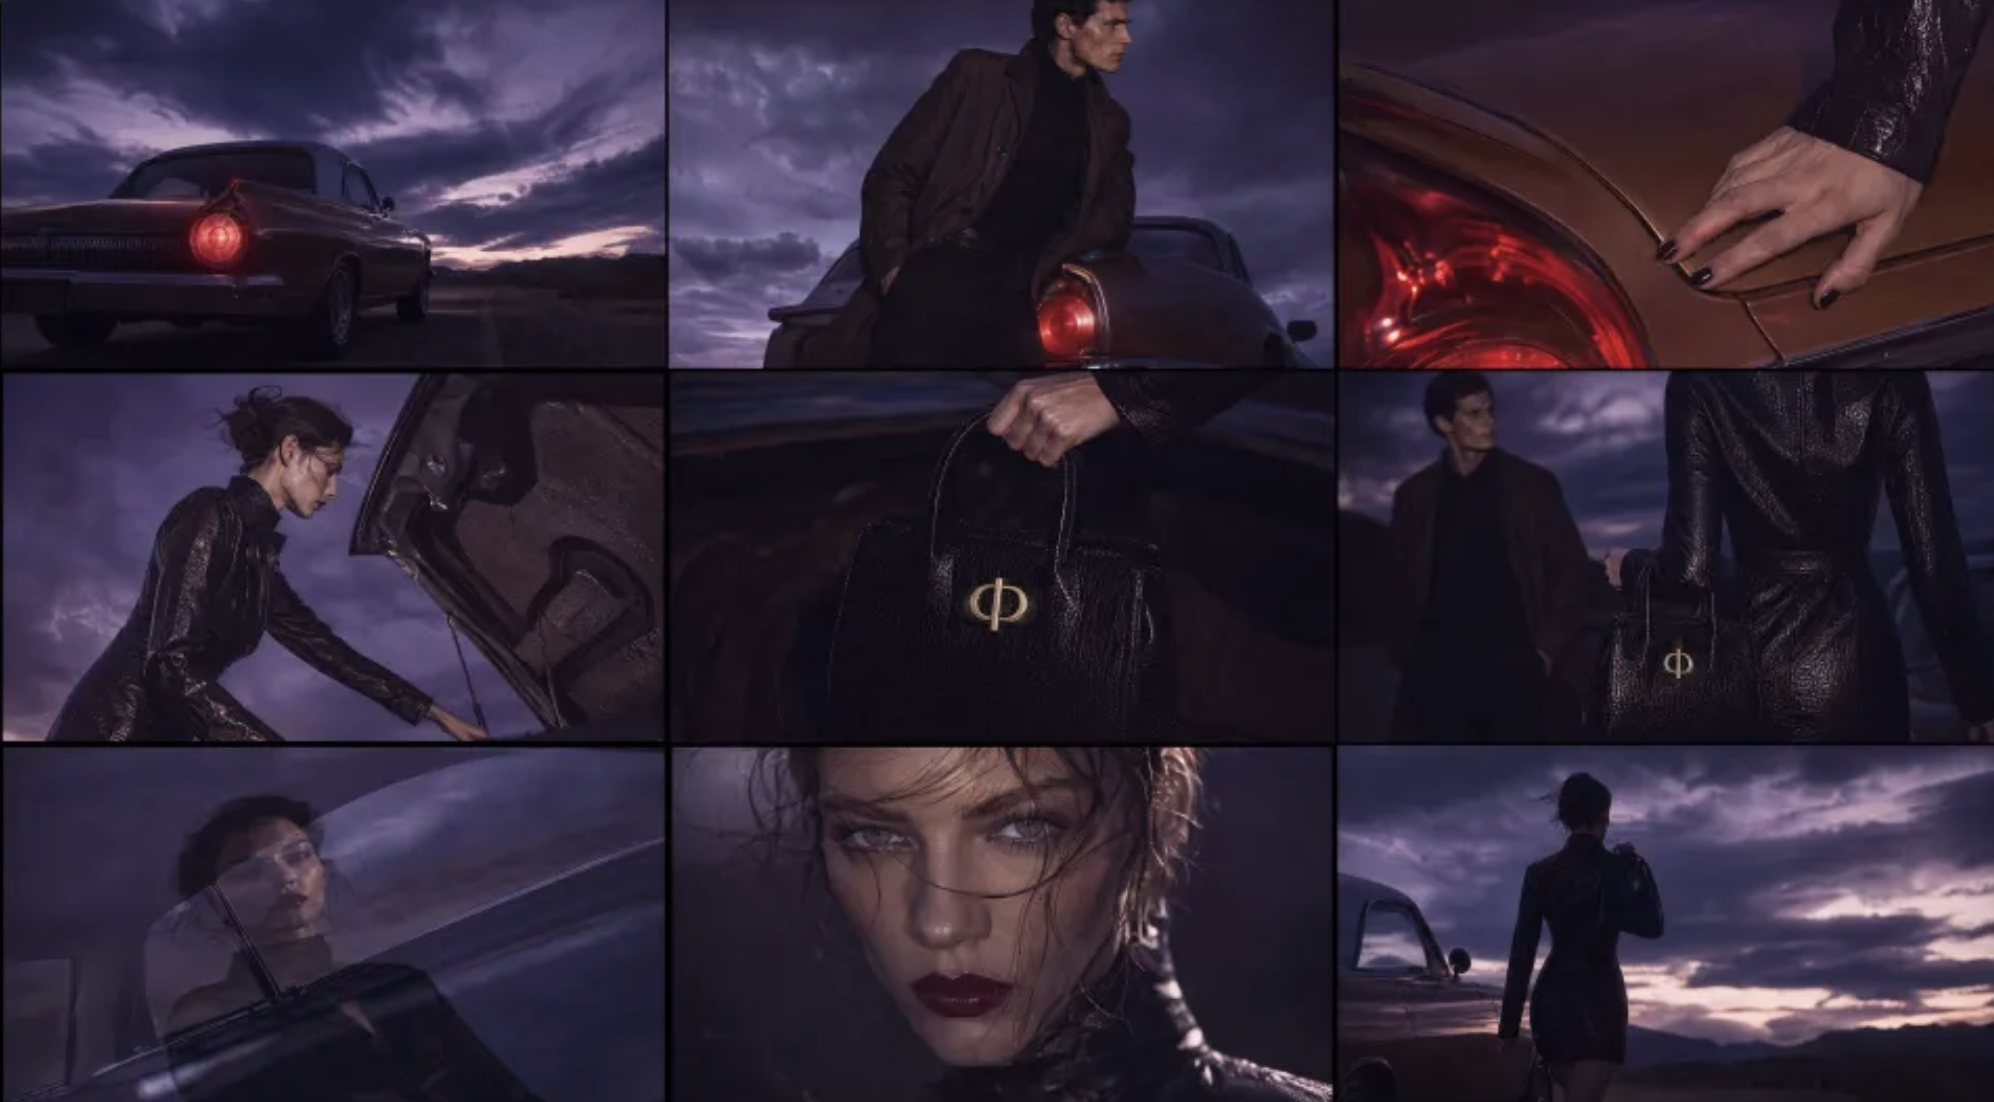
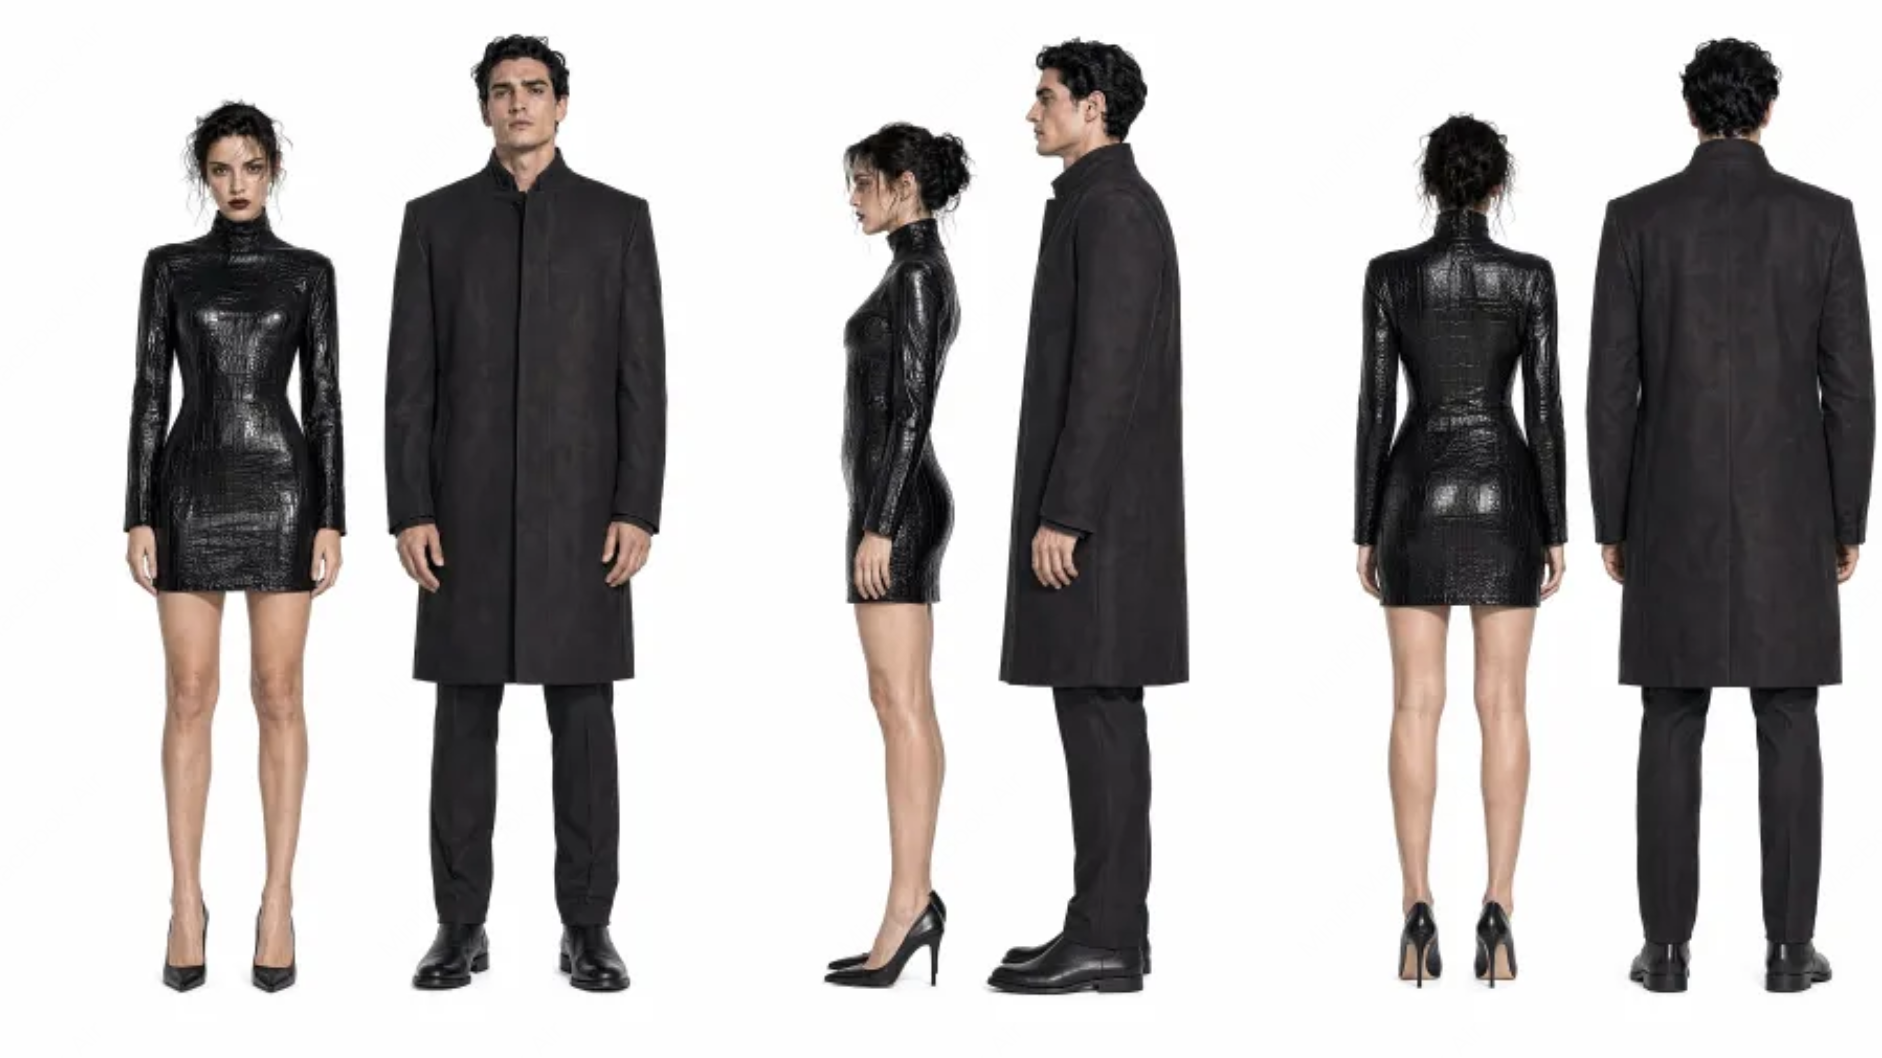
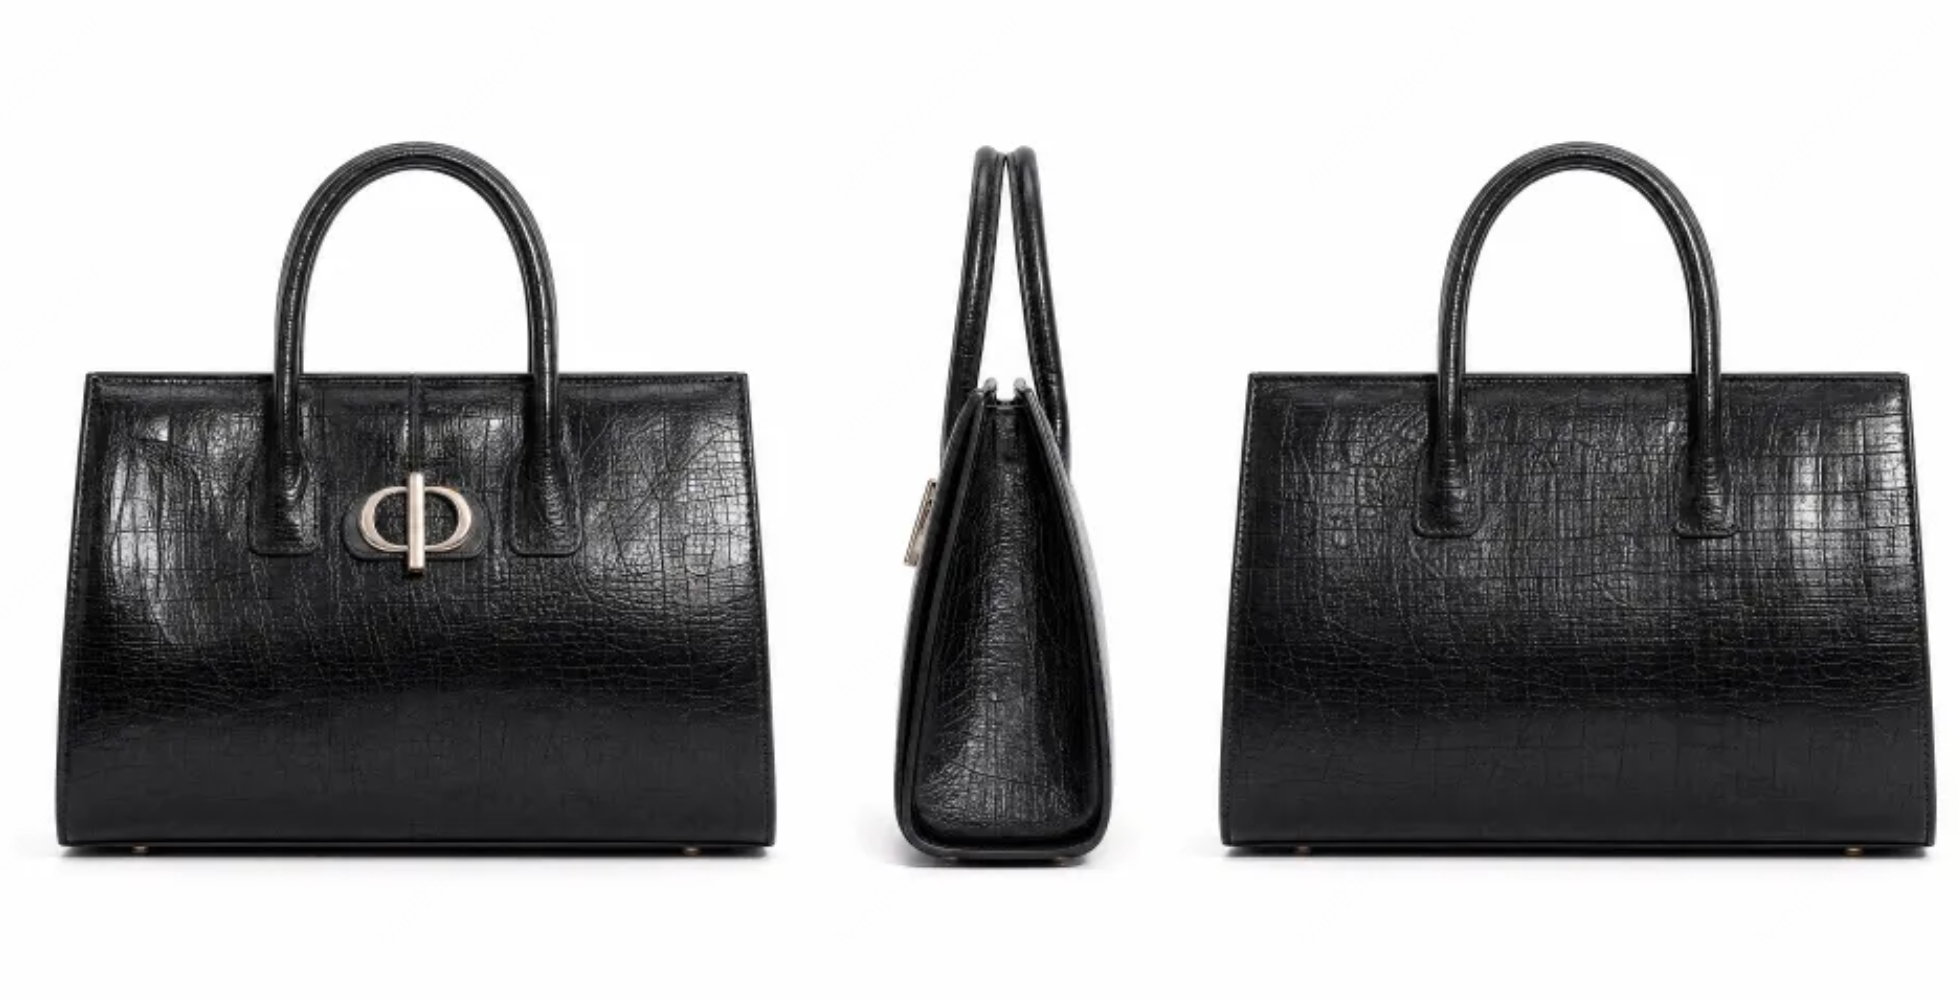
Production goal: 16:9 premium fashion brand film. Establish a cool atmosphere with a desert highway and a vintage car, maintain the female lead’s appearance and the structure of the black handbag, and naturally incorporate the brand Logo at the end. This case focuses on testing cross-shot character consistency, product preservation, cinematic texture, and brand closing capability.| Atmosphere and scene reference | Character reference |
|---|---|
 |  |
| Handbag product reference | Brand Logo reference |
|---|---|
 |  |
content organization method:
Live-action vertical short drama: face consistency and emotional performance
Objetivo de producción: Avance de minidrama romántico oscuro de 15 segundos, 9:16. Bloquea la apariencia de los personajes mediante las imágenes de referencia del protagonista y la protagonista, y restringe el espacio mediante la imagen de referencia del castillo antiguo; utiliza planos medios-cortos y primeros planos faciales para representar el enfrentamiento de miradas, el miedo, la contención y la sensación de peligro. Este caso es adecuado para observar la estabilidad de los rasgos faciales reales, las microexpresiones, las relaciones de mirada y la actuación continua.| Referencia del protagonista y la protagonista | Referencia de la escena del castillo antiguo |
|---|---|
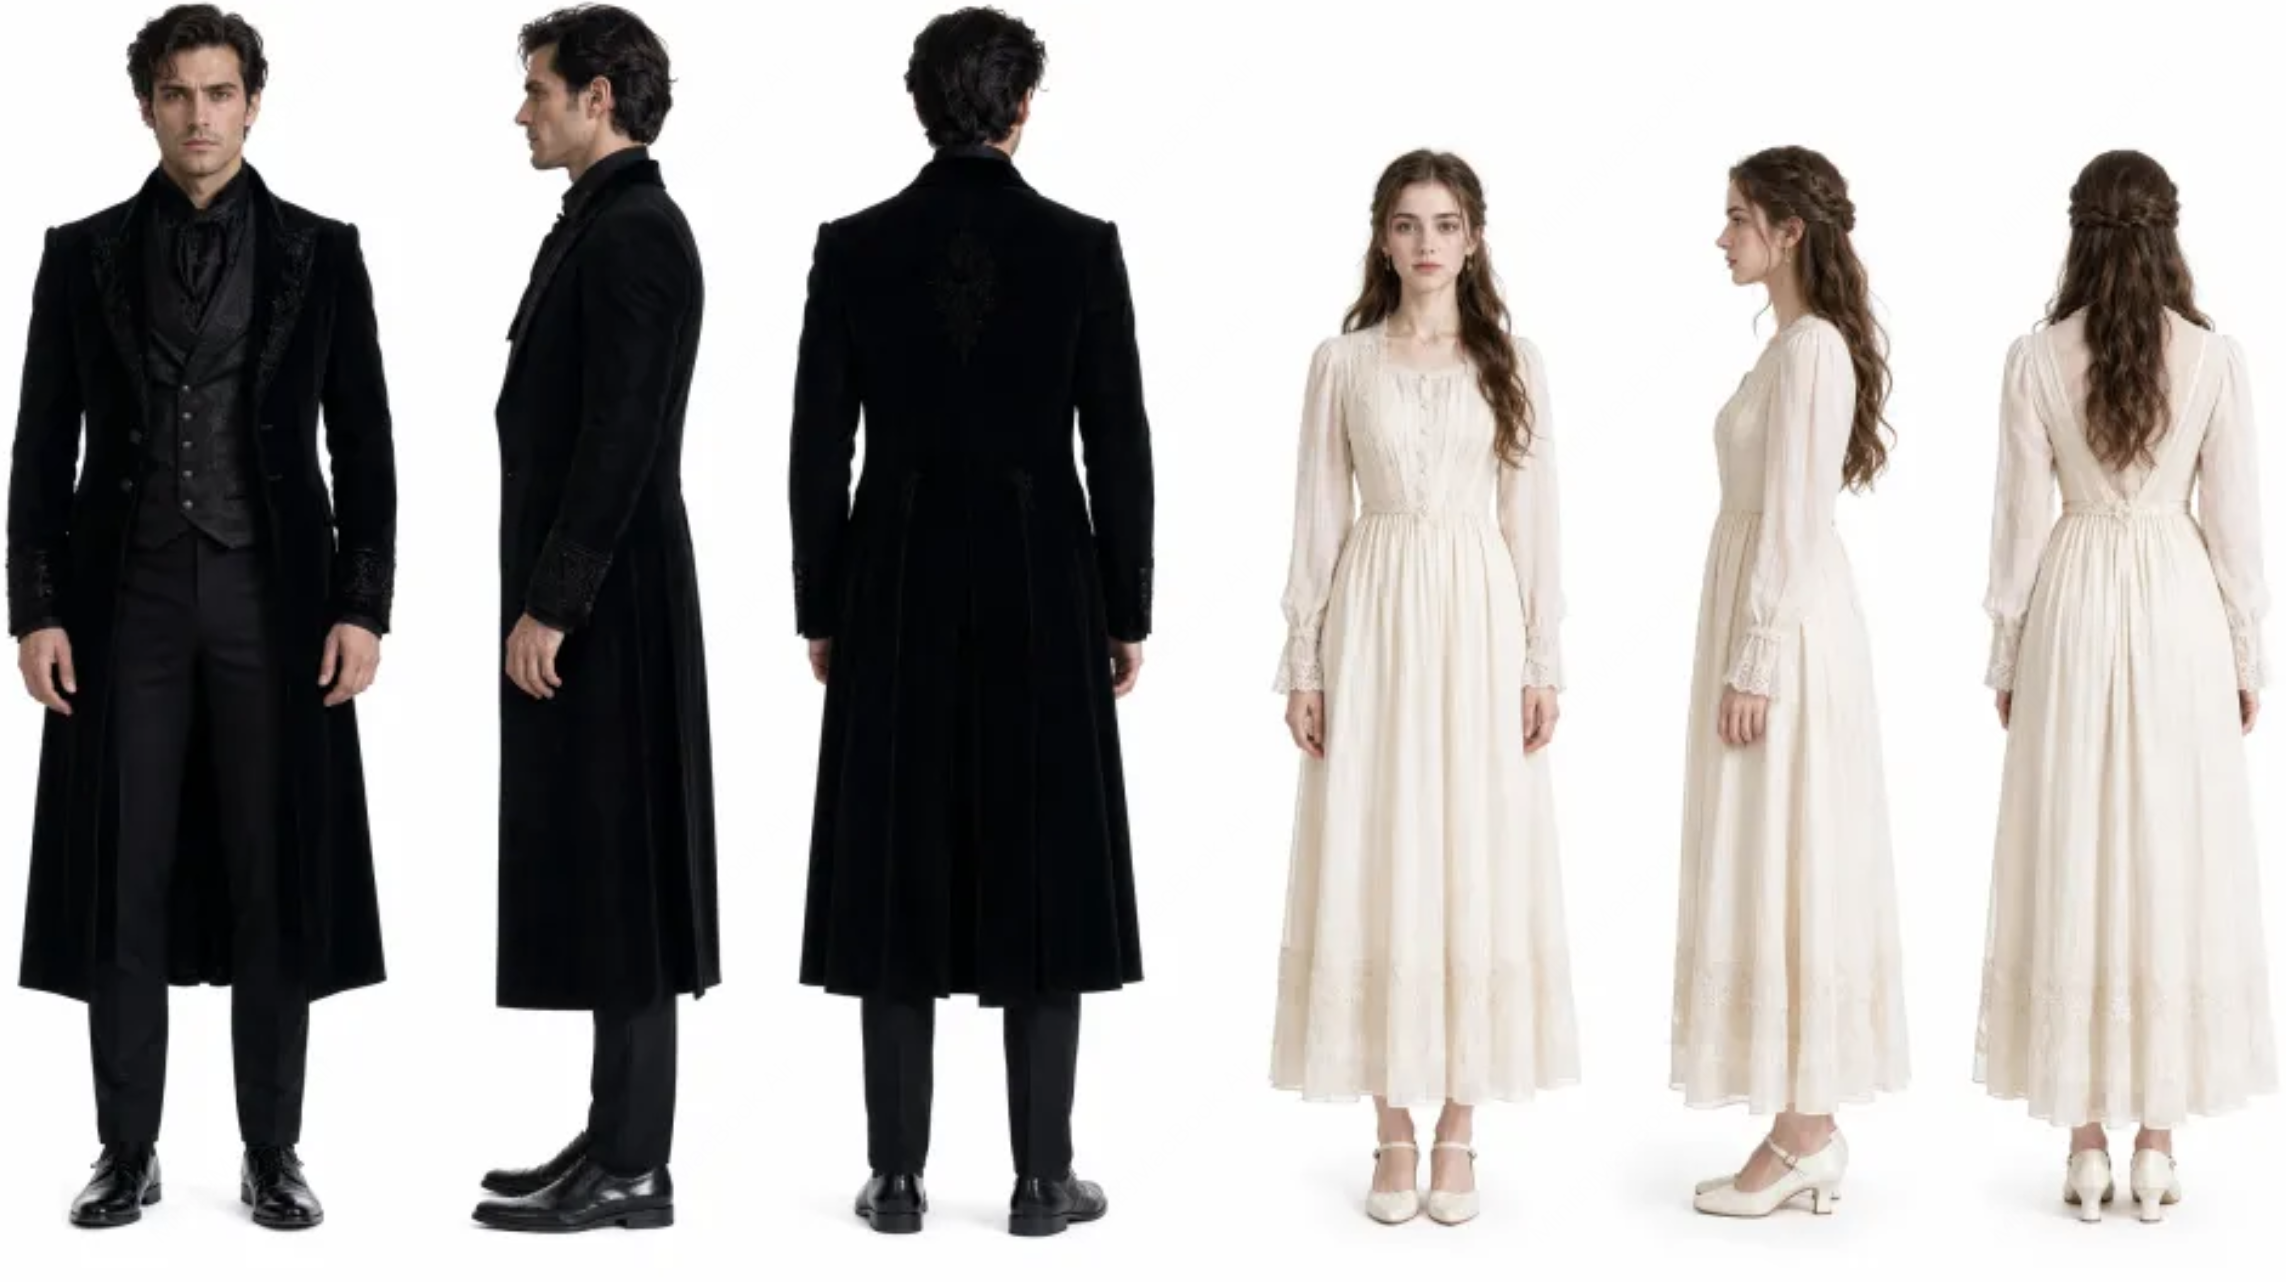 | 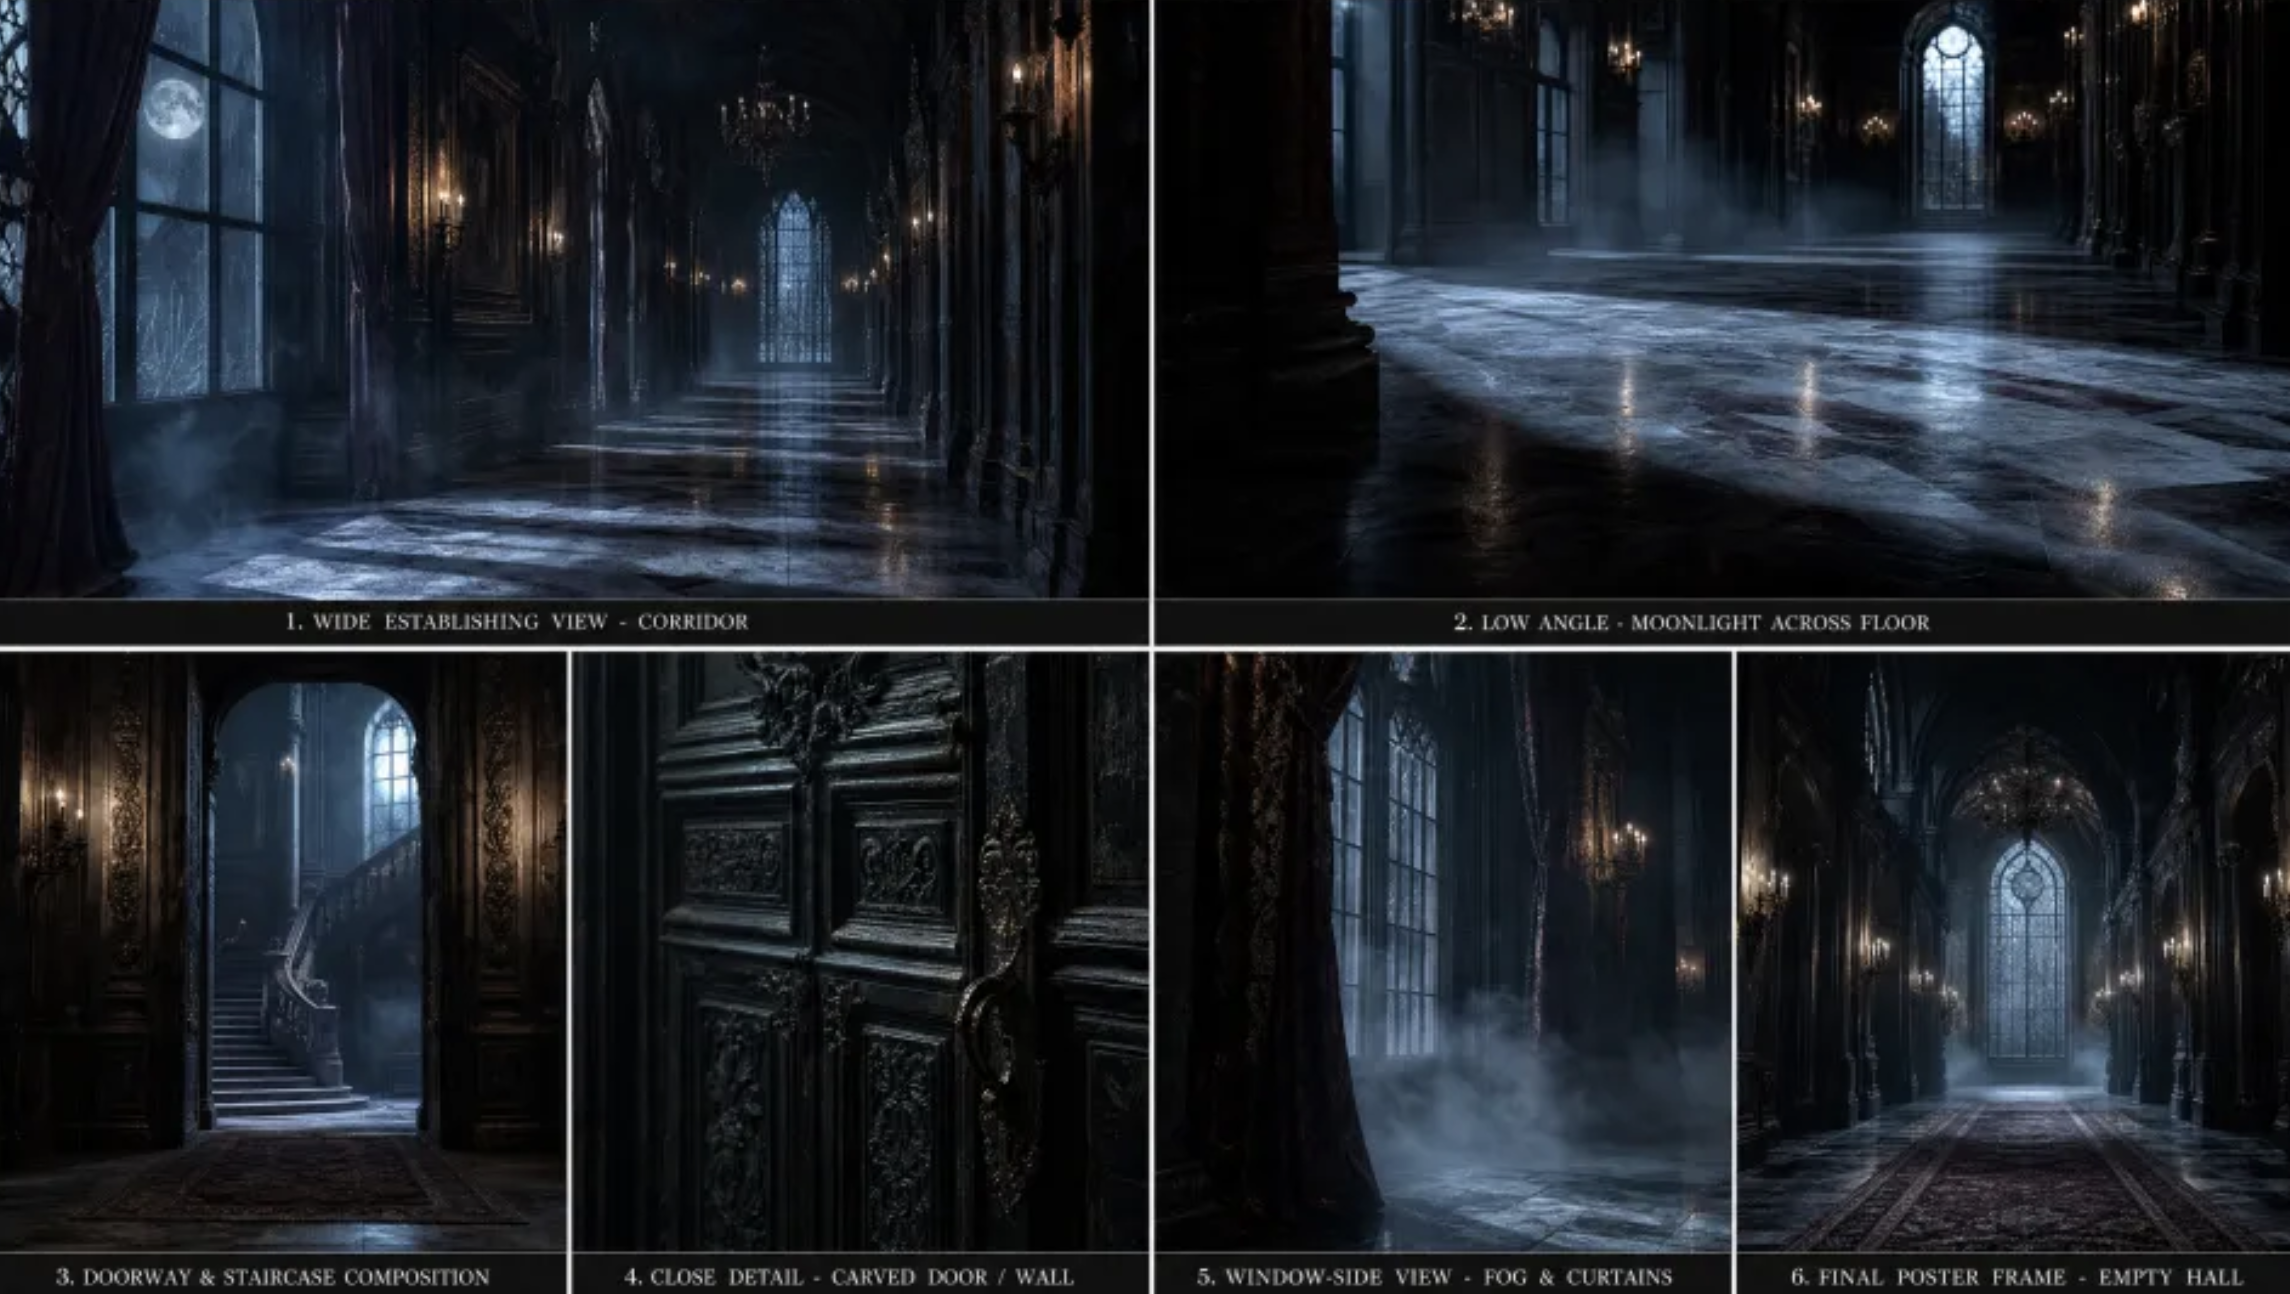 |
Anuncio de gafas de moda: conservación de detalles faciales y estructura del producto
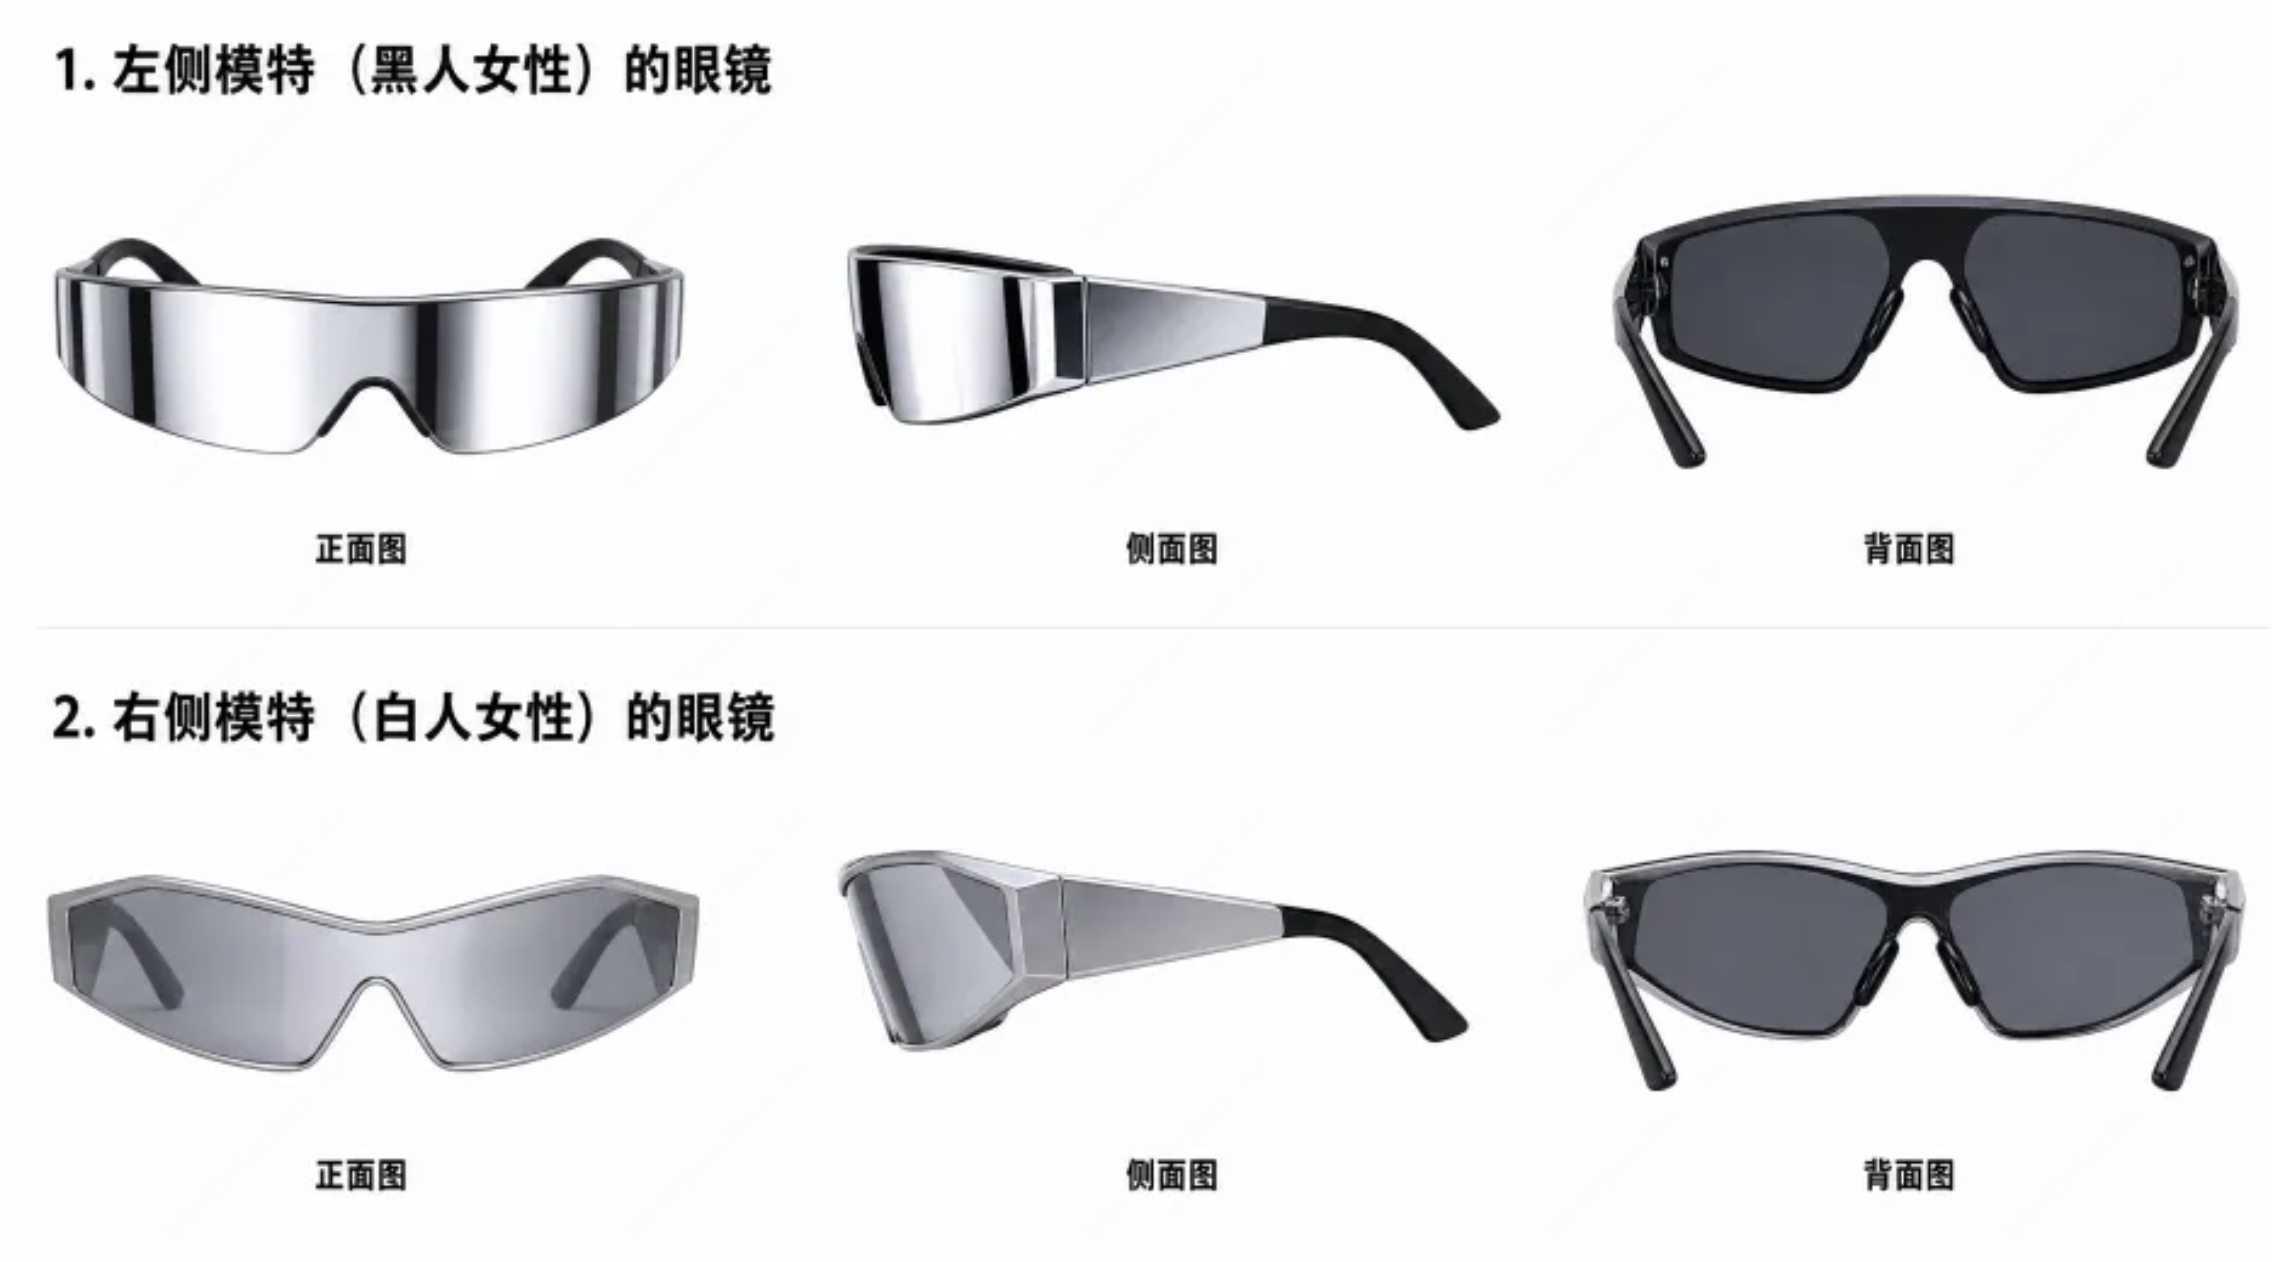
Objetivo de producción: Anuncio de gafas de moda de alta gama, 9:16. La imagen de cuerpo entero del personaje se encarga de la figura y la forma de caminar, la imagen de referencia facial se encarga de los rasgos y el maquillaje, y la imagen del producto se encarga de las curvas envolventes, los reflejos de las lentes, las patillas y el contorno de ojo de gato. Este caso pone a prueba simultáneamente los primeros planos faciales, la consistencia entre varias personas, la relación de uso y la estructura geométrica del producto.| Referencia de modelo y estilismo | Referencia de detalles faciales | Referencia del producto de gafas |
|---|---|---|
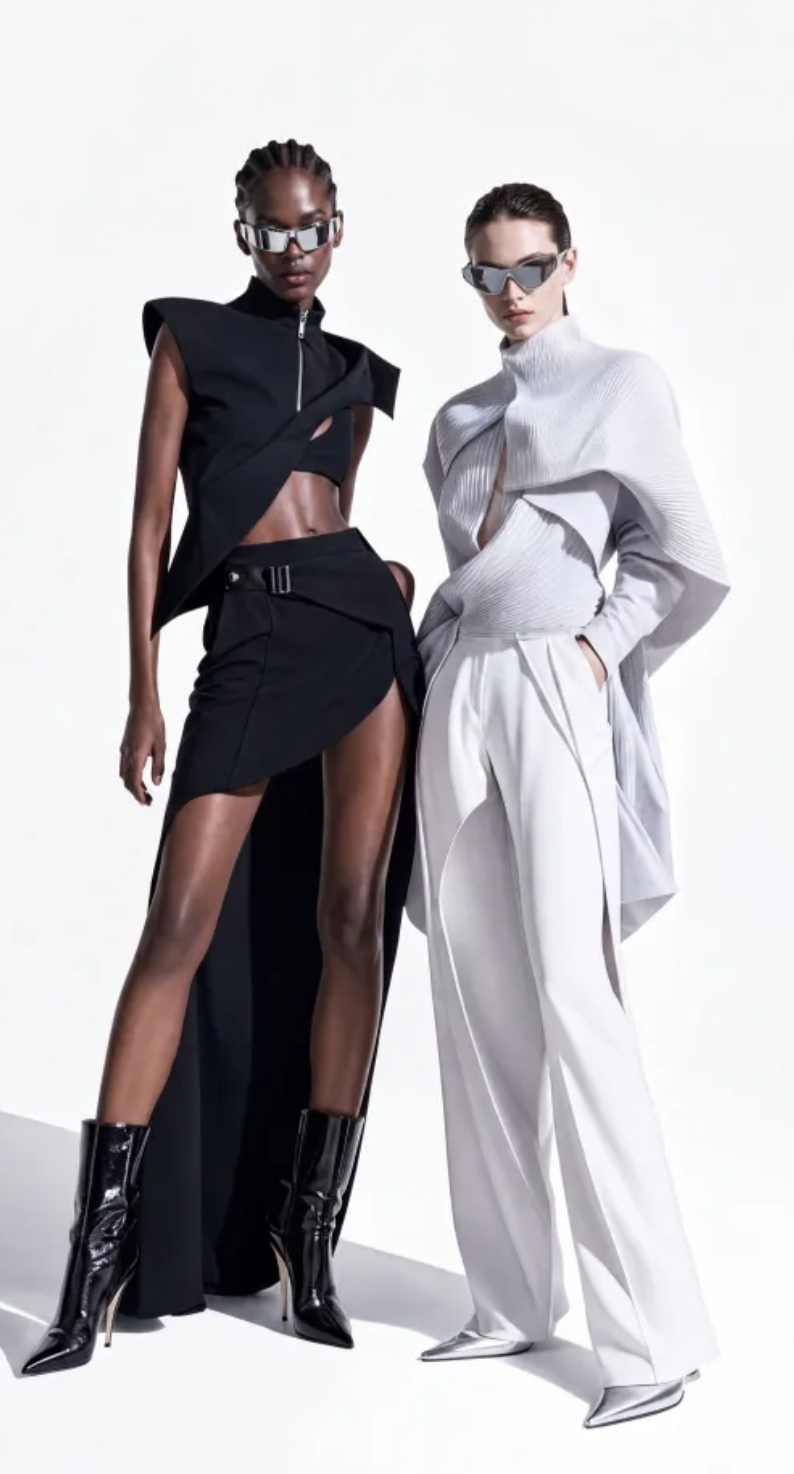 | 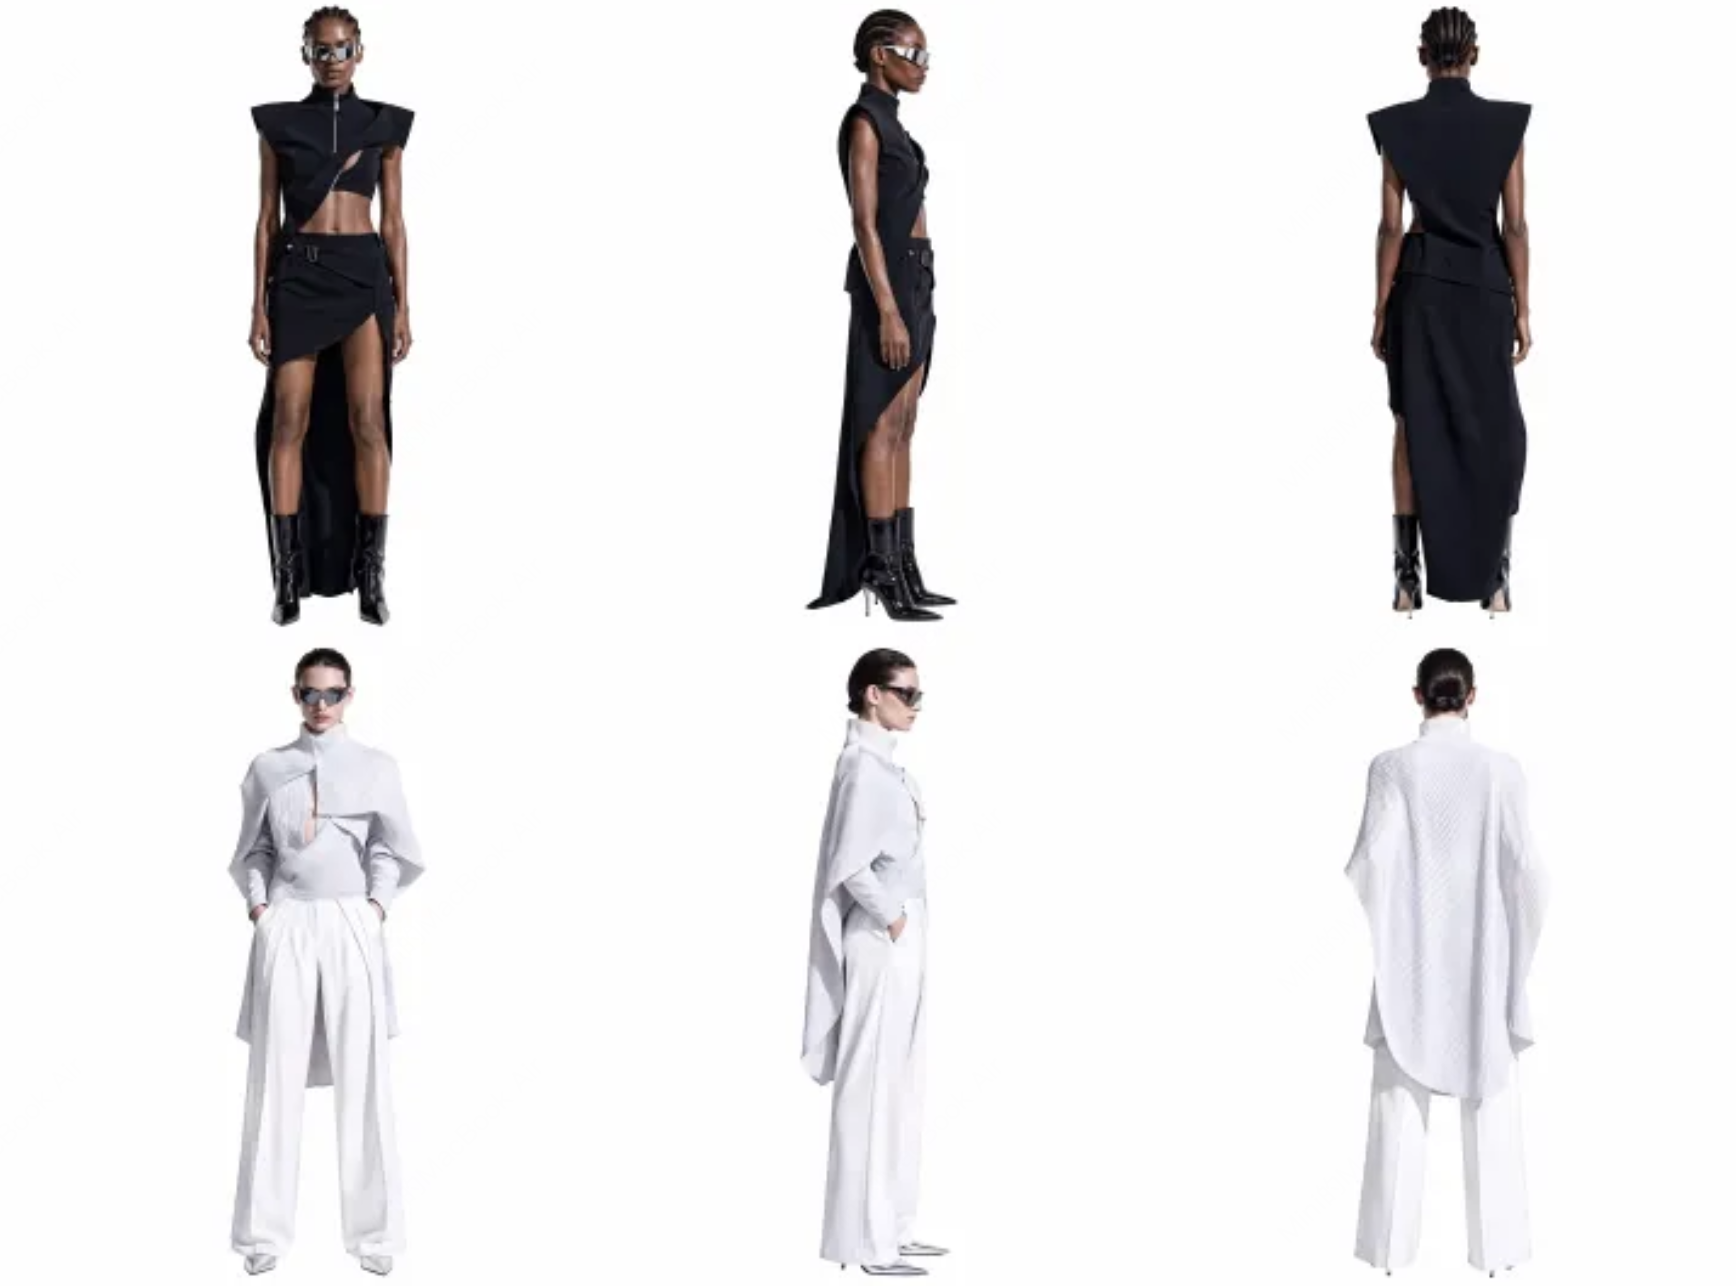 |  |
Texto a vídeo
Cuando solo hay un elemento de texto, se trata de texto a vídeo. Es adecuado para generar imágenes directamente a partir de una idea, guion o descripción de planos. El prompt puede organizarse en el orden de «sujeto + acción + escena + cámara + iluminación + sonido»."async": true a la solicitud, la interfaz devuelve inmediatamente:
Imagen de primer fotograma a vídeo
Marca la imagen comofirst_frame, y el modelo comenzará a generar a partir de esa imagen. Es adecuado para animar de forma natural carteles, imágenes de productos, ilustraciones de diseño de personajes y obras fotográficas.
Vídeo de fotograma final y de primer y último fotograma
Proporcionar sololast_frame permite que el modelo genere de forma natural hasta la imagen especificada; proporcionar simultáneamente first_frame y last_frame permite controlar claramente el punto de inicio y el punto final. Es adecuado para transiciones, cambios de forma, procesos de crecimiento o comparaciones de productos antes y después.
Generación de video con referencias multimodales
Los materiales de referencia se pueden usar en combinación: las imágenes de referencia controlan la apariencia de personajes o productos, los videos de referencia controlan las acciones y el movimiento de cámara, y los audios de referencia controlan el tono de voz de los diálogos, la música o el ritmo de edición. En el prompt se debe indicar claramente qué debe controlar cada tipo de material, evitando subir materiales sin proporcionar su relación.Notificación de devolución de llamada
Al pasarcallback_url se habilita automáticamente el modo asíncrono: la interfaz de creación devuelve inmediatamente task_id y trace_id, y envía mediante POST el resultado final a esa dirección después de que la tarea se complete; la estructura es coherente con la respuesta de consulta de tareas.
Los estados finales en la devolución de llamada son succeeded, failed o cancelled. Incluso si se utiliza una devolución de llamada, también se recomienda guardar task_id, para poder consultar activamente o compensar las notificaciones omitidas.
Errores comunes
task.status: succeeded en la respuesta síncrona indica que el video se ha generado; la confirmación asíncrona solo representa que la tarea ha entrado en la cola. Solo se cobrará cuando la tarea se complete correctamente; consultar las tareas es gratuito y no generará cargos duplicados.
H3 Max
MiniMax-H3-Max admite 480P o 768P, y duraciones enteras de 5 a 15 segundos. La entrada de audio no tiene coste adicional, las primeras 2 imágenes son gratuitas y las que excedan se cobran por imagen; los videos de referencia se cobran según la duración real de entrada. Este modelo no admite 2K.