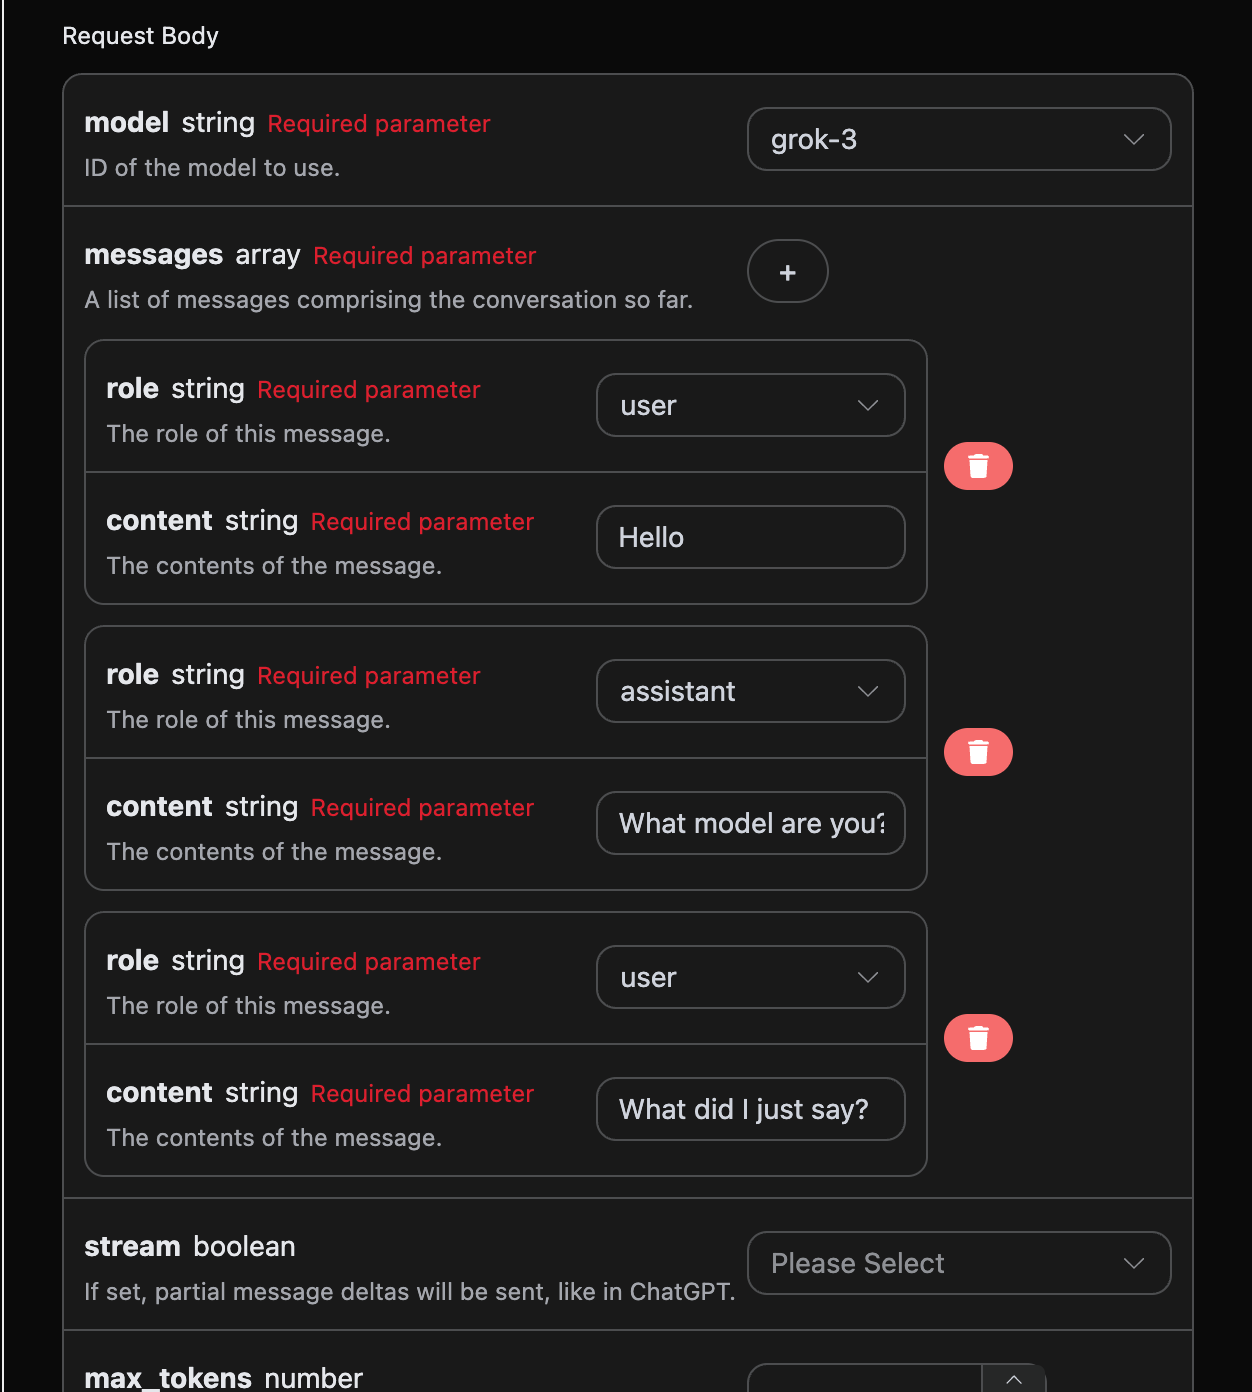
data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"role": "assistant"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "¡Hola, "}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "¿qué"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data:
{"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "'s g"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "bueno?"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": " Rea"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "dy t"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "o di"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "ve i"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "nto "}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "qué"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "siempre"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": " tú"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "'re "}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "pond"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "erin"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "g ab"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "fuera "}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "toda"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "y?"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {}, "logprobs": null, "finish_reason": "stop", "index": 0}], "usage": {"prompt_tokens": 0, "completion_tokens": 0, "total_tokens": 0, "prompt_tokens_details": {"cached_tokens": 0, "text_tokens": 0, "audio_tokens": 0, "image_tokens": 0}, "completion_tokens_details": {"text_tokens": 0, "audio_tokens": 0, "reasoning_tokens": 0}, "input_tokens": 0, "output_tokens": 0, "input_tokens_details": null}}

data:
{"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": "", "choices": [], "usage": {"prompt_tokens": 8, "completion_tokens": 18, "total_tokens": 26, "prompt_tokens_details": {"cached_tokens": 0, "text_tokens": 0, "audio_tokens": 0, "image_tokens": 0}, "completion_tokens_details": {"text_tokens": 0, "audio_tokens": 0, "reasoning_tokens": 0}, "input_tokens": 0, "output_tokens": 0, "input_tokens_details": null}}

data: [DONE]


 Si aún no has iniciado sesión o registrado, serás redirigido automáticamente a la página de inicio de sesión que te invitará a registrarte e iniciar sesión. Una vez completado, serás devuelto automáticamente a la página actual.
Un Token de API es suficiente para acceder a todos los servicios de la plataforma, sin necesidad de solicitar uno por cada servicio. La primera solicitud te otorgará un crédito gratuito para que puedas probarlo; si el crédito es insuficiente, puedes recargar el saldo general en la consola.