

GPT-6.1 Sol
Utilicemodel: "gpt-6.1-sol" para seleccionar este modelo. Admite salida en streaming, llamadas a funciones, salida estructurada y entrada de imágenes. Durante la primera semana desde su apertura, solo estará disponible para titulares verificados de ACE T1+ (al menos 100,000 ACE) o usuarios autorizados; la hora específica de apertura estará sujeta al aviso de acceso de la consola.
Los niveles de razonamiento admiten low, medium, high, xhigh y max; por el momento no se admiten none ni minimal. Se recomienda comenzar con reasoning_effort: "low". Cuando la entrada supere los 272,000 tokens, se aplicará el precio de contexto largo a toda la solicitud; el costo estará sujeto al precio actual de la consola.
Proceso de solicitud
Para utilizar OpenAI Chat Completion API, primero obtenga su API Token en la consola de Ace Data Cloud y guárdelo como respaldo. Si aún no ha iniciado sesión o no se ha registrado, será redirigido automáticamente a la página de inicio de sesión para invitarle a registrarse e iniciar sesión; al completarlo, volverá automáticamente a la página actual.
Un solo API Token permite llamar a todos los servicios de la plataforma, sin necesidad de solicitar uno por separado para cada servicio. La primera solicitud incluye una cuota gratuita para probarlo sin costo; cuando la cuota sea insuficiente, puede recargar saldo general en la consola.
📘 Documentación completa: OpenAI Chat Completion API →
Uso básico
A continuación, puede completar el contenido correspondiente en la interfaz, como se muestra en la imagen: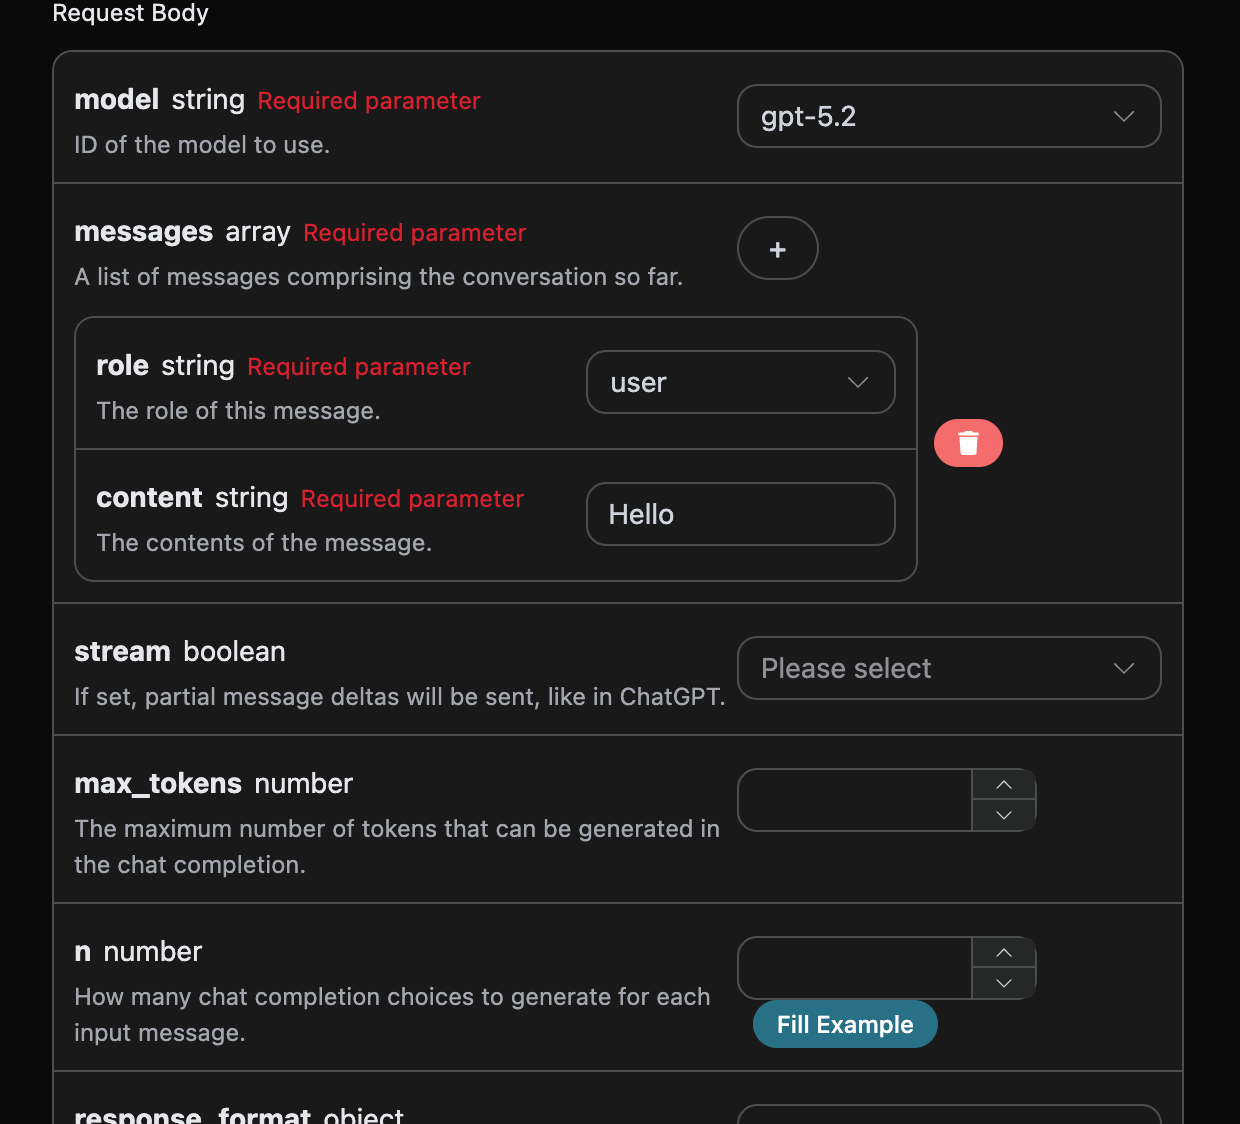
authorization, que puede seleccionarse directamente en la lista desplegable. Otro parámetro es model; model es la categoría de modelo del sitio web oficial de OpenAI ChatGPT que elegimos utilizar. Aquí disponemos principalmente de 20 modelos; para más detalles puede consultar los modelos que proporcionamos. El último parámetro es messages; messages es el arreglo de prompts que introducimos. Es un arreglo, lo que indica que se pueden cargar varios prompts al mismo tiempo. Cada prompt contiene role y content, donde role representa el rol del preguntador. Proporcionamos tres identidades: user, assistant y system. El otro, content, es el contenido específico de nuestra pregunta.
Al mismo tiempo, puede observar que en el lado derecho se genera el código de llamada correspondiente; puede copiar el código y ejecutarlo directamente, o hacer clic directamente en el botón «Try» para realizar una prueba.
Parámetros opcionales comunes:
max_tokens: limita el número máximo de tokens de una sola respuesta.temperature: aleatoriedad de la generación, entre 0 y 2; cuanto mayor sea el valor, más disperso será.n: cuántas respuestas candidatas se generan de una vez.response_format: configuración del formato de retorno.
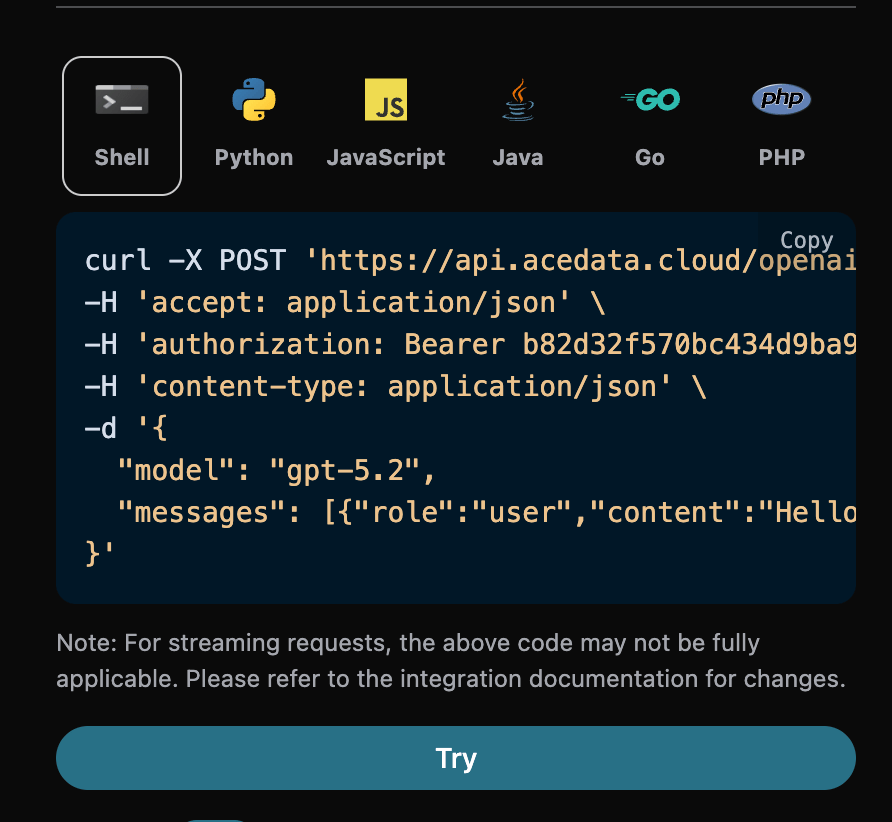
id, el ID generado para esta tarea de conversación, utilizado para identificar de forma única esta tarea de conversación.model, el modelo del sitio web oficial de OpenAI ChatGPT seleccionado.choices, la información de respuesta proporcionada por ChatGPT para el prompt.usage: información estadística sobre los tokens de esta sesión de preguntas y respuestas.
choices contiene la información de respuesta de ChatGPT; el choices dentro de él es ChatGPT, como se puede observar en la imagen.
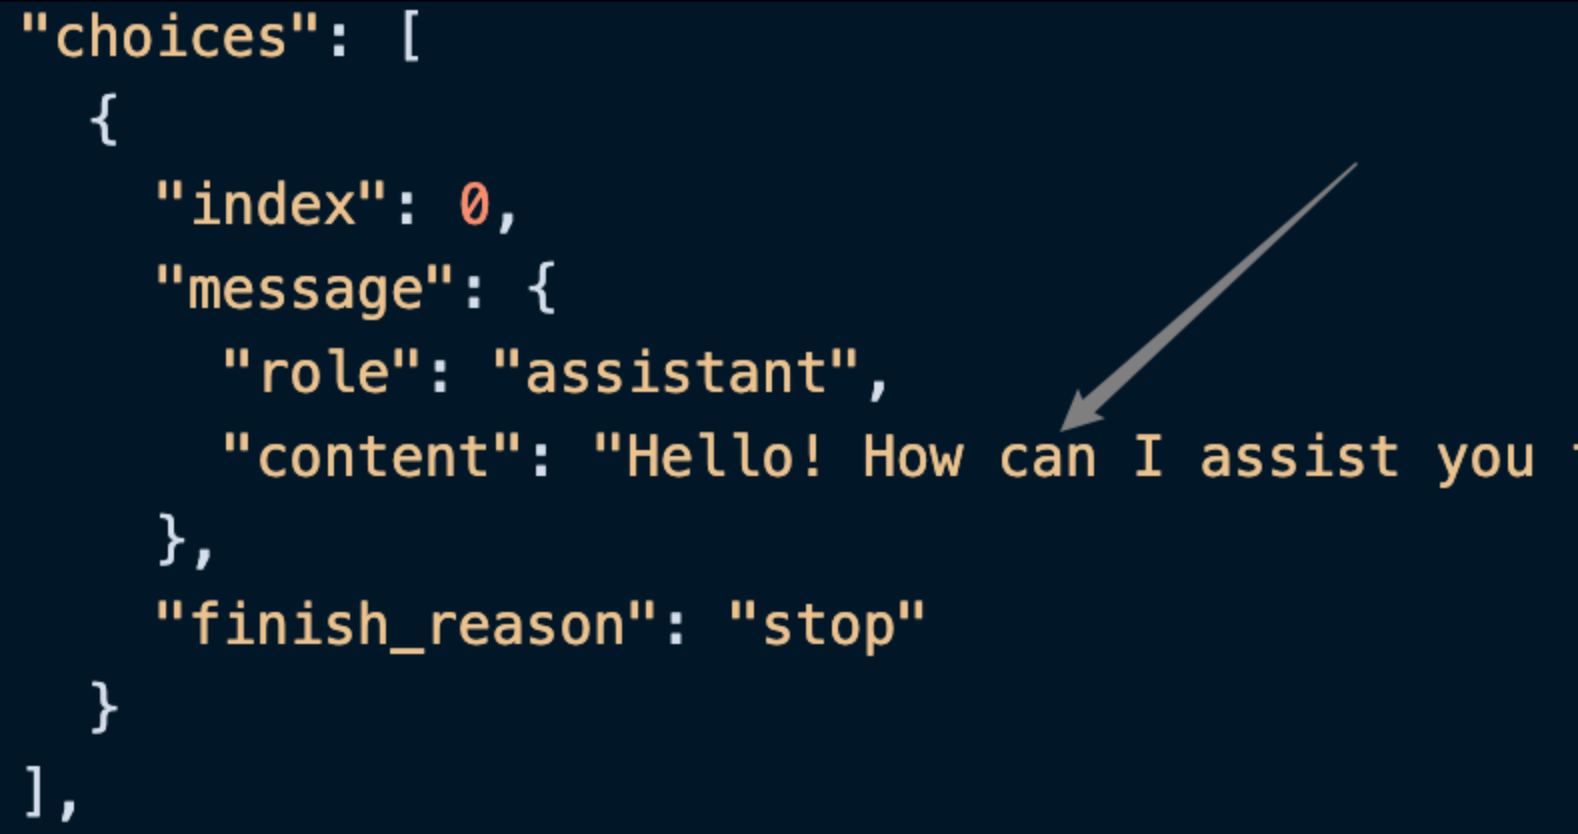
content dentro de choices contiene el contenido específico de la respuesta de ChatGPT.
Respuesta en streaming
Esta interfaz también admite respuestas en streaming, lo cual es muy útil para la integración web y puede permitir que la página web logre un efecto de visualización carácter por carácter. Si desea devolver respuestas en streaming, puede cambiar el parámetrostream en el encabezado de la solicitud a true.
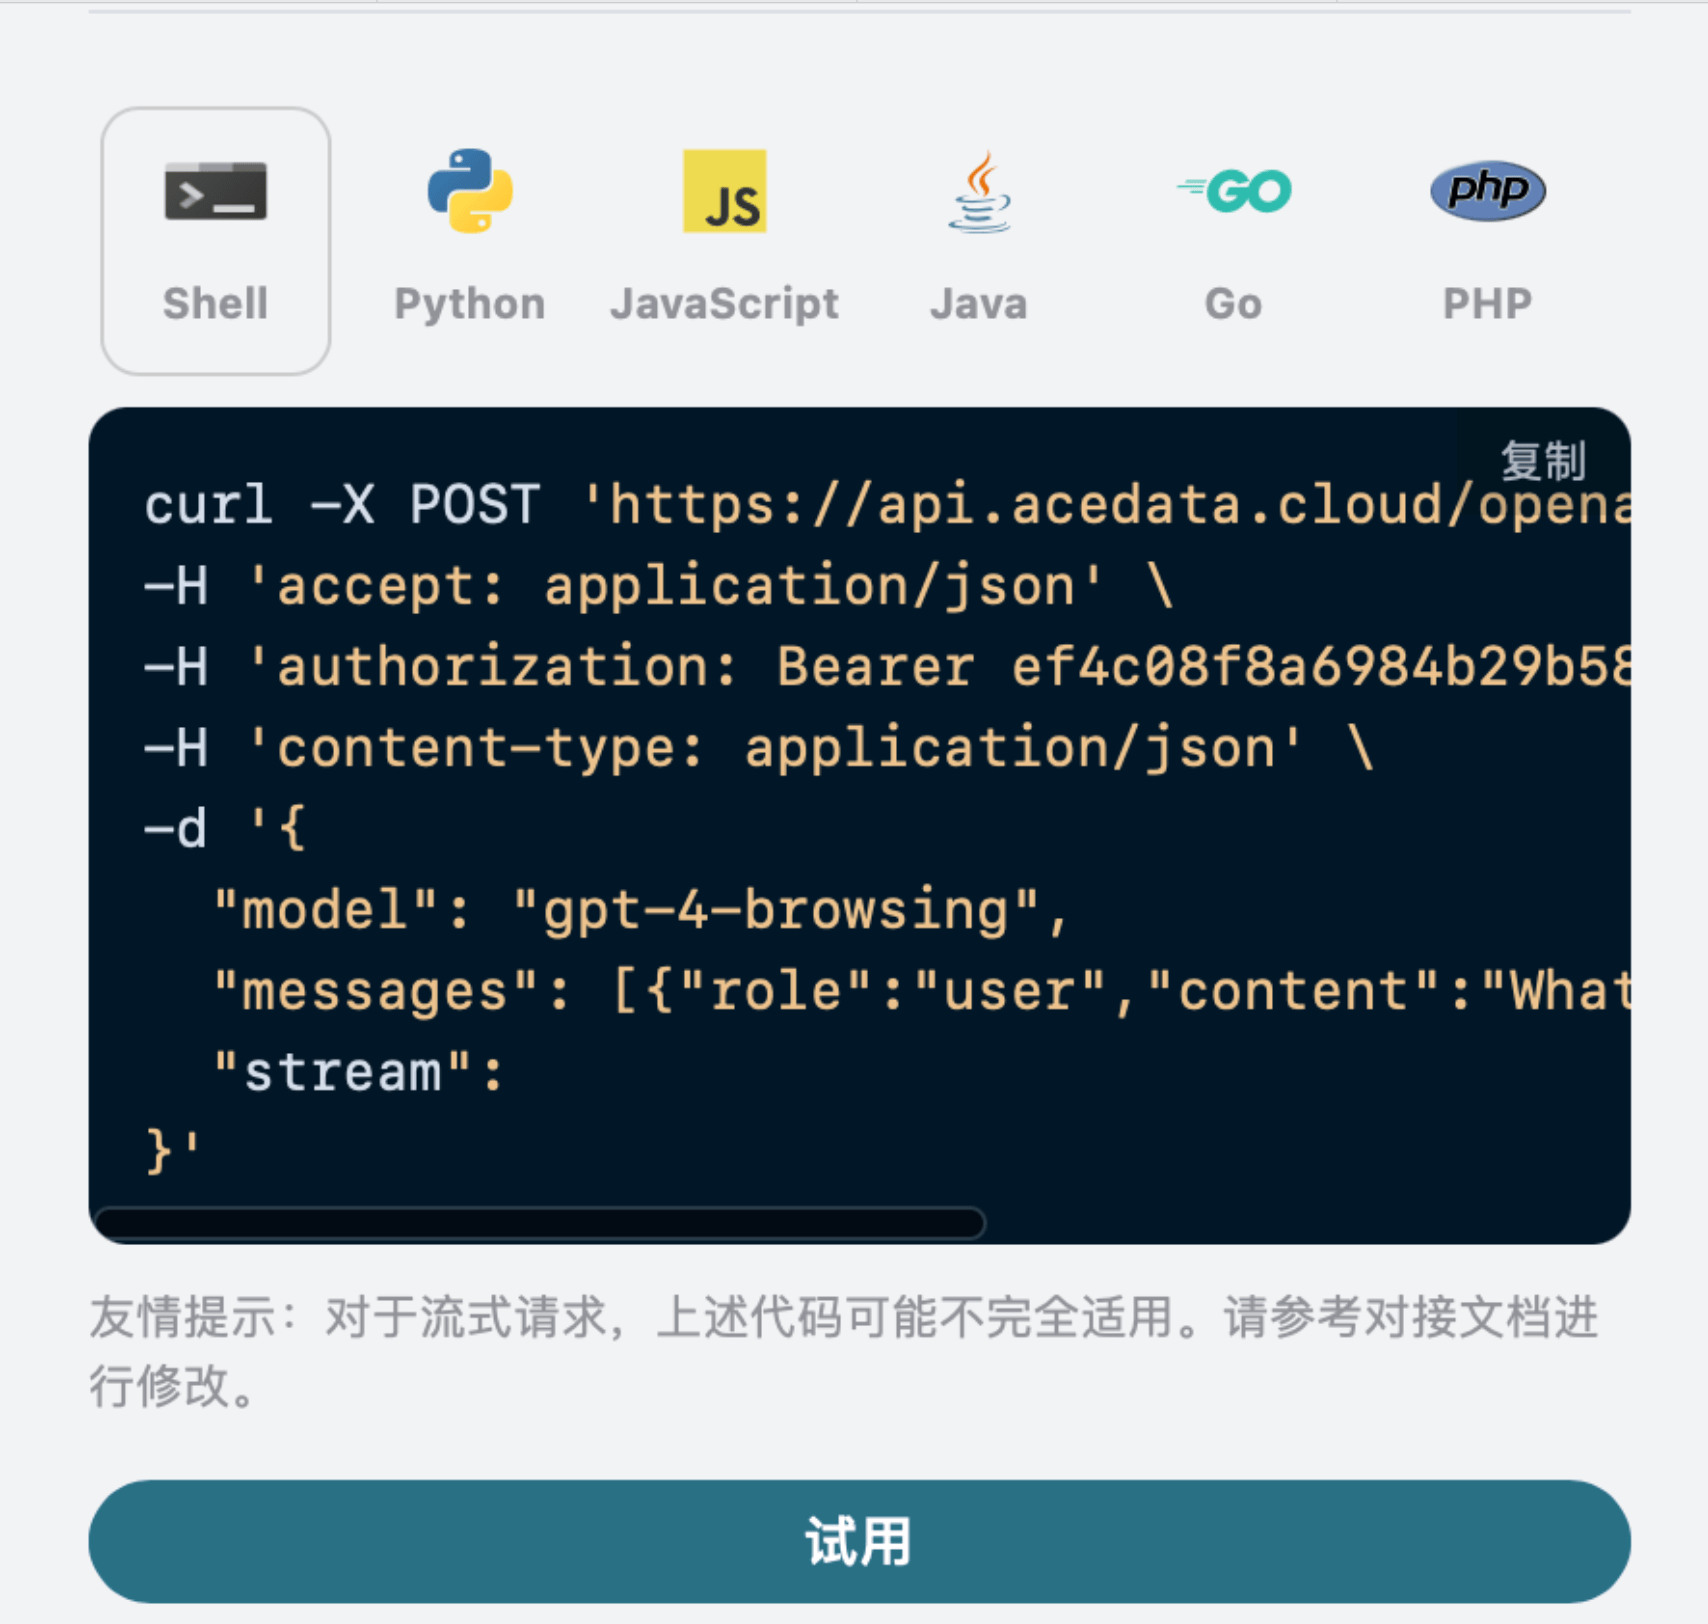
La modificación se muestra en la imagen; sin embargo, el código de llamada debe modificarse correspondientemente para admitir respuestas en streaming.
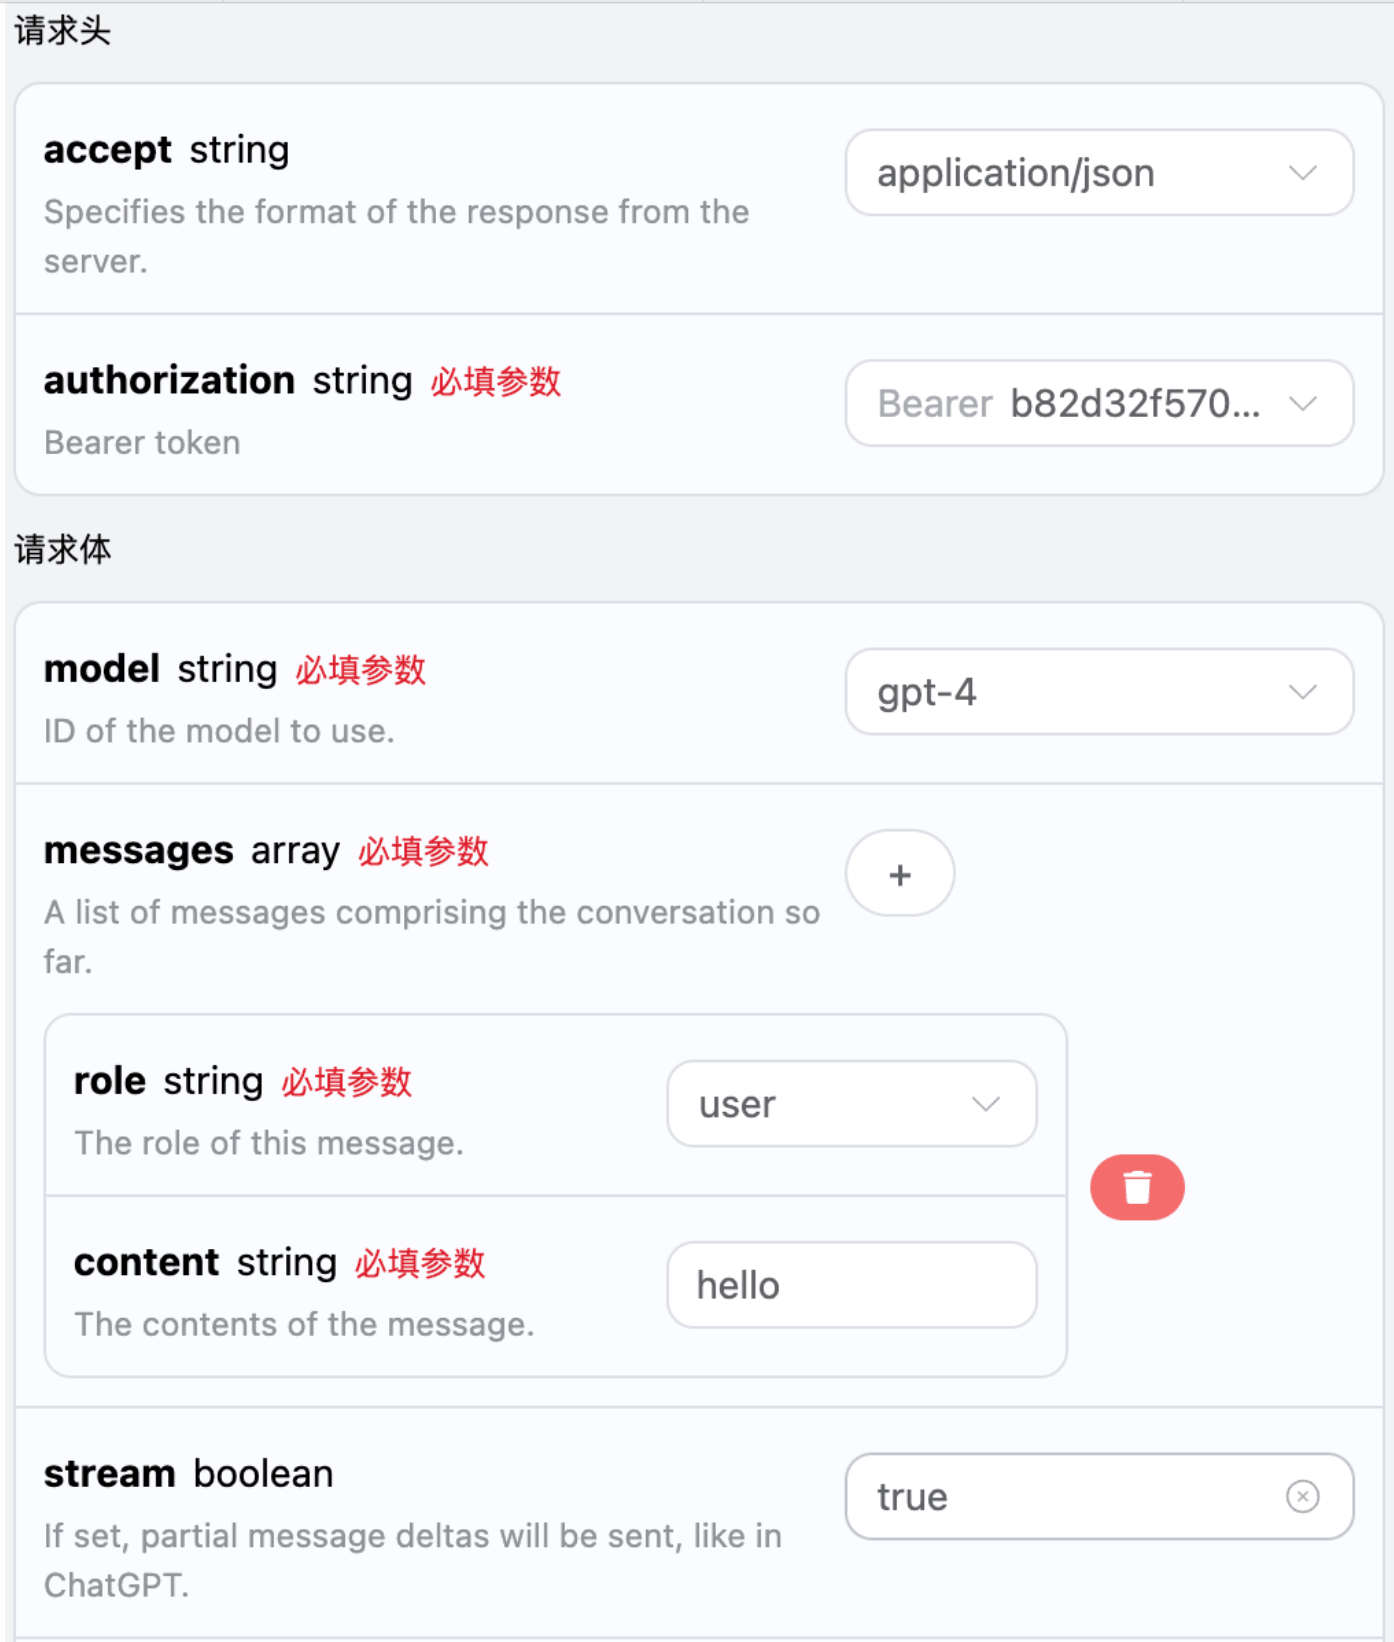
stream a true, la API devolverá los datos JSON correspondientes línea por línea; a nivel de código, necesitamos realizar las modificaciones correspondientes para obtener los resultados línea por línea.
Código de llamada de ejemplo en Python:
data en la respuesta, y los choices dentro de data son el contenido de respuesta más reciente, lo cual es coherente con el contenido presentado anteriormente. choices es el contenido de respuesta añadido; puede conectarlo a su sistema según el resultado. Al mismo tiempo, el final de la respuesta en streaming se determina según el contenido de data; si el contenido es [DONE], indica que la respuesta de la transmisión ha finalizado por completo. El resultado de data devuelto tiene varios campos, que se presentan a continuación:
id, el ID de la tarea de conversación generada esta vez, utilizado para identificar de forma única esta tarea de conversación.model, el modelo del sitio web oficial de OpenAI ChatGPT seleccionado.choices, la información de respuesta proporcionada por ChatGPT para las palabras de consulta.
Conversación de múltiples rondas
Si desea integrar la función de conversación de múltiples rondas, necesita cargar varias palabras de consulta en el campomessages; un ejemplo específico de varias palabras de consulta se muestra en la siguiente imagen:
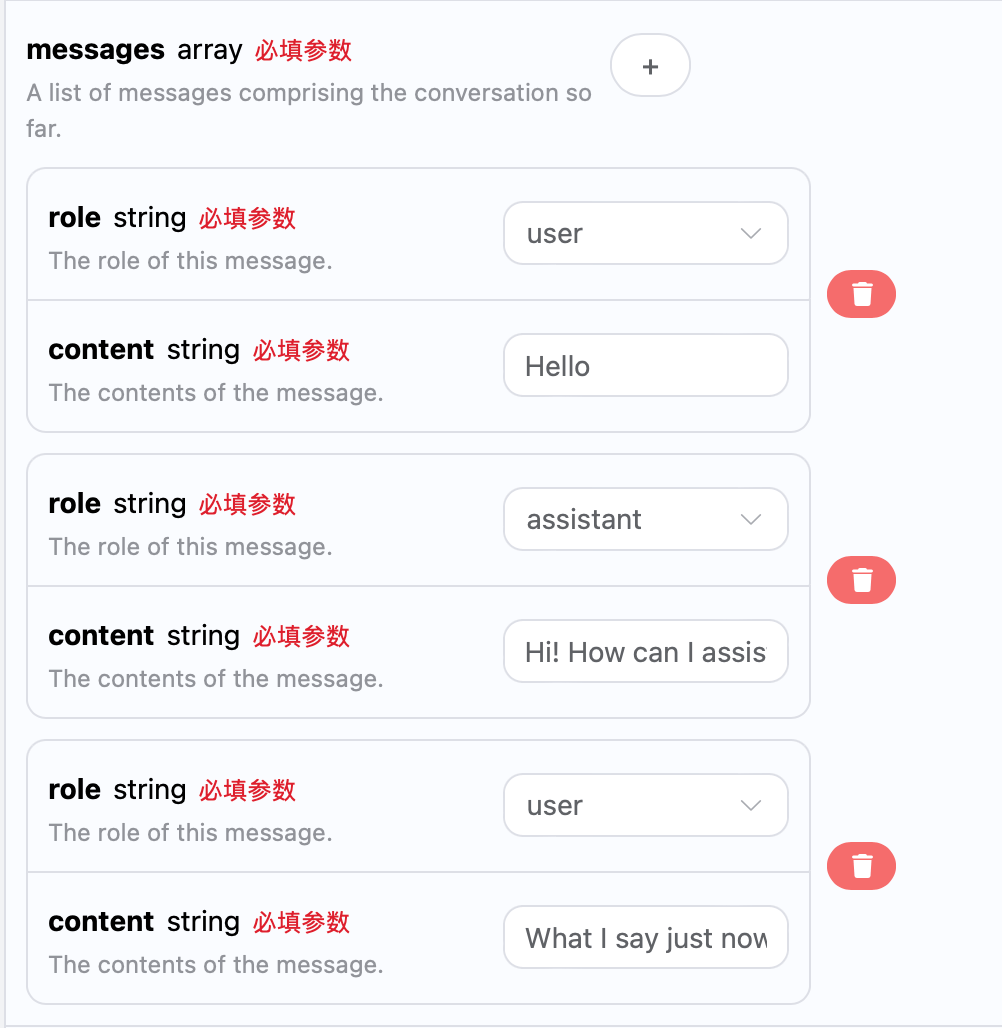
choices es coherente con el contenido del uso básico; esta incluye el contenido específico de las respuestas de ChatGPT a múltiples conversaciones, de modo que se pueden responder las preguntas correspondientes según el contenido de múltiples conversaciones.
Integración con OpenAI-Python
La API de OpenAI Chat Completion mantiene la compatibilidad con la interfaz oficial de OpenAI, y puede integrarse directamente mediante el SDK oficial OpenAI-Python. Este artículo presentará brevemente el método de uso.- Primero es necesario configurar un entorno local de
Python; este proceso se puede buscar en Google. - Descargue e instale un entorno de desarrollo, por ejemplo, el editor VSCode.
- Configure las variables de entorno de
OpenAI.
- En la carpeta del proyecto, cree un archivo llamado
.envy guárdelo. - Contenido del archivo
.env:
sk-xxx con su propia key. OPENAI_BASE_URL es la interfaz proxy para acceder a OpenAI.
- Instale los paquetes de los que depende el proyecto.
- Cree un archivo de código fuente de ejemplo.
index.py; el contenido específico es el siguiente:
Modelos con conexión a Internet
Los modelos gpt-3.5-browsing y gpt-4-browsing son diferentes de otros modelos: pueden realizar búsquedas en Internet según los mensajes de consulta y devolverle los resultados de las búsquedas en Internet con los ajustes adecuados. Este artículo demostrará la función de conexión a Internet mediante un ejemplo concreto. A continuación, puede completar el contenido correspondiente en la interfaz de OpenAI Chat Completion API, como se muestra en la imagen: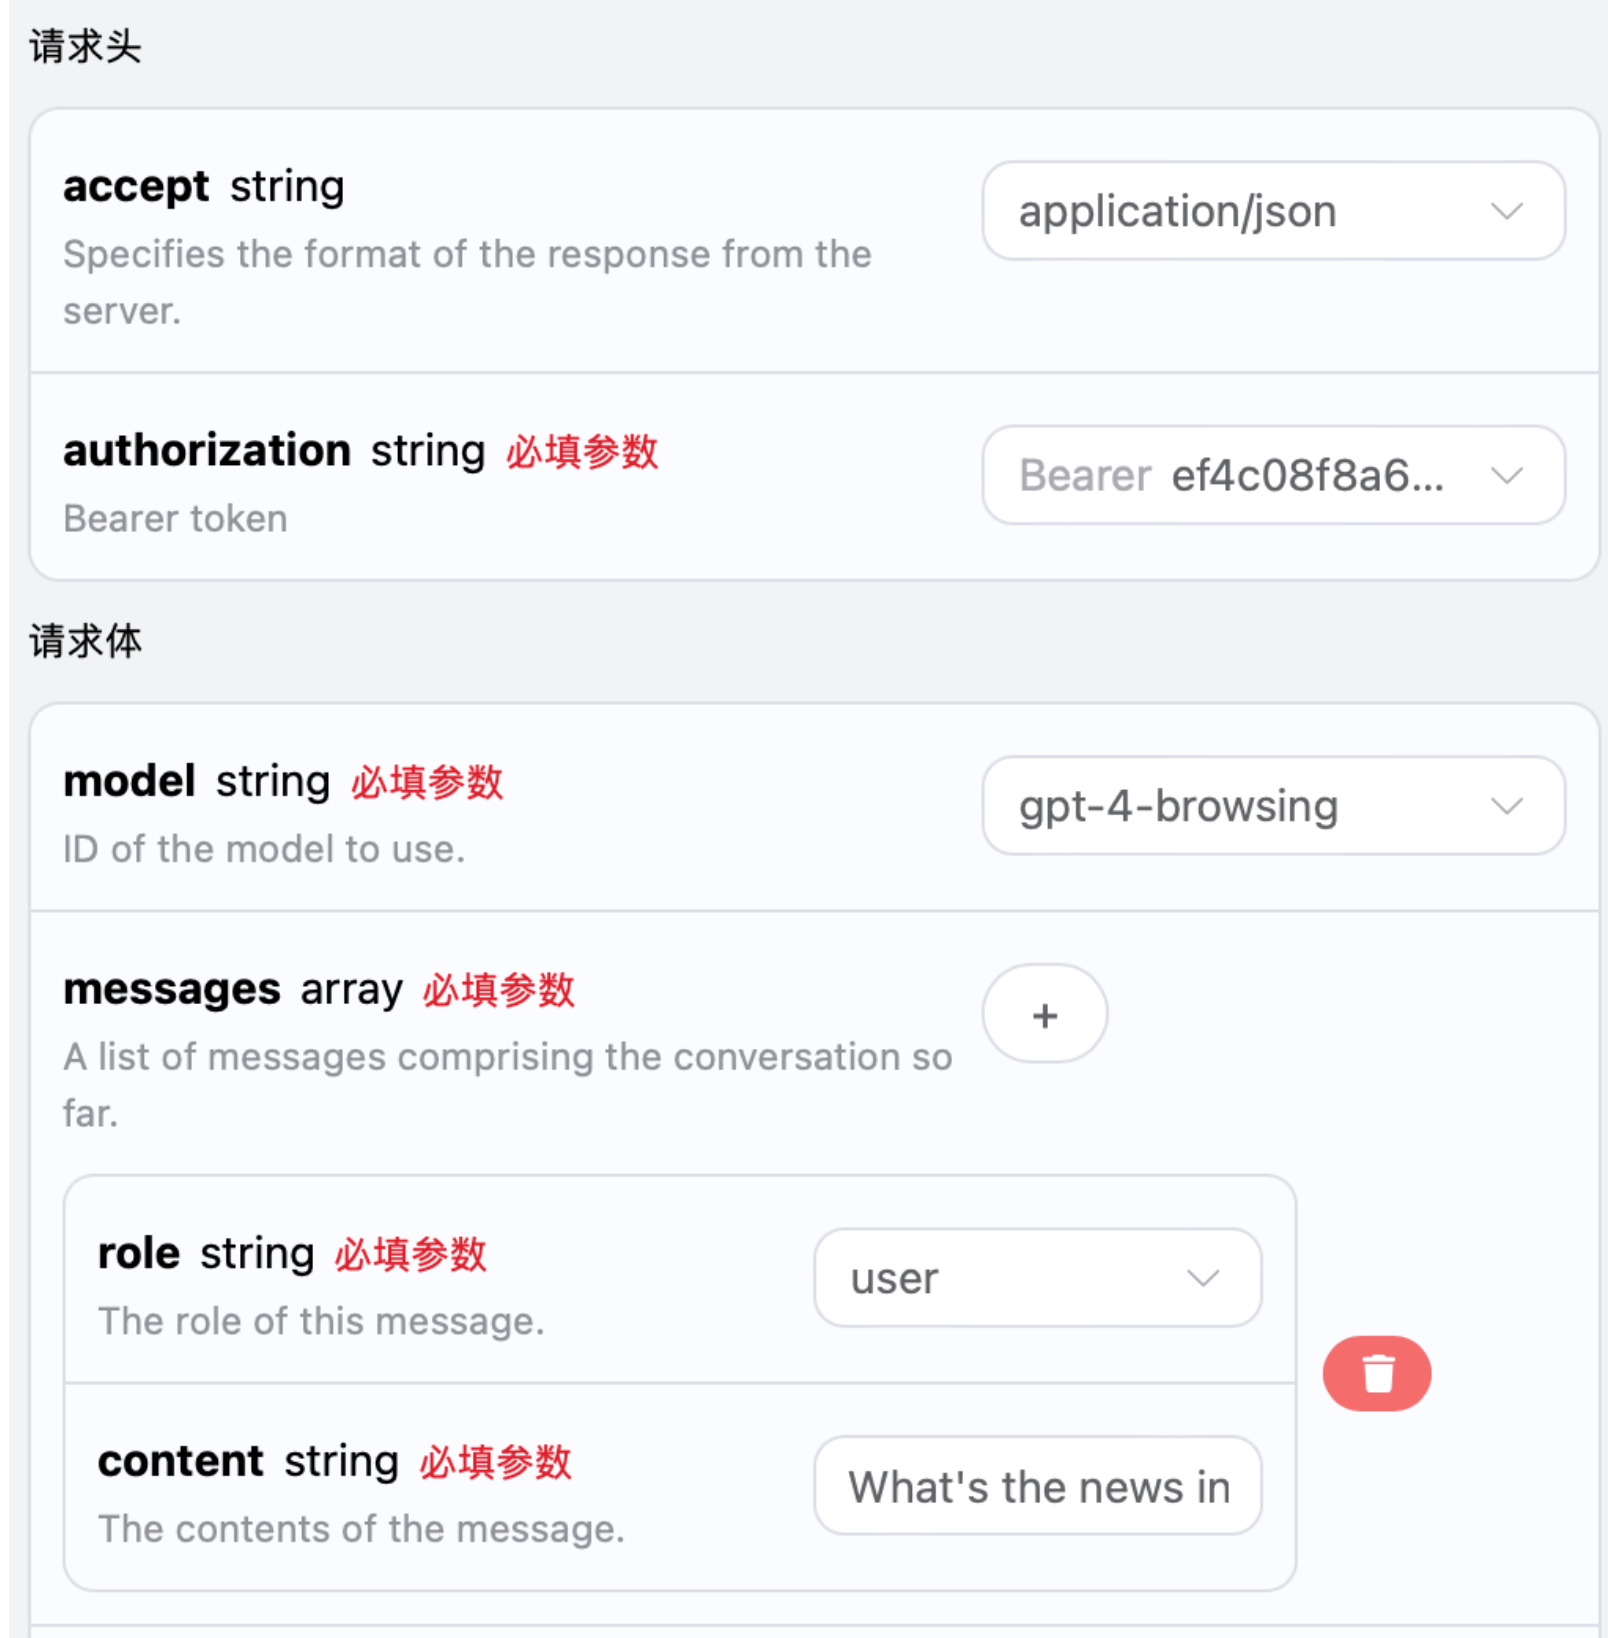
choices se obtiene tras una consulta en Internet, y también se proporcionan enlaces relacionados. La información de respuesta dentro de choices debe renderizarse mediante la sintaxis markdown para obtener la mejor experiencia; finalmente, esto también refleja la gran ventaja de la función de conexión a Internet de nuestro modelo.
Modelo visual
gpt-4o es un modelo de lenguaje grande multimodal desarrollado por OpenAI; añade capacidades de comprensión visual sobre la base de GPT-4. Este modelo puede procesar simultáneamente entradas de texto e imágenes, logrando comprensión y generación multimodales. El procesamiento de texto mediante el modelo gpt-4o es coherente con el contenido de uso básico anterior. A continuación, se presentará brevemente cómo utilizar la capacidad de procesamiento de imágenes del modelo. La capacidad de procesamiento de imágenes del modelo gpt-4o se utiliza principalmente añadiendo un campotype sobre la base del contenido original de content. Mediante este campo se puede saber si se carga texto o una imagen, para así utilizar la capacidad de procesamiento de imágenes del modelo gpt-4o. A continuación se explica principalmente cómo llamar a esta función mediante Curl y Python.
- Método de script Curl
- Método de script Python
Modelo de generación de imágenes GPT-4o
Generación de imágenes basada en una imagen de referencia
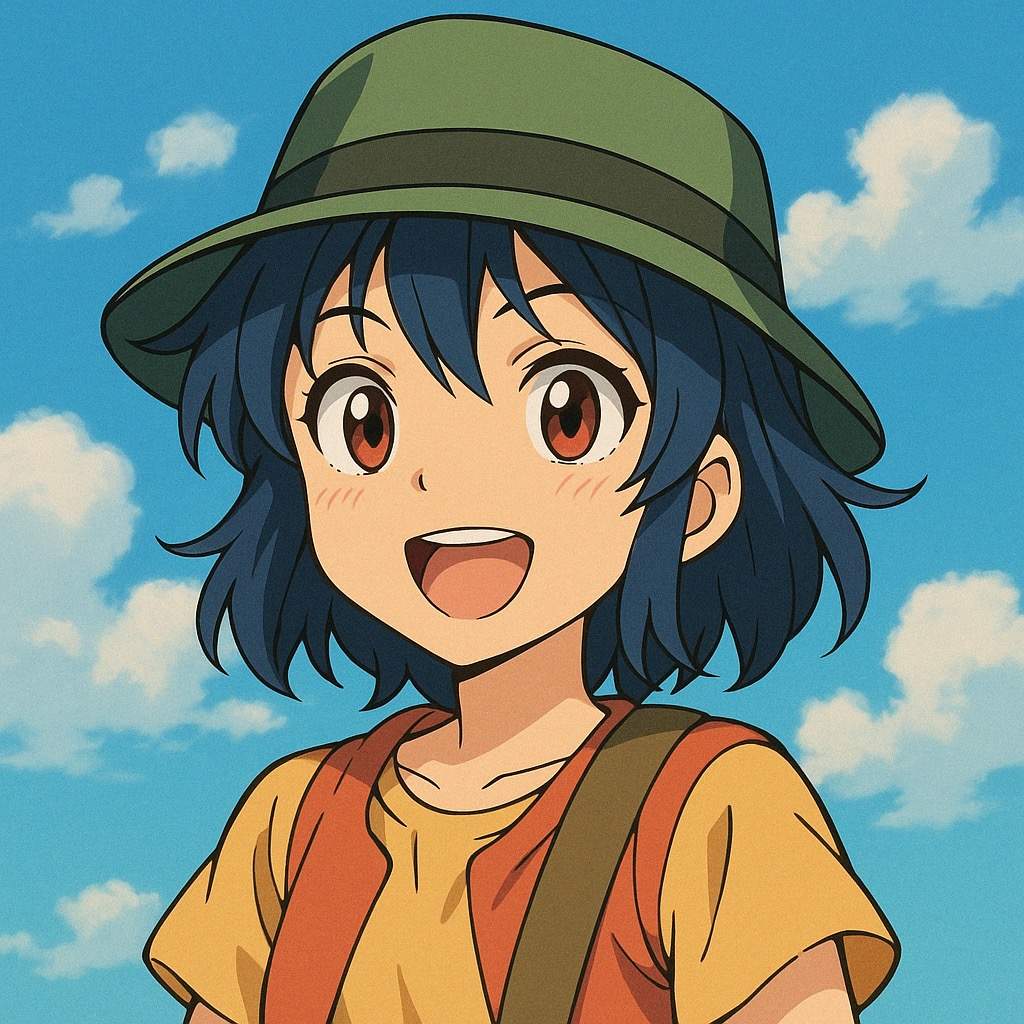
A continuación se muestra un ejemplo de generación de una imagen con estilo personalizado a partir de una imagen; primero veamos la imagen que ingresamos, como se muestra a continuación: Se puede ver que la imagen de referencia es una imagen de una persona real; podemos cambiarle el estilo, por ejemplo, convertirla en una imagen de estilo anime. El ejemplo específico de solicitud es:
message.content dentro de choices es el resultado completo de la conversación generada, y la imagen está incluida en formato Markdown (el enlace de la imagen es una dirección temporal; descárguela y guárdela a tiempo). Se puede ver que la imagen generada es efectivamente de estilo anime, específicamente como se muestra en la siguiente imagen:
Generación de imágenes solo con texto
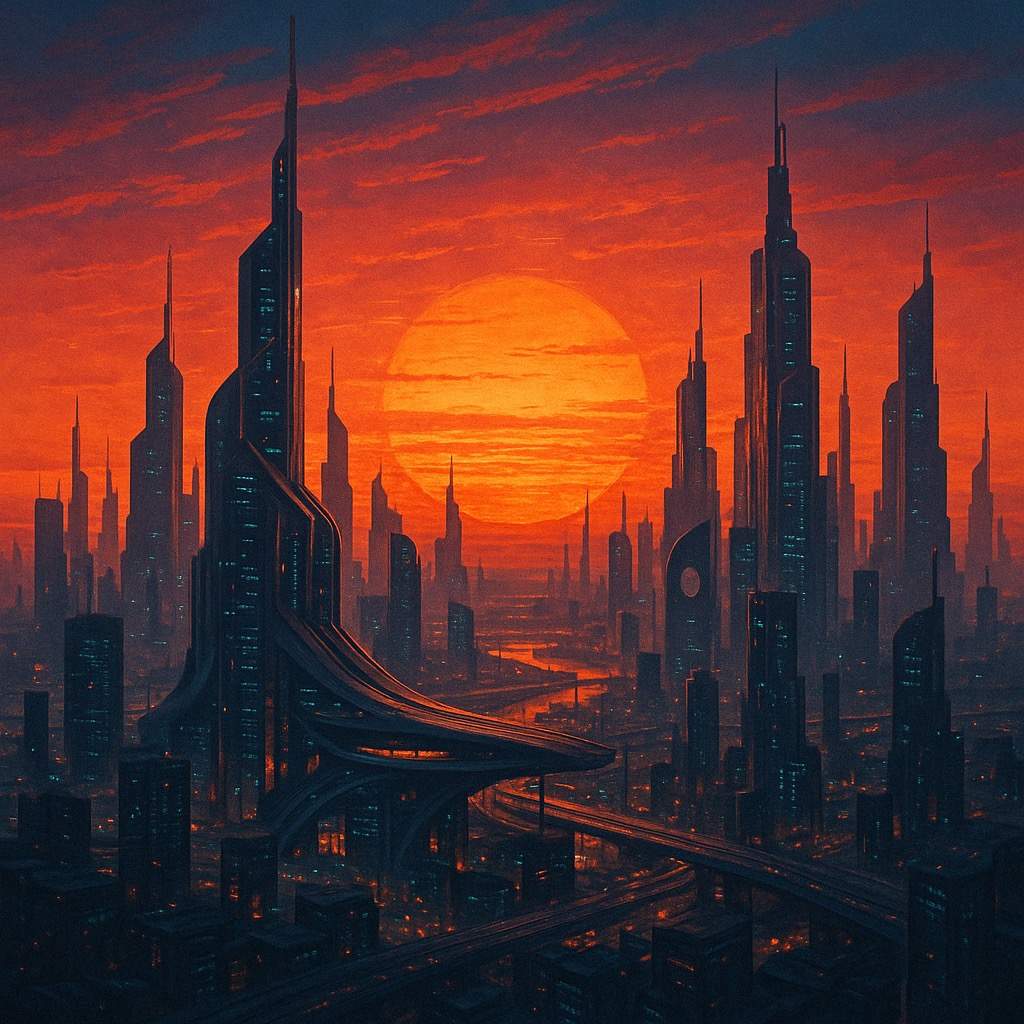
Podemos hacer que genere una imagen mediante un prompt y que nos la devuelva como un resultado conversacional. A continuación, usamoscrear una imagen de una ciudad futurista al atardecer como ejemplo; el ejemplo específico es:
Generar una imagen a partir de múltiples imágenes
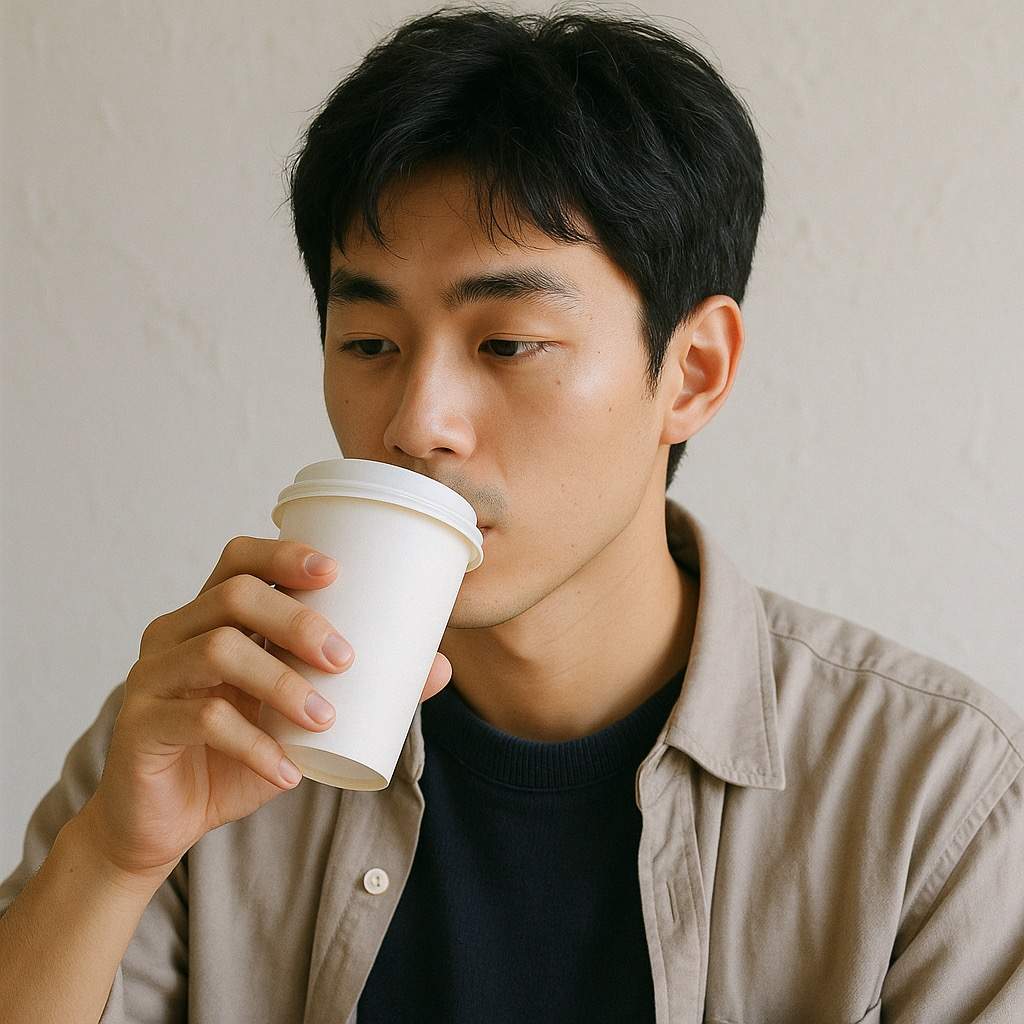
También podemos utilizar varias imágenes de referencia para generar una imagen; por ejemplo, usando una imagen de un chico guapo y una de café, podemos utilizar estas dos imágenes para generar una imagen de un chico guapo tomando café. A continuación se muestran las imágenes de referencia específicas: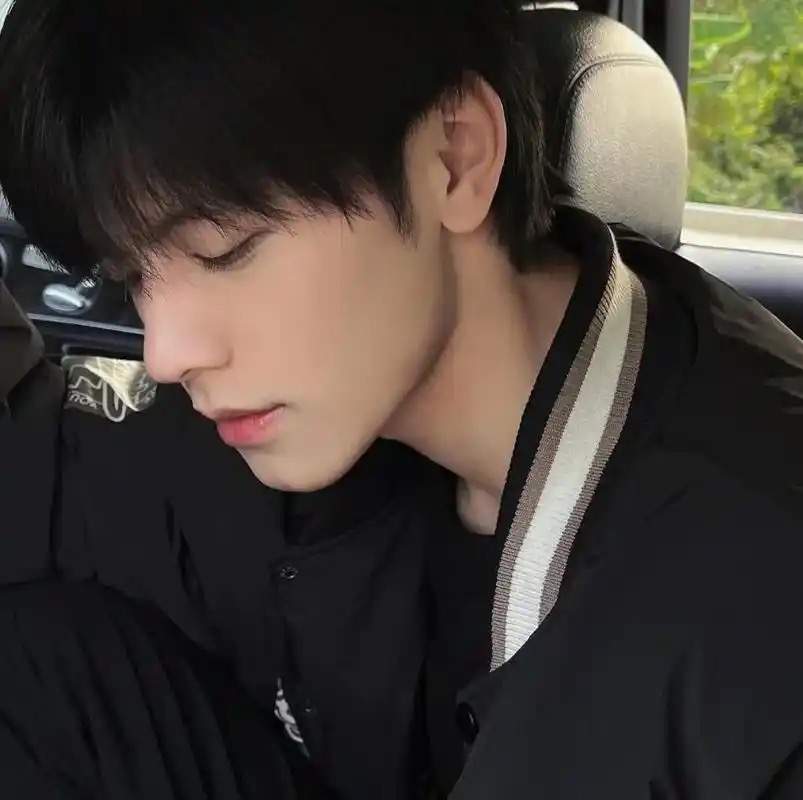
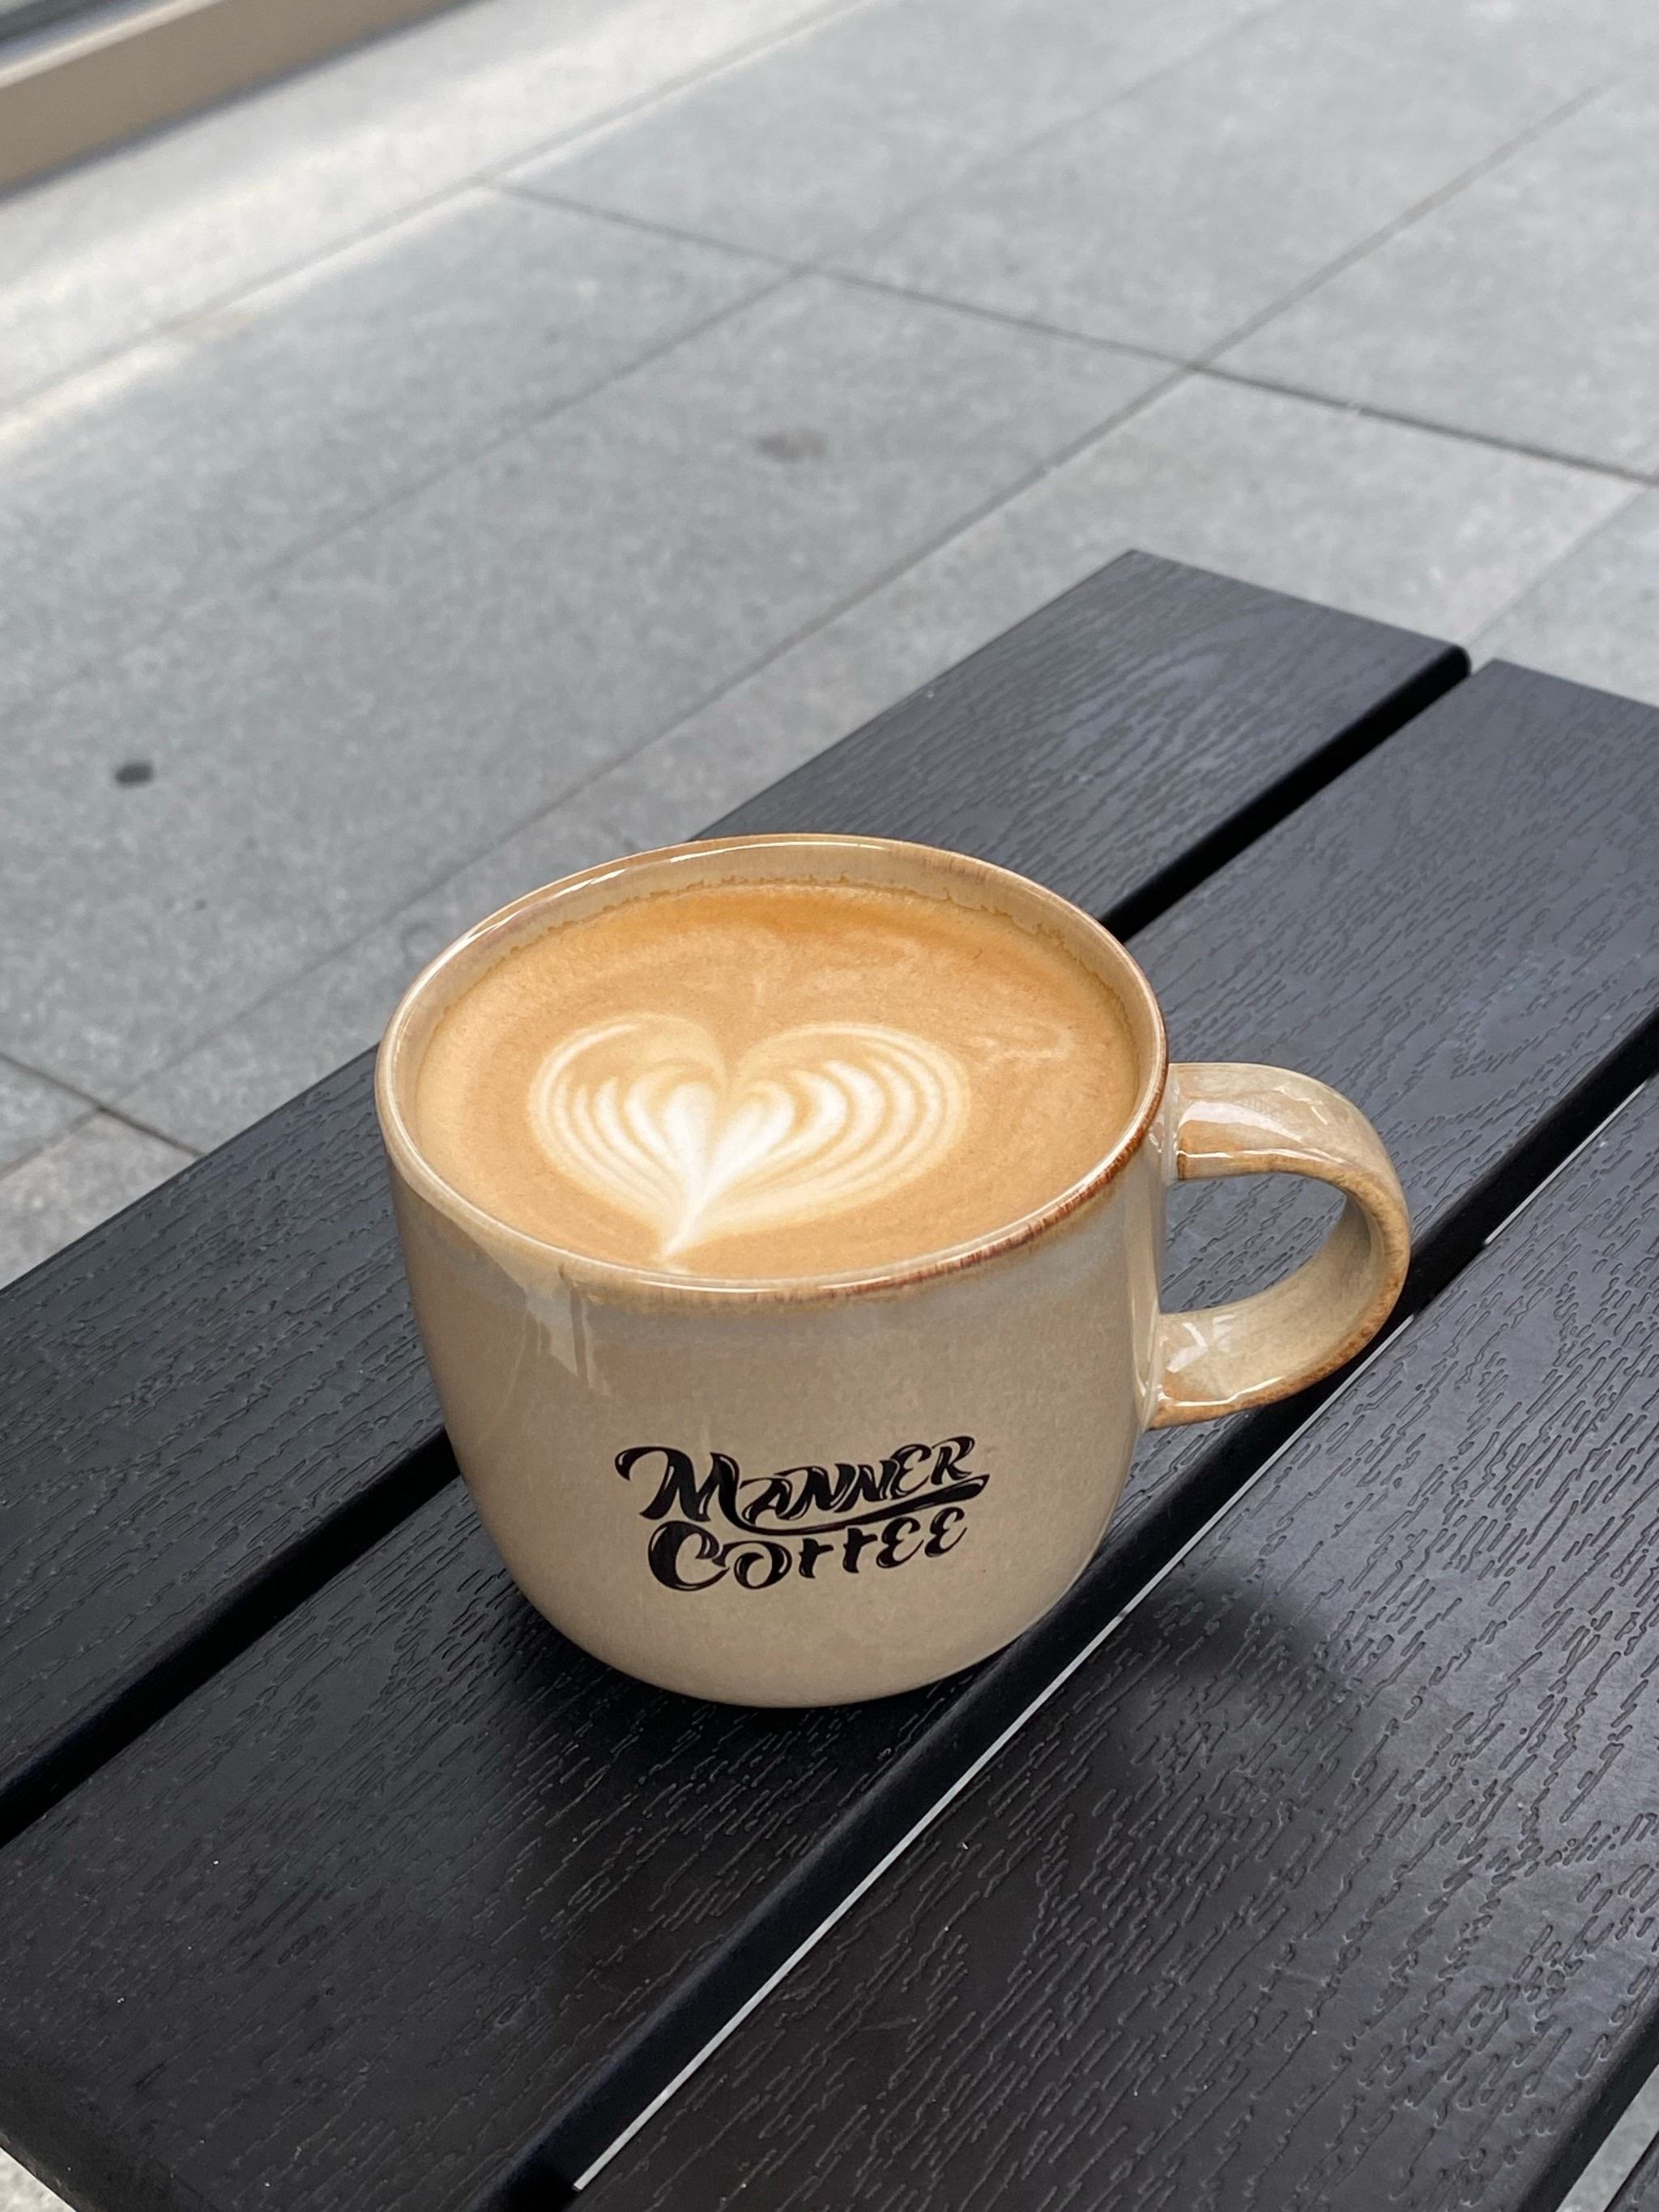
generar la imagen de un chico sosteniendo café y a punto de beberlo como ejemplo; el ejemplo específico es:
Manejo de errores
Al llamar a la API, si se produce un error, la API devolverá el código y la información de error correspondientes. Por ejemplo:400 token_mismatched: Solicitud incorrecta, posiblemente debido a parámetros faltantes o no válidos.400 api_not_implemented: Solicitud incorrecta, posiblemente debido a parámetros faltantes o no válidos.401 invalid_token: No autorizado, token de autorización no válido o faltante.429 too_many_requests: Demasiadas solicitudes, ha excedido el límite de velocidad.500 api_error: Error interno del servidor, algo salió mal en el servidor.