

content-Struktur zur Erstellung von Aufgaben.
Antragsprozess
Um die MiniMax H3 Videoerzeugungs-API zu verwenden, rufen Sie zunächst die Ace Data Cloud-Konsole auf, um Ihren API-Token zu erhalten, und bewahren Sie ihn zur späteren Verwendung auf. Falls Sie noch nicht angemeldet oder registriert sind, werden Sie automatisch zur Anmeldeseite weitergeleitet, um sich zu registrieren und anzumelden. Nach Abschluss kehren Sie automatisch zur aktuellen Seite zurück.
Ein API-Token kann alle Dienste der Plattform aufrufen; es ist nicht erforderlich, ihn für jeden Dienst einzeln zu beantragen. Bei der ersten Beantragung erhalten Sie ein kostenloses Kontingent, das Sie kostenlos ausprobieren können; bei unzureichendem Kontingent können Sie in der Konsole ein allgemeines Guthaben aufladen.
📘 Vollständige Dokumentation: MiniMax H3 Videoerzeugungs-API →Es wird empfohlen, den Token als Umgebungsvariable zu speichern und ihn nicht in den Quellcode zu schreiben oder in das Versionskontrollsystem einzuchecken:
Schnittstellenübersicht
- Base URL:
https://api.acedata.cloud - Endpoint:
POST /minimax/videos - Authentifizierungsmethode:
authorization: Bearer {token}im HTTP-Header übermitteln - Request-Header:
accept: application/jsoncontent-type: application/json
- Modell(model):
MiniMax-H3 - Eingabestruktur:Text, Bilder, Videos und Audio werden einheitlich über
contentübergeben - Ausgabemodus:Standardmäßig wird synchron auf den Abschluss der Erzeugung gewartet und die vollständige
taskzurückgegeben; bei Übergabe vonasync: trueodercallback_urlwerden soforttask_idundtrace_idzurückgegeben - Ergebnisabfrage:Status und fertiges Video über die MiniMax H3 Aufgabenabfrage-API abrufen
- Asynchroner Callback:Optional, das endgültige Aufgabenergebnis über
callback_urlempfangen
action übergeben, um den Erzeugungsmodus auszuwählen. Die Schnittstelle bestimmt den Verwendungszweck automatisch anhand der Materialtypen und role in content.
Für welche Szenarien geeignet
Aufrufablauf
Wennasync standardmäßig nicht übergeben wird, wartet /minimax/videos auf den Abschluss der Erzeugung und gibt direkt die vollständige task zurück. Wenn die Verbindung sofort freigegeben werden soll, übergeben Sie async: true oder callback_url:
- Speichern Sie
task_idundtrace_idaus der sofortigen Antwort. - Wenn kein Callback konfiguriert ist, rufen Sie etwa alle 10 Sekunden einmal
/minimax/taskszur Abfrage auf. - Wenn
task.statuszusucceededwird, rufen Sie das Video übertask.content.urlab. - Wenn der Status
failedodercancelledlautet, beenden Sie das Polling und lesen Sietask.error.
Anfrageparameter der obersten Ebene
Die Regeln für
ratio hängen vom Workflow ab:
- Text-zu-Video:Erforderlich und darf nicht
adaptivesein. - Video mit Anfangsframe, Endframe oder Anfangs- und Endframe:Das Seitenverhältnis wird durch das Eingabebild bestimmt; es wird empfohlen, es wegzulassen oder
adaptivezu übergeben. - Multimodale referenzbasierte Videoerzeugung:Kann weggelassen werden, Standard ist
adaptive; alternativ kann ein festes Verhältnis explizit angegeben werden.
prompt, image_urls, audio_urls, messages und first_frame_image. Wenn Fehler bei solchen Parametern auftreten, löschen Sie die alten Felder und migrieren Sie zu content; ändern Sie beispielsweise "prompt": "一只猫挥手" zu "content": [{"type": "text", "text": "一只猫挥手"}]. Senden Sie nicht gleichzeitig das neue und das alte Format.
Parameter der content-Inhaltselemente
Jedes Inhaltselement musstype haben; die übrigen Felder werden durch den Typ bestimmt:
Medienadressen unterstützen drei Formen:
- Öffentlich zugängliche HTTPS-URL, empfohlen für große Dateien.
mm_file://{file_id}, verweist auf bereits hochgeladene oder vorhandene Ergebnisdateien.- Base64-Data-URI des entsprechenden Medientyps. Base64 erhöht die Größe um etwa ein Drittel; stellen Sie sicher, dass der gesamte Anfragekörper 64 MB nicht überschreitet.
Materialvorgaben und Mengenbeschränkungen
Bilder, Videos und Audios in multimodalen Referenzszenarien umfassen zusammen maximal 12 Dateien. Das Szenario mit erstem und letztem Bild und das Szenario mit Referenzmaterial schließen sich gegenseitig aus: Sobald
reference_image、reference_video oder reference_audio verwendet wird, dürfen first_frame oder last_frame nicht mehr verwendet werden, und umgekehrt.
Präsentation produktionsreifer Fähigkeiten
Das Folgende sind keine Konzeptbilder oder Platzhaltermaterialien, sondern echte Referenzeingaben und tatsächliche Videoausgaben offizieller produktionsreifer MiniMax-H3-Fähigkeitsbeispiele. Die drei Fallbeispiele decken jeweils Marken-Kurzfilme, Realpersonen-Erzählungen und Fashion-E-Commerce ab und eignen sich zur Bewertung der wichtigsten Fähigkeiten des Modells in der kommerziellen Produktion.
Die „Gesichtsfähigkeiten“ hier beziehen sich auf die Konsistenz des Erscheinungsbilds von Personen, Gesichtsdetails und die Steuerung der Darstellung bei der Videogenerierung, nicht auf Identitätserkennung, Gesichtsabgleich oder Face-Swapping-Schnittstellen.
Hochwertiger Marken-Kurzfilm: Einheit von Personen, Produkten und Marken-Assets
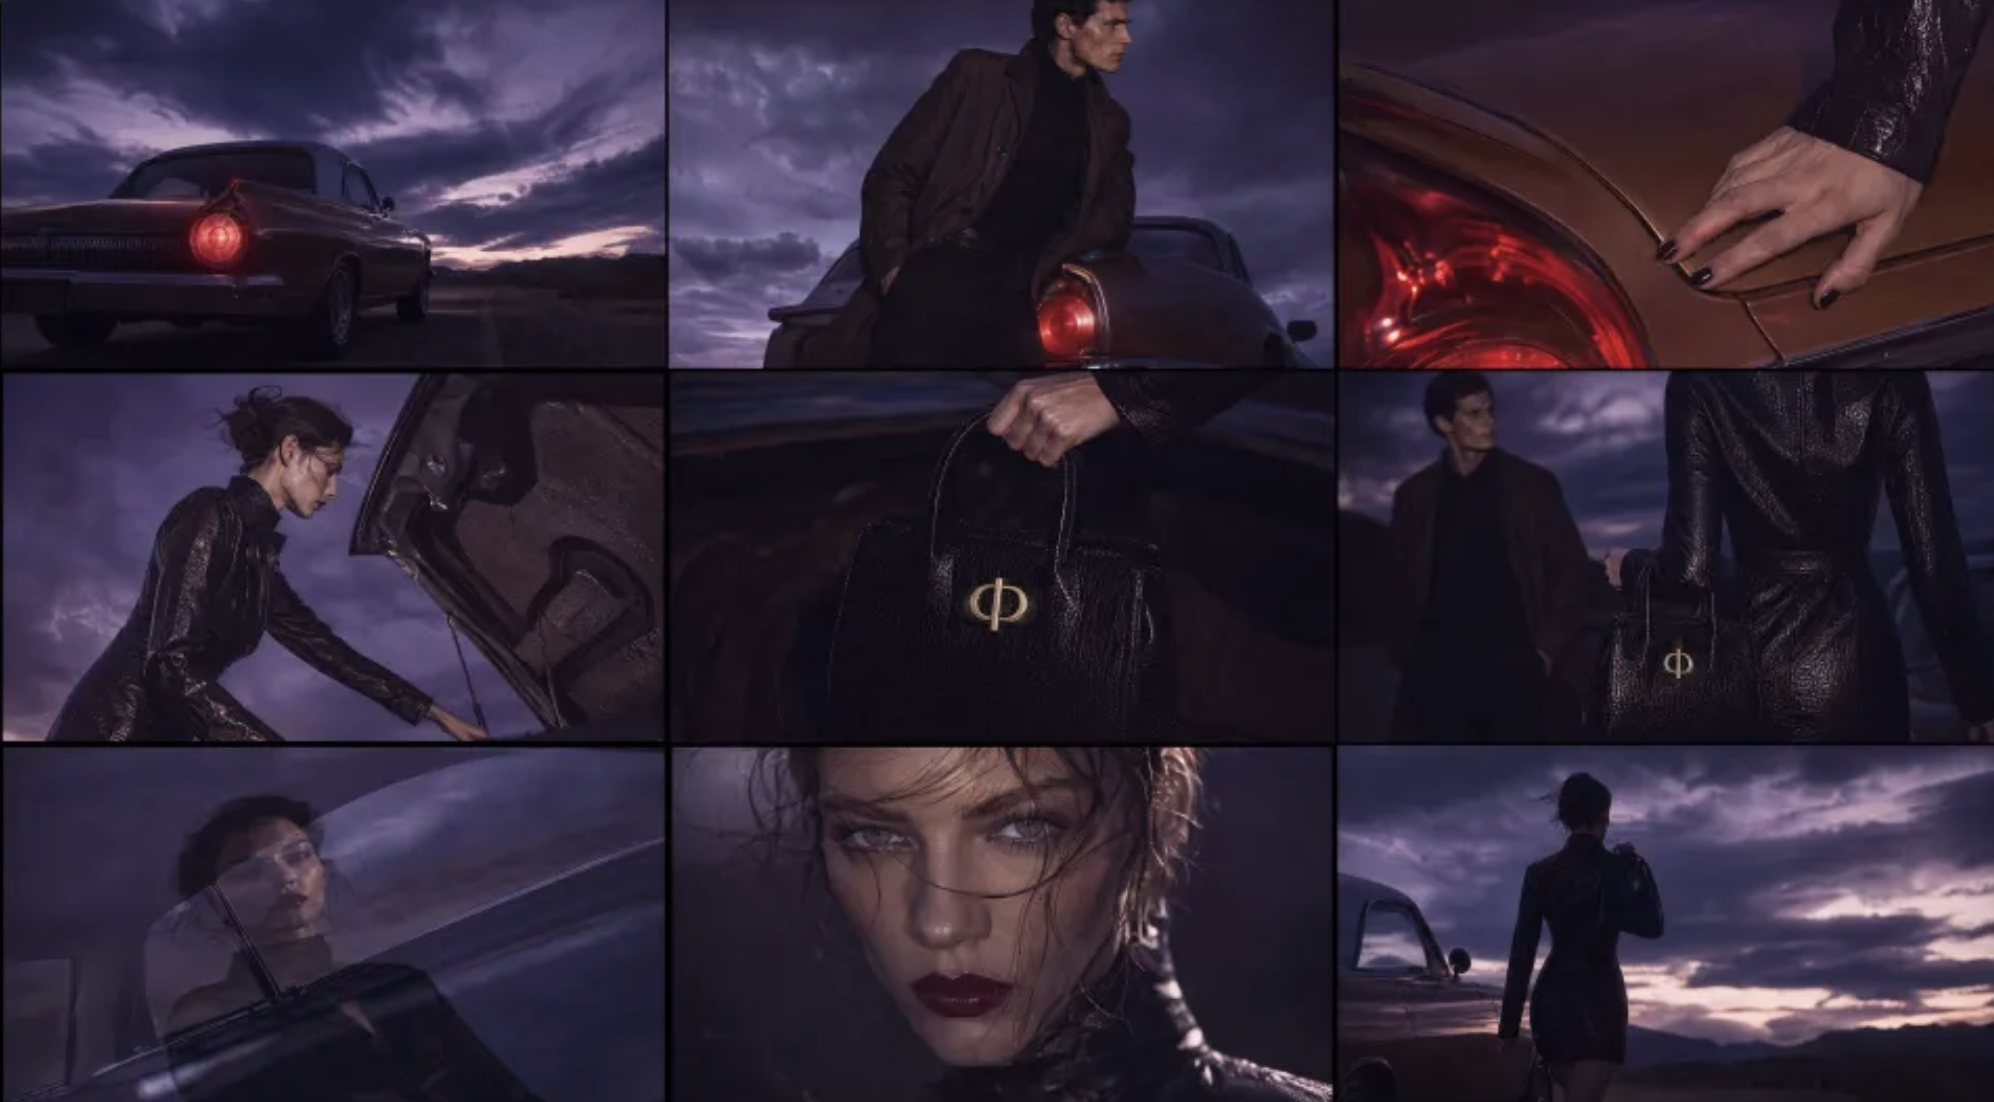
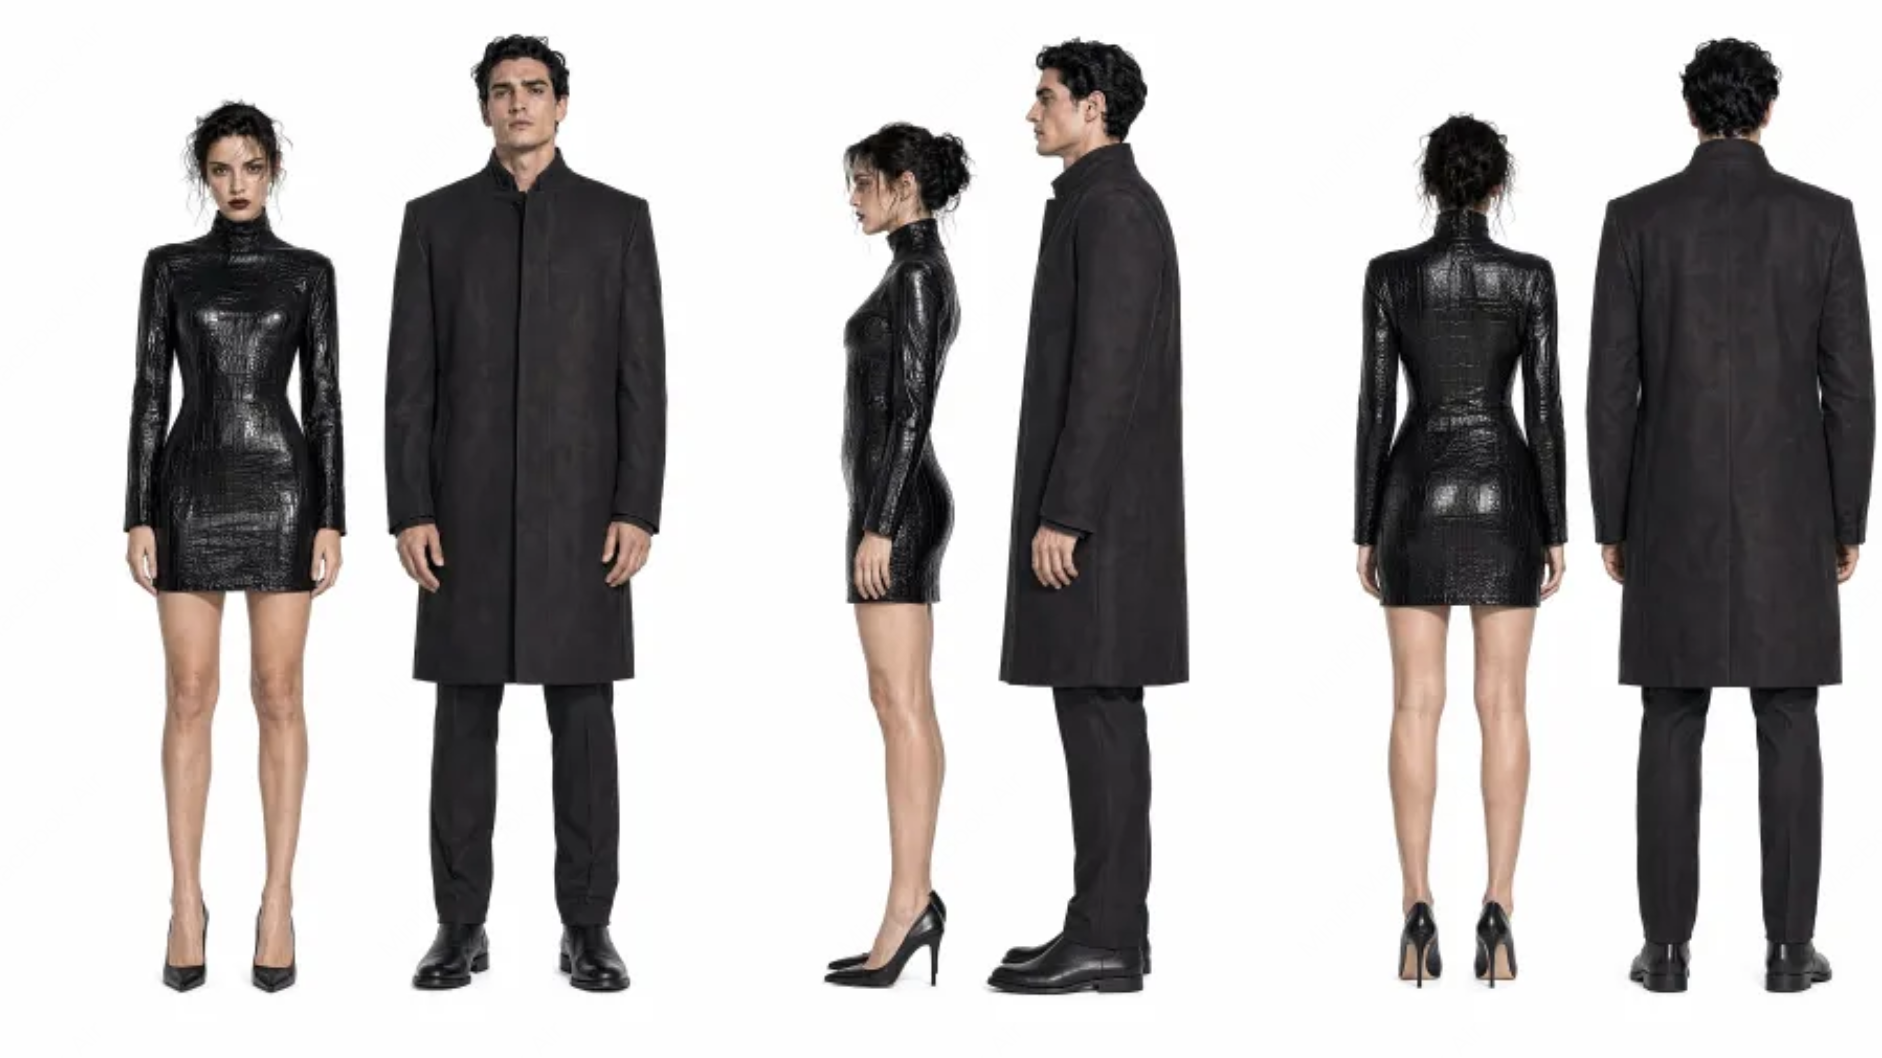
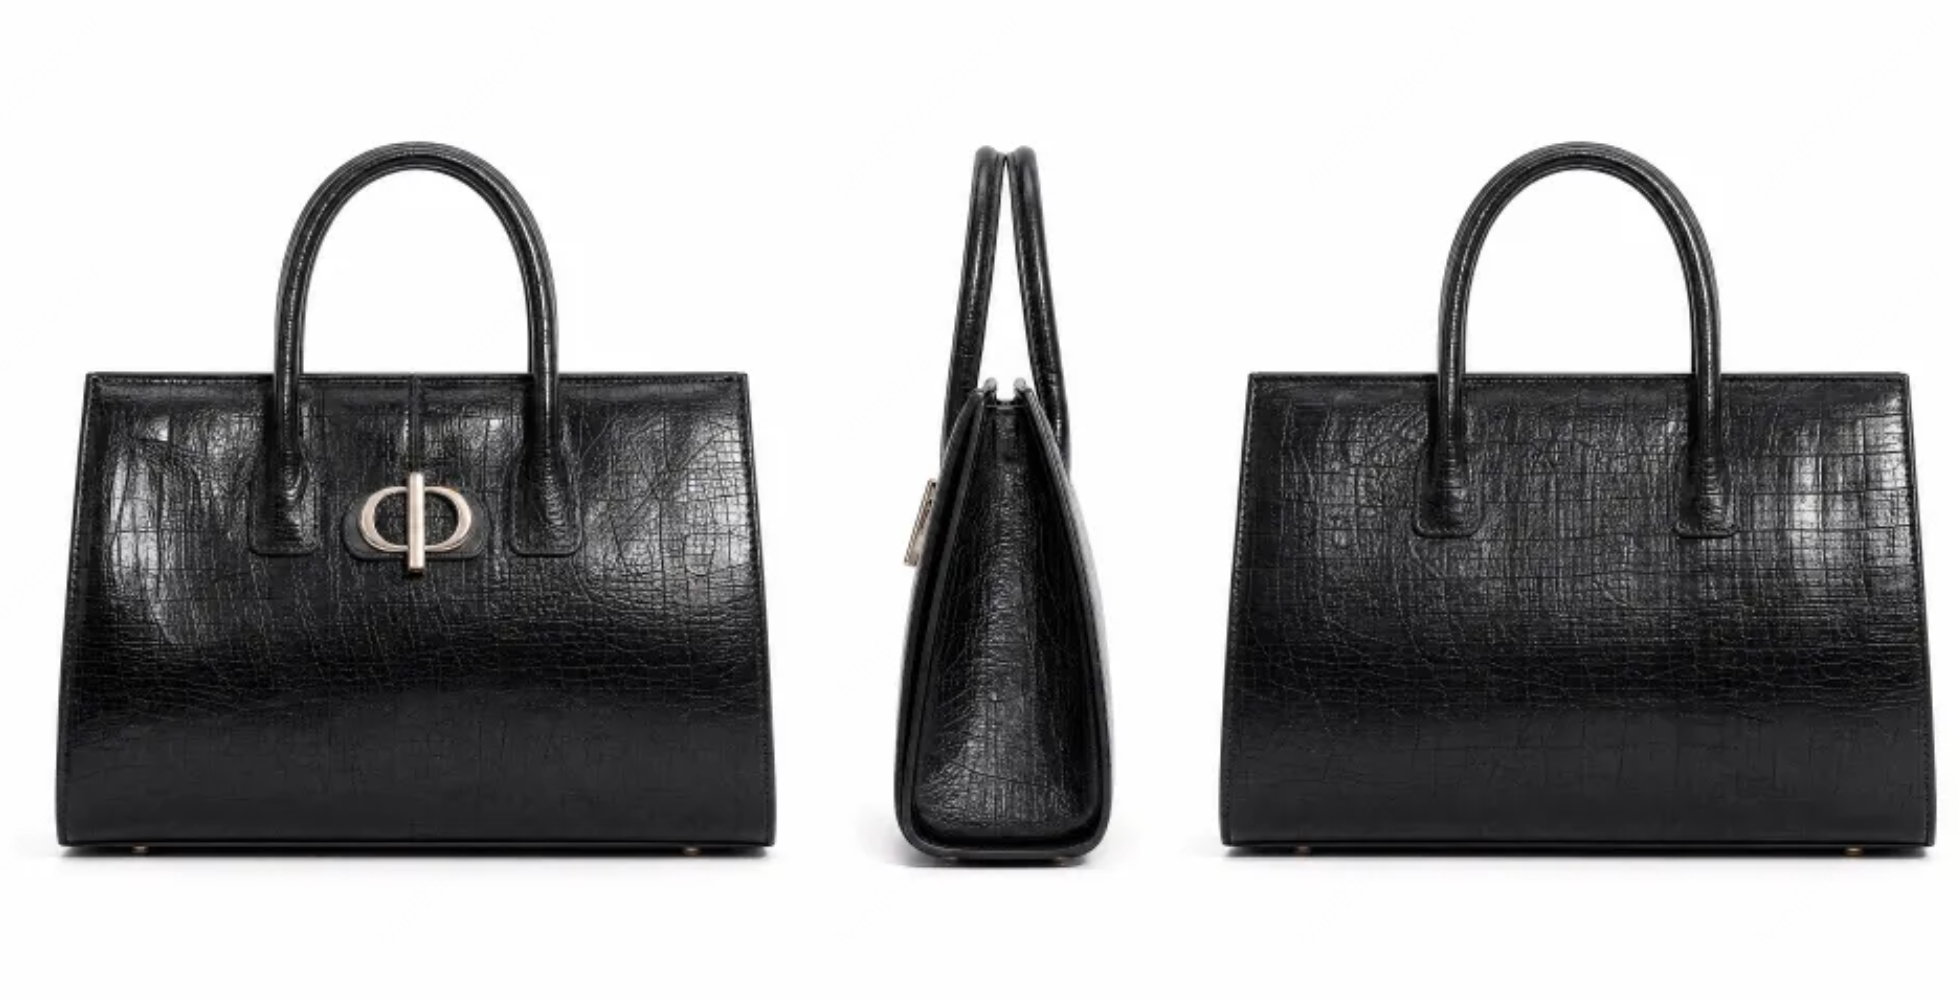
Produktionsziel: 16:9-High-Fashion-Markenfilm. Mit einer Wüstenstraße und einem Retroauto wird eine kühle Atmosphäre geschaffen, während das Erscheinungsbild der weiblichen Hauptfigur und die Struktur der schwarzen Handtasche beibehalten und das Markenlogo natürlich ins Ende integriert werden. Dieses Beispiel prüft vor allem die Personen-Konsistenz über mehrere Einstellungen hinweg, Produktbeibehaltung, filmische Qualität und die Fähigkeit zum Markenabschluss.| Referenz für Atmosphäre und Szene | Personenreferenz |
|---|---|
 |  |
| Handtaschen-Produktreferenz | Markenlogo-Referenz |
|---|---|
 |  |
content:
Vertikales Realpersonen-Kurzdrama: Gesichtskonsistenz und emotionale Darstellung
Produktionsziel: 15-sekündiger, 9:16 düster-romantischer Kurzdrama-Trailer. Die Referenzbilder der weiblichen und männlichen Hauptfiguren fixieren das Erscheinungsbild der Figuren, während das Referenzbild des alten Schlosses den Raum vorgibt; Mittelnaheinstellungen und Gesichtsnahaufnahmen werden verwendet, um Blickduelle, Angst, Beherrschung und ein Gefühl von Gefahr darzustellen. Dieses Beispiel eignet sich zur Beobachtung der Stabilität realistischer Gesichtszüge, Mikroausdrücke, Blickbeziehungen und zusammenhängender Darstellungen.| Referenz der weiblichen und männlichen Hauptfiguren | Referenz der alten Schlosskulisse |
|---|---|
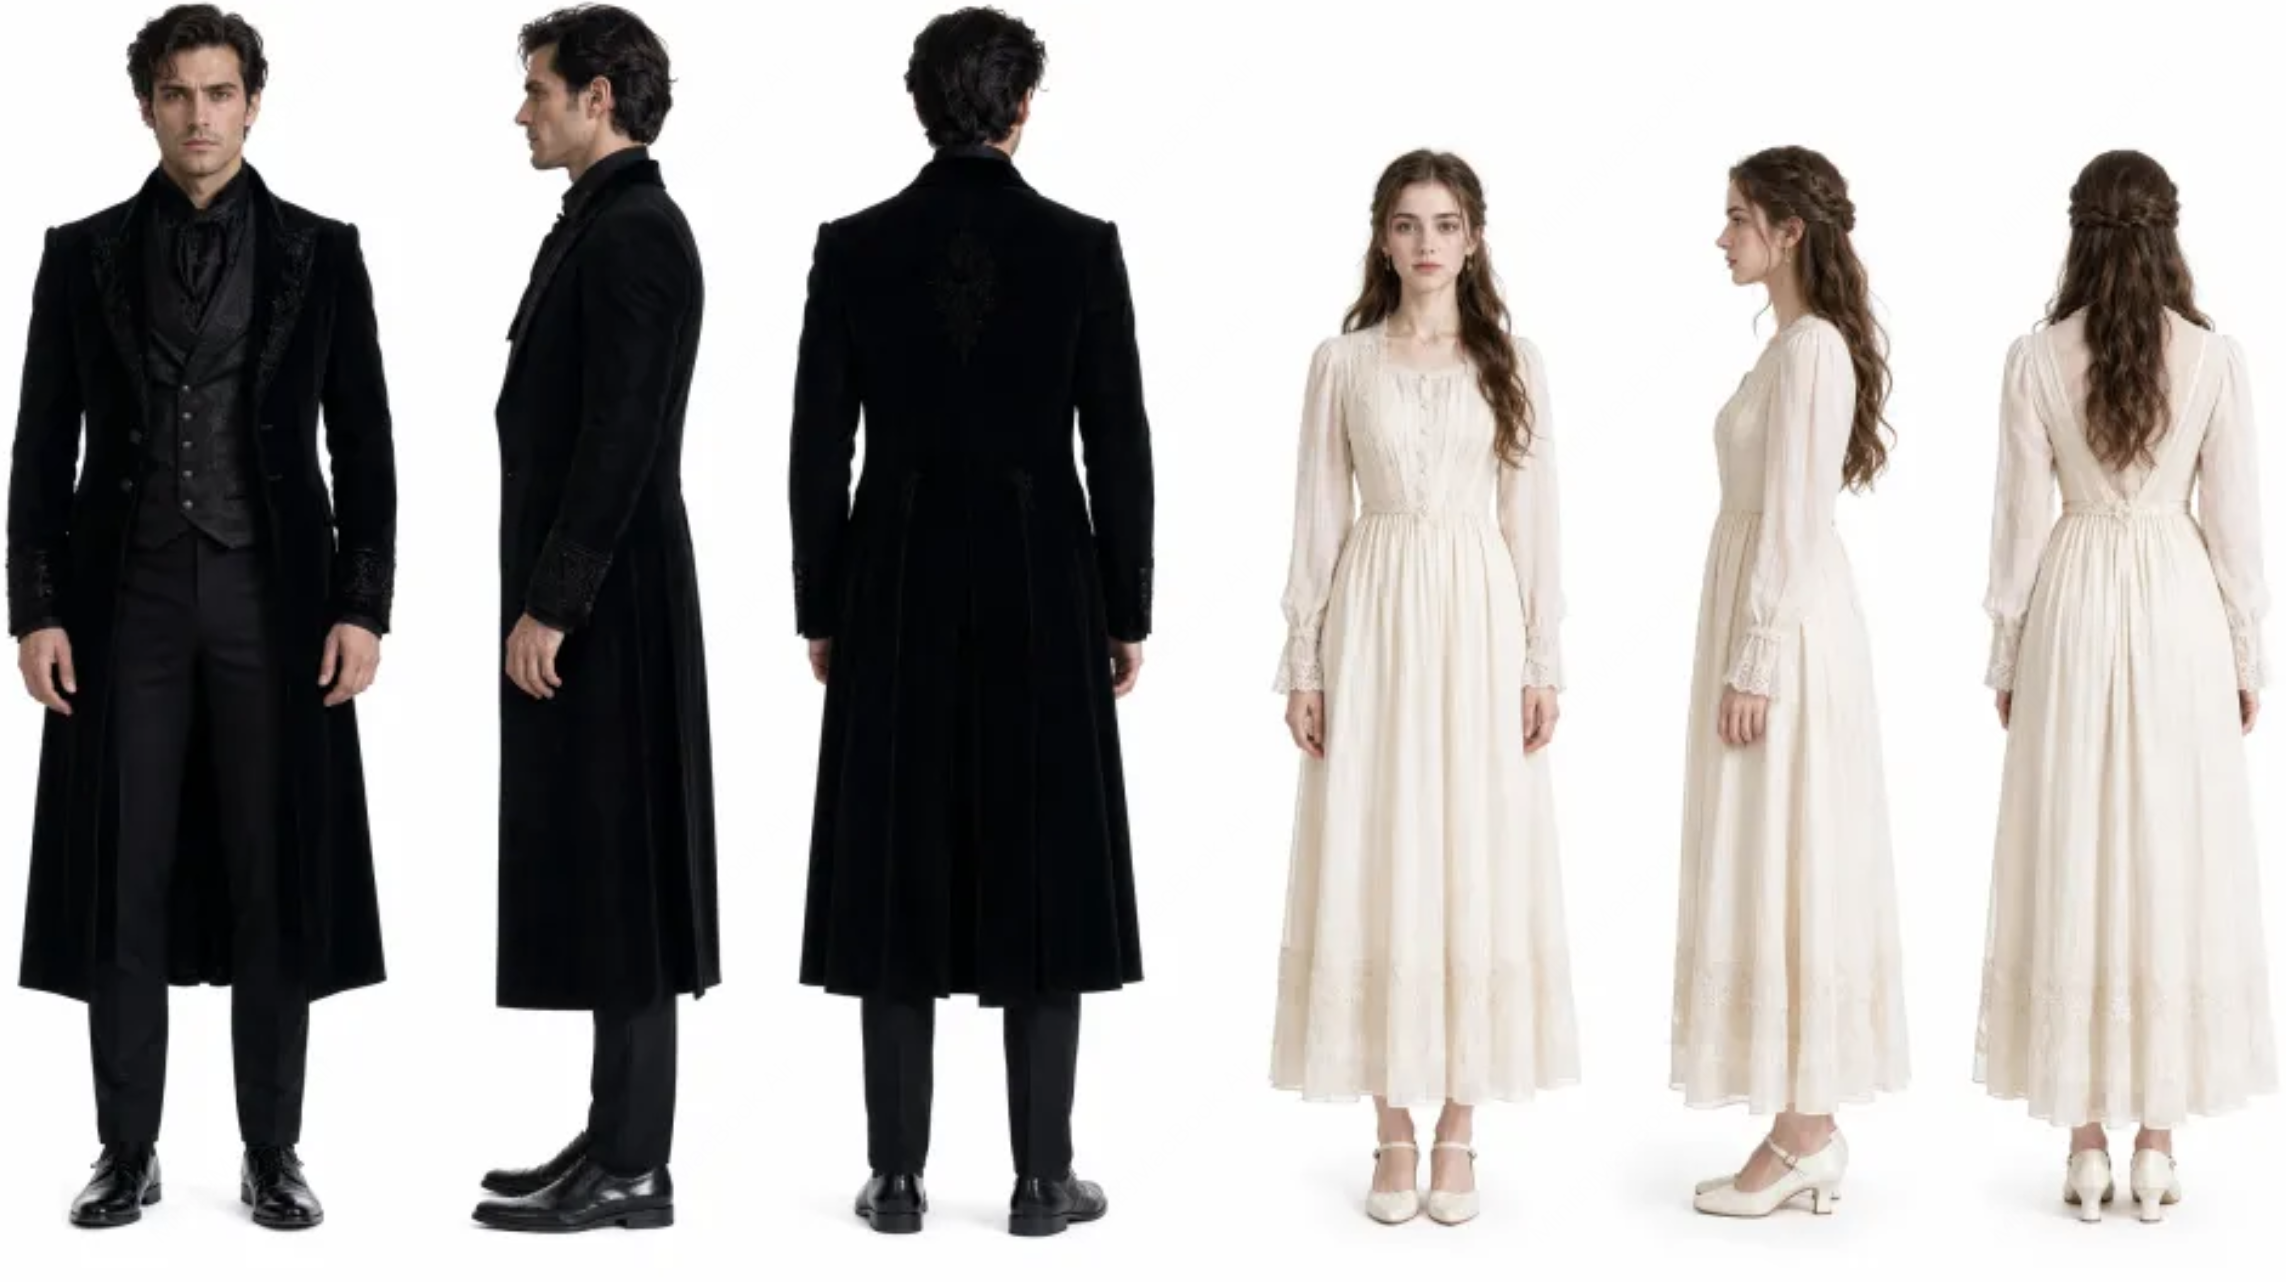 | 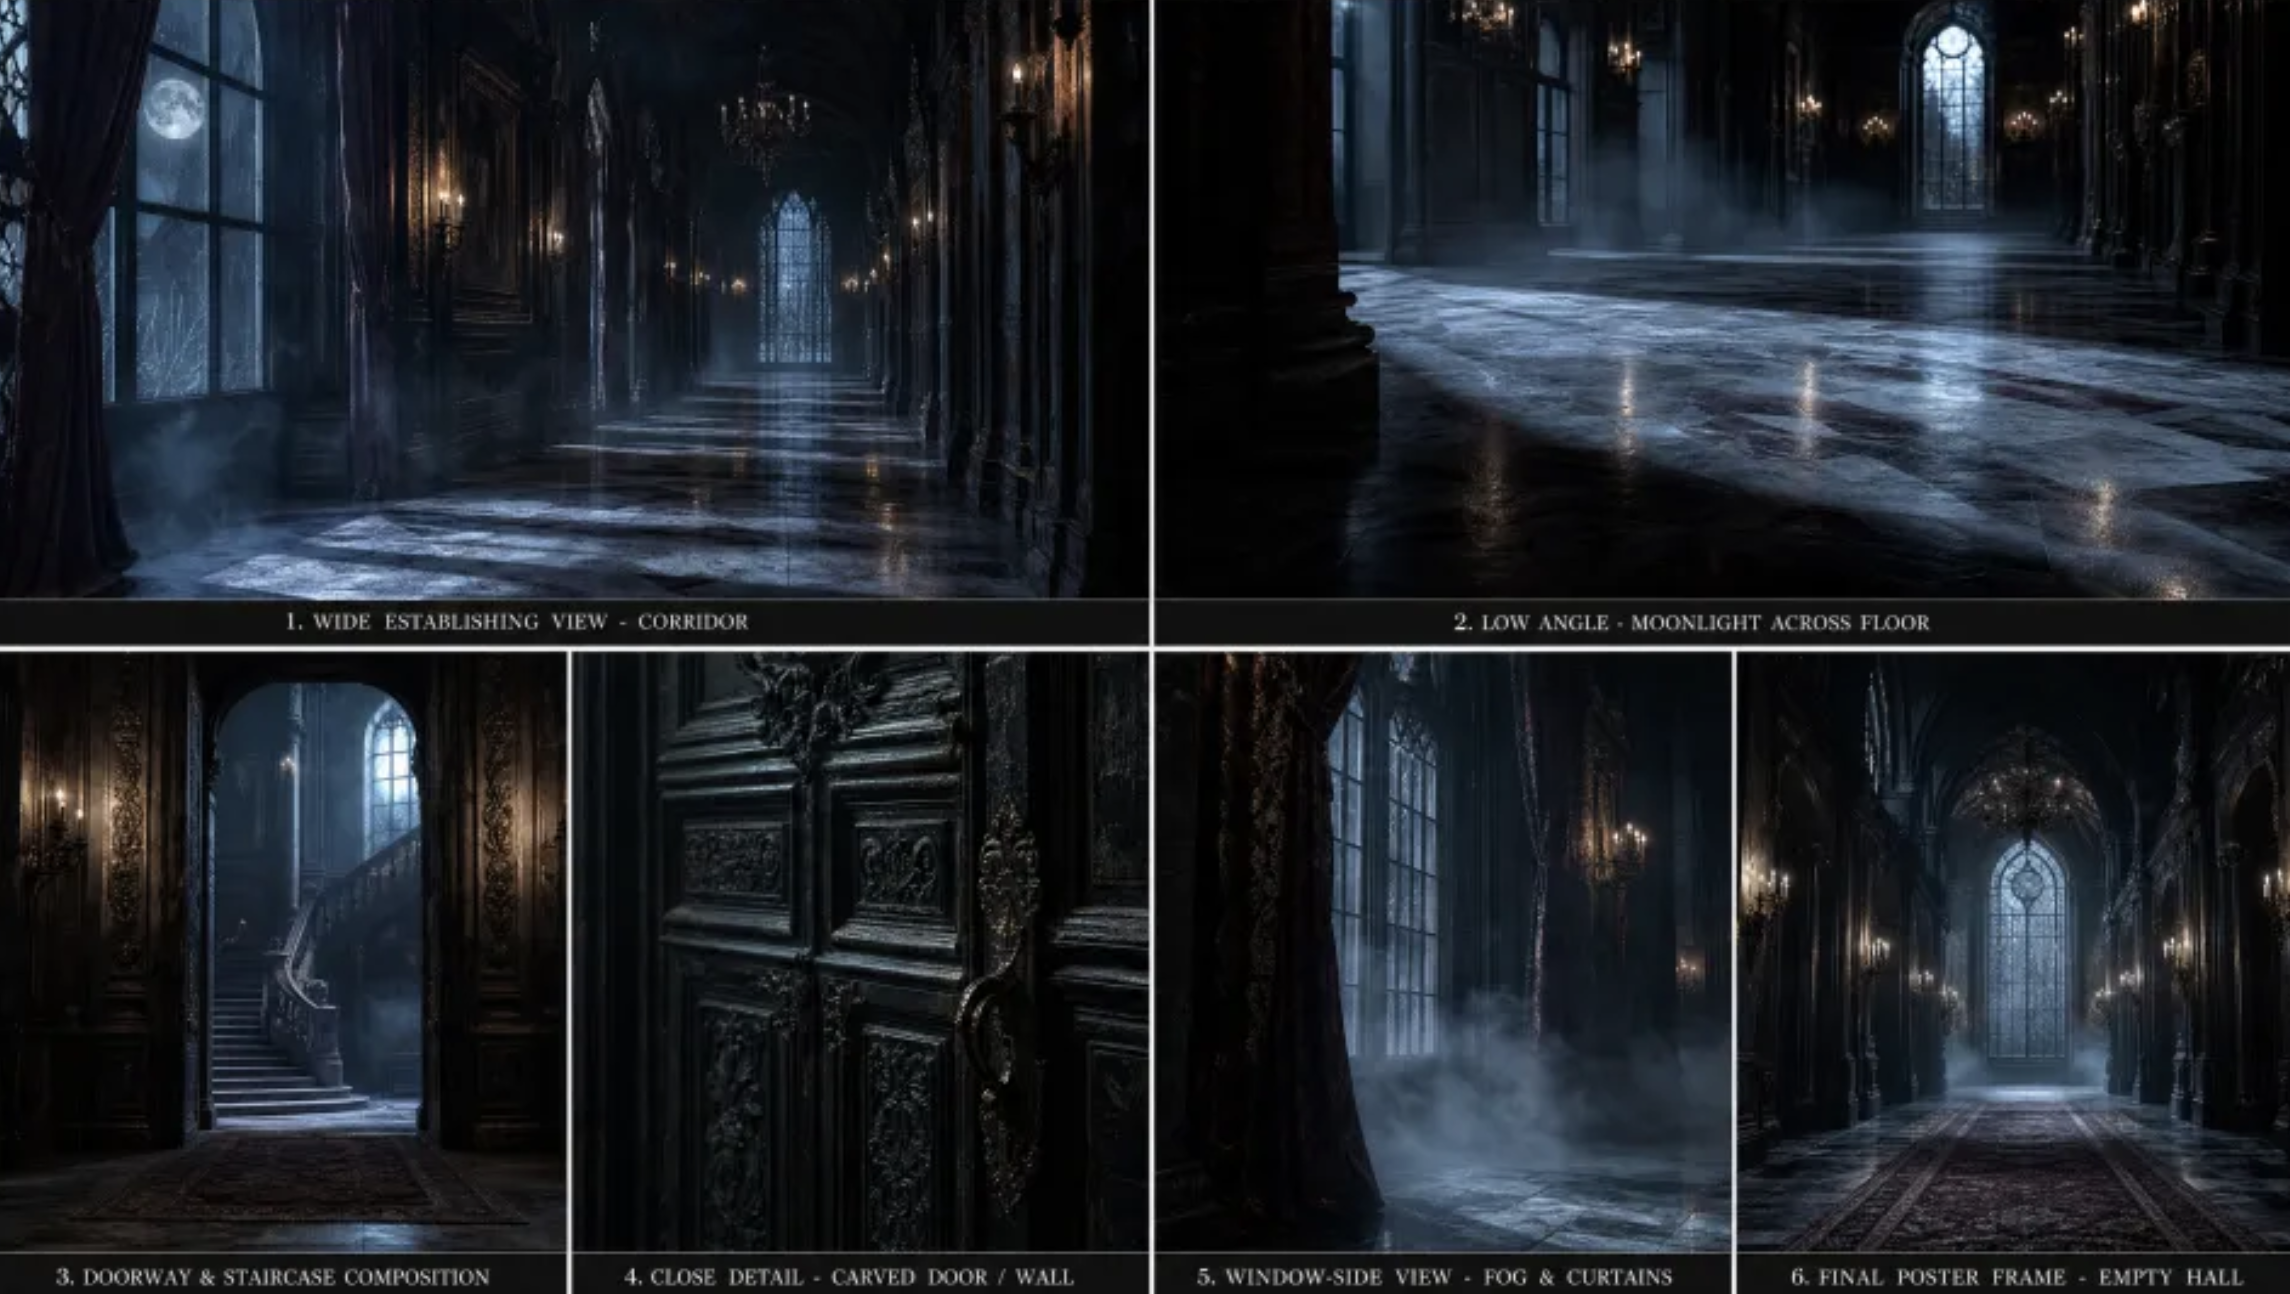 |
Modische Brillenwerbung: Erhalt von Gesichtsdetails und Produktstruktur
Produktionsziel: 9:16 hochwertige modische Brillenwerbung. Das Ganzkörperbild der Person ist für Körperform und Laufstil zuständig, das Gesichtsreferenzbild für Gesichtszüge und Make-up, und das Produktbild für umlaufende Kurven, Linsenreflexionen, Bügel und die Cat-Eye-Kontur. Dieses Beispiel prüft gleichzeitig Gesichtsnahaufnahmen, Konsistenz mehrerer Personen, Tragebeziehungen und die geometrische Struktur des Produkts.| Referenz für Model und Styling | Referenz für Gesichtsdetails | Referenz für das Brillenprodukt |
|---|---|---|
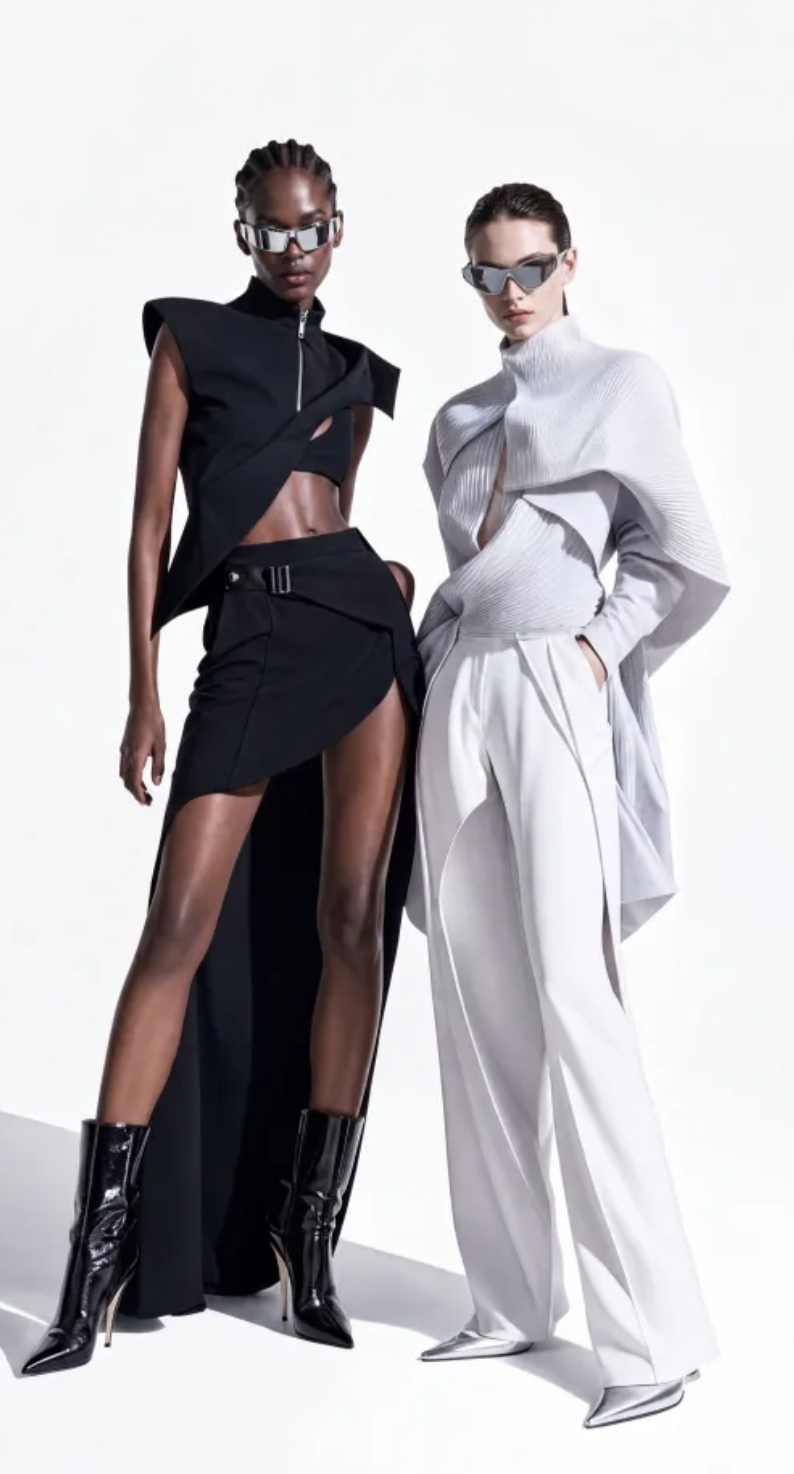 | 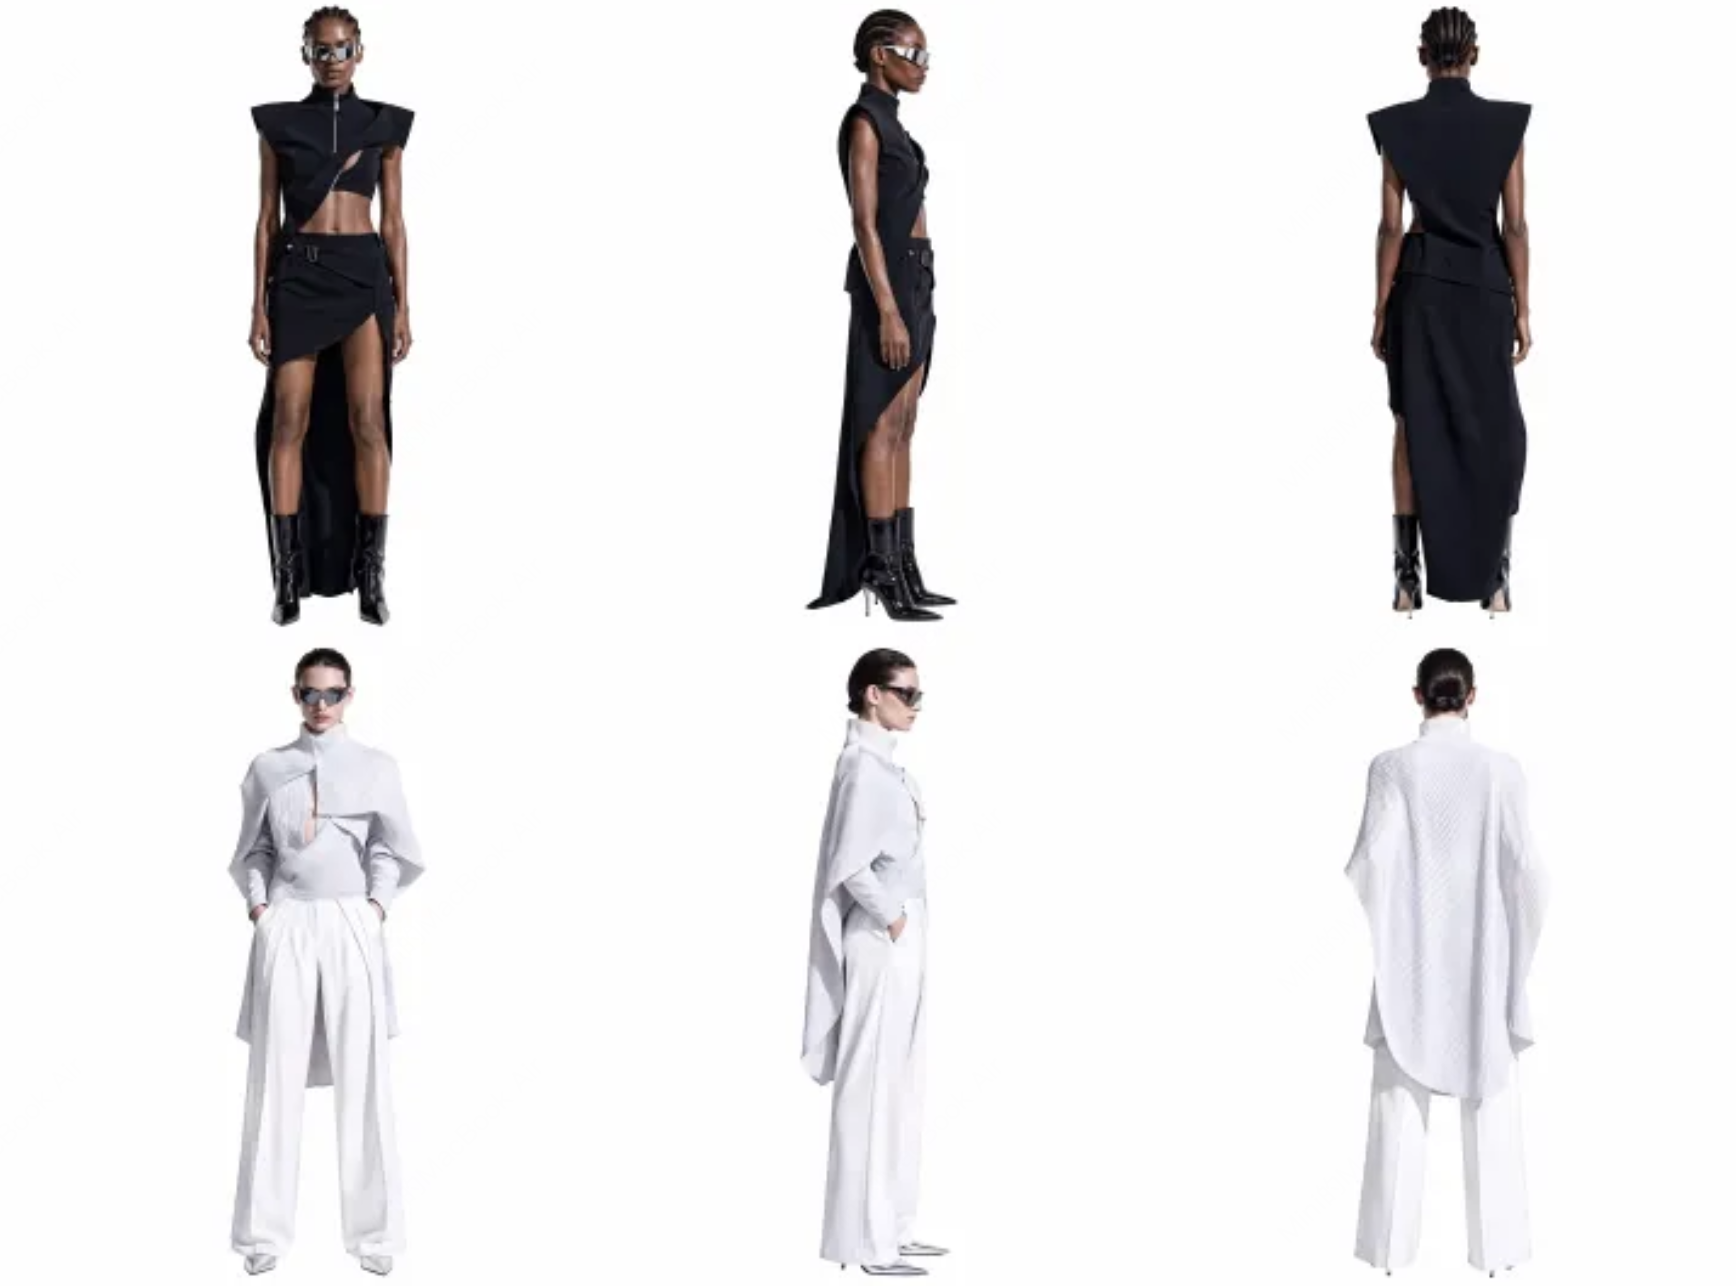 | 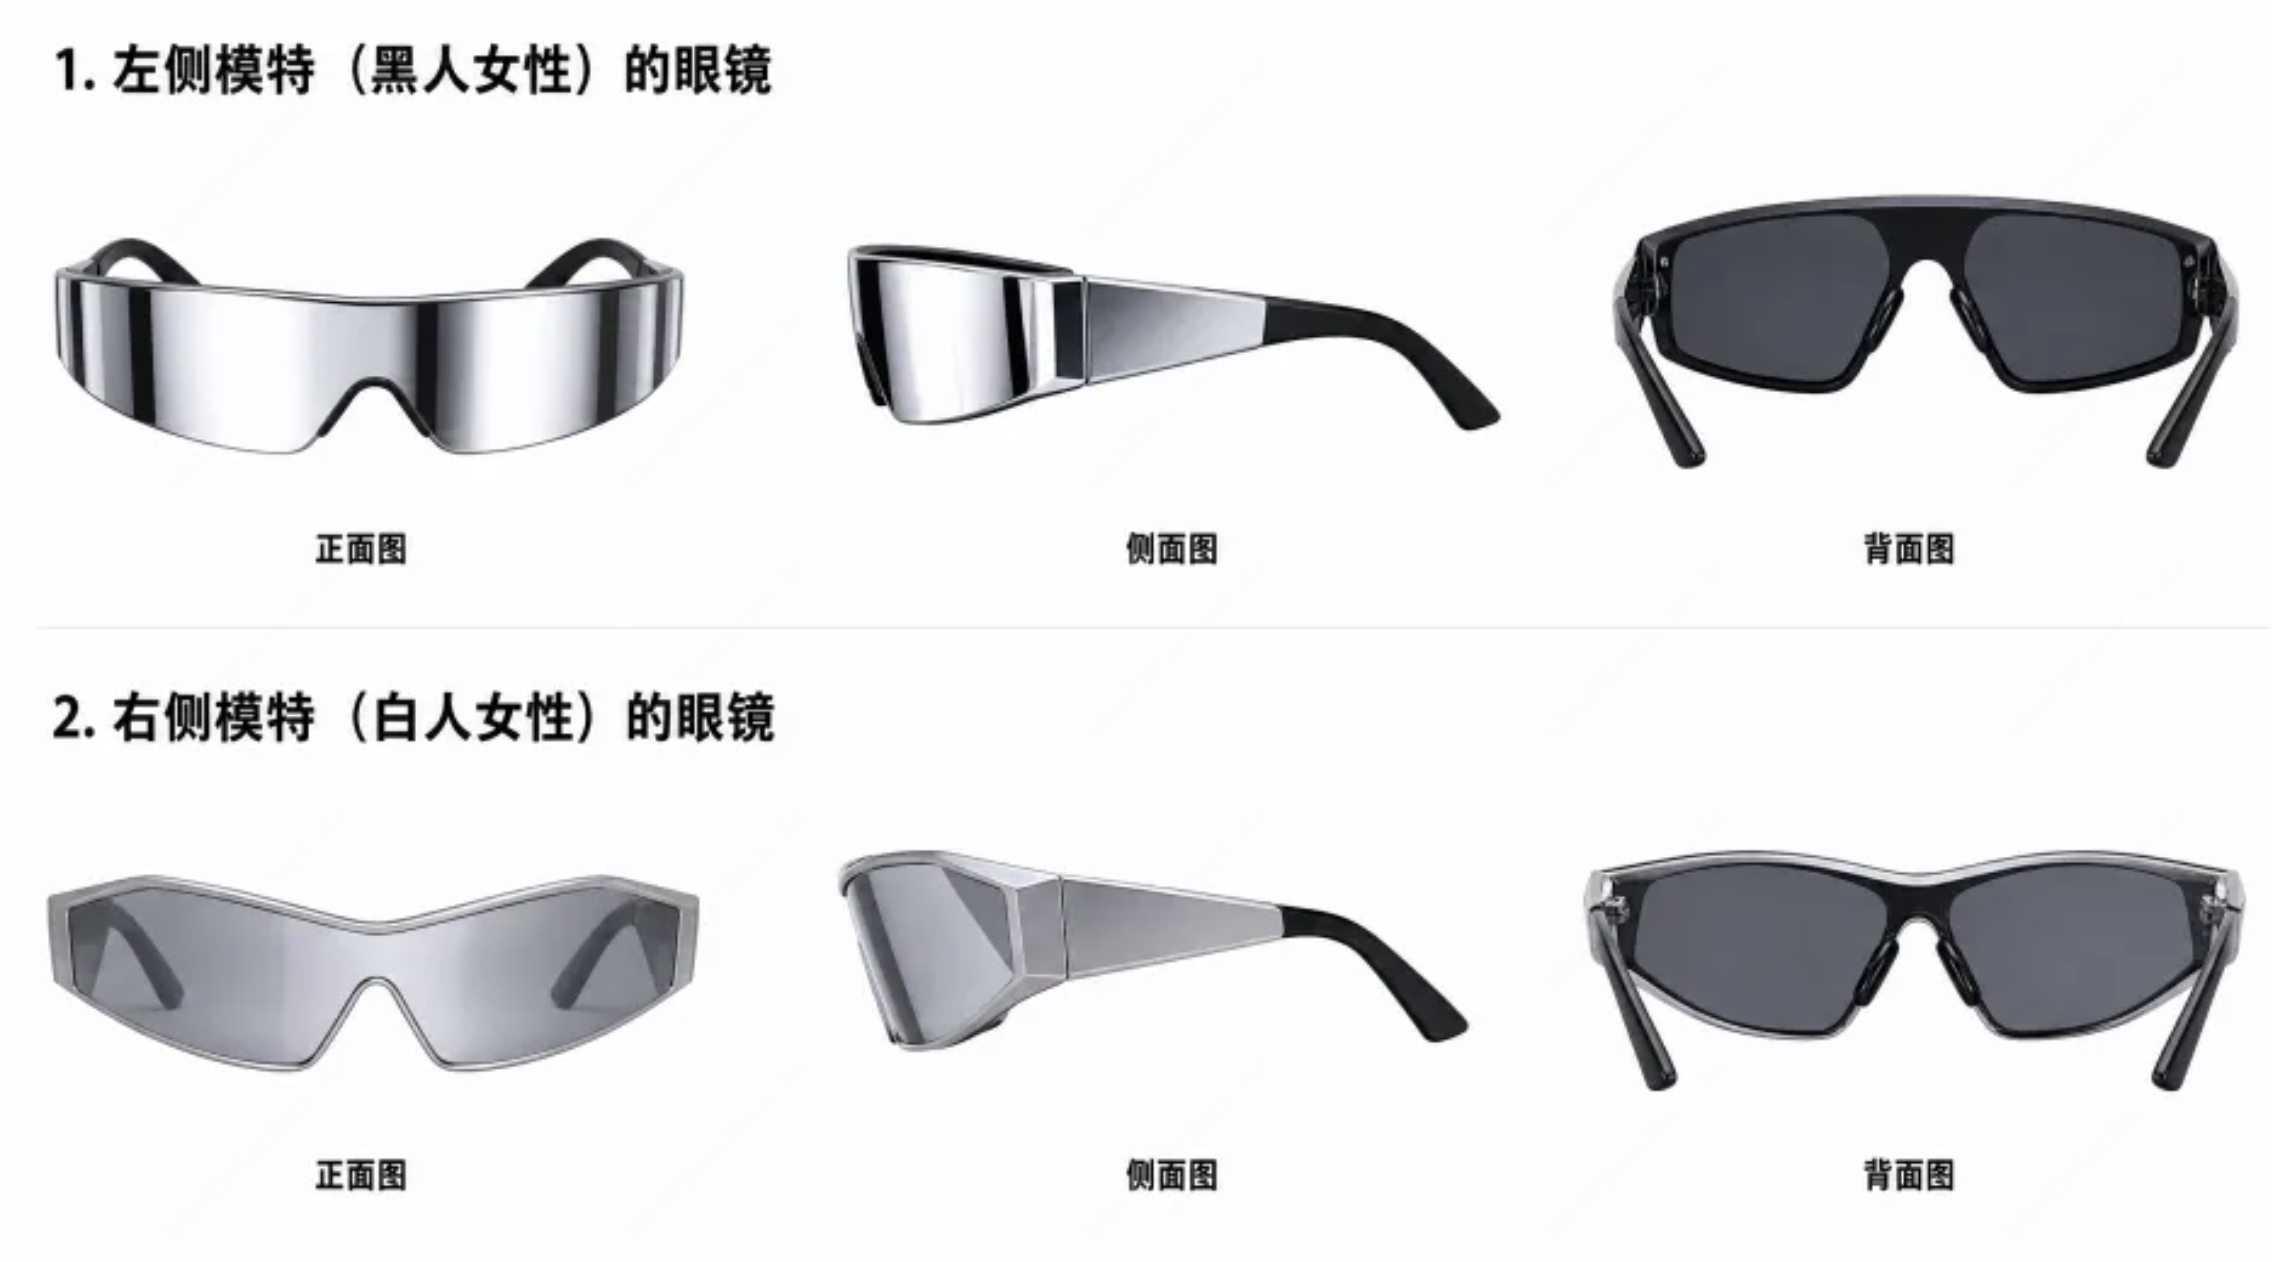 |
Text-zu-Video
Wenn es nur ein Textelement gibt, handelt es sich um Text-zu-Video. Es eignet sich dazu, direkt aus Kreativideen, Skripten oder Einstellungsbeschreibungen Bilder zu generieren. Der Prompt kann in der Reihenfolge „Subjekt + Aktion + Szene + Kamera + Licht + Ton“ organisiert werden."async": true zur Anfrage hinzugefügt wird, gibt die Schnittstelle sofort zurück:
Bild-zu-Video mit erstem Frame
Markieren Sie ein Bild alsfirst_frame, dann generiert das Modell ausgehend von diesem Bild. Dies eignet sich dafür, Poster, Produktbilder, Figurenentwürfe und fotografische Werke auf natürliche Weise in Bewegung zu versetzen.
Letzter Frame sowie Videos mit erstem und letztem Frame
Die alleinige Bereitstellung vonlast_frame ermöglicht dem Modell, sich natürlich bis zum angegebenen Bild zu generieren; die gleichzeitige Bereitstellung von first_frame und last_frame ermöglicht eine eindeutige Steuerung von Start- und Endpunkt. Geeignet für Übergänge, Formveränderungen, Wachstumsprozesse oder Produktvergleiche vorher und nachher.
Multimodales Referenz-zu-Video
Referenzmaterialien können kombiniert verwendet werden: Referenzbilder steuern das Aussehen von Figuren oder Produkten, Referenzvideos steuern Bewegungen und Kameraführung, Referenzaudio steuert Dialogstimme, Musik oder Schnittrhythmus. Im Prompt sollte klar angegeben werden, was jede Art von Material steuern soll, um zu vermeiden, dass Materialien nur hochgeladen werden, ohne eine Zuordnung anzugeben.Callback-Benachrichtigungen
Die Übergabe voncallback_url aktiviert automatisch den asynchronen Modus: Die Erstellungs-Schnittstelle gibt sofort task_id und trace_id zurück und sendet nach Abschluss der Aufgabe das Endergebnis per POST an diese Adresse; die Struktur entspricht der Antwort der Aufgabenabfrage.
Die endgültigen Statuswerte im Callback sind succeeded, failed oder cancelled. Auch bei Verwendung eines Callbacks wird empfohlen, task_id zu speichern, um aktiv abfragen oder verpasste Benachrichtigungen ausgleichen zu können.
Häufige Fehler
task.status: succeeded in der synchronen Antwort bedeutet, dass das Video generiert wurde; eine asynchrone Bestätigung bedeutet nur, dass die Aufgabe in die Warteschlange aufgenommen wurde. Es wird nur abgerechnet, wenn die Aufgabe letztlich erfolgreich ist; die Aufgabenabfrage selbst ist kostenlos und führt nicht zu wiederholten Abbuchungen.
H3 Max
MiniMax-H3-Max unterstützt 480P oder 768P sowie ganzzahlige Dauern von 5–15 Sekunden. Audioeingaben werden nicht zusätzlich berechnet, die ersten 2 Bilder sind kostenlos, darüber hinausgehende Bilder werden einzeln berechnet; Referenzvideos werden nach der tatsächlichen Eingabedauer berechnet. Dieses Modell unterstützt kein 2K.