

content unifiée pour créer les tâches.
Processus de demande
Pour utiliser l’API de génération de vidéos MiniMax H3, rendez-vous d’abord sur la console Ace Data Cloud pour obtenir votre API Token, à conserver en réserve. Si vous n’êtes pas encore connecté ou inscrit, vous serez automatiquement redirigé vers la page de connexion qui vous invitera à vous inscrire et à vous connecter ; une fois terminé, vous reviendrez automatiquement sur la page actuelle.
Un seul API Token permet d’appeler tous les services de la plateforme, sans avoir besoin d’en demander un séparément pour chaque service. Une première demande offre un quota gratuit, permettant une expérience gratuite ; lorsque le quota est insuffisant, vous pouvez recharger le solde général dans la console.
📘 Documentation complète : API de génération de vidéos MiniMax H3 →Il est recommandé d’enregistrer le Token comme variable d’environnement, sans l’écrire dans le code source ni le soumettre à un dépôt de versions :
Vue d’ensemble de l’interface
- Base URL :
https://api.acedata.cloud - Endpoint :
POST /minimax/videos - Méthode d’authentification : transmettre
authorization: Bearer {token}dans le HTTP Header - En-têtes de requête :
accept: application/jsoncontent-type: application/json
- Modèle (model) :
MiniMax-H3 - Structure d’entrée : transmettre uniformément le texte, les images, les vidéos et l’audio via
content - Mode de sortie : attend par défaut de manière synchrone la fin de la génération et retourne le
taskcomplet ; en passantasync: trueoucallback_url, retourne immédiatementtask_idettrace_id - Consultation des résultats : obtenez le statut et la vidéo finale via l’API de consultation des tâches MiniMax H3
- Rappel asynchrone : facultatif, recevez le résultat final de la tâche via
callback_url
action pour choisir le mode de génération, l’interface déterminera automatiquement son utilisation selon le type de média et le role dans content.
Scénarios adaptés
Processus d’appel
Lorsqueasync n’est pas transmis par défaut, /minimax/videos attendra la fin de la génération et retournera directement le task complet. Lorsqu’il est nécessaire de libérer immédiatement la connexion, transmettez async: true ou callback_url :
- Enregistrez
task_idettrace_iddans la réponse immédiate. - En l’absence de rappel configuré, appelez
/minimax/tasksenviron toutes les 10 secondes pour effectuer une consultation. - Lorsque
task.statusdevientsucceeded, récupérez la vidéo depuistask.content.url. - Lorsque le statut est
failedoucancelled, arrêtez l’interrogation et consulteztask.error.
Paramètres de requête de niveau supérieur
Les règles de
ratio dépendent du flux de travail :
- Génération de vidéo à partir de texte : obligatoire et ne peut pas être
adaptive. - Vidéo avec image initiale, image finale ou première et dernière images : le format est déterminé par l’image d’entrée, il est recommandé de l’omettre ou de transmettre
adaptive. - Génération de vidéo à partir de références multimodales : peut être omis, la valeur par défaut est
adaptive; un ratio fixe peut également être explicitement spécifié.
prompt, image_urls, audio_urls, messages et first_frame_image. Lorsque vous recevez des erreurs liées à ce type de paramètres, supprimez les anciens champs et migrez vers content ; par exemple, remplacez "prompt": "一只猫挥手" par "content": [{"type": "text", "text": "一只猫挥手"}]。N’envoyez pas simultanément les deux nouveaux et anciens formats.
Paramètres des éléments de contenu content
Chaque élément de contenu doit avoir untype, les autres champs étant déterminés par le type :
Les adresses média prennent en charge trois formats :
- URL HTTPS accessible publiquement, recommandée pour les fichiers volumineux.
mm_file://{file_id}, référence à un fichier déjà téléversé ou à un résultat existant.- URI data Base64 du type de média correspondant. Base64 augmente la taille d’environ un tiers, assurez-vous que l’ensemble du corps de la requête ne dépasse pas 64 MB.
Spécifications des médias et limites de quantité
Les images, vidéos et audios dans les scénarios de référence multimodaux totalisent au maximum 12 fichiers. Les scénarios de première et dernière image sont mutuellement exclusifs avec les scénarios de ressources de référence : dès lors que
reference_image, reference_video ou reference_audio est utilisé, first_frame ou last_frame ne peut plus être utilisé, et inversement.
Présentation des capacités de niveau production
Les éléments ci-dessous ne sont pas des maquettes conceptuelles ni des ressources de substitution, mais de véritables entrées de référence et sorties vidéo réelles d’échantillons officiels des capacités de niveau production de MiniMax H3. Les trois groupes de cas couvrent respectivement les films de marque, les récits avec acteurs réels et l’e-commerce de mode, et conviennent pour évaluer les capacités les plus cruciales du modèle dans la production commerciale.
Ici, les « capacités faciales » désignent la cohérence de l’apparence des personnages, les détails du visage et le contrôle de l’interprétation dans la génération vidéo ; il ne s’agit pas de reconnaissance d’identité, de comparaison faciale ou d’interface d’échange de visage.
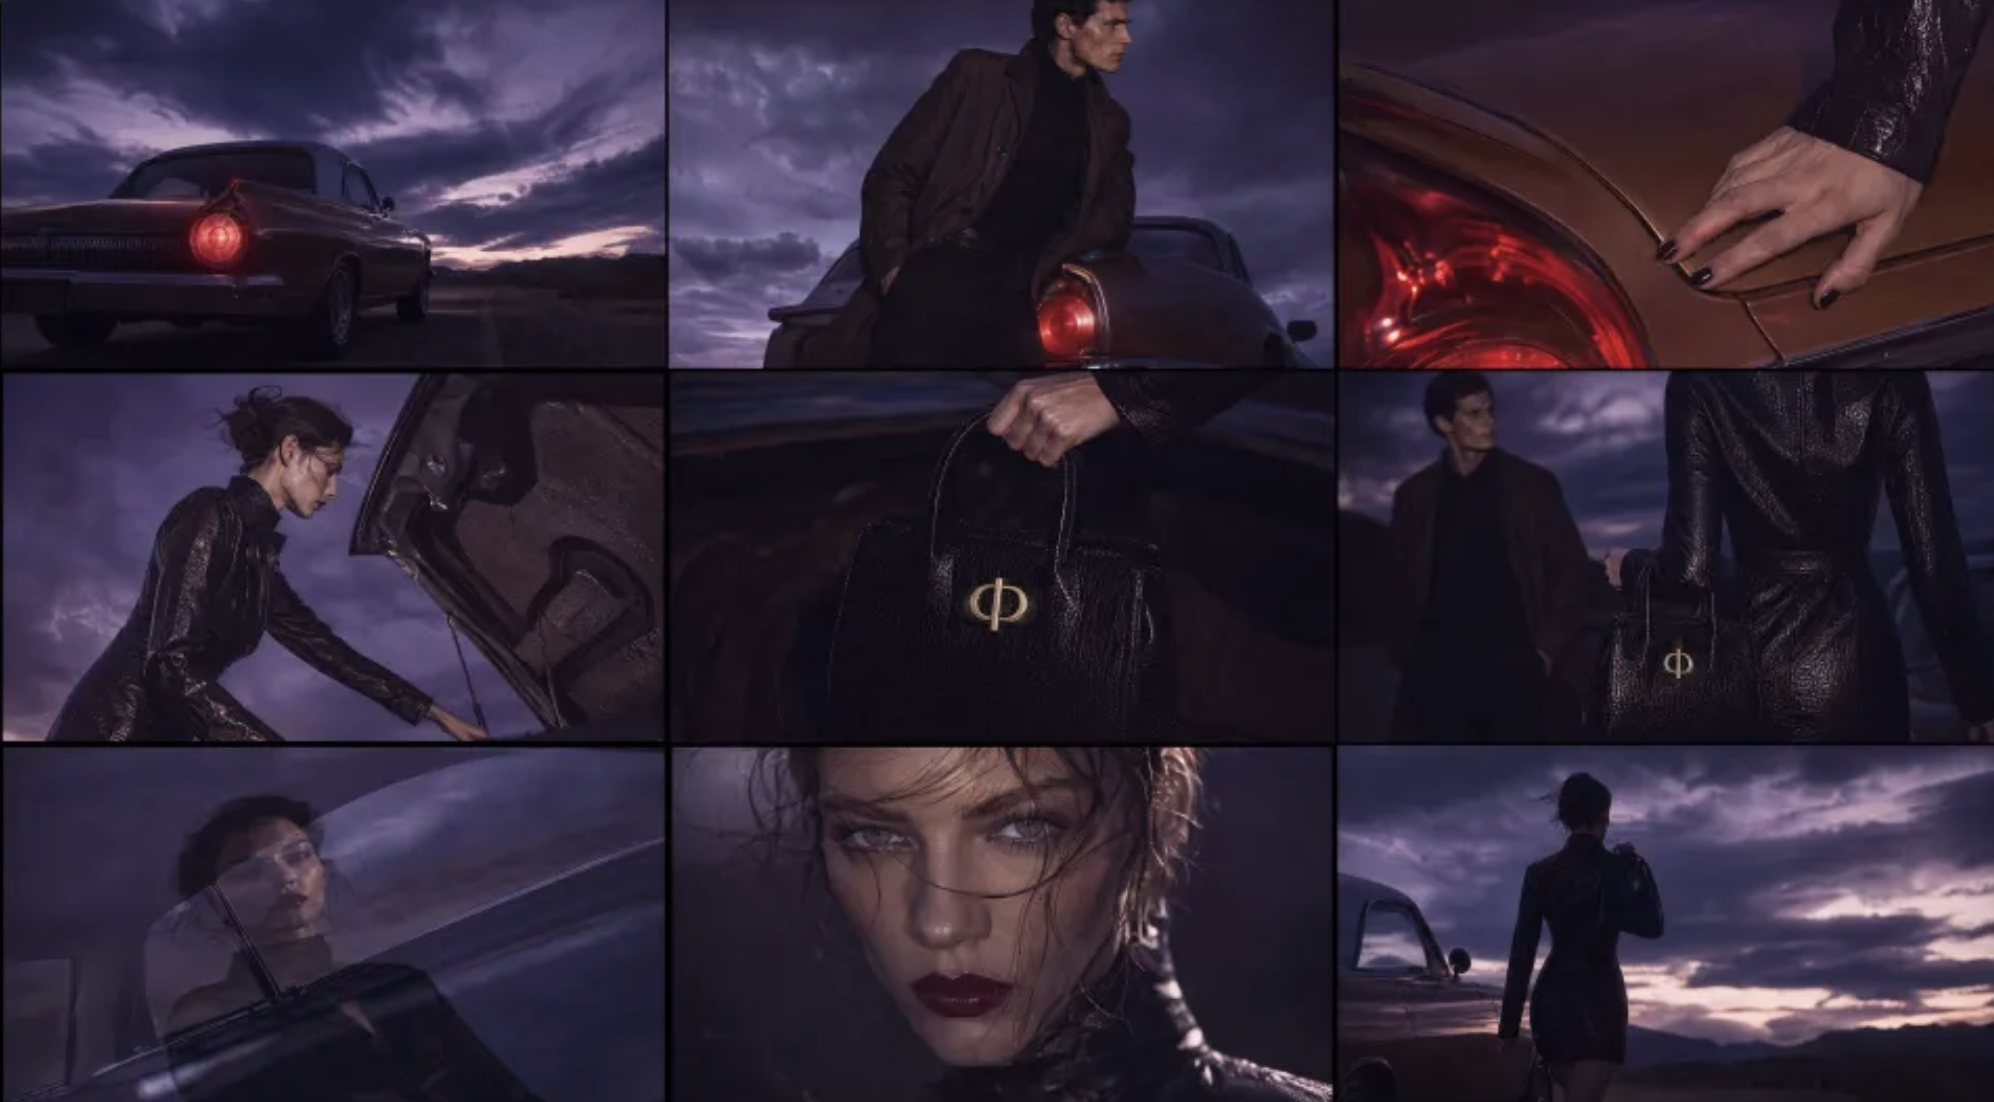
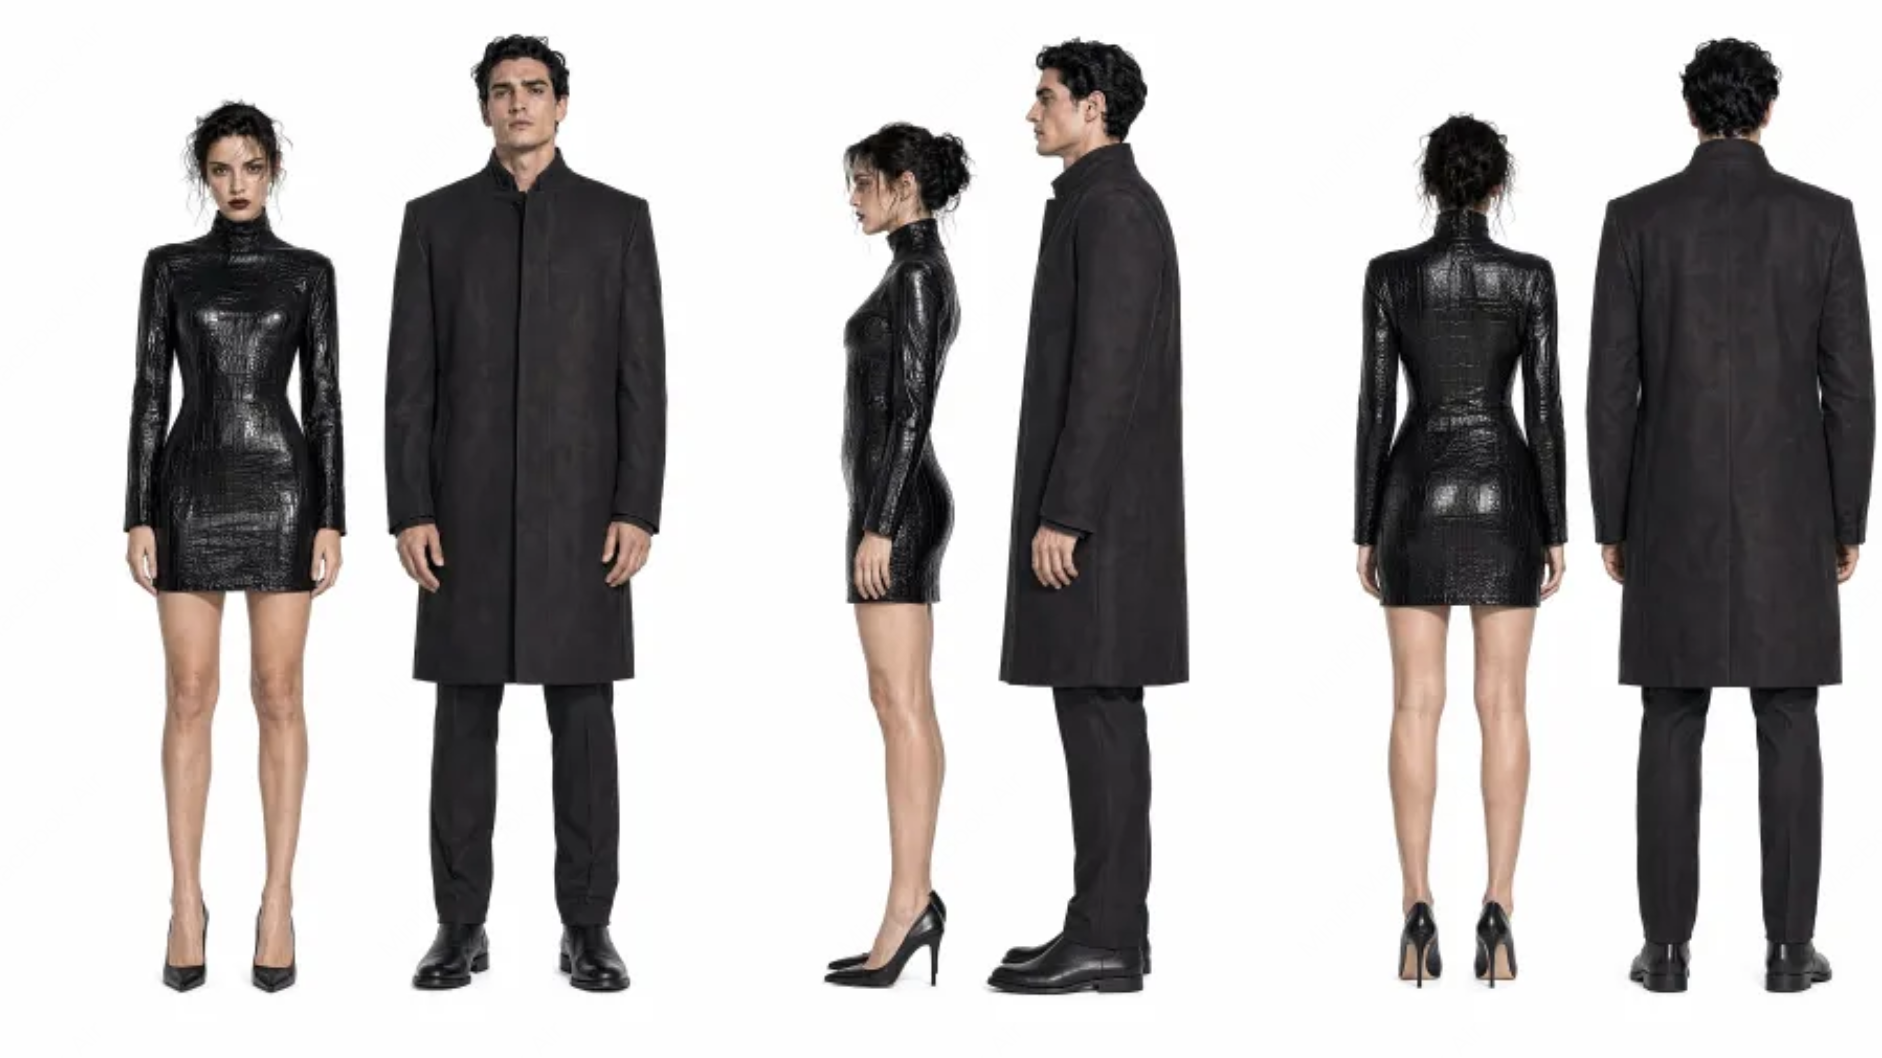
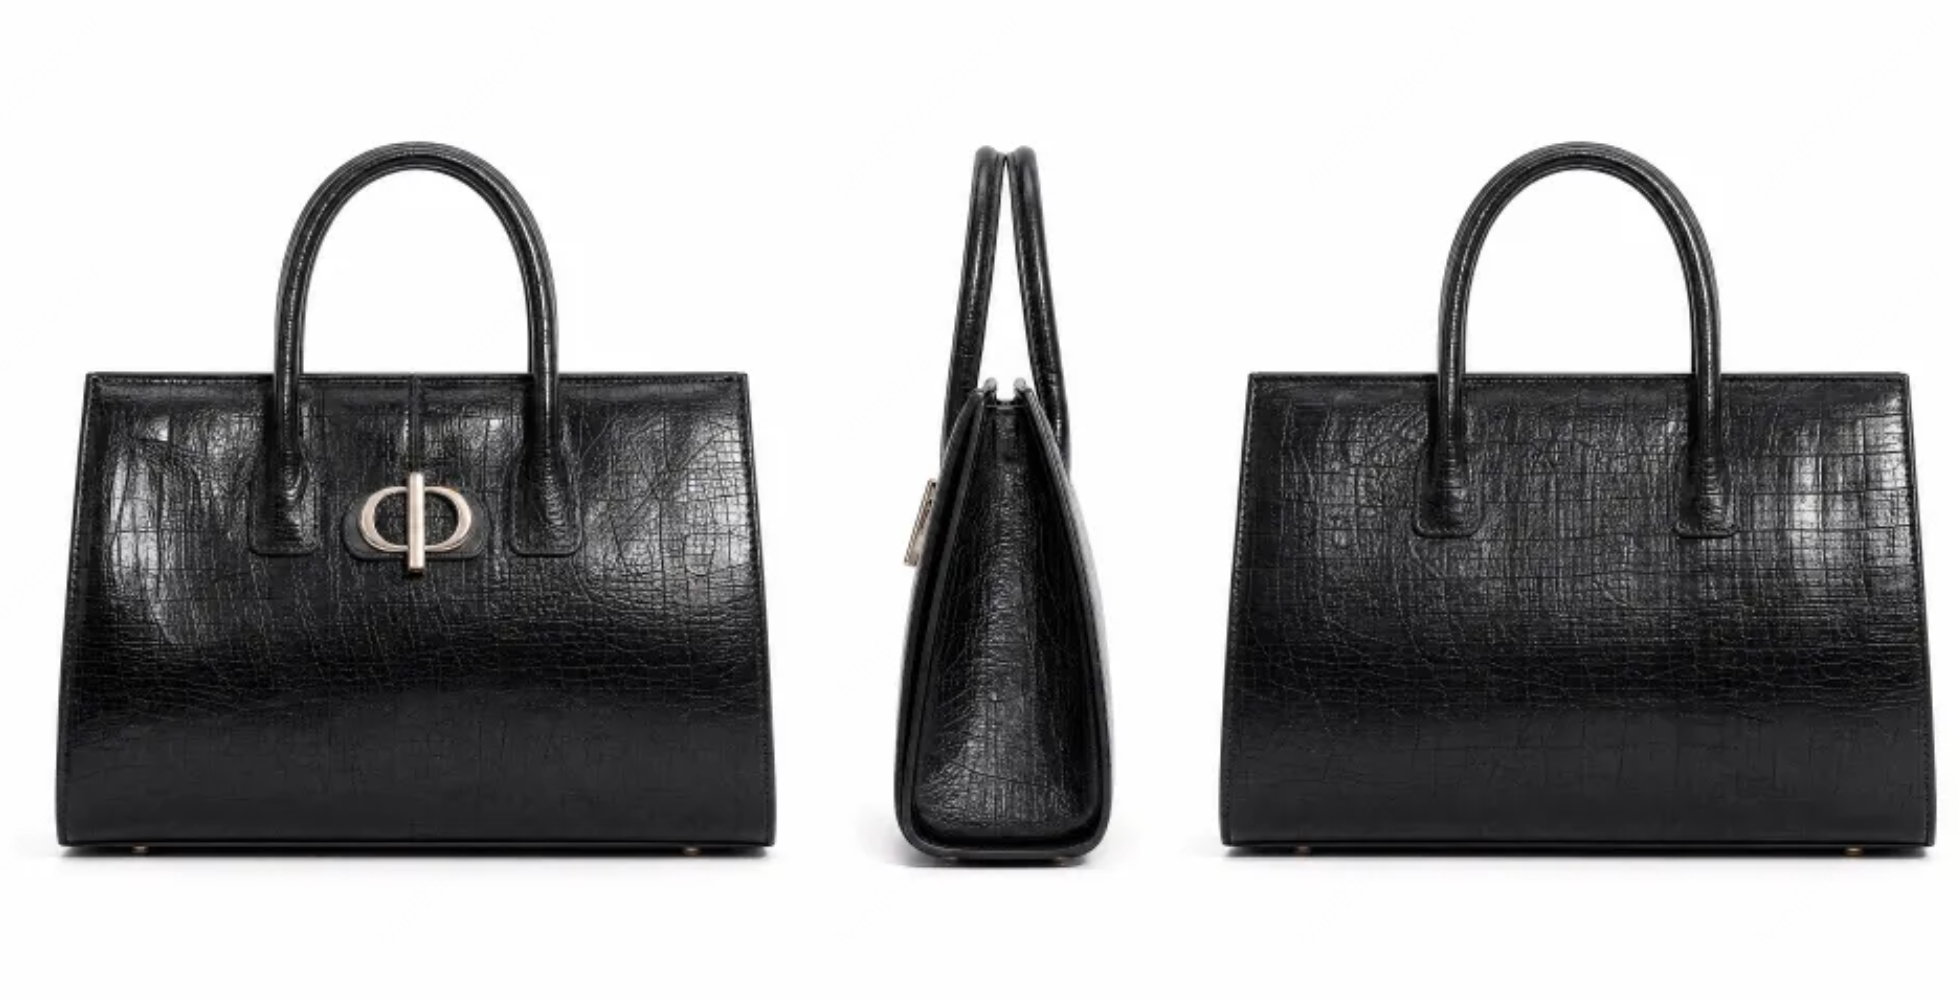
Film court de marque haut de gamme : unification des personnages, des produits et des actifs de marque
Objectif de production : Film de marque de mode haut de gamme en 16:9. Établir une atmosphère froide à l’aide d’une route désertique et d’une voiture vintage, préserver l’apparence de l’héroïne et la structure du sac à main noir, et intégrer naturellement le logo de la marque à la fin. Ce cas teste principalement la cohérence des personnages entre les plans, la préservation du produit, la texture cinématographique et la capacité à conclure avec la marque.| Référence d’ambiance et de scène | Référence du personnage |
|---|---|
 |  |
| Référence du produit sac à main | Référence du logo de la marque |
|---|---|
 |  |
content correspondante :
Mini-série verticale avec acteurs réels : cohérence faciale et interprétation émotionnelle
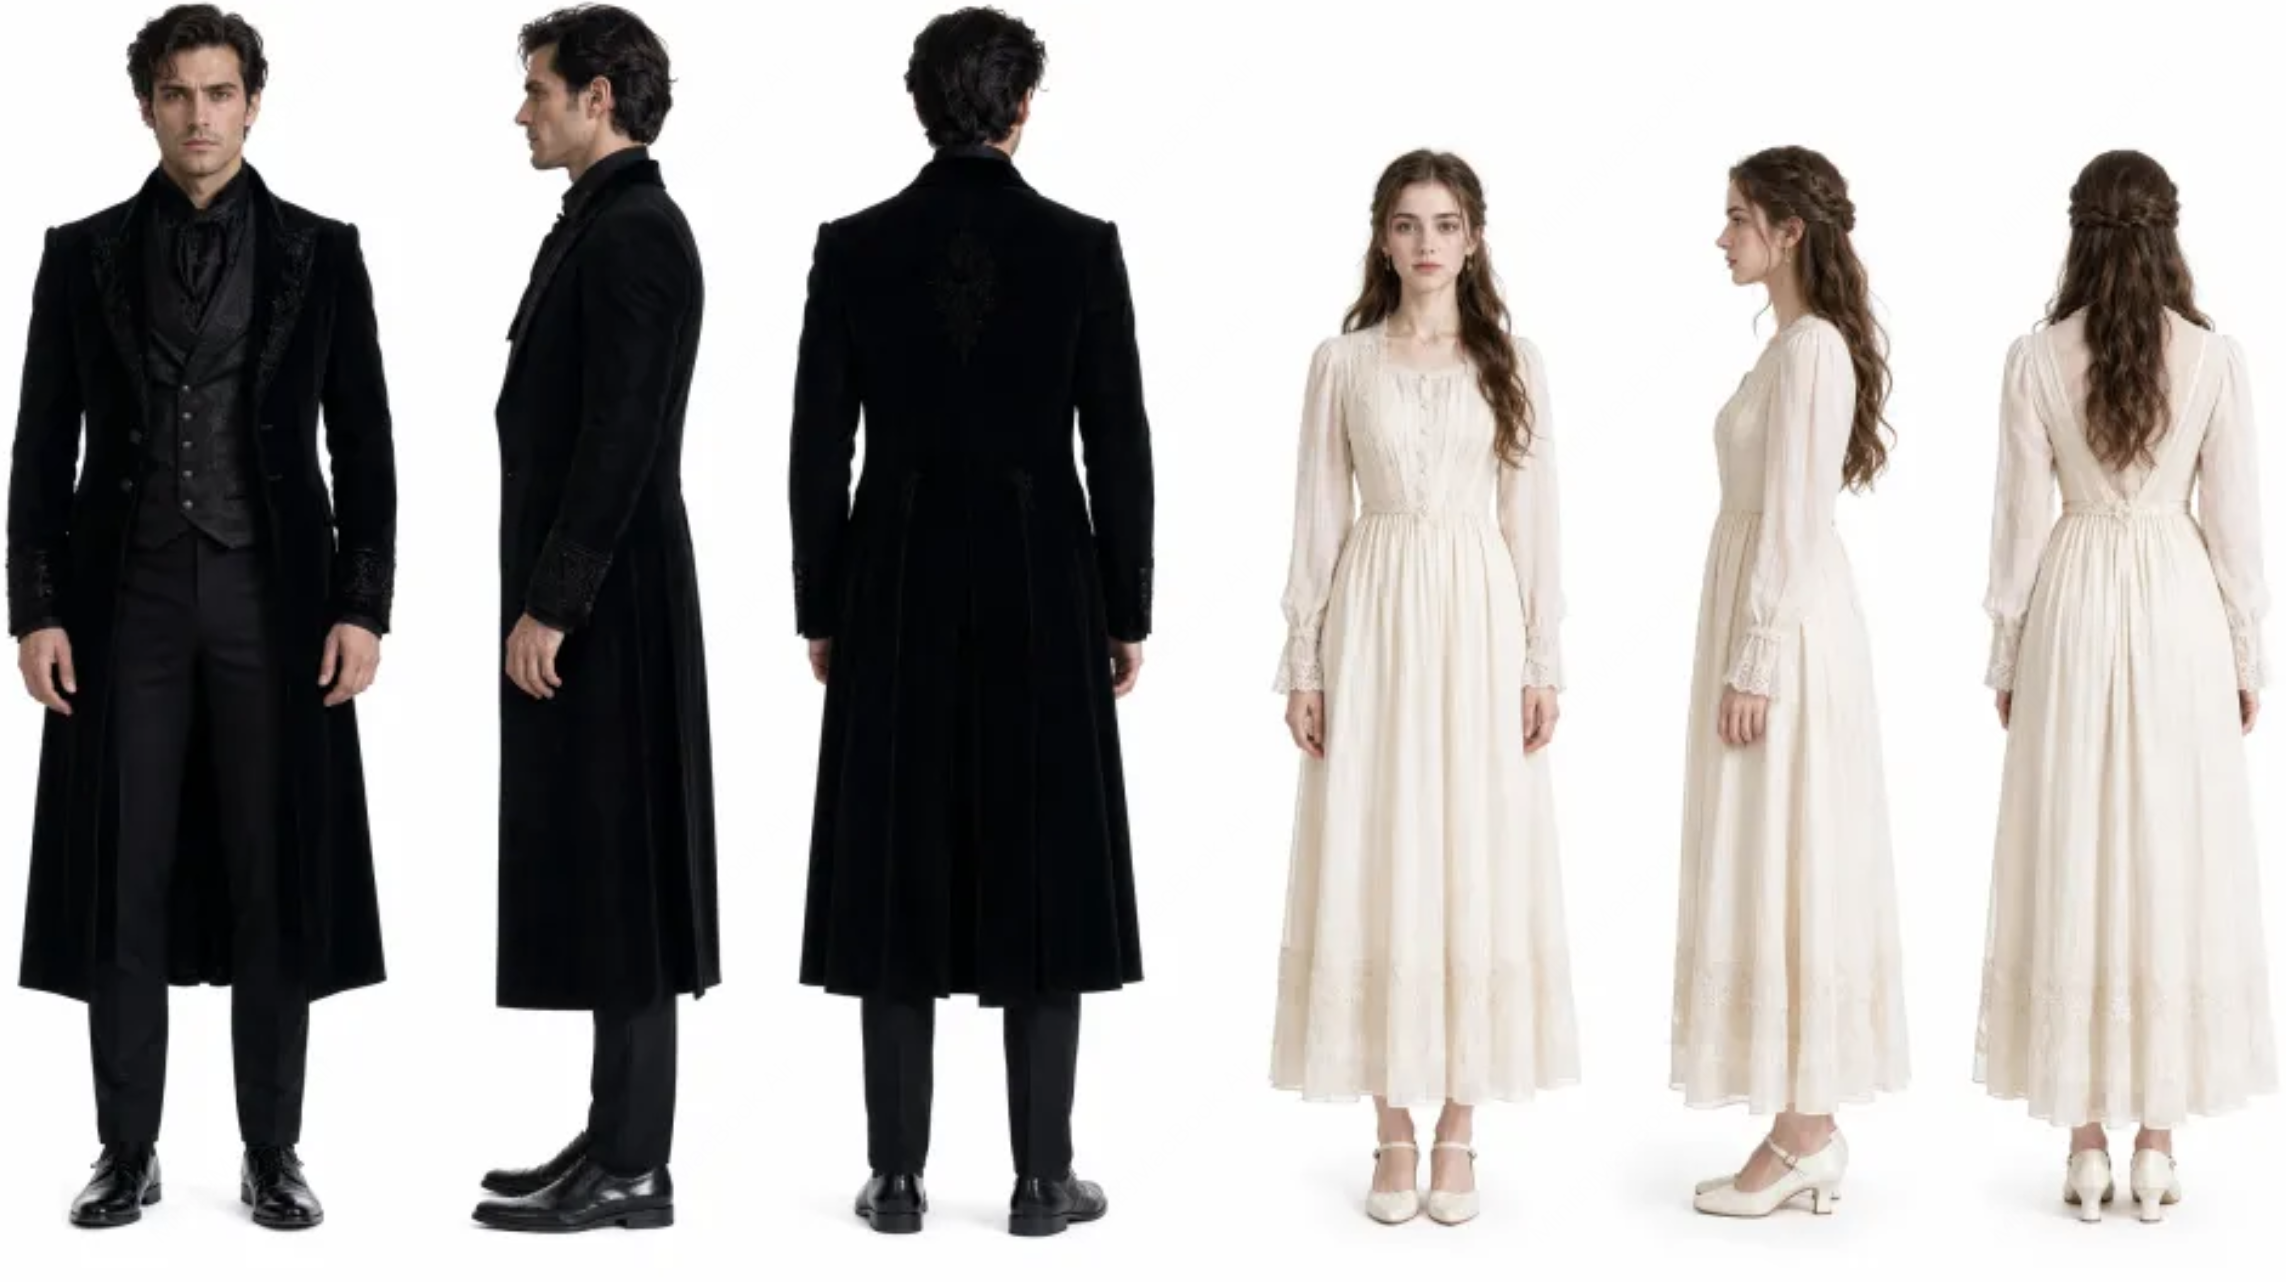
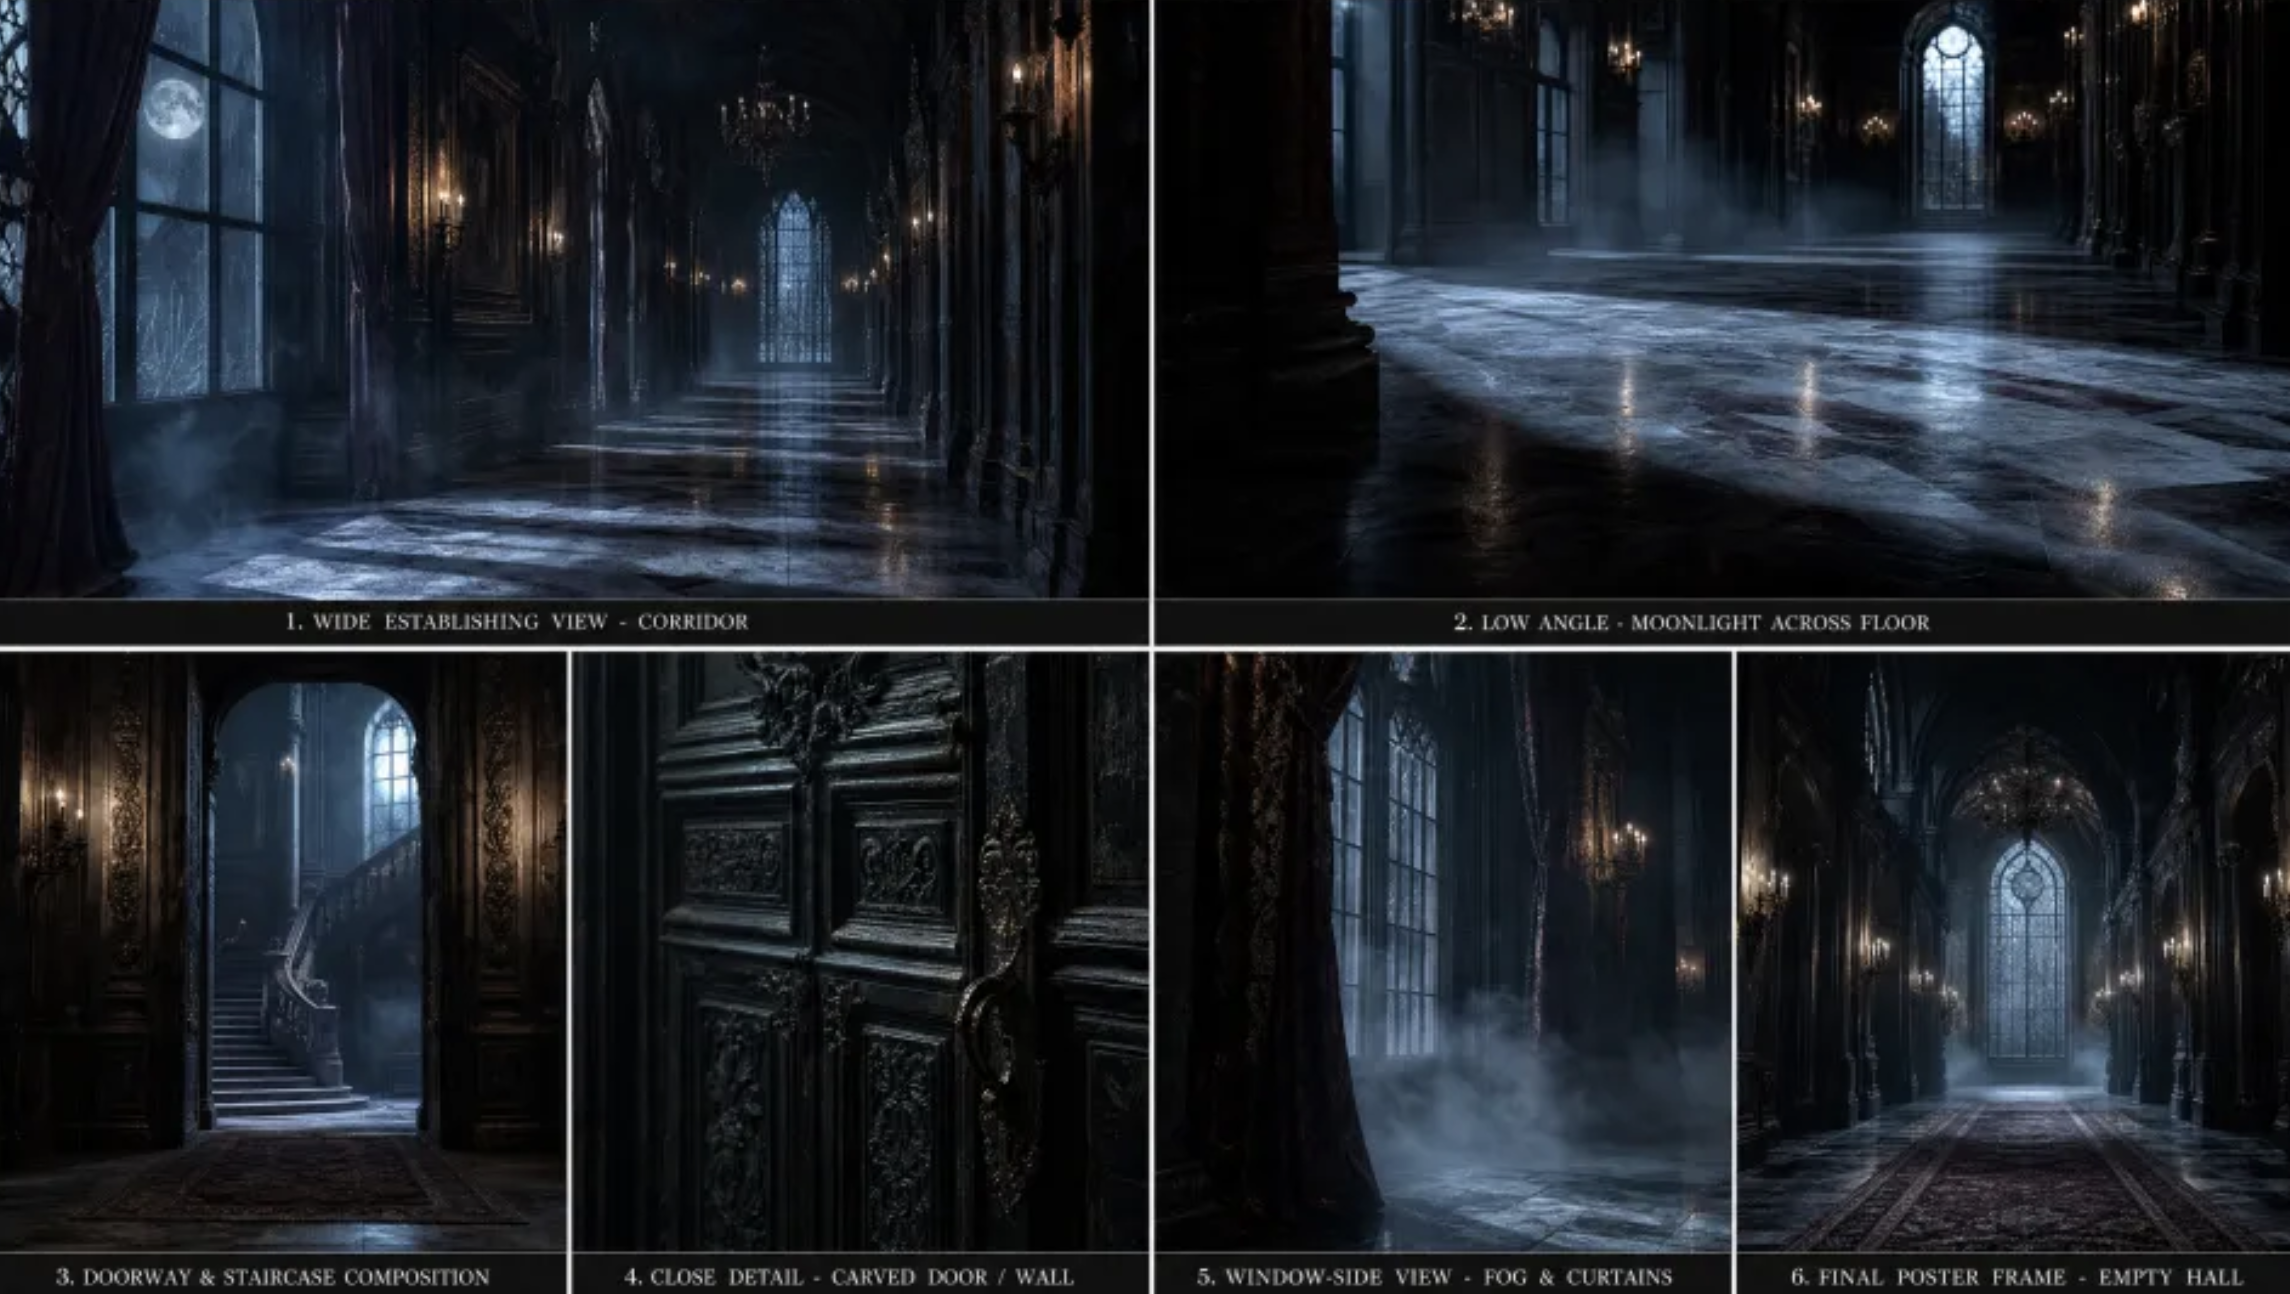
Objectif de production : Bande-annonce de court métrage romantique sombre de 15 secondes, au format 9:16. Verrouillez l’apparence des personnages à l’aide des images de référence des protagonistes masculin et féminin, et contraignez l’espace à l’aide de l’image de référence du château ; utilisez des plans moyens rapprochés et des gros plans du visage pour exprimer la confrontation des regards, la peur, la retenue et le sentiment de danger. Ce cas est adapté à l’observation de la stabilité des traits du visage de personnes réelles, des micro-expressions, des relations de regard et de la continuité de l’interprétation.| Référence des protagonistes masculin et féminin | Référence de la scène du château sombre |
|---|---|
 |  |
Publicité de lunettes de mode : maintien des détails du visage et de la structure du produit
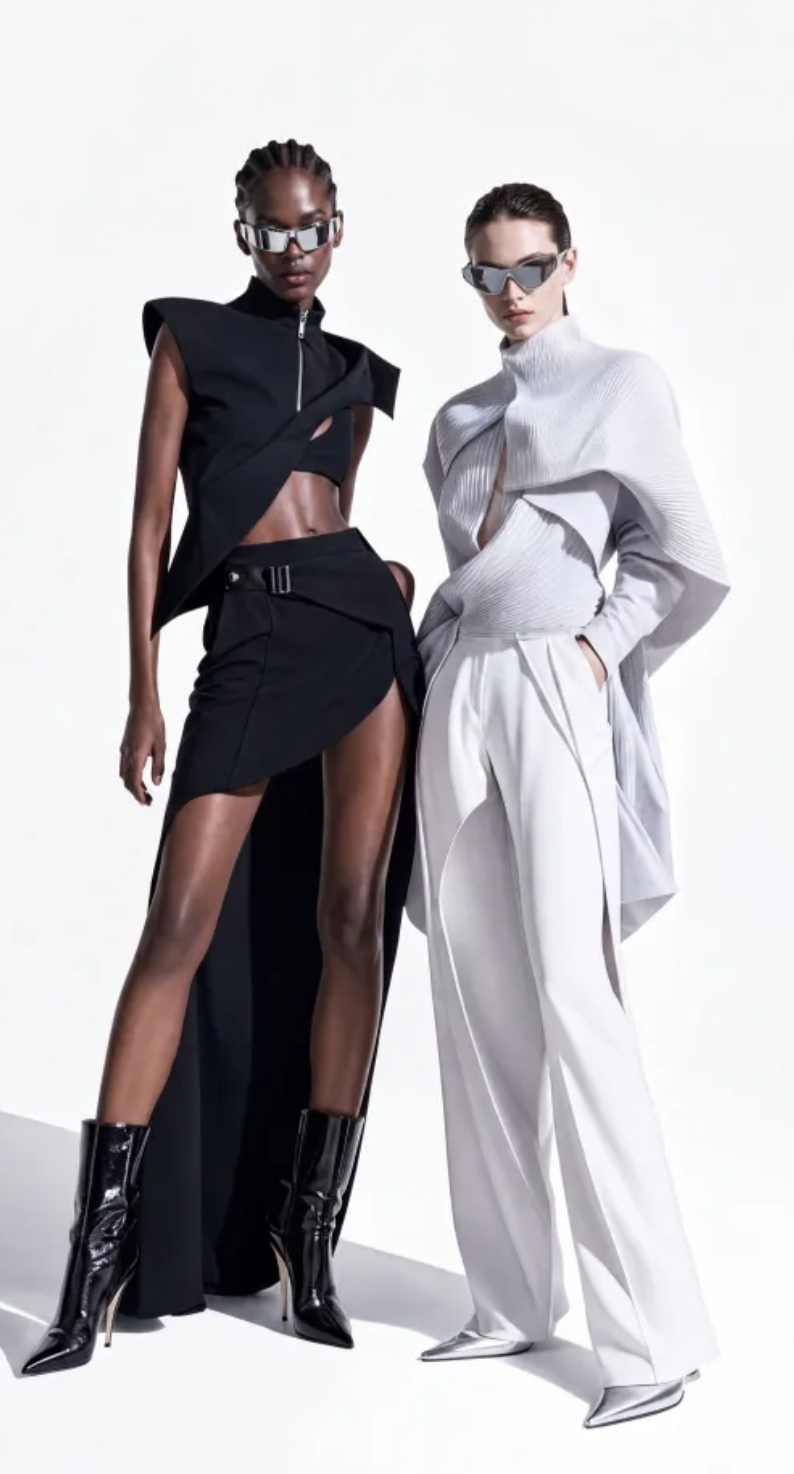
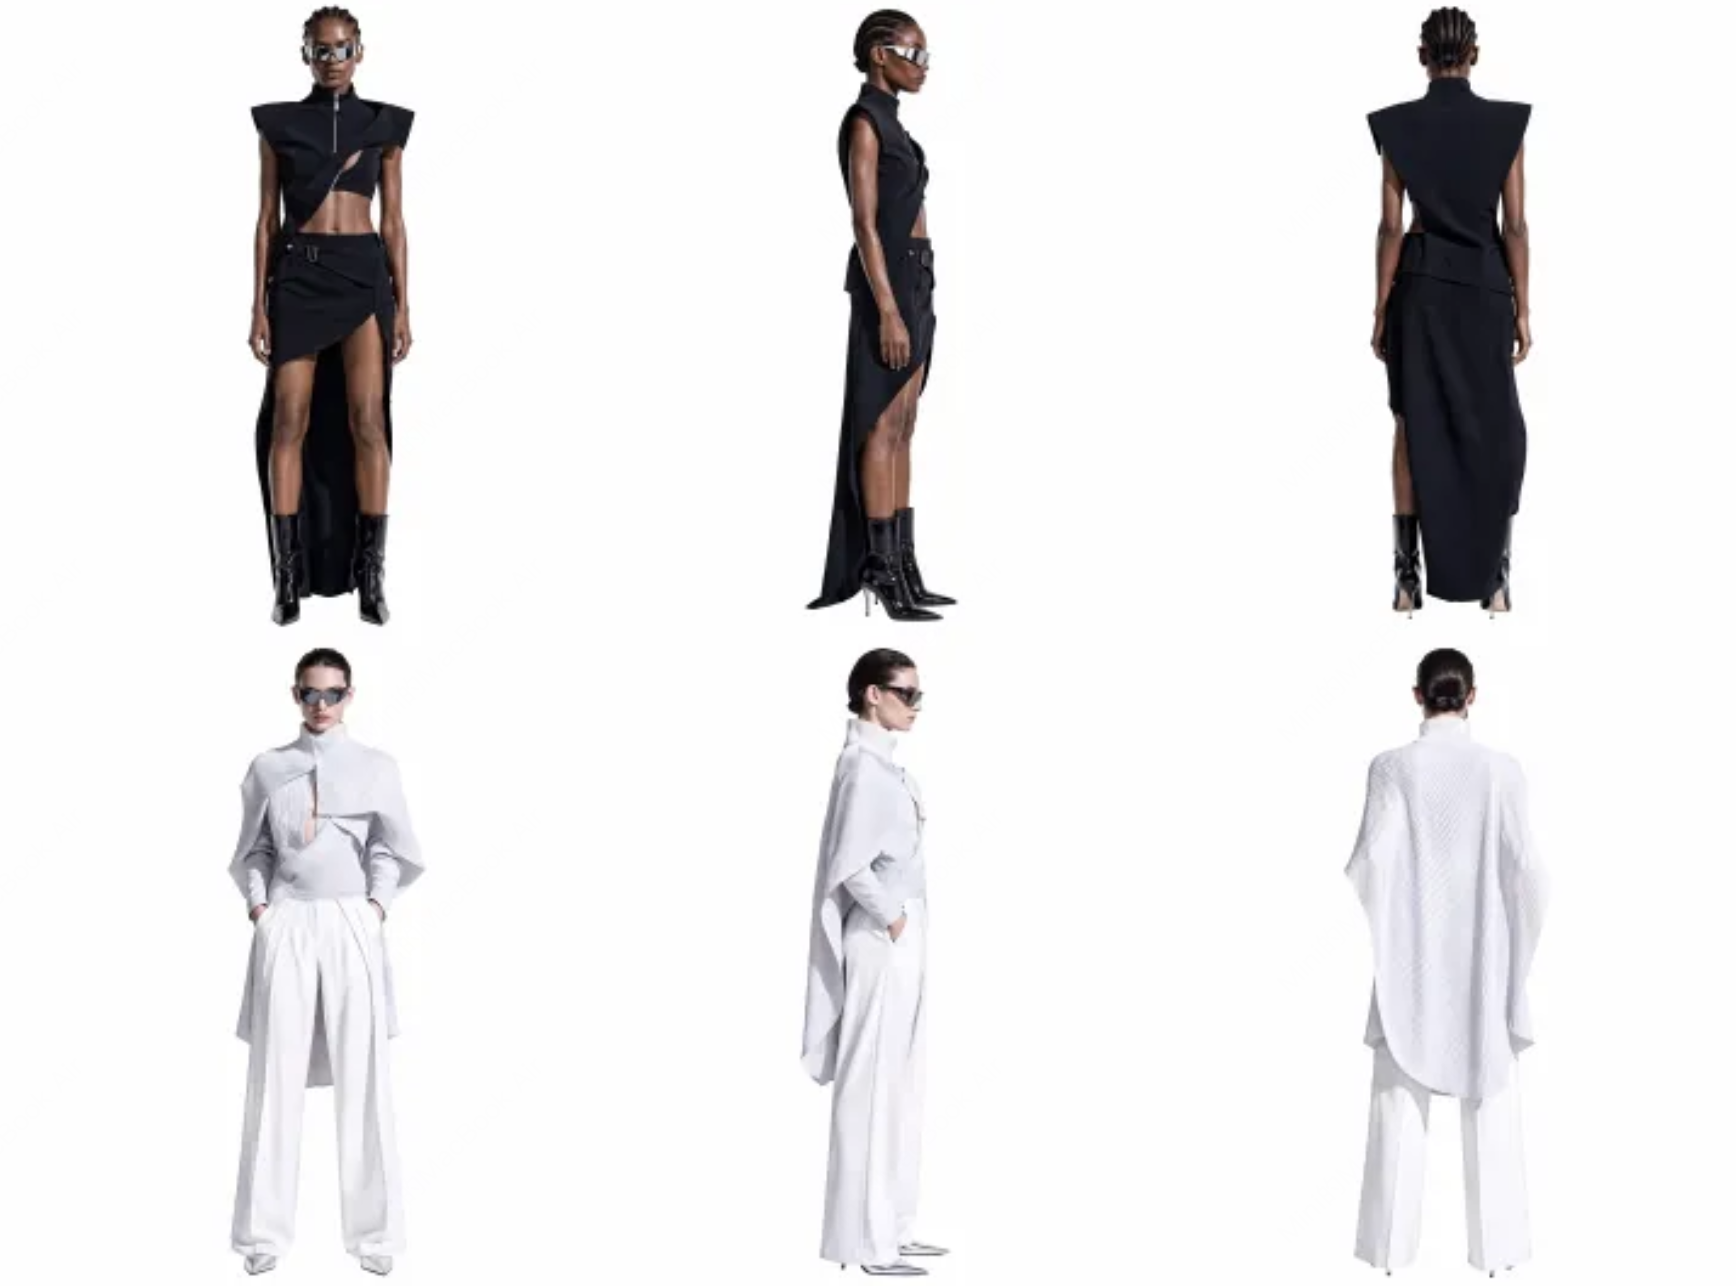
Objectif de production : Publicité de lunettes de mode haut de gamme au format 9:16. L’image en pied du personnage est responsable de la silhouette et de la démarche, l’image de référence du visage est responsable des traits et du maquillage, et l’image du produit est responsable des courbes enveloppantes, des reflets des verres, des branches et du contour œil-de-chat. Ce cas évalue simultanément les gros plans du visage, la cohérence entre plusieurs personnes, la relation de port et la structure géométrique du produit.| Référence du mannequin et du style | Référence des détails du visage | Référence du produit de lunettes |
|---|---|---|
 |  | 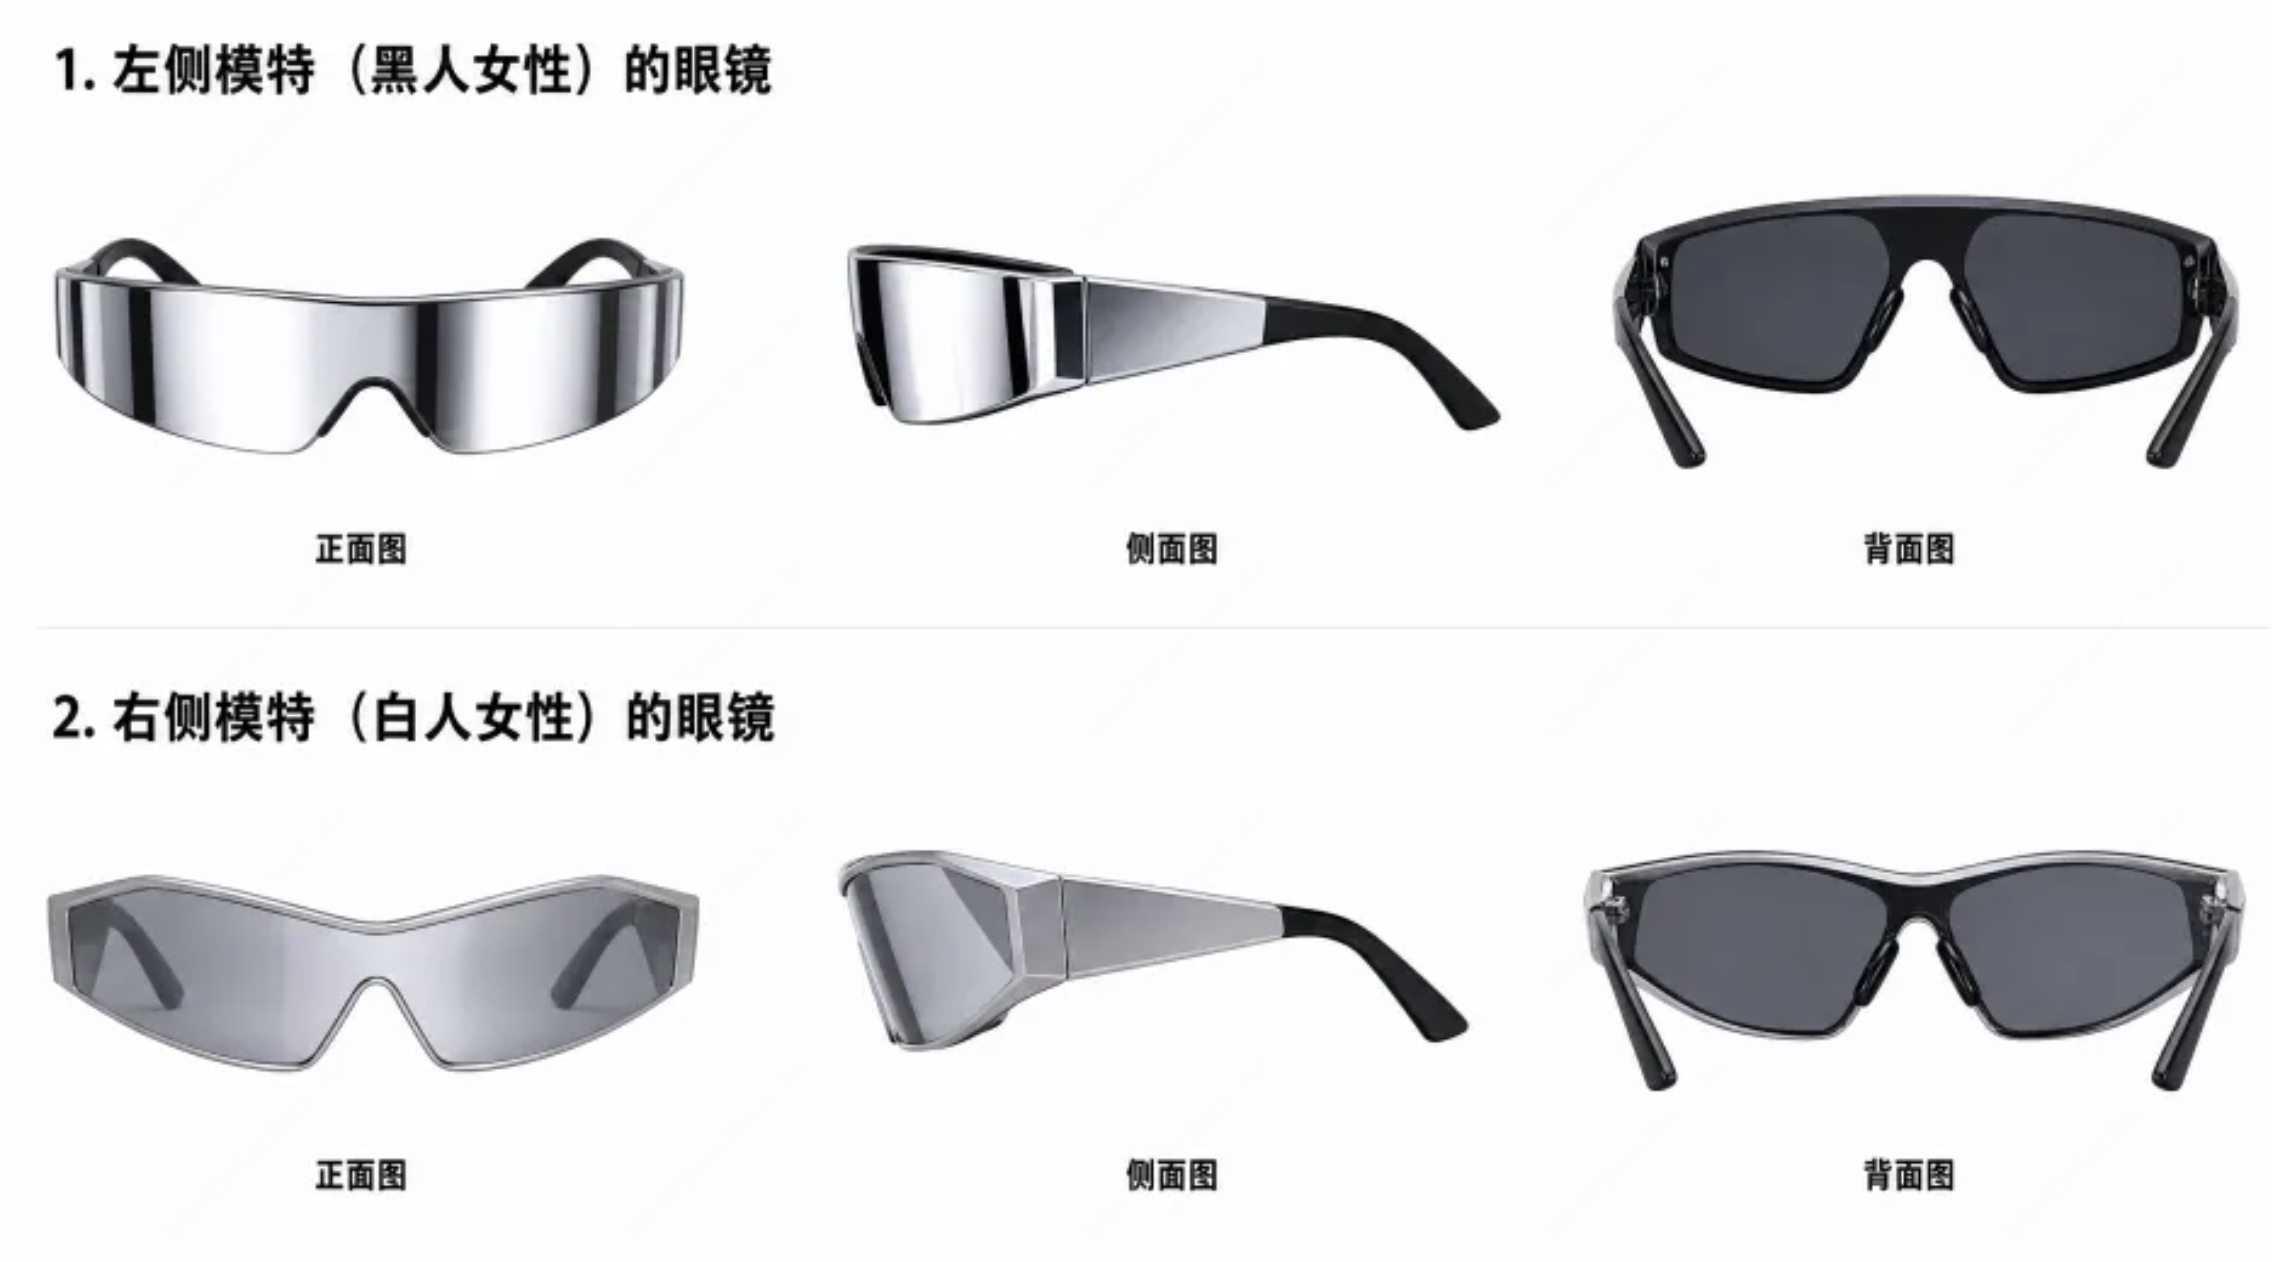 |
Texte vers vidéo
Lorsqu’il n’y a qu’un seul élément de texte, il s’agit d’une génération de vidéo à partir de texte. Cela convient pour générer directement des images à partir d’une idée créative, d’un script ou d’une description de plan. Le prompt peut être organisé selon l’ordre « sujet + action + scène + caméra + lumière + son »."async": true à la requête, l’interface renvoie immédiatement :
Image de première image vers vidéo
Marquez une image commefirst_frame, et le modèle commencera à générer à partir de cette image. Cela convient pour donner naturellement du mouvement à des affiches, des images de produits, des illustrations de personnages et des œuvres photographiques.
Vidéo avec image finale et images initiale et finale
Fournir uniquementlast_frame permet au modèle de générer naturellement jusqu’à l’image spécifiée ; fournir simultanément first_frame et last_frame permet de contrôler clairement le point de départ et le point d’arrivée. Convient aux transitions, aux changements de forme, aux processus de croissance ou aux comparaisons avant/après de produits.
Génération vidéo à partir de références multimodales
Les supports de référence peuvent être combinés : les images de référence contrôlent l’apparence du personnage ou du produit, les vidéos de référence contrôlent les mouvements et les mouvements de caméra, et les audios de référence contrôlent le timbre des dialogues, la musique ou le rythme du montage. Le prompt doit clairement indiquer ce que chaque type de support doit contrôler, afin d’éviter de simplement téléverser des supports sans fournir de relation entre eux.Notification de rappel
La transmission decallback_url active automatiquement le mode asynchrone : l’interface de création renvoie immédiatement task_id et trace_id, et envoie le résultat final par POST à cette adresse une fois la tâche terminée ; la structure est identique à celle de la réponse de requête de tâche.
Les états finaux dans le rappel sont succeeded, failed ou cancelled. Même en utilisant un rappel, il est recommandé de sauvegarder task_id, afin d’effectuer des requêtes actives ou de compenser les notifications manquées.
Erreurs courantes
Dans une réponse synchrone,
task.status: succeeded indique que la vidéo a été générée ; la confirmation asynchrone indique seulement que la tâche est entrée dans la file d’attente. La facturation n’a lieu que lorsque la tâche réussit finalement ; la requête de tâche elle-même est gratuite et ne génère pas de frais répétés.
H3 Max
MiniMax-H3-Max prend en charge une résolution de 480P ou 768P, ainsi que des durées entières de 5 à 15 secondes. Les entrées audio ne sont pas facturées en supplément, les 2 premières images sont gratuites et les images supplémentaires sont facturées une par une ; les vidéos de référence sont facturées selon leur durée réelle d’entrée. Ce modèle ne prend pas en charge la 2K.