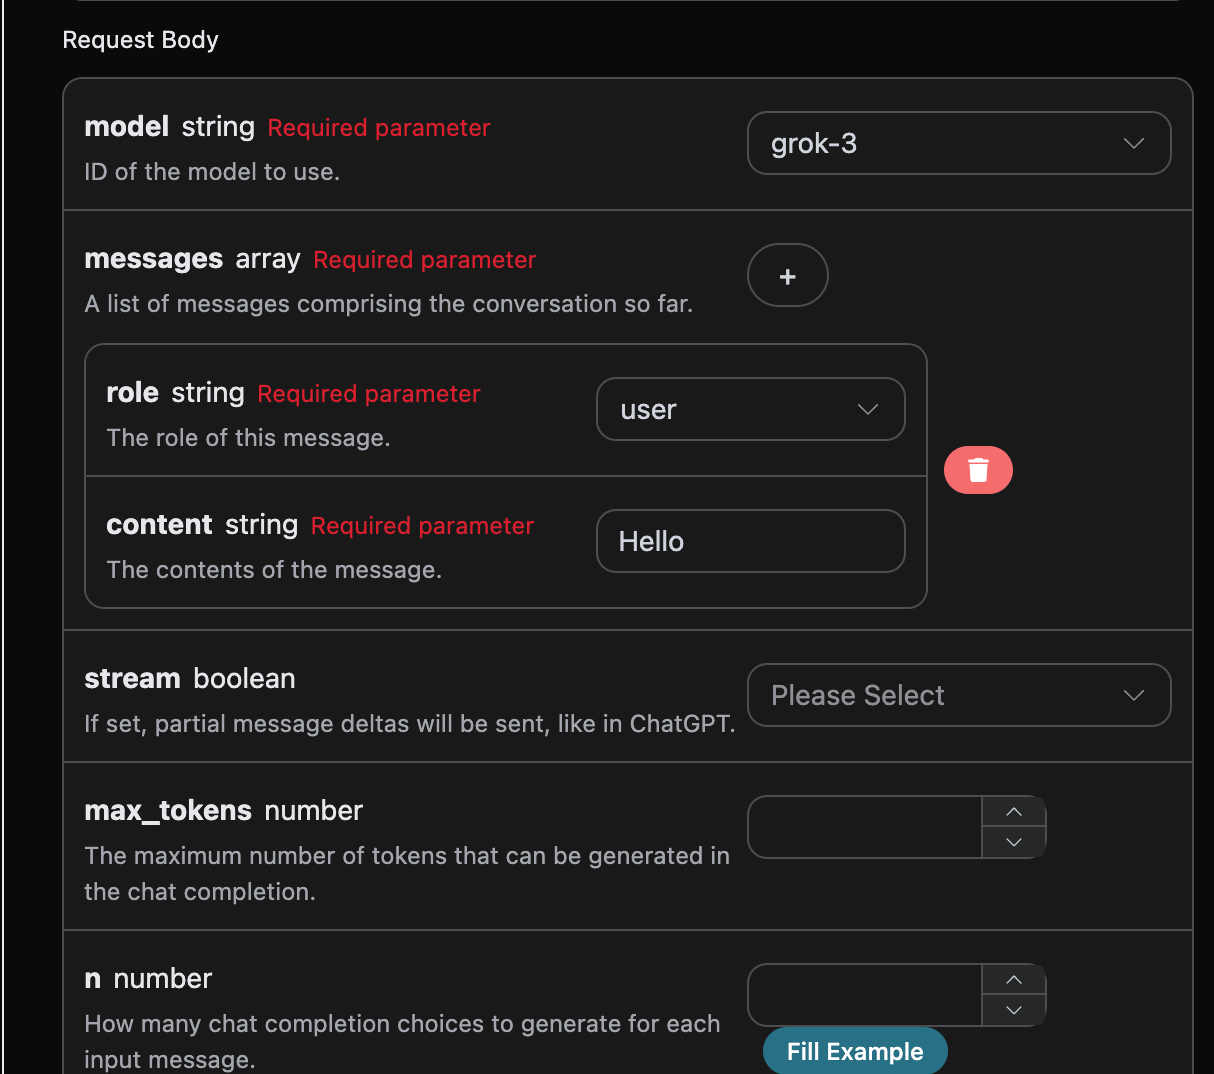
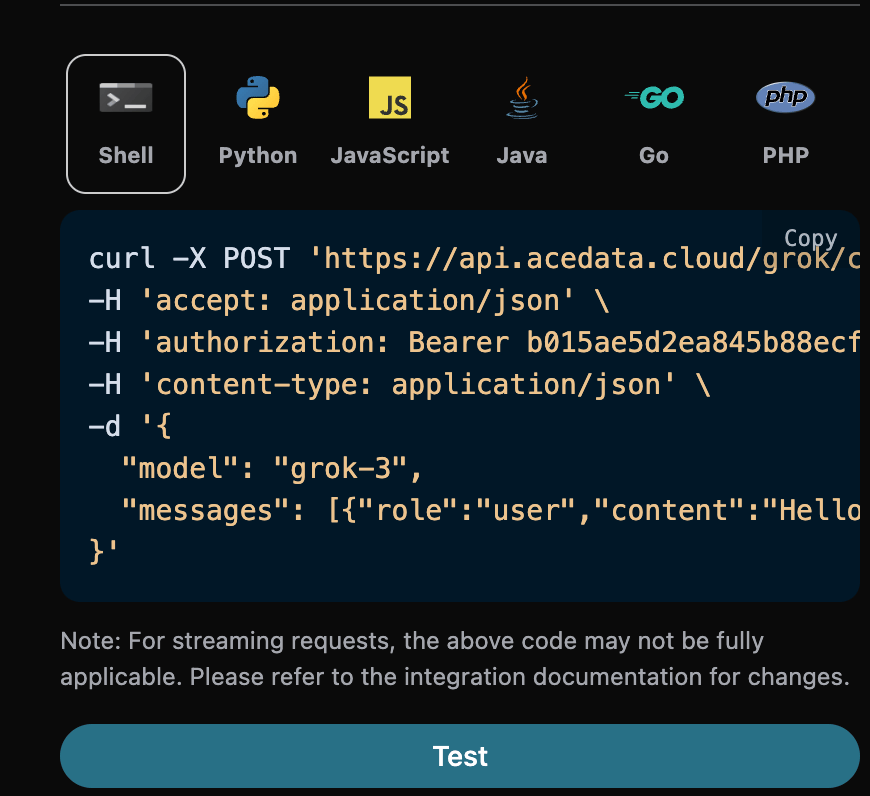
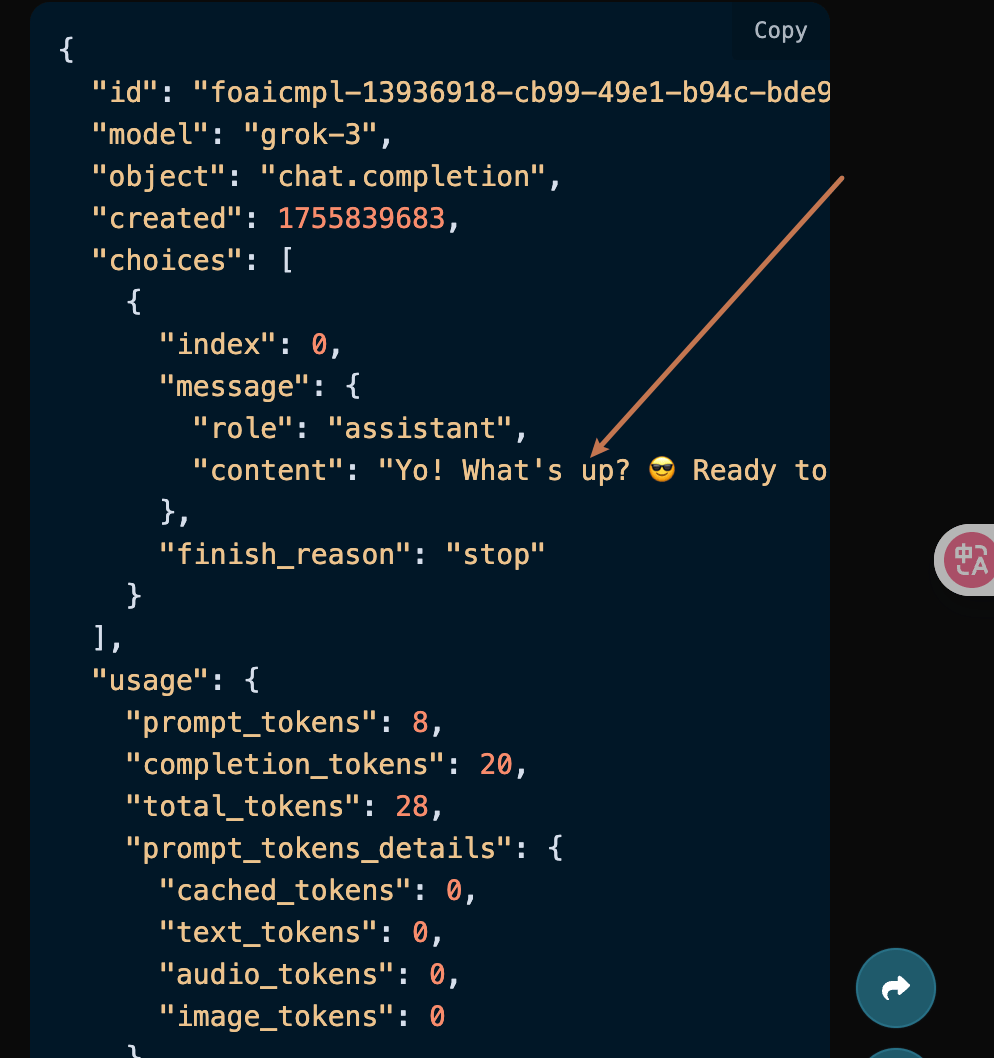
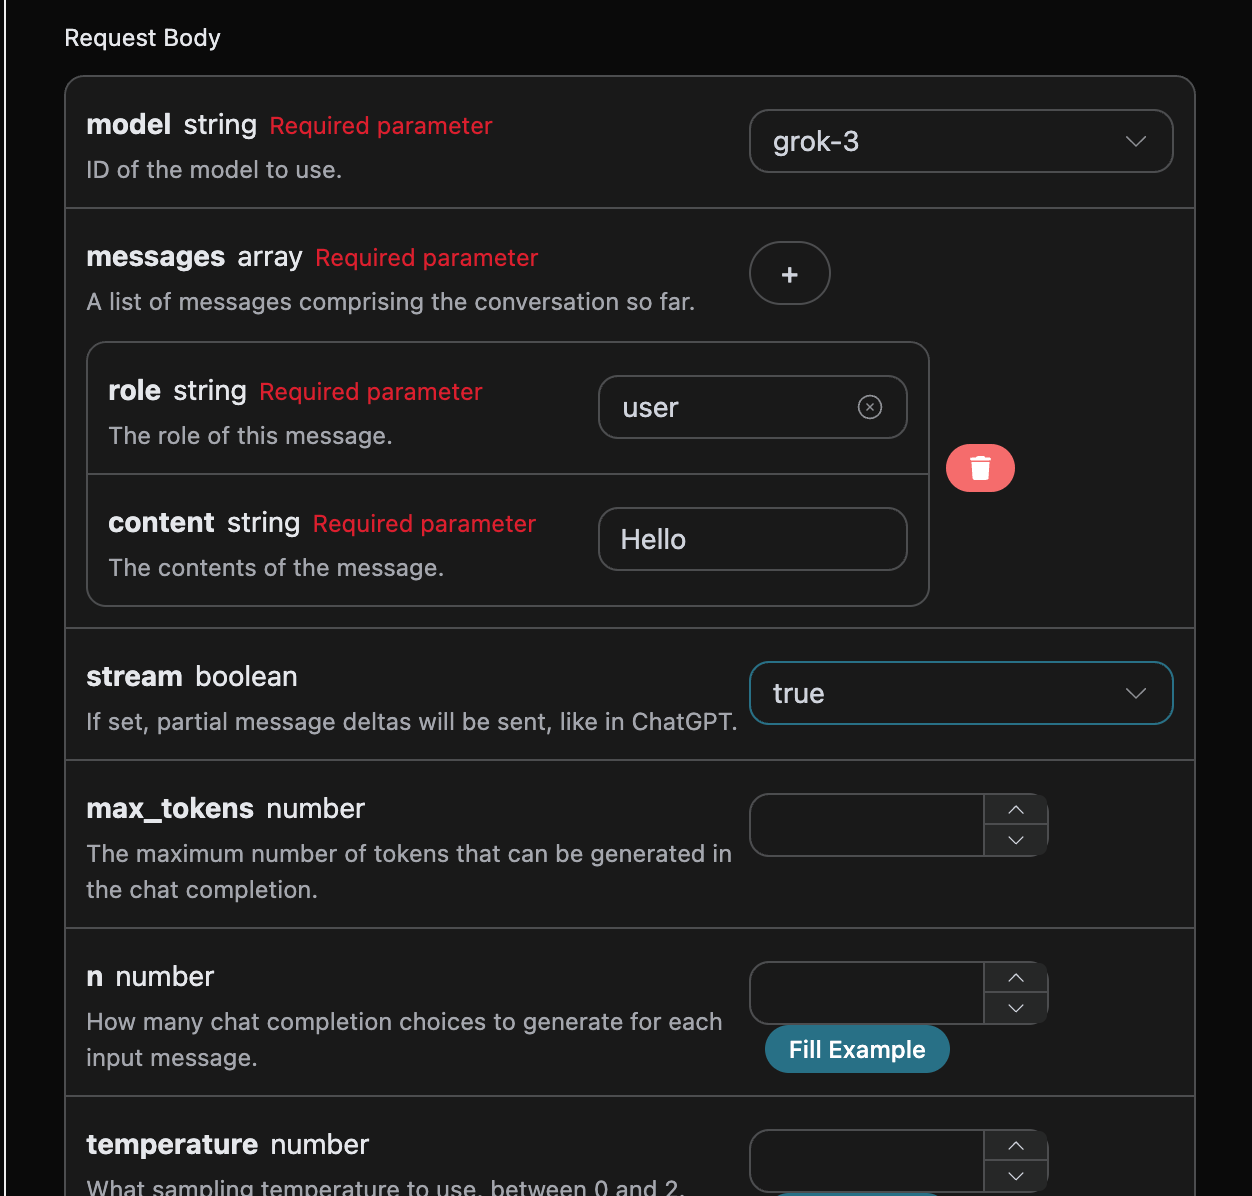
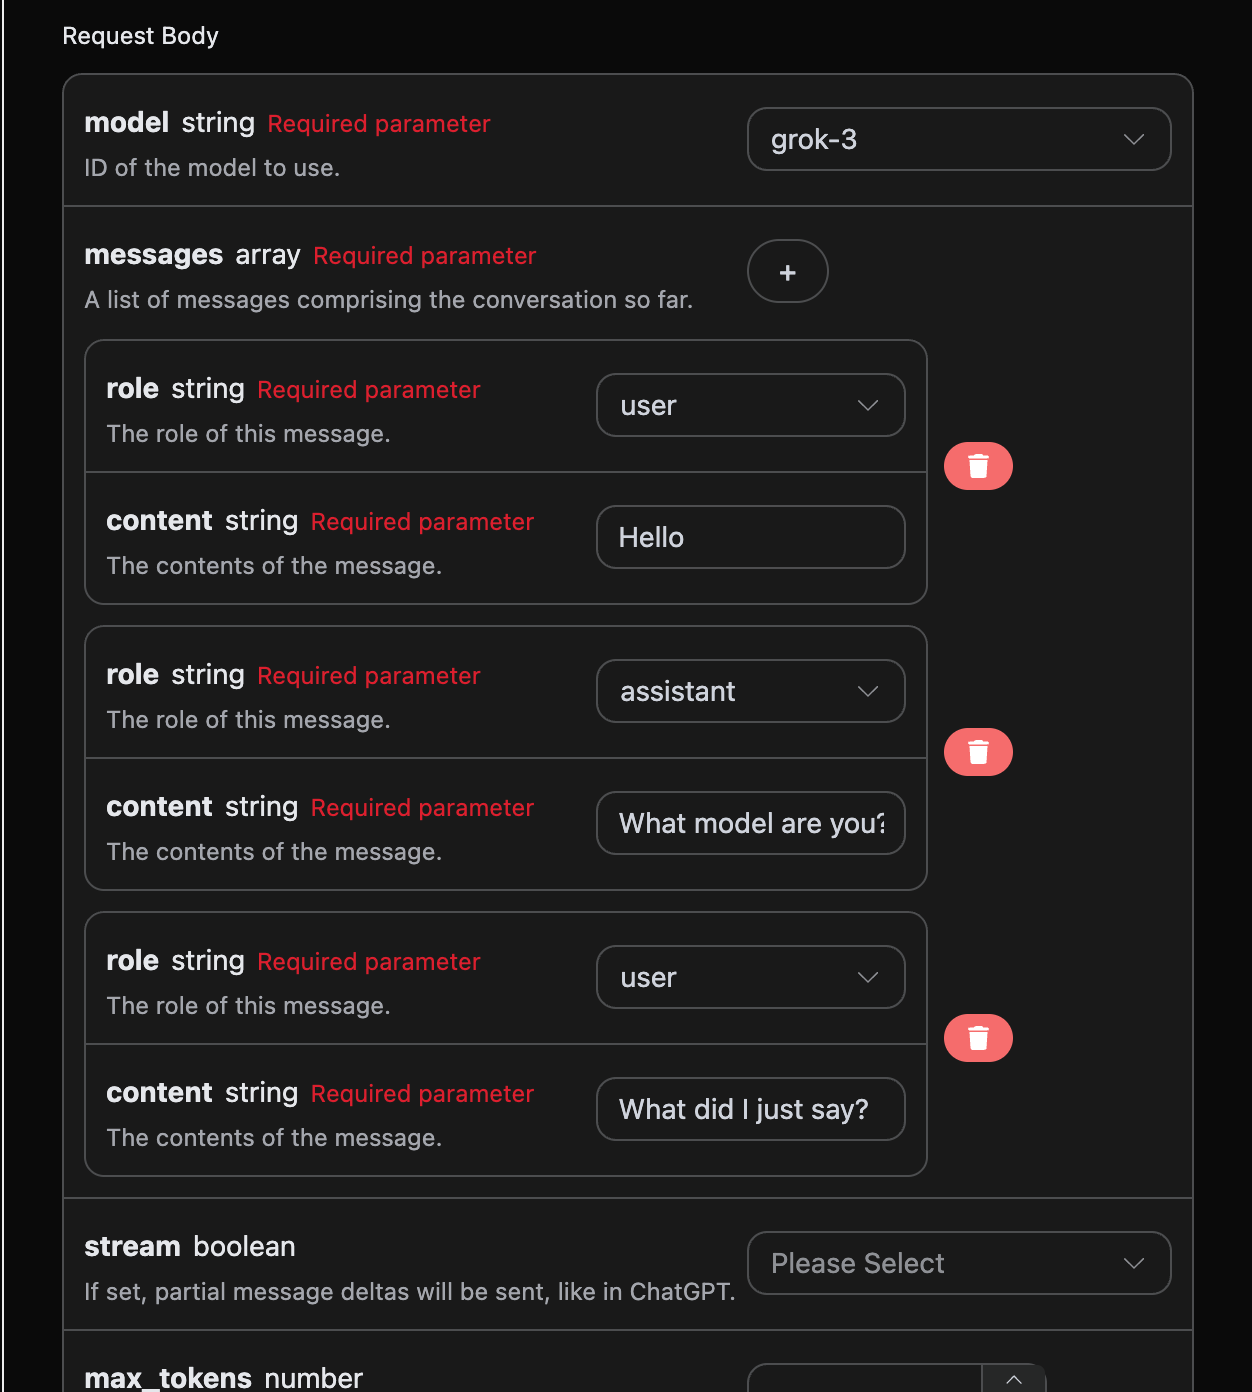
data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"role": "assistant"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "Yo, "}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "quoi"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data:
{"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "'s g"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "ood?"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": " Rea"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "dy t"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "o di"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "ve i"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "nto "}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "quoi"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "que"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": " vous"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "'êtes "}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "pond"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "erin"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "g ab"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "out "}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "aujourd'hui"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "?"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {}, "logprobs": null, "finish_reason": "stop", "index": 0}], "usage": {"prompt_tokens": 0, "completion_tokens": 0, "total_tokens": 0, "prompt_tokens_details": {"cached_tokens": 0, "text_tokens": 0, "audio_tokens": 0, "image_tokens": 0}, "completion_tokens_details": {"text_tokens": 0, "audio_tokens": 0, "reasoning_tokens": 0}, "input_tokens": 0, "output_tokens": 0, "input_tokens_details": null}}

data:
{"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": "", "choices": [], "usage": {"prompt_tokens": 8, "completion_tokens": 18, "total_tokens": 26, "prompt_tokens_details": {"cached_tokens": 0, "text_tokens": 0, "audio_tokens": 0, "image_tokens": 0}, "completion_tokens_details": {"text_tokens": 0, "audio_tokens": 0, "reasoning_tokens": 0}, "input_tokens": 0, "output_tokens": 0, "input_tokens_details": null}}

données: [FAIT]


 Si vous n’êtes pas encore connecté ou inscrit, vous serez automatiquement redirigé vers la page de connexion pour vous inviter à vous inscrire et à vous connecter, après quoi vous serez automatiquement renvoyé à la page actuelle.
Un seul token API suffit pour appeler tous les services de la plateforme, sans avoir besoin de demander séparément pour chaque service. La première demande vous donnera un quota gratuit pour une expérience sans frais ; en cas de quota insuffisant, vous pouvez recharger le solde général sur le tableau de bord.