

GPT-6.1 Sol
Utilisezmodel: "gpt-6.1-sol" pour sélectionner ce modèle. Prend en charge la sortie en streaming, les appels de fonctions, les sorties structurées et les entrées d’images. Au cours de la première semaine d’ouverture, il est disponible uniquement pour les détenteurs vérifiés d’ACE T1+ (au moins 100 000 ACE) ou les utilisateurs autorisés ; l’heure d’ouverture précise dépend de l’invite d’accès dans la console.
Les niveaux de raisonnement pris en charge sont low, medium, high, xhigh et max ; none et minimal ne sont pas encore pris en charge. Il est recommandé de commencer avec reasoning_effort: "low". Lorsque l’entrée dépasse 272 000 tokens, le tarif de long contexte s’applique à l’ensemble de la requête, et les frais sont soumis au tarif actuel de la console.
Processus de demande
Pour utiliser l’API OpenAI Chat Completion, rendez-vous d’abord sur la console Ace Data Cloud pour obtenir votre API Token et le conserver en réserve. Si vous n’êtes pas encore connecté ou inscrit, vous serez automatiquement redirigé vers la page de connexion pour vous inviter à vous inscrire et à vous connecter. Une fois terminé, vous reviendrez automatiquement sur la page actuelle.
Un seul API Token permet d’appeler tous les services de la plateforme, il n’est pas nécessaire de faire une demande séparée pour chaque service. La première demande offre un quota gratuit permettant une expérience gratuite ; lorsque le quota est insuffisant, vous pouvez recharger le solde général dans la console.
📘 Documentation complète : OpenAI Chat Completion API →
Utilisation de base
Ensuite, vous pouvez renseigner le contenu correspondant dans l’interface, comme illustré :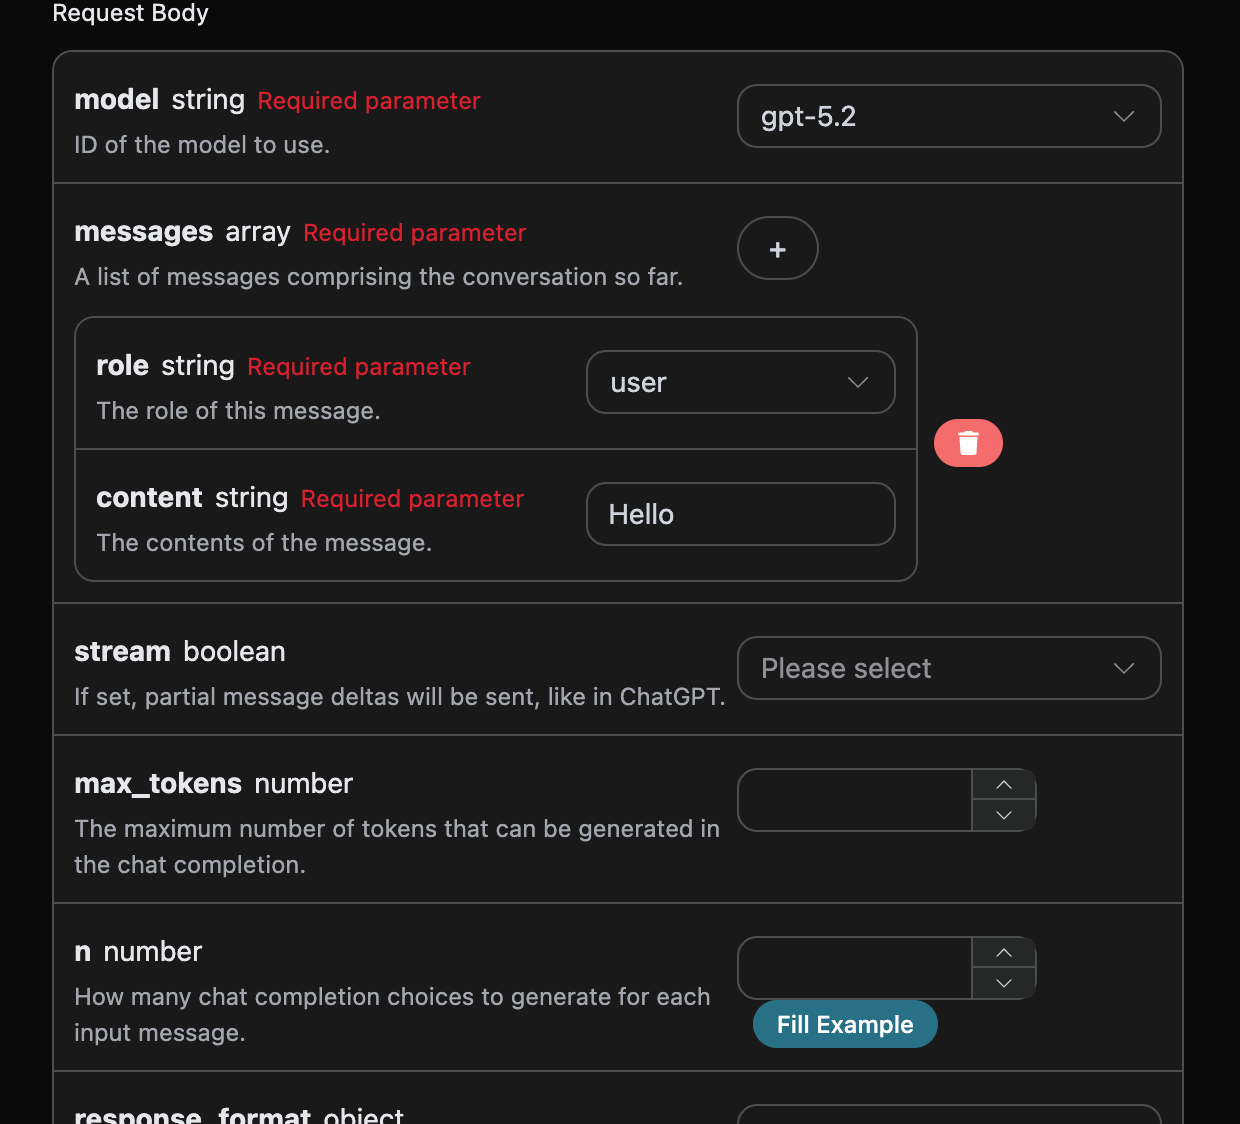
authorization, qui peut être sélectionné directement dans la liste déroulante. Un autre paramètre est model, model correspond à la catégorie de modèle du site officiel OpenAI ChatGPT que nous choisissons d’utiliser. Ici, nous avons principalement 20 modèles, et vous pouvez consulter les modèles que nous fournissons pour plus de détails. Le dernier paramètre est messages, messages est le tableau de prompts que nous saisissons. Il s’agit d’un tableau, ce qui signifie que plusieurs prompts peuvent être envoyés simultanément. Chaque prompt contient role et content, où role représente le rôle de la personne qui pose la question. Nous proposons trois identités : user, assistant et system. L’autre élément, content, est le contenu spécifique de notre question.
En même temps, vous pouvez remarquer qu’un code d’appel correspondant est généré sur la droite. Vous pouvez copier le code et l’exécuter directement, ou cliquer directement sur le bouton « Try » pour effectuer un test.
Paramètres optionnels couramment utilisés :
max_tokens: limite le nombre maximal de tokens dans une seule réponse.temperature: caractère aléatoire de la génération, entre 0 et 2 ; plus la valeur est élevée, plus le résultat est divergent.n: nombre de réponses candidates générées à la fois.response_format: configuration du format de retour.
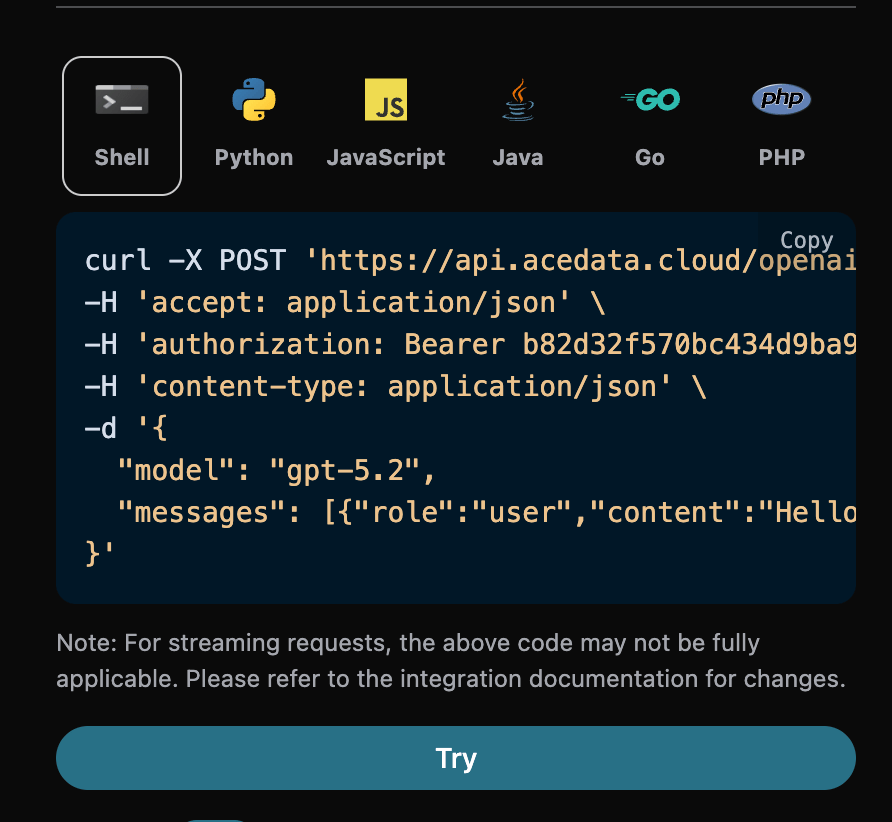
id, l’ID de la tâche de dialogue générée cette fois-ci, utilisé pour identifier de manière unique cette tâche de dialogue.model, le modèle du site officiel OpenAI ChatGPT sélectionné.choices, les informations de réponse fournies par ChatGPT pour le prompt.usage: les informations statistiques sur les tokens pour cette session de questions-réponses.
choices contient les informations de réponse de ChatGPT, et le choices qu’il contient est ChatGPT, comme on peut le voir sur l’illustration.
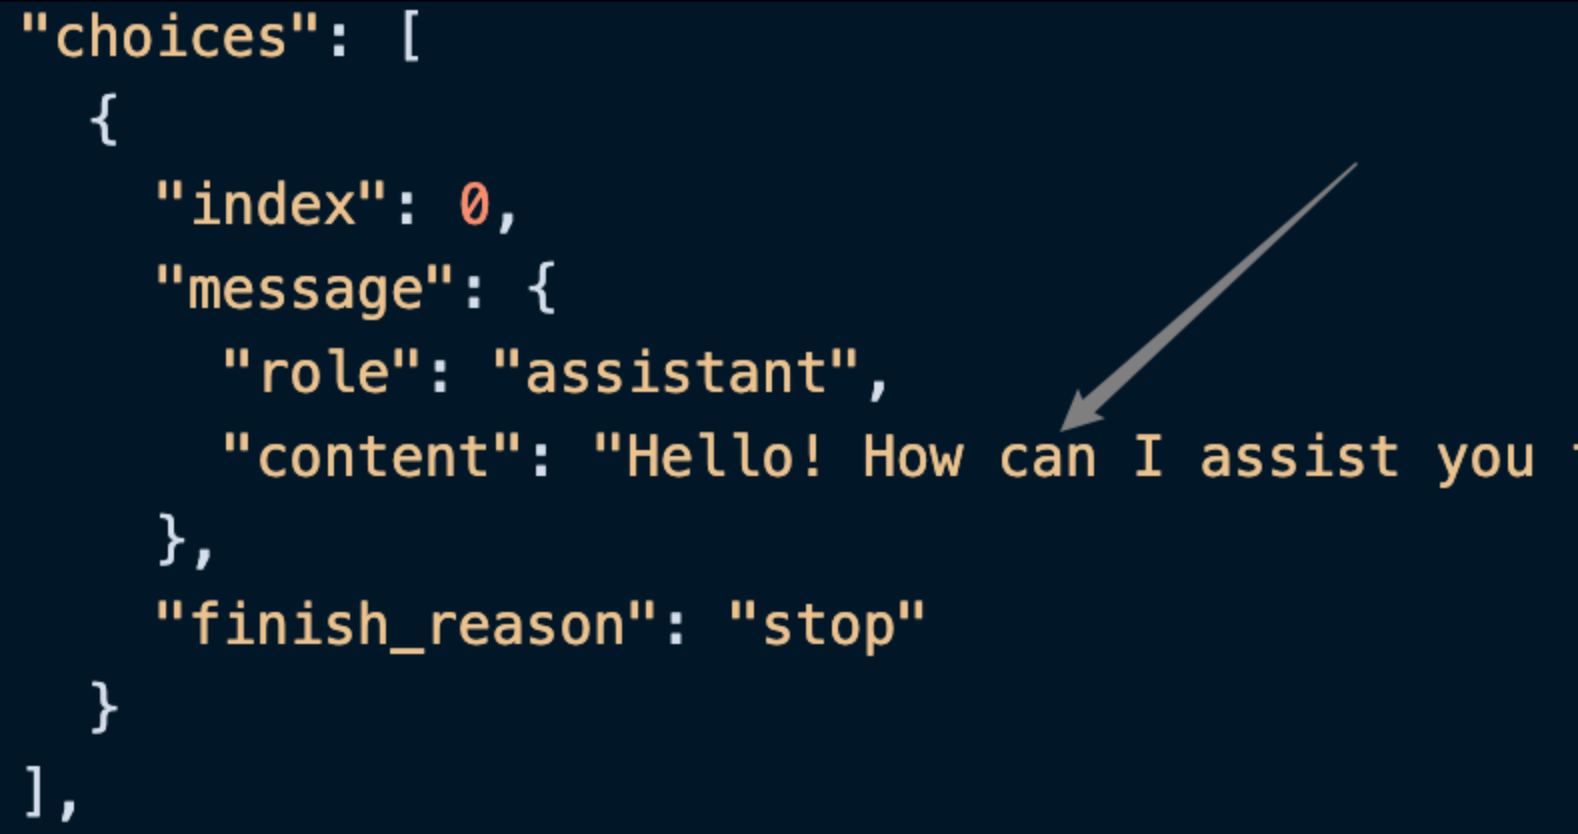
content dans choices contient le contenu spécifique de la réponse de ChatGPT.
Réponse en streaming
Cette interface prend également en charge les réponses en streaming, ce qui est très utile pour l’intégration web et permet à une page web d’obtenir un effet d’affichage caractère par caractère. Si vous souhaitez retourner la réponse en streaming, vous pouvez modifier le paramètrestream dans l’en-tête de la requête, en le définissant sur true.
La modification est illustrée ci-dessous, mais le code d’appel doit être modifié en conséquence pour prendre en charge la réponse en streaming.
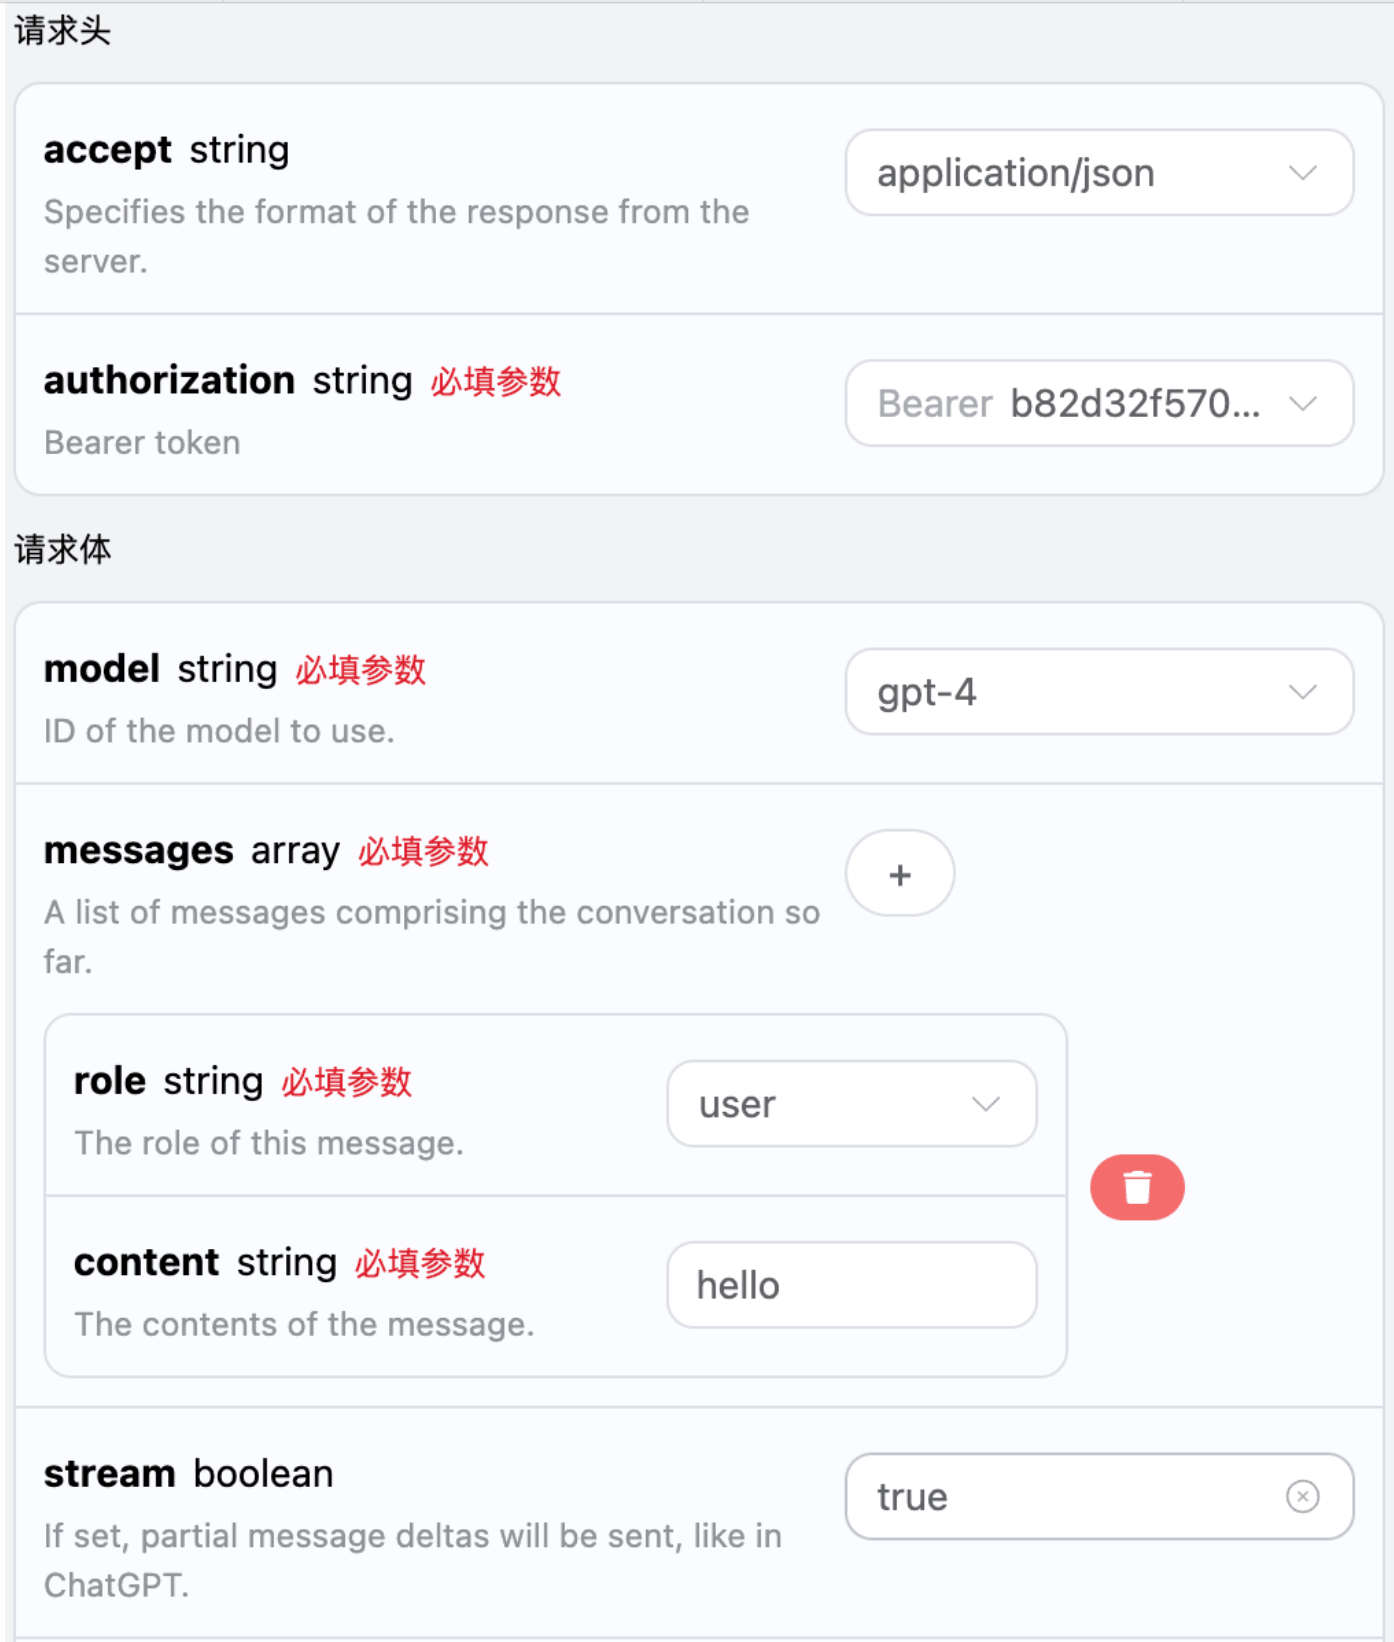
stream en true, l’API retournera les données JSON correspondantes ligne par ligne. Au niveau du code, nous devons effectuer les modifications correspondantes pour obtenir les résultats ligne par ligne.
Exemple de code d’appel Python :
data dans la réponse, et que les choices dans les data constituent le contenu de réponse le plus récent, ce qui est cohérent avec le contenu présenté ci-dessus. Les choices correspondent au nouveau contenu de réponse, vous pouvez les intégrer à votre système selon le résultat. En même temps, la fin de la réponse en flux est déterminée selon le contenu des data : si le contenu est [DONE], cela signifie que la réponse en flux est entièrement terminée. Le résultat data renvoyé comporte plusieurs champs, présentés comme suit :
id, l’ID de la tâche de dialogue générée cette fois, utilisé pour identifier de manière unique cette tâche de dialogue.model, le modèle OpenAI ChatGPT officiel sélectionné.choices, les informations de réponse fournies par ChatGPT pour le mot de question.
Dialogue à plusieurs tours
Si vous souhaitez intégrer la fonctionnalité de dialogue à plusieurs tours, vous devez téléverser plusieurs mots de question dans le champmessages. Un exemple concret de plusieurs mots de question est présenté dans l’image ci-dessous :
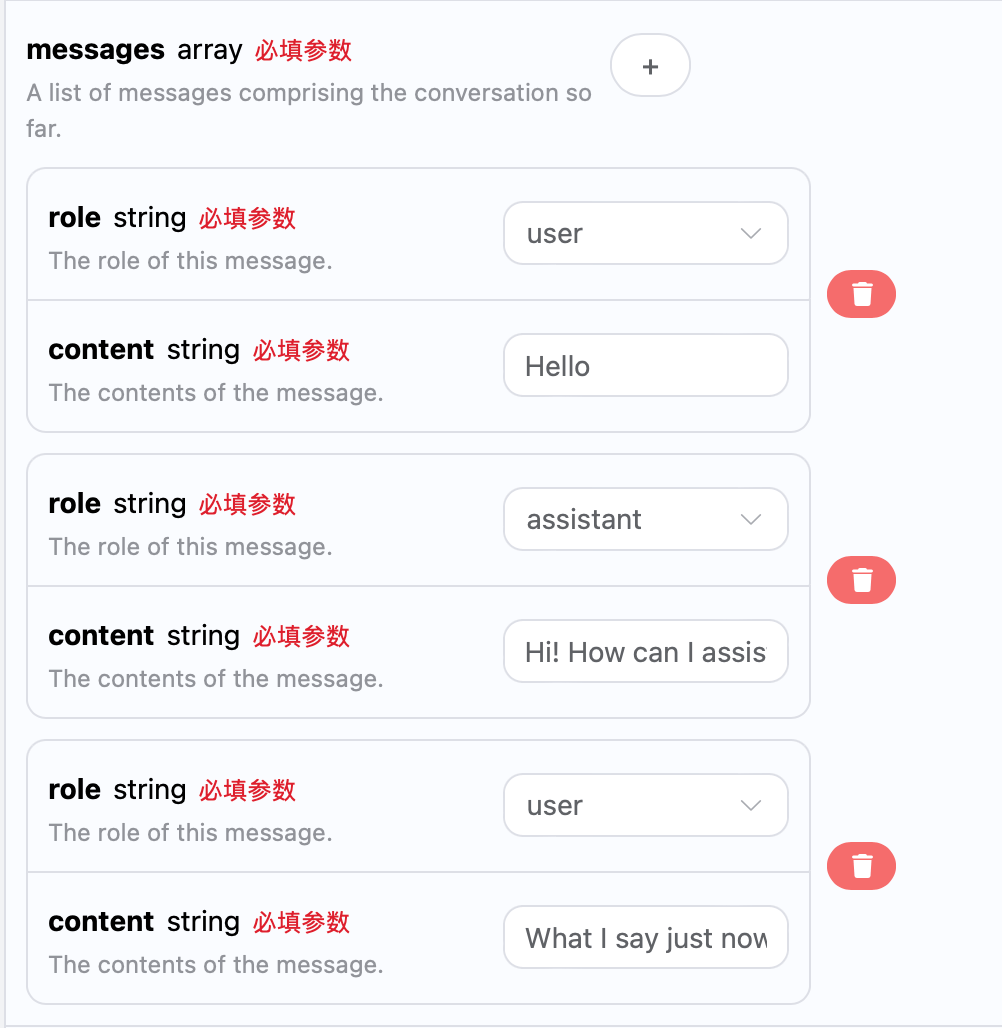
choices sont cohérentes avec le contenu de l’utilisation de base ; cela contient le contenu spécifique de la réponse de ChatGPT à plusieurs conversations, ce qui permet ainsi de répondre aux questions correspondantes en fonction de plusieurs contenus de conversation.
Intégration avec OpenAI-Python
L’API OpenAI Chat Completion reste compatible avec l’interface officielle OpenAI et peut être directement intégrée à l’aide du SDK officiel OpenAI-Python. Cet article présentera brièvement la méthode d’utilisation.- Il faut d’abord mettre en place un environnement
Pythonlocal ; vous pouvez rechercher ce processus sur Google. - Téléchargez et installez un environnement de développement, par exemple l’éditeur VSCode.
- Configurez les variables d’environnement
OpenAI.
- Dans le dossier du projet, créez un fichier nommé
.env, puis enregistrez-le - Contenu du fichier
.env:
sk-xxx par votre propre clé. OPENAI_BASE_URL est l’interface proxy permettant d’accéder à OpenAI.
- Installez les paquets dont le projet dépend
- Créez un fichier de code source d’exemple
index.py, dont le contenu spécifique est le suivant :
Modèles connectés à Internet
Les modèles gpt-3.5-browsing et gpt-4-browsing sont différents des autres modèles : ils peuvent effectuer des recherches sur Internet selon les requêtes et vous renvoyer les résultats de ces recherches après des ajustements appropriés. Cet article présentera la fonctionnalité de connexion à Internet à travers un exemple concret. Vous pouvez ensuite remplir le contenu correspondant dans l’interface OpenAI Chat Completion API, comme illustré ci-dessous :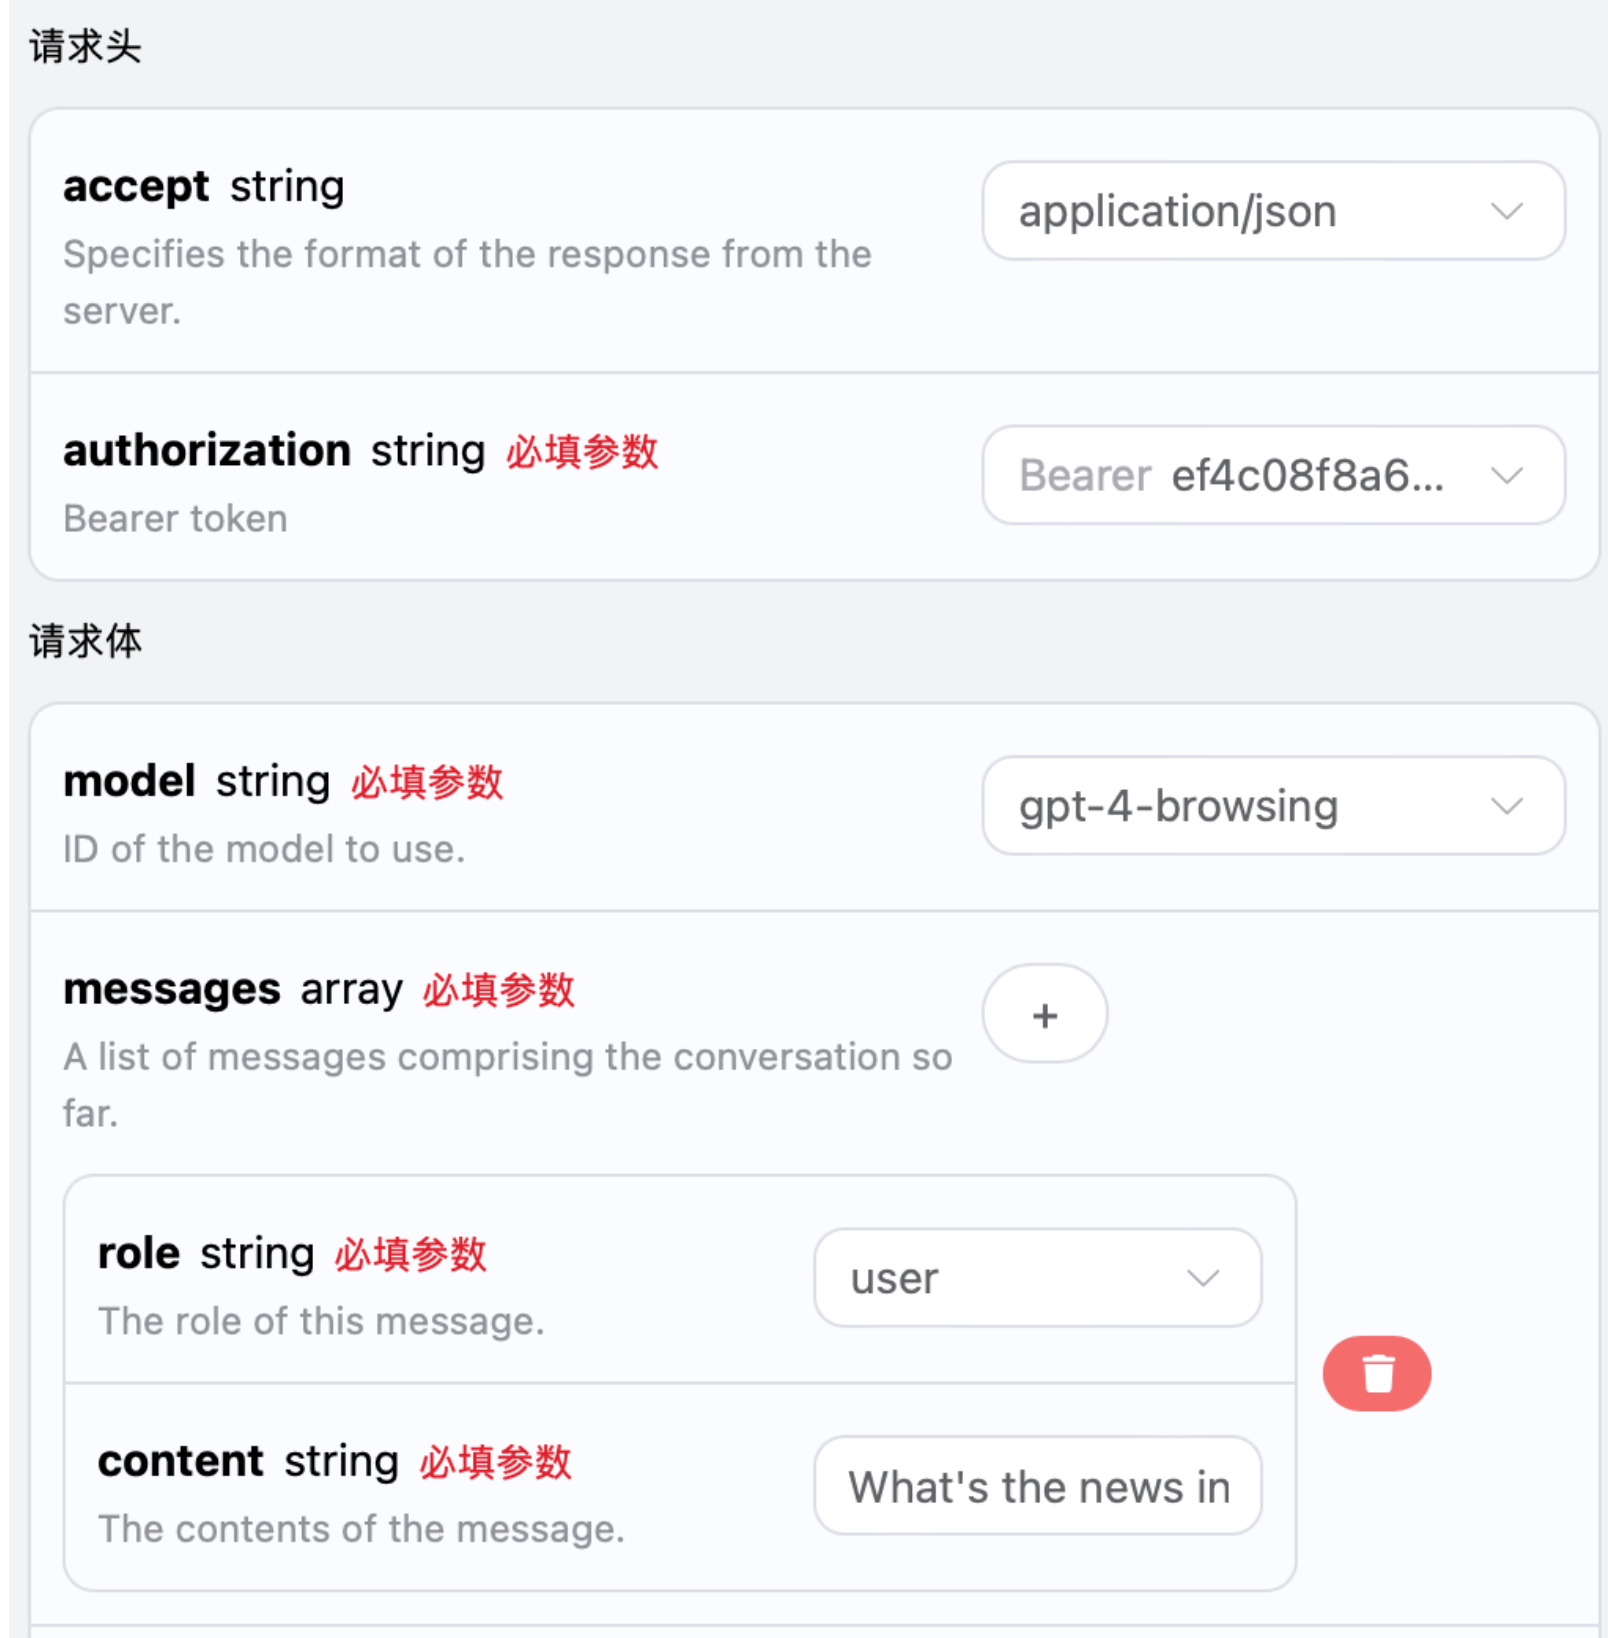
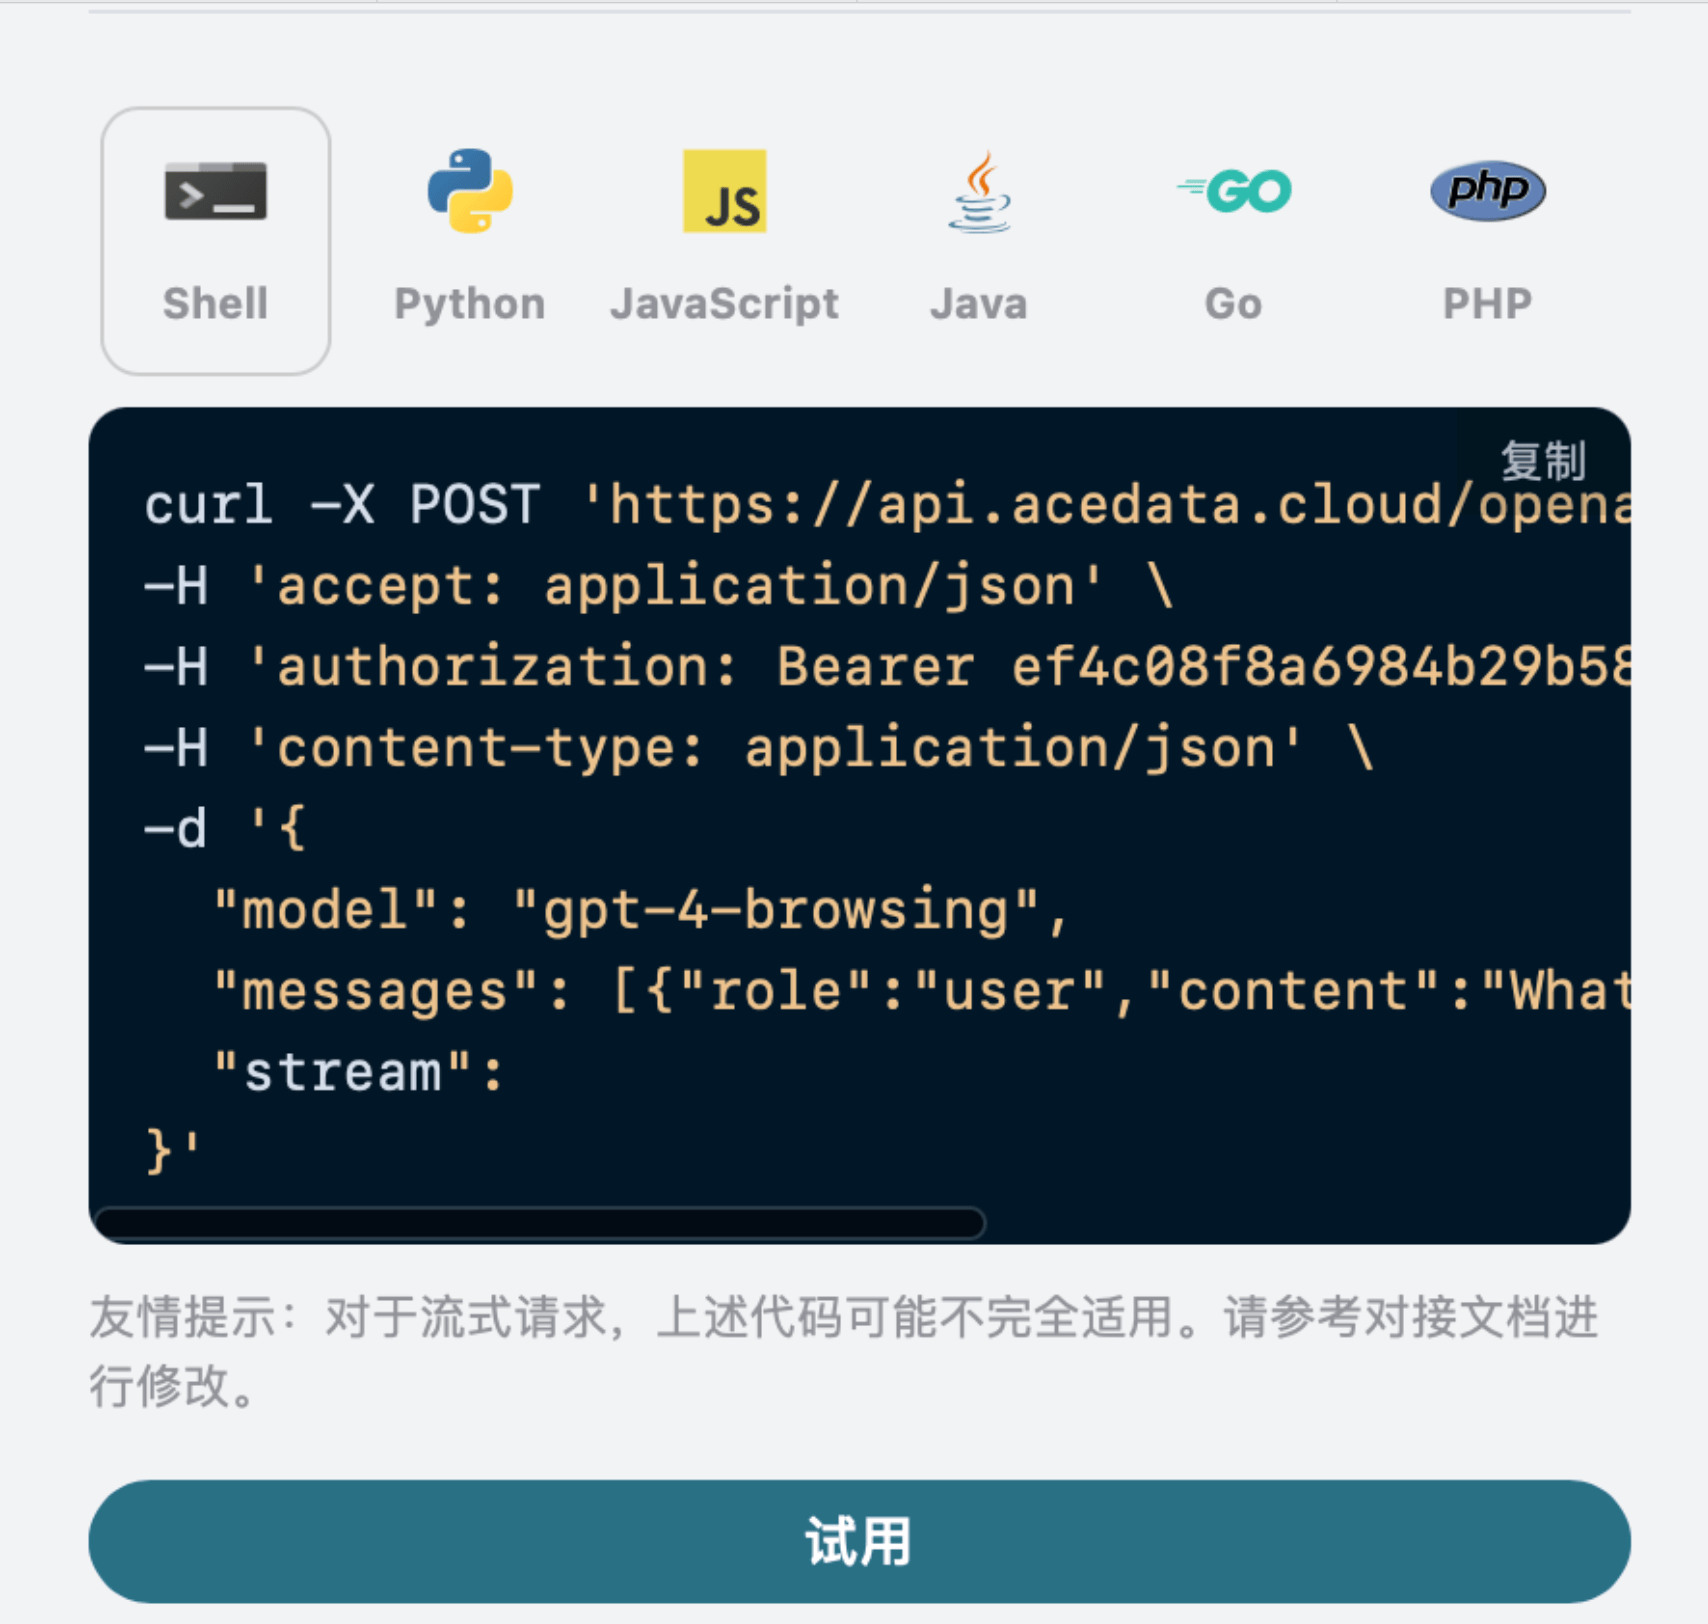
choices sont obtenues après une recherche sur Internet, et que des liens associés sont également fournis. Les informations de réponse dans choices doivent être rendues à l’aide de la syntaxe markdown afin d’obtenir la meilleure expérience ; cela reflète également le puissant avantage de la fonctionnalité de connexion à Internet de notre modèle.
Modèle visuel
gpt-4o est un grand modèle de langage multimodal développé par OpenAI ; il ajoute des capacités de compréhension visuelle sur la base de GPT-4. Ce modèle peut traiter simultanément des entrées de texte et d’images, permettant une compréhension et une génération multimodales. Le traitement de texte avec le modèle gpt-4o est cohérent avec le contenu de l’utilisation de base présenté ci-dessus. Nous allons brièvement présenter ci-dessous comment utiliser les capacités de traitement d’images du modèle. L’utilisation des capacités de traitement d’images du modèle gpt-4o consiste principalement à ajouter un champtype sur la base du contenu content existant. Grâce à ce champ, il est possible de savoir si le contenu téléchargé est du texte ou une image, afin d’utiliser les capacités de traitement d’images du modèle gpt-4o. Nous présenterons principalement ci-dessous l’appel de cette fonctionnalité de deux manières : Curl et Python.
- Méthode par script Curl
- Méthode par script Python
Modèle de dessin GPT-4o
Génération d’images à partir d’une image de référence
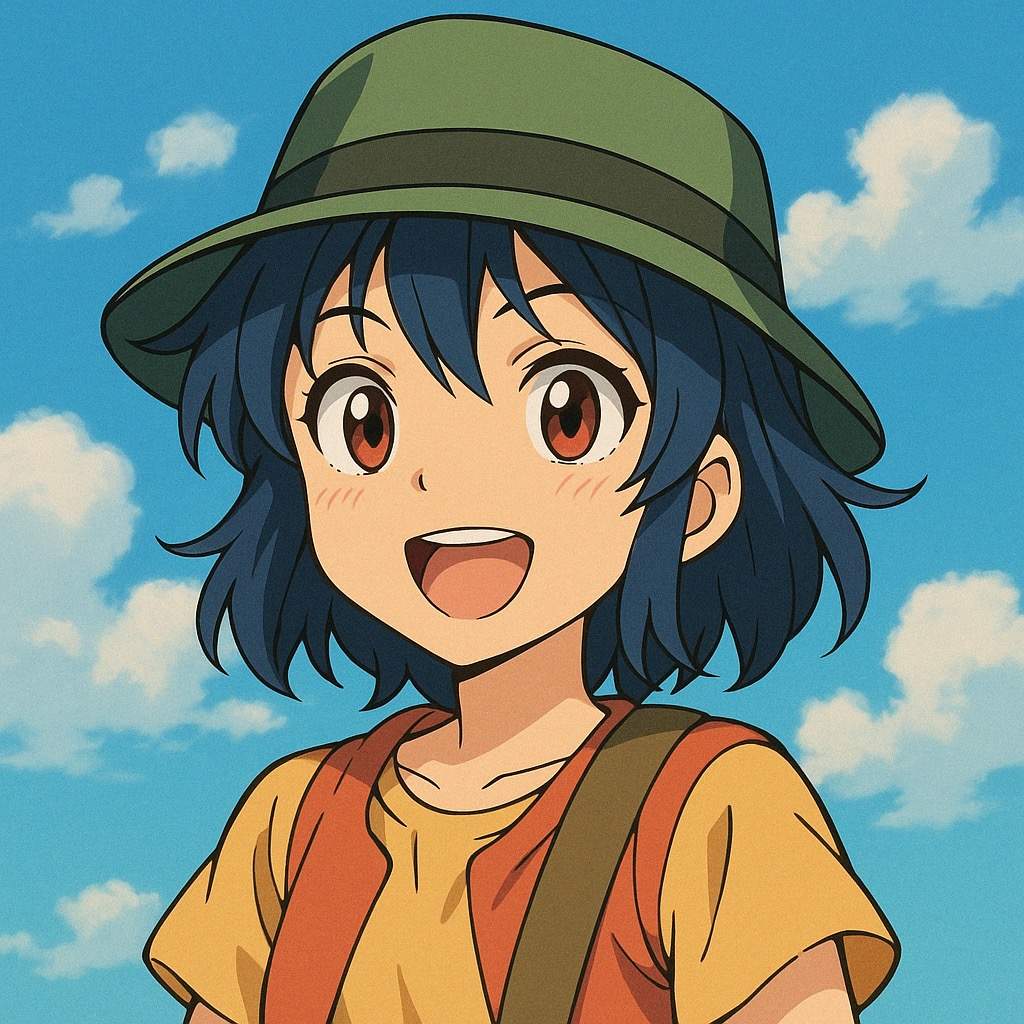
Voici un exemple de génération d’une image de style personnalisé à partir d’une image. Tout d’abord, regardons l’image que nous avons saisie, comme illustré ci-dessous :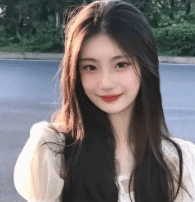 Vous pouvez voir que l’image de référence est une image d’une personne réelle. Nous pouvons lui faire changer de style, par exemple en la transformant en image de style anime. Voici un exemple de requête concret :
message.content dans choices est le résultat complet de la conversation générée. L’image y est incluse au format Markdown (le lien de l’image est une adresse temporaire, veuillez la télécharger et l’enregistrer à temps). Vous pouvez voir que l’image générée est effectivement de style anime, comme illustré ci-dessous :
Génération d’images à partir de texte uniquement
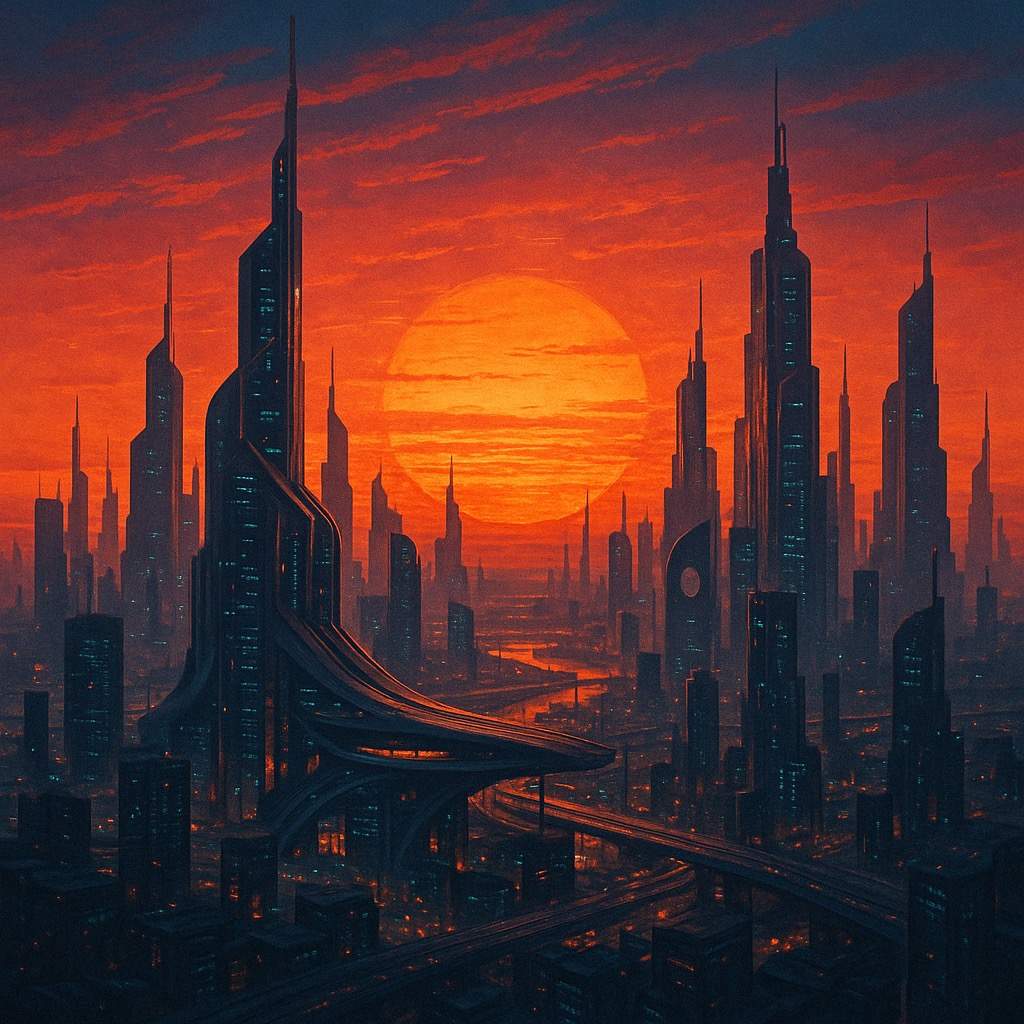
Nous pouvons utiliser une invite pour lui faire générer une image et nous la renvoyer sous la forme d’un résultat conversationnel. Ci-dessous, nous prenons创建一张未来城市日落的图片 comme exemple, voici l’exemple concret :
Génération d’une image à partir de plusieurs images
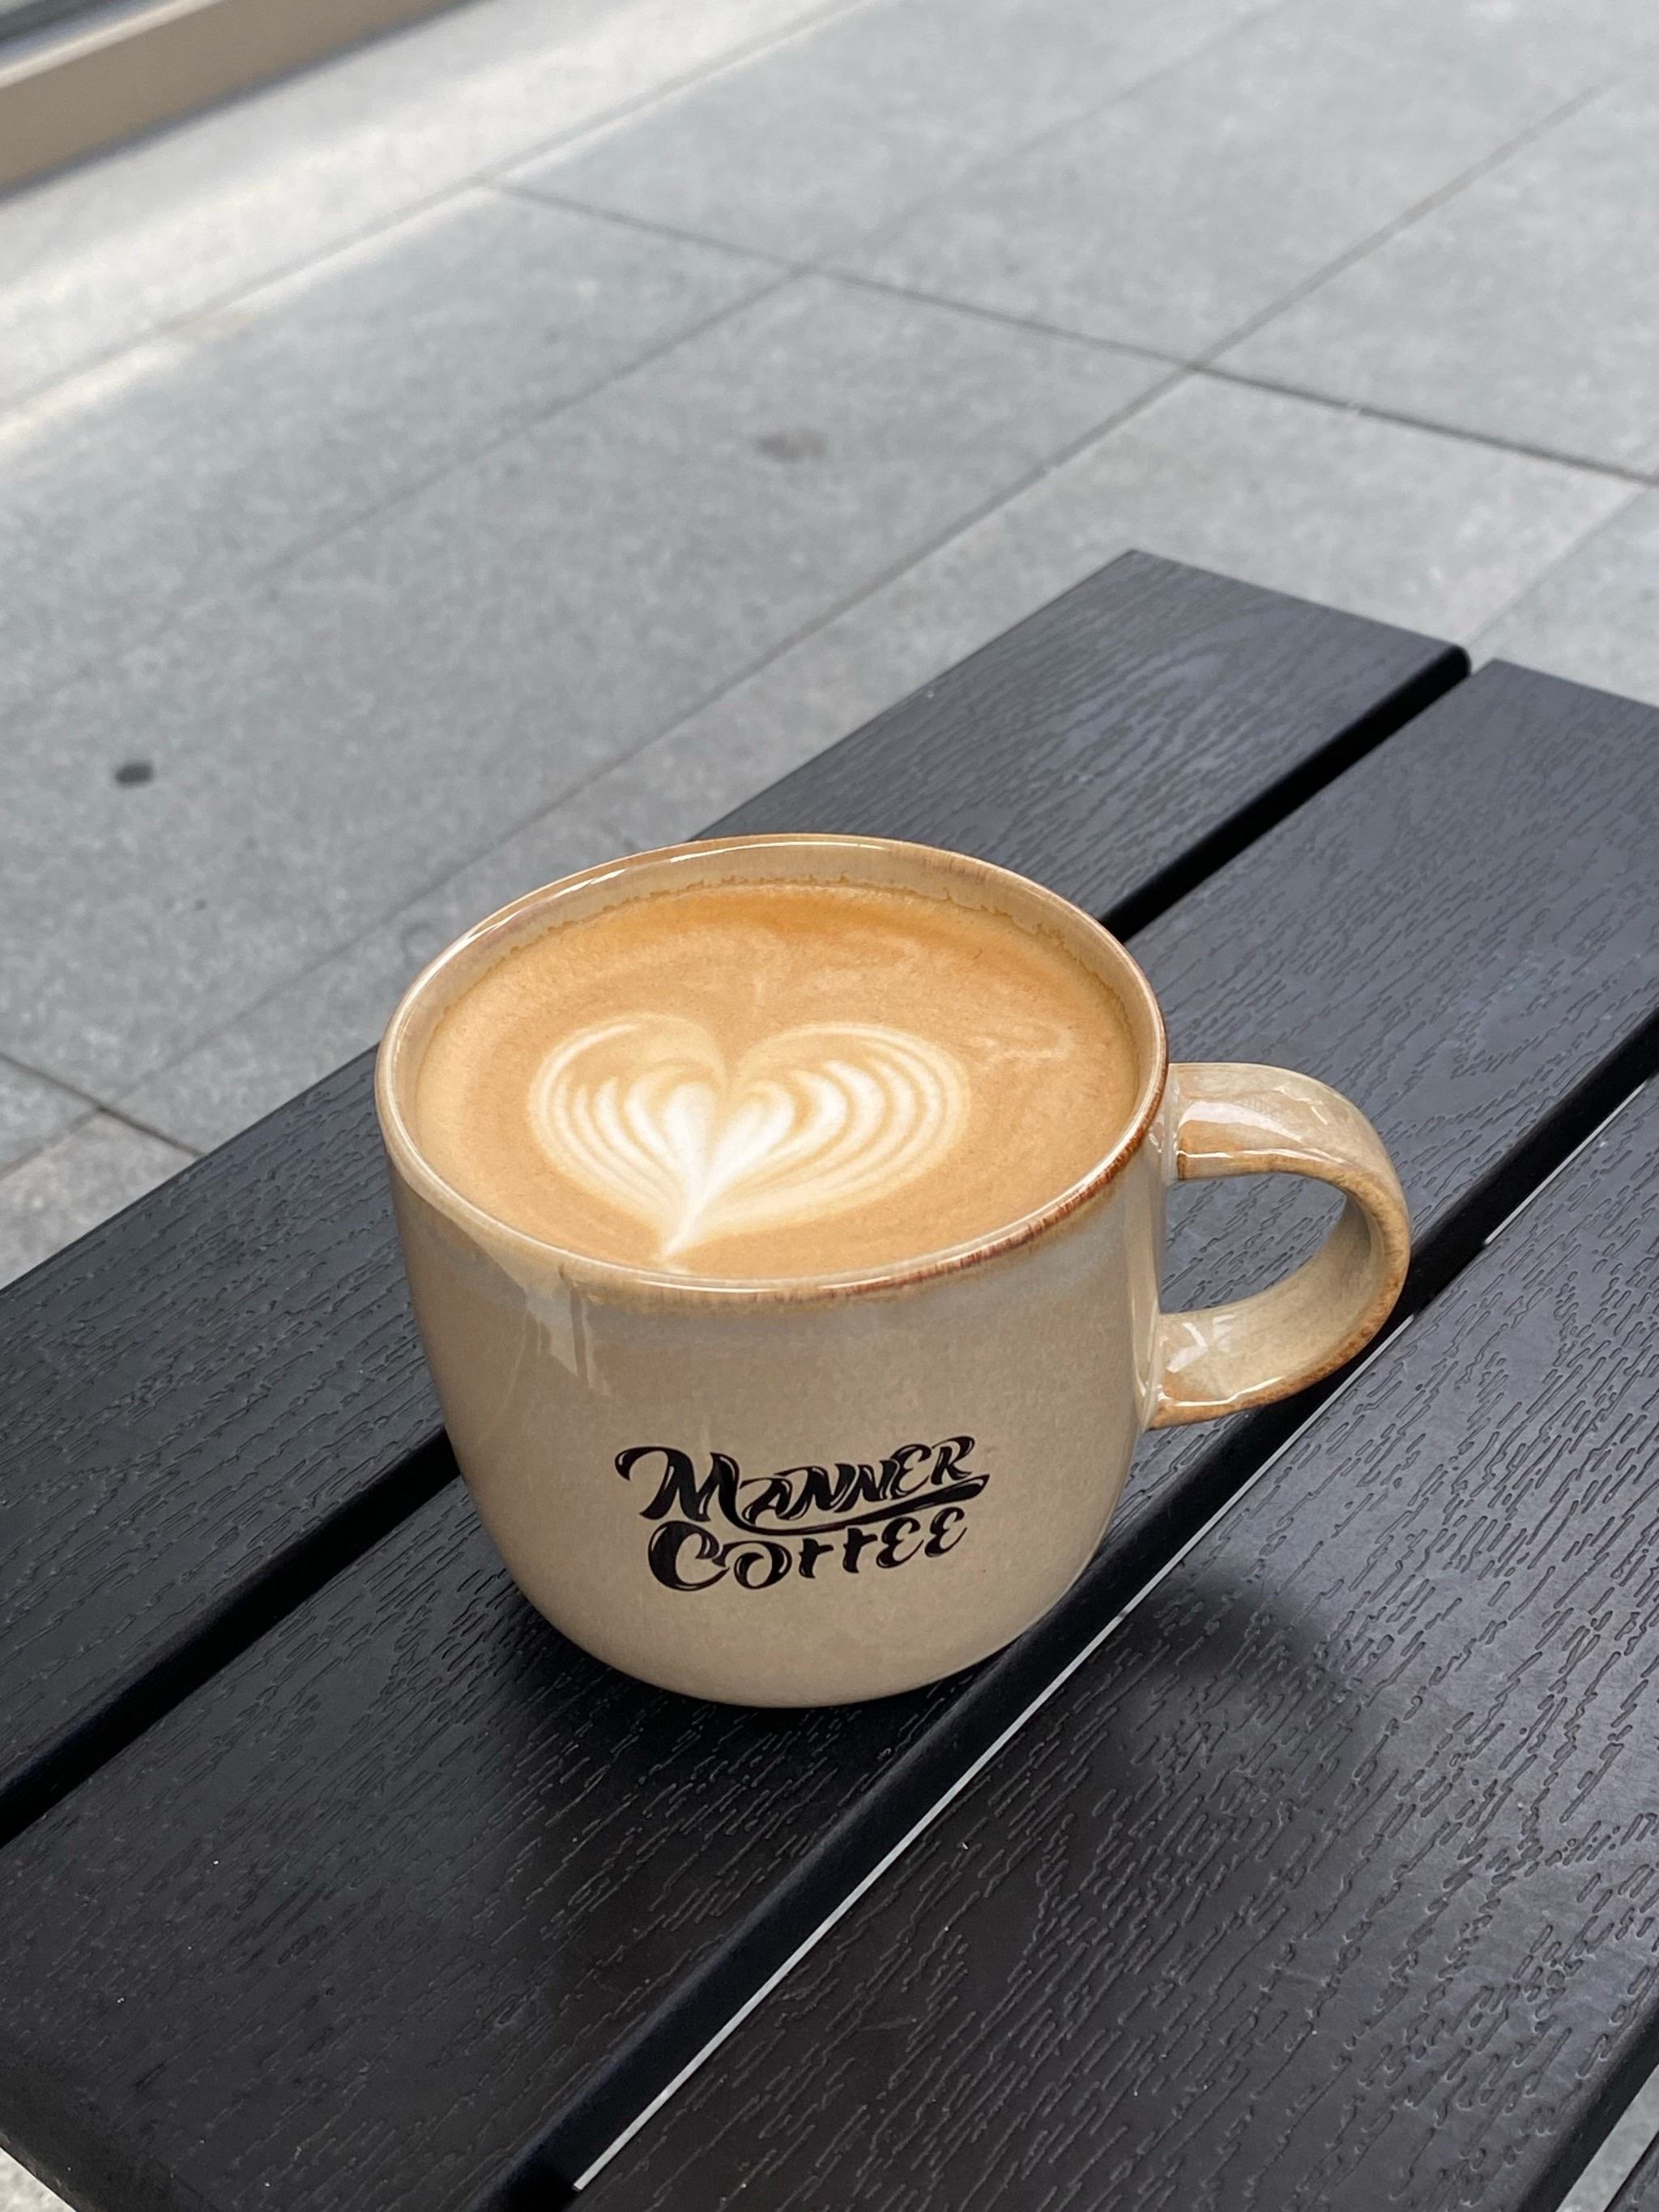
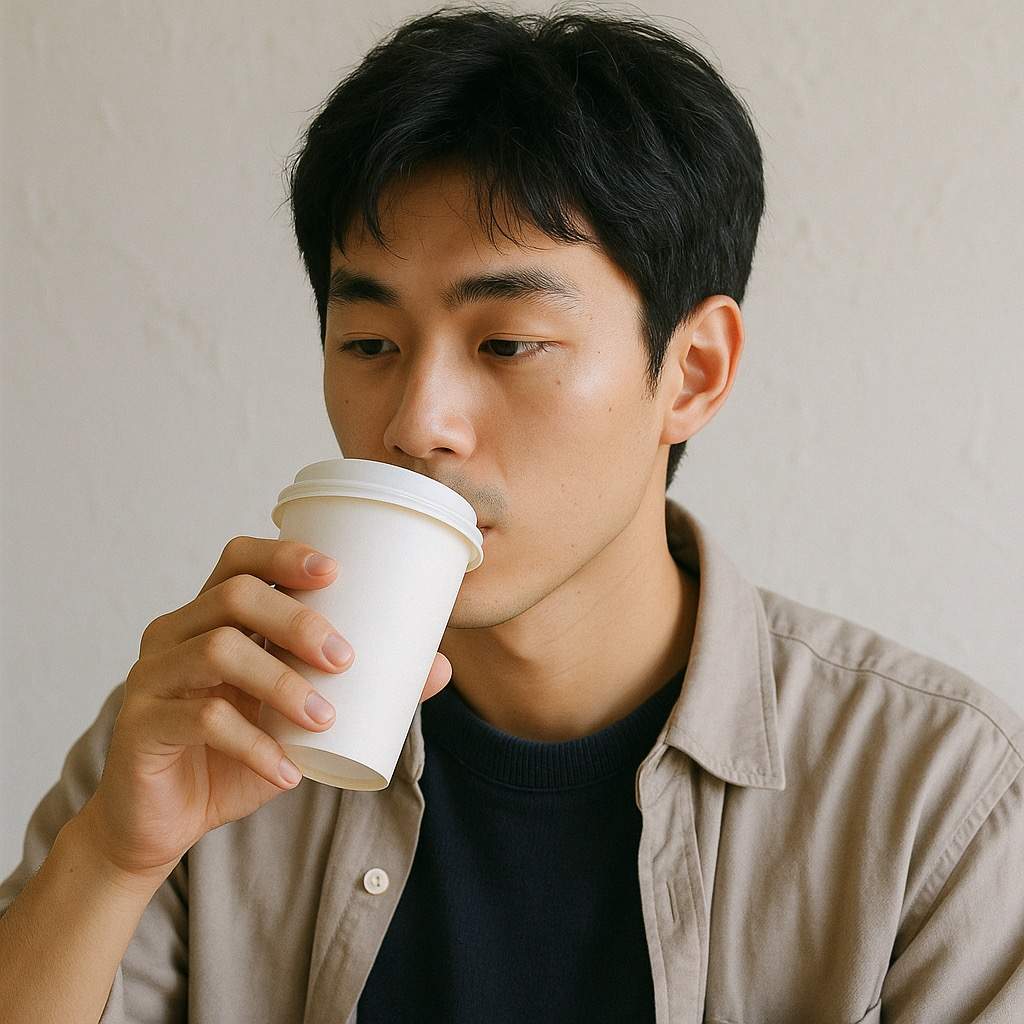
Nous pouvons également utiliser plusieurs images de référence pour générer une image. Par exemple, en utilisant une image d’un beau garçon et une image de café, ces deux images peuvent servir à générer une image d’un beau garçon buvant du café. Voici les images de référence concrètes :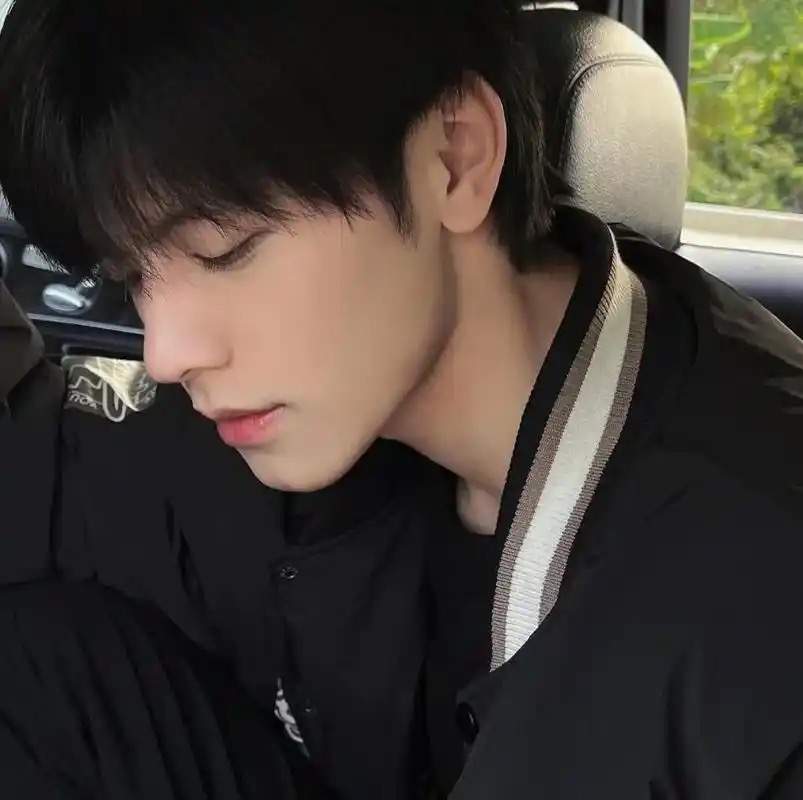
生成男生举着咖啡,并且马上要喝的样子 comme exemple, voici l’exemple concret :
Gestion des erreurs
Lors de l’appel de l’API, si une erreur survient, l’API renverra le code d’erreur et les informations correspondantes. Par exemple :400 token_mismatched: Mauvaise requête, probablement en raison de paramètres manquants ou non valides.400 api_not_implemented: Mauvaise requête, probablement en raison de paramètres manquants ou non valides.401 invalid_token: Non autorisé, jeton d’autorisation non valide ou manquant.429 too_many_requests: Trop de requêtes, vous avez dépassé la limite de débit.500 api_error: Erreur interne du serveur, quelque chose s’est mal passé sur le serveur.