

content do tworzenia zadań.
Proces uzyskania dostępu
Aby używać API generowania wideo MiniMax H3, najpierw przejdź do konsoli Ace Data Cloud, aby uzyskać swój API Token, i zachowaj go do późniejszego użycia. Jeśli nie jesteś jeszcze zalogowany ani zarejestrowany, nastąpi automatyczne przekierowanie na stronę logowania z zaproszeniem do rejestracji i logowania, a po ukończeniu automatycznie wrócisz na bieżącą stronę.
Jeden API Token umożliwia wywoływanie wszystkich usług platformy, bez konieczności osobnego składania wniosku dla każdej usługi. Pierwsze uzyskanie dostępu obejmuje bezpłatny limit, umożliwiający darmowe testowanie; gdy limit będzie niewystarczający, możesz doładować wspólne saldo w konsoli.
📘 Pełna dokumentacja: API generowania wideo MiniMax H3 →Zaleca się zapisanie Tokena jako zmiennej środowiskowej, bez umieszczania go w kodzie źródłowym ani przesyłania do repozytorium wersji:
Przegląd interfejsu
- Base URL:
https://api.acedata.cloud - Endpoint:
POST /minimax/videos - Metoda uwierzytelniania:w HTTP Header należy przekazać
authorization: Bearer {token} - Nagłówki żądania:
accept: application/jsoncontent-type: application/json
- Model(model):
MiniMax-H3 - Struktura wejściowa:tekst, obrazy, wideo i audio są przekazywane jednolicie przez
content - Tryb wyjściowy:domyślnie synchronicznie oczekuje na ukończenie generowania i zwraca pełny
task; po przekazaniuasync: truelubcallback_urlnatychmiast zwracatask_idoraztrace_id - Zapytanie o wynik:status i gotowy materiał można uzyskać przez API zapytań o zadania MiniMax H3
- Asynchroniczne callbacki:opcjonalne, odbieranie końcowego wyniku zadania przez
callback_url
action, aby wybrać tryb generowania; interfejs automatycznie określi zastosowanie na podstawie typu materiałów i role w content.
Do jakich scenariuszy się nadaje
Proces wywołania
Gdy domyślnie nie zostanie przekazaneasync, /minimax/videos będzie oczekiwać na ukończenie generowania i bezpośrednio zwróci pełny task. Aby natychmiast zwolnić połączenie, przekaż async: true lub callback_url:
- Zapisz
task_iditrace_idz natychmiastowej odpowiedzi. - Gdy callback nie jest skonfigurowany, wywołuj
/minimax/tasksmniej więcej co 10 sekund. - Gdy
task.statuszmieni się nasucceeded, pobierz wideo ztask.content.url. - Gdy status wynosi
failedlubcancelled, zatrzymaj odpytywanie i odczytajtask.error.
Parametry żądania najwyższego poziomu
Reguły
ratio zależą od workflow:
- Generowanie wideo z tekstu:wymagane i nie może mieć wartości
adaptive. - Wideo z pierwszą klatką, ostatnią klatką lub pierwszą i ostatnią klatką:format kadru jest określany przez obrazy wejściowe; zaleca się pominięcie parametru lub przekazanie
adaptive. - Generowanie wideo z referencjami multimodalnymi:można pominąć, domyślnie
adaptive; można również jawnie określić stałe proporcje.
prompt, image_urls, audio_urls, messages i first_frame_image. W przypadku otrzymania błędu dotyczącego takich parametrów usuń stare pola i przejdź na content; na przykład zmień "prompt": "Kot macha łapą" na "content": [{"type": "text", "text": "Kot macha łapą"}]. Nie wysyłaj jednocześnie obu formatów, nowego i starego.
Parametry elementów treści content
Każdy element treści musi miećtype, a pozostałe pola są określane przez typ:
Adresy mediów obsługują trzy formy:
- Publicznie dostępny HTTPS URL, zalecany dla dużych plików.
mm_file://{file_id}, odwołanie do przesłanego już lub istniejącego pliku wynikowego.- Base64 data URI odpowiedniego typu mediów. Base64 zwiększa rozmiar o około jedną trzecią; upewnij się, że całe ciało żądania nie przekracza 64 MB.
Specyfikacje materiałów i limity ilościowe
Łącznie obrazy, wideo i audio w scenariuszu referencji multimodalnych mogą obejmować maksymalnie 12 plików. Scenariusz pierwszej i ostatniej klatki oraz scenariusz materiałów referencyjnych wzajemnie się wykluczają: po użyciu
reference_image, reference_video lub reference_audio nie można już używać first_frame ani last_frame, i odwrotnie.
Prezentacja możliwości klasy produkcyjnej
Poniżej nie znajdują się grafiki koncepcyjne ani materiały zastępcze, lecz rzeczywiste wejścia referencyjne i faktyczne wyjścia wideo oficjalnych próbek możliwości klasy produkcyjnej MiniMax H3. Trzy zestawy przykładów obejmują odpowiednio filmy brandingowe, narrację z udziałem prawdziwych osób oraz modowy e-commerce i nadają się do oceny najważniejszych możliwości modelu w produkcji komercyjnej.
„Możliwości twarzy” oznaczają tutaj spójność wyglądu postaci, szczegóły twarzy i kontrolę ekspresji w generowaniu wideo, a nie rozpoznawanie tożsamości, porównywanie twarzy ani interfejs zamiany twarzy.
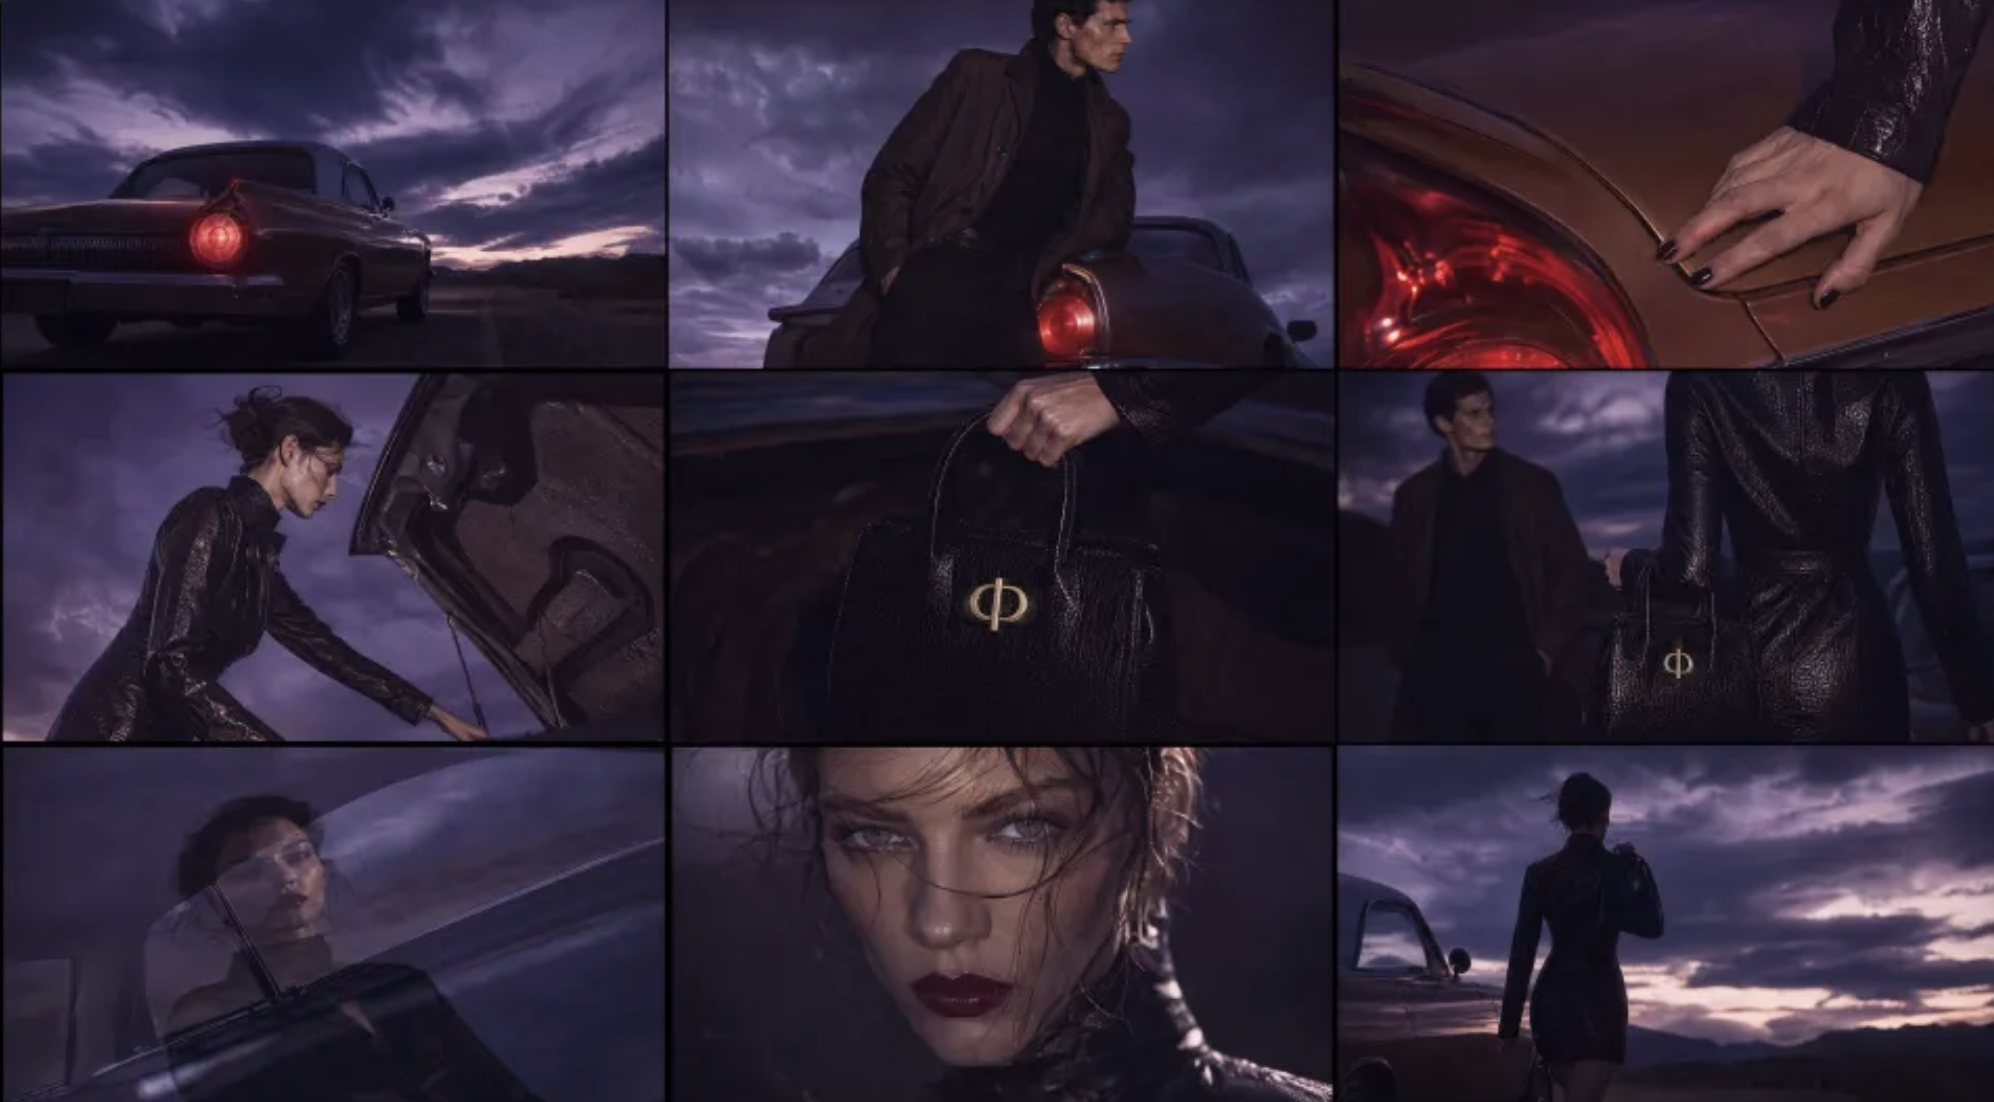
Film krótkometrażowy luksusowej marki: spójność postaci, produktu i zasobów marki
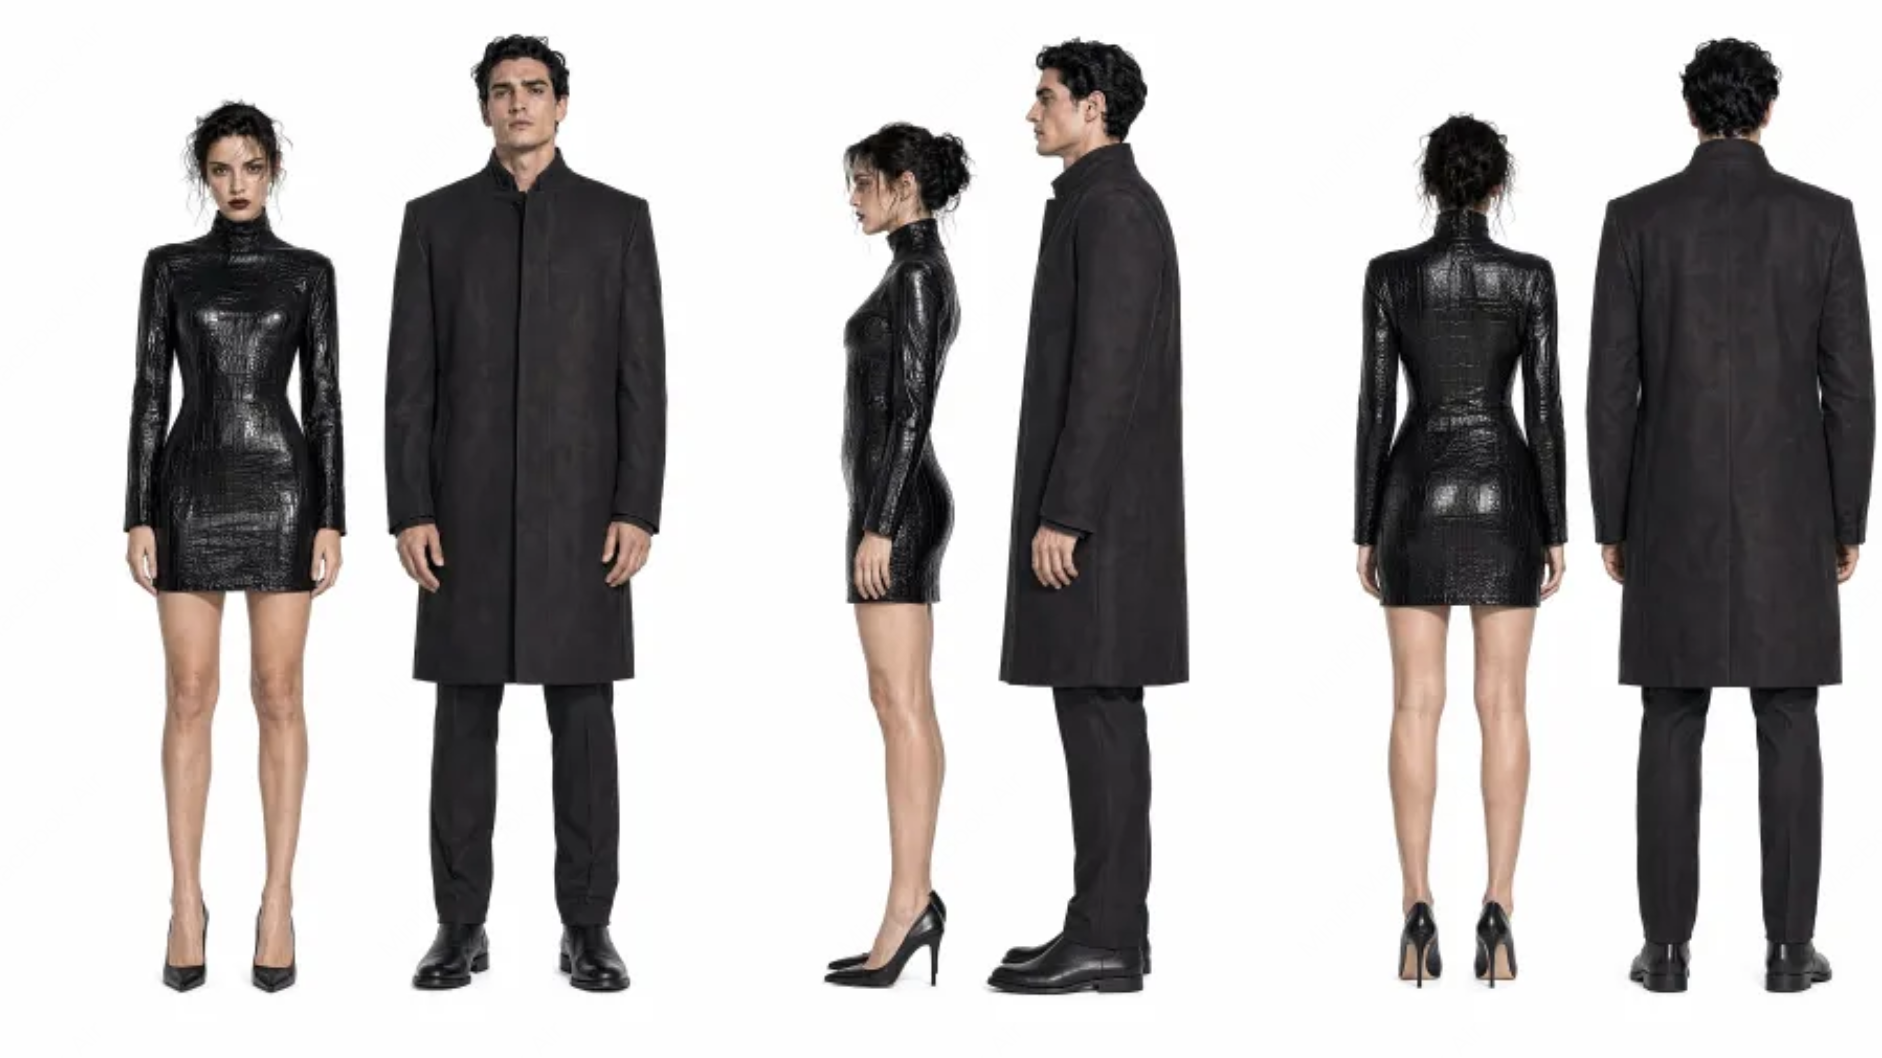
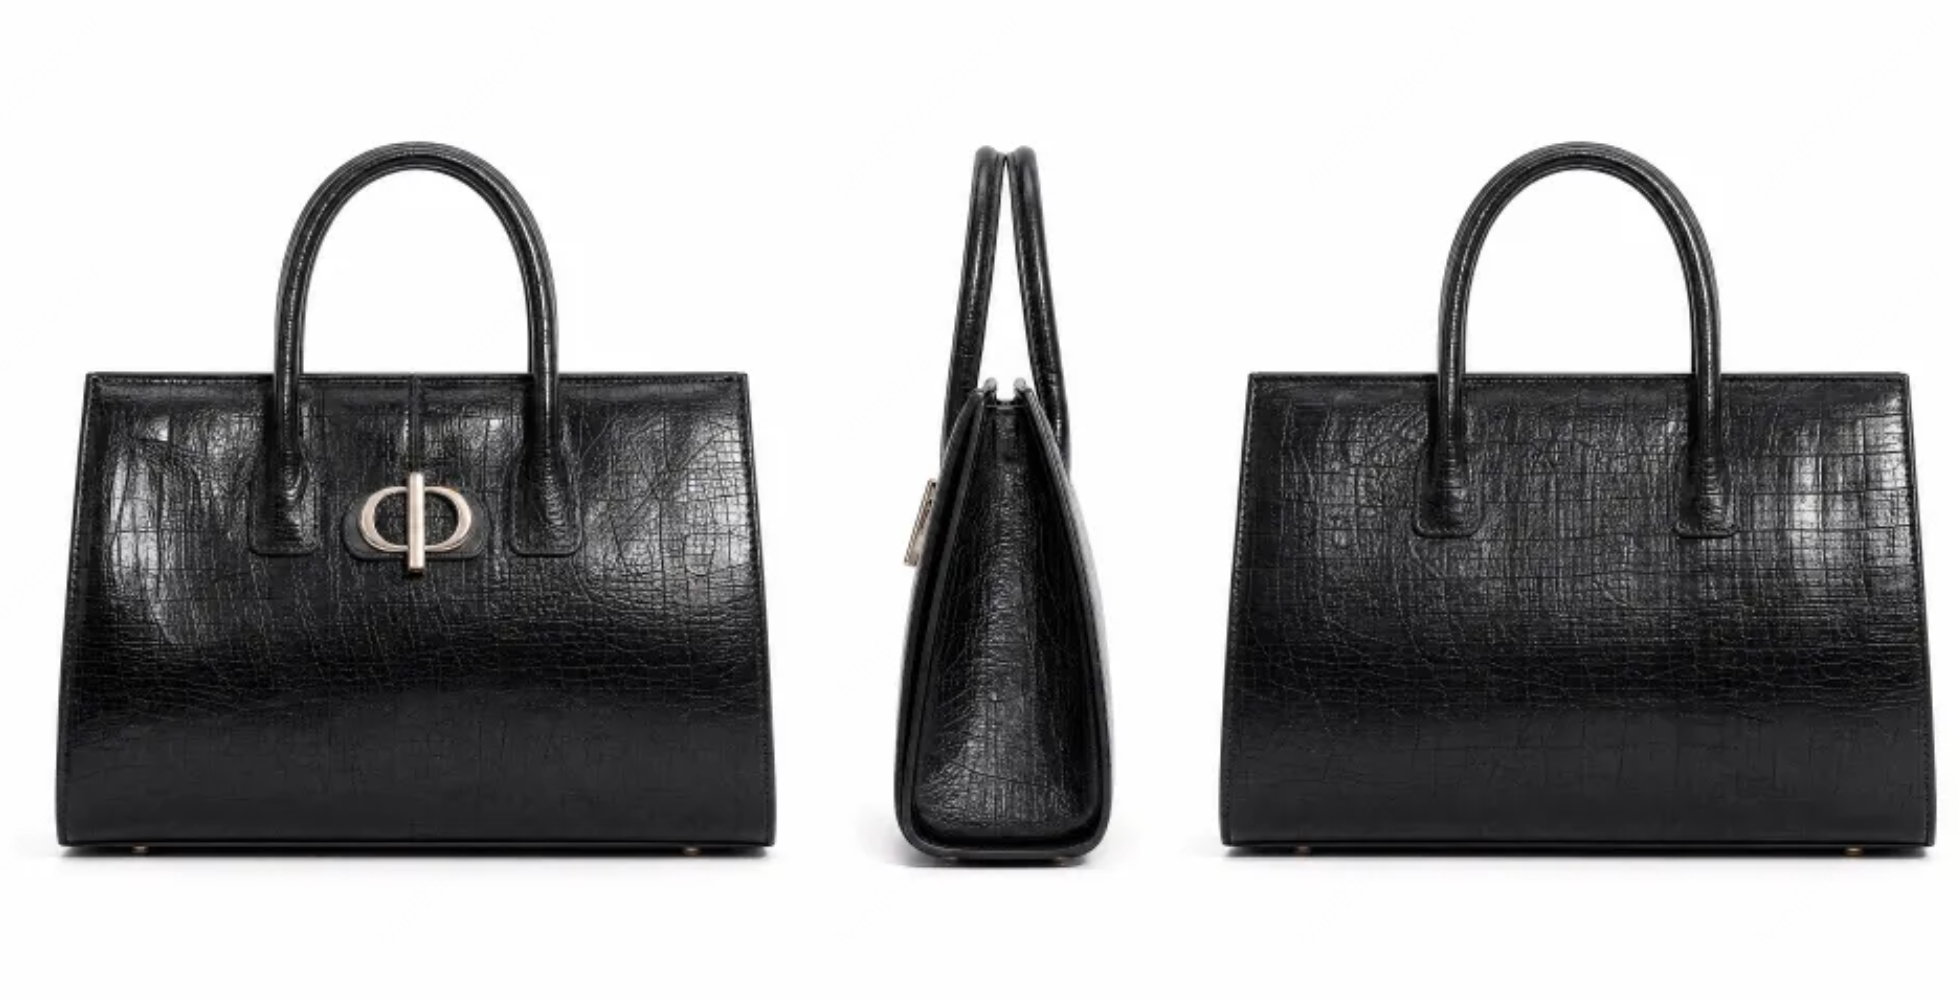
Cel produkcyjny: Film modowy premium w formacie 16:9. Surową atmosferę tworzą pustynna droga i zabytkowy samochód, przy zachowaniu wyglądu głównej bohaterki oraz struktury czarnej torebki, a logo marki zostaje naturalnie włączone do zakończenia. Ten przykład koncentruje się na testowaniu spójności postaci między ujęciami, zachowania produktu, filmowej jakości i możliwości domknięcia przekazu marki.| Referencja atmosfery i sceny | Referencja postaci |
|---|---|
 |  |
| Referencja produktu — torebki | Referencja logo marki |
|---|---|
 |  |
content:
Pionowy krótki dramat z prawdziwymi aktorami: spójność twarzy i ekspresja emocjonalna
Cel produkcji: 15-sekundowy, 9:16 zwiastun mrocznego romantycznego dramatu. Zablokuj wygląd postaci na podstawie obrazów referencyjnych głównych bohaterów oraz ogranicz przestrzeń za pomocą obrazu referencyjnego zamku; użyj średnich zbliżeń i zbliżeń twarzy, aby ukazać konfrontację spojrzeń, strach, powściągliwość i poczucie zagrożenia. Ten przykład nadaje się do obserwowania stabilności rysów twarzy prawdziwych ludzi, mikroekspresji, relacji spojrzeń i ciągłości aktorstwa.| Referencje głównych bohaterów | Referencje sceny zamkowej |
|---|---|
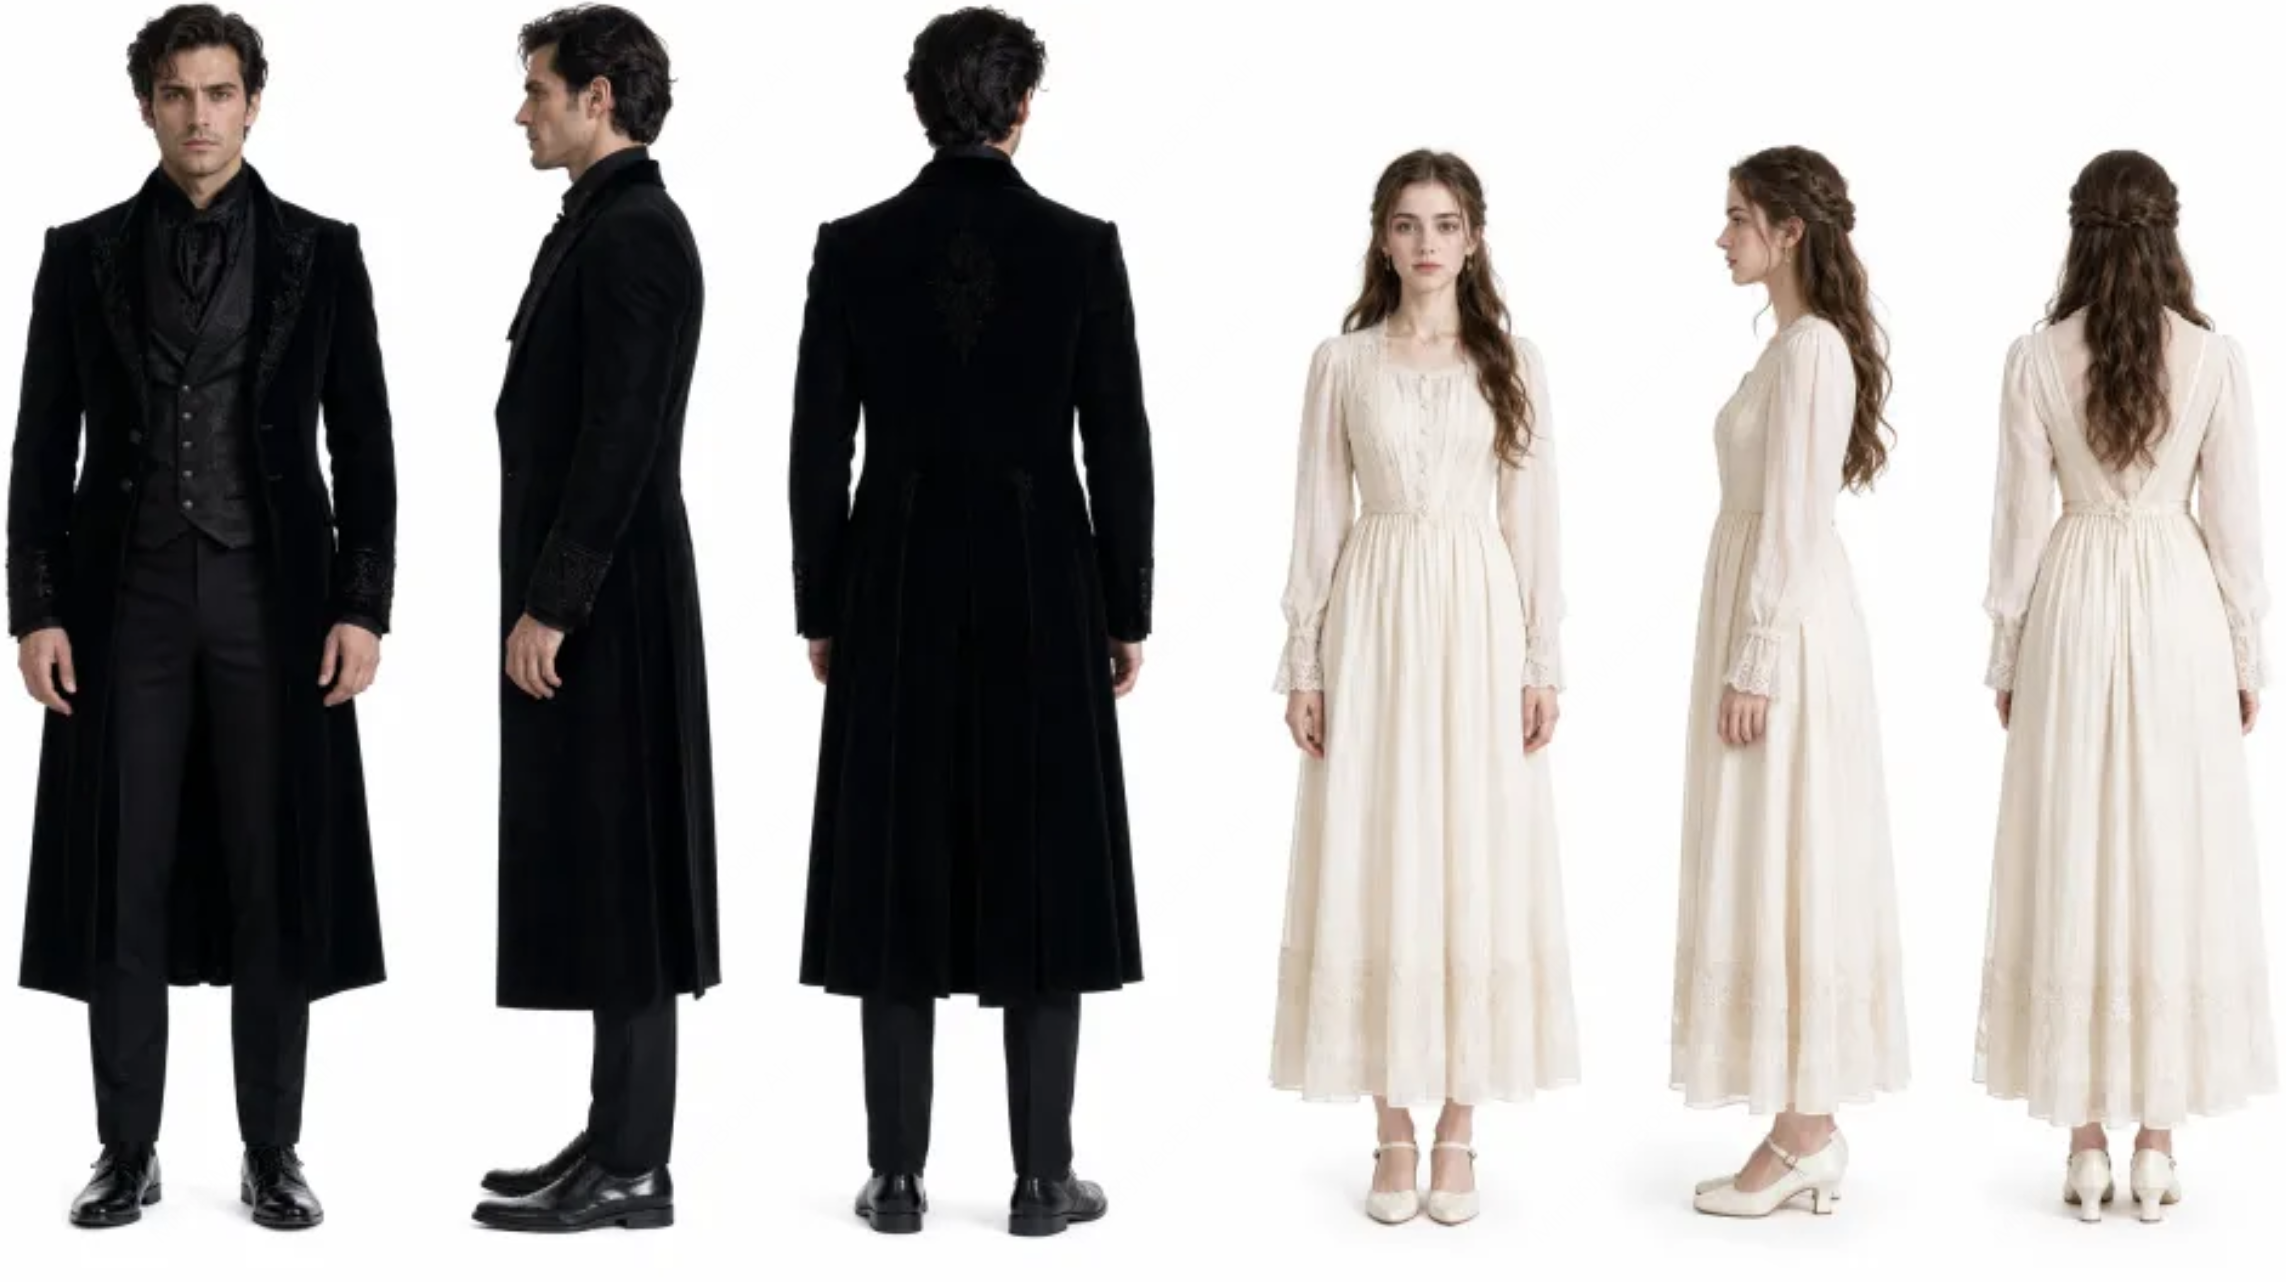 | 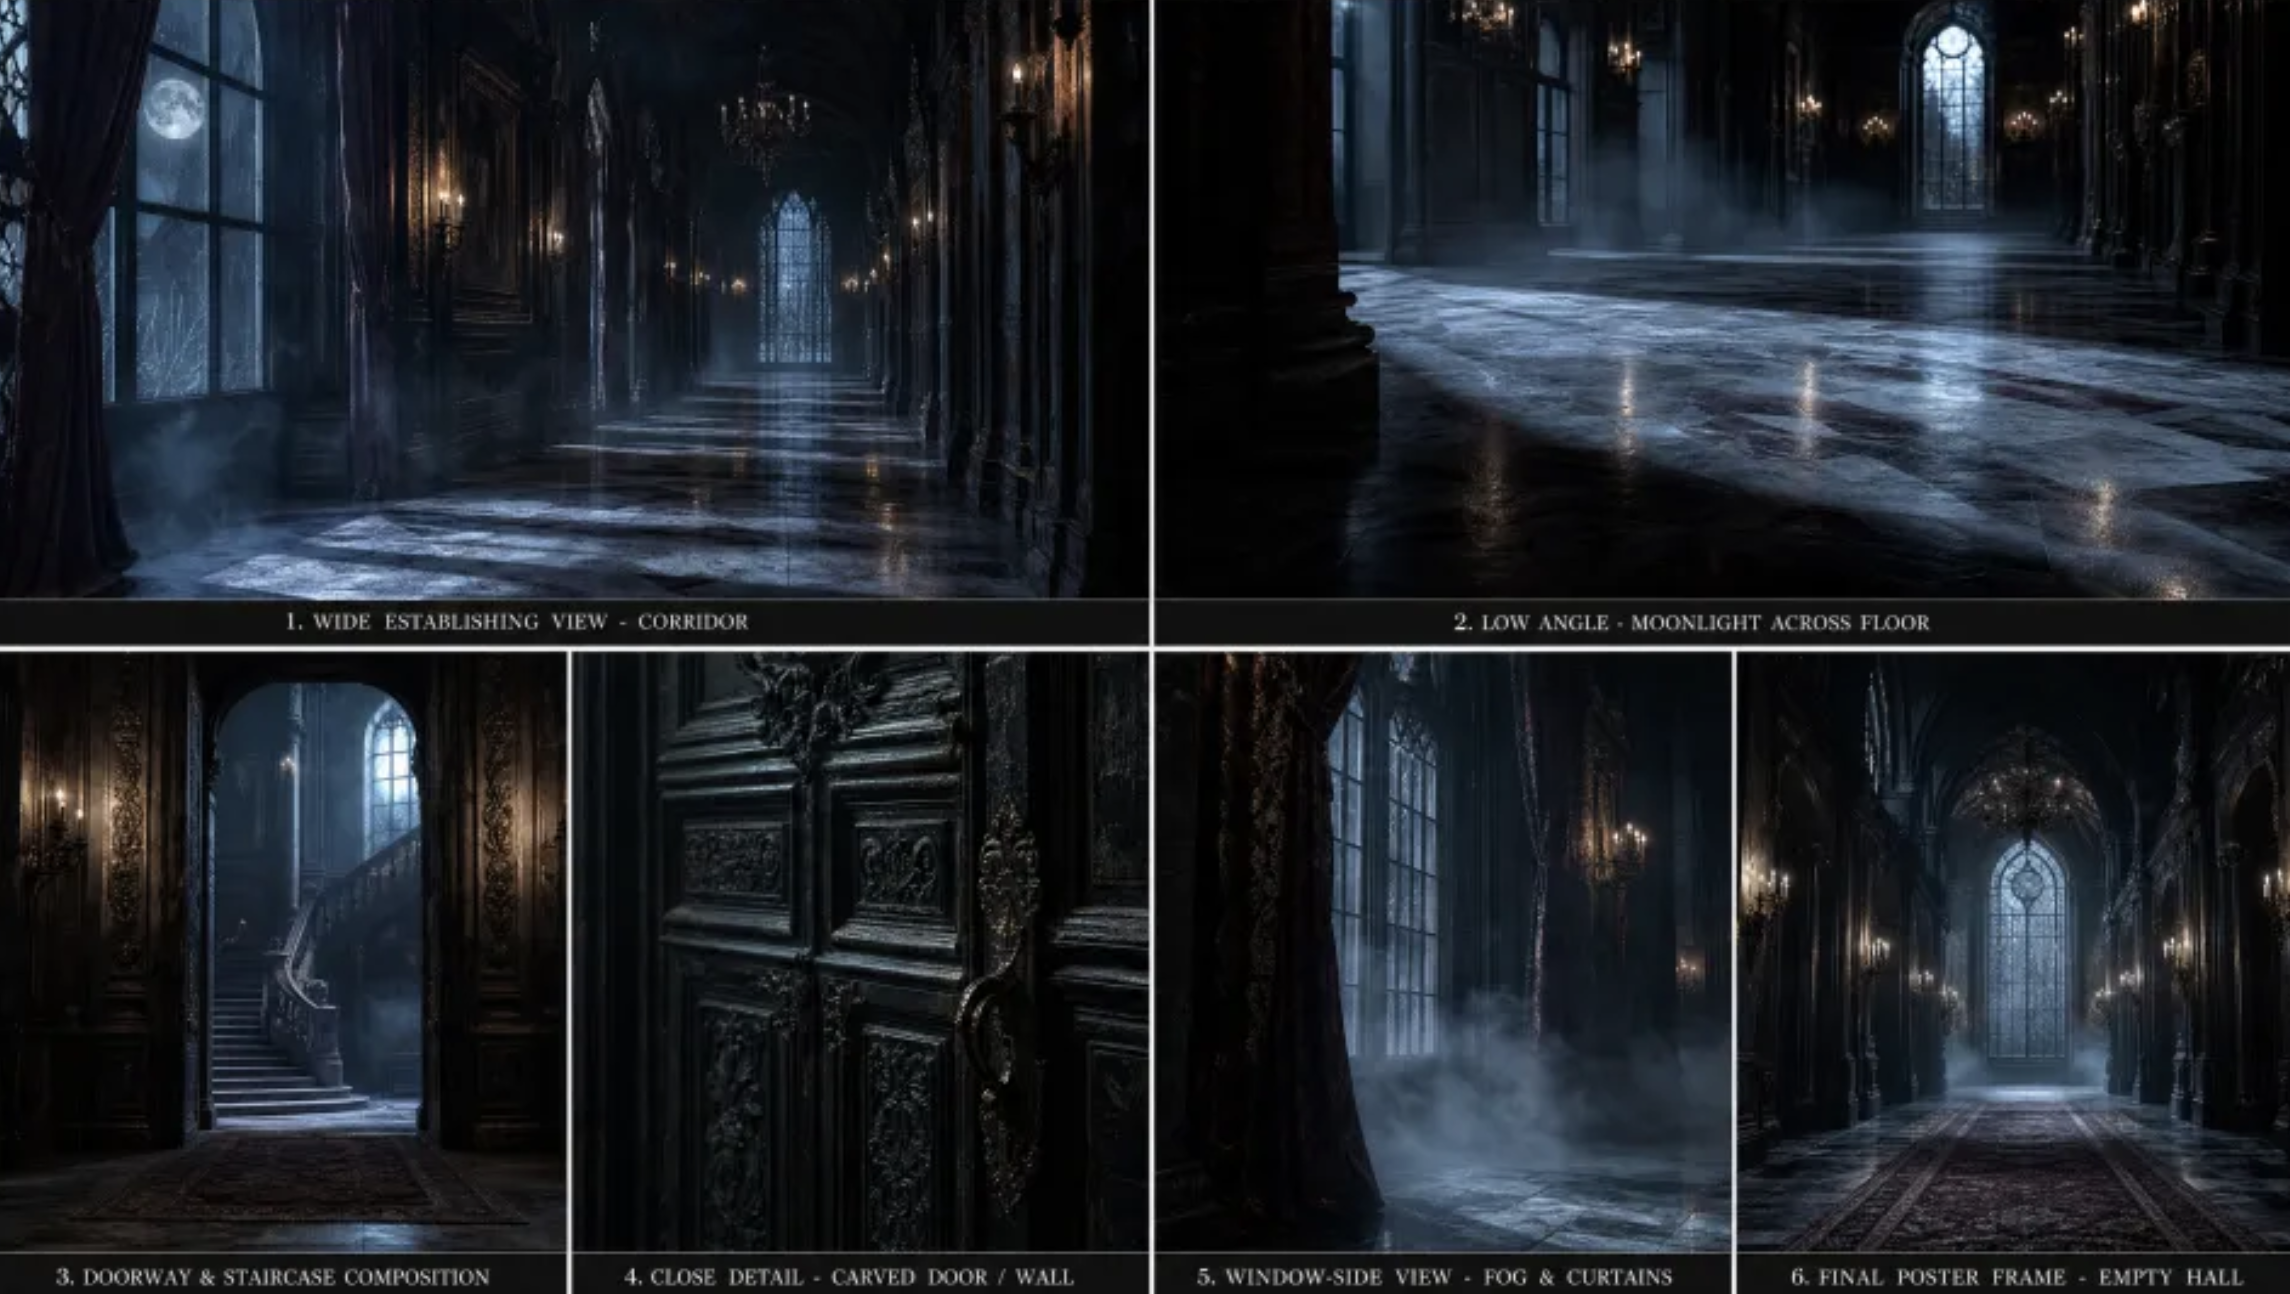 |
Reklama modowych okularów: zachowanie szczegółów twarzy i struktury produktu
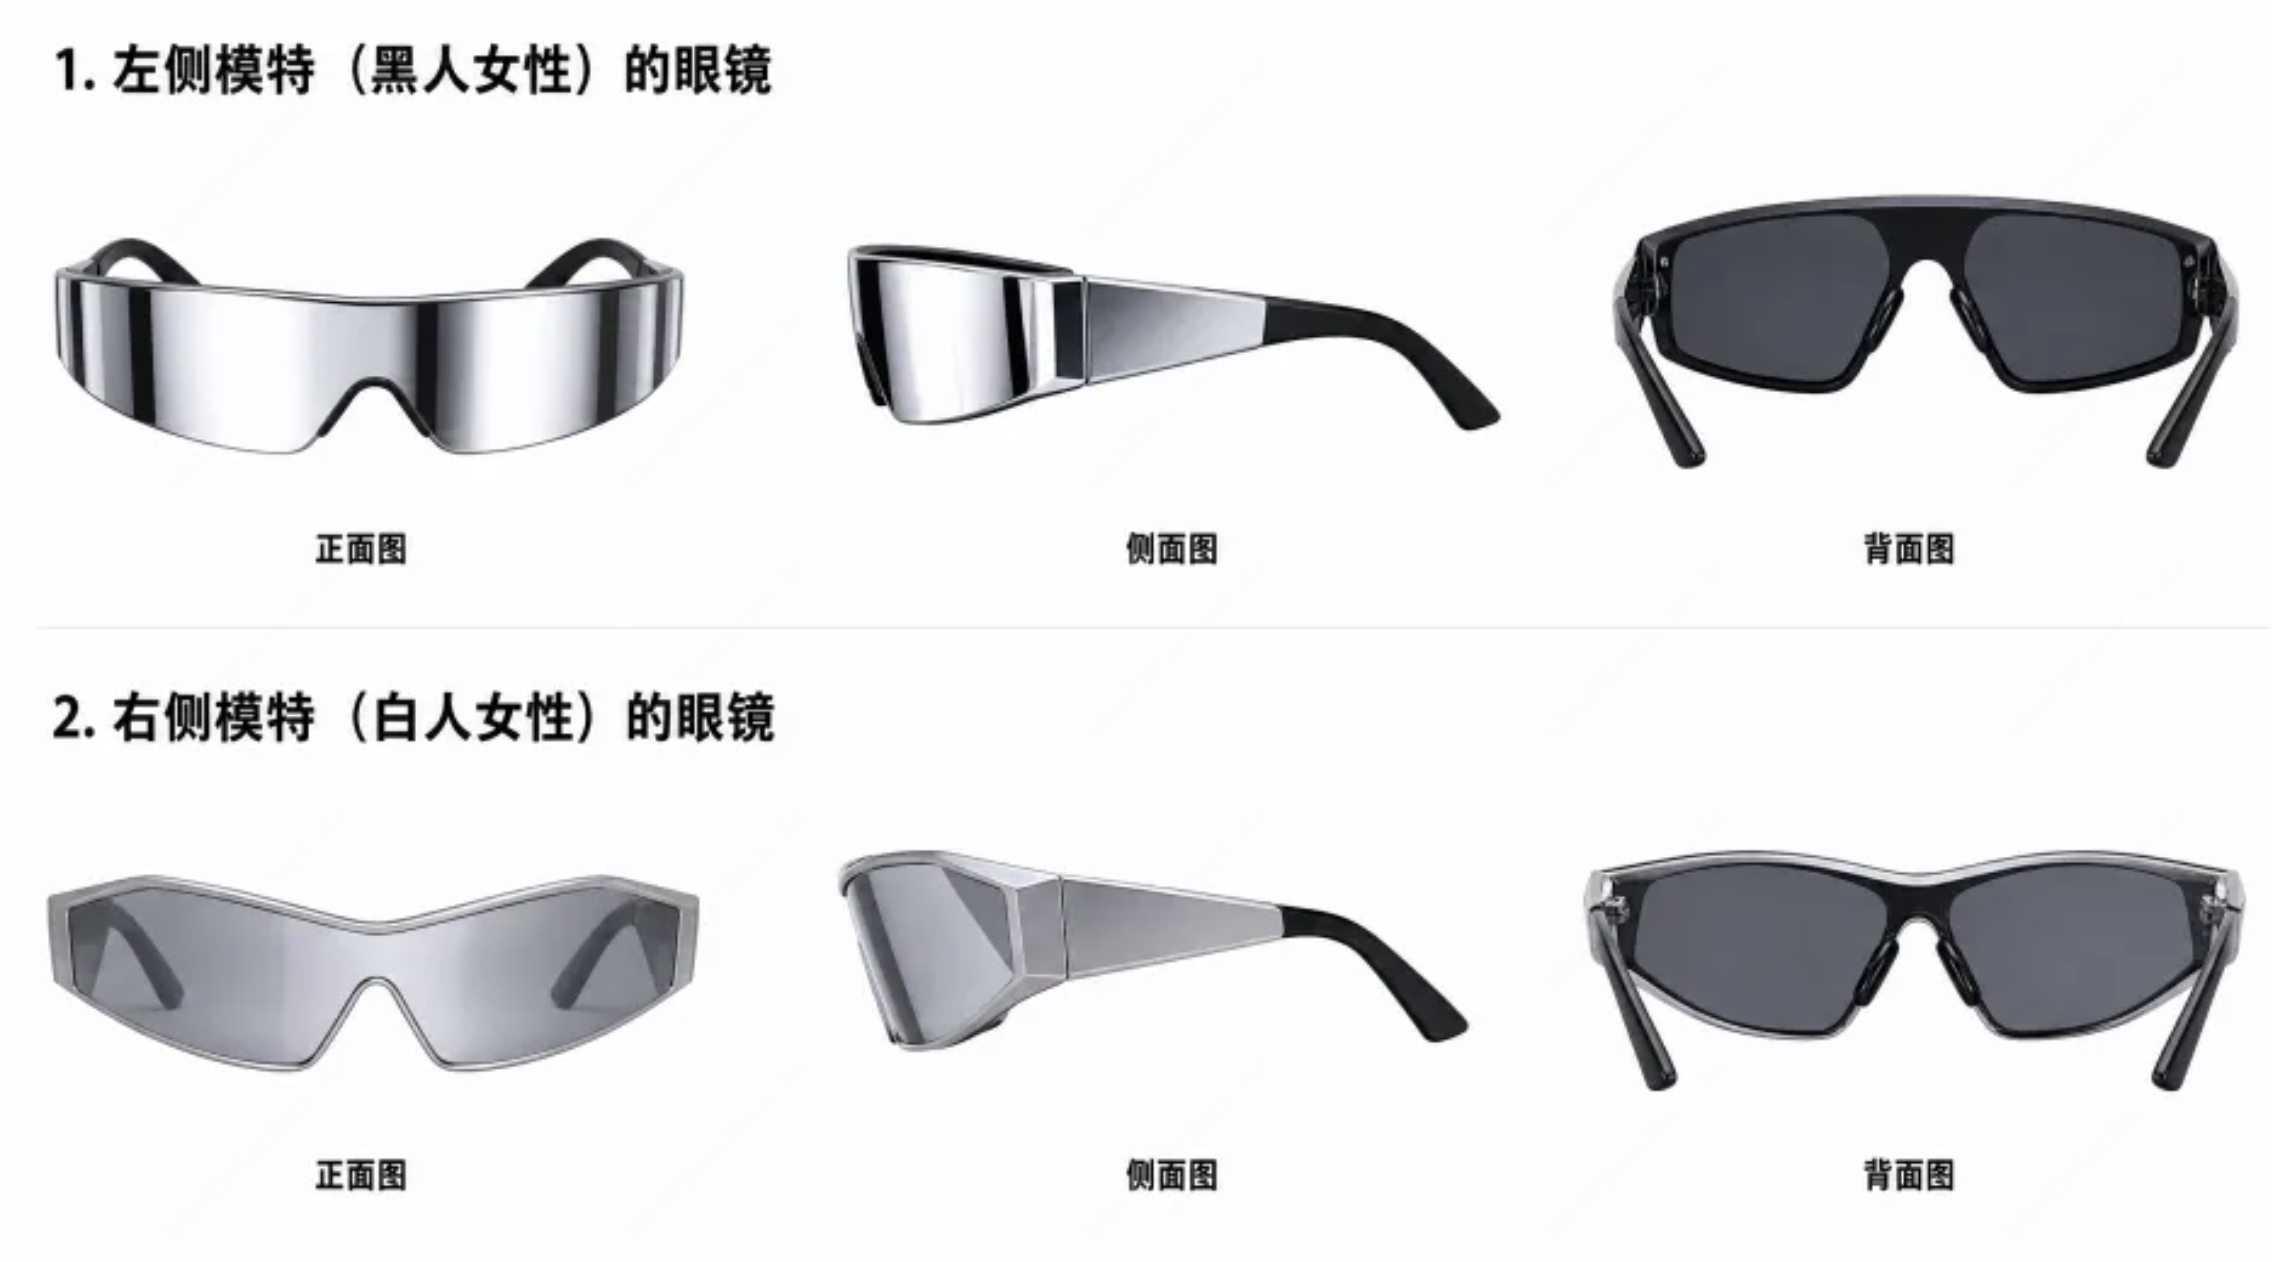
Cel produkcji: Zaawansowana reklama modowych okularów w formacie 9:16. Pełnopostaciowe zdjęcie osoby odpowiada za sylwetkę i chód po wybiegu, referencja twarzy odpowiada za rysy i makijaż, a zdjęcie produktu odpowiada za krzywizny oprawki, odbicia soczewek, zauszniki i kształt kocich oczu. Ten przykład jednocześnie testuje zbliżenia twarzy, spójność wielu osób, relację noszenia i geometryczną strukturę produktu.| Referencje modelki i stylizacji | Referencje szczegółów twarzy | Referencje produktu — okularów |
|---|---|---|
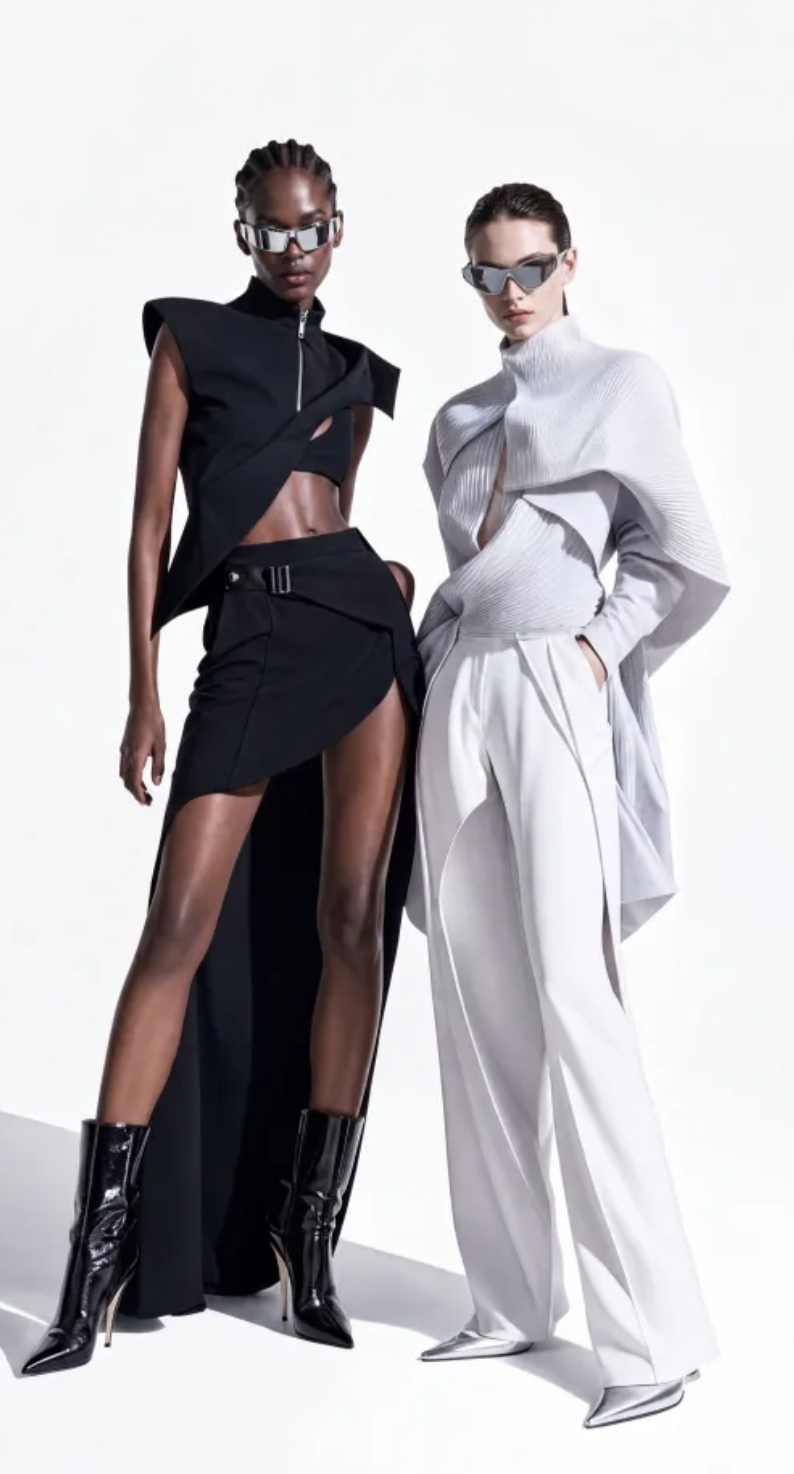 | 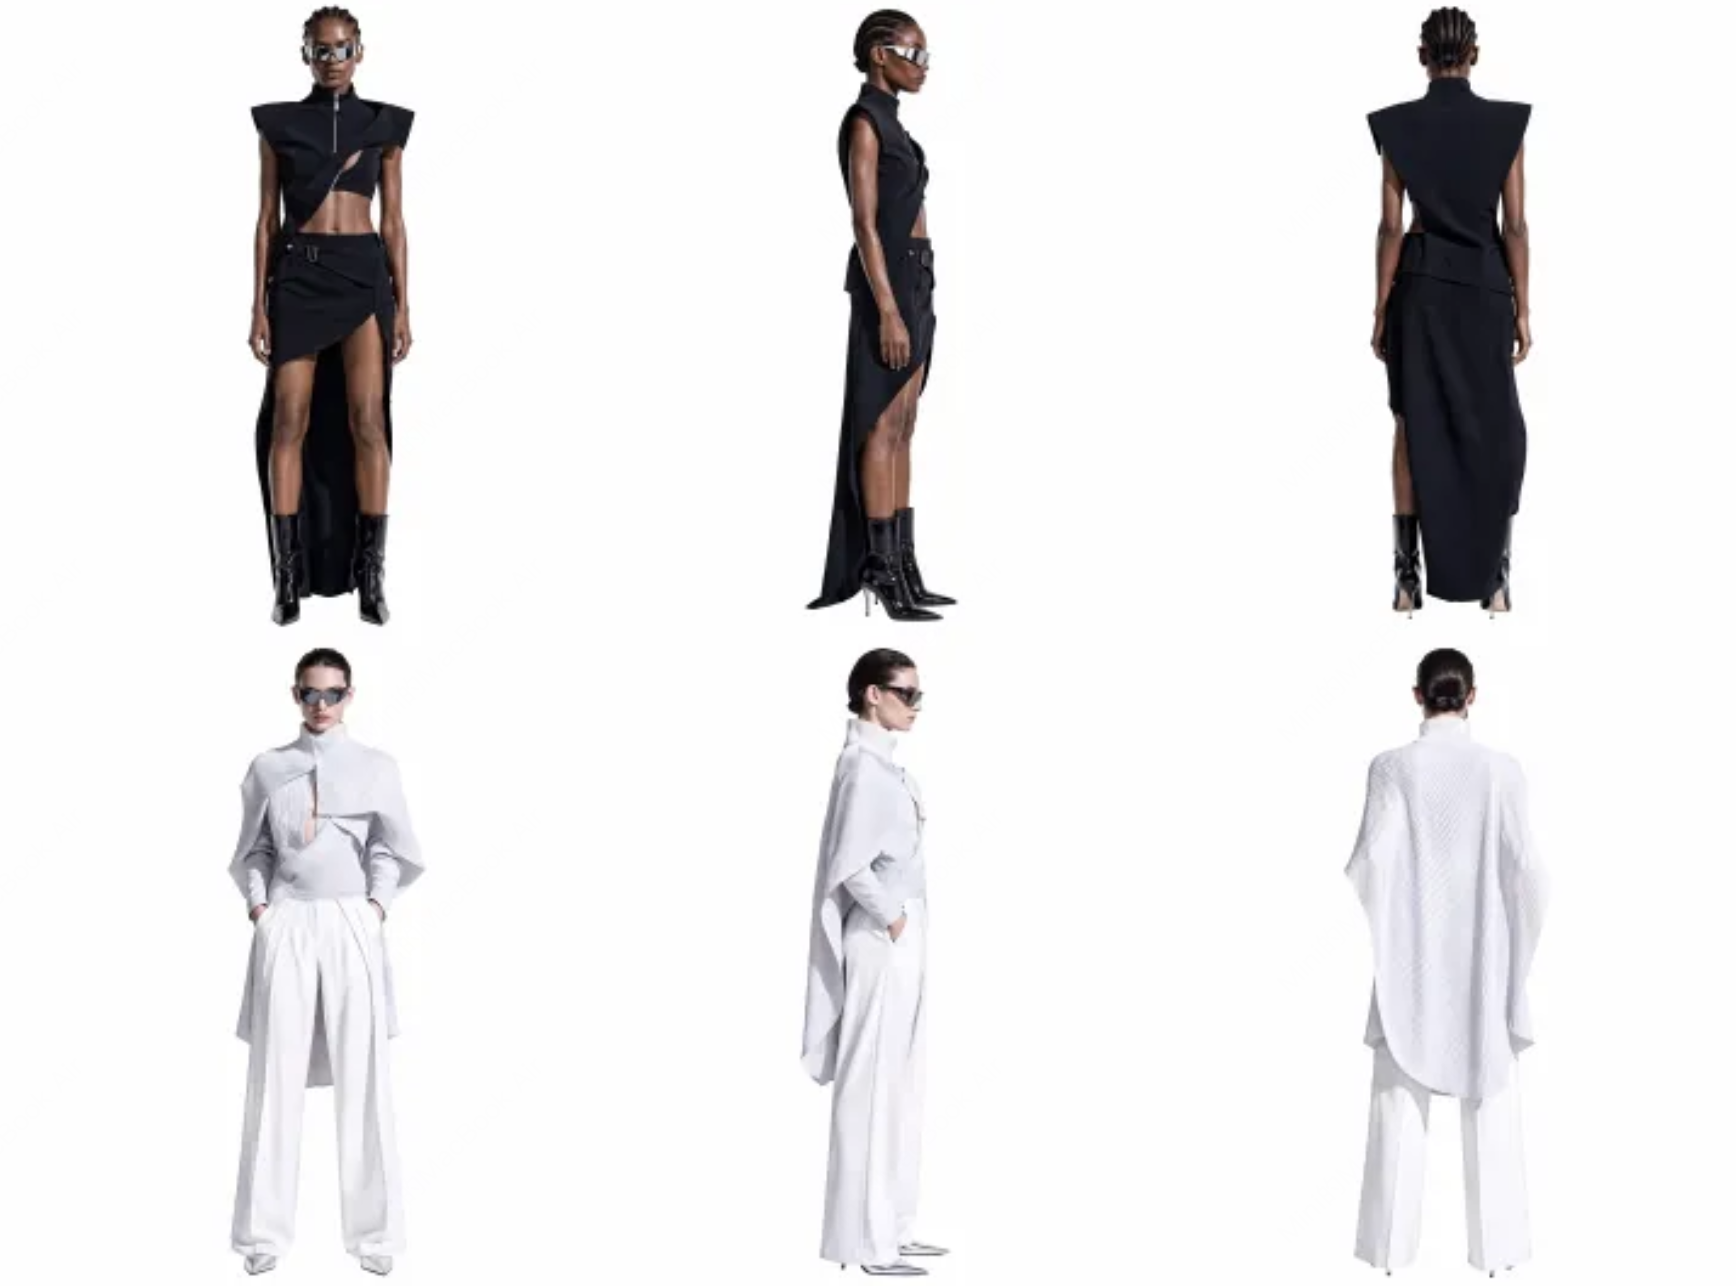 |  |
Tekst na wideo
Gdy istnieje tylko jeden element tekstowy, jest to generowanie wideo z tekstu. Nadaje się do bezpośredniego tworzenia obrazu na podstawie pomysłu, scenariusza lub opisu ujęcia. Prompt można organizować w kolejności „podmiot + działanie + scena + ujęcie + światło + dźwięk”."async": true, interfejs natychmiast zwraca:
Wideo generowane z obrazu pierwszej klatki
Oznacz obraz jakofirst_frame, a model rozpocznie generowanie od tego obrazu. Nadaje się do naturalnego ożywiania plakatów, zdjęć produktów, grafik projektowych postaci i prac fotograficznych.
Ostatnia klatka oraz wideo z pierwszą i ostatnią klatką
Podanie wyłącznielast_frame pozwala modelowi naturalnie wygenerować obraz do określonej klatki; jednoczesne podanie first_frame i last_frame umożliwia precyzyjne kontrolowanie punktu początkowego i końcowego. Nadaje się do przejść, zmian formy, procesu wzrostu lub porównania produktu przed i po.
Generowanie wideo na podstawie referencji multimodalnych
Materiały referencyjne można łączyć: obrazy referencyjne kontrolują wygląd postaci lub produktu, wideo referencyjne kontroluje ruchy i pracę kamery, a audio referencyjne kontroluje barwę dialogów, muzykę lub rytm montażu. W podpowiedzi należy wyraźnie określić, co ma być kontrolowane przez każdy rodzaj materiału, aby uniknąć sytuacji, w której materiały są tylko przesyłane bez wskazania zależności.Powiadomienia zwrotne
Przekazaniecallback_url automatycznie włącza tryb asynchroniczny: interfejs tworzenia natychmiast zwraca task_id i trace_id, a po zakończeniu zadania wysyła pod ten adres metodą POST wynik końcowy, którego struktura jest zgodna z odpowiedzią zapytania o zadanie.
Końcowy status w wywołaniu zwrotnym to succeeded, failed lub cancelled. Nawet w przypadku korzystania z wywołania zwrotnego zaleca się zapisanie task_id, aby umożliwić aktywne sprawdzanie lub uzupełnienie pominiętych powiadomień.
Częste błędy
task.status: succeeded w odpowiedzi synchronicznej oznacza, że wideo zostało wygenerowane; potwierdzenie asynchroniczne oznacza jedynie, że zadanie zostało umieszczone w kolejce. Opłata jest naliczana tylko po ostatecznym pomyślnym zakończeniu zadania, a samo sprawdzanie zadania jest bezpłatne i nie powoduje ponownego naliczenia opłaty.
H3 Max
MiniMax-H3-Max obsługuje 480P lub 768P oraz całkowity czas trwania od 5 do 15 sekund. Wejście audio nie jest dodatkowo płatne, pierwsze 2 obrazy są bezpłatne, a za kolejne naliczana jest opłata za każdy obraz; wideo referencyjne jest rozliczane według rzeczywistego czasu trwania wejścia. Ten model nie obsługuje 2K.