

content multimodale V2 unificata per creare attività.
Procedura di richiesta
Per utilizzare l’API di generazione video MiniMax H3, accedi innanzitutto alla console Ace Data Cloud per ottenere il tuo API Token e conservarlo per l’uso futuro. Se non hai ancora effettuato l’accesso o la registrazione, verrai automaticamente reindirizzato alla pagina di accesso per registrarti ed effettuare l’accesso; al termine, tornerai automaticamente alla pagina corrente.
Un solo API Token consente di chiamare tutti i servizi della piattaforma, senza doverne richiedere uno separatamente per ciascun servizio. La prima richiesta include crediti gratuiti per provare il servizio senza costi; quando i crediti sono insufficienti, puoi ricaricare il saldo universale nella console.
📘 Documentazione completa: API di generazione video MiniMax H3 →Si consiglia di salvare il Token come variabile d’ambiente, senza scriverlo nel codice sorgente né inviarlo al repository di versionamento:
Panoramica dell’interfaccia
- Base URL:
https://api.acedata.cloud - Endpoint:
POST /minimax/videos - Metodo di autenticazione:includere
authorization: Bearer {token}nell’HTTP Header - Intestazioni della richiesta:
accept: application/jsoncontent-type: application/json
- Modello (model):
MiniMax-H3 - Struttura di input:testo, immagini, video e audio vengono passati in modo unificato tramite
content - Modalità di output:per impostazione predefinita attende in modo sincrono il completamento della generazione e restituisce il
taskcompleto; passandoasync: trueocallback_url, restituisce immediatamentetask_idetrace_id - Consultazione del risultato:ottenere lo stato e il video finale tramite l’API di consultazione delle attività MiniMax H3
- Callback asincrono:opzionale, riceve il risultato finale dell’attività tramite
callback_url
action per selezionare la modalità di generazione; l’interfaccia determina automaticamente l’uso in base al tipo di materiale e al role in content.
Scenari adatti
Flusso di chiamata
Quandoasync non viene passato per impostazione predefinita, /minimax/videos attende il completamento della generazione e restituisce direttamente il task completo. Se è necessario liberare immediatamente la connessione, passare async: true o callback_url:
- Salvare
task_idetrace_idnella risposta immediata. - Se non è configurato un callback, chiamare
/minimax/taskscirca ogni 10 secondi per effettuare una query. - Quando
task.statusdiventasucceeded, ottenere il video datask.content.url. - Quando lo stato è
failedocancelled, interrompere il polling e leggeretask.error.
Parametri di richiesta di primo livello
Le regole di
ratio dipendono dal flusso di lavoro:
- Generazione video da testo:obbligatorio e non può essere
adaptive. - Video con primo fotogramma, ultimo fotogramma o primo e ultimo fotogramma:il formato è determinato dall’immagine di input; si consiglia di ometterlo o passare
adaptive. - Generazione video con riferimenti multimodali:può essere omesso, il valore predefinito è
adaptive; è inoltre possibile specificare esplicitamente una proporzione fissa.
prompt, image_urls, audio_urls, messages e first_frame_image. Quando si riceve un errore relativo a tali parametri, eliminare i campi legacy e migrare a content; ad esempio, modificare "prompt": "一只猫挥手" in "content": [{"type": "text", "text": "一只猫挥手"}]. Non inviare contemporaneamente entrambi i formati, nuovo e vecchio.
Parametri degli elementi di contenuto content
Ogni elemento di contenuto deve averetype; gli altri campi dipendono dal tipo:
Gli indirizzi dei media supportano tre formati:
- URL HTTPS accessibili pubblicamente, consigliati per file di grandi dimensioni.
mm_file://{file_id}, per fare riferimento a file già caricati o a risultati esistenti.- Base64 data URI del tipo di media corrispondente. Base64 aumenta le dimensioni di circa un terzo; assicurarsi che l’intero corpo della richiesta non superi 64 MB.
Specifiche dei materiali e limiti di quantità
Immagini, video e audio negli scenari di riferimento multimodale possono totalizzare al massimo 12 file. Lo scenario dei fotogrammi iniziale e finale e lo scenario dei materiali di riferimento sono mutuamente esclusivi: una volta utilizzati
reference_image, reference_video o reference_audio, non è più possibile utilizzare first_frame o last_frame, e viceversa.
Dimostrazione delle capacità di livello produttivo
Quanto segue non sono immagini concettuali o materiali segnaposto, bensì input di riferimento reali e output video effettivi dei filmati campione ufficiali delle capacità di livello produttivo di MiniMax H3. I tre gruppi di casi coprono rispettivamente spot di brand, narrazione con attori reali ed e-commerce di moda, e sono adatti a valutare le capacità più cruciali del modello nella produzione commerciale.
Qui, per “capacità del volto” si intendono la coerenza dell’aspetto dei personaggi, i dettagli facciali e il controllo della recitazione nella generazione video, non il riconoscimento dell’identità, il confronto dei volti o le interfacce di sostituzione del volto.
Cortometraggio di brand di lusso: unificazione di personaggi, prodotti e asset del brand
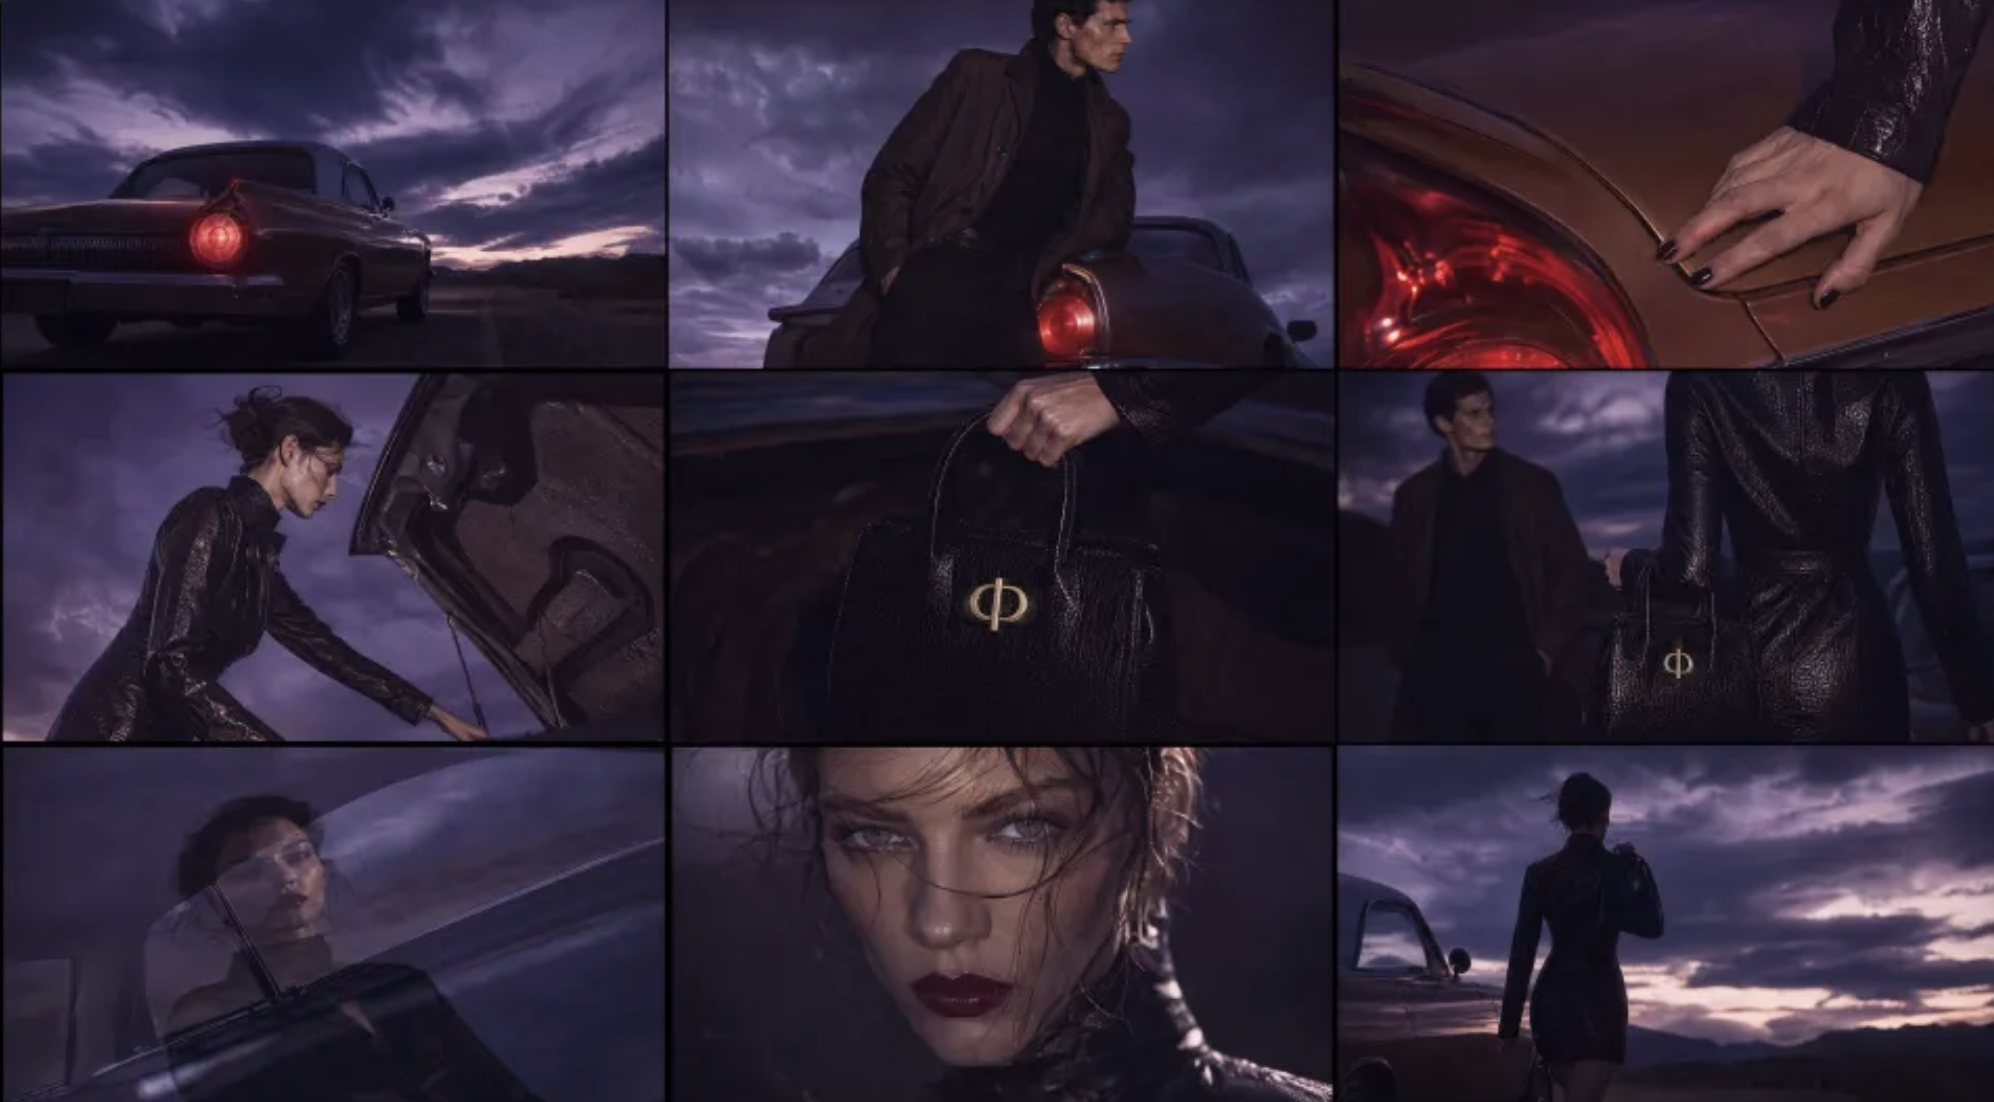
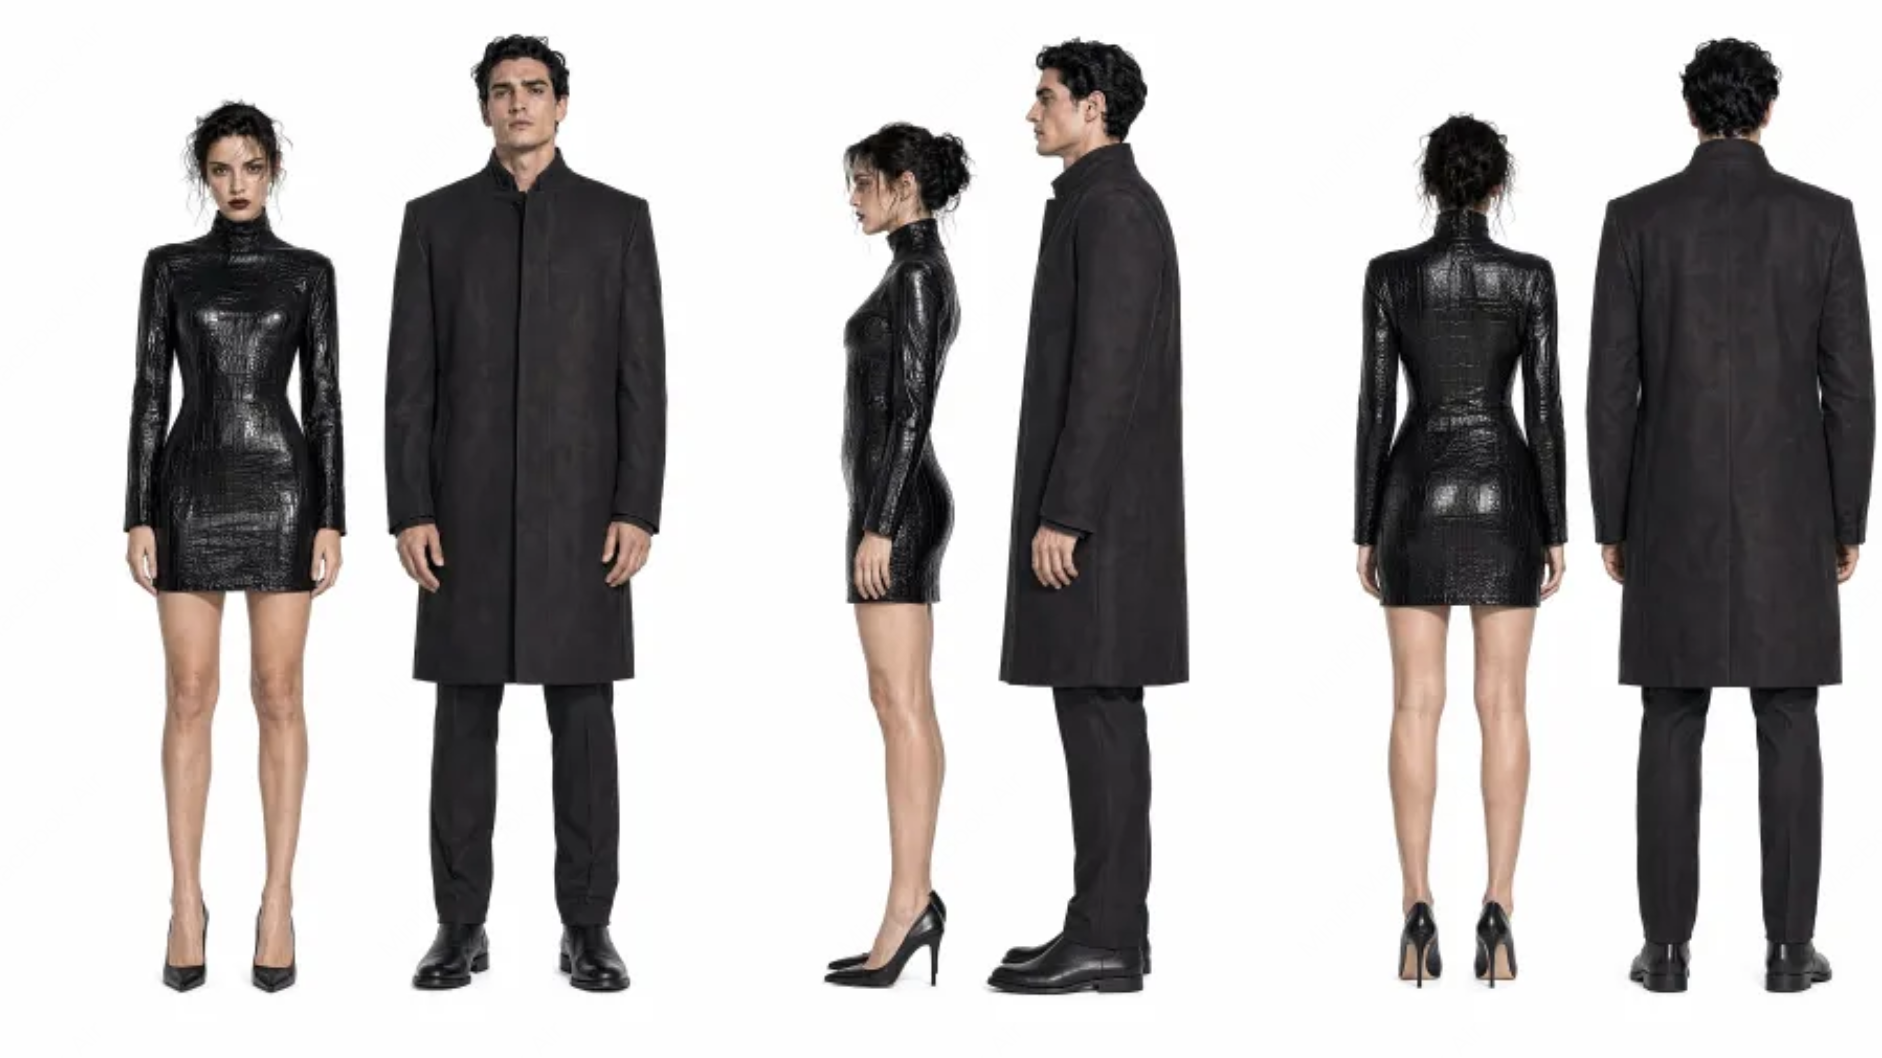
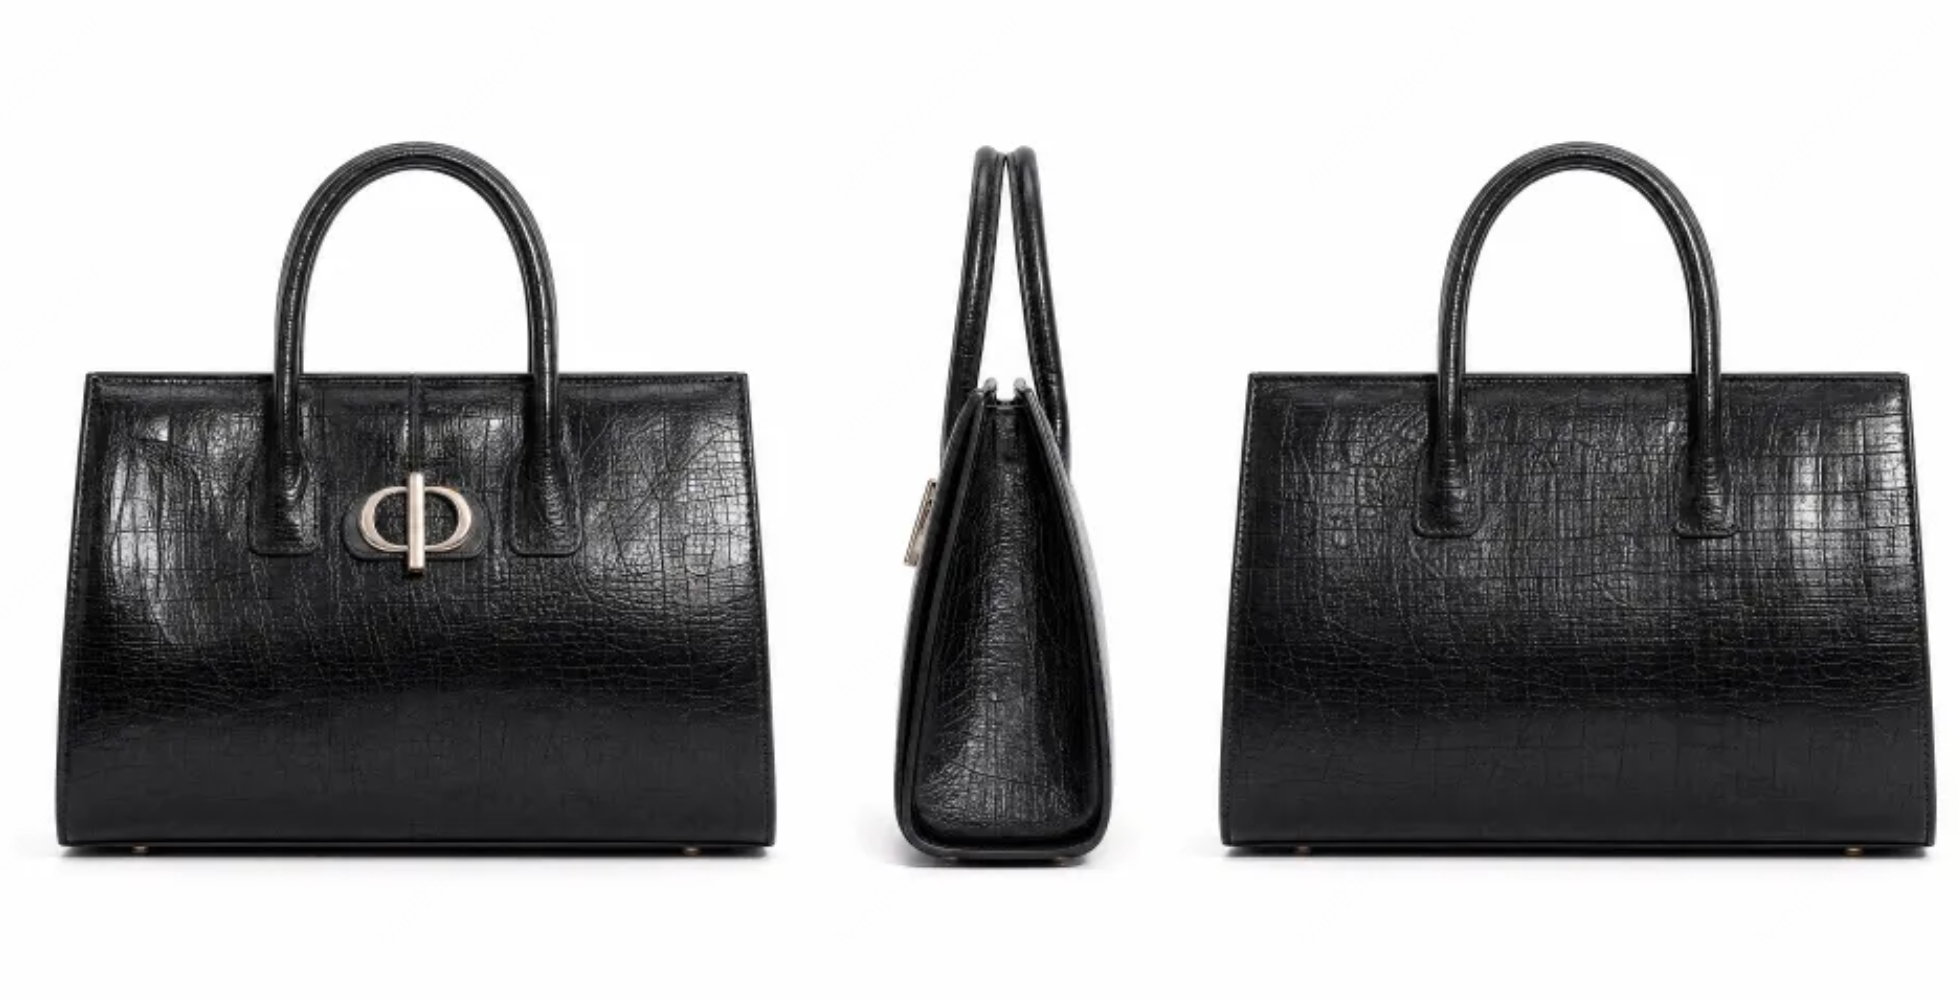
Obiettivo di produzione: Filmato di brand di alta moda in 16:9. Utilizza una strada nel deserto e un’auto d’epoca per creare un’atmosfera algida, mantenendo l’aspetto della protagonista e la struttura della borsa nera, e integrando naturalmente il Logo del brand nel finale. Questo caso verifica in particolare la coerenza dei personaggi tra le inquadrature, il mantenimento del prodotto, la qualità cinematografica e la capacità di chiusura del brand.| Riferimento per atmosfera e scena | Riferimento per il personaggio |
|---|---|
 |  |
| Riferimento per il prodotto borsa | Riferimento per il Logo del brand |
|---|---|
 |  |
content corrispondente:
Miniserie verticale con attori reali: coerenza del volto e recitazione emotiva
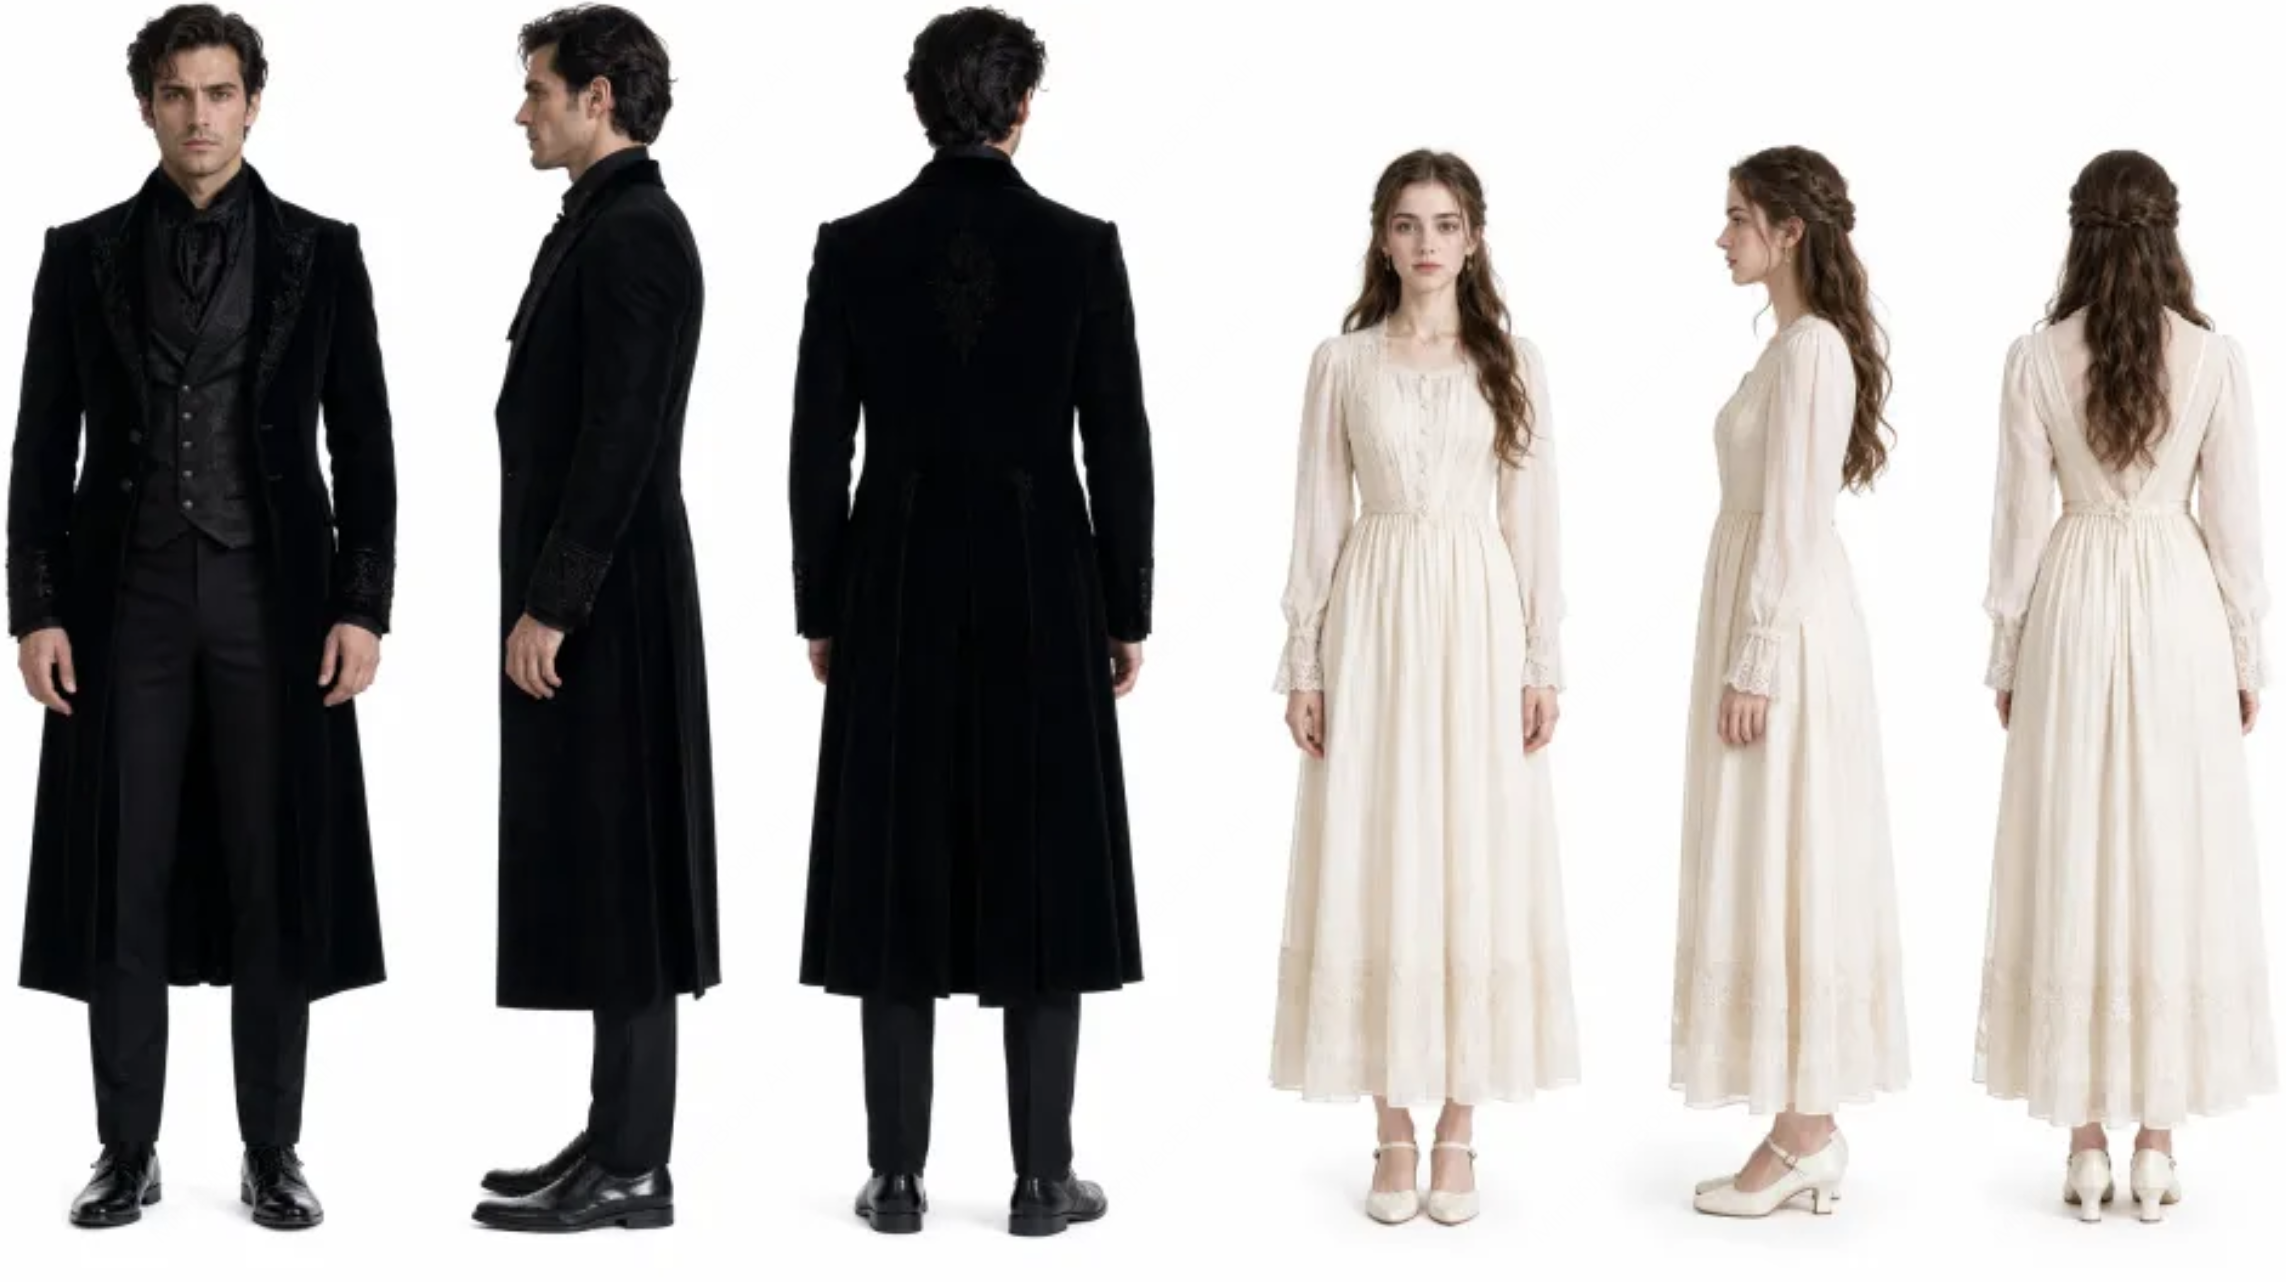
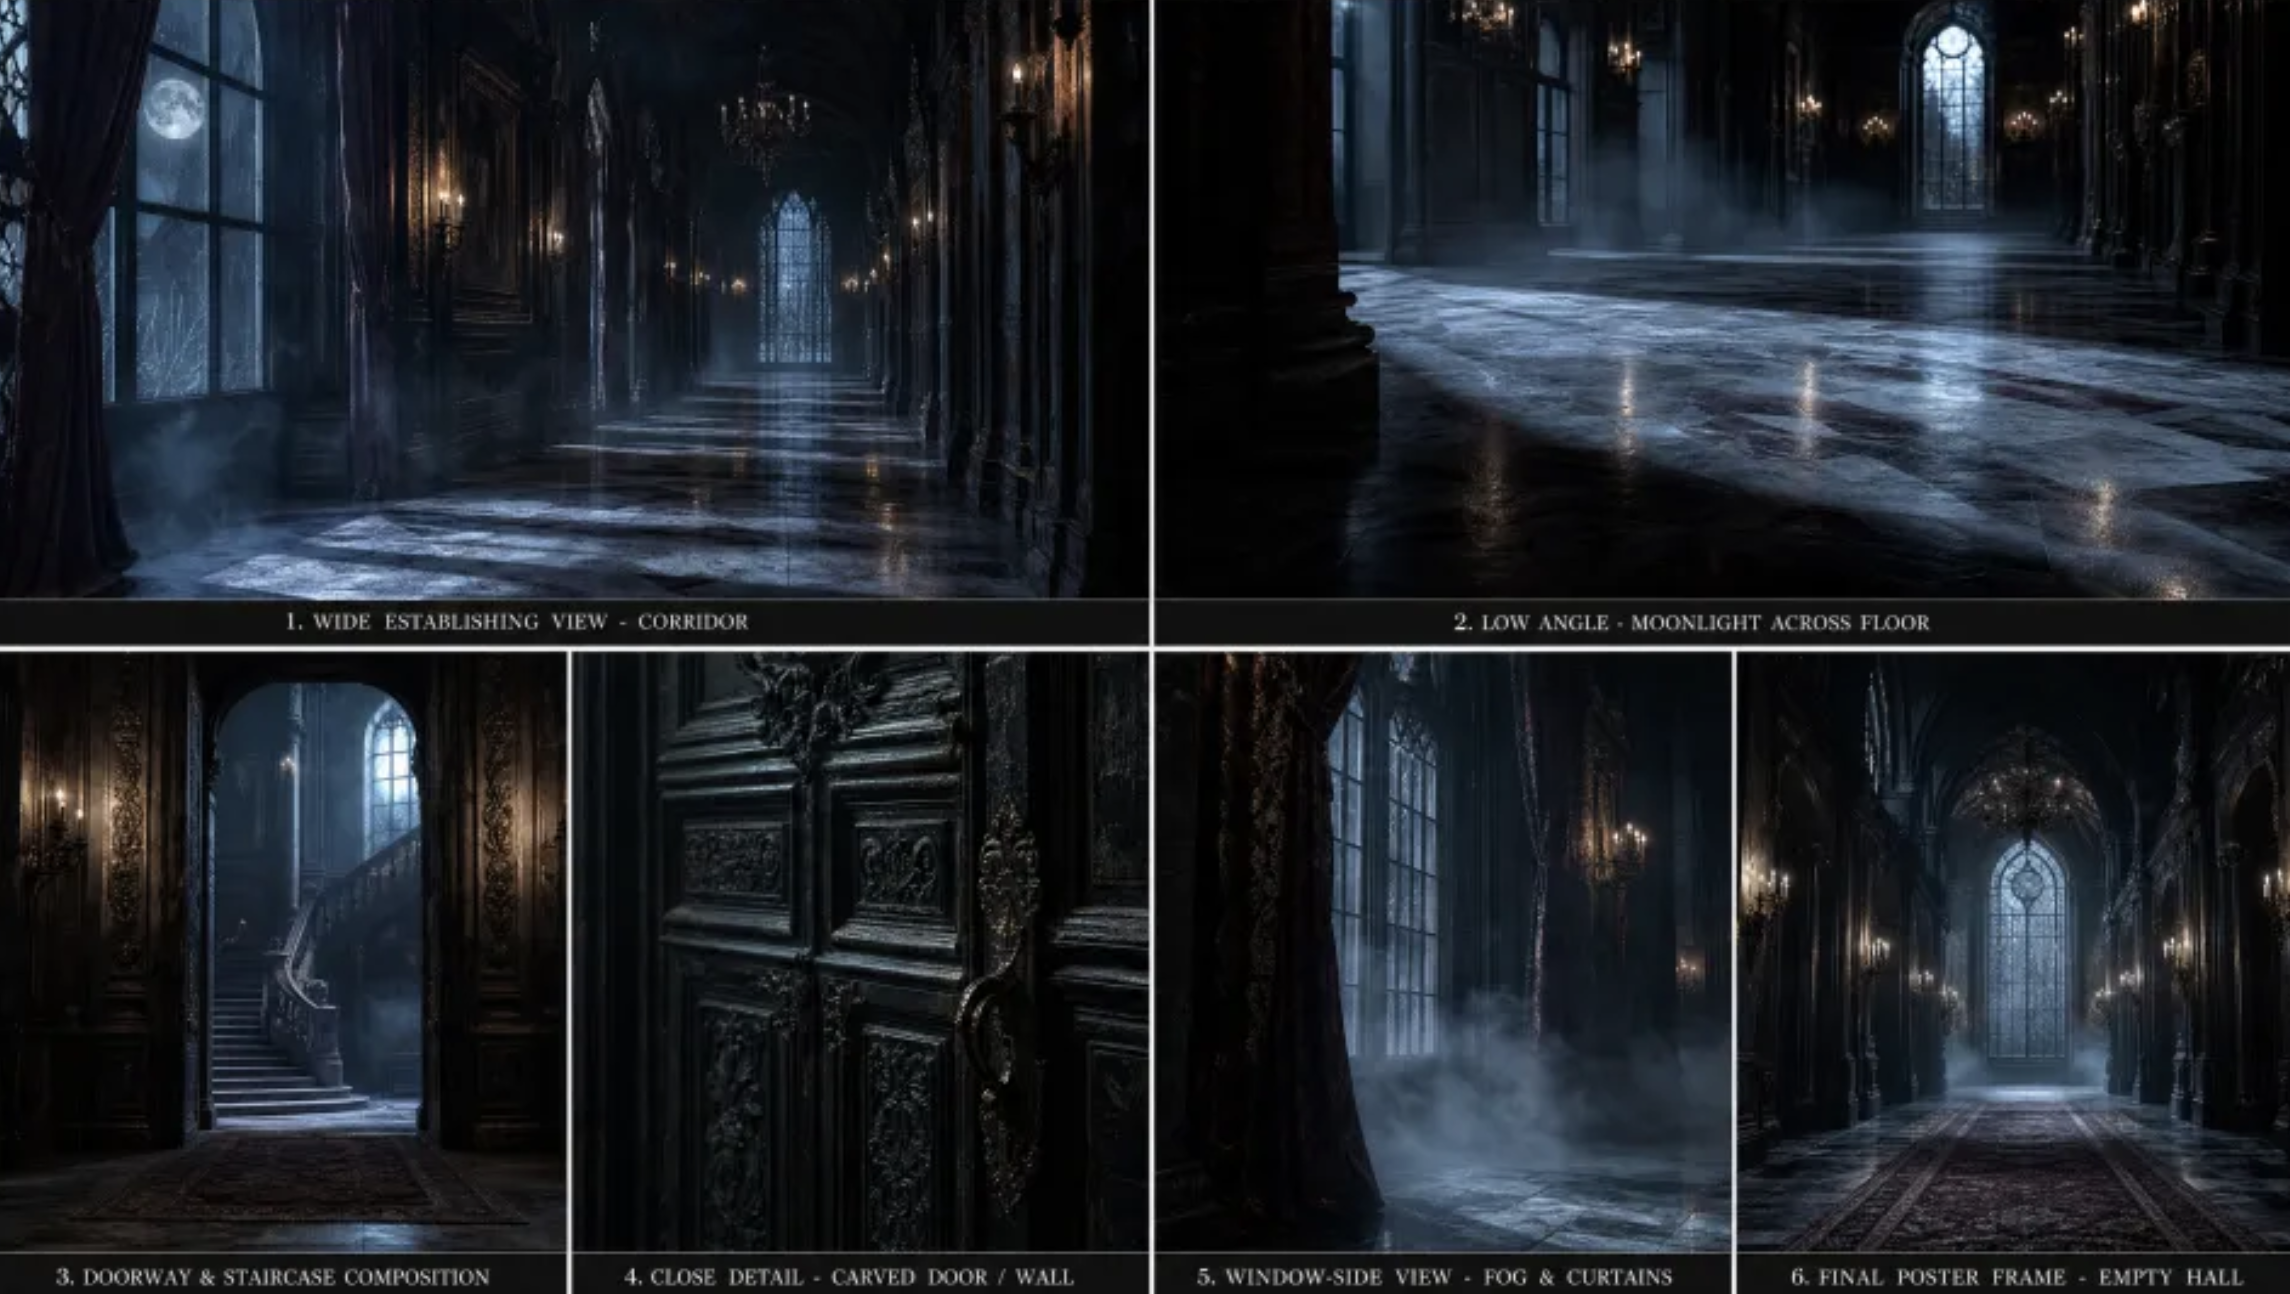
Obiettivo di produzione: Trailer di un breve drama dark romance di 15 secondi, 9:16. Bloccare l’aspetto dei personaggi attraverso le immagini di riferimento dei protagonisti maschile e femminile, e vincolare lo spazio con l’immagine di riferimento del castello; utilizzare inquadrature a mezzo busto ravvicinate e primi piani del viso per mostrare il confronto degli sguardi, la paura, il controllo e il senso di pericolo. Questo caso è adatto per osservare la stabilità dei tratti facciali realistici, le microespressioni, le relazioni di sguardo e la recitazione continua.| Riferimento dei protagonisti maschile e femminile | Riferimento della scena del castello |
|---|---|
 |  |
Pubblicità di occhiali di moda: mantenimento dei dettagli del viso e della struttura del prodotto
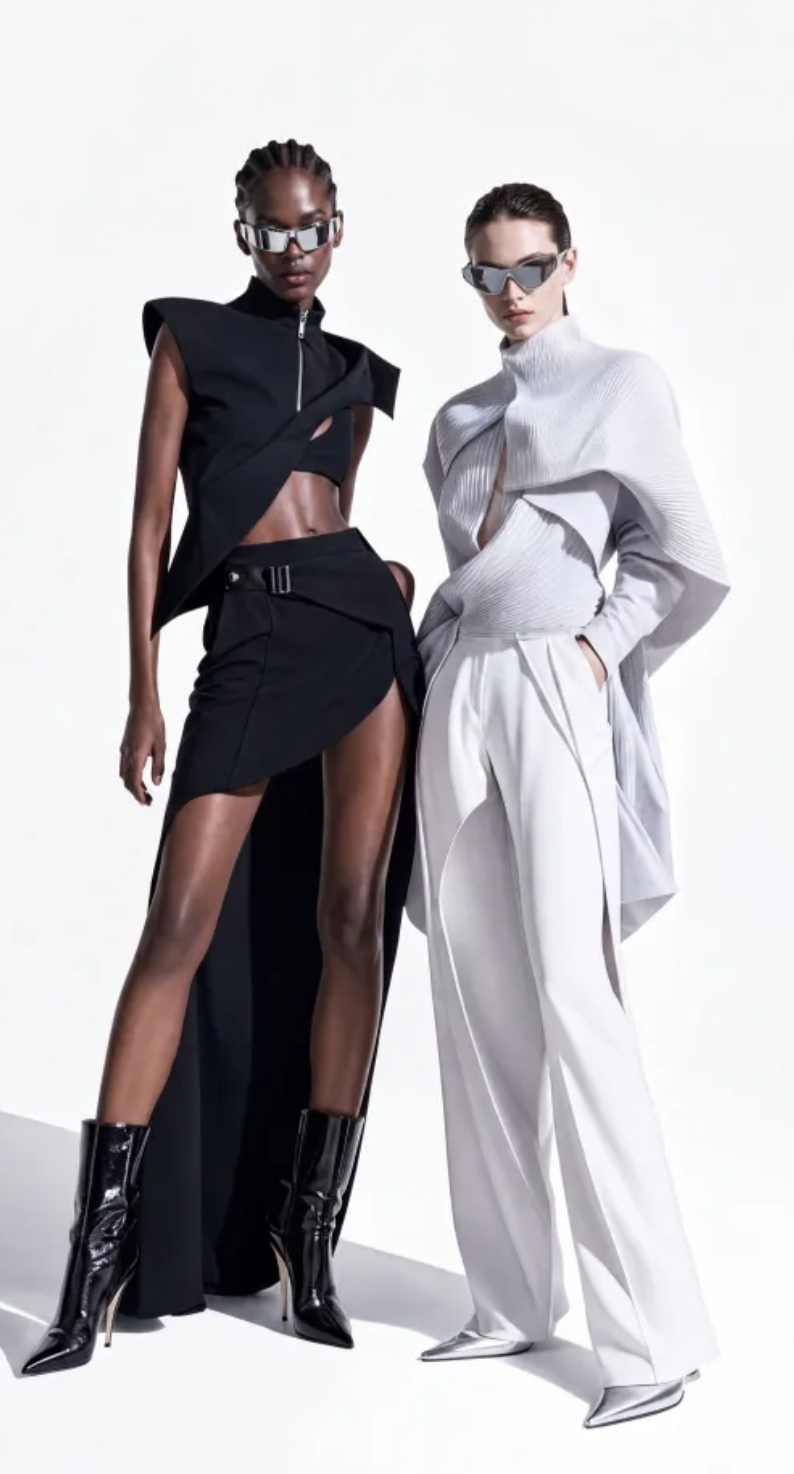
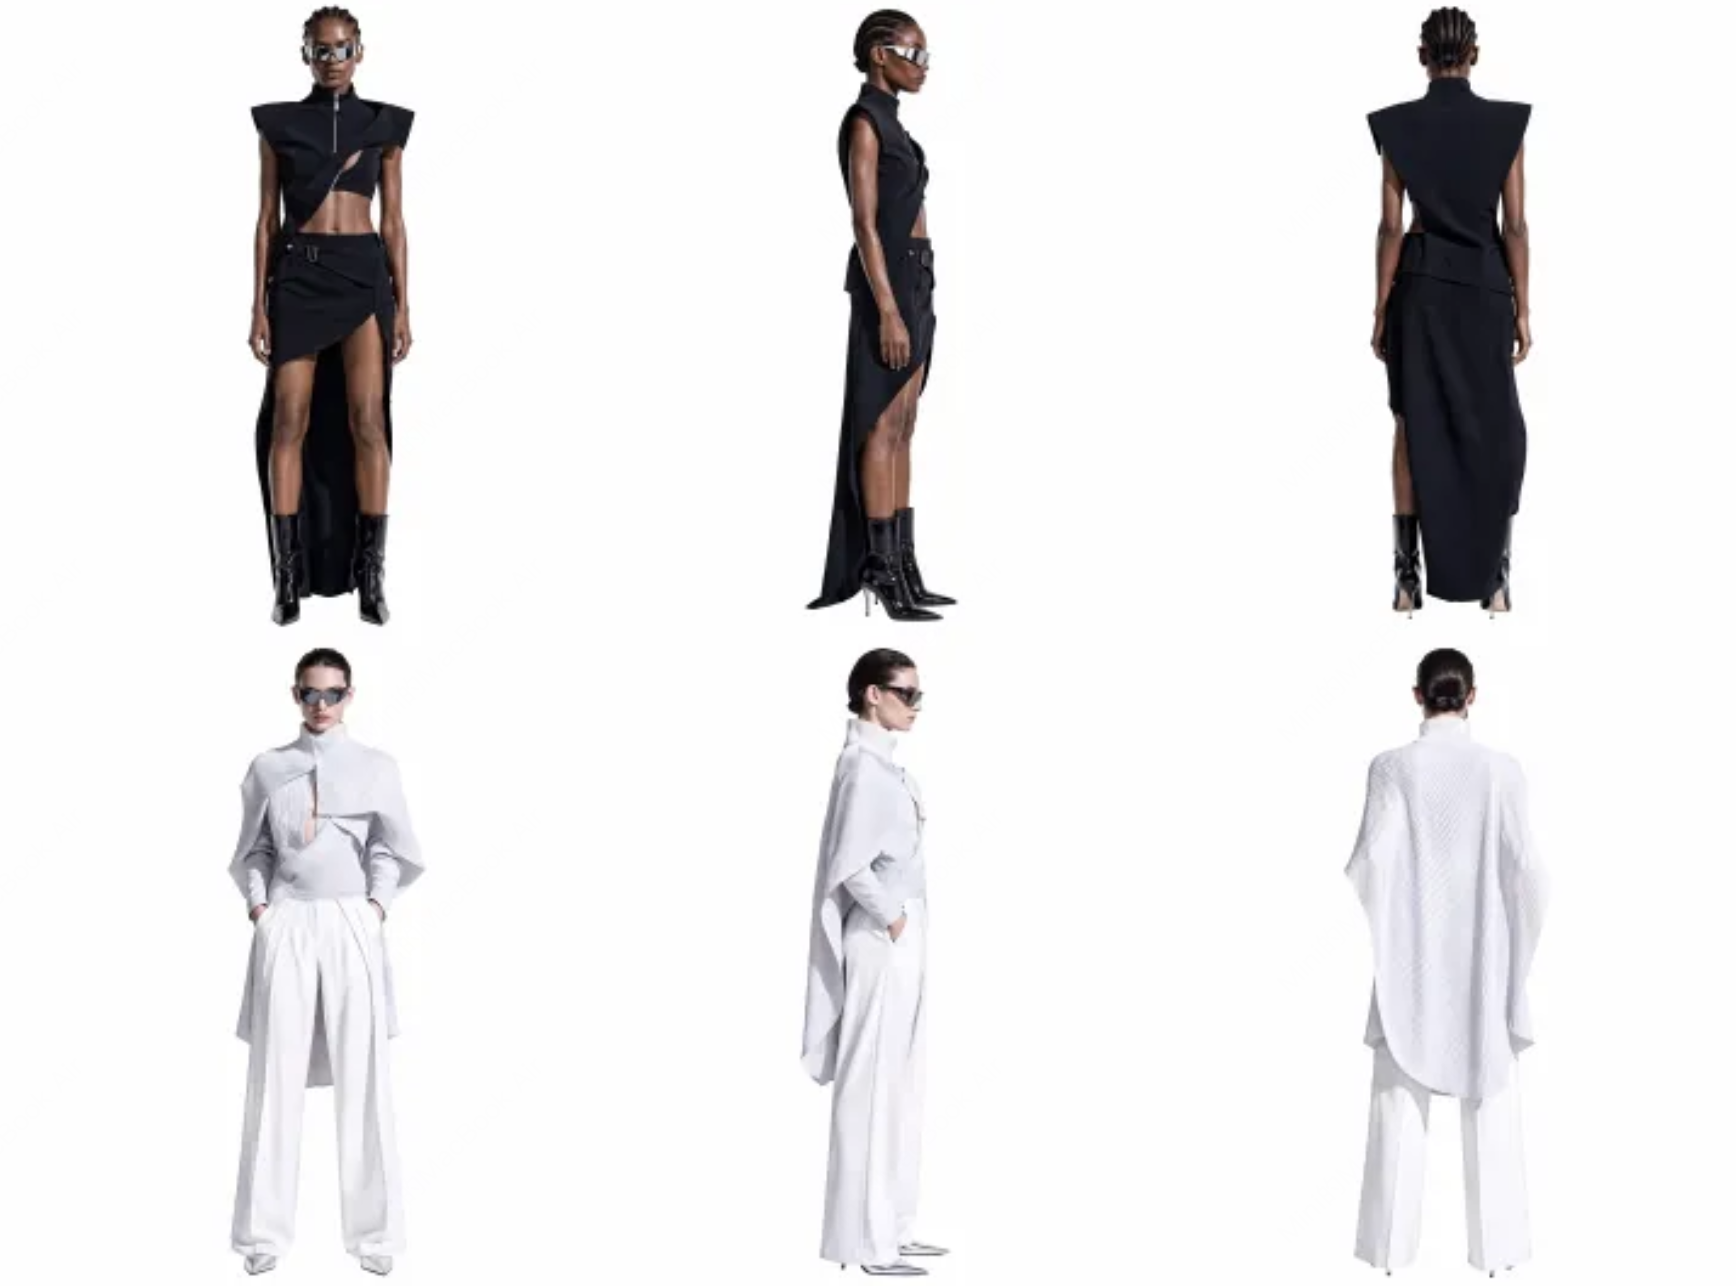
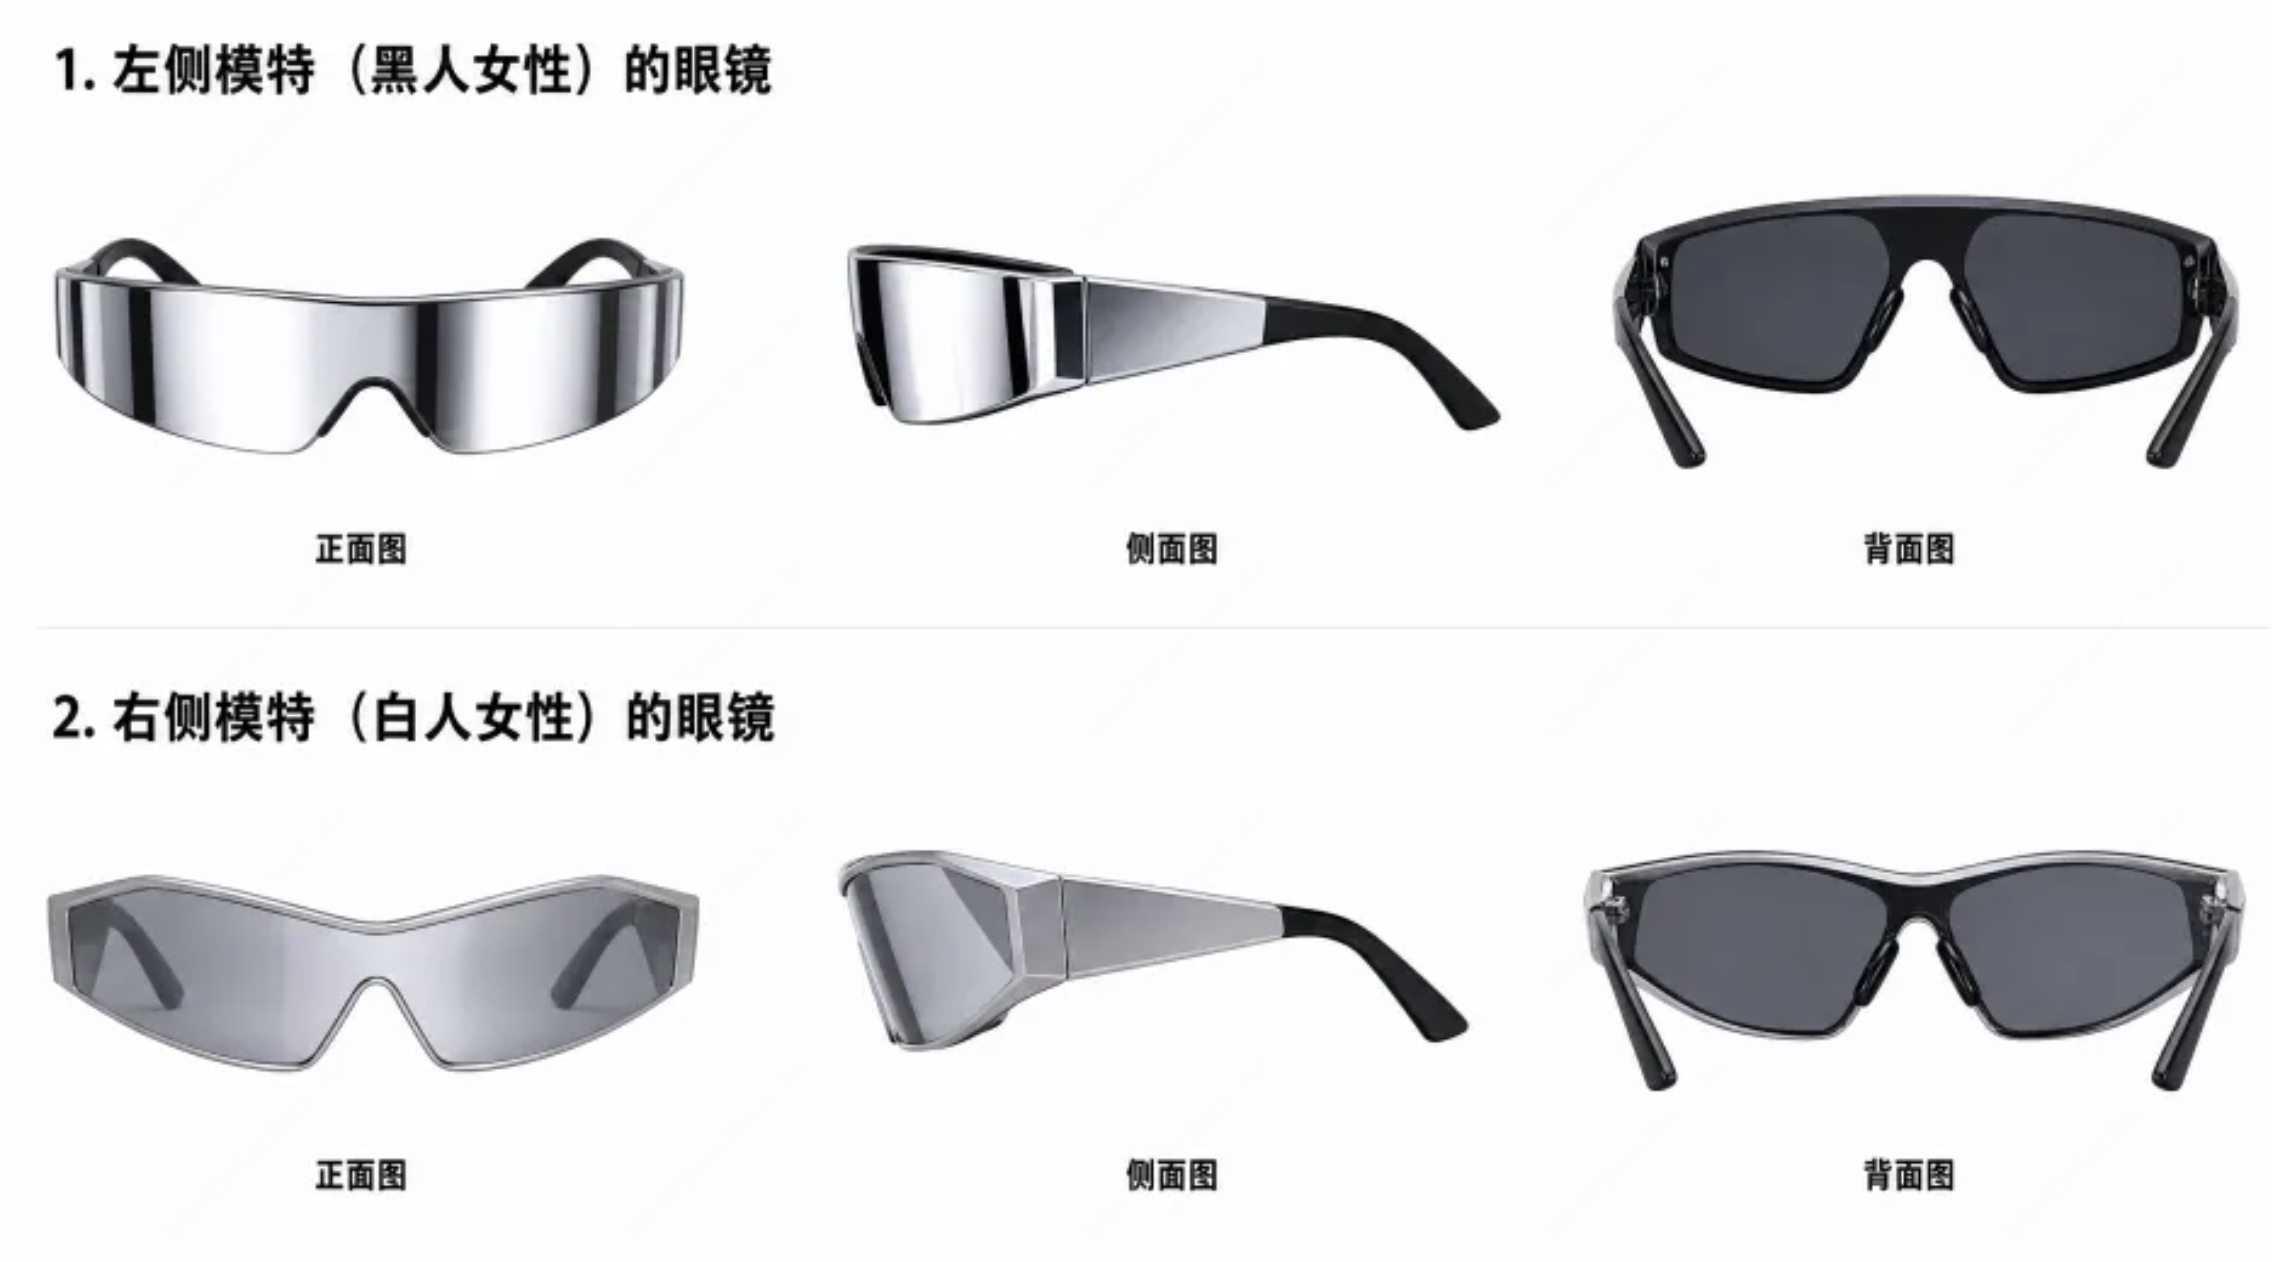
Obiettivo di produzione: Pubblicità di occhiali di alta moda in 9:16. L’immagine a figura intera della persona è responsabile della corporatura e della camminata, l’immagine di riferimento del viso è responsabile dei tratti facciali e del trucco, e l’immagine del prodotto è responsabile delle curve avvolgenti, dei riflessi delle lenti, delle aste e del profilo a occhio di gatto. Questo caso mette alla prova contemporaneamente i primi piani del volto, la coerenza tra più persone, la relazione di indossamento e la struttura geometrica del prodotto.| Riferimento di modella e styling | Riferimento dei dettagli del viso | Riferimento del prodotto occhiali |
|---|---|---|
 |  |  |
Da testo a video
Quando è presente un solo elemento di testo, si tratta di generazione da testo a video. È adatta per generare direttamente immagini a partire da creatività, sceneggiature o descrizioni delle inquadrature. Il prompt può essere organizzato nell’ordine “soggetto + azione + scena + inquadratura + luce + suono”."async": true alla richiesta, l’interfaccia restituisce immediatamente:
Da immagine del primo fotogramma a video
Contrassegnando un’immagine comefirst_frame, il modello inizierà a generare da quell’immagine. È adatto per animare naturalmente poster, immagini di prodotti, tavole di progettazione dei personaggi e opere fotografiche.
Video con fotogramma finale e con fotogrammi iniziale e finale
Fornire sololast_frame consente al modello di generare naturalmente fino all’inquadratura specificata; fornire contemporaneamente first_frame e last_frame permette di controllare chiaramente il punto di partenza e quello di arrivo. È adatto per transizioni, cambiamenti di forma, processi di crescita o confronti prima e dopo di prodotti.
Video generati con riferimenti multimodali
I materiali di riferimento possono essere combinati: le immagini di riferimento controllano l’aspetto di personaggi o prodotti, i video di riferimento controllano le azioni e i movimenti di camera, gli audio di riferimento controllano il timbro dei dialoghi, la musica o il ritmo di montaggio. Nel prompt dovrebbe essere chiaramente specificato cosa deve controllare ciascun tipo di materiale, evitando di caricare soltanto i materiali senza fornire relazioni di riferimento.Notifiche di callback
Il passaggio dicallback_url abilita automaticamente la modalità asincrona: l’interfaccia di creazione restituisce immediatamente task_id e trace_id e, al completamento dell’attività, invia tramite POST il risultato finale a quell’indirizzo, con una struttura coerente con la risposta di interrogazione dell’attività.
Gli stati finali nel callback sono succeeded, failed o cancelled. Anche se si utilizza il callback, è consigliabile salvare task_id, per poter effettuare interrogazioni attive o recuperare le notifiche mancate.
Errori comuni
Nella risposta sincrona,
task.status: succeeded indica che il video è stato generato; la conferma asincrona indica solo che l’attività è entrata nella coda. L’addebito avviene solo se l’attività ha successo definitivamente; l’interrogazione delle attività è gratuita e non comporta addebiti ripetuti.
H3 Max
MiniMax-H3-Max supporta 480P o 768P e durate intere di 5–15 secondi. L’input audio non comporta costi aggiuntivi, le prime 2 immagini sono gratuite e le parti eccedenti vengono addebitate immagine per immagine; i video di riferimento vengono addebitati in base alla durata effettiva dell’input. Questo modello non supporta il 2K.