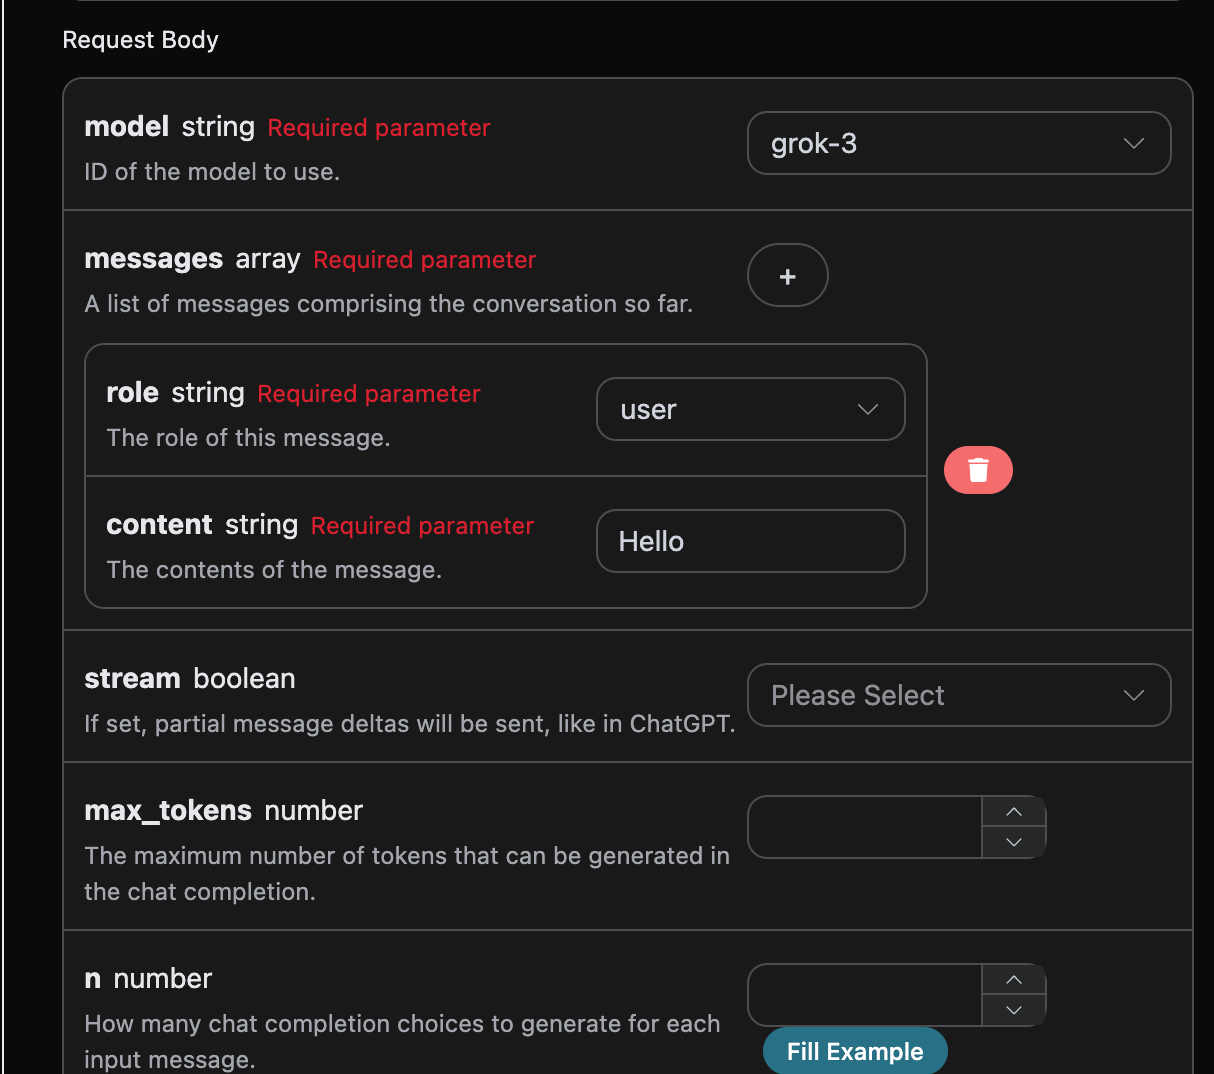
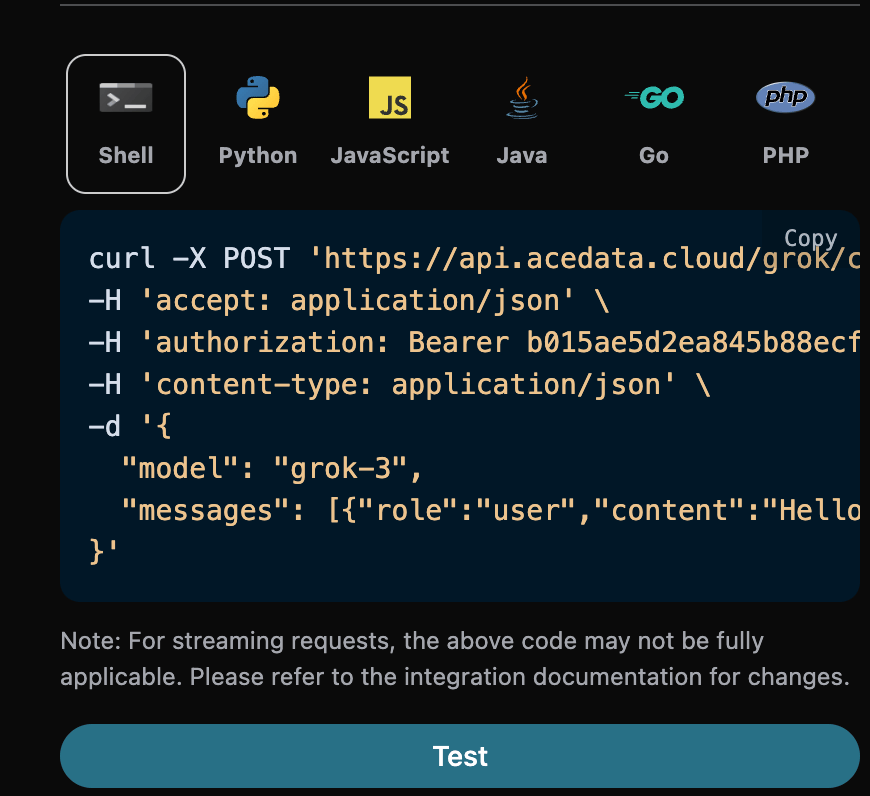
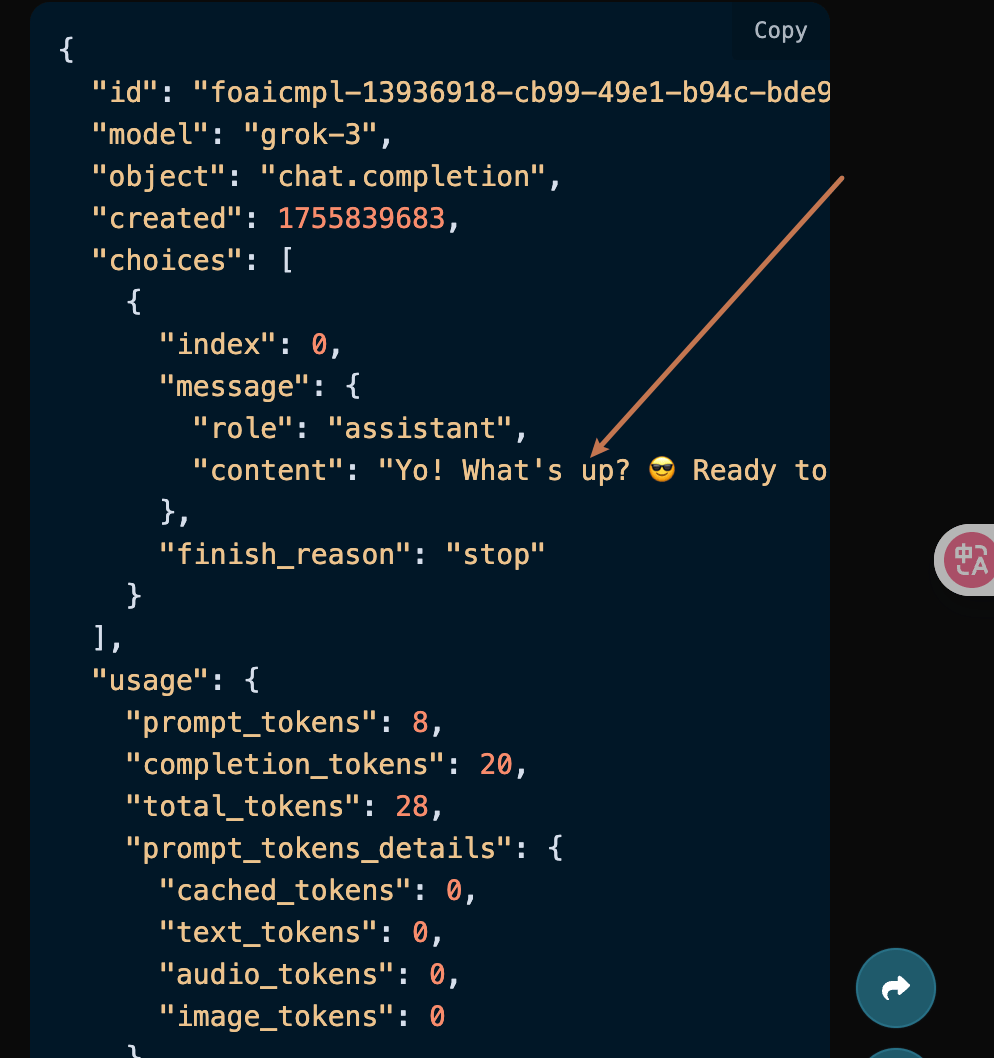
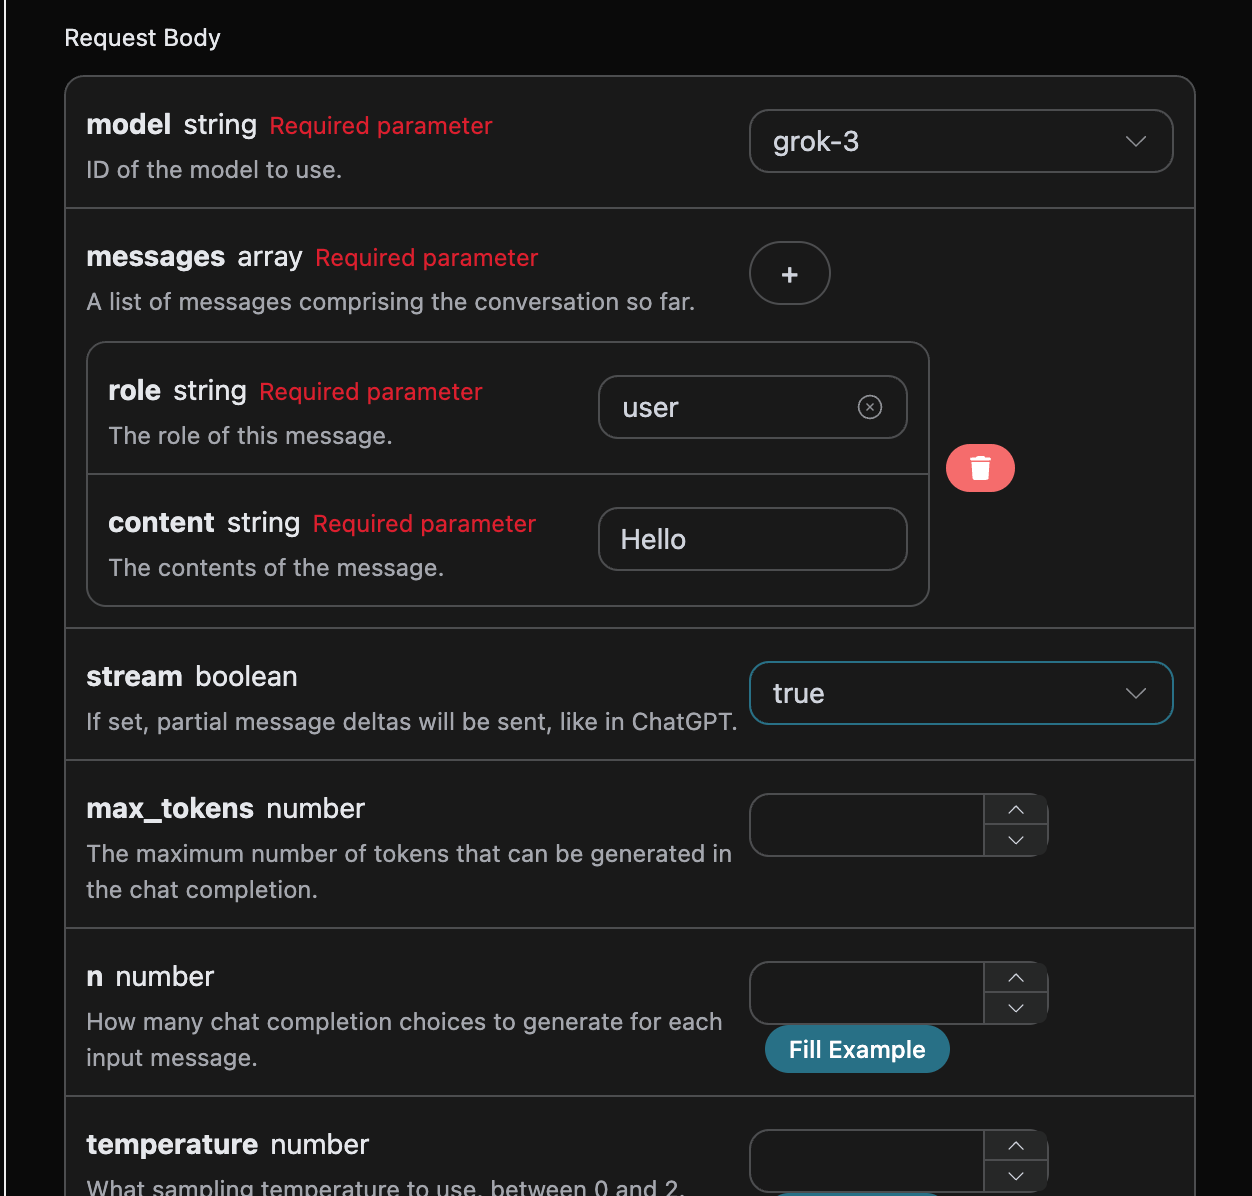
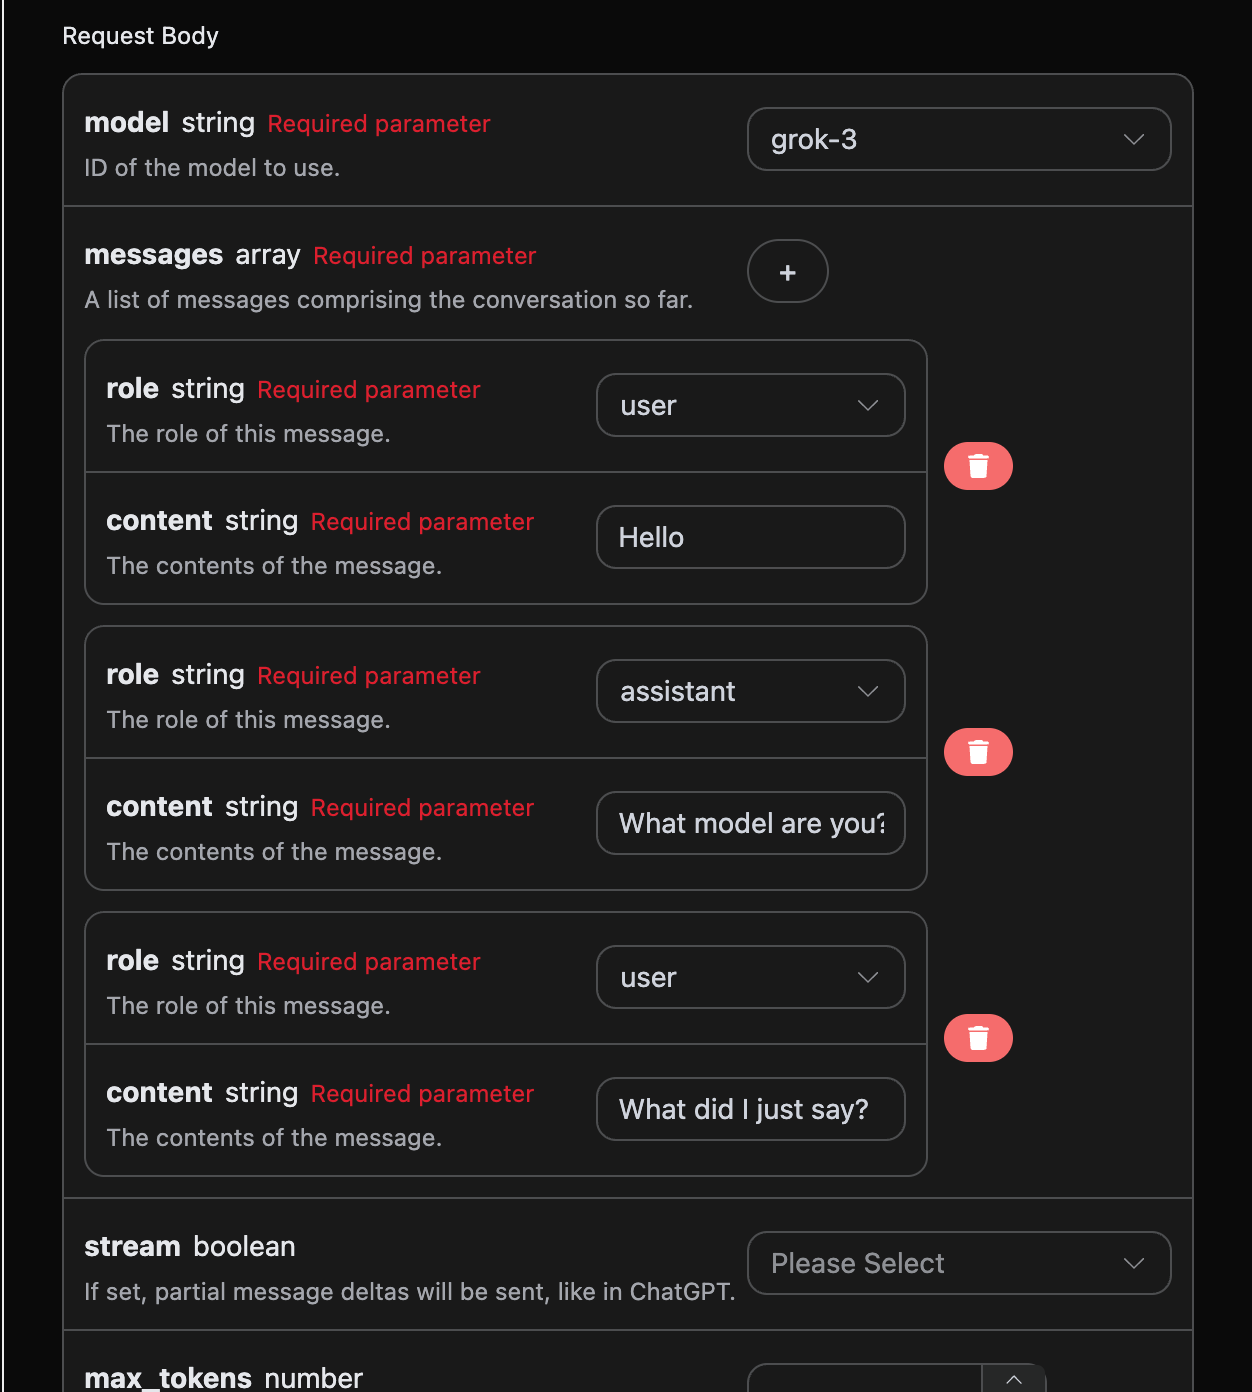
data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"role": "assistant"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "Yo, "}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "what"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data:
{"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "'s g"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "ood?"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": " Rea"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "dy t"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "o di"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "ve i"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "nto "}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "cosa"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "mai"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": " tu"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "'sei "}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "in"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "un"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "stagno"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "?"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {}, "logprobs": null, "finish_reason": "stop", "index": 0}], "usage": {"prompt_tokens": 0, "completion_tokens": 0, "total_tokens": 0, "prompt_tokens_details": {"cached_tokens": 0, "text_tokens": 0, "audio_tokens": 0, "image_tokens": 0}, "completion_tokens_details": {"text_tokens": 0, "audio_tokens": 0, "reasoning_tokens": 0}, "input_tokens": 0, "output_tokens": 0, "input_tokens_details": null}}

data:
{"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": "", "choices": [], "usage": {"prompt_tokens": 8, "completion_tokens": 18, "total_tokens": 26, "prompt_tokens_details": {"cached_tokens": 0, "text_tokens": 0, "audio_tokens": 0, "image_tokens": 0}, "completion_tokens_details": {"text_tokens": 0, "audio_tokens": 0, "reasoning_tokens": 0}, "input_tokens": 0, "output_tokens": 0, "input_tokens_details": null}}

dati: [FATTO]


 Se non hai ancora effettuato il login o registrato, verrai automaticamente reindirizzato alla pagina di login che ti invita a registrarti e accedere, una volta completato, verrai riportato automaticamente alla pagina corrente.
Un API Token è sufficiente per accedere a tutti i servizi della piattaforma, non è necessario richiederne uno separato per ogni servizio. La prima richiesta include un credito gratuito, che consente di provare senza costi; quando il credito è insufficiente, puoi ricaricare il saldo generale nel pannello di controllo.