

DieSuno unterstützt jetztlyric- undstyle-Limits in der obigen Tabelle sind die Obergrenzen im benutzerdefinierten Modus (customisttrue). Im nicht benutzerdefinierten Inspirationsmodus (customistfalse) wird nurpromptausgefüllt, dessen Längenbegrenzung bei 500 Zeichen liegt (für alle Modelle identisch).
chirp-v6, chirp-v6-wild und chirp-v6-mini. Die Verwendung von chirp-v6 wird empfohlen; alte Modellnamen bleiben weiterhin kompatibel.
Suno selbst stellt jedoch keine API bereit. AceDataCloud bietet eine Reihe von Suno-APIs, die die offizielle Suno-Anbindung simulieren und die gewünschte Musik bequem und schnell generieren können.
Beantragung und Nutzung
Um die Suno Audios Generation API zu verwenden, rufen Sie zunächst die Ace Data Cloud-Konsole auf, um Ihren API-Token zu erhalten und ihn als Reserve aufzubewahren. Wenn Sie noch nicht angemeldet oder registriert sind, werden Sie automatisch zur Anmeldeseite weitergeleitet, um sich zu registrieren und anzumelden. Nach Abschluss kehren Sie automatisch zur aktuellen Seite zurück.
Ein API-Token kann alle Dienste der Plattform aufrufen; es ist nicht erforderlich, für jeden Dienst separat einen Antrag zu stellen. Bei der ersten Beantragung wird ein kostenloses Kontingent vergeben, das kostenlos getestet werden kann; bei unzureichendem Kontingent kann in der Konsole ein allgemeines Guthaben aufgeladen werden.
📘 Vollständige Dokumentation: Suno Audios Generation API →
Grundlegende Nutzung
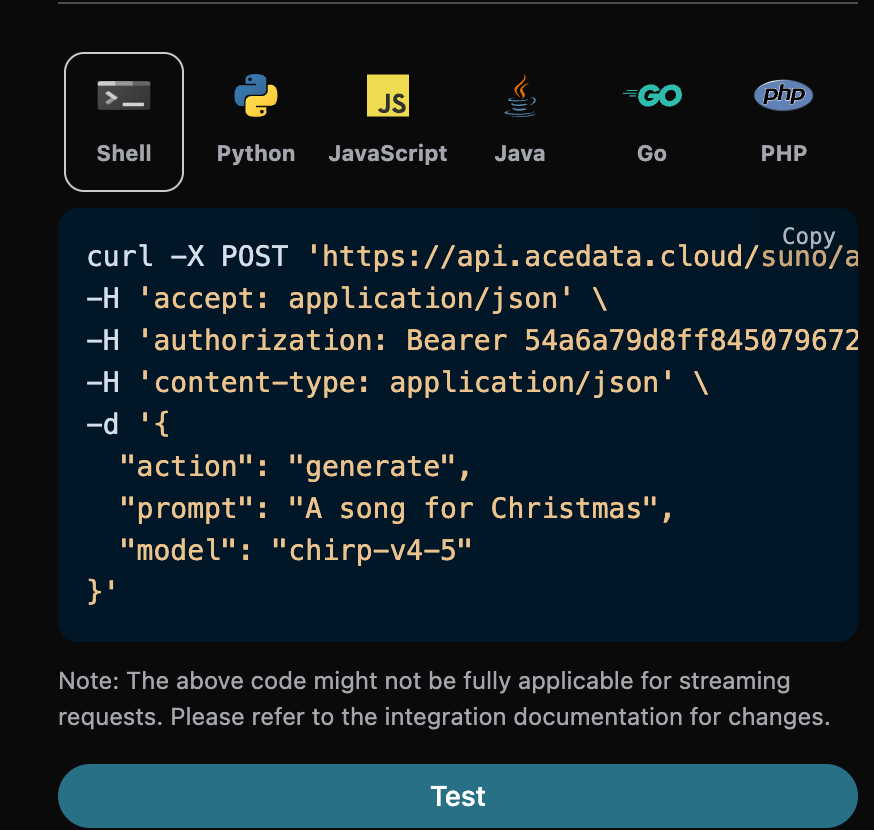
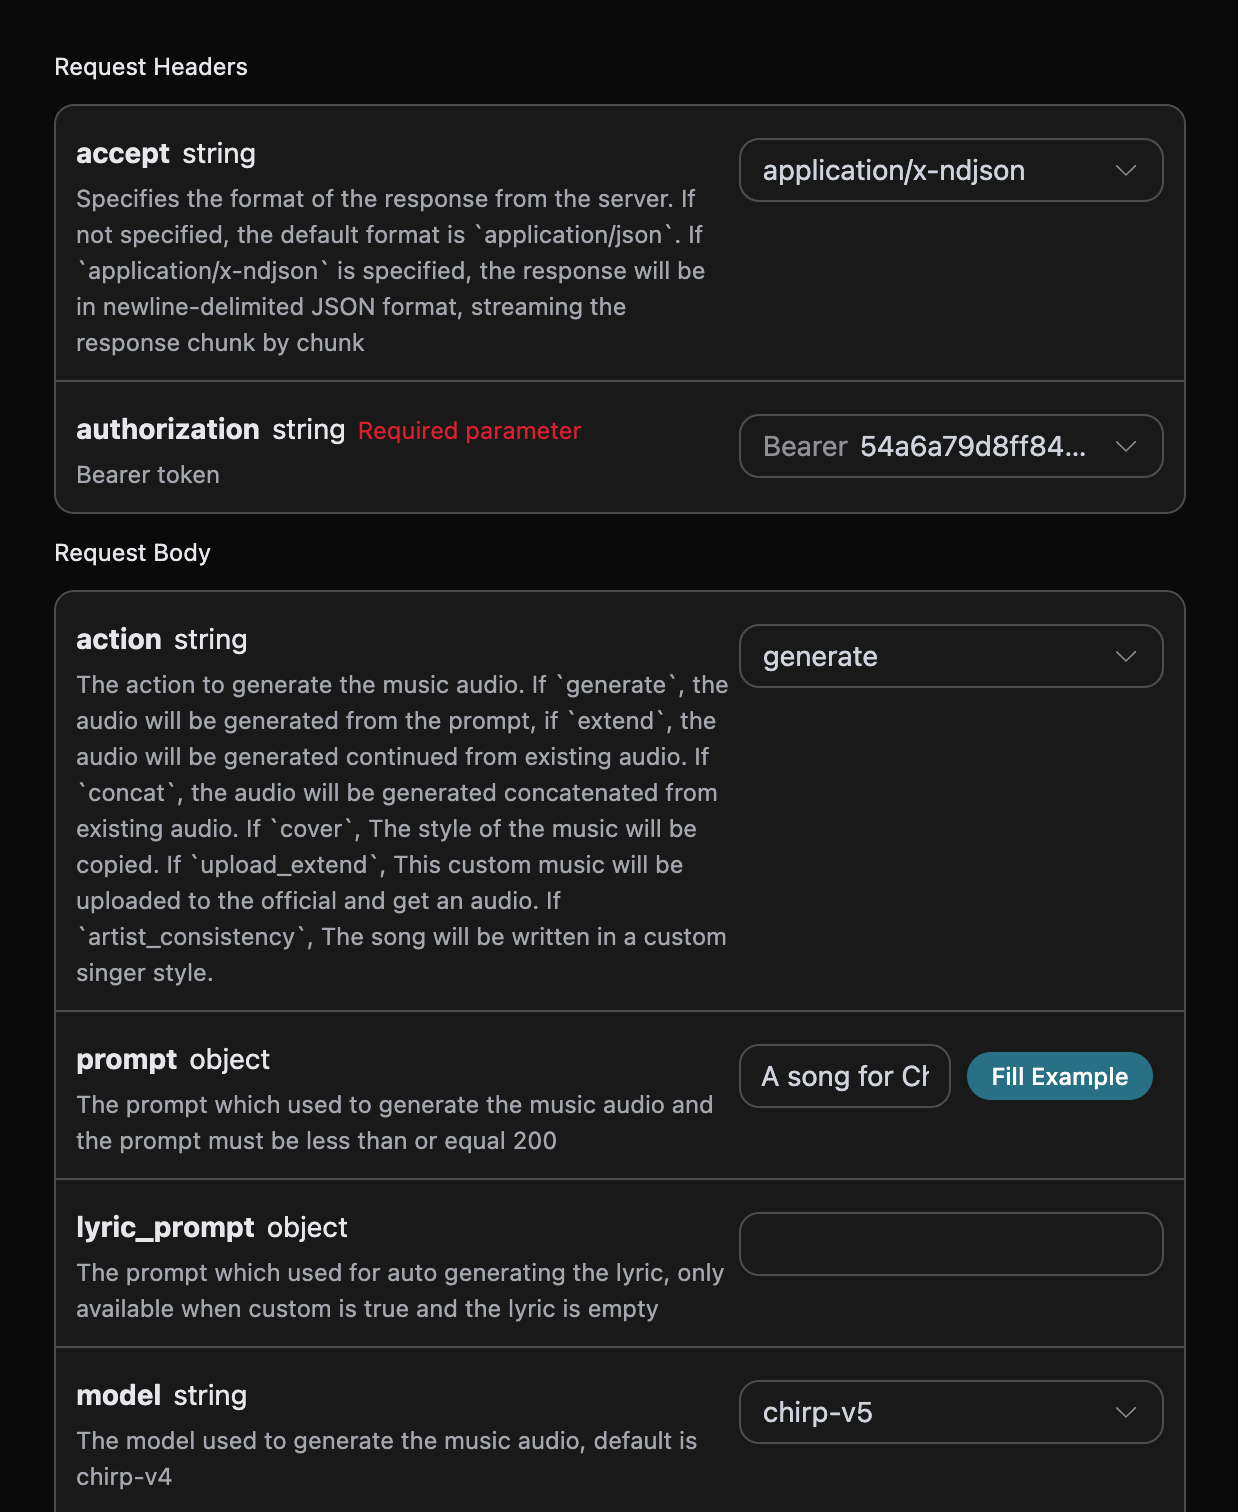
Welche Songs Sie auch immer möchten, Sie können beliebig einen Text eingeben. Wenn ich beispielsweise einen Song über Weihnachten generieren möchte, kann icha song for Christmas eingeben, wie in der Abbildung gezeigt:
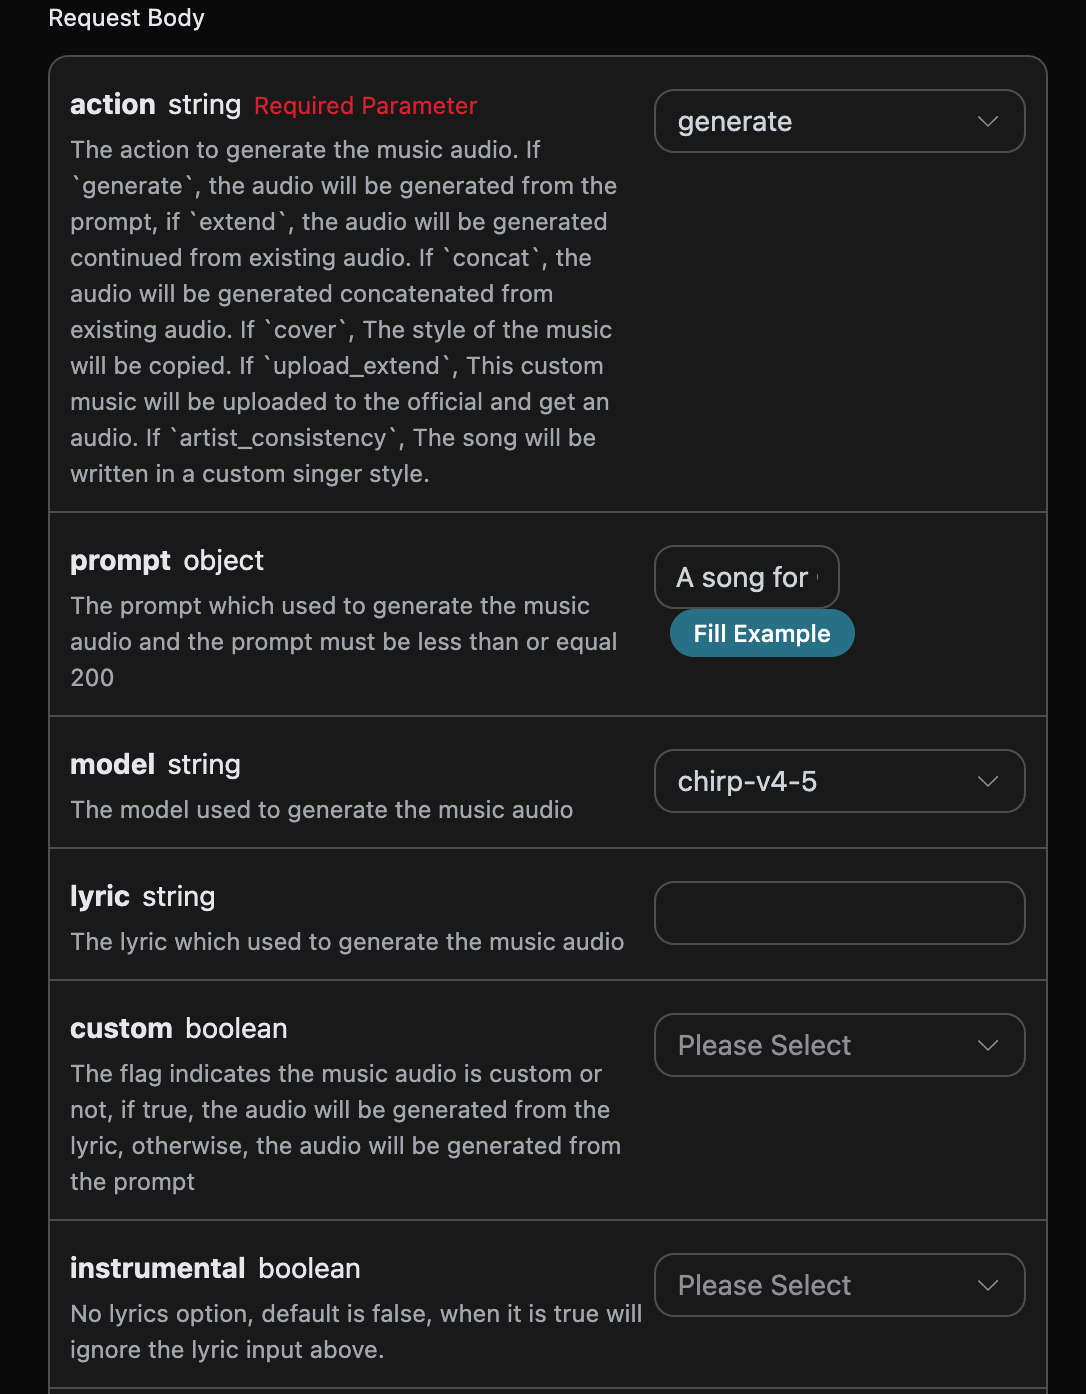
accept: Welches Format des Antwortergebnisses empfangen werden soll; hier wirdapplication/jsoneingetragen, also das JSON-Format.authorization: Der Schlüssel zum Aufrufen der API, der nach der Beantragung direkt über ein Dropdown ausgewählt werden kann.
action: Audio task type, default isgenerate. Supports operations such as generation, continuation, cover, concatenation, stem separation, adding audio tracks, extracting specified audio tracks, generating sound effects, and adjusting speed, all called throughPOST /suno/audios.prompt: Suno’s official inspiration mode prompt (effective whencustomisfalse), maximum 500 characters.model: The model for this music generation task. The v6 series includeschirp-v6,chirp-v6-wild, andchirp-v6-mini; old model names remain compatible.max_mode: Enhanced generation mode.generateis enabled only when bothcustomandmax_modearetrue, costing 1.12 Credits;add_stemcan be enabled directly, costing 1.344 Credits. When disabled or omitted, they cost 0.56 and 0.672 Credits respectively.variety: Diversity intensity of generated results, options includeoff,normal,high,extra, andmax. Only used forgenerateandadd_stem; passing it for other actions returns 400.lyric: Lyrics content for Suno’s official custom mode.chirp-v3-5andchirp-v4allow a maximum of 3000 characters;chirp-v4-5and above (includingchirp-v5andchirp-v5-5) allow a maximum of 5000 characters.custom: Whether to use custom mode, default is:false.instrumental: The instrumental music option for Suno’s official inspiration mode.title: Music title for Suno’s official custom mode.chirp-v3-5andchirp-v4allow a maximum of 80 characters;chirp-v4-5and above allow a maximum of 100 characters.style: Music style for Suno’s official custom mode.chirp-v3-5andchirp-v4allow a maximum of 200 characters;chirp-v4-5and above (includingchirp-v5andchirp-v5-5) allow a maximum of 1000 characters.negative_tags: Music styles or genres to exclude from generated results in custom mode (whencustomistrue).audio_weight: Influence weight of audio or voice characteristics, ranging from 0 to 1, where0is also a valid value. It can be used for operations such as generation, continuation, cover, adding audio tracks, and voice consistency; without reference audio or voice characteristics, the model may weaken or ignore this value.audio_id: The ID of the reference music.overpainting_start/overpainting_end: The start and end times for adding vocals to existing instrumental music, in seconds.underpainting_start/underpainting_end: The start and end times for adding accompaniment to a cappella vocals, in seconds.persona_id: The song ID of the artist.continue_at: Continuation boundary, in seconds. For example, 213.5 means generating the subsequent segment starting at 3 minutes 33.5 seconds.lyricandstyleonly guide new content after the boundary and will not replace lyrics or singing before the boundary in the source audio.style_influence: Style influence in custom mode, ranging from 0 to 1. A larger value usually matches the selected style more closely;0is passed as a valid value.replace_section_end: The final time of the replacement segment.replace_section_start: The start time of the replacement segment.vocal_gender: Controls female and male vocal preferences, withffor female vocals andmfor male vocals, effective for models 4.5 and above; it is a preference option and strict adherence is not guaranteed.weirdness: Weirdness in custom mode, ranging from 0 to 1. A larger value is usually more creative and experimental;0is passed as a valid value.duration: Desired song duration, in seconds, must be an integer, ranging from 10 to 360. This parameter is used for song generation in custom mode (whencustomistrue). It is an inclination hint rather than a hard constraint: the model will refer to it but does not guarantee reaching it. The actual finished duration is subject to thedurationfield in the response and is usually shorter than the desired value.
Scope of Advanced Parameters
The platform validates parameter types and value ranges, but will not reject these optional adjustment options solely because the action is different; specific effects are determined by the operation, mode, and model.
lyric_prompt: Prompt for generating lyrics, effective if and only ifcustomistrueandlyrichas not been passed.callback_url: URL that needs result callbacks.async: Optional. When set totrue, the API immediately returnstask_id; there is no need to providecallback_url, and the result can subsequently be obtained by polling through the corresponding task query API.
- success:Ob die Generierung erfolgreich war; bei Erfolg ist der Wert
true, andernfallsfalse - data:Ist eine Liste, die detaillierte Informationen zu den generierten Songs enthält.
- state:Der Generierungsstatus des Songs umfasst hauptsächlich vier Arten, im Einzelnen wie folgt:
- succeeded:Generierung erfolgreich
- pending:In der Warteschlange
- running:Wird ausgeführt
- error:Fehlgeschlagen
- id:Song-ID
- title:Der Titel des Songs
- image_url:Das Coverbild des Songs
- lyric:Der Liedtext des Songs
- audio_url:Die endgültige Audioadresse des Songs. Die Plattform gibt bevorzugt die Ace Data Cloud CDN-Adresse zurück; falls die Persistenz fehlschlägt, kann die ursprüngliche Medienadresse zurückgegeben werden. Bitte laden Sie sie rechtzeitig herunter.
- video_url:Die Videodatei des Songs; beim Öffnen handelt es sich um ein mp4-Video.
- created_at:Die Erstellungszeit
- model:Das verwendete Modell, in der Regel das neueste v3-Modell
- style:Der Stil
- state:Der Generierungsstatus des Songs umfasst hauptsächlich vier Arten, im Einzelnen wie folgt:
Benutzerdefinierte Generierung
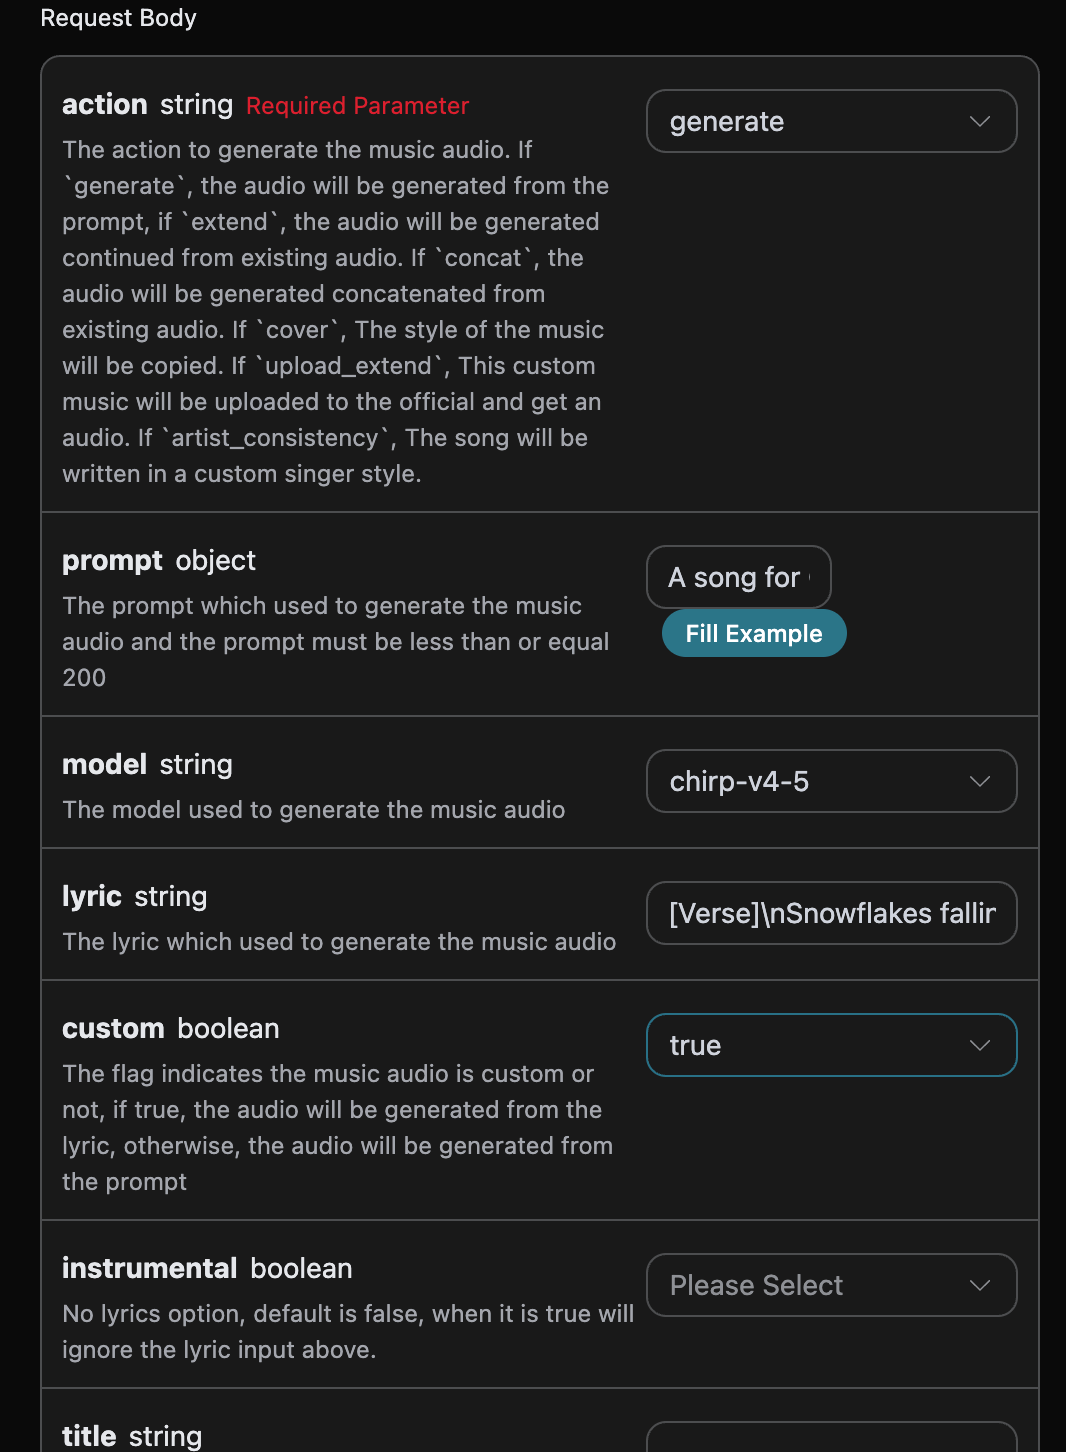
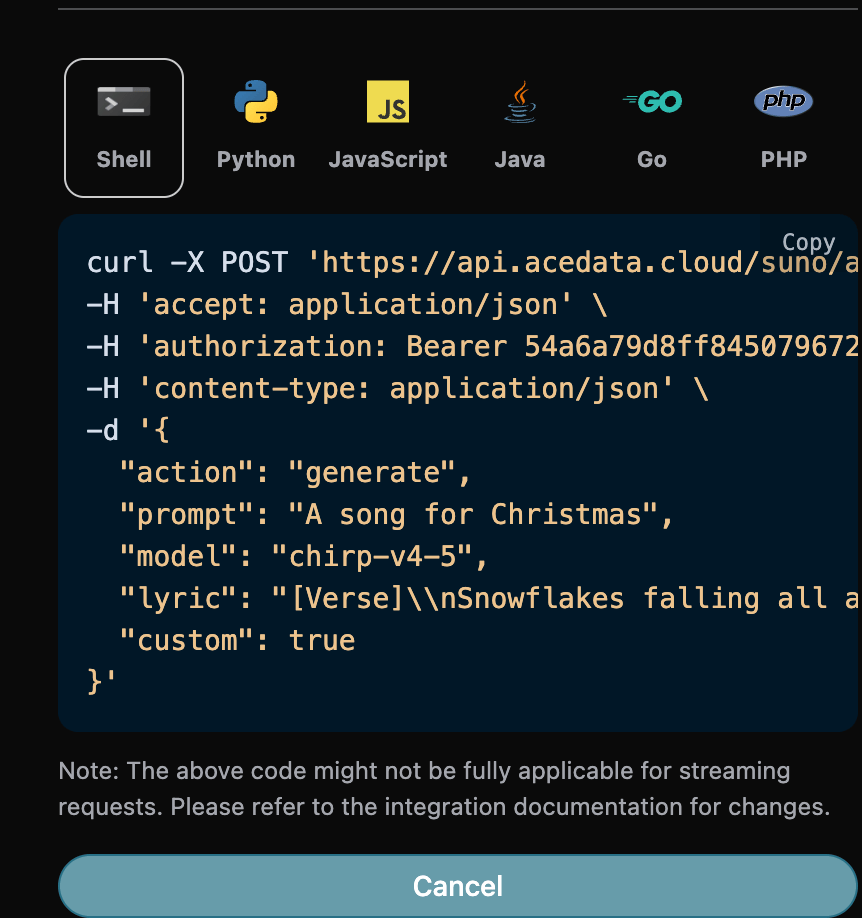
Wenn Sie Liedtexte benutzerdefiniert generieren möchten, können Sie Liedtexte eingeben: Zu diesem Zeitpunkt kann das Feldlyric Inhalte wie die folgenden übergeben:
Hinweis: Das \n im Liedtext steht hier für einen Zeilenumbruch. Wenn Sie nicht wissen, wie Sie Liedtexte generieren, können Sie die von AceDataCloud bereitgestellte API zur Liedtextgenerierung verwenden, um Liedtexte über einen Prompt zu generieren. Die API ist Suno Lyrics Generation API.
Als Nächstes müssen wir Songs anhand von Liedtext, Titel und Stil benutzerdefiniert generieren und können die folgenden Inhalte angeben:
- lyric:Liedtext
- custom:Auf
truesetzen, steht für benutzerdefinierte Generierung; dieser Parameter ist standardmäßig false und steht für die Generierung mitprompt. - title:Der Titel des Songs.
- style:Der Stil des Songs, optional.
Benutzerdefinierte Generierungsfunktion für Sängerstil
Wenn Sie den Stil eines Sängers verwenden möchten, um ein Lied zu generieren, generieren Sie zunächst über die grundlegende Verwendung oben ein Lied.Am Ende müssen Sie dieses Lied als Sängerstil festlegen. Anschließend müssen Sie die Suno Persona API aufrufen, um anhand der offiziell generierten Musik-ID
audio_id einen ID-Parameter persona_id für einen Sängerstil zu generieren. Die spezifischen Parameter sind in der folgenden Abbildung dargestellt:
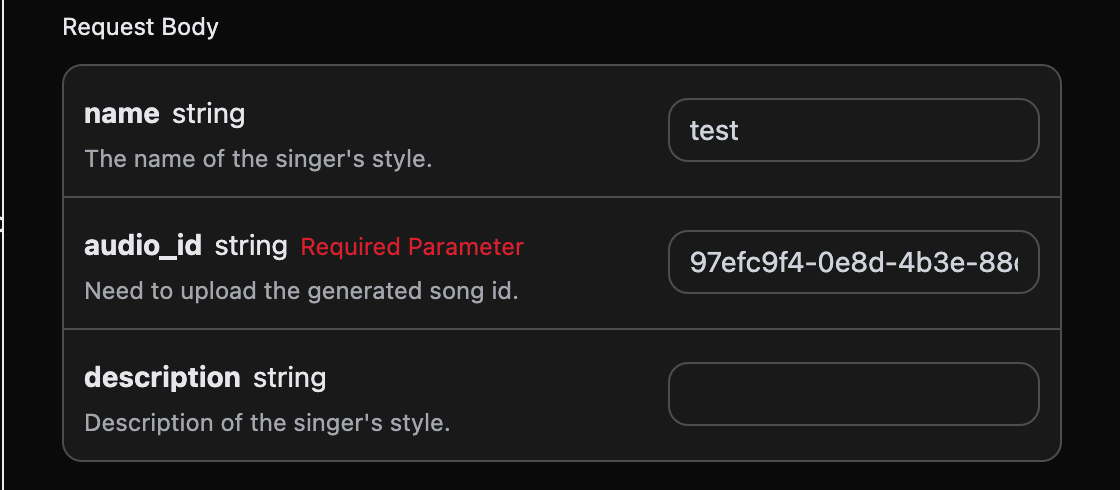
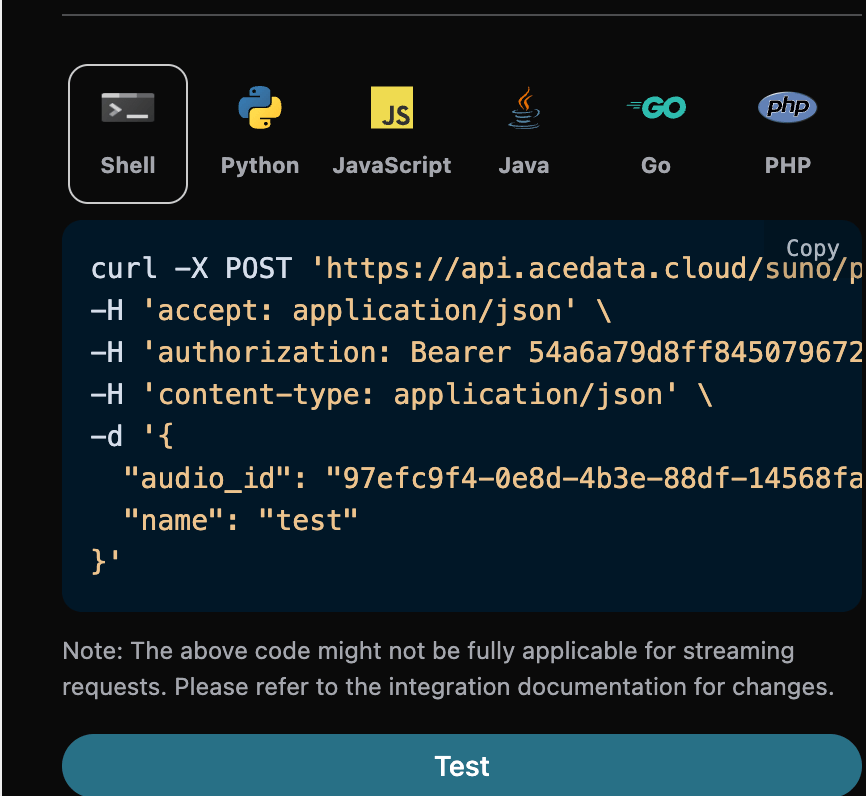
audio_id und persona_id, nämlich 97efc9f4-0e8d-4b3e-88df-14568fa1b11f bzw. e0d7319e-aa2a-44cb-b00a-916218d7cb0b, als Beispieldaten für diesen Vorgang. Anschließend können Sie den Parameter action auf artist_consistency setzen (wenn es sich um den neuen Sängerstil Persona-v2-vox handelt, muss action auf artist_consistency_vox gesetzt werden) und die ID des Liedes, dessen Generierung fortgesetzt werden soll, sowie die Sängerstil-ID eingeben. Ein Ausfüllbeispiel ist wie folgt:
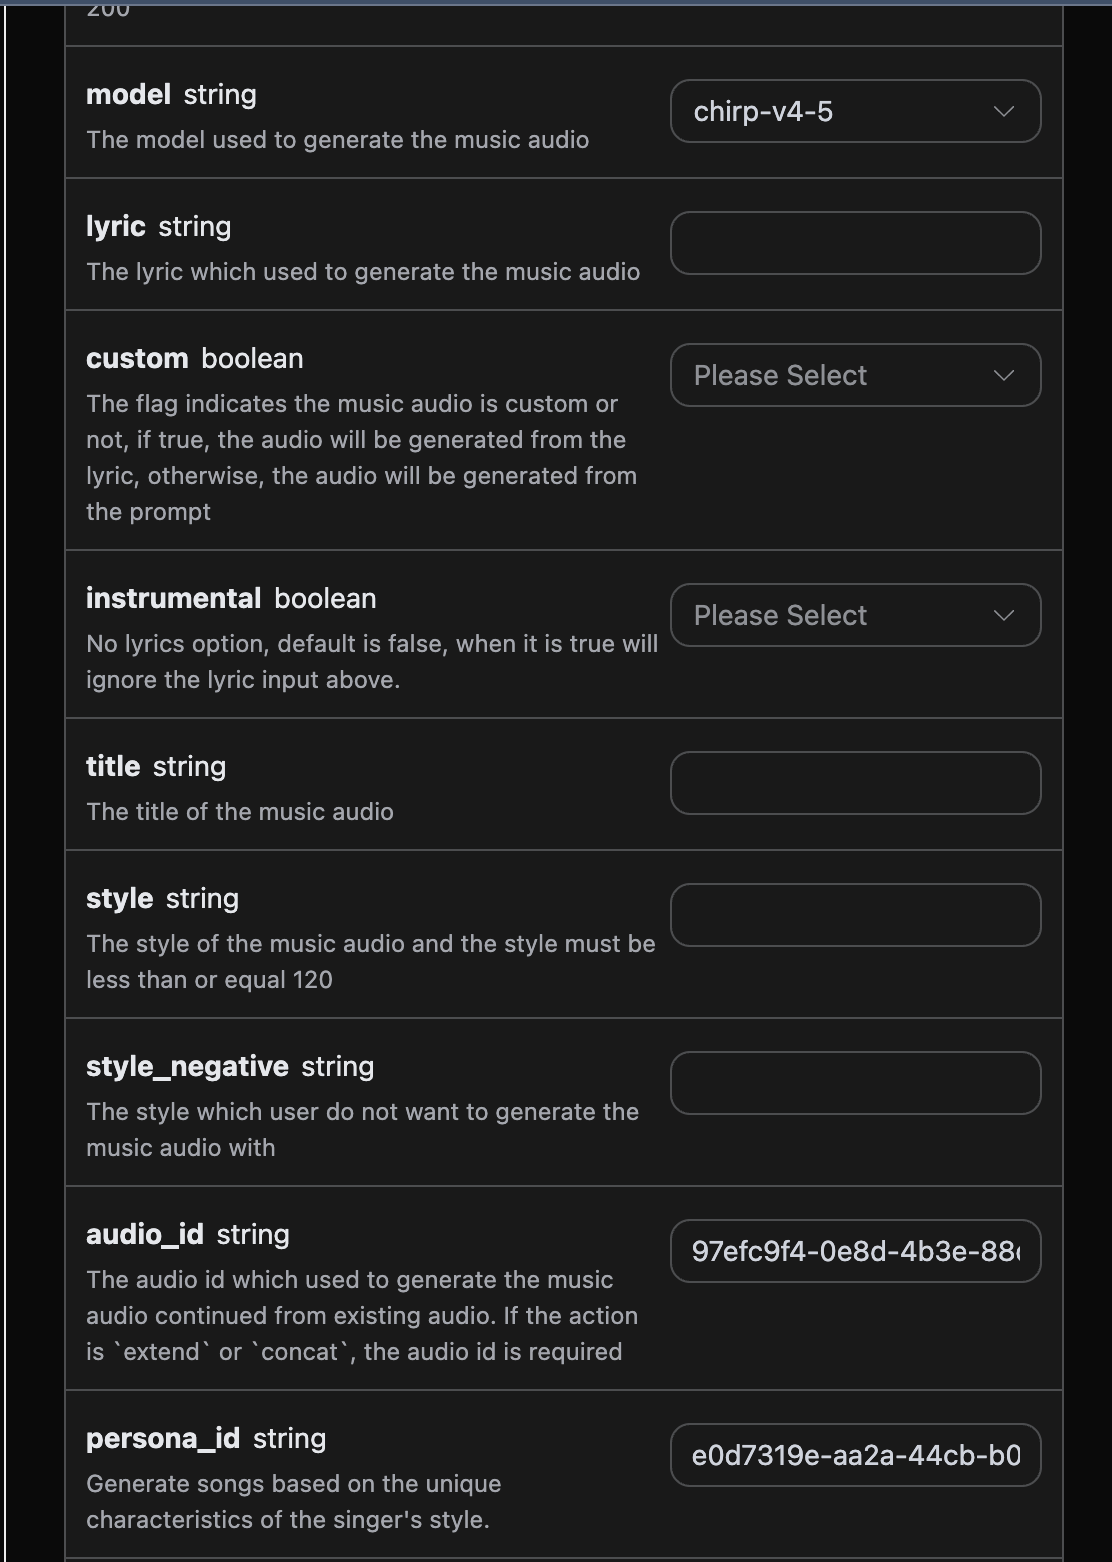
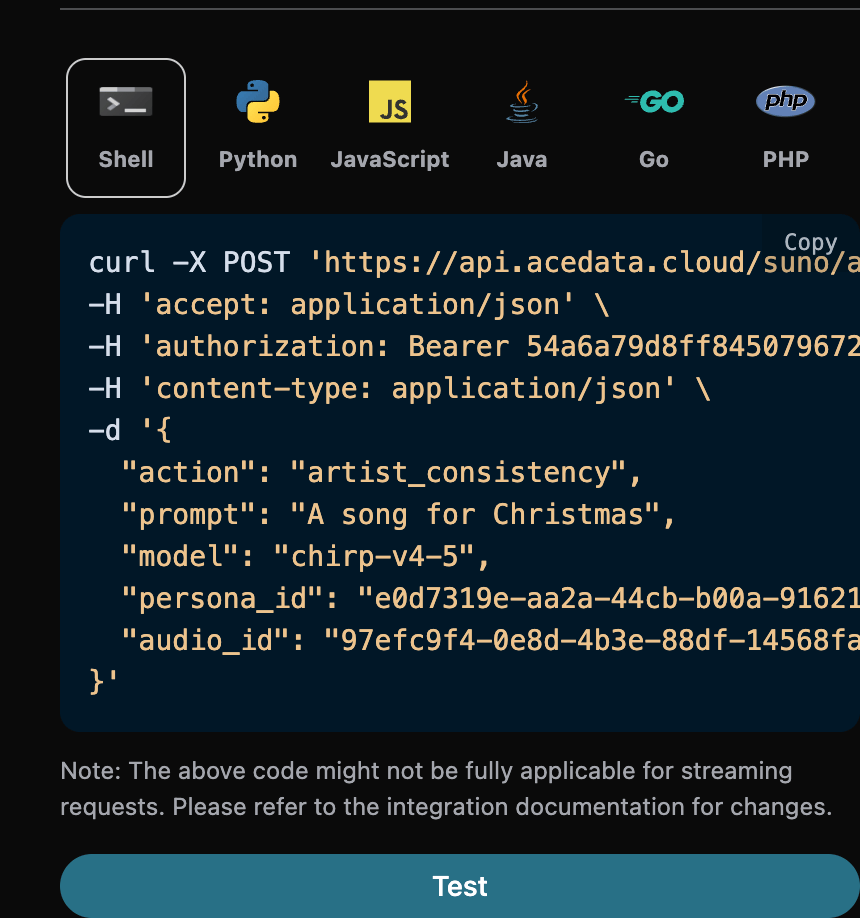
Funktion zum Fortsetzen der Generierung
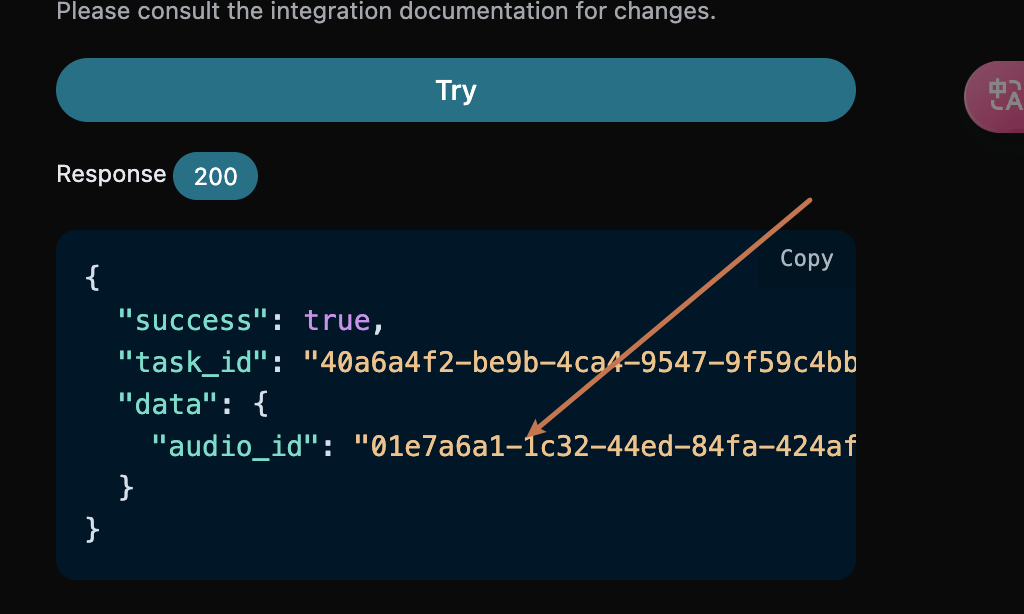
Wenn Sie ein bereits generiertes Suno-Lied weiter generieren möchten, können Sie den Parameteraction auf extend setzen und die ID des Liedes eingeben, dessen Generierung fortgesetzt werden soll. Die Lied-ID wird gemäß der grundlegenden Verwendung abgerufen. Wie oben zu sehen ist, lautet die Lied-ID zu diesem Zeitpunkt:
Hinweis: Die id in den Liedtexten hier ist die ID des nach der Generierung erstellten Liedes. Wenn Sie nicht wissen, wie man Lieder generiert, können Sie sich auf die grundlegende Verwendung oben beziehen, um ein Lied zu generieren.
Wenn Sie ein von Ihnen selbst hochgeladenes Lied weiter generieren möchten, können Sie den Parameter action auf upload_extend setzen und die ID des benutzerdefiniert hochgeladenen Liedes eingeben, dessen Generierung fortgesetzt werden soll. Die Lied-ID wird über die Suno Upload Generation API abgerufen, wie in der folgenden Abbildung dargestellt:
- lyric:Wird nur verwendet, um die Liedtexte des neu generierten Abschnitts nach
continue_atanzuleiten, und ersetzt nicht die Liedtexte im Quellaudio vor diesem Zeitpunkt. - custom:Wenn auf
truegesetzt, bedeutet dies benutzerdefinierte Generierung. Dieser Parameter ist standardmäßig false und bedeutet Generierung mitprompt. - style:Der Liedstil des fortzusetzenden Abschnitts, optional.
- continue_at:Grenze für die Fortsetzung, in Sekunden. Beispielsweise bedeutet 213.5, dass der nachfolgende Abschnitt ab 3 Minuten und 33,5 Sekunden generiert wird.
Ein Ausfüllbeispiel ist wie folgt:extendwird verwendet, um ein vorhandenes Lied nach hinten weiterzuschreiben, nicht um den Text eines ganzen Liedes zu ändern. Wenn Sie für das gesamte Lied von Anfang an neue Liedtexte verwenden möchten, verwenden Sie bittegenerate, um es erneut zu generieren; wenn Sie ein vorhandenes Lied als Referenz neu interpretieren möchten, können Siecoververwenden. Wenn ein vollständiger neuer Liedtext übergeben wird, werden die ursprünglichen Liedtexte vorcontinue_atweiterhin nicht ersetzt.
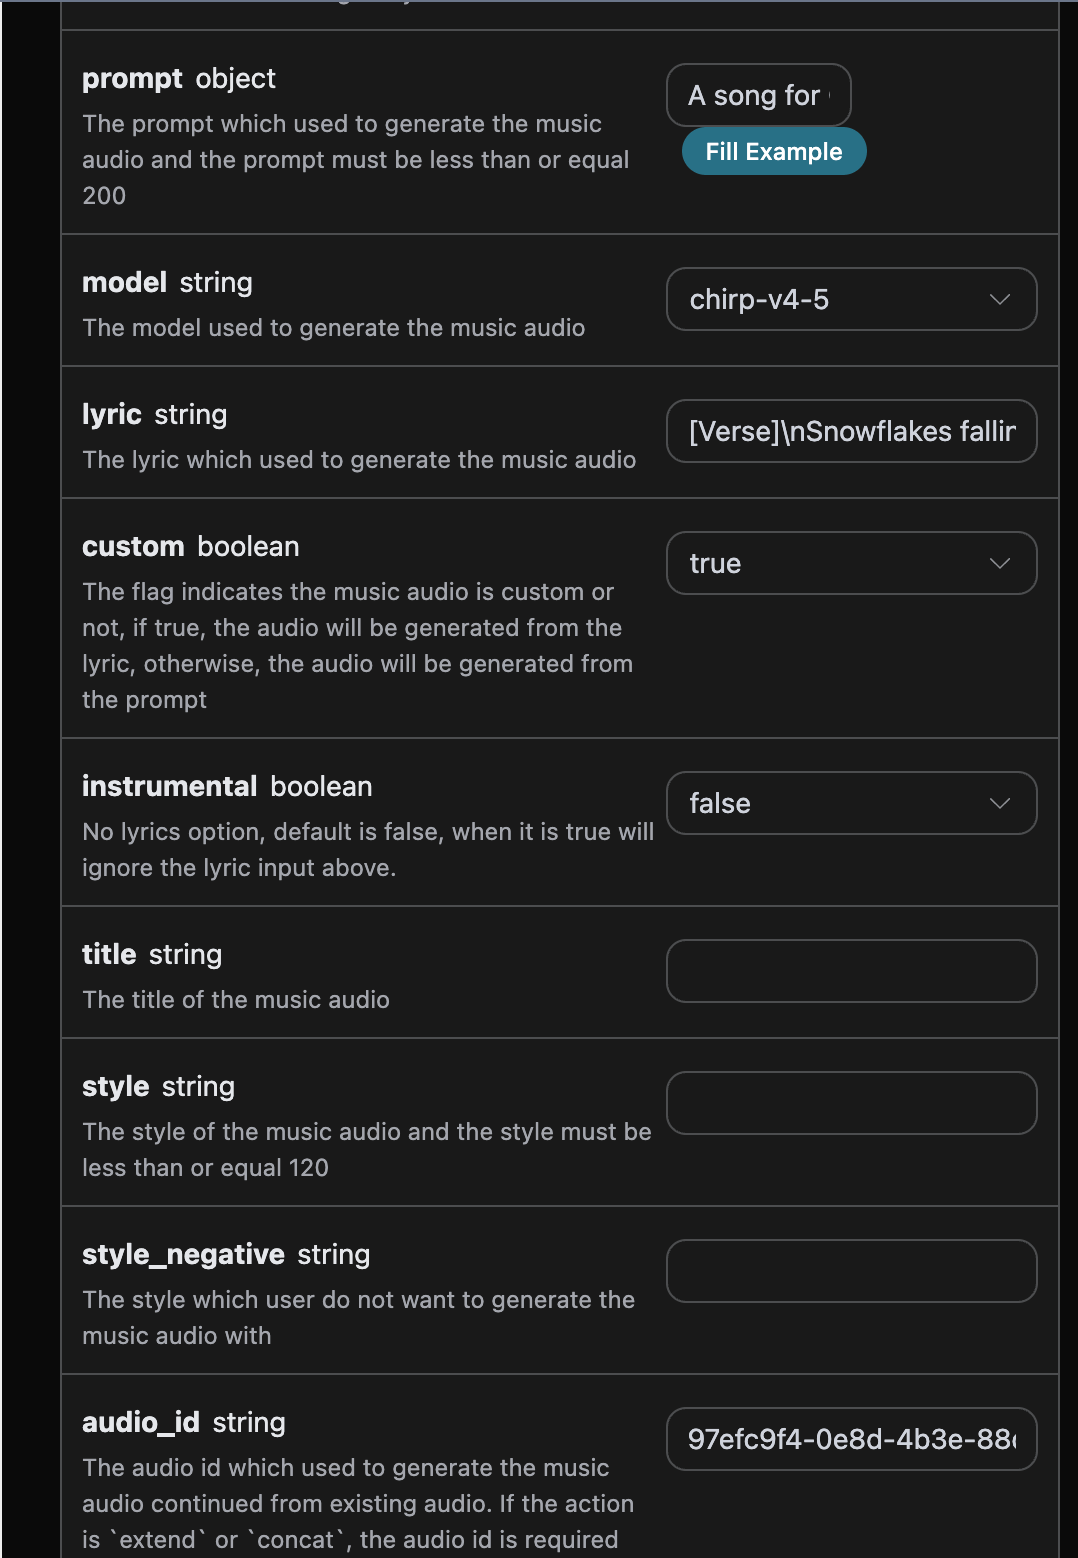
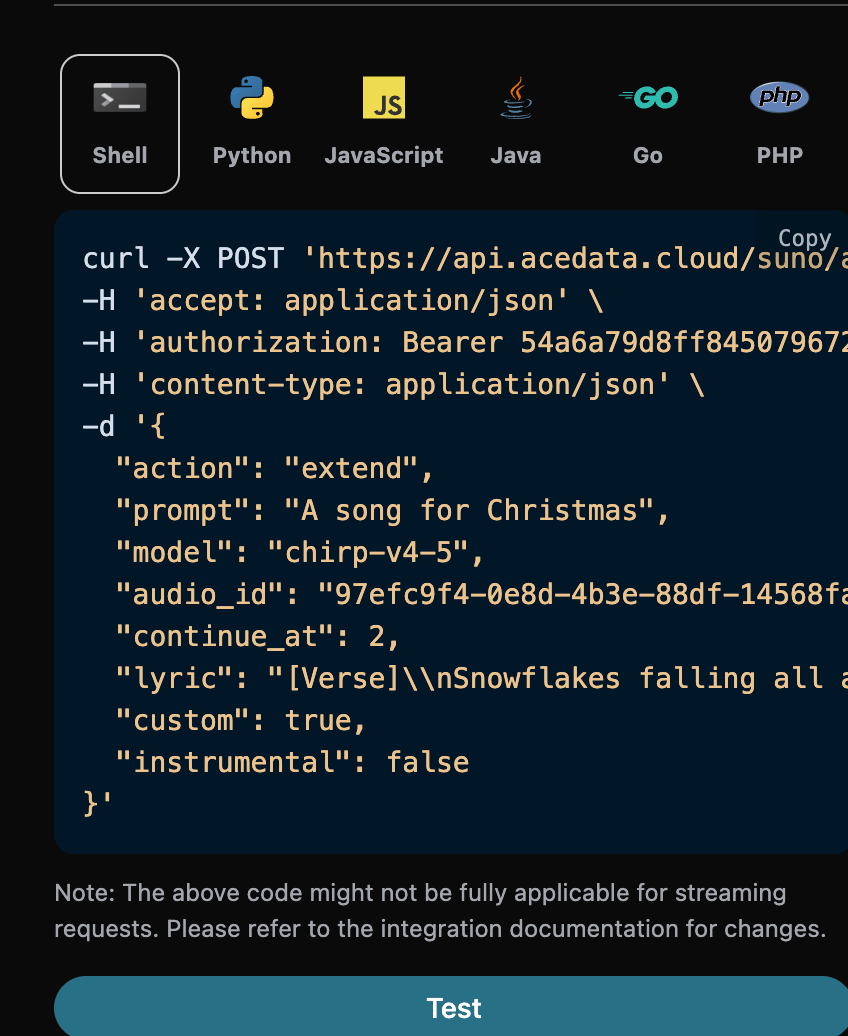
continue_at 2 Sekunden beträgt, daher gehören nur die ersten 2 Sekunden zum ursprünglichen Inhalt vor der Fortsetzungsgrenze. Wenn die Fortsetzung tatsächlich nahe dem Ende des Songs erfolgt, sollte dieser Wert auf die erwartete Sekunde eingestellt werden, an der die Fortsetzung beginnen soll, und in lyric sollte nur der neue Abschnitt bereitgestellt werden, der nach der Grenze gesungen werden soll.
Der entsprechende Python-Code:
lyric im Ergebnis den Liedtext zurückgibt, der für diese Fortsetzungsaufgabe verwendet wurde. Dieses Feld ist keine wortgetreue Transkription des vollständigen fertigen Audios; bei extend verwendet das Quellaudio vor continue_at weiterhin den ursprünglichen Liedtext, und der neue Liedtext wird nur zur Steuerung des fortgesetzten Abschnitts verwendet.
Vollständigen Song abrufen
Dieextend-Ergebnisse des aktuellen Modells enthalten in der Regel bereits das Quellaudio vor continue_at und die neuen Inhalte nach der Grenze. Bitte beurteilen Sie zunächst anhand der tatsächlichen Dauer und des Inhalts des zurückgegebenen Audios, ob es bereits ein vollständiger Song ist. Wenn ein eigenständiges Fortsetzungssegment zurückgegeben wird oder mehrere Fortsetzungshistorien ausdrücklich zu einem Song zusammengeführt werden müssen, verwenden Sie anschließend die Verkettungsfunktion:
- action: Der Inhalt ist
concat. - audio_id: Die ID des letzten Fortsetzungssegments.
Musik-Coverversion
Wenn nach dem Fortsetzen der Songgenerierung auf Basis des ursprünglichen Songs der Stil des zurückgegebenen Songs möglicherweise nicht sehr passend ist. Wenn eine Coverversion des zuvor generierten Songs (wenn es sich um benutzerdefiniert hochgeladene Musik handelt, wird dies ebenfalls unterstützt) erstellt werden soll, muss die Methode für Musik-Coverversionen verwendet werden, dann können die folgenden Inhalte angegeben werden:- action: Der Inhalt ist
cover, wenn eine Coverversion für benutzerdefiniert hochgeladene Musik erstellt wird, muss der Inhalt alsupload_coverangegeben werden. - audio_id: Die ID des zuvor generierten Songs.
Abschnitt ersetzen
Wenn nach der Songgenerierung eine zweite kreative Bearbeitung erforderlich ist, bei der ein Songabschnitt separat ersetzt wird, kann ein bestimmter Abschnitt des Songs ersetzt werden.⚠️ Hinweis:Die Parameterbeschreibung lautet wie folgt:replace_section_result_modeist standardmäßigfull_song: Das System fügt jeweils 2 neu generierte Kandidaten zusammen und gibt 2 vollständige Songs zurück. Wenn nur die noch nicht zusammengefügten Ersatzabschnitt-Kandidaten benötigt werden, setzen Sie ihn ausdrücklich aufcandidatesund wählen dann einen Kandidaten aus, um Musik zusammenfügen aufzurufen.
- action: Der Inhalt ist
replace_section. - audio_id: Die ID des ursprünglichen Songs (des zu ersetzenden Quellsongs).
- model: Songgenerierungsmodell.
- lyric: Der vollständige Liedtext nach dem Ersetzen (einschließlich des ersetzten Abschnitts und seines Kontexts, im Einklang mit dem Inhalt in
prompt). - prompt: Der neue Liedtext für den Abschnitt, der ersetzt werden soll.
- style: Der Stil des Songs, optional.
- replace_section_start: Die Startzeit des zu ersetzenden Abschnitts im Originalsong (Sekunden).
- replace_section_end: Die Endzeit des zu ersetzenden Abschnitts im Originalsong (Sekunden).
- replace_section_result_mode: Rückgabemodus, standardmäßig
full_song.full_songfügt jeweils 2 Kandidaten zusammen und gibt 2 vollständige Songs zurück;candidatesgibt 2 noch nicht zusammengefügte Kandidatenabschnitte zurück.
Schritt eins: Aufgabe zum Ersetzen eines Abschnitts starten
Wenn zum Beispiel die ID des ursprünglich generierten Songs lautet: 18db7ed0-2b8a-41db-91c1-b0781dcca0d4 (Dauer 94,12 Sekunden), und der Refrain von Sekunde 30 bis Sekunde 60 durch einen neuen Liedtext ersetzt werden soll, dann können die Parameter wie folgt festgelegt werden:replace_section_result_mode auf candidates gesetzt wird, werden 2 noch nicht zusammengesetzte Ersatzabschnitte zurückgegeben; die Struktur entspricht dem folgenden Beispiel:
candidates sind die Längen der zwei zurückgegebenen Audiodateien (45,16 Sekunden, 33,8 Sekunden) deutlich kürzer als der Originalsong (94,12 Sekunden). Sie sind Ersatzabschnitte mit wenig Kontext und nicht der vollständige Song. Zufriedenstellende Kandidaten können ausgewählt und anschließend manuell zusammengesetzt werden. Der Standardmodus full_song führt dagegen zwei Zusammensetzungen durch und gibt direkt 2 vollständige Songs zurück.
Vollständige Songs direkt zurückgeben
Wenn vollständige Songs direkt erhalten werden sollen, kann in Schritt einsreplace_section_result_mode auf full_song gesetzt werden. Die Schnittstelle setzt die beiden Kandidaten jeweils zusammen und gibt 2 vollständige Songs zurück; in diesem Fall muss concat nicht erneut aufgerufen werden.
Schritt zwei: Den Ersatzabschnitt wieder mit dem Originalsong zusammensetzen
Für den oben ausgewählten Abschnitt (zum Beispiel364f9d8b-ca25-463b-9a5e-d0b7139e2d6a) wird gemäß der Methode im Abschnitt Musikzusammensetzung eine concat-Aufgabe gestartet:
duration auf die vollständige Songlänge wiederhergestellt (105,28 Sekunden, ungefähr gleich der Länge des Originalsongs), und audio_url verweist auf den vollständigen Song nach dem Ersetzen. Damit ist der Prozess der sekundären Erstellung „Generieren → Segment ersetzen → gesamten Song zusammenfügen“ abgeschlossen.
Trennung von Gesang und Musik
Wenn nach dem Generieren eines Songs eine sekundäre Erstellung erforderlich ist, bei der Begleitung und Gesang separat bearbeitet werden müssen, können reine Instrumentalbegleitung und A-cappella-Gesang getrennt werden. Dazu können die folgenden Inhalte angegeben werden:- action: Der Inhalt ist
stems. - audio_id: Die ID des zuvor generierten Songs.
Trennung von Gesang und Musik aller Spuren
Wenn nach dem Generieren eines Songs eine Trennung von Gesang und Musik aller Spuren erforderlich ist, können die folgenden Inhalte angegeben werden:- action: Der Inhalt ist
all_stems. - audio_id: Die ID des zuvor generierten Songs.
Audiospur hinzufügen
add_stem generiert für das angegebene Audio eine Zielinstrumenten- oder Gesangsspur und wird über POST /suno/audios aufgerufen.
- Erforderlich:
action,audio_id,stem_type. - Optional:
model,prompt,title,style,negative_tags,weirdness,style_influence,audio_weight,max_mode,variety. - Abrechnung: 0.672 Credits im normalen Modus; 1.344 Credits, wenn
max_modeauftruegesetzt ist.
Audiospur extrahieren
extract_stem extrahiert die Zielaudiospur aus dem angegebenen Audio und gibt gleichzeitig die ergänzende Version zurück, aus der diese Audiospur entfernt wurde; der Aufruf erfolgt über POST /suno/audios.
- Erforderlich:
action,audio_id,stem_type. - Optional:
audio_format; der aktuelle öffentliche Zwei-Kanal-Vertrag unterstützt nurmp3. - Abrechnung: 1.12 Credits.
data im Endzustands-Response behält eine flache Audioliste bei, und stem_sets stellt die Zuordnung zwischen der Zielaudiospur und der ergänzenden Audiospur dar:
Soundeffekte generieren
sounds generiert anhand einer Textbeschreibung einmalige oder schleifenfähige Soundeffekte und wird über POST /suno/audios aufgerufen.
- Erforderlich:
action,sound,sound_type. - Optional:
model,bpm,key,audio_format;audio_formatunterstützt derzeit nurmp3. sound_type:one-shotoderloop.- Abrechnung: 0.112 Credits.
Audiogeschwindigkeit anpassen
adjust_speed passt die Wiedergabegeschwindigkeit des angegebenen Audios an und wird über POST /suno/audios aufgerufen.
- Erforderlich:
action,audio_id,speed_multiplier,title. - Optional:
keep_pitch. speed_multiplier: Bereich 0.25–4.- Abrechnung: 0.28 Credits.
Erweiterte Parameter für die benutzerdefinierte Generierung
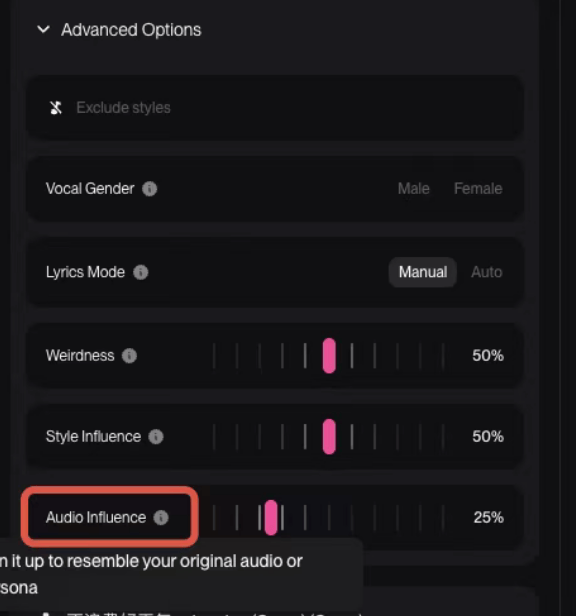
Offiziell ist es erlaubt, im benutzerdefinierten Modus die erweiterten Parameterweirdness==>Weirdness, style_influence==>Style Influence, audio_weight==>Audio Influence für die Generierung zu verwenden, entsprechend den folgenden offiziellen Beispielen:
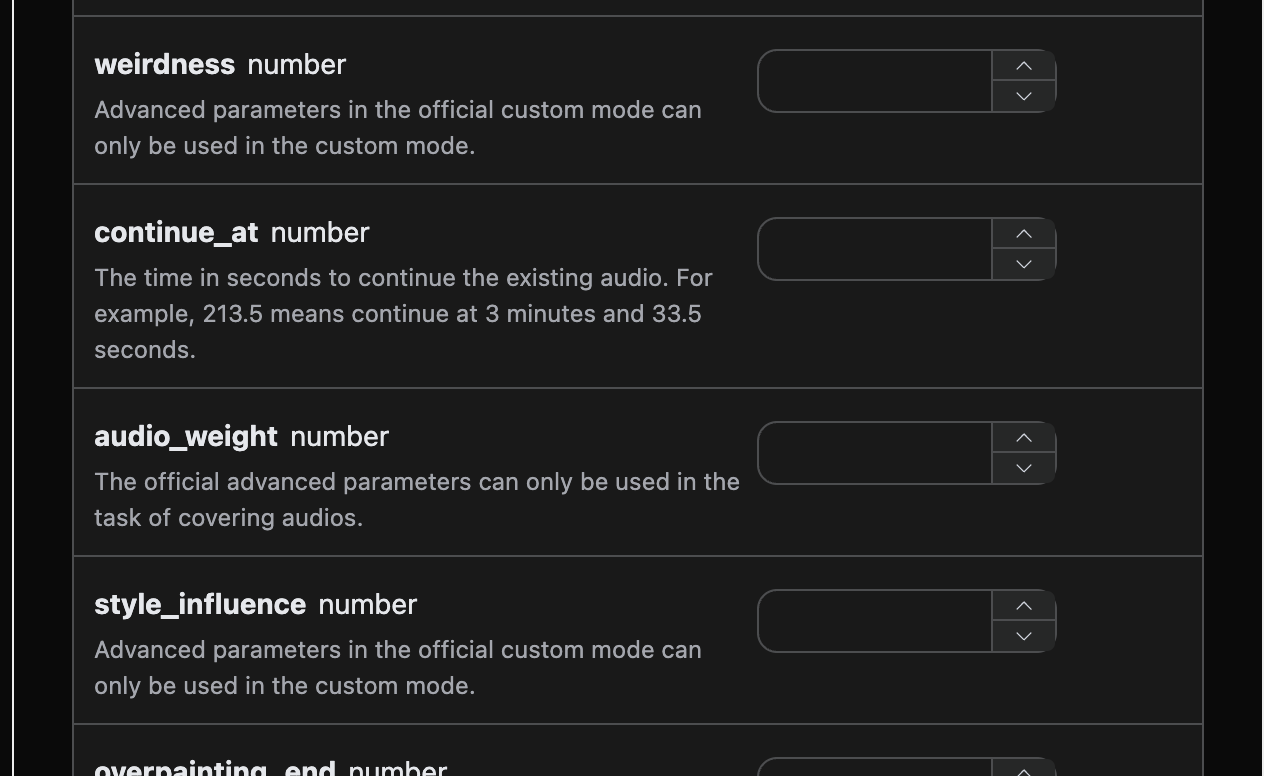
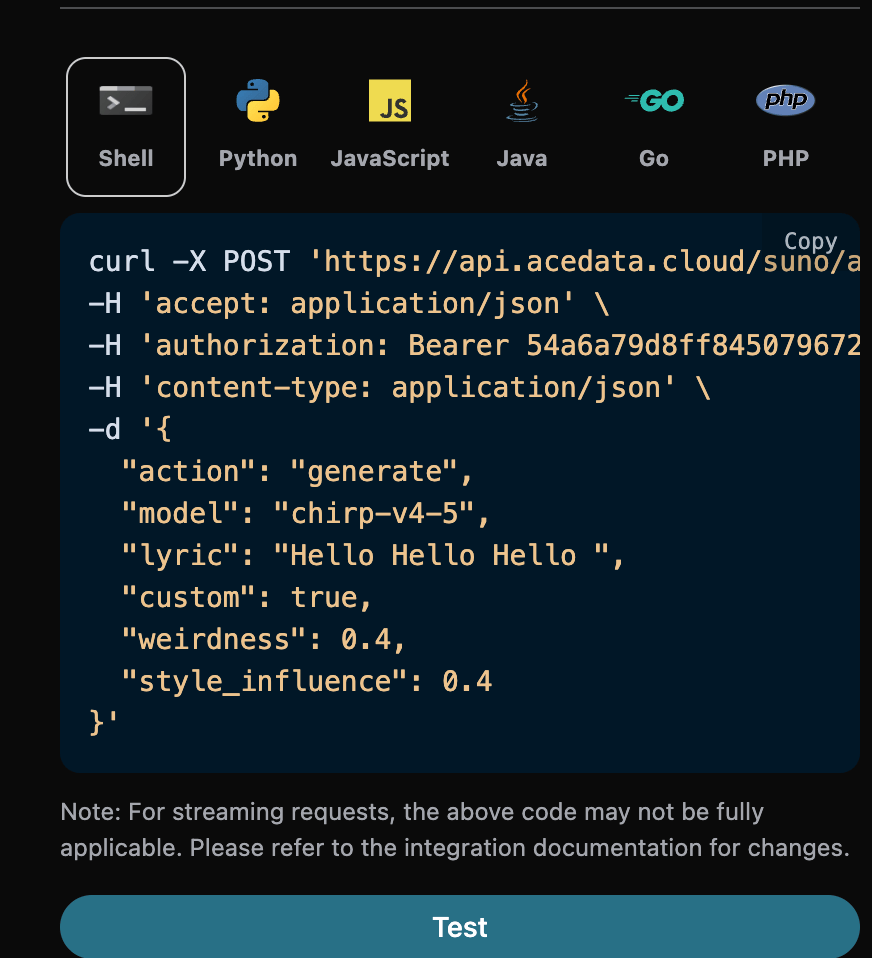
Songdauer steuern
Standardmäßig wird die Dauer des generierten Songs vom Modell selbst festgelegt und liegt normalerweise zwischen 30 Sekunden und 4 Minuten. Wenn ein längeres oder kürzeres Endprodukt benötigt wird, kann über den Parameterduration die gewünschte Dauer angegeben werden, die Einheit ist Sekunden, und der Wert ist eine ganze Zahl zwischen 10 und 360.
Dieser Parameter wird für die Songgenerierung im benutzerdefinierten Modus (wenn custom true ist) verwendet. Besonders zu beachten ist, dass duration ein tendenzieller Hinweis und keine harte Einschränkung ist: Das Modell wird diesen Wert beim Erstellen berücksichtigen, garantiert jedoch nicht, ihn zu erreichen; in tatsächlichen Tests ist die tatsächliche Dauer normalerweise deutlich kürzer als der erwartete Wert, und die Dauer der zwei Songs, die von derselben Anfrage zurückgegeben werden, kann ebenfalls um ein Mehrfaches variieren. Selbst bei vollständig identischen Anfragen kann die bei mehrfacher Übermittlung erhaltene Dauer stark variieren. Verwenden Sie ihn daher nicht als präzise Dauersteuerung; wenn geschäftlich eine feste Dauer erforderlich ist, schneiden Sie das Endprodukt nach dem Erhalt selbst zu oder versuchen Sie es erneut.
Der entsprechende Python-Code:
duration in der Anfrage die erwartete Dauer ist, während das Feld duration jeder einzelnen Songdatei in den Antwort-data die tatsächliche Dauer dieses Songs ist. Beide haben denselben Namen, aber unterschiedliche Bedeutungen; die tatsächliche Dauer wird nicht garantiert dem Erwartungswert entsprechen. Die Länge des Liedtexts ist einer der Hauptfaktoren, die die Dauer des fertigen Produkts beeinflussen. Wenn ein längeres fertiges Produkt benötigt wird, wird empfohlen, gleichzeitig vollständigere Liedtexte bereitzustellen.
Die Schnittstelle überprüft, dass duration eine ganze Zahl zwischen 10 und 360 sein muss; sie ist weiterhin nur ein Generierungsziel und keine Garantie für die Länge des fertigen Produkts.
Add-Instrumental-Funktion
Im August 2025 hat Suno die neue Add-Instrumental-Funktion eingeführt. Zunächst muss ein Song mit A-cappella-Gesang ohne Begleitung hochgeladen werden, damit Suno die Musik dazu erstellt. Zuerst kann über die Suno Upload API ein Song mit A-cappella-Gesang ohne musikalische Begleitung hochgeladen werden. Die entsprechende Vorgehensweise ist in der folgenden Abbildung dargestellt: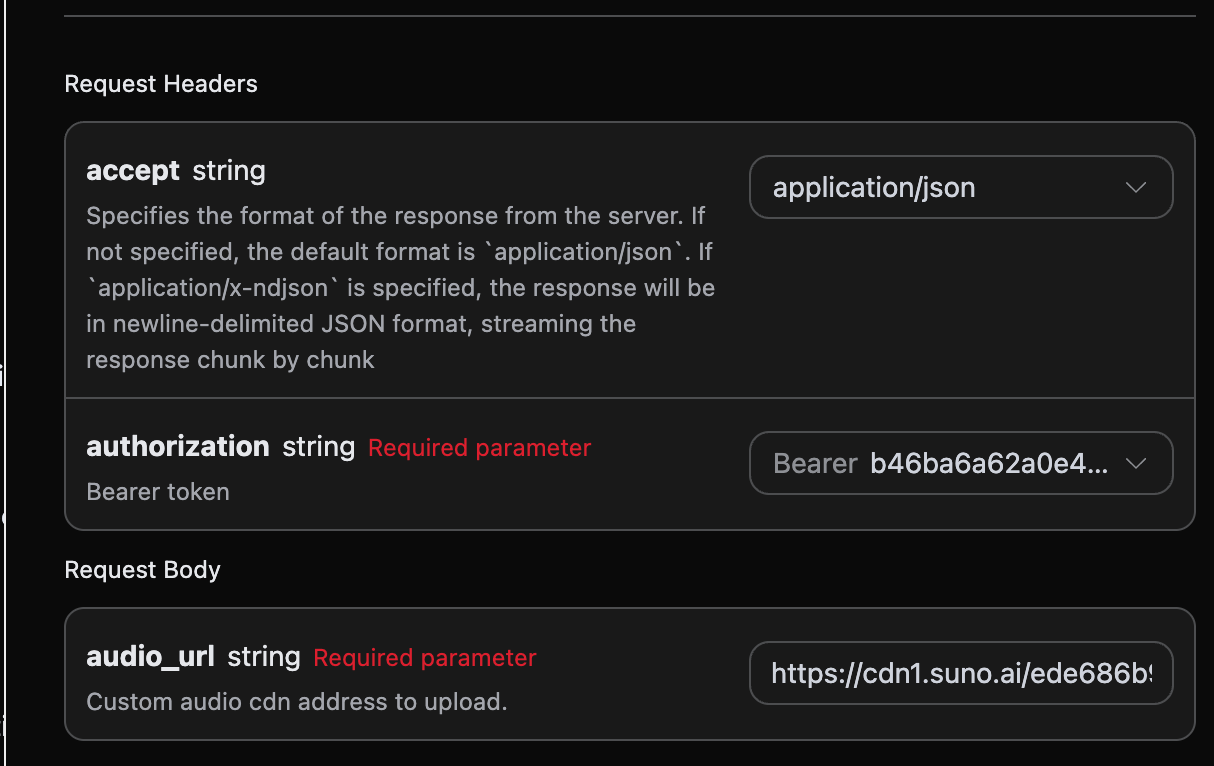
audio_id nach dem Upload notiert werden. Das konkrete Ergebnis ist in der folgenden Abbildung dargestellt:
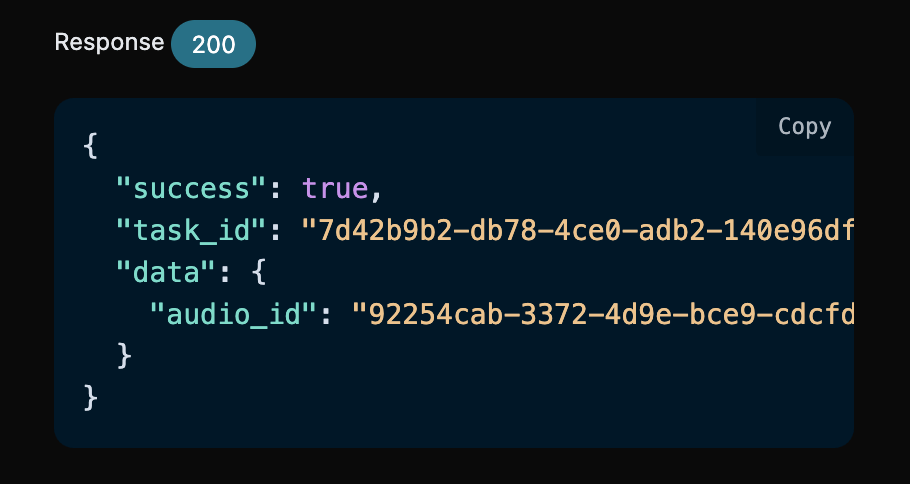
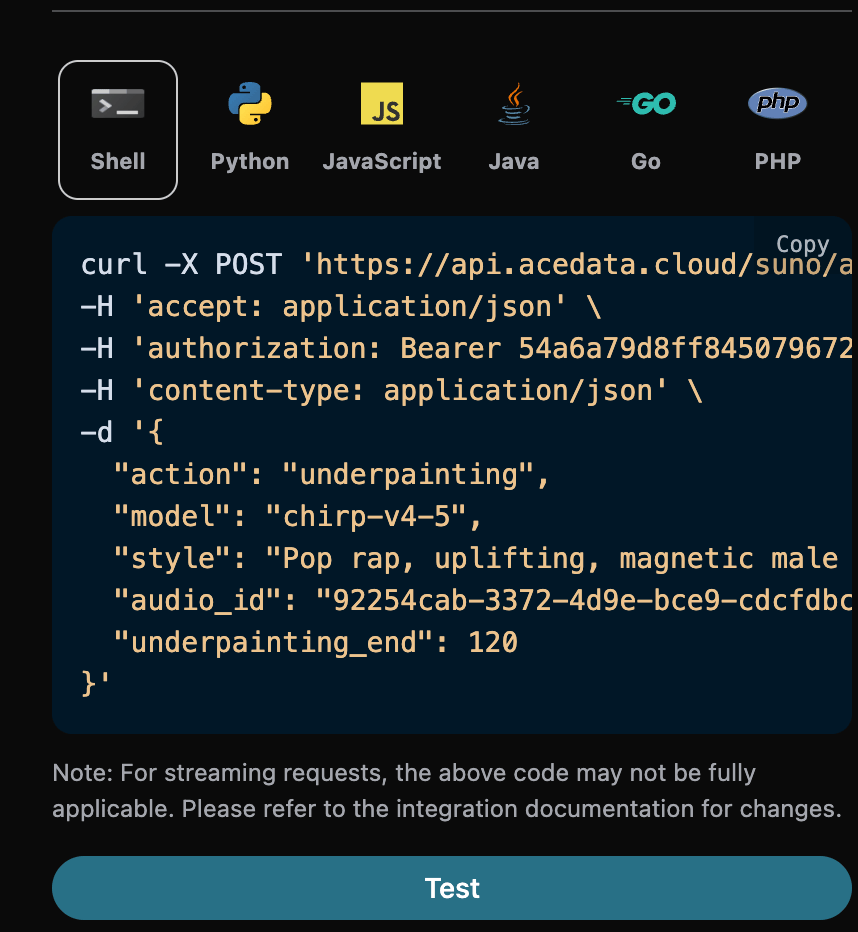
audio_id erhalten: 92254cab-3372-4d9e-bce9-cdcfdbc39070. Danach müssen noch die folgenden Parameter ausgefüllt werden:
- action: Der Inhalt ist
underpainting. - underpainting_start: Die Startzeit für das Hinzufügen einer Begleitung zum hochgeladenen Song; der Standardwert ist 0.
- underpainting_end: Die Endzeit für das Hinzufügen einer Begleitung zum hochgeladenen Song; sie muss kleiner als die Gesamtdauer des Songs sein.
- audio_id: Die ID des hochgeladenen Songs mit A-cappella-Gesang ohne Begleitung.
- style: Der Stil der Begleitung; am besten ohne Liedtext, da es sich schließlich um eine Begleitung handelt.
Add-Vocals-Funktion
Im August 2025 hat Suno die neue Add-Vocals-Funktion eingeführt. Zunächst muss ein reines Musikstück hochgeladen werden, damit Suno Liedtexte erstellt und menschlichen Gesang erzeugt. Zuerst kann über die Suno Upload API ein Song mit A-cappella-Gesang ohne musikalische Begleitung hochgeladen werden. Die entsprechende Vorgehensweise ist in der folgenden Abbildung dargestellt:
audio_id nach dem Upload notiert werden. Das konkrete Ergebnis ist in der folgenden Abbildung dargestellt:
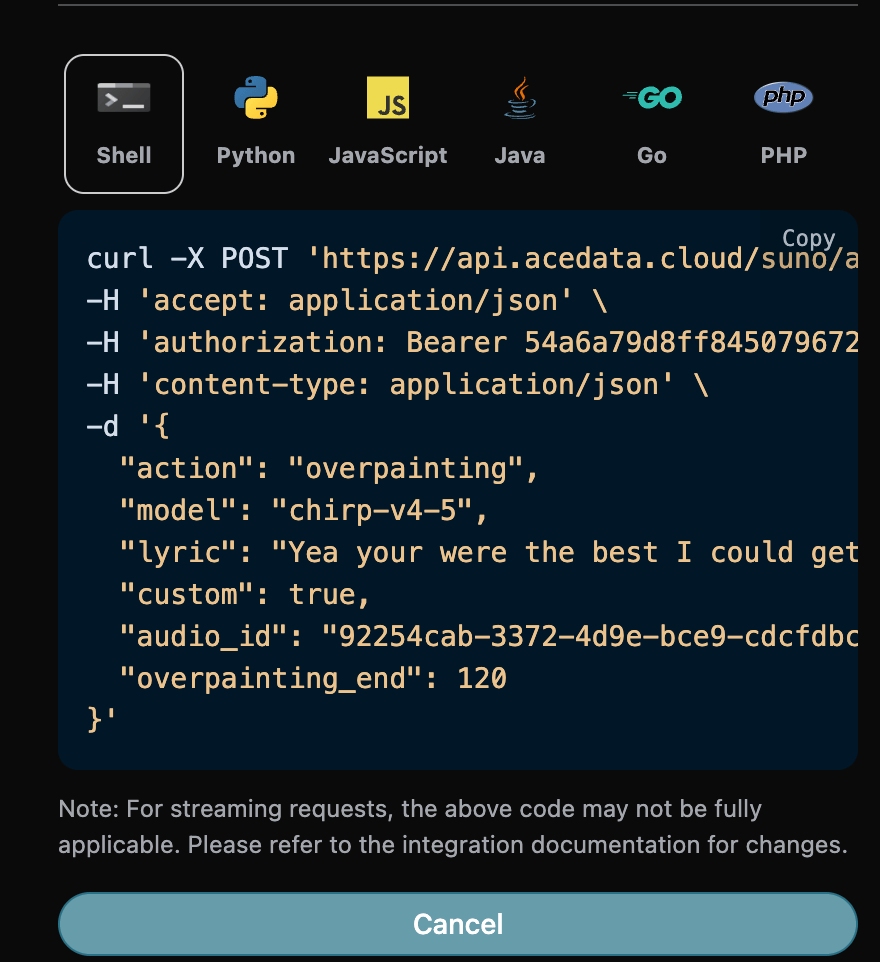
audio_id erhalten: 92254cab-3372-4d9e-bce9-cdcfdbc39070. Danach müssen noch die folgenden Parameter ausgefüllt werden:
- action: Der Inhalt ist
overpainting. - overpainting_start: Die Startzeit für das Hinzufügen von Gesang zum hochgeladenen Song; der Standardwert ist 0.
- overpainting_end: Die Endzeit für das Hinzufügen von Gesang zum hochgeladenen Song; sie muss kleiner als die Gesamtdauer des Songs sein.
- audio_id: Die ID des hochgeladenen Songs mit A-cappella-Gesang ohne Begleitung.
- custom: In diesem Modus muss der benutzerdefinierte Modus verwendet werden, um Liedtexte einzugeben.
- lyric: Die im benutzerdefinierten Modus eingegebenen Liedtexte.
- style: Der Stil der Begleitung.
Remaster-Funktion
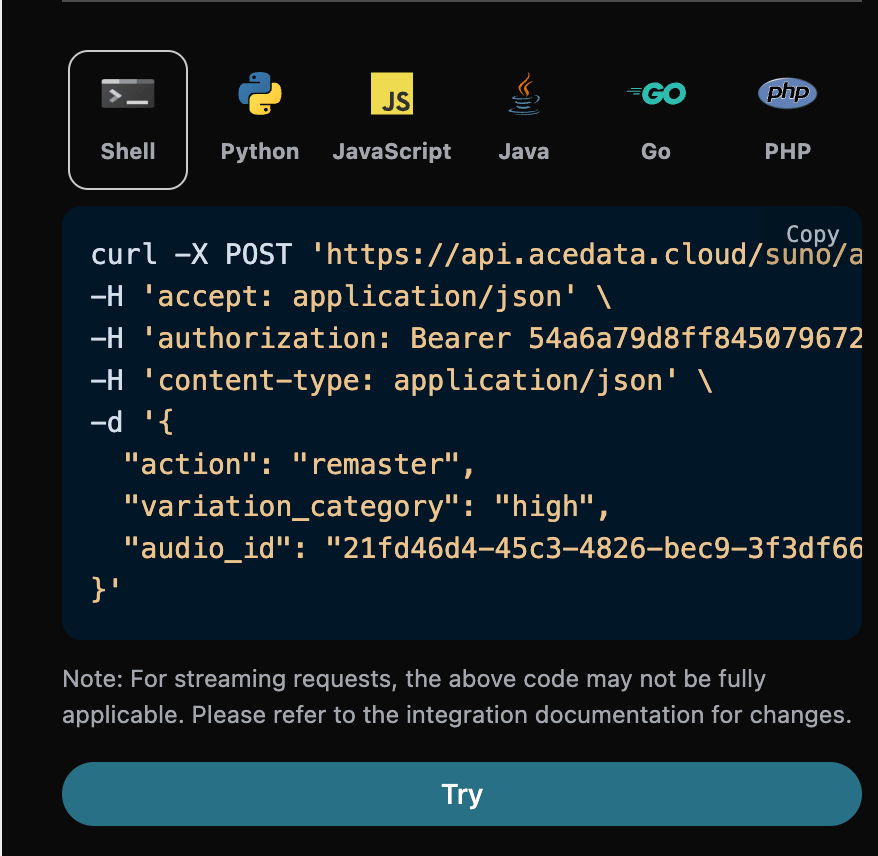
Im Dezember 2025 hat suno die neue Remaster-Funktion eingeführt. Diese Funktion kann Songs erneut generieren, kontoübergreifend ist dies nicht möglich, und dann müssen wir die folgenden Parameter ausfüllen:- action: Der Inhalt ist
remaster. - audio_id: Die ID des Songs, der erneut generiert werden soll.
- model: Unterstützt nur v4.5+ und v5.
- variation_category: Wird nur ab Version v5 unterstützt und hat nur 3 Werte: high, normal, subtle.
Mashup-Funktion zur Erstellung gemischter Songs
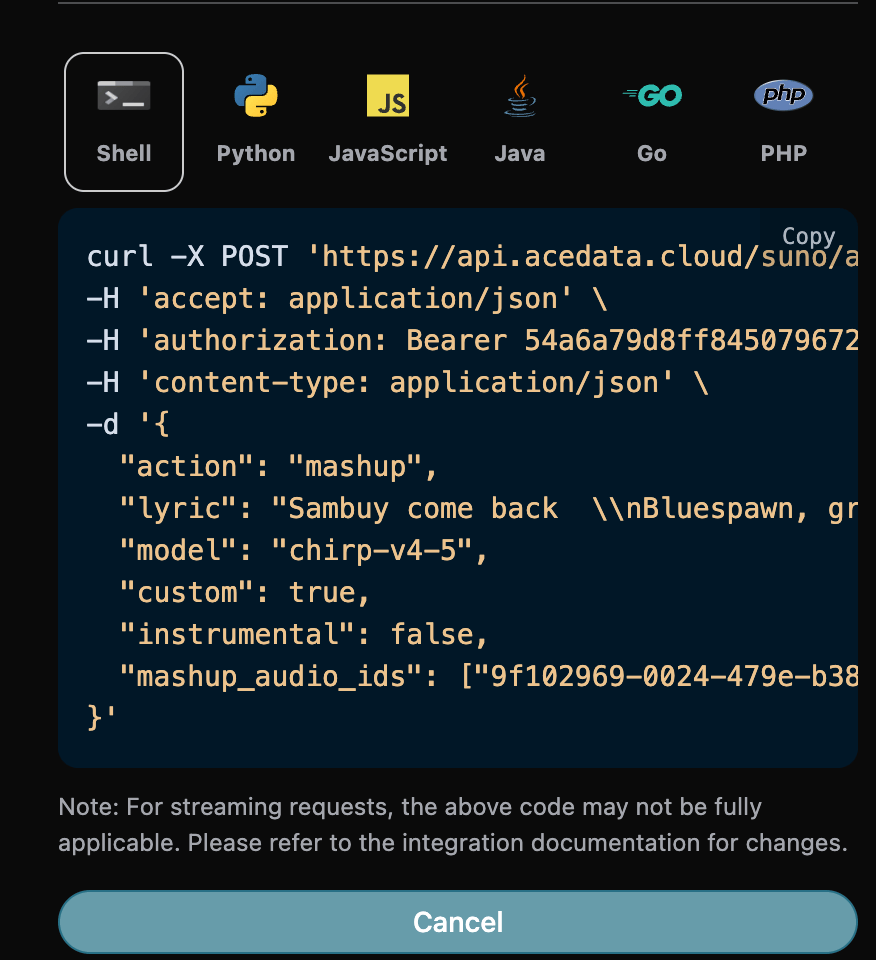
Im Dezember 2025 hat suno die neue Mashup-Funktion eingeführt. Diese Funktion kann anhand von zwei Referenzsongs Songs generieren, und dann müssen wir die folgenden Parameter ausfüllen:- action: Der Inhalt ist
mashup. - mashup_audio_ids: Die IDs der zwei Referenzsongs. Nach dem Ausfüllen wird automatisch folgender Code generiert:
Samples Sampling-Generierung von Songs
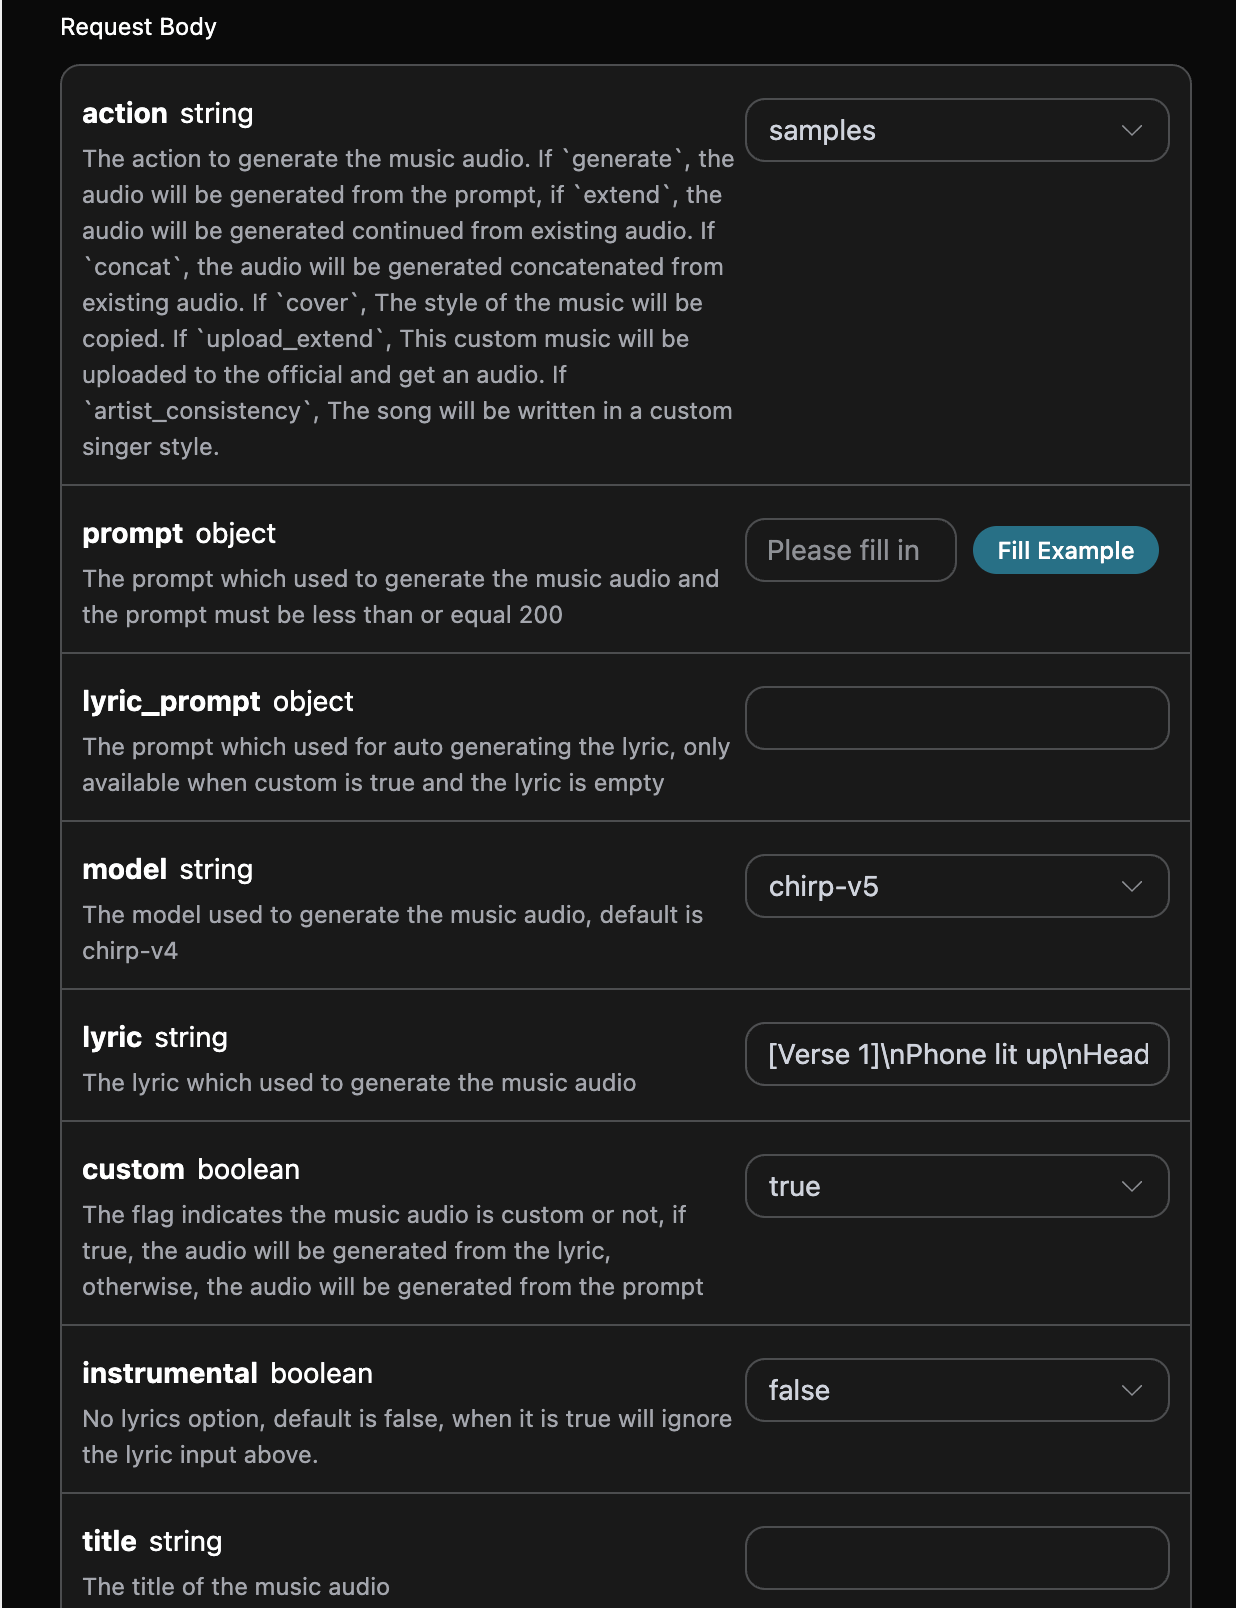
Diesamples hier beziehen sich auf das Sampling eines einzelnen Audiointervalls: Wählen Sie aus einem vorhandenen Audio eine Start- und Endzeit aus und verwenden Sie diesen Ausschnitt als Sampling-Material für die Erstellung. Dies unterscheidet sich von der unten verwendeten Inspo-Funktion zur Inspirationskreation mit 1 bis 4 vollständigen Referenzaudios. Die folgenden Parameter müssen ausgefüllt werden:
- action: Der Inhalt ist
samples. - samples_start: Startzeit des Samplings.
- samples_end: Endzeit des Samplings.
- audio_id: Die ID des Referenzsongs, der gesampelt werden soll.
Inspo-Inspirations-Kreationsfunktion
Die Inspo-Inspirations-Kreationsfunktion kann anhand von 1 bis 4 vollständigen Referenz-Audiodateien neue Musik generieren und unterstützt das Ziehen oder Hochladen von Audio als Inspirationsquelle. Die API verwendet die bestehendeinspo-Aktion: Der Client stellt öffentlich zugängliche Audio-URLs bereit, und der Dienst erledigt automatisch die Vorbereitung der Referenz-Audios und die Kreation, ohne dass der Client Liedtexte, Stil oder Dauer separat auslesen und dann die Anfrage zusammenstellen muss. Sie unterscheidet sich vom obigen Bereichs-Sampling und auch vom Cover, das den Stil des Originalsongs nachbildet. Bei der Verwendung müssen die folgenden Parameter ausgefüllt werden:
- action: Der Inhalt ist
inspo. - audio_urls: Eine Liste von URLs der Referenz-Audios; es müssen 1 bis 4 öffentlich zugängliche Audio-Adressen bereitgestellt werden.
- model: Das verwendete Modell; empfohlen wird
chirp-v6. - prompt: Liedtext oder kreativer Hinweistext (optional).
Hinweis: Die Referenz-Audios müssen öffentlich zugängliche Audiodateien sein. Wenn ein Referenz-Audio vollständig mit einer bekannten Aufnahme in der Musikbibliothek der Plattform übereinstimmt, kann Suno die Generierung aufgrund einer Urheberrechtsprüfung ablehnen. Es wird empfohlen, eigene oder von Suno generierte Audios als Inspirationsquelle zu verwenden.Der entsprechende Python-Code:
chirp-v5, das aktuelle Anfragebeispiel empfiehlt chirp-v6, und die Rückgabestruktur ist identisch:
Asynchroner Rückruf
Da Suno relativ lange für die Musikgenerierung benötigt, etwa 1–2 Minuten, bleibt die HTTP-Anfrage bei einer längeren Nichtantwort der API dauerhaft verbunden, was zu zusätzlichem Verbrauch von Systemressourcen führt. Daher bietet diese API auch Unterstützung für asynchrone Rückrufe. Der gesamte Ablauf ist: Wenn der Client eine Anfrage initiiert, gibt er zusätzlich ein Feldcallback_url an. Nachdem der Client die API-Anfrage initiiert hat, gibt die API sofort ein Ergebnis zurück, das ein Feld task_id enthält, welches die aktuelle Aufgaben-ID darstellt. Nachdem die Aufgabe abgeschlossen ist, wird das Ergebnis der Musikgenerierung in Form von POST JSON an die vom Client angegebene callback_url gesendet, die ebenfalls das Feld task_id enthält, sodass die Aufgabenergebnisse über die ID verknüpft werden können.
Im Folgenden erfahren wir anhand eines Beispiels, wie die konkrete Vorgehensweise aussieht.
Zunächst einmal ist der Webhook-Rückruf ein Dienst, der HTTP-Anfragen empfangen kann. Entwickler sollten ihn durch die URL eines selbst eingerichteten HTTP-Servers ersetzen. Zur einfacheren Demonstration wird hier eine öffentliche Webhook-Beispielwebsite https://webhook.site/ verwendet. Beim Öffnen dieser Website erhalten Sie eine Webhook-URL, wie in der Abbildung gezeigt:
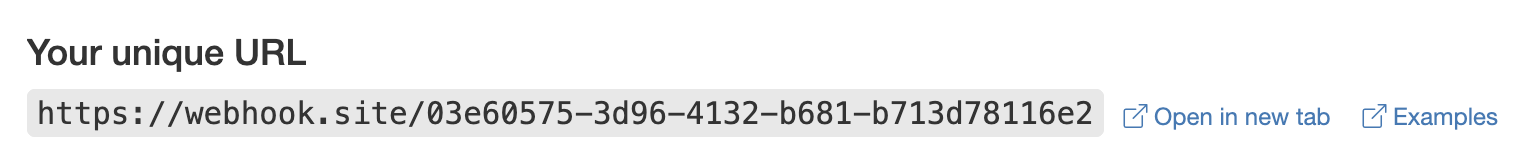 Kopieren Sie diese URL, dann kann sie als Webhook verwendet werden. Das Beispiel hier ist https://webhook.site/03e60575-3d96-4132-b681-b713d78116e2.
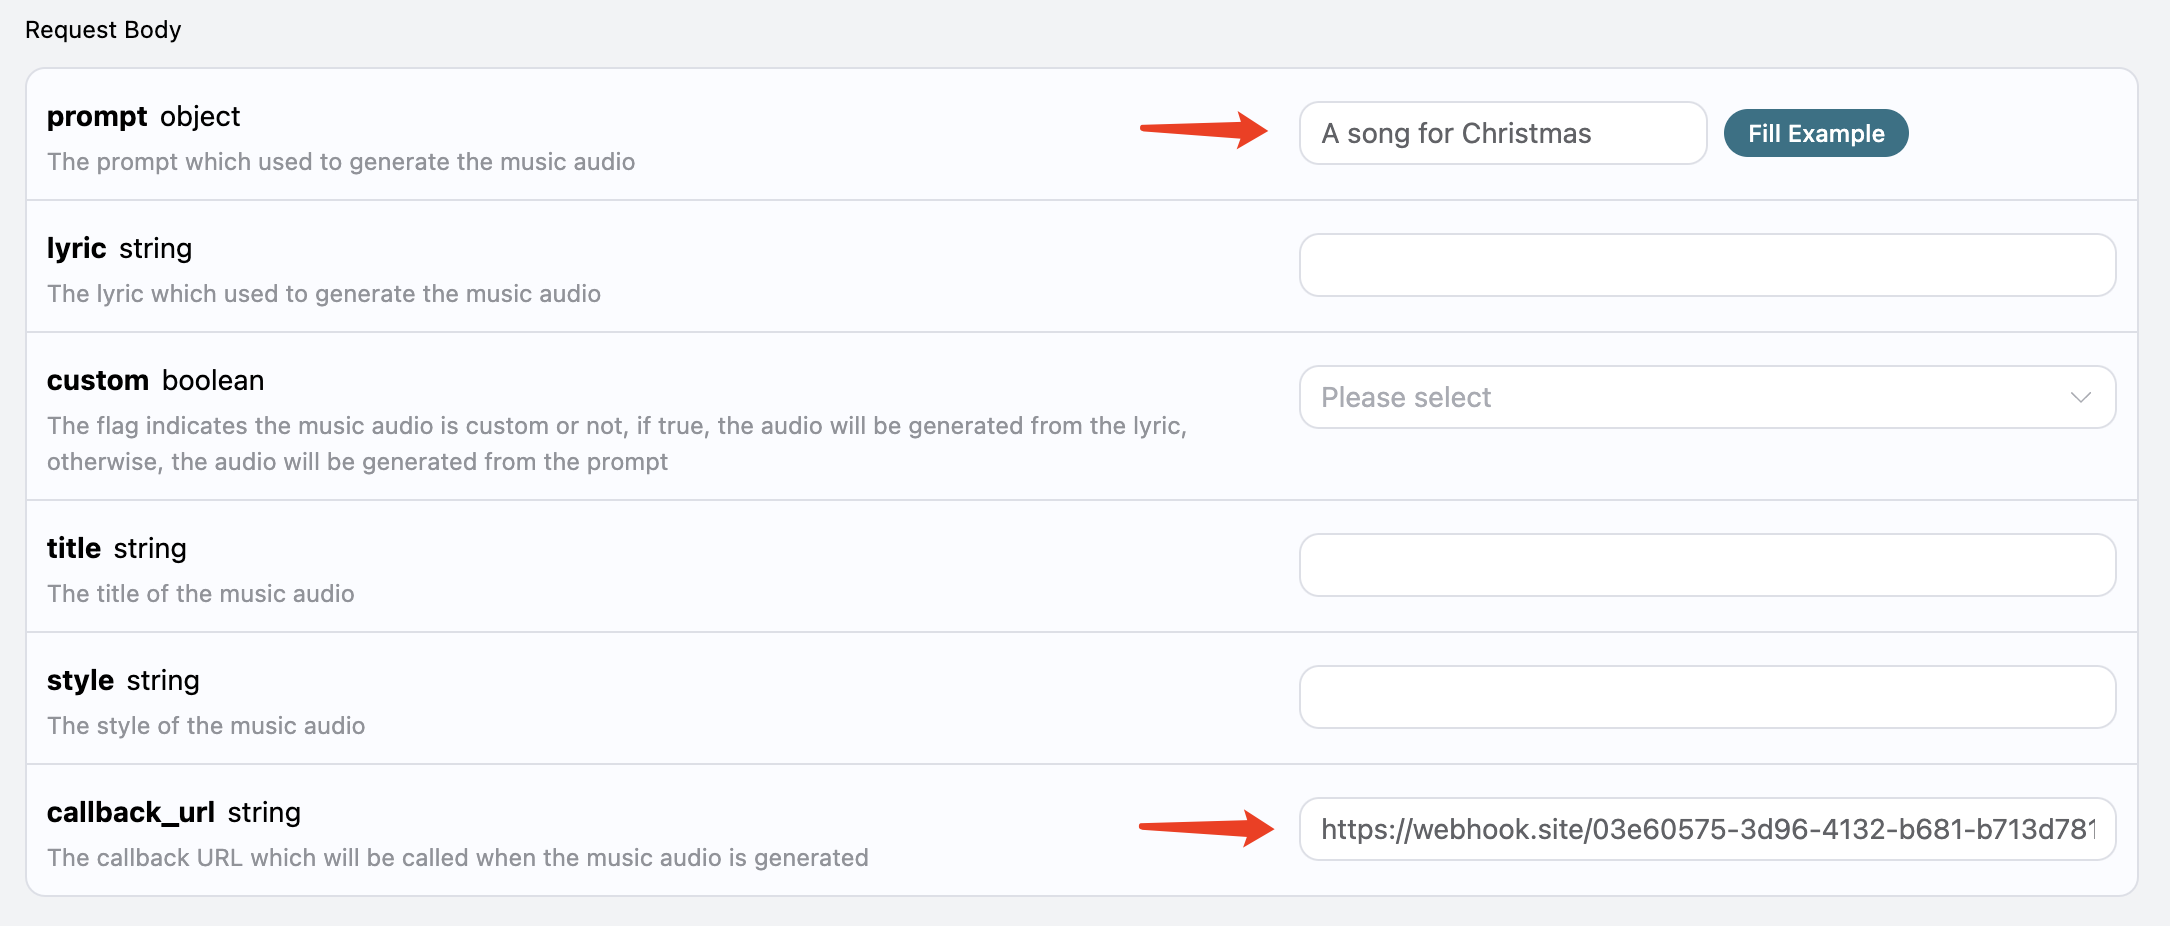
Als Nächstes können wir das Feld
callback_url auf die oben genannte Webhook-URL setzen und gleichzeitig prompt ausfüllen, wie in der Abbildung gezeigt:
 Klicken Sie auf Ausführen, und Sie können feststellen, dass sofort ein Ergebnis wie folgt erhalten wird:
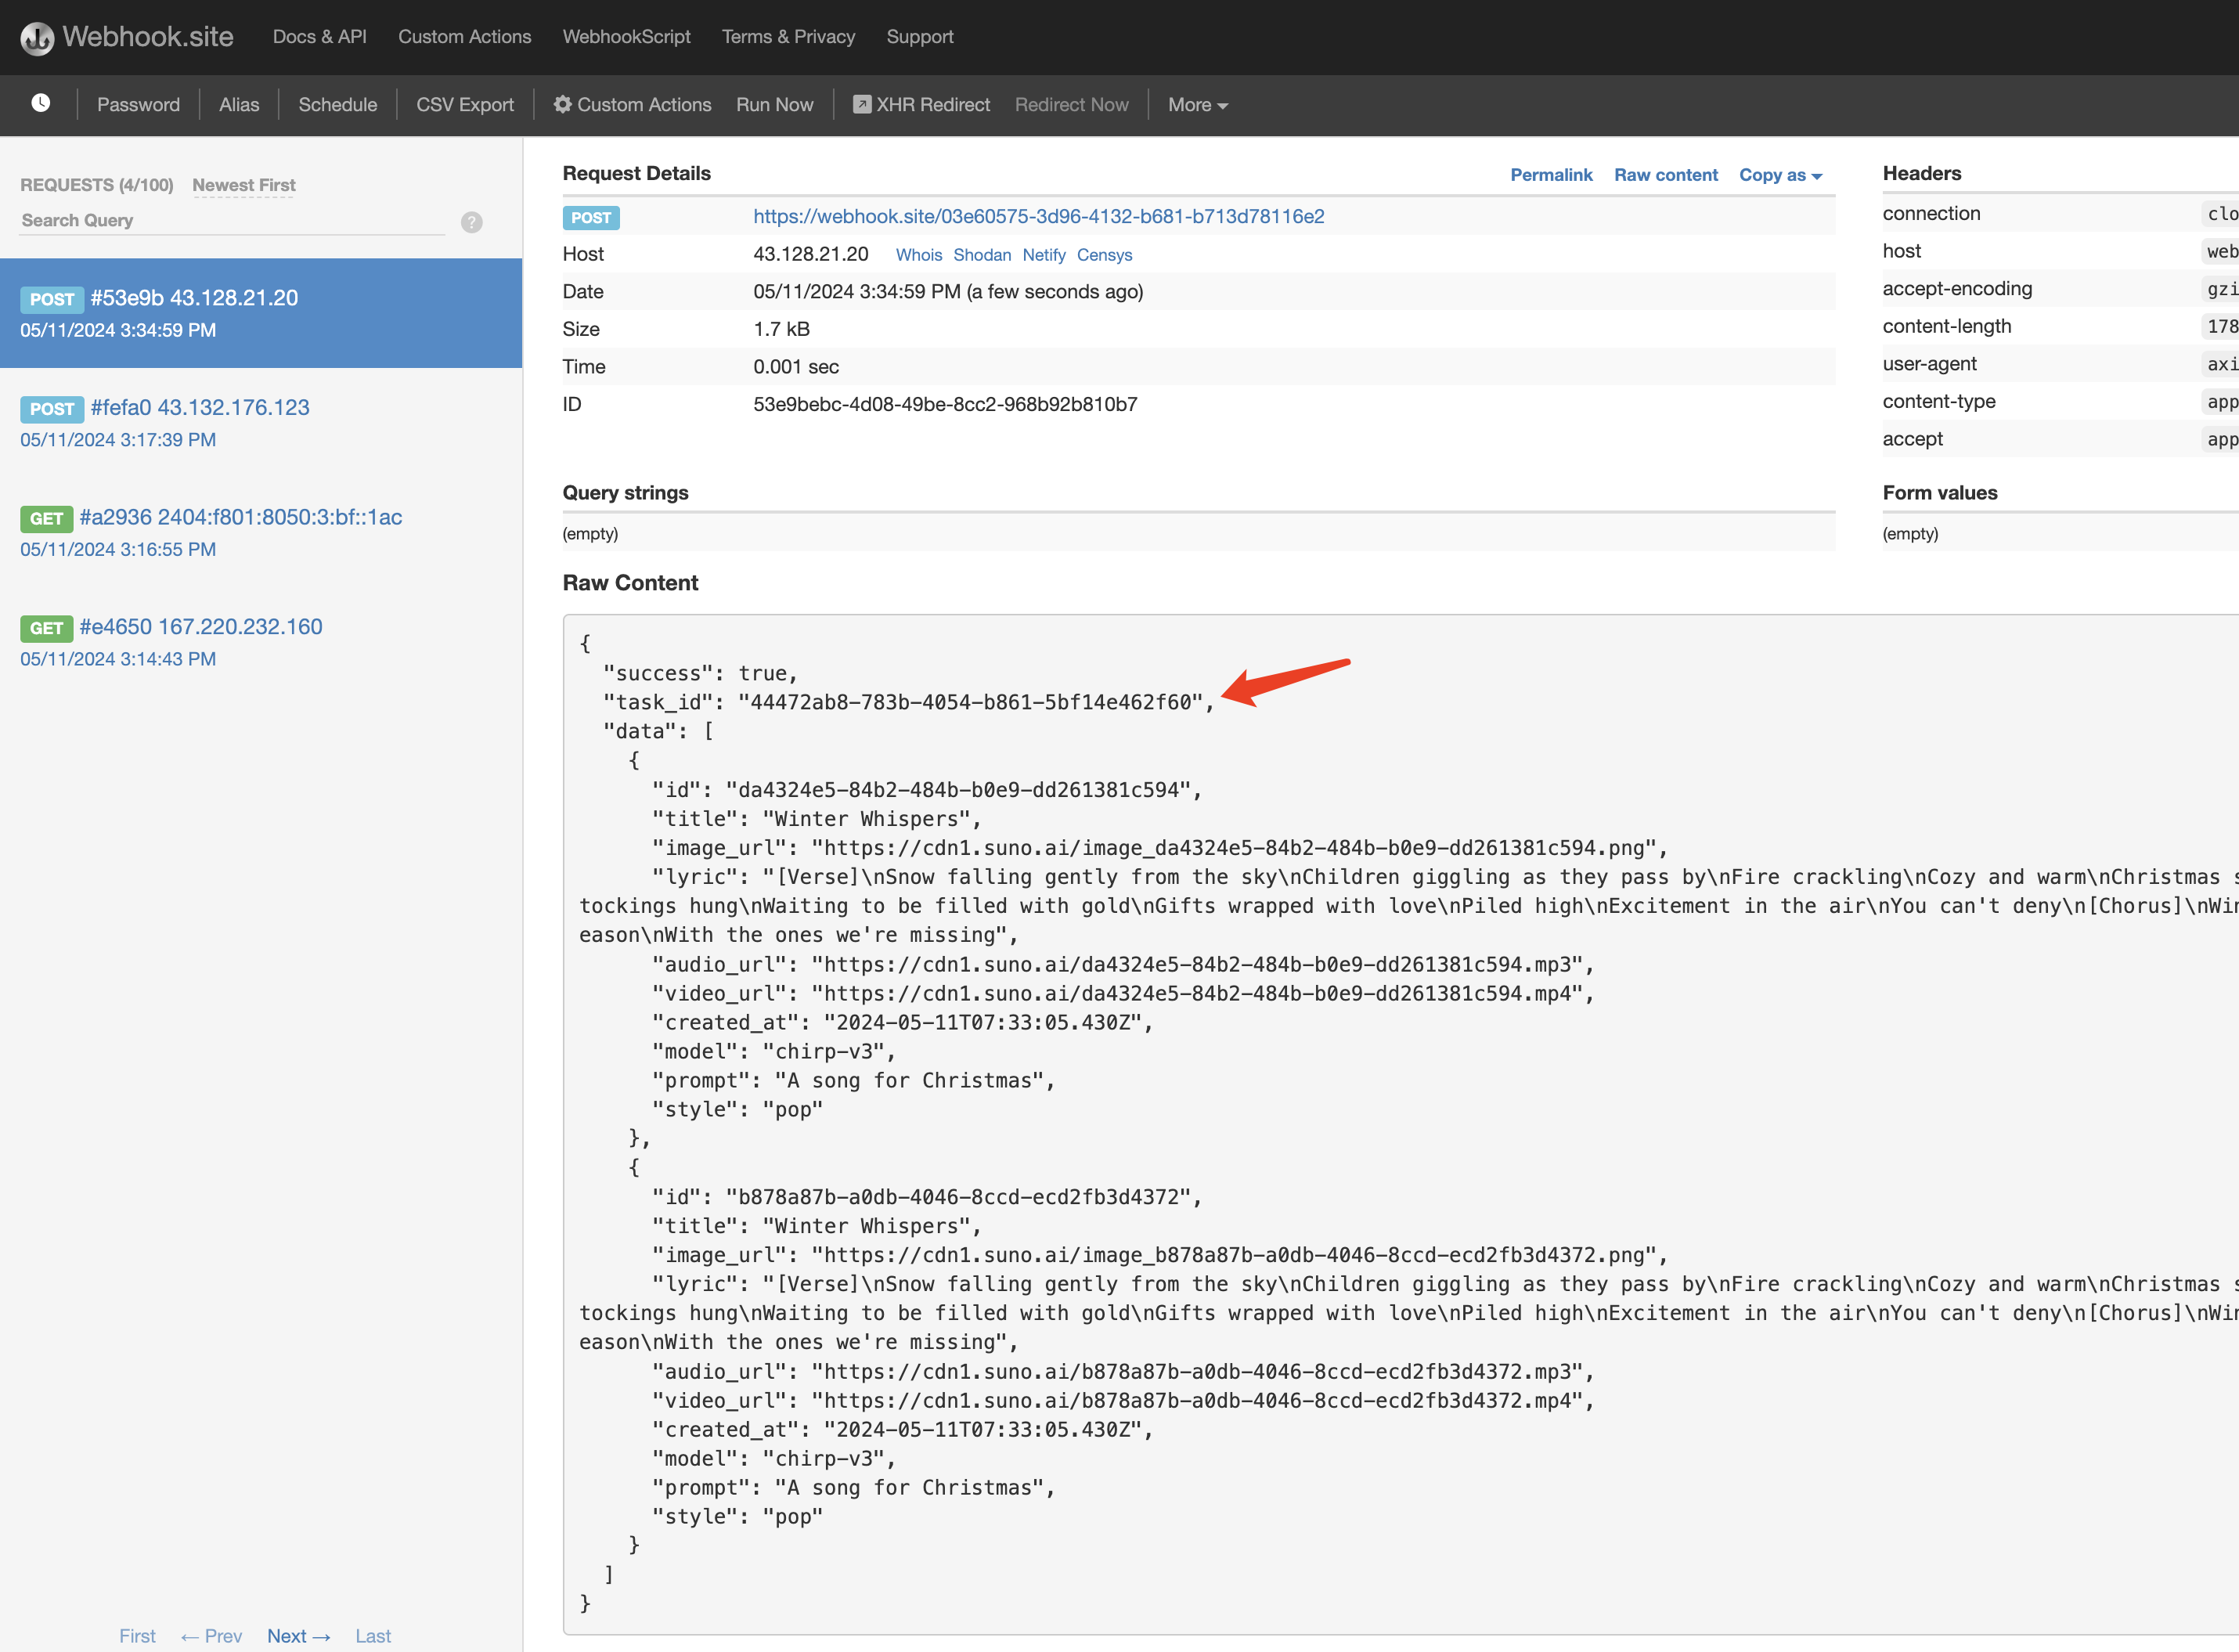 Der Inhalt lautet wie folgt:
task_id enthält. Die anderen Felder sind ähnlich wie oben, und über dieses Feld kann die Verknüpfung der Aufgaben realisiert werden.
Natürlich können wir die Ergebnisse auch über Streaming-Aufrufe abrufen. Wir müssen nur den Wert von accept im Anfrage-Header auf application/x-ndjson setzen. Im Folgenden wird eine Beispieleingabe zur Demonstration verwendet:
task_id nacheinander den Verarbeitungsstatus und das Endergebnis; oben wurden nur die erste und die endgültige reale Antwort beibehalten, wiederholte Zwischenaktualisierungen wurden ausgelassen.
Fehlerbehandlung
Wenn ein Fehler auftritt, erhalten Sie eine ähnliche Fehlermeldung wie die folgende:error.code und error.message:
Hinweis: Die Limits und Fehlermeldungstexte verschiedener Upstream-Konten können abweichen. In der Regel habenchirp-v3-5/chirp-v4niedrigerestyle-Limits (200), währendchirp-v4-5und höher normalerweise bis zu 1000 unterstützen; bei einem älteren Upstream können kompatible Meldungen wieTags too long.oderstyle must be less than or equal 120erscheinen. | Statuscode |error.code|error.message| | ----------- | ------------- | --------------------------------------------------------------- | | 400 |bad_request|Die Song-ID existiert nicht oder wurde offline genommen.| | 400 |bad_request|Prompt zu lang.| | 400 |bad_request|Tags zu lang.| | 400 |bad_request|Hochgeladenes Audio stimmt mit einem bestehenden Kunstwerk überein.| | 400 |bad_request|instrumental muss ein Boolean sein| | 400 |bad_request|Titel zu lang.| | 400 |bad_request|Thema zu lang.| | 400 |bad_request|style muss kleiner oder gleich 120 sein| | 400 |bad_request|custom muss ein Boolean sein| | 400 |bad_request|audio_id ist erforderlich, wenn Audio erweitert wird| | 400 |bad_request|continue_at ist erforderlich, wenn Audio erweitert wird| | 400 |bad_request|continue_at muss eine Zahl größer als 0 sein| | 400 |bad_request|lyric ist erforderlich, wenn Audio erweitert wird und instrumental false ist| | 400 |bad_request|prompt ist erforderlich, wenn Audio generiert wird| | 400 |bad_request|lyric ist erforderlich, wenn benutzerdefiniertes Audio generiert wird| | 403 |forbidden|Prompt wahrscheinlich fehlerhaft formatiert| | 403 |forbidden|Prompt wahrscheinlich urheberrechtlich geschützt| | 403 |forbidden|Prompt enthielt unangemessenes Material| | 403 |forbidden|Songbeschreibung zur Moderation markiert| | 403 |forbidden|Songbeschreibung enthielt Künstlernamen| | 403 |forbidden|Tags enthielten Künstlernamen| | 403 |forbidden|Liedtext enthielt urheberrechtlich geschütztes Material| | 403 |forbidden|Songbeschreibung enthielt Produzenten-Tag| | 403 |forbidden|Allgemeiner openAI-Fehler| | 403 |forbidden|Prompt zur Moderation markiert| | 500 |api_error|Liedtext konnte nicht aus der Songbeschreibung generiert werden| | 500 |api_error|Job ist mit unbekanntem Fehler fehlgeschlagen| | 500 |api_error|Kein verfügbarer Worker im System| | 500 |api_error|Dienst wird gewartet, Generierung pausiert| | 504 |timeout|Zeitüberschreitung beim Warten auf die Audiogenerierung|