

Los límites deSuno ahora admitelyricystylede la tabla anterior son los límites máximos en el modo personalizado (customestrue). El modo de inspiración no personalizado (customesfalse) solo completaprompt, y su límite de longitud es de 500 caracteres (igual para todos los modelos).
chirp-v6, chirp-v6-wild y chirp-v6-mini. Se recomienda utilizar chirp-v6; los nombres de modelos antiguos siguen siendo compatibles.
Sin embargo, Suno oficialmente no proporciona una API; AceDataCloud proporciona un conjunto de API de Suno, simulando la integración oficial de Suno, que permite generar de forma cómoda y rápida la música deseada.
Solicitud y uso
Para utilizar Suno Audios Generation API, primero obtenga su API Token en la consola de Ace Data Cloud, para tenerlo de respaldo. Si aún no ha iniciado sesión o no se ha registrado, será redirigido automáticamente a la página de inicio de sesión para invitarle a registrarse e iniciar sesión; al finalizar, volverá automáticamente a la página actual.
Un API Token puede invocar todos los servicios de la plataforma, no es necesario solicitarlo por separado para cada servicio. La primera solicitud otorgará cuota gratuita, que puede usarse para una experiencia gratuita; cuando la cuota sea insuficiente, puede recargar saldo general en la consola.
📘 Documentación completa: Suno Audios Generation API →
Uso básico
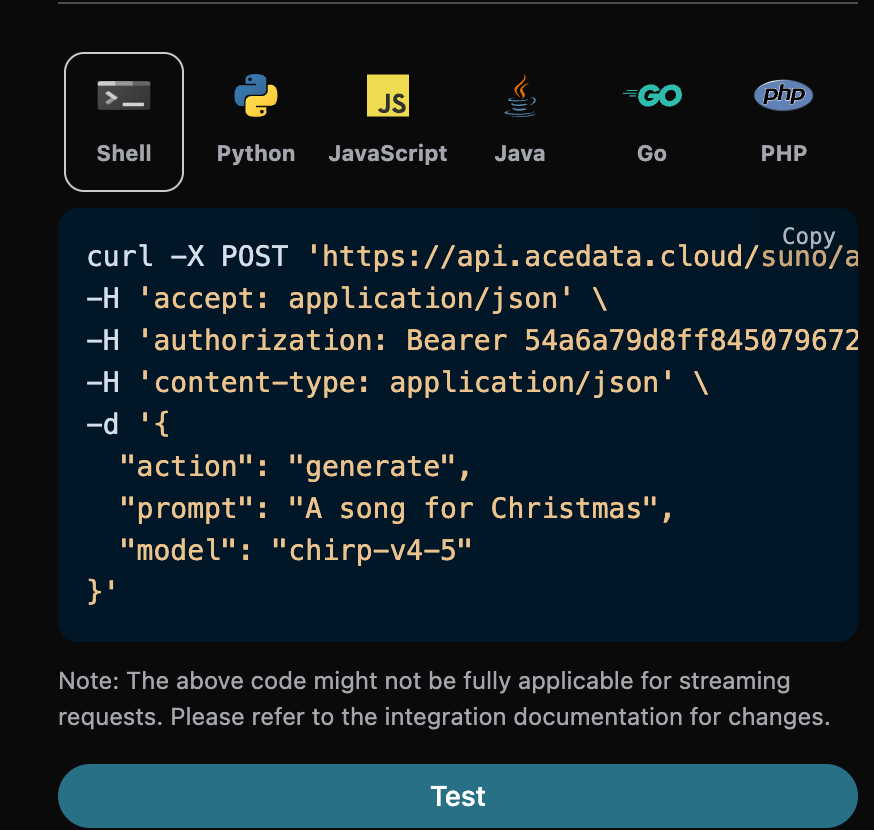
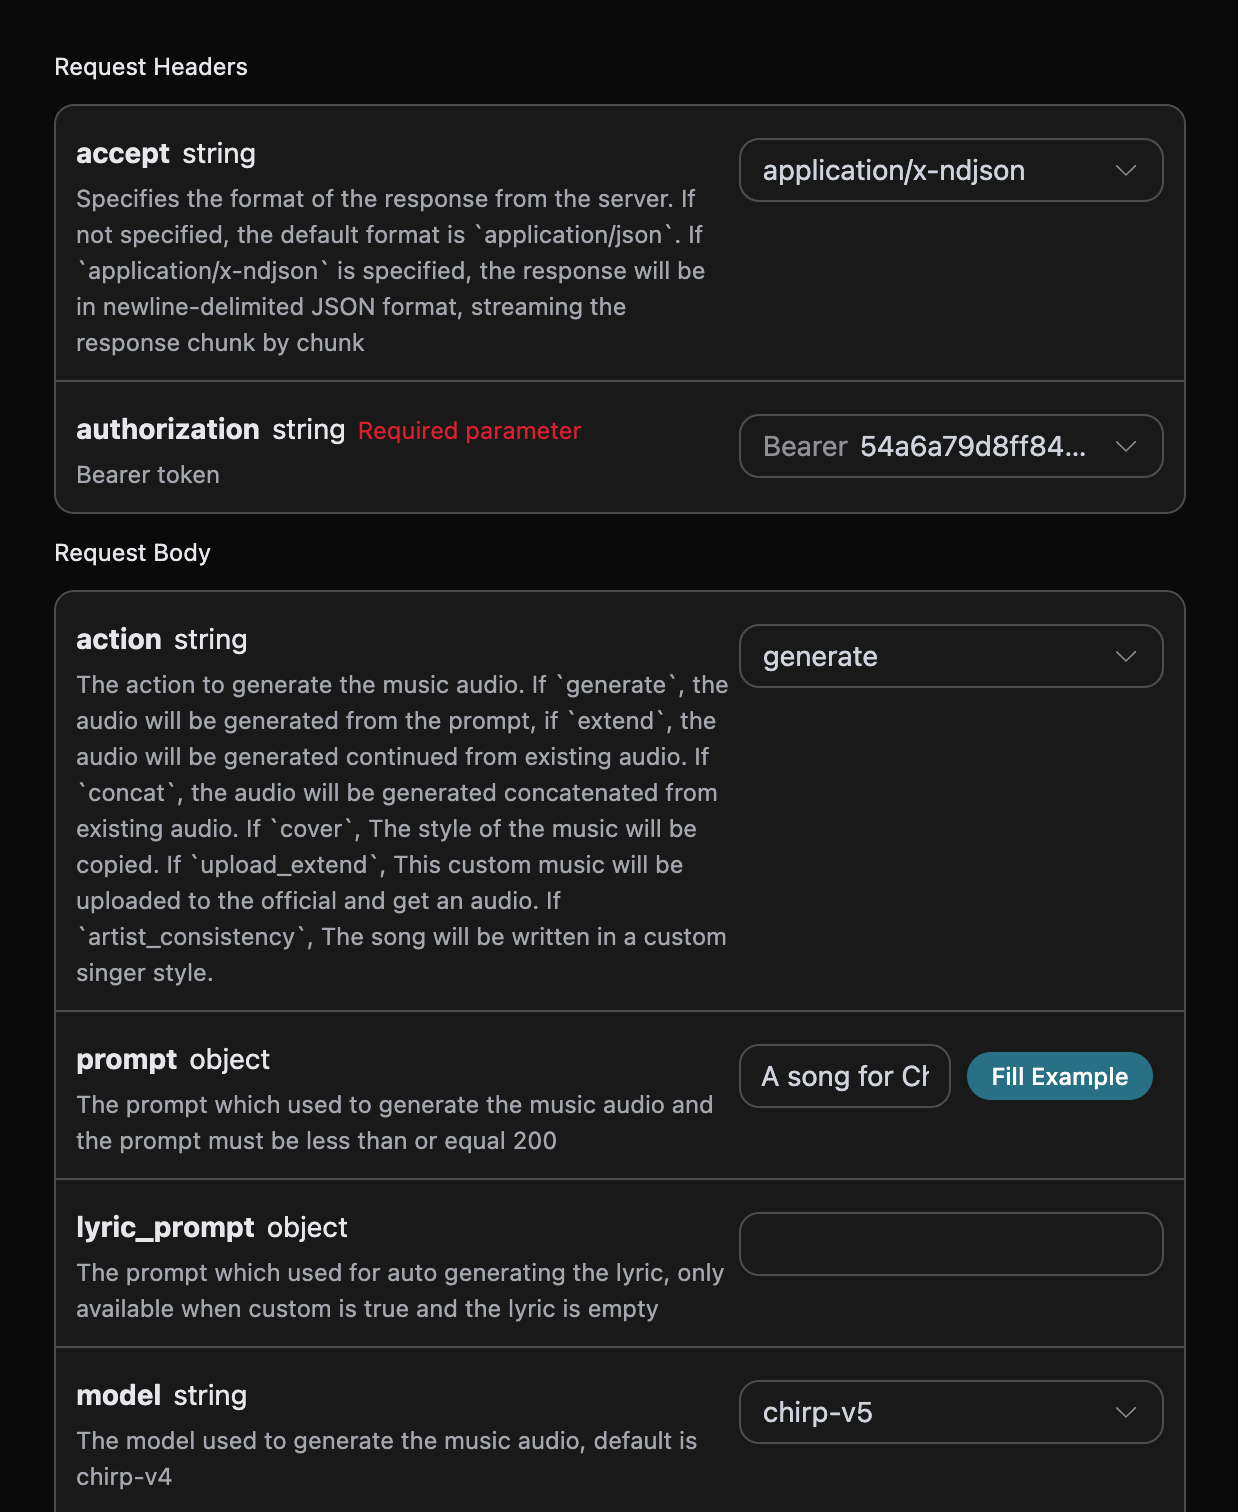
Qué canciones pensar, se puede introducir arbitrariamente un texto, por ejemplo, si quiero generar una canción sobre Navidad, puedo introducira song for Christmas, como se muestra en la imagen:
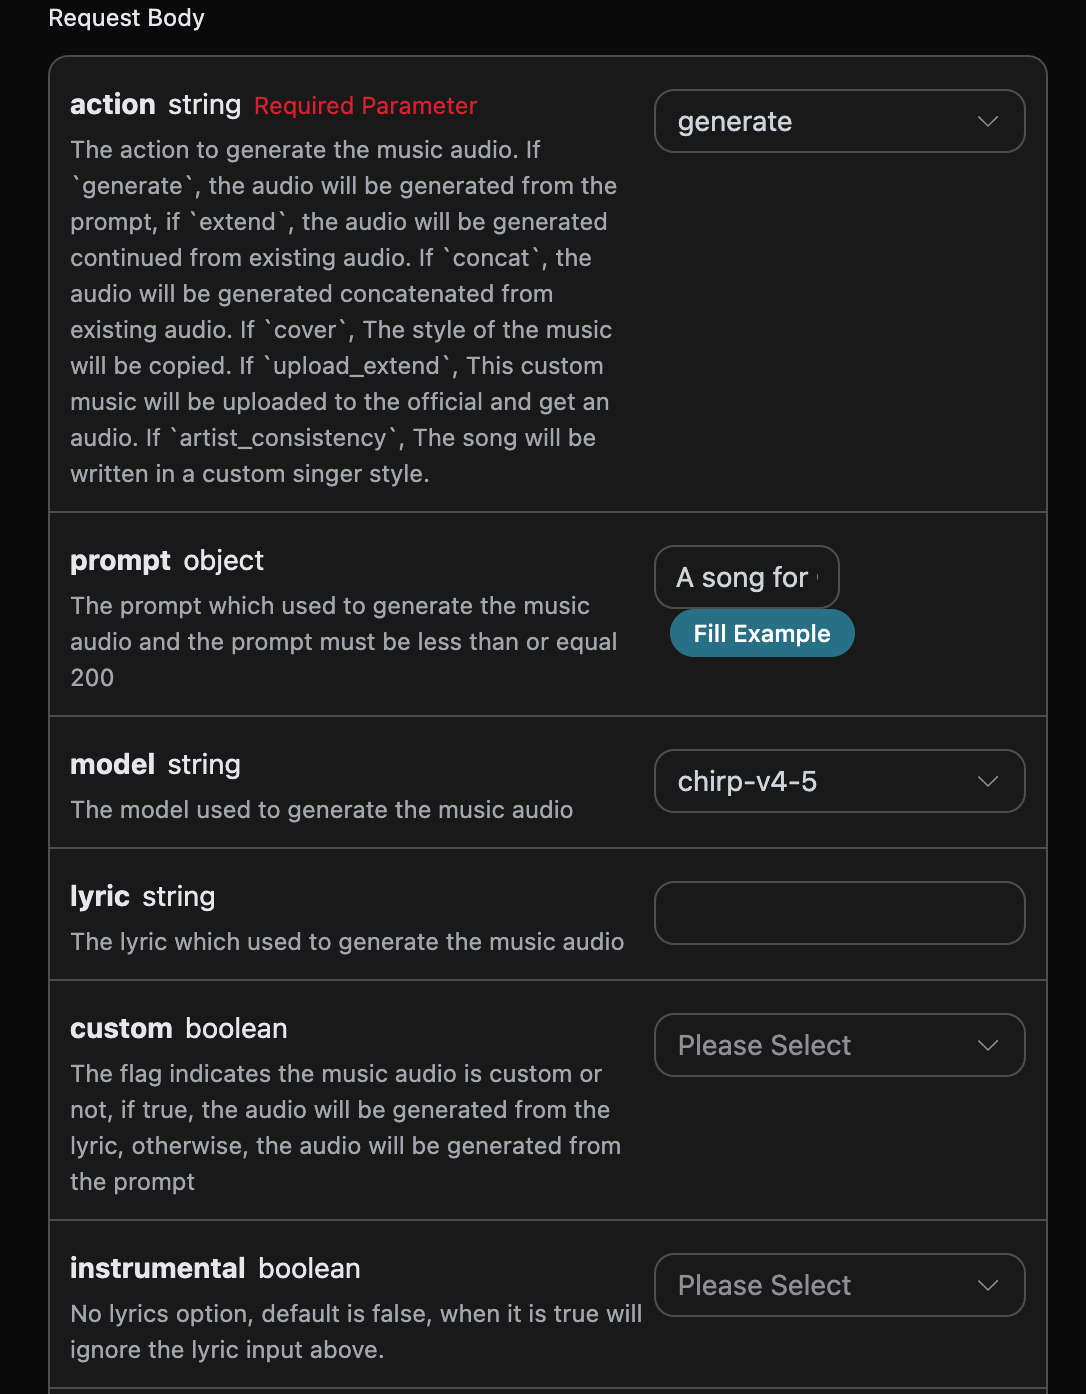
accept: qué formato de resultado de respuesta se desea recibir; aquí se completa comoapplication/json, es decir, formato JSON.authorization: la clave para invocar la API; después de solicitarla, puede seleccionarse directamente desde la lista desplegable.
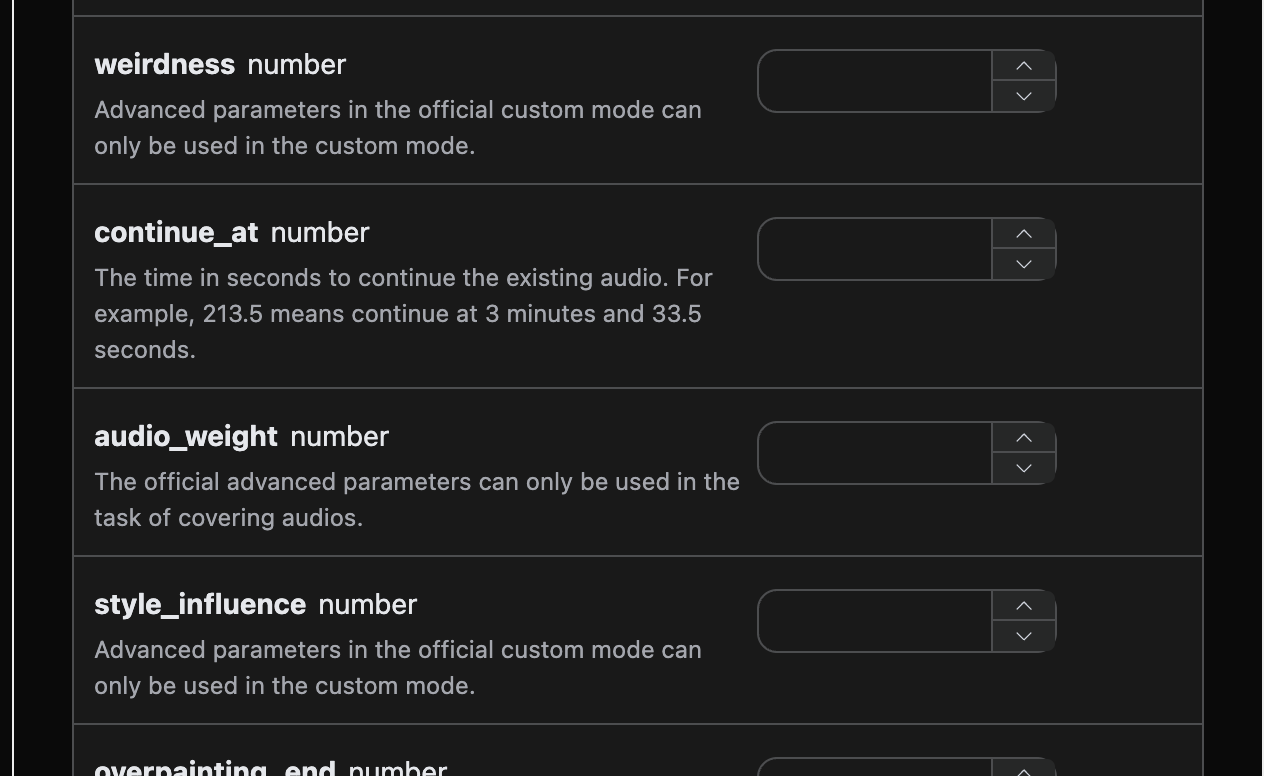
action: tipo de tarea de audio, el valor predeterminado esgenerate. Admite operaciones como generación, continuación, cover, concatenación, separación de pistas, adición de pistas de audio, extracción de pistas de audio especificadas, generación de efectos de sonido y ajuste de velocidad, todas invocadas de forma unificada mediantePOST /suno/audios.prompt: palabras clave del modo de inspiración oficial de Suno (surte efecto cuandocustomesfalse), máximo 500 caracteres.model: modelo para esta tarea de generación musical. La serie v6 incluyechirp-v6,chirp-v6-wildychirp-v6-mini; los nombres de modelos antiguos siguen siendo compatibles.max_mode: modo de generación mejorado.generatesolo se habilita cuando tantocustomcomomax_modesontrue, con un costo de 1.12 Credits;add_stempuede habilitarse directamente, con un costo de 1.344 Credits. Cuando se desactiva o se omite, los costos son 0.56 y 0.672 Credits respectivamente.variety: intensidad de diversidad de los resultados generados, opcional entreoff,normal,high,extra,max. Solo se utiliza paragenerateyadd_stem; pasarla en otras action devolverá 400.lyric: contenido de la letra en el modo personalizado oficial de Suno.chirp-v3-5ychirp-v4tienen un máximo de 3000 caracteres;chirp-v4-5y superiores (incluidoschirp-v5,chirp-v5-5) tienen un máximo de 5000 caracteres.custom: si se utiliza el modo personalizado, el valor predeterminado es:false.instrumental: opción de música instrumental del modo de inspiración oficial de Suno.title: título de la música en el modo personalizado oficial de Suno.chirp-v3-5,chirp-v4tienen un máximo de 80 caracteres;chirp-v4-5y superiores tienen un máximo de 100 caracteres.style: estilo musical del modo personalizado oficial de Suno.chirp-v3-5ychirp-v4tienen un máximo de 200 caracteres;chirp-v4-5y superiores (incluidoschirp-v5,chirp-v5-5) tienen un máximo de 1000 caracteres.negative_tags: estilos musicales o géneros que se desea excluir de los resultados generados en el modo personalizado (customestrue).audio_weight: peso de influencia de las características de audio o voz, rango 0-1,0también es un valor válido. Puede utilizarse para operaciones como generación, continuación, cover, adición de pistas de audio y consistencia de voz; cuando no hay audio de referencia o características de voz, el modelo puede atenuar o ignorar este valor.audio_id: ID de la música de referencia.overpainting_start/overpainting_end: tiempo de inicio y fin para añadir voces a música instrumental existente, en segundos.underpainting_start/underpainting_end: tiempo de inicio y fin para añadir acompañamiento a canto a capela, en segundos.persona_id: ID de la canción del artista.continue_at: límite de continuación, en segundos. Por ejemplo, 213.5 indica que se comienza a generar el fragmento posterior desde los 3 minutos y 33.5 segundos.lyricystylesolo guían el contenido nuevo después del límite, y no reemplazarán la letra ni el canto antes del límite en el audio de origen.style_influence: influencia del estilo en el modo personalizado, rango 0-1; cuanto mayor sea, normalmente más se ajustará al estilo seleccionado;0se transmitirá como un valor válido.replace_section_end: tiempo final del fragmento que se reemplazará.replace_section_start: tiempo de inicio del fragmento que se reemplazará.vocal_gender: controla la preferencia por voz femenina o masculina, voz femeninaf, voz masculinam; válido para modelos 4.5 y superiores; es una opción de preferencia y no se garantiza un cumplimiento estricto.weirdness: grado de rareza en el modo personalizado, rango 0-1; cuanto mayor sea, normalmente será más creativo y experimental;0se transmitirá como un valor válido.duration: duración esperada de la canción, en segundos, debe ser un entero, con un rango de 10 a 360. Este parámetro se utiliza para la generación de canciones en modo personalizado (customestrue). Es una indicación de tendencia y no una restricción estricta: el modelo la tendrá en cuenta, pero no garantiza alcanzarla; la duración real del producto final se basará en el campodurationde la respuesta y normalmente será menor que el valor esperado.
Ámbito de aplicación de parámetros avanzados
La plataforma validará los tipos de parámetros y los rangos numéricos, pero no rechazará estos elementos de ajuste opcionales únicamente porque la action sea diferente; el efecto específico depende de la operación, el modo y el modelo.
lyric_prompt: prompt para generar letras, surte efecto si y solo sicustomestruey no se proporcionalyric.callback_url: URL que requiere recibir el resultado mediante callback.async: opcional; cuando se establece entrue, la interfaz devuelve inmediatamentetask_id, no es necesario proporcionarcallback_url, y posteriormente se obtiene el resultado mediante sondeo a través de la interfaz de consulta de tareas correspondiente.
- success: si la generación se realizó correctamente; si tiene éxito, será
true, de lo contrario seráfalse - data: es una lista que contiene la información detallada de las canciones generadas.
- state: estado de generación de la canción, incluye principalmente cuatro tipos, específicamente los siguientes:
- succeeded: generación exitosa
- pending: en cola
- running: en ejecución
- error: error
- id: ID de la canción
- title: el título de la canción
- image_url: la imagen de portada de la canción
- lyric: la letra de la canción
- audio_url: la dirección de audio final de la canción. La plataforma devolverá prioritariamente la dirección de Ace Data Cloud CDN; si la persistencia falla, puede devolver la dirección de medios original, descárguela a tiempo.
- video_url: el archivo de video de la canción; al abrirlo es un video mp4.
- created_at: la hora de creación
- model: el modelo utilizado, generalmente el modelo v3 más reciente
- style: el estilo
- state: estado de generación de la canción, incluye principalmente cuatro tipos, específicamente los siguientes:
Generación personalizada
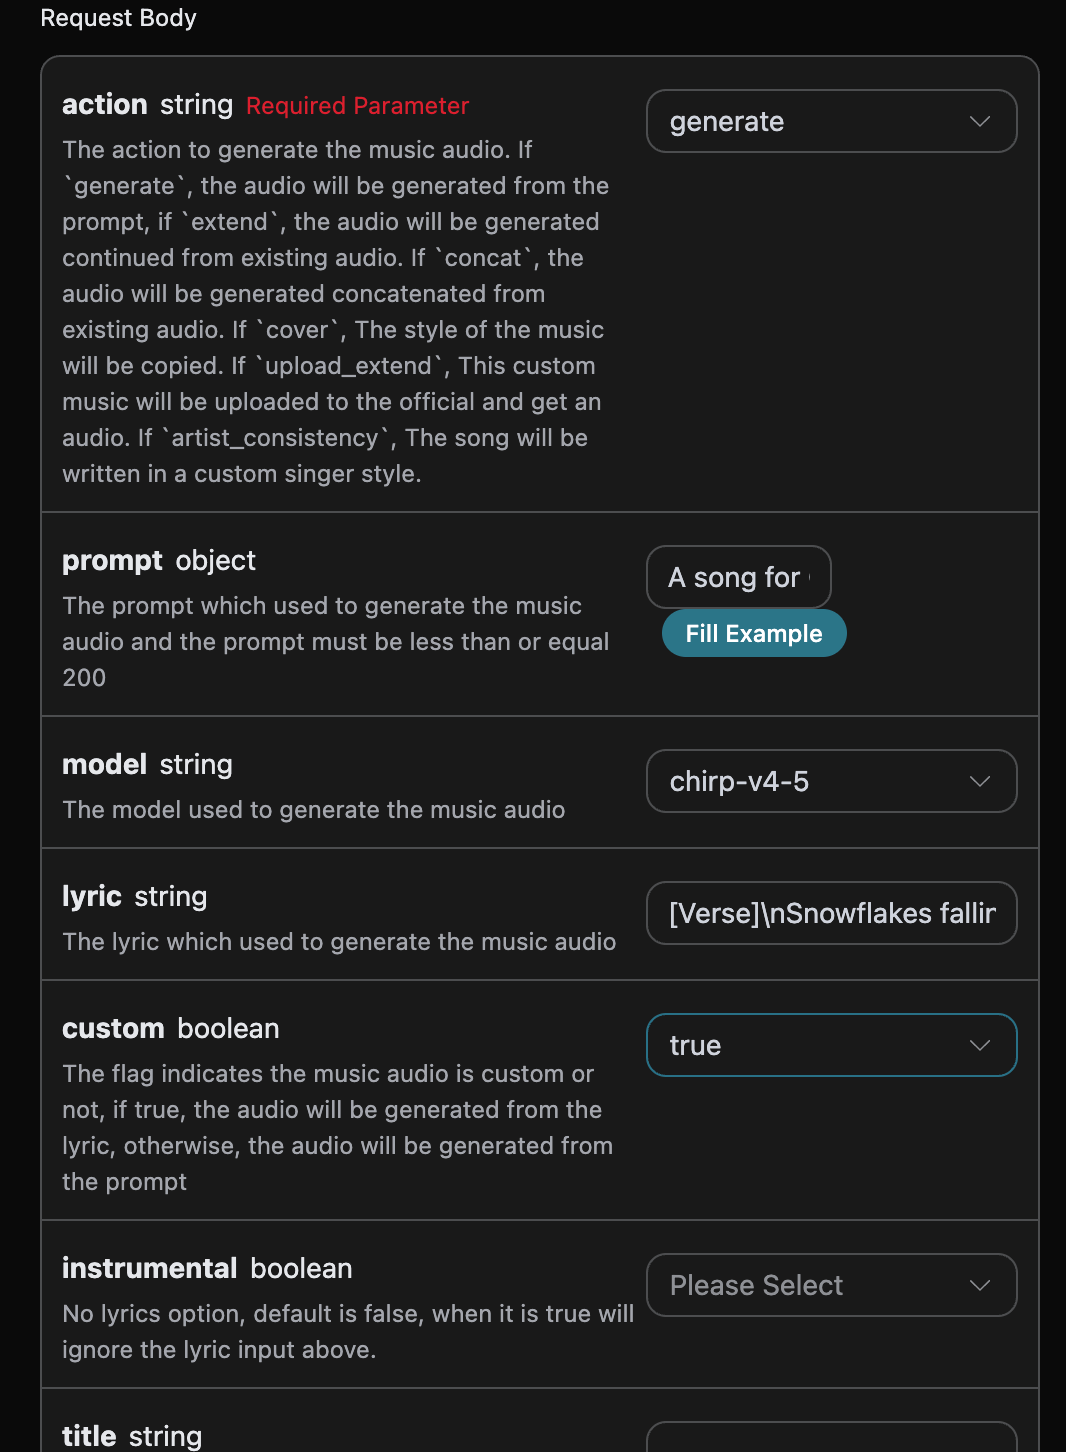
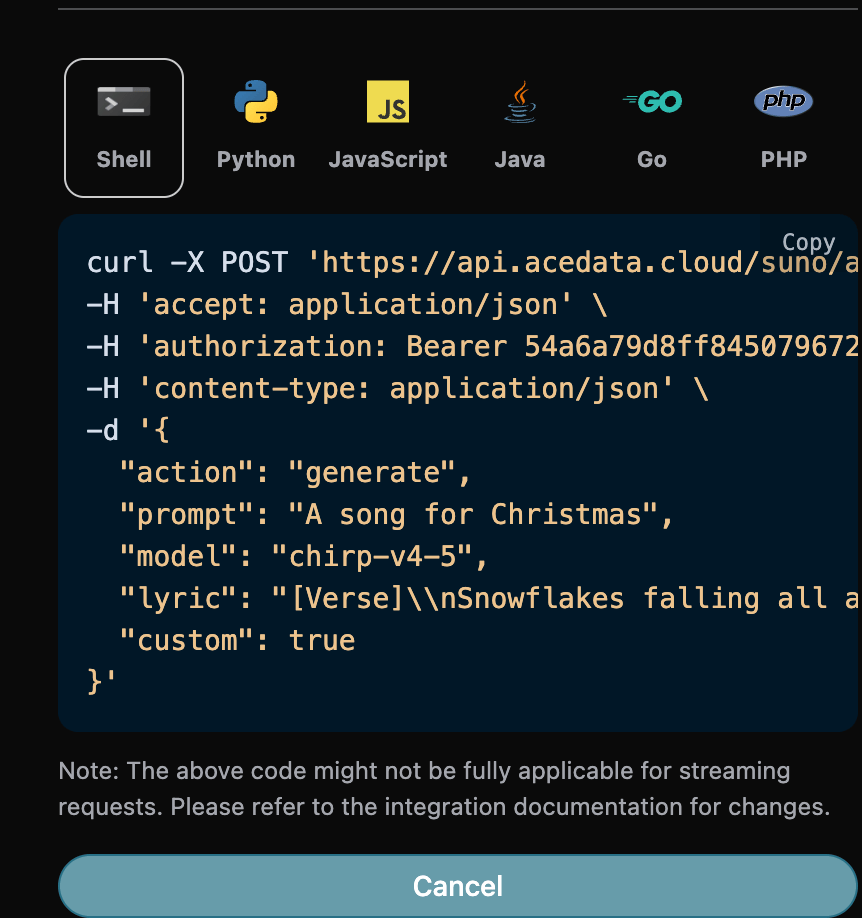
Si desea generar letras de forma personalizada, puede ingresar la letra: En este momento, el campolyric puede recibir contenido similar al siguiente:
Nota: en la letra aquí, \n es un salto de línea. Si no sabe cómo generar letras, puede utilizar la API de generación de letras proporcionada por AceDataCloud para generar letras mediante un prompt; la API es Suno Lyrics Generation API.
A continuación, para generar una canción personalizada según la letra, el título y el estilo, puede especificar el siguiente contenido:
- lyric: texto de la letra
- custom: complete con
true, lo que representa la generación personalizada; este parámetro es false de forma predeterminada, lo que representa la generación medianteprompt. - title: el título de la canción.
- style: el estilo de la canción, opcional.
Función de generación personalizada de estilo de cantante
Si desea utilizar un estilo de cantante para generar canciones, primero genere una canción mediante el uso básico anterior,finalmente se obtiene que es necesario configurar esta canción como estilo de cantante, luego debe ingresar a Suno Persona API para generar un parámetro de ID de estilo de cantante
persona_id según el ID de música generado oficialmente audio_id; los parámetros específicos se muestran en la siguiente imagen:
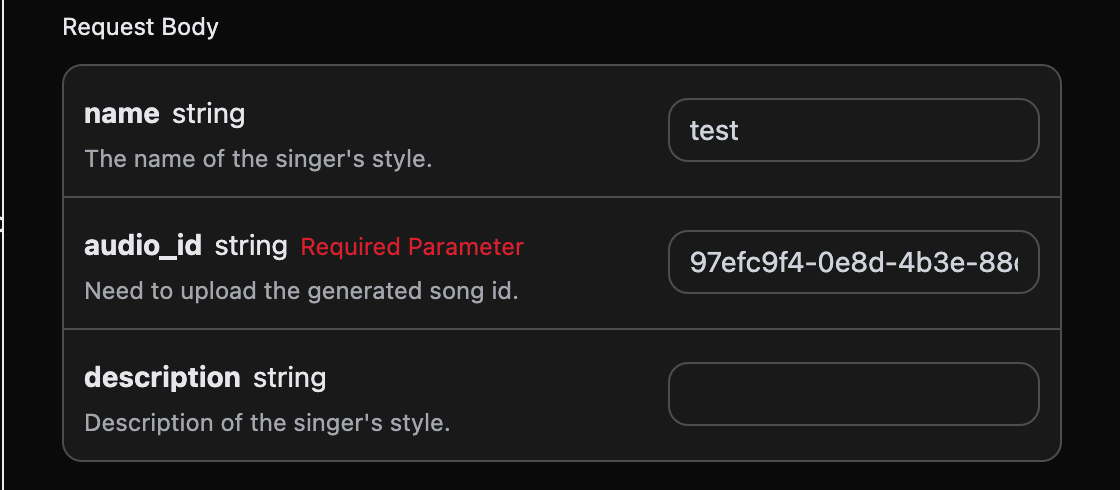
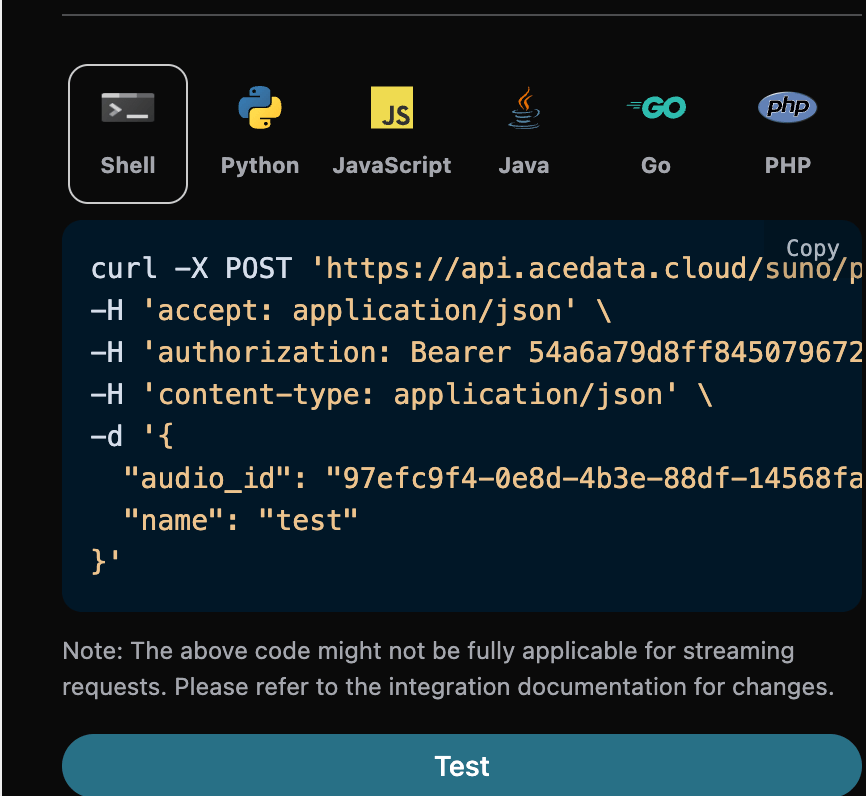
audio_id y persona_id anteriores, 97efc9f4-0e8d-4b3e-88df-14568fa1b11f y e0d7319e-aa2a-44cb-b00a-916218d7cb0b respectivamente, como datos de ejemplo para esta ocasión. Luego puede establecer el parámetro action como artist_consistency (si se trata del nuevo estilo de cantante Persona-v2-vox, action debe establecerse como artist_consistency_vox), e introducir el ID de la canción que necesita seguir generándose y el ID del estilo de cantante; el ejemplo de llenado es el siguiente:
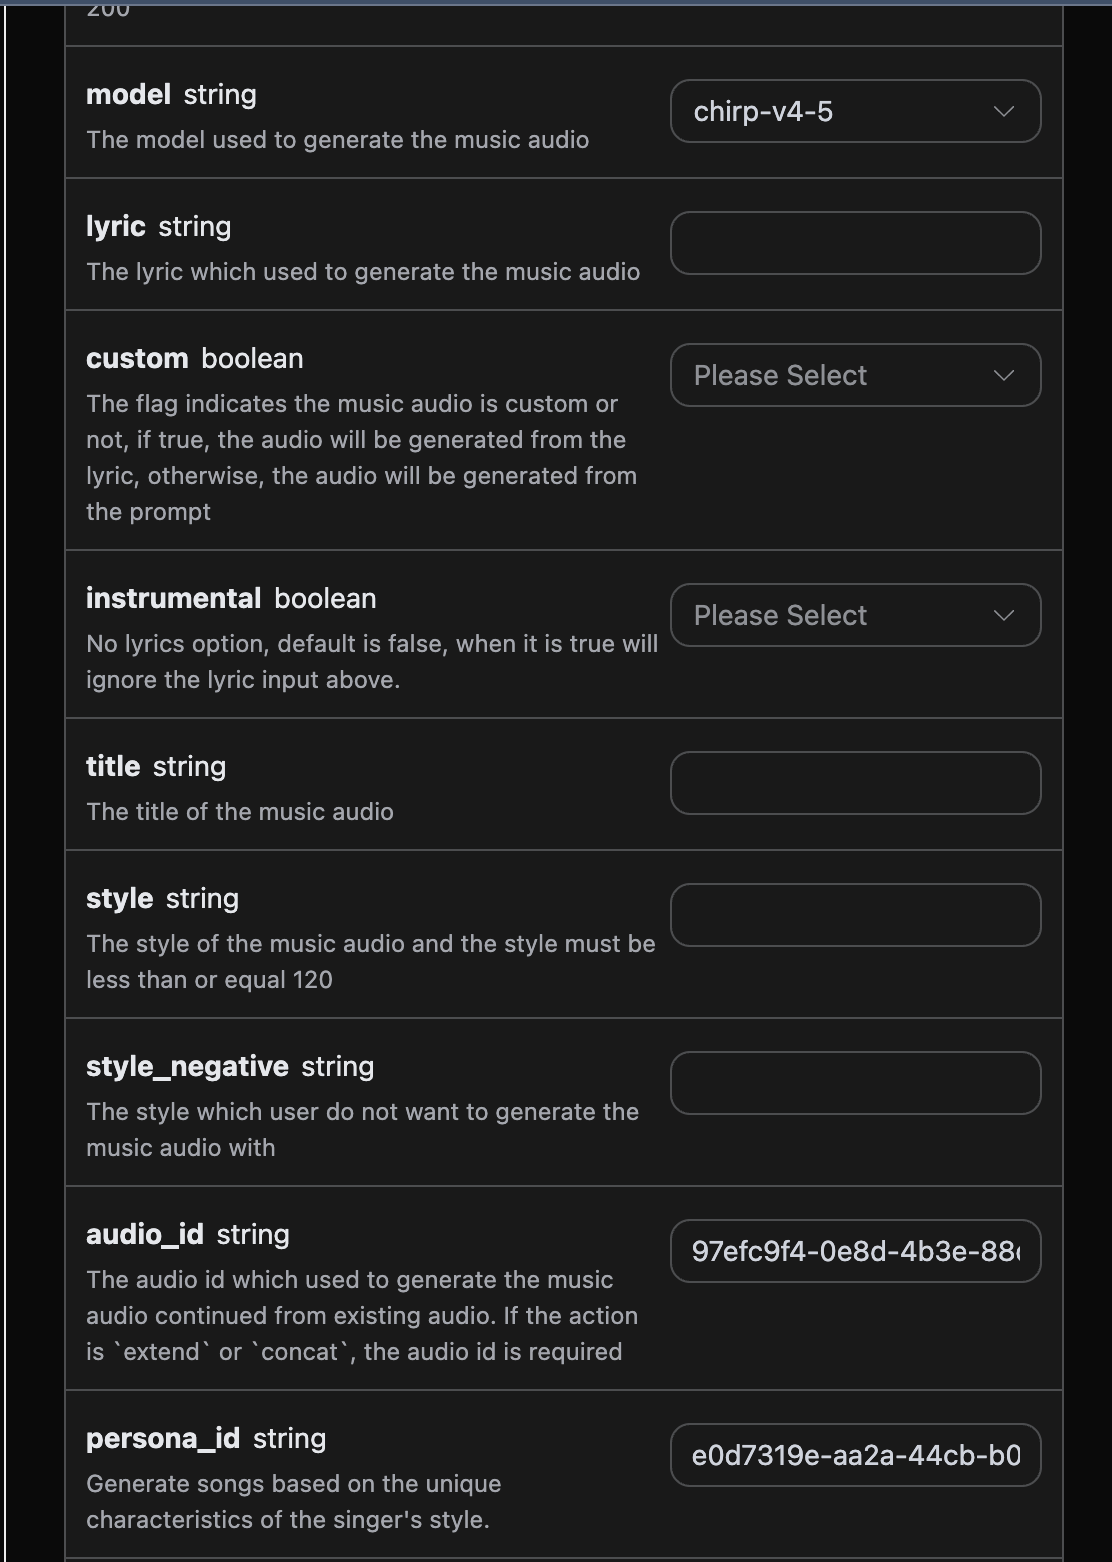
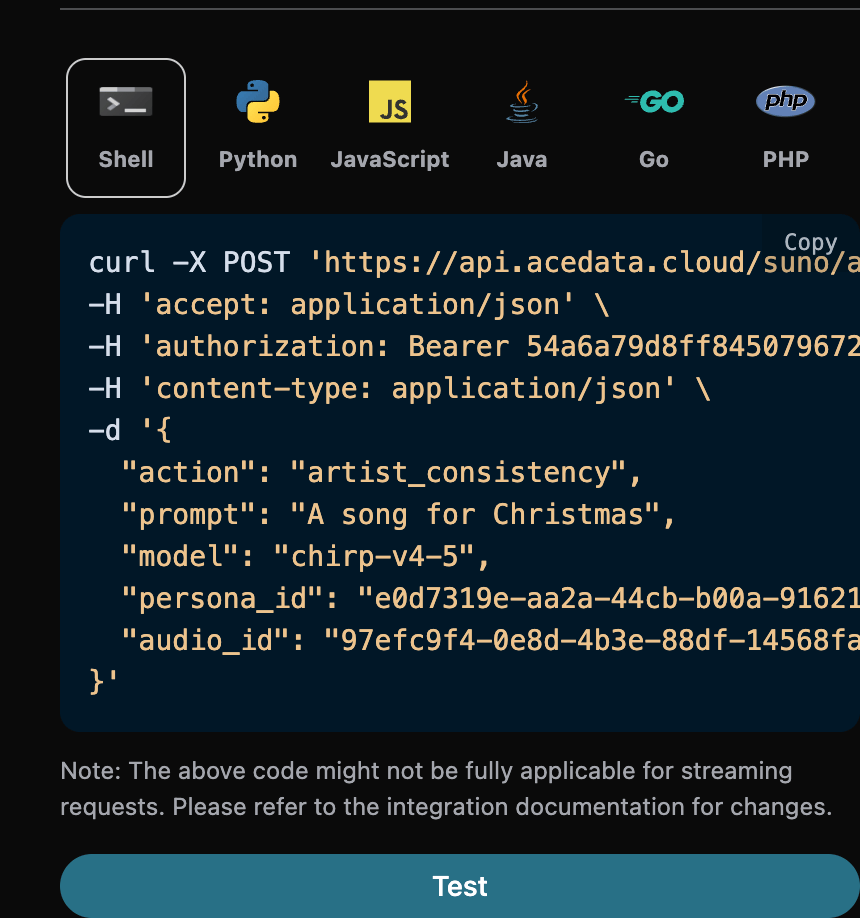
Función de continuación de generación
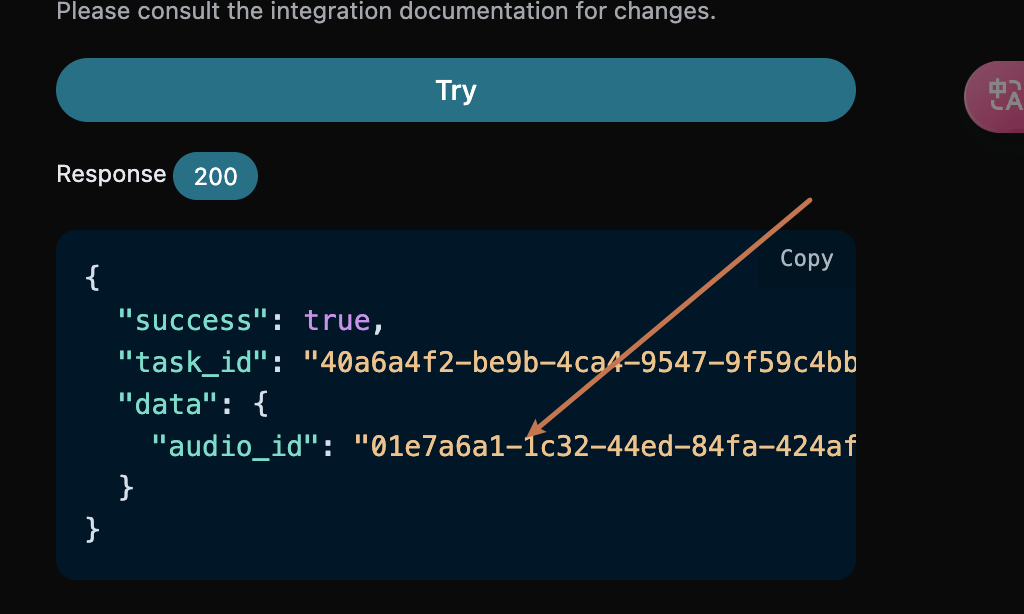
Si desea continuar generando una canción de Suno ya generada, puede establecer el parámetroaction como extend e introducir el ID de la canción que necesita seguir generándose. La obtención del ID de la canción se realiza según el uso básico; según lo anterior, en este momento puede ver que el ID de la canción es:
Tenga en cuenta que el id en la letra aquí es el ID de la canción después de generarse. Si no sabe cómo generar una canción, puede consultar el uso básico anterior para generar una canción.
Si desea continuar generando una canción que haya subido usted mismo, puede establecer el parámetro action como upload_extend e introducir el ID de la canción personalizada subida que necesita seguir generándose. La obtención del ID de la canción se realiza mediante Suno Upload Generation API, como se muestra en la siguiente imagen:
- lyric: solo se utiliza para guiar la letra del nuevo fragmento generado después de
continue_at; no reemplazará la letra anterior a ese punto temporal en el audio de origen. - custom: complételo como
true, lo que representa una generación personalizada; este parámetro es false por defecto, lo que representa la generación medianteprompt. - style: el estilo de canción del fragmento de continuación, opcional.
- continue_at: límite de continuación, en segundos. Por ejemplo, 213.5 indica que se generan los fragmentos posteriores a partir de los 3 minutos y 33.5 segundos.
El ejemplo de llenado es el siguiente:extendse utiliza para continuar creando a partir de una canción existente, no para cambiar la letra de toda la canción. Si desea utilizar una nueva letra desde el principio para toda la canción, utilicegeneratepara volver a generar; si desea reinterpretar una canción existente como referencia, puede utilizarcover. Al introducir una letra nueva completa, la letra original anterior acontinue_atseguirá sin reemplazarse.
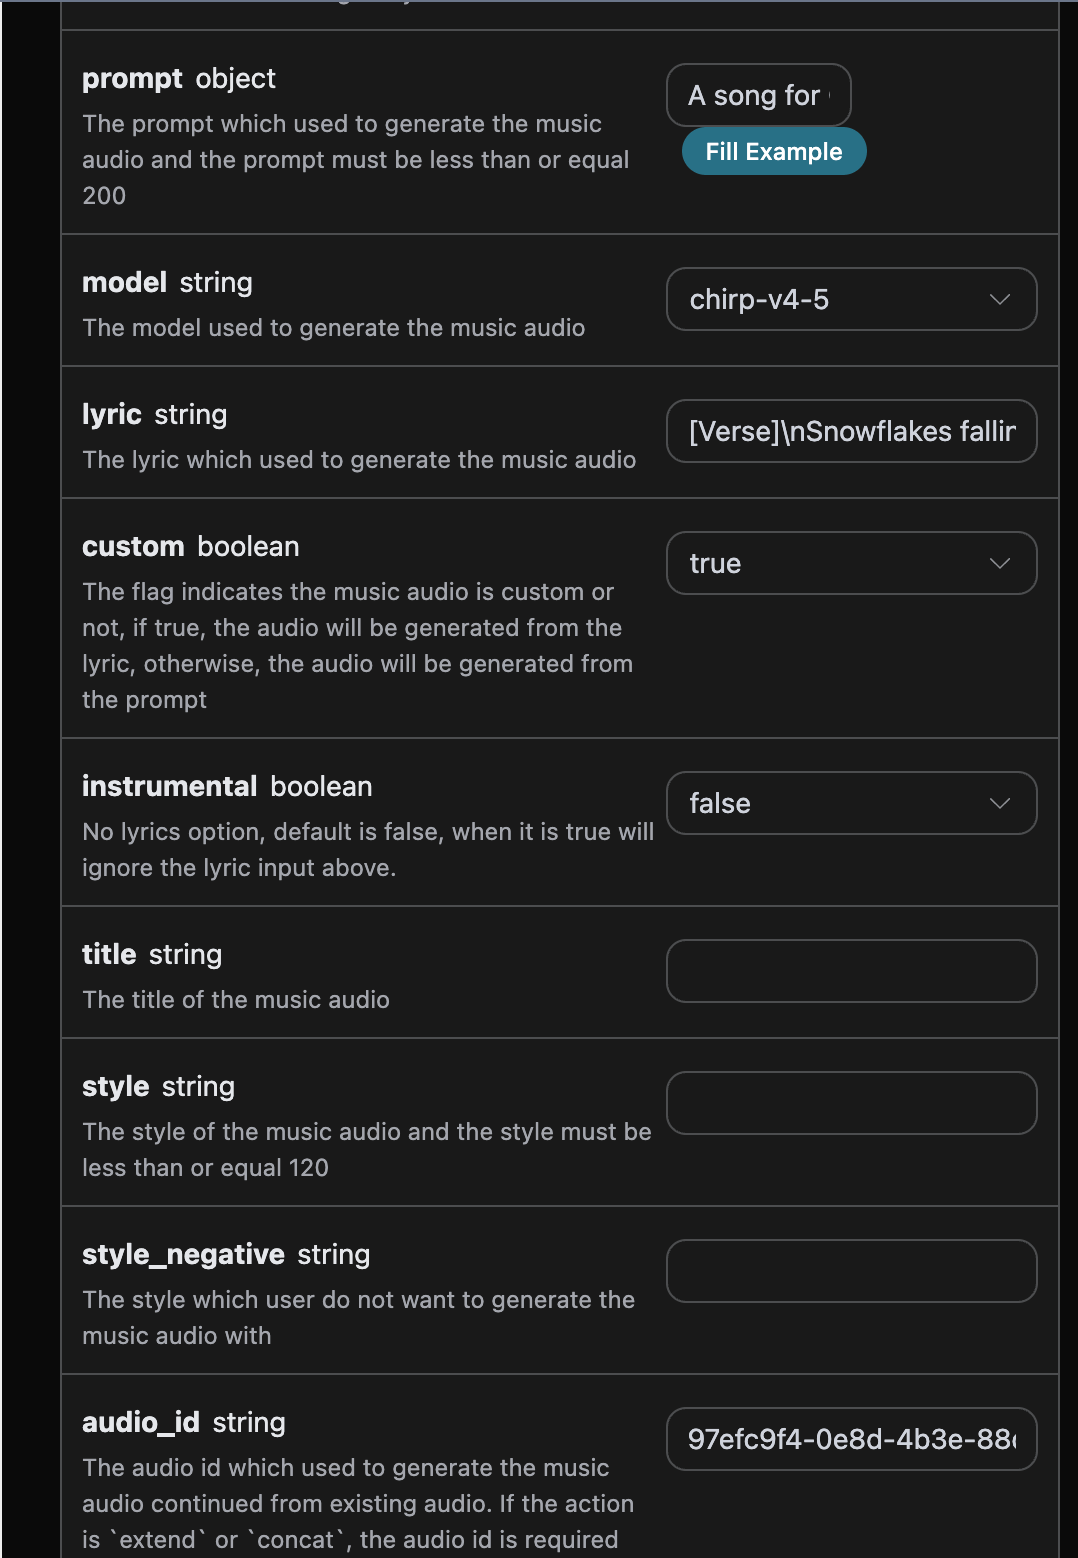
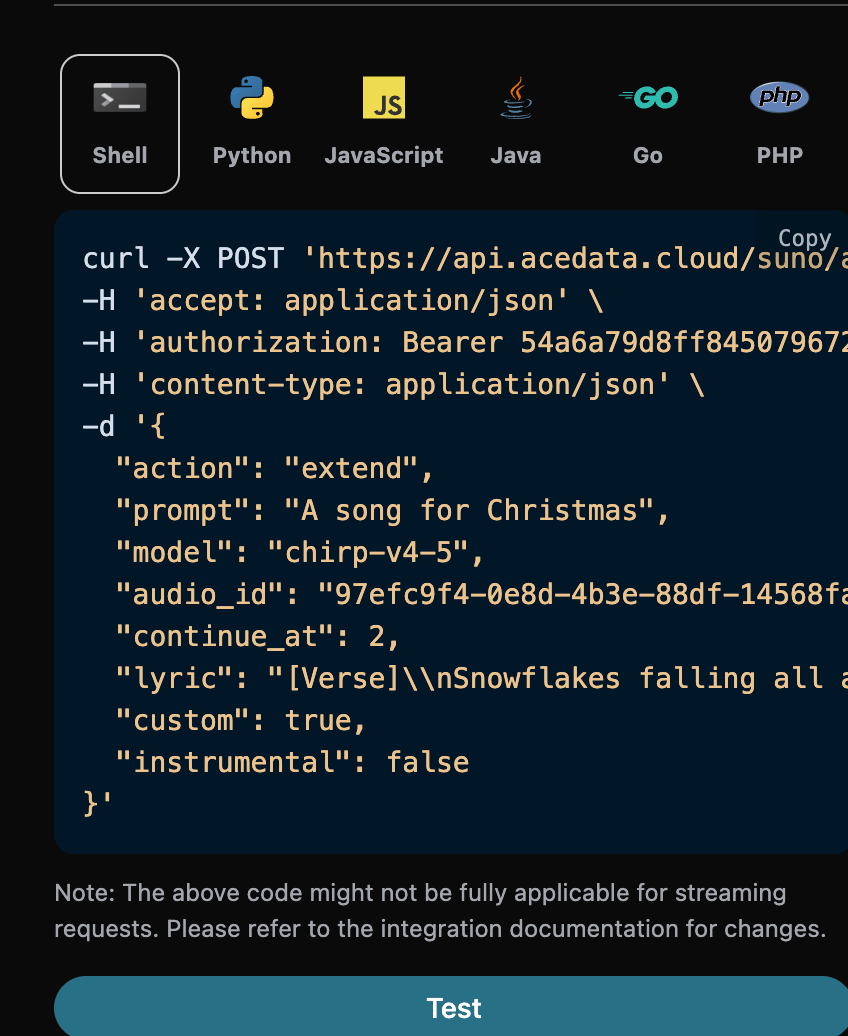
continue_at es de 2 segundos; por lo tanto, solo los primeros 2 segundos pertenecen al contenido original anterior al límite de continuación. Al continuar cerca del final de una canción, este valor debe establecerse en el segundo en el que se espera comenzar la continuación, y solo se debe proporcionar en lyric el nuevo fragmento que se cantará después del límite.
El código Python correspondiente:
lyric en el resultado devuelve el texto de la letra utilizado en esta tarea de continuación. Este campo no es una transcripción literal del audio final completo; para extend, el audio de origen anterior a continue_at sigue usando la letra original, y la nueva letra solo se utiliza para guiar el fragmento de continuación.
Obtener la canción completa
El resultado deextend del modelo actual normalmente ya incluye el audio de origen anterior a continue_at y el nuevo contenido posterior al límite; primero determina si ya es la canción completa según la duración real y el contenido del audio devuelto. Si se devuelve un fragmento de continuación independiente, o si es necesario fusionar explícitamente el historial de múltiples continuaciones en una canción, utiliza entonces la función de concatenación:
- action: el contenido es
concat. - audio_id: el ID del último fragmento de continuación.
Versión de música
Cuando se continúa generando una canción basándose en una canción existente, el estilo de la canción devuelta puede no ser muy adecuado. Si se desea crear una versión de una canción generada previamente (también se admite música personalizada subida), se debe utilizar el método de versión de música, con el que se puede especificar el siguiente contenido:- action: El contenido es
cover; cuando se realiza una operación de versión sobre música personalizada subida, se debe especificar el contenido como:upload_cover. - audio_id: El ID de la canción generada previamente.
Reemplazar fragmento
Cuando, después de generar una canción, se necesita realizar una creación secundaria mediante una operación independiente de reemplazo de fragmentos de la canción, se puede realizar una operación de reemplazo sobre un determinado fragmento de la canción.⚠️ Nota:La descripción de los parámetros es la siguiente:replace_section_result_modeesfull_songde forma predeterminada: el sistema concatenará respectivamente 2 candidatos recién generados y devolverá 2 canciones completas. Si solo se necesitan los candidatos de fragmentos de reemplazo que aún no se han concatenado, establezca explícitamente el valor encandidatesy luego seleccione un candidato para llamar a Concatenación de música.
- action: El contenido es
replace_section. - audio_id: El ID de la canción original (la canción fuente que se reemplaza).
- model: El modelo de generación de canciones.
- lyric: La letra completa después del reemplazo (incluido el fragmento reemplazado y su contexto, coherente con el contenido de
prompt). - prompt: La nueva letra de la sección que se necesita reemplazar.
- style: El estilo de la canción, opcional.
- replace_section_start: El tiempo de inicio (segundos) del fragmento reemplazado en la canción original.
- replace_section_end: El tiempo de finalización (segundos) del fragmento reemplazado en la canción original.
- replace_section_result_mode: El modo de devolución, cuyo valor predeterminado es
full_song.full_songconcatena respectivamente 2 candidatos y devuelve 2 canciones completas;candidatesdevuelve 2 fragmentos candidatos aún no concatenados.
Paso uno: iniciar una tarea de reemplazo de fragmento
Por ejemplo, si el ID de la canción generada previamente es: 18db7ed0-2b8a-41db-91c1-b0781dcca0d4 (con una duración de 94.12 segundos), y se desea reemplazar el estribillo desde el segundo 30 hasta el segundo 60 por una nueva letra, entonces se pueden establecer los parámetros de la siguiente manera:replace_section_result_mode se establece en candidates, devuelve 2 fragmentos de reemplazo aún no concatenados, con una estructura coherente con el siguiente ejemplo:
candidates, las duraciones de las dos pistas de audio devueltas (45.16 segundos, 33.8 segundos) son mucho más cortas que la canción original (94.12 segundos); son fragmentos de reemplazo que contienen una pequeña cantidad de contexto y no son la canción completa. Puedes seleccionar un candidato satisfactorio y continuar concatenándolo manualmente. El modo predeterminado full_song completará dos concatenaciones y devolverá directamente 2 canciones completas.
Devolver directamente canciones completas
Si deseas obtener directamente canciones completas, puedes establecerreplace_section_result_mode en full_song en el paso uno. La interfaz concatenará respectivamente los dos candidatos y devolverá 2 canciones completas; en este caso, no es necesario llamar de nuevo a concat.
Paso dos: concatenar el fragmento de reemplazo de vuelta a la canción original
Para el fragmento seleccionado anteriormente (por ejemplo,364f9d8b-ca25-463b-9a5e-d0b7139e2d6a), inicia una tarea concat según el método de la sección Concatenación de música:
duration se ha restaurado a la duración completa de la canción (105.28 segundos, aproximadamente igual a la duración de la canción original), y audio_url apunta a la canción completa después de finalizar el reemplazo. Esto completa el flujo de creación secundaria de “generar → reemplazar fragmento → unir canción completa”.
Separación de voces e instrumentos
Cuando, después de generar una canción, se necesita realizar una creación secundaria con operaciones independientes sobre el acompañamiento y las voces, se pueden separar el acompañamiento instrumental puro y las voces a capela. Se puede especificar el siguiente contenido:- action: el contenido es
stems. - audio_id: el ID de la canción generada anteriormente.
Separación de voces e instrumentos de todas las pistas
Cuando, después de generar una canción, se necesita realizar una operación de separación de voces e instrumentos de todas las pistas, se puede especificar el siguiente contenido:- action: el contenido es
all_stems. - audio_id: el ID de la canción generada anteriormente.
Añadir pista de audio
add_stem genera una pista del instrumento o sonido objetivo para el audio especificado, mediante la llamada a POST /suno/audios.
- Obligatorios:
action,audio_id,stem_type. - Opcionales:
model,prompt,title,style,negative_tags,weirdness,style_influence,audio_weight,max_mode,variety. - Facturación: 0.672 Credits en modo normal; 1.344 Credits cuando
max_modeestrue.
Extraer pista de audio
extract_stem extrae la pista de audio objetivo del audio especificado y, al mismo tiempo, devuelve la versión complementaria después de eliminar dicha pista, mediante la llamada a POST /suno/audios.
- Obligatorios:
action,audio_id,stem_type. - Opcional:
audio_format, el contrato público actual de doble canal solo admitemp3. - Facturación: 1.12 Credits.
data de la respuesta en estado final conserva una lista plana de audios, y stem_sets indica la relación correspondiente entre la pista de audio objetivo y la pista de audio complementaria:
Generar efectos de sonido
sounds genera efectos de sonido de una sola vez o en bucle según una descripción de texto, mediante la llamada a POST /suno/audios.
- Obligatorios:
action,sound,sound_type. - Opcionales:
model,bpm,key,audio_format;audio_formatactualmente solo admitemp3. sound_type:one-shotoloop.- Facturación: 0.112 Credits.
Ajustar la velocidad del audio
adjust_speed ajusta la velocidad de reproducción del audio especificado, mediante la llamada a POST /suno/audios.
- Obligatorio:
action,audio_id,speed_multiplier,title. - Opcional:
keep_pitch. speed_multiplier: rango de 0.25–4.- Facturación: 0.28 Credits.
Parámetros avanzados para la generación personalizada
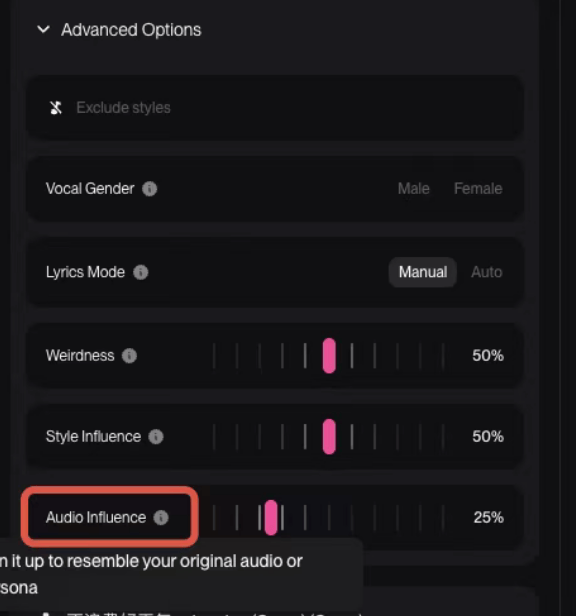
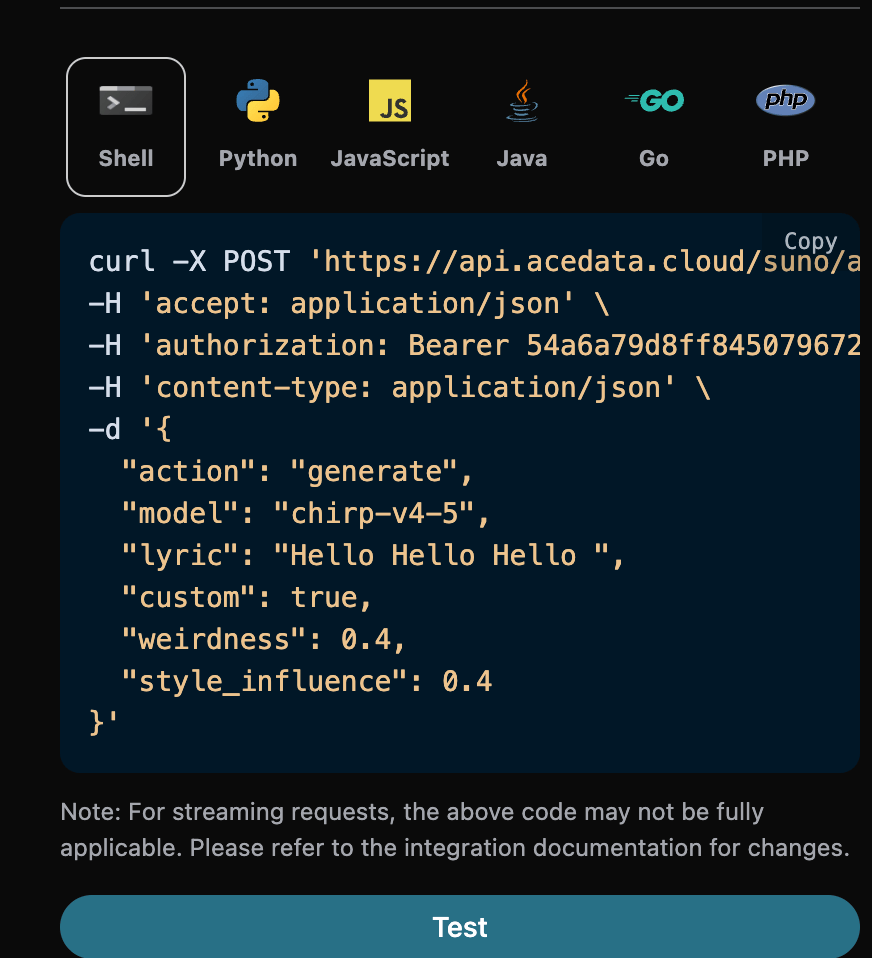
La plataforma oficial permite utilizar los parámetros avanzadosweirdness==>Weirdness, style_influence==>Style Influence, audio_weight==>Audio Influence para la generación en modo personalizado, correspondientes a los siguientes ejemplos oficiales:
Controlar la duración de la canción
De forma predeterminada, la duración de las canciones generadas la decide el propio modelo, normalmente entre 30 segundos y 4 minutos. Si se necesita un producto final más largo o más corto, se puede especificar la duración deseada mediante el parámetroduration, cuya unidad son segundos y cuyo valor debe ser un número entero entre 10 y 360.
Este parámetro se utiliza para la generación de canciones en modo personalizado (custom es true). Es necesario aclarar especialmente que duration es una indicación de tendencia, no una restricción estricta: el modelo hará referencia a este valor al crear, pero no garantiza alcanzarlo; en las pruebas, la duración real suele ser notablemente menor que el valor esperado, y las duraciones de las dos canciones devueltas en una misma solicitud también pueden diferir varias veces. Incluso para solicitudes completamente idénticas, las duraciones obtenidas tras varios envíos también pueden variar considerablemente. Por lo tanto, no lo utilice como un control preciso de duración; si se requiere una duración fija para el negocio, recorte o vuelva a intentarlo por su cuenta después de obtener el producto final.
El código Python correspondiente:
duration en la solicitud es la duración esperada, mientras que el campo duration de cada canción en los data de la respuesta es la duración real de esa canción. Ambos tienen el mismo nombre, pero significados diferentes; no se garantiza que la duración real sea igual al valor esperado. La longitud de la letra es uno de los principales factores que afectan la duración del producto final; si se necesita un producto final más largo, se recomienda proporcionar letras más completas al mismo tiempo.
La interfaz validará que duration debe ser un entero entre 10 y 360; sigue siendo solo un objetivo de generación, no una garantía de la duración del producto final.
Función Add Insterumental
En agosto de 2025, suno lanzó la nueva función Add Insterumental. Primero es necesario subir una canción a capela sin voz en off, para que suno te ayude a añadirle acompañamiento musical. Primero puedes ir a Suno Upload API para subir una canción a capela sin acompañamiento musical; las operaciones correspondientes se muestran en la siguiente imagen: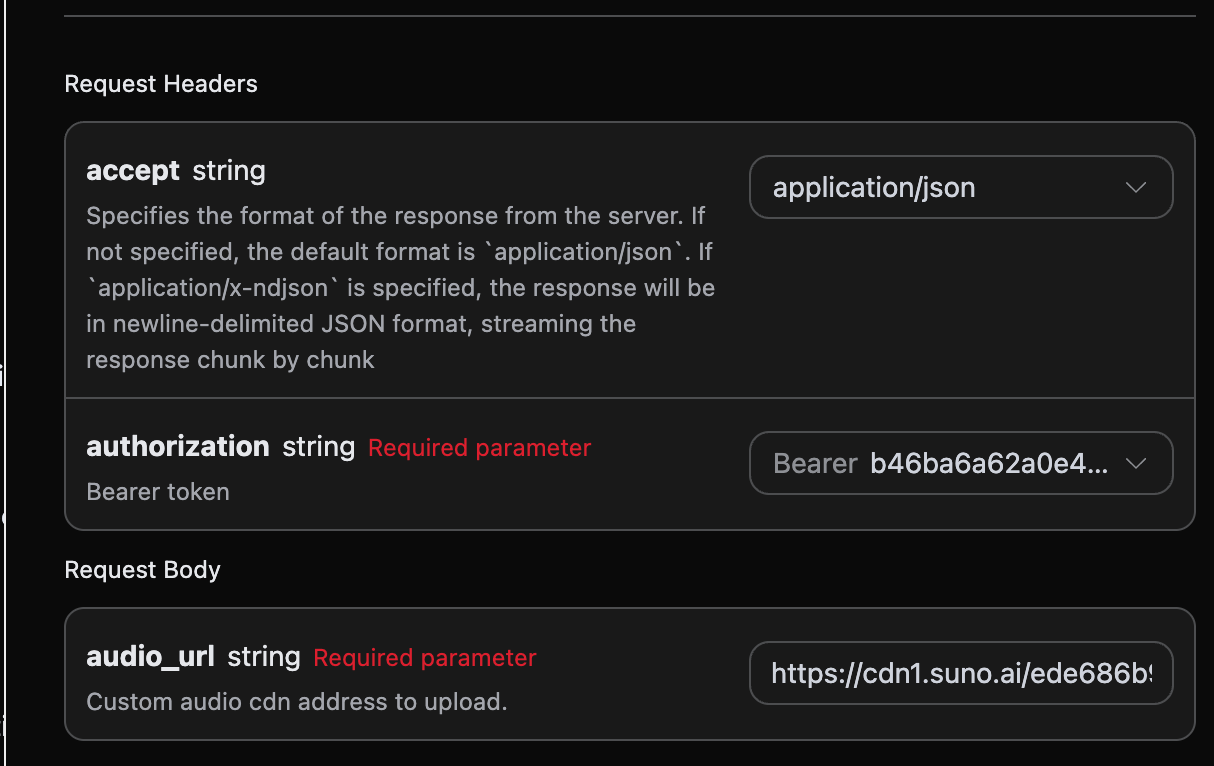
audio_id después de la subida; el resultado específico se muestra en la siguiente imagen:
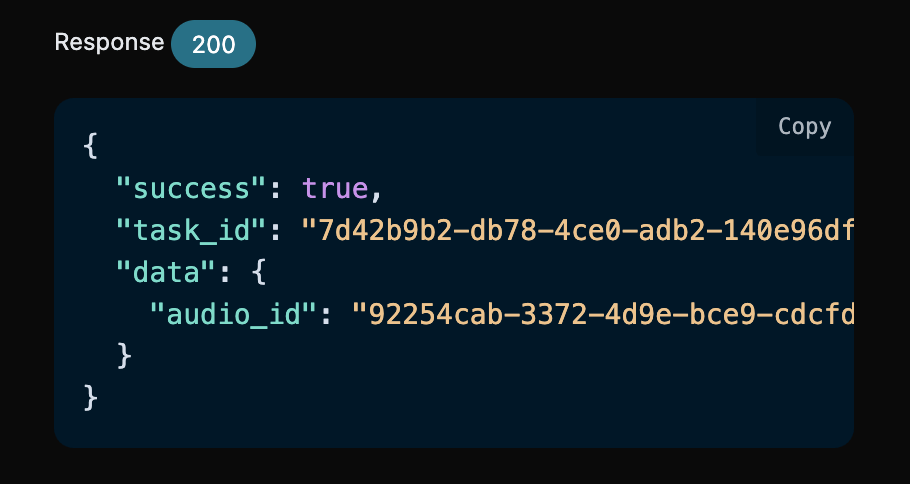
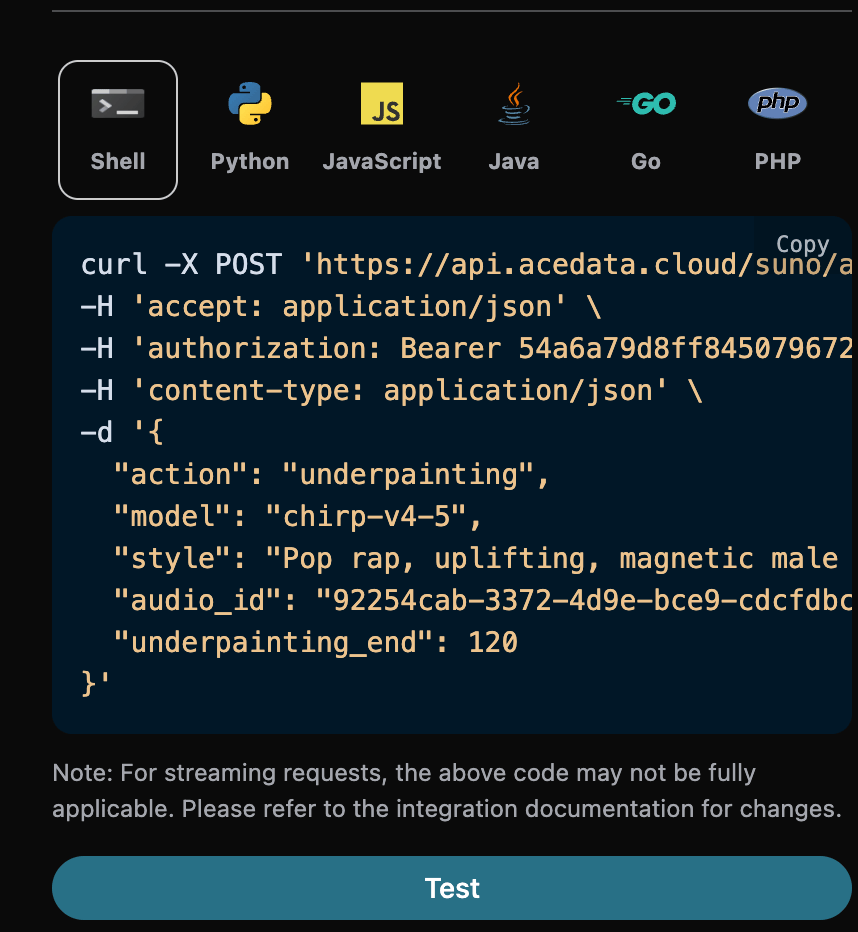
audio_id: 92254cab-3372-4d9e-bce9-cdcfdbc39070, y luego también necesitamos completar los siguientes parámetros:
- action: el contenido es
underpainting. - underpainting_start: la hora de inicio para añadir acompañamiento a la canción subida; el valor predeterminado es 0.
- underpainting_end: la hora de finalización para añadir acompañamiento a la canción subida; debe ser menor que la duración total de la canción.
- audio_id: el ID de la canción a capela sin voz en off subida.
- style: el estilo del acompañamiento; es mejor no usar letra, después de todo es doblaje.
Función Add Vocals
En agosto de 2025, suno lanzó la nueva función Add Vocals. Primero es necesario subir una pieza de música instrumental, para que suno escriba la letra y genere canto vocal. Primero puedes ir a Suno Upload API para subir una canción a capela sin acompañamiento musical; las operaciones correspondientes se muestran en la siguiente imagen:
audio_id después de la subida; el resultado específico se muestra en la siguiente imagen:
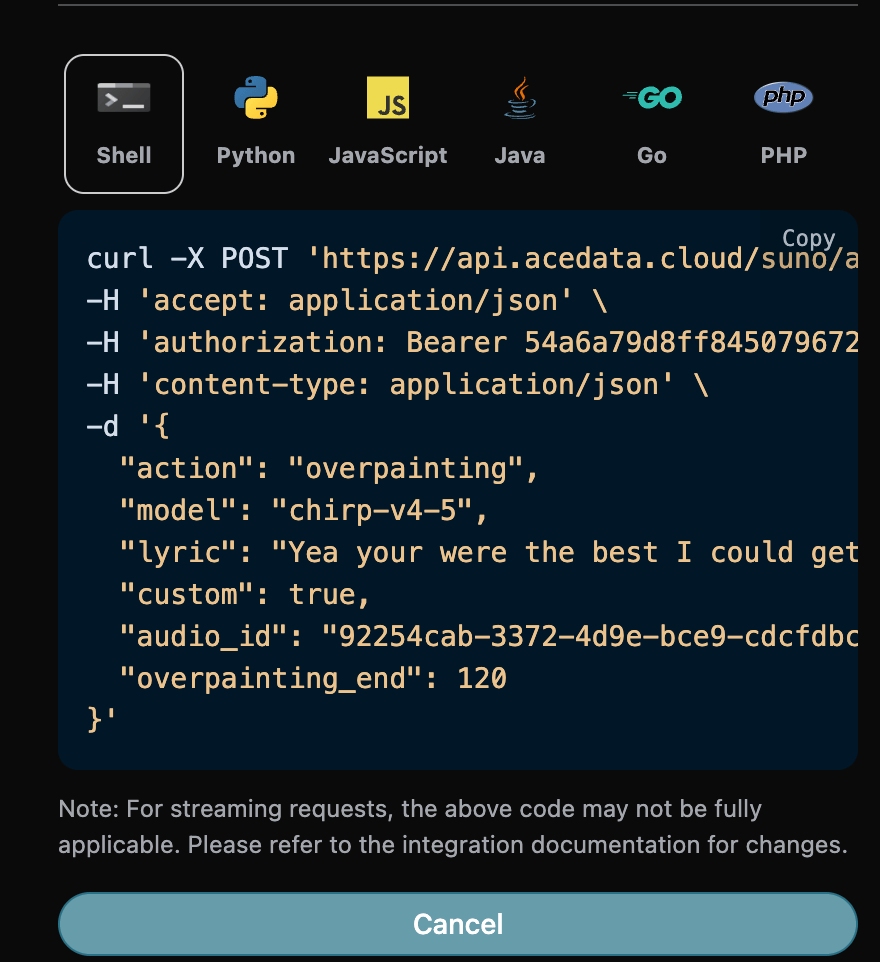
audio_id: 92254cab-3372-4d9e-bce9-cdcfdbc39070, y luego también necesitamos completar los siguientes parámetros:
- action: el contenido es
overpainting. - overpainting_start: la hora de inicio para añadir voces a la canción subida; el valor predeterminado es 0.
- overpainting_end: la hora de finalización para añadir voces a la canción subida; debe ser menor que la duración total de la canción.
- audio_id: el ID de la canción a capela sin voz en off subida.
- custom: en este modo se debe usar el modo personalizado para introducir la letra.
- lyric: la letra introducida en el modo personalizado.
- style: el estilo del acompañamiento.
Función Remaster
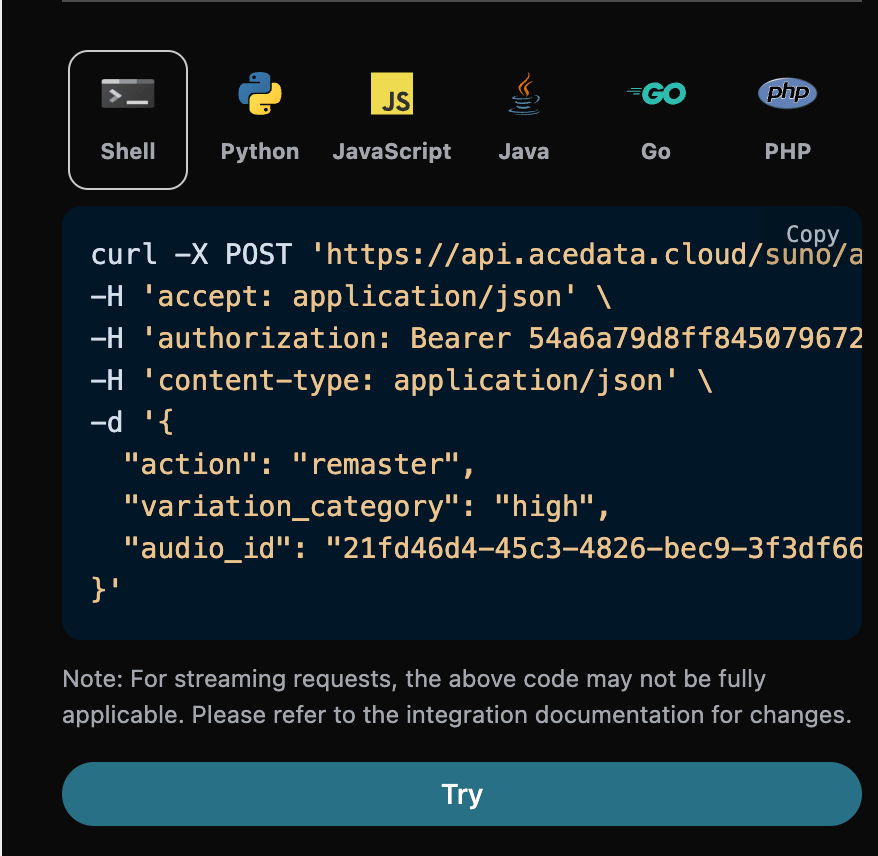
En diciembre de 2025, Suno lanzó la nueva función Remaster. Esta función puede regenerar canciones, no puede utilizarse entre cuentas, y luego también debemos rellenar los siguientes parámetros:- action: el contenido es
remaster. - audio_id: el ID de la canción que necesita regenerarse.
- model: solo admite v4.5+ y v5.
- variation_category: solo se admite en versiones v5 o superiores, y solo tiene 3 valores: high, normal y subtle.
Función de generación de mezclas Mashup
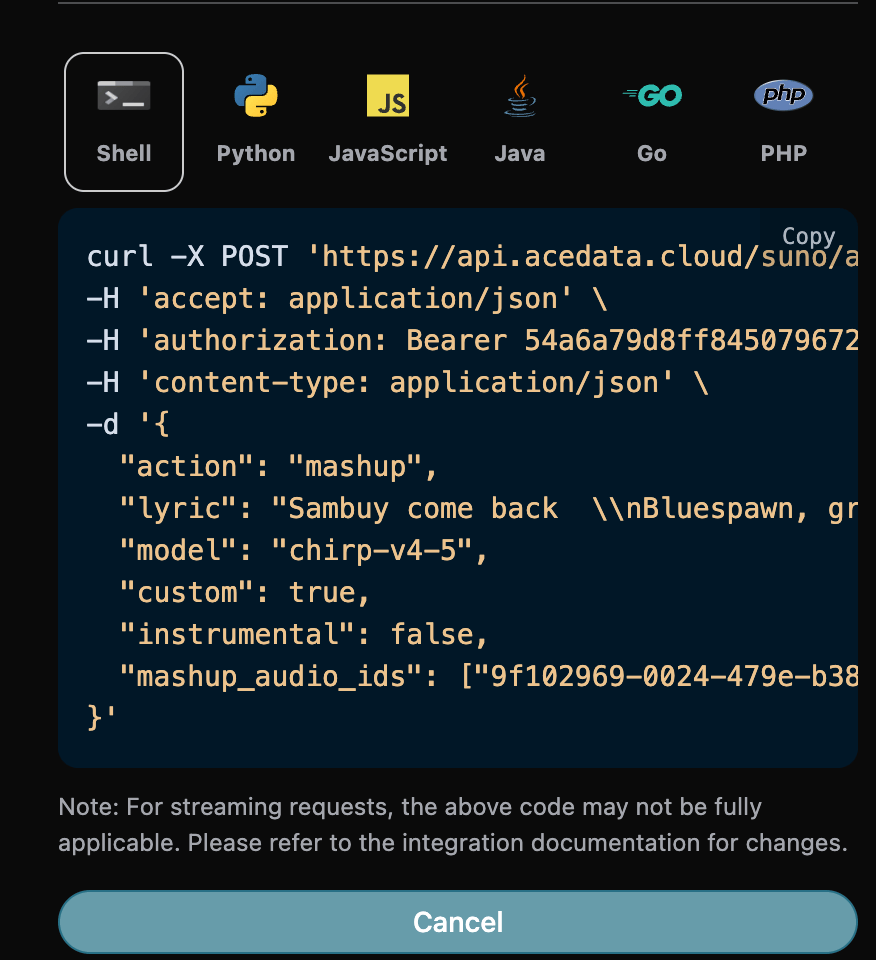
En diciembre de 2025, Suno lanzó la nueva función Mashup. Esta función puede generar canciones basándose en dos canciones de referencia, y luego también debemos rellenar los siguientes parámetros:- action: el contenido es
mashup. - mashup_audio_ids: los ID de las dos canciones de referencia. Después de completar el formulario, se genera automáticamente el siguiente código:
Samples Generar canciones mediante muestreo
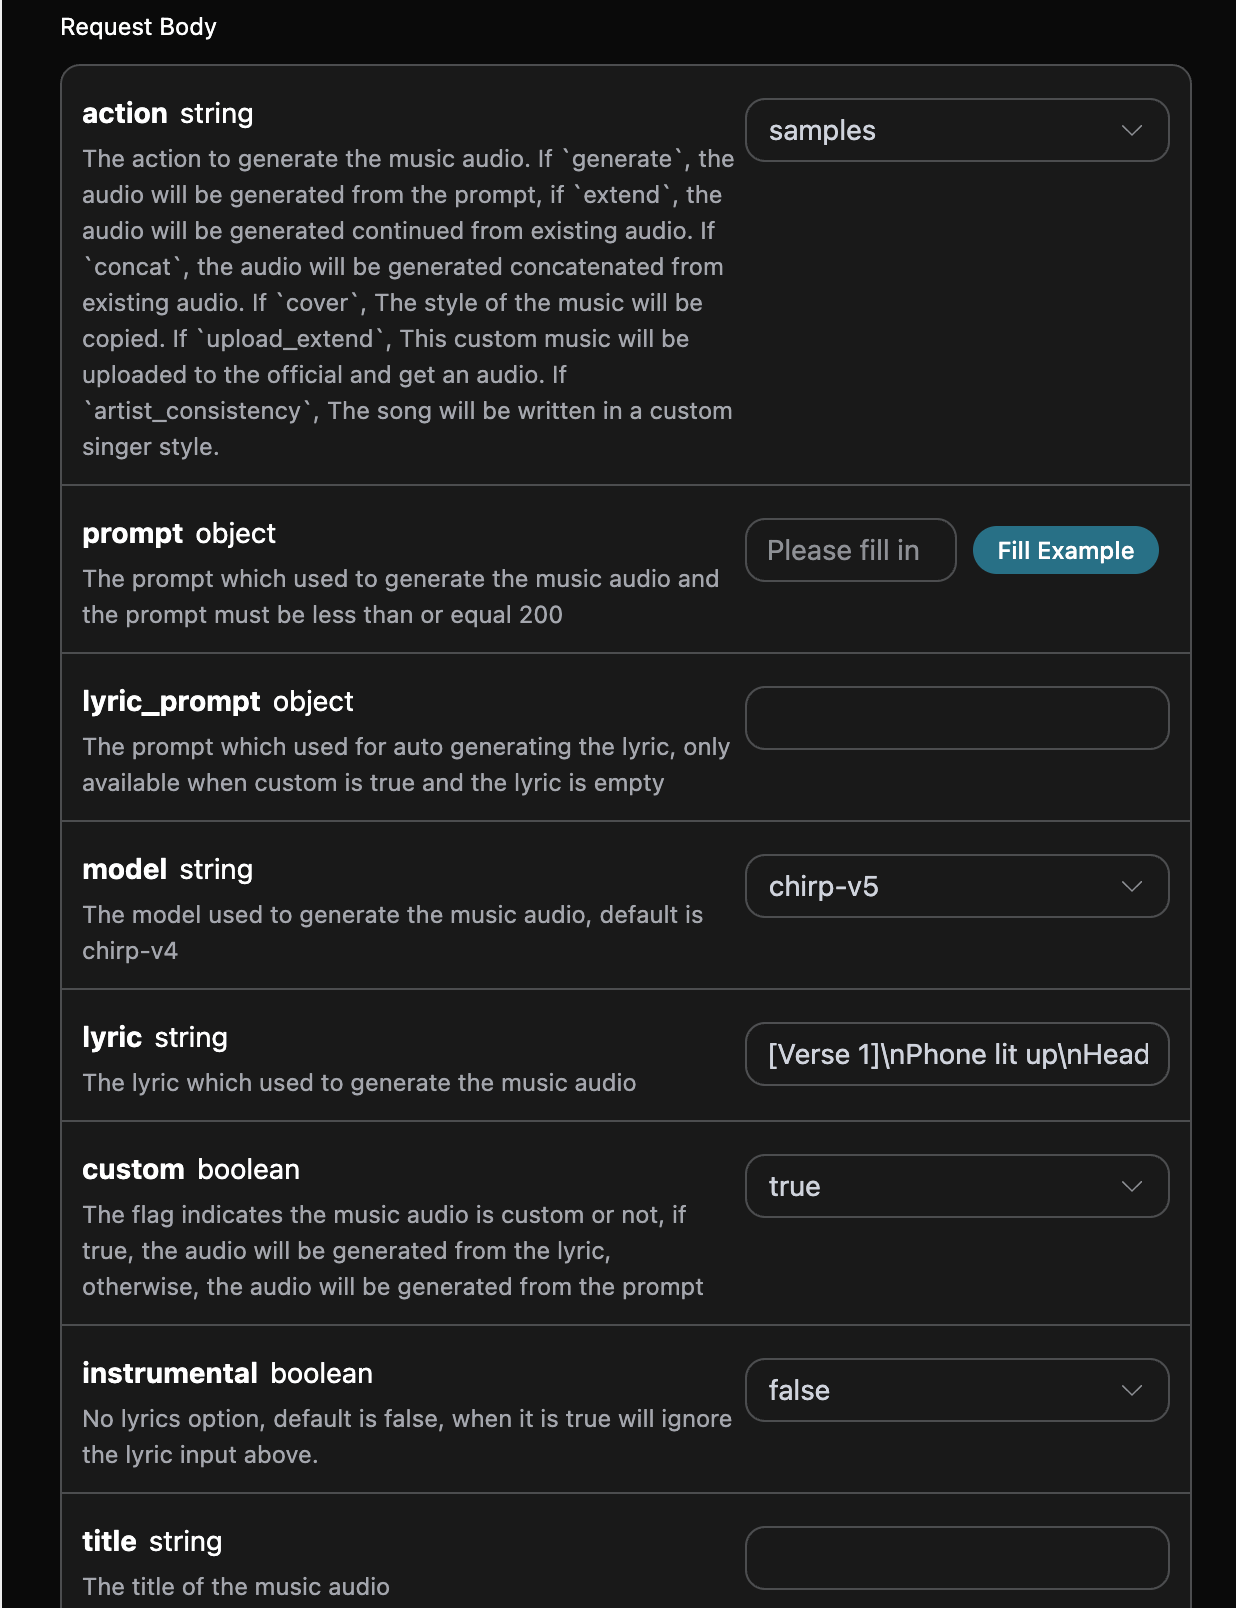
Aquí,samples se refiere al muestreo de un intervalo de un único audio: se seleccionan los tiempos de inicio y finalización de un audio existente, y el fragmento se utiliza como material de muestreo para la creación. Es diferente de la función de creación de inspiración Inspo que utiliza de 1 a 4 segmentos completos de audio de referencia a continuación. Se deben completar los siguientes parámetros:
- action: el contenido es
samples. - samples_start: tiempo de inicio del muestreo.
- samples_end: tiempo de finalización del muestreo.
- audio_id: el ID de la canción de referencia que se debe muestrear.
Función de creación por inspiración de Inspo
La función de creación por inspiración de Inspo puede generar música nueva basándose en 1 a 4 segmentos completos de audio de referencia, y admite arrastrar o cargar audio como fuente de inspiración. La API utiliza la acción existenteinspo: el cliente proporciona URL de audio accesibles públicamente, y el servicio completa automáticamente la preparación del audio de referencia y la creación, sin necesidad de que el cliente lea por separado la letra, el estilo o la duración para luego ensamblar la solicitud. Es diferente del muestreo por intervalos anterior y también diferente de Cover, que replica el estilo de la canción original. Al utilizarla, se deben completar los siguientes parámetros:
- action: el contenido es
inspo. - audio_urls: lista de URL de audio de referencia; se deben proporcionar de 1 a 4 direcciones de audio accesibles públicamente.
- model: el modelo utilizado; se recomienda
chirp-v6. - prompt: letra o palabras clave de creación (opcional).
Nota: el audio de referencia debe ser un archivo de audio accesible públicamente. Si el audio de referencia coincide exactamente con una grabación conocida en la biblioteca musical de la plataforma, Suno podría rechazar la generación debido a la verificación de derechos de autor; se recomienda utilizar audio propio o generado por Suno como fuente de inspiración.El código Python correspondiente:
chirp-v5 de ese momento, el ejemplo de solicitud actual recomienda chirp-v6, y la estructura de respuesta es la misma:
Devolución de llamada asíncrona
Dado que Suno tarda relativamente mucho tiempo en generar música, aproximadamente 1-2 minutos, si la API no responde durante mucho tiempo, la solicitud HTTP mantendrá la conexión abierta, lo que provoca un consumo adicional de recursos del sistema, por lo que esta API también proporciona soporte para devoluciones de llamada asíncronas. El proceso general es: cuando el cliente inicia una solicitud, especifica adicionalmente un campocallback_url; después de que el cliente inicia una solicitud a la API, la API devolverá inmediatamente un resultado que contiene un campo task_id, que representa el ID de la tarea actual. Cuando la tarea se completa, el resultado de la generación de música se enviará mediante POST JSON al callback_url especificado por el cliente, que también incluye el campo task_id, de esta forma los resultados de la tarea pueden asociarse mediante el ID.
A continuación, entenderemos cómo operar específicamente mediante un ejemplo.
Primero, la devolución de llamada Webhook es un servicio que puede recibir solicitudes HTTP; los desarrolladores deben reemplazarla por la URL de su propio servidor HTTP implementado. Aquí, para facilitar la demostración, se utiliza un sitio web público de ejemplo de Webhook https://webhook.site/; al abrir este sitio web se puede obtener una URL de Webhook, como se muestra en la imagen:
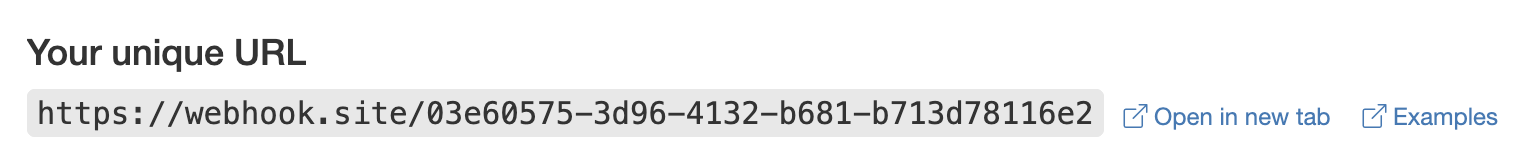 Copie esta URL para poder utilizarla como Webhook; el ejemplo aquí es https://webhook.site/03e60575-3d96-4132-b681-b713d78116e2.
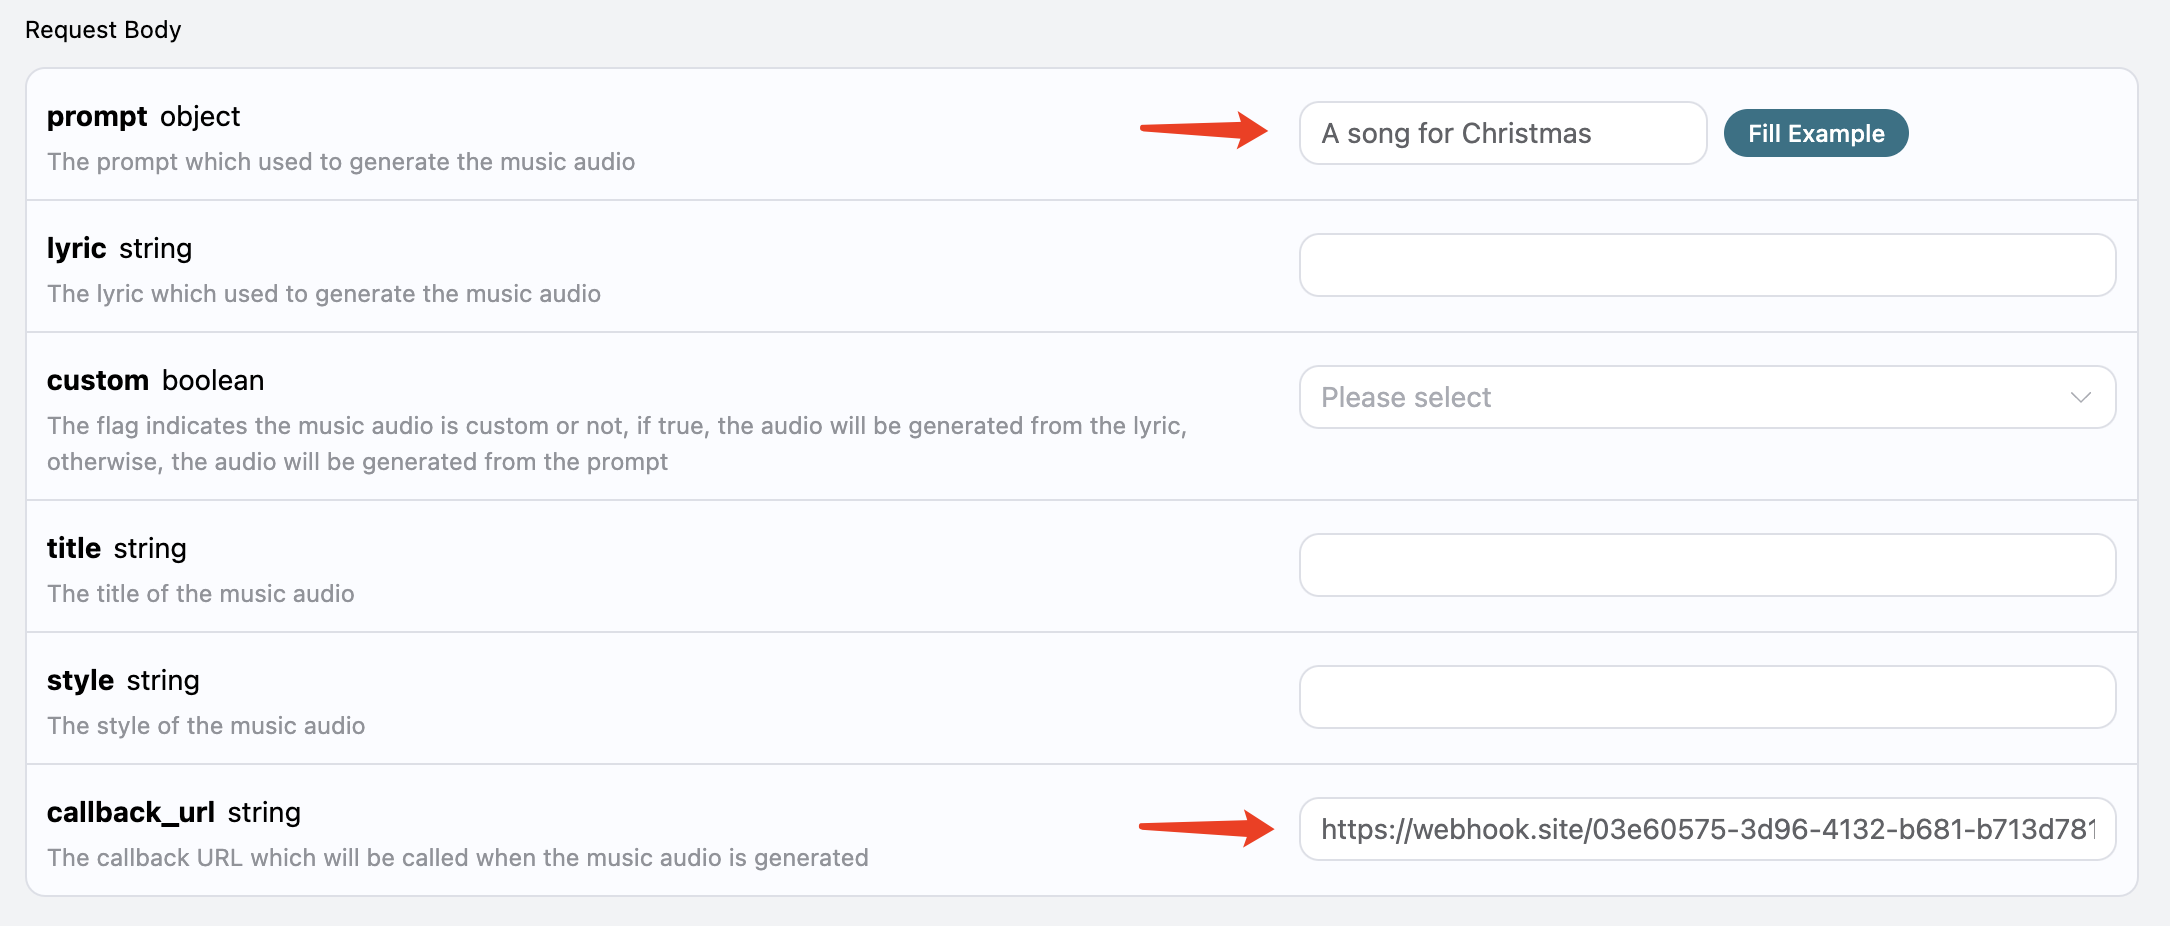
A continuación, podemos establecer el campo
callback_url con la URL de Webhook anterior y, al mismo tiempo, rellenar prompt, como se muestra en la imagen:
 Haga clic en ejecutar; podrá observar que se obtiene inmediatamente un resultado, como el siguiente:
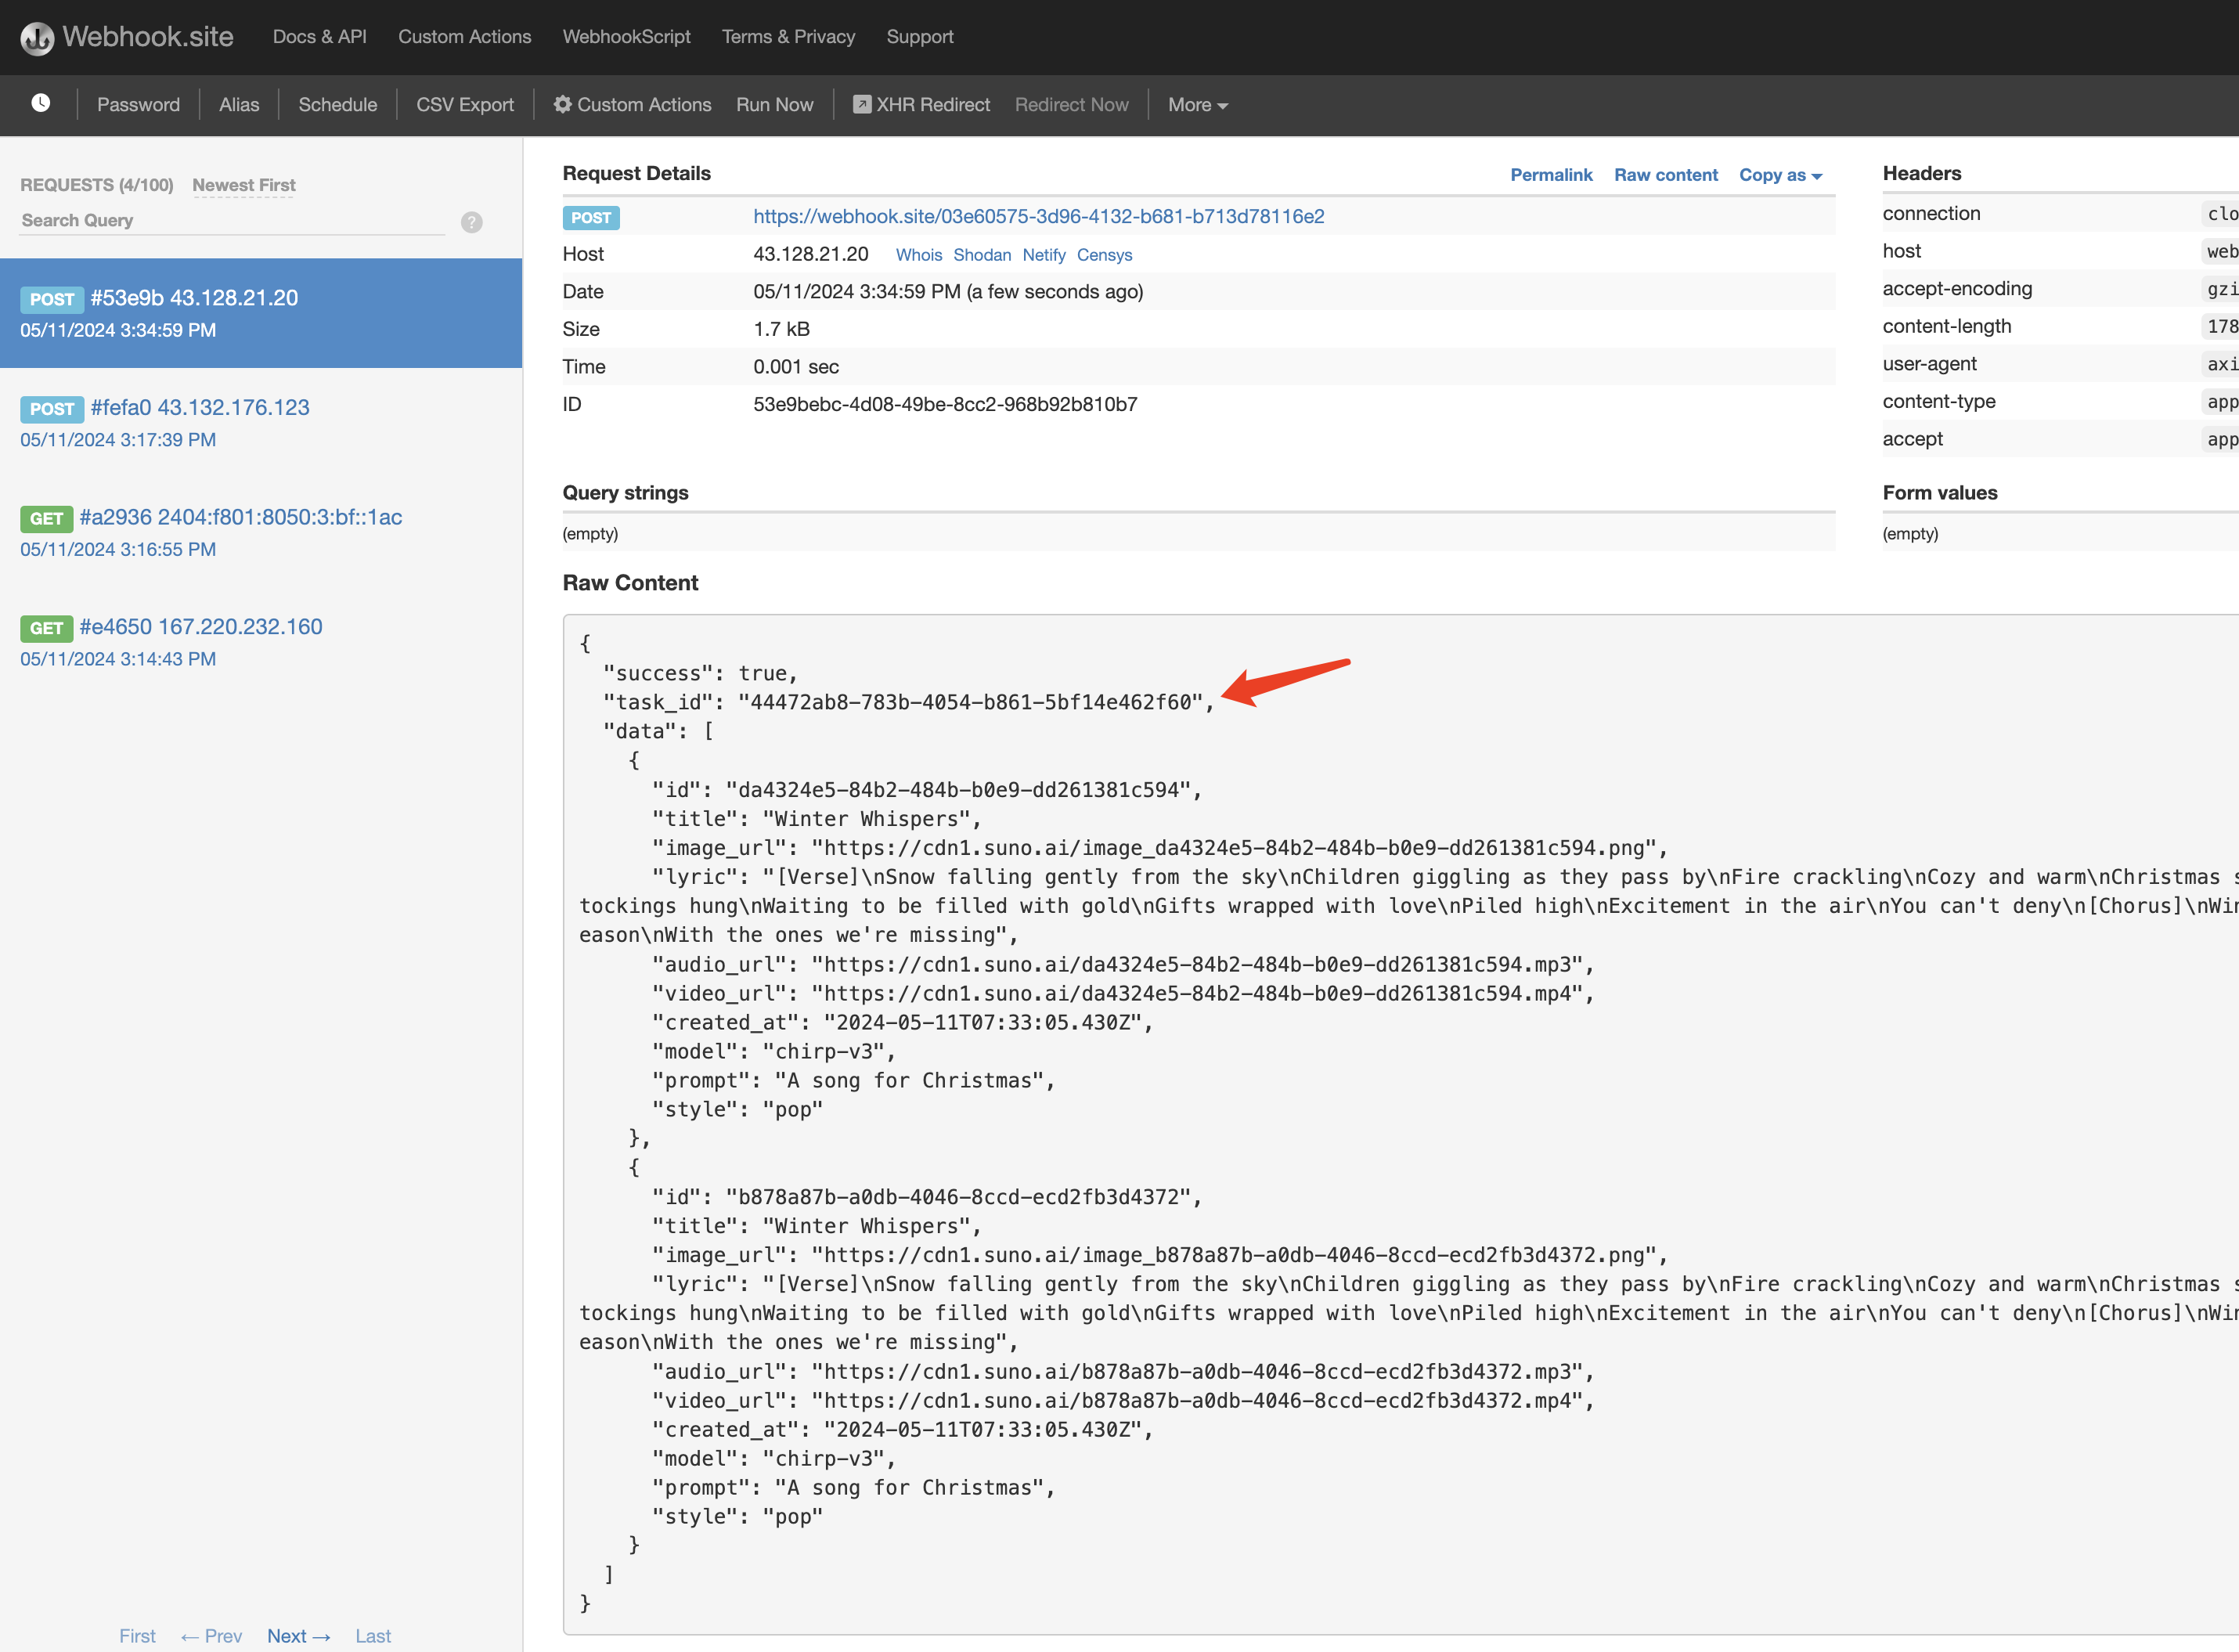 El contenido es el siguiente:
task_id en el resultado; los demás campos son similares a los anteriores, y la asociación de tareas puede realizarse mediante este campo.
Por supuesto, también podemos obtener los resultados mediante llamadas de flujo; solo necesitamos establecer el valor de accept en el encabezado de la solicitud como application/x-ndjson. A continuación, se utiliza una entrada de ejemplo como demostración:
task_id; arriba solo se conservan la primera y la última respuesta real, omitiendo las actualizaciones intermedias repetidas.
Manejo de errores
Si ocurre un error, obtendrá un mensaje de error similar al siguiente:error.code, error.message:
Nota: Los límites y los textos de error de distintas cuentas upstream pueden variar. Por lo general,chirp-v3-5/chirp-v4tienen límites más bajos parastyle(200), mientras quechirp-v4-5y superiores suelen admitir hasta 1000; al usar un upstream antiguo, pueden aparecer textos de compatibilidad comoTags too long.ostyle must be less than or equal 120. | Código de estado |error.code|error.message| | ---------------- | ------------- | --------------------------------------------------------------- | | 400 |bad_request|El id de la canción no existe o se ha desconectado.| | 400 |bad_request|La indicación es demasiado larga.| | 400 |bad_request|Las etiquetas son demasiado largas.| | 400 |bad_request|El audio subido coincide con una obra de arte existente.| | 400 |bad_request|instrumental debe ser un booleano| | 400 |bad_request|El título es demasiado largo.| | 400 |bad_request|El tema es demasiado largo.| | 400 |bad_request|style debe ser menor o igual a 120| | 400 |bad_request|custom debe ser un booleano| | 400 |bad_request|audio_id es obligatorio al extender audio| | 400 |bad_request|continue_at es obligatorio al extender audio| | 400 |bad_request|continue_at debe ser un número mayor que 0| | 400 |bad_request|lyric es obligatorio al extender audio y instrumental es falso| | 400 |bad_request|prompt es obligatorio al generar audio| | 400 |bad_request|lyric es obligatorio al generar audio personalizado| | 403 |forbidden|La indicación probablemente está malformada| | 403 |forbidden|La indicación probablemente tiene derechos de autor| | 403 |forbidden|La indicación contenía material inapropiado| | 403 |forbidden|La descripción de la canción fue marcada para moderación| | 403 |forbidden|La descripción de la canción contenía el nombre de un artista| | 403 |forbidden|Las etiquetas contenían el nombre de un artista| | 403 |forbidden|La letra contenía material con derechos de autor| | 403 |forbidden|La descripción de la canción contenía una etiqueta de productor| | 403 |forbidden|Error genérico de openAI| | 403 |forbidden|La indicación fue marcada para moderación| | 500 |api_error|No se puede generar letra a partir de la descripción de la canción| | 500 |api_error|el trabajo falló con un error desconocido| | 500 |api_error|no hay trabajador disponible en el sistema| | 500 |api_error|servicio en mantenimiento, generación pausada| | 504 |timeout|tiempo de espera agotado mientras se esperaba la generación de audio|