

content-struktur för att skapa uppgifter.
Ansökningsprocess
För att använda MiniMax H3 API för videogenerering, hämta först din API-token från Ace Data Cloud-konsolen och spara den för senare användning. Om du ännu inte har loggat in eller registrerat dig, omdirigeras du automatiskt till inloggningssidan där du uppmanas att registrera dig och logga in. När detta är klart återvänder du automatiskt till den aktuella sidan.
En API-token kan anropa alla plattformens tjänster, utan att du behöver ansöka separat för varje tjänst. Vid första ansökan får du en gratis kvot för att kunna prova kostnadsfritt; när kvoten inte räcker till kan du fylla på det gemensamma saldot i konsolen.
📘 Fullständig dokumentation: MiniMax H3 API för videogenerering →Det rekommenderas att spara token som en miljövariabel och inte skriva in den i källkoden eller skicka den till versionshanteringssystemet:
Översikt över gränssnittet
- Base URL:
https://api.acedata.cloud - Endpoint:
POST /minimax/videos - Autentiseringsmetod:Ange
authorization: Bearer {token}i HTTP Header - Request Headers:
accept: application/jsoncontent-type: application/json
- Modell (model):
MiniMax-H3 - Indatastruktur:Text, bilder, video och ljud skickas enhetligt via
content - Utmatningsläge:Väntar synkront som standard tills genereringen är klar och returnerar hela
task; medasync: trueellercallback_urlreturnerastask_idochtrace_idomedelbart - Resultatfråga:Hämta status och färdig video via MiniMax H3 API för uppgiftsfråga
- Asynkron callback:Valfritt, ta emot slutligt uppgiftsresultat via
callback_url
action för att välja genereringsläge; gränssnittet avgör automatiskt användningen baserat på materialtyperna och role i content.
Vilka scenarier passar det för
Anropsflöde
Närasync inte skickas som standard väntar /minimax/videos tills genereringen är klar och returnerar direkt hela task. Om anslutningen behöver frigöras omedelbart, skicka async: true eller callback_url:
- Spara
task_idochtrace_idi det omedelbara svaret. - Om ingen callback har konfigurerats, anropa
/minimax/tasksungefär var 10:e sekund för att fråga. - När
task.statusblirsucceeded, hämta videon fråntask.content.url. - När statusen är
failedellercancelled, sluta polla och lästask.error.
Begärandeparametrar på toppnivå
Reglerna för
ratio beror på arbetsflödet:
- Text-till-video:Obligatoriskt och får inte vara
adaptive. - Video med första bildruta, sista bildruta eller första och sista bildruta:Bildformatet bestäms av indatabilden; det rekommenderas att utelämna det eller skicka
adaptive. - Multimodal referensbaserad videogenerering:Kan utelämnas, med standardvärdet
adaptive; du kan även uttryckligen ange ett fast förhållande.
prompt, image_urls, audio_urls, messages och first_frame_image. När du får ett parameterfel för denna typ av parametrar, ta bort de gamla fälten och migrera till content; ändra till exempel "prompt": "一只猫挥手" till "content": [{"type": "text", "text": "一只猫挥手"}]。Skicka inte både det nya och gamla formatet samtidigt.
Parametrar för innehållsobjekt i content
Varje innehållsobjekt måste hatype, medan övriga fält bestäms av typen:
Medieadresser stöder tre format:
- HTTPS-URL:er som är offentligt tillgängliga, rekommenderas för stora filer.
mm_file://{file_id}, som refererar till filer som redan har laddats upp eller befintliga resultat.- Base64 data URI för motsvarande medietyp. Base64 ökar storleken med ungefär en tredjedel; säkerställ att hela begärandetexten inte överstiger 64 MB.
Materialspecifikationer och kvantitetsbegränsningar
Bilder, videor och ljud i multimodala referensscenarier får sammanlagt omfatta högst 12 filer. Scenarier med första och sista bildruta och scenarier med referensmaterial utesluter varandra: när
reference_image, reference_video eller reference_audio används, kan first_frame eller last_frame inte längre användas, och vice versa.
Presentation av produktionsklassade funktioner
Nedan följer inte konceptbilder eller platshållarmaterial, utan verkliga referensingångar och faktiska videoutgångar från MiniMax H3:s officiella exempel på produktionsklassade funktioner. De tre exempelgrupperna omfattar varumärkeskortfilmer, berättelser med verkliga personer och mode-e-handel, och lämpar sig för att utvärdera modellens viktigaste förmågor inom kommersiell produktion.
Med ”ansiktsförmåga” avses konsekvens i personers utseende, ansiktsdetaljer och kontroll av skådespel i videogenerering, inte ansiktsigenkänning, ansiktsjämförelse eller ansiktsbytesgränssnitt.
Kortfilm för exklusivt varumärke: enhetlighet mellan person, produkt och varumärkestillgångar
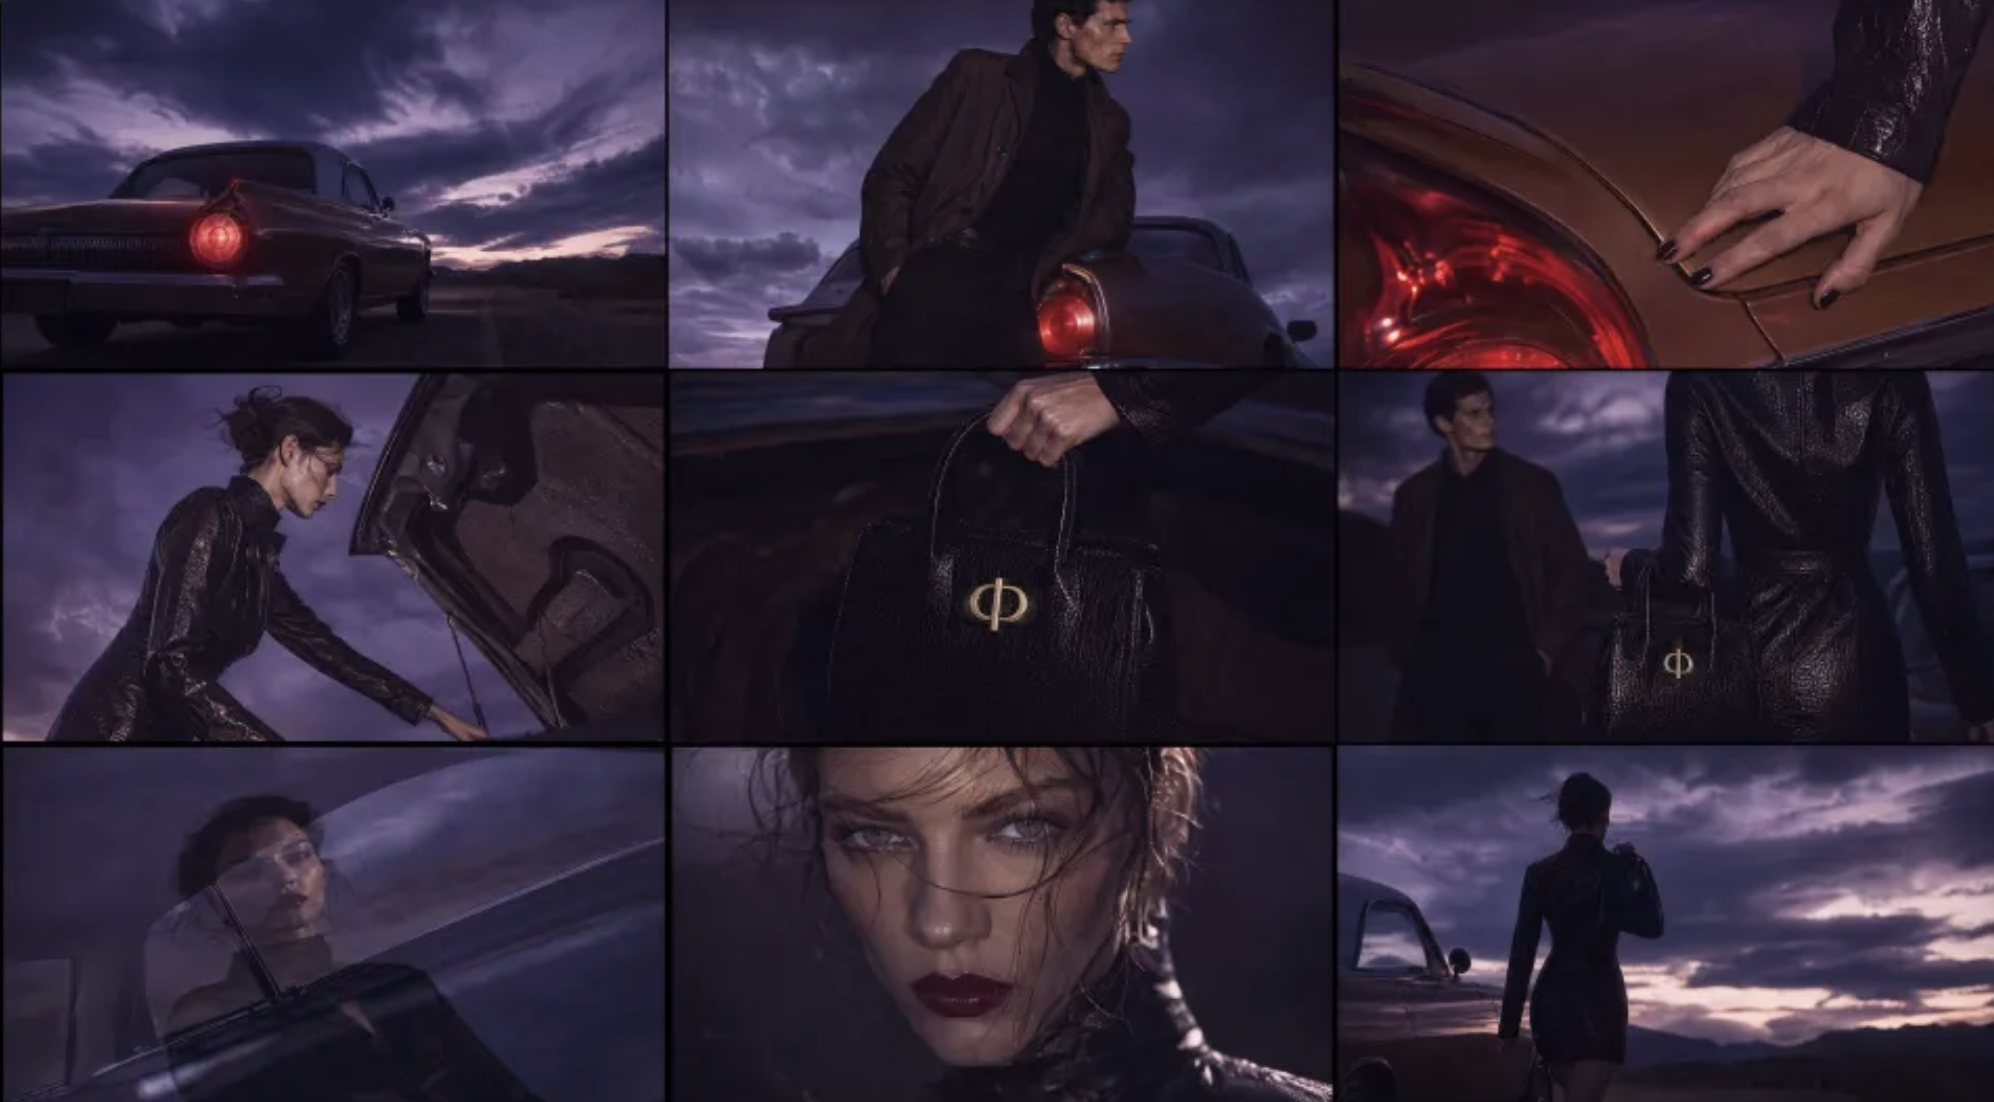
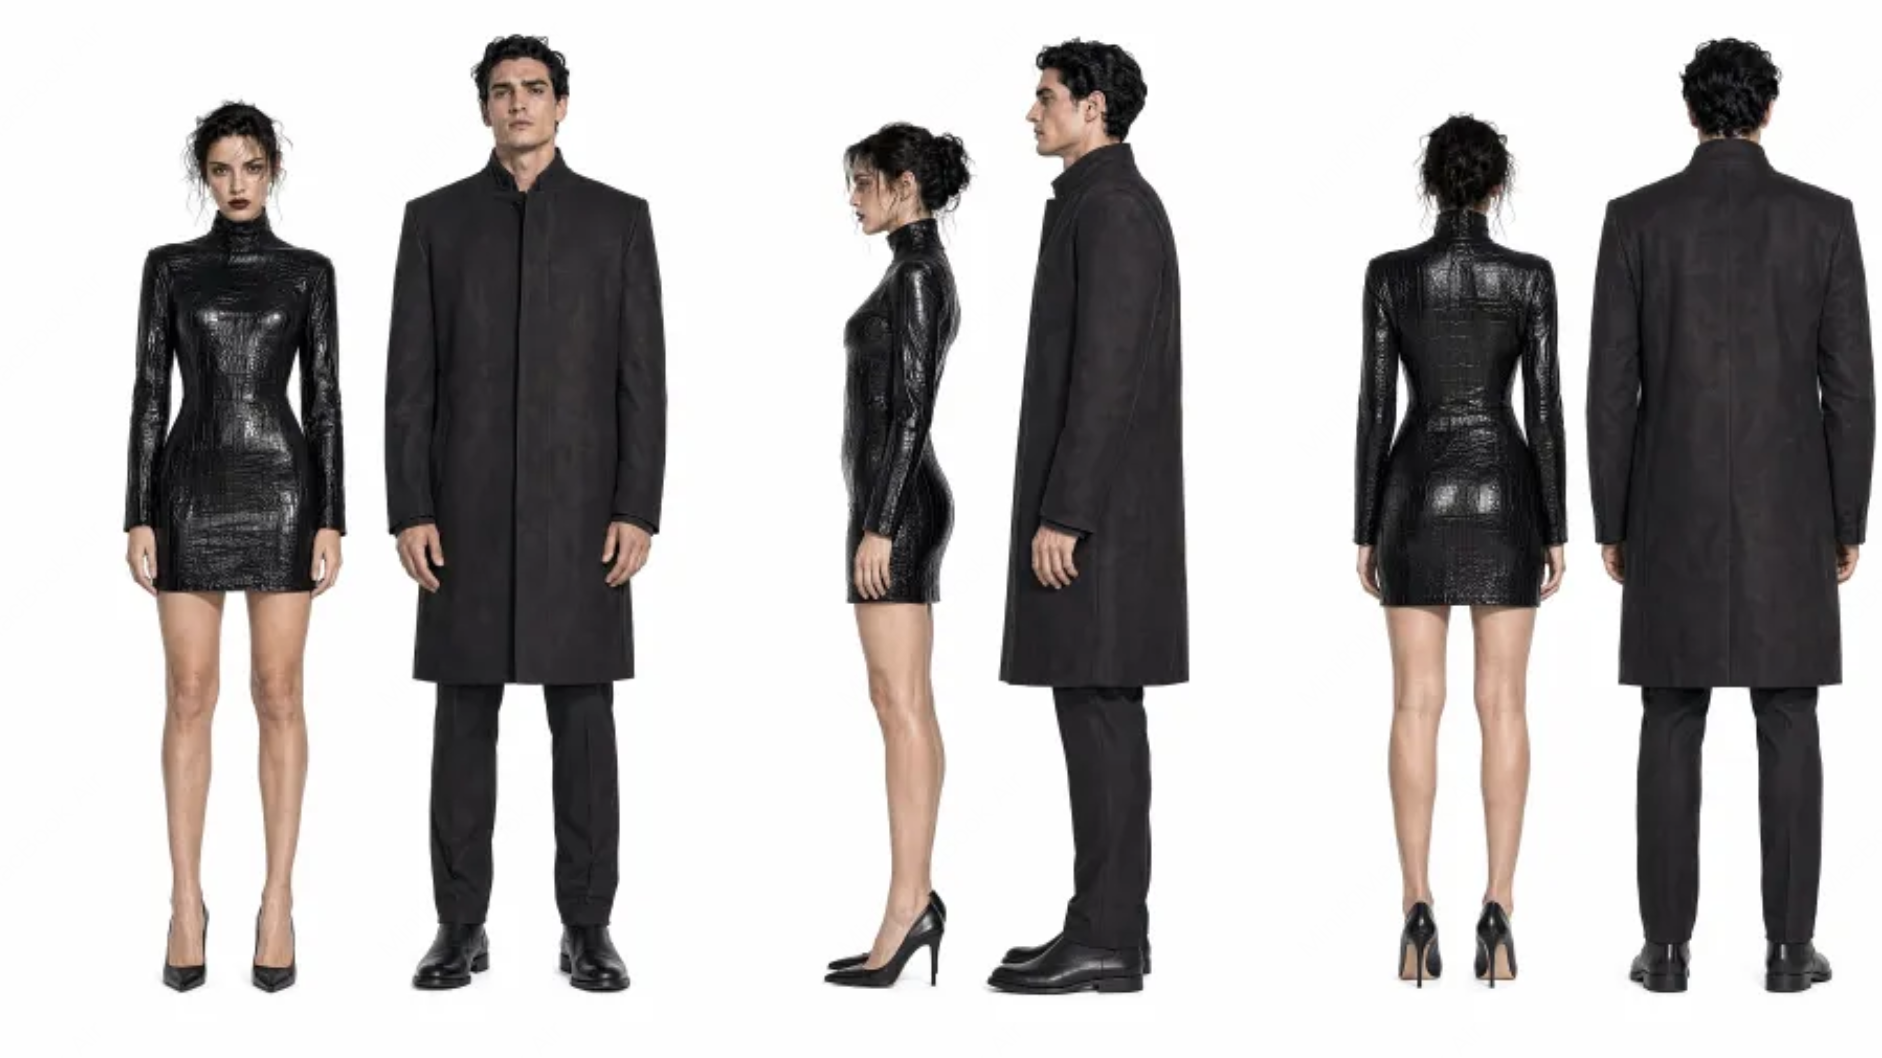
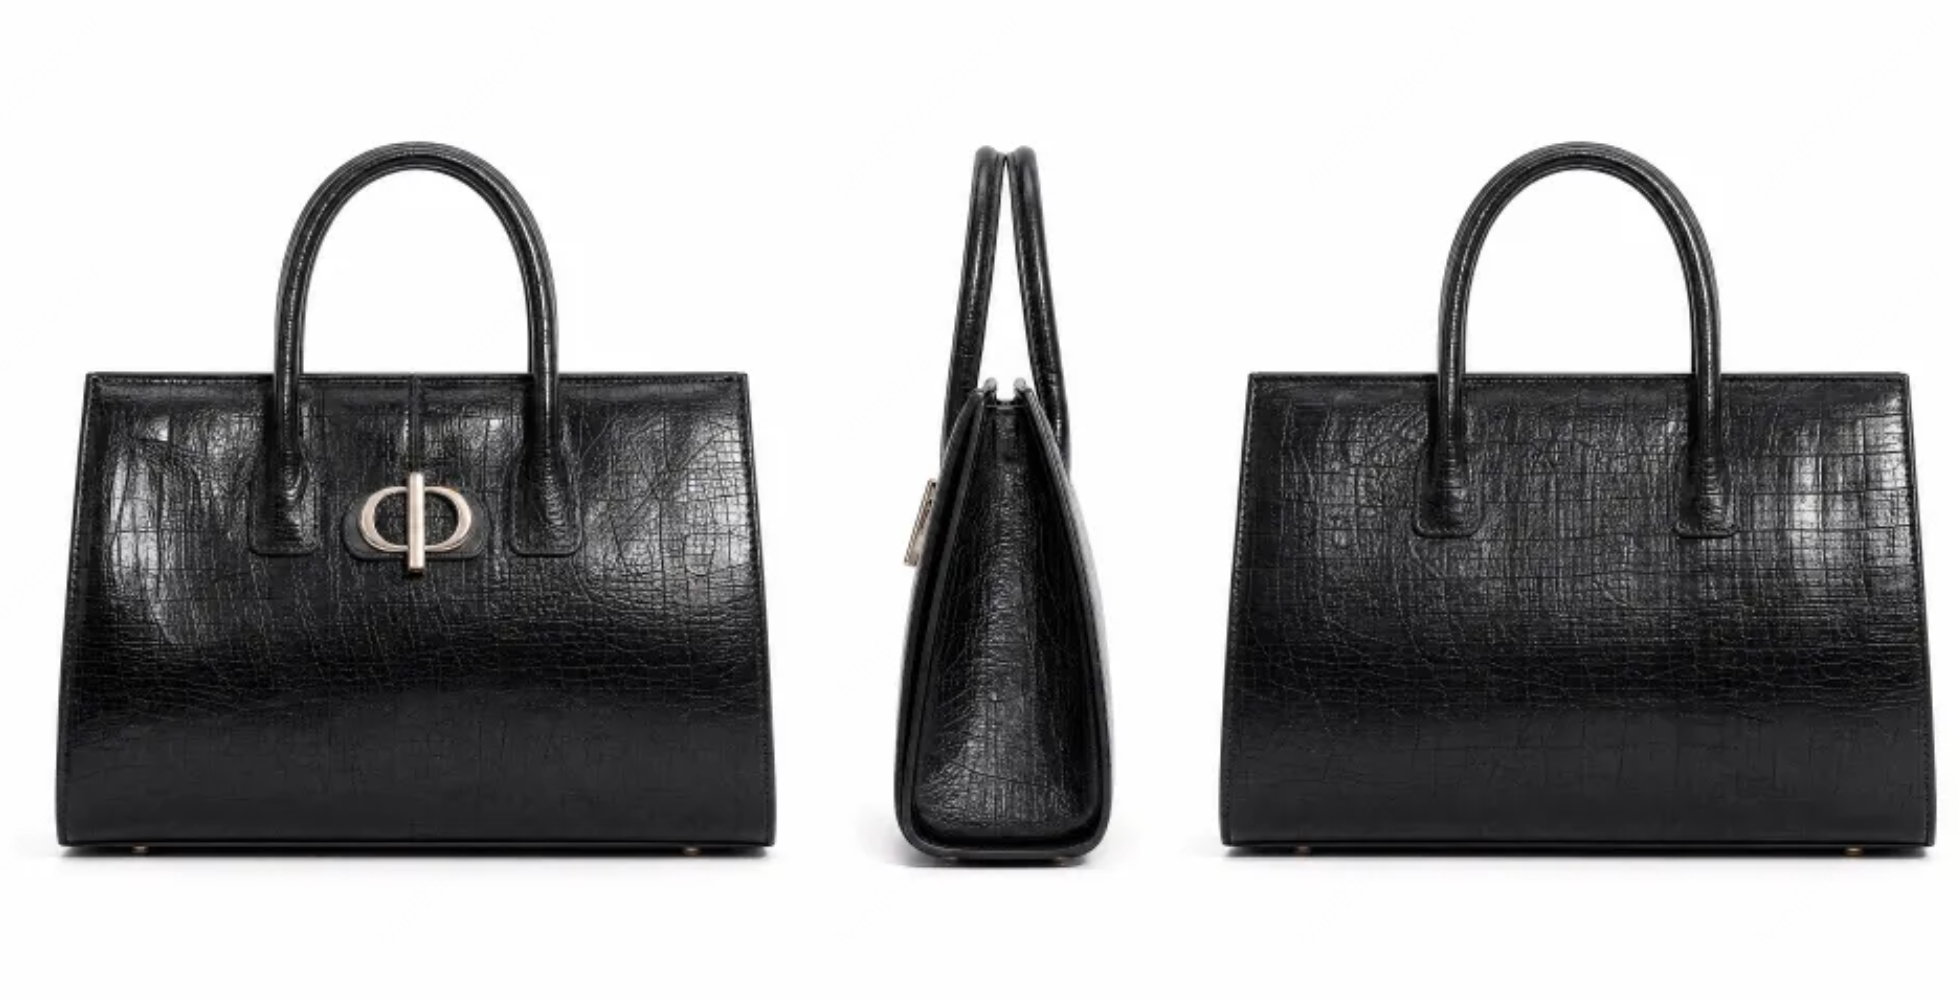
Produktionsmål: 16:9-film för ett exklusivt modemärke. Skapa en kylig atmosfär med en ökenväg och en veteranbil, behåll huvudrollsinnehavarinnans utseende och den svarta handväskans struktur, och integrera varumärkets logotyp naturligt i slutet. Detta exempel testar främst konsekvens för personer mellan tagningar, produktbevarande, filmisk känsla och förmågan att avsluta med varumärket.| Referens för atmosfär och scen | Personreferens |
|---|---|
 |  |
| Referens för handväskprodukt | Referens för varumärkeslogotyp |
|---|---|
 |  |
content:
Vertikalt kortdrama med verkliga personer: ansiktskonsekvens och känslomässigt skådespel
Produktionsmål: 15 sekunder, 9:16 mörk romantisk kortdramatrailer. Lås karaktärernas utseende genom referensbilder av den kvinnliga och manliga huvudrollen, och styr miljön med en referensbild av det gamla slottet; använd mellanbilder och ansiktsnärbilder för att visa ögonkontaktens konfrontation, rädsla, återhållsamhet och känslan av fara. Detta exempel är lämpligt för att observera stabiliteten i verklighetstrogna ansiktsdrag, mikroansiktsuttryck, blickrelationer och sammanhängande skådespel.| Referens för kvinnlig och manlig huvudroll | Referens för slottsmiljö |
|---|---|
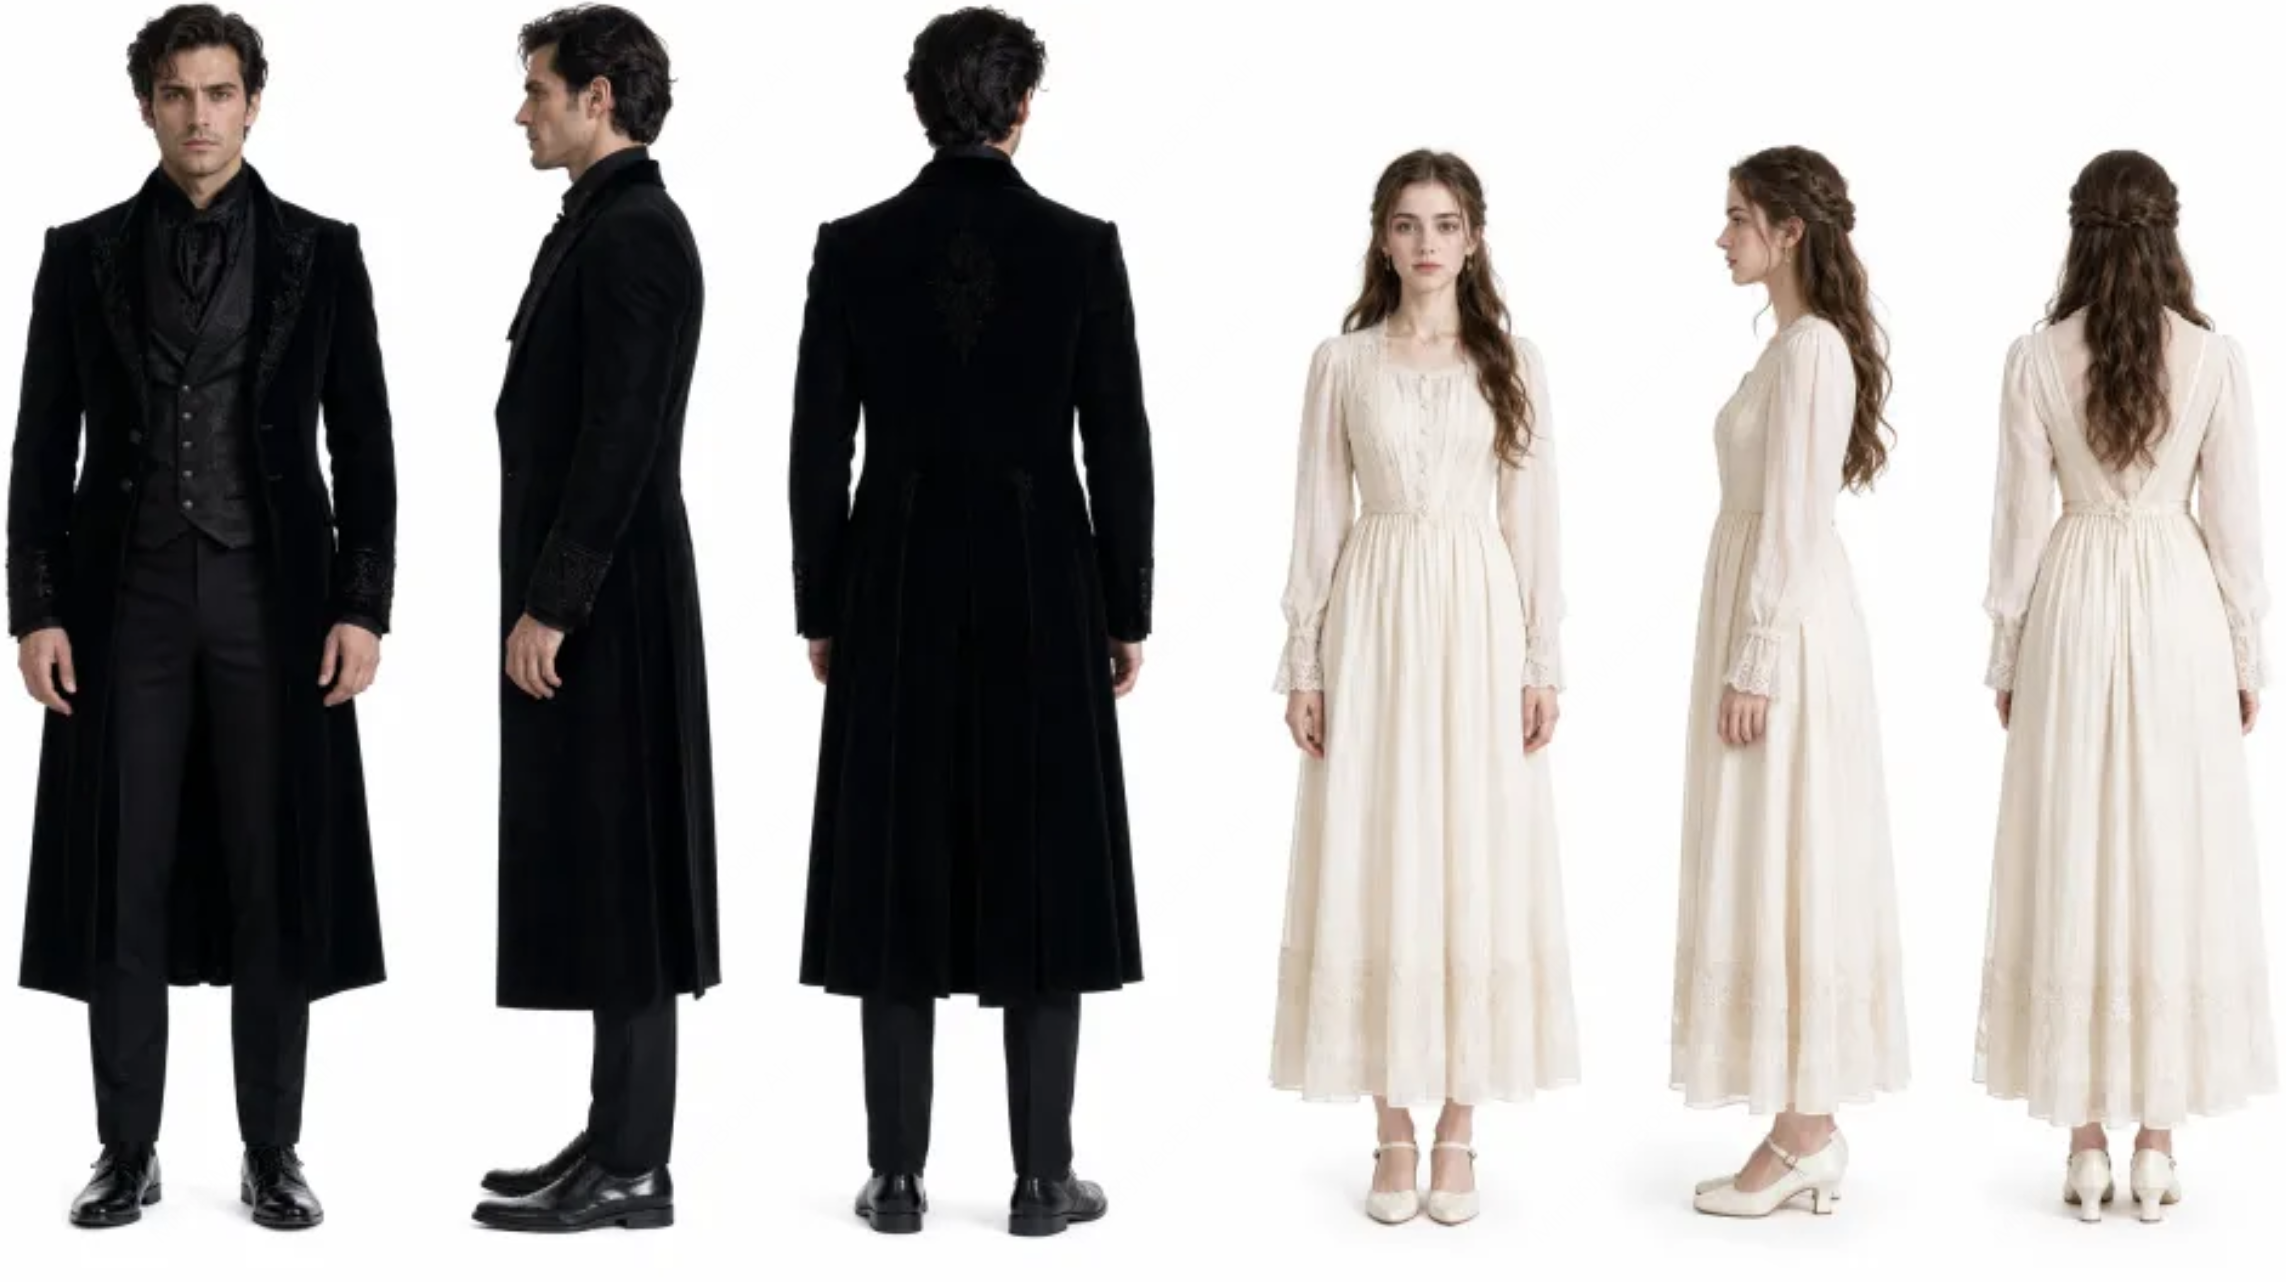 | 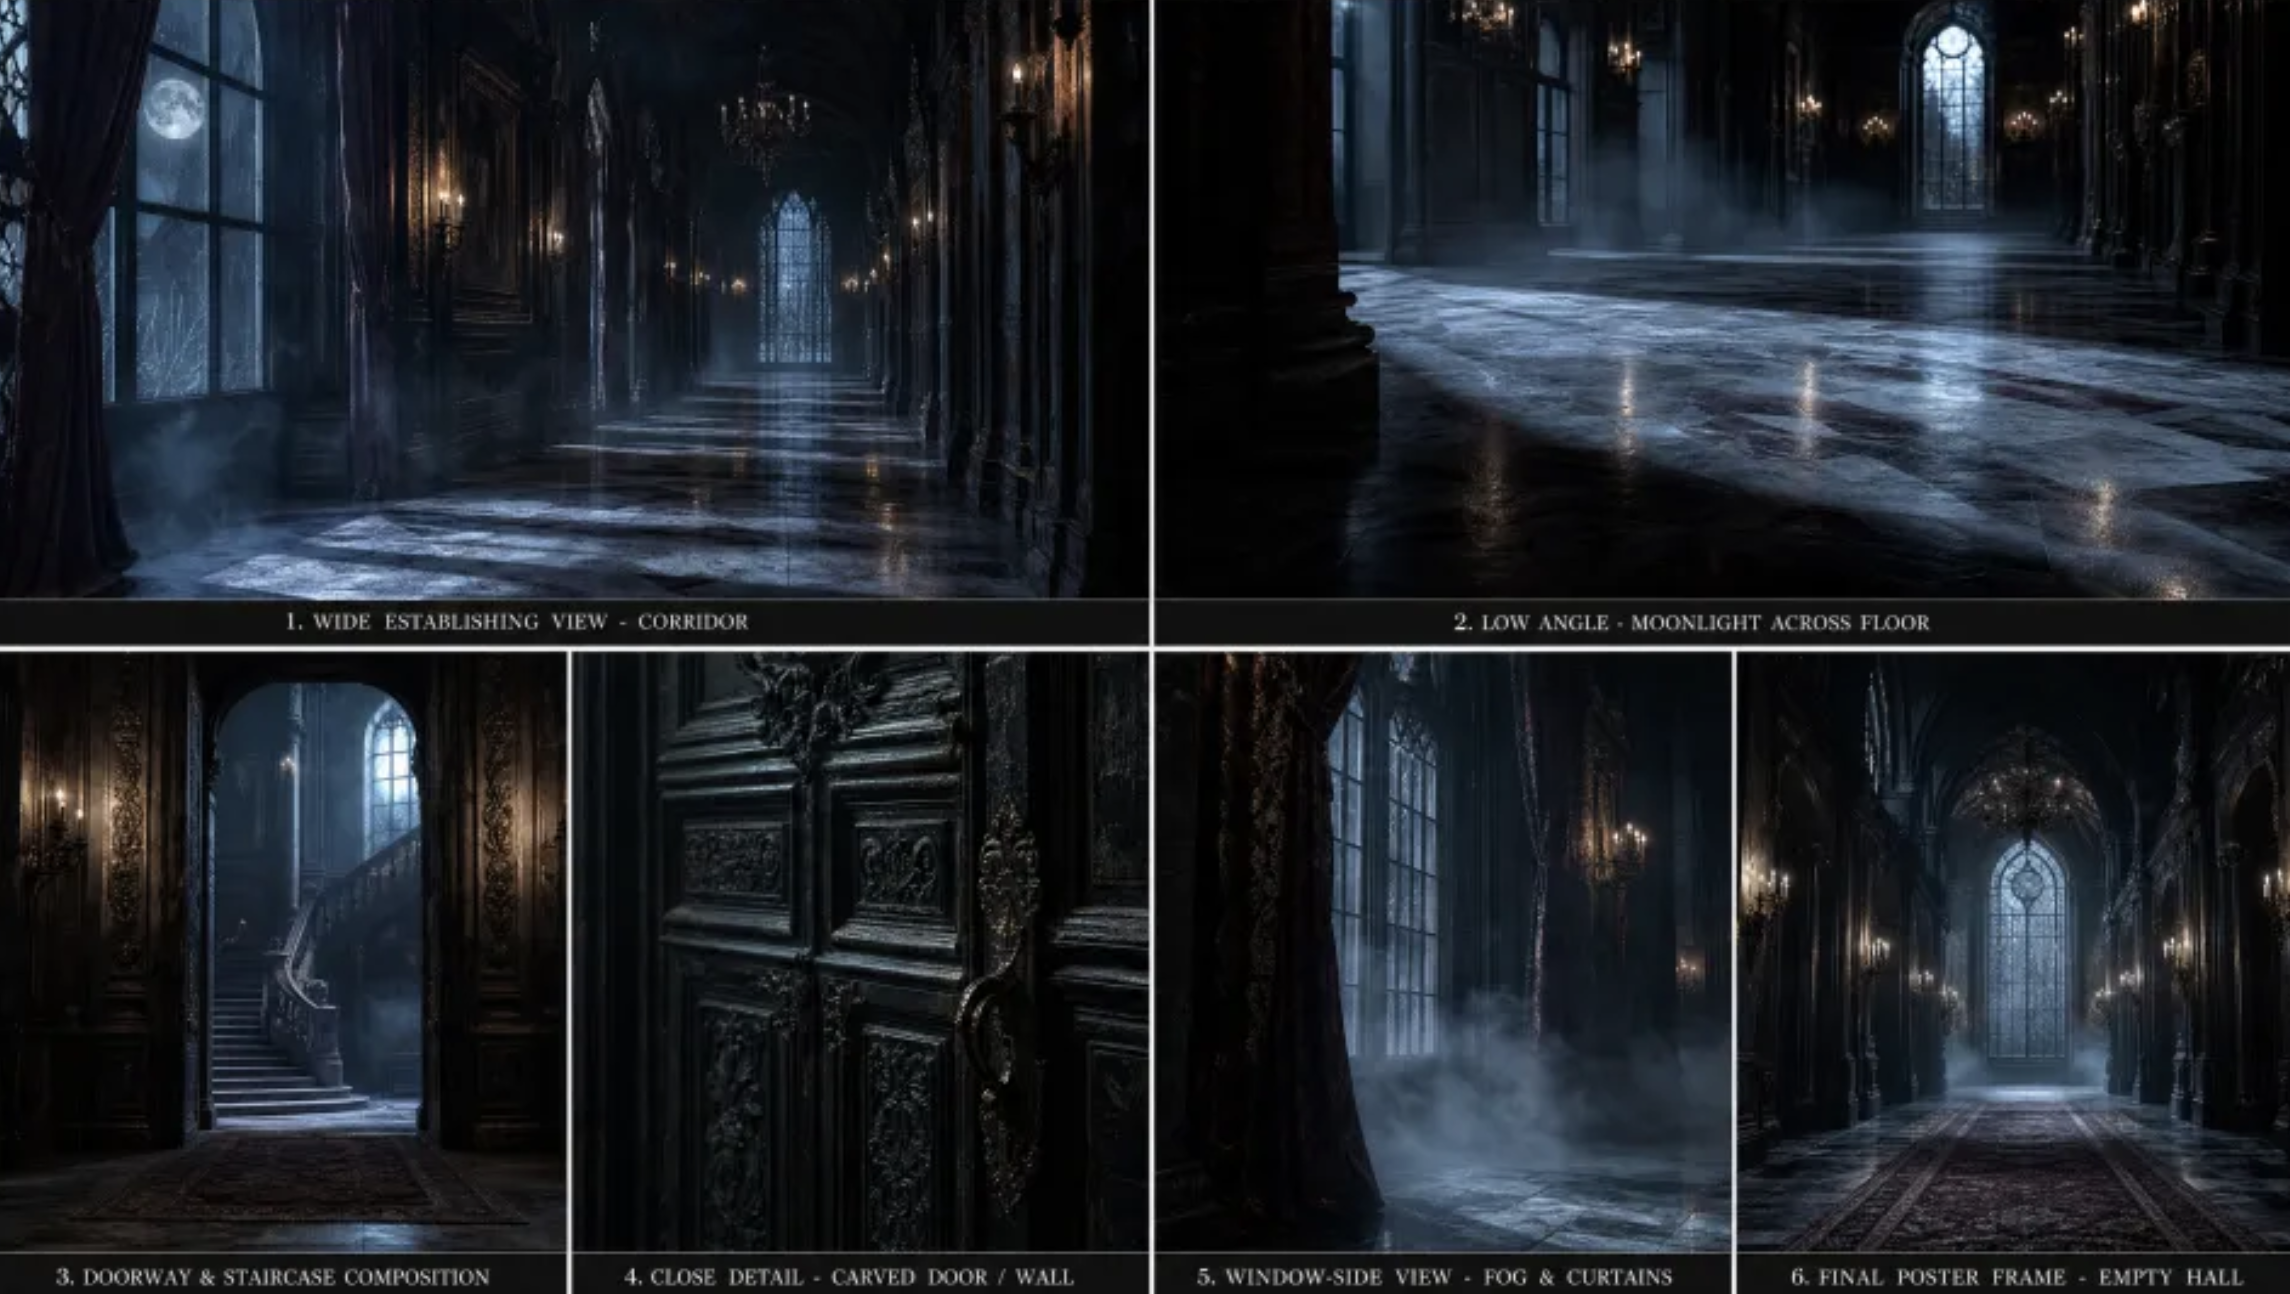 |
Modeannons för glasögon: behåll ansiktsdetaljer och produktstruktur
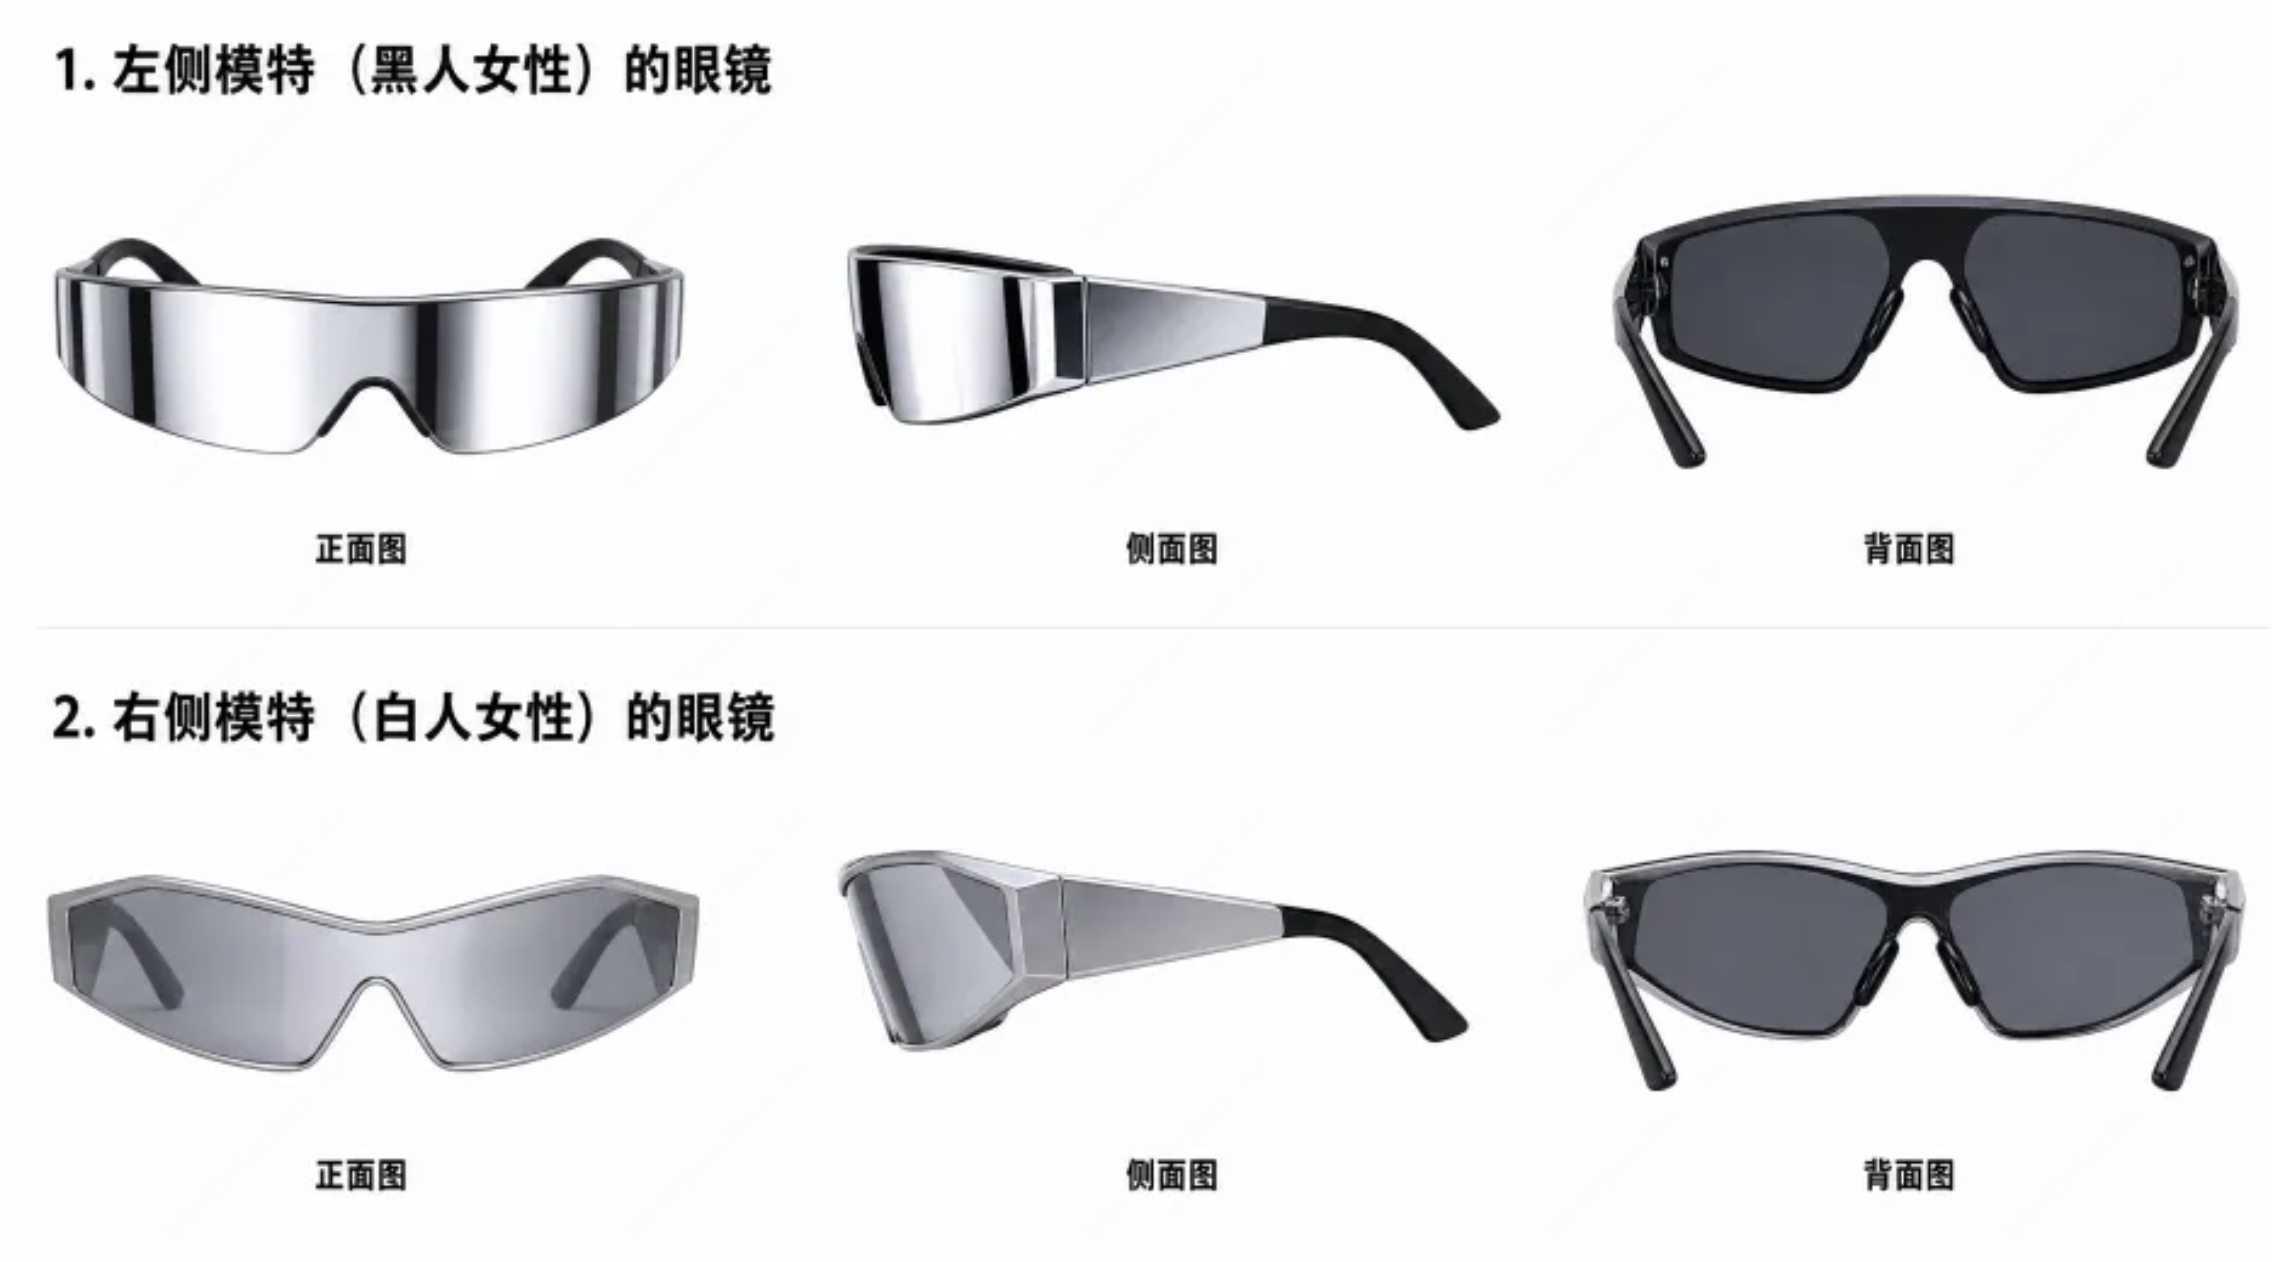
Produktionsmål: 9:16 exklusiv modeannons för glasögon. Helkroppsbilden av personen ansvarar för kroppsform och gångstil, ansiktsreferensbilden ansvarar för ansiktsdrag och makeup, produktbilden ansvarar för omslutande kurvor, linsreflektioner, skalmar och kattögonkonturer. Detta exempel testar samtidigt ansiktsnärbilder, konsekvens mellan flera personer, bärrelationer och produktens geometriska struktur.| Referens för modell och styling | Referens för ansiktsdetaljer | Referens för glasögonprodukt |
|---|---|---|
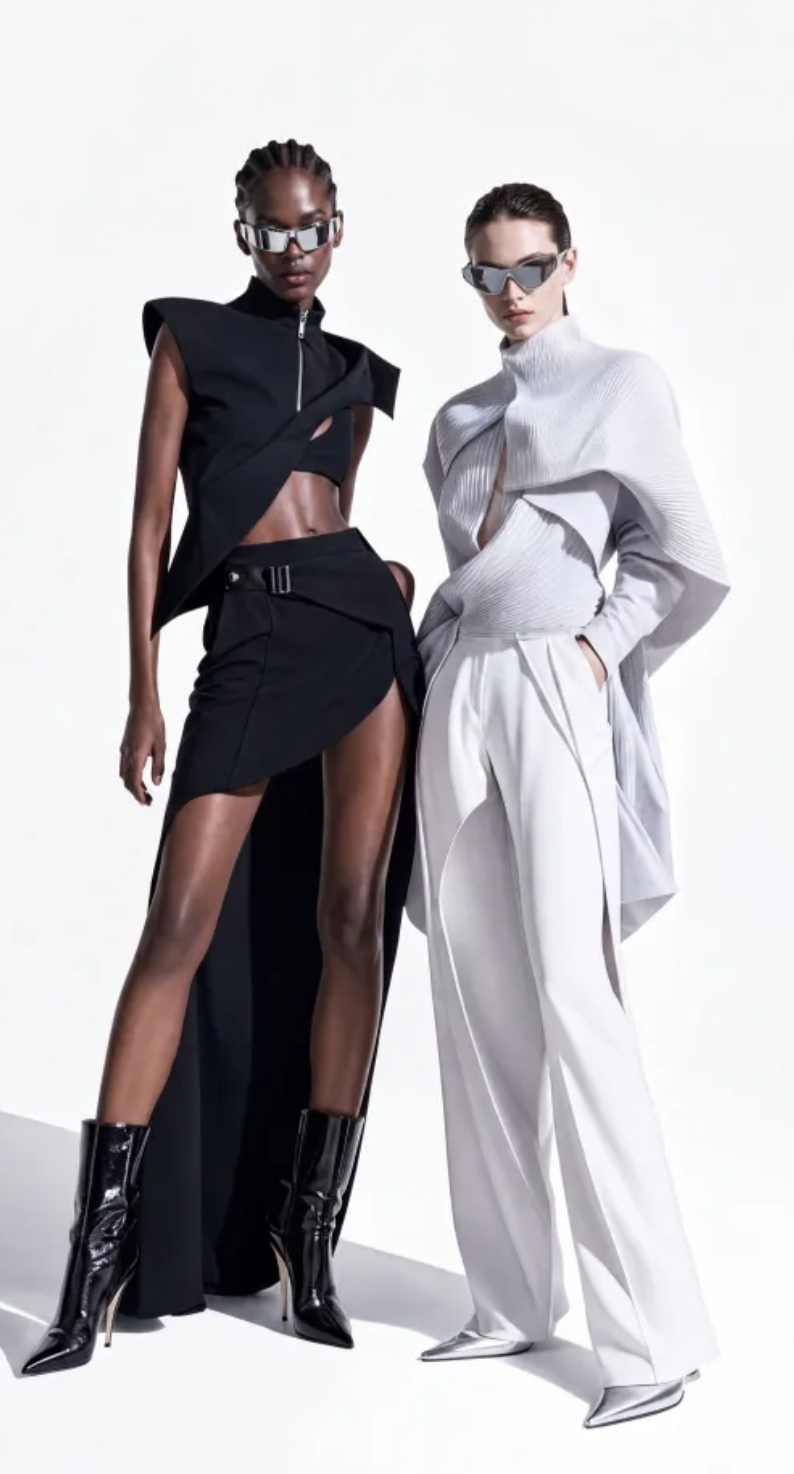 | 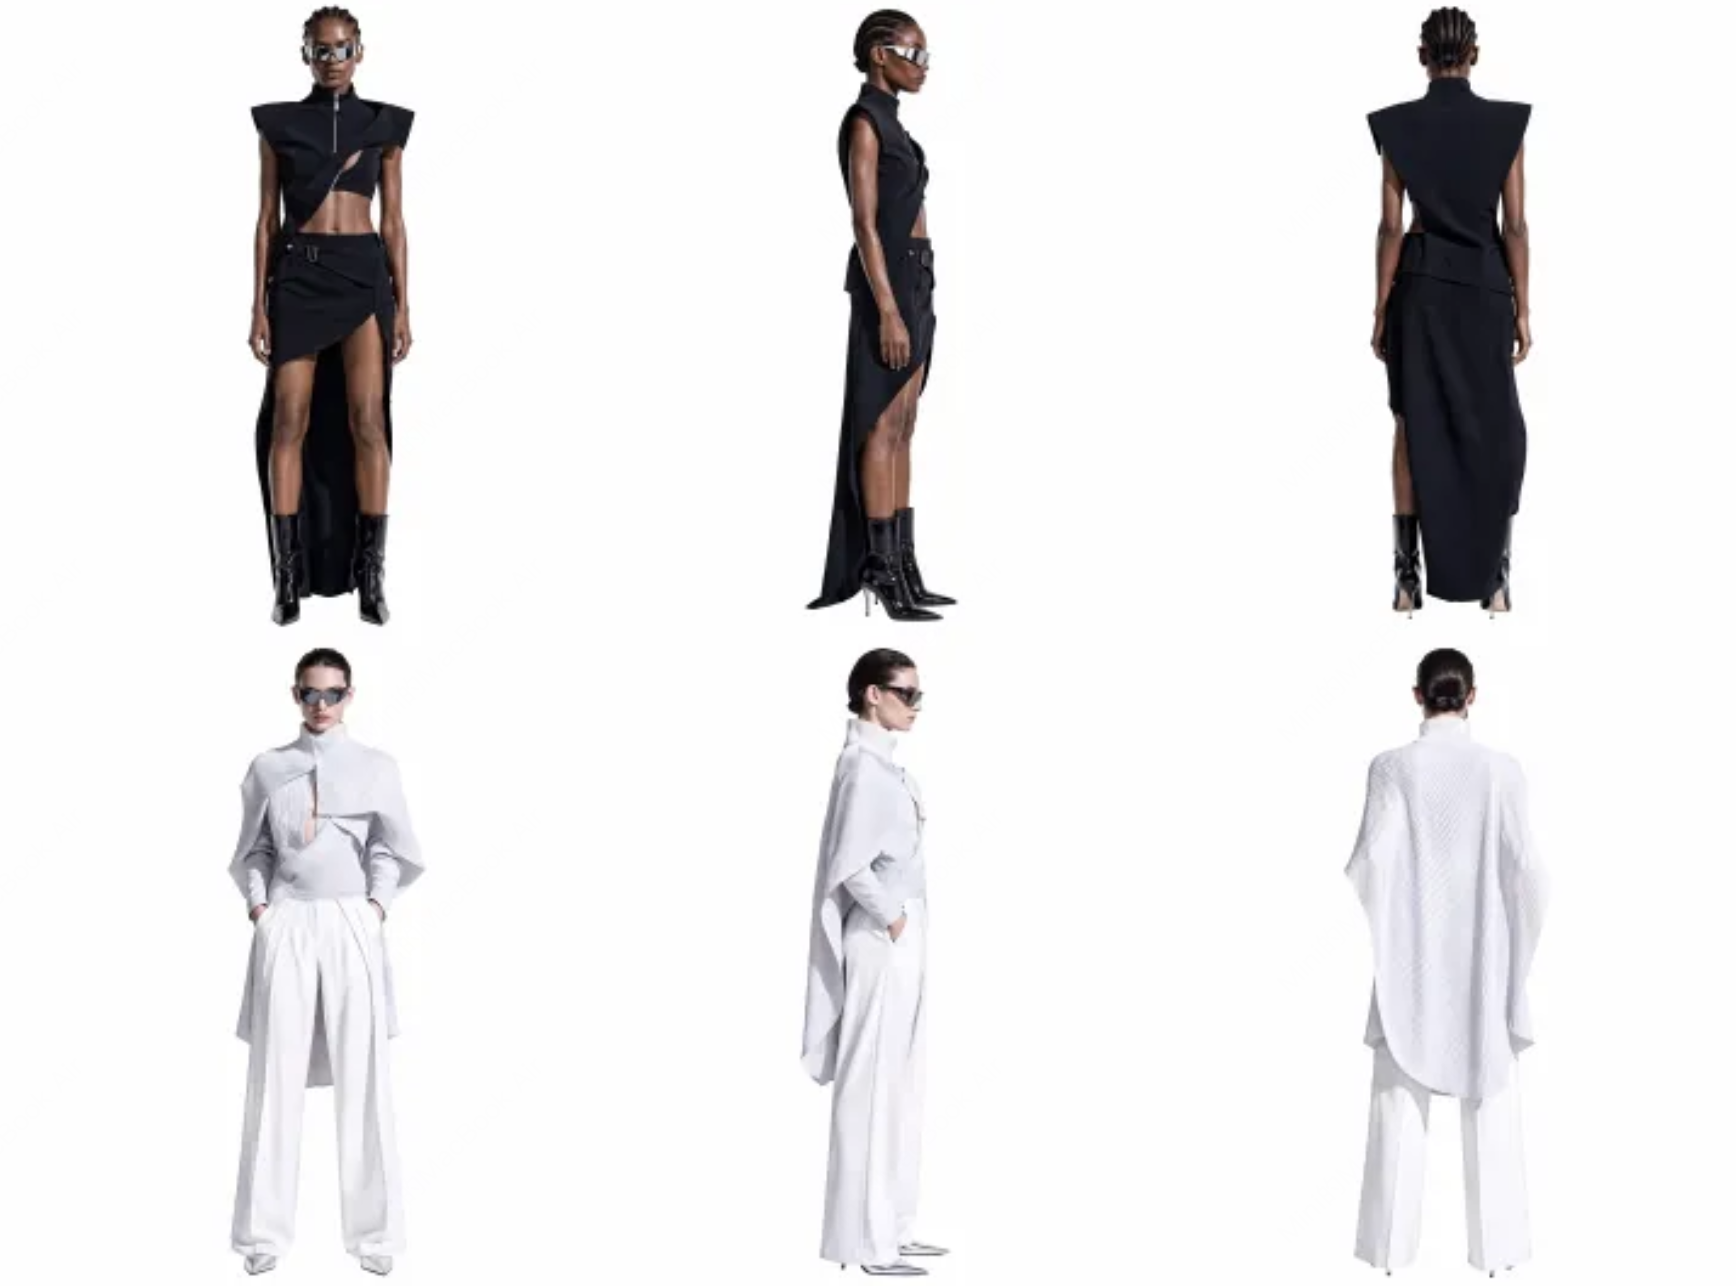 |  |
Text-till-video
När det bara finns ett textobjekt är det text-till-video. Det passar för att direkt generera bilder från idéer, manus eller bildbeskrivningar. Prompten kan organiseras i ordningen ”motiv + handling + miljö + kamera + ljus + ljud”."async": true läggs till i begäran returnerar gränssnittet omedelbart:
Bild-till-video med första bildrutan
Markera bilden somfirst_frame, så börjar modellen generera från denna bild. Det passar för att få affischer, produktbilder, karaktärsdesignbilder och fotografiska verk att naturligt börja röra sig.
Slutbildruta samt video med första och sista bildruta
Att endast tillhandahållalast_frame gör att modellen naturligt kan generera fram till den angivna bilden; att samtidigt tillhandahålla first_frame och last_frame gör det möjligt att tydligt kontrollera start- och slutpunkt. Lämpligt för övergångar, formförändringar, tillväxtprocesser eller jämförelser av produkter före och efter.
Multimodal referens för video-generering
Referensmaterial kan användas i kombination: referensbilder styr karaktärers eller produkters utseende, referensvideor styr rörelser och kameraföring, och referensljud styr dialogröst, musik eller klipprytm. I prompten bör det tydligt anges vad varje typ av material ska styra, för att undvika att bara ladda upp material utan att ange sambandet.Återanropsnotifiering
Att skicka incallback_url aktiverar automatiskt asynkront läge: skapandegränssnittet returnerar omedelbart task_id och trace_id, och skickar det slutliga resultatet via POST till den adressen när uppgiften är klar. Strukturen är densamma som för svaret vid uppgiftsfråga.
Slutstatusen i återanropet är succeeded, failed eller cancelled. Även vid användning av återanrop rekommenderas det att spara task_id, för att kunna göra aktiva förfrågningar eller kompensera för missade notifieringar.
Vanliga fel
task.status: succeeded i det synkrona svaret innebär att videon har genererats; asynkron bekräftelse innebär endast att uppgiften har lagts i kön. Debitering sker endast när uppgiften slutligen lyckas; att fråga efter uppgifter är kostnadsfritt och leder inte till upprepad debitering.
H3 Max
MiniMax-H3-Max stöder 480P eller 768P samt heltalslängder på 5–15 sekunder. Ljudinmatning debiteras inte extra, de första 2 bilderna är kostnadsfria och överskjutande bilder debiteras per bild; referensvideor debiteras utifrån faktisk inmatningslängd. Denna modell stöder inte 2K.