Hoppa till huvudinnehåll
Google Gemini är ett mycket kraftfullt AI-konversationssystem. Genom att bara ange en prompt kan det generera flytande och naturliga svar på bara några sekunder. Gemini kan erbjuda fantastisk intelligent assistans, vilket avsevärt förbättrar människors arbetseffektivitet och kreativitet. Detta dokument introducerar främst användningsprocessen för Gemini Chat Completion API. Med hjälp av det kan vi enkelt använda den officiella Gemini-konversationsfunktionen.

Ansökningsprocess

För att använda Gemini Chat Completion API, gå först till Ace Data Cloud-konsolen för att hämta din API-token och spara den för senare användning. Om du ännu inte har loggat in eller registrerat dig omdirigeras du automatiskt till inloggningssidan, där du uppmanas att registrera dig och logga in. När det är klart återgår du automatiskt till den aktuella sidan. En API-token kan anropa alla plattformens tjänster, utan att du behöver ansöka separat för varje tjänst. Vid den första ansökan får du gratis kvot för att prova utan kostnad; när kvoten inte räcker till kan du fylla på ett gemensamt saldo i konsolen.
📘 Fullständig dokumentation: Gemini Chat Completion API →

Grundläggande användning

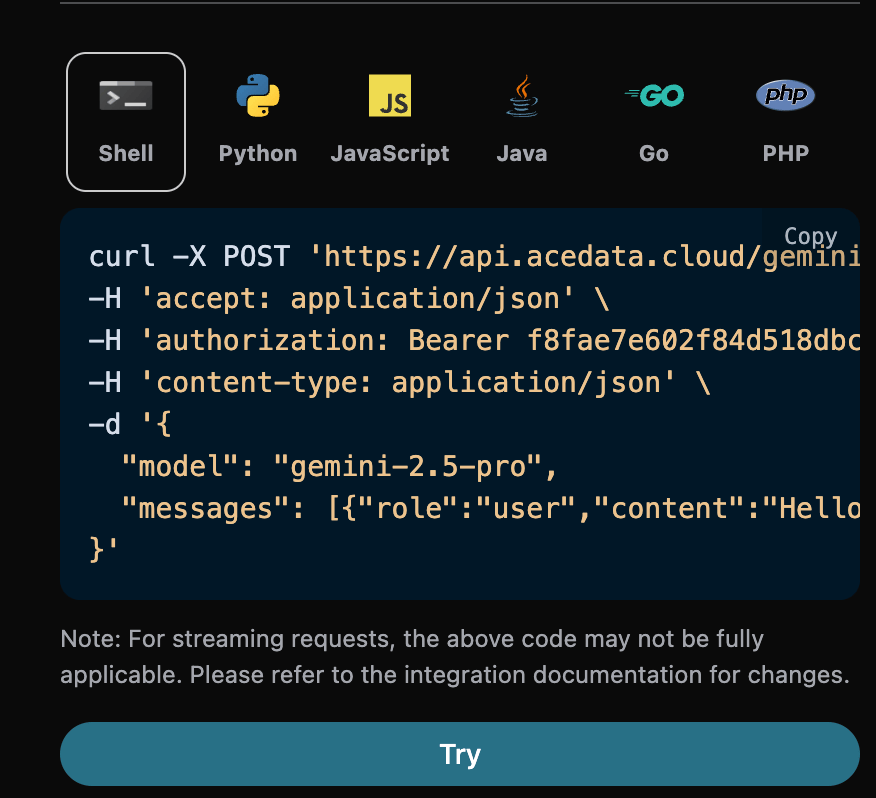
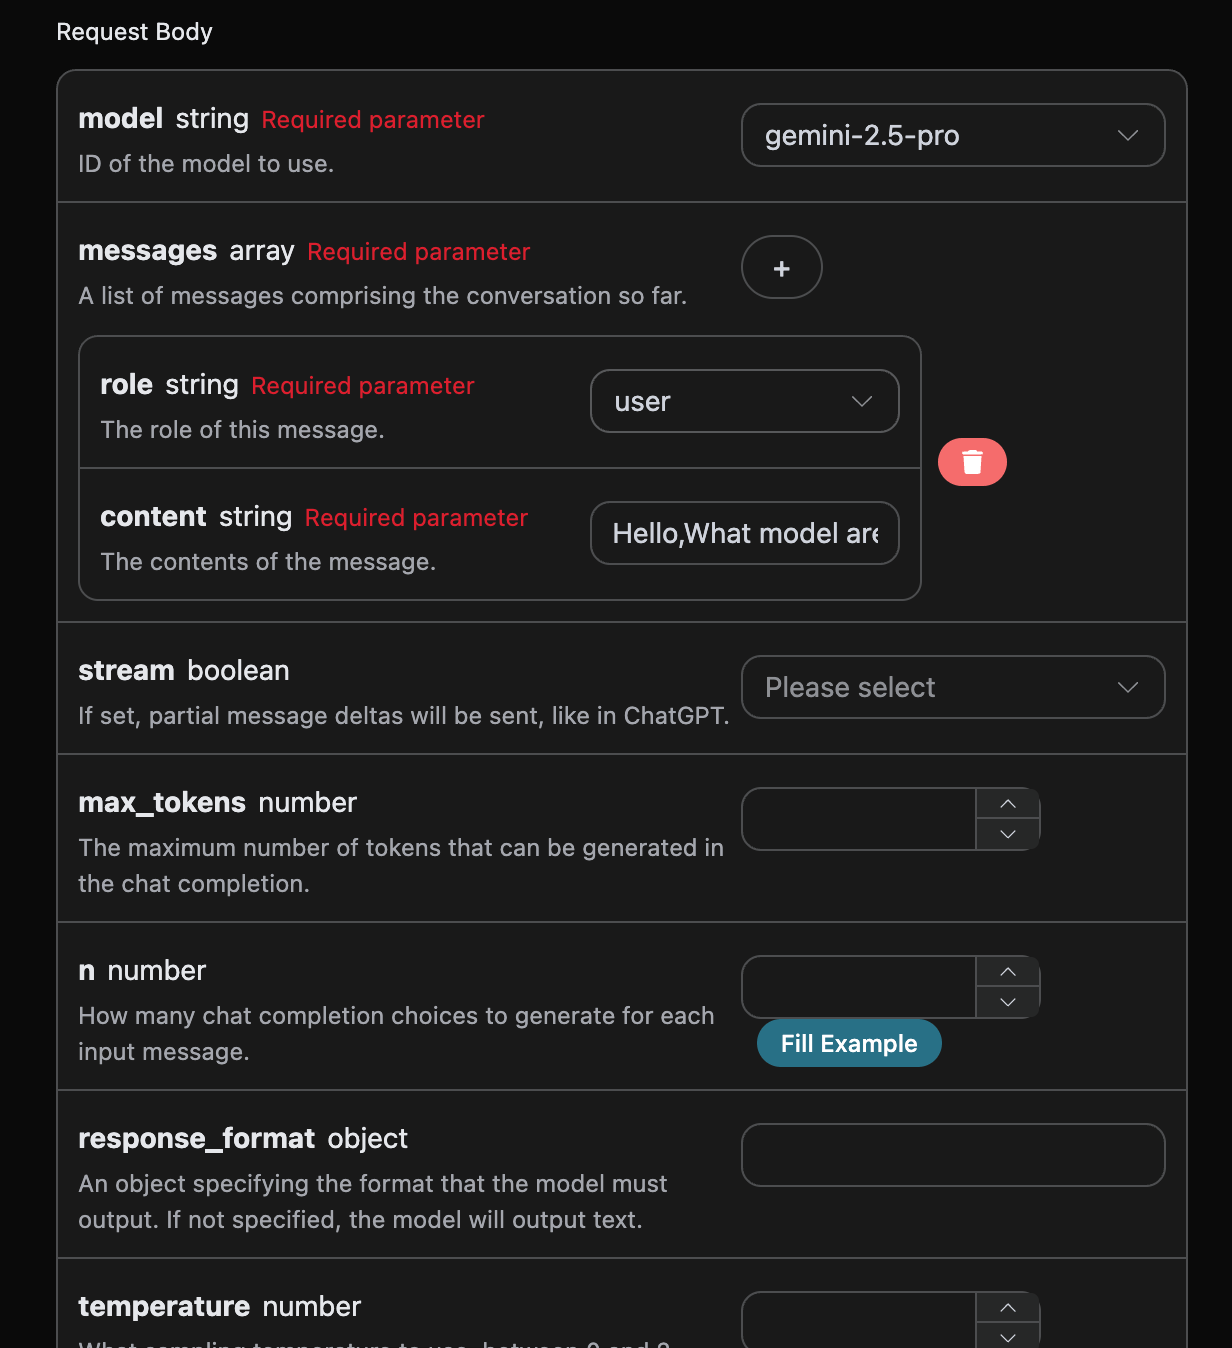
Därefter kan du fylla i motsvarande innehåll i gränssnittet, som visas i bilden:

När vi använder detta gränssnitt för första gången behöver vi minst fylla i tre saker. Den ena är authorization, som du kan välja direkt i rullgardinslistan. En annan parameter är model, model är den kategori av Gemini-modell från den officiella webbplatsen som vi väljer att använda, och tillgängliga modeller följer model-uppräkningen i gränssnittsdokumentationen. Den sista parametern är messages, messages är den array av frågor som vi anger. Det är en array, vilket innebär att flera frågor kan skickas samtidigt. Varje fråga innehåller role och content, där role anger frågeställarens roll. Vi tillhandahåller tre identiteter: user, assistant och system. Det andra, content, är det specifika innehållet i vår fråga. Samtidigt kan du notera att motsvarande anropskod genereras på höger sida. Du kan kopiera koden och köra den direkt, eller klicka direkt på knappen ”Try” för att testa.

Tips: Flash-modellerna i serien gemini-3.x är resonerande modeller och förbrukar först reasoning tokens; ställ in max_tokens till över 512, annars kan endast tomt innehåll returneras. gemini-3.8-flash är den för närvarande rekommenderade Flash-modellen och stöder upp till 1 miljon Token kontext, bildinmatning, verktygsanrop och strömmande svar; den anropas för närvarande via Chat Completions-gränssnittet.
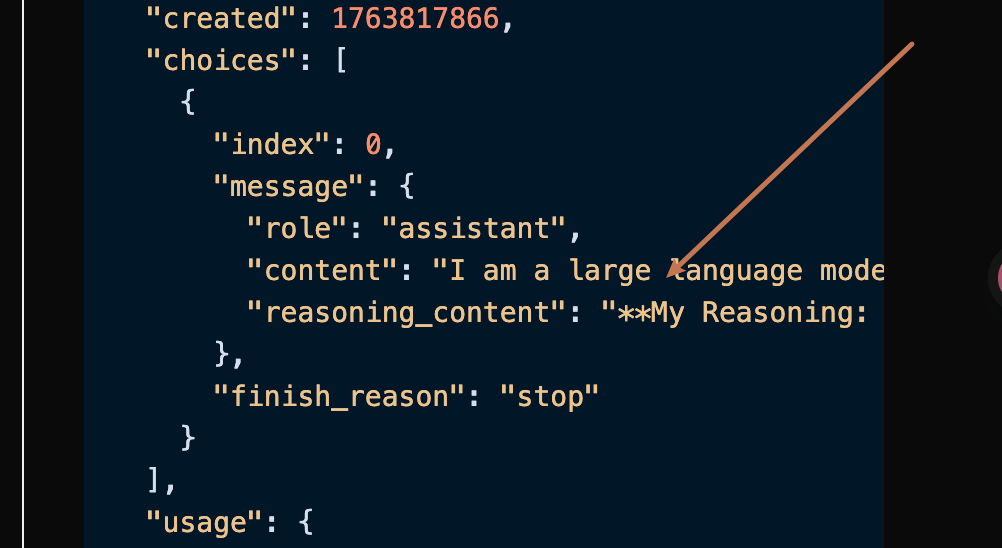
Efter anropet ser vi att det returnerade resultatet är följande:
Det returnerade resultatet har flera fält, som beskrivs nedan:
  • id, ID:t för den genererade konversationsuppgiften, som används för att unikt identifiera denna konversationsuppgift.
  • model , den valda Gemini-modellen från den officiella webbplatsen.
  • choices, svarsinformationen som Gemini ger för frågan.
  • usage : statistisk information om tokens för denna fråga och svar.
Bland dessa innehåller choices Geminis svarsinformation, och dess choices är den specifika informationen om Geminis svar, vilket kan ses i bilden.

Man kan se att fältet content i choices innehåller det specifika innehållet i Geminis svar.

Bildförståelse (multimodal inmatning)

Gemini är en inbyggt multimodal modell och kan direkt ”se bilder”. För att skicka in en bild ändrar du content för ett meddelande från en sträng till en innehållsblocksarray, och lägger både ett text-block och ett image_url-block i arrayen — detta är helt förenligt med OpenAI och det officiella Gemini-formatet som är kompatibelt med OpenAI. image_url.url stöder två skrivsätt:
  • base64 data: URI (rekommenderas, mest stabilt): formatet är data:<medietyp>;base64,<data>, till exempel data:image/jpeg;base64,/9j/4AAQ.... Medietypen (MIME) är redan angiven i prefixet data:, så ett separat fält för media_type behövs inte och finns inte heller.
  • Offentligt tillgänglig bild-URL: till exempel https://cdn.acedata.cloud/4hfydw.jpg.
Bildtyper som stöds: png, jpeg, webp, heic, heif. Python-exempelkod för anrop (base64 data URI):
Du kan även direkt skicka en offentligt åtkomlig bild-URL:
💡 image_url accepterar endast fältet url (värdet kan vara en bild-URL eller en base64-data:-URI), samt det valfria fältet detail. Skicka inte media_type — det är Anthropic Claudes bildfält och tillhör inte OpenAI / Geminis image_url-format.

Strömmande svar

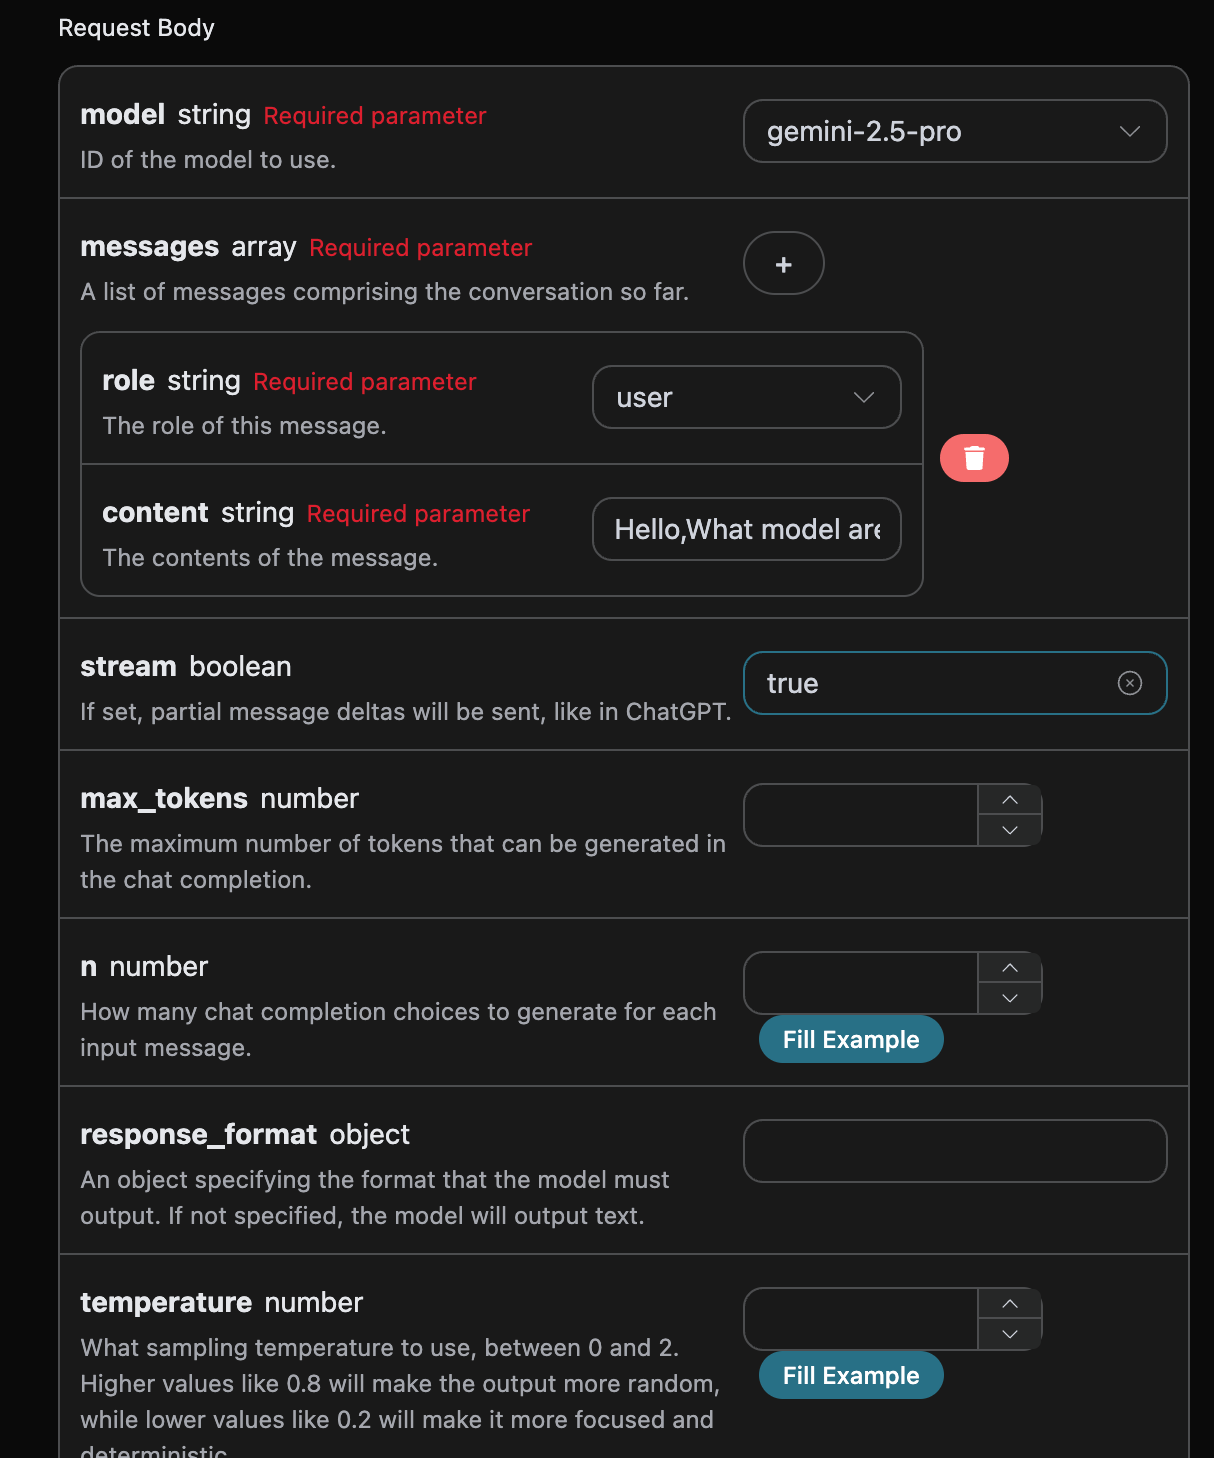
Detta gränssnitt stöder också strömmande svar, vilket är mycket användbart för webbintegration och gör det möjligt för webbsidor att visa text ord för ord. Om du vill returnera svaret som en ström kan du ändra parametern stream i begärans huvud till true. Ändringen visas i bilden, men anropskoden behöver motsvarande ändringar för att stödja strömmande svar.

Efter att stream har ändrats till true kommer API:et att returnera motsvarande JSON-data rad för rad, och på kodnivå behöver vi göra motsvarande ändringar för att få resultat rad för rad. Python-exempel på anropskod:
Utdataeffekten är följande:
Som du kan se finns det många data i svaret, och choices i data är det senaste svars-innehållet, vilket överensstämmer med innehållet som introducerades ovan. choices är det nytillagda svars-innehållet, och du kan integrera det i ditt system utifrån resultaten. Samtidigt avgörs slutet på det strömmande svaret utifrån innehållet i data; om innehållet är [DONE] betyder det att det strömmande svaret har avslutats helt. Det returnerade data-resultatet har flera fält, som introduceras enligt följande:
  • id,genererar ID:t för denna konversationsuppgift, som används för att unikt identifiera denna konversationsuppgift.
  • model ,den valda Gemini-modellen på den officiella webbplatsen.
  • choices,svarsinformationen som Gemini ger för frågeorden.
JavaScript stöds också, till exempel är koden för strömmande anrop i Node.js följande:
Java-exempelkod:
Andra språk kan dessutom anpassas på egen hand, principen är densamma.

Fleromgångskonversation

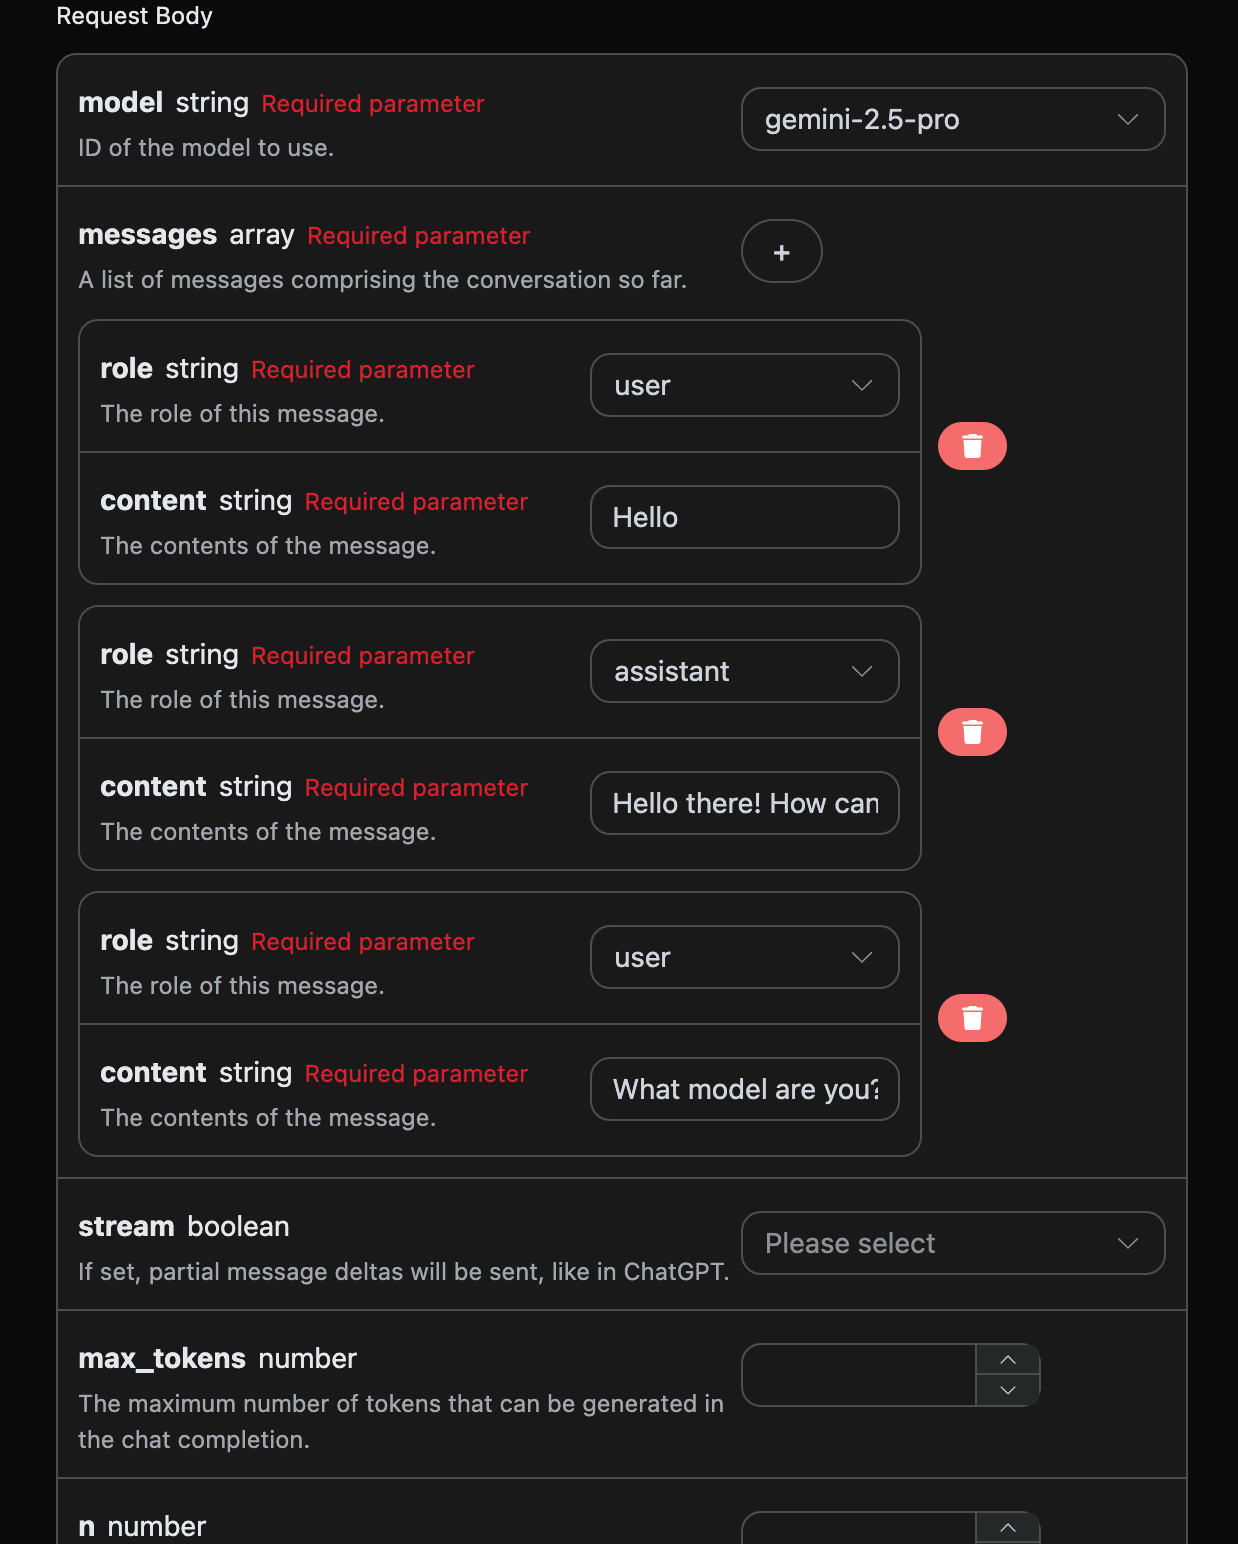
Om du vill integrera funktionen för flersamtalskonversationer behöver du skicka flera frågeord till fältet messages, ett specifikt exempel med flera frågeord visas i bilden nedan:

Python-exempelkod för anrop:
Genom att skicka flera frågeord kan flersamtalskonversationer enkelt implementeras, och följande svar kan erhållas:
Som kan ses är informationen som choices innehåller densamma som innehållet vid grundläggande användning. Detta innehåller det specifika innehållet i Geminis svar på flera konversationer, så att motsvarande frågor kan besvaras utifrån innehållet i flera konversationer.

Gemini-3.0 multimodal modell

Exempel på begäran:
Exempelresultat:
Du kan naturligtvis också skicka länkar till exempelvis videor, och den specifika inmatningen är följande:
Exempelresultat:
Av ovanstående kan man se att Gemini 3.0-modellen kan stödja multimodal förståelse.

Gemini-3.1 multimodal modell

gemini-3.1-pro-preview är det officiella modell-ID:t för den nuvarande Gemini 3.1 Pro och stöder multimodala indata som text, bilder och videor, vilket gör den lämplig för komplexa uppgifter inom resonemang, kodning och förståelse. Begäransexempel:
Gemini 3.1 Pro stöder också videoförståelse:
Returformatet är detsamma som för Gemini 3.0 Pro. Se beskrivningen i avsnittet om Gemini-3.0 multimodal modell ovan för detaljer.

Felhantering

Vid anrop av API:et returnerar API:et motsvarande felkod och information om ett fel uppstår. Till exempel:
  • 400 token_mismatched: Bad request, possibly due to missing or invalid parameters.
  • 400 api_not_implemented: Bad request, possibly due to missing or invalid parameters.
  • 401 invalid_token: Unauthorized, invalid or missing authorization token.
  • 429 too_many_requests: Too many requests, you have exceeded the rate limit.
  • 500 api_error: Internal server error, something went wrong on the server.

Exempel på felsvar

Slutsats

Genom detta dokument har du lärt dig hur du använder Gemini Chat Completion API för att enkelt implementera den officiella Geminis konversationsfunktion. Vi hoppas att detta dokument kan hjälpa dig att bättre ansluta till och använda detta API. Om du har några frågor, kontakta gärna vårt tekniska supportteam.