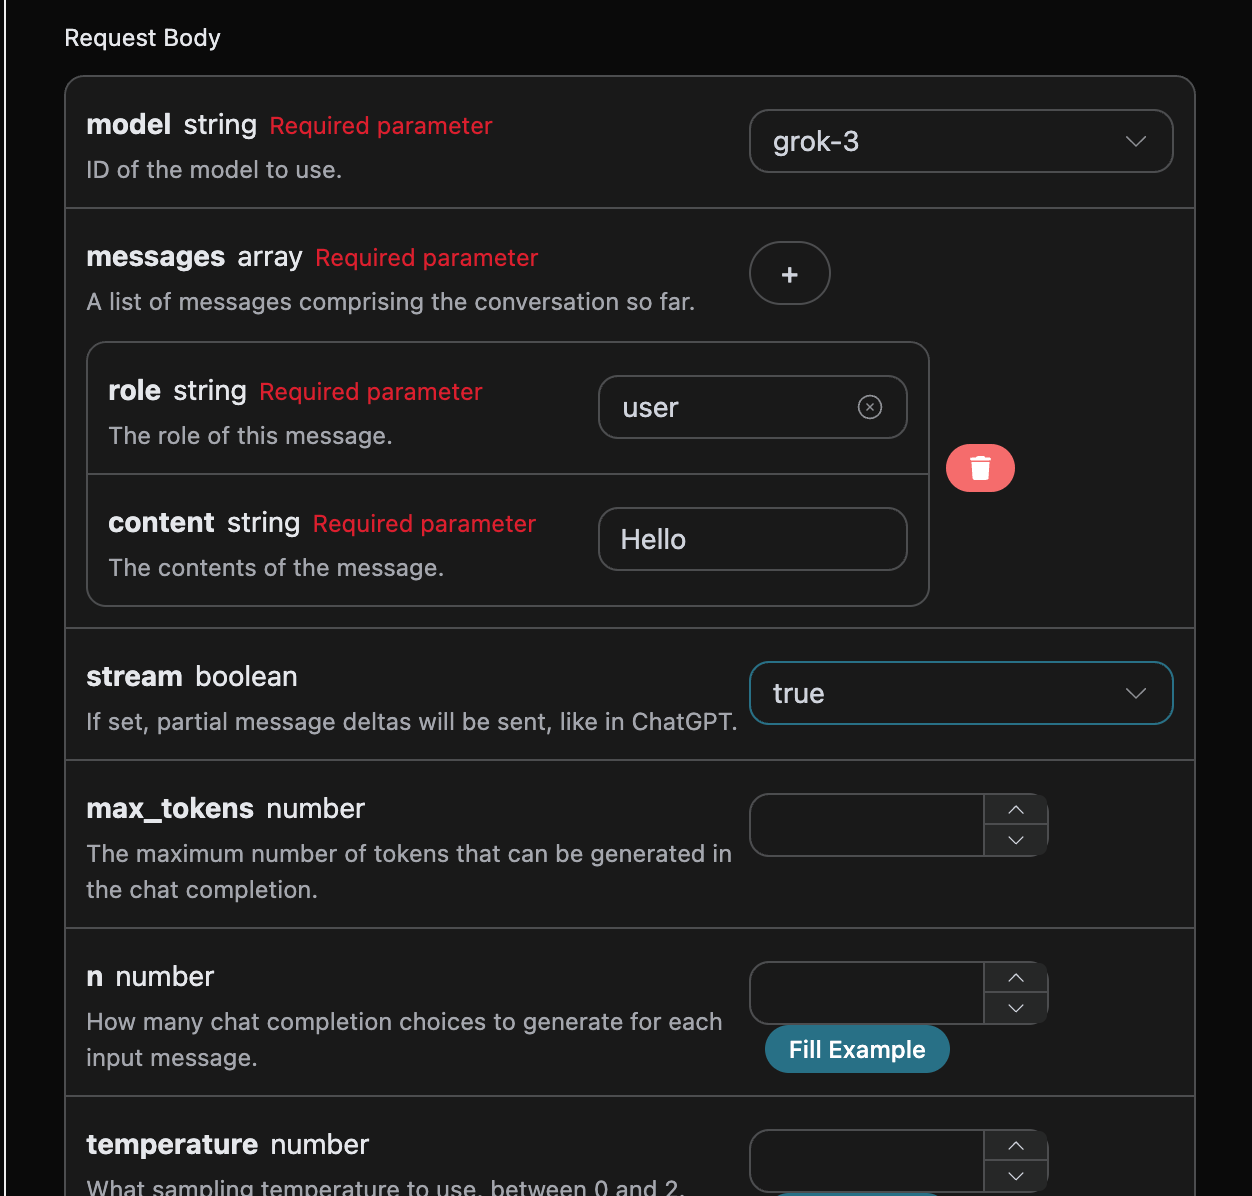
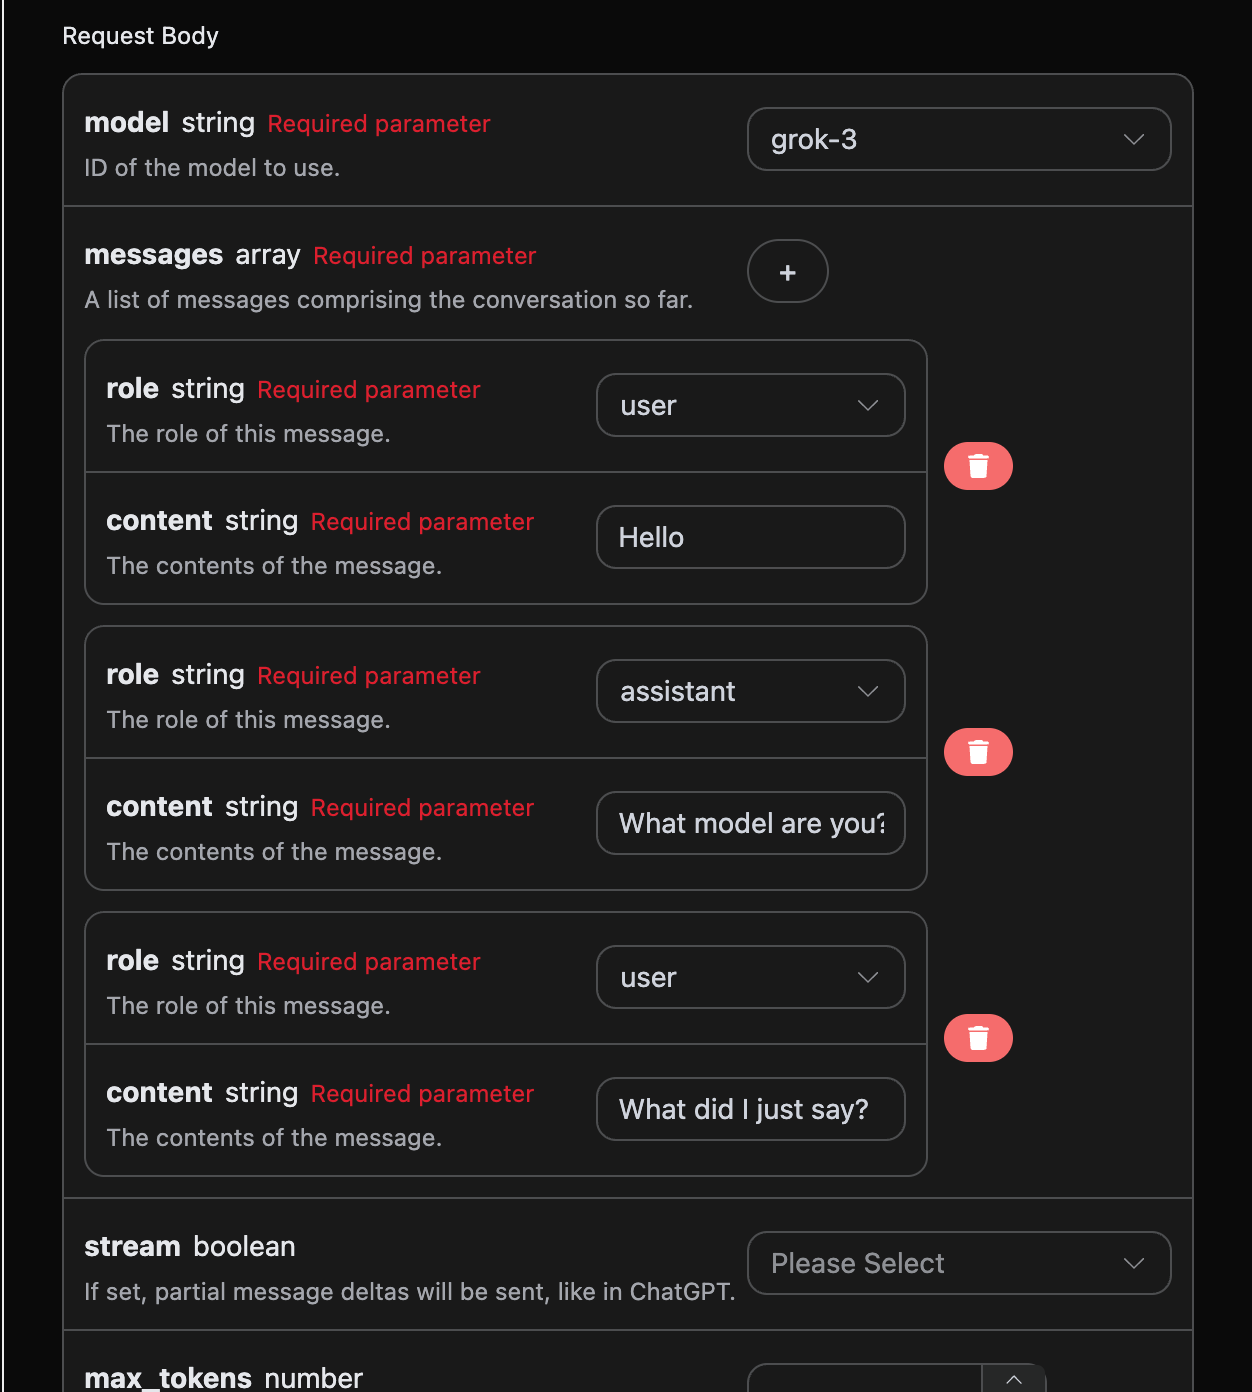
data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"role": "assistant"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "Yo, "}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "what"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data:
{"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "'s g"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "ood?"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": " Rea"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "dy t"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "o di"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "ve i"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "nto "}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "vad"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "som helst"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": " du"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "'re "}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "pond"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "erin"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "g ab"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "ut "}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "i dag"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {"content": "?"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": null, "choices": [{"delta": {}, "logprobs": null, "finish_reason": "stop", "index": 0}], "usage": {"prompt_tokens": 0, "completion_tokens": 0, "total_tokens": 0, "prompt_tokens_details": {"cached_tokens": 0, "text_tokens": 0, "audio_tokens": 0, "image_tokens": 0}, "completion_tokens_details": {"text_tokens": 0, "audio_tokens": 0, "reasoning_tokens": 0}, "input_tokens": 0, "output_tokens": 0, "input_tokens_details": null}}

data:
{"id": "foaicmpl-503ab14f-3f22-46ab-9f91-3fb44773be38", "object": "chat.completion.chunk", "created": 1755839790, "model": "grok-3", "system_fingerprint": "", "choices": [], "usage": {"prompt_tokens": 8, "completion_tokens": 18, "total_tokens": 26, "prompt_tokens_details": {"cached_tokens": 0, "text_tokens": 0, "audio_tokens": 0, "image_tokens": 0}, "completion_tokens_details": {"text_tokens": 0, "audio_tokens": 0, "reasoning_tokens": 0}, "input_tokens": 0, "output_tokens": 0, "input_tokens_details": null}}

data: [DONE]


 Om du inte har loggat in eller registrerat dig kommer du automatiskt att omdirigeras till inloggningssidan för att registrera dig och logga in. När detta är klart kommer du automatiskt att återvända till den aktuella sidan.
En API-token räcker för att anropa alla plattformens tjänster, du behöver inte ansöka separat för varje tjänst. Första gången du ansöker får du en gratis kvot för att prova; när kvoten är slut kan du ladda på allmän balans i konsolen.