

GPT-6.1 Sol
Användmodel: "gpt-6.1-sol" för att välja denna modell. Stöder strömmande utdata, funktionsanrop, strukturerade utdata och bildindata. Under den första veckan efter öppningen är den endast tillgänglig för verifierade ACE T1+-innehavare (minst 100 000 ACE) eller auktoriserade användare; den specifika öppningstiden avgörs av åtkomstmeddelandet i konsolen.
Resoneringsnivåer stöder low, medium, high, xhigh och max, medan none eller minimal för närvarande inte stöds. Det rekommenderas att börja med reasoning_effort: "low". När indata överstiger 272 000 tokens tillämpas prissättning för lång kontext på hela begäran, och kostnaden avgörs av det aktuella priset i konsolen.
Ansökningsprocess
För att använda OpenAI Chat Completion API, gå först till Ace Data Cloud-konsolen för att hämta din API Token och spara den som reserv. Om du ännu inte är inloggad eller registrerad omdirigeras du automatiskt till inloggningssidan för att registrera och logga in, och när det är klart återvänder du automatiskt till den aktuella sidan.
En API Token kan användas för att anropa alla tjänster på plattformen, utan att behöva ansöka separat för varje tjänst. Vid första ansökan får du gratis kredit för kostnadsfri testning; om krediten inte räcker till kan du fylla på det gemensamma saldot i konsolen.
📘 Fullständig dokumentation: OpenAI Chat Completion API →
Grundläggande användning
Därefter kan du fylla i motsvarande innehåll i gränssnittet, som visas i bilden: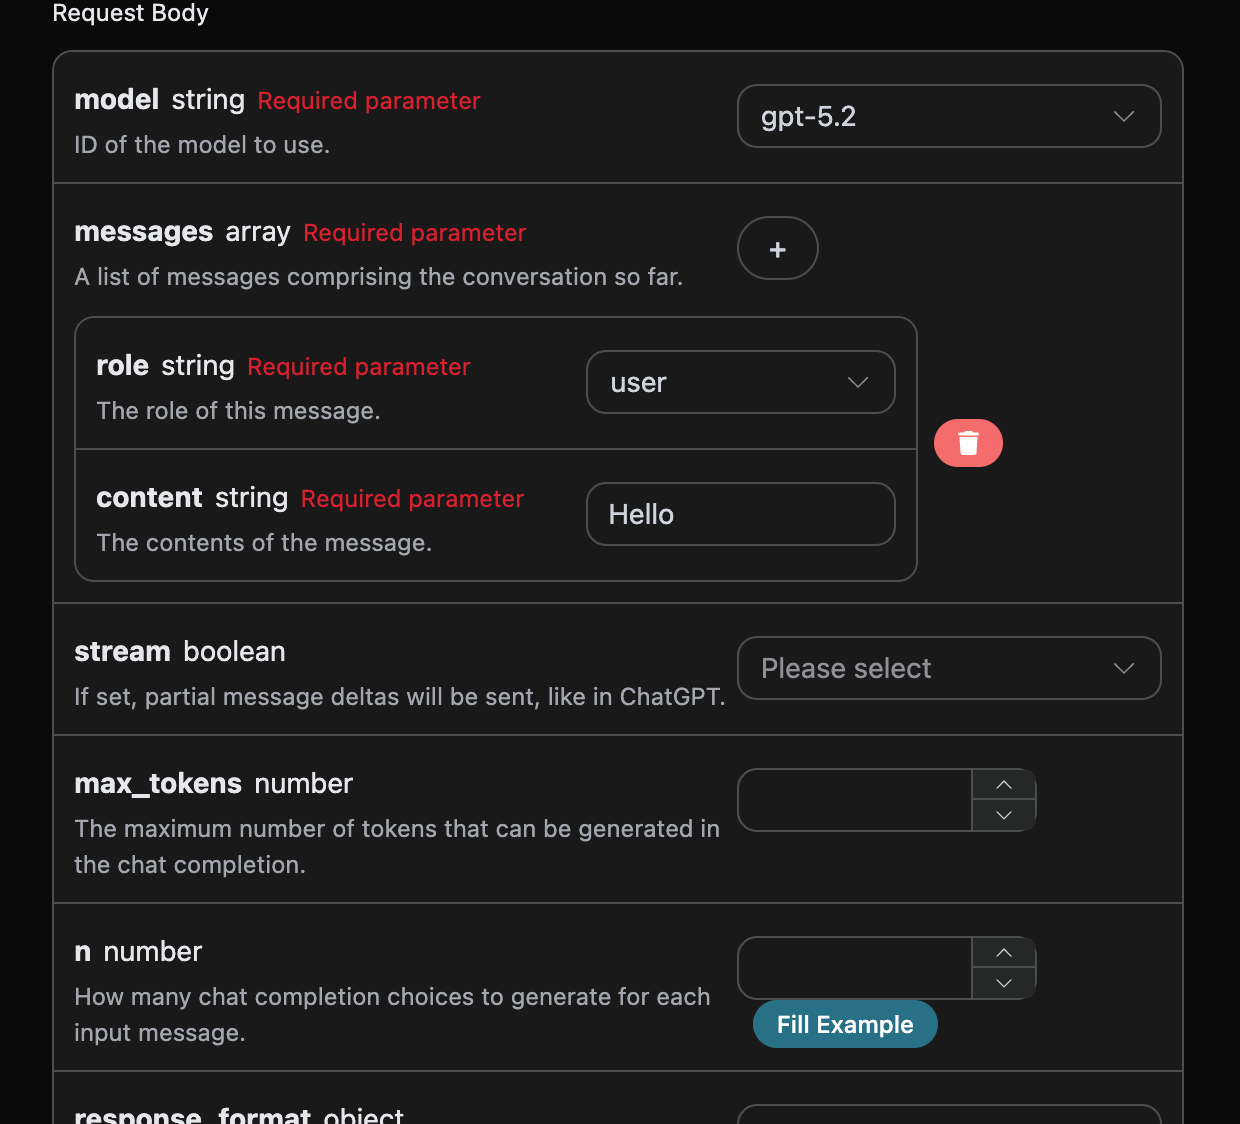
authorization, som kan väljas direkt i rullgardinslistan. Den andra parametern är model, där model är den modellkategori från OpenAI ChatGPT:s officiella webbplats som vi väljer att använda. Här har vi främst 20 modeller, och du kan se detaljer om de modeller vi tillhandahåller. Den sista parametern är messages, där messages är den array av frågeord som vi matar in. Det är en array, vilket innebär att flera frågeord kan laddas upp samtidigt. Varje frågeord innehåller role och content, där role anger frågeställarens roll. Vi erbjuder tre identiteter: user, assistant och system. Den andra, content, är det specifika innehållet i vår fråga.
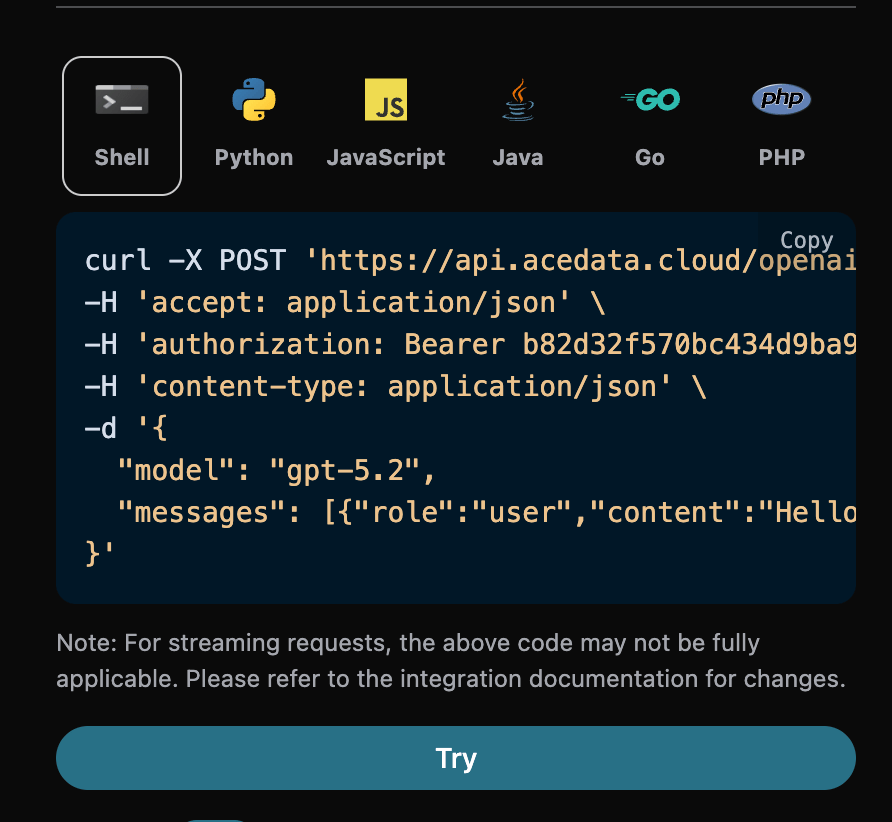
Samtidigt kan du se att motsvarande anropskod genereras till höger. Du kan kopiera koden och köra den direkt, eller klicka direkt på knappen ”Try” för att testa.
Vanliga valfria parametrar:
max_tokens: Begränsar det maximala antalet tokens i ett enskilt svar.temperature: Genereringsslumpmässighet, mellan 0 och 2; ju högre värde, desto mer spritt.n: Hur många kandidatsvar som genereras åt gången.response_format: Inställning för returformat.
id, ID:t som genereras för denna konversationsuppgift och används för att unikt identifiera denna konversationsuppgift.model, den valda modellen från OpenAI ChatGPT:s officiella webbplats.choices, den svarsinformation som ChatGPT ger för frågeorden.usage: statistisk information om tokens för denna fråga och detta svar.
choices ChatGPT:s svarsinformation, och choices i den är ChatGPT, vilket kan ses som visas i bilden.
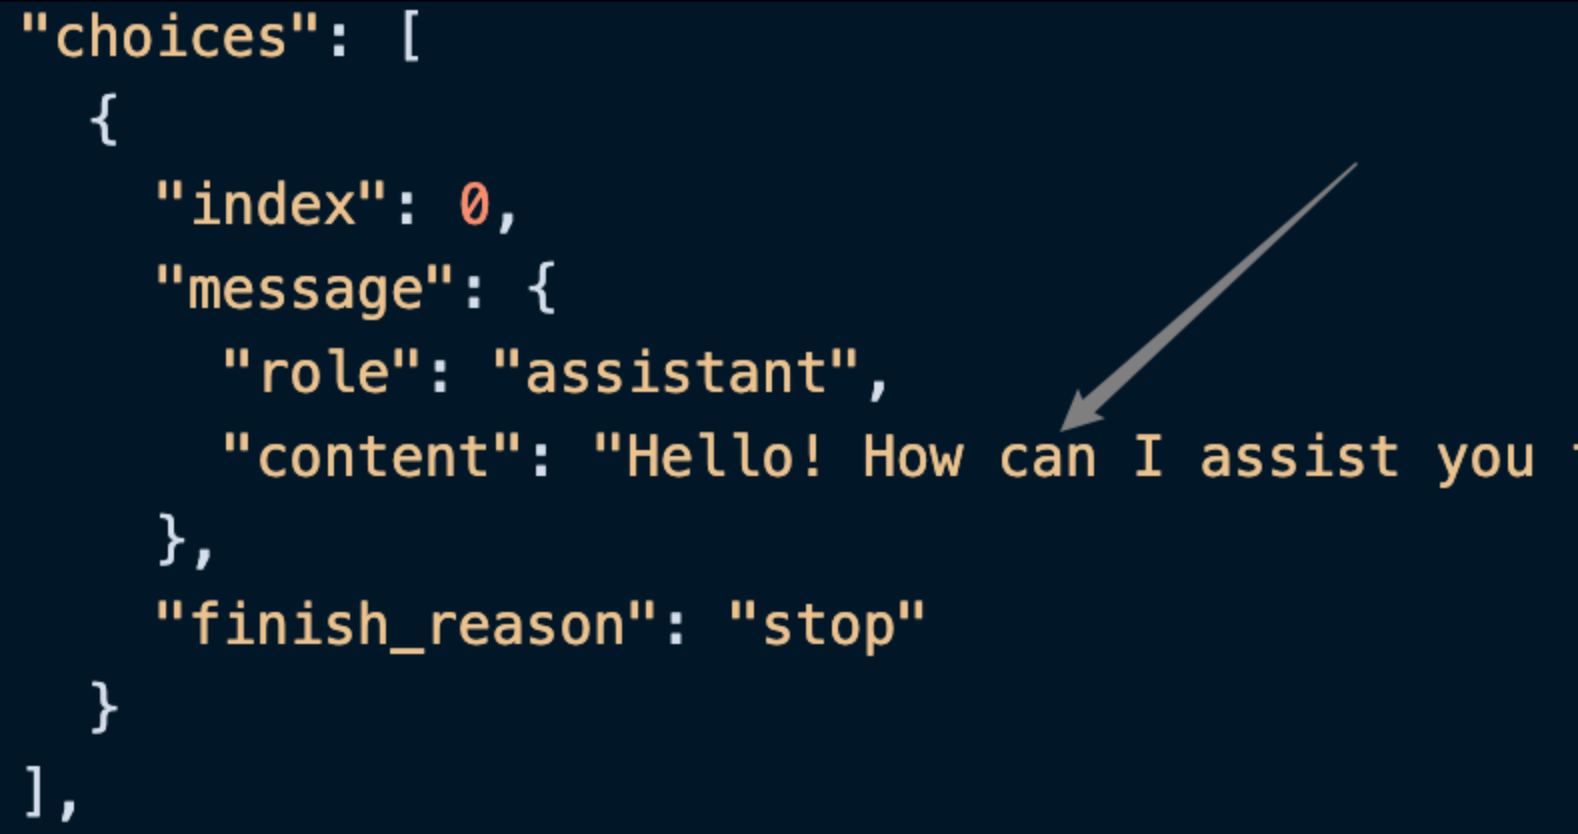
content i choices innehåller det specifika innehållet i ChatGPT:s svar.
Strömmande svar
Detta gränssnitt stöder också strömmande svar, vilket är mycket användbart för webbintegration och kan göra det möjligt för webbsidor att visa tecken för tecken. Om du vill returnera svar strömmande kan du ändra parameternstream i begärandehuvudet till true.
Ändringen visas i bilden, men anropskoden måste ändras motsvarande för att stödja strömmande svar.
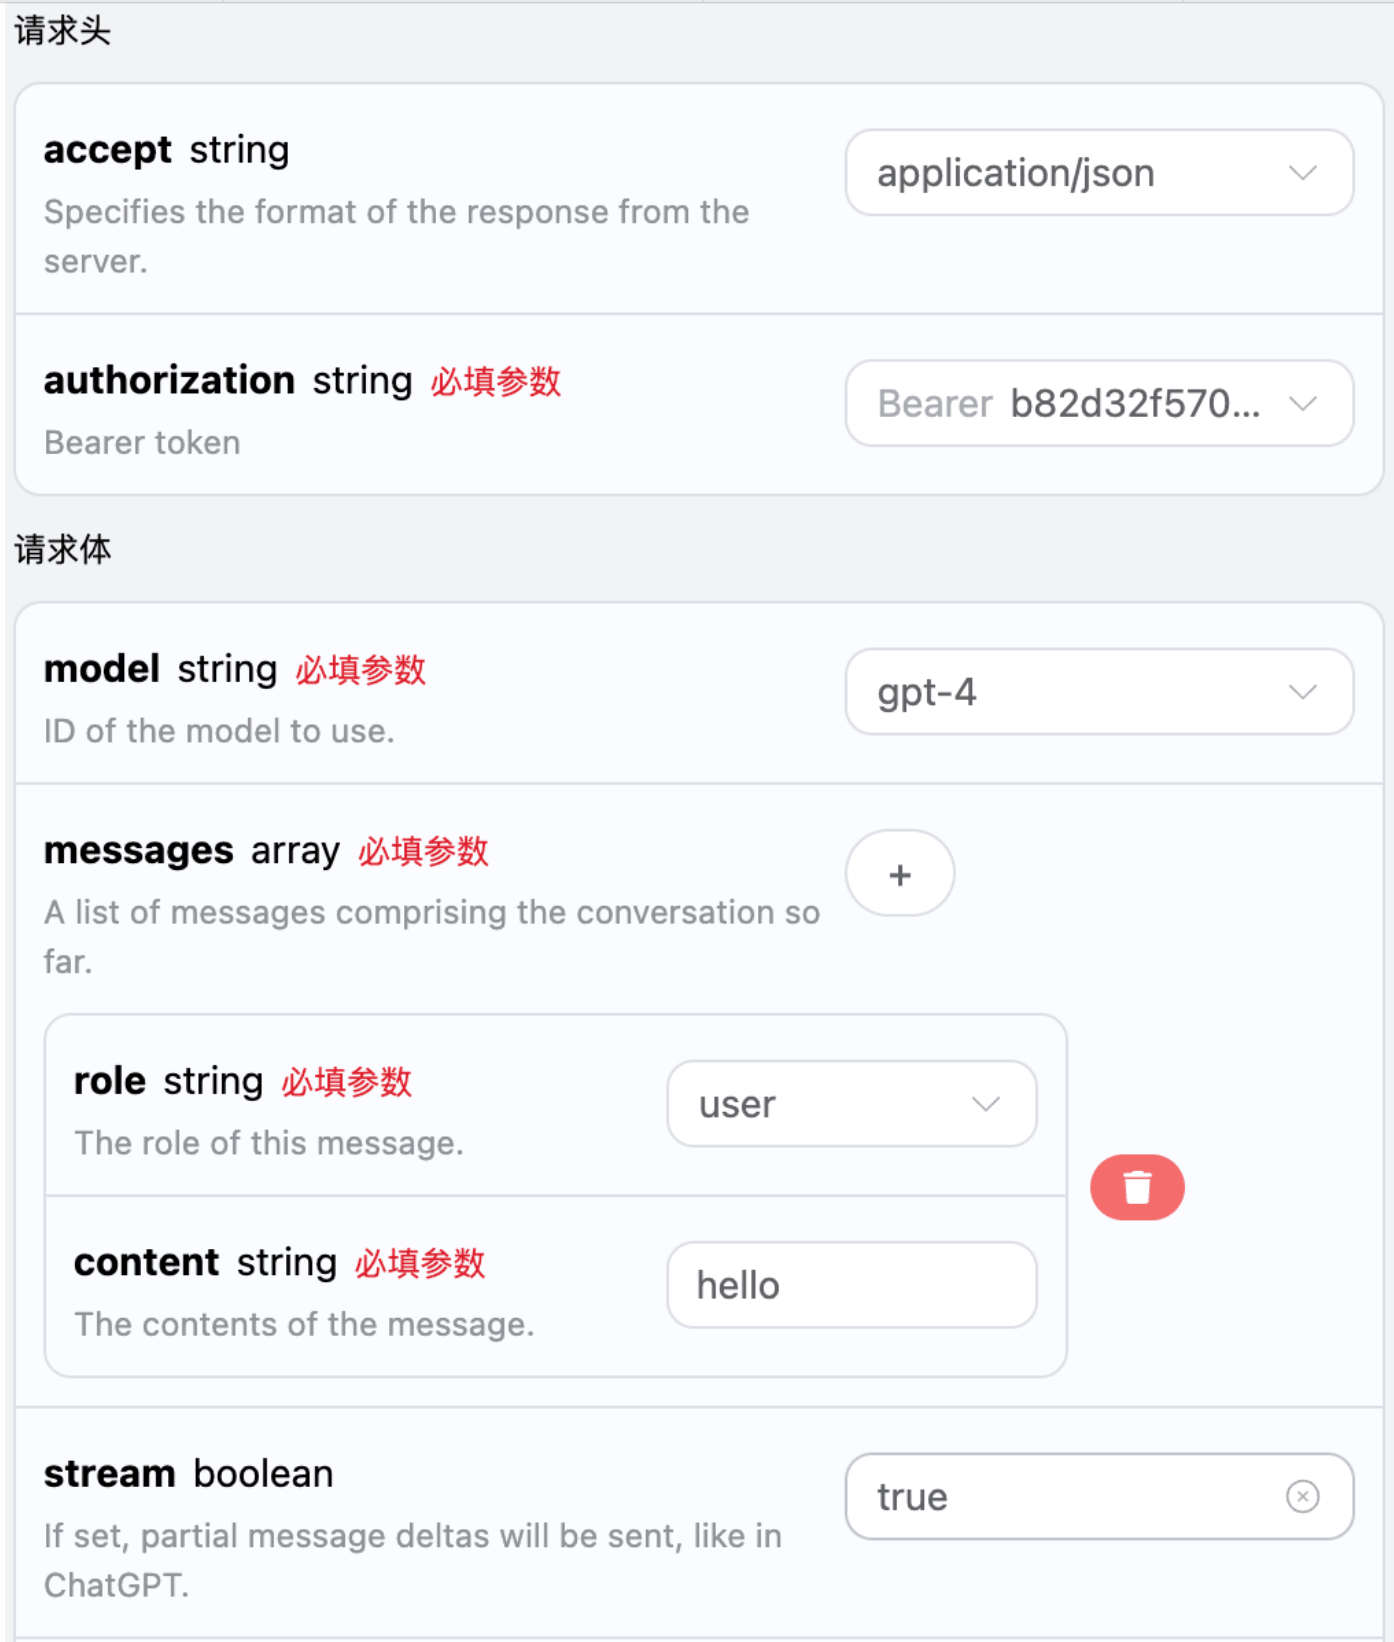
stream har ändrats till true returnerar API:t motsvarande JSON-data rad för rad, och på kodnivå behöver vi göra motsvarande ändringar för att få resultatet rad för rad.
Exempel på Python-anropskod:
data i svaret, och choices i data är det senaste svarsinhållet, vilket stämmer överens med innehållet som introducerats ovan. choices är det nytillkomna svarsinhållet, och du kan ansluta det till ditt system baserat på resultatet. Samtidigt avgörs slutet på det strömmande svaret utifrån innehållet i data; om innehållet är [DONE] betyder det att det strömmande svaret har avslutats helt. Det returnerade data-resultatet har flera fält, som introduceras nedan:
id, ID:t som genereras för denna dialoguppgift och används för att unikt identifiera denna dialoguppgift.model, den valda modellen från OpenAI ChatGPT:s officiella webbplats.choices, svarsinformationen som ChatGPT ger för frågan.
Fleromgångsdialog
Om du vill ansluta funktionen för flersamtalsdialog behöver du skicka flera frågor till fältetmessages. Ett specifikt exempel på flera frågor visas i bilden nedan:
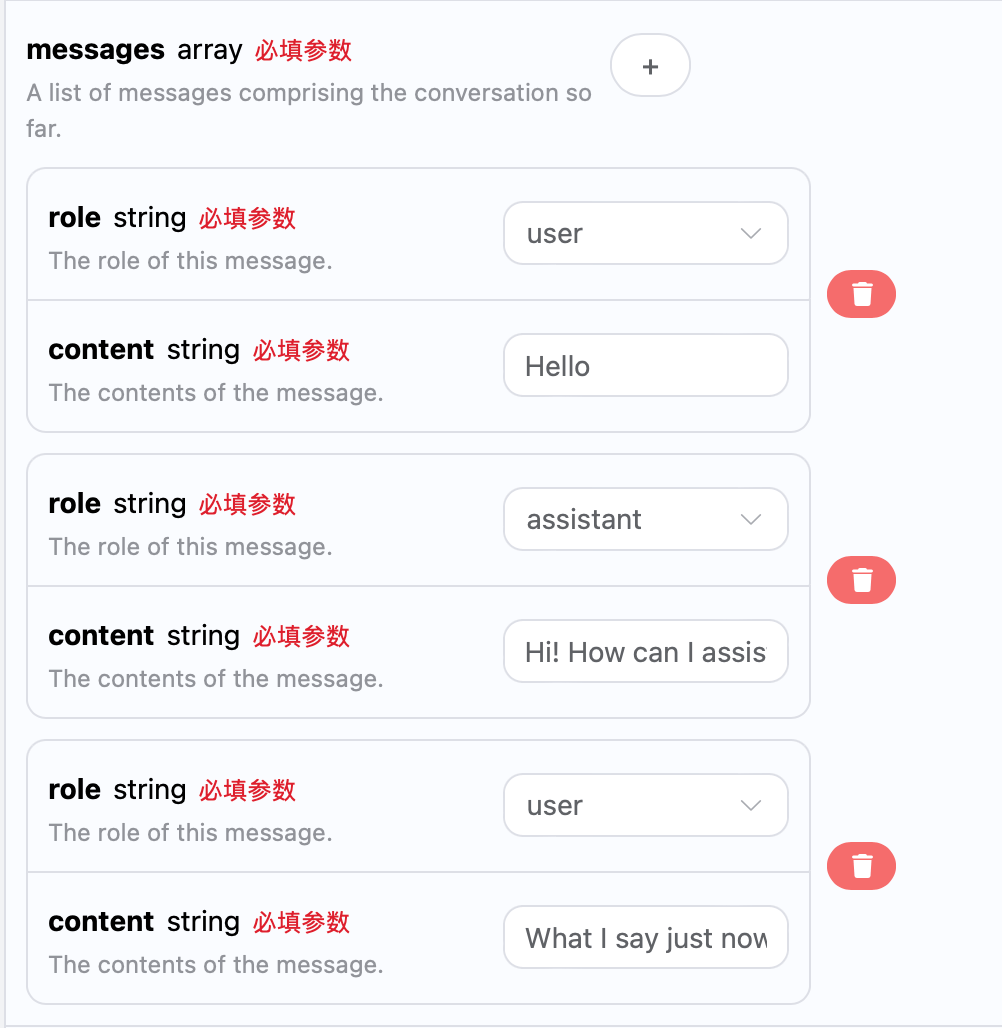
choices innehåller är densamma som innehållet i den grundläggande användningen, detta innehåller det specifika innehållet i ChatGPT:s svar för flera dialoger, och på så sätt kan motsvarande frågor besvaras utifrån innehållet i flera dialoger.
Anslutning till OpenAI-Python
OpenAI Chat Completion API är kompatibelt med det officiella OpenAI-gränssnittet och kan anslutas direkt med den officiella SDK:n OpenAI-Python. Den här artikeln kommer kortfattat att introducera användningen.- Först behöver du konfigurera en lokal
Python-miljö, denna process kan du söka efter på Google. - Ladda ner och installera utvecklingsmiljön, till exempel VSCode-redigeraren.
- Konfigurera miljövariabler för
OpenAI.
- Skapa och spara en fil med namnet
.envi projektmappen. - Innehållet i filen
.env:
sk-xxx med din egen key. OPENAI_BASE_URL är proxygränssnittet för åtkomst till OpenAI.
- Installera paketen som projektet är beroende av
- Skapa en exempelkällkodsfil
index.py, det specifika innehållet är följande:
Internetanslutna modeller
Modellerna gpt-3.5-browsing och gpt-4-browsing skiljer sig från andra modeller, de kan genomföra internetsökningar baserat på frågeord och returnera resultatet av internetsökningen till dig efter lämpliga justeringar. Den här artikeln kommer att demonstrera internetfunktionen genom ett konkret exempel. Därefter kan du fylla i motsvarande innehåll i gränssnittet för OpenAI Chat Completion API, som visas i bilden: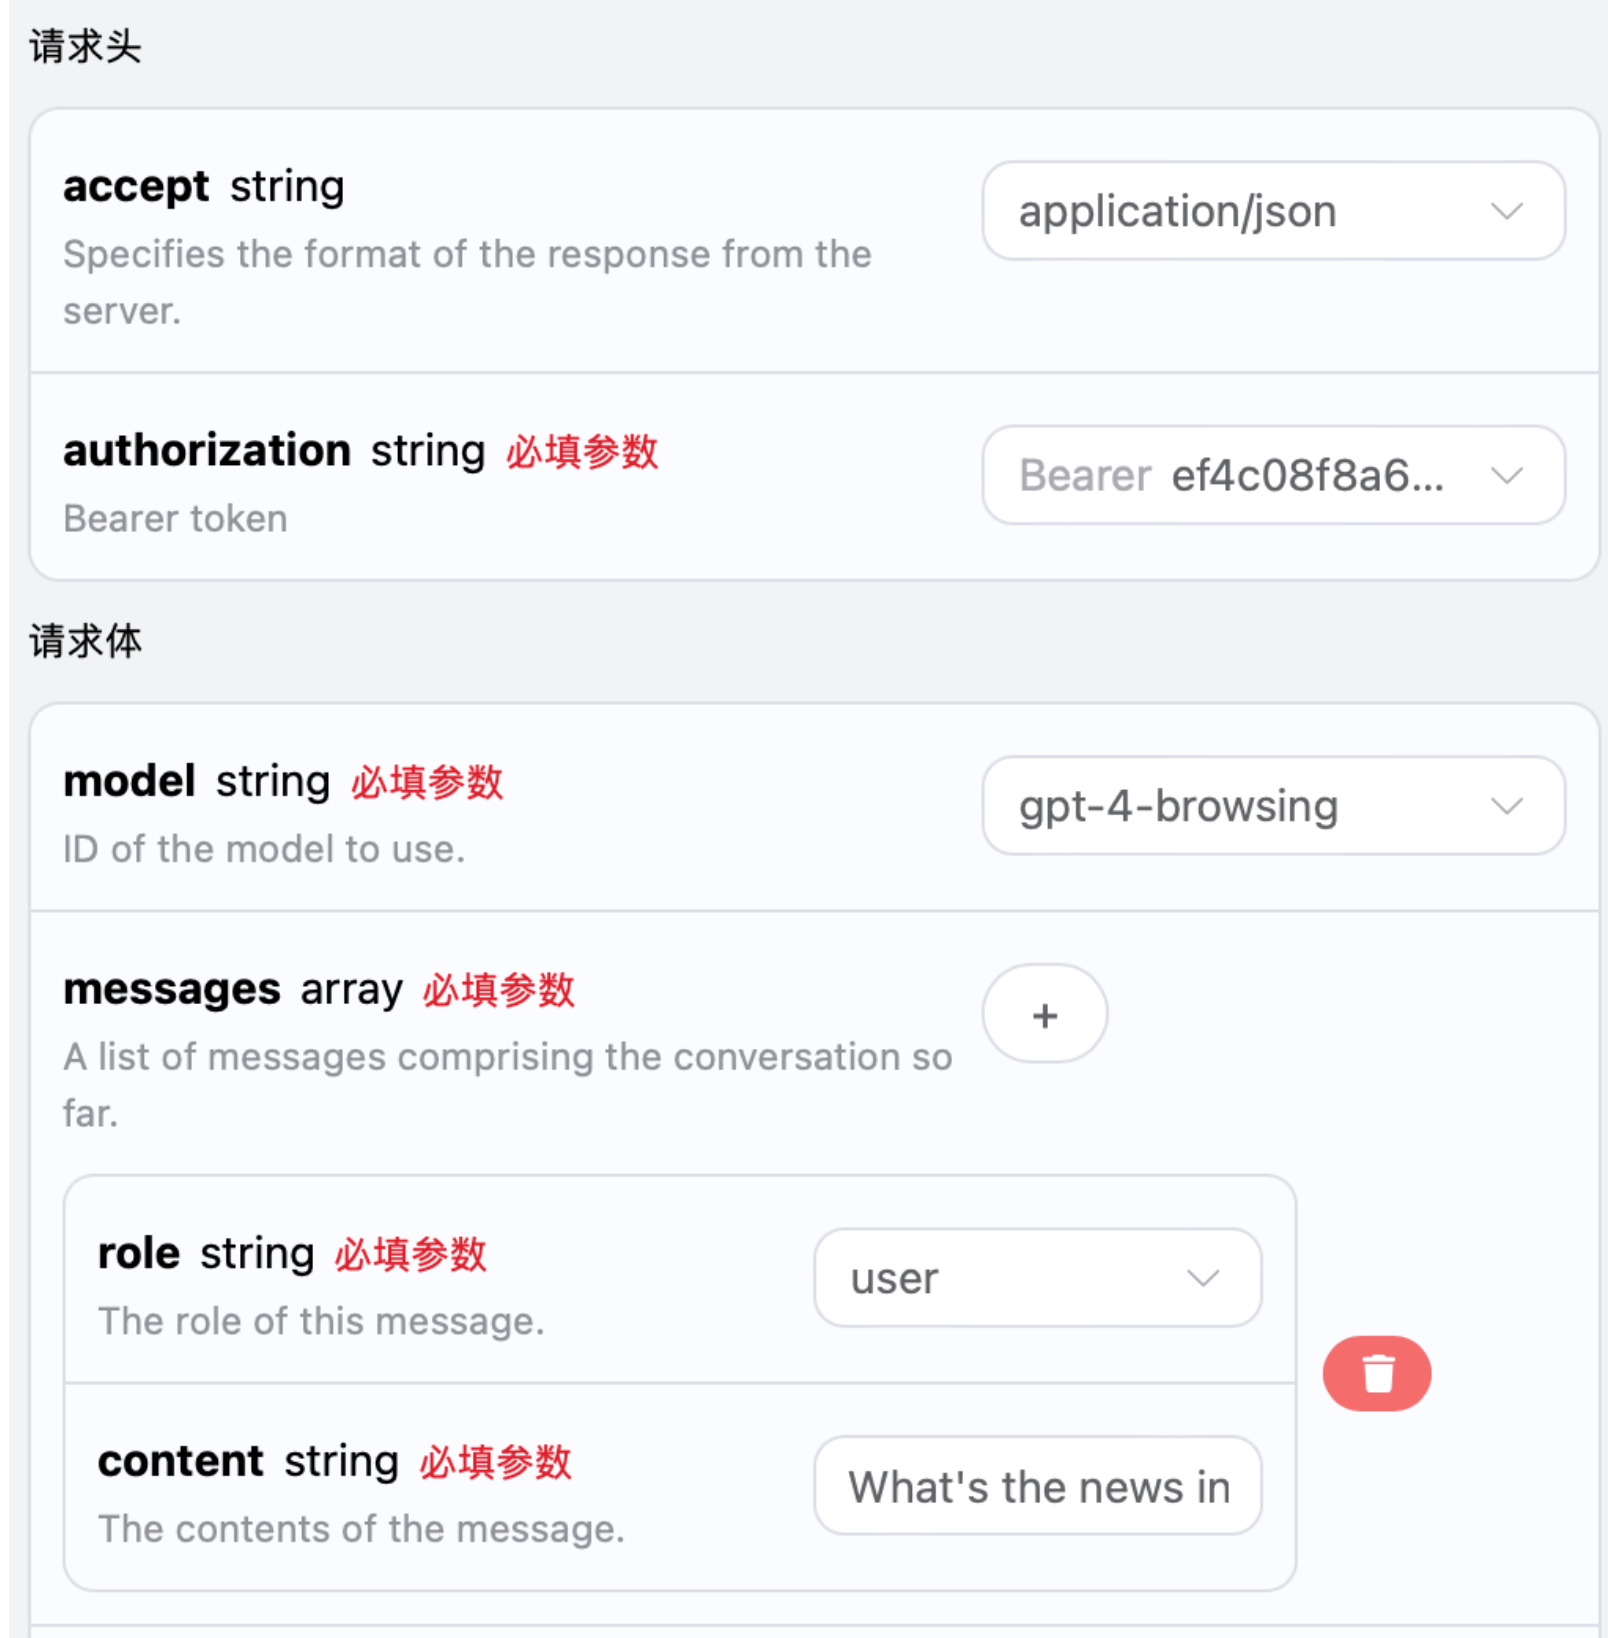
choices erhålls efter en internetansluten sökning, och relevanta länkar ges också. Svarsinformationen i choices ska renderas med markdown-syntax för att få den bästa upplevelsen, och detta återspeglar slutligen den kraftfulla fördelen med våra modellers internetfunktion.
Visuell modell
gpt-4o är en multimodal stor språkmodell utvecklad av OpenAI, den har lagt till visuell förståelseförmåga på basis av GPT-4. Denna modell kan samtidigt bearbeta text- och bildindata och uppnå förståelse och generering över flera modaliteter. Textbearbetningen med modellen gpt-4o är densamma som innehållet för grundläggande användning ovan. Nedan kommer vi kortfattat att introducera hur man använder modellens bildbearbetningsförmåga. Bildbearbetningsförmågan hos modellen gpt-4o används främst genom att lägga till etttype-fält på basis av det ursprungliga content-innehållet. Genom detta fält kan man veta om det som laddas upp är text eller en bild, och därmed använda bildbearbetningsförmågan hos modellen gpt-4o. Nedan beskrivs främst hur denna funktion anropas på två sätt: Curl och Python.
- Curl-skriptmetod
- Python-skriptmetod
GPT-4o-bildgenereringsmodell
Generera bilder baserat på en referensbild
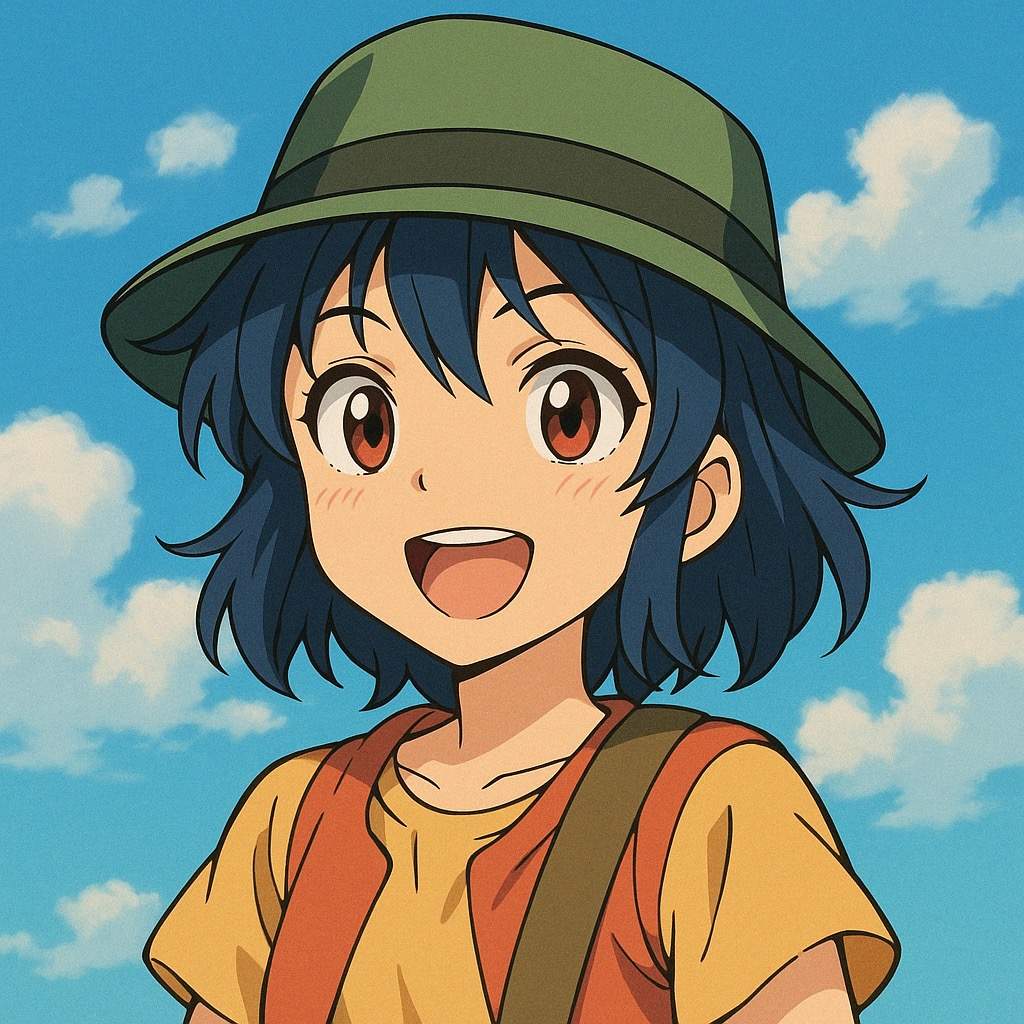
Nedan följer ett exempel på att generera en bild med en anpassad stil baserat på en bild. Låt oss först titta på bilden vi matar in, som visas nedan: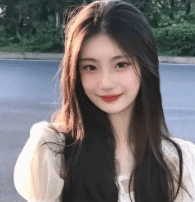 Det kan ses att referensbilden är en bild av en verklig person. Vi kan låta den ändra stil, till exempel göra den till en bild i anime-stil. Det specifika exempelanropet:
message.content i choices det fullständiga genererade dialogresultatet, och bilden inkluderas i Markdown-format (bildlänken är en tillfällig adress, ladda ner och spara den i tid). Det kan ses att den genererade bilden verkligen är i anime-stil, som visas specifikt i bilden nedan:
Generera bilder med enbart text
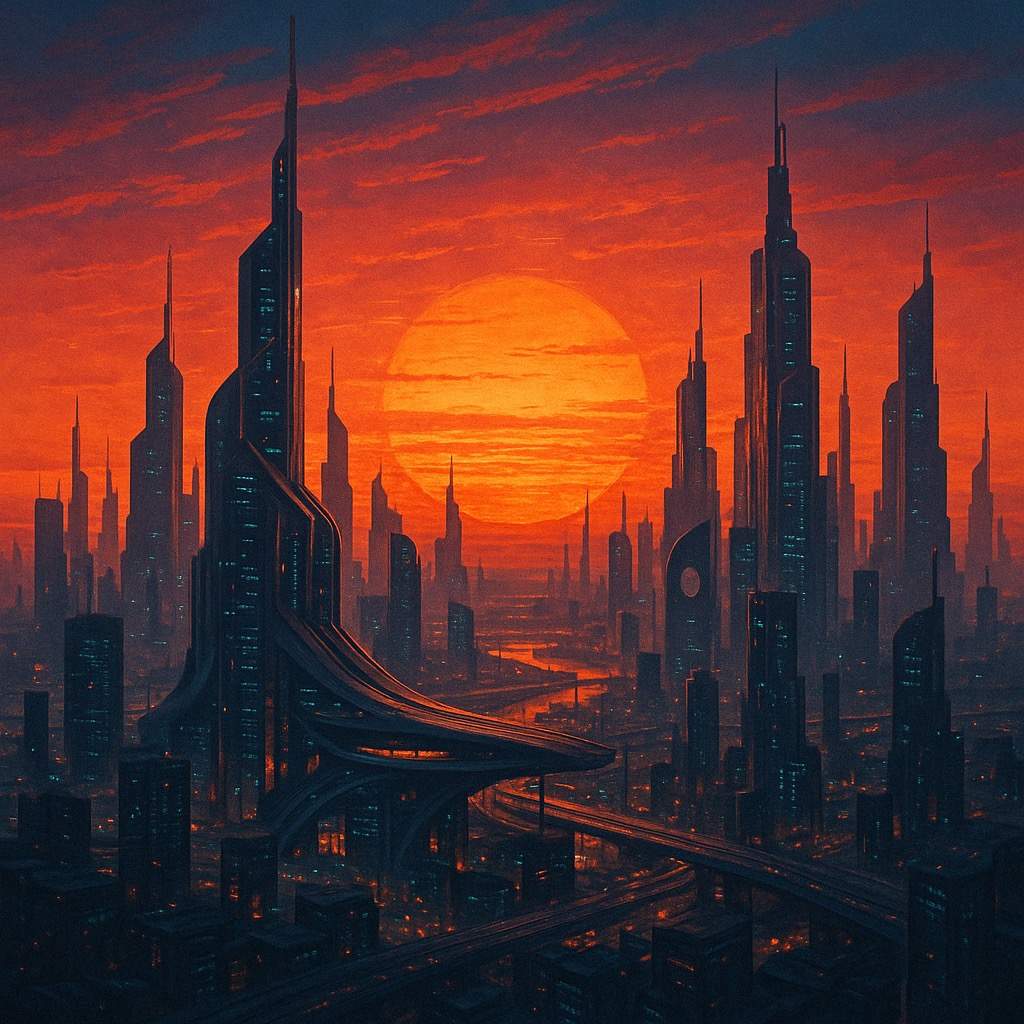
Vi kan använda en prompt för att låta den generera en bild och returnera den till oss i ett dialogbaserat resultat. Nedan använder viSkapa en bild av en framtida stad vid solnedgång som exempel, och det specifika exemplet är följande:
Generera en bild från flera bilder
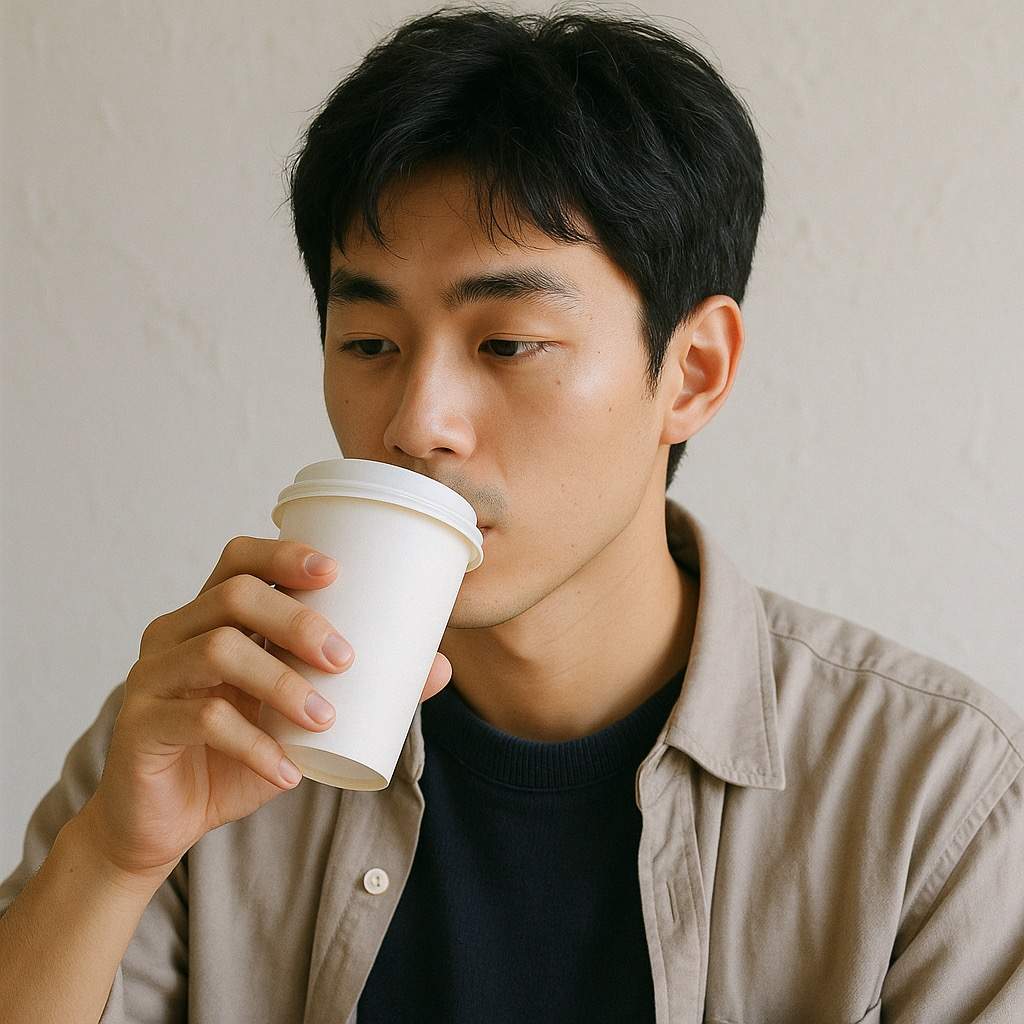
Vi kan också använda flera referensbilder för att generera en bild, till exempel använda en bild på en snygg man och en bild på kaffe. Med hjälp av dessa två bilder kan en bild av en snygg man som dricker kaffe genereras. Nedan följer de specifika referensbilderna: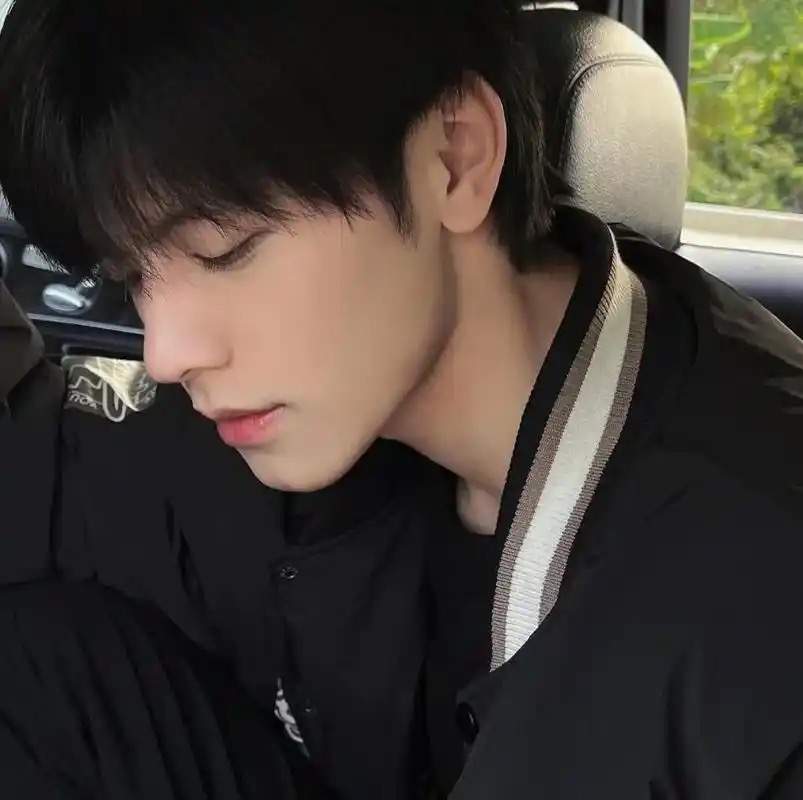
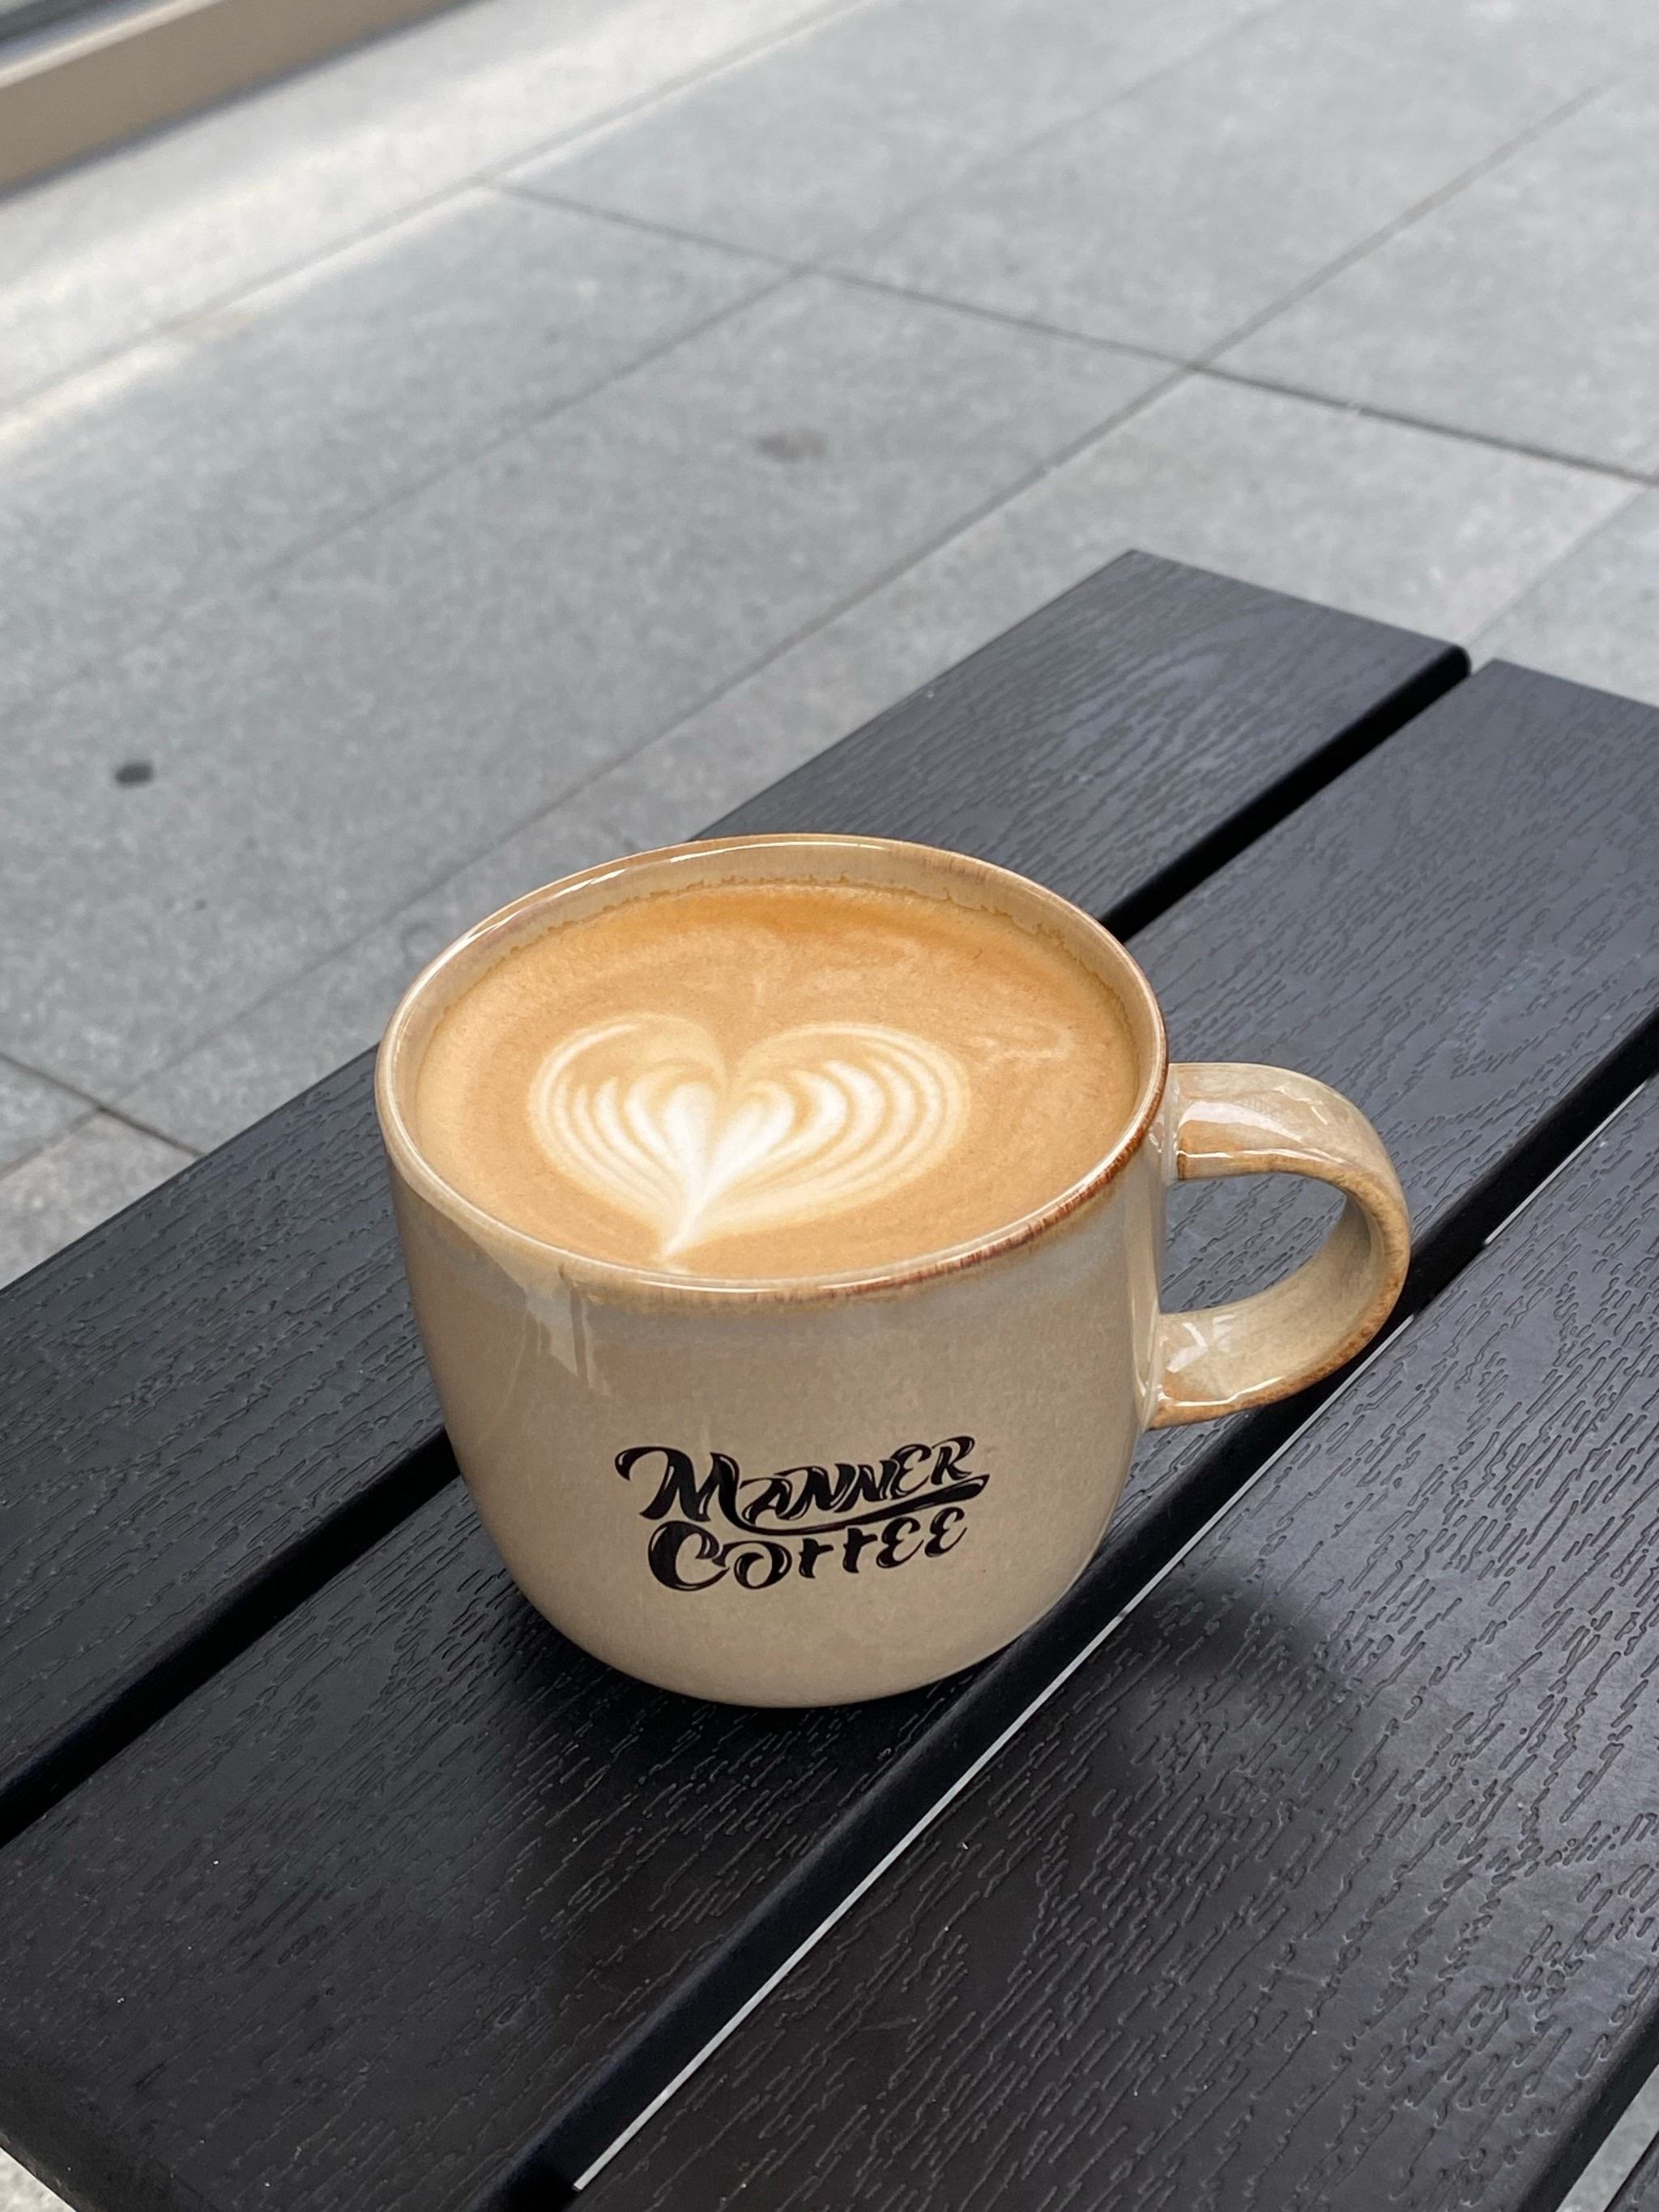
Generera en bild av en man som håller upp kaffe och är på väg att dricka det som exempel, och det specifika exemplet är följande:
Felhantering
När API:et anropas returnerar API:et motsvarande felkoder och information om ett fel uppstår. Till exempel:400 token_mismatched: Felaktig begäran, möjligen på grund av saknade eller ogiltiga parametrar.400 api_not_implemented: Felaktig begäran, möjligen på grund av saknade eller ogiltiga parametrar.401 invalid_token: Obehörig, ogiltig eller saknad auktoriseringstoken.429 too_many_requests: För många begäranden, du har överskridit hastighetsgränsen.500 api_error: Internt serverfel, något gick fel på servern.