

I limitiSuno ora supportalyricestylenella tabella sopra sono i limiti massimi in modalità personalizzata (quandocustomètrue). La modalità di ispirazione non personalizzata (quandocustomèfalse) compila soloprompt, il cui limite di lunghezza è di 500 caratteri (uguale per tutti i modelli).
chirp-v6, chirp-v6-wild e chirp-v6-mini. Si consiglia di utilizzare chirp-v6; i nomi dei vecchi modelli continuano a essere compatibili.
Tuttavia, Suno ufficialmente non fornisce API, AceDataCloud fornisce un set di API di Suno, simulando l’integrazione ufficiale di Suno, per generare in modo comodo e rapido la musica desiderata.
Richiesta e utilizzo
Per utilizzare Suno Audios Generation API, innanzitutto vai alla console Ace Data Cloud per ottenere il tuo API Token, da conservare come riserva. Se non hai ancora effettuato l’accesso o la registrazione, verrai automaticamente reindirizzato alla pagina di accesso per invitarti a registrarti e ad accedere, al termine tornerai automaticamente alla pagina corrente.
Un solo API Token può chiamare tutti i servizi della piattaforma, non è necessario richiederne uno separatamente per ogni servizio. Alla prima richiesta verrà assegnato un credito gratuito, che può essere utilizzato per una prova gratuita; quando il credito è insufficiente, puoi ricaricare il saldo universale nella console.
📘 Documentazione completa: Suno Audios Generation API →
Utilizzo di base
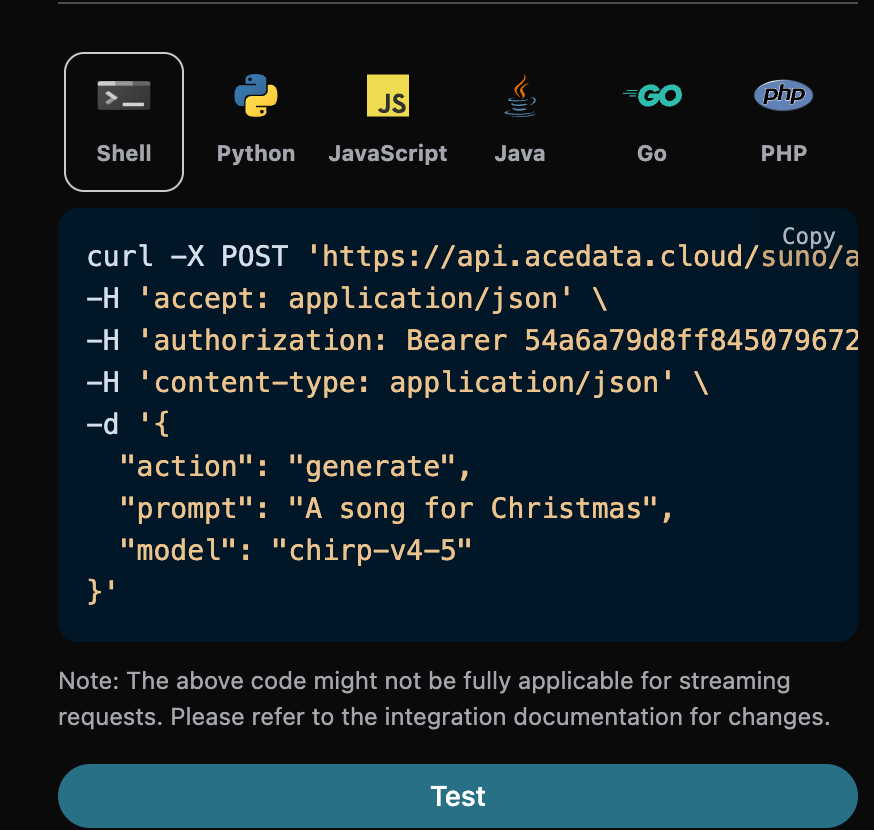
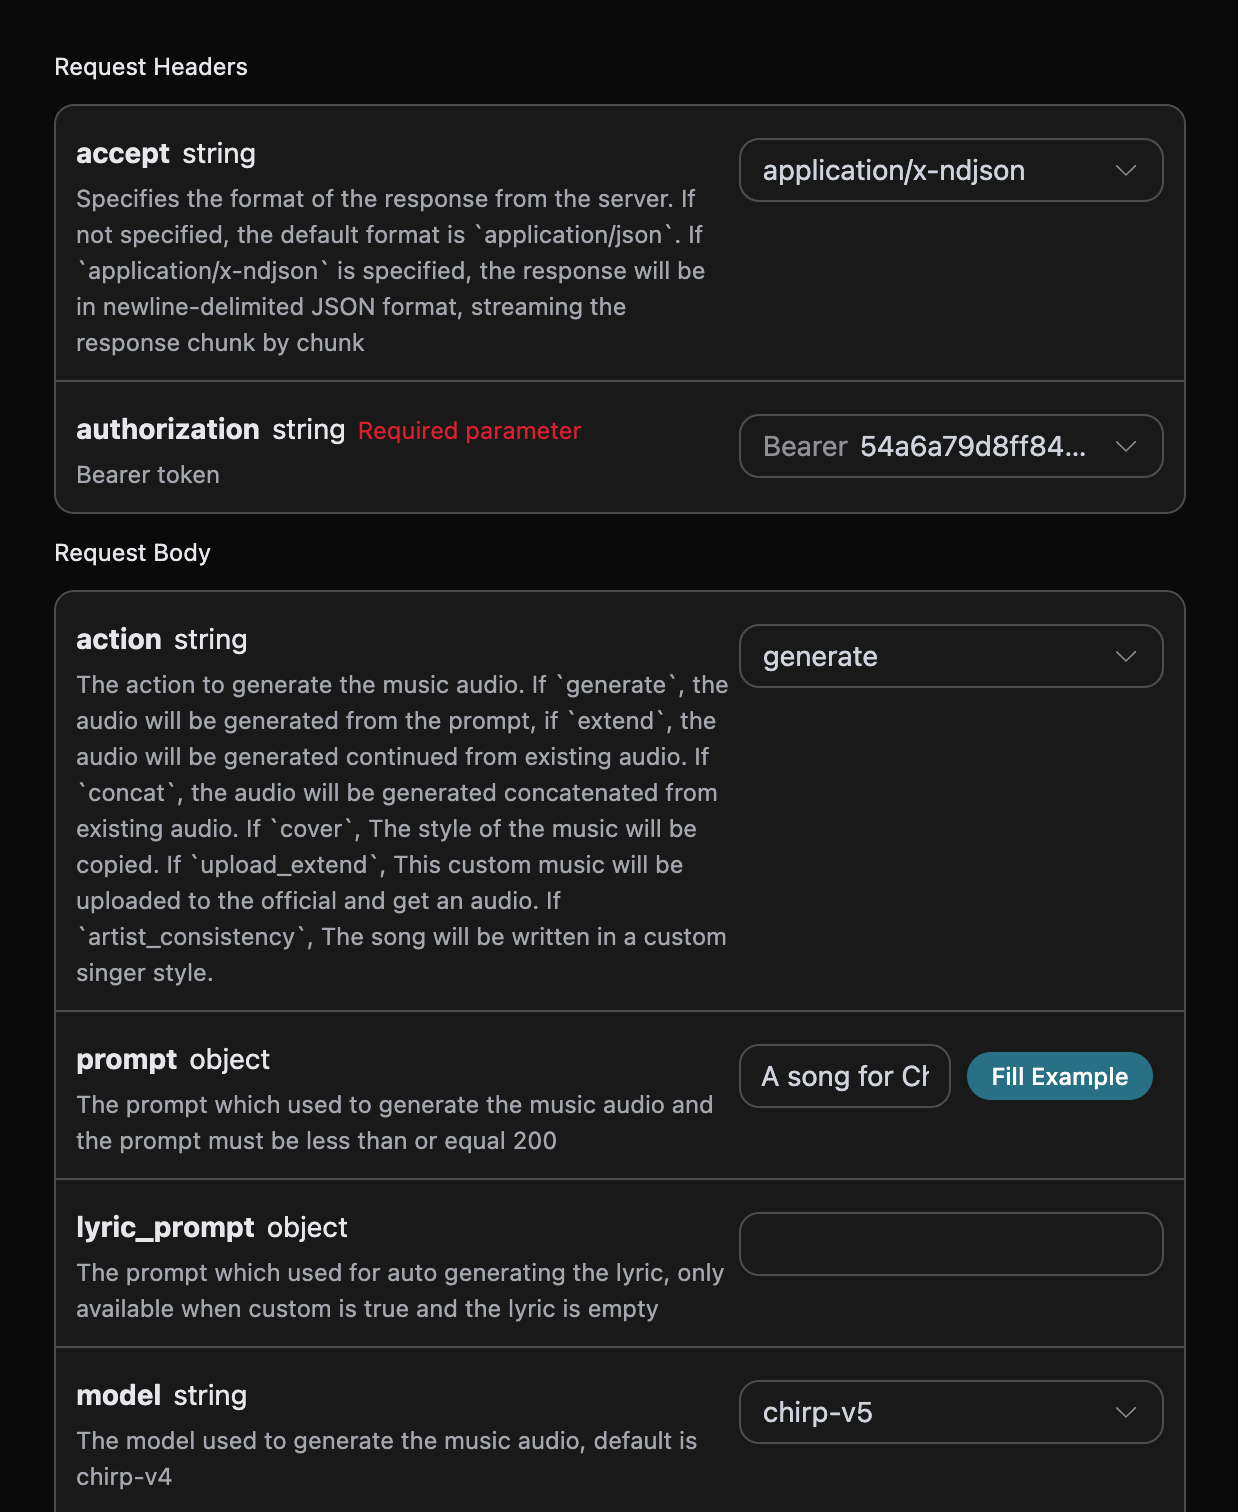
Che tipo di canzoni desideri, puoi inserire arbitrariamente un testo, per esempio se voglio generare una canzone sul Natale, posso inserirea song for Christmas, come mostrato nell’immagine:
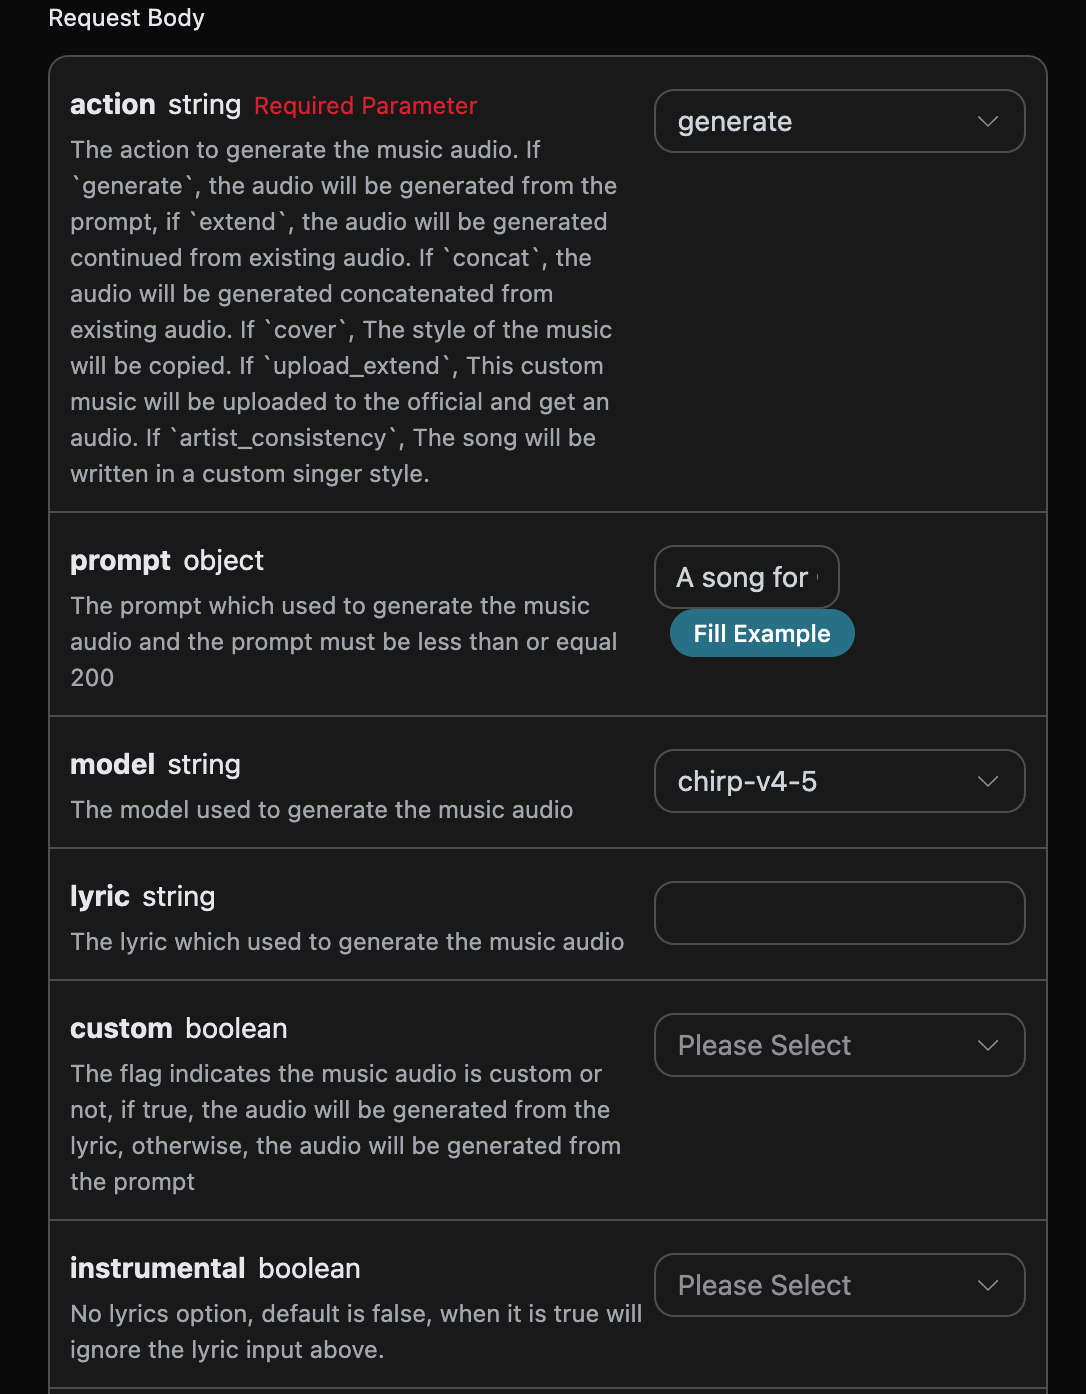
accept: quale formato di risultato della risposta si desidera ricevere, qui viene compilato comeapplication/json, ovvero il formato JSON.authorization: la chiave per chiamare l’API, dopo la richiesta può essere selezionata direttamente dal menu a discesa.
action: tipo di attività audio, il valore predefinito ègenerate. Supporta operazioni come generazione, continuazione, cover, concatenazione, separazione delle tracce, aggiunta di tracce audio, estrazione di tracce audio specificate, generazione di effetti sonori e regolazione della velocità, tutte richiamate in modo unificato tramitePOST /suno/audios.prompt: prompt della modalità ispirazione ufficiale di Suno (efficace quandocustomèfalse), massimo 500 caratteri.model: modello per questa attività di generazione musicale. La serie v6 includechirp-v6,chirp-v6-wildechirp-v6-mini; i nomi dei vecchi modelli restano compatibili.max_mode: modalità di generazione avanzata.generateviene abilitato solo quando siacustomsiamax_modesonotrue, al costo di 1.12 Credits;add_stempuò essere abilitato direttamente, al costo di 1.344 Credits. Quando è disabilitato o omesso, i costi sono rispettivamente 0.56 e 0.672 Credits.variety: intensità della varietà dei risultati generati, opzionale traoff,normal,high,extra,max. Utilizzato solo pergenerateeadd_stem; se passato ad altre action restituisce 400.lyric: contenuto dei testi della modalità personalizzata ufficiale di Suno.chirp-v3-5echirp-v4hanno un massimo di 3000 caratteri;chirp-v4-5e versioni successive (inclusichirp-v5,chirp-v5-5) hanno un massimo di 5000 caratteri.custom: se utilizzare la modalità personalizzata, il valore predefinito è:false.instrumental: opzione di musica strumentale della modalità ispirazione ufficiale di Suno.title: titolo musicale della modalità personalizzata ufficiale di Suno.chirp-v3-5,chirp-v4hanno un massimo di 80 caratteri;chirp-v4-5e versioni successive hanno un massimo di 100 caratteri.style: stile musicale della modalità personalizzata ufficiale di Suno.chirp-v3-5echirp-v4hanno un massimo di 200 caratteri;chirp-v4-5e versioni successive (inclusichirp-v5,chirp-v5-5) hanno un massimo di 1000 caratteri.negative_tags: stili musicali o generi che si desidera escludere dai risultati generati nella modalità personalizzata (customètrue).audio_weight: peso dell’influenza delle caratteristiche audio o vocali, intervallo 0-1, anche0è un valore valido. Può essere utilizzato per operazioni come generazione, continuazione, cover, aggiunta di tracce audio e coerenza vocale; in assenza di audio di riferimento o caratteristiche vocali, il modello potrebbe attenuare o ignorare questo valore.audio_id: ID della musica di riferimento.overpainting_start/overpainting_end: orari di inizio e fine per aggiungere voci a una musica strumentale esistente, in secondi.underpainting_start/underpainting_end: orari di inizio e fine per aggiungere accompagnamento a un canto a cappella, in secondi.persona_id: ID della canzone dell’artista.continue_at: confine della continuazione, in secondi. Ad esempio, 213.5 indica che il frammento successivo viene generato a partire da 3 minuti e 33.5 secondi.lyricestyleguidano solo il nuovo contenuto dopo il confine e non sostituiscono i testi o il canto precedenti al confine nell’audio sorgente.style_influence: influenza dello stile nella modalità personalizzata, intervallo 0-1; maggiore è il valore, maggiore è solitamente l’aderenza allo stile selezionato;0viene trasmesso come valore valido.replace_section_end: orario finale del frammento da sostituire.replace_section_start: orario iniziale del frammento da sostituire.vocal_gender: controlla la preferenza per voce femminile o maschile, voce femminilef, voce maschilem, valido per i modelli 4.5 e superiori; è un’impostazione di preferenza e non ne garantisce il rispetto rigoroso.weirdness: grado di eccentricità nella modalità personalizzata, intervallo 0-1; maggiore è il valore, maggiore è solitamente la creatività e la sperimentazione;0viene trasmesso come valore valido.duration: durata desiderata della canzone, in secondi, deve essere un numero intero, intervallo da 10 a 360. Questo parametro viene utilizzato per la generazione di canzoni in modalità personalizzata (customètrue). È un suggerimento di tendenza piuttosto che un vincolo rigido: il modello lo prenderà come riferimento, ma non ne garantisce il raggiungimento; la durata effettiva del prodotto finale è soggetta al campodurationnella risposta e di solito è inferiore al valore desiderato.
Ambito di applicazione dei parametri avanzati
La piattaforma convalida i tipi dei parametri e gli intervalli numerici, ma non rifiuta questi elementi di regolazione opzionali solo perché l’action è diversa; l’effetto specifico è determinato dall’operazione, dalla modalità e dal modello.
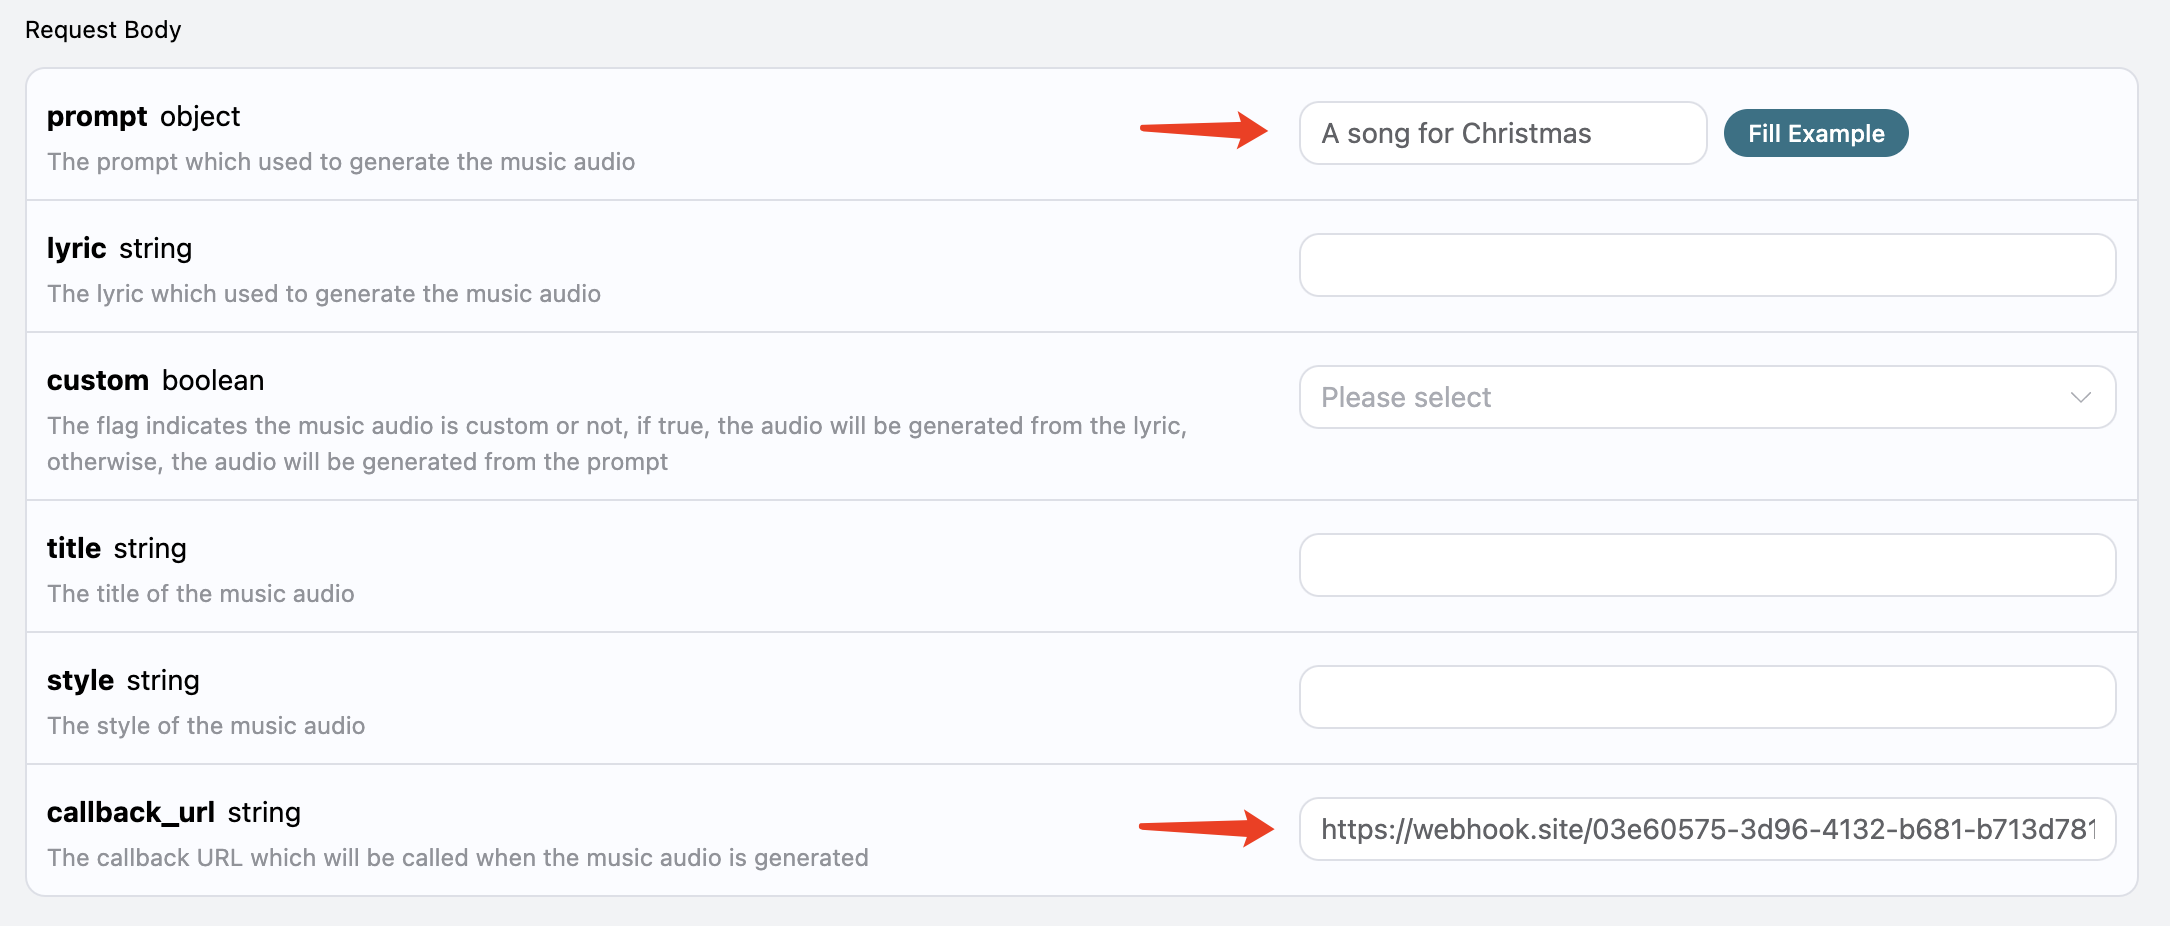
lyric_prompt: prompt per generare i testi, efficace se e solo secustomètrueelyricnon viene passato.callback_url: URL a cui restituire il risultato tramite callback.async: opzionale, quando impostato sutruel’interfaccia restituisce immediatamentetask_id, senza necessità di fornirecallback_url; successivamente il risultato viene ottenuto tramite polling attraverso la corrispondente interfaccia di query dell’attività.
- success: indica se la generazione è riuscita; se riesce è
true, altrimenti èfalse - data: è una lista che contiene le informazioni dettagliate delle canzoni generate.
- state: stato di generazione della canzone, include principalmente quattro tipi, nello specifico:
- succeeded: generazione riuscita
- pending: in coda
- running: in esecuzione
- error: fallita
- id: ID della canzone
- title: titolo della canzone
- image_url: immagine di copertina della canzone
- lyric: testo della canzone
- audio_url: indirizzo audio finale della canzone. La piattaforma restituirà prioritariamente l’indirizzo Ace Data Cloud CDN; se la persistenza fallisce, potrebbe restituire l’indirizzo del media originale, si prega di scaricarlo tempestivamente.
- video_url: file video della canzone, aprendolo si tratta di un video mp4.
- created_at: ora di creazione
- model: modello utilizzato, generalmente l’ultimo modello v3
- style: stile
- state: stato di generazione della canzone, include principalmente quattro tipi, nello specifico:
Generazione personalizzata
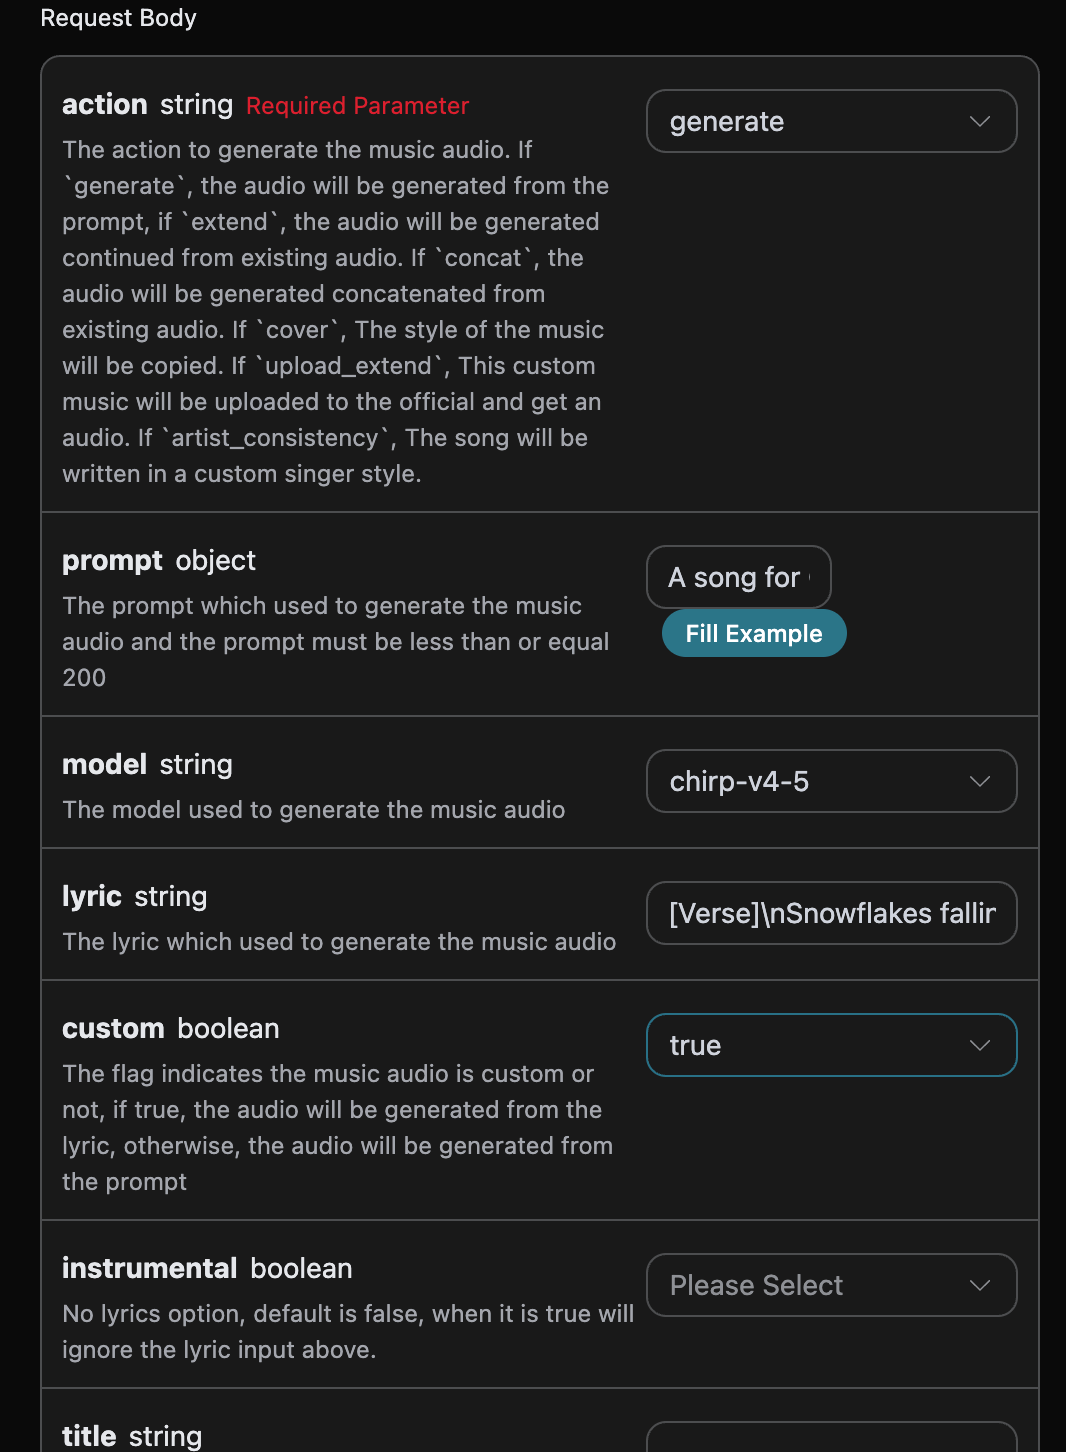
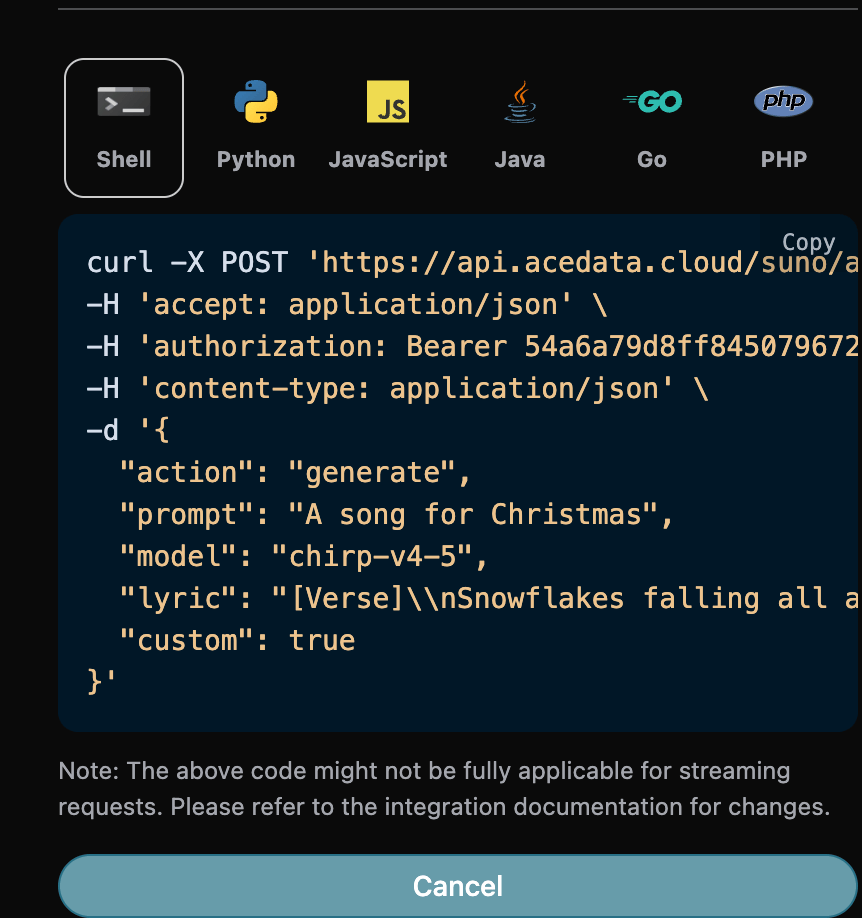
Se si desidera generare un testo personalizzato, è possibile inserire il testo: A questo punto il campolyric può ricevere contenuti simili ai seguenti:
Nota: nel testo qui \n è un carattere di nuova riga. Se non sai come generare il testo, puoi utilizzare l’API di generazione dei testi fornita da AceDataCloud per generare il testo tramite prompt; l’API è Suno Lyrics Generation API.
Successivamente, per generare una canzone personalizzata in base al testo, al titolo e allo stile, è possibile specificare i seguenti contenuti:
- lyric: testo del brano
- custom: impostare su
true, rappresenta la generazione personalizzata; questo parametro èfalseper impostazione predefinita, rappresenta la generazione tramiteprompt. - title: titolo della canzone.
- style: stile della canzone, facoltativo.
Funzionalità di generazione personalizzata dello stile del cantante
Se si desidera utilizzare lo stile di un cantante per generare una canzone, innanzitutto generare una canzone tramite l’utilizzo di base sopra descritto, infine è necessario impostare questa canzone come stile del cantante, quindi è necessario accedere a Suno Persona API per generare un parametro id dello stile del cantantepersona_id in base all’ID della musica generata ufficialmente audio_id; i parametri specifici sono mostrati nella figura seguente:
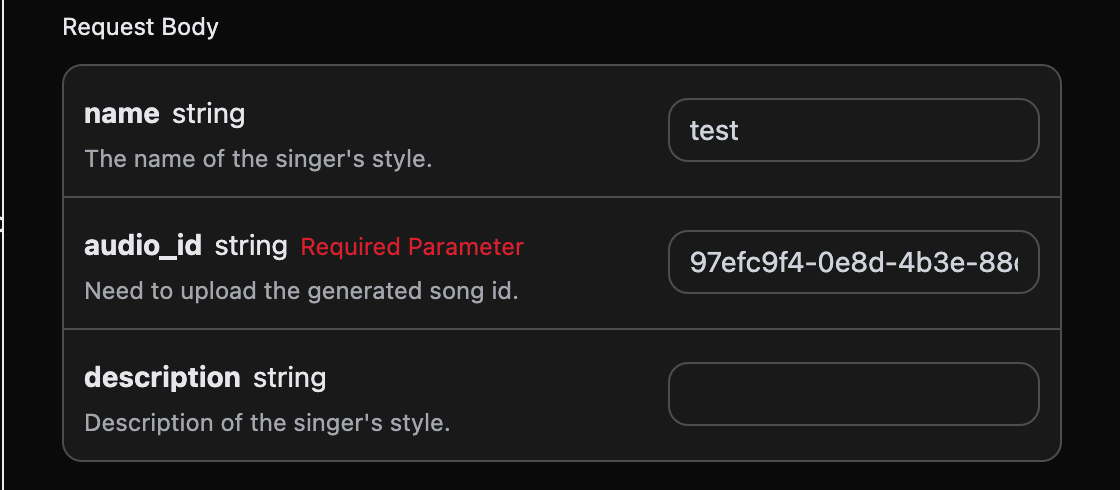
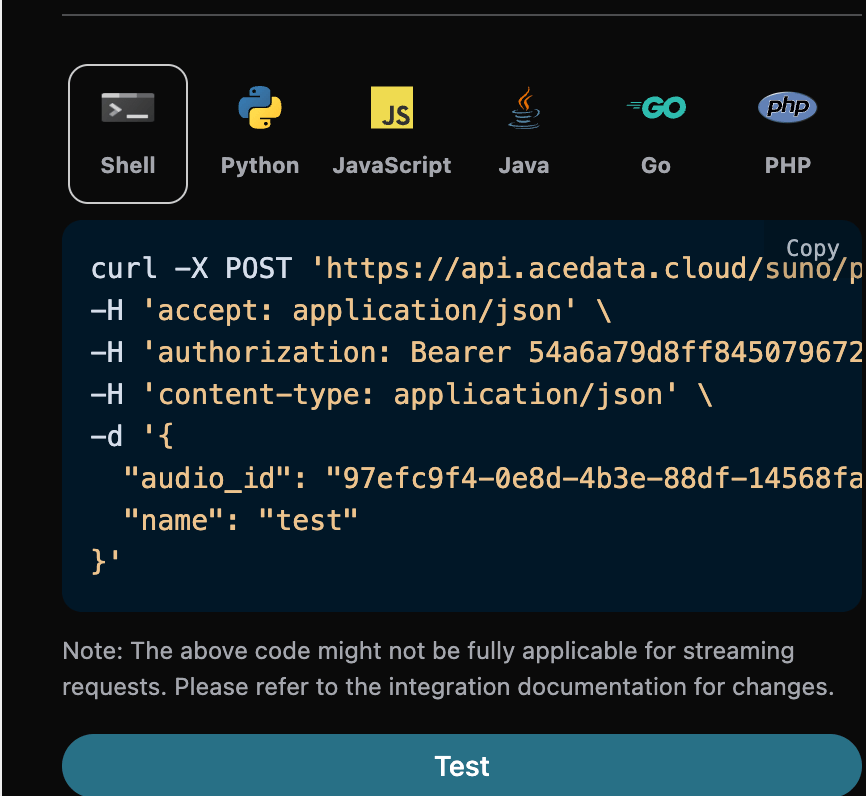
audio_id e il persona_id sopra indicati, ovvero 97efc9f4-0e8d-4b3e-88df-14568fa1b11f e e0d7319e-aa2a-44cb-b00a-916218d7cb0b, come dati di esempio per questa volta. Quindi è possibile impostare il parametro action su artist_consistency (se si utilizza il nuovo stile del cantante Persona-v2-vox, action deve essere impostato su artist_consistency_vox) e inserire l’ID della canzone da continuare a generare e l’ID dello stile del cantante; un esempio di compilazione è il seguente:
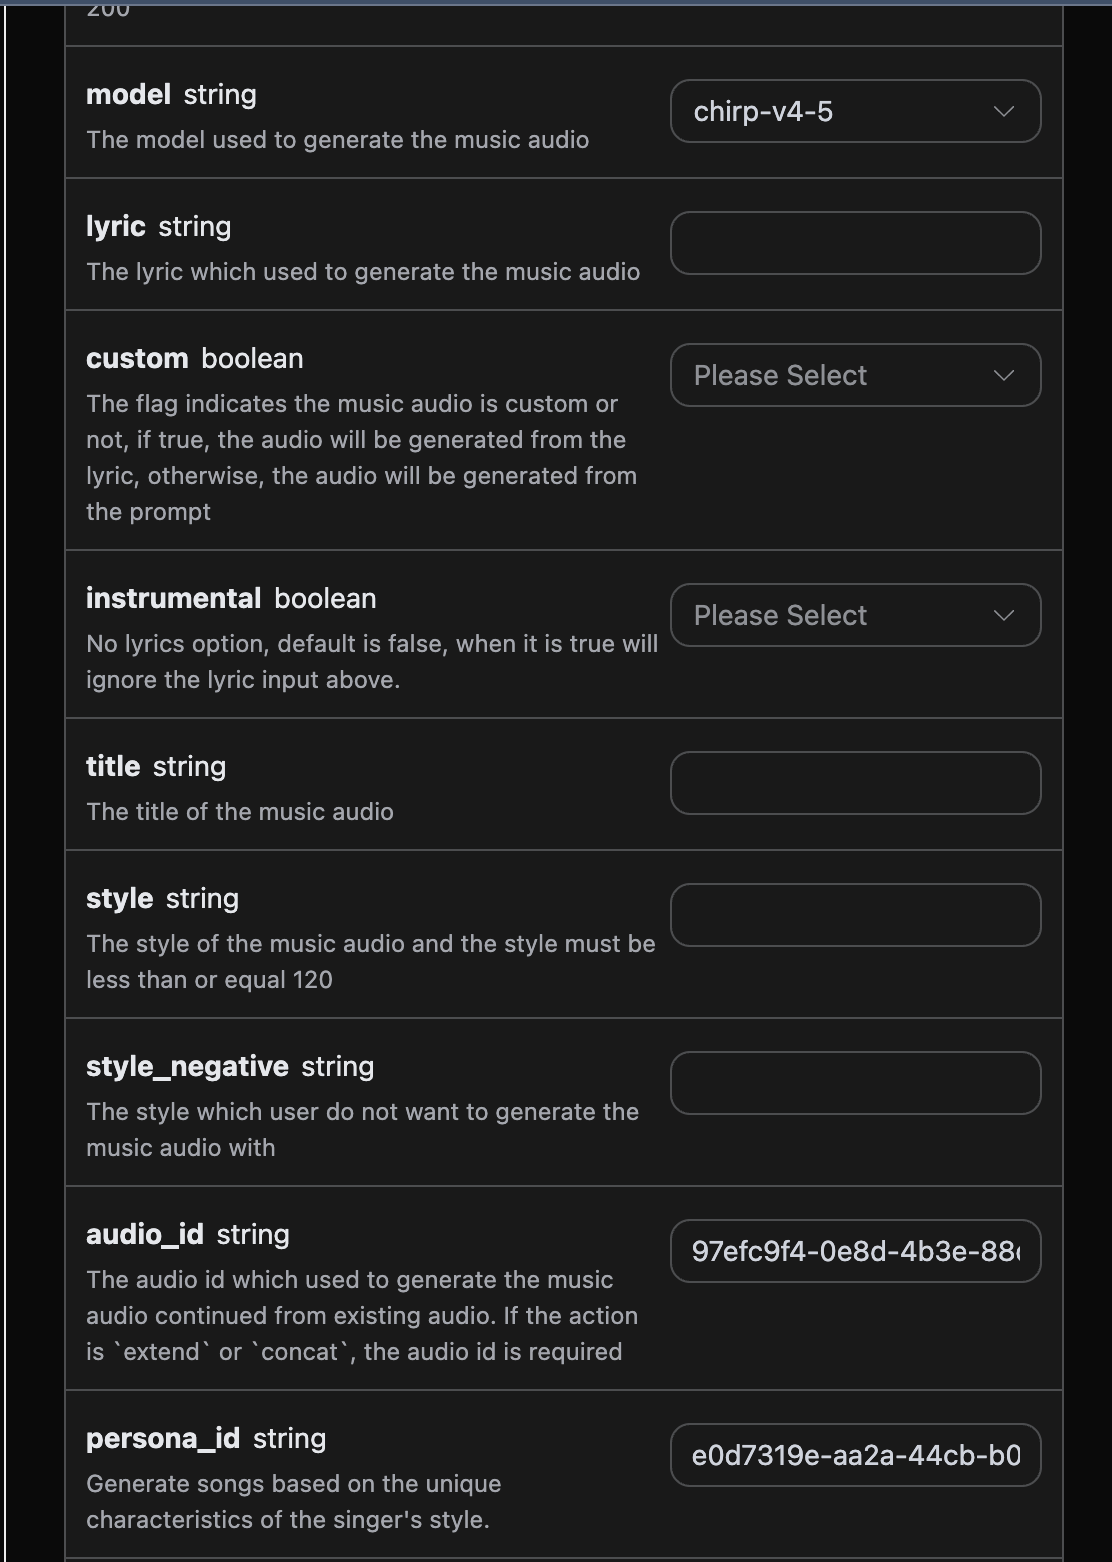
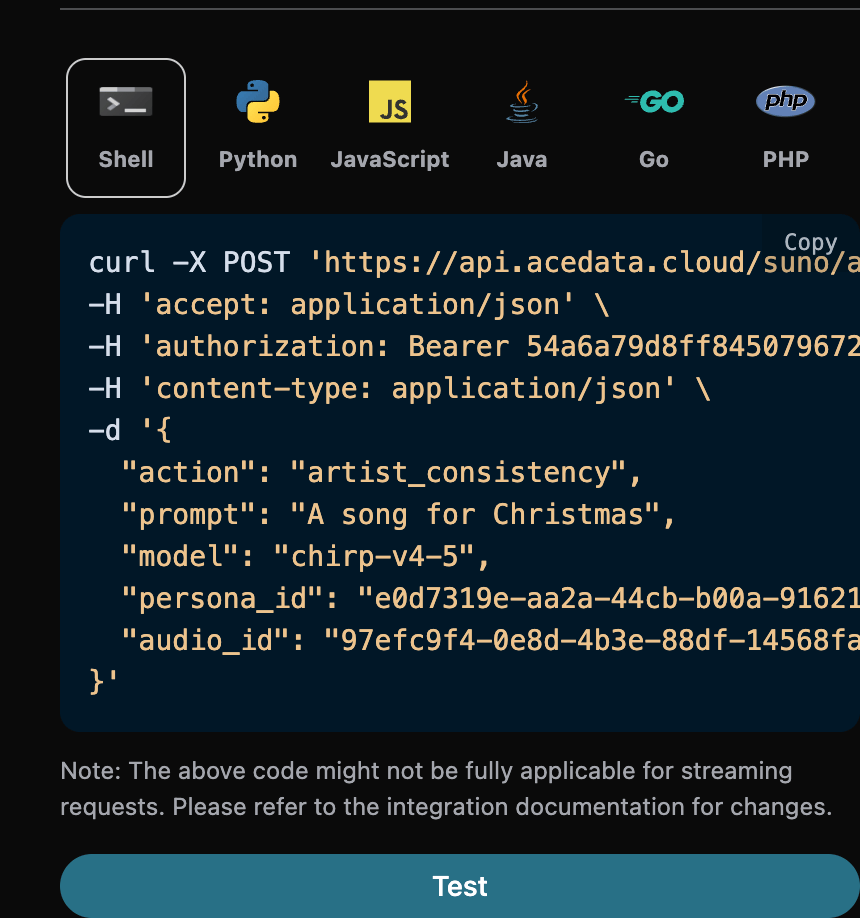
Funzionalità di continuazione della generazione
Se si desidera continuare a generare una canzone Suno già generata, è possibile impostare il parametroaction su extend e inserire l’ID della canzone da continuare a generare. L’ottenimento dell’ID della canzone avviene tramite l’utilizzo di base; da quanto sopra si può sapere che in questo momento l’ID della canzone è:
Nota: qui l’id nel testo della canzone è l’ID della canzone dopo la generazione. Se non sai come generare una canzone, puoi fare riferimento all’utilizzo di base sopra descritto per generare una canzone.
Se si desidera continuare a generare una canzone caricata autonomamente, è possibile impostare il parametro action su upload_extend e inserire l’ID della canzone caricata personalizzata da continuare a generare. L’ottenimento dell’ID della canzone avviene tramite Suno Upload Generation API, come mostrato nella figura seguente:
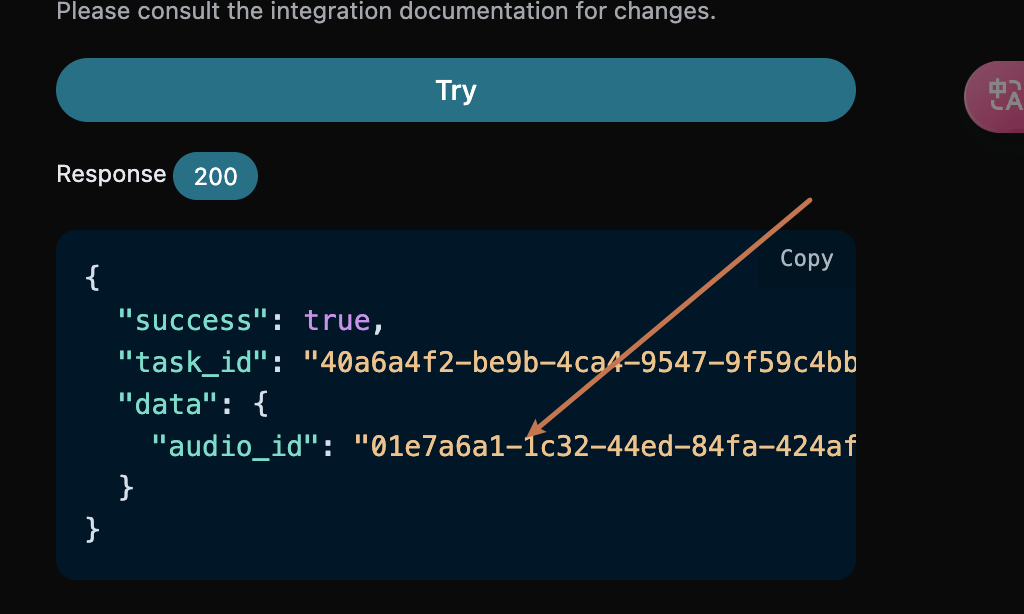
- lyric: utilizzato solo per guidare il testo del segmento appena generato dopo
continue_at, non sostituirà il testo prima di questo punto temporale nell’audio sorgente. - custom: impostare su
truerappresenta la generazione personalizzata; il valore predefinito di questo parametro è false, che rappresenta la generazione tramiteprompt. - style: lo stile della canzone del segmento di continuazione, facoltativo.
- continue_at: il confine della continuazione, in secondi. Ad esempio, 213.5 indica la generazione del segmento successivo a partire da 3 minuti e 33,5 secondi.
Un esempio di compilazione è il seguente:extendviene utilizzato per continuare a creare dopo una canzone esistente, non per cambiare il testo dell’intera canzone. Se si desidera utilizzare un nuovo testo dall’inizio per l’intera canzone, utilizzaregenerateper rigenerarla; se si desidera reinterpretare una canzone esistente come riferimento, è possibile utilizzarecover. Quando si passa un intero nuovo testo, il testo originale prima dicontinue_atnon verrà comunque sostituito.
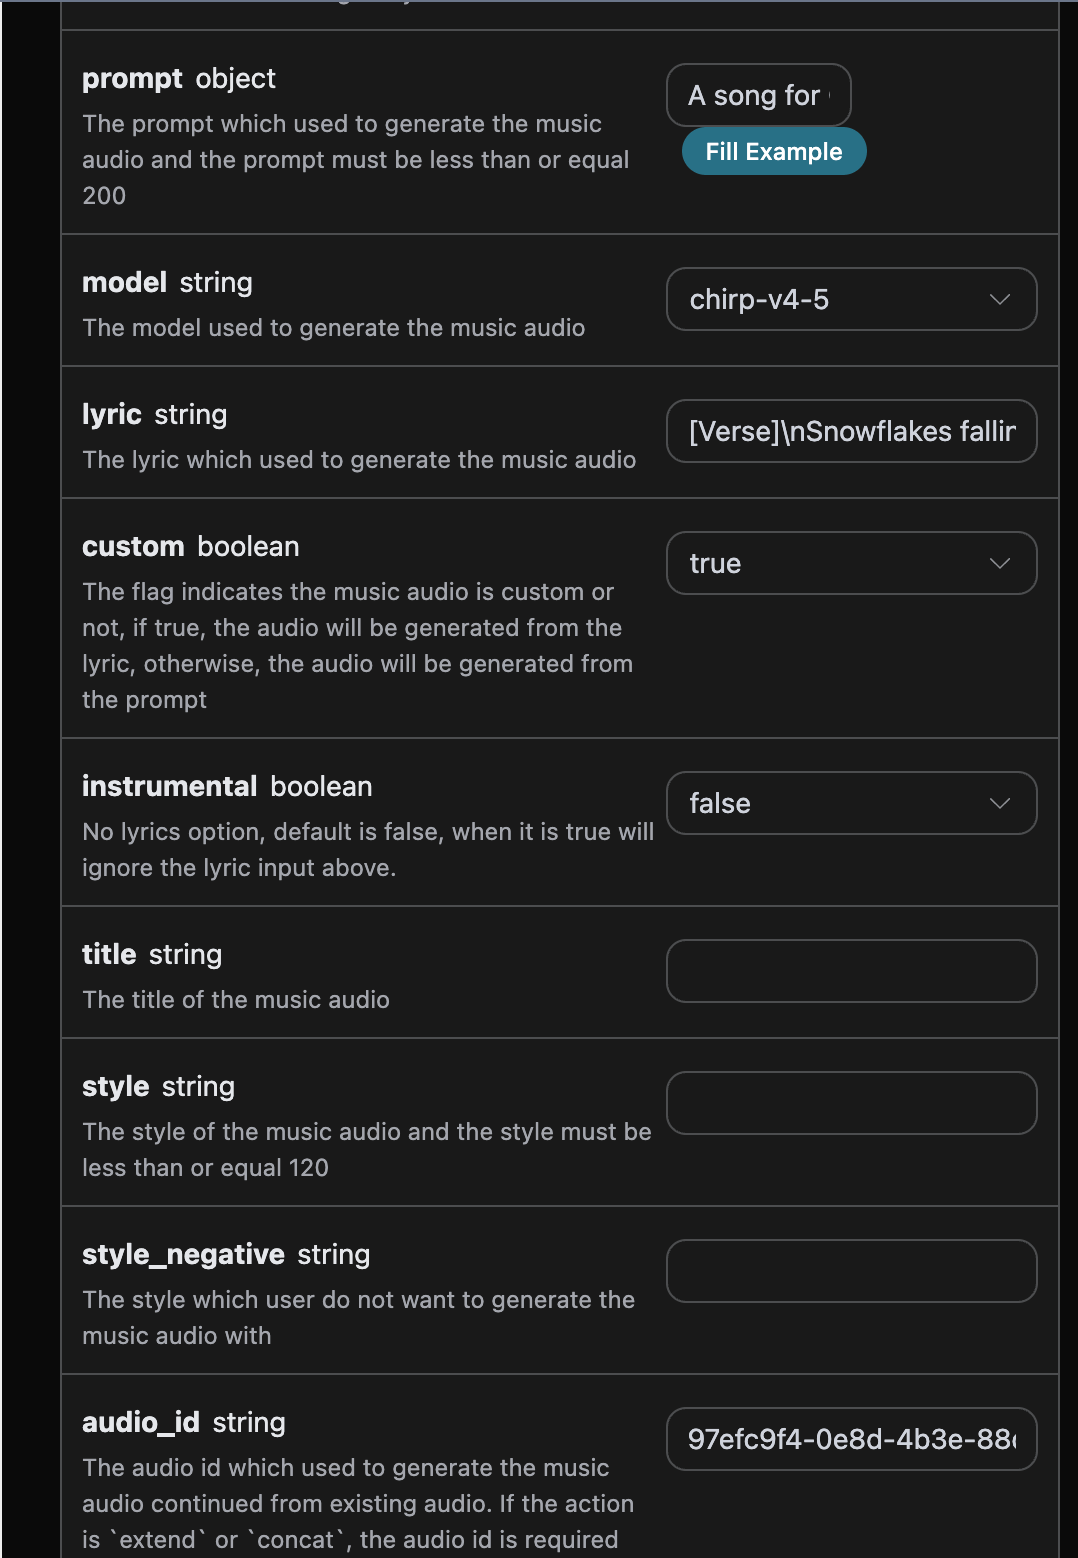
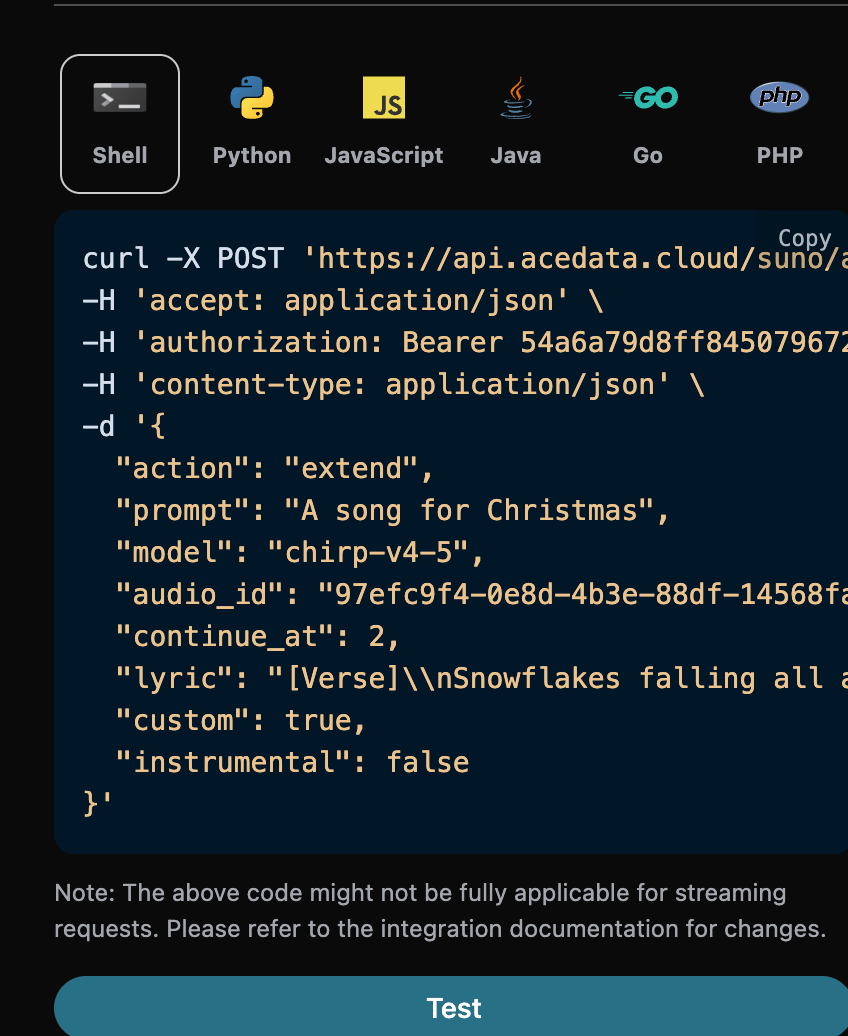
continue_at è 2 secondi; pertanto, solo i primi 2 secondi appartengono al contenuto originale prima del confine di continuazione. Quando si continua effettivamente vicino alla fine del brano, questo valore deve essere impostato sui secondi in cui si desidera iniziare la continuazione e in lyric deve essere fornita solo la nuova sezione da cantare dopo il confine.
Il codice Python corrispondente:
lyric nel risultato restituisce il testo utilizzato per questa attività di continuazione. Questo campo non è una trascrizione parola per parola dell’audio finale completo; per extend, l’audio sorgente precedente a continue_at utilizza ancora il testo originale, mentre il nuovo testo viene usato solo per guidare il segmento di continuazione.
Ottenere il brano completo
Il risultato diextend del modello corrente di solito include già l’audio sorgente prima di continue_at e il nuovo contenuto dopo il confine; verificare prima, in base alla durata effettiva e al contenuto dell’audio restituito, se si tratta già del brano completo. Se viene restituito un segmento di continuazione indipendente, oppure se è necessario unire esplicitamente la cronologia di più continuazioni in un brano, utilizzare quindi la funzione di concatenazione:
- action: il contenuto è
concat. - audio_id: l’ID dell’ultimo segmento di continuazione.
Cover musicale
Dopo aver continuato a generare una canzone sulla base della canzone originale, lo stile della canzone restituita potrebbe non essere molto adatto. Se si desidera eseguire un cover della canzone generata in precedenza (sono supportate anche le musiche caricate personalizzate), è necessario utilizzare il metodo di cover musicale, con cui è possibile specificare i seguenti contenuti:- action: il contenuto è
cover; quando si esegue un’operazione di cover su musica caricata personalizzata, il contenuto deve essere specificato come:upload_cover. - audio_id: l’ID della canzone generata in precedenza.
Sostituzione di segmenti
Quando, dopo aver generato una canzone, è necessaria una creazione secondaria con un’operazione separata di sostituzione di un segmento della canzone, è possibile eseguire un’operazione di sostituzione su un determinato segmento della canzone.⚠️ Nota:I parametri sono descritti come segue:replace_section_result_modeè impostato per impostazione predefinita sufull_song: il sistema concatena rispettivamente 2 nuovi candidati generati e restituisce 2 canzoni complete. Se sono necessari solo i candidati dei segmenti sostituiti non ancora concatenati, impostarlo esplicitamente sucandidates, quindi selezionare un candidato e chiamare Concatenazione musicale.
- action: il contenuto è
replace_section. - audio_id: l’ID della canzone originale (la canzone sorgente da sostituire).
- model: modello di generazione della canzone.
- lyric: il testo completo dopo la sostituzione (incluso il segmento sostituito e il suo contesto, coerente con il contenuto in
prompt). - prompt: il nuovo testo di quella sezione da sostituire.
- style: lo stile della canzone, facoltativo.
- replace_section_start: il momento di inizio del segmento sostituito nella canzone originale (secondi).
- replace_section_end: il momento di fine del segmento sostituito nella canzone originale (secondi).
- replace_section_result_mode: modalità di restituzione, il valore predefinito è
full_song.full_songconcatena rispettivamente 2 candidati e restituisce 2 canzoni complete;candidatesrestituisce 2 segmenti candidati non ancora concatenati.
Passaggio uno: avviare l’attività di sostituzione del segmento
Ad esempio, se l’ID della canzone generata in precedenza è: 18db7ed0-2b8a-41db-91c1-b0781dcca0d4 (durata 94,12 secondi), e si desidera sostituire il ritornello dal secondo 30 al secondo 60 con un nuovo testo, allora è possibile impostare i parametri come segue:replace_section_result_mode viene impostato su candidates, vengono restituiti 2 frammenti di sostituzione non ancora uniti, con una struttura coerente con l’esempio seguente:
candidates, le durate delle due tracce audio restituite (45,16 secondi e 33,8 secondi) sono molto più brevi della canzone originale (94,12 secondi); sono frammenti di sostituzione contenenti una piccola quantità di contesto e non sono la canzone completa. Puoi selezionare il candidato desiderato e continuare a unirlo manualmente. La modalità predefinita full_song, invece, completerà due unioni e restituirà direttamente 2 canzoni complete.
Restituire direttamente canzoni complete
Se desideri ottenere direttamente canzoni complete, nel primo passaggio puoi impostarereplace_section_result_mode su full_song. L’interfaccia unirà separatamente i due candidati e restituirà 2 canzoni complete; in questo caso non è necessario chiamare nuovamente concat.
Passaggio due: unire il frammento di sostituzione alla canzone originale
Per il frammento selezionato sopra (ad esempio364f9d8b-ca25-463b-9a5e-d0b7139e2d6a), avvia un’attività concat secondo il metodo descritto nella sezione Unione musicale:
duration è tornato alla lunghezza completa della canzone (105,28 secondi, approssimativamente uguale alla lunghezza della canzone originale), e ciò a cui punta audio_url è l’intera canzone dopo il completamento della sostituzione. Questo completa il processo di creazione secondaria “generazione → sostituzione del frammento → unione dell’intera canzone”.
Separazione voce-musica
Quando, dopo aver generato una canzone, è necessario effettuare una creazione secondaria con operazioni separate su accompagnamento e voce, è possibile separare l’accompagnamento musicale puro e la voce a cappella. È quindi possibile specificare i seguenti contenuti:- action: il contenuto è
stems. - audio_id: l’ID della canzone generata in precedenza.
Separazione voce-musica di tutte le tracce
Quando, dopo aver generato una canzone, è necessario eseguire l’operazione di separazione voce-musica di tutte le tracce, è possibile specificare i seguenti contenuti:- action: il contenuto è
all_stems. - audio_id: l’ID della canzone generata in precedenza.
Aggiungere una traccia audio
add_stem genera una traccia dello strumento o del suono di destinazione per l’audio specificato, tramite chiamata POST /suno/audios.
- Obbligatori:
action,audio_id,stem_type. - Facoltativi:
model,prompt,title,style,negative_tags,weirdness,style_influence,audio_weight,max_mode,variety. - Fatturazione: modalità normale 0.672 Credits; 1.344 Credits quando
max_modeètrue.
Estrarre una traccia audio
extract_stem estrae la traccia audio di destinazione dall’audio specificato, restituendo contemporaneamente la versione complementare dopo la rimozione di tale traccia, tramite chiamata POST /suno/audios.
- Obbligatori:
action,audio_id,stem_type. - Facoltativo:
audio_format, l’attuale contratto pubblico a doppio canale supporta solomp3. - Fatturazione: 1.12 Credits.
data mantiene un elenco audio piatto, mentre stem_sets indica la relazione tra la traccia audio di destinazione e la traccia audio complementare:
Generare effetti sonori
sounds genera effetti sonori una tantum o ripetibili in base a una descrizione testuale, tramite chiamata POST /suno/audios.
- Obbligatori:
action,sound,sound_type. - Facoltativi:
model,bpm,key,audio_format;audio_formatattualmente supporta solomp3. sound_type:one-shotoppureloop.- Fatturazione: 0.112 Credits.
Regolare la velocità dell’audio
adjust_speed regola la velocità di riproduzione dell’audio specificato, tramite la chiamata POST /suno/audios.
- Obbligatori:
action,audio_id,speed_multiplier,title. - Facoltativo:
keep_pitch. speed_multiplier: intervallo 0.25–4.- Costo: 0.28 Credits.
Parametri avanzati della generazione personalizzata
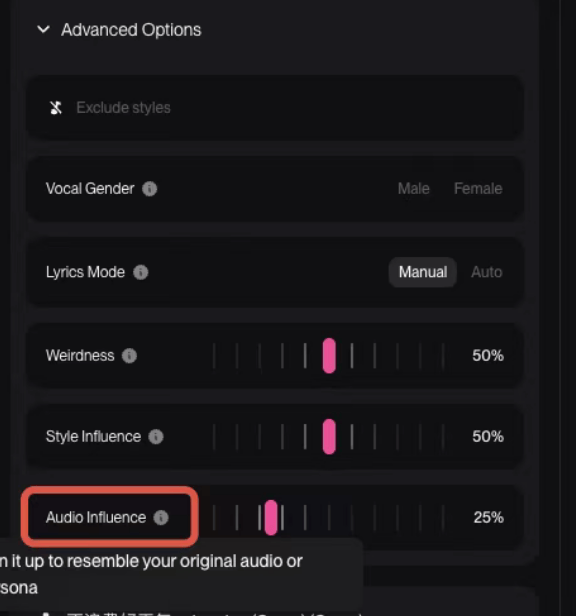
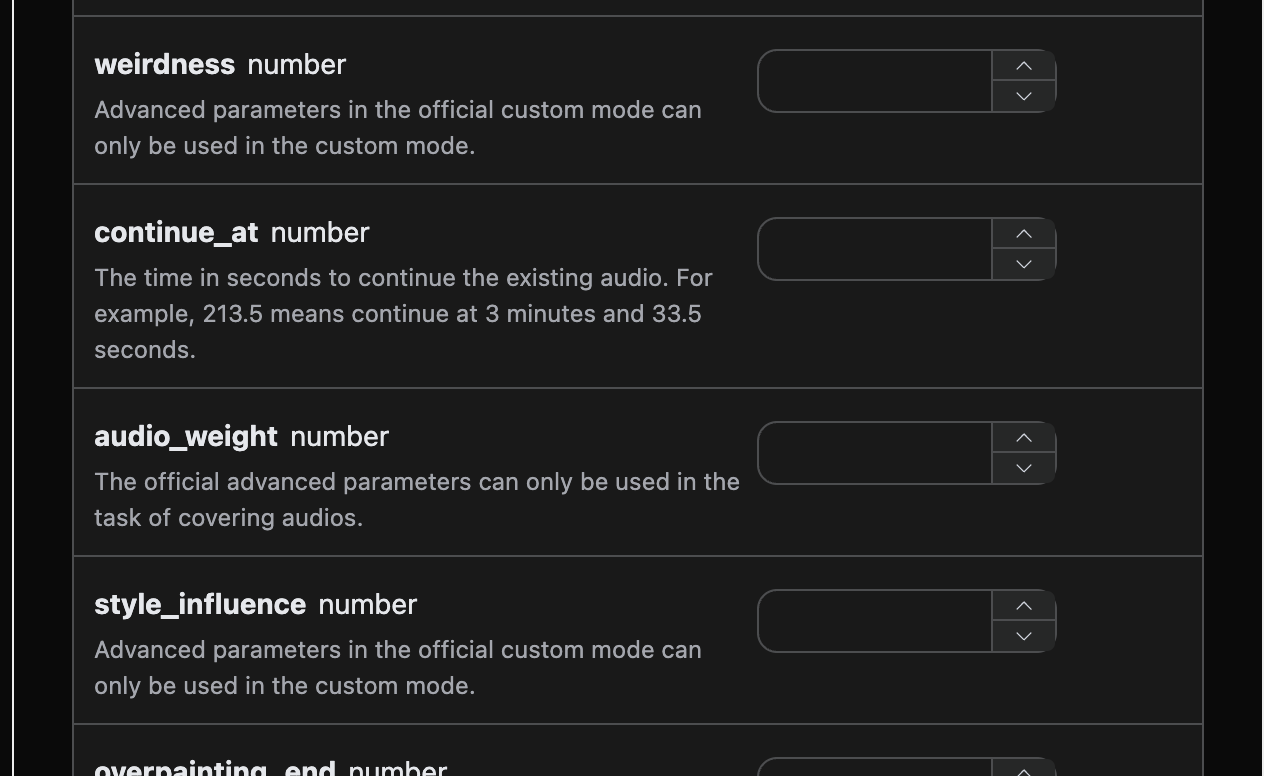
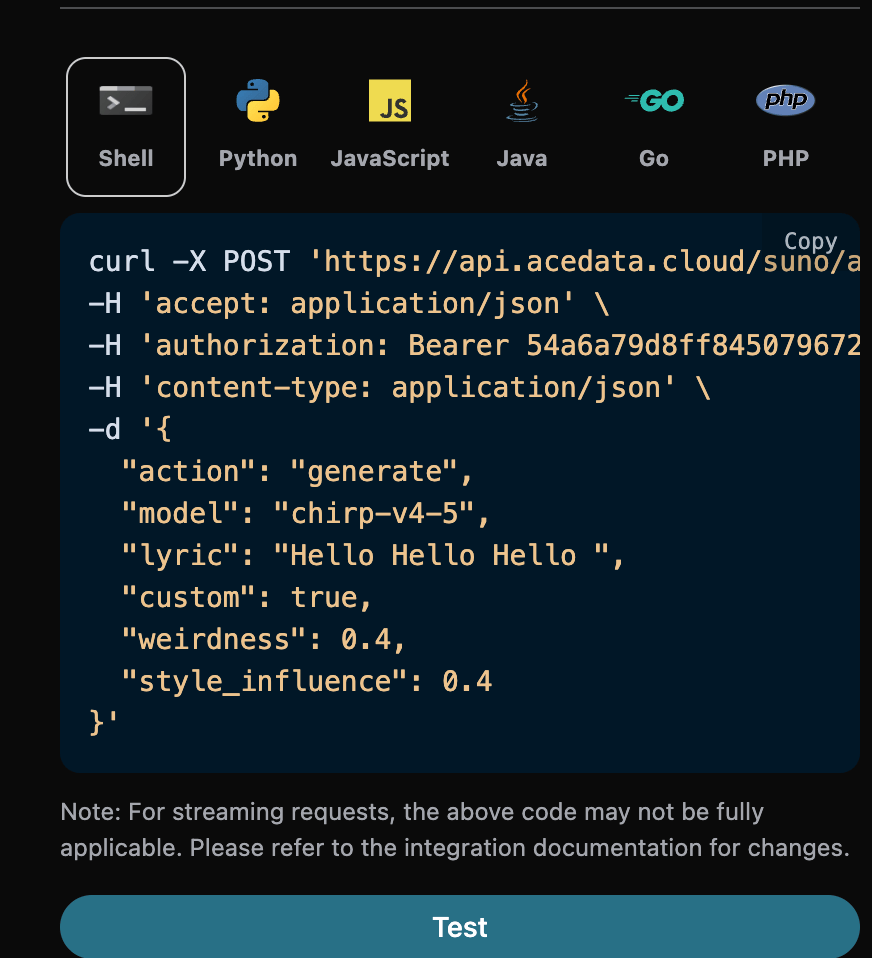
L’ufficiale consente di utilizzare nella modalità personalizzata i parametri avanzatiweirdness==>Weirdness, style_influence==>Style Influence, audio_weight==>Audio Influence per la generazione, corrispondenti ai seguenti esempi ufficiali:
Controllare la durata del brano
Per impostazione predefinita, la durata dei brani generati è determinata dal modello stesso, solitamente tra 30 secondi e 4 minuti. Se è necessario un prodotto finito più lungo o più corto, è possibile specificare la durata desiderata tramite il parametroduration, l’unità è il secondo e il valore è un intero compreso tra 10 e 360.
Questo parametro viene utilizzato per la generazione di brani in modalità personalizzata (custom è true). Va sottolineato che duration è un suggerimento di tendenza, non un vincolo rigido: il modello farà riferimento a questo valore durante la creazione, ma non ne garantisce il raggiungimento; nei test la durata effettiva è solitamente significativamente inferiore al valore previsto e anche le durate dei due brani restituiti dalla stessa richiesta possono differire di più volte. Anche per richieste completamente identiche, le durate ottenute da invii multipli possono presentare differenze notevoli. Pertanto, non utilizzarlo come controllo preciso della durata; se è necessaria una durata fissa a livello di business, ritagliare autonomamente il risultato finale o riprovare dopo averlo ottenuto.
Il corrispondente codice Python:
duration nella richiesta è la durata prevista, mentre il campo duration di ciascuna canzone nella data della risposta è la durata effettiva di quella canzone. I due hanno lo stesso nome ma significati diversi; non è garantito che la durata effettiva sia uguale al valore previsto. La lunghezza del testo è uno dei principali fattori che influenzano la durata del prodotto finale; se è necessario un prodotto finale più lungo, si consiglia di fornire contemporaneamente un testo più completo.
L’interfaccia verificherà che duration sia un numero intero compreso tra 10 e 360; rimane comunque solo un obiettivo di generazione e non una garanzia sulla durata del prodotto finale.
Funzionalità Add Insterumental
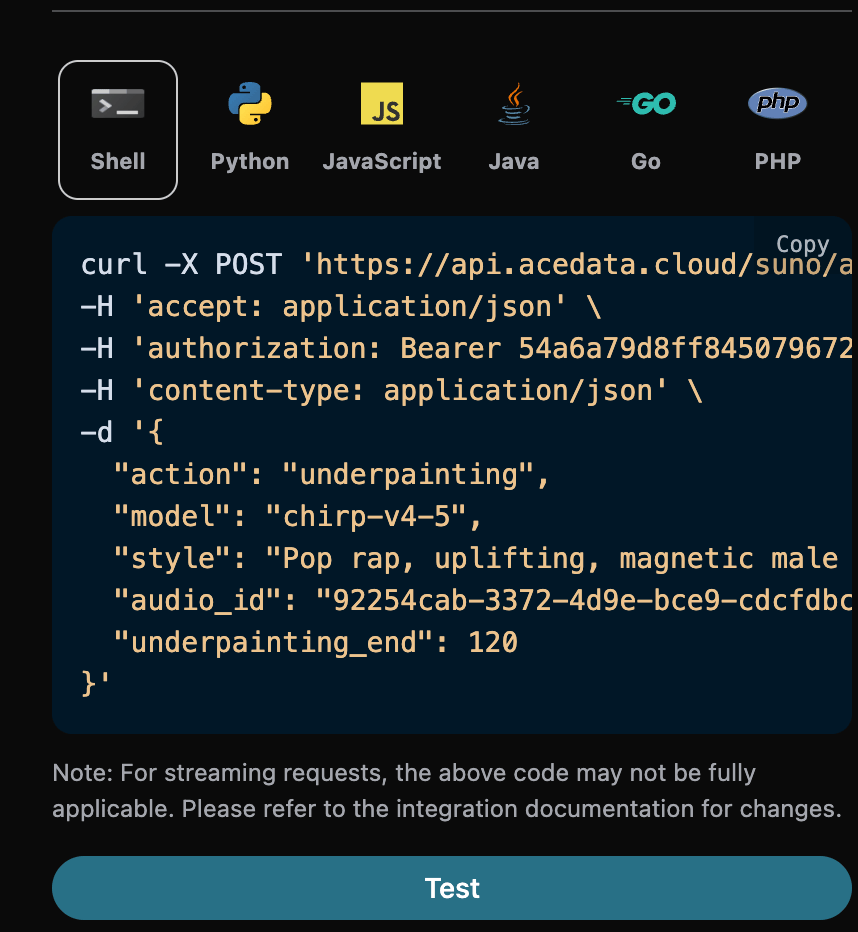
Nell’agosto 2025 Suno ha introdotto la funzionalità Add Insterumental. Innanzitutto è necessario caricare una canzone a cappella senza accompagnamento, affinché Suno possa aggiungere la musica. Per prima cosa è possibile caricare una canzone a cappella senza accompagnamento tramite Suno Upload API; l’operazione corrispondente è mostrata nella figura seguente: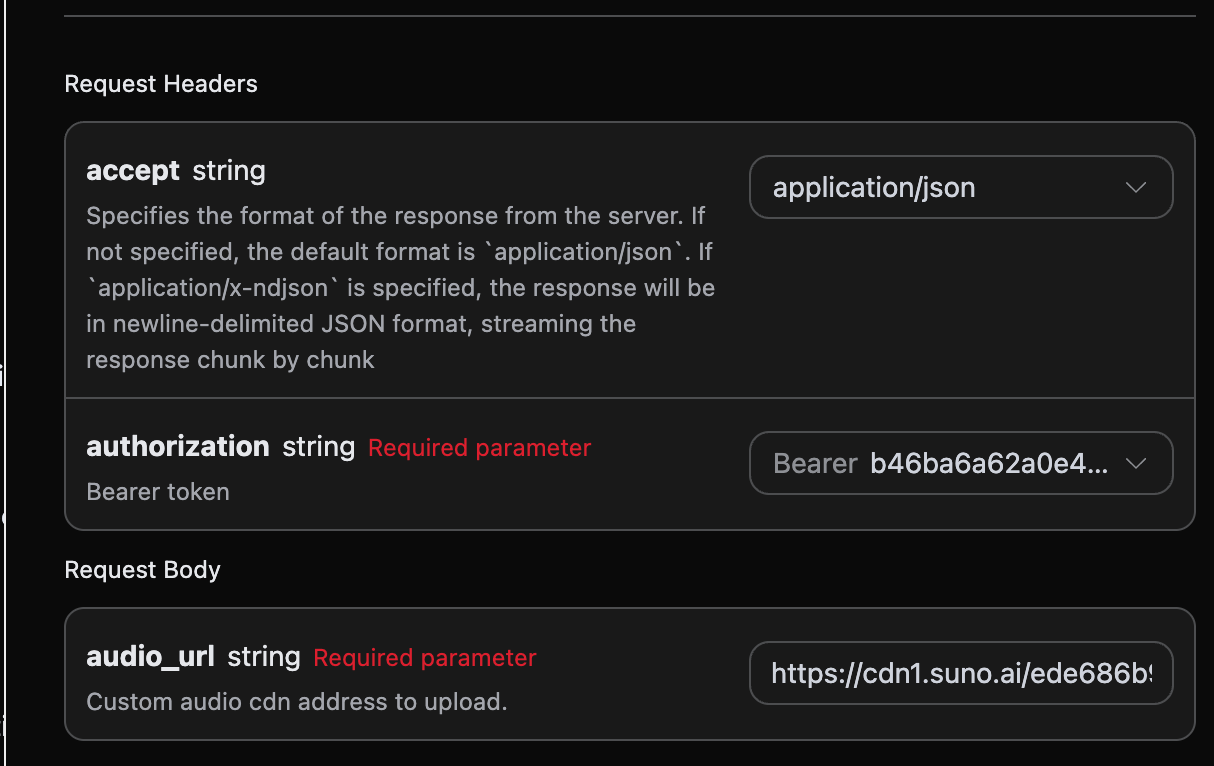
audio_id dopo il caricamento; il risultato specifico è mostrato nella figura seguente:
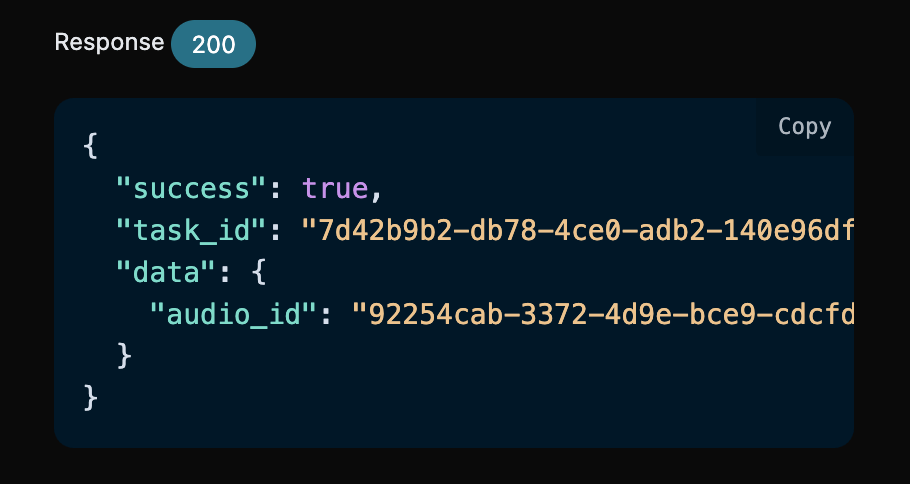
audio_id: 92254cab-3372-4d9e-bce9-cdcfdbc39070, quindi è necessario compilare anche i seguenti parametri:
- action: il contenuto è
underpainting. - underpainting_start: l’ora di inizio per aggiungere l’accompagnamento alla canzone caricata; il valore predefinito è 0.
- underpainting_end: l’ora di fine per aggiungere l’accompagnamento alla canzone caricata; deve essere inferiore alla durata totale della canzone.
- audio_id: l’ID della canzone a cappella senza accompagnamento caricata.
- style: lo stile dell’accompagnamento; è meglio non usare testo, dato che si tratta di un accompagnamento.
Funzionalità Add Vocals
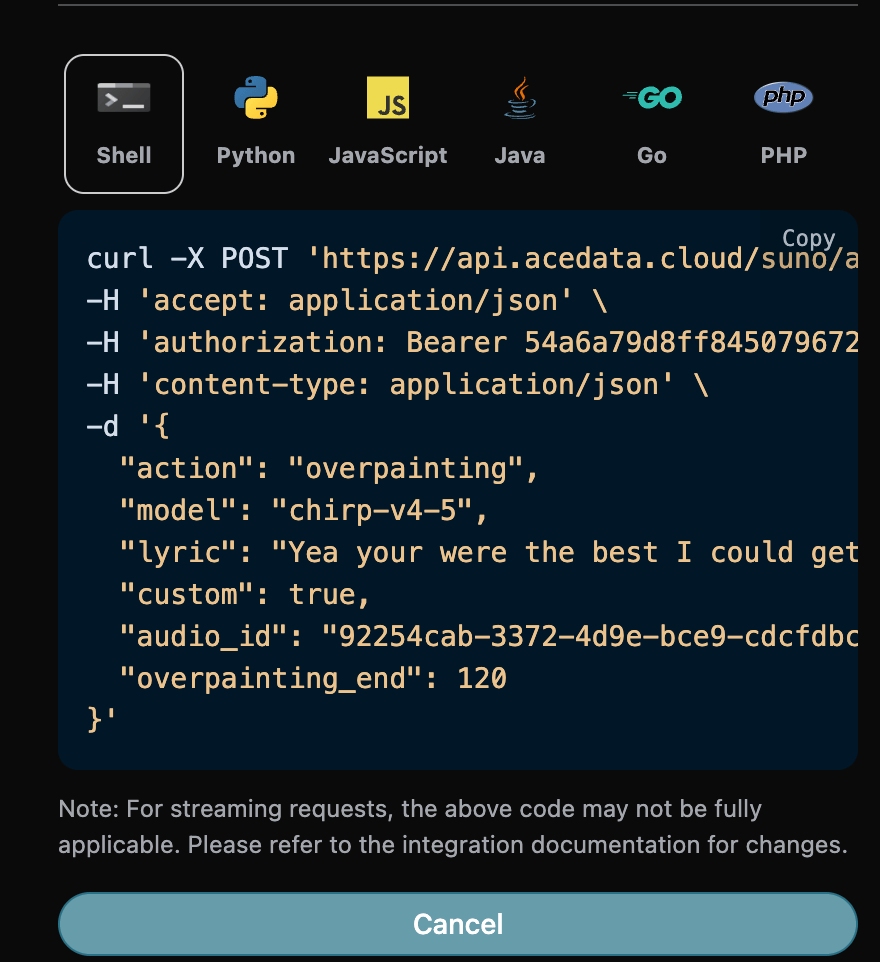
Nell’agosto 2025 Suno ha introdotto la funzionalità Add Vocals. Innanzitutto è necessario caricare un brano puramente strumentale, affinché Suno possa scrivere il testo e generare il canto vocale. Per prima cosa è possibile caricare una canzone a cappella senza accompagnamento tramite Suno Upload API; l’operazione corrispondente è mostrata nella figura seguente:
audio_id dopo il caricamento; il risultato specifico è mostrato nella figura seguente:
audio_id: 92254cab-3372-4d9e-bce9-cdcfdbc39070, quindi è necessario compilare anche i seguenti parametri:
- action: il contenuto è
overpainting. - overpainting_start: l’ora di inizio per aggiungere la voce alla canzone caricata; il valore predefinito è 0.
- overpainting_end: l’ora di fine per aggiungere la voce alla canzone caricata; deve essere inferiore alla durata totale della canzone.
- audio_id: l’ID della canzone a cappella senza accompagnamento caricata.
- custom: in questa modalità è necessario usare la modalità personalizzata per inserire il testo.
- lyric: il testo inserito in modalità personalizzata.
- style: lo stile dell’accompagnamento.
Funzionalità Remaster
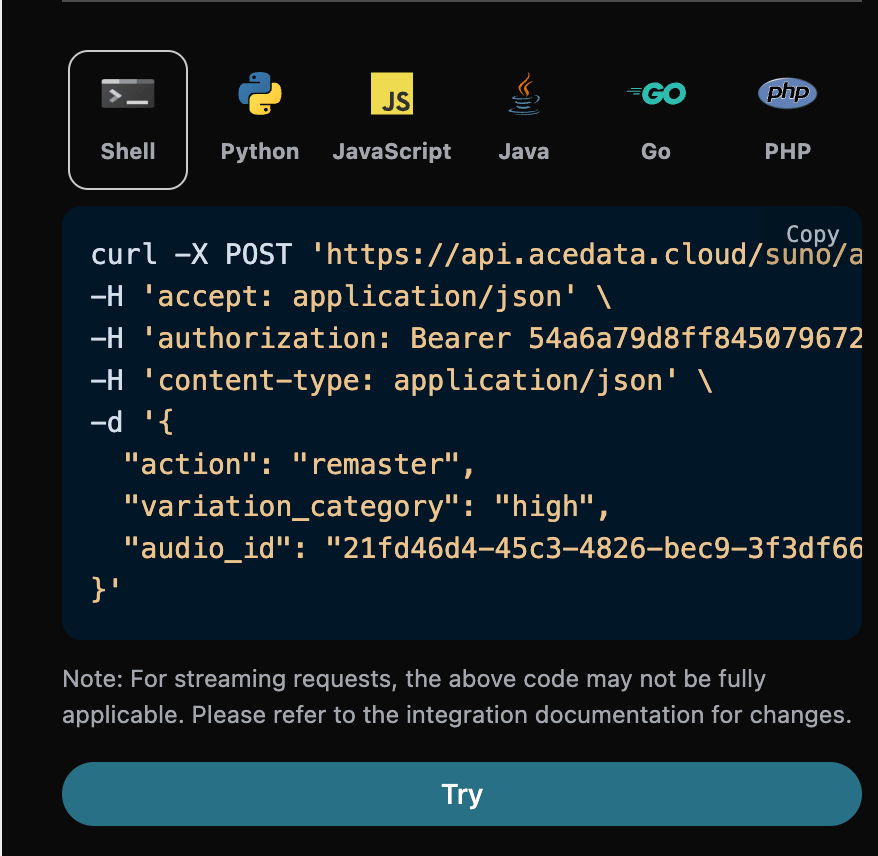
Nel dicembre 2025 suno ha introdotto una nuova funzionalità Remaster, questa funzione può rigenerare le canzoni e non può essere utilizzata tra account diversi, quindi dobbiamo anche compilare i seguenti parametri:- action:il contenuto è
remaster。 - audio_id:l’ID della canzone che deve essere rigenerata。
- model:supporta solo v4.5+、v5。
- variation_category:supportato solo nelle versioni v5 e successive, e ha solo 3 valori: high normal subtle。
Funzionalità di generazione mashup
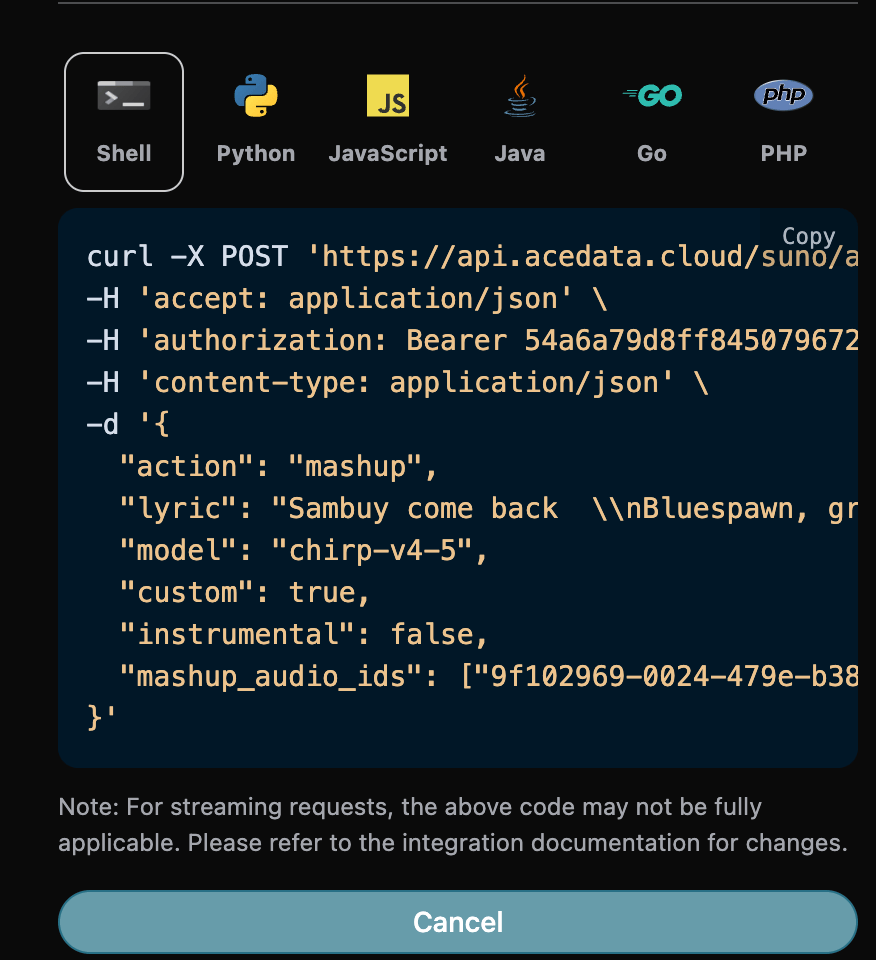
Nel dicembre 2025 suno ha introdotto una nuova funzionalità Mashup, questa funzione può generare una canzone in base a due canzoni di riferimento, quindi dobbiamo anche compilare i seguenti parametri:- action:il contenuto è
mashup。 - mashup_audio_ids:gli ID delle due canzoni di riferimento。 Dopo aver completato la compilazione, il codice viene generato automaticamente come segue:
Samples Generazione di canzoni tramite campionamento
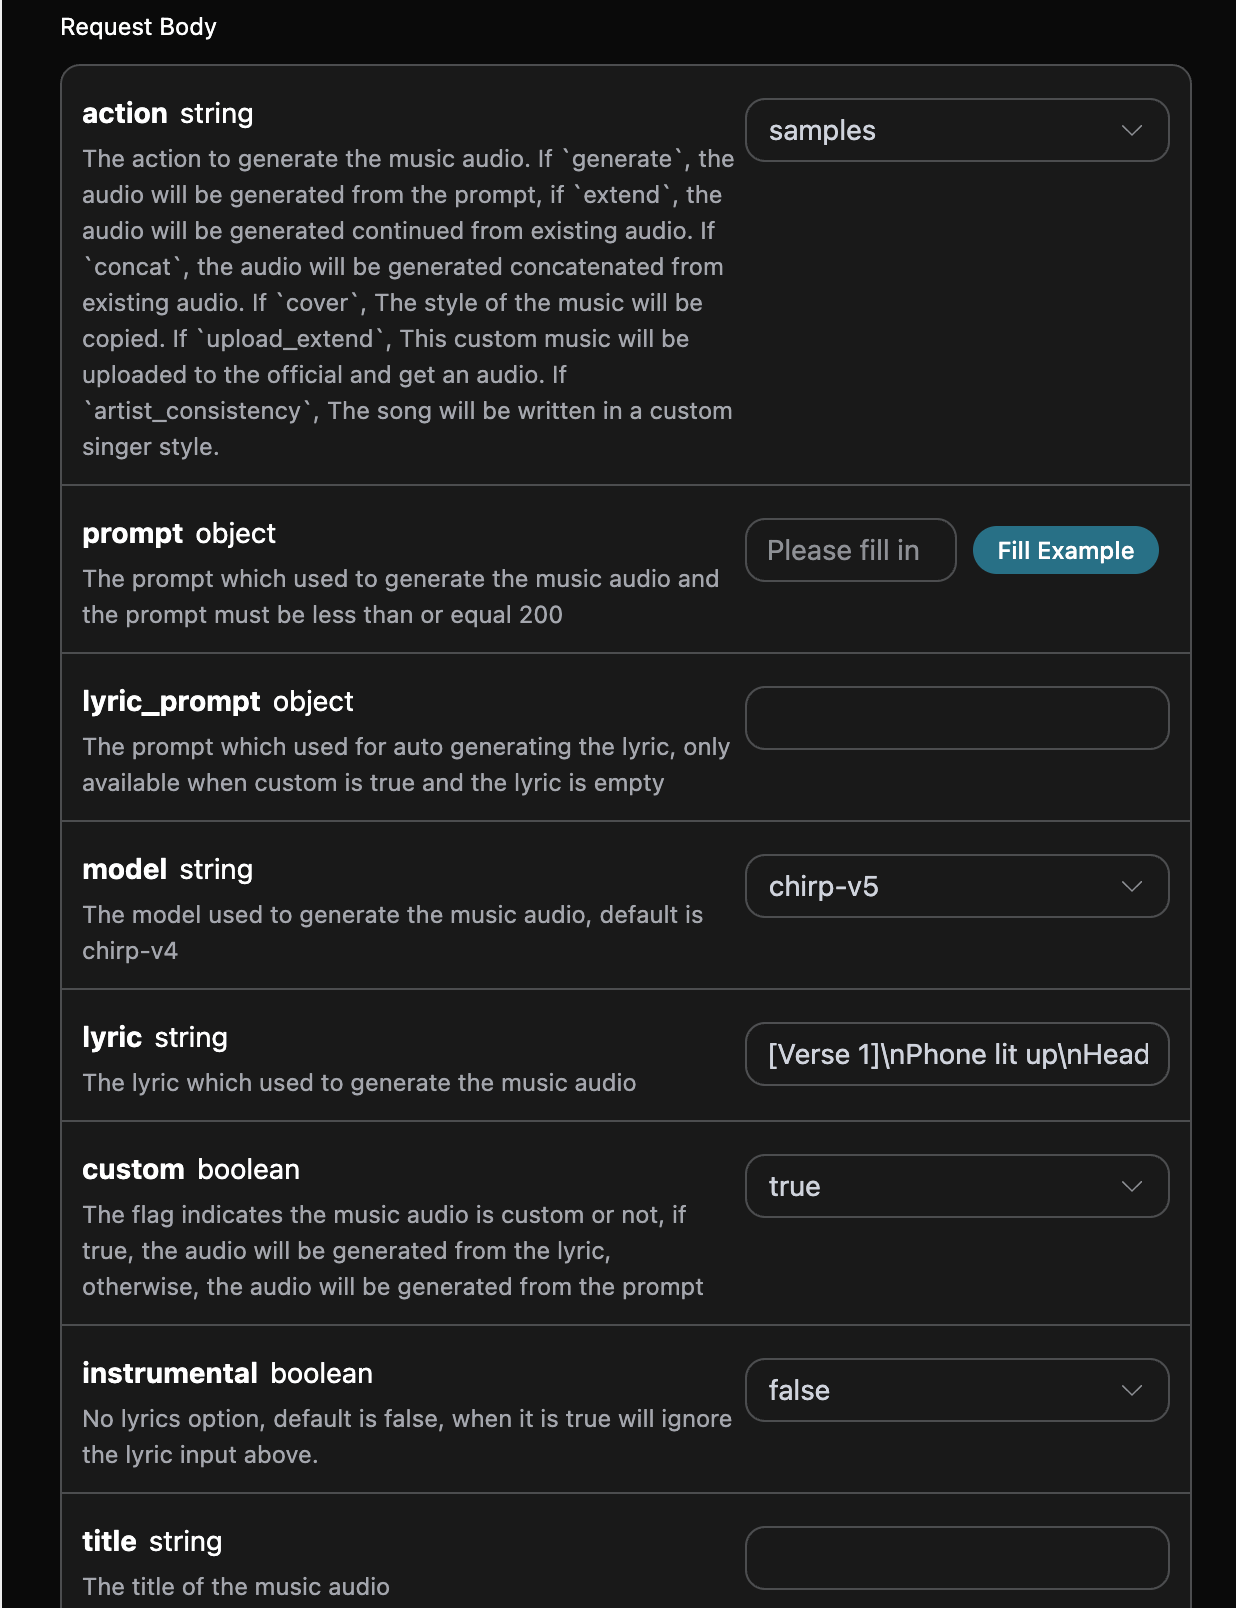
Qui,samples indica il campionamento di un intervallo di un singolo audio: si selezionano l’ora di inizio e di fine da un audio esistente e si utilizza questo frammento come materiale di campionamento per la creazione. È diverso dalla funzione di creazione ispirata Inspo che utilizza da 1 a 4 segmenti audio di riferimento completi descritta di seguito. È necessario compilare i seguenti parametri:
- action: il contenuto è
samples. - samples_start: ora di inizio del campionamento.
- samples_end: ora di fine del campionamento.
- audio_id: l’ID della canzone di riferimento da campionare.
Funzionalità di creazione ispirata Inspo
La funzionalità di creazione ispirata Inspo può generare nuova musica sulla base di 1-4 tracce audio di riferimento complete e supporta il trascinamento o il caricamento di audio come fonte d’ispirazione. L’API utilizza l’azioneinspo esistente: il client fornisce URL audio pubblicamente accessibili e il servizio completa automaticamente la preparazione degli audio di riferimento e la creazione, senza che il client debba leggere separatamente testi, stile o durata per poi assemblare la richiesta. È diversa dal campionamento di intervalli descritto sopra, nonché dal Cover che riproduce lo stile del brano originale. Durante l’utilizzo, è necessario compilare i seguenti parametri:
- action: il contenuto è
inspo. - audio_urls: elenco di URL degli audio di riferimento; è necessario fornire da 1 a 4 indirizzi audio pubblicamente accessibili.
- model: il modello utilizzato; è consigliato
chirp-v6. - prompt: testo o prompt creativo (facoltativo).
Nota: gli audio di riferimento devono essere file audio pubblicamente accessibili. Se un audio di riferimento corrisponde esattamente a una registrazione nota nella libreria musicale della piattaforma, Suno potrebbe rifiutare la generazione a causa della verifica del copyright; si consiglia di utilizzare audio propri o generati da Suno come fonte d’ispirazione.Il codice Python corrispondente:
chirp-v5 dell’epoca, mentre l’esempio di richiesta attuale raccomanda chirp-v6; la struttura restituita è identica:
Callback asincrono
Poiché Suno impiega un tempo relativamente lungo per generare musica, circa 1-2 minuti, se l’API non risponde per molto tempo, la richiesta HTTP manterrà continuamente la connessione, causando un consumo aggiuntivo di risorse di sistema, quindi questa API fornisce anche il supporto per callback asincroni. Il flusso complessivo è: quando il client avvia una richiesta, specifica inoltre un campocallback_url; dopo che il client ha avviato una richiesta API, l’API restituirà immediatamente un risultato, contenente un campo task_id, che rappresenta l’ID dell’attività corrente. Quando l’attività è completata, il risultato della generazione musicale verrà inviato tramite POST JSON al callback_url specificato dal client, includendo anch’esso il campo task_id, in modo che il risultato dell’attività possa essere associato tramite l’ID.
Di seguito, comprendiamo nello specifico come operare attraverso un esempio.
Innanzitutto, il callback Webhook è un servizio in grado di ricevere richieste HTTP; gli sviluppatori dovrebbero sostituirlo con l’URL del server HTTP da loro configurato. Qui, per comodità di dimostrazione, viene utilizzato un sito di esempio Webhook pubblico https://webhook.site/; aprendo questo sito è possibile ottenere un URL Webhook, come mostrato nell’immagine:
 Copia questo URL, che potrà essere usato come Webhook; l’esempio qui è https://webhook.site/03e60575-3d96-4132-b681-b713d78116e2。
Successivamente, possiamo impostare il campo
callback_url sull’URL Webhook sopra indicato e contemporaneamente inserire prompt, come mostrato nell’immagine:
 Facendo clic su Esegui, si può notare che si ottiene immediatamente un risultato, come segue:
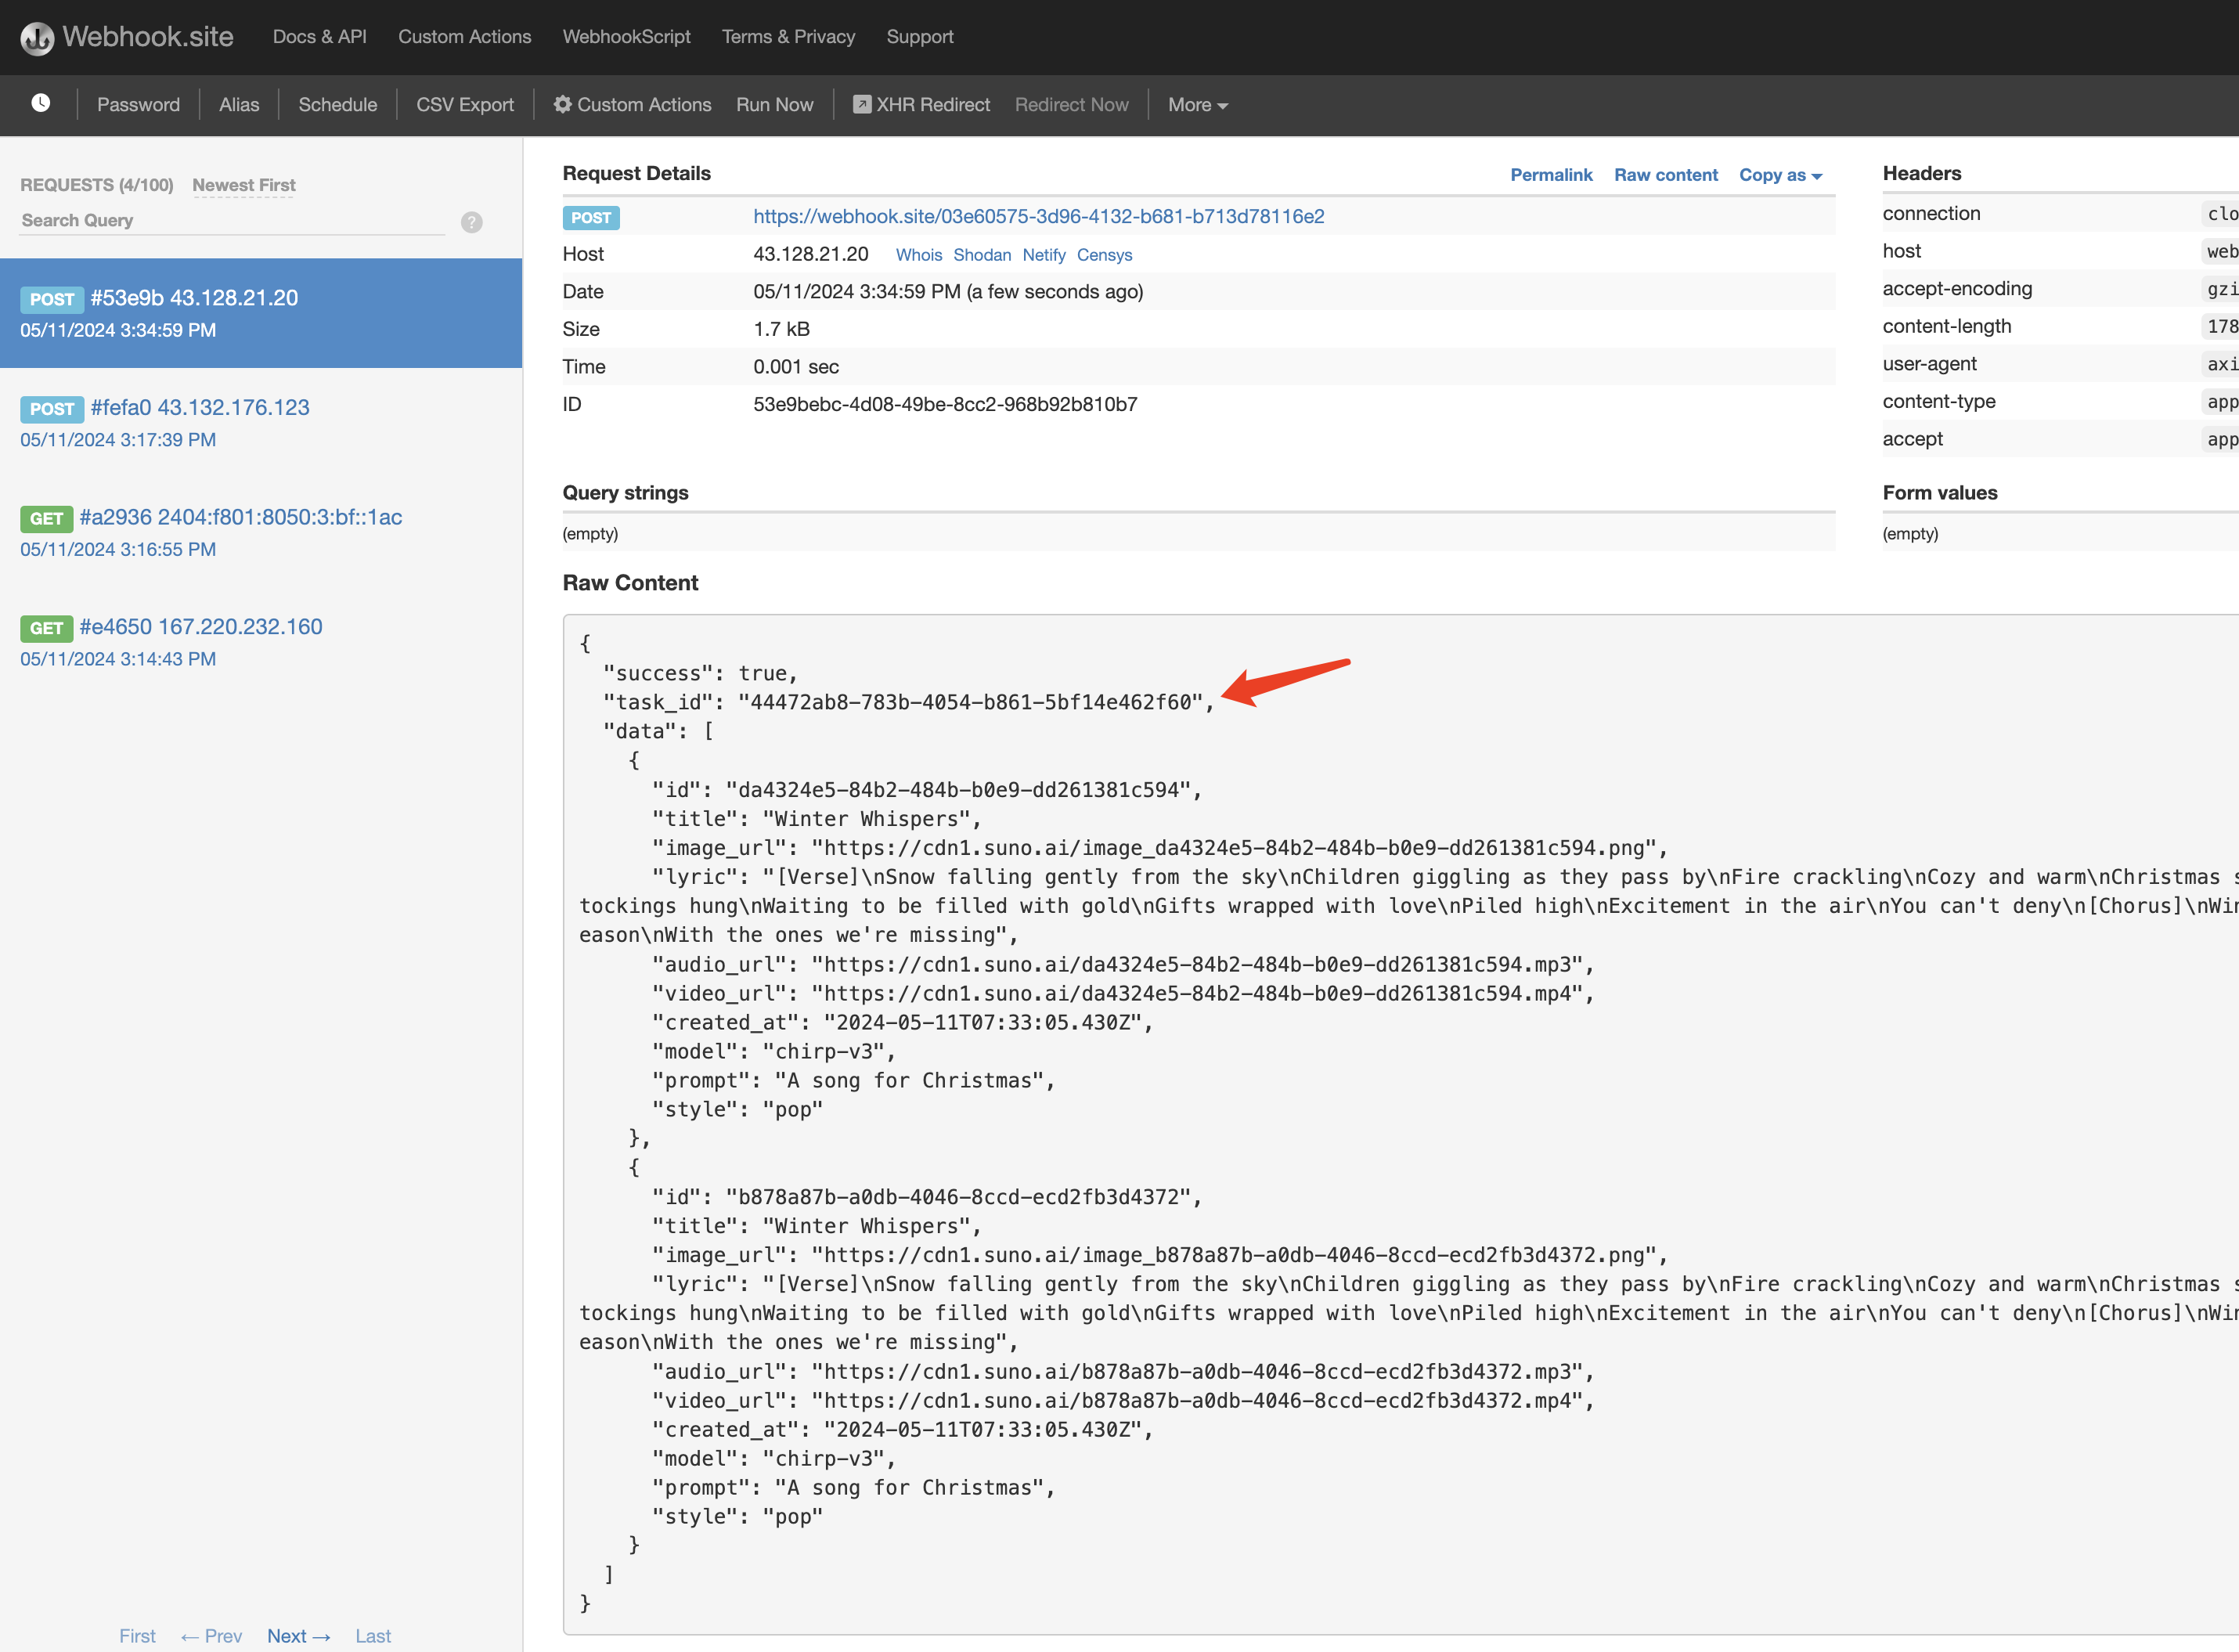 Il contenuto è il seguente:
task_id, mentre gli altri campi sono simili a quelli sopra riportati; tramite questo campo è possibile realizzare l’associazione dell’attività.
Naturalmente, possiamo anche ottenere il risultato tramite chiamata in streaming; ci basta impostare il valore di accept nell’intestazione della richiesta su application/x-ndjson. Di seguito viene utilizzato un input di esempio come dimostrazione:
task_id; sopra vengono mantenute solo la prima e le due risposte reali dello stato finale, omettendo gli aggiornamenti intermedi ripetuti.
Gestione degli errori
Se si verifica un errore, riceverete un messaggio di errore simile al seguente:error.code, error.message:
Nota: le quote e i messaggi di errore per diversi account upstream possono variare. In genere,chirp-v3-5/chirp-v4hanno un limitestyleinferiore (200), mentrechirp-v4-5e versioni successive supportano generalmente fino a 1000; quando viene utilizzato un upstream precedente, possono apparire messaggi di compatibilità comeTags too long.ostyle must be less than or equal 120. | Codice di stato |error.code|error.message| | --------------- | ------------- | --------------------------------------------------------------- | | 400 |bad_request|L'id della canzone non esiste o è stata rimossa.| | 400 |bad_request|Prompt troppo lungo.| | 400 |bad_request|Tag troppo lunghi.| | 400 |bad_request|L'audio caricato corrisponde a un'opera d'arte esistente.| | 400 |bad_request|instrumental deve essere un booleano| | 400 |bad_request|Titolo troppo lungo.| | 400 |bad_request|Argomento troppo lungo.| | 400 |bad_request|style deve essere minore o uguale a 120| | 400 |bad_request|custom deve essere un booleano| | 400 |bad_request|audio_id è richiesto quando si estende l'audio| | 400 |bad_request|continue_at è richiesto quando si estende l'audio| | 400 |bad_request|continue_at deve essere un numero maggiore di 0| | 400 |bad_request|lyric è richiesto quando si estende l'audio e instrumental è falso| | 400 |bad_request|prompt è richiesto quando si genera l'audio| | 400 |bad_request|lyric è richiesto quando si genera audio personalizzato| | 403 |forbidden|Prompt probabilmente malformato| | 403 |forbidden|Prompt probabilmente protetto da copyright| | 403 |forbidden|Il prompt conteneva materiale inappropriato| | 403 |forbidden|Descrizione della canzone segnalata per la moderazione| | 403 |forbidden|La descrizione della canzone conteneva il nome di un artista| | 403 |forbidden|I tag contenevano il nome di un artista| | 403 |forbidden|I testi contenevano materiale protetto da copyright| | 403 |forbidden|La descrizione della canzone conteneva un tag del produttore| | 403 |forbidden|Errore generico di openAI| | 403 |forbidden|Prompt segnalato per la moderazione| | 500 |api_error|Impossibile generare i testi dalla descrizione della canzone| | 500 |api_error|processo non riuscito con errore sconosciuto| | 500 |api_error|nessun worker disponibile nel sistema| | 500 |api_error|servizio in manutenzione, generazione in pausa| | 504 |timeout|timeout durante l'attesa della generazione dell'audio|