

Os limites deSuno agora oferece suporte alyricestylena tabela acima são os limites máximos no modo personalizado (custométrue). O modo de inspiração não personalizado (customéfalse) preenche apenasprompt, cujo limite de comprimento é de 500 caracteres (igual para todos os modelos).
chirp-v6, chirp-v6-wild e chirp-v6-mini. Recomenda-se usar chirp-v6; os nomes de modelos antigos continuam compatíveis.
No entanto, a Suno oficialmente não fornece uma API. A AceDataCloud fornece um conjunto de APIs da Suno, simulando a integração oficial da Suno, permitindo gerar de forma prática e rápida a música desejada.
Solicitação e uso
Para usar a Suno Audios Generation API, primeiro acesse o console Ace Data Cloud para obter seu API Token e guarde-o para uso posterior. Se você ainda não tiver feito login ou se registrado, será automaticamente redirecionado para a página de login, onde será convidado a se registrar e fazer login; após concluir, retornará automaticamente à página atual.
Um único API Token pode chamar todos os serviços da plataforma, não sendo necessário solicitar um separadamente para cada serviço. Na primeira solicitação, será concedida uma cota gratuita, permitindo uma experiência gratuita; quando a cota for insuficiente, você poderá recarregar o saldo geral no console.
📘 Documentação completa: Suno Audios Generation API →
Uso básico
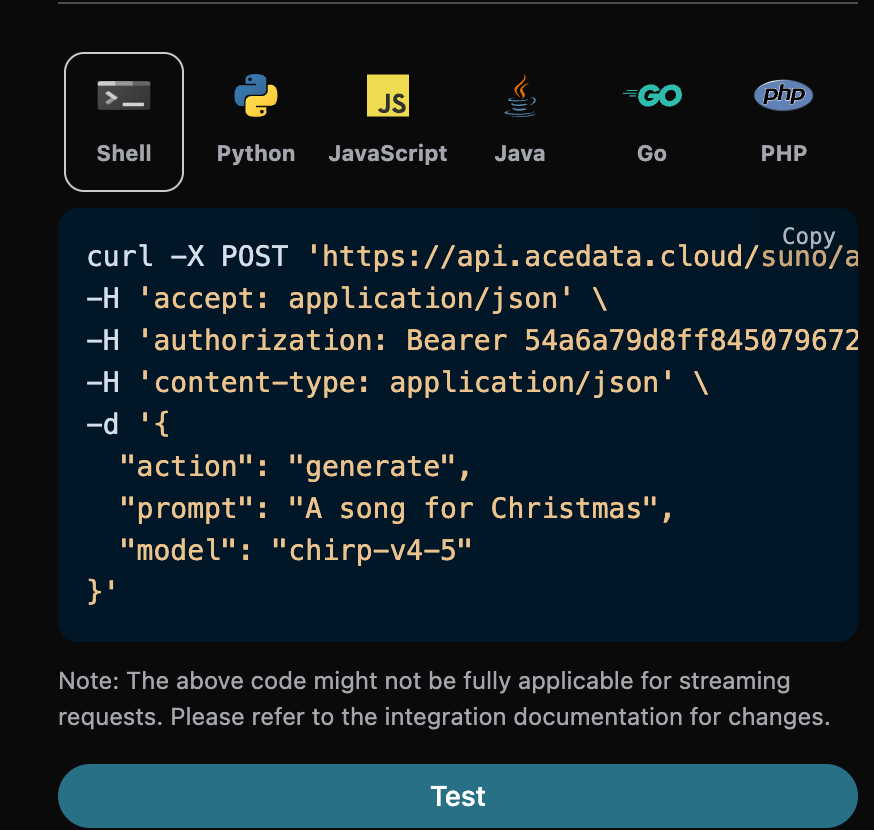
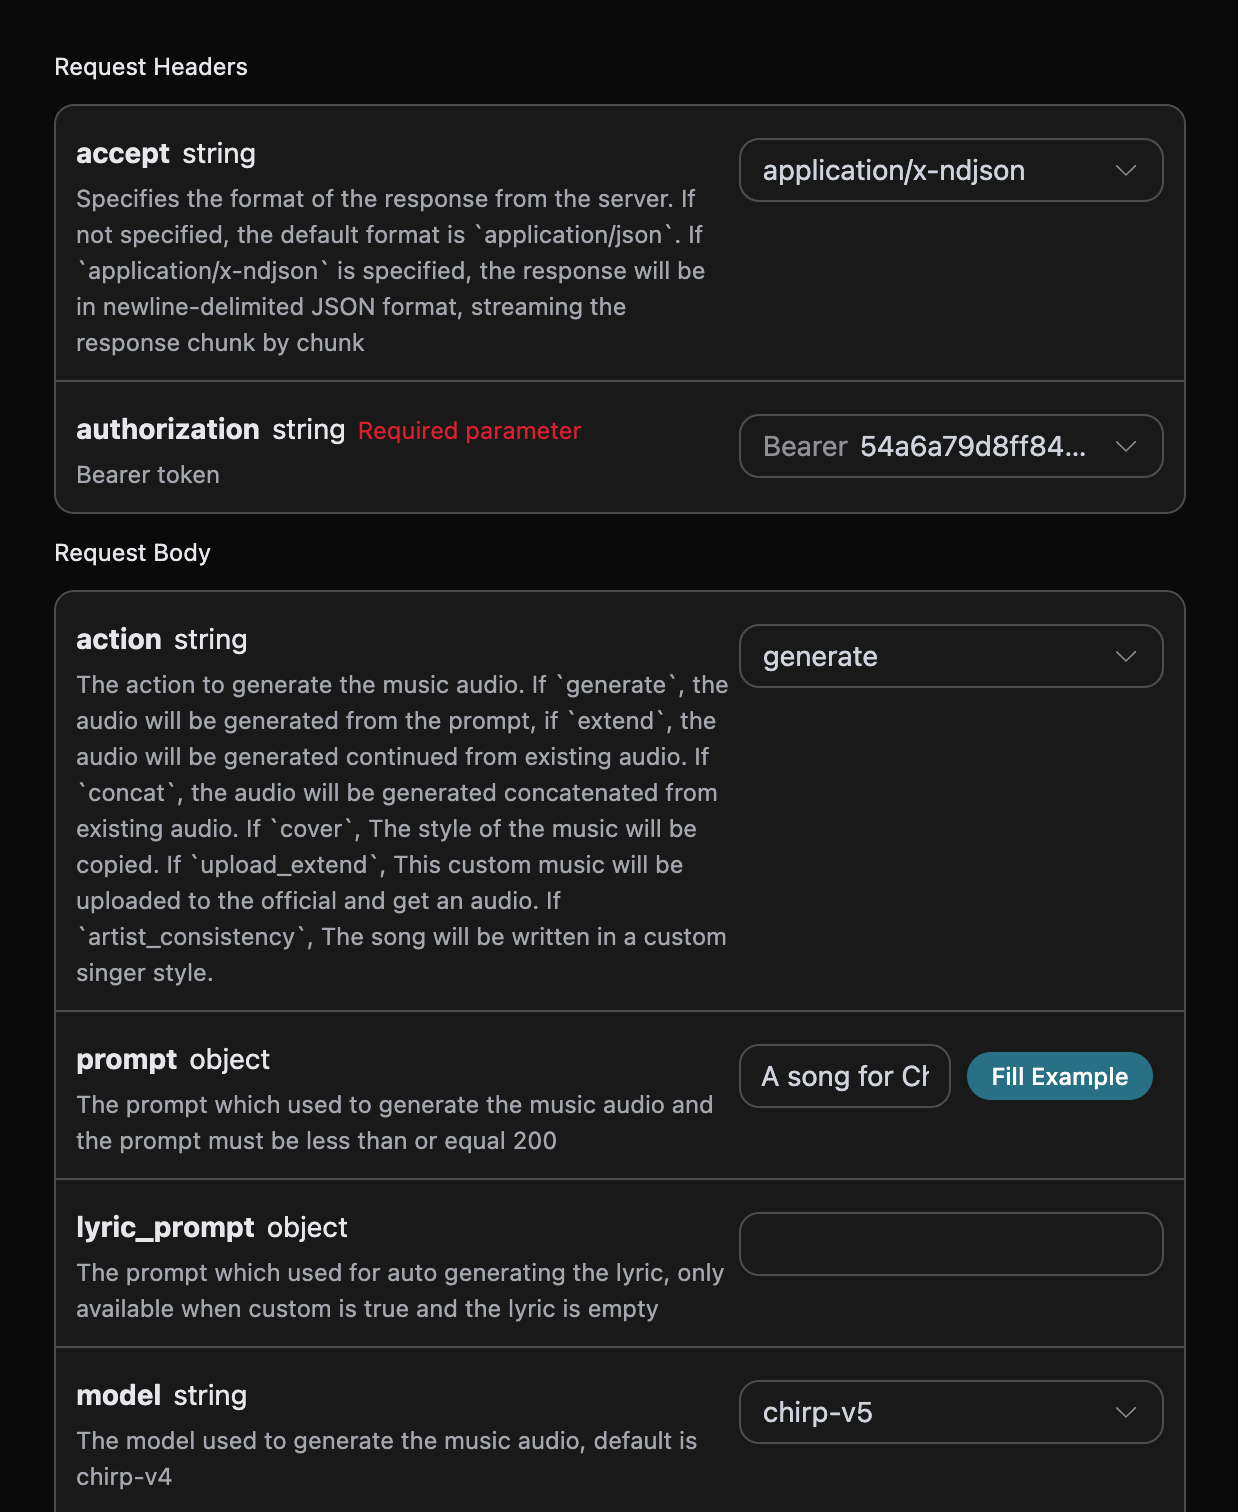
Que tipo de música você quer? Você pode inserir livremente um trecho de texto. Por exemplo, se eu quiser gerar uma música sobre o Natal, posso inserira song for Christmas, como mostrado na imagem:
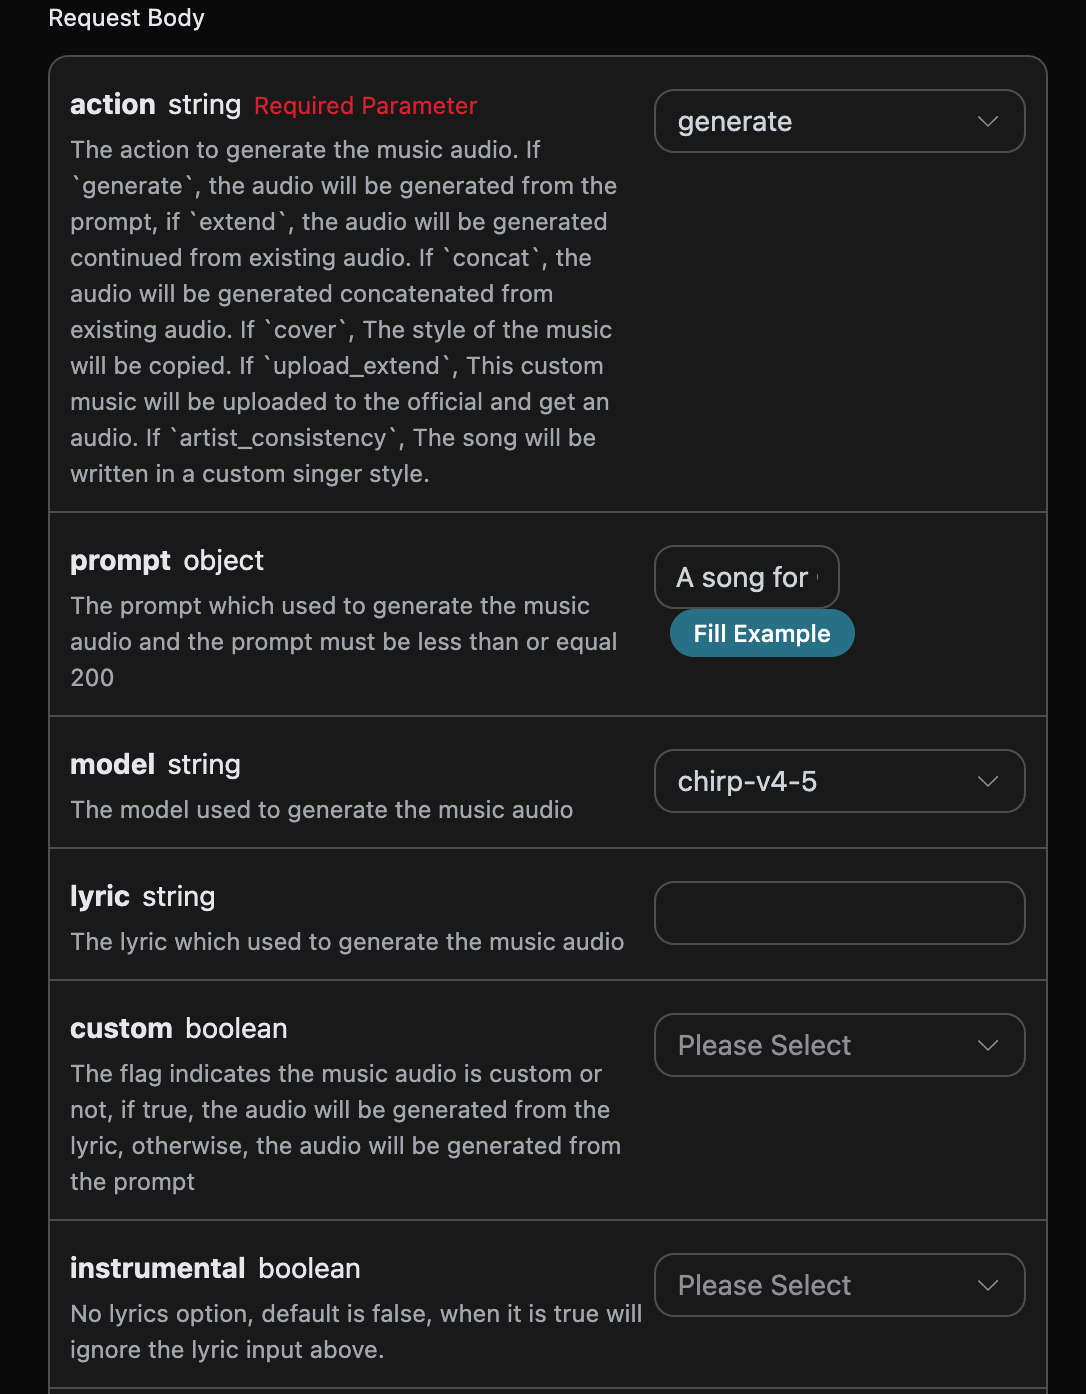
accept: qual formato de resultado de resposta se deseja receber; aqui é preenchido comoapplication/json, ou seja, o formato JSON.authorization: a chave para chamar a API, que pode ser selecionada diretamente na lista suspensa após a solicitação.
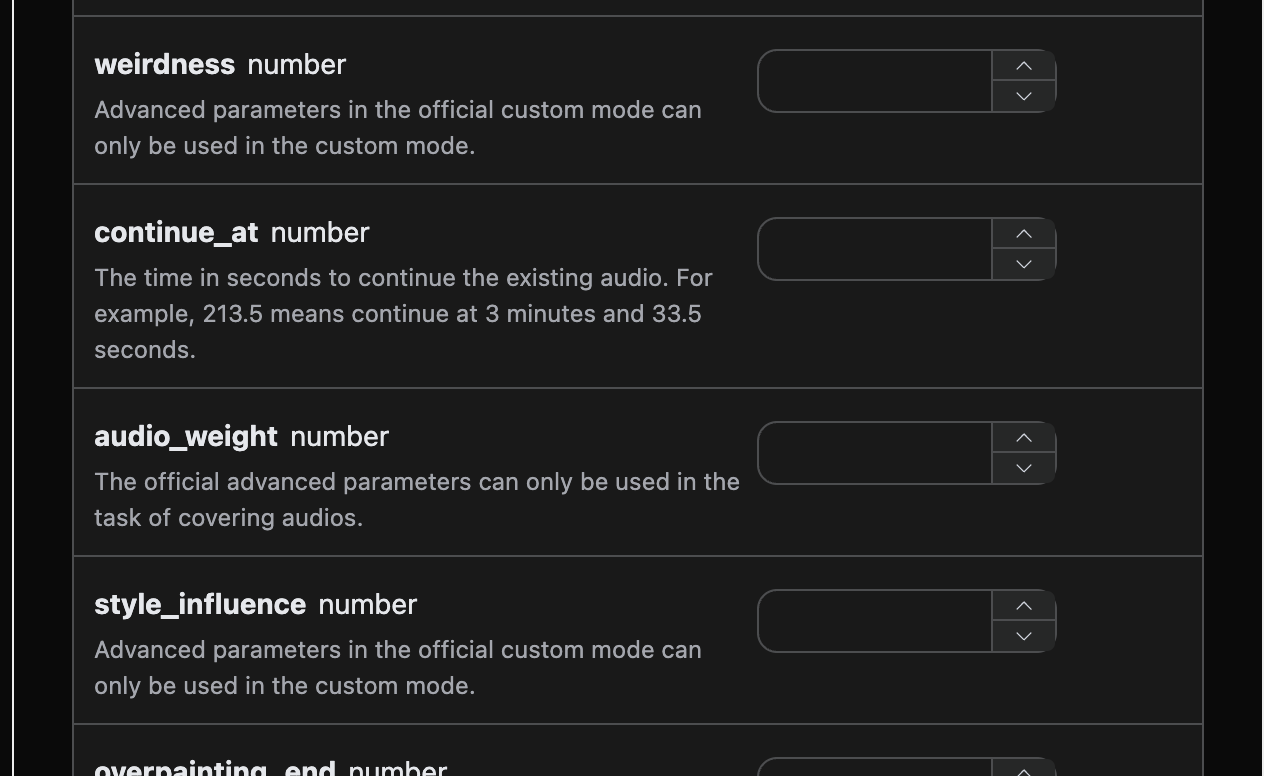
action: tipo de tarefa de áudio, o padrão égenerate. Suporta operações como geração, continuação, cover, concatenação, separação de faixas, adição de faixa de áudio, extração de uma faixa de áudio especificada, geração de efeitos sonoros e ajuste de velocidade, todas chamadas de forma unificada por meio dePOST /suno/audios.prompt: prompt do modo de inspiração oficial do Suno (válido quandocustoméfalse), máximo de 500 caracteres.model: o modelo para esta tarefa de geração de música. A série v6 incluichirp-v6,chirp-v6-wildechirp-v6-mini; os nomes de modelos antigos continuam compatíveis.max_mode: modo de geração aprimorado.generateé habilitado apenas quandocustomemax_modesão ambostrue, com custo de 1.12 Credits;add_stempode ser habilitado diretamente, com custo de 1.344 Credits. Quando desativado ou omitido, os custos são 0.56 e 0.672 Credits, respectivamente.variety: intensidade da diversidade dos resultados gerados, com opçõesoff,normal,high,extra,max. Usado apenas paragenerateeadd_stem; passá-lo para outros actions retornará 400.lyric: conteúdo da letra no modo personalizado oficial do Suno.chirp-v3-5echirp-v4têm máximo de 3000 caracteres;chirp-v4-5e superiores (incluindochirp-v5,chirp-v5-5) têm máximo de 5000 caracteres.custom: se deve usar o modo personalizado, o padrão é:false.instrumental: opção de música instrumental no modo de inspiração oficial do Suno.title: título da música no modo personalizado oficial do Suno.chirp-v3-5,chirp-v4têm máximo de 80 caracteres;chirp-v4-5e superiores têm máximo de 100 caracteres.style: estilo musical do modo personalizado oficial do Suno.chirp-v3-5echirp-v4têm máximo de 200 caracteres;chirp-v4-5e superiores (incluindochirp-v5,chirp-v5-5) têm máximo de 1000 caracteres.negative_tags: estilos musicais ou gêneros que se deseja excluir dos resultados gerados no modo personalizado (custométrue).audio_weight: peso de influência de características de áudio ou voz, intervalo de 0-1, sendo que0também é um valor válido. Pode ser usado em operações como geração, continuação, cover, adição de faixa de áudio e consistência de voz; quando não há áudio de referência ou características de voz, o modelo pode enfraquecer ou ignorar esse valor.audio_id: ID da música de referência.overpainting_start/overpainting_end: horários de início e fim para adicionar vocais a uma música instrumental existente, em segundos.underpainting_start/underpainting_end: horários de início e fim para adicionar acompanhamento a uma performance a cappella, em segundos.persona_id: ID da música do artista.continue_at: limite de continuação, em segundos. Por exemplo, 213.5 indica gerar o trecho seguinte a partir de 3 minutos e 33.5 segundos.lyricestyleorientam apenas o novo conteúdo após o limite e não substituem a letra ou o canto antes do limite no áudio de origem.style_influence: influência de estilo no modo personalizado, intervalo de 0-1; quanto maior, geralmente mais fiel será ao estilo selecionado;0será transmitido como um valor válido.replace_section_end: tempo final do trecho de substituição.replace_section_start: tempo inicial do trecho de substituição.vocal_gender: controla a preferência por voz feminina ou masculina, voz femininaf, voz masculinam, válido para modelos 4.5 e superiores; é um item de preferência, não sendo garantido que seja seguido rigorosamente.weirdness: grau de estranheza no modo personalizado, intervalo de 0-1; quanto maior, geralmente mais criativo e experimental;0será transmitido como um valor válido.duration: duração esperada da música, em segundos, deve ser um inteiro, com intervalo de 10 a 360. Este parâmetro é usado para geração de música no modo personalizado (custométrue). É uma sugestão de preferência e não uma restrição rígida: o modelo a considerará, mas não garante atingi-la; a duração real do produto final é determinada pelo campodurationna resposta e normalmente é menor que o valor esperado.
Escopo de aplicação dos parâmetros avançados
A plataforma validará os tipos de parâmetros e os intervalos numéricos, mas não rejeitará esses itens de ajuste opcionais apenas porque o action é diferente; os efeitos específicos são determinados pela operação, modo e modelo.
lyric_prompt: prompt para gerar letras, válido se e somente secustomfortrueelyricnão for enviado.callback_url: URL para a qual os resultados precisam ser retornados por callback.async: opcional; quando definido comotrue, a interface retorna imediatamentetask_id, sem necessidade de fornecercallback_url, e os resultados podem ser obtidos posteriormente por polling por meio da interface de consulta de tarefa correspondente.
- success: se a geração foi bem-sucedida; se for bem-sucedida, será
true, caso contrário seráfalse - data: é uma lista que contém as informações detalhadas das músicas geradas.
- state: estado de geração da música, contendo principalmente quatro tipos, especificamente os seguintes:
- succeeded: geração bem-sucedida
- pending: na fila
- running: em execução
- error: falha
- id: ID da música
- title: o título da música
- image_url: a imagem de capa da música
- lyric: a letra da música
- audio_url: o endereço de áudio final da música. A plataforma retornará prioritariamente o endereço do Ace Data Cloud CDN; se a persistência falhar, poderá retornar o endereço de mídia original, faça o download a tempo.
- video_url: o arquivo de vídeo da música; ao abri-lo, será um vídeo mp4.
- created_at: o horário de criação
- model: o modelo usado, geralmente o modelo v3 mais recente
- style: o estilo
- state: estado de geração da música, contendo principalmente quatro tipos, especificamente os seguintes:
Geração personalizada
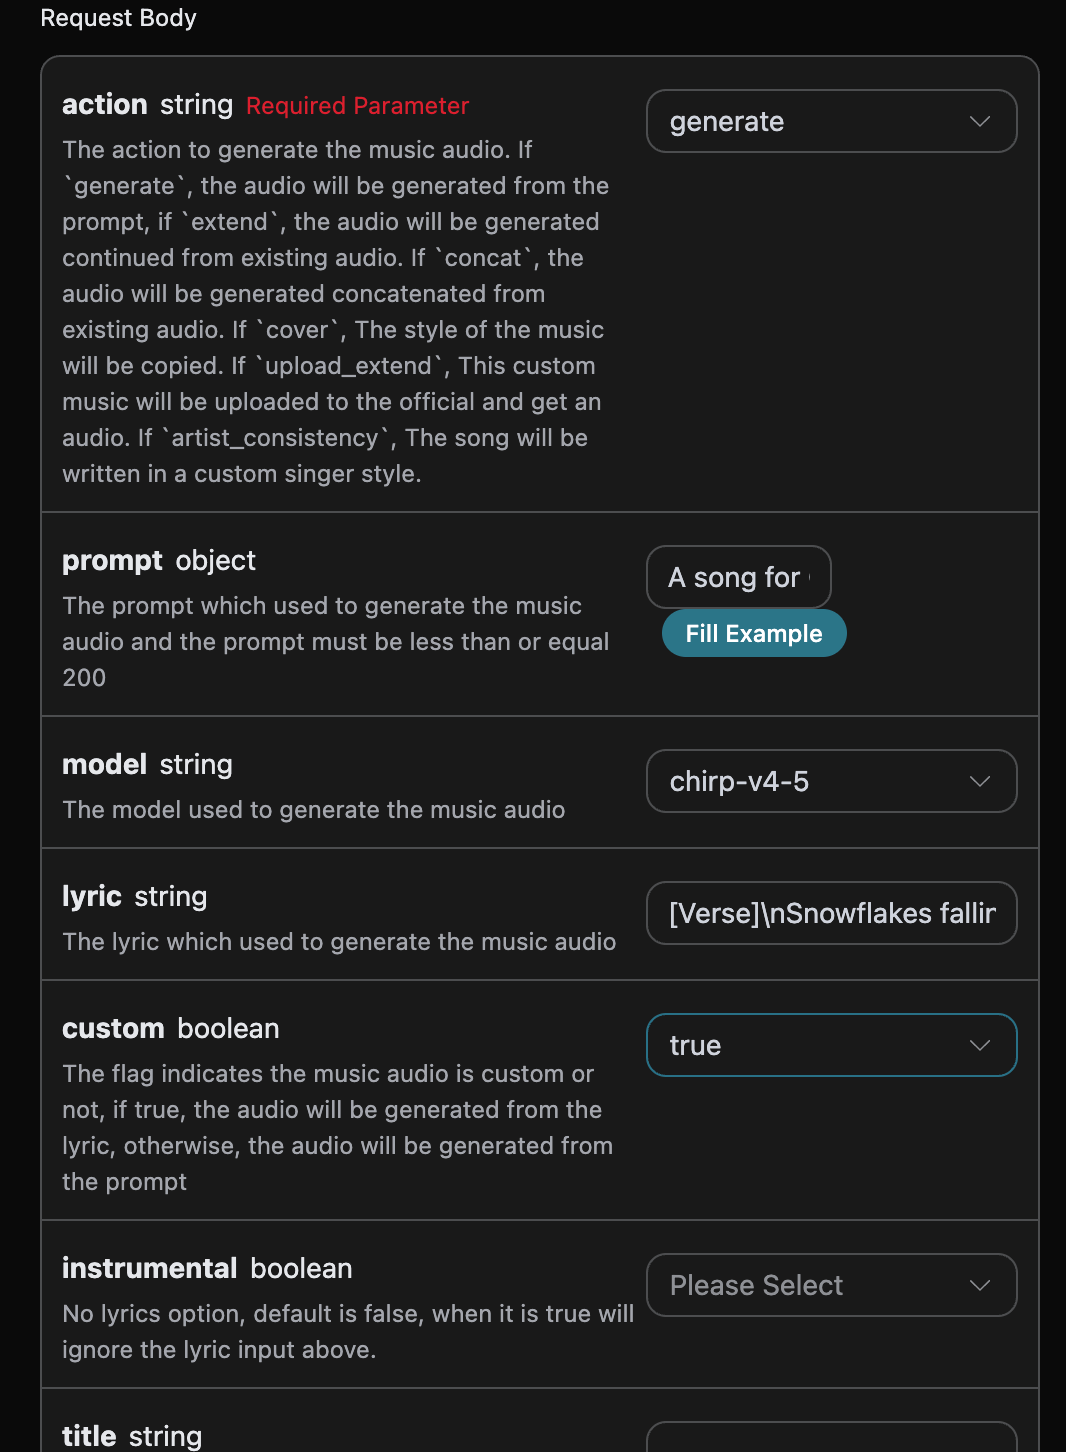
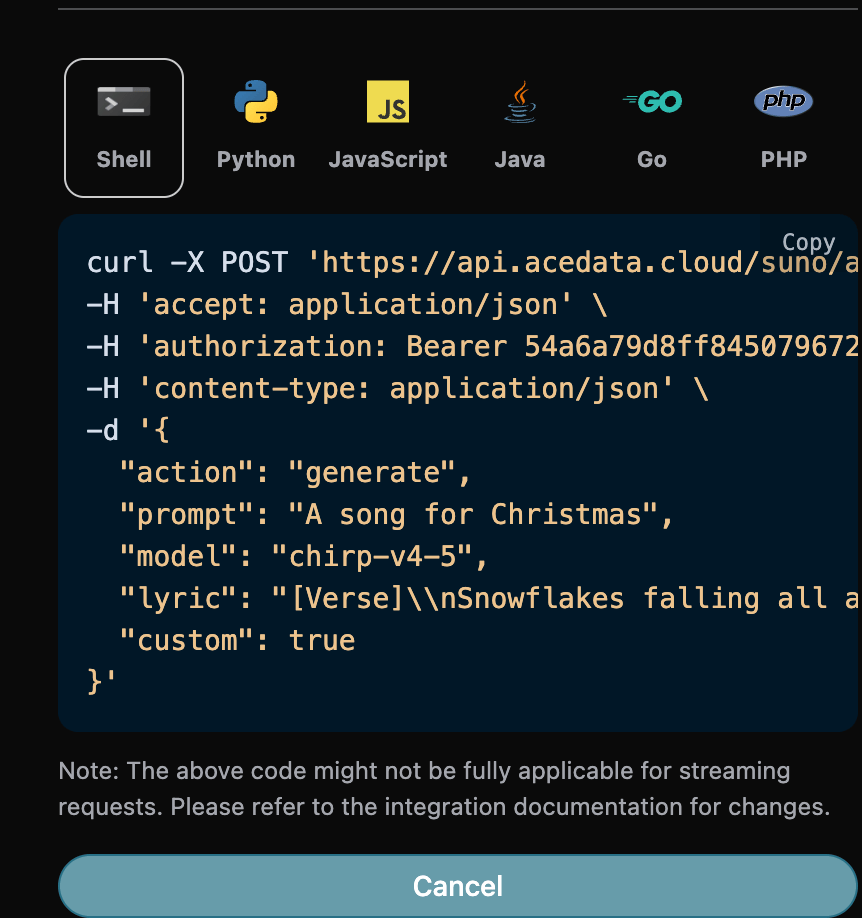
Se quiser gerar letras personalizadas, você pode inserir a letra: Neste momento, o campolyric pode receber conteúdo semelhante ao seguinte:
Observação: na letra aqui, \n é um caractere de quebra de linha. Se você não souber como gerar a letra, pode usar a API de geração de letras fornecida pelo AceDataCloud para gerar letras por meio de um prompt; a API é Suno Lyrics Generation API.
Em seguida, para gerar uma música personalizada com base na letra, no título e no estilo, você pode especificar o seguinte conteúdo:
- lyric: texto da letra
- custom: preencha como
true, representando a geração personalizada; este parâmetro é, por padrão, false, representando a geração usandoprompt. - title: o título da música.
- style: o estilo da música, opcional.
Funcionalidade de geração personalizada de estilo de cantor
Se você quiser usar o estilo de cantor para gerar músicas, primeiro gere uma música por meio do uso básico acima, por fim, é necessário configurar esta música como estilo de cantor, então é necessário acessar a Suno Persona API para gerar um parâmetro de id de estilo de cantorpersona_id com base no ID da música gerada oficialmente audio_id, os parâmetros específicos são mostrados na imagem abaixo:
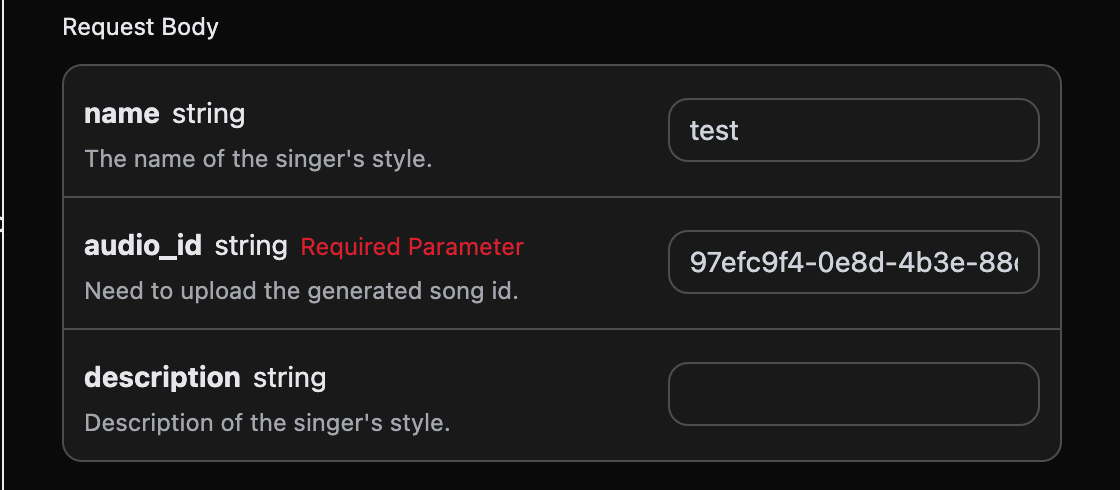
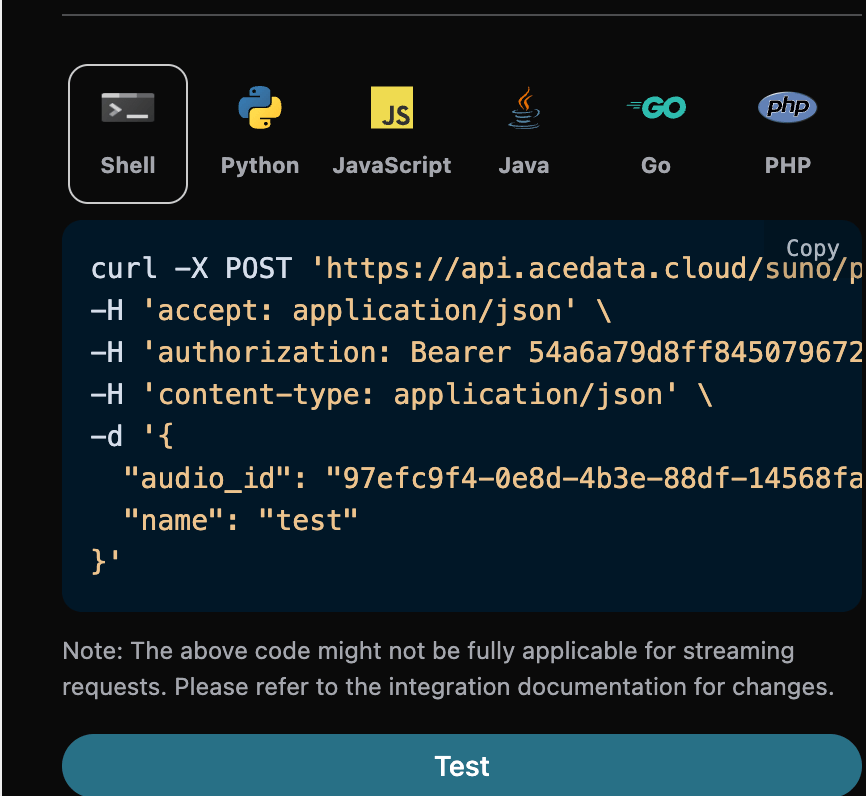
audio_id e o persona_id acima, respectivamente 97efc9f4-0e8d-4b3e-88df-14568fa1b11f e e0d7319e-aa2a-44cb-b00a-916218d7cb0b, como dados de exemplo desta vez. Em seguida, você pode definir o parâmetro action como artist_consistency (se for o novo estilo de cantor Persona-v2-vox, action deve ser definido como artist_consistency_vox), e inserir o ID da música que precisa continuar sendo gerada e o ID do estilo de cantor, o exemplo de preenchimento é o seguinte:
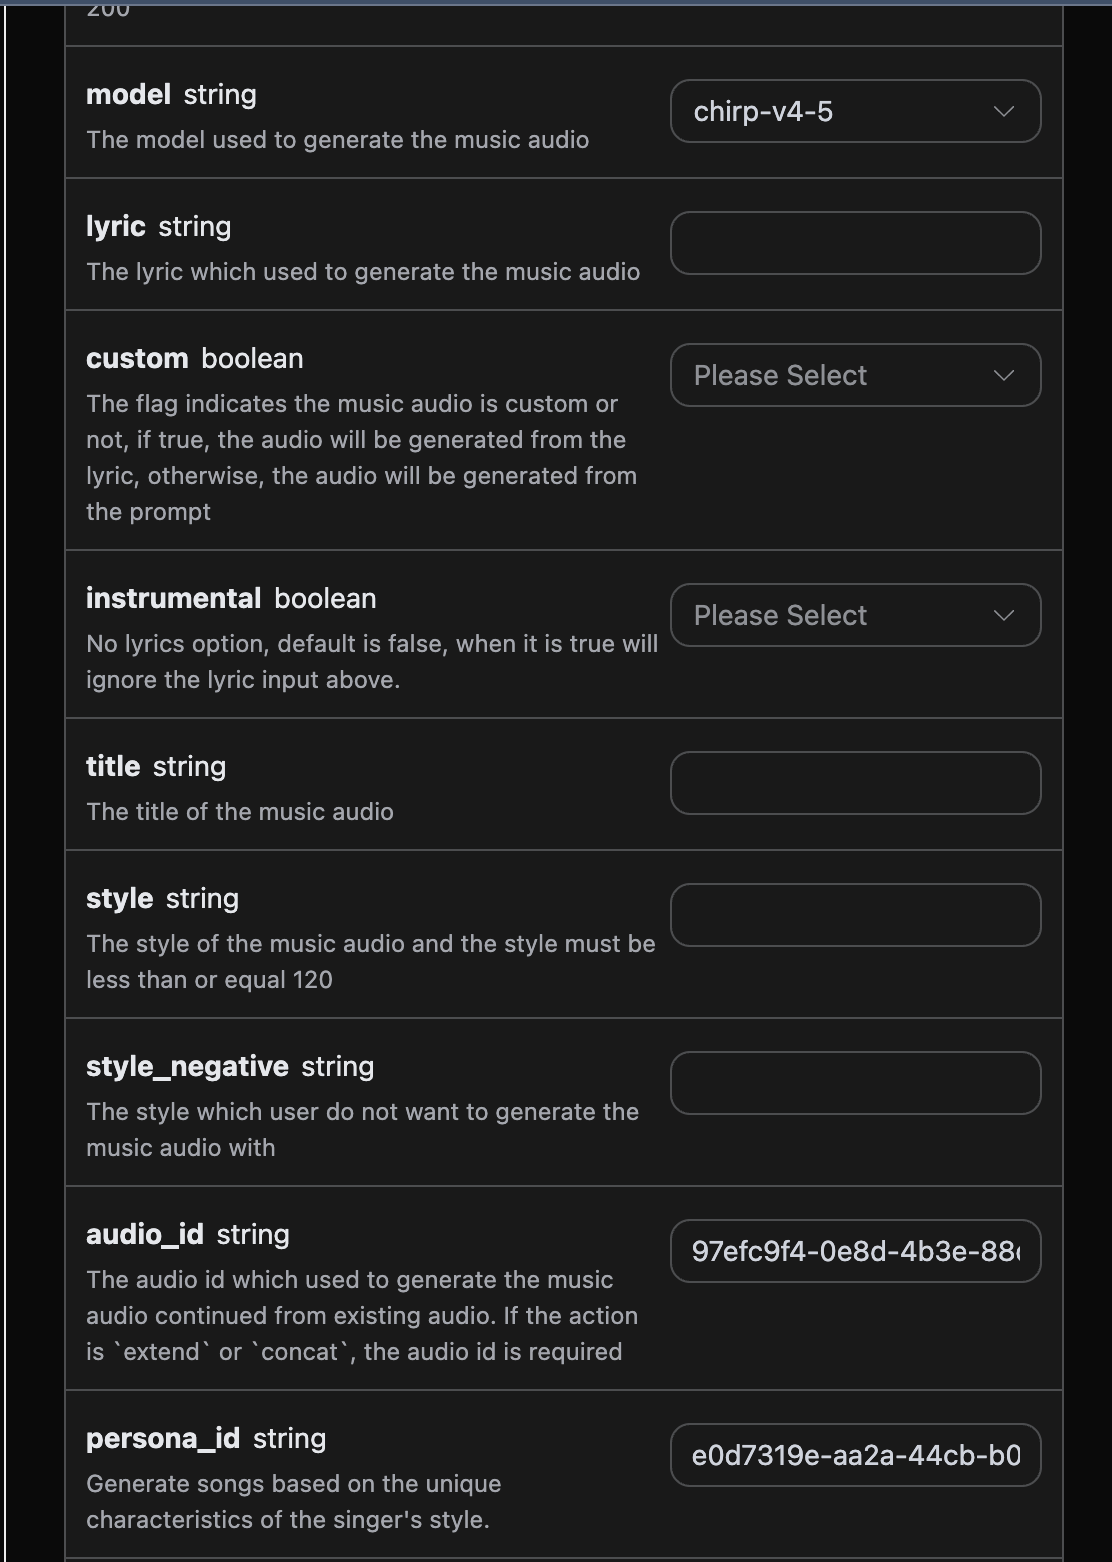
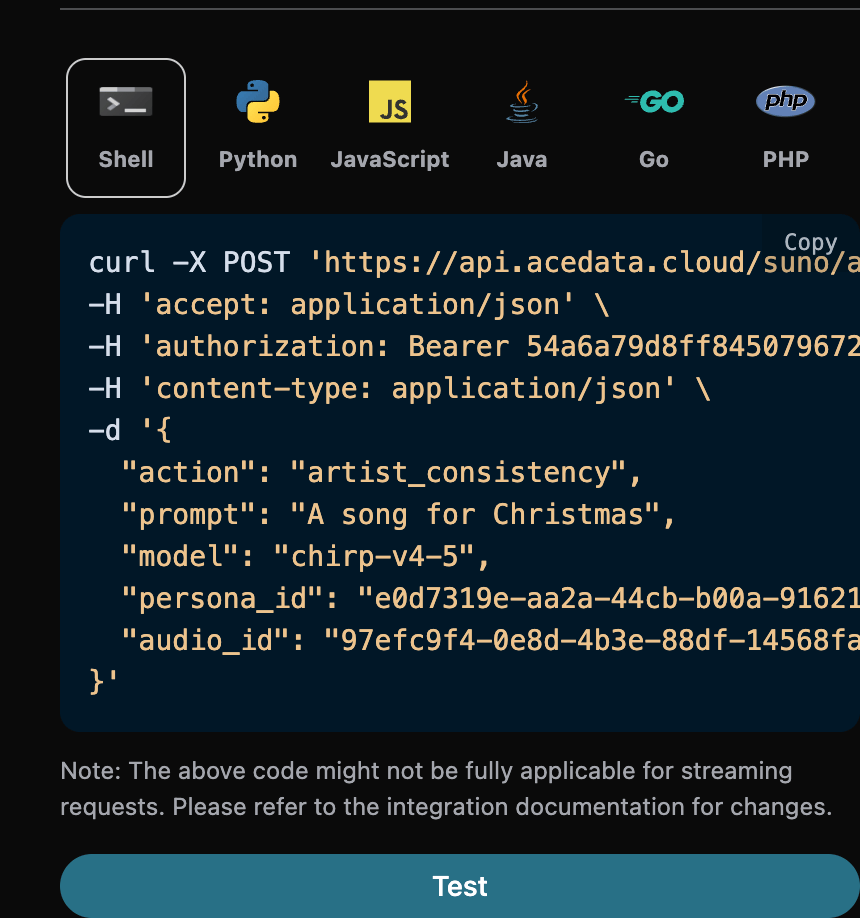
Funcionalidade de continuar gerando
Se quiser continuar gerando uma música Suno já gerada, você pode definir o parâmetroaction como extend e inserir o ID da música que precisa continuar sendo gerada. O ID da música é obtido com base no uso básico; pelo texto acima, pode-se saber que, neste momento, o ID da música é:
Observe que aqui o id na letra é o ID da música após a geração. Se você não souber como gerar uma música, pode consultar o uso básico acima para gerar uma música.
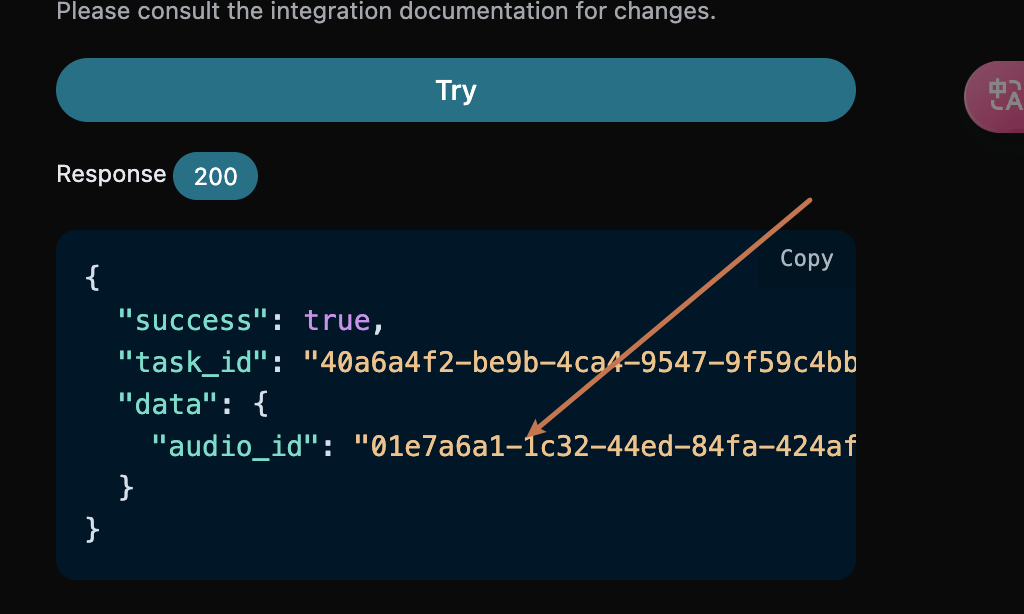
Se quiser continuar gerando uma música enviada por você mesmo, você pode definir o parâmetro action como upload_extend e inserir o ID da música enviada personalizada que precisa continuar sendo gerada. O ID da música é obtido usando a Suno Upload Generation API, como mostrado na imagem abaixo:
- lyric: usado apenas para orientar a letra do trecho recém-gerado após
continue_at, não substituirá a letra antes desse ponto no tempo no áudio de origem. - custom: preencha com
true, representando a geração personalizada; esse parâmetro é false por padrão, representando a geração usandoprompt. - style: o estilo da música do trecho de continuação, opcional.
- continue_at: limite de continuação, em segundos. Por exemplo, 213.5 representa gerar o trecho subsequente a partir de 3 minutos e 33,5 segundos.
O exemplo de preenchimento é o seguinte:extendé usado para continuar criando a partir de uma música existente, não para trocar a letra de toda a música. Se desejar usar uma nova letra para toda a música desde o início, usegeneratepara gerar novamente; se desejar reinterpretar com referência a uma música existente, pode usarcover. Ao enviar uma letra nova completa, a letra original antes decontinue_atainda não será substituída.
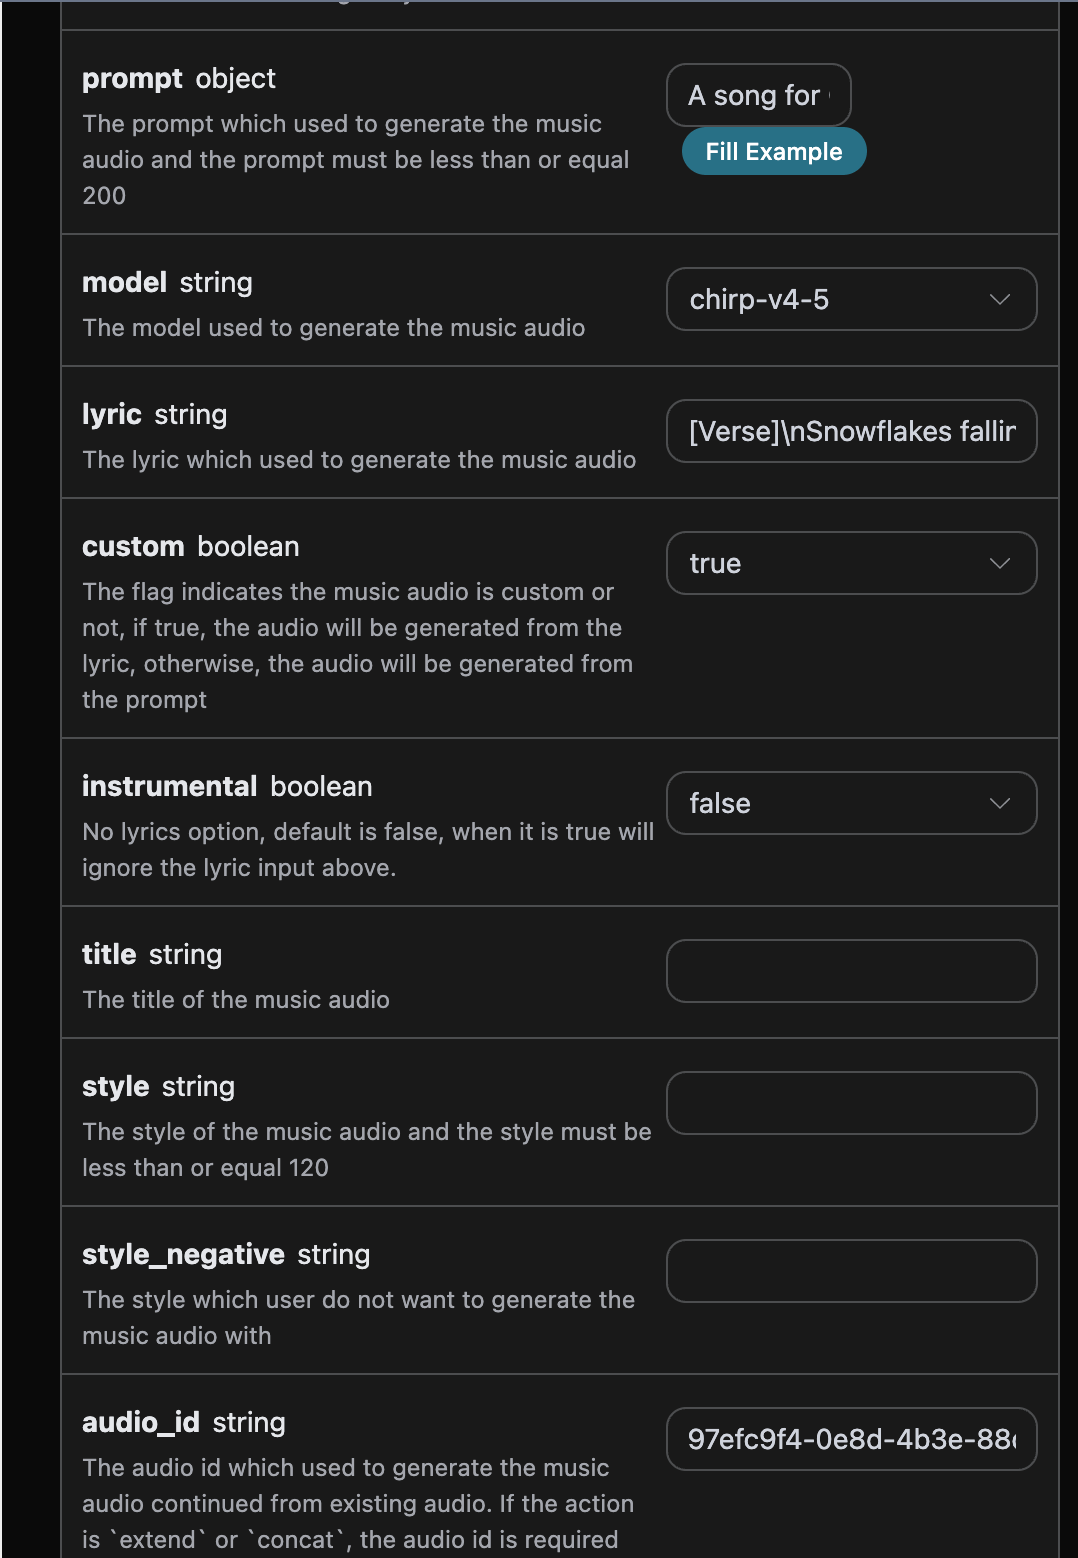
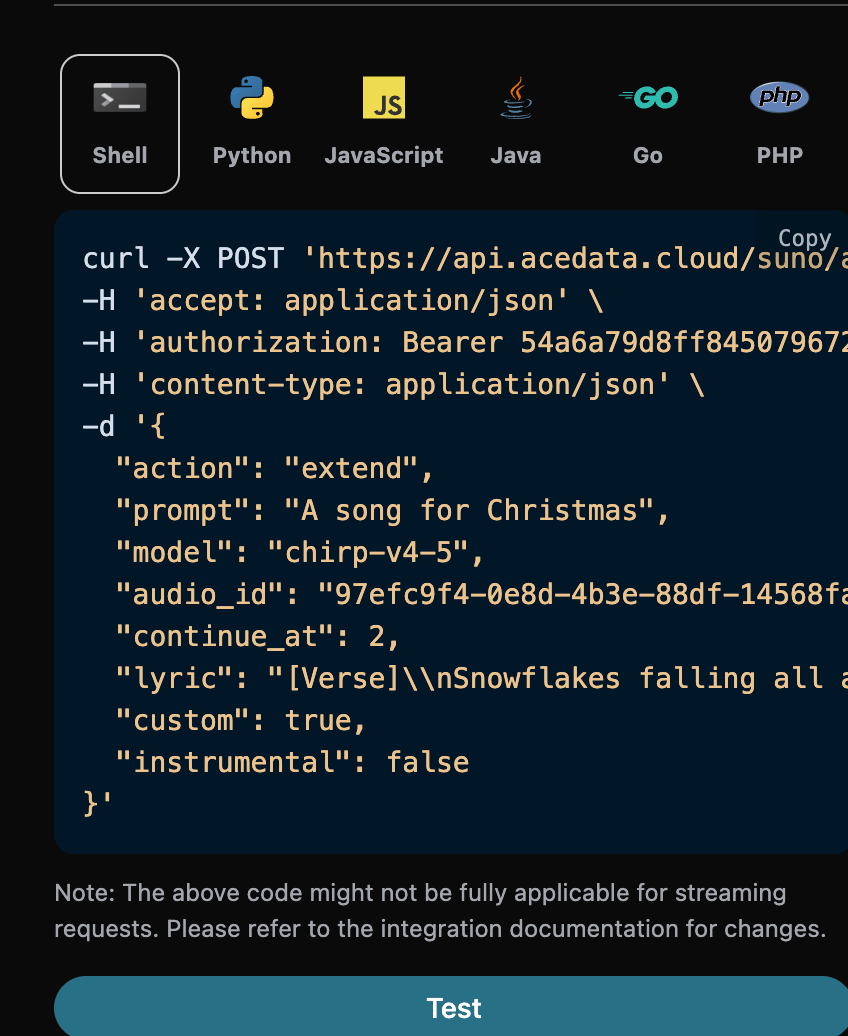
continue_at é de 2 segundos; portanto, apenas os primeiros 2 segundos pertencem ao conteúdo original antes do limite da continuação. Ao continuar próximo ao final da música, esse valor deve ser definido como o segundo esperado para iniciar a continuação, e apenas o novo trecho a ser cantado após o limite deve ser fornecido em lyric.
O código Python correspondente:
lyric no resultado retornará o texto da letra usado nesta tarefa de continuação. Esse campo não é uma transcrição literal do áudio final completo; para extend, o áudio de origem antes de continue_at continua usando a letra original, e a nova letra é usada apenas para orientar o trecho de continuação.
Obter a música completa
O resultado deextend do modelo atual normalmente já inclui o áudio de origem antes de continue_at e o novo conteúdo após o limite; primeiro, determine se já é a música completa com base na duração real e no conteúdo do áudio retornado. Se o retorno for um trecho de continuação independente, ou se for necessário mesclar explicitamente o histórico de várias continuações em uma única música, use então a funcionalidade de concatenação:
- action: o conteúdo é
concat. - audio_id: o ID do último trecho de continuação.
Versão cover da música
Quando uma música é gerada com base em uma música original, o estilo da música retornada pode não ser muito adequado. Se quiser fazer uma versão cover da música gerada anteriormente (também há suporte para músicas personalizadas enviadas), é necessário usar o método de versão cover da música, e então é possível especificar o seguinte conteúdo:- action: o conteúdo é
cover; quando for realizar uma operação de versão cover em música personalizada enviada, deve obrigatoriamente especificar o conteúdo como:upload_cover. - audio_id: o ID da música gerada anteriormente.
Substituir trecho
Quando, após gerar uma música, for necessário realizar uma segunda criação substituindo separadamente um trecho da música, é possível realizar uma operação de substituição em um determinado trecho da música.⚠️ Observação:A descrição dos parâmetros é a seguinte:replace_section_result_modetem como padrãofull_song: o sistema concatena separadamente 2 candidatos recém-gerados e retorna 2 músicas completas. Se forem necessários apenas candidatos de trechos substituídos que ainda não foram concatenados, defina explicitamente comocandidatese, em seguida, selecione um candidato para chamar Concatenação de música.
- action: o conteúdo é
replace_section. - audio_id: o ID da música original (a música-fonte a ser substituída).
- model: modelo de geração de música.
- lyric: a letra completa após a substituição (incluindo o trecho substituído e seu contexto, mantendo-se consistente com o conteúdo em
prompt). - prompt: o novo trecho de letra que precisa ser substituído.
- style: o estilo da música, opcional.
- replace_section_start: o tempo inicial (segundos) do trecho substituído na música original.
- replace_section_end: o tempo final (segundos) do trecho substituído na música original.
- replace_section_result_mode: modo de retorno, cujo padrão é
full_song.full_songconcatena separadamente 2 candidatos e retorna 2 músicas completas;candidatesretorna 2 trechos candidatos que ainda não foram concatenados.
Etapa um: iniciar a tarefa de substituição de trecho
Por exemplo, se o ID da música após a geração original for: 18db7ed0-2b8a-41db-91c1-b0781dcca0d4 (com duração de 94,12 segundos), e você desejar substituir o refrão entre o segundo 30 e o segundo 60 por uma nova letra, então os parâmetros podem ser definidos da seguinte forma:replace_section_result_mode for definido como candidates, serão retornados 2 trechos de substituição ainda não concatenados, com a estrutura consistente com o exemplo abaixo:
candidates, as durações dos dois áudios retornados (45,16 segundos, 33,8 segundos) são muito menores do que a música original (94,12 segundos). Eles são trechos de substituição que incluem uma pequena quantidade de contexto e não são a música completa. É possível selecionar um candidato satisfatório e continuar a concatená-lo manualmente. O modo padrão full_song, por sua vez, concluirá duas concatenações e retornará diretamente 2 músicas completas.
Retornar diretamente músicas completas
Se desejar obter diretamente músicas completas, você pode definirreplace_section_result_mode como full_song na etapa um. A interface concatenará separadamente os dois candidatos e retornará 2 músicas completas; nesse caso, não é necessário chamar concat novamente.
Etapa dois: concatenar o trecho de substituição de volta à música original
Para o trecho selecionado acima (por exemplo,364f9d8b-ca25-463b-9a5e-d0b7139e2d6a), inicie uma tarefa concat conforme o método da seção Concatenação de música:
duration foi restaurado para a duração completa da música (105,28 segundos, aproximadamente igual à duração da música original), e audio_url aponta para a música completa após a substituição. Isso conclui o processo de criação secundária de “gerar → substituir trecho → unir música completa”.
Separação de vocais e música
Quando, após gerar uma música, for necessário realizar uma criação secundária com operações separadas de acompanhamento e vocais, é possível separar o acompanhamento puramente instrumental e os vocais a cappella. É possível especificar o seguinte conteúdo:- action: o conteúdo é
stems. - audio_id: o ID da música gerada anteriormente.
Separação de vocais e música em todas as faixas
Quando, após gerar uma música, for necessário realizar uma operação de separação de vocais e música em todas as faixas, é possível especificar o seguinte conteúdo:- action: o conteúdo é
all_stems. - audio_id: o ID da música gerada anteriormente.
Adicionar faixa de áudio
add_stem gera uma faixa de instrumento ou voz de destino para o áudio especificado, por meio da chamada POST /suno/audios.
- Obrigatórios:
action,audio_id,stem_type. - Opcionais:
model,prompt,title,style,negative_tags,weirdness,style_influence,audio_weight,max_mode,variety. - Cobrança: 0.672 Credits no modo normal; 1.344 Credits quando
max_modefortrue.
Extrair faixa de áudio
extract_stem extrai a faixa de áudio de destino do áudio especificado e, ao mesmo tempo, retorna a versão complementar após a remoção dessa faixa de áudio, por meio da chamada POST /suno/audios.
- Obrigatórios:
action,audio_id,stem_type. - Opcional:
audio_format, o contrato público atual de canal duplo suporta apenasmp3. - Cobrança: 1.12 Credits.
data na resposta em estado final mantém uma lista plana de áudios, e stem_sets representa a relação correspondente entre a faixa de áudio de destino e a faixa de áudio complementar:
Gerar efeitos sonoros
sounds gera efeitos sonoros de uso único ou repetíveis com base em descrições textuais, por meio da chamada POST /suno/audios.
- Obrigatórios:
action,sound,sound_type. - Opcionais:
model,bpm,key,audio_format; atualmente,audio_formatsuporta apenasmp3. sound_type:one-shotouloop.- Cobrança: 0.112 Credits.
Ajustar a velocidade do áudio
adjust_speed ajusta a velocidade de reprodução do áudio especificado, por meio da chamada POST /suno/audios.
- Obrigatório:
action,audio_id,speed_multiplier,title. - Opcional:
keep_pitch. speed_multiplier: intervalo de 0.25–4.- Cobrança: 0.28 Credits.
Parâmetros avançados para geração personalizada
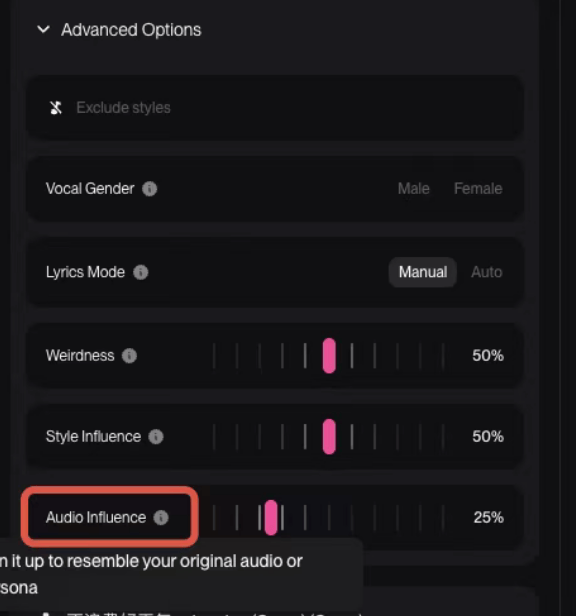
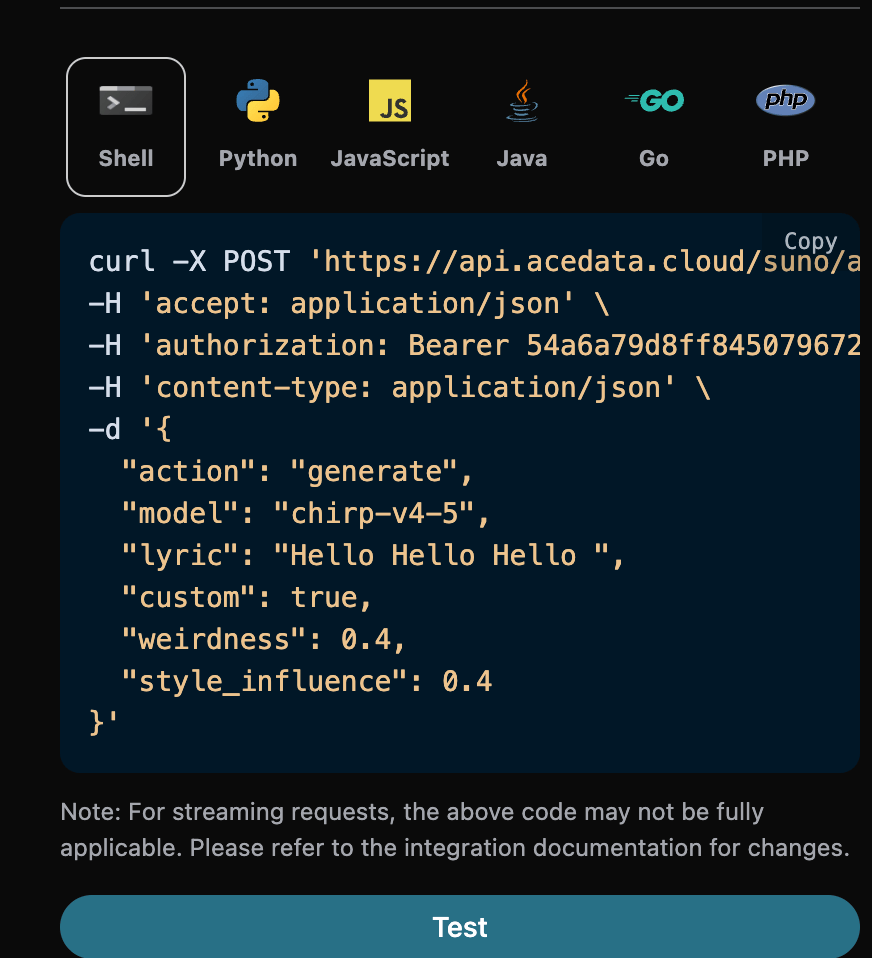
O oficial permite usar os parâmetros avançadosweirdness==>Weirdness, style_influence==>Style Influence, audio_weight==>Audio Influence no modo personalizado para realizar a geração, correspondendo aos seguintes exemplos oficiais:
Controlar a duração da música
Por padrão, a duração da música gerada é determinada pelo próprio modelo, geralmente entre 30 segundos e 4 minutos. Se for necessário um produto final mais longo ou mais curto, é possível especificar a duração desejada por meio do parâmetroduration, em segundos, com valores inteiros entre 10 e 360.
Este parâmetro é usado para a geração de músicas no modo personalizado (custom como true). É necessário destacar que duration é uma indicação de tendência, e não uma restrição rígida: o modelo fará referência a esse valor durante a criação, mas não garante que o atingirá. Em testes reais, a duração efetiva geralmente é significativamente menor que o valor esperado, e as durações das duas músicas retornadas pela mesma solicitação também podem diferir por várias vezes. Mesmo para solicitações completamente idênticas, as durações obtidas após vários envios também podem ter grandes diferenças. Portanto, não o utilize como um controle preciso de duração; se forem necessárias durações fixas para o negócio, corte ou tente novamente por conta própria após obter o produto final.
O código Python correspondente:
duration na solicitação é a duração esperada, enquanto o campo duration de cada música em data na resposta é a duração real daquela música. Os dois possuem o mesmo nome, mas significados diferentes; não é garantido que a duração real seja igual ao valor esperado. O comprimento da letra é um dos principais fatores que afetam a duração do produto final; se for necessário um produto final mais longo, recomenda-se também fornecer letras mais completas.
A interface validará que duration deve ser um número inteiro entre 10 e 360; ele ainda é apenas um objetivo de geração, não uma garantia da duração do produto final.
Funcionalidade Add Instrumental
Em agosto de 2025, o Suno lançou a funcionalidade Add Instrumental. Primeiro, é necessário enviar uma música a cappella sem acompanhamento para que o Suno adicione a música. Primeiro, você pode acessar a Suno Upload API para enviar uma música a cappella sem acompanhamento; a operação correspondente é mostrada na imagem abaixo: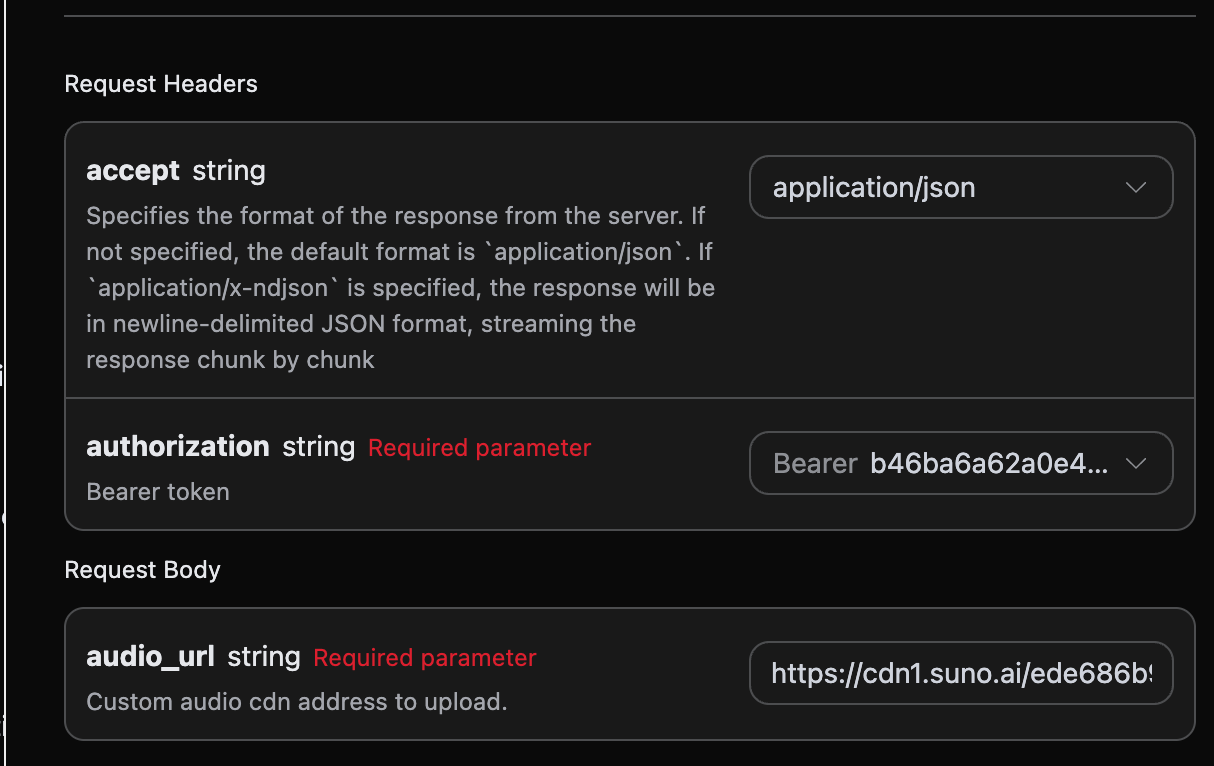
audio_id após o envio; o resultado específico é mostrado na imagem abaixo:
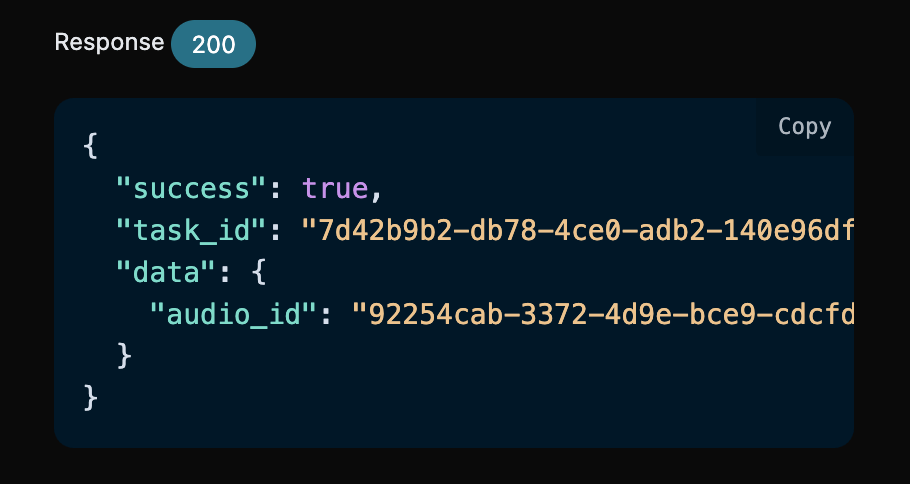
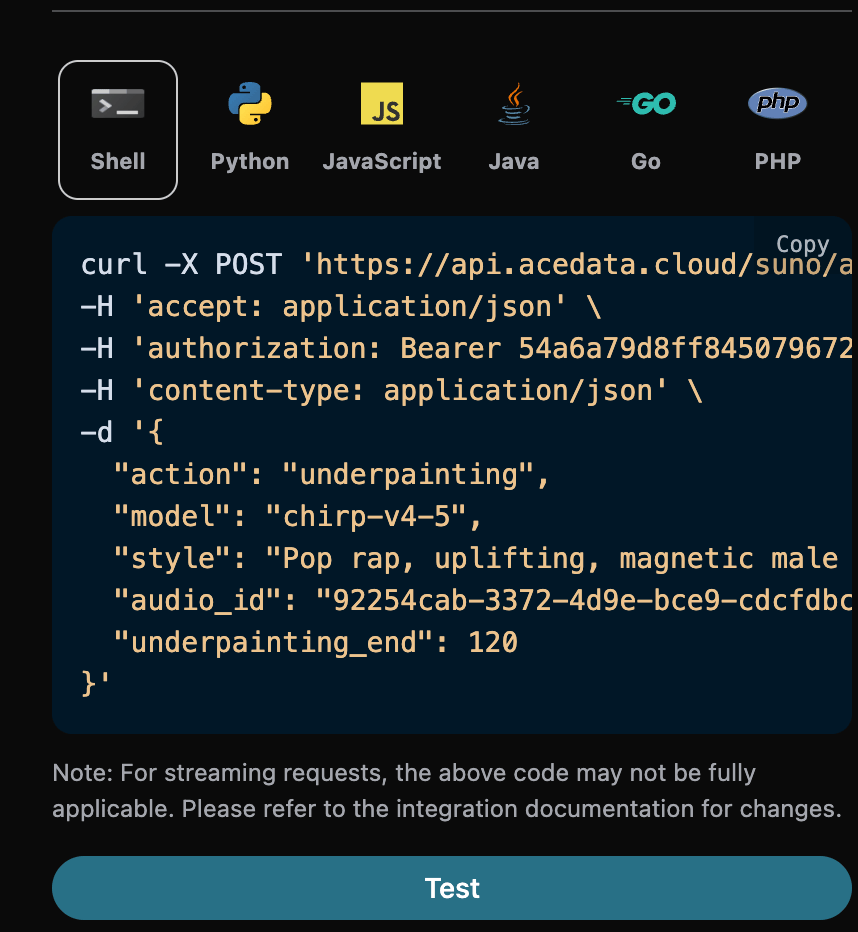
audio_id: 92254cab-3372-4d9e-bce9-cdcfdbc39070. Em seguida, também precisamos preencher os seguintes parâmetros:
- action: o conteúdo é
underpainting. - underpainting_start: o horário de início para adicionar acompanhamento à música enviada; o valor padrão é 0.
- underpainting_end: o horário de término para adicionar acompanhamento à música enviada; deve ser menor que a duração total da música.
- audio_id: o ID da música a cappella sem acompanhamento enviada.
- style: o estilo do acompanhamento; é melhor não usar letras, afinal é para o acompanhamento.
Funcionalidade Add Vocals
Em agosto de 2025, o Suno lançou a funcionalidade Add Vocals. Primeiro, é necessário enviar uma música puramente instrumental para que o Suno escreva a letra e gere vocais cantados. Primeiro, você pode acessar a Suno Upload API para enviar uma música a cappella sem acompanhamento; a operação correspondente é mostrada na imagem abaixo:
audio_id após o envio; o resultado específico é mostrado na imagem abaixo:
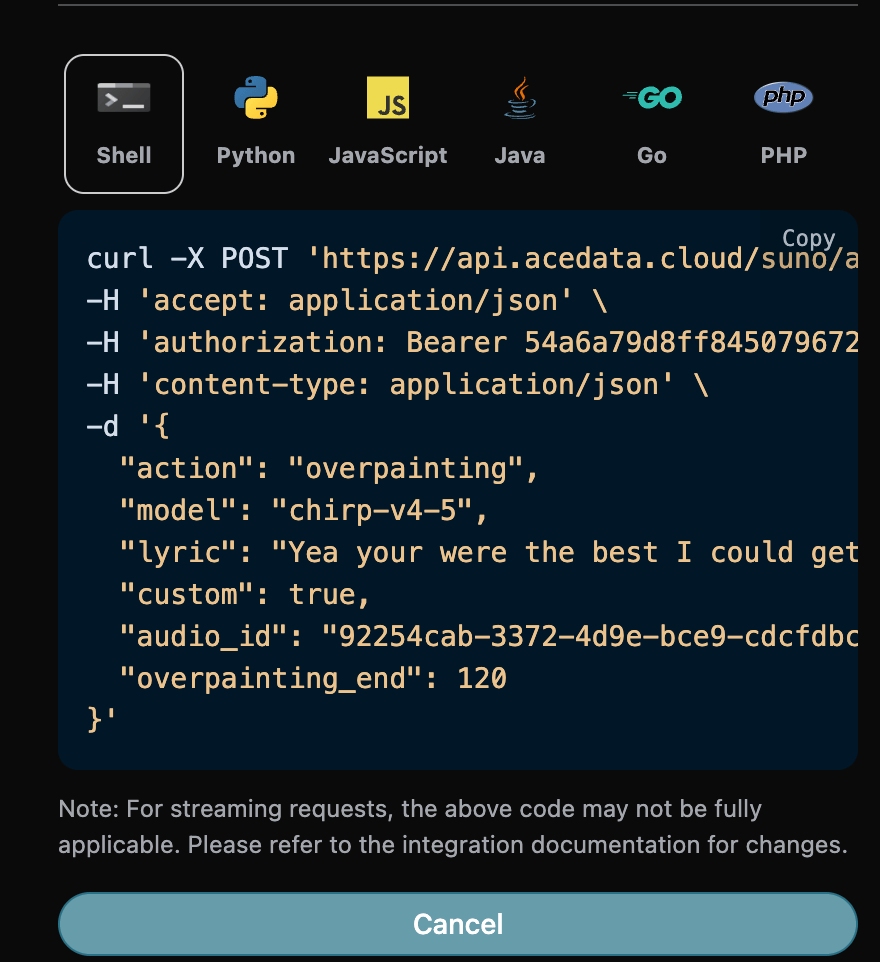
audio_id: 92254cab-3372-4d9e-bce9-cdcfdbc39070. Em seguida, também precisamos preencher os seguintes parâmetros:
- action: o conteúdo é
overpainting. - overpainting_start: o horário de início para adicionar vocais à música enviada; o valor padrão é 0.
- overpainting_end: o horário de término para adicionar vocais à música enviada; deve ser menor que a duração total da música.
- audio_id: o ID da música a cappella sem acompanhamento enviada.
- custom: neste modo, é obrigatório usar o modo personalizado para inserir a letra.
- lyric: a letra preenchida no modo personalizado.
- style: o estilo do acompanhamento.
Funcionalidade Remaster
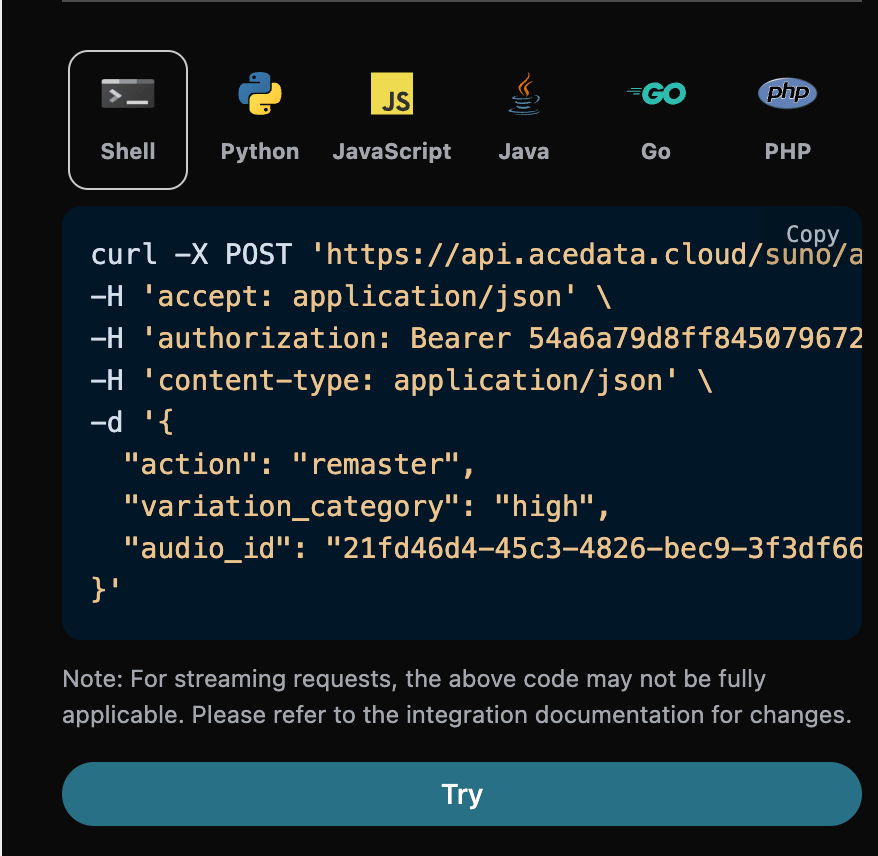
Em dezembro de 2025, o suno lançou a funcionalidade Remaster. Essa funcionalidade pode gerar novamente músicas, não sendo possível entre contas, e então também precisamos preencher os seguintes parâmetros:- action: o conteúdo é
remaster. - audio_id: o ID da música que precisa ser gerada novamente.
- model: suporta apenas v4.5+ e v5.
- variation_category: compatível apenas com versões v5 ou superiores, e possui apenas 3 valores: high, normal, subtle.
Funcionalidade de geração de mixagem Mashup
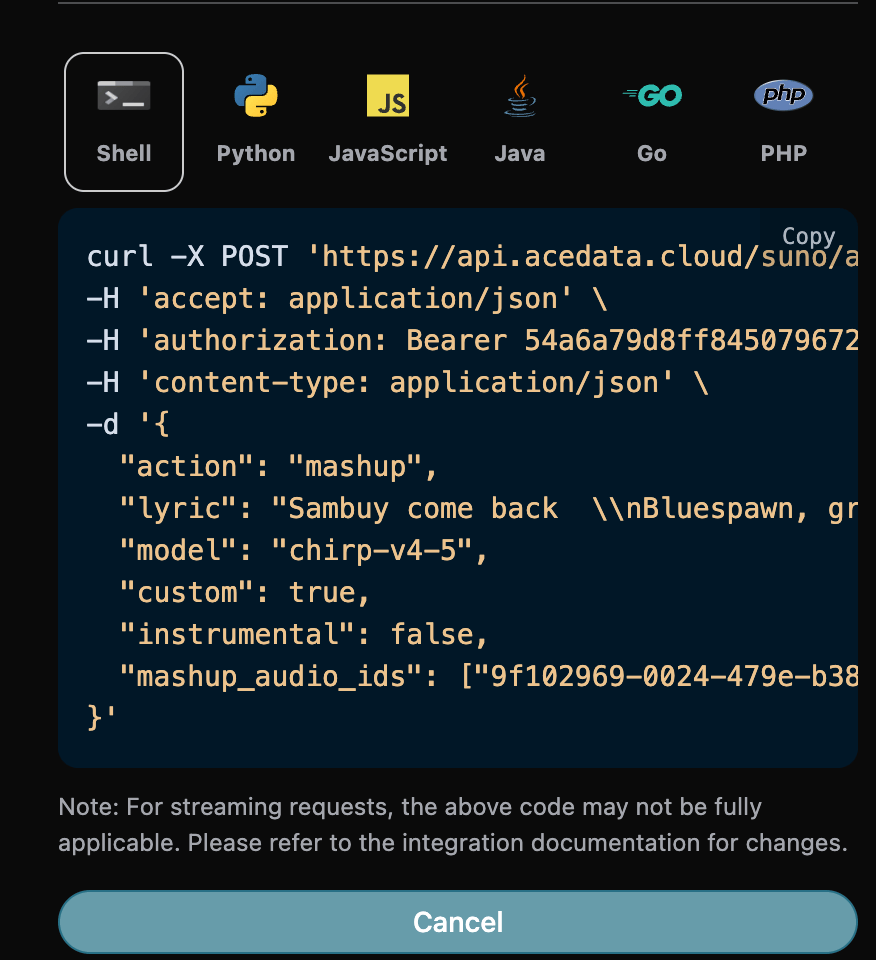
Em dezembro de 2025, o suno lançou a funcionalidade Mashup. Essa funcionalidade pode gerar músicas com base em duas músicas de referência, e então também precisamos preencher os seguintes parâmetros:- action: o conteúdo é
mashup. - mashup_audio_ids: os IDs das duas músicas de referência. Após o preenchimento, o código a seguir foi gerado automaticamente:
Samples Geração de músicas por amostragem
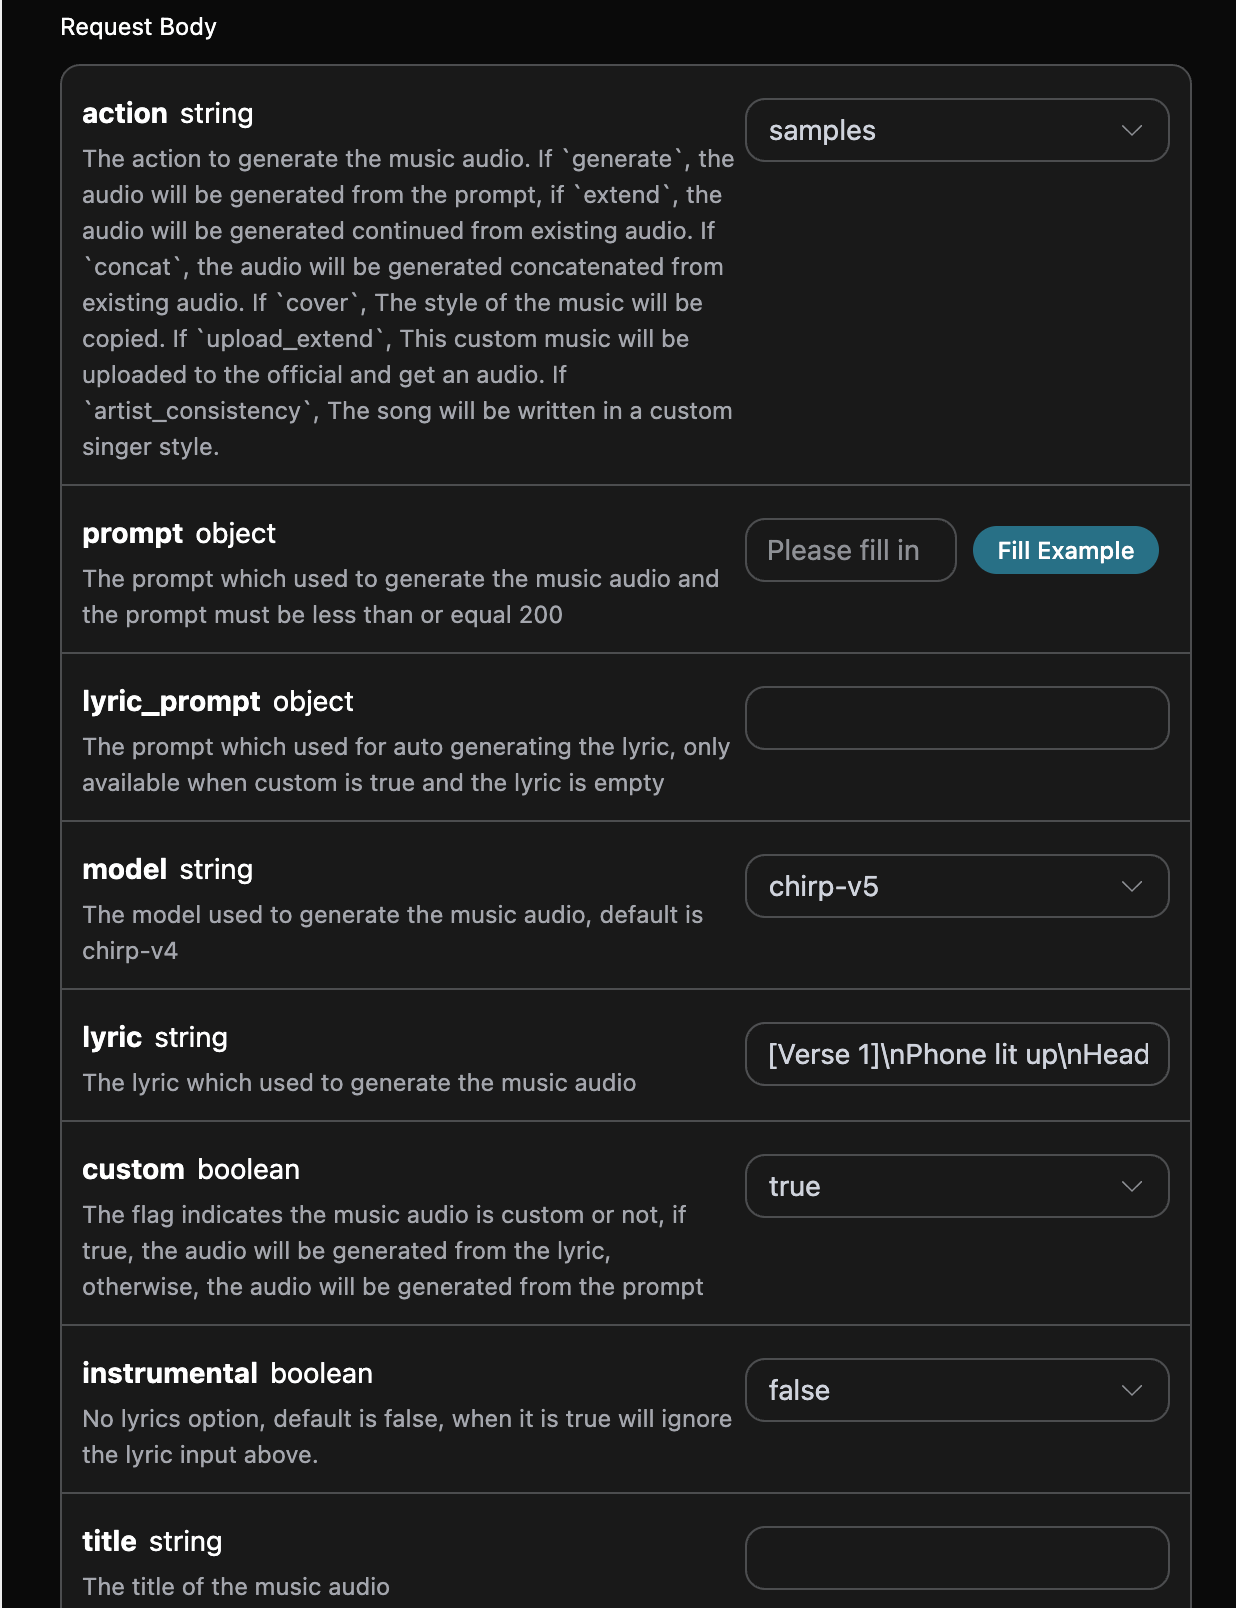
Aqui,samples refere-se à amostragem de um intervalo de áudio único: selecione os horários de início e término em um áudio existente e use esse trecho como material de amostragem para criação. Isso é diferente da função de criação por inspiração Inspo, que utiliza de 1 a 4 áudios de referência completos, mencionada abaixo. É necessário preencher os seguintes parâmetros:
- action: o conteúdo é
samples. - samples_start: horário de início da amostragem.
- samples_end: horário de término da amostragem.
- audio_id: o ID da música de referência que precisa ser amostrada.
Funcionalidade de criação por inspiração Inspo
A funcionalidade de criação por inspiração Inspo pode gerar novas músicas com base em 1 a 4 áudios de referência completos, oferecendo suporte para arrastar e soltar ou enviar áudios como fonte de inspiração. A API usa a actioninspo existente: o cliente fornece URLs de áudio acessíveis publicamente, e o serviço conclui automaticamente a preparação dos áudios de referência e a criação, sem que o cliente precise ler separadamente letras, estilo ou duração e depois montar a solicitação. Ela é diferente da amostragem de intervalo descrita acima e também diferente do Cover que replica o estilo da música original. Ao usar, é necessário preencher os seguintes parâmetros:
- action:o conteúdo é
inspo。 - audio_urls:lista de URLs dos áudios de referência; é necessário fornecer de 1 a 4 endereços de áudio acessíveis publicamente。
- model:o modelo utilizado; recomenda-se
chirp-v6。 - prompt:letras ou texto de sugestão criativa (opcional)。
Observação:os áudios de referência devem ser arquivos de áudio acessíveis publicamente. Se o áudio de referência corresponder exatamente a uma gravação conhecida no catálogo da plataforma, o Suno poderá recusar a geração devido à verificação de direitos autorais; recomenda-se usar áudios próprios ou gerados pelo Suno como fonte de inspiração。O código Python correspondente:
chirp-v5 daquela época, enquanto o exemplo de solicitação atual recomenda o chirp-v6; a estrutura de retorno é a mesma:
Retorno de chamada assíncrono
Como o Suno leva relativamente muito tempo para gerar música, cerca de 1 a 2 minutos, se a API ficar sem resposta por muito tempo, a solicitação HTTP permanecerá conectada, resultando em consumo adicional de recursos do sistema; portanto, esta API também fornece suporte para retornos de chamada assíncronos. O processo geral é: quando o cliente inicia uma solicitação, ele especifica adicionalmente um campocallback_url; após o cliente iniciar a solicitação à API, a API retornará imediatamente um resultado, contendo um campo task_id, que representa o ID da tarefa atual. Quando a tarefa for concluída, o resultado da geração de música será enviado em formato POST JSON para o callback_url especificado pelo cliente, que também inclui o campo task_id, para que os resultados da tarefa possam ser associados por meio do ID.
A seguir, vamos entender como operar especificamente por meio de um exemplo.
Primeiro, o retorno de chamada Webhook é um serviço que pode receber solicitações HTTP, e o desenvolvedor deve substituí-lo pela URL do servidor HTTP criado por ele mesmo. Aqui, para facilitar a demonstração, é usado um site público de exemplo de Webhook https://webhook.site/; ao abrir esse site, é possível obter uma URL de Webhook, como mostrado na imagem:
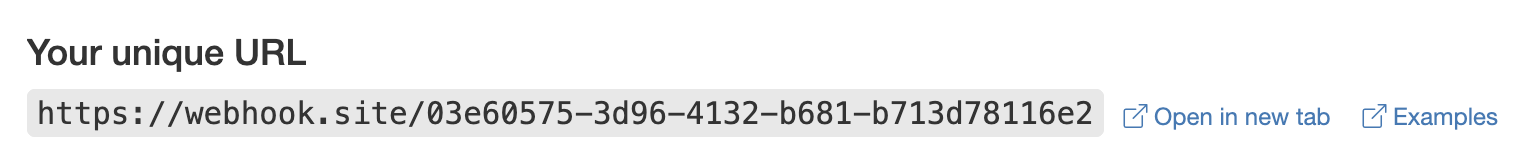 Copie esta URL, e ela poderá ser usada como Webhook; o exemplo aqui é https://webhook.site/03e60575-3d96-4132-b681-b713d78116e2。
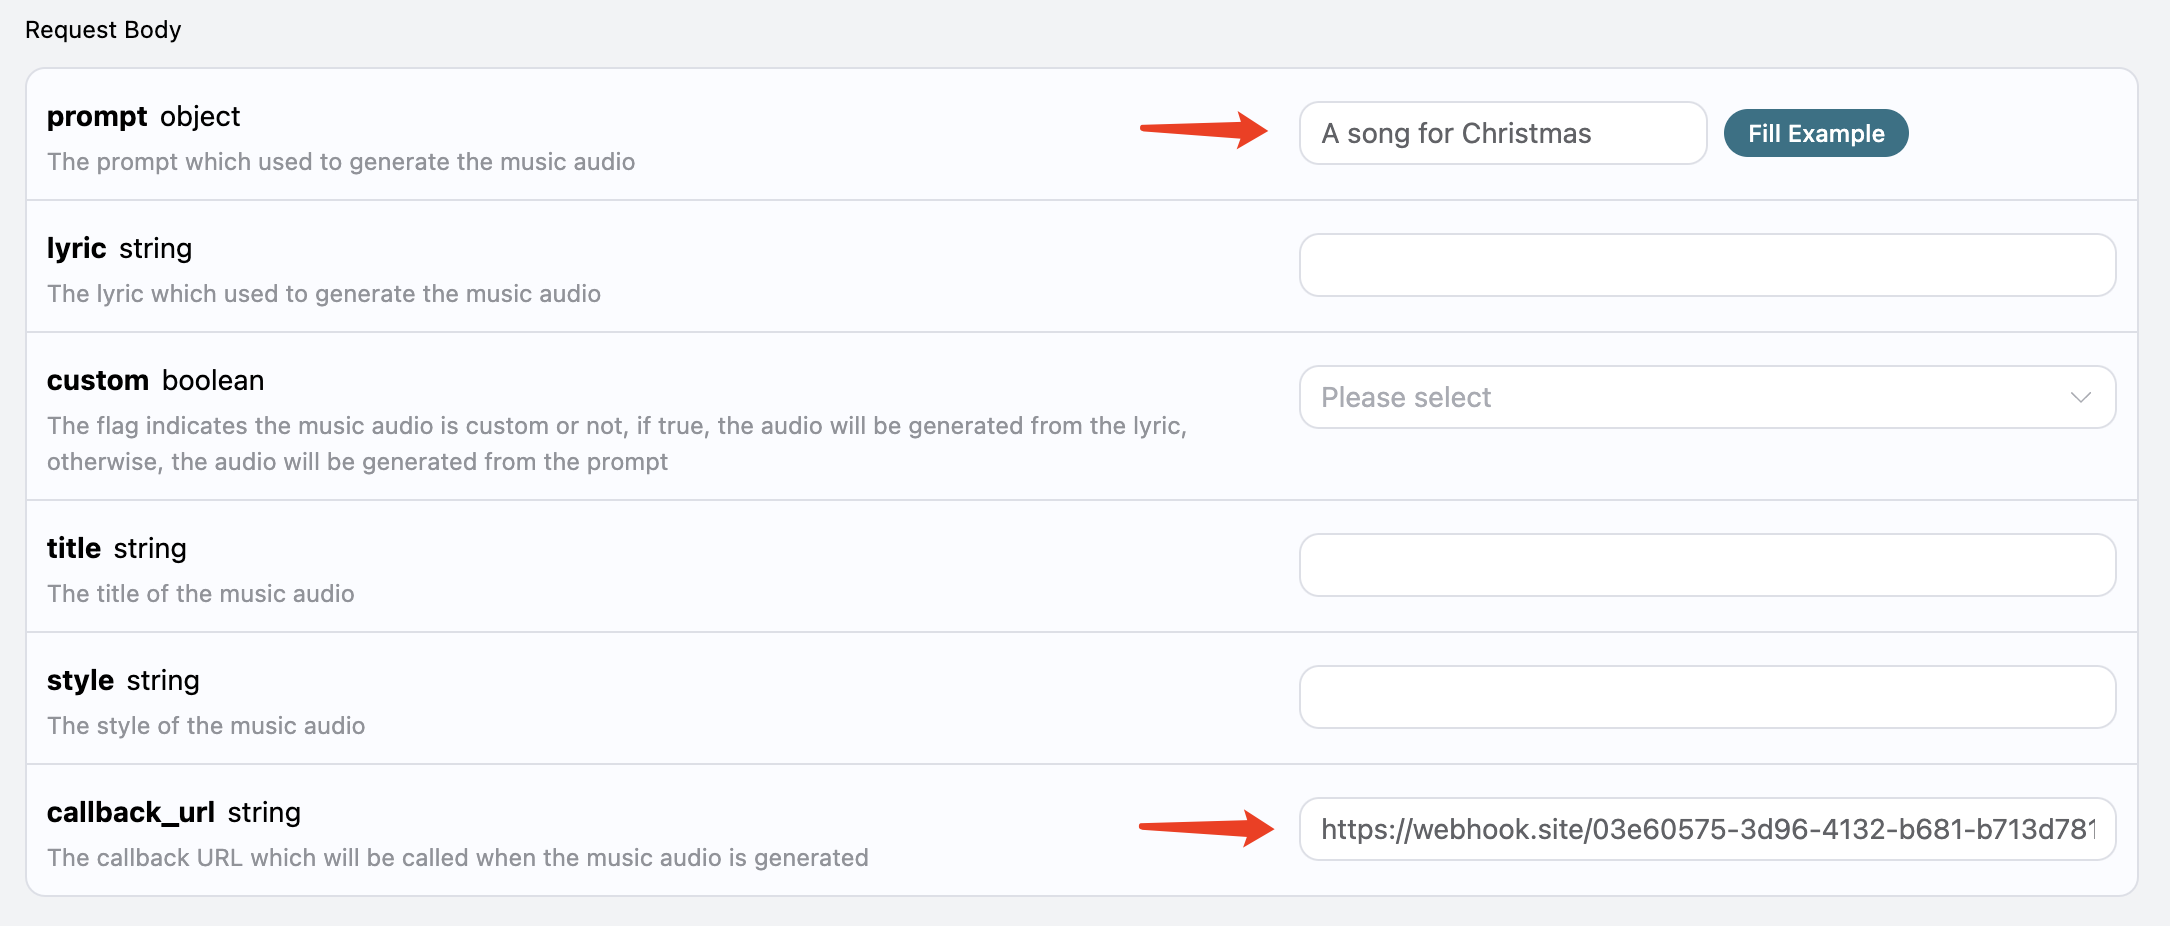
Em seguida, podemos definir o campo
callback_url como a URL de Webhook acima e, ao mesmo tempo, preencher prompt, como mostrado na imagem:
 Clique em executar, e será possível ver que um resultado será obtido imediatamente, conforme abaixo:
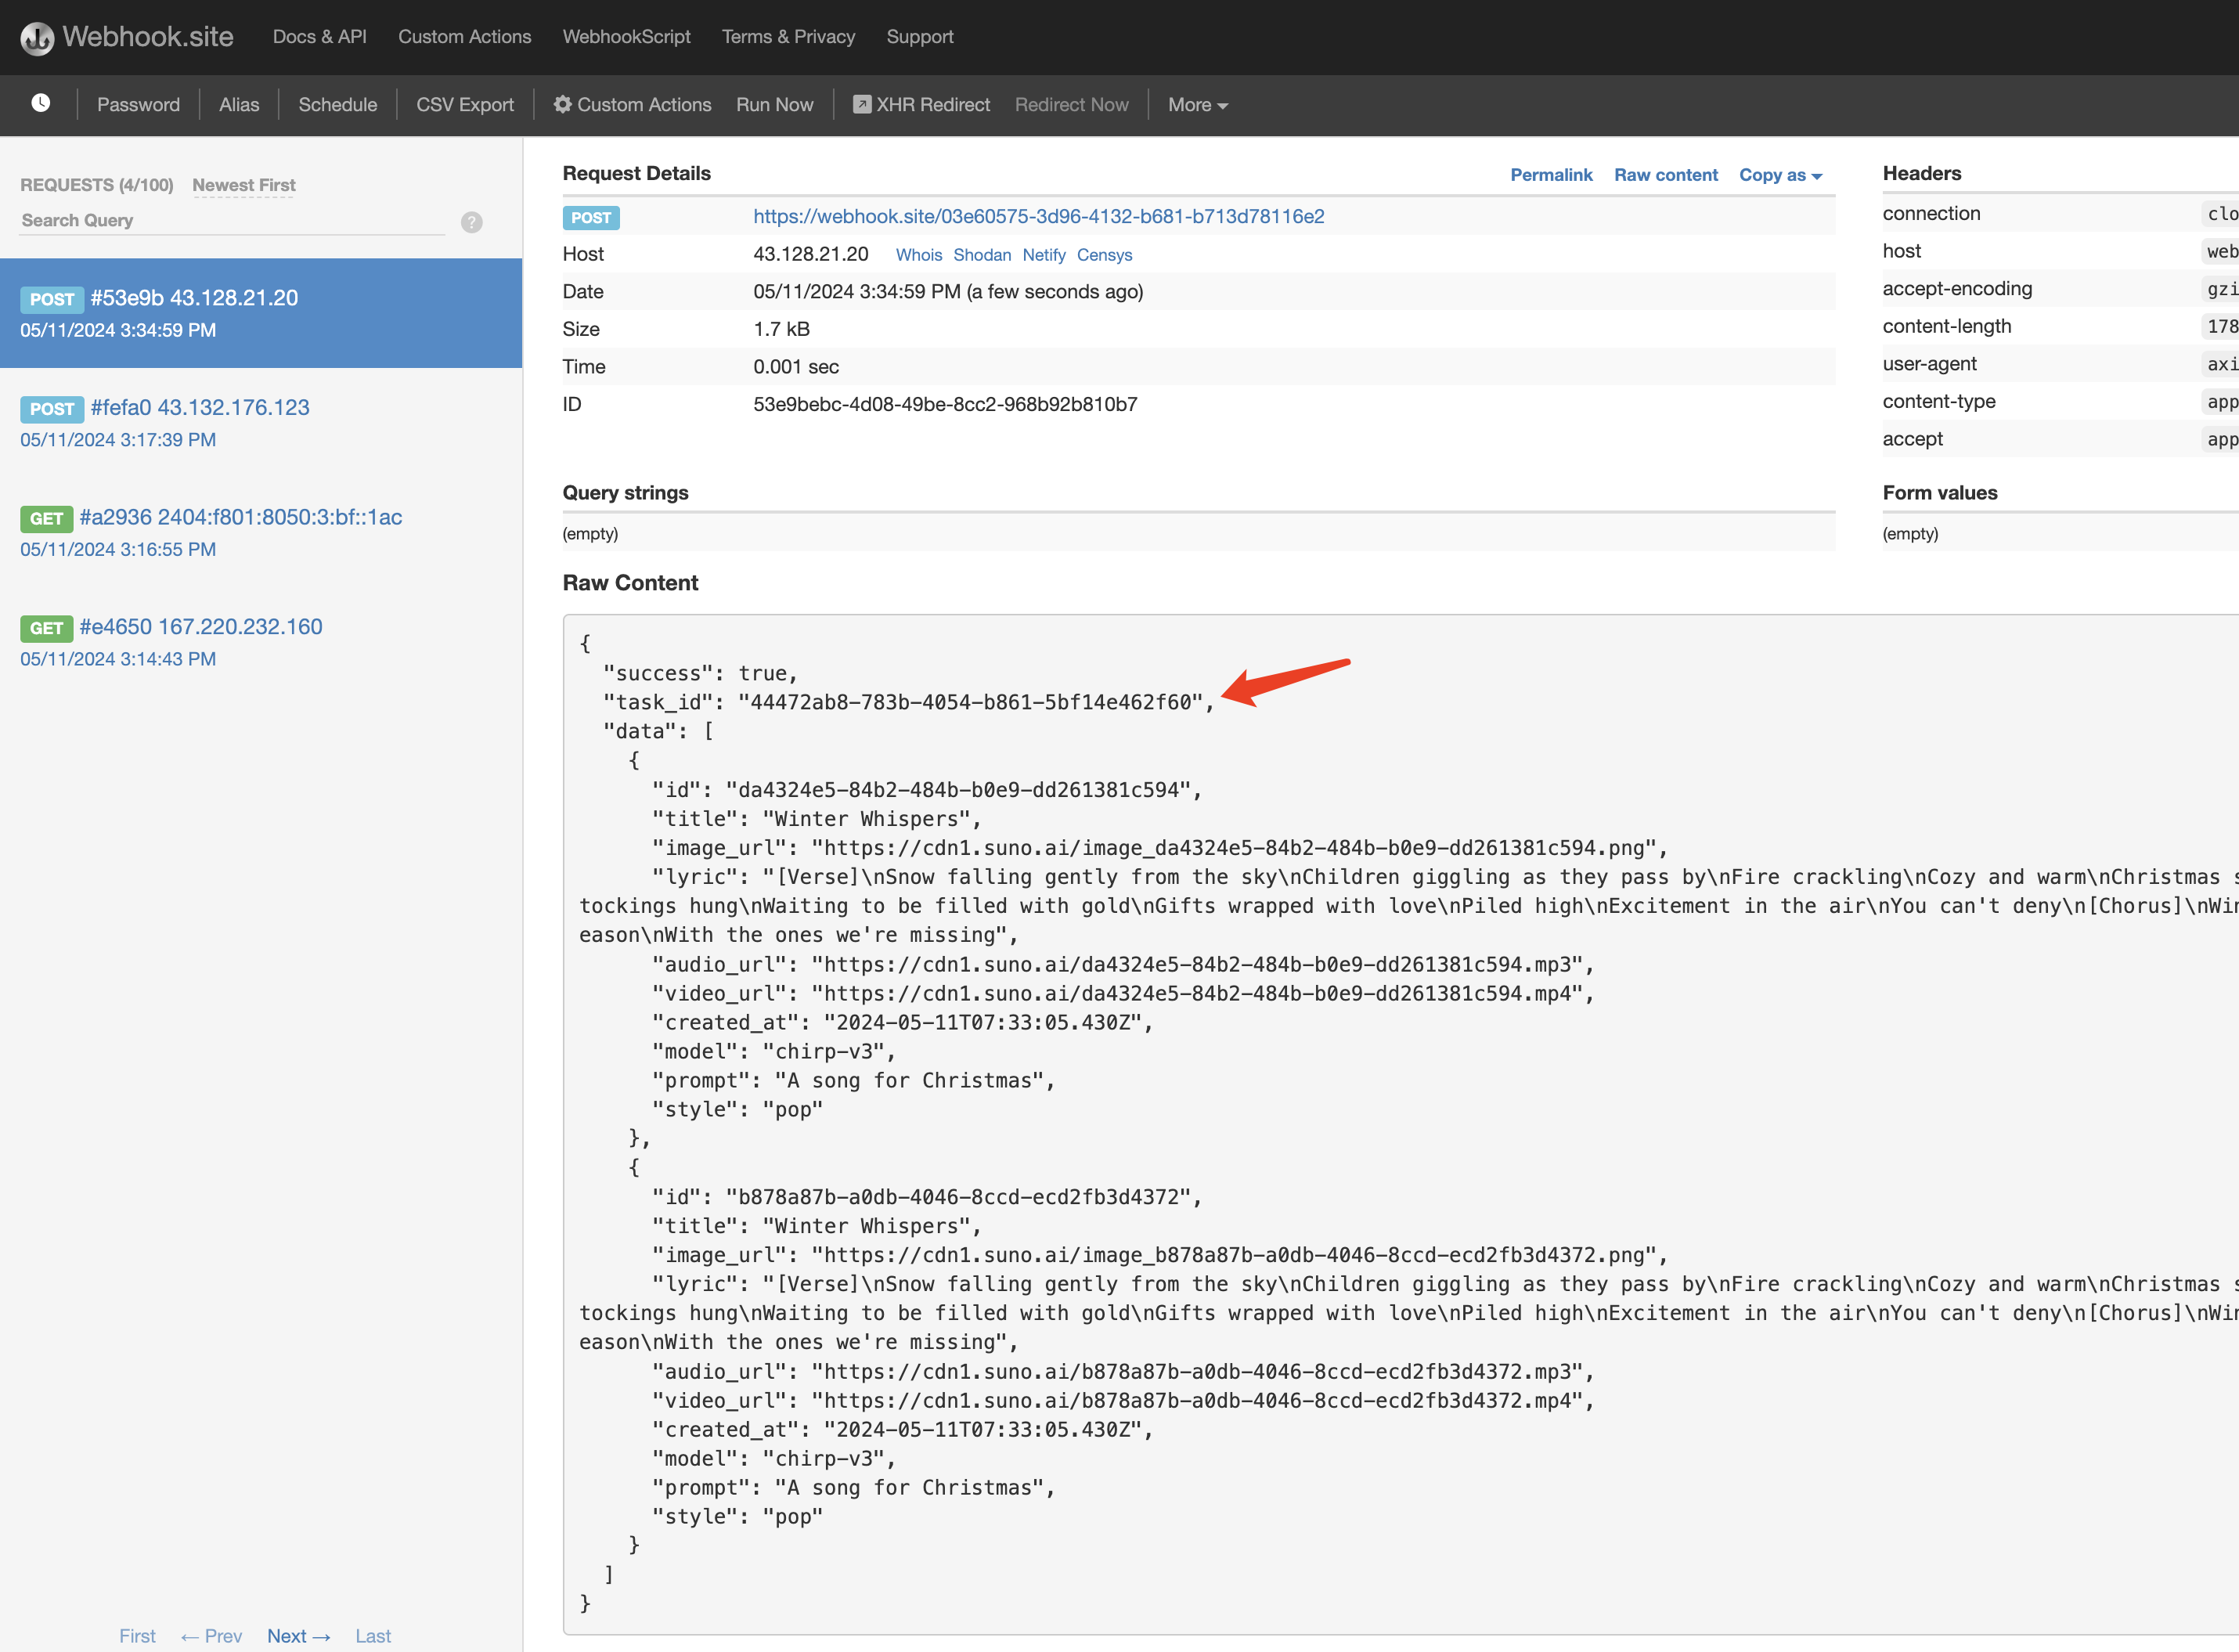 O conteúdo é o seguinte:
task_id no resultado, e os outros campos são semelhantes aos descritos acima; por meio desse campo, é possível realizar a associação da tarefa.
É claro que também podemos obter o resultado por meio de chamada em streaming; basta definir o valor de accept no cabeçalho da solicitação como application/x-ndjson. A seguir, usaremos uma entrada de exemplo como demonstração:
task_id; acima, apenas a primeira e a última das respostas reais foram mantidas, com as atualizações intermediárias repetidas omitidas.
Tratamento de erros
Se ocorrer um erro, você receberá uma mensagem de erro semelhante à seguinte:error.code, error.message:
Observação: os limites e as mensagens de erro de diferentes contas upstream podem variar. Normalmente,chirp-v3-5/chirp-v4têm um limite menor parastyle(200), enquantochirp-v4-5e versões posteriores geralmente suportam até 1000; ao atingir um upstream antigo, podem aparecer mensagens de compatibilidade comoTags muito longas.oustyle deve ser menor ou igual a 120. | Código de Status |error.code|error.message| | ----------- | ------------- | --------------------------------------------------------------- | | 400 |bad_request|O id da música não existe ou foi removido.| | 400 |bad_request|Prompt muito longo.| | 400 |bad_request|Tags muito longas.| | 400 |bad_request|O áudio enviado corresponde a uma obra de arte existente.| | 400 |bad_request|instrumental deve ser um booleano| | 400 |bad_request|Título muito longo.| | 400 |bad_request|Tópico muito longo.| | 400 |bad_request|style deve ser menor ou igual a 120| | 400 |bad_request|custom deve ser um booleano| | 400 |bad_request|audio_id é obrigatório ao estender áudio| | 400 |bad_request|continue_at é obrigatório ao estender áudio| | 400 |bad_request|continue_at deve ser um número maior que 0| | 400 |bad_request|lyric é obrigatório ao estender áudio e instrumental é falso| | 400 |bad_request|prompt é obrigatório ao gerar áudio| | 400 |bad_request|lyric é obrigatório ao gerar áudio personalizado| | 403 |forbidden|Prompt provavelmente malformado| | 403 |forbidden|Prompt provavelmente protegido por direitos autorais| | 403 |forbidden|Prompt continha material impróprio| | 403 |forbidden|Descrição da música sinalizada para moderação| | 403 |forbidden|Descrição da música continha nome de artista| | 403 |forbidden|Tags continham nome de artista| | 403 |forbidden|Letras continham material protegido por direitos autorais| | 403 |forbidden|Descrição da música continha tag de produtor| | 403 |forbidden|Erro genérico do openAI| | 403 |forbidden|Prompt sinalizado para moderação| | 500 |api_error|Não foi possível gerar letras a partir da descrição da música| | 500 |api_error|a tarefa falhou com erro desconhecido| | 500 |api_error|nenhum worker disponível no sistema| | 500 |api_error|serviço em manutenção, geração pausada| | 504 |timeout|tempo esgotado enquanto aguardava a geração de áudio|