

LimitySuno obsługuje obecnielyricistylew powyższej tabeli są górnymi limitami w trybie niestandardowym (customma wartośćtrue). W nieniestandardowym trybie inspiracji (customma wartośćfalse) należy wypełnić tylkoprompt, którego maksymalna długość wynosi 500 znaków (taka sama dla wszystkich modeli).
chirp-v6, chirp-v6-wild i chirp-v6-mini. Zaleca się używanie chirp-v6; nazwy starszych modeli są nadal kompatybilne.
Jednak Suno oficjalnie nie udostępnia API. AceDataCloud oferuje zestaw API Suno, który symuluje integrację z oficjalnym Suno i umożliwia wygodne oraz szybkie generowanie wybranej muzyki.
Aplikowanie i korzystanie
Aby korzystać z Suno Audios Generation API, najpierw przejdź do konsoli Ace Data Cloud, aby uzyskać swój API Token i zachowaj go na później. Jeśli nie jesteś jeszcze zalogowany ani zarejestrowany, nastąpi automatyczne przekierowanie na stronę logowania z zaproszeniem do rejestracji i logowania. Po zakończeniu automatycznie wrócisz na bieżącą stronę.
Jeden API Token pozwala wywoływać wszystkie usługi platformy, bez potrzeby osobnego aplikowania dla każdej usługi. Przy pierwszym zgłoszeniu otrzymasz bezpłatny limit, aby móc korzystać z bezpłatnej wersji próbnej; gdy limit będzie niewystarczający, możesz doładować uniwersalne saldo w konsoli.
📘 Pełna dokumentacja: Suno Audios Generation API →
Podstawowe użycie
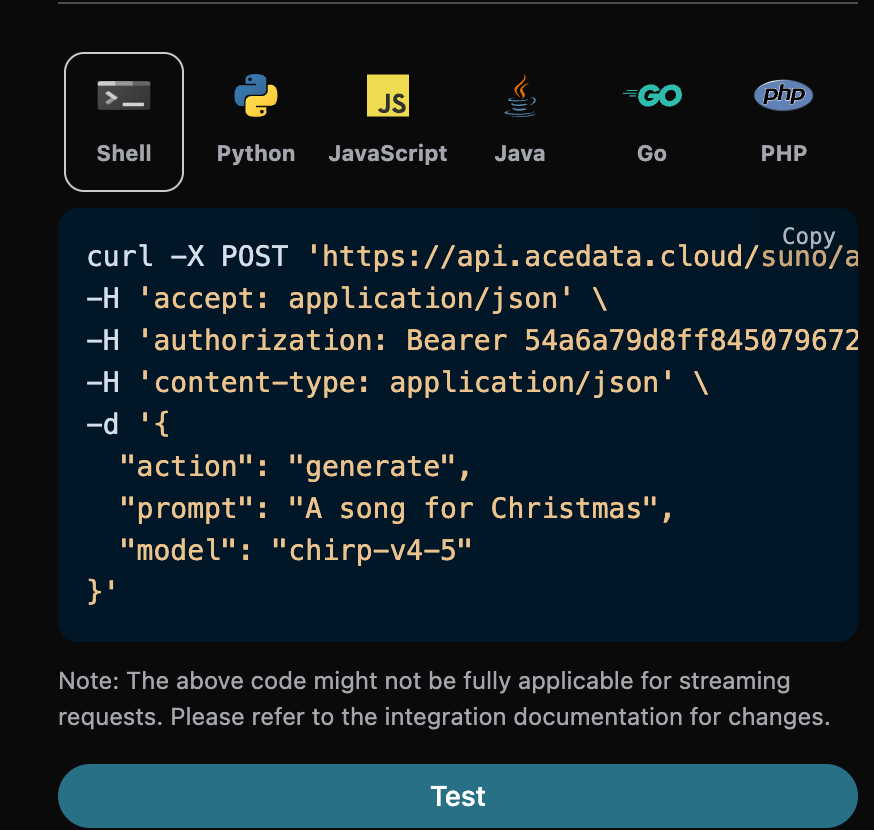
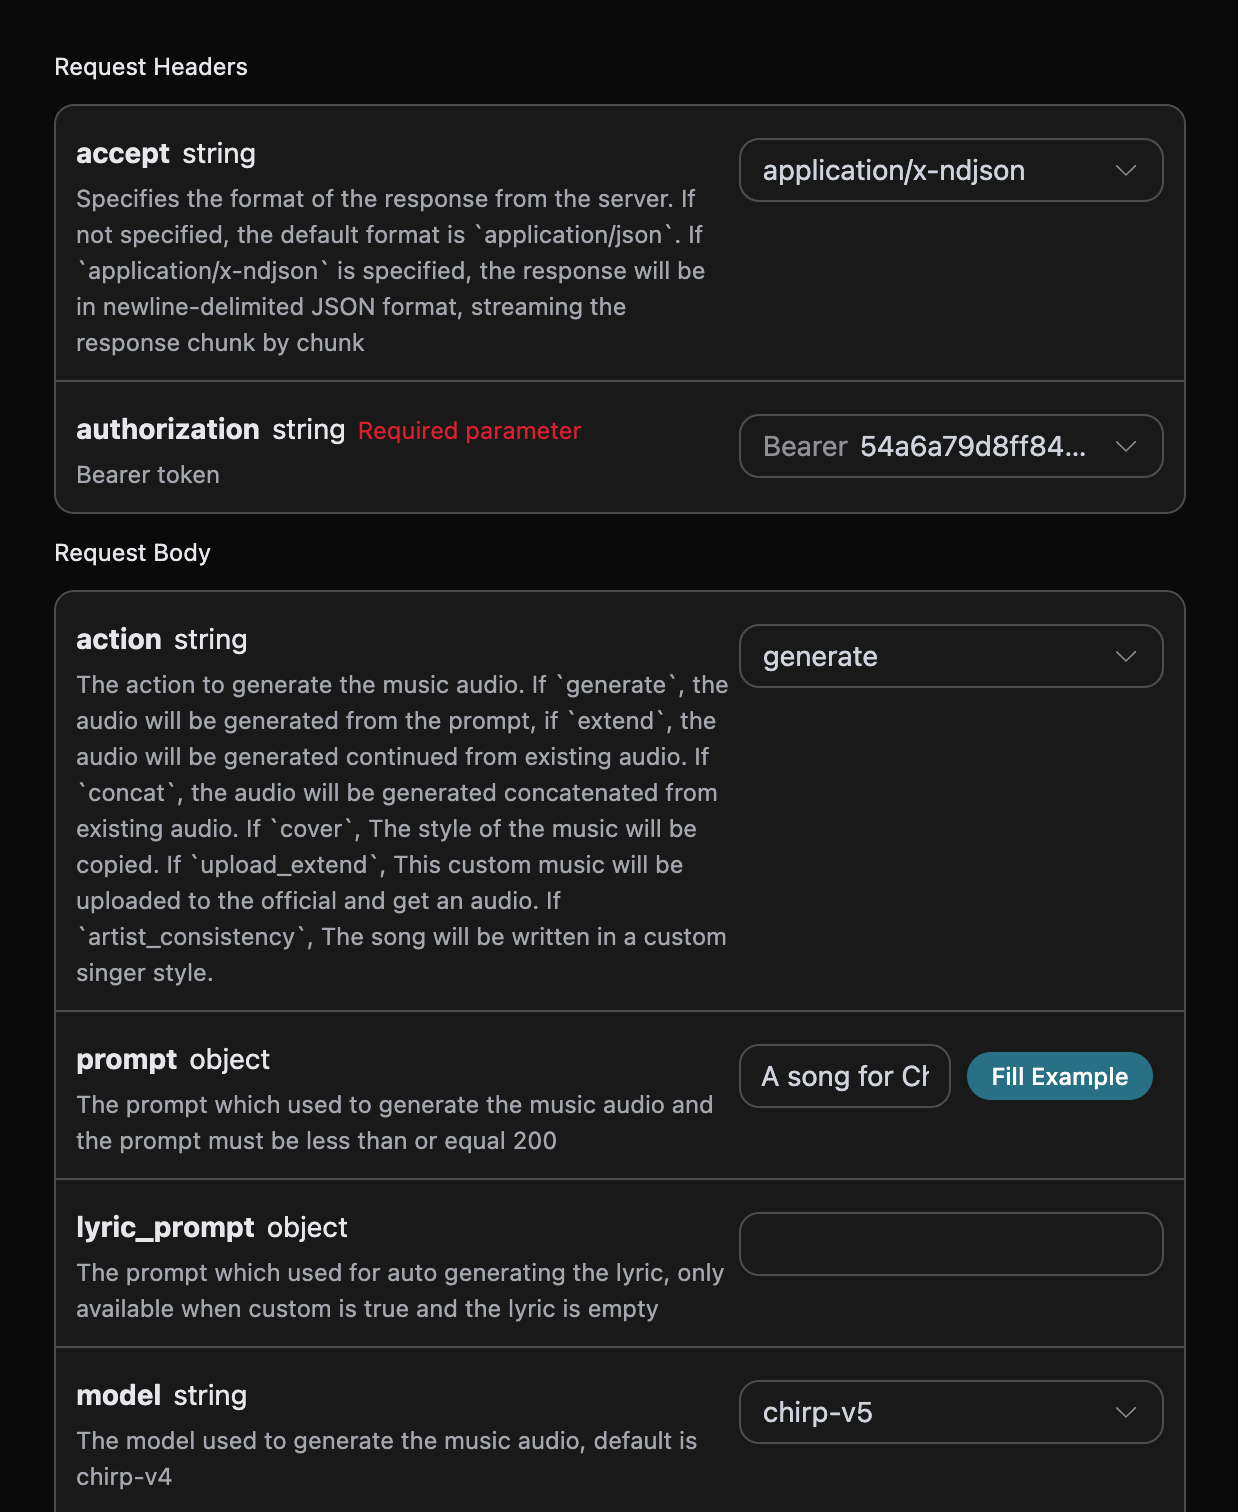
Jakie piosenki chcesz, możesz dowolnie wprowadzić fragment tekstu. Na przykład, jeśli chcę wygenerować piosenkę o Bożym Narodzeniu, mogę wprowadzića song for Christmas, jak pokazano na ilustracji:
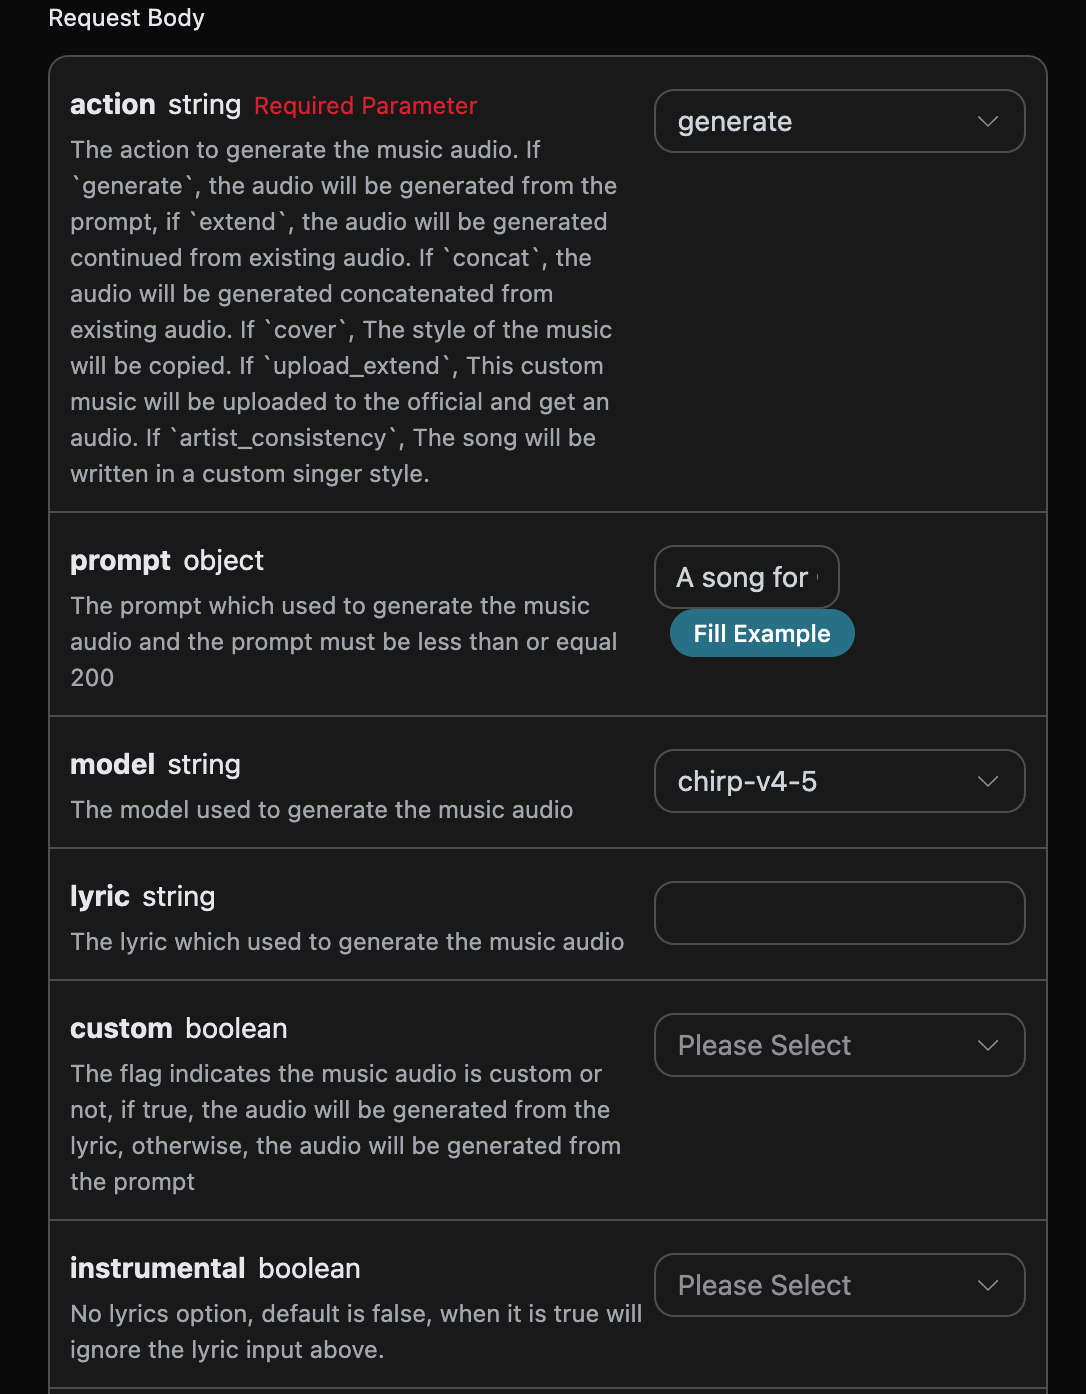
accept: jaki format odpowiedzi chcesz otrzymać; tutaj wpiszapplication/json, czyli format JSON.authorization: klucz do wywoływania API, który po aplikowaniu można bezpośrednio wybrać z listy rozwijanej.
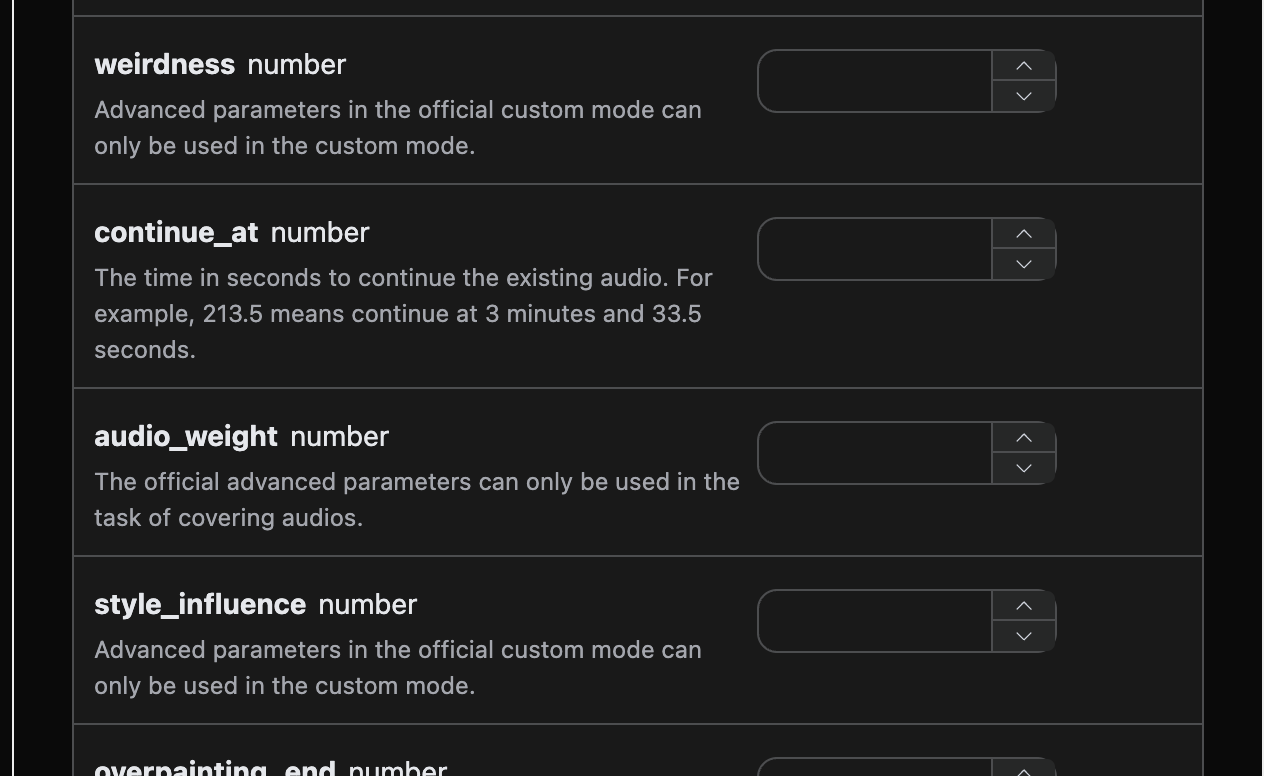
action: typ zadania audio, domyślniegenerate. Obsługuje operacje takie jak generowanie, kontynuacja, cover, łączenie, rozdzielanie ścieżek, dodawanie ścieżek audio, wyodrębnianie wskazanych ścieżek audio, generowanie efektów dźwiękowych i dostosowywanie prędkości itd.; wszystkie są wywoływane jednolicie przezPOST /suno/audios.prompt: podpowiedź trybu inspiracji Suno Official (obowiązuje, gdycustomma wartośćfalse), maksymalnie 500 znaków.model: model dla tego zadania generowania muzyki. Seria v6 obejmujechirp-v6,chirp-v6-wildichirp-v6-mini; nazwy starszych modeli są nadal kompatybilne.max_mode: ulepszony tryb generowania.generatejest włączany tylko wtedy, gdy zarównocustom, jak imax_modemają wartośćtrue, a koszt wynosi 1.12 Credits;add_stemmożna włączyć bezpośrednio, a koszt wynosi 1.344 Credits. Gdy jest wyłączony lub pominięty, koszty wynoszą odpowiednio 0.56 i 0.672 Credits.variety: intensywność różnorodności wyników generowania, opcje tooff,normal,high,extra,max. Używane tylko dlagenerateiadd_stem; przekazanie dla innych action zwróci 400.lyric: treść tekstu piosenki w niestandardowym trybie Suno Official. Maksymalnie 3000 znaków dlachirp-v3-5ichirp-v4; maksymalnie 5000 znaków dlachirp-v4-5i wyższych (w tymchirp-v5,chirp-v5-5).custom: czy używać trybu niestandardowego, domyślnie:false.instrumental: opcja muzyki instrumentalnej w trybie inspiracji Suno Official.title: tytuł utworu w niestandardowym trybie Suno Official. Maksymalnie 80 znaków dlachirp-v3-5,chirp-v4; maksymalnie 100 znaków dlachirp-v4-5i wyższych.style: styl muzyczny w niestandardowym trybie Suno Official. Maksymalnie 200 znaków dlachirp-v3-5ichirp-v4; maksymalnie 1000 znaków dlachirp-v4-5i wyższych (w tymchirp-v5,chirp-v5-5).negative_tags: style muzyczne lub gatunki, które mają zostać wykluczone z wyników generowania w trybie niestandardowym (gdycustomma wartośćtrue).audio_weight: waga wpływu cech audio lub głosu, w zakresie 0-1;0również jest prawidłową wartością. Może być używana w operacjach generowania, kontynuacji, coveru, dodawania ścieżek audio i spójności głosu itd.; gdy nie ma referencyjnego audio ani cech głosu, model może osłabić lub zignorować tę wartość.audio_id: ID muzyki referencyjnej.overpainting_start/overpainting_end: czas rozpoczęcia i zakończenia dodawania wokalu do istniejącej muzyki instrumentalnej, w sekundach.underpainting_start/underpainting_end: czas rozpoczęcia i zakończenia dodawania akompaniamentu do śpiewu a cappella, w sekundach.persona_id: ID utworu artysty.continue_at: granica kontynuacji, w sekundach. Na przykład 213.5 oznacza rozpoczęcie generowania kolejnego fragmentu od 3 minuty i 33.5 sekundy.lyricistylekierują tylko nową treścią po granicy i nie zastępują tekstu ani śpiewu przed granicą w źródłowym audio.style_influence: wpływ stylu w trybie niestandardowym, w zakresie 0-1; większa wartość zazwyczaj lepiej dopasowuje do wybranego stylu;0zostanie przekazane jako prawidłowa wartość.replace_section_end: końcowy czas zastępowanego fragmentu.replace_section_start: początkowy czas zastępowanego fragmentu.vocal_gender: kontroluje preferencję głosu żeńskiego lub męskiego, głos żeńskif, głos męskim; obowiązuje dla modeli 4.5 i wyższych; jest to preferencja i nie gwarantuje ścisłego przestrzegania.weirdness: dziwaczność w trybie niestandardowym, w zakresie 0-1; większa wartość zwykle oznacza więcej kreatywności i eksperymentalności;0zostanie przekazane jako prawidłowa wartość.duration: oczekiwany czas trwania utworu, w sekundach, musi być liczbą całkowitą w zakresie od 10 do 360. Ten parametr jest używany do generowania utworów w trybie niestandardowym (gdycustomma wartośćtrue). Jest to wskazówka dotycząca preferencji, a nie twarde ograniczenie: model weźmie ją pod uwagę, ale nie gwarantuje jej osiągnięcia; rzeczywisty czas trwania gotowego utworu zależy od poladurationw odpowiedzi i zazwyczaj jest krótszy niż oczekiwany.
Zakres zastosowania parametrów zaawansowanych
Platforma sprawdza typy parametrów i zakresy wartości, ale nie odrzuca tych opcjonalnych elementów regulacji wyłącznie z powodu różnic w action; konkretny efekt zależy od operacji, trybu i modelu.
lyric_prompt: prompt do generowania tekstu piosenki, obowiązuje wtedy i tylko wtedy, gdycustomma wartośćtrueorazlyricnie zostało przekazane.callback_url: URL, na który ma zostać przekazany wynik wywołania zwrotnego.async: opcjonalne; gdy ustawione natrue, interfejs natychmiast zwracatask_id, bez konieczności podawaniacallback_url, a następnie wynik jest uzyskiwany przez odpytywanie odpowiedniego interfejsu zapytań o zadania.
- success:czy generowanie zakończyło się powodzeniem; jeśli tak, wartość wynosi
true, w przeciwnym raziefalse - data:jest listą zawierającą szczegółowe informacje o wygenerowanych piosenkach.
- state: status generowania piosenki, obejmuje głównie cztery rodzaje, konkretnie:
- succeeded:wygenerowano pomyślnie
- pending:w kolejce
- running:w trakcie wykonywania
- error:niepowodzenie
- id:ID piosenki
- title:tytuł piosenki
- image_url:obraz okładki piosenki
- lyric:tekst piosenki
- audio_url:adres końcowego pliku audio piosenki. Platforma w pierwszej kolejności zwróci adres Ace Data Cloud CDN; jeśli trwałe zapisanie się nie powiedzie, może zostać zwrócony oryginalny adres mediów, należy go niezwłocznie pobrać.
- video_url:plik wideo piosenki, po otwarciu jest to wideo mp4.
- created_at:czas utworzenia
- model:użyty model, zazwyczaj najnowszy model v3
- style:styl
- state: status generowania piosenki, obejmuje głównie cztery rodzaje, konkretnie:
Generowanie niestandardowe
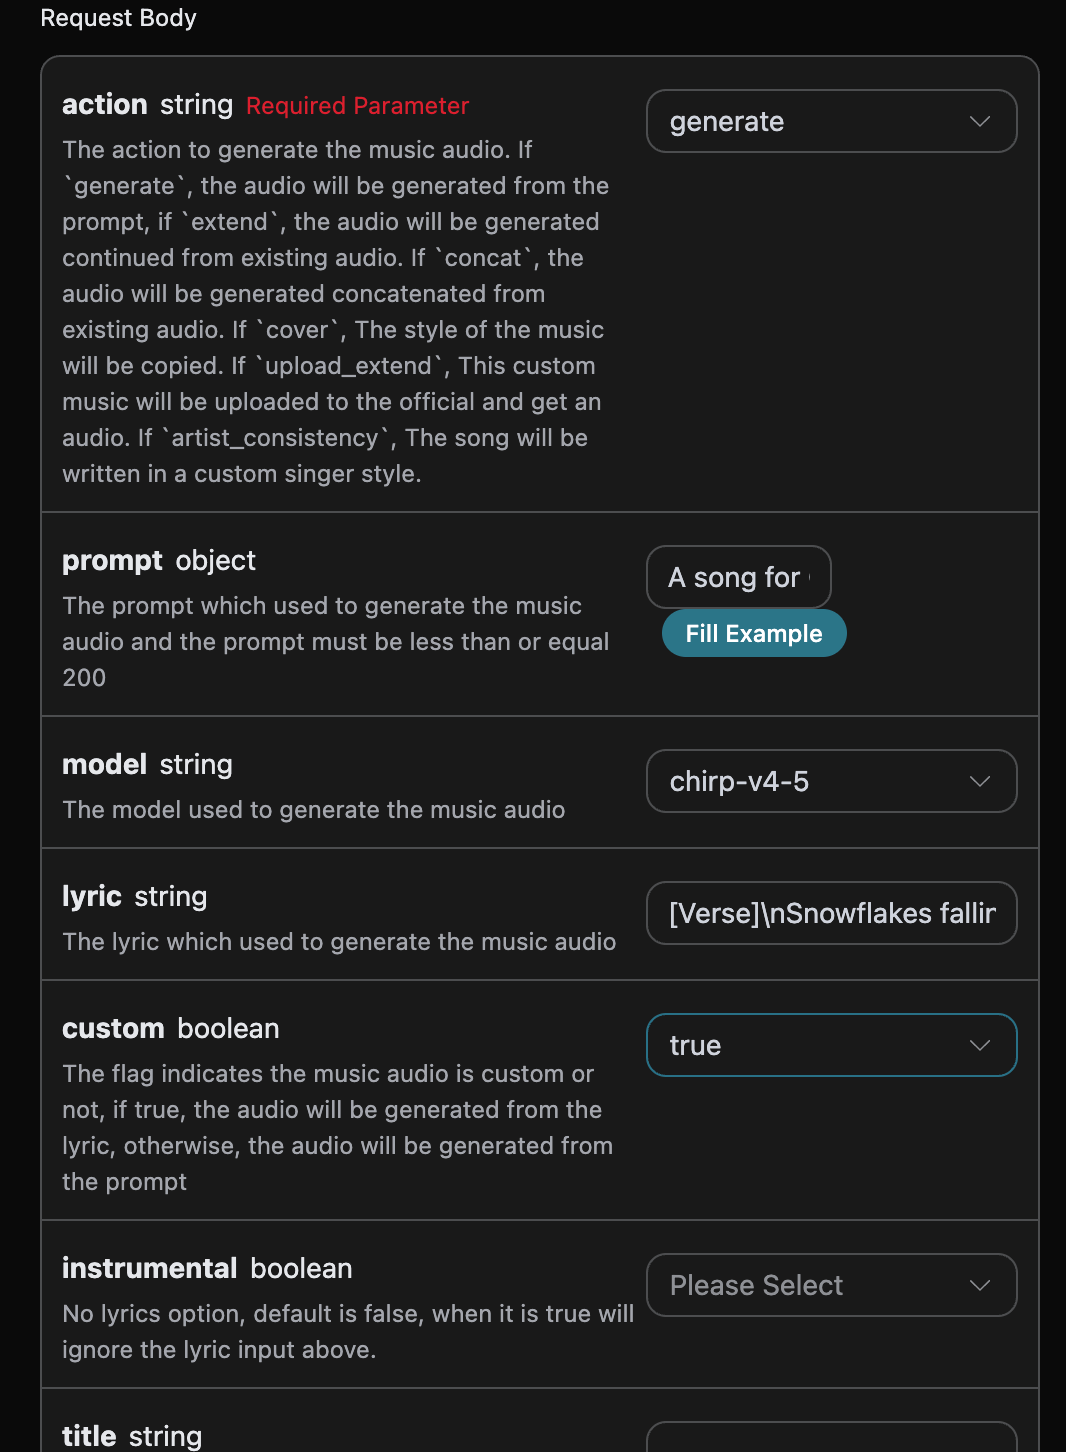
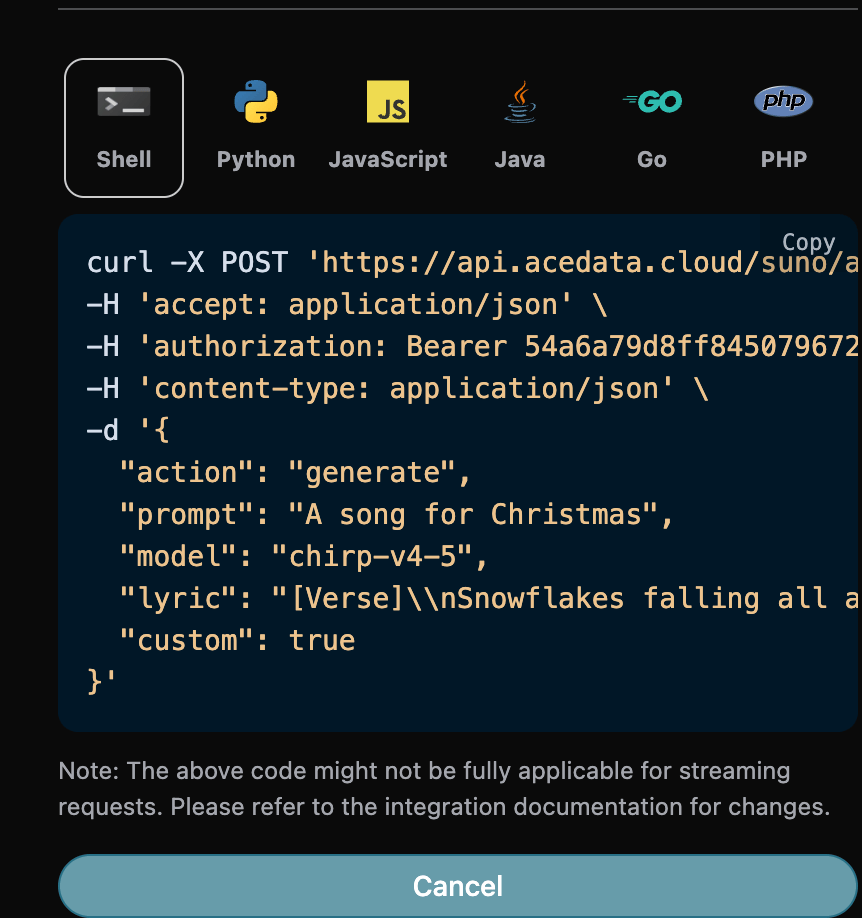
Jeśli chcesz niestandardowo wygenerować tekst piosenki, możesz wprowadzić tekst: W tym momencie do polalyric można przekazać treść podobną do poniższej:
Uwaga, \n w tekście piosenki tutaj oznacza znak nowej linii. Jeśli nie wiesz, jak wygenerować tekst piosenki, możesz użyć interfejsu API generowania tekstów dostarczanego przez AceDataCloud, aby wygenerować tekst na podstawie promptu; API to Suno Lyrics Generation API.
Następnie, aby niestandardowo wygenerować piosenkę na podstawie tekstu, tytułu i stylu, można określić następującą zawartość:
- lyric:tekst piosenki
- custom:ustaw na
true, co oznacza generowanie niestandardowe; domyślna wartość tego parametru to false, co oznacza generowanie przy użyciuprompt. - title:tytuł piosenki.
- style:styl piosenki, opcjonalnie.
Funkcja niestandardowego generowania stylu wokalisty
Jeśli chcesz użyć stylu piosenkarza do generowania piosenek, najpierw wygeneruj piosenkę poprzez podstawowe użycie opisane powyżej, a następnie należy ustawić tę piosenkę jako styl piosenkarza. Potem należy przejść do Suno Persona API, aby na podstawie oficjalnie wygenerowanego identyfikatora muzykiaudio_id wygenerować parametr id stylu piosenkarza persona_id; konkretne parametry są pokazane na poniższym obrazku:
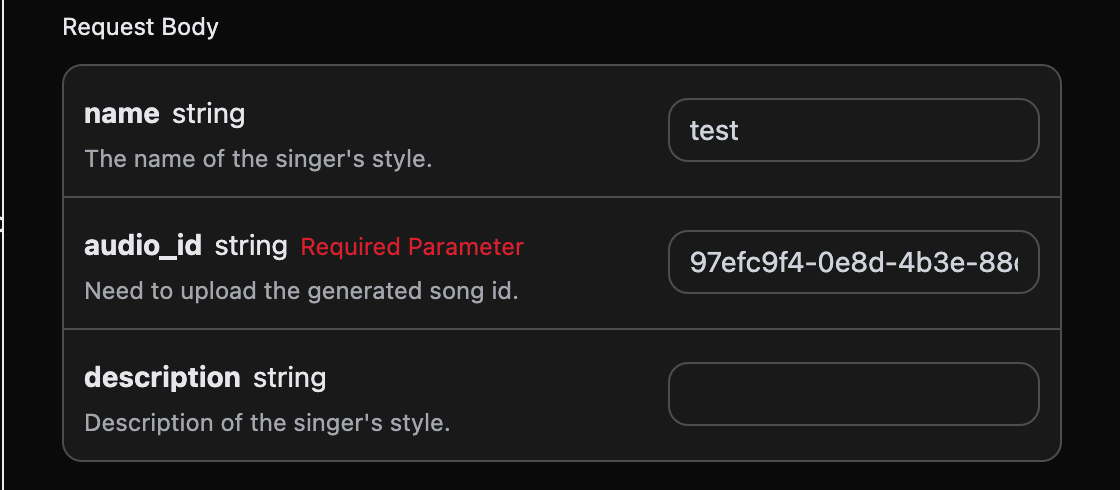
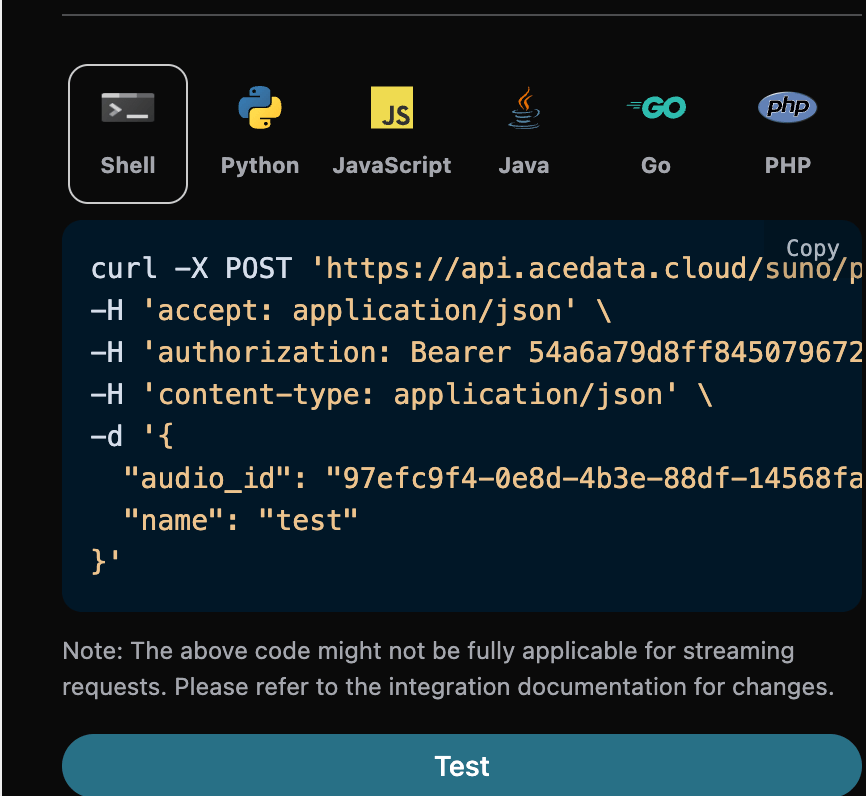
audio_id i persona_id, odpowiednio 97efc9f4-0e8d-4b3e-88df-14568fa1b11f oraz e0d7319e-aa2a-44cb-b00a-916218d7cb0b. Następnie można ustawić parametr action na artist_consistency (jeśli jest to nowa wersja stylu piosenkarza Persona-v2-vox, action musi być ustawione na artist_consistency_vox) i wprowadzić ID piosenki, której generowanie ma być kontynuowane, oraz ID stylu piosenkarza, jak pokazano w poniższym przykładzie:
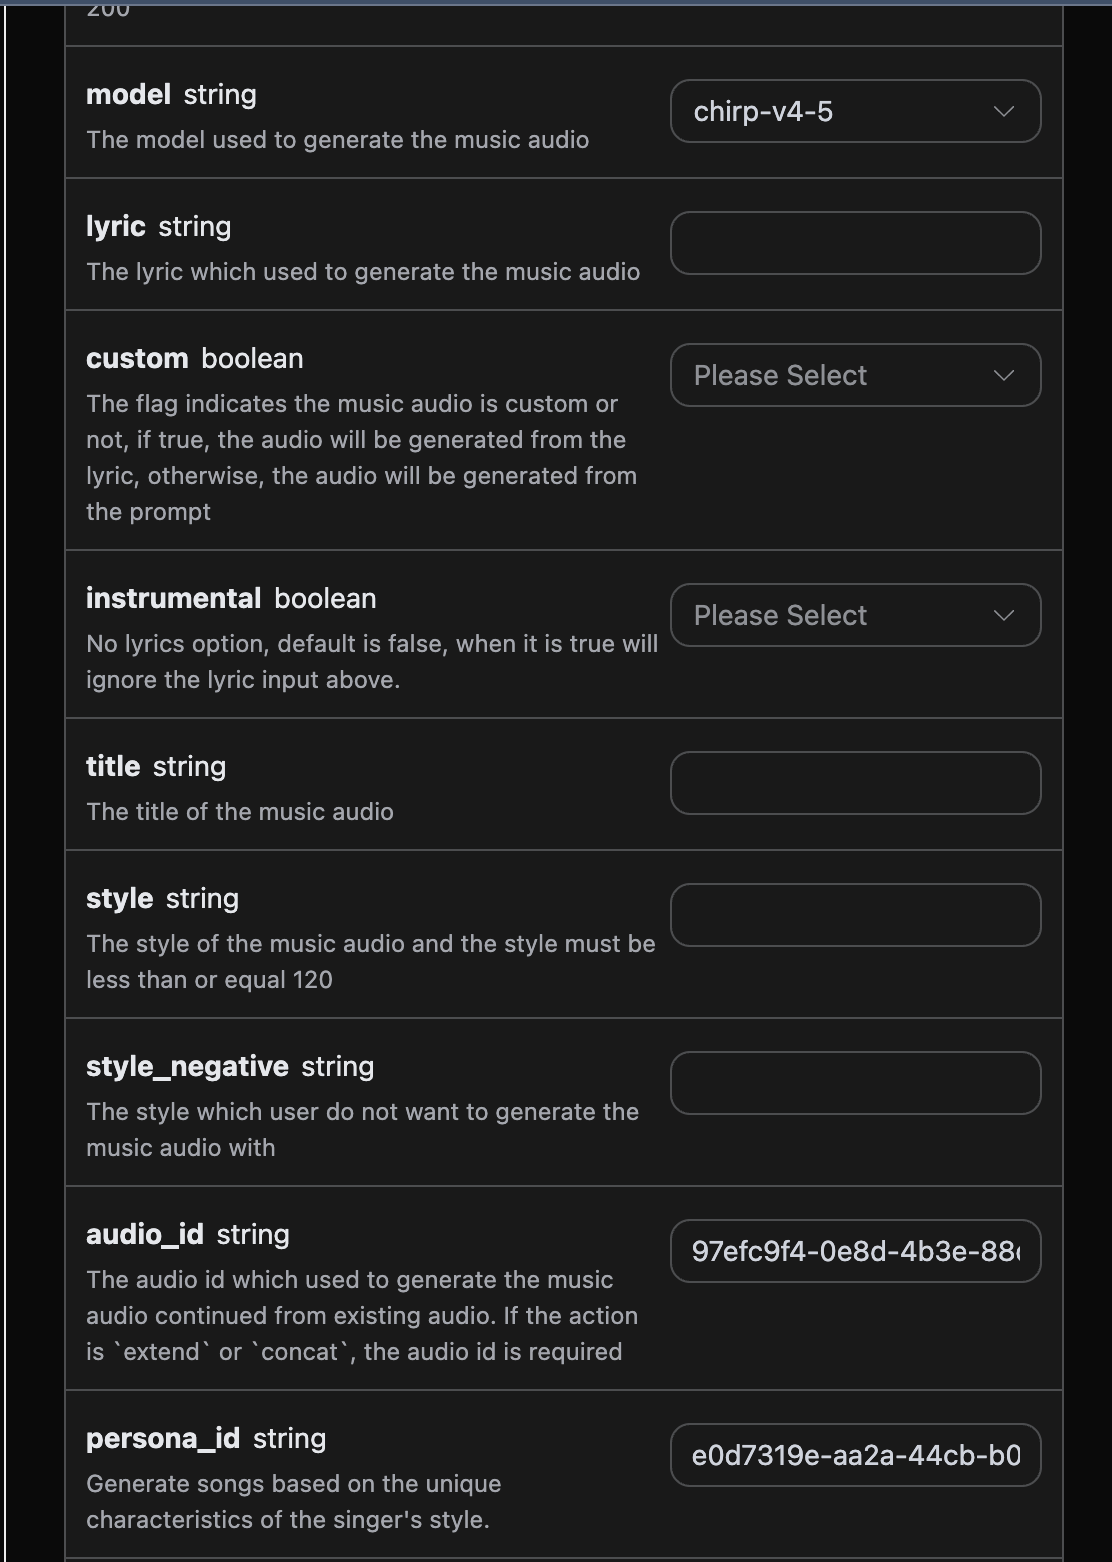
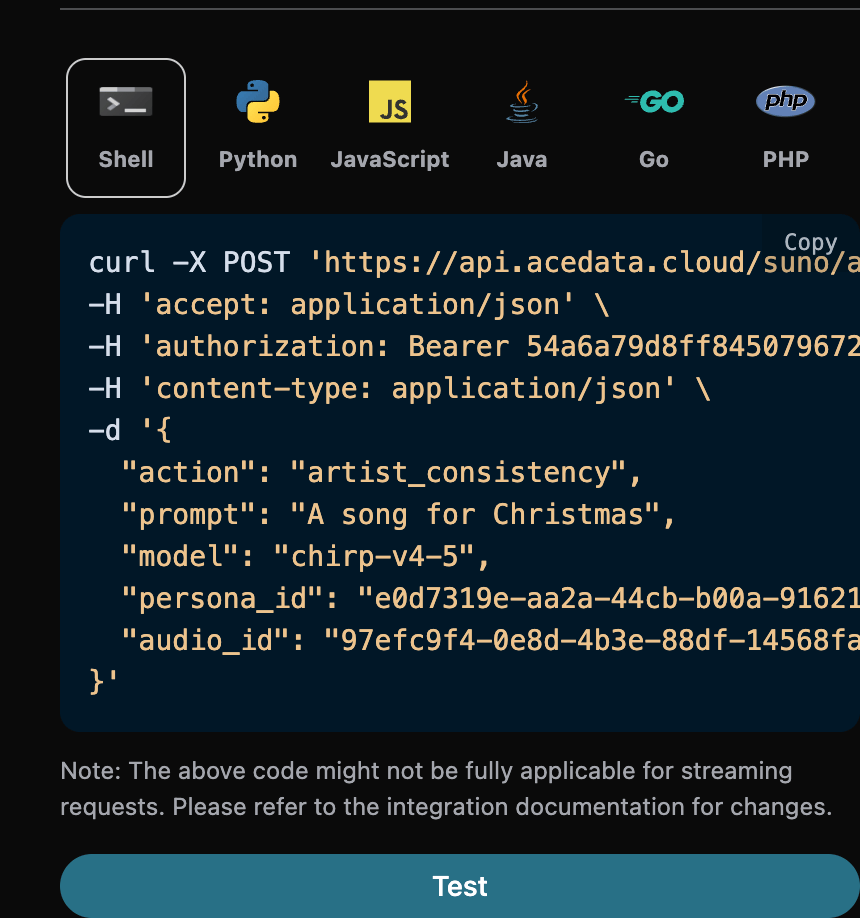
Funkcja kontynuowania generowania
Jeśli chcesz kontynuować generowanie już wygenerowanej piosenki Suno, możesz ustawić parametraction na extend i wprowadzić ID piosenki, której generowanie ma być kontynuowane. ID piosenki uzyskuje się poprzez podstawowe użycie; z powyższego tekstu wiadomo, że w tym momencie ID piosenki to:
Uwaga, id w tekście piosenki tutaj jest ID piosenki po jej wygenerowaniu. Jeśli nie wiesz, jak wygenerować piosenkę, możesz zapoznać się z podstawowym użyciem opisanym powyżej, aby wygenerować piosenkę.
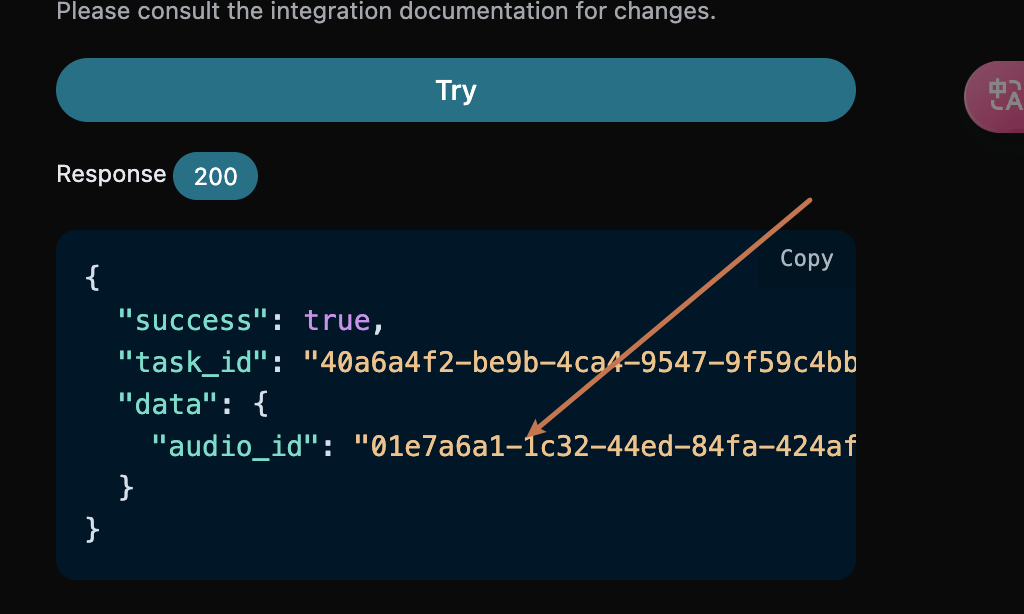
Jeśli chcesz kontynuować generowanie własnej przesłanej piosenki, możesz ustawić parametr action na upload_extend i wprowadzić ID własnej przesłanej piosenki, której generowanie ma być kontynuowane. ID piosenki uzyskuje się za pomocą Suno Upload Generation API, jak pokazano na poniższym obrazku:
- lyric:używane tylko do kierowania tekstem nowo wygenerowanego fragmentu po
continue_at; nie zastąpi tekstu przed tym punktem czasowym w źródłowym audio. - custom:ustawienie na
trueoznacza niestandardowe generowanie; domyślna wartość tego parametru to false, co oznacza generowanie z użyciemprompt. - style:styl piosenki dla fragmentu kontynuacji, opcjonalny.
- continue_at:granica kontynuacji, w sekundach. Na przykład 213.5 oznacza rozpoczęcie generowania kolejnego fragmentu od 3 minut i 33.5 sekundy.
Przykład wypełnienia jest następujący:extendsłuży do dalszego tworzenia na podstawie istniejącej piosenki, a nie do zmiany tekstu całej piosenki. Jeśli chcesz użyć nowego tekstu od początku całej piosenki, użyjgenerate, aby wygenerować ją ponownie; jeśli chcesz ponownie zinterpretować istniejącą piosenkę, możesz użyćcover. Po przekazaniu całego nowego tekstu oryginalny tekst przedcontinue_atnadal nie zostanie zastąpiony.
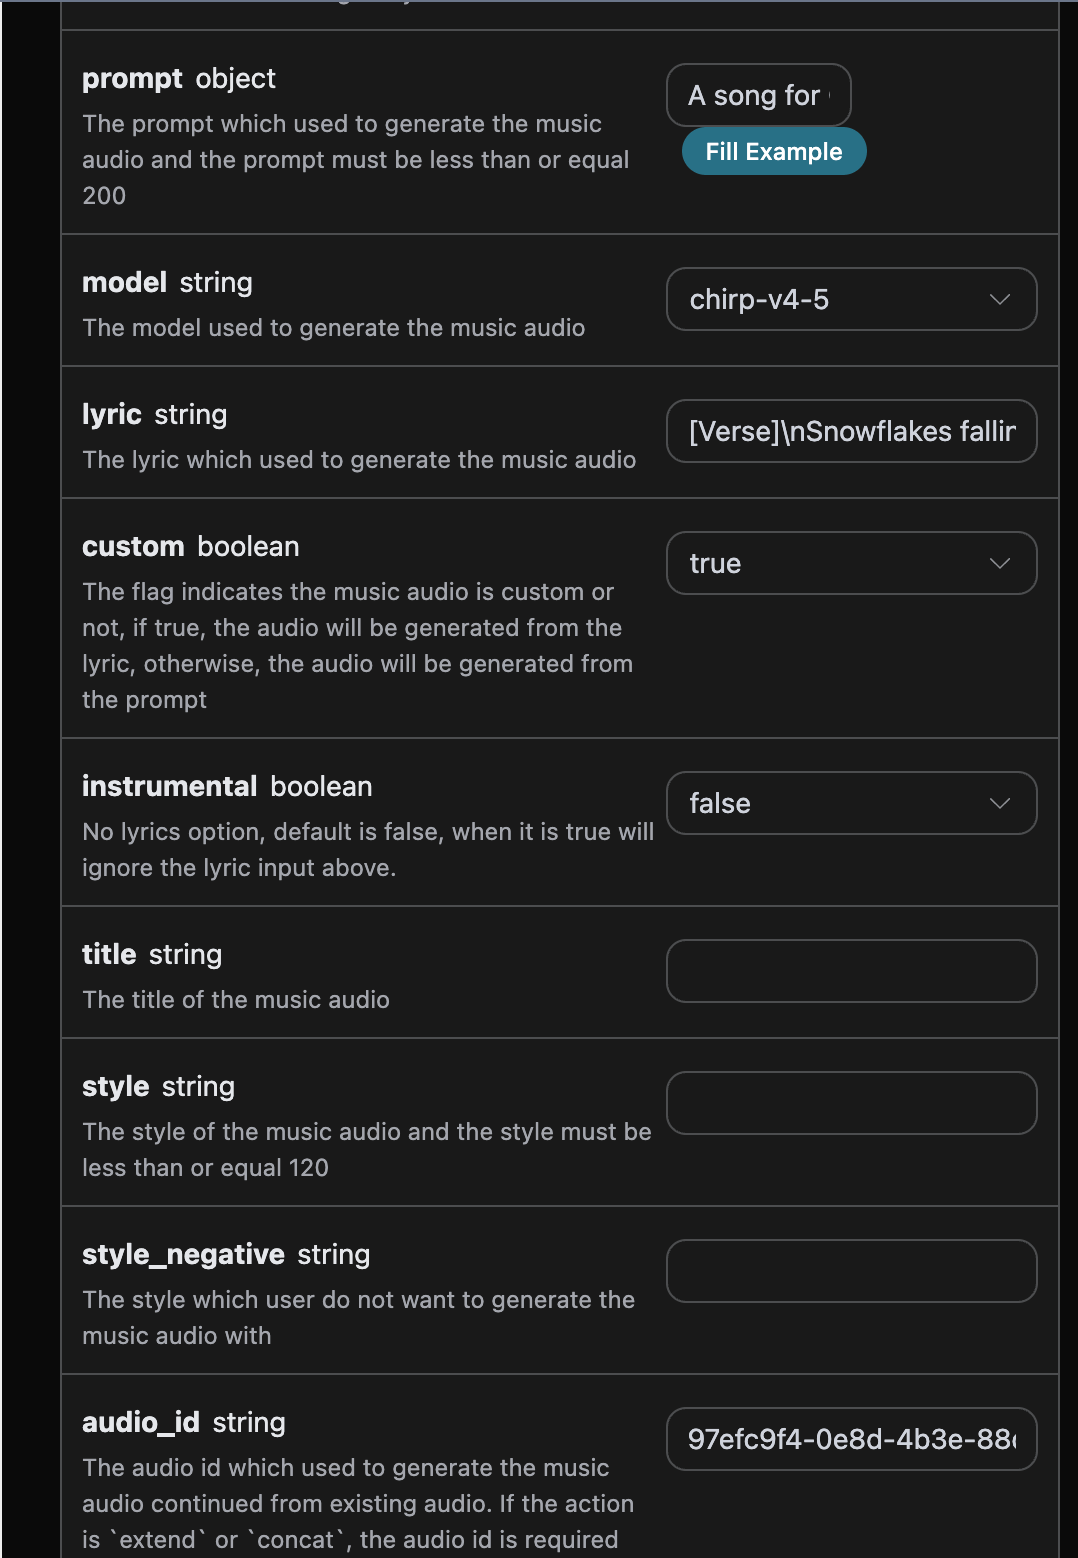
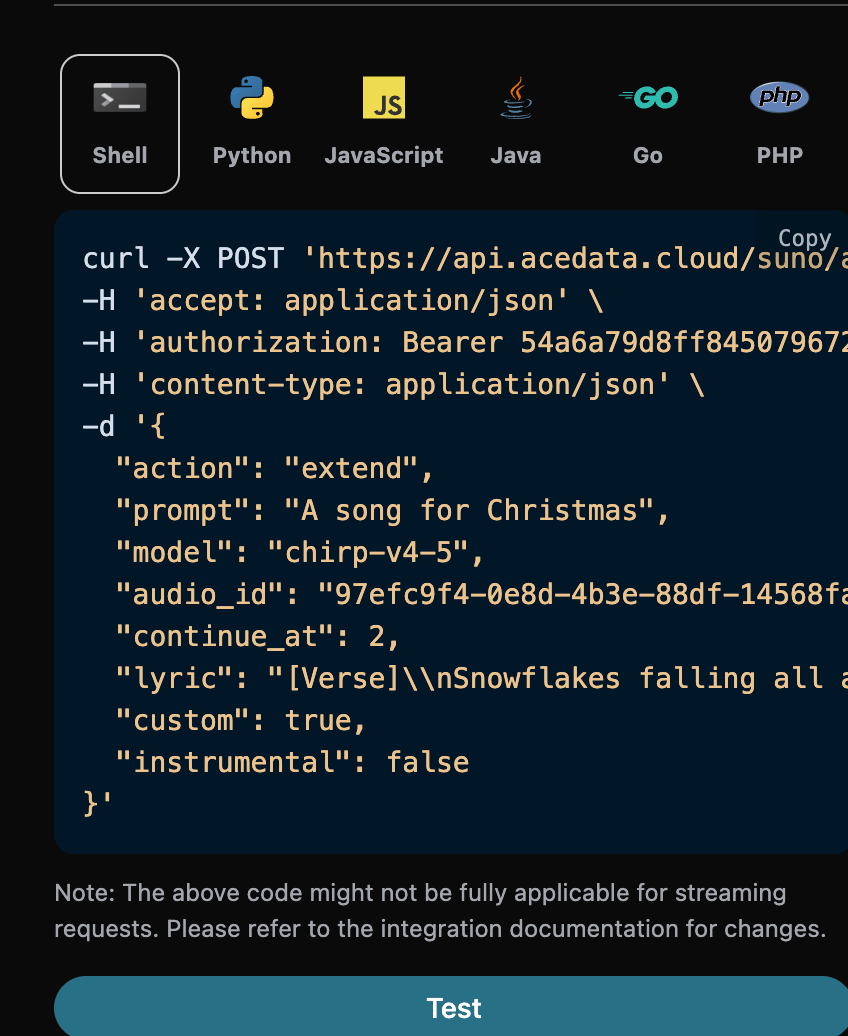
continue_at wynosi 2 sekundy, dlatego tylko pierwsze 2 sekundy należą do oryginalnej treści sprzed granicy kontynuacji. Przy faktycznej kontynuacji w pobliżu końca utworu należy ustawić tę wartość na liczbę sekund, od której oczekuje się rozpoczęcia kontynuacji, oraz podać w lyric wyłącznie nowy fragment, który ma być śpiewany po granicy.
Odpowiedni kod Python:
lyric w wyniku zwróci tekst piosenki użyty w tym zadaniu kontynuacji. To pole nie jest dosłowną transkrypcją kompletnego gotowego audio; w przypadku extend źródłowe audio przed continue_at nadal używa oryginalnego tekstu, a nowy tekst służy jedynie do kierowania fragmentem kontynuacji.
Pobieranie kompletnej piosenki
Wynikextend bieżącego modelu zazwyczaj zawiera już źródłowe audio przed continue_at oraz nową treść po granicy, dlatego najpierw należy ocenić na podstawie rzeczywistego czasu trwania i zawartości zwróconego audio, czy jest to już kompletna piosenka. Jeśli zwrócony został niezależny fragment kontynuacji lub konieczne jest jawne połączenie historii wielu kontynuacji w jedną piosenkę, należy następnie użyć funkcji łączenia:
- action: wartość to
concat. - audio_id: ID ostatniego fragmentu kontynuacji.
Cover muzyczny
Po kontynuowaniu generowania utworu na podstawie oryginalnego utworu styl zwróconego utworu może nie być zbyt odpowiedni. Jeśli chcesz wykonać cover wcześniej wygenerowanego utworu (obsługiwana jest również niestandardowo przesłana muzyka), musisz użyć metody coveru muzycznego, dzięki czemu możesz określić następującą zawartość:- action:wartość to
cover; gdy wykonywana jest operacja coveru na niestandardowo przesłanej muzyce, należy określić wartość jako:upload_cover. - audio_id:ID wcześniej wygenerowanego utworu.
Zastępowanie fragmentu
Gdy po wygenerowaniu utworu konieczne jest przeprowadzenie wtórnej kreacji polegającej na osobnej operacji zastąpienia fragmentu utworu, można wykonać operację zastąpienia określonego fragmentu utworu.⚠️ Uwaga:Opis parametrów jest następujący:replace_section_result_modedomyślnie ma wartośćfull_song: system osobno połączy 2 nowo wygenerowane kandydaty i zwróci 2 kompletne utwory. Jeśli potrzebujesz tylko jeszcze niepołączonych kandydatów zastępowanego fragmentu, jawnie ustaw wartość nacandidates, a następnie wybierz kandydata i wywołaj Łączenie muzyki.
- action:wartość to
replace_section. - audio_id:ID oryginalnego utworu (źródłowego utworu, który zostanie zastąpiony).
- model: model generowania utworu.
- lyric: pełny tekst po zastąpieniu (obejmujący zastępowany segment i jego kontekst, zgodny z treścią w
prompt). - prompt:nowy tekst dla segmentu, który ma zostać zastąpiony.
- style:styl utworu, opcjonalny.
- replace_section_start:czas rozpoczęcia zastępowanego fragmentu w oryginalnym utworze (w sekundach).
- replace_section_end:czas zakończenia zastępowanego fragmentu w oryginalnym utworze (w sekundach).
- replace_section_result_mode:tryb zwracania, domyślnie
full_song.full_songosobno łączy 2 kandydatów i zwraca 2 kompletne utwory;candidateszwraca 2 jeszcze niepołączone fragmenty kandydackie.
Krok pierwszy: rozpoczęcie zadania zastępowania fragmentu
Na przykład, jeśli ID wcześniej wygenerowanego utworu to: 18db7ed0-2b8a-41db-91c1-b0781dcca0d4 (czas trwania 94,12 sekundy) i chcesz zastąpić refren od 30. do 60. sekundy nowym tekstem, możesz ustawić parametry w następujący sposób:replace_section_result_mode zostanie ustawione na candidates, zwrócone zostaną 2 niepołączone jeszcze fragmenty zastępcze, o strukturze zgodnej z poniższym przykładem:
candidates długości dwóch zwróconych nagrań audio (45,16 sekundy, 33,8 sekundy) są znacznie krótsze niż oryginalny utwór (94,12 sekundy); są to fragmenty zastępcze zawierające niewielką ilość kontekstu i nie są całymi utworami. Można wybrać zadowalającego kandydata, aby kontynuować ręczne łączenie. Domyślny tryb full_song wykona natomiast dwa połączenia i bezpośrednio zwróci 2 pełne utwory.
Bezpośrednie zwracanie pełnych utworów
Jeśli chcesz bezpośrednio uzyskać pełne utwory, w kroku pierwszym możesz ustawićreplace_section_result_mode na full_song. Interfejs połączy odpowiednio dwóch kandydatów i zwróci 2 pełne utwory; wówczas nie ma potrzeby ponownego wywoływania concat.
Krok drugi: połączenie fragmentu zastępczego z powrotem z oryginalnym utworem
Dla wybranego powyżej fragmentu (na przykład364f9d8b-ca25-463b-9a5e-d0b7139e2d6a) rozpocznij zadanie concat zgodnie z metodą opisaną w sekcji Łączenie muzyki:
duration zostało przywrócone do pełnej długości utworu (105,28 sekundy, w przybliżeniu równej długości oryginalnego utworu), a audio_url wskazuje na cały utwór po zakończeniu zastępowania. Tym samym kończy się proces wtórnej twórczości „generowanie → zastępowanie fragmentu → składanie całego utworu”.
Separacja wokalu i muzyki
Gdy po wygenerowaniu utworu konieczne jest przeprowadzenie wtórnej twórczości z osobnymi operacjami na akompaniamencie i wokalu, można oddzielić czysto muzyczny akompaniament i wokal a cappella. Można wtedy określić następującą zawartość:- action:wartość to
stems。 - audio_id:ID wcześniej wygenerowanego utworu。
Separacja wokalu i muzyki na wszystkich ścieżkach
Gdy po wygenerowaniu utworu konieczne jest przeprowadzenie operacji separacji wokalu i muzyki na wszystkich ścieżkach, można określić następującą zawartość:- action:wartość to
all_stems。 - audio_id:ID wcześniej wygenerowanego utworu。
Dodawanie ścieżki audio
add_stem generuje docelową ścieżkę instrumentu lub głosu dla określonego dźwięku audio, wywoływane przez POST /suno/audios.
- Wymagane:
action,audio_id,stem_type. - Opcjonalne:
model,prompt,title,style,negative_tags,weirdness,style_influence,audio_weight,max_mode,variety. - Opłata: tryb zwykły 0.672 Credits; gdy
max_modema wartośćtrue, 1.344 Credits.
Wyodrębnianie ścieżki audio
extract_stem wyodrębnia docelową ścieżkę audio z określonego dźwięku audio, jednocześnie zwracając wersję uzupełniającą po usunięciu tej ścieżki, wywoływane przez POST /suno/audios.
- Wymagane:
action,audio_id,stem_type. - Opcjonalne:
audio_format, obecny publiczny kontrakt dwukanałowy obsługuje tylkomp3. - Opłata: 1.12 Credits.
data w odpowiedzi w stanie końcowym zachowuje płaską listę audio, a stem_sets wskazuje relację między docelową ścieżką audio a ścieżką uzupełniającą:
Generowanie efektów dźwiękowych
sounds generuje jednorazowe lub zapętlane efekty dźwiękowe na podstawie opisu tekstowego, wywoływane przez POST /suno/audios.
- Wymagane:
action,sound,sound_type. - Opcjonalne:
model,bpm,key,audio_format;audio_formatobecnie obsługuje tylkomp3. sound_type:one-shotlubloop.- Opłata: 0.112 Credits.
Dostosowywanie prędkości audio
adjust_speed dostosowuje prędkość odtwarzania określonego audio, wywoływane przez POST /suno/audios.
- Wymagane:
action,audio_id,speed_multiplier,title. - Opcjonalne:
keep_pitch. speed_multiplier: zakres 0.25–4.- Rozliczenie: 0.28 Credits.
Zaawansowane parametry niestandardowego generowania
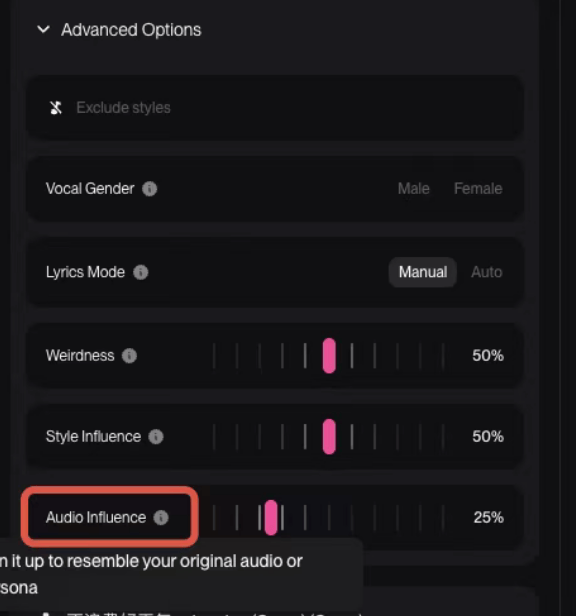
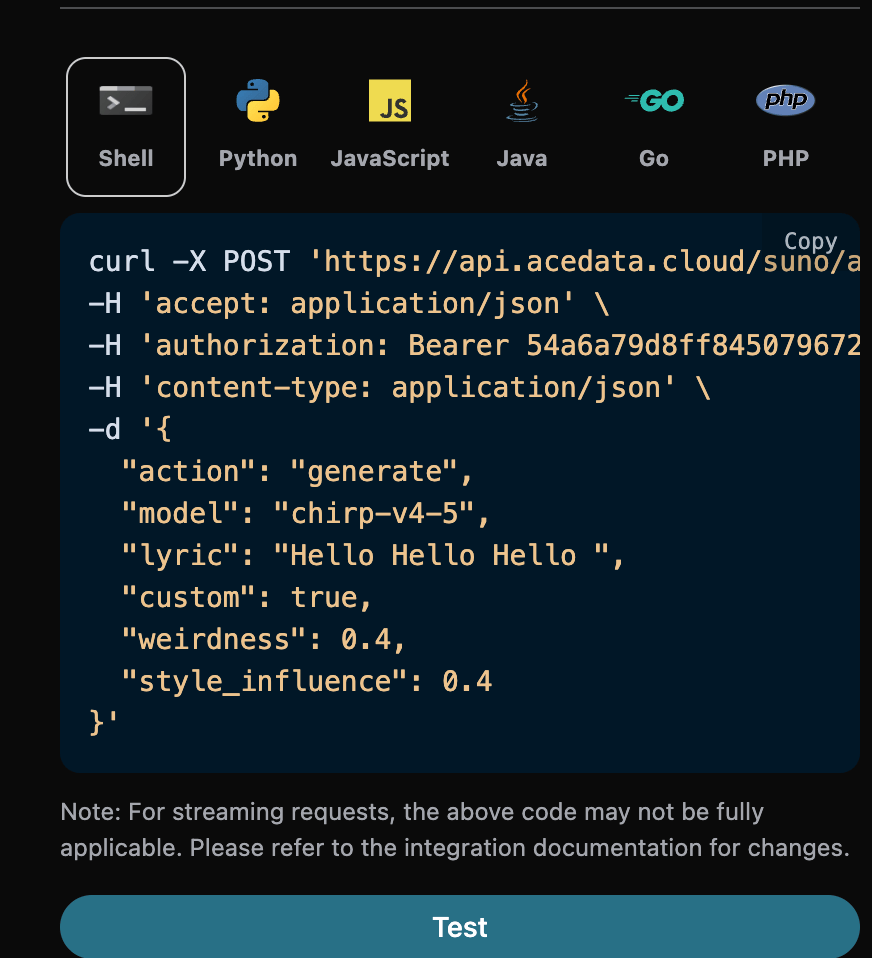
Oficjalnie zezwala się na używanie w trybie niestandardowym zaawansowanych parametrówweirdness==>Weirdness, style_influence==>Style Influence, audio_weight==>Audio Influence do generowania, odpowiadających następującym oficjalnym przykładom:
Kontrolowanie długości piosenki
Domyślnie długość generowanej piosenki jest określana przez model, zwykle wynosi od 30 sekund do 4 minut. Jeśli potrzebny jest dłuższy lub krótszy gotowy utwór, można określić oczekiwaną długość za pomocą parametruduration, jednostką są sekundy, a wartość jest liczbą całkowitą od 10 do 360.
Ten parametr jest używany do generowania piosenek w trybie niestandardowym (custom ma wartość true). Należy szczególnie wyjaśnić, że duration jest wskazówką tendencji, a nie twardym ograniczeniem: model będzie odnosił się do tej wartości podczas tworzenia, ale nie gwarantuje jej osiągnięcia; w testach rzeczywista długość jest zwykle wyraźnie krótsza od oczekiwanej wartości, a długości dwóch piosenek zwróconych w tym samym żądaniu mogą również różnić się kilkukrotnie. Nawet w przypadku całkowicie identycznych żądań długości uzyskane po wielokrotnym przesłaniu mogą również znacznie się różnić. Dlatego nie należy używać tego jako precyzyjnej kontroli długości; jeśli w zastosowaniu biznesowym potrzebna jest stała długość, należy samodzielnie przyciąć gotowy utwór lub ponowić próbę po jego otrzymaniu.
Odpowiedni kod Python:
duration w żądaniu jest oczekiwanym czasem trwania, natomiast pole duration każdej piosenki w odpowiedzi data jest rzeczywistym czasem trwania tej piosenki. Nazwy obu są takie same, ale ich znaczenia są różne; rzeczywisty czas trwania nie musi być równy oczekiwanej wartości. Długość tekstu jest jednym z głównych czynników wpływających na czas trwania gotowego utworu; jeśli potrzebny jest dłuższy gotowy utwór, zaleca się jednoczesne podanie pełniejszego tekstu.
Interfejs sprawdza, czy duration jest liczbą całkowitą od 10 do 360; nadal jest to jedynie cel generowania, a nie gwarancja długości gotowego utworu.
Funkcja Add Insterumental
W sierpniu 2025 roku suno wprowadziło nową funkcję Add Insterumental. Najpierw należy przesłać utwór a cappella bez podkładu muzycznego, aby suno mogło dodać do niego muzykę. Najpierw można przejść do Suno Upload API, aby przesłać utwór a cappella bez podkładu muzycznego; odpowiednie operacje są pokazane na poniższym obrazie: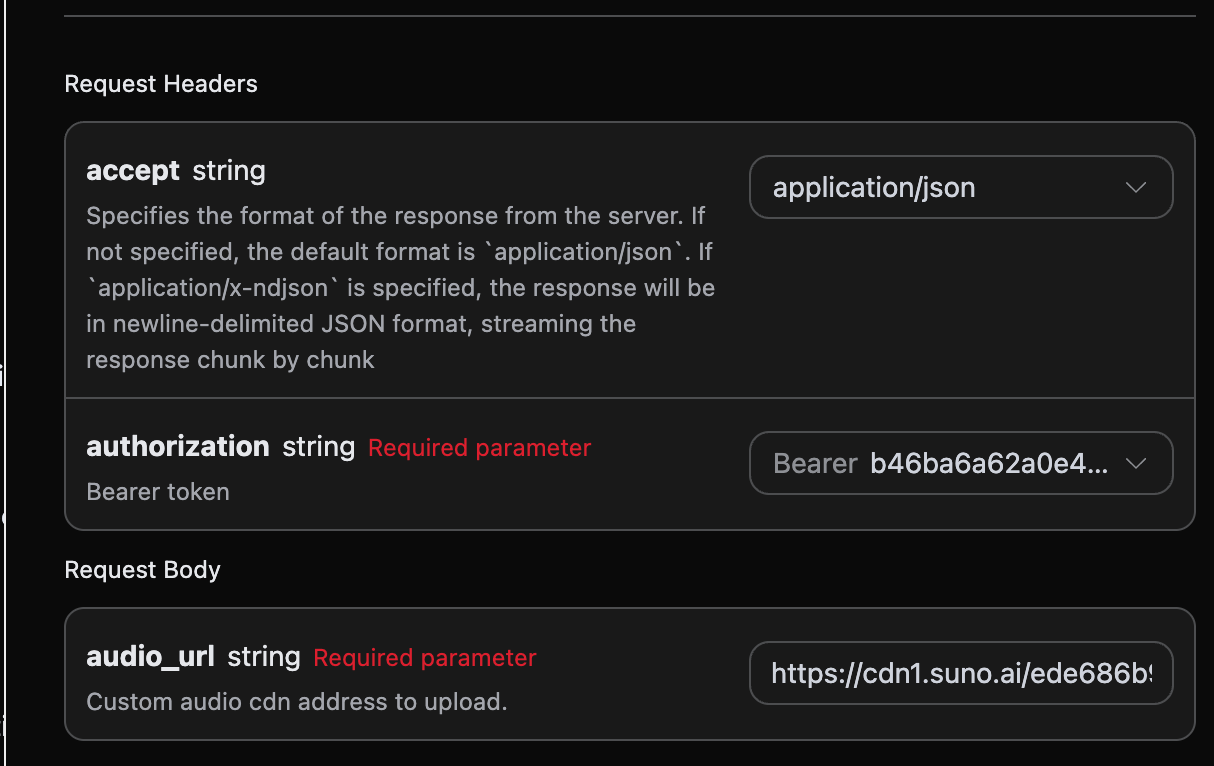
audio_id po przesłaniu, a konkretny wynik jest pokazany na poniższym obrazie:
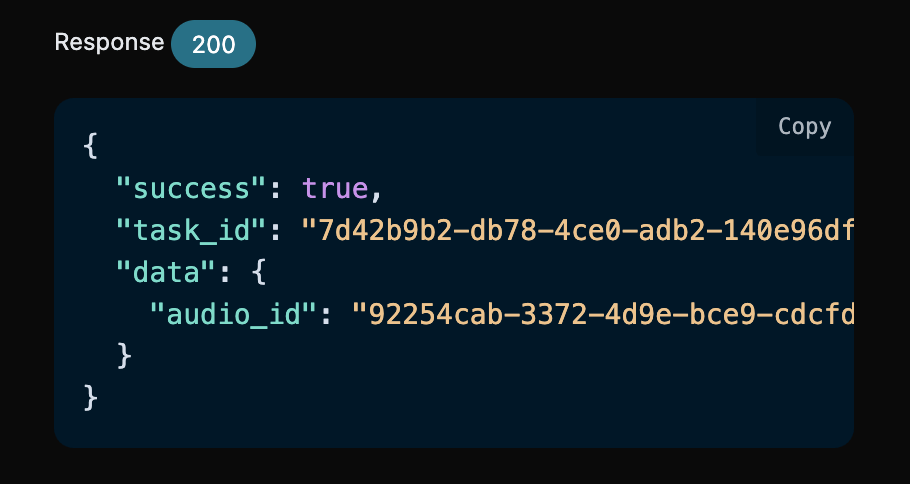
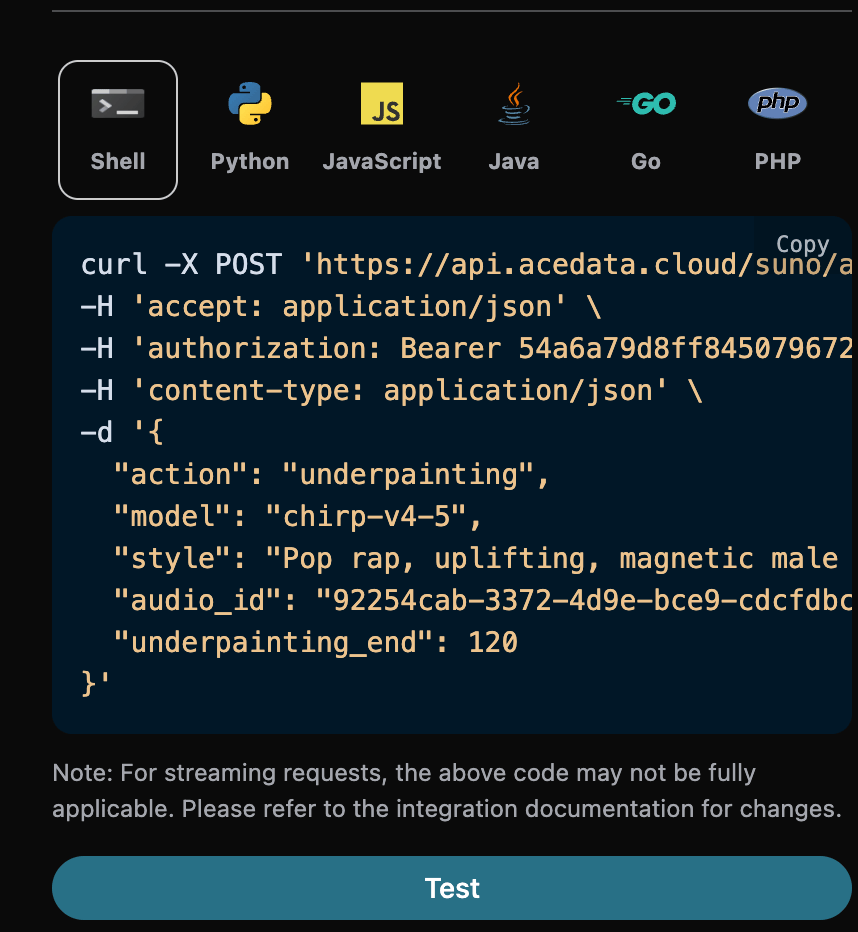
audio_id: 92254cab-3372-4d9e-bce9-cdcfdbc39070, a następnie musimy jeszcze wypełnić następujące parametry:
- action: wartość to
underpainting. - underpainting_start: czas rozpoczęcia dodawania akompaniamentu do przesłanego utworu, wartość domyślna to 0.
- underpainting_end: czas zakończenia dodawania akompaniamentu do przesłanego utworu, musi być mniejszy niż całkowity czas trwania utworu.
- audio_id: ID przesłanego utworu a cappella bez podkładu muzycznego.
- style: styl akompaniamentu, najlepiej bez tekstu, ponieważ w końcu jest to podkład muzyczny.
Funkcja Add Vocals
W sierpniu 2025 roku suno wprowadziło nową funkcję Add Vocals. Najpierw należy przesłać utwór instrumentalny, aby suno napisało tekst i wygenerowało śpiew wokalny. Najpierw można przejść do Suno Upload API, aby przesłać utwór a cappella bez podkładu muzycznego; odpowiednie operacje są pokazane na poniższym obrazie:
audio_id po przesłaniu, a konkretny wynik jest pokazany na poniższym obrazie:
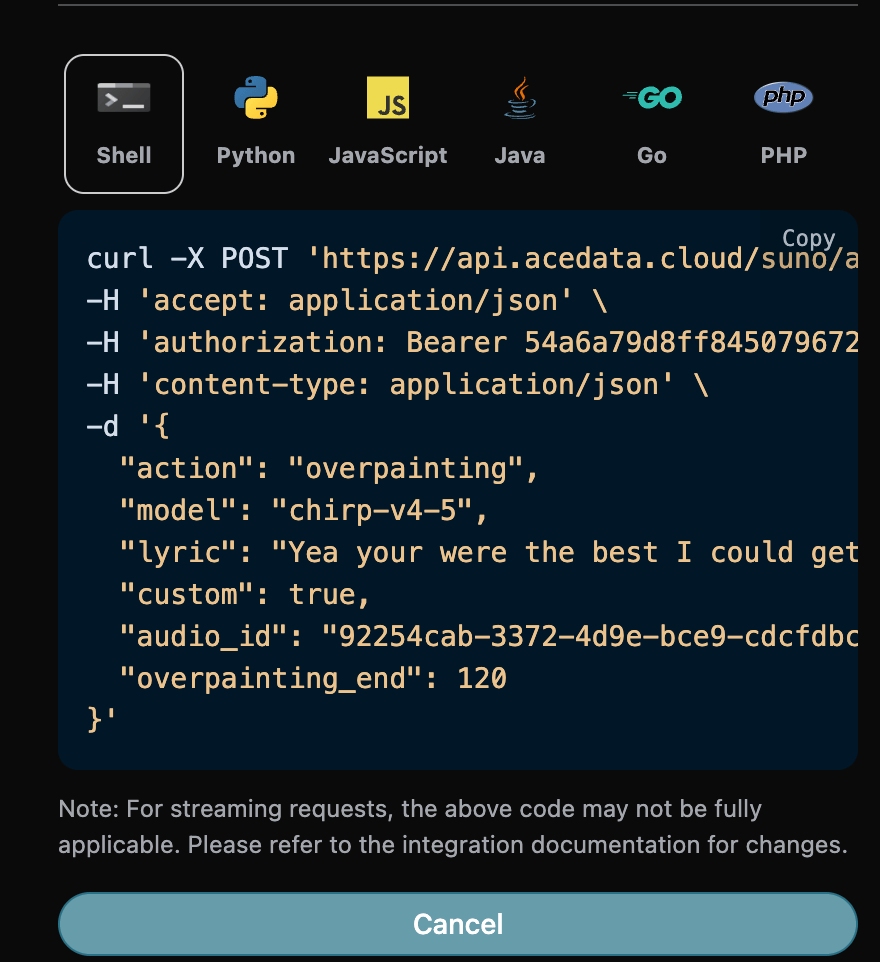
audio_id: 92254cab-3372-4d9e-bce9-cdcfdbc39070, a następnie musimy jeszcze wypełnić następujące parametry:
- action: wartość to
overpainting. - overpainting_start: czas rozpoczęcia dodawania wokalu do przesłanego utworu, wartość domyślna to 0.
- overpainting_end: czas zakończenia dodawania wokalu do przesłanego utworu, musi być mniejszy niż całkowity czas trwania utworu.
- audio_id: ID przesłanego utworu a cappella bez podkładu muzycznego.
- custom: w tym trybie należy użyć trybu niestandardowego do wprowadzenia tekstu.
- lyric: tekst wprowadzony w trybie niestandardowym.
- style: styl akompaniamentu.
Funkcja Remaster
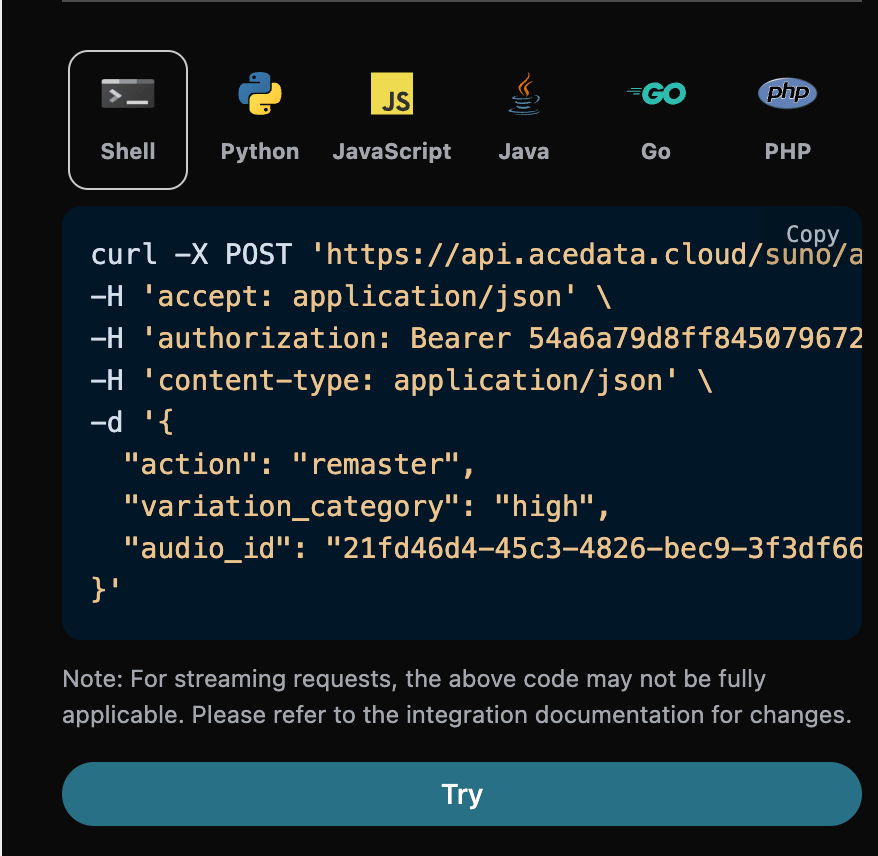
W grudniu 2025 roku suno wprowadziło nową funkcję Remaster, funkcja ta może ponownie wygenerować piosenkę, nie można tego robić między kontami, następnie musimy jeszcze wypełnić następujące parametry:- action:wartość to
remaster。 - audio_id:ID piosenki, którą należy ponownie wygenerować。
- model:obsługuje tylko v4.5+、v5。
- variation_category:obsługiwane tylko w wersji v5 i wyższych, a dostępne są tylko 3 wartości: high normal subtle。
Funkcja generowania miksów Mashup
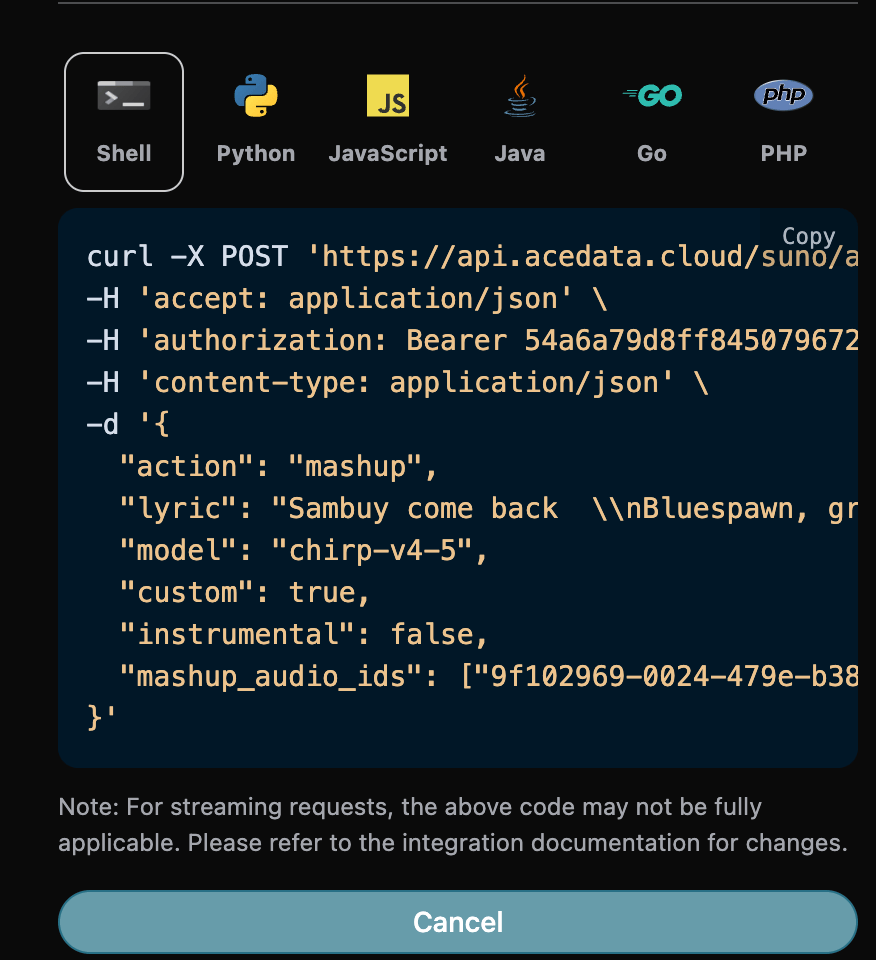
W grudniu 2025 roku suno wprowadziło nową funkcję Mashup, funkcja ta może generować piosenkę na podstawie dwóch referencyjnych piosenek, następnie musimy jeszcze wypełnić następujące parametry:- action:wartość to
mashup。 - mashup_audio_ids:ID dwóch referencyjnych piosenek。 Po wypełnieniu formularza kod został automatycznie wygenerowany w następujący sposób:
Samples generowanie piosenek na podstawie próbek
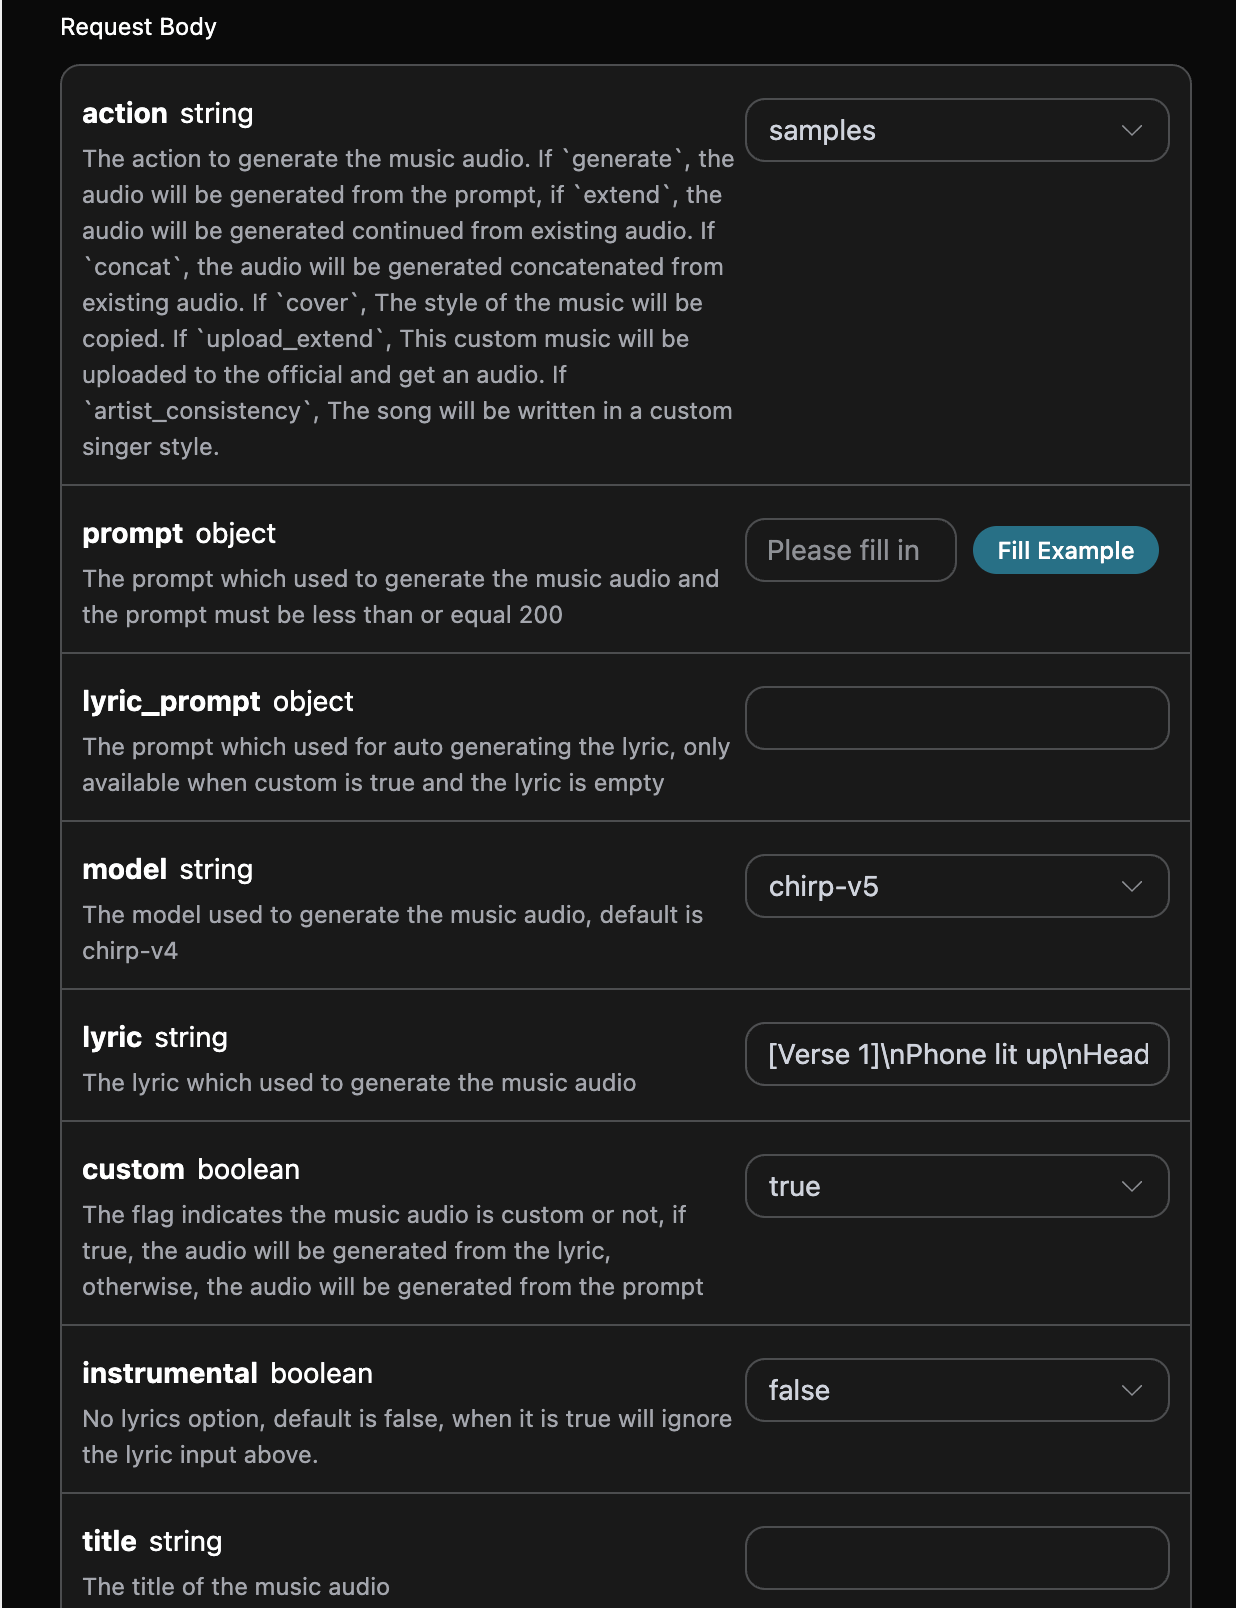
Samples tutaj oznacza pobieranie próbek z pojedynczego fragmentu audio: wybierz czas rozpoczęcia i zakończenia z istniejącego nagrania audio, a następnie użyj tego fragmentu jako materiału do tworzenia. Różni się to od funkcji tworzenia inspirowanego Inspo, która używa od 1 do 4 pełnych referencyjnych nagrań audio, opisanej poniżej. Należy wypełnić następujące parametry:
- action:wartość to
samples. - samples_start:czas rozpoczęcia pobierania próbki.
- samples_end:czas zakończenia pobierania próbki.
- audio_id:ID referencyjnej piosenki, z której należy pobrać próbkę.
Funkcja tworzenia inspirowanego Inspo
Funkcja tworzenia inspirowanego Inspo może generować nową muzykę na podstawie od 1 do 4 pełnych referencyjnych nagrań audio oraz obsługuje przeciąganie i upuszczanie lub przesyłanie audio jako źródła inspiracji. API używa istniejącej akcjiinspo: klient podaje publicznie dostępne adresy URL audio, a usługa automatycznie kończy przygotowanie referencyjnego audio i tworzenie, bez konieczności osobnego odczytywania przez klienta tekstu, stylu lub długości i składania żądania. Różni się to od opisanego powyżej próbkowania zakresu, a także od Cover odtwarzającego styl oryginalnego utworu. Podczas użycia należy wypełnić następujące parametry:
- action: zawartością jest
inspo. - audio_urls: lista adresów URL referencyjnego audio; należy podać od 1 do 4 publicznie dostępnych adresów audio.
- model: używany model, zalecany jest
chirp-v6. - prompt: tekst piosenki lub wskazówki twórcze (opcjonalnie).
Uwaga: referencyjne audio musi być publicznie dostępnym plikiem audio. Jeśli referencyjne audio idealnie odpowiada znanemu nagraniu w katalogu utworów platformy, Suno może odmówić generowania z powodu weryfikacji praw autorskich; zaleca się używanie własnego audio lub audio wygenerowanego przez Suno jako źródła inspiracji.Odpowiedni kod Python:
chirp-v5, w bieżącym przykładzie żądania zalecany jest chirp-v6, a struktura zwracanych danych jest taka sama:
Asynchroniczne wywołanie zwrotne
Ponieważ generowanie muzyki przez Suno trwa stosunkowo długo, około 1–2 minut, jeśli API przez długi czas nie odpowiada, żądanie HTTP będzie stale utrzymywać połączenie, co prowadzi do dodatkowego zużycia zasobów systemowych, dlatego to API również zapewnia obsługę asynchronicznych wywołań zwrotnych. Ogólny proces wygląda następująco: gdy klient inicjuje żądanie, dodatkowo określa polecallback_url; po wysłaniu przez klienta żądania API, API natychmiast zwróci wynik zawierający informację w polu task_id, reprezentującą bieżący identyfikator zadania. Po zakończeniu zadania wynik generowania muzyki zostanie wysłany w formie POST JSON na callback_url określony przez klienta, który również zawiera pole task_id, dzięki czemu wynik zadania można powiązać za pomocą identyfikatora.
Poniżej zapoznamy się ze szczegółowym sposobem działania na przykładzie.
Po pierwsze, wywołanie zwrotne Webhook jest usługą, która może odbierać żądania HTTP; programista powinien zastąpić je adresem URL własnego serwera HTTP. W celu wygodnej prezentacji użyto tutaj publicznej przykładowej strony Webhook https://webhook.site/; po otwarciu tej strony można uzyskać adres URL Webhook, jak pokazano na rysunku:
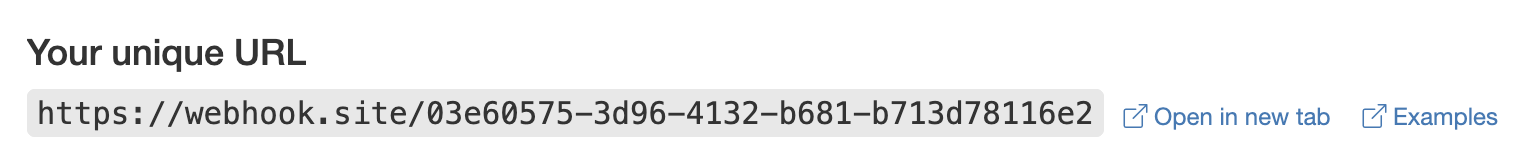 Skopiuj ten URL, aby użyć go jako Webhooka; przykładowy adres tutaj to https://webhook.site/03e60575-3d96-4132-b681-b713d78116e2.
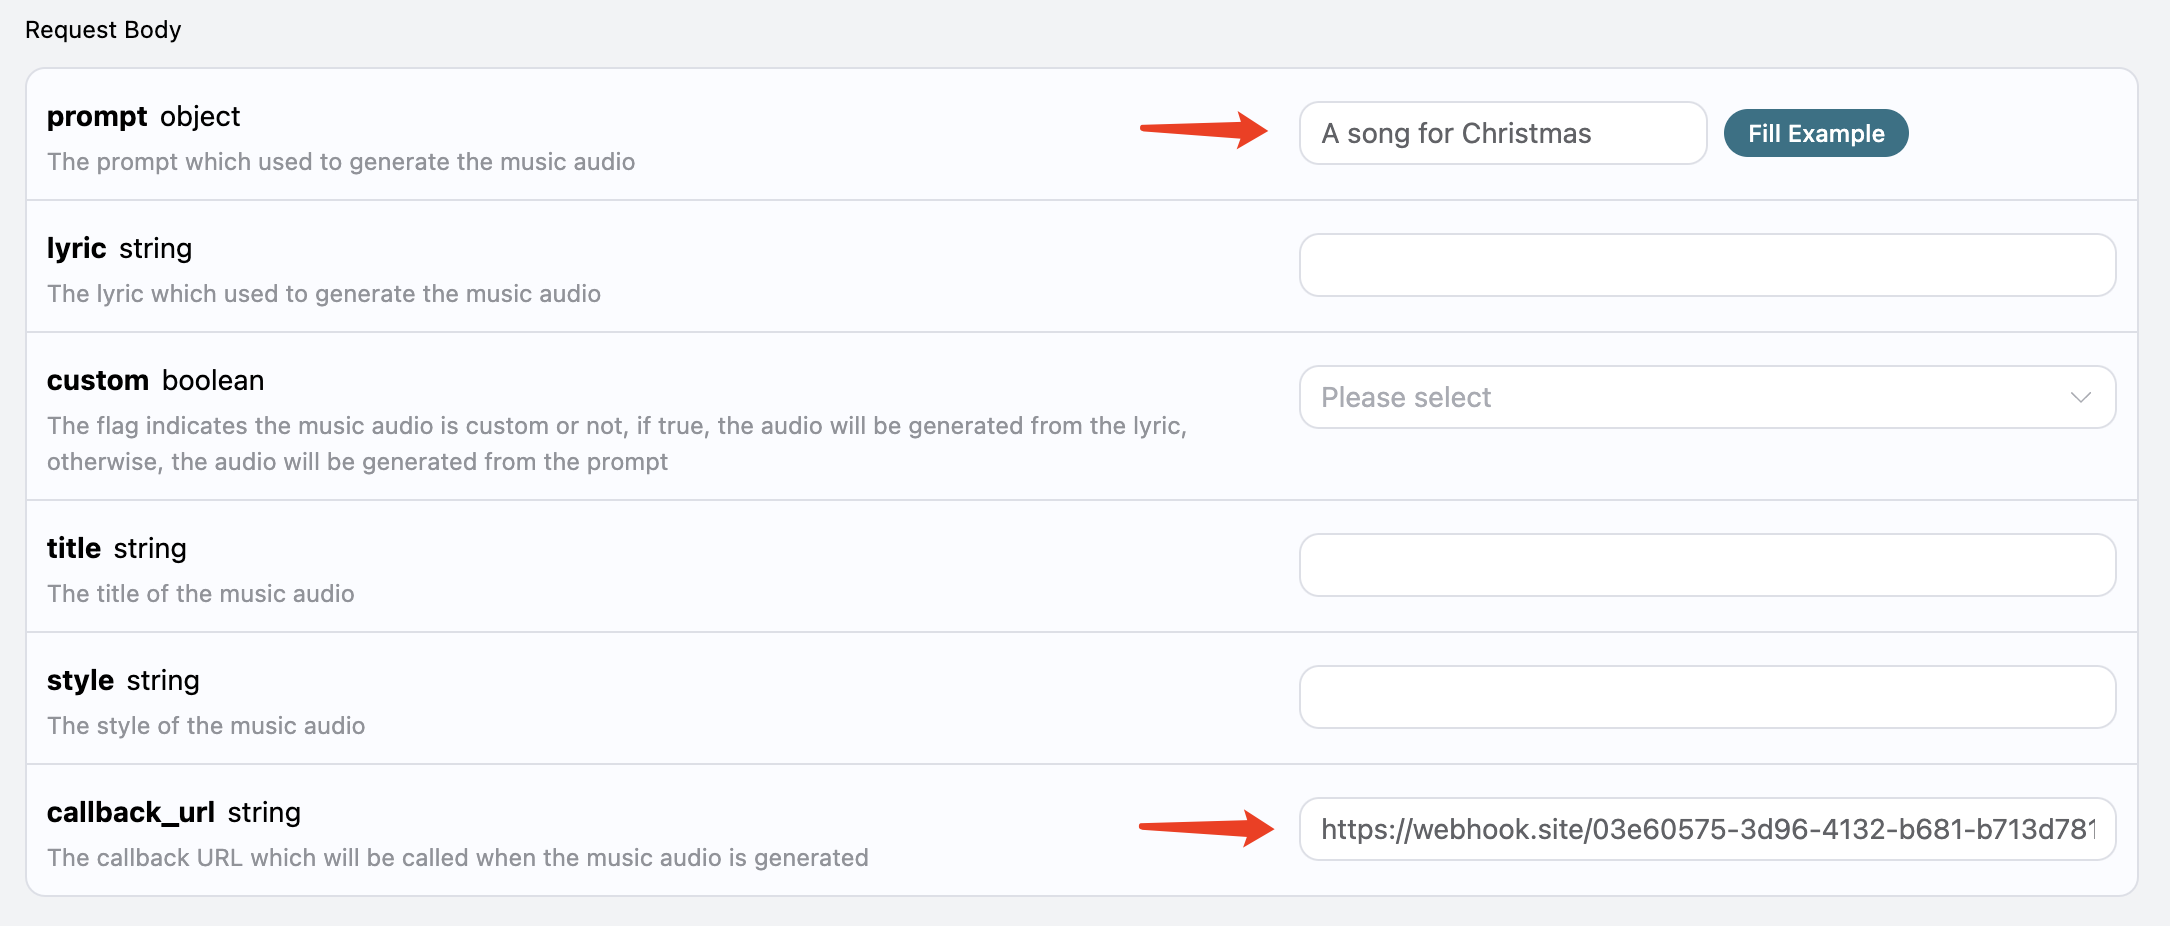
Następnie możemy ustawić pole
callback_url na powyższy adres URL Webhooka, jednocześnie wypełniając prompt, jak pokazano na rysunku:
 Kliknij uruchom, a zobaczysz, że wynik zostanie uzyskany natychmiast, jak poniżej:
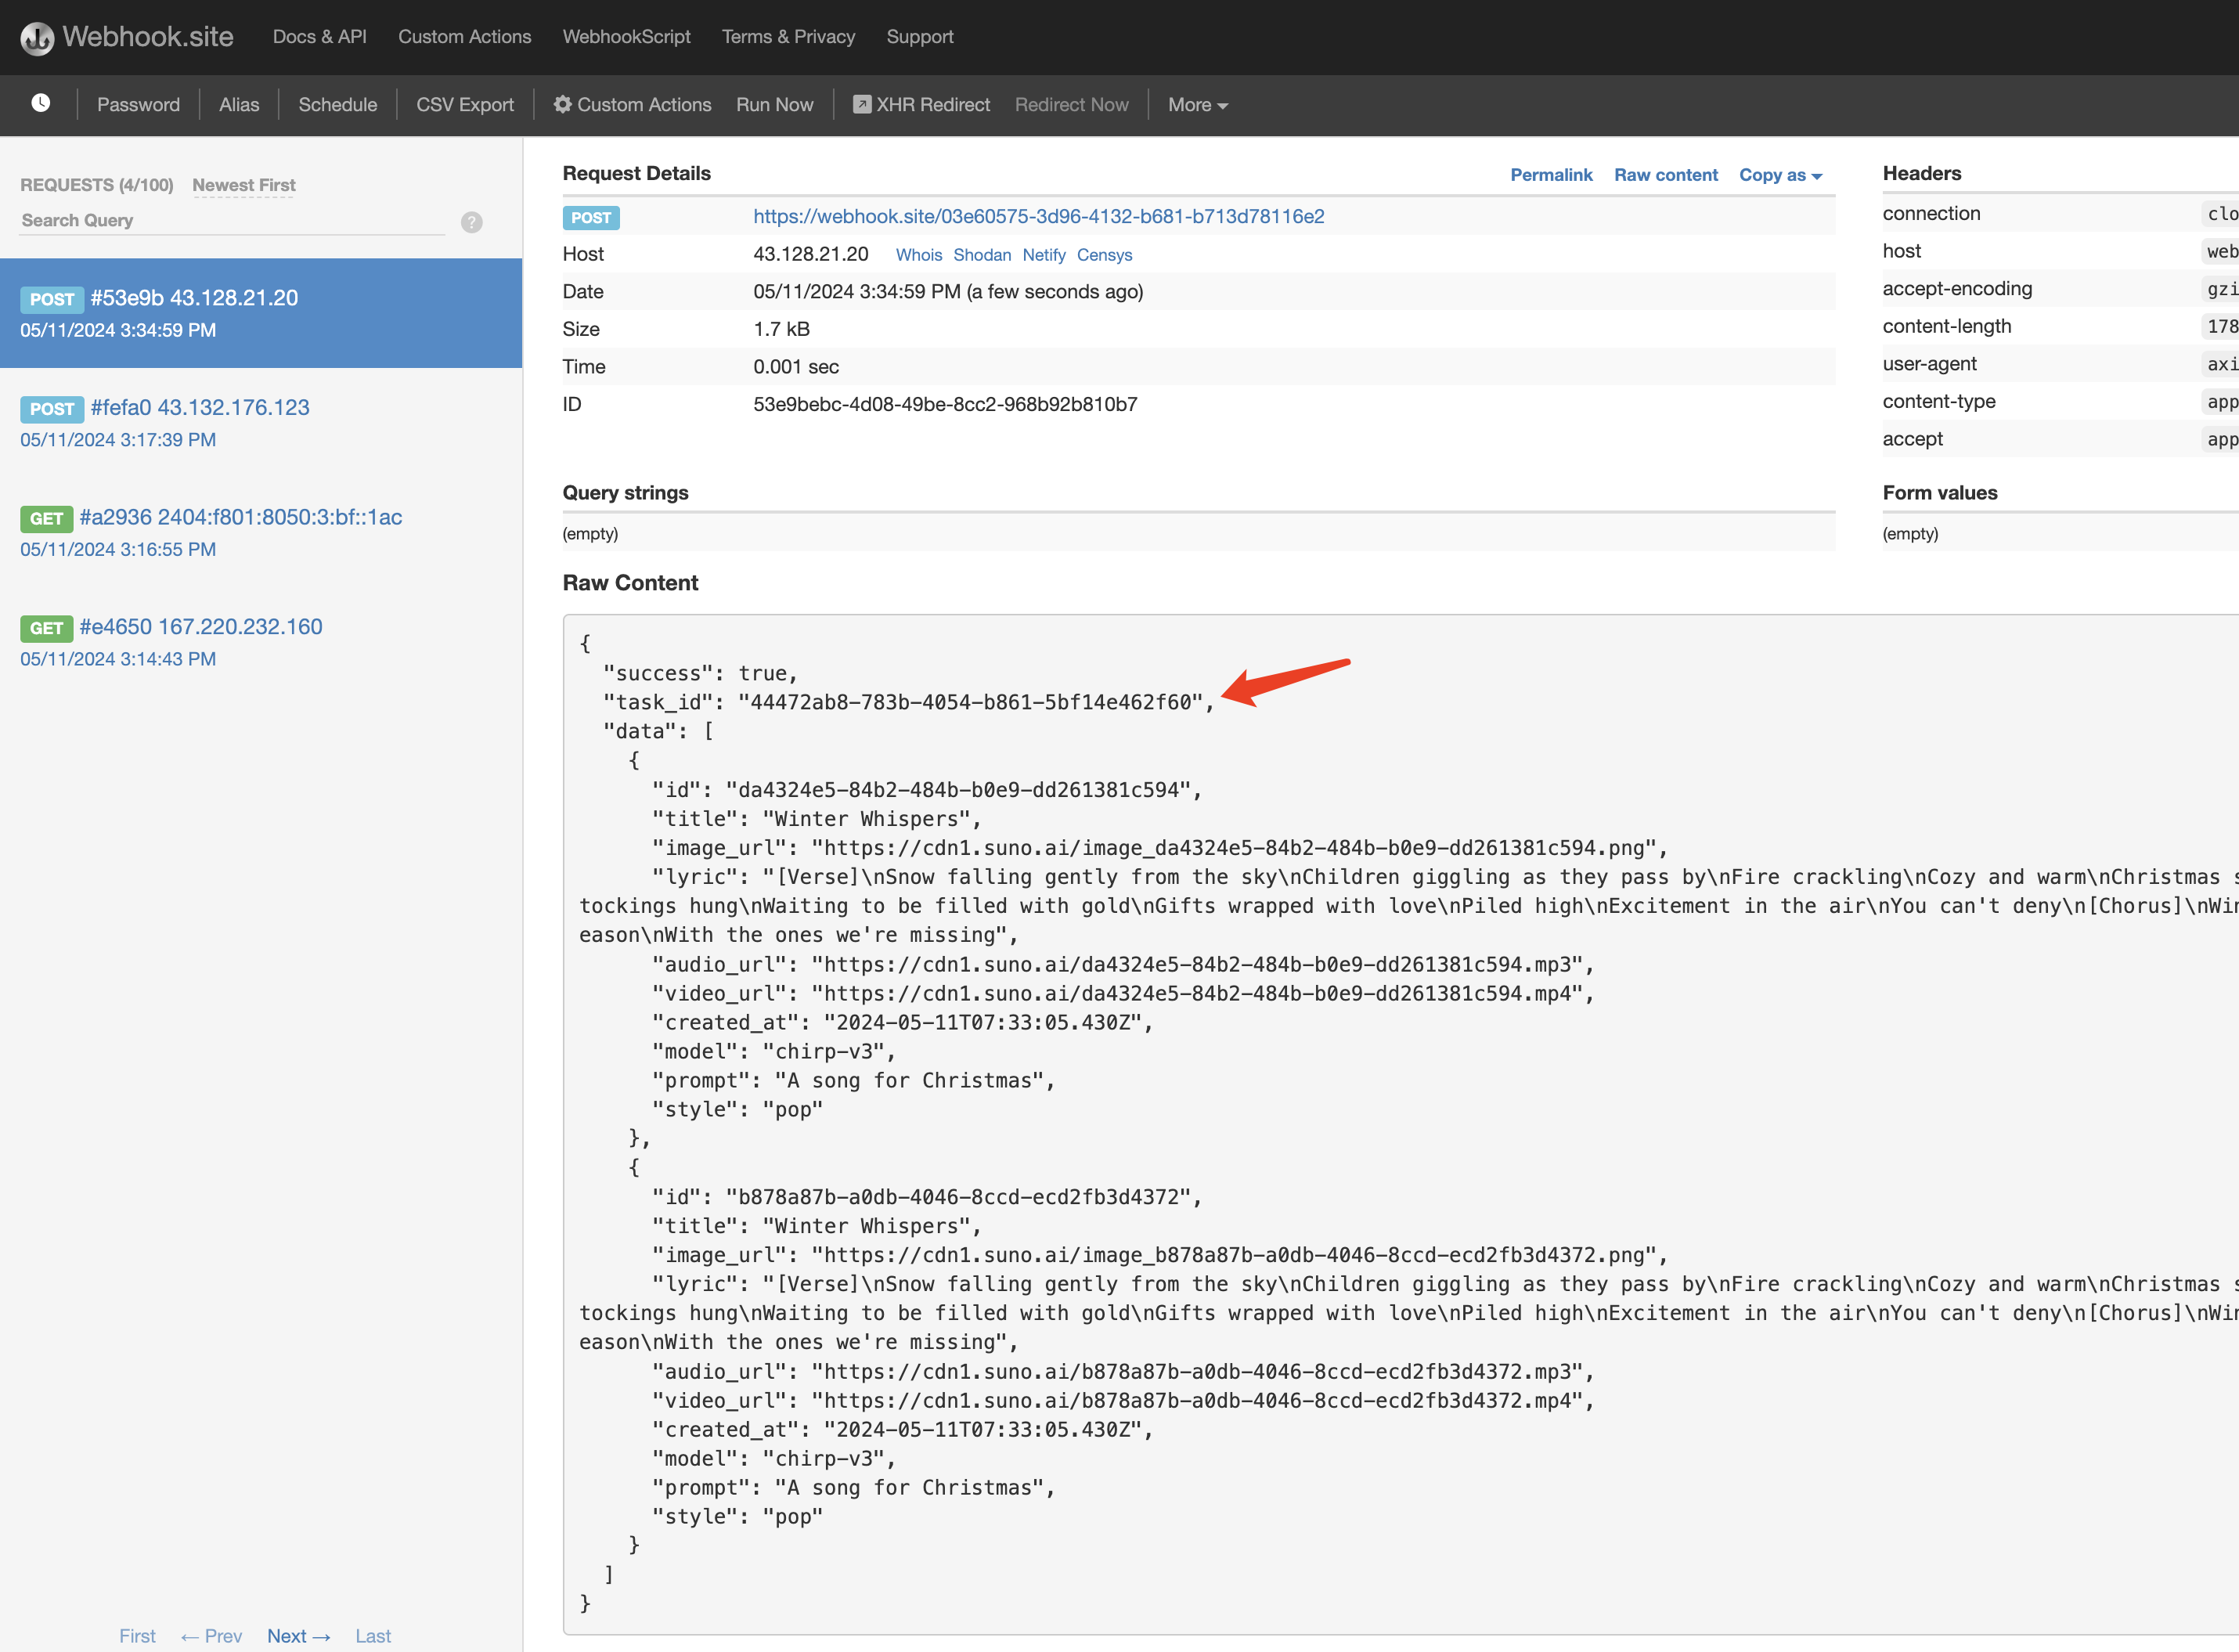 Treść jest następująca:
task_id, a pozostałe pola są podobne do opisanych powyżej; za pomocą tego pola można zrealizować powiązanie zadań.
Oczywiście możemy również uzyskać wynik poprzez wywołanie strumieniowe; wystarczy ustawić wartość accept w nagłówku żądania na application/x-ndjson, poniżej użyto przykładowego wejścia jako demonstracji:
task_id; powyżej zachowano jedynie pierwszą i końcową rzeczywistą odpowiedź, pomijając powtarzające się aktualizacje pośrednie.
Obsługa błędów
Jeśli wystąpi błąd, otrzymasz komunikat o błędzie podobny do następującego:error.code, error.message:
Uwaga: limity i komunikaty o błędach różnych kont upstream mogą się różnić. Zwykle ograniczeniestyledlachirp-v3-5/chirp-v4jest niższe (200), podczas gdychirp-v4-5i nowsze wersje zazwyczaj obsługują do 1000; w przypadku korzystania ze starszego upstreamu mogą pojawić się kompatybilne komunikaty, takie jakTags too long.lubstyle must be less than or equal 120. | Kod statusu |error.code|error.message| | ----------- | ------------- | --------------------------------------------------------------- | | 400 |bad_request|Id utworu nie istnieje lub został wyłączony.| | 400 |bad_request|Prompt jest zbyt długi.| | 400 |bad_request|Tagi są zbyt długie.| | 400 |bad_request|Przesłane audio odpowiada istniejącemu dziełu sztuki.| | 400 |bad_request|instrumental musi być wartością logiczną| | 400 |bad_request|Tytuł jest zbyt długi.| | 400 |bad_request|Temat jest zbyt długi.| | 400 |bad_request|style musi być mniejsze lub równe 120| | 400 |bad_request|custom musi być wartością logiczną| | 400 |bad_request|audio_id jest wymagane podczas rozszerzania audio| | 400 |bad_request|continue_at jest wymagane podczas rozszerzania audio| | 400 |bad_request|continue_at musi być liczbą większą niż 0| | 400 |bad_request|lyric jest wymagane podczas rozszerzania audio, gdy instrumental ma wartość false| | 400 |bad_request|prompt jest wymagane podczas generowania audio| | 400 |bad_request|lyric jest wymagane podczas generowania niestandardowego audio| | 403 |forbidden|Prompt jest prawdopodobnie nieprawidłowo sformułowany| | 403 |forbidden|Prompt prawdopodobnie jest chroniony prawem autorskim| | 403 |forbidden|Prompt zawierał nieodpowiednie materiały| | 403 |forbidden|Opis utworu oznaczony do moderacji| | 403 |forbidden|Opis utworu zawierał nazwę artysty| | 403 |forbidden|Tagi zawierały nazwę artysty| | 403 |forbidden|Tekst zawierał materiały chronione prawem autorskim| | 403 |forbidden|Opis utworu zawierał tag producenta| | 403 |forbidden|Ogólny błąd openAI| | 403 |forbidden|Prompt oznaczony do moderacji| | 500 |api_error|Nie można wygenerować tekstu z opisu utworu| | 500 |api_error|zadanie nie powiodło się z nieznanym błędem| | 500 |api_error|brak dostępnego workera w systemie| | 500 |api_error|usługa w trakcie konserwacji, generowanie wstrzymane| | 504 |timeout|przekroczono limit czasu podczas oczekiwania na generowanie audio|