

Les limitesSuno prend désormais en chargelyricetstyledu tableau ci-dessus sont les plafonds en mode personnalisé (lorsquecustomest défini surtrue). Le mode d’inspiration non personnalisé (lorsquecustomest défini surfalse) ne renseigne queprompt, dont la longueur maximale est de 500 caractères (identique pour tous les modèles).
chirp-v6, chirp-v6-wild et chirp-v6-mini. Il est recommandé d’utiliser chirp-v6 ; les anciens noms de modèles restent compatibles.
Cependant, Suno ne fournit officiellement pas d’API. AceDataCloud fournit un ensemble d’API Suno qui simule l’intégration officielle de Suno, permettant de générer facilement et rapidement la musique souhaitée.
Demande et utilisation
Pour utiliser Suno Audios Generation API, rendez-vous d’abord sur la console Ace Data Cloud afin d’obtenir votre API Token et conservez-le pour une utilisation ultérieure. Si vous n’êtes pas encore connecté ou inscrit, vous serez automatiquement redirigé vers la page de connexion afin de vous inviter à vous inscrire et à vous connecter. Une fois terminé, vous retournerez automatiquement à la page actuelle.
Un seul API Token permet d’appeler tous les services de la plateforme, il n’est pas nécessaire d’en demander un séparément pour chaque service. La première demande offre un quota gratuit permettant une expérience gratuite ; lorsque le quota est insuffisant, vous pouvez recharger le solde universel dans la console.
📘 Documentation complète : Suno Audios Generation API →
Utilisation de base
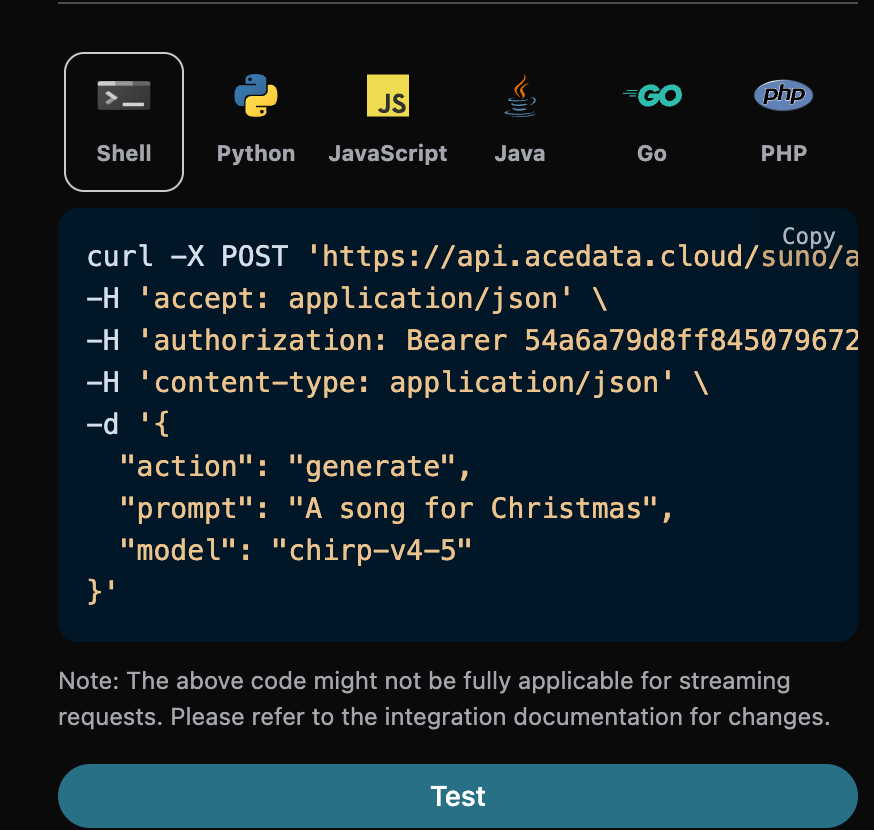
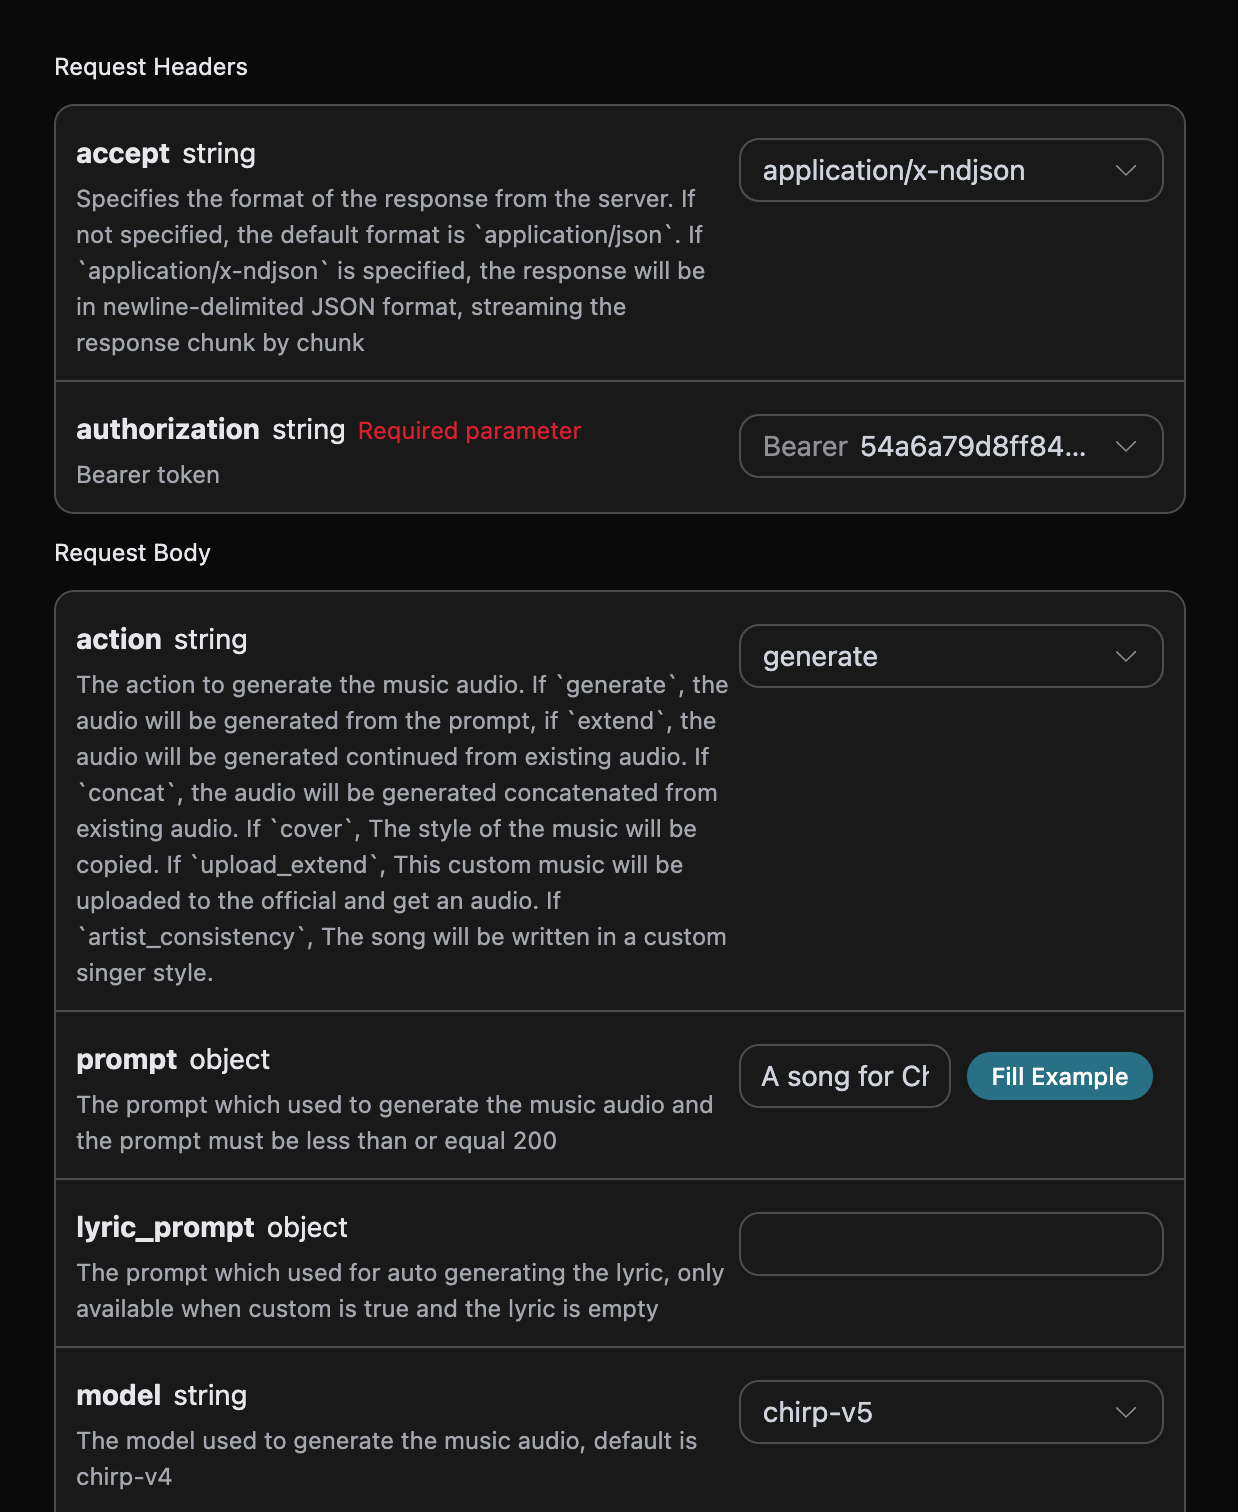
Quelle chanson souhaitez-vous ? Vous pouvez saisir librement un texte, par exemple si je souhaite générer une chanson sur Noël, je peux saisira song for Christmas, comme illustré ci-dessous :
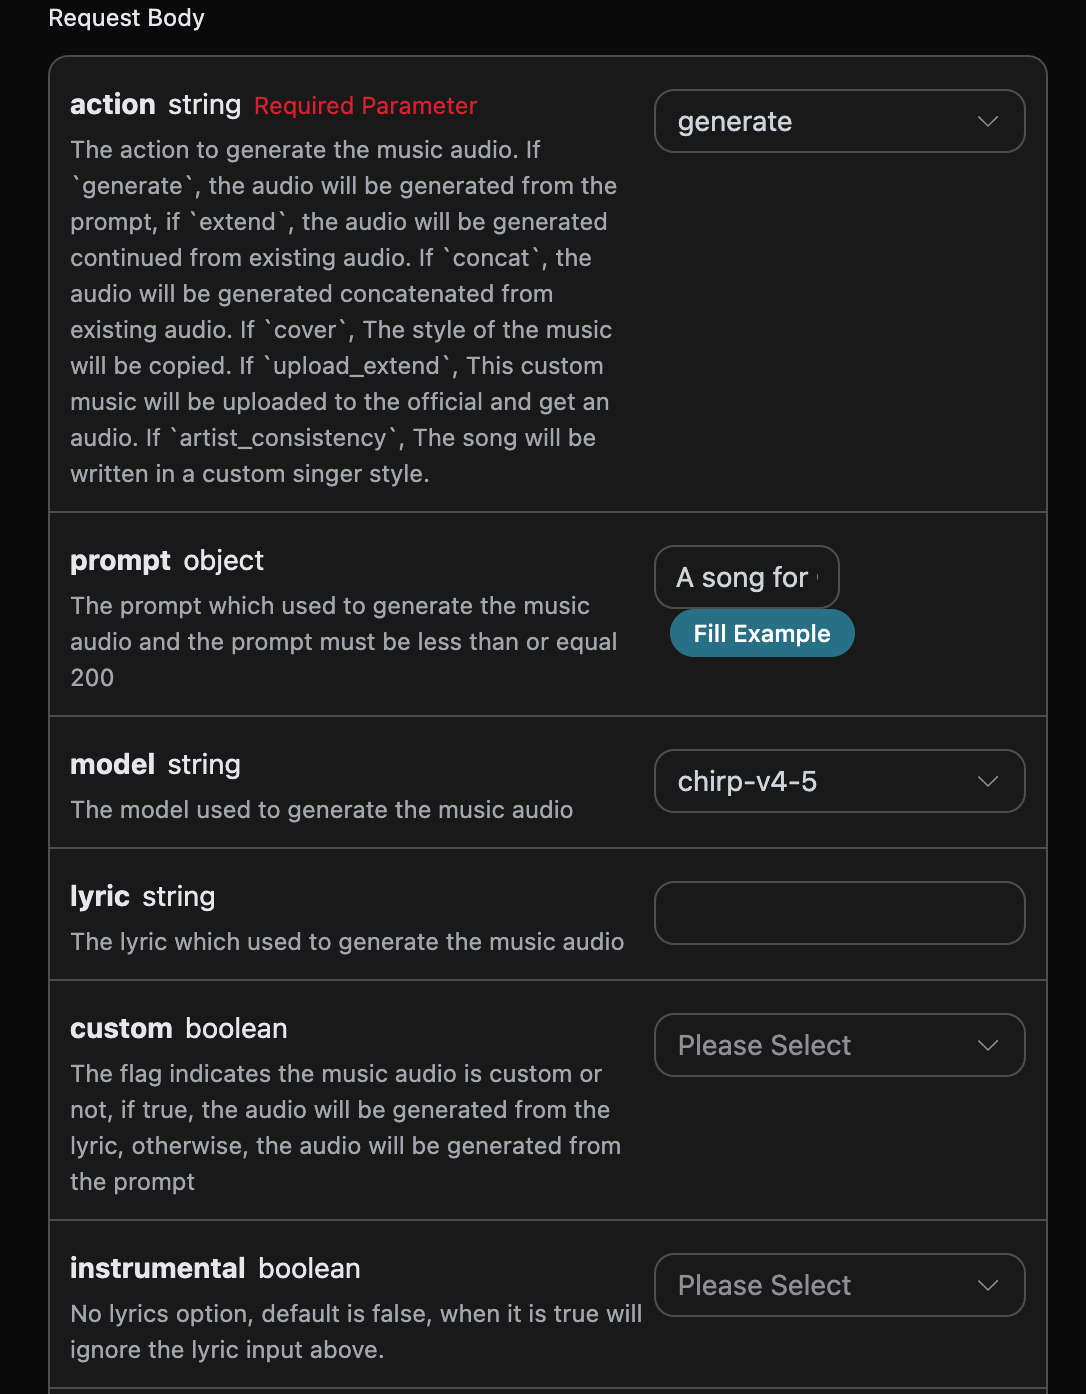
accept: le format de résultat de réponse que vous souhaitez recevoir ; renseignez iciapplication/json, c’est-à-dire le format JSON.authorization: la clé pour appeler l’API, qui peut être sélectionnée directement dans la liste déroulante après la demande.
action: type de tâche audio, par défautgenerate. Prend en charge des opérations telles que la génération, la continuation, la reprise, l’assemblage, la séparation en pistes, l’ajout de piste audio, l’extraction de pistes audio spécifiées, la génération d’effets sonores et l’ajustement de la vitesse, toutes appelées viaPOST /suno/audios.prompt: prompt du mode inspiration officiel de Suno (effectif lorsquecustomestfalse), maximum 500 caractères.model: modèle de cette tâche de génération musicale. La série v6 inclutchirp-v6,chirp-v6-wildetchirp-v6-mini; les anciens noms de modèles restent compatibles.max_mode: mode de génération amélioré.generaten’est activé que lorsquecustometmax_modesont tous deux définis surtrue, avec un coût de 1.12 Credits ;add_stempeut être activé directement, avec un coût de 1.344 Credits. Lorsqu’il est désactivé ou omis, les coûts sont respectivement de 0.56 et 0.672 Credits.variety: intensité de diversité des résultats générés, options disponibles :off,normal,high,extra,max. Utilisé uniquement pourgenerateetadd_stem, son envoi pour d’autres action renverra 400.lyric: contenu des paroles du mode personnalisé officiel de Suno. Maximum 3000 caractères pourchirp-v3-5etchirp-v4; maximum 5000 caractères pourchirp-v4-5et versions ultérieures (y comprischirp-v5,chirp-v5-5).custom: indique s’il faut utiliser le mode personnalisé, par défaut :false.instrumental: option de musique instrumentale du mode inspiration officiel de Suno.title: titre musical du mode personnalisé officiel de Suno. Maximum 80 caractères pourchirp-v3-5,chirp-v4; maximum 100 caractères pourchirp-v4-5et versions ultérieures.style: style musical du mode personnalisé officiel de Suno. Maximum 200 caractères pourchirp-v3-5etchirp-v4; maximum 1000 caractères pourchirp-v4-5et versions ultérieures (y comprischirp-v5,chirp-v5-5).negative_tags: styles ou genres musicaux à exclure des résultats générés en mode personnalisé (customesttrue).audio_weight: poids d’influence des caractéristiques audio ou vocales, plage 0-1,0est également une valeur valide. Peut être utilisé pour des opérations telles que la génération, la continuation, la reprise, l’ajout de piste audio et la cohérence vocale ; sans audio de référence ou caractéristiques vocales, le modèle peut atténuer ou ignorer cette valeur.audio_id: ID de la musique de référence.overpainting_start/overpainting_end: heures de début et de fin, en secondes, pour ajouter des voix à une musique instrumentale existante.underpainting_start/underpainting_end: heures de début et de fin, en secondes, pour ajouter un accompagnement à un chant a cappella.persona_id: ID de chanson de l’artiste.continue_at: limite de continuation, en secondes. Par exemple, 213.5 signifie générer le segment suivant à partir de 3 minutes et 33.5 secondes.lyricetstyleguident uniquement le nouveau contenu après la limite et ne remplacent pas les paroles ou le chant avant la limite dans l’audio source.style_influence: influence du style en mode personnalisé, plage 0-1 ; plus elle est élevée, plus le résultat correspond généralement au style sélectionné ;0est transmis comme valeur valide.replace_section_end: heure finale du segment à remplacer.replace_section_start: heure de début du segment à remplacer.vocal_gender: contrôle la préférence pour les voix féminines et masculines, voix fémininef, voix masculinem, effectif pour les modèles 4.5 et ultérieurs ; il s’agit d’une préférence, dont le respect strict n’est pas garanti.weirdness: degré d’étrangeté en mode personnalisé, plage 0-1 ; plus il est élevé, plus le résultat est généralement créatif et expérimental ;0est transmis comme valeur valide.duration: durée souhaitée de la chanson, en secondes, doit être un entier, plage de 10 à 360. Ce paramètre est utilisé pour la génération de chansons en mode personnalisé (customesttrue). Il s’agit d’une indication d’orientation plutôt que d’une contrainte stricte : le modèle s’y référera, mais ne garantit pas de l’atteindre ; la durée réelle du produit final dépend du champdurationdans la réponse et est généralement inférieure à la valeur souhaitée.
Portée d’application des paramètres avancés
La plateforme vérifie les types de paramètres et les plages de valeurs, mais ne rejettera pas ces options de réglage facultatives uniquement parce que l’action est différente ; les effets spécifiques dépendent de l’opération, du mode et du modèle.
lyric_prompt: prompt pour générer les paroles, effectif si et seulement sicustomesttrueet quelyricn’est pas fourni.callback_url: URL à laquelle les résultats doivent être rappelés.async: facultatif, lorsque défini surtrue, l’interface renvoie immédiatementtask_id, sans nécessiter de fournircallback_url, puis récupère les résultats en interrogeant périodiquement l’interface de requête de tâche correspondante.
- success : indique si la génération a réussi ; si elle réussit, la valeur est
true, sinon elle estfalse - data : est une liste contenant les informations détaillées des chansons générées.
- state : état de génération de la chanson, comprenant principalement quatre types, comme suit :
- succeeded : génération réussie
- pending : dans la file d’attente
- running : en cours d’exécution
- error : échec
- id : ID de la chanson
- title : titre de la chanson
- image_url : image de couverture de la chanson
- lyric : paroles de la chanson
- audio_url : adresse audio finale de la chanson. La plateforme renverra en priorité l’adresse Ace Data Cloud CDN ; en cas d’échec de la persistance, l’adresse média d’origine peut être renvoyée, veuillez la télécharger à temps.
- video_url : fichier vidéo de la chanson, qui est une vidéo mp4 une fois ouvert.
- created_at : heure de création
- model : modèle utilisé, généralement le dernier modèle v3
- style : style
- state : état de génération de la chanson, comprenant principalement quatre types, comme suit :
Génération personnalisée
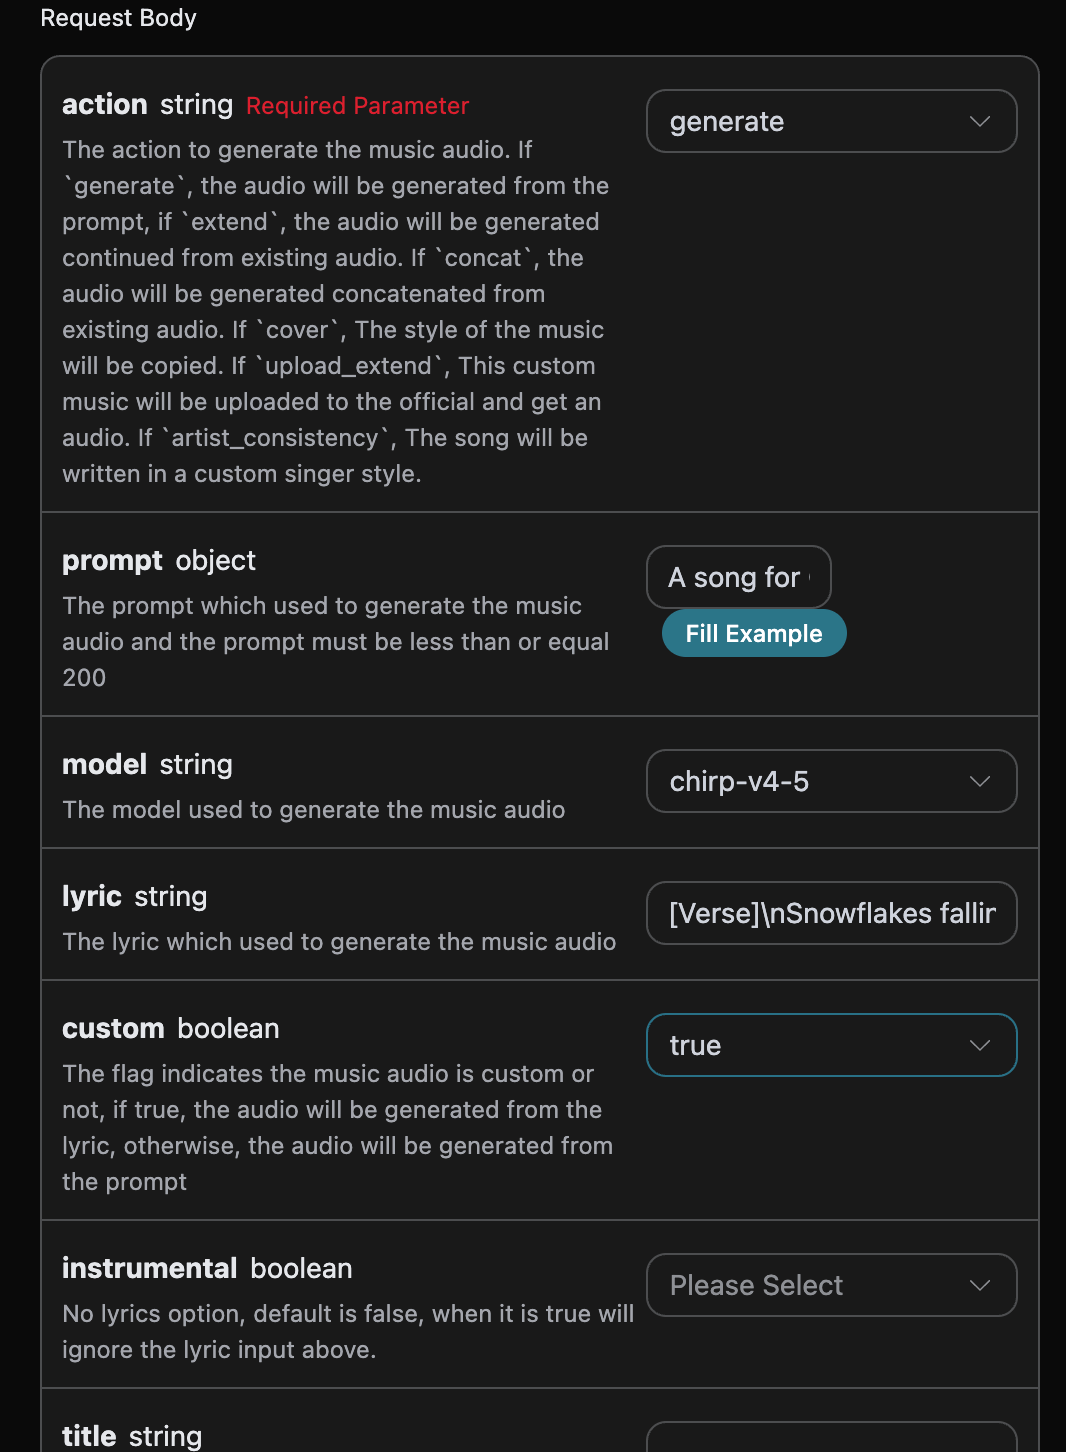
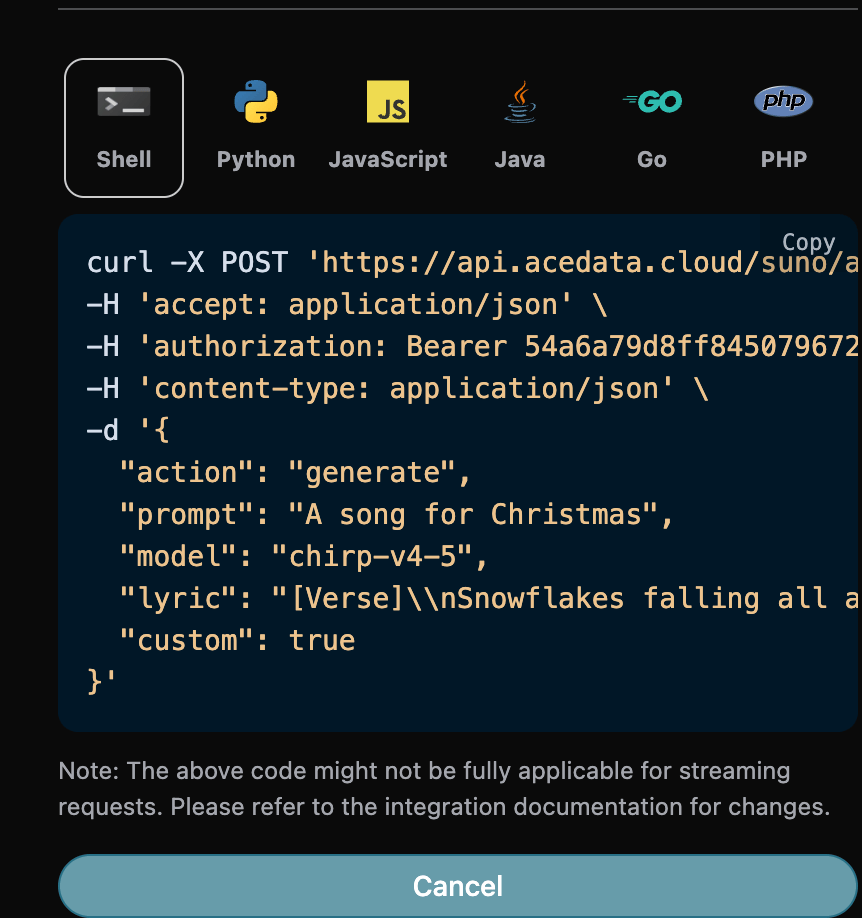
Si vous souhaitez générer des paroles personnalisées, vous pouvez saisir des paroles : À ce moment-là, le champlyric peut transmettre un contenu semblable à celui-ci :
Remarque : dans les paroles ici, \n est un caractère de saut de ligne. Si vous ne savez pas comment générer des paroles, vous pouvez utiliser l’API de génération de paroles fournie par AceDataCloud pour générer des paroles via un prompt. L’API est Suno Lyrics Generation API.
Ensuite, si nous voulons générer une chanson personnalisée selon les paroles, le titre et le style, nous pouvons spécifier le contenu suivant :
- lyric : texte des paroles
- custom : renseignez
true, ce qui représente une génération personnalisée ; ce paramètre estfalsepar défaut, ce qui représente une génération à l’aide deprompt. - title : titre de la chanson.
- style : style de la chanson, facultatif.
Fonction de génération personnalisée de style de chanteur
Si vous souhaitez utiliser un style de chanteur pour générer une chanson, générez d’abord une chanson via l’utilisation de base ci-dessus,puis vous devez définir cette chanson comme style de chanteur. Ensuite, vous devez accéder à Suno Persona API pour générer un paramètre d’identifiant de style de chanteur
persona_id à partir de l’ID de musique audio_id généré officiellement. Les paramètres spécifiques sont indiqués dans l’image ci-dessous :
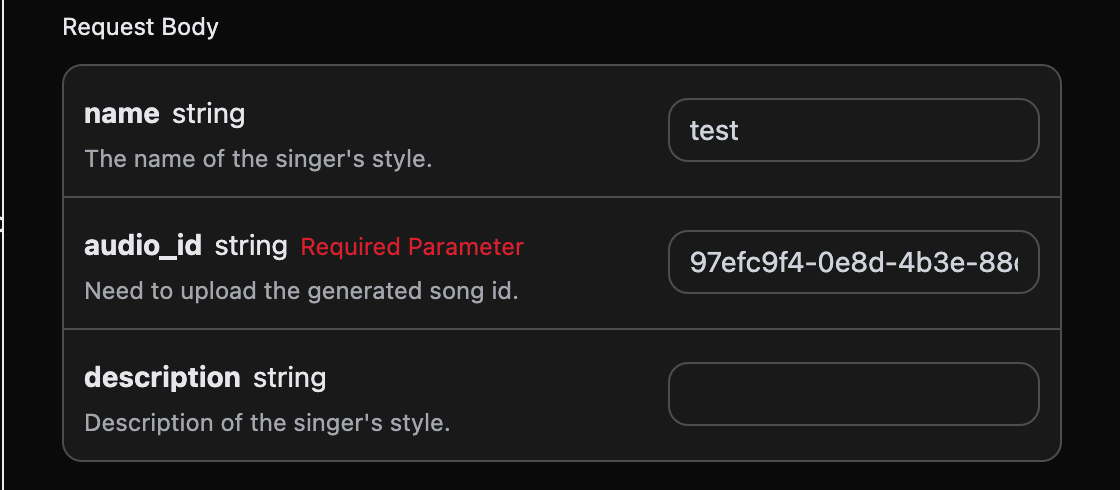
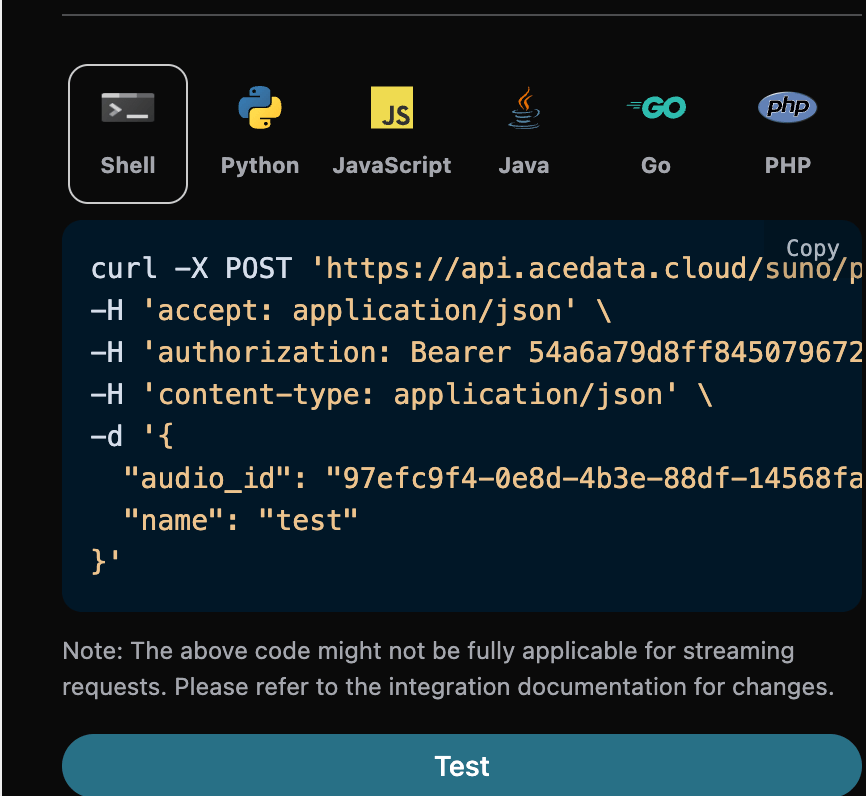
audio_id et persona_id ci-dessus, soit respectivement 97efc9f4-0e8d-4b3e-88df-14568fa1b11f et e0d7319e-aa2a-44cb-b00a-916218d7cb0b, comme données d’exemple pour cette fois-ci. Ensuite, vous pouvez définir le paramètre action sur artist_consistency (s’il s’agit du nouveau style de chanteur Persona-v2-vox, action doit être défini sur artist_consistency_vox), puis saisir l’ID de la chanson à continuer de générer et l’ID du style de chanteur. Un exemple de remplissage est présenté ci-dessous :
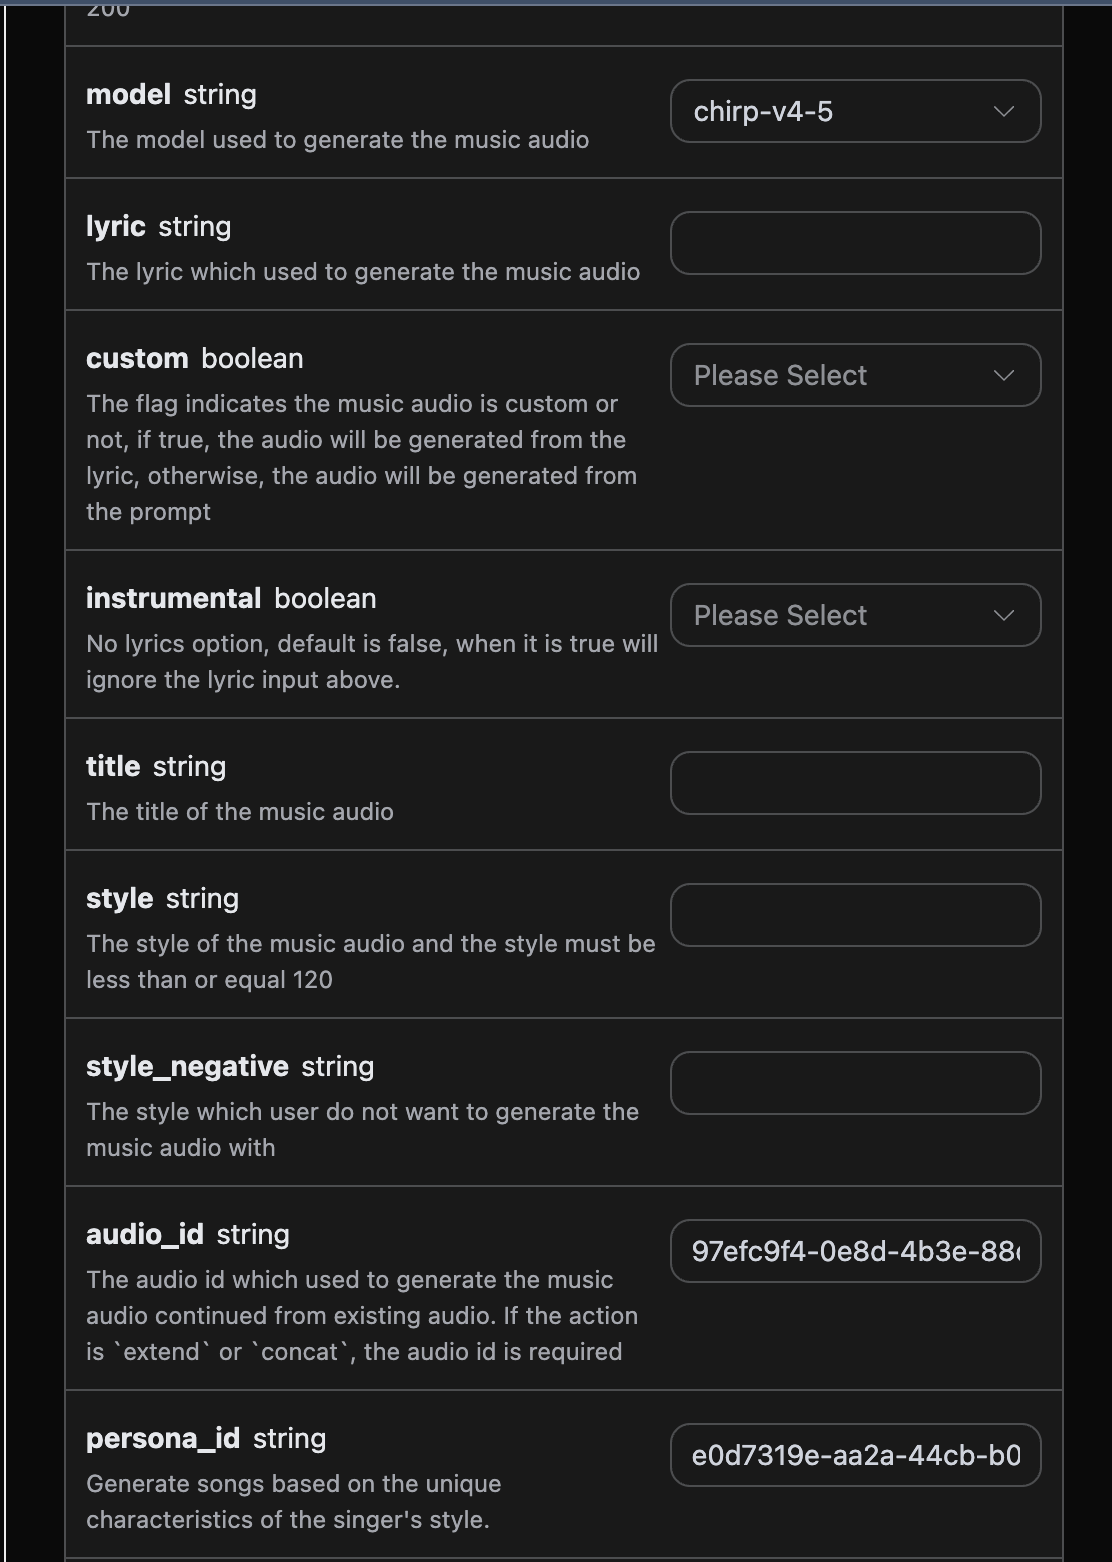
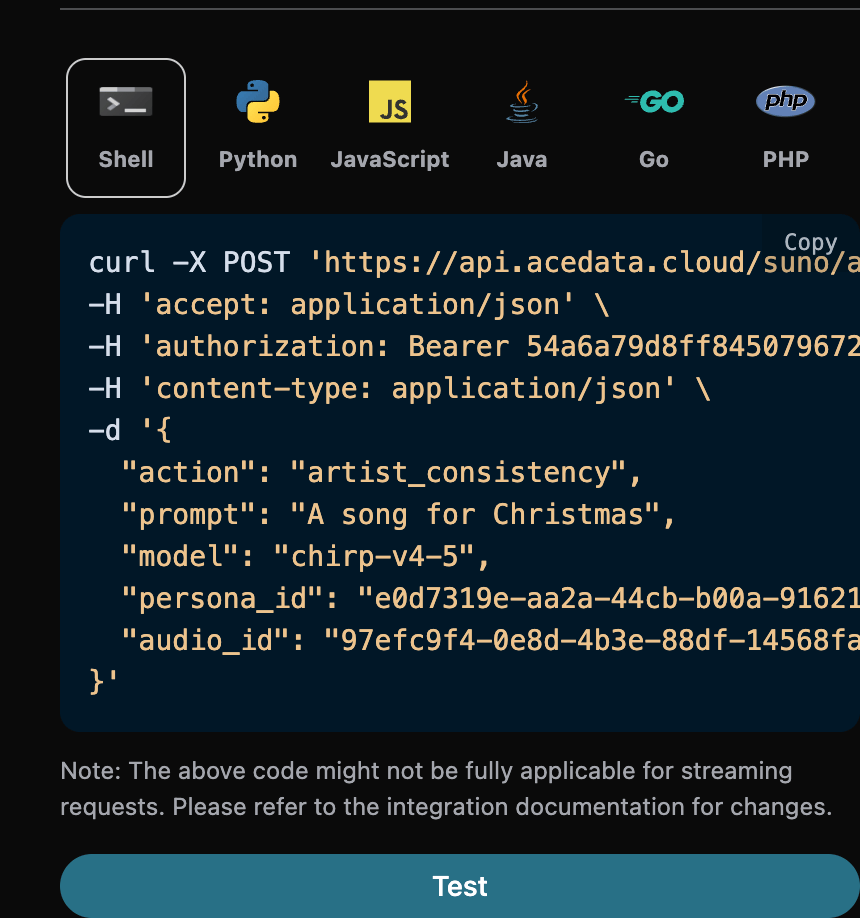
Fonctionnalité de prolongation de génération
Si vous souhaitez prolonger la génération d’une chanson Suno déjà générée, vous pouvez définir le paramètreaction sur extend, puis saisir l’ID de la chanson à continuer de générer. L’obtention de l’ID de la chanson se fait selon l’utilisation de base ; d’après ce qui précède, vous pouvez voir que l’ID de la chanson est alors :
Remarque : ici, l’id dans les paroles est l’ID de la chanson générée. Si vous ne savez pas comment générer une chanson, vous pouvez vous référer à l’utilisation de base ci-dessus pour générer une chanson.
Si vous souhaitez prolonger la génération d’une chanson que vous avez vous-même téléversée, vous pouvez définir le paramètre action sur upload_extend, puis saisir l’ID de la chanson téléversée personnalisée à continuer de générer. L’obtention de l’ID de la chanson se fait en utilisant Suno Upload Generation API, comme indiqué dans l’image ci-dessous :
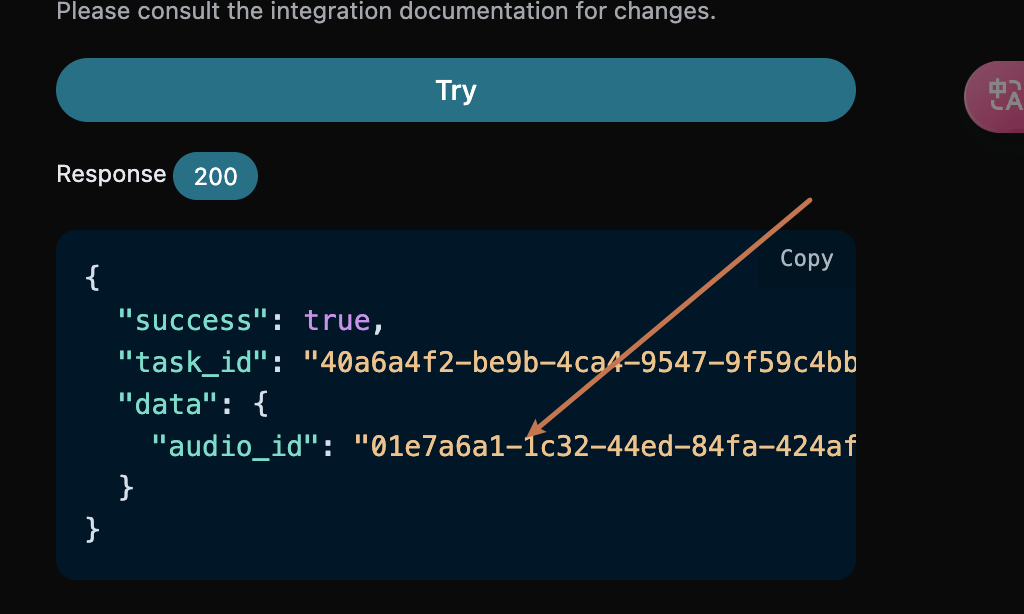
- lyric : utilisé uniquement pour guider les paroles du nouveau segment généré après
continue_at, et ne remplacera pas les paroles avant ce point temporel dans l’audio source. - custom : renseignez
true, ce qui représente une génération personnalisée ; ce paramètre est défini par défaut sur false, ce qui représente une génération à l’aide deprompt. - style : le style musical du segment à prolonger, facultatif.
- continue_at : la limite de prolongation, en secondes. Par exemple, 213.5 signifie que le segment suivant sera généré à partir de 3 minutes 33,5 secondes.
Un exemple de remplissage est présenté ci-dessous :extendest utilisé pour continuer la création après une chanson existante, et non pour changer les paroles de toute la chanson. Si vous souhaitez utiliser de nouvelles paroles depuis le début pour toute la chanson, veuillez utilisergeneratepour régénérer ; si vous souhaitez réinterpréter une chanson existante à titre de référence, vous pouvez utilisercover. Lors de la transmission de nouvelles paroles complètes, les paroles originales avantcontinue_atne seront toujours pas remplacées.
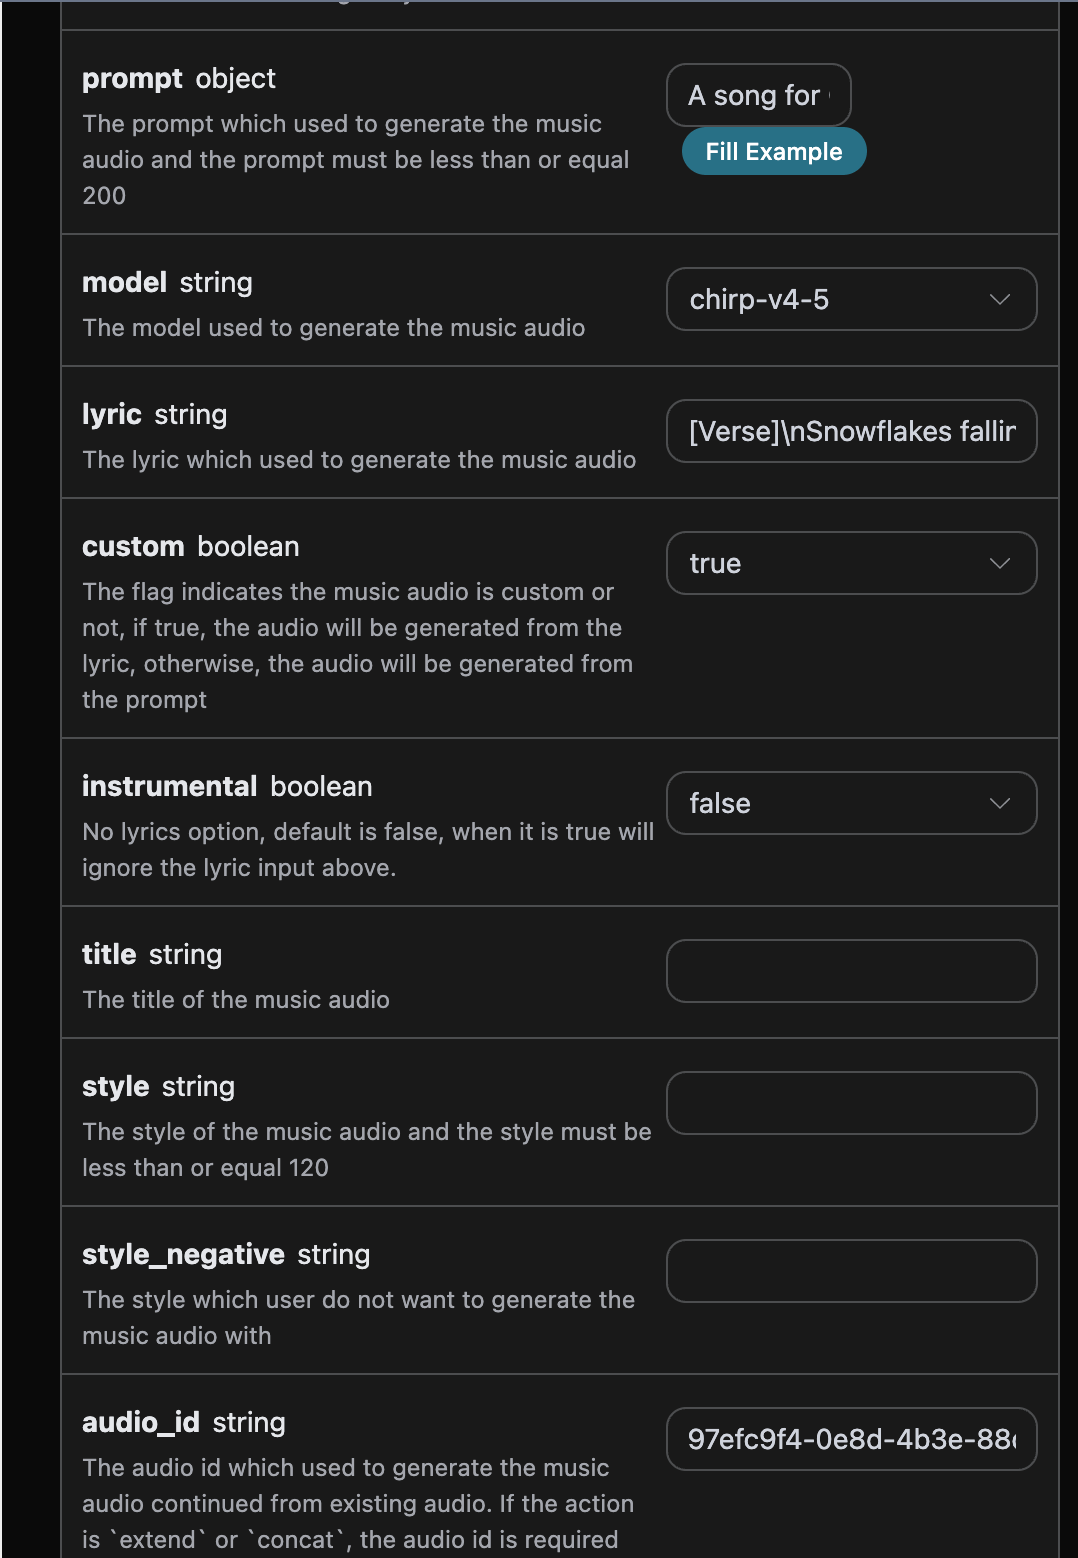
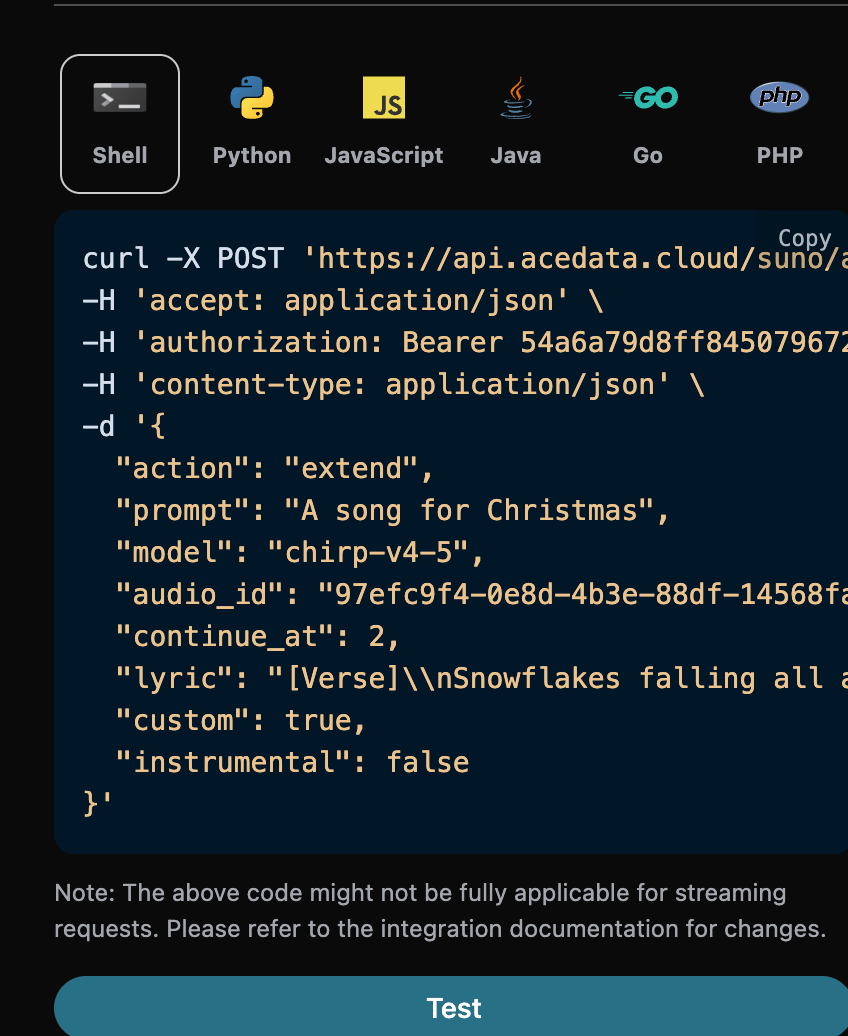
continue_at est de 2 secondes ; par conséquent, seules les 2 premières secondes appartiennent au contenu original avant la limite de continuation. Lors d’une continuation proche de la fin réelle de la chanson, cette valeur doit être définie sur le nombre de secondes auquel vous souhaitez commencer la continuation, et fournissez uniquement dans lyric le nouveau passage à chanter après la limite.
Le code Python correspondant :
lyric dans le résultat renvoie le texte des paroles utilisé par cette tâche de continuation. Ce champ n’est pas une transcription mot à mot de l’audio final complet ; pour extend, l’audio source avant continue_at utilise toujours les paroles originales, et les nouvelles paroles sont utilisées uniquement pour guider le segment de continuation.
Obtenir la chanson complète
Le résultat deextend du modèle actuel contient généralement déjà l’audio source avant continue_at et le nouveau contenu après la limite ; veuillez d’abord déterminer, en fonction de la durée réelle et du contenu de l’audio renvoyé, s’il s’agit déjà de la chanson complète. Si le résultat renvoyé est un segment de continuation indépendant, ou s’il est nécessaire de fusionner explicitement l’historique de plusieurs continuations en une seule chanson, utilisez ensuite la fonction de concaténation :
- action : la valeur est
concat. - audio_id : l’ID du dernier segment de continuation.
Reprise musicale
Lorsqu’une chanson est générée à partir d’une chanson existante, le style de la chanson renvoyée peut ne pas être très approprié. Si vous souhaitez faire une reprise de la chanson précédemment générée (les musiques téléversées de manière personnalisée sont également prises en charge), vous devez utiliser la méthode de reprise musicale, qui permet de spécifier le contenu suivant :- action : le contenu est
cover; lorsqu’il s’agit d’effectuer une opération de reprise sur une musique téléversée de manière personnalisée, le contenu doit obligatoirement être spécifié comme :upload_cover. - audio_id : l’ID de la chanson générée précédemment.
Remplacer un segment
Lorsqu’après la génération d’une chanson, une seconde création nécessitant une opération distincte de remplacement d’un segment de la chanson doit être effectuée, il est possible de remplacer un certain segment de la chanson.⚠️ Remarque :Les paramètres sont décrits comme suit :replace_section_result_modeest par défaut défini surfull_song: le système concatène respectivement 2 nouveaux candidats générés et renvoie 2 chansons complètes. Si seuls les candidats de segments de remplacement non encore concaténés sont nécessaires, définissez explicitement cette valeur surcandidates, puis sélectionnez un candidat pour appeler Concaténation musicale.
- action : le contenu est
replace_section. - audio_id : l’ID de la chanson originale (la chanson source à remplacer).
- model : le modèle de génération de chansons.
- lyric : les paroles complètes après remplacement (y compris le segment remplacé et son contexte, cohérents avec le contenu dans
prompt). - prompt : les nouvelles paroles du segment à remplacer.
- style : le style de la chanson, facultatif.
- replace_section_start : l’heure de début du segment remplacé dans la chanson originale (secondes).
- replace_section_end : l’heure de fin du segment remplacé dans la chanson originale (secondes).
- replace_section_result_mode : le mode de retour, défini par défaut sur
full_song.full_songconcatène respectivement 2 candidats et renvoie 2 chansons complètes ;candidatesrenvoie 2 segments candidats non encore concaténés.
Étape 1 : lancer une tâche de remplacement de segment
Par exemple, si l’ID de la chanson générée précédemment est : 18db7ed0-2b8a-41db-91c1-b0781dcca0d4 (durée de 94,12 secondes), et que vous souhaitez remplacer le refrain de la 30e à la 60e seconde par de nouvelles paroles, les paramètres peuvent être définis comme suit :replace_section_result_mode est défini sur candidates, 2 extraits de remplacement non encore assemblés sont renvoyés, avec une structure identique à l’exemple ci-dessous :
candidates, les durées des deux pistes audio renvoyées (45,16 secondes, 33,8 secondes) sont bien plus courtes que la chanson originale (94,12 secondes) ; ce sont des extraits de remplacement contenant un peu de contexte, et non la chanson entière. Vous pouvez sélectionner un candidat satisfaisant pour continuer à l’assembler manuellement. Le mode full_song par défaut effectue quant à lui les deux assemblages et renvoie directement 2 chansons complètes.
Renvoyer directement des chansons complètes
Si vous souhaitez obtenir directement des chansons complètes, vous pouvez définirreplace_section_result_mode sur full_song à l’étape un. L’interface assemblera respectivement les deux candidats et renverra 2 chansons complètes ; il n’est alors pas nécessaire d’appeler concat à nouveau.
Étape deux : assembler l’extrait de remplacement dans la chanson originale
Pour l’extrait sélectionné ci-dessus (par exemple364f9d8b-ca25-463b-9a5e-d0b7139e2d6a), lancez une tâche concat selon la méthode de la section Assemblage musical :
duration est revenu à la durée complète de la chanson (105,28 secondes, soit approximativement la durée de la chanson originale), et audio_url pointe vers la chanson entière une fois le remplacement terminé. Cela achève le processus de création secondaire « génération → remplacement de segment → assemblage de la chanson entière ».
Séparation voix-musique
Lorsqu’une création secondaire nécessitant des opérations distinctes sur l’accompagnement et les voix est requise après la génération d’une chanson, il est possible de séparer l’accompagnement musical pur et les voix a cappella. Vous pouvez alors spécifier le contenu suivant :- action : la valeur est
stems. - audio_id : l’ID de la chanson générée précédemment.
Séparation voix-musique de toutes les pistes
Lorsqu’une opération de séparation voix-musique de toutes les pistes est requise après la génération d’une chanson, vous pouvez alors spécifier le contenu suivant :- action : la valeur est
all_stems. - audio_id : l’ID de la chanson générée précédemment.
Ajouter une piste audio
add_stem génère une piste d’instrument ou de voix cible pour l’audio spécifié, via POST /suno/audios.
- Requis :
action,audio_id,stem_type. - Facultatif :
model,prompt,title,style,negative_tags,weirdness,style_influence,audio_weight,max_mode,variety. - Facturation : 0.672 Credits en mode normal ; 1.344 Credits lorsque
max_modeest défini surtrue.
Extraire une piste audio
extract_stem extrait la piste audio cible de l’audio spécifié, tout en renvoyant une version complémentaire après suppression de cette piste audio, via POST /suno/audios.
- Requis :
action,audio_id,stem_type. - Facultatif :
audio_format, le contrat public à deux canaux ne prend actuellement en charge quemp3. - Facturation : 1.12 Credits.
data dans la réponse à l’état terminal conserve une liste audio plate, tandis que stem_sets indique la relation de correspondance entre la piste audio cible et la piste audio complémentaire :
Générer des effets sonores
sounds génère des effets sonores ponctuels ou en boucle à partir d’une description textuelle, via POST /suno/audios.
- Requis :
action,sound,sound_type. - Facultatif :
model,bpm,key,audio_format;audio_formatne prend actuellement en charge quemp3. sound_type:one-shotouloop.- Facturation : 0.112 Credits.
Ajuster la vitesse audio
adjust_speed ajuste la vitesse de lecture de l’audio spécifié, via l’appel POST /suno/audios.
- Obligatoire :
action,audio_id,speed_multiplier,title. - Facultatif :
keep_pitch. speed_multiplier: plage de 0.25 à 4.- Facturation : 0.28 Credits.
Paramètres avancés de génération personnalisée
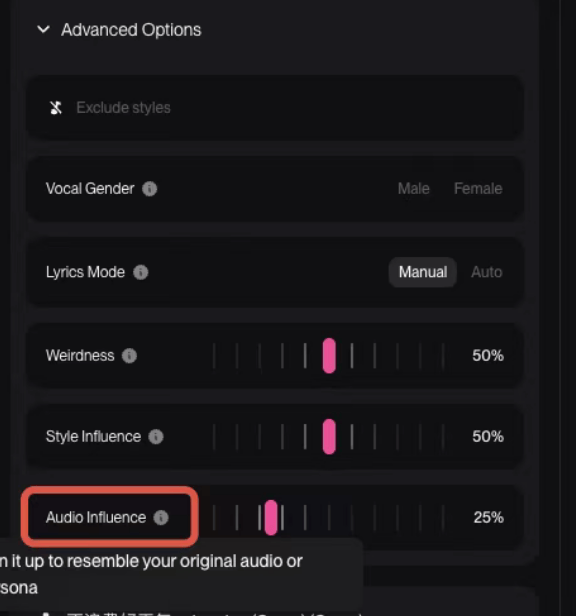
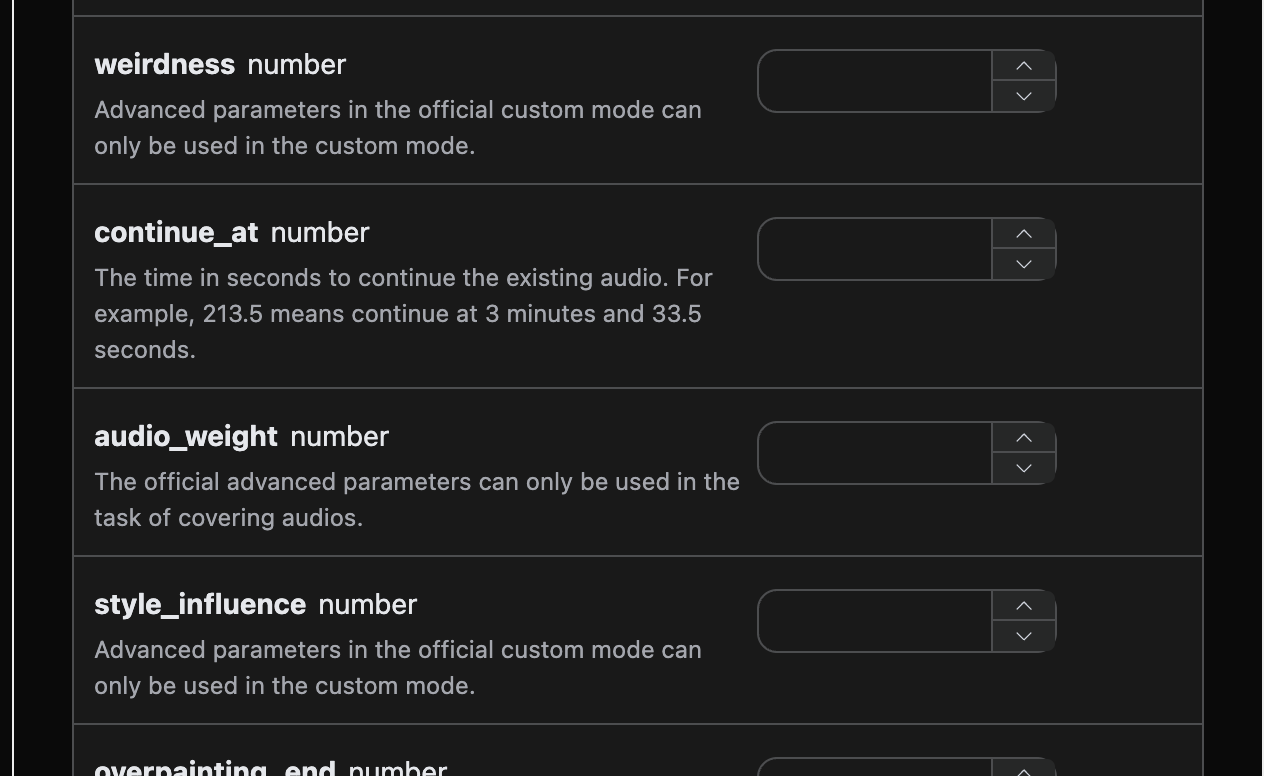
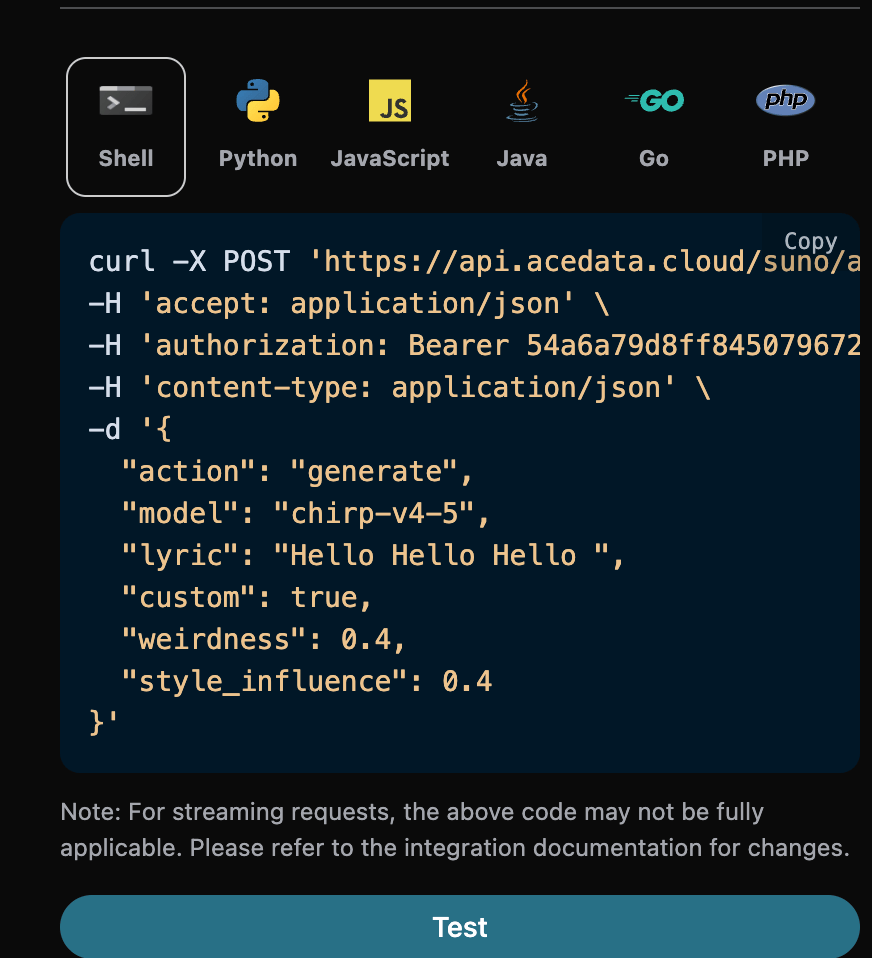
L’interface officielle permet d’utiliser, en mode personnalisé, les paramètres avancésweirdness==>Weirdness, style_influence==>Style Influence, audio_weight==>Audio Influence pour générer du contenu, correspondant aux exemples officiels suivants :
Contrôler la durée de la chanson
Par défaut, la durée des chansons générées est déterminée par le modèle lui-même, généralement entre 30 secondes et 4 minutes. Si un résultat final plus long ou plus court est nécessaire, la durée souhaitée peut être spécifiée à l’aide du paramètreduration, en secondes, avec une valeur entière comprise entre 10 et 360.
Ce paramètre est utilisé pour la génération de chansons en mode personnalisé (custom est true). Il est particulièrement important de préciser que duration est une indication de préférence, et non une contrainte stricte : le modèle se référera à cette valeur lors de la création, mais ne garantit pas de l’atteindre ; lors des tests, la durée réelle est généralement nettement inférieure à la valeur souhaitée, et la durée des deux chansons renvoyées par une même requête peut également différer de plusieurs fois. Même pour des requêtes entièrement identiques, les durées obtenues après plusieurs soumissions peuvent présenter des différences importantes. Par conséquent, ne l’utilisez pas comme un contrôle précis de la durée ; si une durée fixe est nécessaire pour votre activité, veuillez recadrer ou réessayer vous-même après avoir obtenu le résultat final.
Le code Python correspondant :
duration dans la requête est la durée souhaitée, tandis que le champ duration de chaque chanson dans les data de la réponse est la durée réelle de cette chanson. Les deux ont le même nom mais des significations différentes ; la durée réelle n’est pas garantie d’être égale à la valeur souhaitée. La longueur des paroles est l’un des principaux facteurs qui influencent la durée du produit final ; si vous avez besoin d’un produit final plus long, il est recommandé de fournir également des paroles plus complètes.
L’interface vérifiera que duration est un entier compris entre 10 et 360 ; cela reste uniquement un objectif de génération, et non une garantie sur la durée du produit final.
Fonctionnalité Add Insterumental
En août 2025, Suno a lancé la fonctionnalité Add Insterumental. Vous devez d’abord téléverser une chanson a cappella sans accompagnement, afin que Suno ajoute l’accompagnement musical. Vous pouvez d’abord téléverser une chanson a cappella sans accompagnement via Suno Upload API. L’opération correspondante est illustrée ci-dessous :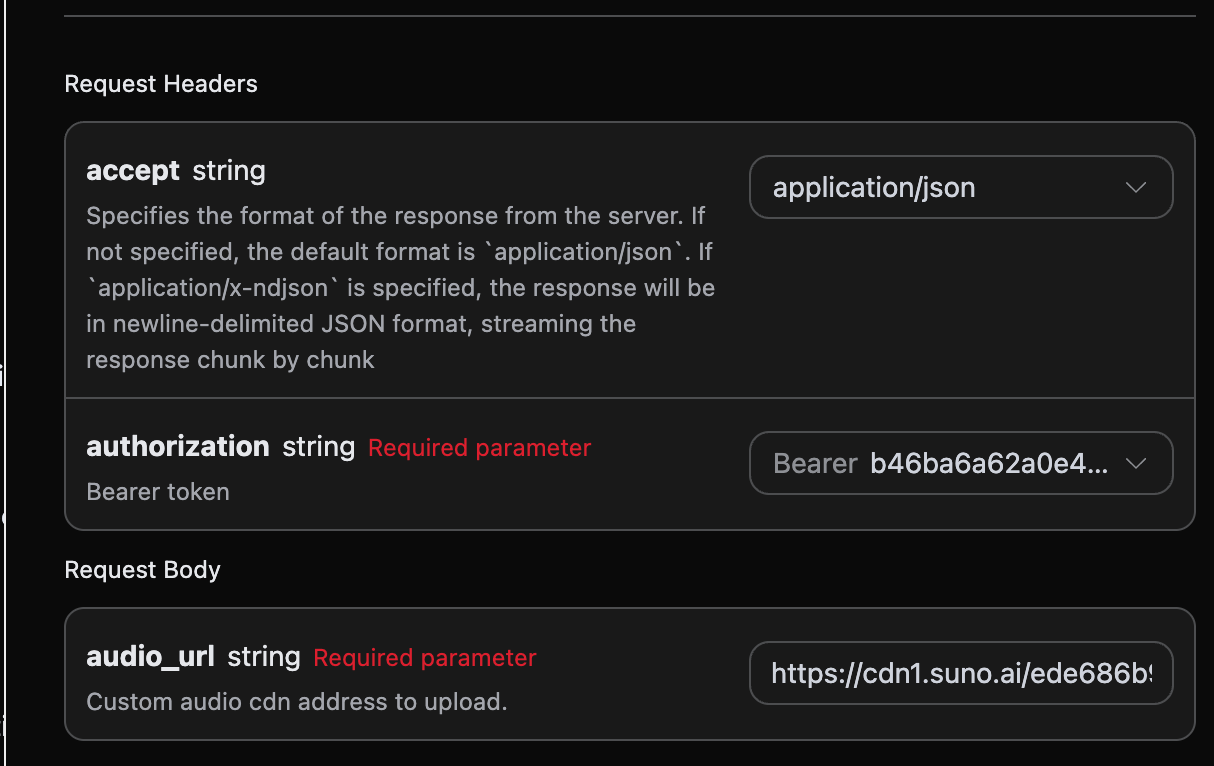
audio_id après le téléversement. Le résultat spécifique est illustré ci-dessous :
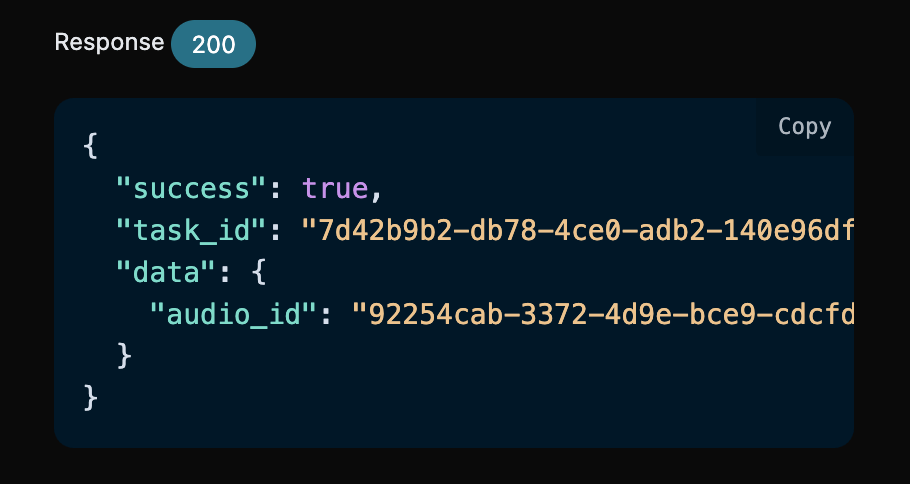
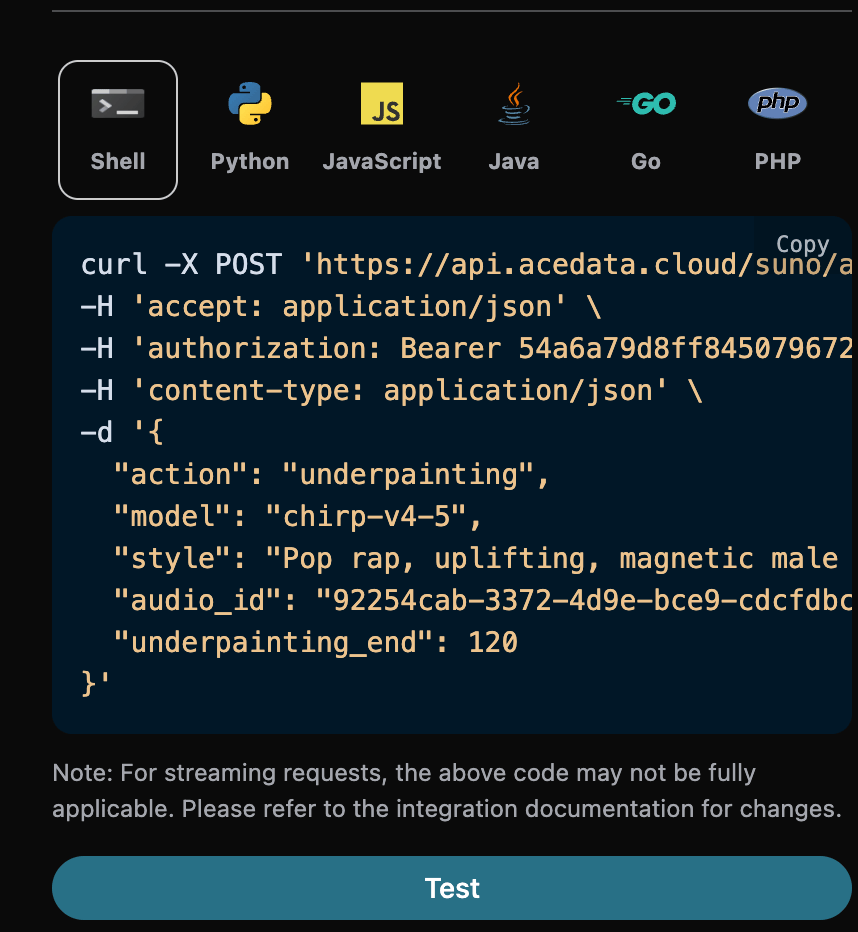
audio_id : 92254cab-3372-4d9e-bce9-cdcfdbc39070, puis nous devons également renseigner les paramètres suivants :
- action : le contenu est
underpainting. - underpainting_start : l’heure de début pour ajouter un accompagnement à la chanson téléversée, la valeur par défaut est 0.
- underpainting_end : l’heure de fin pour ajouter un accompagnement à la chanson téléversée, elle doit être inférieure à la durée totale de la chanson.
- audio_id : l’ID de la chanson a cappella sans accompagnement téléversée.
- style : le style de l’accompagnement, il est préférable de ne pas utiliser de paroles puisqu’il s’agit d’un accompagnement.
Fonctionnalité Add Vocals
En août 2025, Suno a lancé la fonctionnalité Add Vocals. Vous devez d’abord téléverser une musique pure, afin que Suno écrive les paroles et génère un chant vocal. Vous pouvez d’abord téléverser une chanson a cappella sans accompagnement via Suno Upload API. L’opération correspondante est illustrée ci-dessous :
audio_id après le téléversement. Le résultat spécifique est illustré ci-dessous :
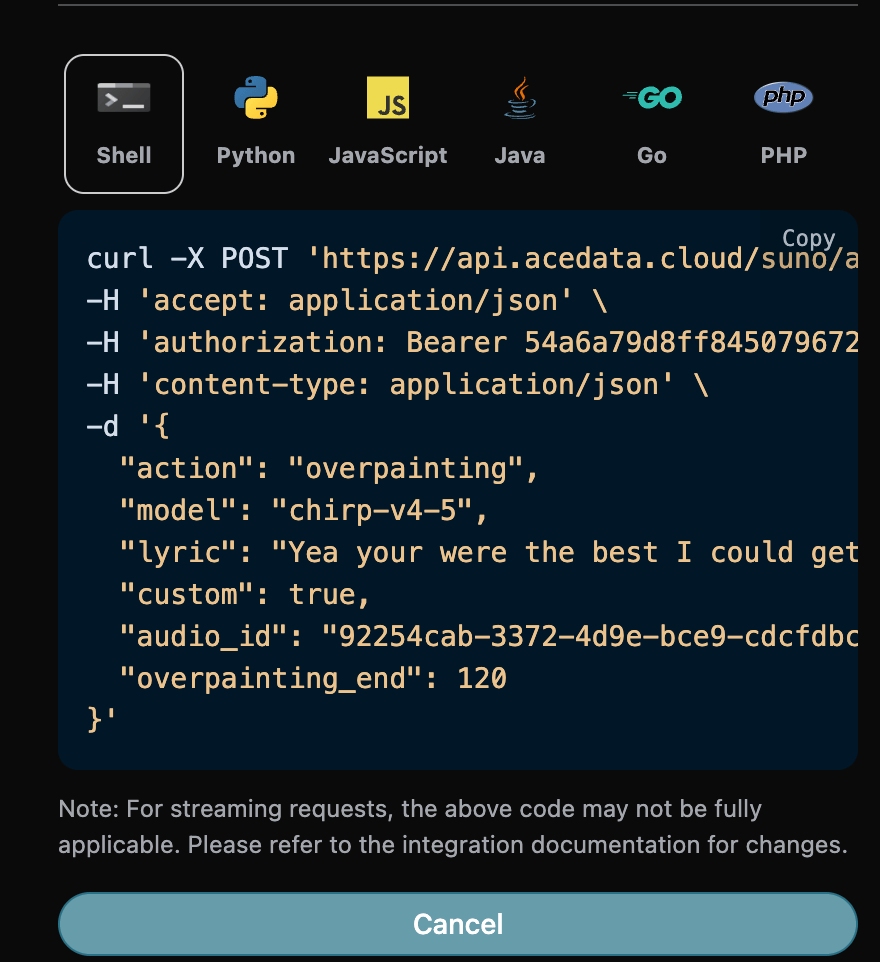
audio_id : 92254cab-3372-4d9e-bce9-cdcfdbc39070, puis nous devons également renseigner les paramètres suivants :
- action : le contenu est
overpainting. - overpainting_start : l’heure de début pour ajouter des voix à la chanson téléversée, la valeur par défaut est 0.
- overpainting_end : l’heure de fin pour ajouter des voix à la chanson téléversée, elle doit être inférieure à la durée totale de la chanson.
- audio_id : l’ID de la chanson a cappella sans accompagnement téléversée.
- custom : dans ce mode, le mode personnalisé doit être utilisé pour renseigner les paroles.
- lyric : les paroles renseignées dans le mode personnalisé.
- style : le style de l’accompagnement.
Fonction Remaster
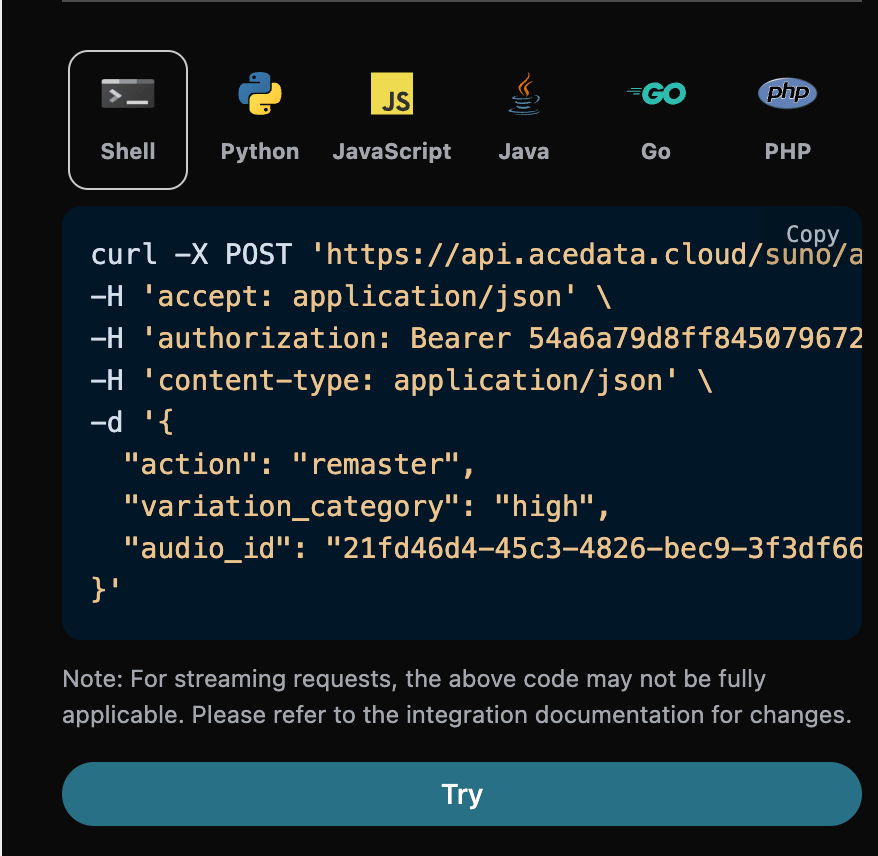
En décembre 2025, Suno a lancé la nouvelle fonction Remaster. Cette fonction peut régénérer des chansons, sans possibilité d’utiliser plusieurs comptes, puis nous devons également renseigner les paramètres suivants :- action : le contenu est
remaster. - audio_id : l’ID de la chanson à régénérer.
- model : prend uniquement en charge v4.5+ et v5.
- variation_category : pris en charge uniquement dans les versions v5 et supérieures, et ne possède que 3 valeurs : high, normal, subtle.
Fonction de génération de mix Mashup
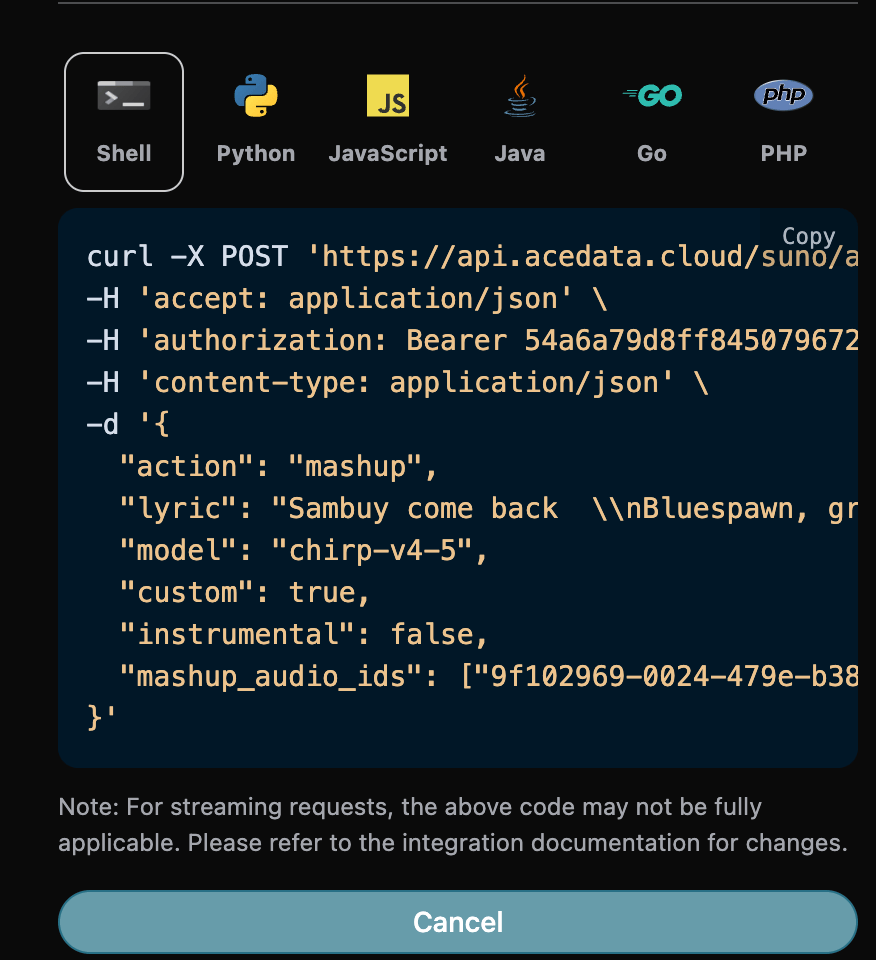
En décembre 2025, Suno a lancé la nouvelle fonction Mashup. Cette fonction peut générer une chanson à partir de deux chansons de référence, puis nous devons également renseigner les paramètres suivants :- action : le contenu est
mashup. - mashup_audio_ids : les ID des deux chansons de référence. Après avoir rempli les champs, le code suivant est automatiquement généré :
Samples Génération de chansons par échantillonnage
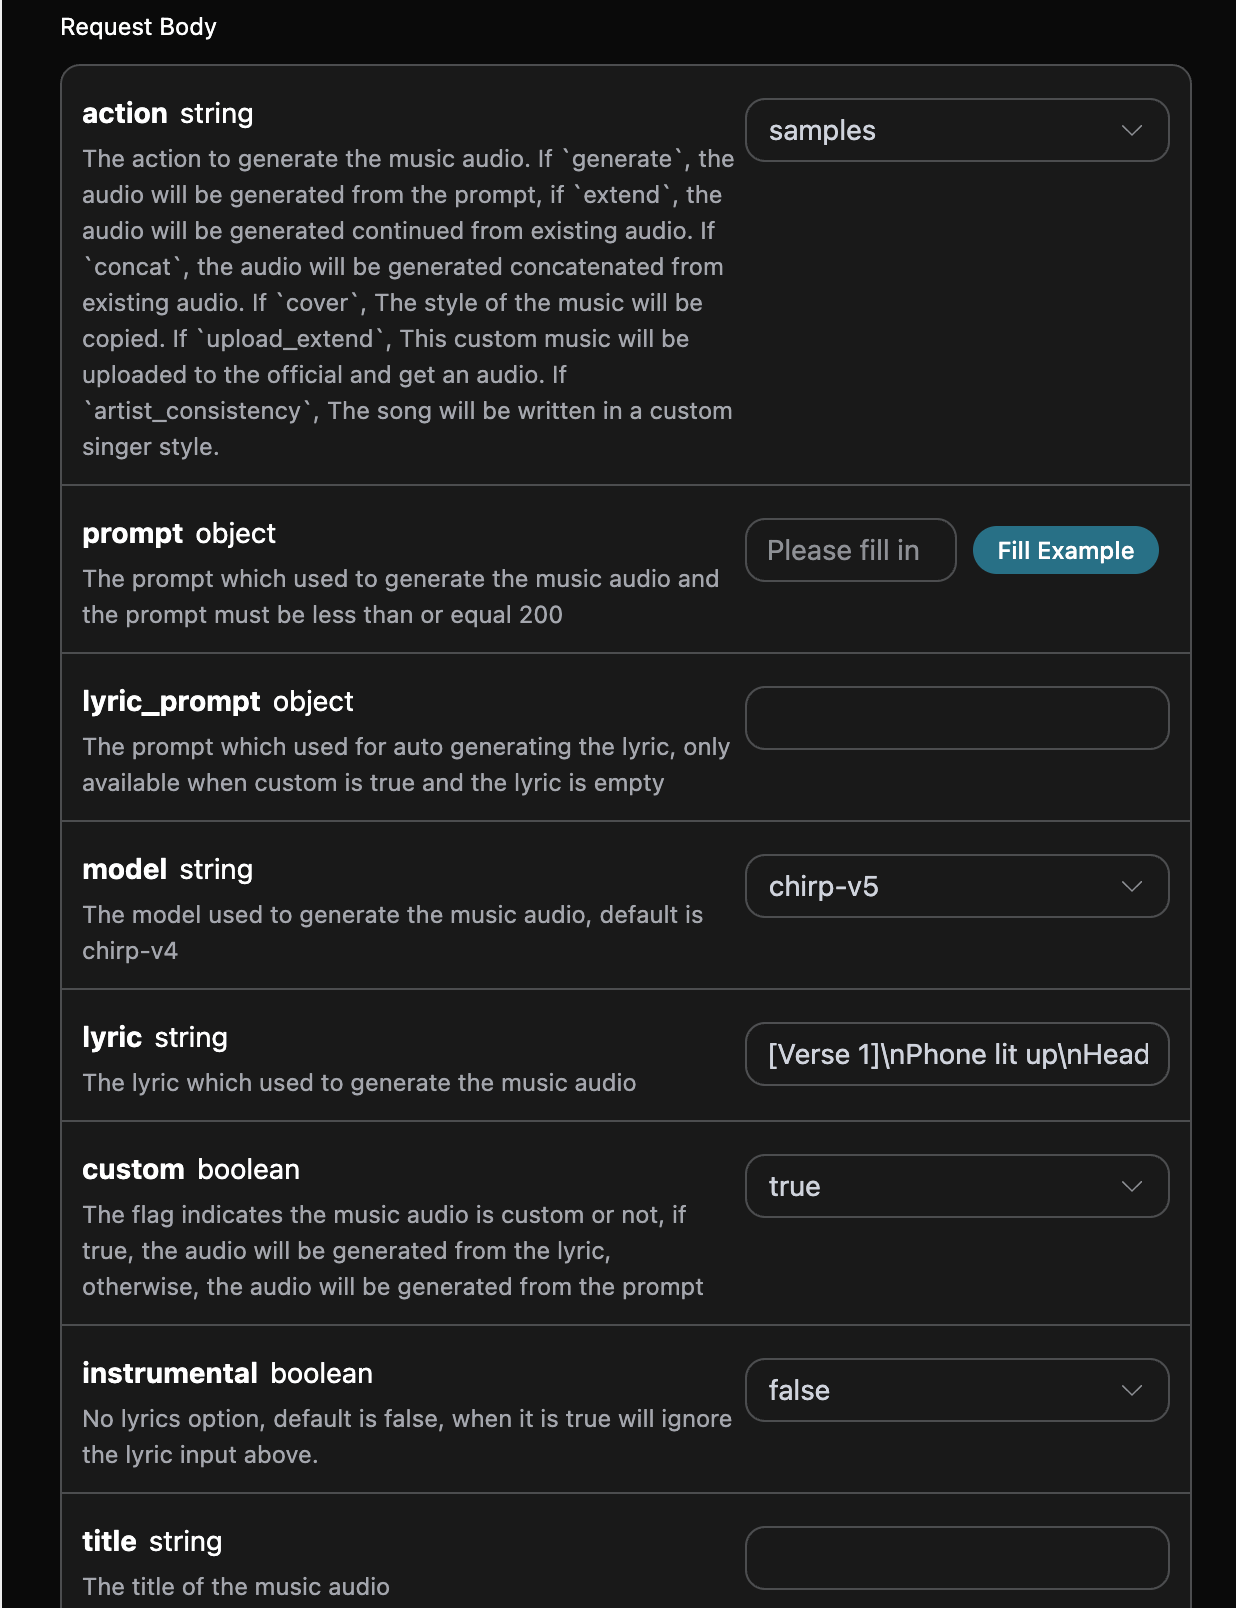
Ici, lessamples correspondent à l’échantillonnage d’un segment d’un seul audio : sélectionnez les heures de début et de fin d’un audio existant, puis utilisez ce segment comme matériau d’échantillonnage pour créer. Cela diffère de la fonction de création inspirée Inspo utilisant 1 à 4 audios de référence complets décrite ci-dessous. Les paramètres suivants doivent être renseignés :
- action : le contenu est
samples. - samples_start : heure de début de l’échantillonnage.
- samples_end : heure de fin de l’échantillonnage.
- audio_id : l’ID de la chanson de référence à échantillonner.
Fonction de création inspirée Inspo
La fonction de création inspirée Inspo peut générer de nouvelles musiques à partir de 1 à 4 pistes audio de référence complètes, et prend en charge le glisser-déposer ou le téléversement d’audio comme source d’inspiration. L’API utilise l’actioninspo existante : le client fournit des URL audio accessibles publiquement, et le service effectue automatiquement la préparation des audios de référence et la création, sans que le client ait besoin de lire séparément les paroles, le style ou la durée avant d’assembler la requête. Elle diffère de l’échantillonnage par intervalle ci-dessus, ainsi que du Cover qui reproduit le style de la chanson originale. Les paramètres suivants doivent être renseignés lors de l’utilisation :
- action : la valeur est
inspo. - audio_urls : liste d’URL des audios de référence ; fournissez 1 à 4 adresses audio accessibles publiquement.
- model : le modèle utilisé ;
chirp-v6est recommandé. - prompt : paroles ou invite de création (facultatif).
Remarque : l’audio de référence doit être un fichier audio accessible publiquement. Si l’audio de référence correspond exactement à un enregistrement connu dans le catalogue musical de la plateforme, Suno peut refuser la génération en raison d’une vérification des droits d’auteur ; il est recommandé d’utiliser un audio vous appartenant ou généré par Suno comme source d’inspiration.Le code Python correspondant :
chirp-v5 de l’époque, l’exemple de requête actuel recommande chirp-v6, et la structure de retour est identique :
Rappel asynchrone
Étant donné que Suno met relativement longtemps à générer de la musique, environ 1 à 2 minutes, si l’API ne répond pas pendant une longue période, la requête HTTP restera connectée en continu, entraînant une consommation supplémentaire de ressources système ; cette API prend donc également en charge les rappels asynchrones. Le processus global est le suivant : lorsque le client initie une requête, il spécifie en plus un champcallback_url. Après que le client a initié la requête API, l’API renvoie immédiatement un résultat, comprenant un champ task_id, qui représente l’ID de la tâche actuelle. Une fois la tâche terminée, le résultat de la génération musicale est envoyé au callback_url spécifié par le client sous la forme d’un POST JSON, qui inclut également le champ task_id, afin que les résultats de la tâche puissent être associés par ID.
Voyons ci-dessous comment procéder concrètement à travers un exemple.
Tout d’abord, un rappel Webhook est un service capable de recevoir des requêtes HTTP ; le développeur doit le remplacer par l’URL de son propre serveur HTTP. Afin de faciliter la démonstration, nous utilisons ici un site d’exemple Webhook public https://webhook.site/ ; ouvrez ce site pour obtenir une URL Webhook, comme indiqué sur l’image :
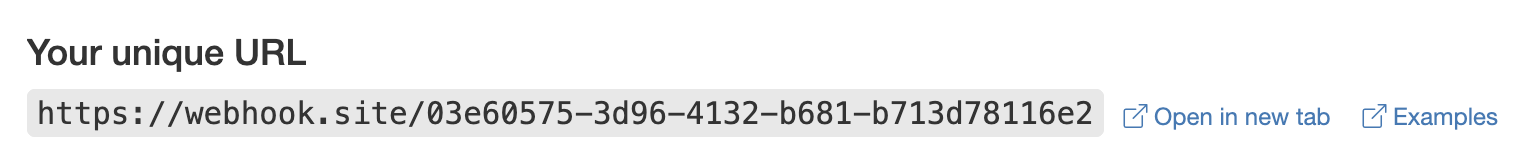 Copiez cette URL pour pouvoir l’utiliser comme Webhook ; l’exemple ici est https://webhook.site/03e60575-3d96-4132-b681-b713d78116e2。
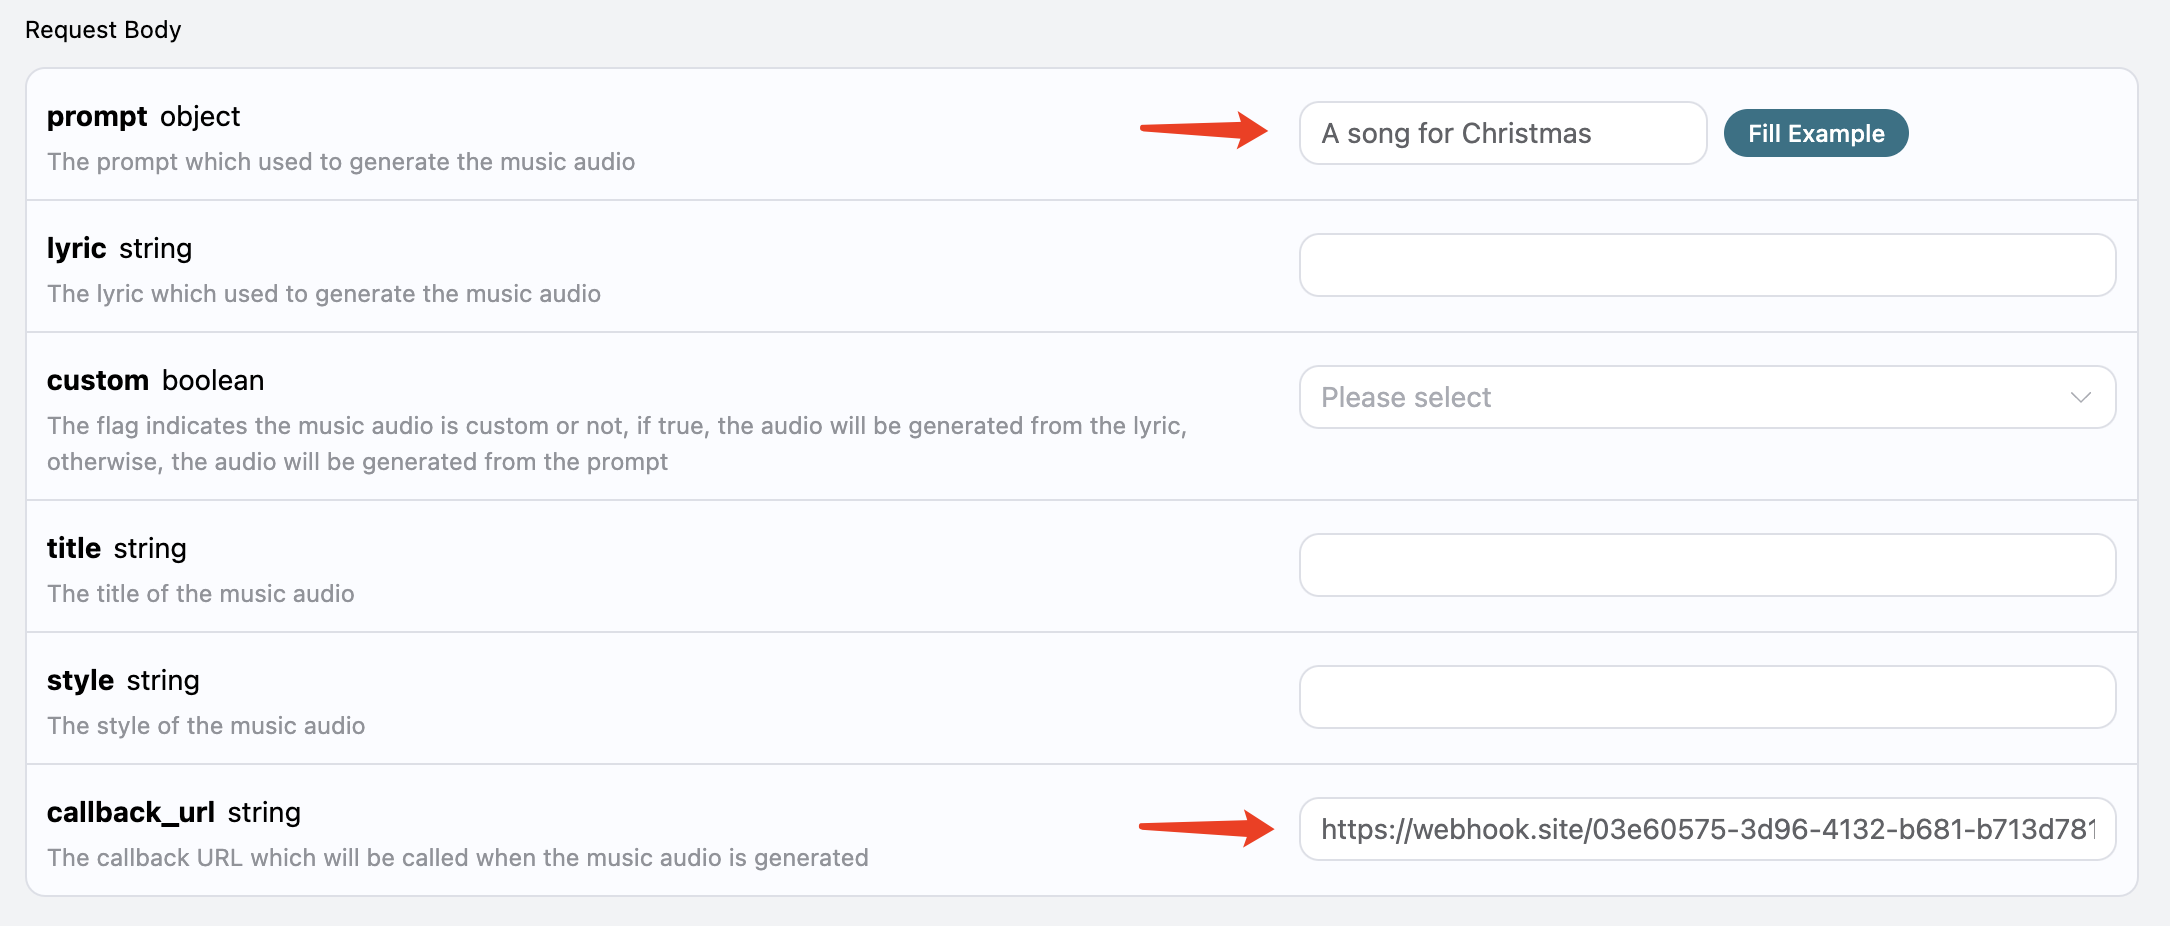
Ensuite, nous pouvons définir le champ
callback_url avec l’URL Webhook ci-dessus, tout en renseignant prompt, comme indiqué sur l’image :
 Cliquez sur Exécuter ; vous constaterez qu’un résultat est obtenu immédiatement, comme suit :
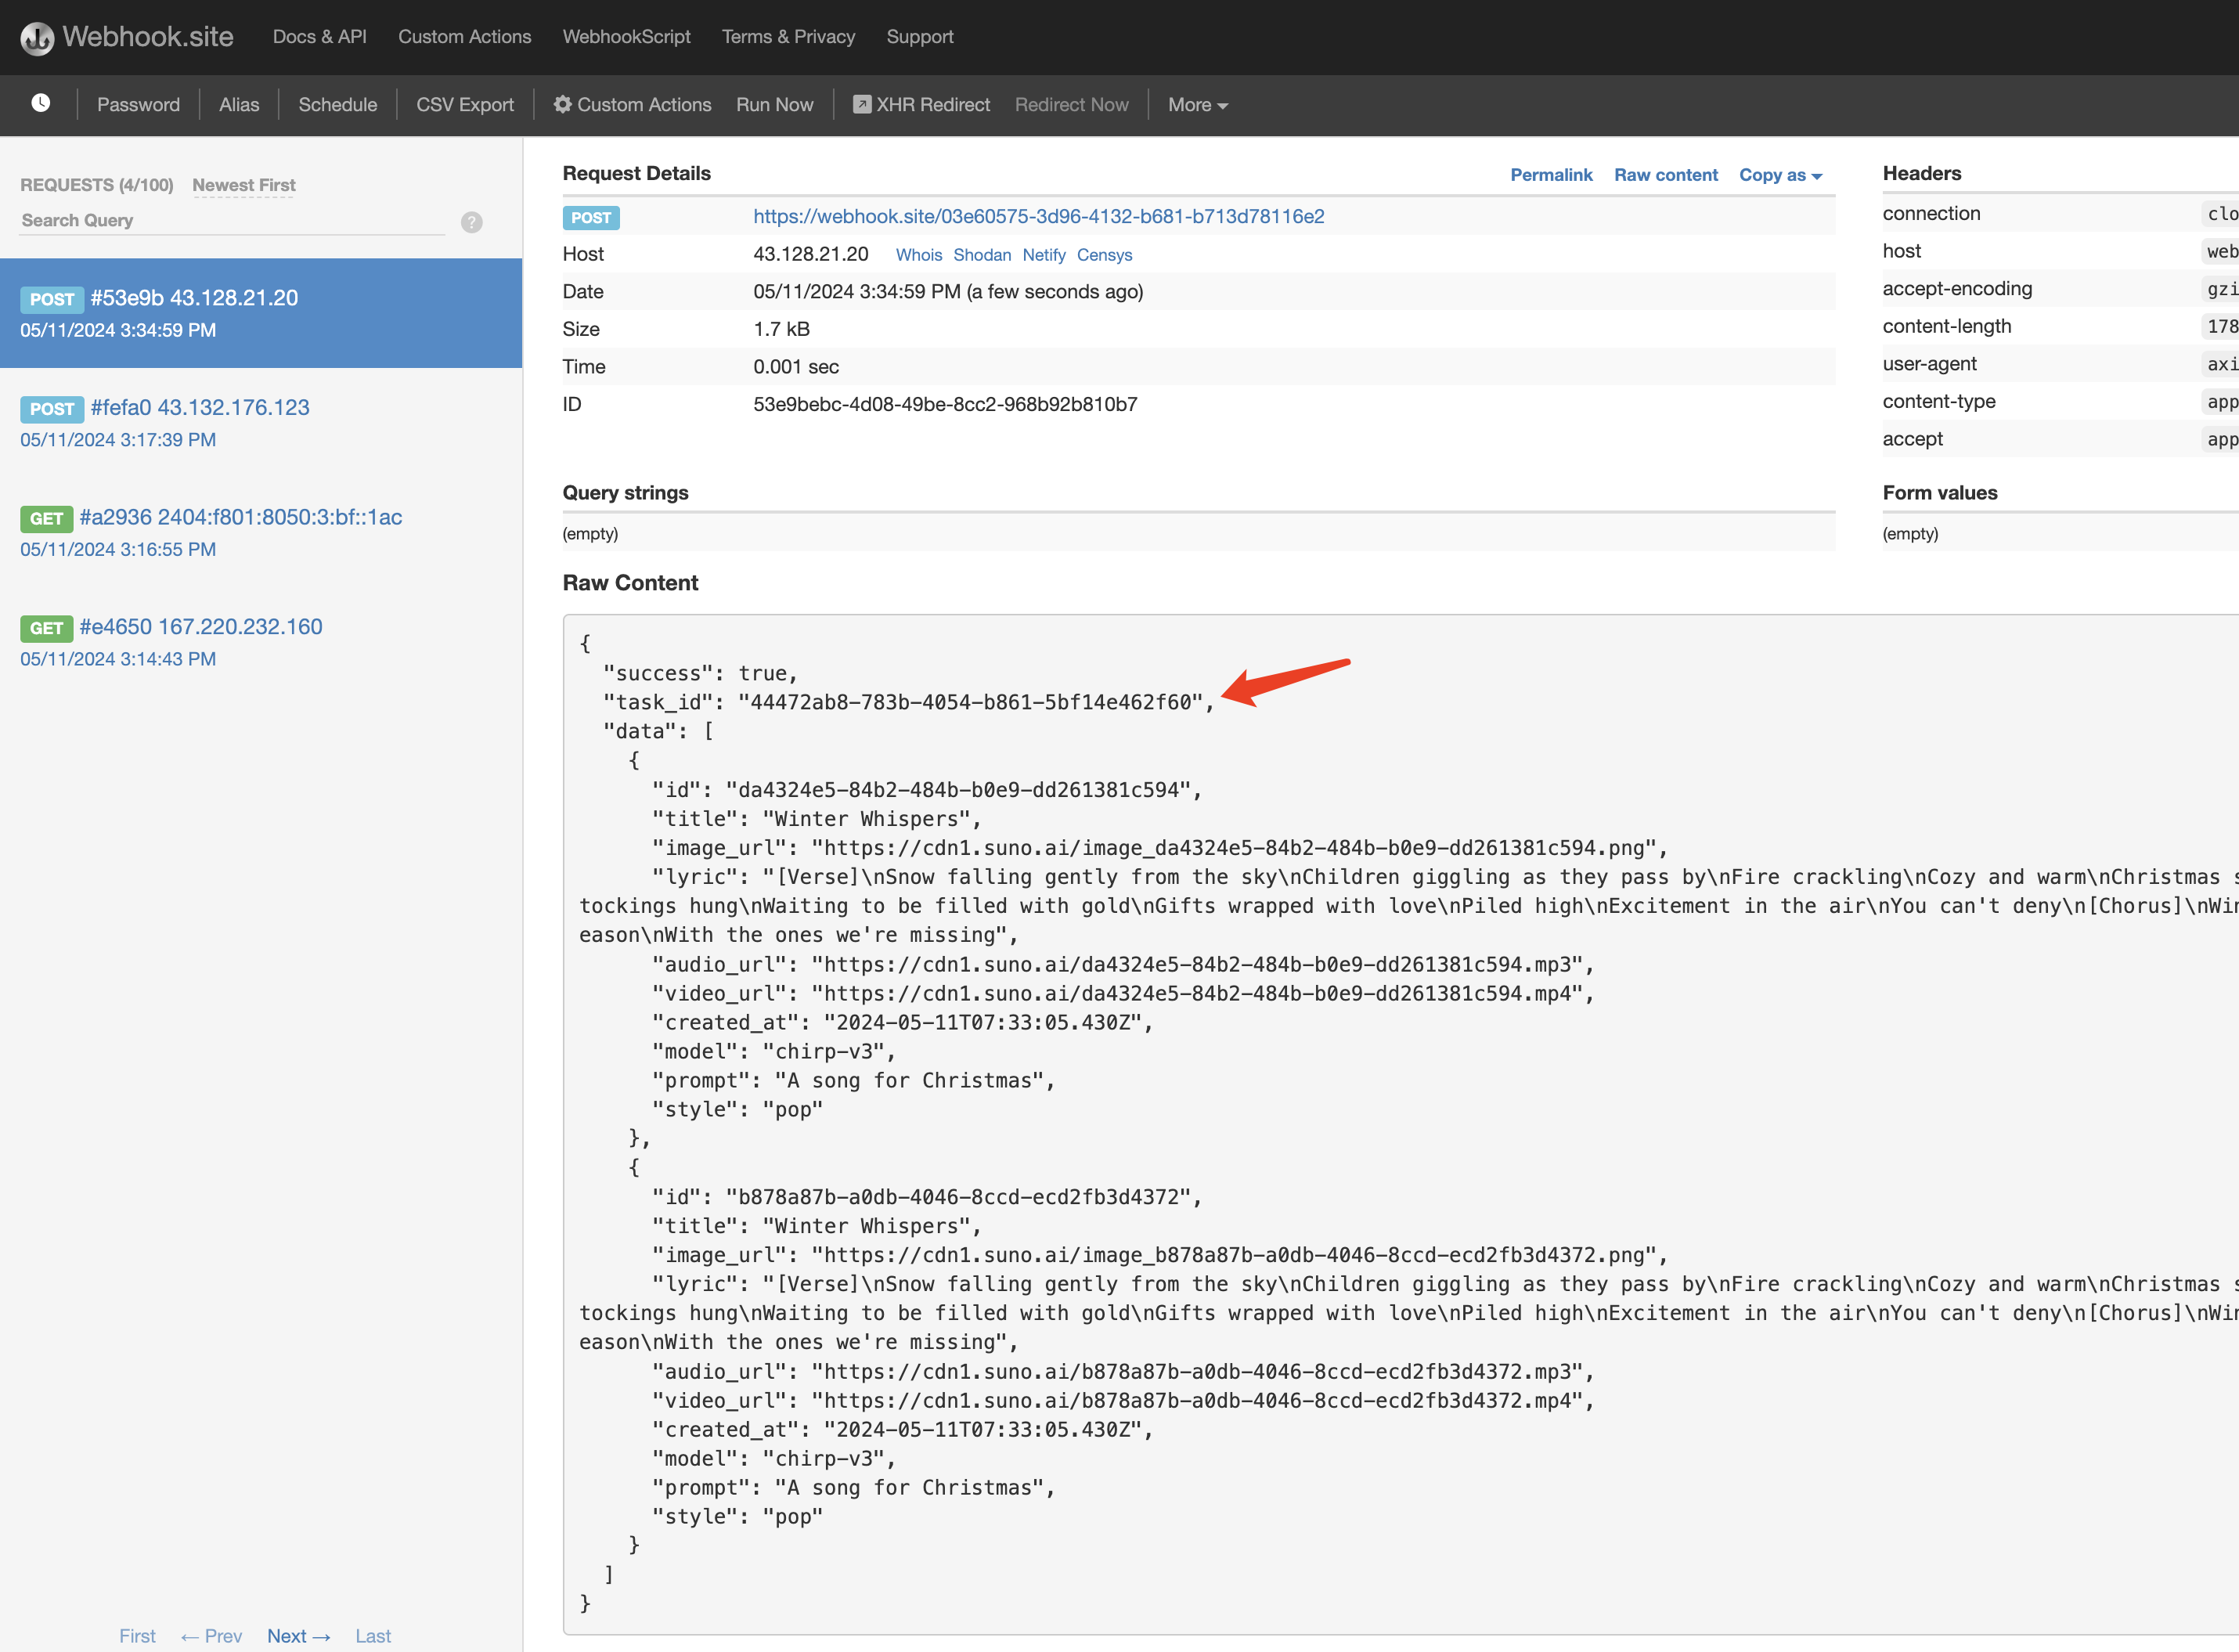 Le contenu est le suivant :
task_id dans le résultat ; les autres champs sont similaires à ceux ci-dessus, et ce champ permet d’associer les tâches.
Bien entendu, nous pouvons également obtenir les résultats via un appel en streaming ; il suffit de définir la valeur de accept dans l’en-tête de requête sur application/x-ndjson. Voici un exemple d’entrée à titre de démonstration :
task_id ; ci-dessus, seules la première et les deux réponses réelles de l’état final sont conservées, les mises à jour intermédiaires répétées étant omises.
Gestion des erreurs
En cas d’erreur, vous recevrez un message d’erreur semblable au suivant :error.code, error.message :
Remarque : les quotas et les messages d’erreur peuvent différer selon les comptes en amont. En général, les restrictions destylepourchirp-v3-5/chirp-v4sont plus faibles (200), tandis quechirp-v4-5et les versions ultérieures prennent généralement en charge jusqu’à 1000 ; lorsqu’un ancien service en amont est utilisé, des messages de compatibilité tels queTags too long.oustyle must be less than or equal 120peuvent apparaître. | Code d’état |error.code|error.message| | ----------- | ------------- | --------------------------------------------------------------- | | 400 |bad_request|L’identifiant de la chanson n’existe pas ou a été mis hors ligne.| | 400 |bad_request|Prompt trop long.| | 400 |bad_request|Tags trop longs.| | 400 |bad_request|L’audio téléchargé correspond à une œuvre d’art existante.| | 400 |bad_request|instrumental doit être un booléen| | 400 |bad_request|Titre trop long.| | 400 |bad_request|Sujet trop long.| | 400 |bad_request|style doit être inférieur ou égal à 120| | 400 |bad_request|custom doit être un booléen| | 400 |bad_request|audio_id est requis lors de l’extension de l’audio| | 400 |bad_request|continue_at est requis lors de l’extension de l’audio| | 400 |bad_request|continue_at doit être un nombre supérieur à 0| | 400 |bad_request|lyric est requis lors de l’extension de l’audio et lorsque instrumental est faux| | 400 |bad_request|prompt est requis lors de la génération d’audio| | 400 |bad_request|lyric est requis lors de la génération d’audio personnalisé| | 403 |forbidden|Prompt probablement mal formé| | 403 |forbidden|Prompt probablement protégé par le droit d’auteur| | 403 |forbidden|Le prompt contenait du contenu inapproprié| | 403 |forbidden|La description de la chanson a été signalée pour modération| | 403 |forbidden|La description de la chanson contenait un nom d’artiste| | 403 |forbidden|Les tags contenaient un nom d’artiste| | 403 |forbidden|Les paroles contenaient du contenu protégé par le droit d’auteur| | 403 |forbidden|La description de la chanson contenait une balise de producteur| | 403 |forbidden|Erreur openAI générique| | 403 |forbidden|Prompt signalé pour modération| | 500 |api_error|Impossible de générer des paroles à partir de la description de la chanson| | 500 |api_error|la tâche a échoué avec une erreur inconnue| | 500 |api_error|aucun travailleur disponible dans le système| | 500 |api_error|service en maintenance, génération suspendue| | 504 |timeout|délai d’attente dépassé lors de l’attente de la génération audio|