

content 结构创建任务。
申请流程
要使用 MiniMax H3 视频生成 API,首先到 Ace Data Cloud 控制台 获取您的 API Token,留作备用。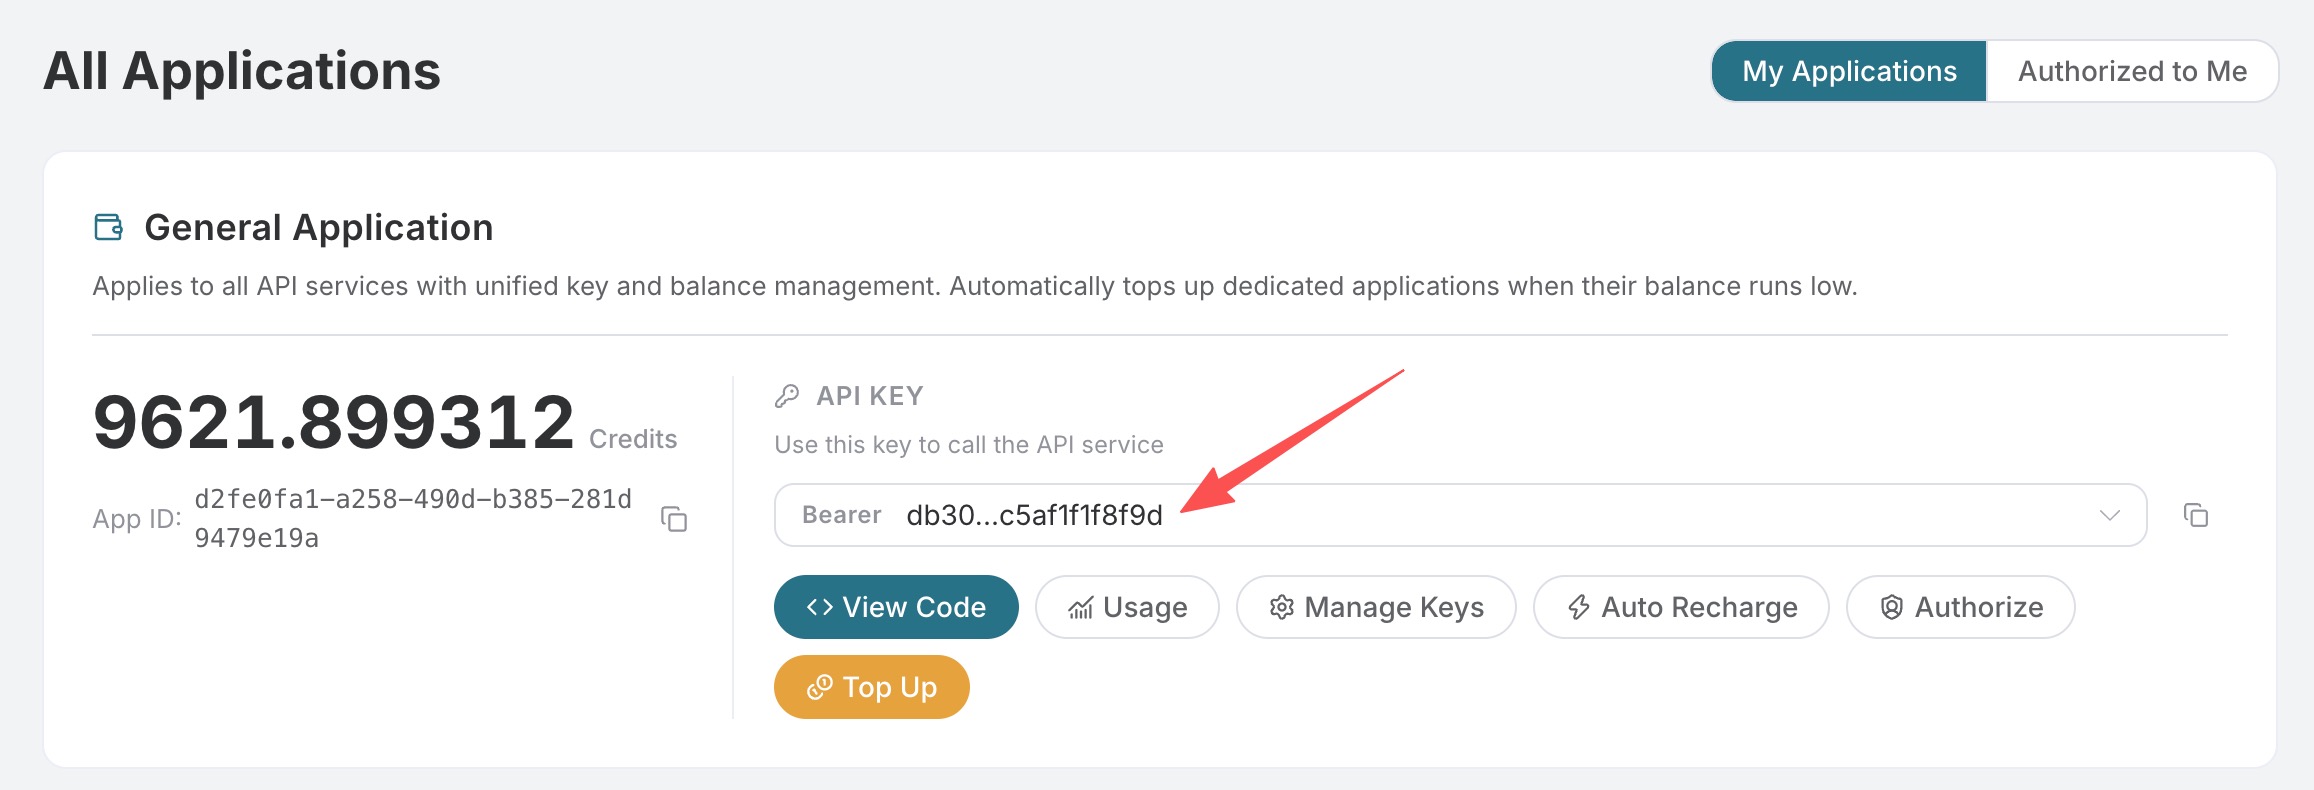 如果你尚未登录或注册,会自动跳转到登录页面邀请你注册和登录,完成后会自动返回当前页面。
一个 API Token 即可调用平台所有服务,无需为每个服务单独申请。 首次申请会赠送免费额度,可免费体验;额度不足时可在 控制台 充值通用余额。
📘 完整文档:MiniMax H3 视频生成 API →建议把 Token 保存为环境变量,不要写入源码或提交到版本库:
接口概览
-
Base URL:
https://api.acedata.cloud -
Endpoint:
POST /minimax/videos -
认证方式:HTTP Header 中携带
authorization: Bearer {token} -
请求头:
accept: application/jsoncontent-type: application/json
-
模型(model):
MiniMax-H3 -
输入结构:通过
content统一传入文本、图片、视频和音频 -
输出模式:默认同步等待生成完成并返回完整
task;传async: true或callback_url时立即返回task_id与trace_id - 结果查询:通过 MiniMax H3 任务查询 API 获取状态和成片
-
异步回调:可选,通过
callback_url接收最终任务结果
action 来选择生成模式,接口会根据 content 中的素材类型和 role 自动判断用途。
适合哪些场景
调用流程
默认不传async 时,/minimax/videos 会等待生成完成并直接返回完整 task。需要立即释放连接时,传 async: true 或 callback_url:
- 保存立即响应中的
task_id和trace_id。 - 未配置回调时,每隔约 10 秒调用
/minimax/tasks查询一次。 - 当
task.status变为succeeded时,从task.content.url获取视频。 - 当状态为
failed或cancelled时停止轮询,并读取task.error。
顶层请求参数
ratio 的规则取决于工作流:
- 文生视频:必填,且不能为
adaptive。 - 首帧、尾帧或首尾帧视频:画幅由输入图片决定,建议省略或传
adaptive。 - 多模态参考生视频:可省略,默认
adaptive;也可以明确指定一个固定比例。
prompt、image_urls、audio_urls、messages 和 first_frame_image。收到这类参数错误时,请删除旧字段并迁移到 content;例如把 "prompt": "一只猫挥手" 改为 "content": [{"type": "text", "text": "一只猫挥手"}]。不要同时发送新旧两种格式。
content 内容项参数
每个内容项都必须有type,其余字段由类型决定:
媒体地址支持三种形式:
- 可公网访问的 HTTPS URL,推荐用于大文件。
mm_file://{file_id},引用已经上传或已有结果的文件。- 对应媒体类型的 Base64 data URI。Base64 会使体积增加约三分之一,请确保整个请求体不超过 64 MB。
素材规格与数量限制
多模态参考场景中的图片、视频和音频合计最多 12 个文件。首尾帧场景和参考素材场景互斥:一旦使用
reference_image、reference_video 或 reference_audio,就不能再使用 first_frame 或 last_frame,反之亦然。
生产级能力展示
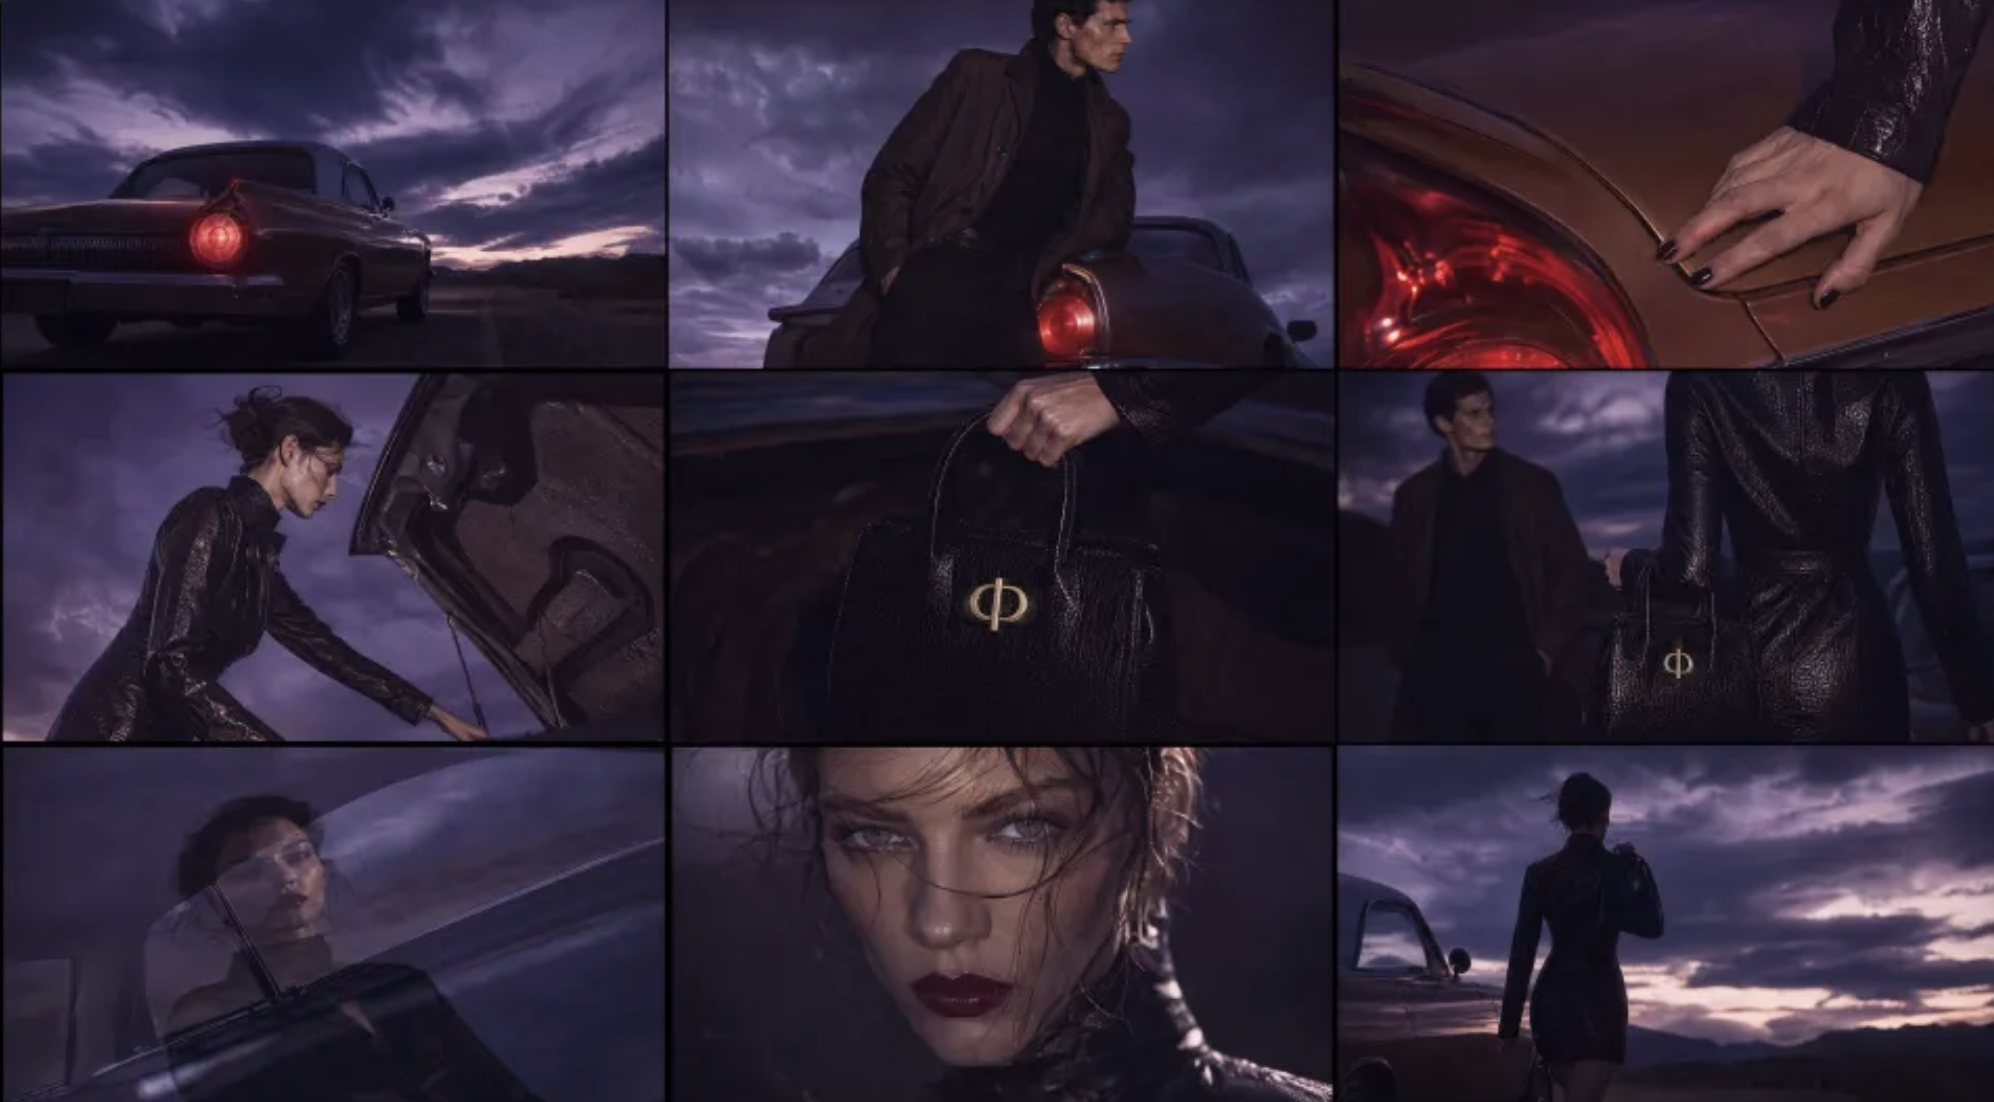
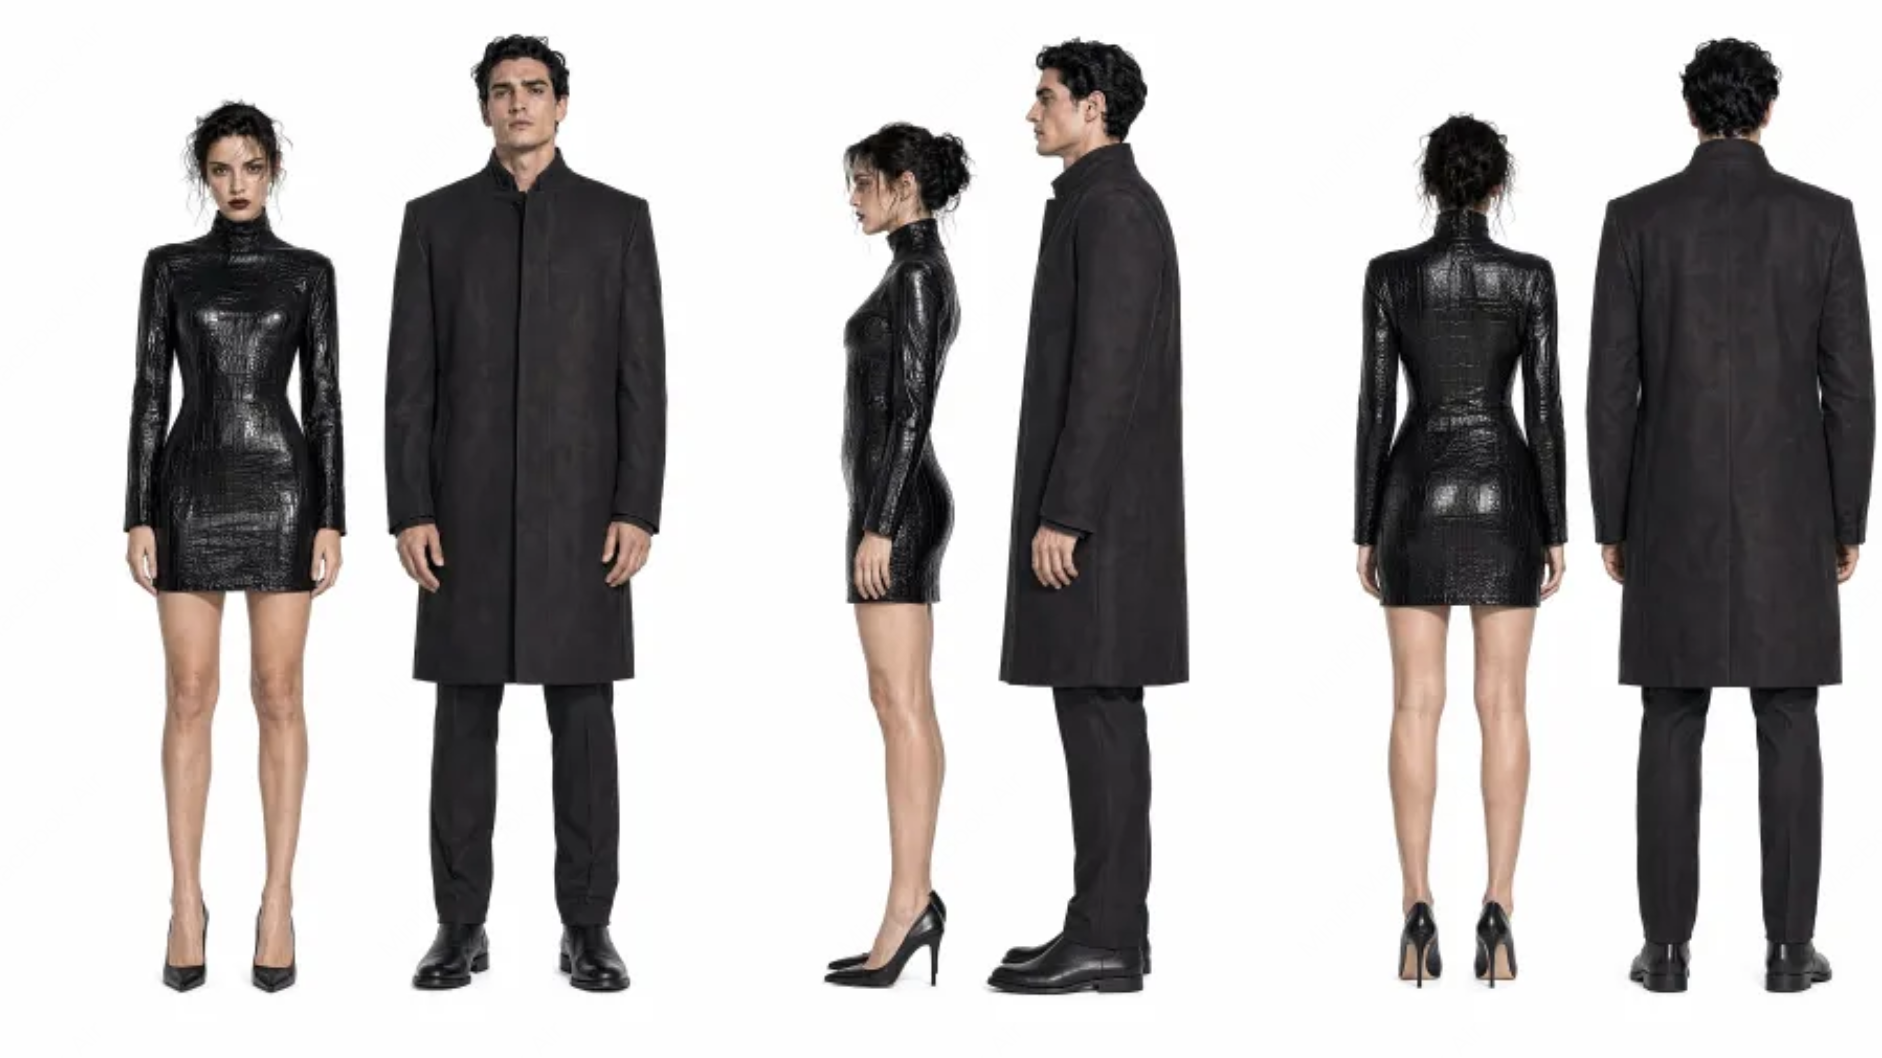
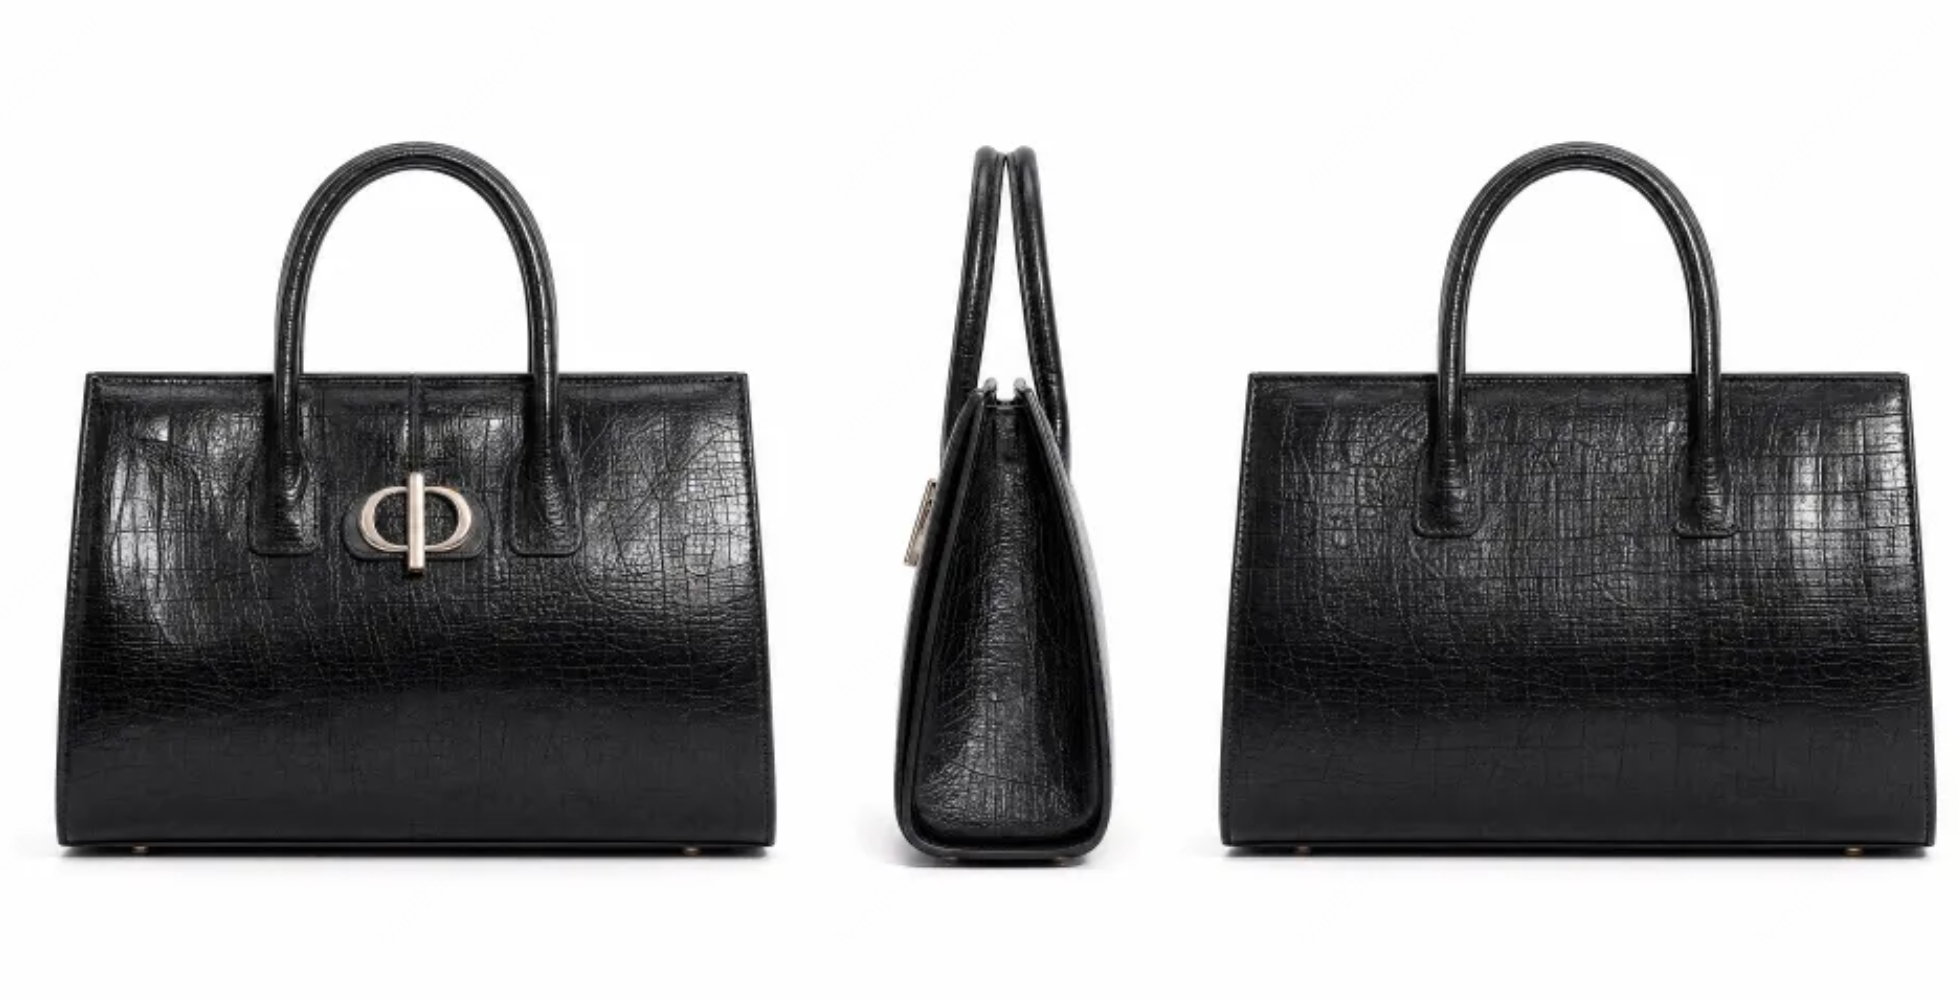
下面不是概念图或占位素材,而是 MiniMax H3 官方生产级能力样片的真实参考输入与实际视频输出。三组案例分别覆盖品牌短片、真人叙事和时尚电商,适合评估模型在商业制作中最关键的能力。
这里的“人脸能力”指视频生成中的人物外观一致性、面部细节和表演控制,不是身份识别、人脸比对或换脸接口。
高端品牌短片:人物、产品与品牌资产统一
制作目标: 16:9 高级时装品牌片。以荒漠公路和复古汽车建立冷峻氛围,保持女主角外观与黑色手袋结构,并将品牌 Logo 自然纳入结尾。这个案例重点检验跨镜头人物一致性、商品保持、电影质感和品牌收束能力。| 氛围与场景参考 | 人物参考 |
|---|---|
 |  |
| 手袋产品参考 | 品牌 Logo 参考 |
|---|---|
 |  |
content 组织方式:
真人竖屏短剧:人脸一致性与情绪表演
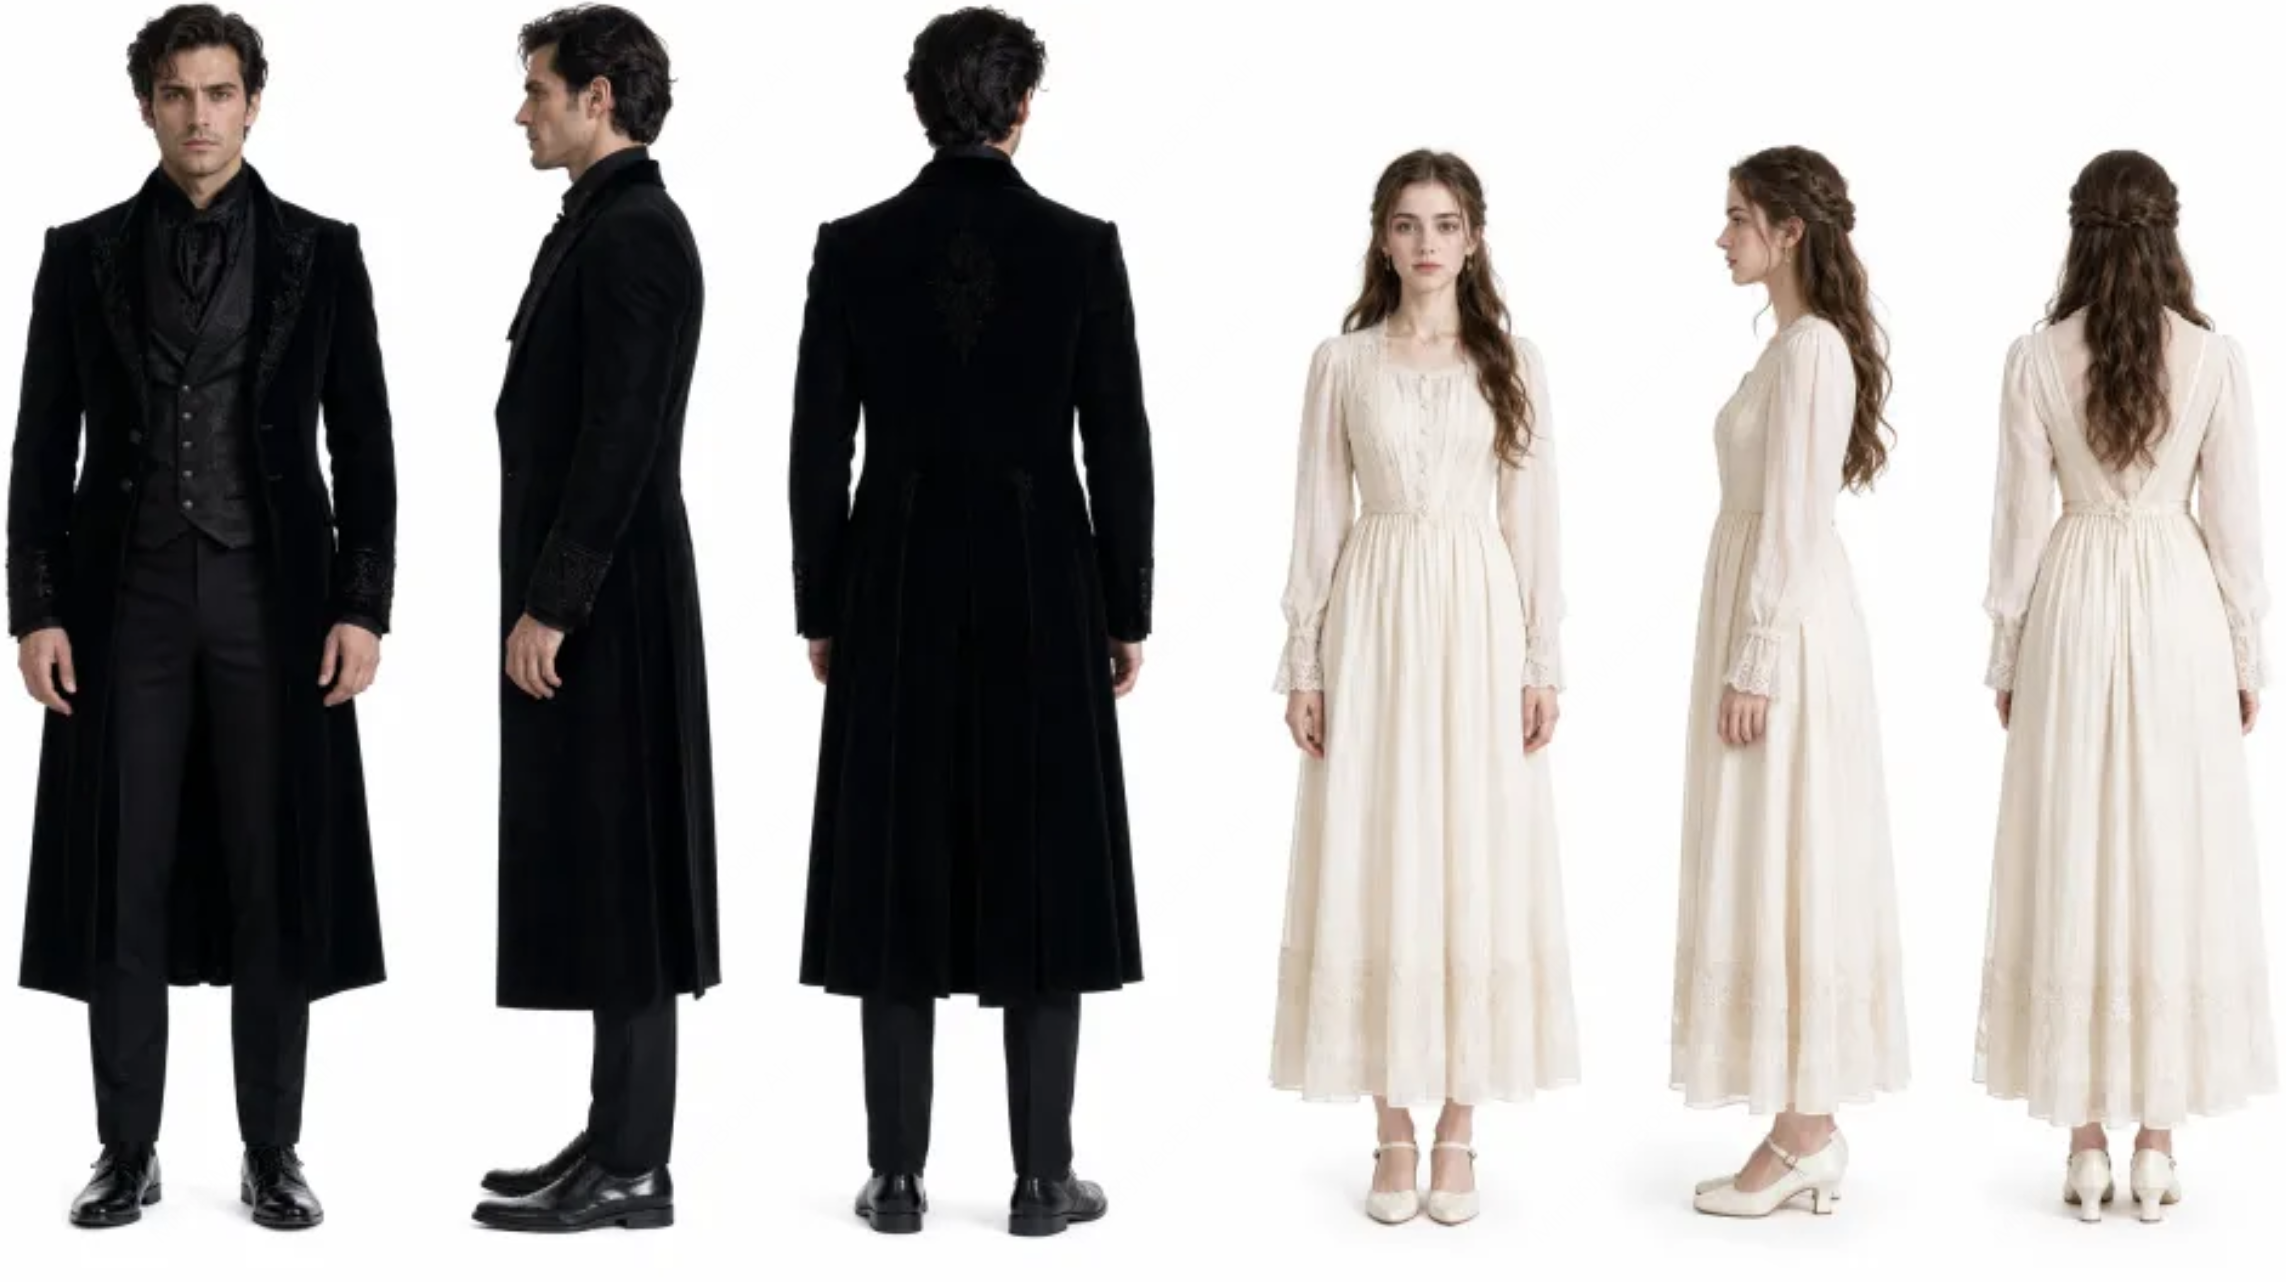
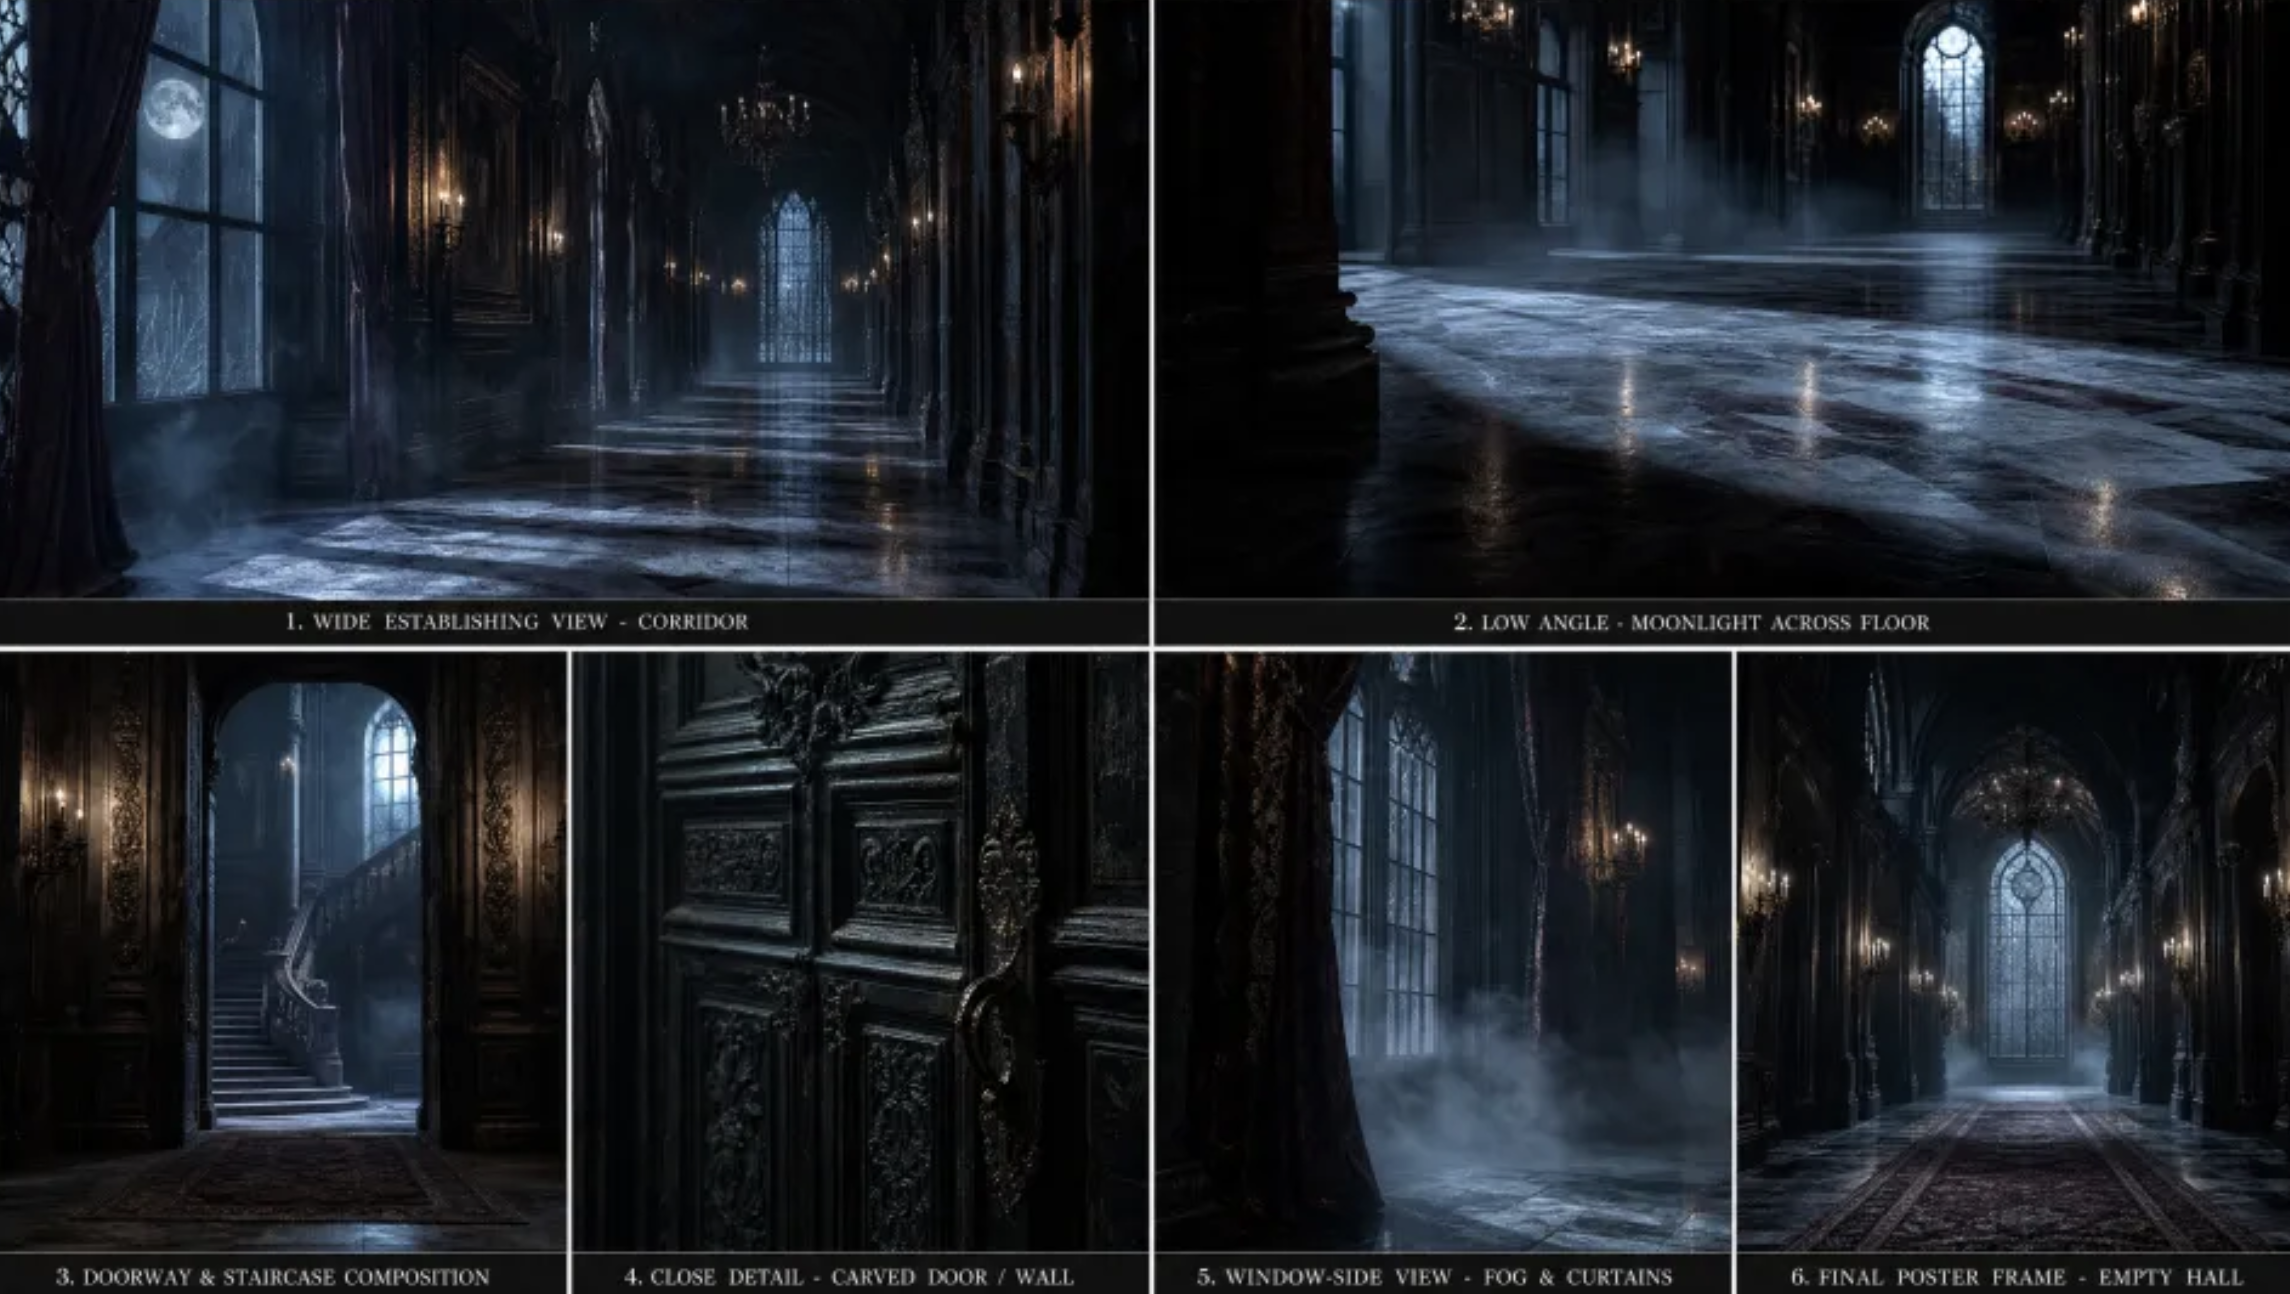
制作目标: 15 秒、9:16 暗黑浪漫短剧预告。通过男女主角参考图锁定人物外观,以古堡参考图约束空间;使用中近景与面部特写表现眼神对峙、恐惧、克制和危险感。这个案例适合观察真人五官稳定性、微表情、视线关系和连续表演。| 男女主角参考 | 古堡场景参考 |
|---|---|
 |  |
时尚眼镜广告:人脸细节与商品结构保持
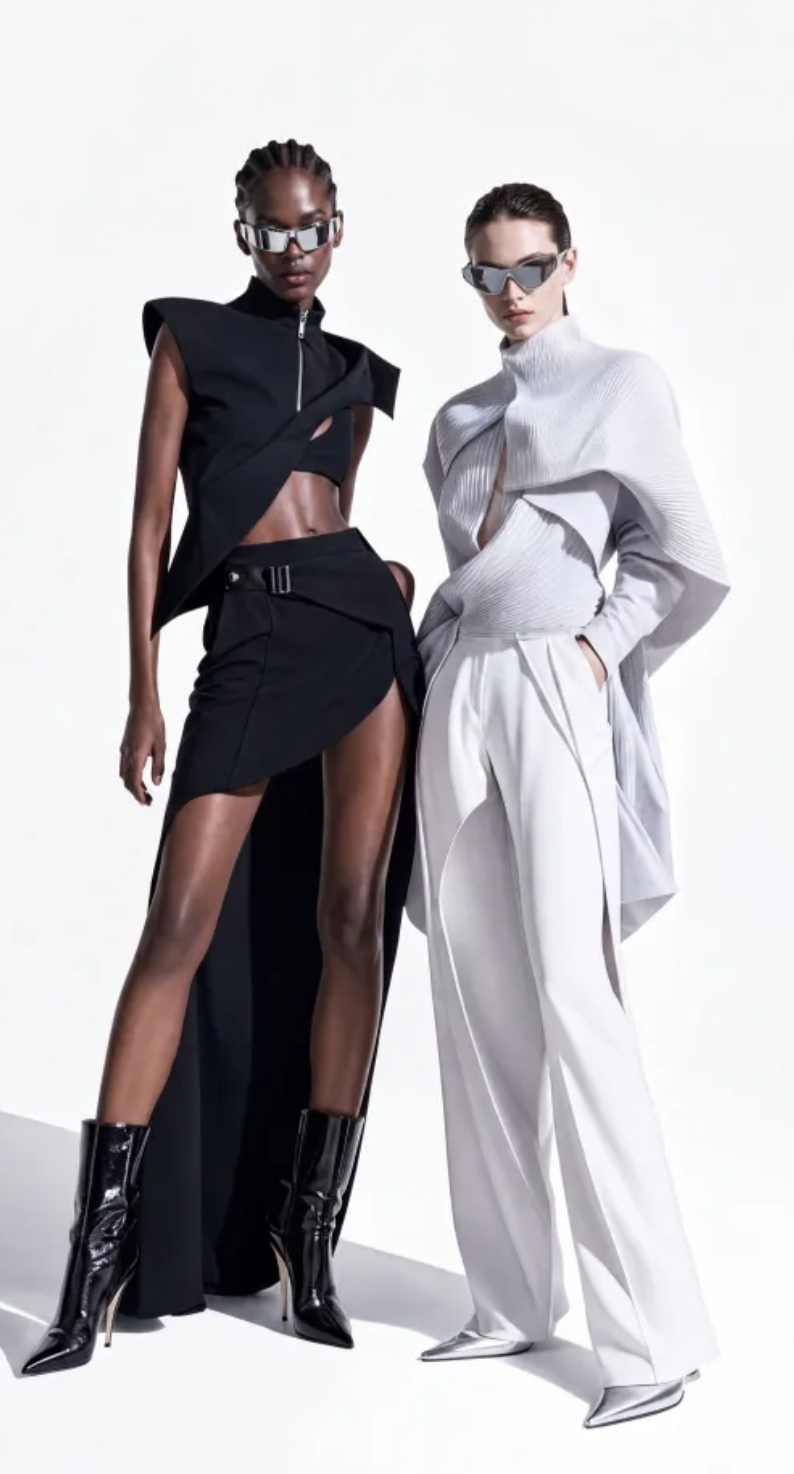
制作目标: 9:16 高级时尚眼镜广告。人物全身图负责身形与台步,人脸参考图负责五官和妆容,产品图负责环绕曲线、镜片反射、镜腿和猫眼轮廓。这个案例同时考验脸部近景、多人一致性、佩戴关系和商品几何结构。| 模特与造型参考 | 人脸细节参考 | 眼镜产品参考 |
|---|---|---|
 | 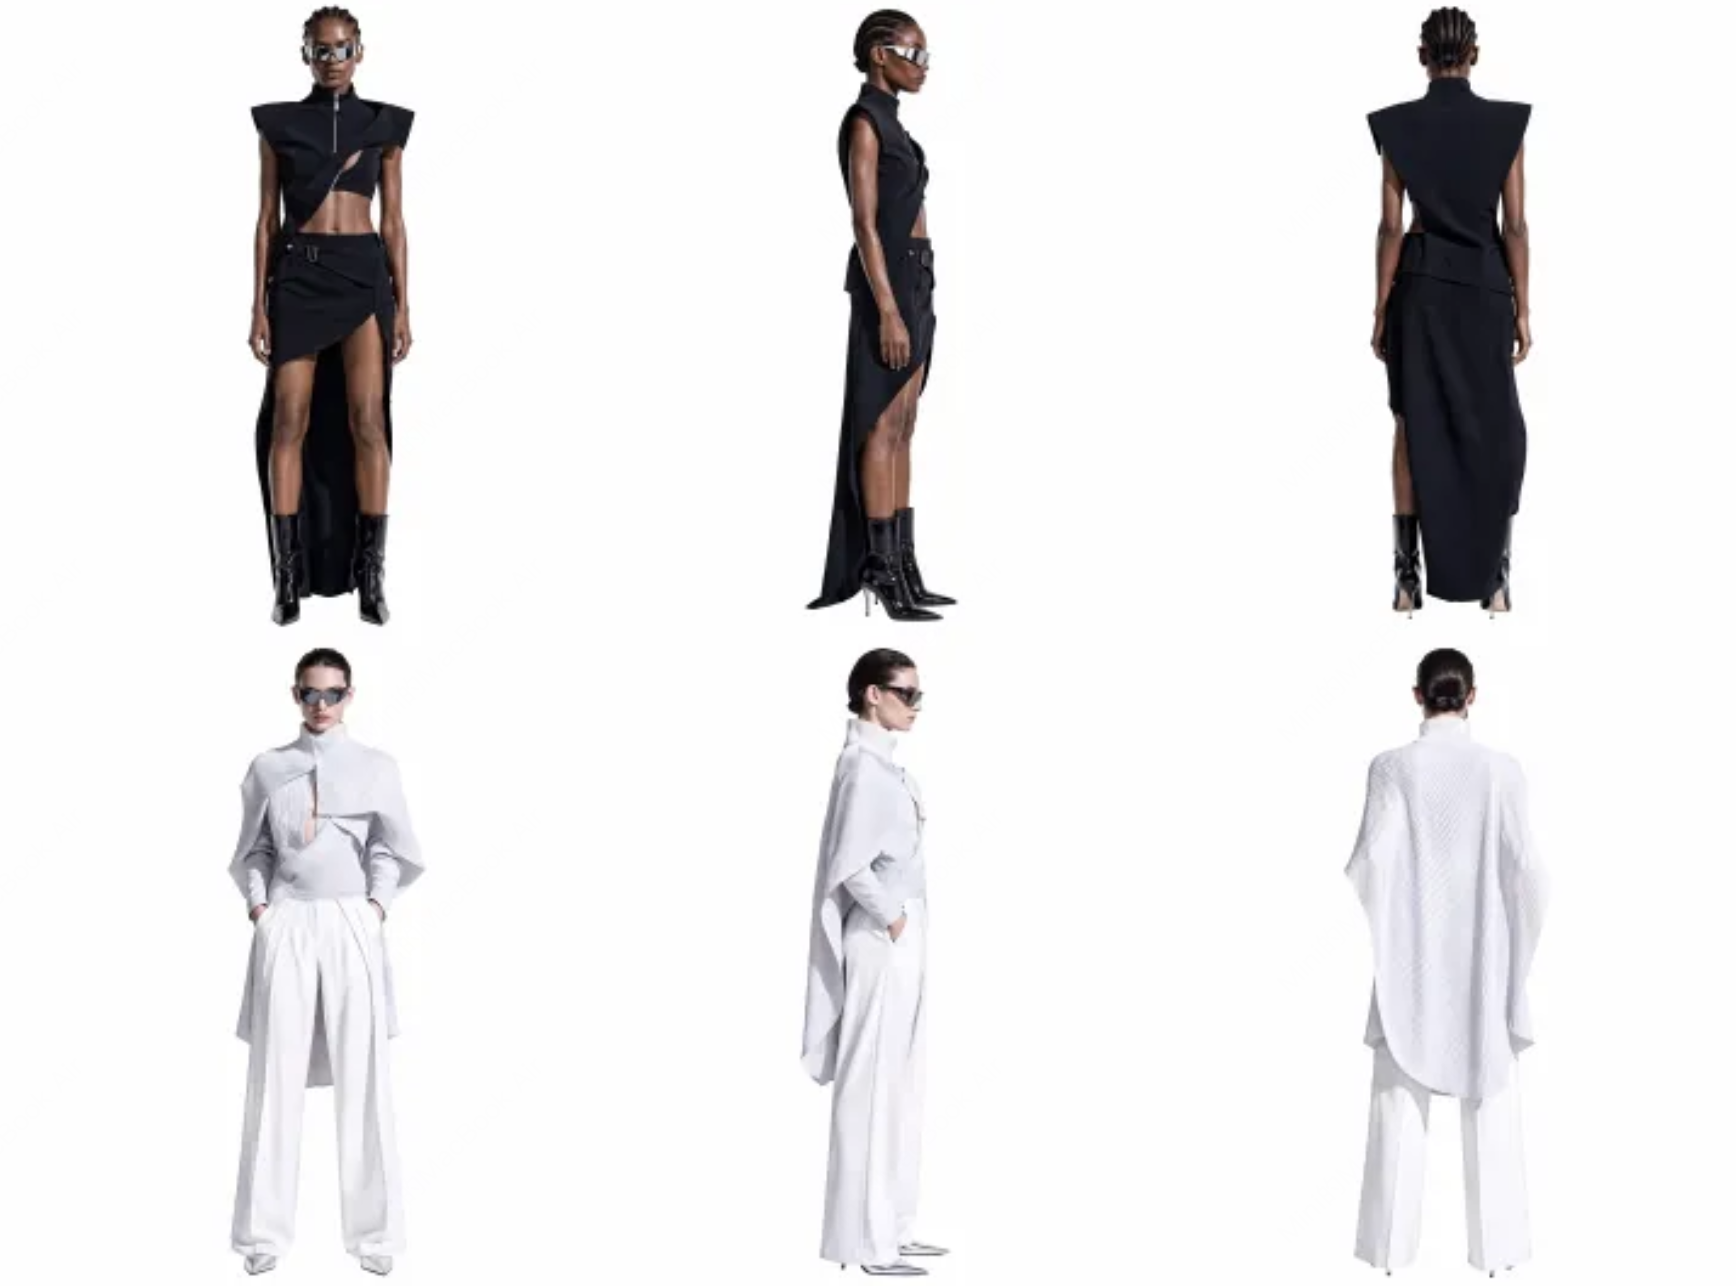 | 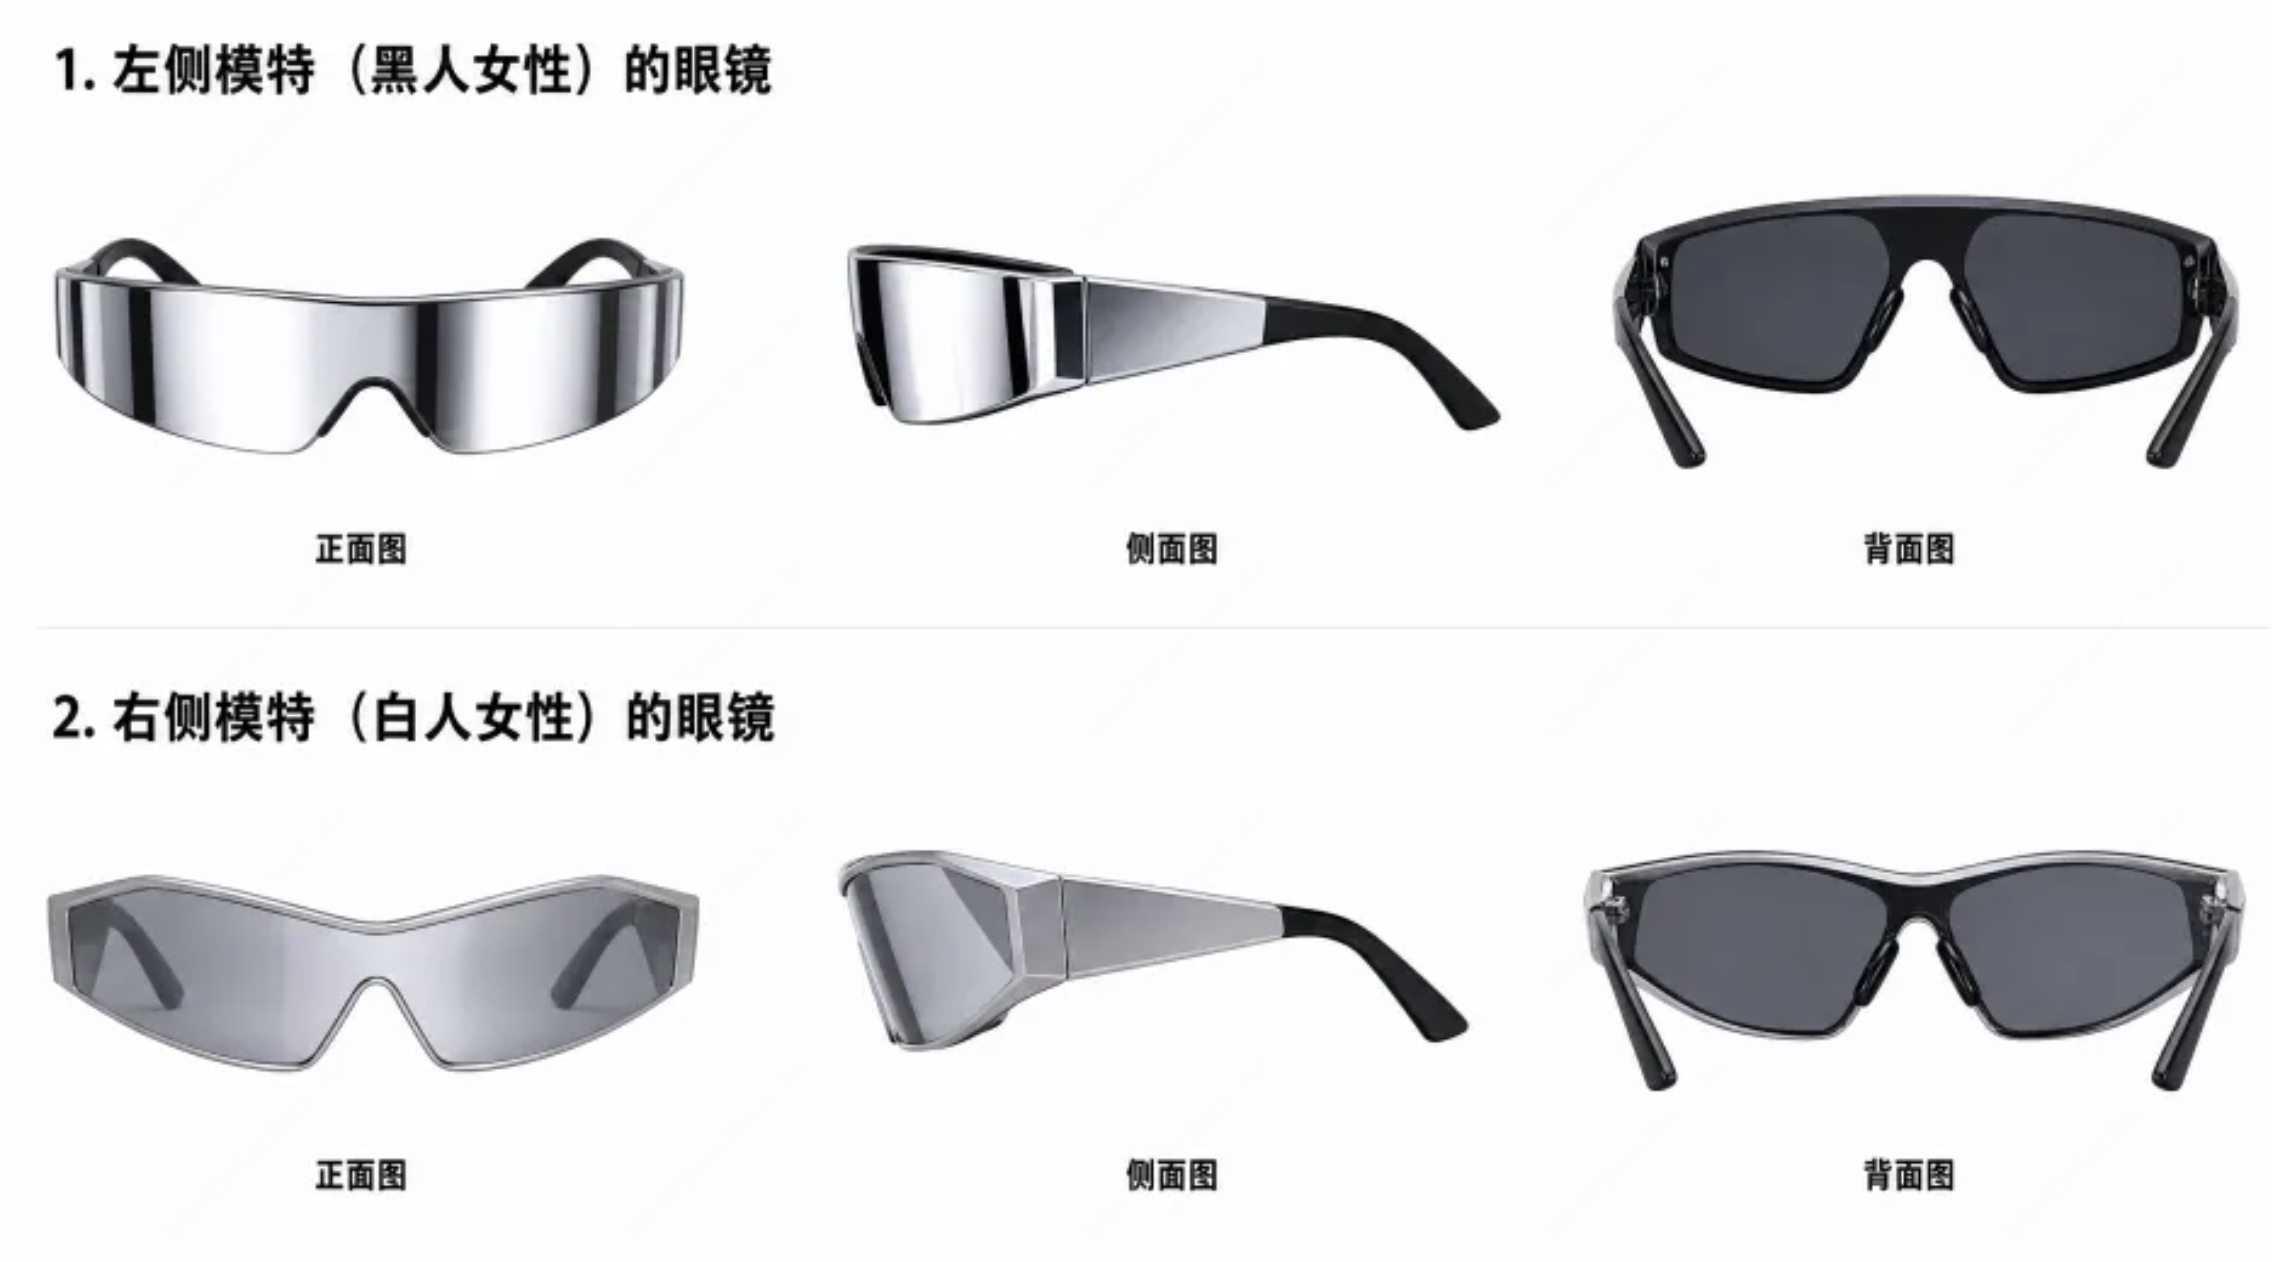 |
文生视频
只有一个文本项时即为文生视频。适合从创意、脚本或镜头描述直接生成画面。提示词可以按“主体 + 动作 + 场景 + 镜头 + 光线 + 声音”的顺序组织。"async": true,接口立即返回:
首帧图生视频
将图片标记为first_frame,模型会从该画面开始生成。适合让海报、商品图、角色设定图和摄影作品自然动起来。
尾帧和首尾帧视频
只提供last_frame 可以让模型自然生成到指定画面;同时提供 first_frame 与 last_frame,可以明确控制起点和终点。适合转场、形态变化、成长过程或产品前后对比。
多模态参考生视频
参考素材可以组合使用:参考图片控制角色或产品外观,参考视频控制动作和运镜,参考音频控制对白音色、音乐或剪辑节奏。提示词中应明确说明每类素材要控制什么,避免只上传素材却不给出关联关系。回调通知
传入callback_url 会自动启用异步模式:创建接口立即返回 task_id 和 trace_id,并在任务完成后向该地址 POST 最终结果,结构与任务查询响应一致。
回调中的最终状态为 succeeded、failed 或 cancelled。即使使用回调,也建议保存 task_id,以便主动查询或补偿漏掉的通知。
常见错误
同步响应中的
task.status: succeeded 表示视频已生成;异步确认只代表任务已进入队列。只有任务最终成功时才会计费,查询任务本身免费,不会重复扣费。
H3 Max
MiniMax-H3-Max 支持 480P 或 768P、5–15 秒整数时长。音频输入不额外计费,前 2 张图片免费,超出部分逐张计费;参考视频按实际输入时长计费。该模型不支持 2K。