

حدوديدعم Suno الآنlyricوstyleفي الجدول أعلاه هي الحدود القصوى في الوضع المخصص (عندما تكونcustomبقيمةtrue). أما وضع الإلهام غير المخصص (عندما تكونcustomبقيمةfalse) فيملأpromptفقط، وحده الأقصى للطول هو 500 حرف (ومتطابق في جميع النماذج).
chirp-v6 وchirp-v6-wild وchirp-v6-mini. يُوصى باستخدام chirp-v6؛ وتبقى أسماء النماذج القديمة متوافقة.
ومع ذلك، لا يوفر Suno الرسمي واجهة API، وتوفر AceDataCloud مجموعة من واجهات API لـ Suno، تحاكي التكامل مع Suno الرسمي، ويمكنها إنشاء الموسيقى المطلوبة بسهولة وسرعة.
التقديم والاستخدام
لاستخدام Suno Audios Generation API، انتقل أولًا إلى وحدة تحكم Ace Data Cloud للحصول على API Token الخاص بك، واحتفظ به للاستخدام لاحقًا. إذا لم تكن قد سجلت الدخول أو أنشأت حسابًا بعد، فسيتم تحويلك تلقائيًا إلى صفحة تسجيل الدخول لدعوتك إلى التسجيل وتسجيل الدخول، وبعد الإكمال ستعود تلقائيًا إلى الصفحة الحالية.
يمكن لـ API Token واحد استدعاء جميع خدمات المنصة، ولا حاجة للتقديم بشكل منفصل لكل خدمة. سيُمنح رصيد مجاني عند التقديم للمرة الأولى، ويمكنك التجربة مجانًا؛ وعندما لا يكون الرصيد كافيًا، يمكنك شحن الرصيد العام من وحدة التحكم.
📘 الوثائق الكاملة: Suno Audios Generation API →
الاستخدام الأساسي
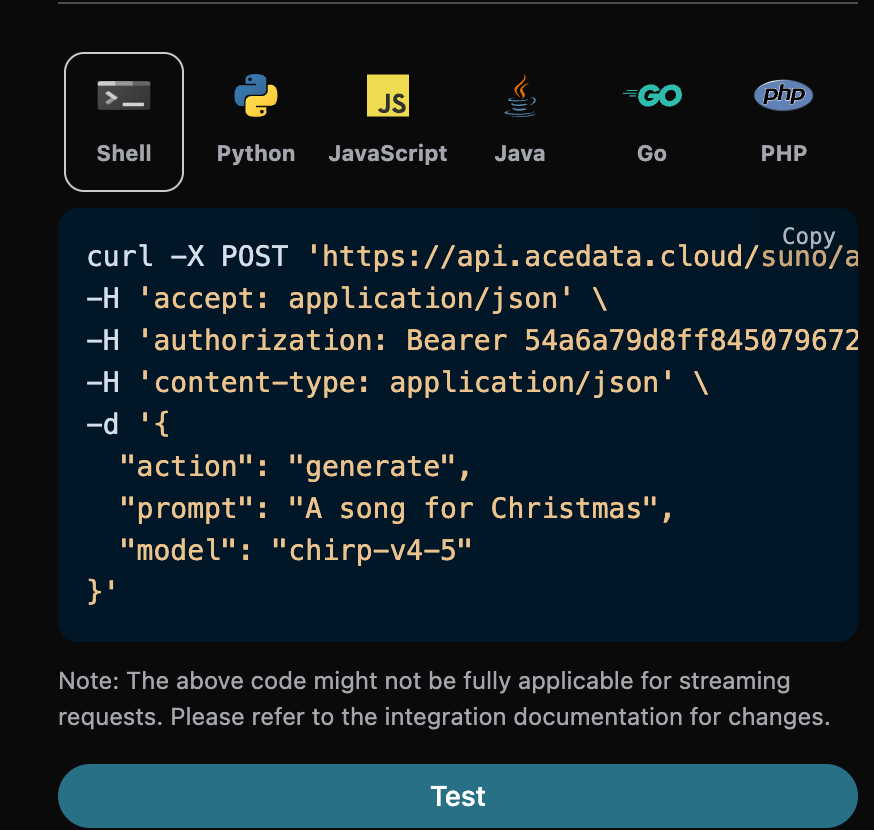
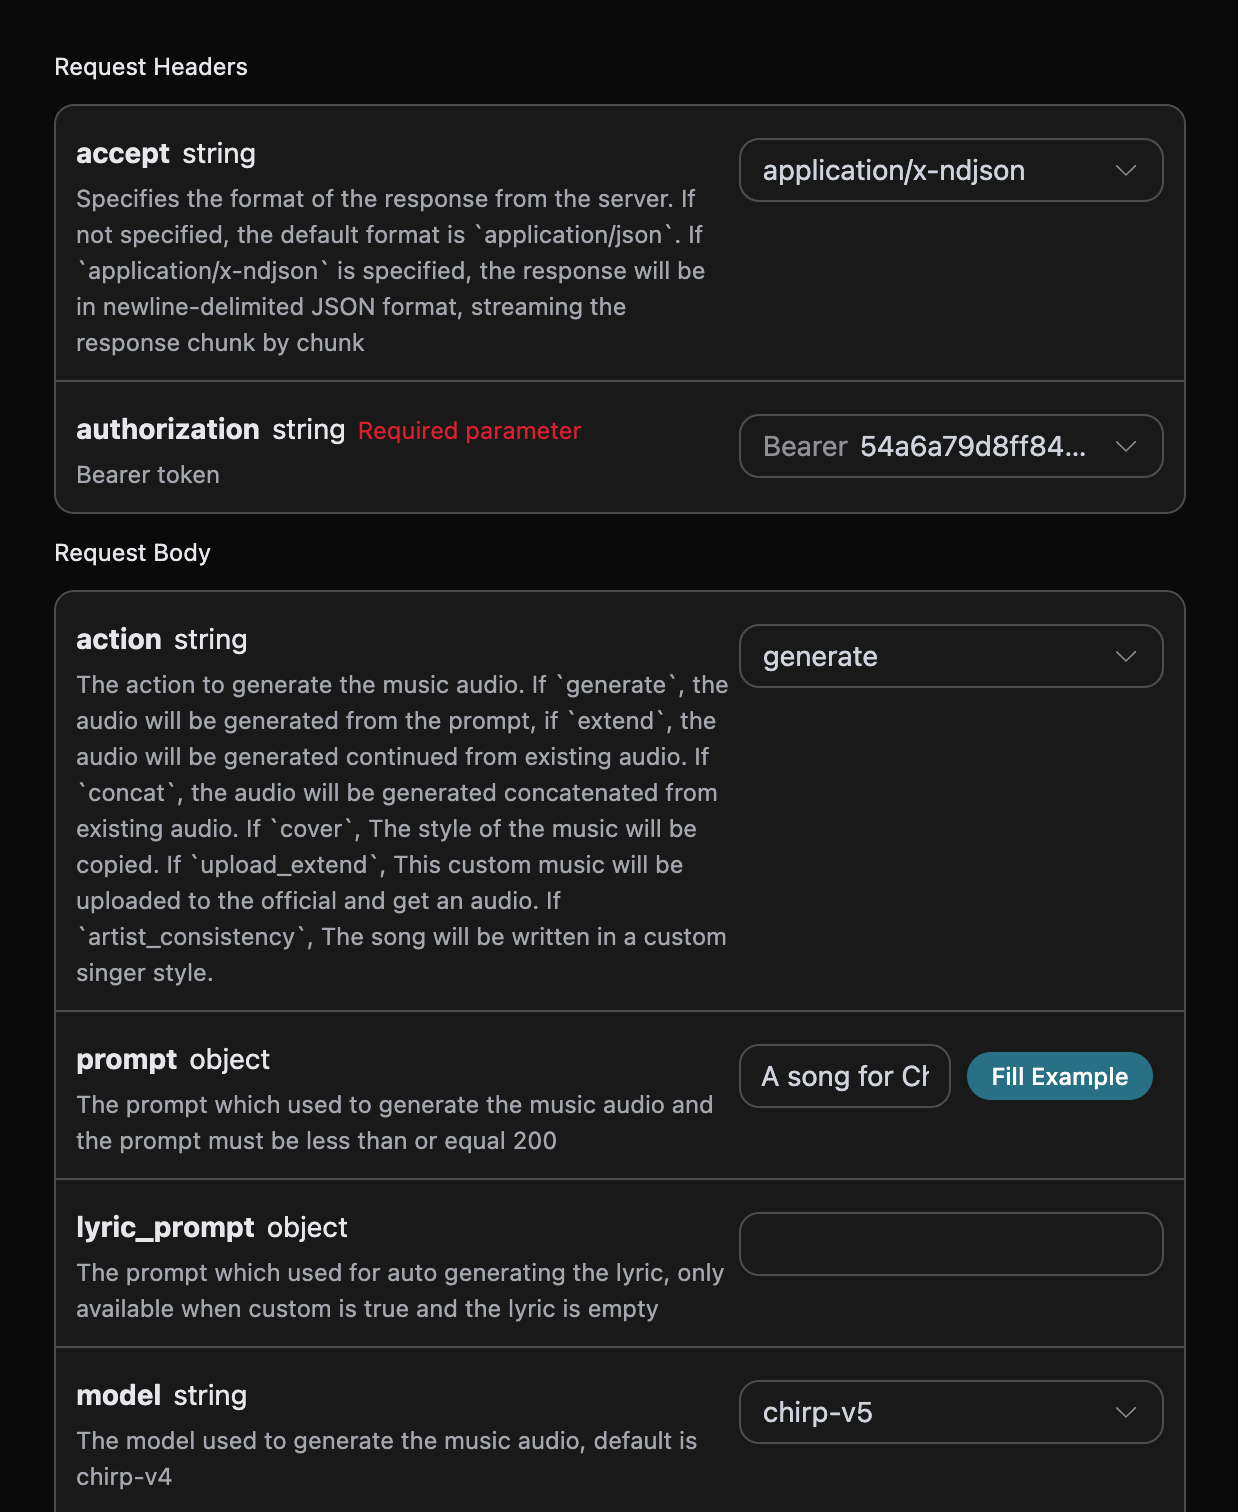
أي نوع من الأغاني تفكر فيه، يمكنك إدخال أي نص، على سبيل المثال إذا أردت إنشاء أغنية عن عيد الميلاد، يمكنك إدخالa song for Christmas، كما هو موضح في الصورة:
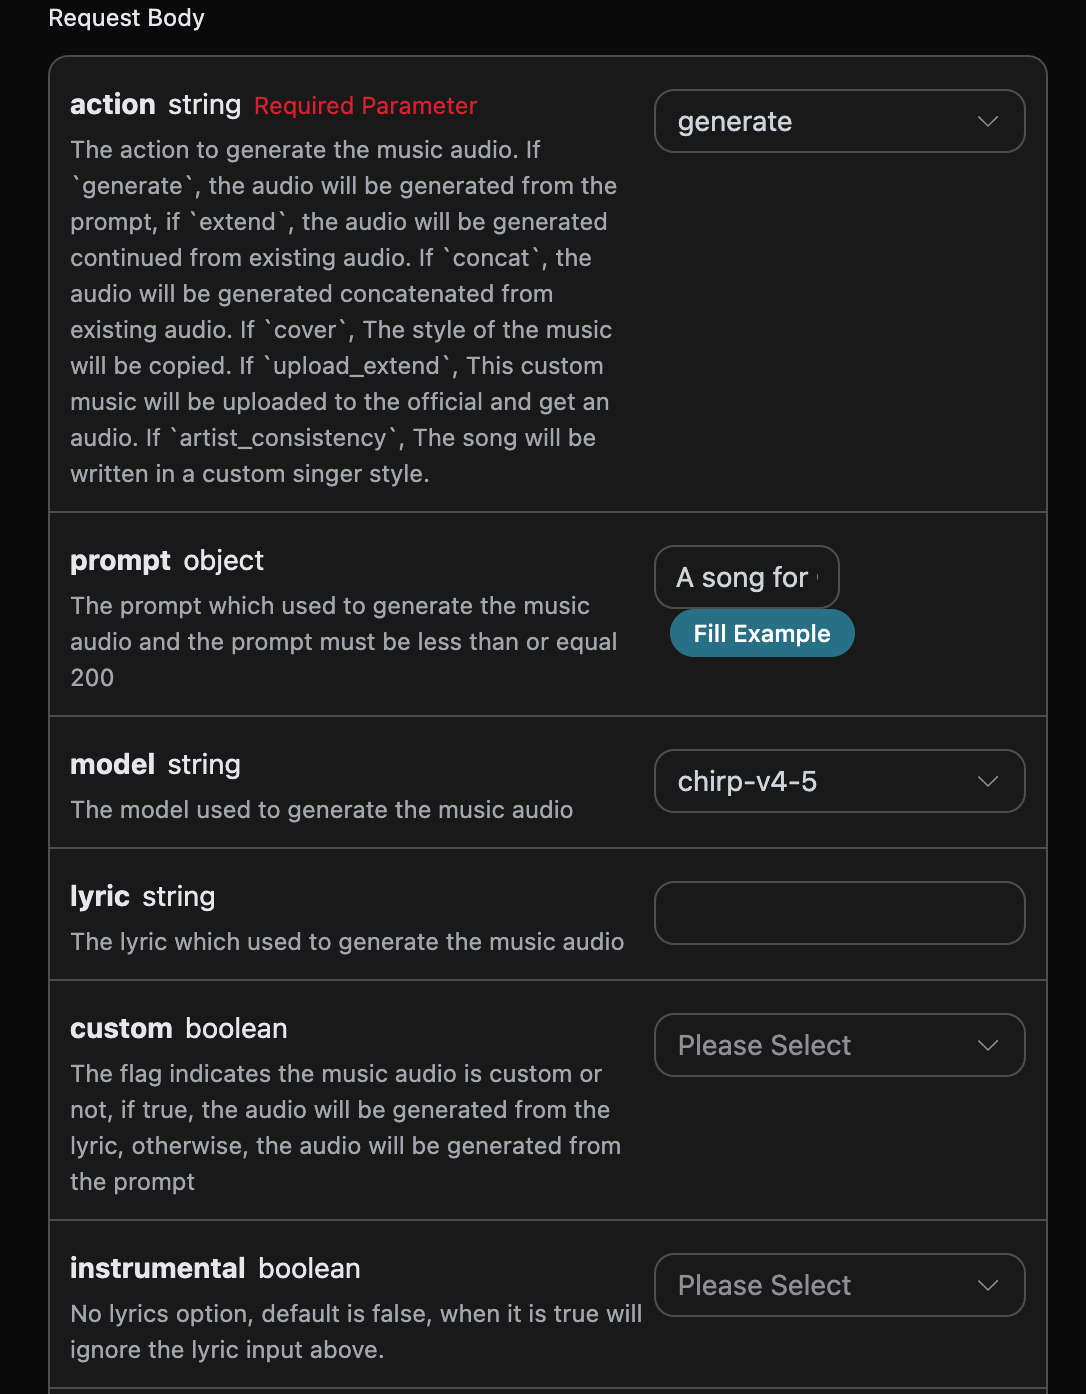
accept: نوع تنسيق نتيجة الاستجابة التي تريد تلقيها، وهنا تم تعبئته بـapplication/json، أي تنسيق JSON.authorization: مفتاح استدعاء API، ويمكن اختياره مباشرة من القائمة المنسدلة بعد التقديم.
action: نوع مهمة الصوت، الافتراضي هوgenerate. يدعم عمليات مثل التوليد، والتمديد، وإعادة الغناء، والدمج، وفصل المسارات، وإضافة المسارات الصوتية، واستخراج مسار صوتي محدد، وتوليد المؤثرات الصوتية، وضبط السرعة، وغيرها، ويتم استدعاؤها جميعًا عبرPOST /suno/audios.prompt: نص مطالبة وضع الإلهام الرسمي من Suno (يكون فعالًا عندما تكونcustomبقيمةfalse)، بحد أقصى 500 حرف.model: نموذج مهمة توليد الموسيقى هذه. تتضمن سلسلة v6 كلاً منchirp-v6وchirp-v6-wildوchirp-v6-mini؛ وتظل أسماء النماذج القديمة متوافقة.max_mode: وضع التوليد المحسّن. لا يتم تمكينgenerateإلا عندما تكون كل منcustomوmax_modeبقيمةtrue، وتكلفته 1.12 Credits؛ ويمكن تمكينadd_stemمباشرةً، وتكلفته 1.344 Credits. عند إيقافه أو حذفه، تكون التكلفة 0.56 و0.672 Credits على التوالي.variety: شدة تنوع النتائج المُولَّدة، والقيم الاختيارية هيoffوnormalوhighوextraوmax. يُستخدم فقط معgenerateوadd_stem، وسيؤدي تمريره مع action آخر إلى إرجاع 400.lyric: محتوى كلمات الأغنية لوضع التخصيص الرسمي من Suno. الحد الأقصى لـchirp-v3-5وchirp-v4هو 3000 حرف؛ ولـchirp-v4-5وما بعده (بما في ذلكchirp-v5وchirp-v5-5) هو 5000 حرف.custom: ما إذا كان سيتم استخدام وضع التخصيص، والافتراضي هو:false.instrumental: خيار الموسيقى الآلية الخالصة لوضع الإلهام الرسمي من Suno.title: عنوان الموسيقى لوضع التخصيص الرسمي من Suno. الحد الأقصى لـchirp-v3-5وchirp-v4هو 80 حرفًا؛ ولـchirp-v4-5وما بعده هو 100 حرف.style: نمط الموسيقى لوضع التخصيص الرسمي من Suno. الحد الأقصى لـchirp-v3-5وchirp-v4هو 200 حرف؛ ولـchirp-v4-5وما بعده (بما في ذلكchirp-v5وchirp-v5-5) هو 1000 حرف.negative_tags: أنماط أو أنواع موسيقية يُراد استبعادها من النتائج المُولَّدة في وضع التخصيص (عندما تكونcustomبقيمةtrue).audio_weight: وزن تأثير خصائص الصوت أو الصوت البشري، ضمن النطاق 0-1، وتُعد0أيضًا قيمة صالحة. يمكن استخدامه لعمليات مثل التوليد، والتمديد، وإعادة الغناء، وإضافة المسارات الصوتية، واتساق الصوت؛ وعند عدم وجود صوت مرجعي أو خصائص صوتية، قد يُضعف النموذج هذه القيمة أو يتجاهلها.audio_id: معرّف الموسيقى المرجعية.overpainting_start/overpainting_end: وقتا البدء والانتهاء لإضافة غناء بشري إلى موسيقى آلية موجودة، بوحدة الثواني.underpainting_start/underpainting_end: وقتا البدء والانتهاء لإضافة مرافقة موسيقية إلى غناء دون مرافقة، بوحدة الثواني.persona_id: معرّف أغنية الفنان.continue_at: حد التمديد، بوحدة الثواني. على سبيل المثال، يشير 213.5 إلى بدء توليد المقطع اللاحق من الدقيقة الثالثة و33.5 ثانية. لا يوجّهlyricوstyleإلا المحتوى الجديد بعد الحد، ولن يستبدلا الكلمات أو الغناء قبل الحد في الصوت المصدر.style_influence: تأثير النمط في وضع التخصيص، ضمن النطاق 0-1، وكلما زادت القيمة، زادت عادةً مطابقة النمط المحدد؛ ويتم تمرير0كقيمة صالحة.replace_section_end: الوقت النهائي للمقطع المستبدل.replace_section_start: وقت بدء المقطع المستبدل.vocal_gender: يتحكم في تفضيل الصوت الأنثوي أو الذكوري، الصوت الأنثويf، والصوت الذكوريm، وهو فعّال في نماذج 4.5 وما بعدها؛ وهو عنصر تفضيل ولا يضمن الالتزام الصارم.weirdness: درجة الغرابة في وضع التخصيص، ضمن النطاق 0-1، وكلما زادت القيمة، كانت النتيجة عادةً أكثر إبداعًا وتجريبية؛ ويتم تمرير0كقيمة صالحة.duration: مدة الأغنية المطلوبة، بوحدة الثواني، ويجب أن تكون عددًا صحيحًا، ضمن النطاق من 10 إلى 360. تُستخدم هذه المعلمة لتوليد الأغاني في وضع التخصيص (عندما تكونcustomبقيمةtrue). وهي مطالبة توجيهية وليست قيدًا صارمًا: سيأخذها النموذج في الاعتبار، لكنه لا يضمن تحقيقها، وتكون مدة المنتج الفعلية وفقًا لحقلdurationفي الاستجابة، وعادةً ما تكون أقصر من القيمة المطلوبة.
نطاق تطبيق المعلمات المتقدمة
ستتحقق المنصة من أنواع المعلمات ونطاقات القيم، لكنها لن ترفض هذه عناصر الضبط الاختيارية لمجرد اختلاف action؛ إذ يحدد التأثير الفعلي كل من العملية والوضع والنموذج.
lyric_prompt: prompt لتوليد الكلمات، ولا يكون فعالًا إلا عندما تكونcustomبقيمةtrueولا يتم تمريرlyric.callback_url: عنوان URL الذي يتطلب استدعاءً راجعًا للنتيجة.async: اختياري، عند ضبطه علىtrueتُرجع الواجهةtask_idفورًا، دون الحاجة إلى تقديمcallback_url، ثم يتم الحصول على النتيجة عبر الاستعلام الدوري باستخدام واجهة الاستعلام عن المهمة المقابلة.
- success: ما إذا كان التوليد ناجحًا، فإذا نجح تكون القيمة
true، وإلا فتكونfalse - data: هي قائمة تحتوي على المعلومات التفصيلية للأغاني التي تم توليدها.
- state: حالة توليد الأغنية، وتتضمن بشكل أساسي أربع حالات، كما يلي:
- succeeded: تم التوليد بنجاح
- pending: في قائمة الانتظار
- running: قيد التنفيذ
- error: فشل
- id: معرّف الأغنية
- title: عنوان الأغنية
- image_url: صورة غلاف الأغنية
- lyric: كلمات الأغنية
- audio_url: عنوان الصوت النهائي للأغنية. ستُرجع المنصة عنوان Ace Data Cloud CDN بشكلٍ تفضيلي؛ وإذا فشلت الاستمرارية، فقد تُرجع عنوان الوسائط الأصلي، لذا يُرجى التنزيل في الوقت المناسب.
- video_url: ملف فيديو الأغنية، وعند فتحه يكون فيديو mp4.
- created_at: وقت الإنشاء
- model: النموذج المستخدم، وعادةً ما يكون أحدث نموذج v3
- style: النمط
- state: حالة توليد الأغنية، وتتضمن بشكل أساسي أربع حالات، كما يلي:
التوليد المخصص
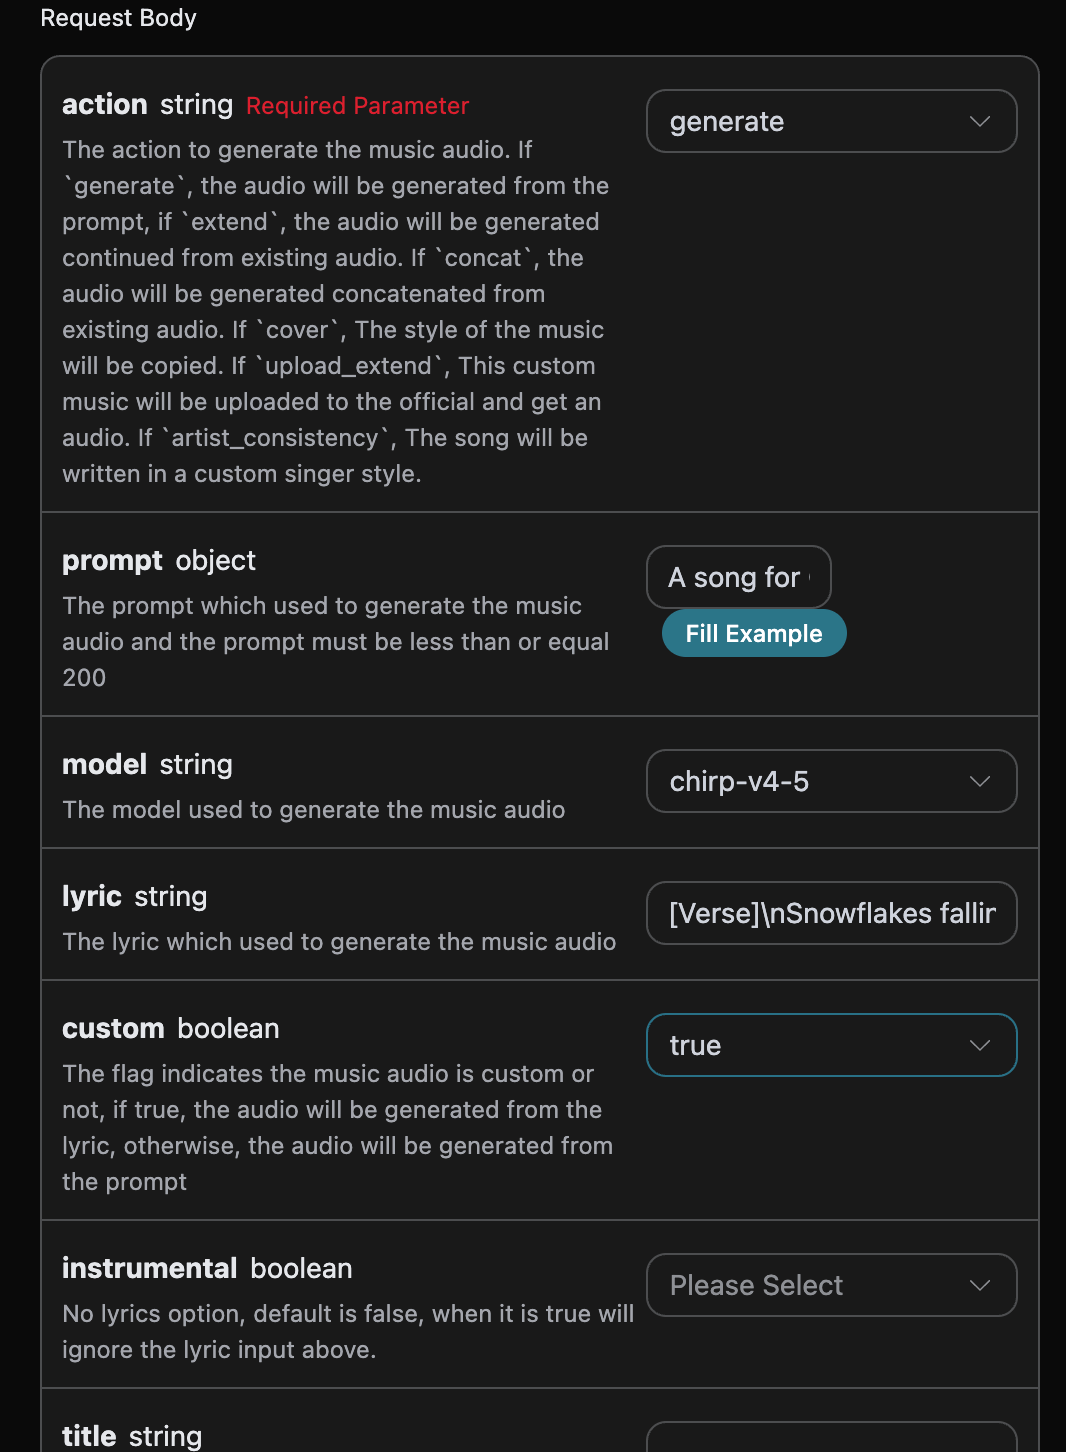
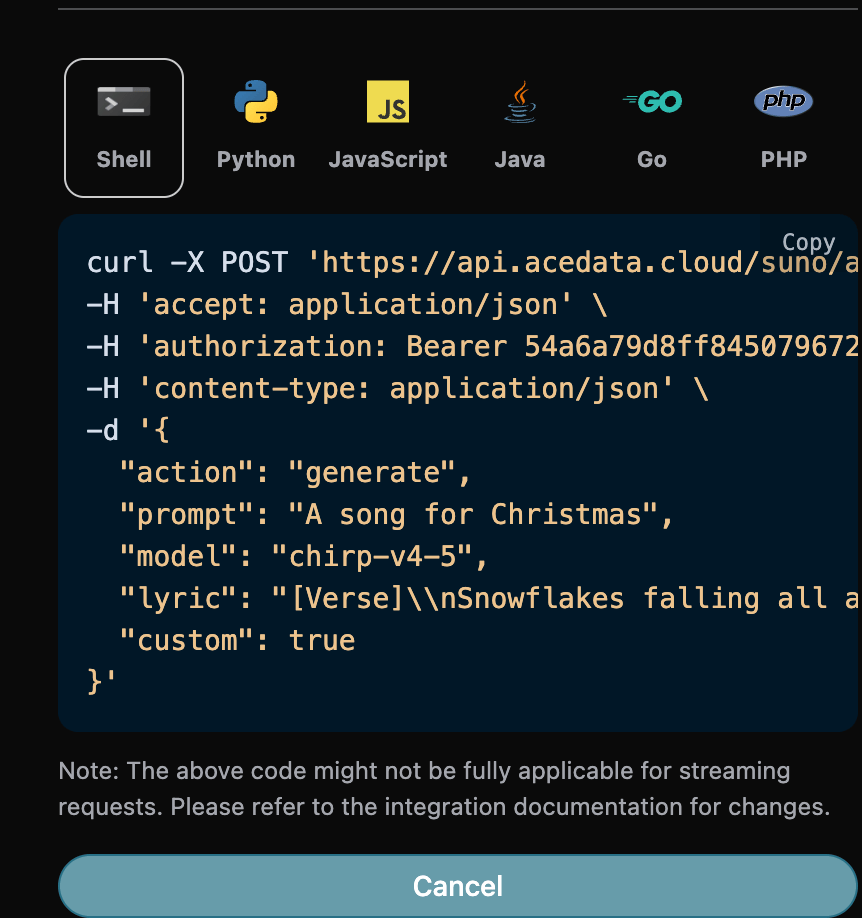
إذا كنت ترغب في تخصيص توليد كلمات الأغنية، يمكنك إدخال الكلمات: في هذه المرحلة، يمكن تمرير محتوى مشابه لما يلي في حقلlyric:
ملاحظة: إن \n في كلمات الأغنية هنا هو رمز سطر جديد، وإذا كنت لا تعرف كيفية توليد كلمات الأغنية، يمكنك استخدام واجهة برمجة التطبيقات لتوليد كلمات الأغاني التي توفرها AceDataCloud لتوليد الكلمات عبر prompt، وواجهة البرمجة هي Suno Lyrics Generation API.
بعد ذلك، لتخصيص توليد الأغنية بناءً على كلمات الأغنية والعنوان والنمط، يمكن تحديد المحتوى التالي:
- lyric: نص كلمات الأغنية
- custom: املأها بـ
true، وهي تمثل التوليد المخصص، والقيمة الافتراضية لهذه المعلمة هي false، وتمثل استخدامpromptللتوليد. - title: عنوان الأغنية.
- style: نمط الأغنية، اختياري.
ميزة التوليد المخصص لنمط المغني
إذا كنت ترغب في استخدام أسلوب مغنٍّ لتوليد أغنية، فقم أولاً بتوليد أغنية عبر الاستخدام الأساسي أعلاه، وفي النهاية تحصل على الحاجة إلى تعيين هذه الأغنية كأسلوب مغنٍّ، ثم تحتاج إلى الدخول إلى Suno Persona API لإنشاء معلمة معرف أسلوب مغنٍّpersona_id استنادًا إلى معرف الموسيقى الذي تم إنشاؤه رسميًا audio_id، والمعلمات المحددة موضحة في الصورة أدناه:
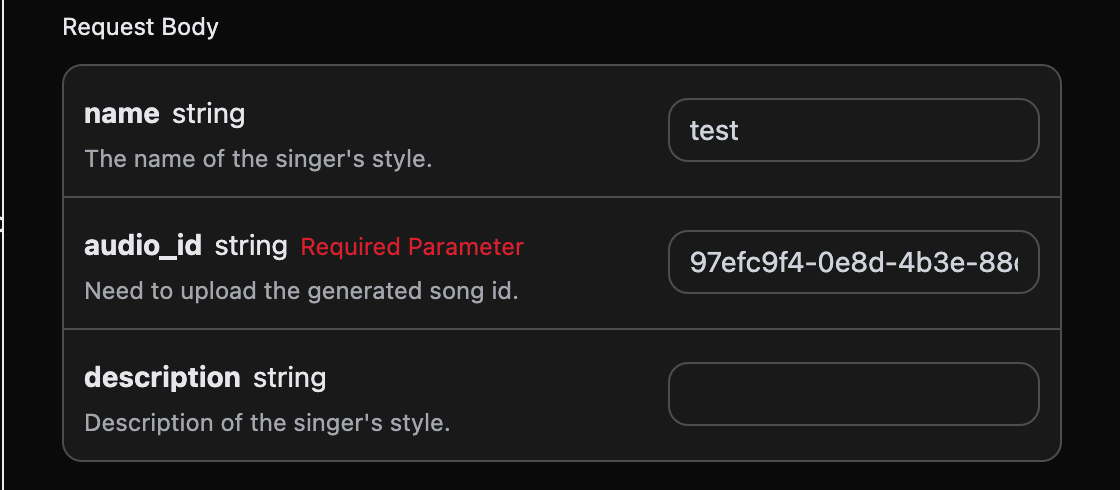
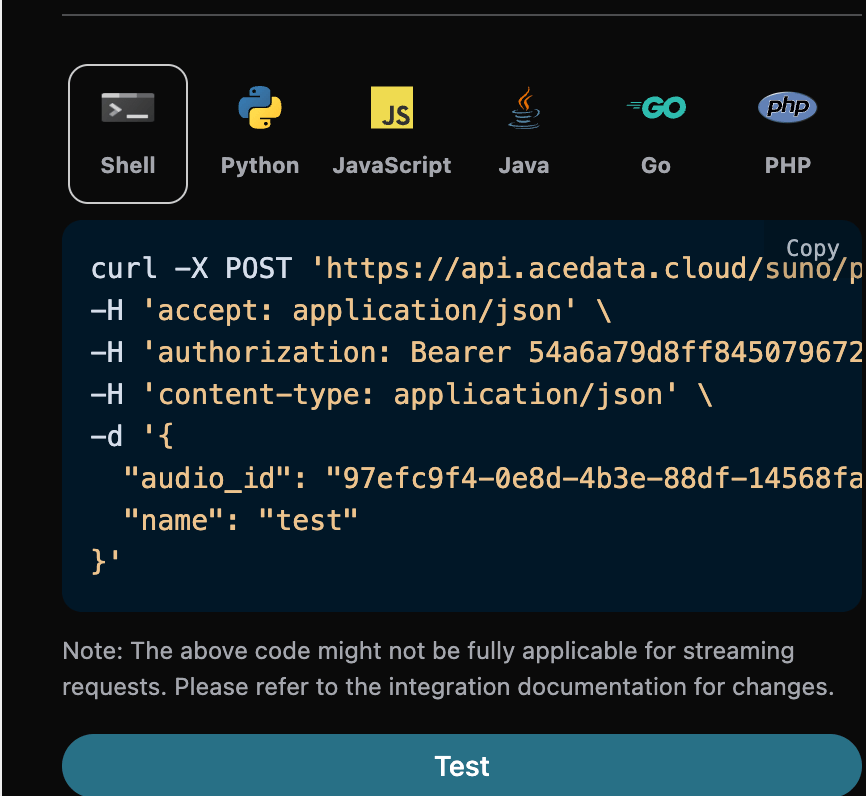
audio_id وpersona_id أعلاه، وهما 97efc9f4-0e8d-4b3e-88df-14568fa1b11f وe0d7319e-aa2a-44cb-b00a-916218d7cb0b على التوالي، كبيانات المثال هذه. ثم يمكن تعيين المعلمة action إلى artist_consistency (إذا كان أسلوب المغني الجديد Persona-v2-vox، فيجب تعيين action إلى artist_consistency_vox)، وإدخال معرف الأغنية التي تحتاج إلى مواصلة توليدها، ومعرف أسلوب المغني، ومثال التعبئة كما يلي:
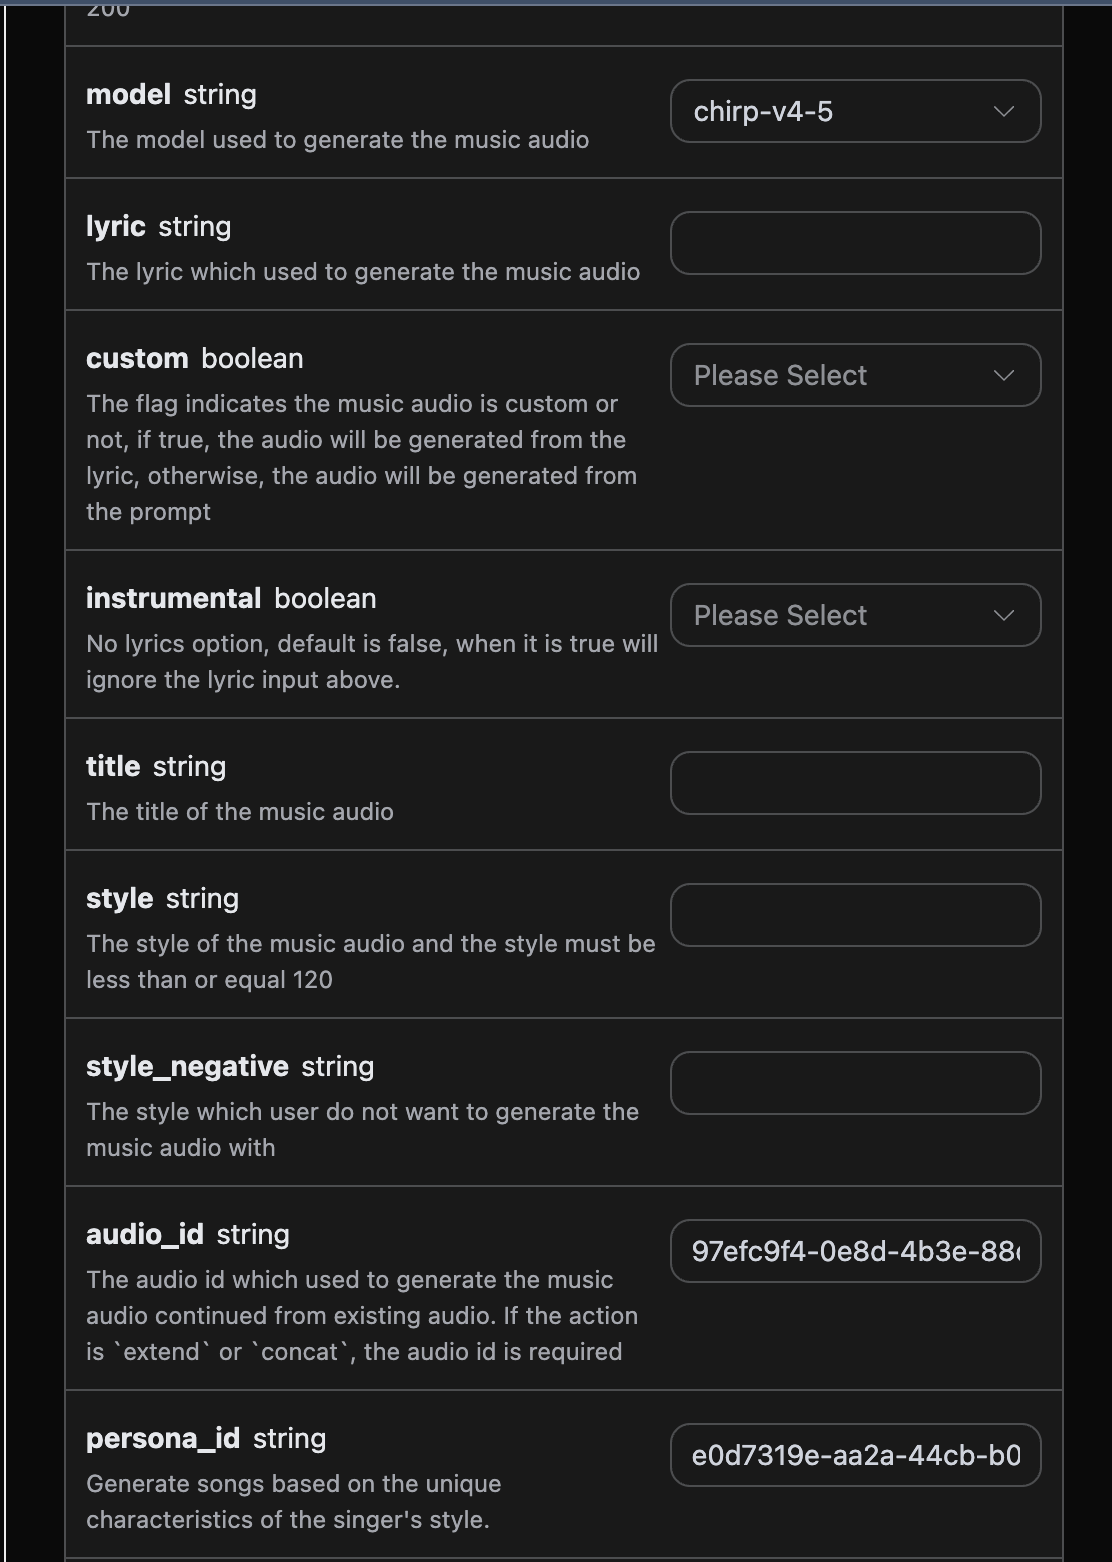
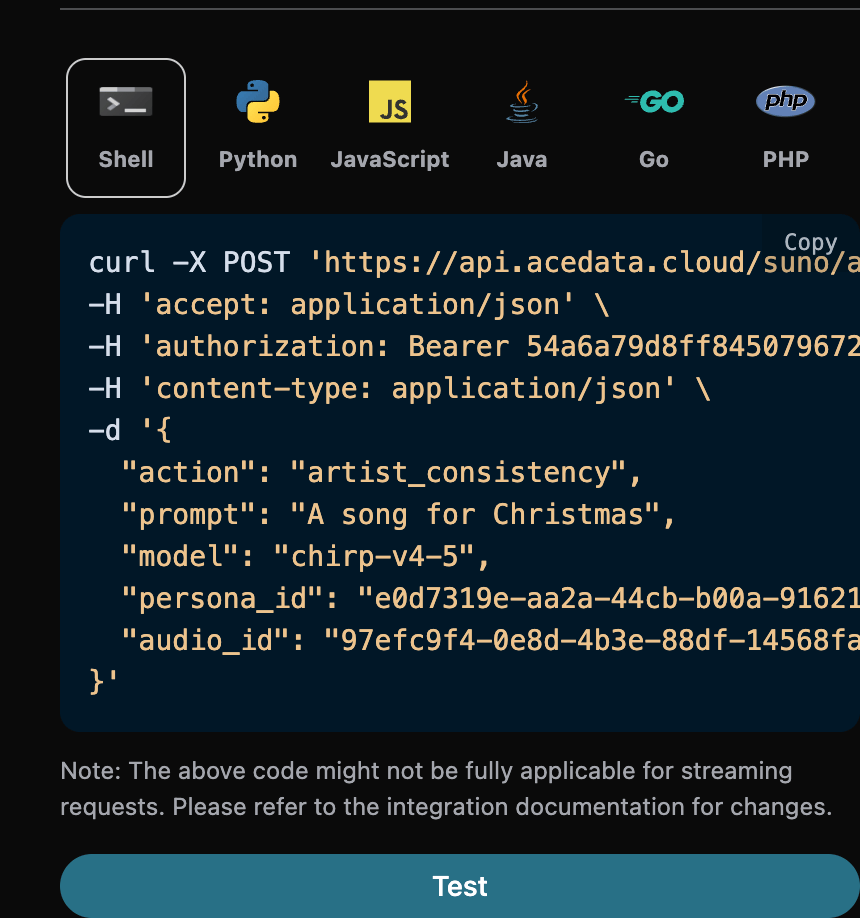
وظيفة مواصلة التوليد
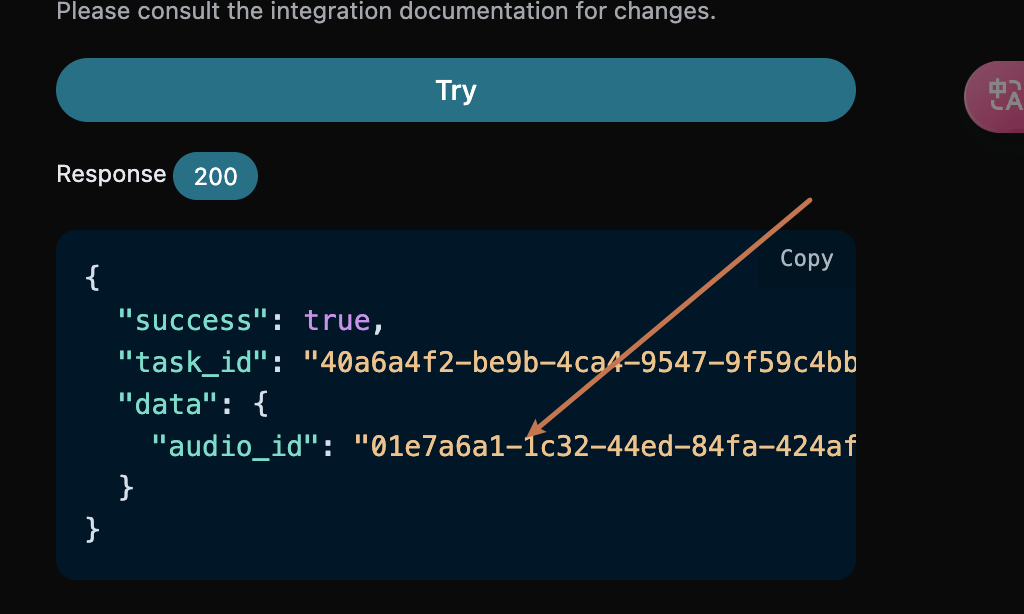
إذا كنت ترغب في مواصلة توليد أغنية Suno تم إنشاؤها بالفعل، فيمكنك تعيين المعلمةaction إلى extend، وإدخال معرف الأغنية التي تحتاج إلى مواصلة توليدها، ويتم الحصول على معرف الأغنية وفقًا للاستخدام الأساسي، ومن خلال ما سبق يمكن معرفة أنه في هذا الوقت يمكن رؤية أن معرف الأغنية هو:
ملاحظة، id في كلمات الأغنية هنا هو معرف الأغنية بعد التوليد. إذا كنت لا تعرف كيفية توليد أغنية، فيمكنك الرجوع إلى الاستخدام الأساسي أعلاه لتوليد أغنية.
إذا كنت ترغب في مواصلة توليد أغنية رفعتها بنفسك، فيمكنك تعيين المعلمة action إلى upload_extend، وإدخال معرف الأغنية المرفوعة المخصصة التي تحتاج إلى مواصلة توليدها، ويتم الحصول على معرف الأغنية باستخدام Suno Upload Generation API، كما هو موضح في الصورة أدناه:
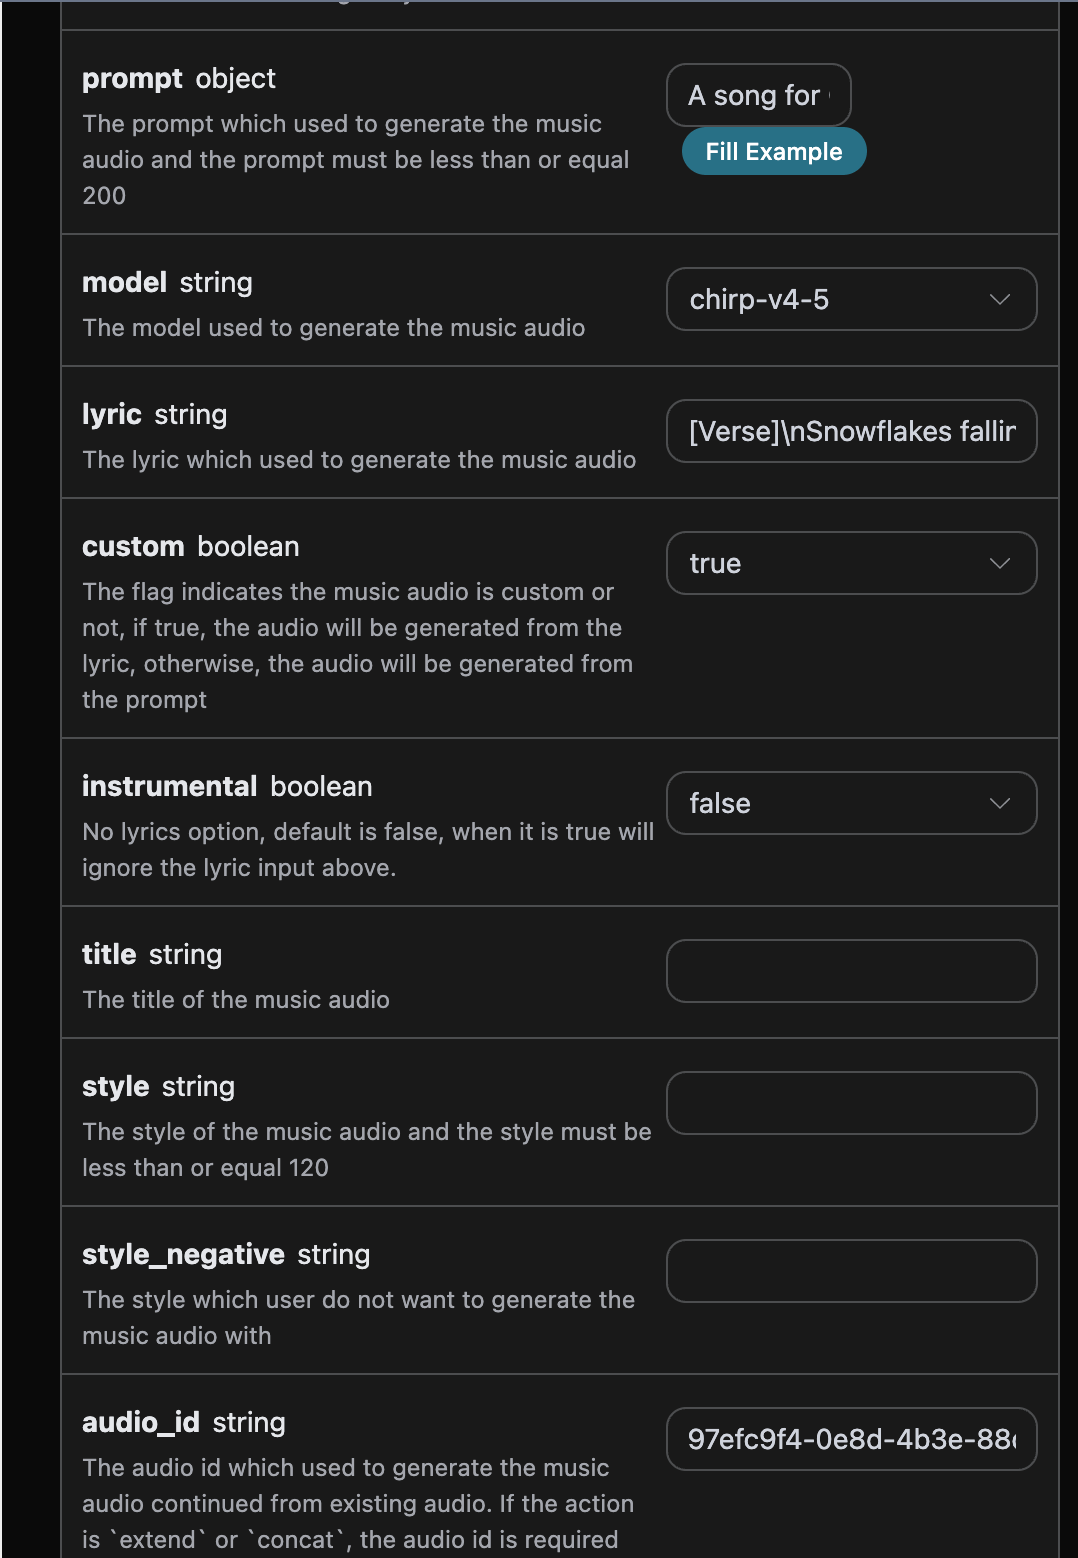
- lyric: يُستخدم فقط لتوجيه كلمات المقطع المُولَّد حديثًا بعد
continue_at، ولن يستبدل الكلمات الموجودة في الصوت المصدر قبل تلك النقطة الزمنية. - custom: املأه بـ
true، وهو ما يعني التوليد المخصص، والقيمة الافتراضية لهذه المعلمة هي false، مما يعني استخدامpromptللتوليد. - style: أسلوب أغنية مقطع المتابعة، اختياري.
- continue_at: حد المتابعة، بوحدة الثواني. على سبيل المثال، تشير 213.5 إلى بدء توليد المقطع اللاحق من الدقيقة الثالثة و33.5 ثانية.
يُستخدممثال التعبئة كما يلي:extendلمواصلة الإبداع إلى الأمام انطلاقًا من أغنية موجودة، وليس لتغيير كلمات الأغنية كاملة. إذا كنت ترغب في استخدام كلمات جديدة للأغنية كاملة من البداية، فيرجى استخدامgenerateلإعادة التوليد؛ وإذا كنت ترغب في إعادة أداء الأغنية بالرجوع إلى أغنية موجودة، فيمكنك استخدامcover. عند تمرير كلمات جديدة كاملة، لن يتم استبدال الكلمات الأصلية قبلcontinue_atأيضًا.
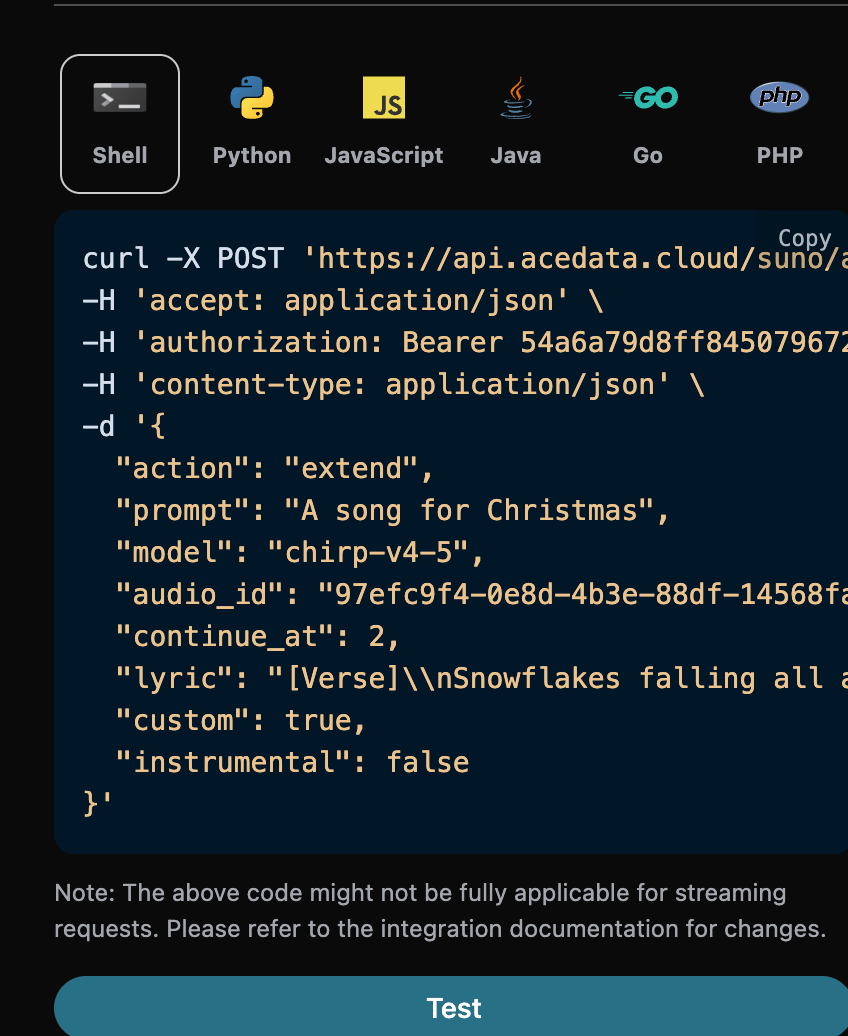
continue_at يساوي ثانيتين، لذلك فإن أول ثانيتين فقط تنتميان إلى المحتوى الأصلي قبل حد الاستكمال. عند الاستكمال فعليًا بالقرب من نهاية الأغنية، يجب ضبط هذه القيمة على عدد الثواني المتوقع بدء الاستكمال عندها، وتوفير المقطع الجديد المراد غناؤه بعد الحد فقط في lyric.
كود Python المقابل:
lyric في النتيجة سيُرجع نص كلمات الأغنية المستخدمة في مهمة الاستكمال هذه. هذا الحقل ليس تفريغًا حرفيًا للصوت النهائي الكامل؛ بالنسبة إلى extend، يستمر الصوت المصدر قبل continue_at في استخدام الكلمات الأصلية، وتُستخدم الكلمات الجديدة فقط لتوجيه مقطع الاستكمال.
الحصول على الأغنية الكاملة
عادةً ما تتضمن نتيجةextend للنموذج الحالي الصوت المصدر قبل continue_at والمحتوى الجديد بعد الحد، لذا يُرجى أولًا تحديد ما إذا كانت أغنية كاملة بالفعل بناءً على المدة الفعلية ومحتوى الصوت المُرجع. إذا كان المُرجع مقطع استكمال مستقلًا، أو إذا كان من الضروري دمج سجل عدة عمليات استكمال صراحةً في أغنية واحدة، فاستخدم وظيفة الدمج بعد ذلك:
- action: المحتوى هو
concat. - audio_id: معرّف آخر مقطع استكمال.
إعادة إنتاج الموسيقى
عند الاستمرار في إنشاء أغنية بناءً على الأغنية الأصلية، قد لا يكون نمط الأغنية المُعادة مناسبًا تمامًا. إذا أردت إعادة إنتاج الأغنية التي تم إنشاؤها سابقًا (ويُدعم أيضًا إذا كانت موسيقى مرفوعة بشكل مخصص)، فيجب استخدام طريقة إعادة إنتاج الموسيقى، ويمكن عندها تحديد المحتوى التالي:- action: المحتوى هو
cover، وعند إجراء عملية إعادة إنتاج لموسيقى مرفوعة بشكل مخصص، يجب تحديد المحتوى على أنه:upload_cover. - audio_id: معرّف الأغنية التي تم إنشاؤها سابقًا.
استبدال المقطع
عند الحاجة إلى إجراء إبداع ثانوي من خلال عملية مستقلة لاستبدال مقطع من الأغنية بعد إنشائها، يمكن إجراء عملية استبدال لمقطع معين من الأغنية.⚠️ ملاحظة: القيمة الافتراضية لـتوضيح المعلمات كما يلي:replace_section_result_modeهيfull_song: سيقوم النظام بدمج مرشحين تم إنشاؤهما حديثًا بشكل منفصل، وإرجاع أغنيتين كاملتين. إذا كنت تحتاج فقط إلى مرشحي مقاطع الاستبدال غير المدمجين بعد، فعيّنها صراحةً إلىcandidates، ثم اختر المرشح لاستدعاء دمج الموسيقى.
- action: المحتوى هو
replace_section. - audio_id: معرّف الأغنية الأصلية (الأغنية المصدر التي سيتم استبدالها).
- model: نموذج إنشاء الأغنية.
- lyric: كلمات الأغنية الكاملة بعد الاستبدال (بما في ذلك المقطع المستبدل وسياقه، مع الحفاظ على الاتساق مع المحتوى في
prompt). - prompt: كلمات الأغنية الجديدة للمقطع الذي يجب استبداله.
- style: نمط الأغنية، اختياري.
- replace_section_start: وقت بداية المقطع المستبدل في الأغنية الأصلية (بالثواني).
- replace_section_end: وقت نهاية المقطع المستبدل في الأغنية الأصلية (بالثواني).
- replace_section_result_mode: وضع الإرجاع، والقيمة الافتراضية هي
full_song. يقومfull_songبدمج المرشحين الاثنين بشكل منفصل وإرجاع أغنيتين كاملتين؛ بينما يُرجعcandidatesمقطعين مرشحين لم يتم دمجهما بعد.
الخطوة الأولى: بدء مهمة استبدال المقطع
على سبيل المثال، إذا كان معرّف الأغنية التي تم إنشاؤها سابقًا هو: 18db7ed0-2b8a-41db-91c1-b0781dcca0d4 (مدتها 94.12 ثانية)، وتريد استبدال اللازمة الموسيقية من الثانية 30 إلى الثانية 60 بكلمات جديدة، فيمكن تعيين المعلمات كما يلي:replace_section_result_mode إلى candidates، فسيتم إرجاع مقطعي استبدال غير موصولين، ويكون الهيكل متسقًا مع المثال أدناه:
candidates، تكون مدة المقطعين الصوتيين المُعادين (45.16 ثانية و33.8 ثانية) أقصر بكثير من الأغنية الأصلية (94.12 ثانية)، وهما مقطعا استبدال يحتويان على قدر قليل من السياق، وليسا الأغنية كاملة. يمكنك اختيار المرشح المُرضي ومتابعة وصله يدويًا. أما وضع full_song الافتراضي، فسيُكمل عمليتي الوصل ويُرجع مباشرة أغنيتين كاملتين.
إرجاع الأغاني الكاملة مباشرة
إذا كنت ترغب في الحصول على الأغاني الكاملة مباشرة، يمكنك في الخطوة الأولى تعيينreplace_section_result_mode إلى full_song. ستقوم الواجهة بوصْل المرشحين على التوالي وإرجاع أغنيتين كاملتين؛ وفي هذه الحالة لا حاجة لاستدعاء concat مرة أخرى.
الخطوة الثانية: وصل مقطع الاستبدال بالأغنية الأصلية
بالنسبة للمقطع المختار أعلاه (مثلًا364f9d8b-ca25-463b-9a5e-d0b7139e2d6a)، ابدأ مهمة concat وفقًا للطريقة الواردة في قسم وصل الموسيقى:
duration إلى طول الأغنية الكامل (105.28 ثانية، وهو ما يعادل تقريبًا طول الأغنية الأصلية)، ويشير audio_url إلى الأغنية الكاملة بعد اكتمال الاستبدال. بهذا تكتمل عملية الإبداع الثانوي: “إنشاء → استبدال مقطع → دمج الأغنية كاملة”.
فصل الغناء والموسيقى
عندما تحتاج، بعد إنشاء الأغنية، إلى إجراء إبداع ثانوي من خلال التعامل بشكل منفصل مع الموسيقى المصاحبة والغناء، يمكنك فصل الموسيقى المصاحبة الخالصة والغناء المنفرد. يمكنك حينها تحديد المحتوى التالي:- action:القيمة هي
stems. - audio_id:معرّف الأغنية التي تم إنشاؤها سابقًا.
فصل الغناء والموسيقى لجميع المسارات
عندما تحتاج، بعد إنشاء الأغنية، إلى إجراء عملية فصل الغناء والموسيقى لجميع المسارات، يمكنك تحديد المحتوى التالي:- action:القيمة هي
all_stems. - audio_id:معرّف الأغنية التي تم إنشاؤها سابقًا.
إضافة مسار صوتي
يُنشئadd_stem مسار الآلة الموسيقية أو الصوت المستهدف للصوت المحدد، عبر استدعاء POST /suno/audios.
- مطلوب:
action،audio_id،stem_type. - اختياري:
model،prompt،title،style،negative_tags،weirdness،style_influence،audio_weight،max_mode،variety. - الفوترة: 0.672 Credits في الوضع العادي؛ و1.344 Credits عندما تكون
max_modeبقيمةtrue.
استخراج مسار صوتي
يستخرجextract_stem المسار الصوتي المستهدف من الصوت المحدد، ويُرجع في الوقت نفسه النسخة التكميلية بعد إزالة هذا المسار الصوتي، عبر استدعاء POST /suno/audios.
- مطلوب:
action،audio_id،stem_type. - اختياري:
audio_format، يدعم عقد القناة المزدوجة العام الحاليmp3فقط. - الفوترة: 1.12 Credits.
data في استجابة الحالة النهائية بقائمة صوتية مسطحة، ويمثل stem_sets علاقة المطابقة بين المسار الصوتي المستهدف والمسار الصوتي التكميلي:
إنشاء مؤثرات صوتية
يُنشئsounds مؤثرات صوتية لمرة واحدة أو قابلة للتكرار بناءً على وصف نصي، عبر استدعاء POST /suno/audios.
- مطلوب:
action،sound،sound_type. - اختياري:
model،bpm،key،audio_format؛ يدعمaudio_formatحاليًاmp3فقط. sound_type:one-shotأوloop.- الفوترة: 0.112 Credits.
ضبط سرعة الصوت
يضبطadjust_speed سرعة تشغيل الصوت المحدد، من خلال استدعاء POST /suno/audios.
- مطلوب:
action، وaudio_id، وspeed_multiplier، وtitle. - اختياري:
keep_pitch. speed_multiplier: النطاق من 0.25 إلى 4.- الفوترة: 0.28 Credits.
المعلمات المتقدمة للتوليد المخصص
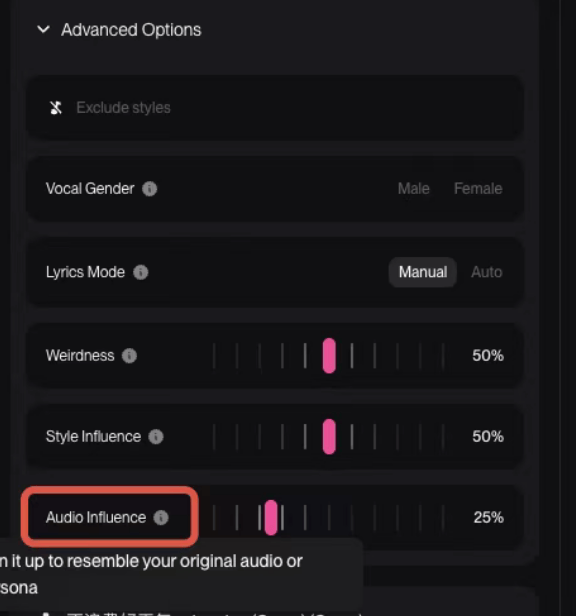
يسمح الرسمي باستخدام المعلمات المتقدمةweirdness==>Weirdness، وstyle_influence==>Style Influence، وaudio_weight==>Audio Influence للتوليد في الوضع المخصص، وذلك وفقًا للأمثلة الرسمية التالية:
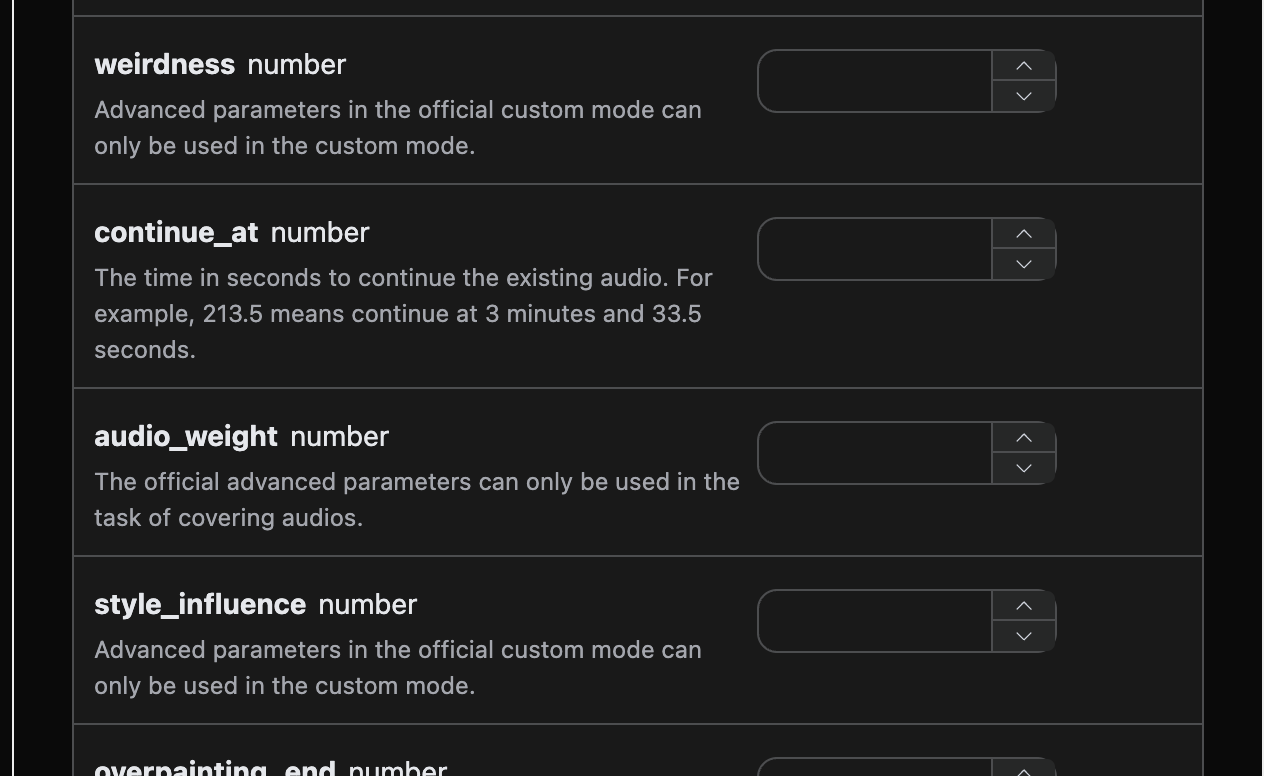
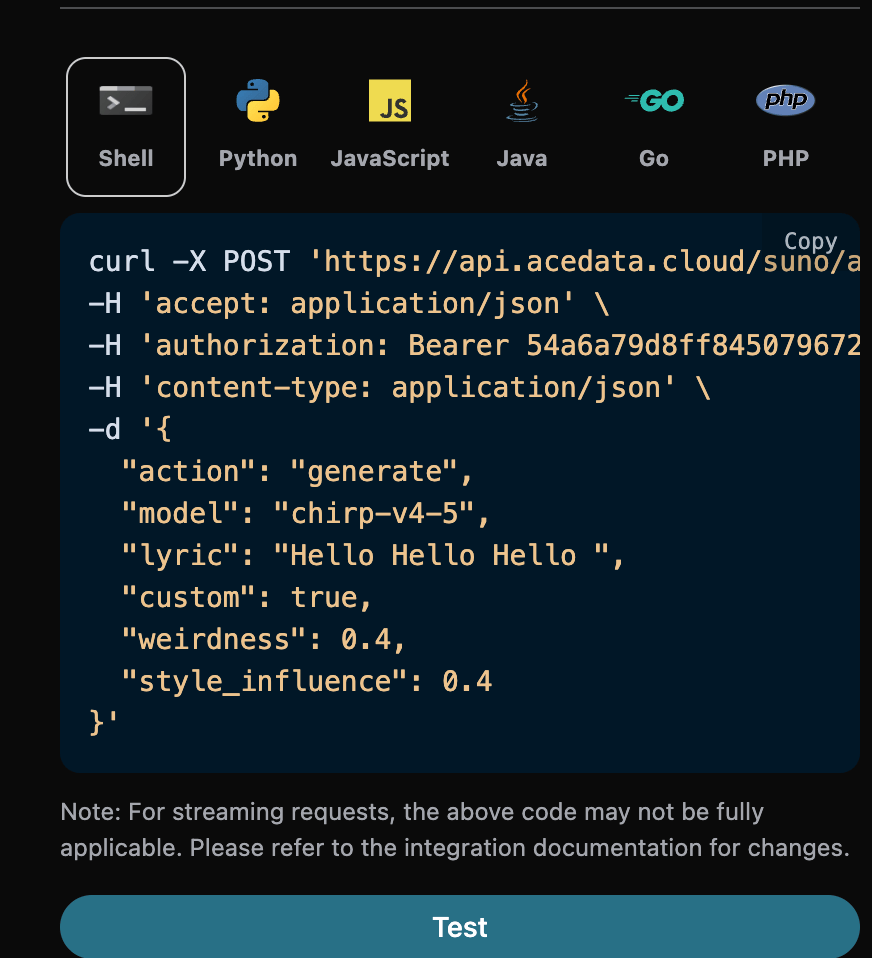
التحكم في مدة الأغنية
بشكل افتراضي، يحدد النموذج مدة الأغنية المولدة بنفسه، وعادةً ما تكون بين 30 ثانية و4 دقائق. إذا كانت هناك حاجة إلى منتج نهائي أطول أو أقصر، يمكن تحديد المدة المطلوبة عبر المعلمةduration، ووحدتها الثانية، وتكون قيمتها عددًا صحيحًا بين 10 و360.
تُستخدم هذه المعلمة لتوليد الأغاني في الوضع المخصص (custom هو true). تجدر الإشارة بشكل خاص إلى أن duration هو تلميح توجهي وليس قيدًا صارمًا: سيشير النموذج إلى هذه القيمة أثناء الإبداع، لكنه لا يضمن تحقيقها. في الاختبارات الفعلية، تكون المدة الفعلية عادةً أقصر بكثير من القيمة المطلوبة، وقد تختلف مدة الأغنيتين المعادتين من الطلب نفسه بعدة أضعاف. حتى مع الطلبات المتطابقة تمامًا، قد تختلف المدة التي يتم الحصول عليها من عمليات الإرسال المتعددة بشكل كبير. لذلك لا تستخدمه كتحكم دقيق في المدة، وإذا كانت هناك حاجة تجاريًا إلى مدة ثابتة، فقم بقص المنتج النهائي بنفسك أو أعد المحاولة بعد الحصول عليه.
كود Python المقابل:
duration في الطلب هي المدة المتوقعة، بينما حقل duration لكل أغنية في data ضمن الاستجابة هو المدة الفعلية لتلك الأغنية. الاسمان متماثلان لكن المعنى مختلف، ولا يُضمن أن تساوي المدة الفعلية القيمة المتوقعة. يُعد طول كلمات الأغنية أحد العوامل الرئيسية التي تؤثر في مدة المنتج النهائي؛ وإذا كنت بحاجة إلى منتج نهائي أطول، فمن المستحسن تقديم كلمات أكثر اكتمالًا في الوقت نفسه.
ستتحقق الواجهة من أن duration يجب أن تكون عددًا صحيحًا من 10 إلى 360؛ لكنها تظل مجرد هدف للتوليد، وليست ضمانًا لطول المنتج النهائي.
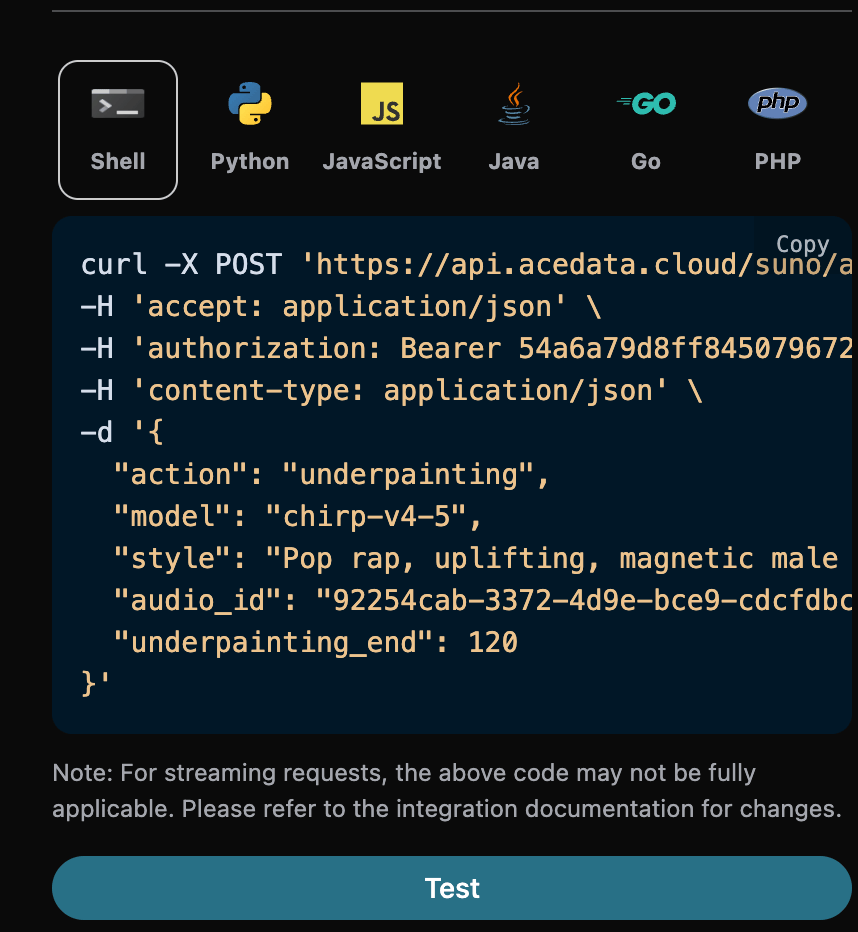
ميزة Add Insterumental
في أغسطس 2025، أطلقت suno حديثًا ميزة Add Insterumental. تحتاج أولًا إلى رفع أغنية غنائية مجردة دون مرافقة موسيقية، لكي تساعدك suno في إضافة الموسيقى إليها. يمكنك أولًا الذهاب إلى Suno Upload API لرفع أغنية غنائية مجردة دون مرافقة موسيقية، وتكون العملية المقابلة كما هو موضح في الصورة أدناه: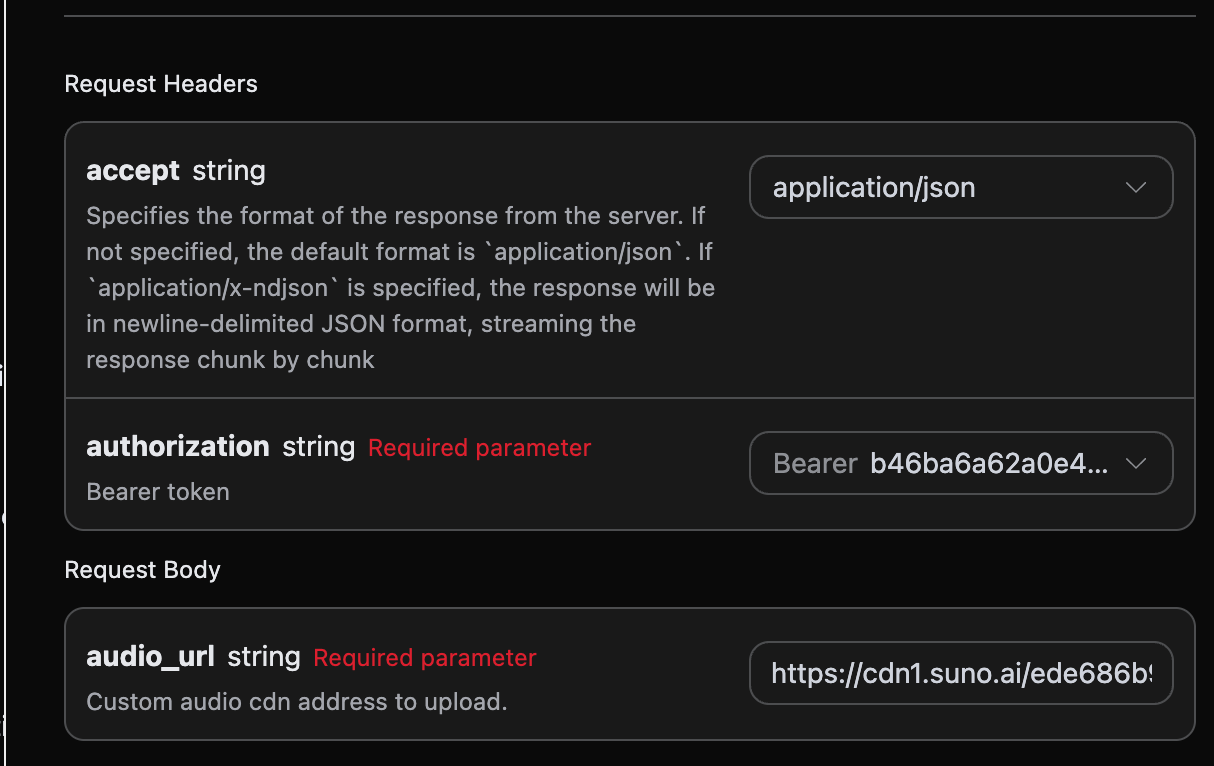
audio_id بعد الرفع، والنتيجة المحددة كما هو موضح في الصورة أدناه:
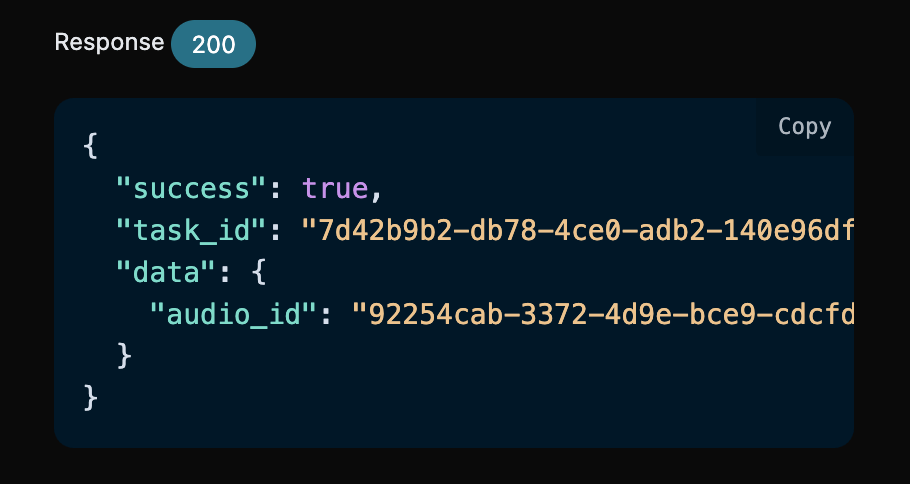
audio_id وهو: 92254cab-3372-4d9e-bce9-cdcfdbc39070، ثم نحتاج أيضًا إلى تعبئة المعلمات التالية:
- action: المحتوى هو
underpainting. - underpainting_start: وقت البدء لإضافة المرافقة الموسيقية إلى الأغنية المرفوعة، والقيمة الافتراضية هي 0.
- underpainting_end: وقت الانتهاء لإضافة المرافقة الموسيقية إلى الأغنية المرفوعة، ويجب أن يكون أقل من المدة الإجمالية للأغنية.
- audio_id: معرّف الأغنية الغنائية المجردة دون مرافقة موسيقية التي تم رفعها.
- style: نمط المرافقة الموسيقية، ومن الأفضل عدم استخدام كلمات لأنها مرافقة موسيقية في النهاية.
ميزة Add Vocals
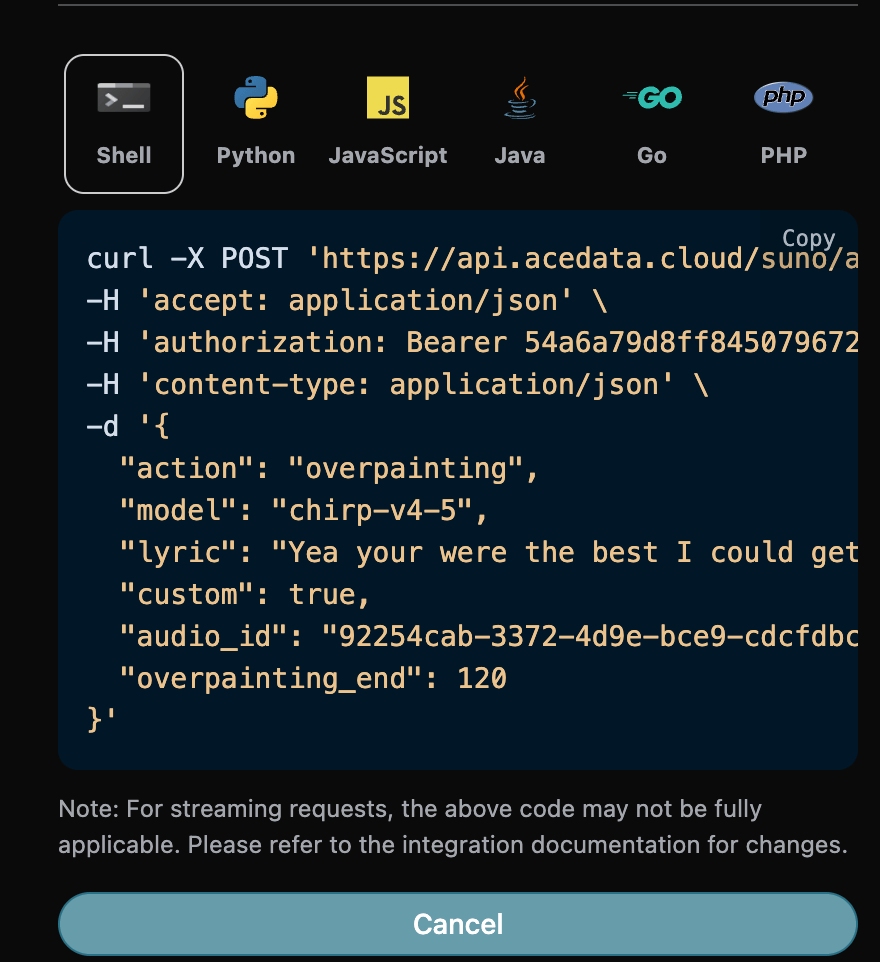
في أغسطس 2025، أطلقت suno حديثًا ميزة Add Vocals. تحتاج أولًا إلى رفع مقطوعة موسيقية خالصة، لكي تقوم suno بكتابة الكلمات وإنتاج غناء بشري. يمكنك أولًا الذهاب إلى Suno Upload API لرفع أغنية غنائية مجردة دون مرافقة موسيقية، وتكون العملية المقابلة كما هو موضح في الصورة أدناه:
audio_id بعد الرفع، والنتيجة المحددة كما هو موضح في الصورة أدناه:
audio_id وهو: 92254cab-3372-4d9e-bce9-cdcfdbc39070، ثم نحتاج أيضًا إلى تعبئة المعلمات التالية:
- action: المحتوى هو
overpainting. - overpainting_start: وقت البدء لإضافة الصوت البشري إلى الأغنية المرفوعة، والقيمة الافتراضية هي 0.
- overpainting_end: وقت الانتهاء لإضافة الصوت البشري إلى الأغنية المرفوعة، ويجب أن يكون أقل من المدة الإجمالية للأغنية.
- audio_id: معرّف الأغنية الغنائية المجردة دون مرافقة موسيقية التي تم رفعها.
- custom: يجب استخدام الوضع المخصص في هذا الوضع لإدخال كلمات الأغنية.
- lyric: كلمات الأغنية المُدخلة في الوضع المخصص.
- style: نمط المرافقة الموسيقية.
وظيفة Remaster
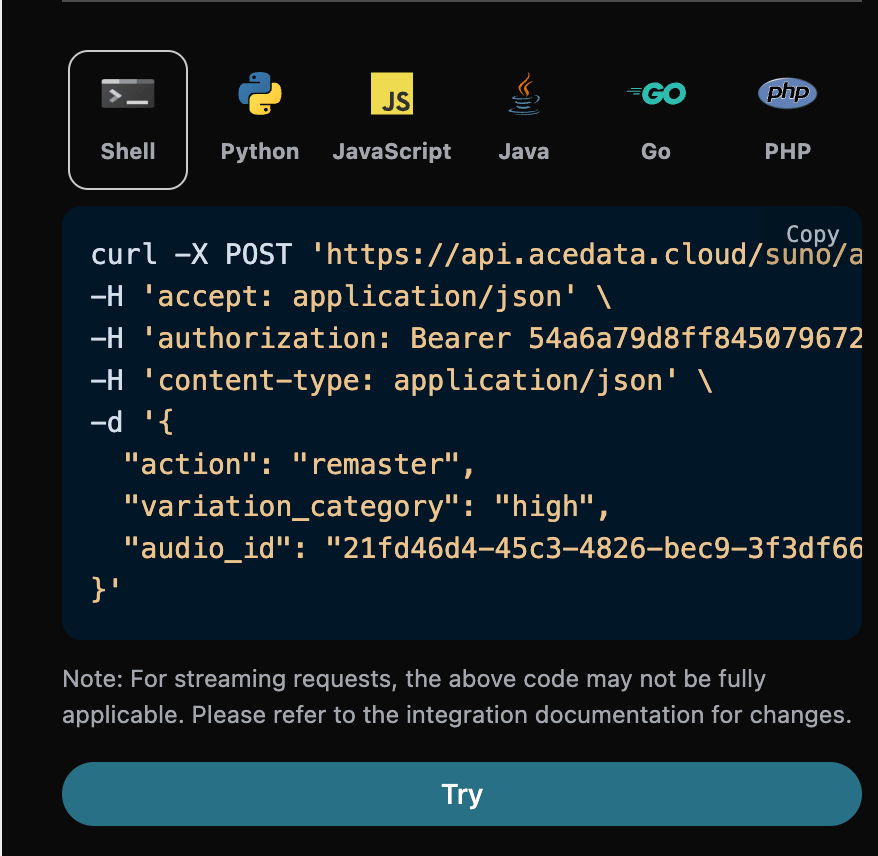
في ديسمبر 2025، أطلق suno وظيفة Remaster جديدة، ويمكن لهذه الوظيفة إعادة إنشاء الأغاني، ولا يمكن استخدامها عبر حسابات مختلفة، ثم نحتاج أيضًا إلى ملء المعلمات التالية:- action: المحتوى هو
remaster. - audio_id: معرّف الأغنية التي تحتاج إلى إعادة إنشائها.
- model: يدعم فقط v4.5+ وv5.
- variation_category: مدعوم فقط في إصدارات v5 وما فوق، وله 3 قيم فقط: high وnormal وsubtle.
وظيفة إنشاء المزج Mashup
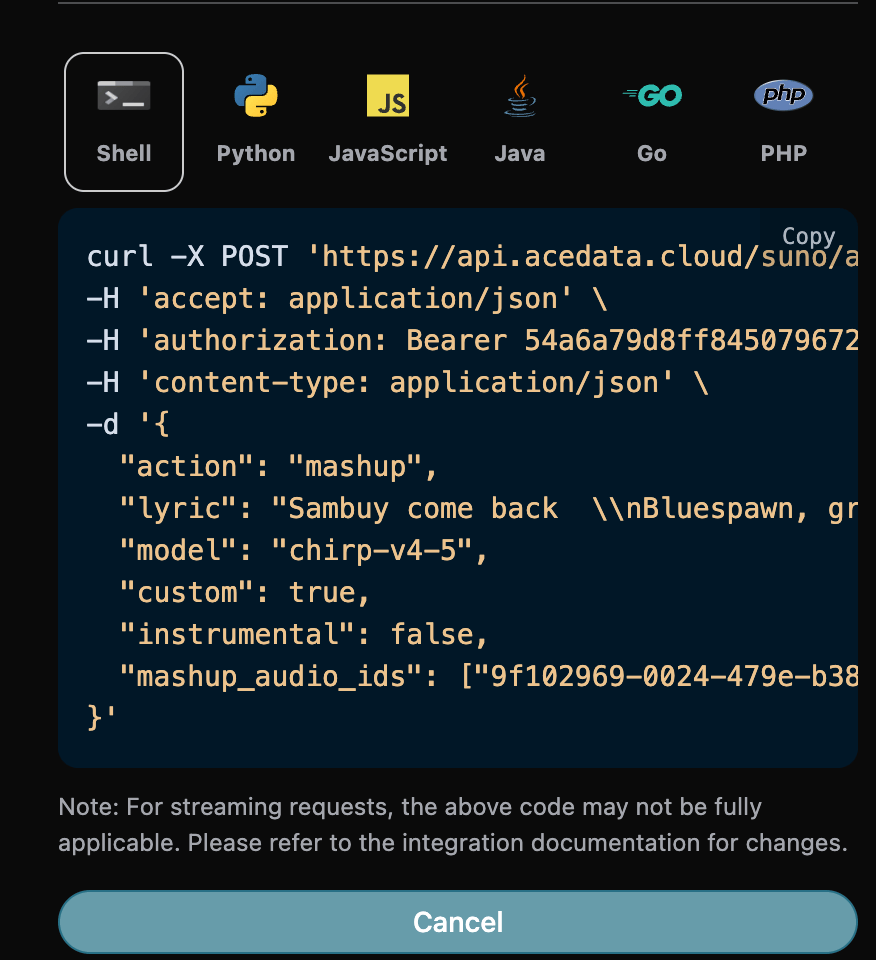
في ديسمبر 2025، أطلق suno وظيفة Mashup جديدة، ويمكن لهذه الوظيفة إنشاء أغنية بناءً على أغنيتين مرجعيتين، ثم نحتاج أيضًا إلى ملء المعلمات التالية:- action: المحتوى هو
mashup. - mashup_audio_ids: معرّفا الأغنيتين المرجعيتين. 填写完毕后,自动生成的代码如下:
Samples إنشاء أغنية بالعينات
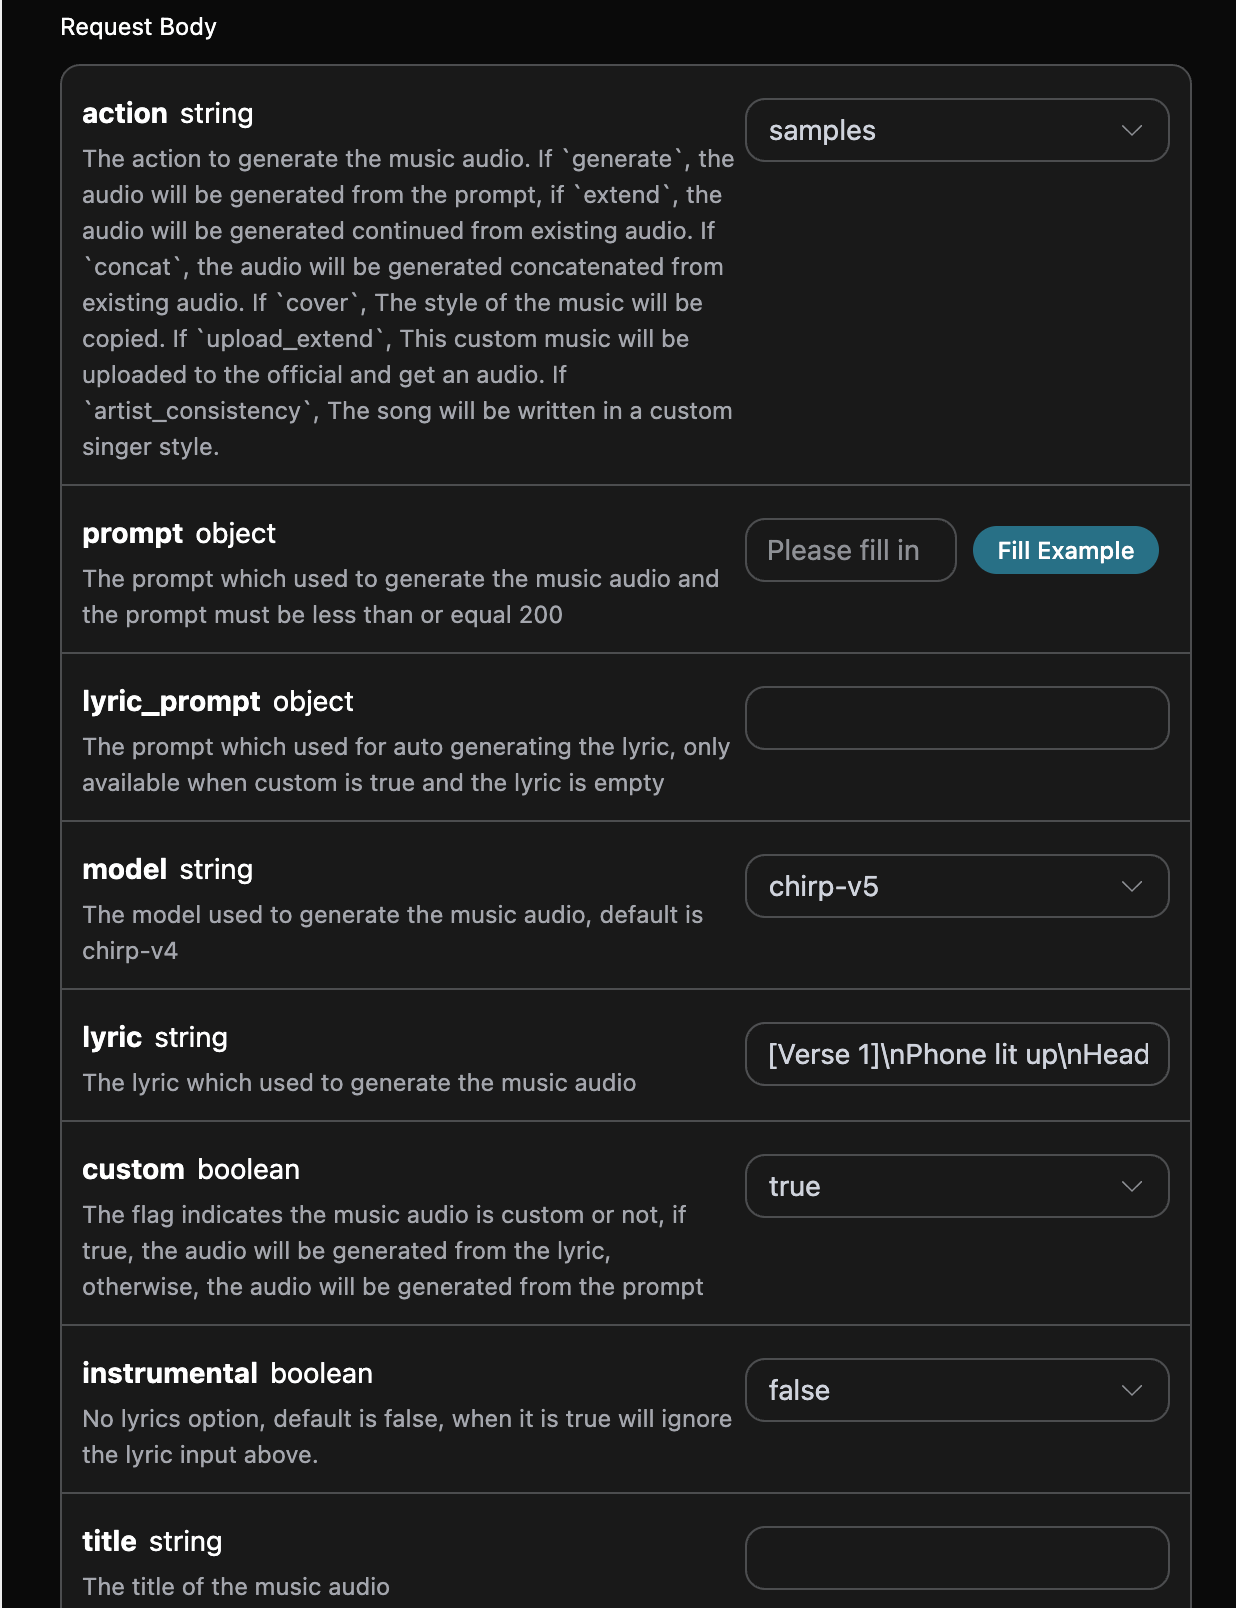
يشيرsamples هنا إلى أخذ عينة من مقطع صوتي واحد: اختيار وقت البداية والنهاية من ملف صوتي موجود، واستخدام هذا المقطع كمادة عيّنة للإبداع. وهو يختلف عن وظيفة الإبداع بالإلهام Inspo التي تستخدم من 1 إلى 4 مقاطع صوتية مرجعية كاملة كما هو موضح أدناه. يجب تعبئة المعلمات التالية:
- action: تكون القيمة
samples. - samples_start: وقت بدء أخذ العينة.
- samples_end: وقت انتهاء أخذ العينة.
- audio_id: معرّف الأغنية المرجعية المطلوب أخذ عينة منها.
ميزة الإبداع بالإلهام Inspo
يمكن لميزة الإبداع بالإلهام Inspo إنشاء موسيقى جديدة استنادًا إلى 1 إلى 4 مقاطع صوتية مرجعية كاملة، وتدعم سحب الصوت أو رفعه كمصدر للإلهام. تستخدم API إجراءinspo الحالي: يوفّر العميل عنوان URL صوتي متاحًا للعامة، وتُكمل الخدمة تلقائيًا إعداد الصوت المرجعي والإبداع، دون حاجة إلى أن يقرأ العميل كلمات الأغنية أو النمط أو المدة بشكل منفصل ثم يجمع الطلب. وهي تختلف عن أخذ العيّنات ضمن نطاق المذكور أعلاه، كما تختلف عن Cover الذي يحاكي نمط الأغنية الأصلية. عند الاستخدام، يجب ملء المعلمات التالية:
- action: المحتوى هو
inspo. - audio_urls: قائمة بعناوين URL للصوت المرجعي، ويجب توفير 1 إلى 4 عناوين صوتية متاحة للعامة.
- model: النموذج المستخدم، ويوصى بـ
chirp-v6. - prompt: كلمات الأغنية أو نص تلميح إبداعي (اختياري).
ملاحظة: يجب أن تكون الملفات الصوتية المرجعية متاحة للعامة. إذا تطابق الصوت المرجعي تمامًا مع تسجيل معروف في مكتبة أغاني المنصة، فقد يرفض Suno الإنشاء بسبب التحقق من حقوق النشر، ويوصى باستخدام صوت مملوك لك أو تم إنشاؤه بواسطة Suno كمصدر للإلهام.كود Python المقابل:
chirp-v5 في ذلك الوقت، بينما يوصى في مثال الطلب الحالي بـ chirp-v6، وبنية الإرجاع متطابقة:
الاستدعاء غير المتزامن
نظرًا لأن الوقت الذي يستغرقه Suno لإنشاء الموسيقى طويل نسبيًا، إذ يحتاج تقريبًا إلى 1-2 دقيقة، فإذا لم تستجب واجهة API لفترة طويلة، سيظل طلب HTTP محتفظًا بالاتصال، مما يؤدي إلى استهلاك إضافي لموارد النظام، لذلك توفر واجهة API هذه أيضًا دعمًا للاستدعاء غير المتزامن. تتمثل العملية الكاملة في: عند قيام العميل بإرسال طلب، يحدد بالإضافة إلى ذلك حقلcallback_url، وبعد أن يرسل العميل طلب API، ستعيد واجهة API نتيجة فورًا تتضمن معلومات حقل task_id، والذي يمثل معرّف المهمة الحالية. عند اكتمال المهمة، سيتم إرسال نتيجة إنشاء الموسيقى بصيغة POST JSON إلى callback_url الذي حدده العميل، وتتضمن أيضًا حقل task_id، وبهذه الطريقة يمكن ربط نتائج المهمة عبر المعرّف.
فيما يلي سنتعرف من خلال مثال على كيفية التنفيذ تحديدًا.
أولًا، استدعاء Webhook هو خدمة يمكنها استقبال طلبات HTTP، وينبغي للمطور استبداله بعنوان URL لخادم HTTP الذي أنشأه بنفسه. هنا ولأغراض العرض المريح، نستخدم موقع مثال Webhook عام https://webhook.site/، ويمكنك الحصول على عنوان URL لـ Webhook بمجرد فتح هذا الموقع، كما هو موضح في الصورة:
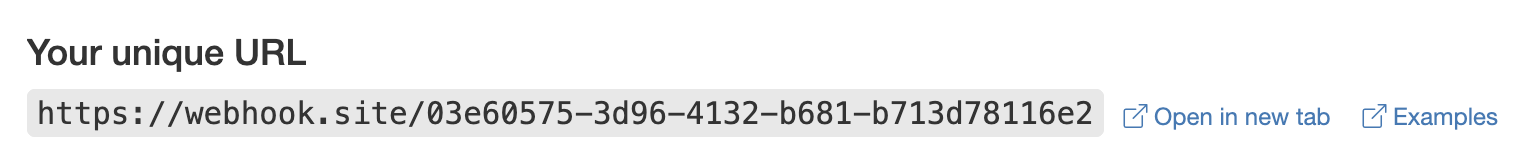 انسخ عنوان URL هذا، ويمكن استخدامه كـ Webhook، والمثال هنا هو https://webhook.site/03e60575-3d96-4132-b681-b713d78116e2.
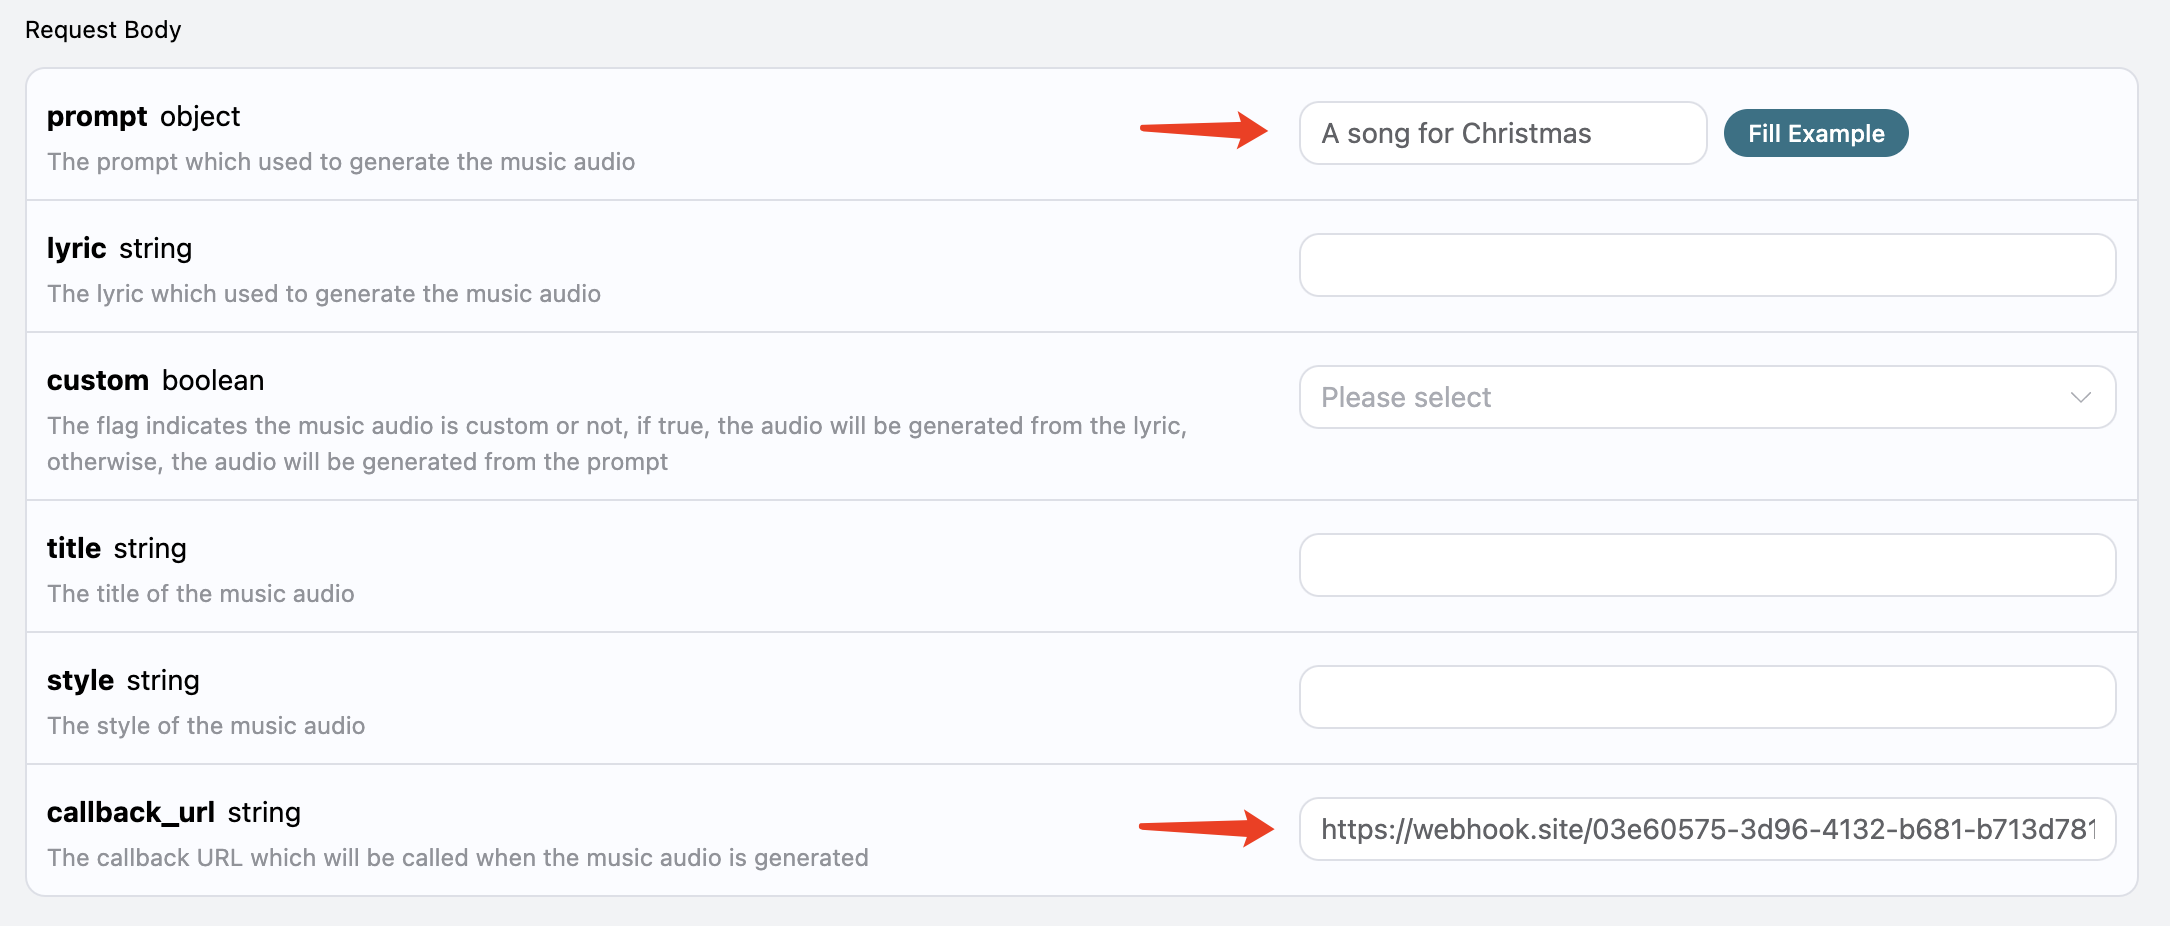
بعد ذلك، يمكننا تعيين الحقل
callback_url إلى عنوان URL الخاص بـ Webhook المذكور أعلاه، مع إدخال prompt في الوقت نفسه، كما هو موضح في الصورة:
 انقر على تشغيل، وستجد أنه يتم الحصول على نتيجة فورًا، كما يلي:
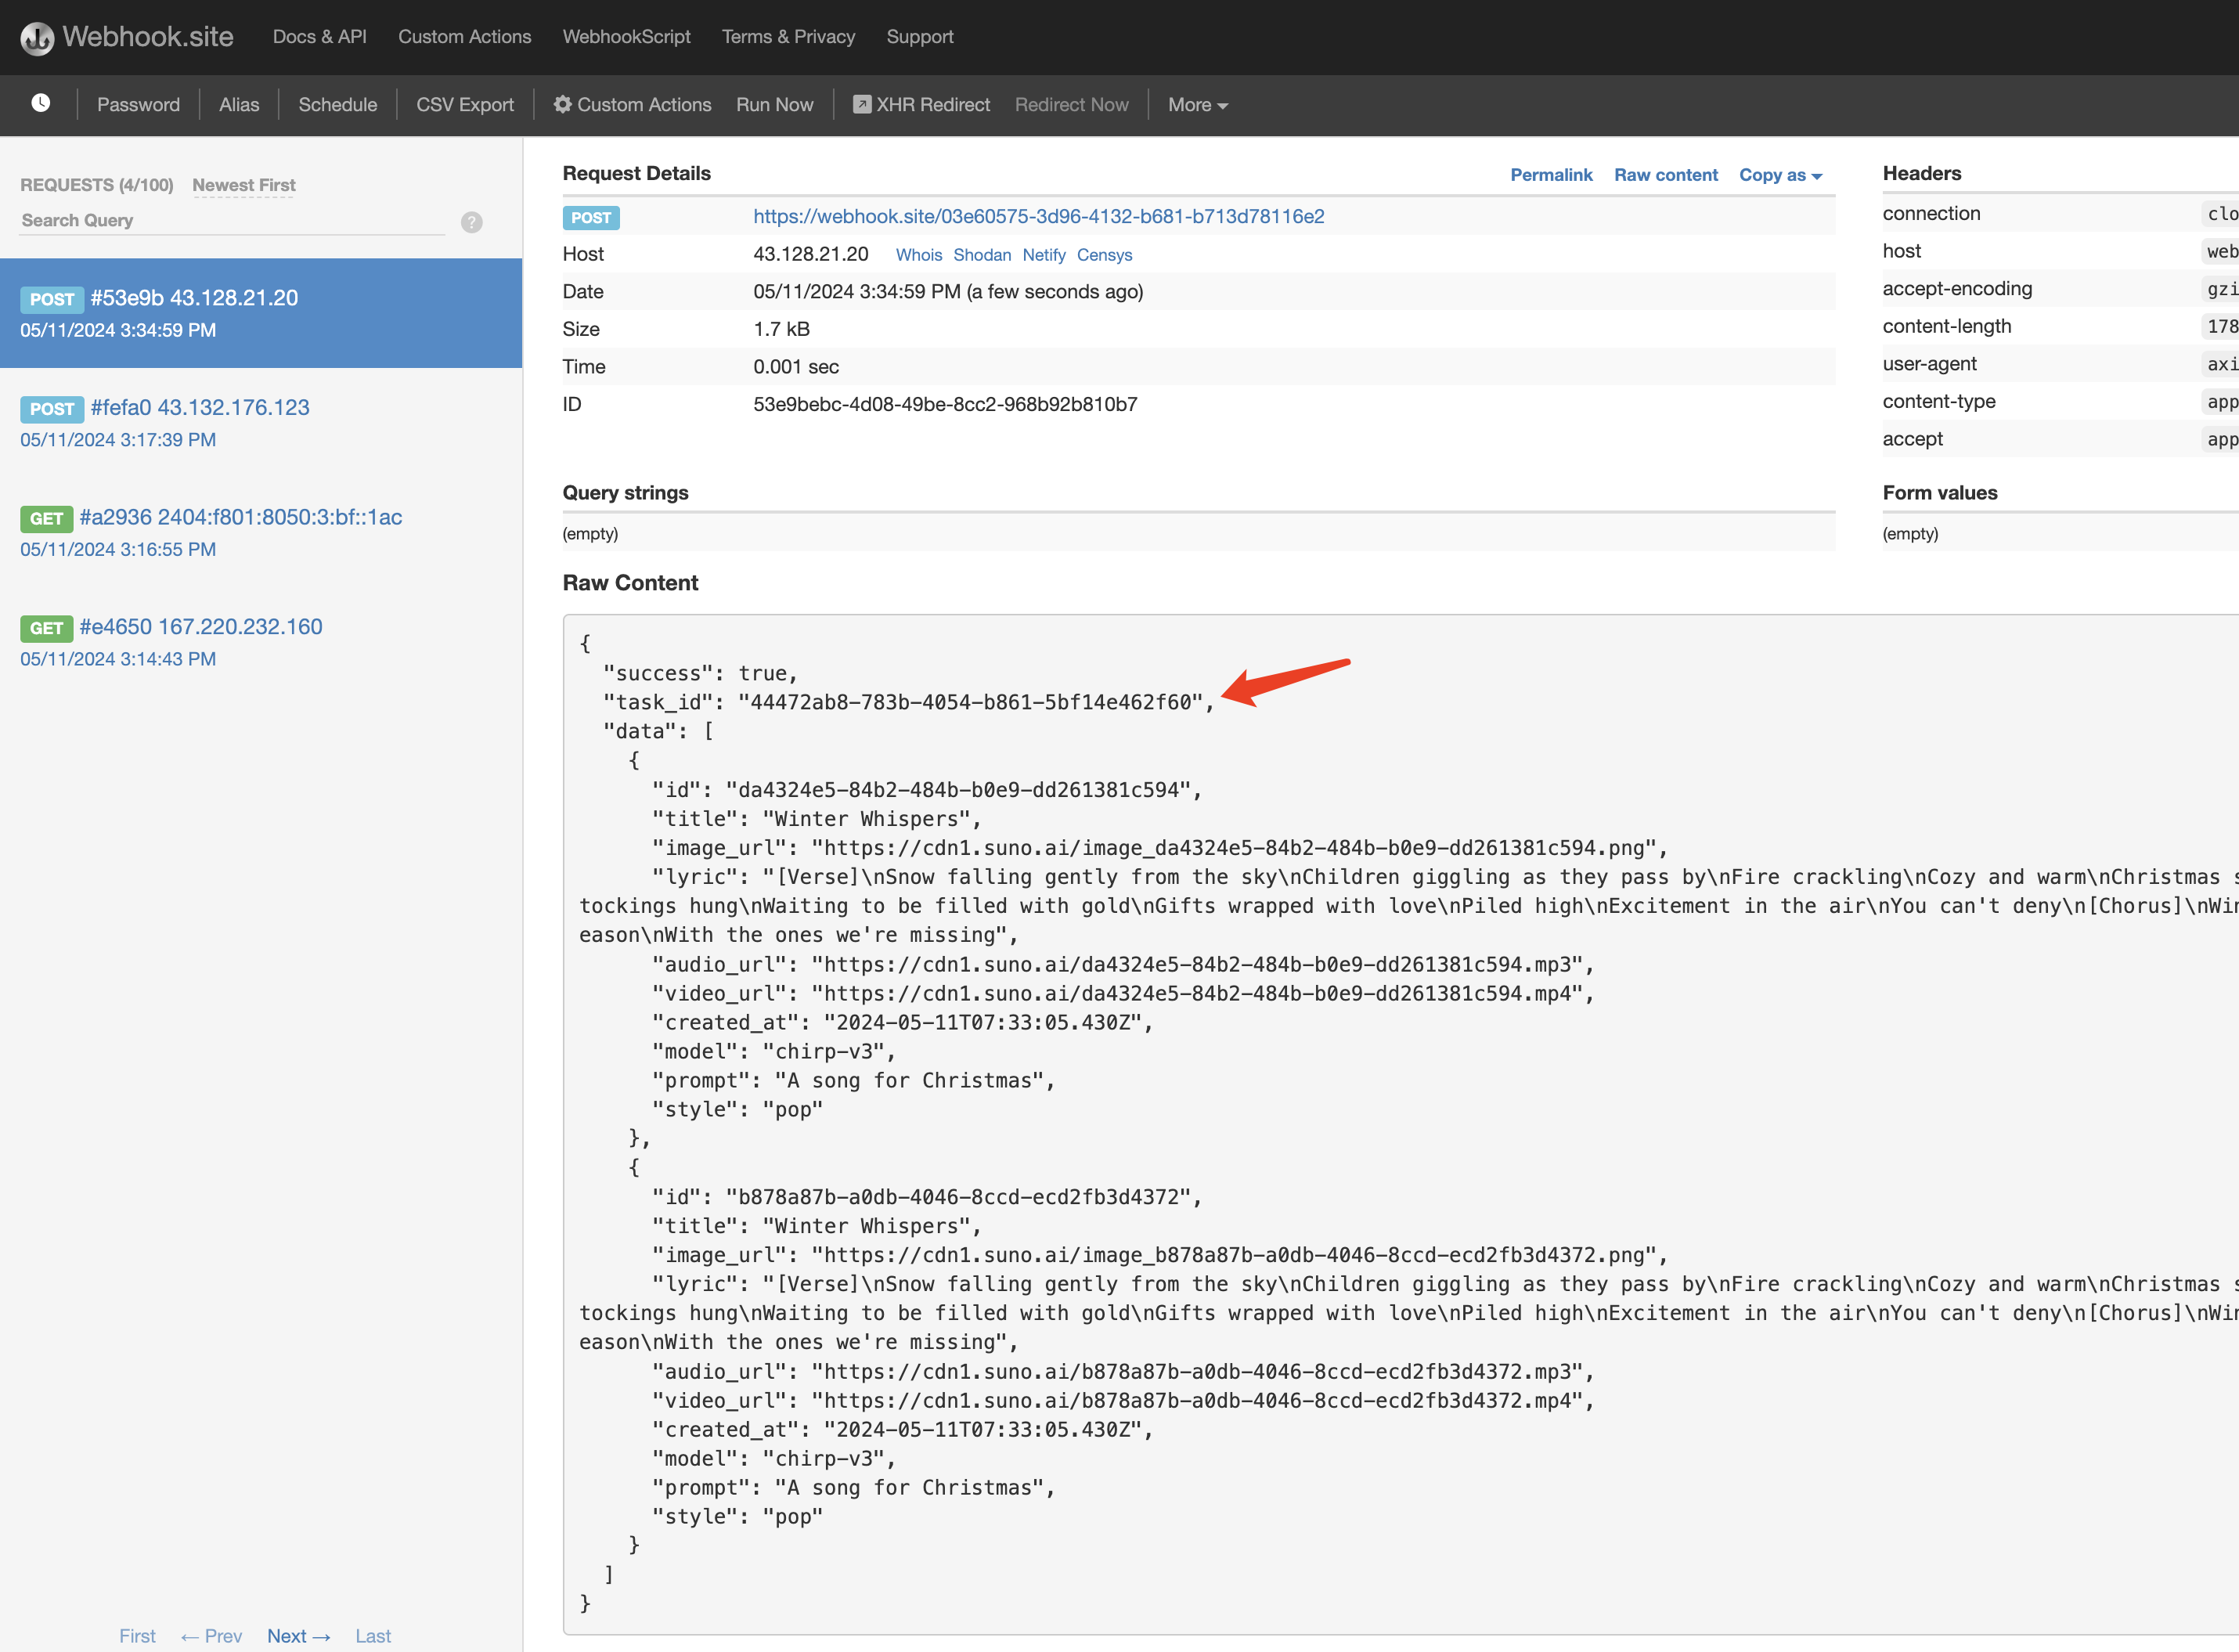 المحتوى كما يلي:
task_id في النتيجة، أما الحقول الأخرى فهي مشابهة لما ورد أعلاه، ويمكن تحقيق ربط المهام عبر هذا الحقل.
بالطبع، يمكننا أيضًا الحصول على النتيجة من خلال الاستدعاء المتدفق، وكل ما نحتاجه هو تعيين قيمة accept في رأس الطلب إلى application/x-ndjson، وفيما يلي نستخدم إدخالًا نموذجيًا كمثال:
task_id، حالة المعالجة والنتيجة النهائية؛ وقد احتُفظ أعلاه فقط بالاستجابتين الحقيقيتين الأولية والنهائية، مع حذف التحديثات المتوسطة المتكررة.
معالجة الأخطاء
إذا حدث خطأ، فستحصل على معلومات خطأ مشابهة لما يلي:error.code وerror.message:
ملاحظة: قد تختلف الحصص ورسائل الخطأ بين حسابات المنبع المختلفة. عادةً ما تكون قيودstyleفيchirp-v3-5/chirp-v4أقل (200)، بينما يدعمchirp-v4-5والإصدارات الأحدث عادةً حتى 1000؛ وعند استخدام منبع قديم، قد تظهر رسائل توافق مثلTags too long.أوstyle must be less than or equal 120. | رمز الحالة |error.code|error.message| | ----------- | ------------- | --------------------------------------------------------------- | | 400 |bad_request|معرّف الأغنية غير موجود أو تم إيقافها.| | 400 |bad_request|المطالبة طويلة جدًا.| | 400 |bad_request|الوسوم طويلة جدًا.| | 400 |bad_request|الصوت المرفوع يطابق عملاً فنياً موجوداً.| | 400 |bad_request|يجب أن تكون instrumental قيمة منطقية| | 400 |bad_request|العنوان طويل جدًا.| | 400 |bad_request|الموضوع طويل جدًا.| | 400 |bad_request|يجب أن يكون style أقل من أو يساوي 120| | 400 |bad_request|يجب أن تكون custom قيمة منطقية| | 400 |bad_request|audio_id مطلوب عند تمديد الصوت| | 400 |bad_request|continue_at مطلوب عند تمديد الصوت| | 400 |bad_request|يجب أن يكون continue_at رقماً أكبر من 0| | 400 |bad_request|lyric مطلوب عند تمديد الصوت وعندما تكون instrumental خاطئة| | 400 |bad_request|prompt مطلوب عند إنشاء الصوت| | 400 |bad_request|lyric مطلوب عند إنشاء صوت مخصص| | 403 |forbidden|يبدو أن المطالبة مشوهة| | 403 |forbidden|يبدو أن المطالبة محمية بحقوق الطبع والنشر| | 403 |forbidden|احتوت المطالبة على مادة غير لائقة| | 403 |forbidden|تم وضع علامة على وصف الأغنية للمراجعة| | 403 |forbidden|احتوى وصف الأغنية على اسم فنان| | 403 |forbidden|احتوت الوسوم على اسم فنان| | 403 |forbidden|احتوت كلمات الأغنية على مادة محمية بحقوق الطبع والنشر| | 403 |forbidden|احتوى وصف الأغنية على وسم منتج| | 403 |forbidden|خطأ عام من openAI| | 403 |forbidden|تم وضع علامة على المطالبة للمراجعة| | 500 |api_error|تعذر إنشاء كلمات الأغنية من وصف الأغنية| | 500 |api_error|فشلت المهمة بسبب خطأ غير معروف| | 500 |api_error|لا يوجد عامل متاح في النظام| | 500 |api_error|الخدمة قيد الصيانة، تم إيقاف الإنشاء مؤقتًا| | 504 |timeout|انتهت المهلة أثناء انتظار إنشاء الصوت|