data: {"type": "response.created", "sequence_number": 0, "response":
{"id": "resp_68a9837bb9bc8190b403947311db6faa0721186e8fbb89d0", "object": "response", "created_at": 1755939707, "status": "in_progress", "background": false, "content_filters": null, "error": null, "incomplete_details": null, "instructions": null, "max_output_tokens": null, "max_tool_calls": null, "model": "gpt-4.1-data", "output": [], "parallel_tool_calls": true, "previous_response_id": null, "prompt_cache_key": null, "reasoning": {"effort": null, "summary": null}, "safety_identifier": null, "service_tier": "auto", "store": true, "temperature": 1.0, "text": {"format": {"type": "text"}}, "tool_choice": "auto", "tools": [], "top_p": 1.0, "truncation": "disabled", "usage": null, "user": null, "metadata": {}}, "model": "gpt-4.1"}

data: {"type": "response.in_progress", "sequence_number": 1, "response": {"id": "resp_68a9837bb9bc8190b403947311db6faa0721186e8fbb89d0", "object": "response", "created_at": 1755939707, "status": "in_progress", "background": false, "content_filters": null, "error": null, "incomplete_details": null, "instructions": null, "max_output_tokens": null, "max_tool_calls": null, "model": "gpt-4.1-data", "output": [], "parallel_tool_calls": true, "previous_response_id": null, "prompt_cache_key": null, "reasoning": {"effort": null, "summary": null}, "safety_identifier": null, "service_tier": "auto", "store": true, "temperature": 1.0, "text": {"format": {"type": "text"}}, "tool_choice": "auto", "tools": [], "top_p": 1.0, "truncation": "disabled", "usage": null, "user": null, "metadata": {}}, "model": "gpt-4.1"}

data: {"type": "response.output_item.added", "sequence_number": 2, "output_index": 0, "item": {"id": "msg_68a9837c49f081908f568bf9c6065c620721186e8fbb89d0", "type": "message", "status": "in_progress", "content": [], "role": "assistant"}, "model": "gpt-4.1"}

data: {"type": "response.content_part.added", "sequence_number": 3, "item_id": "msg_68a9837c49f081908f568bf9c6065c620721186e8fbb89d0", "output_index": 0, "content_index": 0, "part": {"type": "output_text", "annotations": [], "text": ""}, "model": "gpt-4.1"}

data: {"type": "response.output_text.delta", "sequence_number": 4, "item_id": "msg_68a9837c49f081908f568bf9c6065c620721186e8fbb89d0", "output_index": 0, "content_index": 0, "delta": "مرحبًا", "model": "gpt-4.1"}

data: {"type": "response.output_text.delta", "sequence_number": 5, "item_id": "msg_68a9837c49f081908f568bf9c6065c620721186e8fbb89d0", "output_index": 0, "content_index": 0, "delta": "!", "model": "gpt-4.1"}

data: {"type": "response.output_text.delta", "sequence_number": 6, "item_id": "msg_68a9837c49f081908f568bf9c6065c620721186e8fbb89d0", "output_index": 0, "content_index": 0, "delta": " كيف", "model": "gpt-4.1"}

data: {"type": "response.output_text.delta", "sequence_number": 7, "item_id": "msg_68a9837c49f081908f568bf9c6065c620721186e8fbb89d0", "output_index": 0, "content_index": 0, "delta": " يمكنني", "model": "gpt-4.1"}

data: {"type": "response.output_text.delta", "sequence_number": 8, "item_id": "msg_68a9837c49f081908f568bf9c6065c620721186e8fbb89d0", "output_index": 0, "content_index": 0, "delta": " أن", "model": "gpt-4.1"}

data: {"type": "response.output_text.delta", "sequence_number": 9, "item_id": "msg_68a9837c49f081908f568bf9c6065c620721186e8fbb89d0", "output_index": 0, "content_index": 0, "delta": " أساعدك", "model": "gpt-4.1"}

data: {"type": "response.output_text.delta", "sequence_number": 10, "item_id": "msg_68a9837c49f081908f568bf9c6065c620721186e8fbb89d0", "output_index": 0, "content_index": 0, "delta": " اليوم", "model": "gpt-4.1"}

data: {"type": "response.output_text.delta", "sequence_number": 11, "item_id": "msg_68a9837c49f081908f568bf9c6065c620721186e8fbb89d0", "output_index": 0, "content_index": 0, "delta": "؟", "model": "gpt-4.1"}

data: {"type": "response.output_text.delta", "sequence_number": 12, "item_id": "msg_68a9837c49f081908f568bf9c6065c620721186e8fbb89d0", "output_index": 0, "content_index": 0, "delta": " 😊", "model": "gpt-4.1"}

data: {"type": "response.output_text.done", "sequence_number": 14, "item_id": "msg_68a9837c49f081908f568bf9c6065c620721186e8fbb89d0", "output_index": 0, "content_index": 0, "text": "مرحبًا! كيف يمكنني أن أساعدك اليوم؟ 😊", "model": "gpt-4.1"}

data: {"type": "response.content_part.done", "sequence_number": 15, "item_id": "msg_68a9837c49f081908f568bf9c6065c620721186e8fbb89d0", "output_index": 0, "content_index": 0, "part": {"type": "output_text", "annotations": [], "text": "مرحبًا! كيف يمكنني أن أساعدك اليوم؟ 😊"}, "model": "gpt-4.1"}

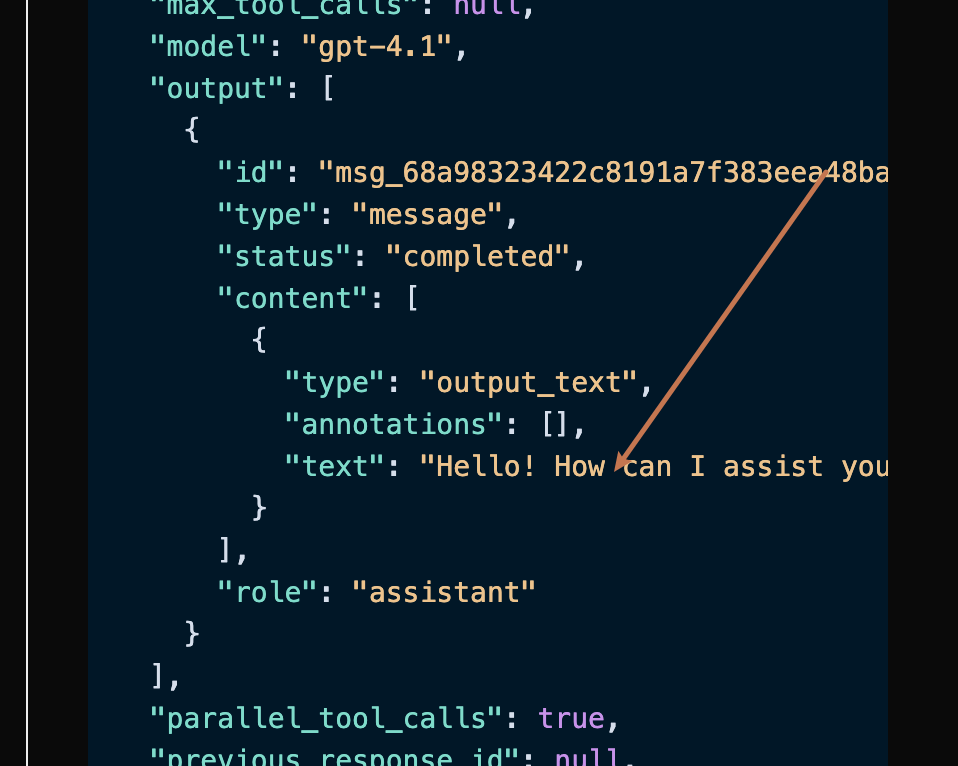
data: {"type": "response.output_item.done", "sequence_number": 16, "output_index": 0, "item": {"id": "msg_68a9837c49f081908f568bf9c6065c620721186e8fbb89d0", "type": "message", "status": "completed", "content": [{"type": "output_text", "annotations": [], "text": "مرحبًا! كيف يمكنني أن أساعدك اليوم؟ 😊"}], "role": "assistant"}, "model": "gpt-4.1"}

data: {"type": "response.completed", "sequence_number": 17, "response":
{"id": "resp_68a9837bb9bc8190b403947311db6faa0721186e8fbb89d0", "object": "response", "created_at": 1755939707, "status": "completed", "background": false, "content_filters": null, "error": null, "incomplete_details": null, "instructions": null, "max_output_tokens": null, "max_tool_calls": null, "model": "gpt-4.1-data", "output": [{"id": "msg_68a9837c49f081908f568bf9c6065c620721186e8fbb89d0", "type": "message", "status": "completed", "content": [{"type": "output_text", "annotations": [], "text": "مرحبًا! كيف يمكنني مساعدتك اليوم؟ 😊"}], "role": "assistant"}], "parallel_tool_calls": true, "previous_response_id": null, "prompt_cache_key": null, "reasoning": {"effort": null, "summary": null}, "safety_identifier": null, "service_tier": "default", "store": true, "temperature": 1.0, "text": {"format": {"type": "text"}}, "tool_choice": "auto", "tools": [], "top_p": 1.0, "truncation": "disabled", "usage": {"input_tokens": 8, "input_tokens_details": {"cached_tokens": 0}, "output_tokens": 11, "output_tokens_details": {"reasoning_tokens": 0}, "total_tokens": 19}, "user": null, "metadata": {}}, "model": "gpt-4.1"}


 إذا لم تكن قد سجلت الدخول أو أنشأت حسابًا بعد، فسيتم تحويلك تلقائيًا إلى صفحة تسجيل الدخول لدعوتك إلى التسجيل وتسجيل الدخول، وبعد الإكمال ستعود تلقائيًا إلى الصفحة الحالية.
يمكن لـ API Token واحد استدعاء جميع خدمات المنصة، ولا حاجة للتقديم بشكل منفصل لكل خدمة. سيُمنحك رصيد مجاني عند التقديم لأول مرة، ويمكنك التجربة مجانًا؛ وعندما لا يكون الرصيد كافيًا، يمكنك شحن الرصيد العام من وحدة التحكم.