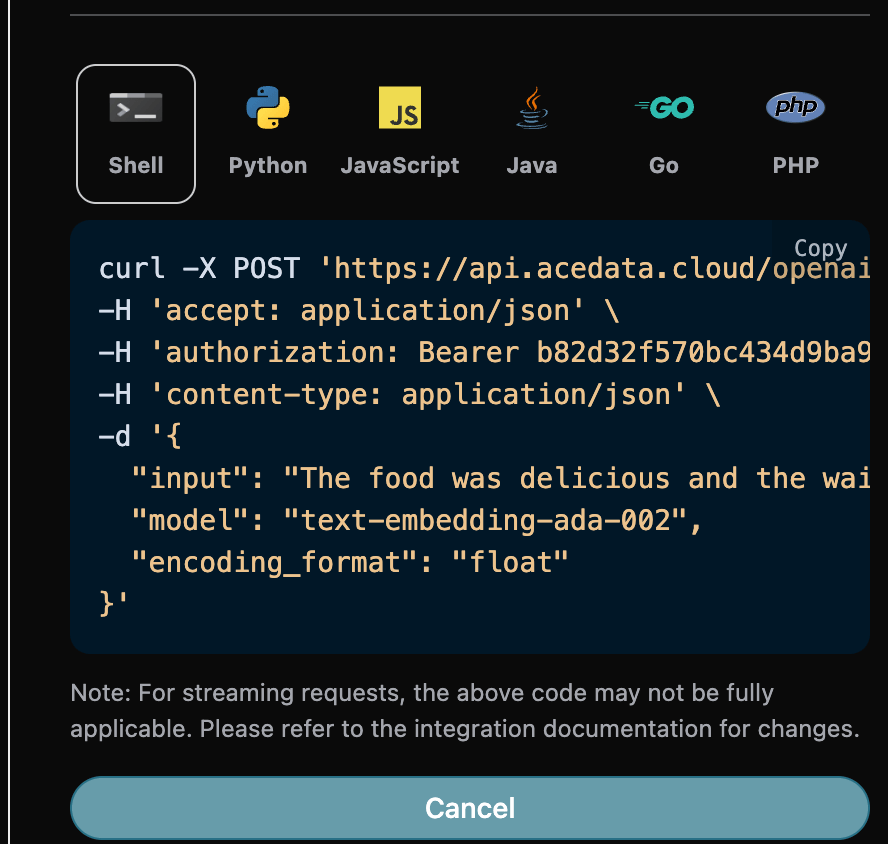
{
  "object": "list",
  "data": [
    {
      "object": "embedding",
      "index": 0,
      "embedding": [
        0.0022756963,
        -0.009305916,
        0.015742613,
        -0.0077253063,
        -0.0047450014,
        0.014917395,
        -0.009807394,
        -0.038264707,
        -0.0069127847,
        -0.028590616,
        0.025251659,
        ....
        -0.014079482,
        -0.015425222,
        0.0040753055,
        0.002727979,
        -0.03138366,
        0.041159317,
        -0.017608874,
        -0.018637223,
        0.014587308,
        0.010486611,
        -0.015387135,
        -0.019424353,
        -0.002800979
      ]
    }
  ],
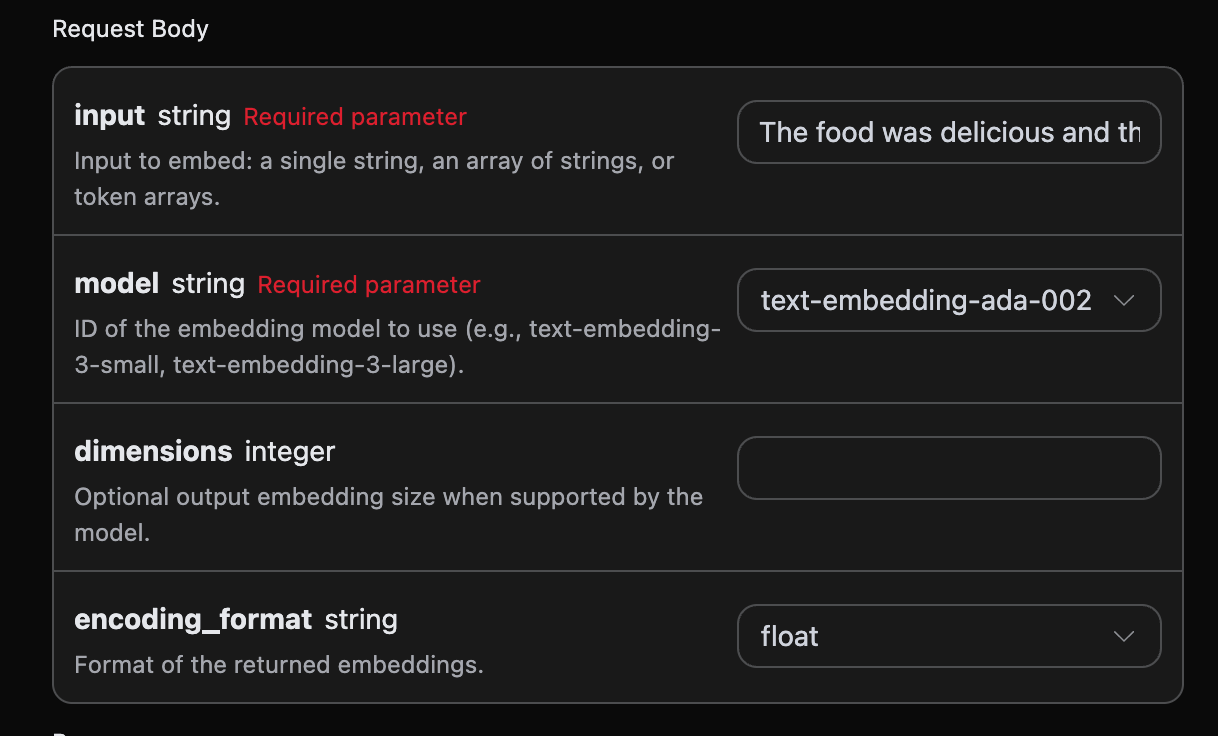
  "model": "text-embedding-3-small",
  "usage": {
    "prompt_tokens": 8,
    "total_tokens": 8
  }
}


 如果您尚未登入或註冊,會自動跳轉到登入頁面邀請您註冊和登入,完成後會自動返回目前頁面。
一個 API Token 即可呼叫平台所有服務,無需為每個服務個別申請。 首次申請會贈送免費額度,可免費體驗;額度不足時可在 控制台 儲值通用餘額。