

上表的Suno 現已支援lyric與style限制為自訂模式(custom為true)下的上限。非自訂的靈感模式(custom為false)只填寫prompt,其長度上限為 500 字元(各模型一致)。
chirp-v6、chirp-v6-wild 和 chirp-v6-mini。推薦使用 chirp-v6;舊模型名稱繼續相容。
然而 Suno 官方並沒有提供 API,AceDataCloud 提供了一套 Suno 的 API,模擬串接了 Suno 官方,可以方便快速地生成想要的音樂。
申請和使用
要使用 Suno Audios Generation API,首先到 Ace Data Cloud 控制台 取得您的 API Token,留作備用。 如果你尚未登入或註冊,會自動跳轉到登入頁面邀請你註冊和登入,完成後會自動返回目前頁面。
一個 API Token 即可呼叫平台所有服務,無需為每個服務單獨申請。 首次申請會贈送免費額度,可免費體驗;額度不足時可在 控制台 儲值通用餘額。
📘 完整文件:Suno Audios Generation API →
基本使用
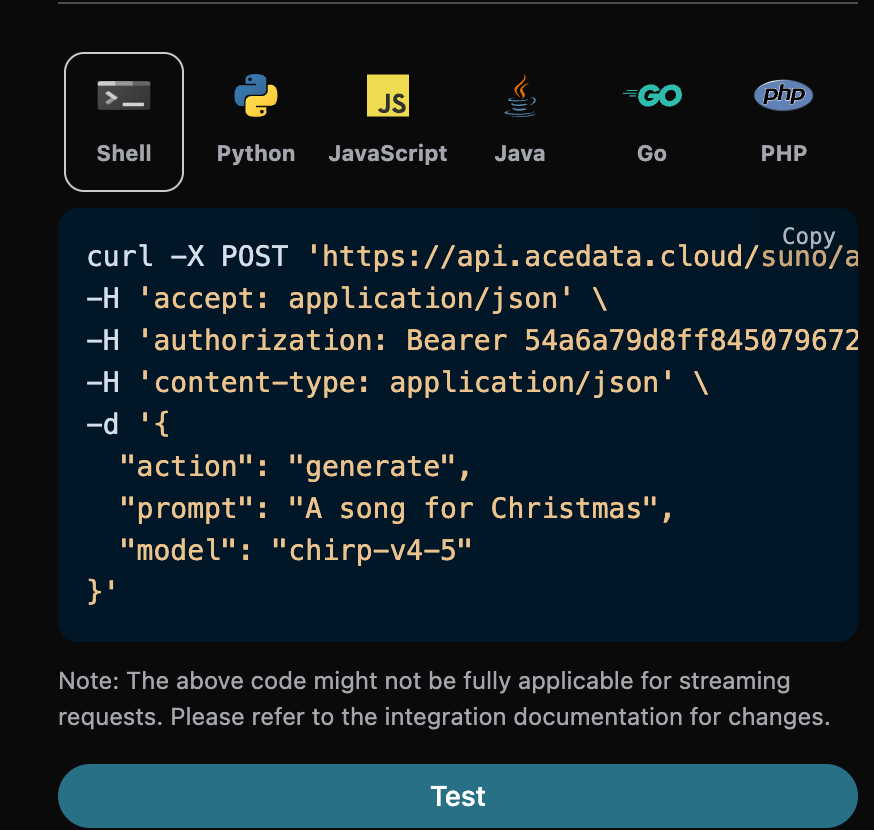
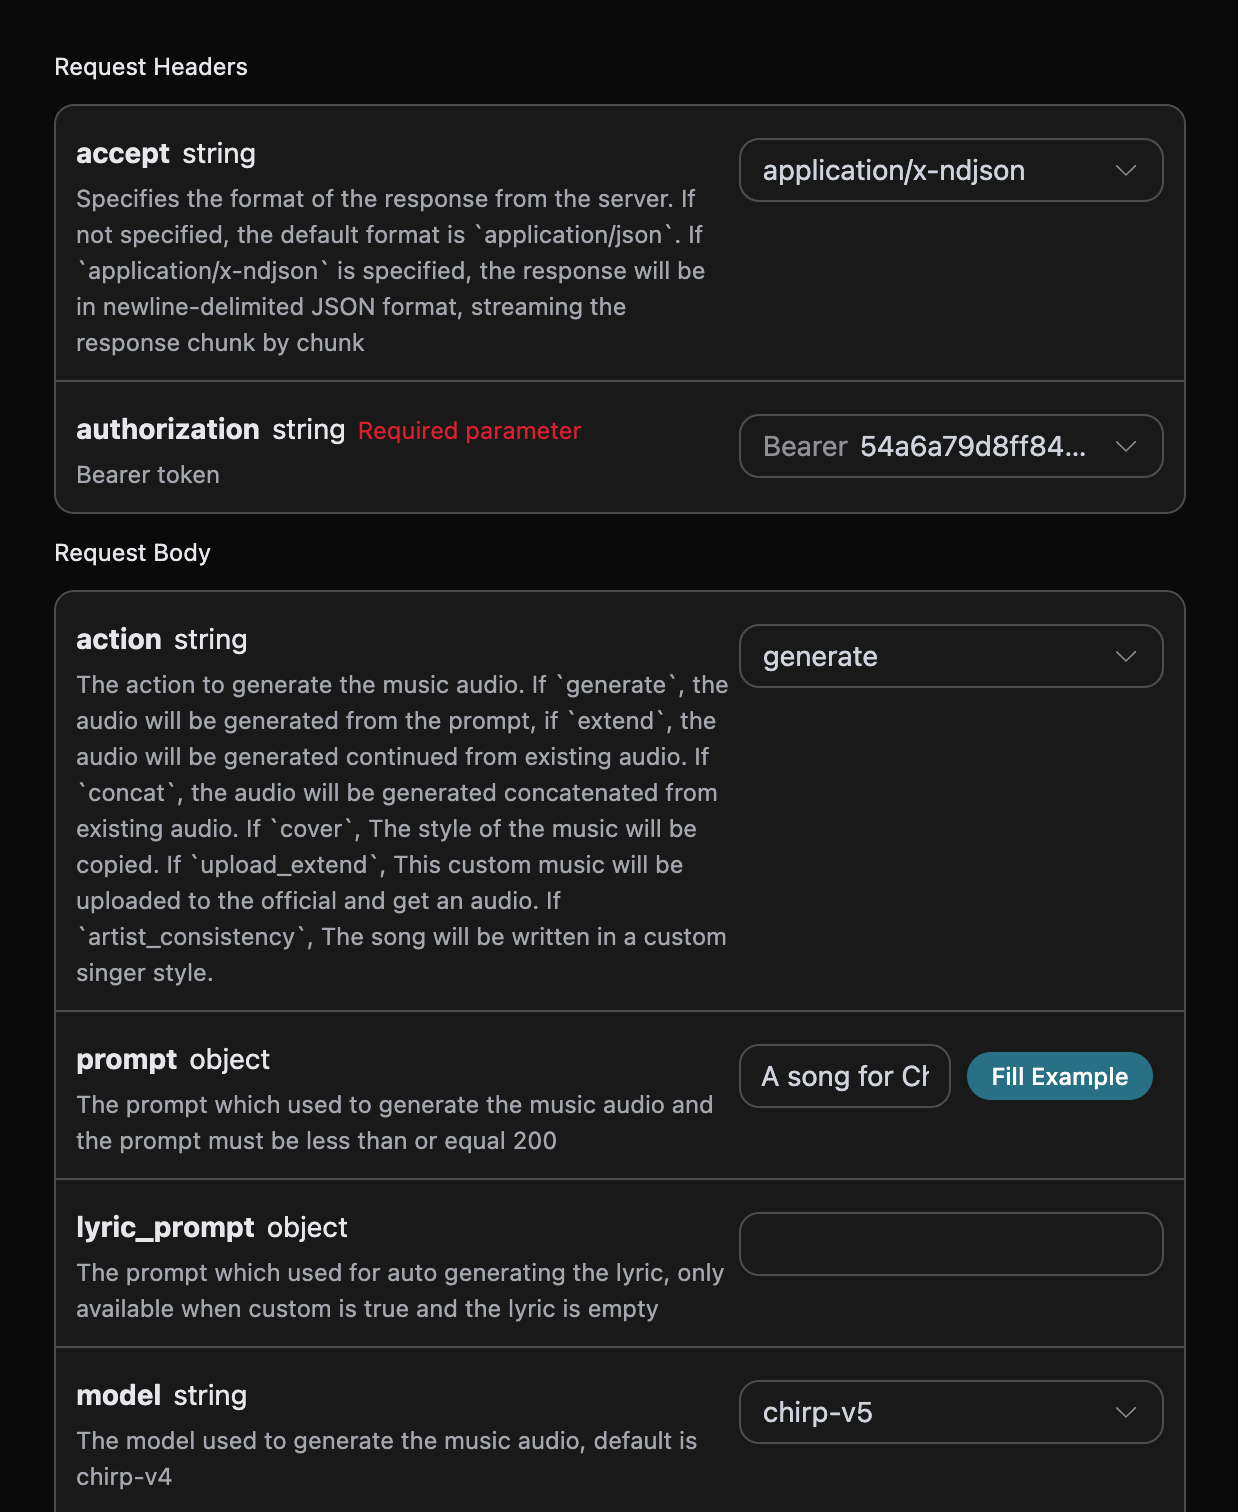
想生成什麼歌曲,可以任意輸入一段文字,例如我想生成一首關於聖誕節的歌曲,就可以輸入a song for Christmas,如圖所示:
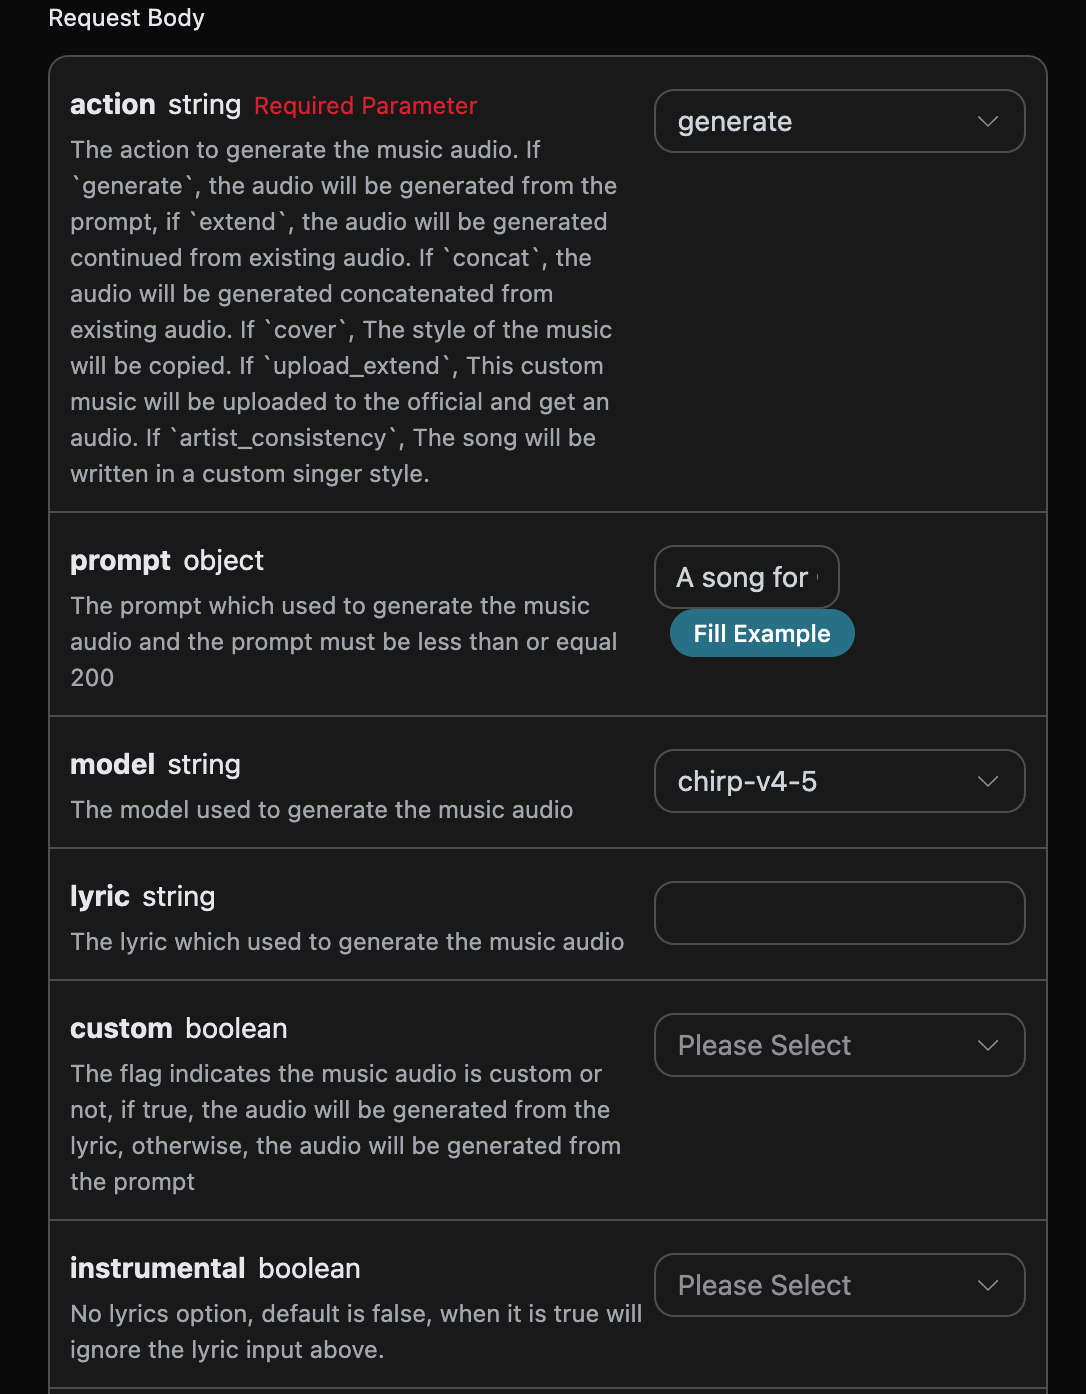
accept:想要接收什麼格式的回應結果,這裡填寫為application/json,即 JSON 格式。authorization:呼叫 API 的金鑰,申請之後可以直接下拉選擇。
action:音訊任務類型,預設是generate。支援生成、續寫、翻唱、拼接、分軌、添加音軌、提取指定音軌、生成音效和調整速度等操作,統一透過POST /suno/audios呼叫。prompt:Suno 官方的靈感模式提示詞(custom為false時生效),最大 500 字元。model:此次音樂生成任務的模型。v6 系列包含chirp-v6、chirp-v6-wild和chirp-v6-mini;舊模型名稱繼續相容。max_mode:增強生成模式。generate僅在custom與max_mode均為true時啟用,費用為 1.12 Credits;add_stem可直接啟用,費用為 1.344 Credits。關閉或省略時分別為 0.56 和 0.672 Credits。variety:生成結果的多樣性強度,可選off、normal、high、extra、max。僅用於generate和add_stem,其他 action 傳入會回傳 400。lyric:Suno 官方的自訂模式的歌詞內容。chirp-v3-5與chirp-v4最大 3000 字元;chirp-v4-5及以上(含chirp-v5、chirp-v5-5)最大 5000 字元。custom:是否採用自訂模式,預設是:false。instrumental:Suno 官方的靈感模式的純音樂選項。title:Suno 官方的自訂模式的音樂標題。chirp-v3-5、chirp-v4最大 80 字元;chirp-v4-5及以上最大 100 字元。style:Suno 官方的自訂模式音樂風格。chirp-v3-5與chirp-v4最大 200 字元;chirp-v4-5及以上(含chirp-v5、chirp-v5-5)最大 1000 字元。negative_tags:自訂生成時希望排除的音樂風格或流派,也可用於replace_section。本介面目前未對該欄位設定固定字元數上限;過長內容仍可能無法處理,建議保持描述精簡。audio_weight:音訊或聲音特徵的影響權重,範圍 0-1,0也是有效值。可用於生成、續寫、翻唱、添加音軌和聲音一致性等操作;沒有參考音訊或聲音特徵時,模型可能弱化或忽略該值。audio_id:參考音樂的 ID,用於翻唱、續寫、分軌等後續操作。音訊檔案仍可下載,不代表該 ID 的後續處理始終可用;若回傳suno_processing_unavailable,請保留task_id和trace_id聯絡支援。overpainting_start/overpainting_end:為已有純音樂補充人聲的起止時間,單位秒。underpainting_start/underpainting_end:為清唱加伴奏的起止時間,單位秒。persona_id:透過 Persona 或聲音建立介面獲得的聲音 ID,不是歌曲的audio_id。continue_at:續寫邊界,單位為秒。例如,213.5 表示從第 3 分 33.5 秒處開始生成後續片段。lyric和style只引導邊界之後的新內容,不會取代來源音訊中邊界之前的歌詞或演唱。style_influence:自訂模式下的風格影響力,範圍 0-1,越大通常越貼合所選風格;0會作為有效值傳遞。replace_section_end:替換片段的最終時間。replace_section_start:替換片段的起始時間。vocal_gender:控制男女聲偏好,女聲f,男聲m,4.5 及以上模型有效;為偏好項,不保證嚴格遵循。weirdness:自訂模式下的怪異度,範圍 0-1,越大通常越具創意和實驗性;0會作為有效值傳遞。duration:期望的歌曲時長,單位秒,需為整數,取值範圍 10 到 360。目前僅generate使用該參數,具體效果取決於模式和模型。它是一個傾向性提示而非硬性約束:模型會參考它,但不保證達到,實際成品時長以回應中的duration欄位為準,通常短於期望值。
聲音 ID 的適用範圍
generate、cover、upload_cover、artist_consistency、artist_consistency_vox 可以使用 persona_id。後兩個 action 必須提供 persona_id;也可以同時提供建立該 Persona 時所用歌曲的 audio_id。
extend、upload_extend 不使用額外的 persona_id。mashup、inspo 是否支援聲音 ID 取決於所選服務通道;其他 action 不保證套用該欄位,請依各操作說明使用。vocal_gender 是可選的性別偏好,不能取代聲音 ID。
後續創作操作需要有效的來源 audio_id;mashup 需要至少兩個 mashup_audio_ids。缺少必要來源或時間參數時會回傳 HTTP 400。
進階參數適用範圍
平台會驗證參數類型和數值範圍,但不會僅因 action 不同而拒絕這些可選調整項;具體效果由操作、模式和模型決定。
lyric_prompt:生成歌詞的 prompt,當且僅當custom為true並且未傳遞lyric時生效。callback_url:需要回呼結果的 URL。async:可選,設為true時介面立即返回task_id,無需提供callback_url,之後透過對應的任務查詢介面輪詢取得結果。
- success:生成是否成功,如果成功則為
true,否則為false - data:是一個列表,包含了生成歌曲的詳細資訊。
- state:歌曲生成狀態,主要包含四種,具體如下:
- succeeded:生成成功
- pending:佇列中
- running:執行中
- error:失敗
- id:歌曲 ID
- title:歌曲的標題
- image_url:歌曲的封面圖片
- lyric:歌曲的歌詞
- audio_url:歌曲的最終音訊位址。平台會優先返回 Ace Data Cloud CDN 位址;若持久化失敗,可能返回原始媒體位址,請及時下載。
- video_url:歌曲的影片檔案,開啟就是一個 mp4 影片。
- created_at:建立時間
- model:使用的模型,一般是最新的 v3 模型
- style:風格
- state:歌曲生成狀態,主要包含四種,具體如下:
自訂生成
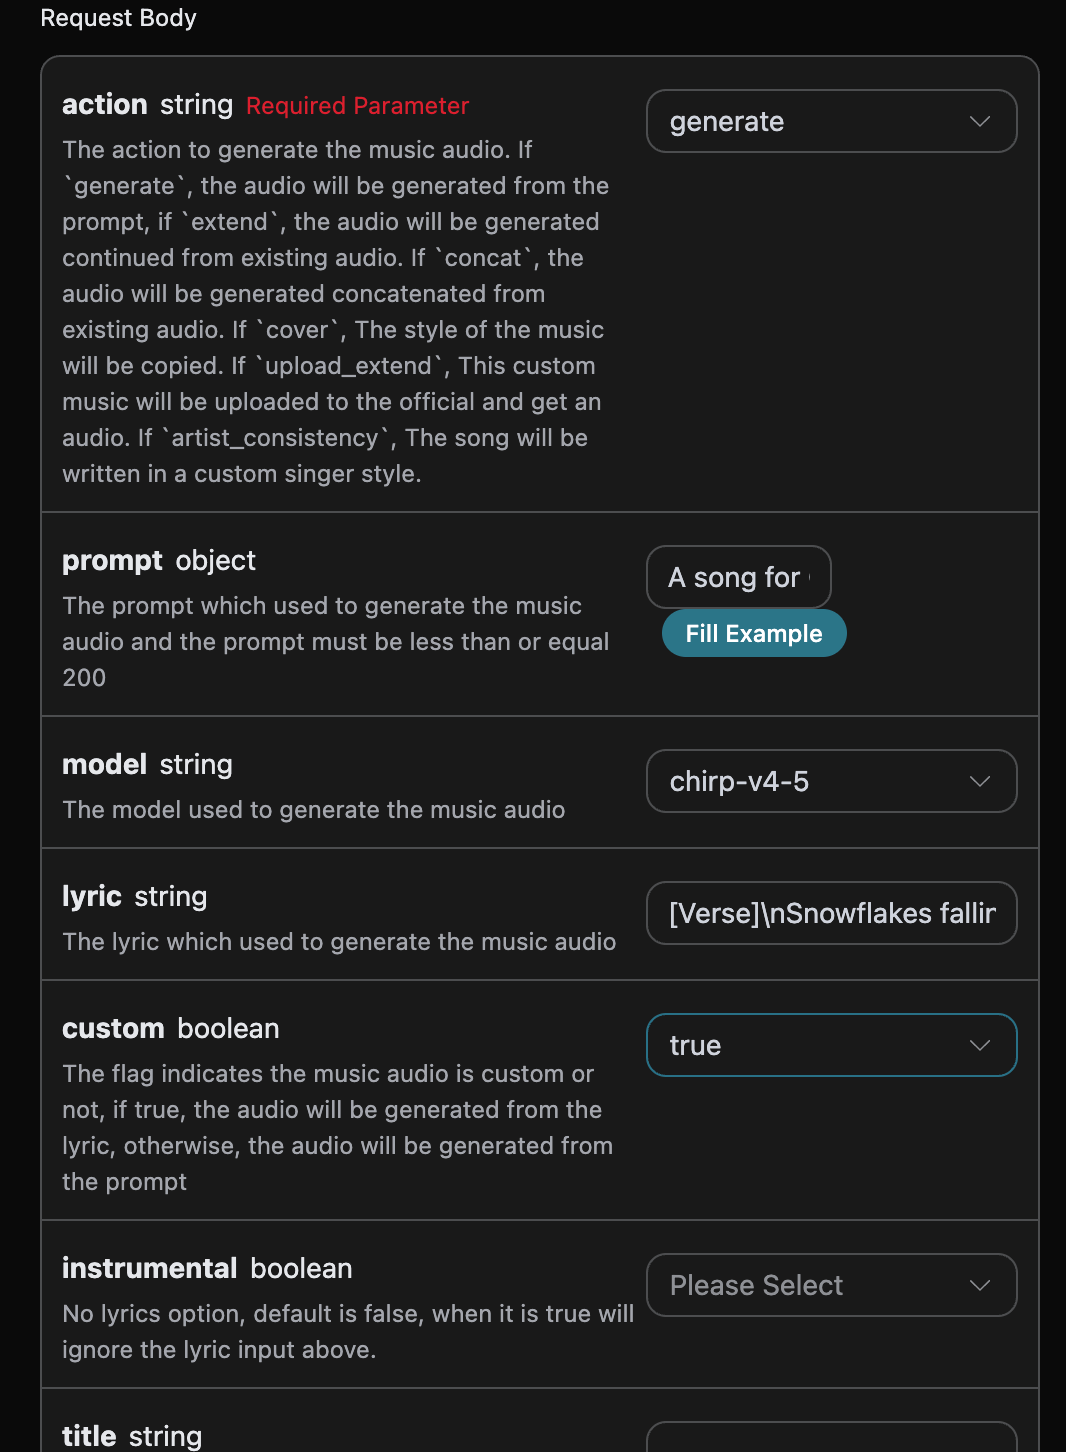
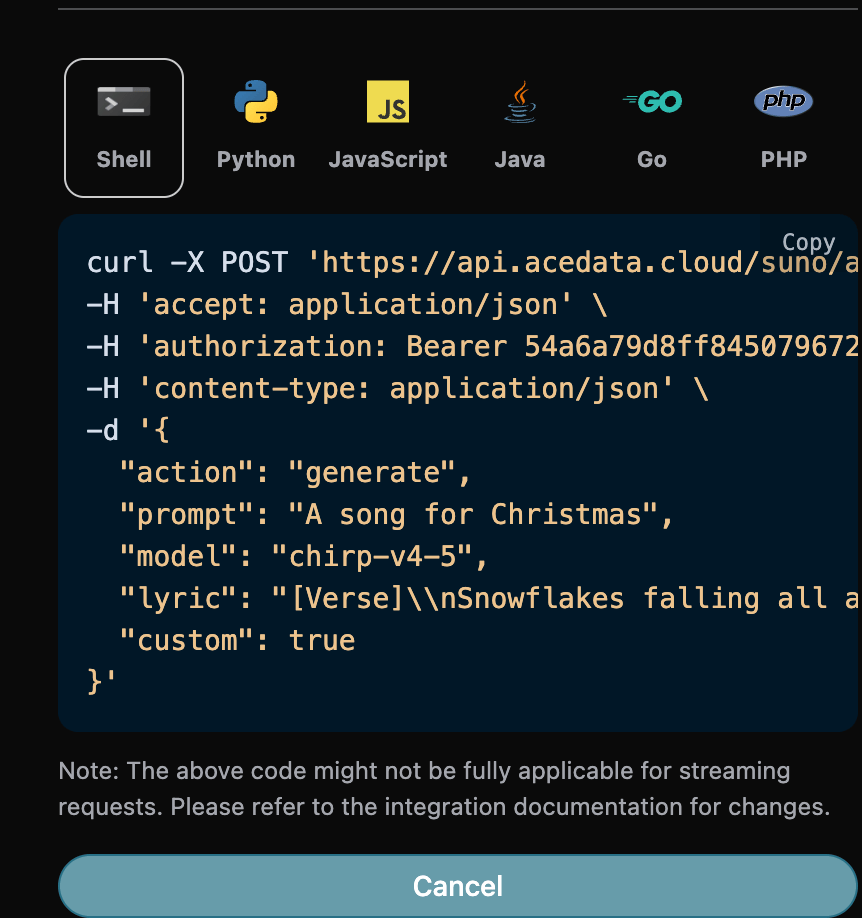
如果想自訂生成歌詞,可以輸入歌詞: 這時候lyric 欄位可以傳入類似如下內容:
注意,這裡的歌詞中 \n 是換行符,如果你不知道如何生成歌詞,可以使用 AceDataCloud 提供的歌詞生成 API 來透過 prompt 生成歌詞,API 是 Suno 歌詞生成 API。
接下來我們要根據歌詞、標題、風格自訂生成歌曲,就可以指定如下內容:
- lyric:歌詞文字
- custom:填寫為
true,代表自訂生成,該參數預設為 false,代表使用prompt生成。 - title:歌曲的標題。
- style:歌曲的風格,選填。
自訂歌手風格生成功能
如果想使用歌手風格來生成歌曲的話,首先透過上文的基本使用生成一首歌曲, 最後得到需要設定這首歌曲為歌手風格,然後需要進入Suno Persona API根據官方生成的音樂 IDaudio_id 來生成一個歌手風格的 id 參數 persona_id,具體的參數如下圖所示:
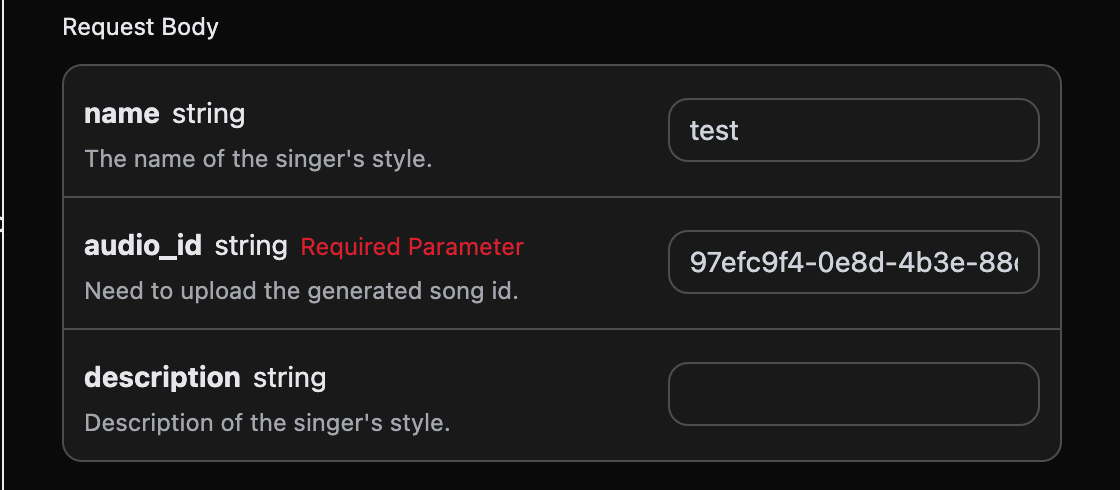
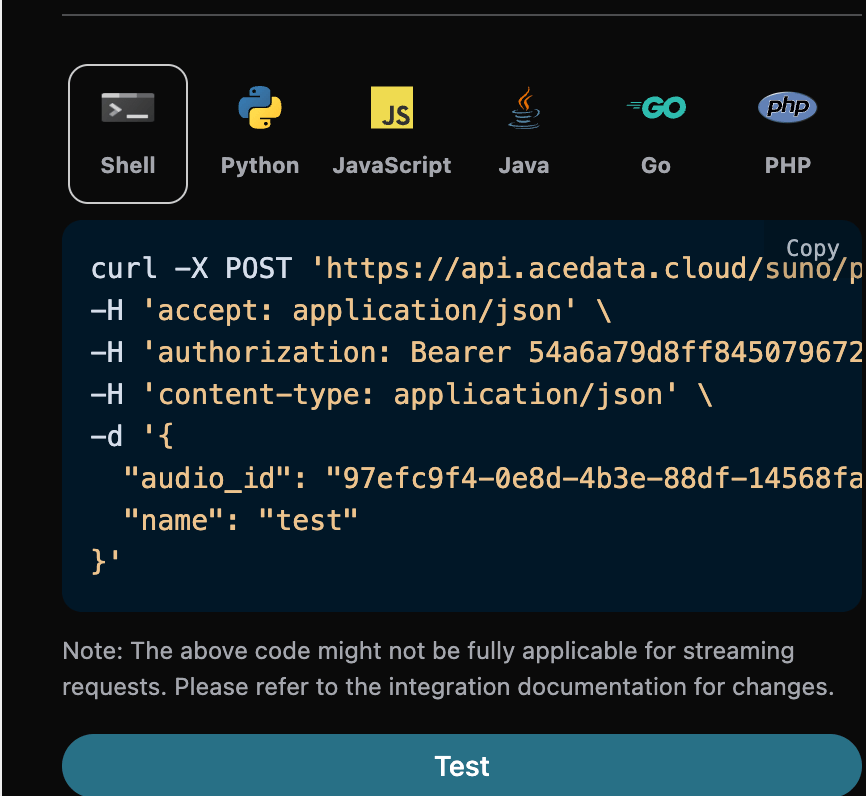
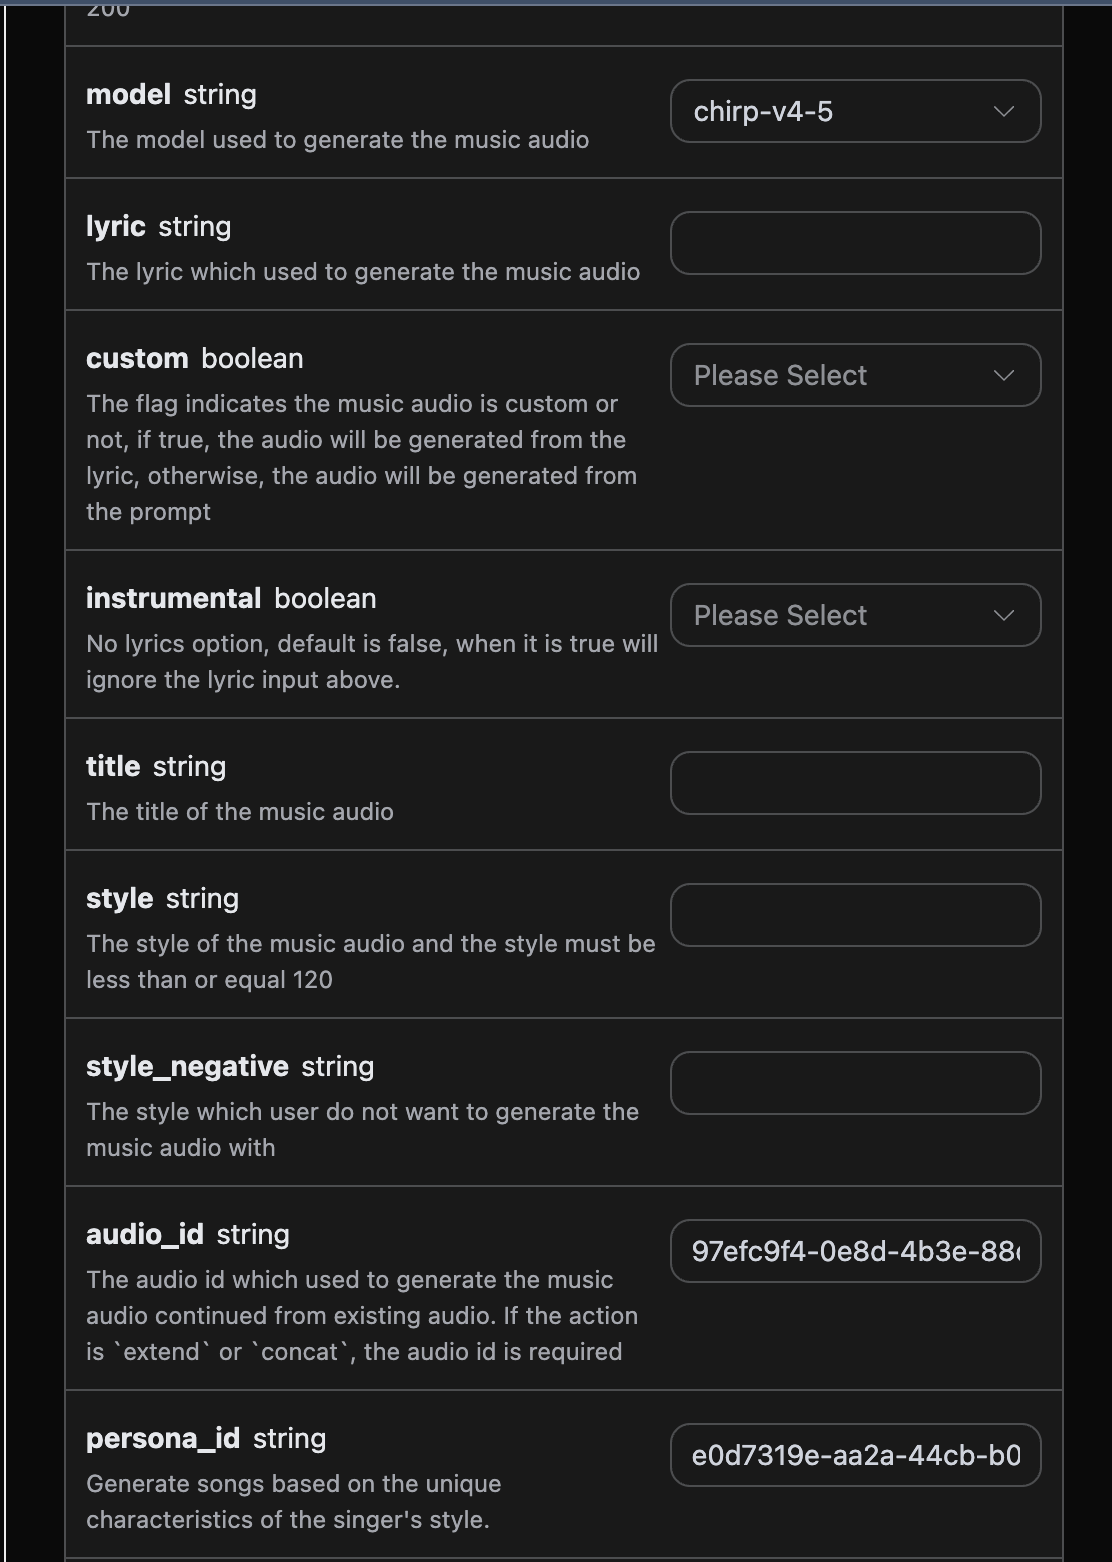
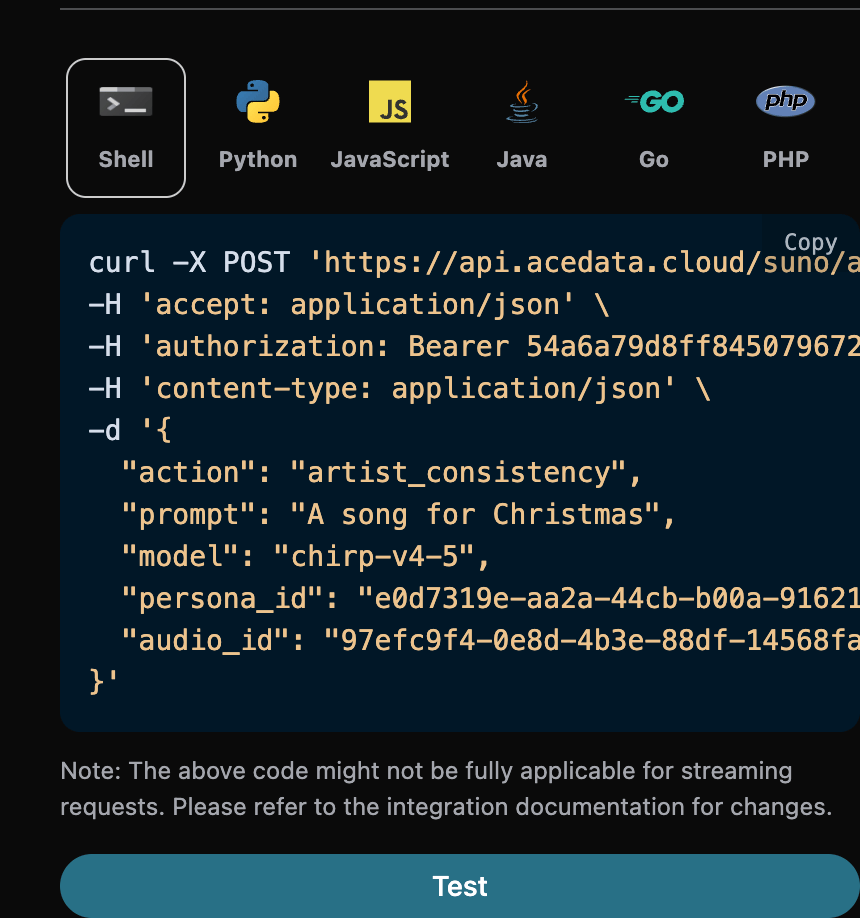
audio_id 和 persona_id 分別為 97efc9f4-0e8d-4b3e-88df-14568fa1b11f、e0d7319e-aa2a-44cb-b00a-916218d7cb0b 作為這次的範例資料。 然後可以將參數 action 設定為 artist_consistency (如果是新版的歌手風格Persona-v2-vox,action 必須設定為 artist_consistency_vox),並且輸入需要繼續生成歌曲的 ID、歌手風格 ID,填寫範例如下:
繼續生成功能
如果想對已經生成的 Suno 歌曲進行繼續生成的話,可以將參數action 設定為 extend ,並且輸入需要繼續生成歌曲的 ID,歌曲 ID 的取得是根據基本使用來取得,透過上文可知,這時候可以看到歌曲的 ID 為:
注意,這裡的歌詞中 id 是生成後歌曲的 ID,如果你不知道如何生成歌曲,可以參考上文的基本使用來生成歌曲。
如果想對自己上傳的歌曲進行繼續生成的話,可以將參數 action 設定為 upload_extend ,並且輸入需要繼續生成自訂上傳的歌曲 ID,歌曲 ID 的取得是使用 Suno Upload Generation API來取得,如下圖所示:
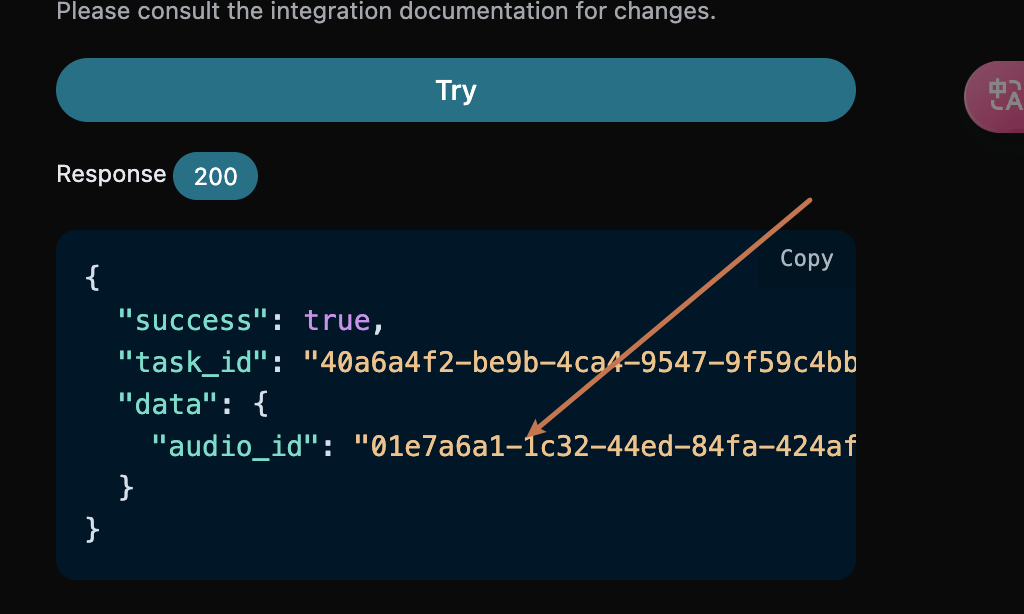
- lyric:只用於引導
continue_at之後新生成片段的歌詞,不會替換來源音訊中該時間點之前的歌詞。 - custom:填寫為
true,代表自訂生成,該參數預設為 false,代表使用prompt生成。 - style:續寫片段的歌曲風格,選填。
- continue_at:續寫邊界,單位為秒。例如,213.5 表示從第 3 分 33.5 秒處開始生成後續片段。
extend 和 upload_extend 的 continue_at 必須大於 0,支援小數秒,例如 30.792;提交時不會取整。
填寫範例如下:extend用於接著已有歌曲往後創作,不是給整首歌曲換詞。若希望整首歌曲從頭使用新歌詞,請使用generate重新生成;若希望參考已有歌曲重新演繹,可使用cover。傳入一整首新歌詞時,continue_at之前的原歌詞仍不會被替換。
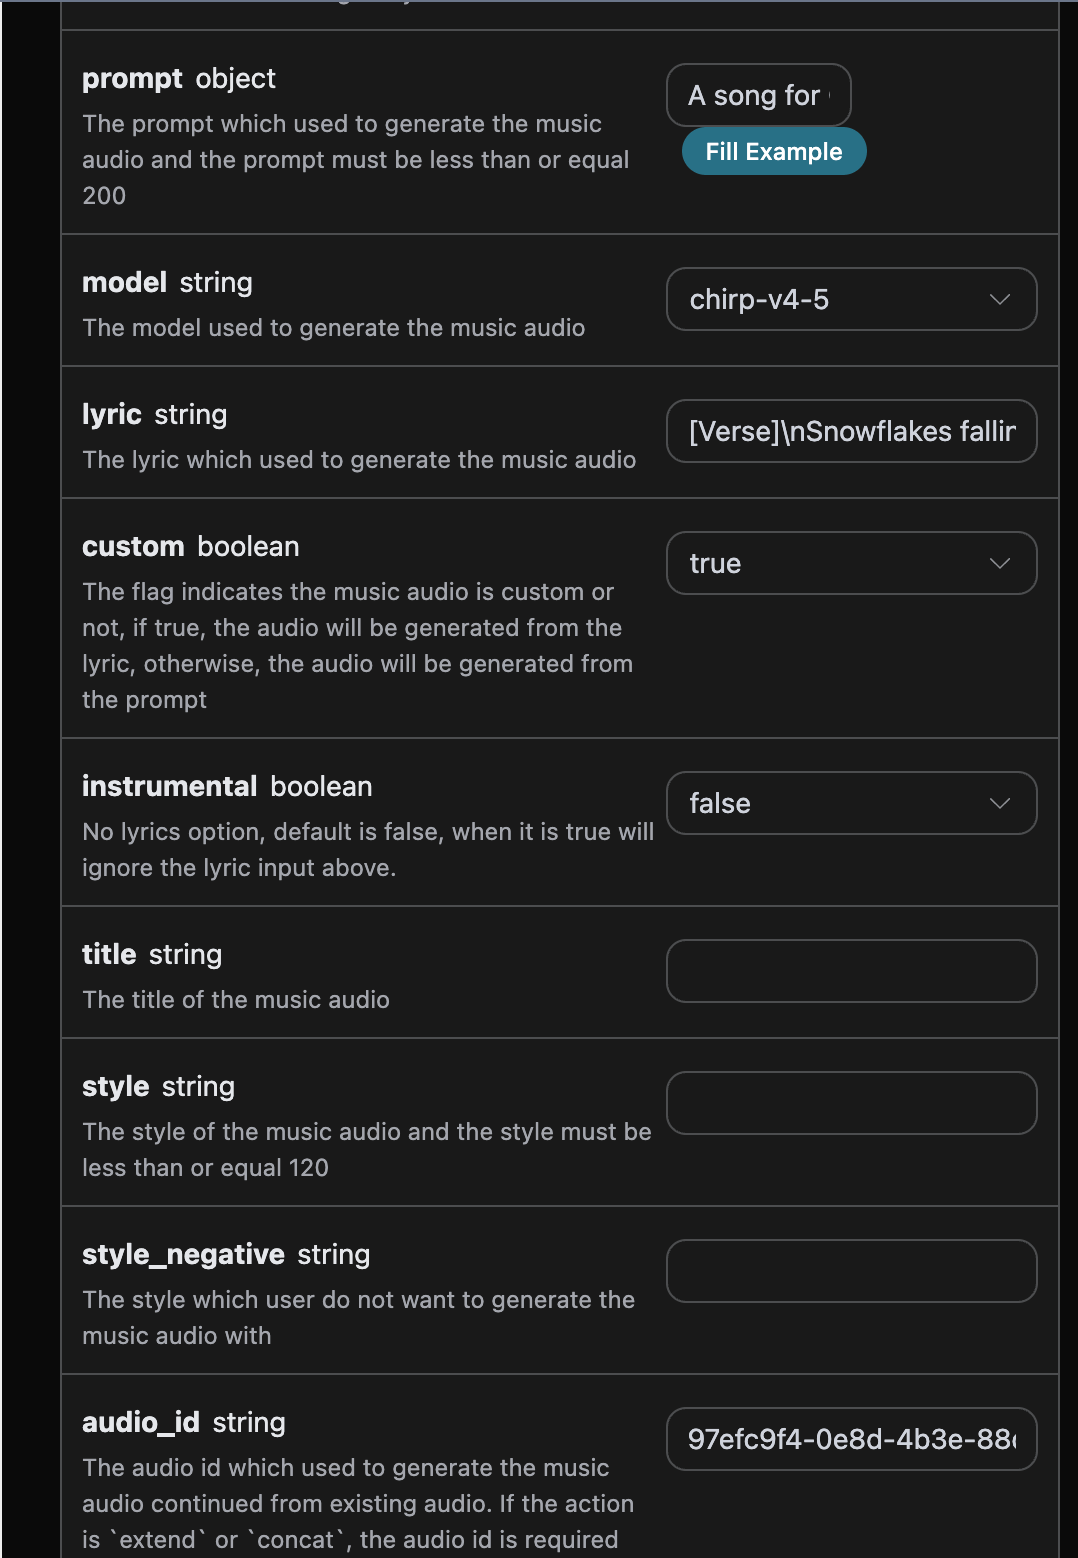
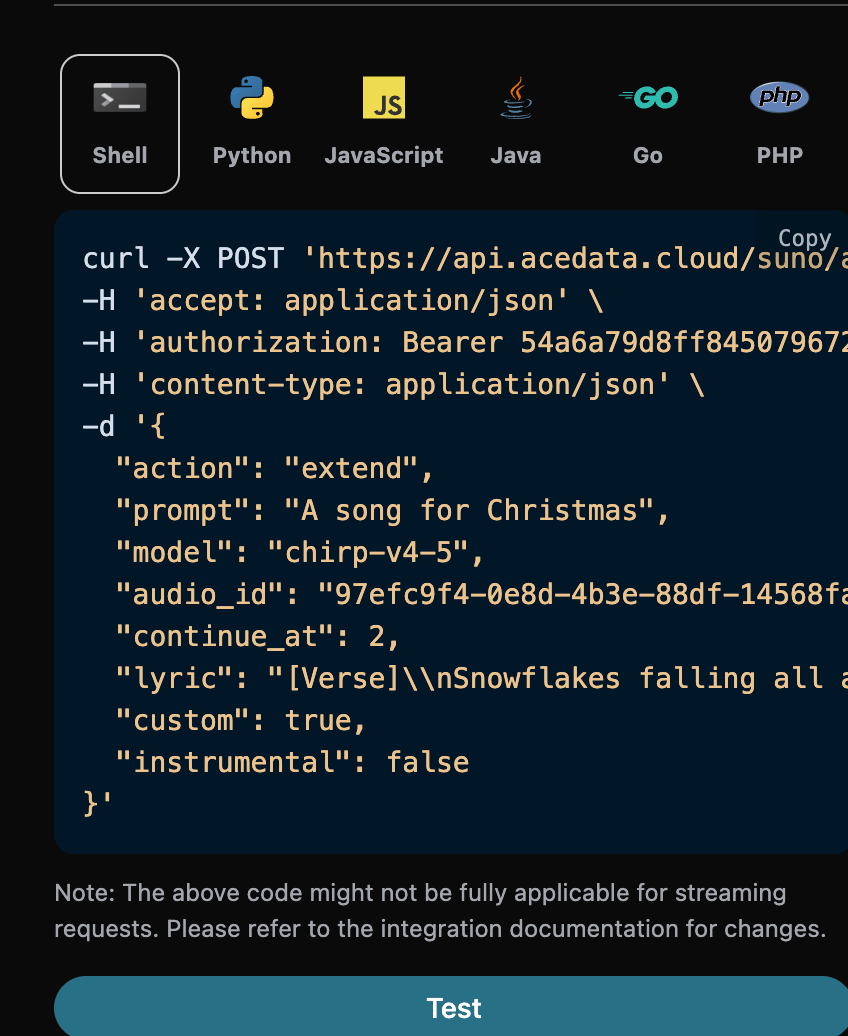
continue_at 為 2 秒,因此只有前 2 秒屬於續寫邊界之前的原內容。實際接近歌曲結尾續寫時,應將該值設為期望開始續寫的秒數,並僅在 lyric 中提供邊界之後要唱的新段落。
對應的 Python 程式碼:
lyric 會回傳此次續寫任務使用的歌詞文字。該欄位不是完整成品音訊的逐字轉寫;對於 extend,continue_at 之前的來源音訊仍使用原歌詞,新歌詞只用於引導續寫片段。
取得完整歌曲
目前模型的extend 結果通常已包含 continue_at 之前的來源音訊和邊界之後的新內容,請先根據回傳音訊的實際時長與內容判斷是否已經是完整歌曲。若回傳的是獨立續寫片段,或者需要將多次續寫歷史明確合併為一首歌,再使用拼接功能:
- action:內容為
concat。 - audio_id:最後一個續寫片段的 ID。
音樂翻版
當基於原有的歌曲繼續生成歌曲之後,回傳歌曲的風格可能不太合適。如果要對原先生成的歌曲(若是自訂上傳的音樂也支援)進行翻版,需要使用音樂翻版方法,就可以指定如下內容:- action:內容為
cover,當是對自訂上傳的音樂進行翻版操作的時候必須指定內容為:upload_cover。 - audio_id:之前生成歌曲的 ID。
persona_id。透過 /suno/voices 建立的私人聲音需要先在 /suno/upload 中攜帶相同的 persona_id 上傳原曲,再使用回傳的 audio_id 進行 upload_cover。各步驟須使用相同的服務通道。無需額外指定 vocal_gender,性別偏好不能取代聲音 ID。
例如原先生成後的歌曲 ID 是:0a1e1b10-c36a-41c9-9bfb-b26d9d25db98,那麼可以設定參數如下:
替換片段
當生成歌曲之後需要進行替換歌曲片段單獨操作的二次創作時,可以對歌曲的某個片段進行替換操作。⚠️ 注意:參數說明如下:replace_section_result_mode預設為full_song:系統會分別拼接 2 個新生成的候選,並回傳 2 首完整歌曲。若只需要尚未拼接的替換片段候選,請明確設定為candidates,然後選取候選呼叫 音樂拼接。
- action:內容為
replace_section。 - audio_id:原始歌曲(被替換的來源歌曲)的 ID。
- model: 歌曲生成模型。
- lyric: 替換後的完整歌詞(包含被替換段及其上下文,與
prompt中的內容保持一致)。 - prompt:需要替換的那一段新歌詞。
- style:歌曲的風格,選填。
- negative_tags:希望排除的風格或流派,選填。
- replace_section_start:被替換片段在原曲中的起始時間(秒),必填且不得小於 0。
- replace_section_end:被替換片段在原曲中的結束時間(秒),必填且必須大於起始時間。
- replace_section_result_mode:回傳模式,預設為
full_song。full_song分別拼接 2 個候選並回傳 2 首完整歌曲;candidates回傳 2 個尚未拼接的候選片段。
步驟一:發起替換片段任務
例如原先生成後的歌曲 ID 是:18db7ed0-2b8a-41db-91c1-b0781dcca0d4(時長 94.12 秒),希望把第 30 秒到第 60 秒處的副歌替換為新的歌詞,那麼可以設定參數如下:replace_section_result_mode 設為 candidates,則回傳 2 個尚未拼接的替換片段,結構與下方範例一致:
candidates 模式下,回傳的兩條音訊時長(45.16 秒、33.8 秒)遠短於原曲(94.12 秒),它們是包含少量上下文的替換片段,並不是整首歌曲。可以挑選滿意的候選繼續手動拼接。預設 full_song 模式則會完成兩次拼接,直接回傳 2 首完整歌曲。
直接回傳完整歌曲
如果希望直接取得完整歌曲,可以在步驟一把replace_section_result_mode 設為 full_song。介面會分別拼接兩個候選並回傳 2 首完整歌曲;此時無需再呼叫 concat。
步驟二:將替換片段拼接回原曲
針對上面挑選的片段(例如364f9d8b-ca25-463b-9a5e-d0b7139e2d6a),依照 音樂拼接 一節的方法發起 concat 任務:
duration 已恢復成完整歌曲長度(105.28 秒,約等於原曲長度),audio_url 指向的就是替換完成後的整首歌。這就完成了「生成 → 替換片段 → 拼接整曲」的二次創作流程。
聲曲分離
當生成歌曲之後需要進行伴奏和人聲單獨操作的二次創作時,可以分離純音樂伴奏和清唱人聲。就可以指定如下內容:- action:內容為
stems。 - audio_id:之前生成歌曲的 ID。
全軌道聲曲分離
任務會等待全部音軌生成完成後才返回成功終態。處理中出現可播放地址不代表整組音軌已經完成。 當生成歌曲之後需要進行全軌道聲曲分離操作時,就可以指定如下內容:- action:內容為
all_stems。 - audio_id:之前生成歌曲的 ID。
新增音軌
add_stem 為指定音訊產生目標樂器或聲音軌,透過 POST /suno/audios 呼叫。
- 必填:
action、audio_id、stem_type。 - 可選:
model、prompt、title、style、negative_tags、weirdness、style_influence、audio_weight、max_mode、variety。 - 計費:一般模式 0.672 Credits;
max_mode為true時 1.344 Credits。
擷取音軌
extract_stem 從指定音訊中擷取目標音軌,同時回傳移除該音軌後的互補版本,透過 POST /suno/audios 呼叫。
- 必填:
action、audio_id、stem_type。 - 可選:
audio_format,目前公共雙通道契約僅支援mp3。 - 計費:1.12 Credits。
data 保留扁平音訊清單,stem_sets 表示目標音軌與互補音軌的對應關係:
生成音效
sounds 根據文字描述生成一次性或可循環音效,透過 POST /suno/audios 呼叫。
- 必填:
action、sound、sound_type。 - 可選:
model、bpm、key、audio_format;audio_format目前僅支援mp3。 sound_type:one-shot或loop。- 計費:0.112 Credits。
調整音訊速度
adjust_speed 調整指定音訊的播放速度,透過 POST /suno/audios 呼叫。
- 必填:
action、audio_id、speed_multiplier、title。 - 可選:
keep_pitch。 speed_multiplier:範圍 0.25–4。- 計費:0.28 Credits。
自訂生成的進階參數
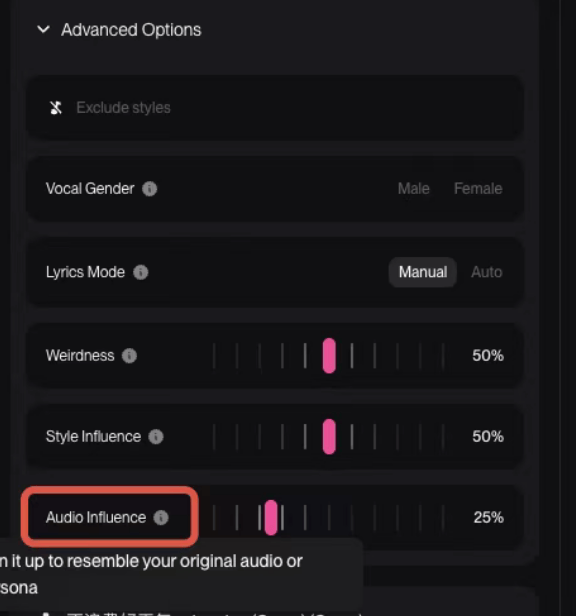
官方允許在自訂模式下使用進階參數weirdness==>Weirdness、style_influence==>Style Influence、audio_weight==>Audio Influence來進行生成,對應如下的官方範例:
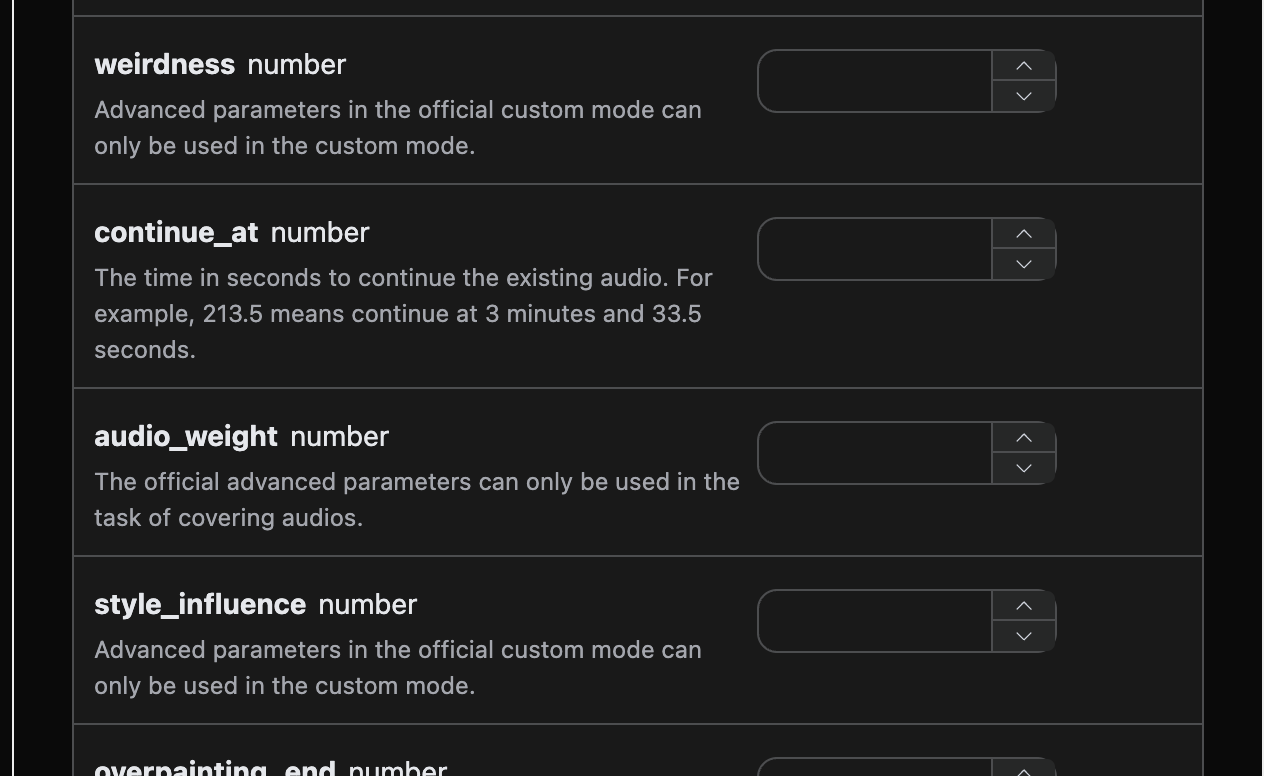
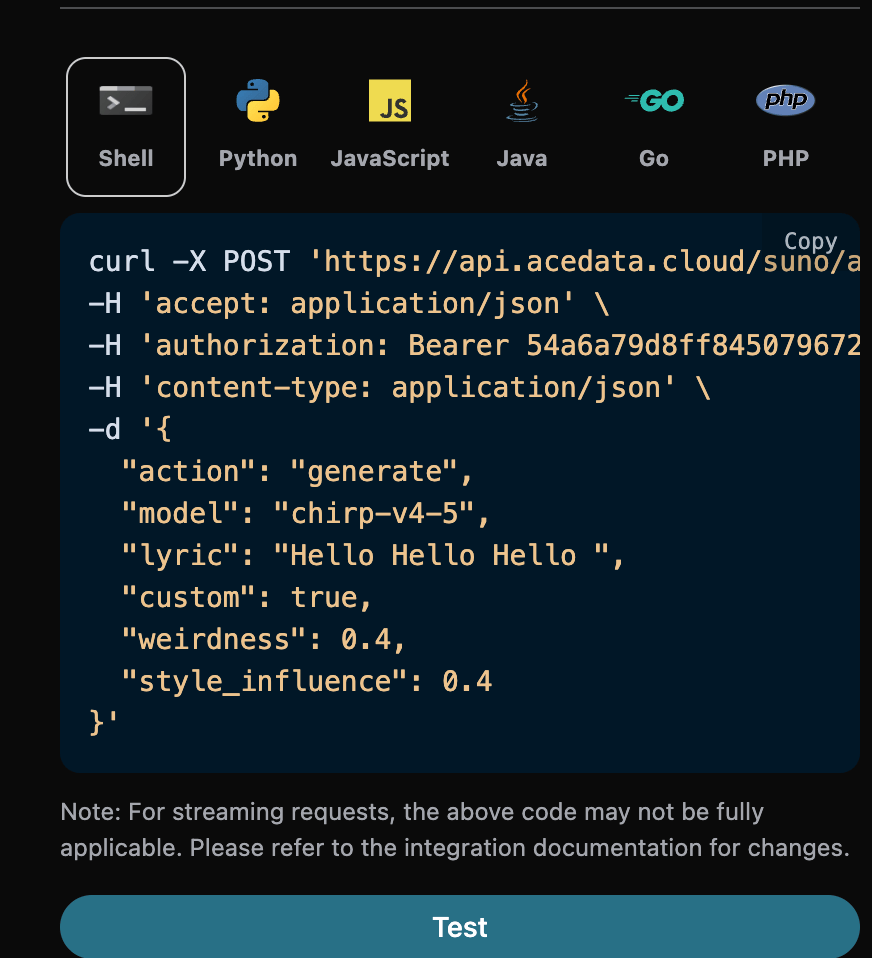
控制歌曲時長
預設情況下生成的歌曲時長由模型自行決定,通常在 30 秒到 4 分鐘之間。如果需要更長或更短的成品,可以透過duration 參數指定期望時長,單位是秒,取值為 10 到 360 之間的整數。
該參數用於自訂模式(custom 為 true)的歌曲生成。需要特別說明的是,duration 是一個傾向性提示,而不是硬性約束:模型在創作時會參考這個值,但不保證達到,實測中實際時長通常明顯短於期望值,同一次請求返回的兩首歌曲時長也可能相差數倍。即使是完全相同的請求,多次提交得到的時長也可能有較大差異。因此不要把它當作精確的時長控制來使用,如果業務上需要固定時長,請在拿到成品後自行裁剪或重試。
對應的 Python 程式碼:
duration 是期望時長,而回應 data 中每首歌曲的 duration 欄位是該首歌曲的實際時長。兩者名稱相同但含義不同,實際時長不保證等於期望值。歌詞長度是影響成品時長的主要因素之一,若需要較長的成品,建議同時提供更完整的歌詞。
介面會驗證 duration 必須是 10 到 360 的整數;它仍然只是生成目標,不是成品長度保證。
Add Insterumental 功能
2025 年 8 月 suno 新推出 Add Insterumental 功能,首先需要上傳一首清唱無配音的歌曲,讓 suno 幫你配樂,首先可以先到 Suno Upload API上傳一首清唱無配樂的歌曲,對應如下的操作如下圖所示: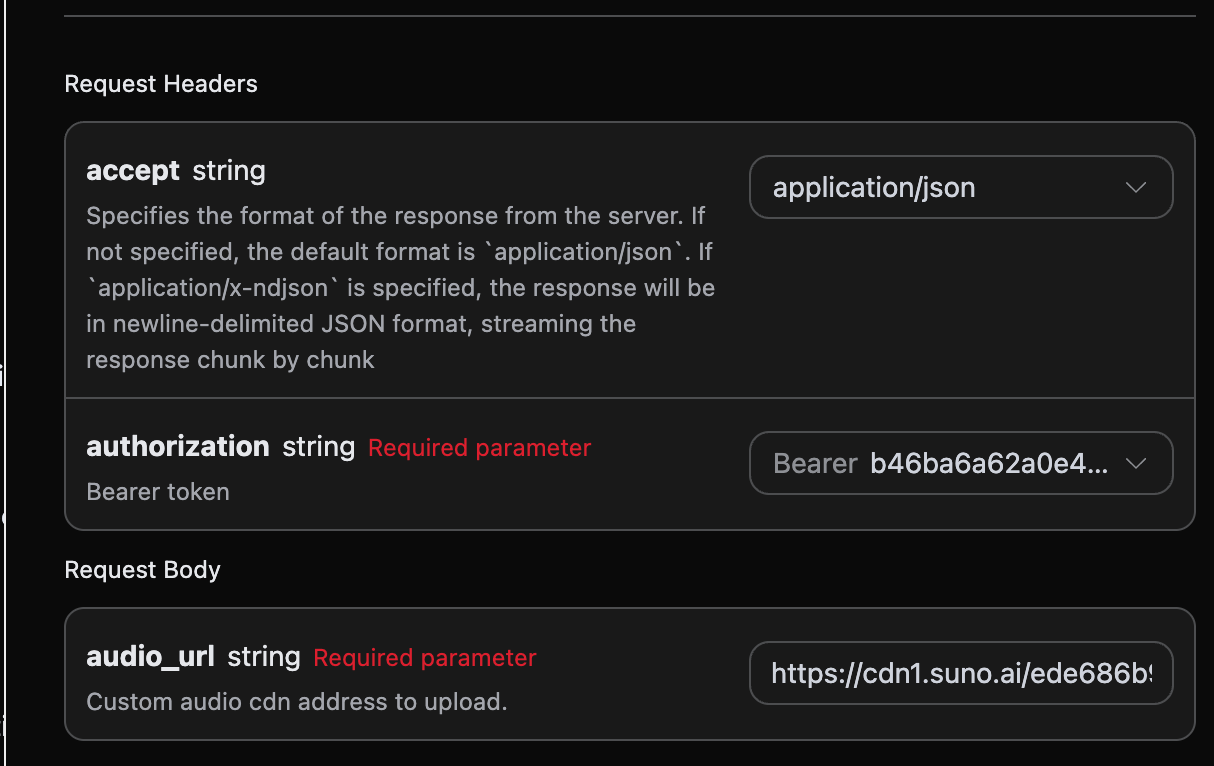
audio_id,具體的結果如下圖所示:
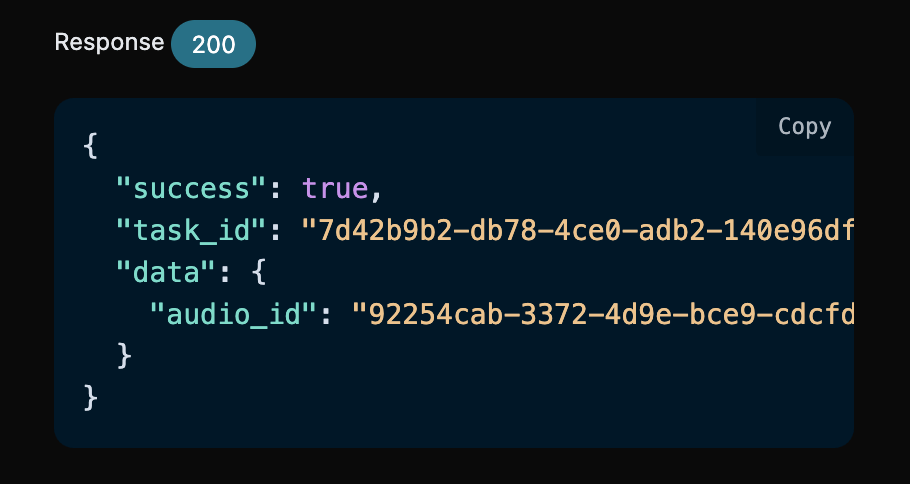
audio_id:92254cab-3372-4d9e-bce9-cdcfdbc39070,然後我們還需要填寫如下參數:
- action:內容為
underpainting。 - underpainting_start:對上傳的歌曲進行添加伴奏的起始時間,預設值是 0。
- underpainting_end:對上傳的歌曲進行添加伴奏的終點時間,必須小於歌曲的總時長。
- audio_id:上傳的清唱無配音的歌曲 ID。
- style:伴奏的風格,最好是不用歌詞,畢竟是配音。
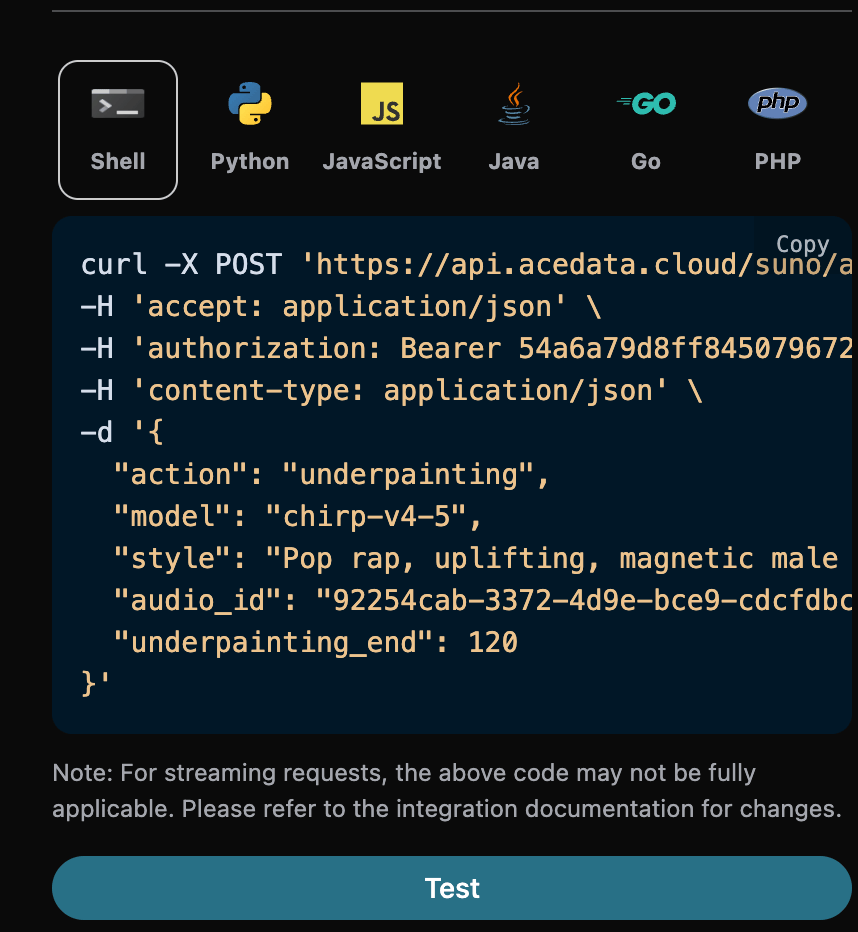
Add Vocals 功能
2025 年 8 月份 suno 新推出 Add Vocals 功能,首先需要上傳一首純音樂,讓 suno 填詞、產出人聲演唱,首先可以先到 Suno Upload API上傳一首清唱無配樂的歌曲,對應的操作如下圖所示:
audio_id,具體的結果如下圖所示:
audio_id:92254cab-3372-4d9e-bce9-cdcfdbc39070,然後我們還需要填寫如下參數:
- action:內容為
overpainting。 - overpainting_start:對上傳的歌曲進行添加人聲的起始時間,預設值是 0。
- overpainting_end:對上傳的歌曲進行添加人聲的終點時間,必須小於歌曲的總時長。
- audio_id:上傳的清唱無配音的歌曲 ID。
- custom:該模式下必須使用自訂模式填入歌詞。
- lyric:自訂模式下填寫的歌詞。
- style:伴奏的風格。
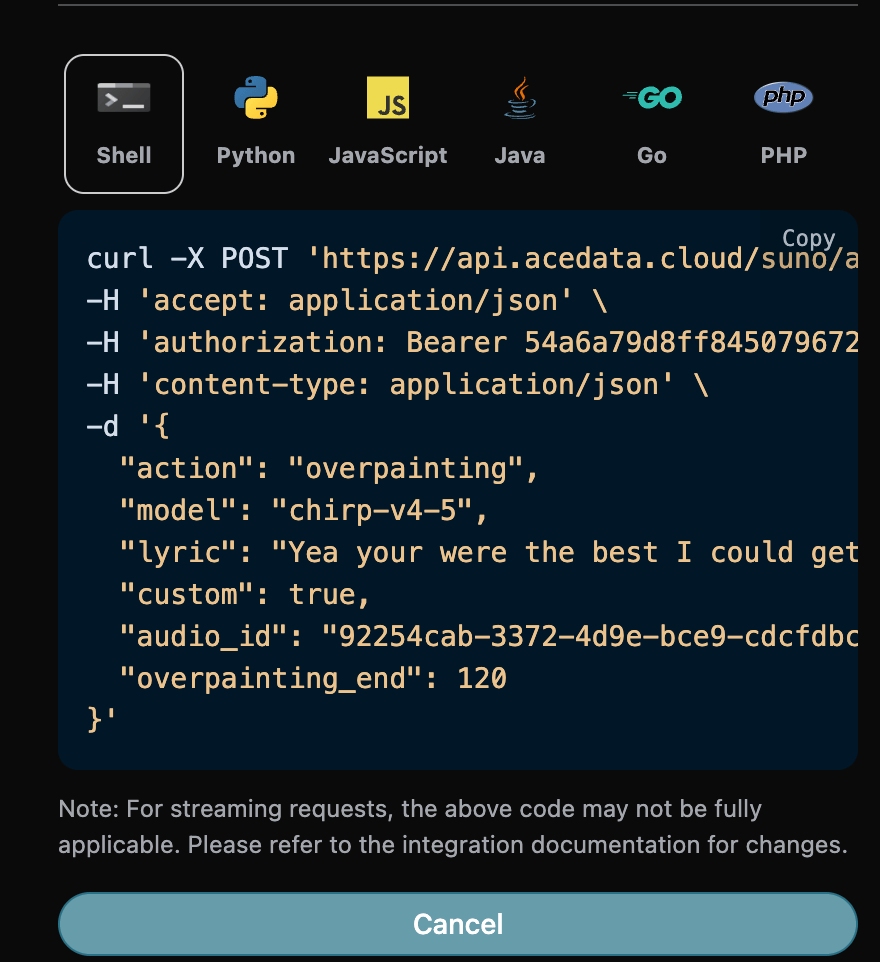
Remaster 功能
2025 年 12 月份 suno 新推出 Remaster 功能,該功能可以重新產生歌曲,不可跨帳號,然後我們還需要填寫如下參數:- action:內容為
remaster。 - audio_id:需要重新產生的歌曲 ID。
- model:僅支援 v4.5+、v5。
- variation_category:僅在 v5 以上版本支援,而且只有 3 個值 high normal subtle。
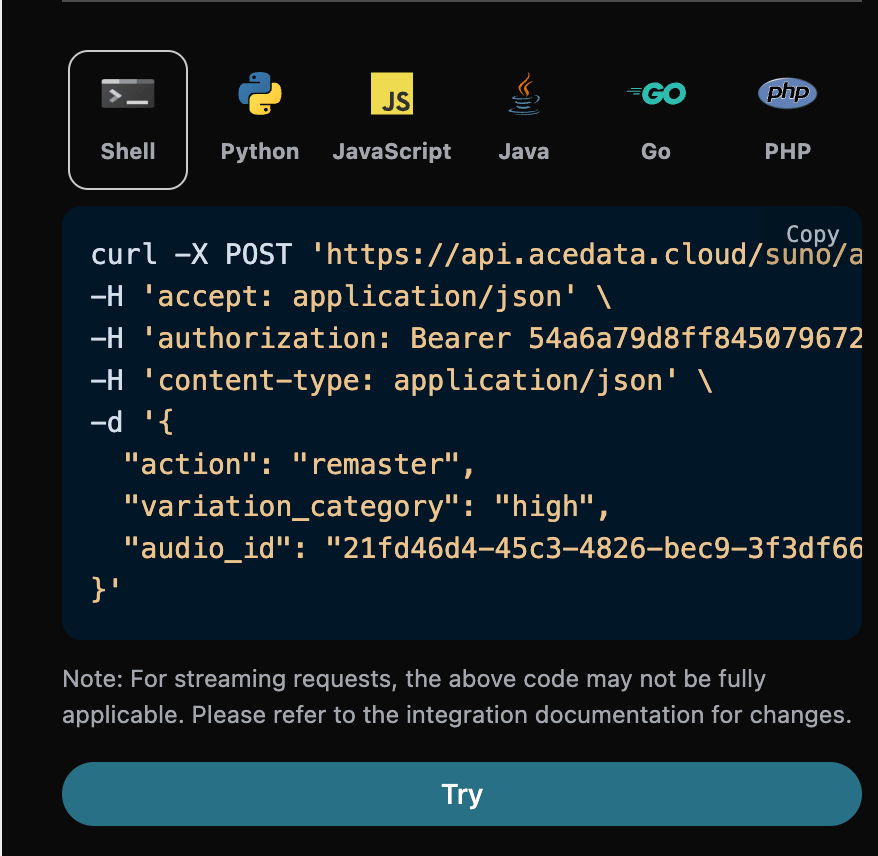
Mashup 混曲生成功能
2025 年 12 月 suno 新推出 Mashup 功能,該功能可以根據兩首參考歌曲生成歌曲,然後我們還需要填寫如下參數:- action:內容為
mashup。 - mashup_audio_ids:兩首參考歌曲的 ID。
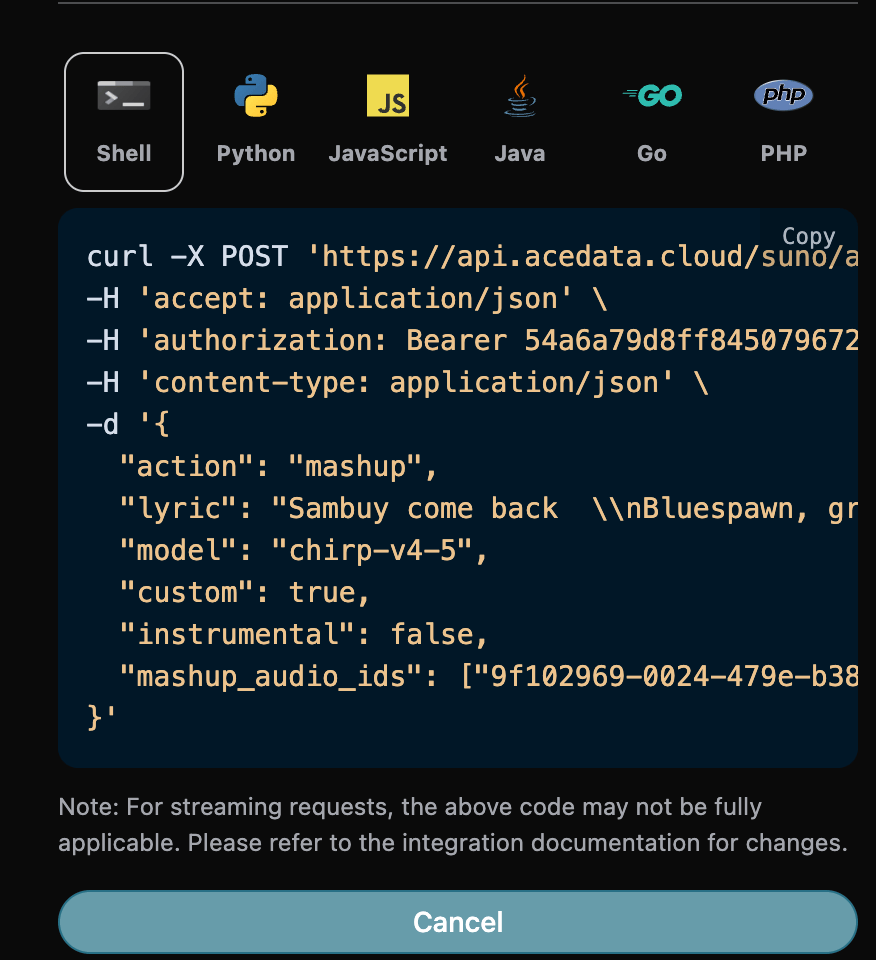
Samples 取樣生成歌曲
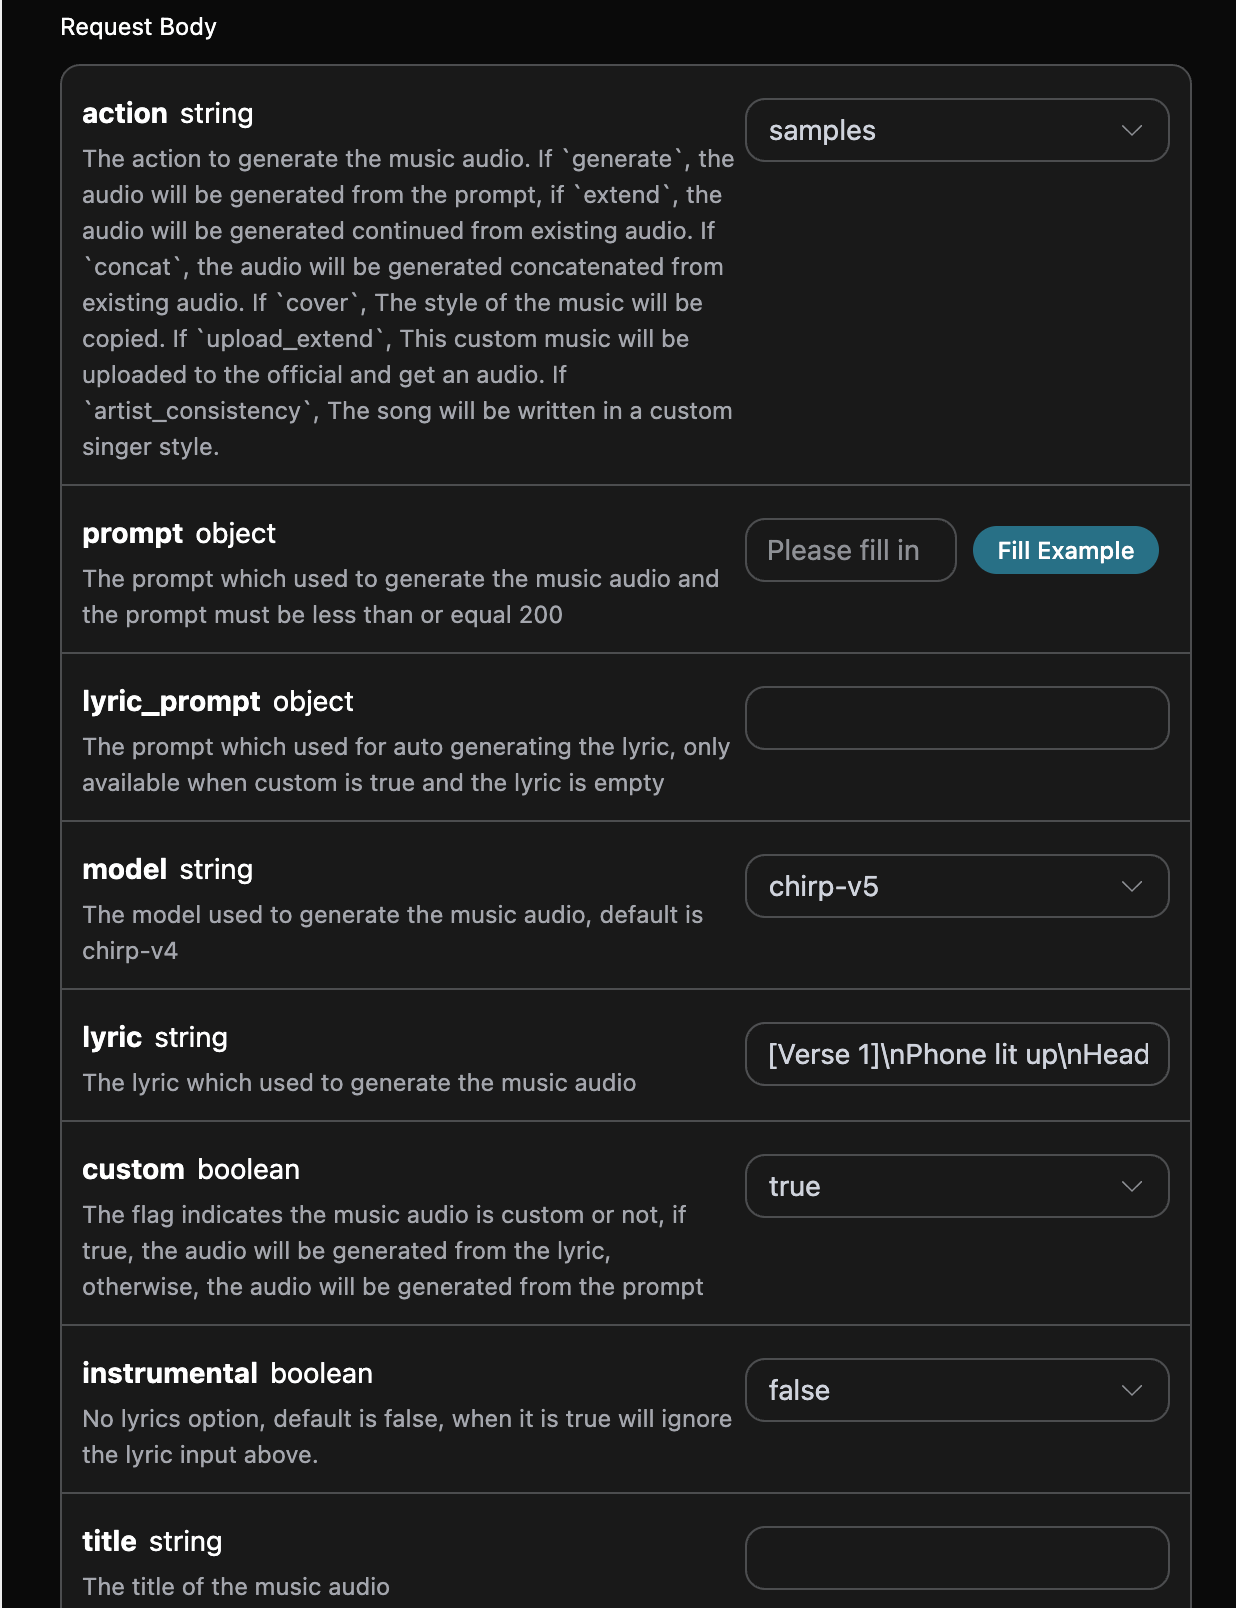
這裡的samples 是單音訊區間取樣:從一首已有音訊中選擇起訖時間,將該片段作為取樣素材進行創作。它不同於下文使用 1 到 4 段完整參考音訊的 Inspo 靈感創作功能。需要填寫如下參數:
- action:內容為
samples。 - samples_start:取樣開始時間(秒),預設為 0,不得小於 0。
- samples_end:取樣結束時間(秒),必填且必須大於開始時間。
- audio_id:需要取樣的參考歌曲 ID。
Inspo 靈感創作功能
Inspo 靈感創作功能可以根據 1 到 4 段完整參考音訊生成新的音樂,支援拖曳或上傳音訊作為靈感來源。API 使用現有inspo action:用戶端提供公開可存取的音訊 URL,服務會自動完成參考音訊準備和創作,無需用戶端分別讀取歌詞、風格或時長再組裝請求。它不同於上文的區間取樣,也不同於復刻原曲風格的 Cover。使用時需要填寫如下參數:
- action:內容為
inspo。 - audio_urls:參考音訊的 URL 列表,需提供 1 到 4 個公開可存取的音訊位址。
- model:使用的模型,推薦
chirp-v6。 - prompt:歌詞或創作提示詞(可選)。
- instrumental:設為
true時按純音樂請求生成,不使用歌詞。 - persona_id:在支援該組合的服務通道上使用指定聲音;參考音訊會在準備階段繫結到該聲音所需的資源環境。
- lyric_prompt:當
custom=true且未提供lyric時,用於自動生成歌詞。
說明:參考音訊需為公開可存取的音訊檔案。若參考音訊與平台曲庫中的已知錄音完全相符,Suno 可能會因版權校驗而拒絕生成,建議使用自有或由 Suno 生成的音訊作為靈感來源。對應的 Python 程式碼:
chirp-v5,目前請求範例推薦 chirp-v6,回傳結構一致:
非同步回呼
由於 Suno 生成音樂的時間相對較長,大約需要 1-2 分鐘,如果 API 長時間沒有回應,HTTP 請求會一直保持連線,導致額外的系統資源消耗,所以本 API 也提供了非同步回呼的支援。 整體流程是:用戶端發起請求的時候,額外指定一個callback_url 欄位,用戶端發起 API 請求之後,API 會立刻回傳一個結果,包含一個 task_id 的欄位資訊,代表目前的任務 ID。當任務完成之後,生成音樂的結果會透過 POST JSON 的形式傳送到用戶端指定的 callback_url,其中也包括了 task_id 欄位,這樣任務結果就可以透過 ID 關聯起來了。
下面我們透過範例來了解具體要怎樣操作。
首先,Webhook 回呼是一個可以接收 HTTP 請求的服務,開發者應該替換為自己搭建的 HTTP 伺服器的 URL。此處為了方便示範,使用一個公開的 Webhook 範例網站 https://webhook.site/,開啟該網站即可取得一個 Webhook URL,如圖所示:
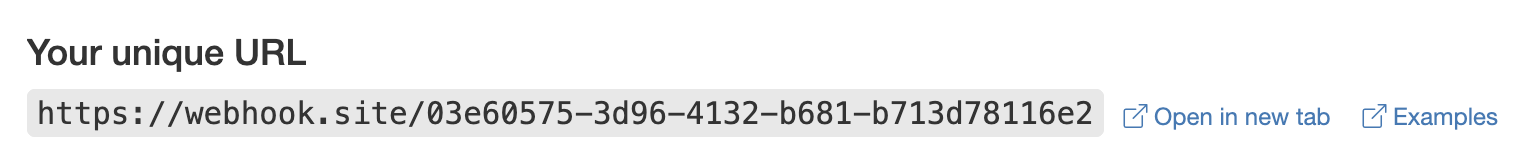 將此 URL 複製下來,就可以作為 Webhook 來使用,此處的範例為 https://webhook.site/03e60575-3d96-4132-b681-b713d78116e2。
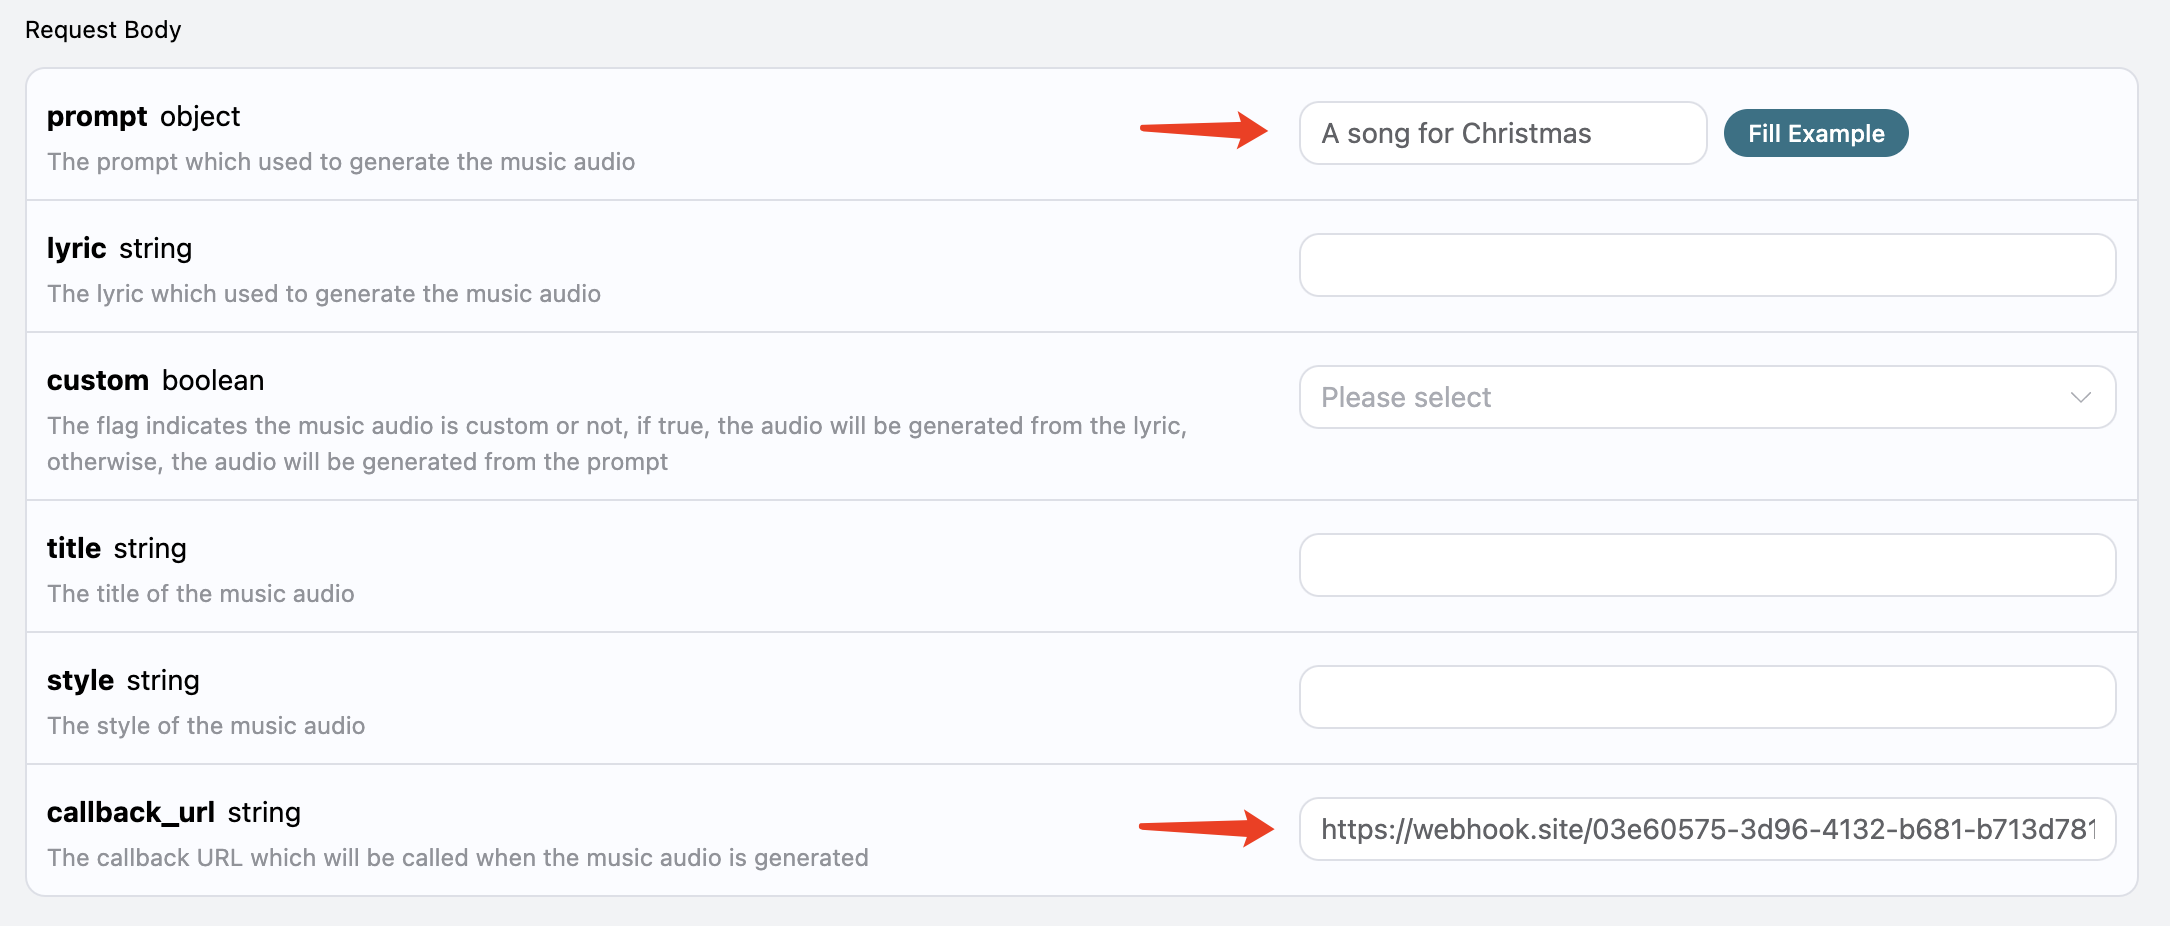
接下來,我們可以設定欄位
callback_url 為上述 Webhook URL,同時填入 prompt,如圖所示:
 點擊執行,可以發現會立即取得一個結果,如下:
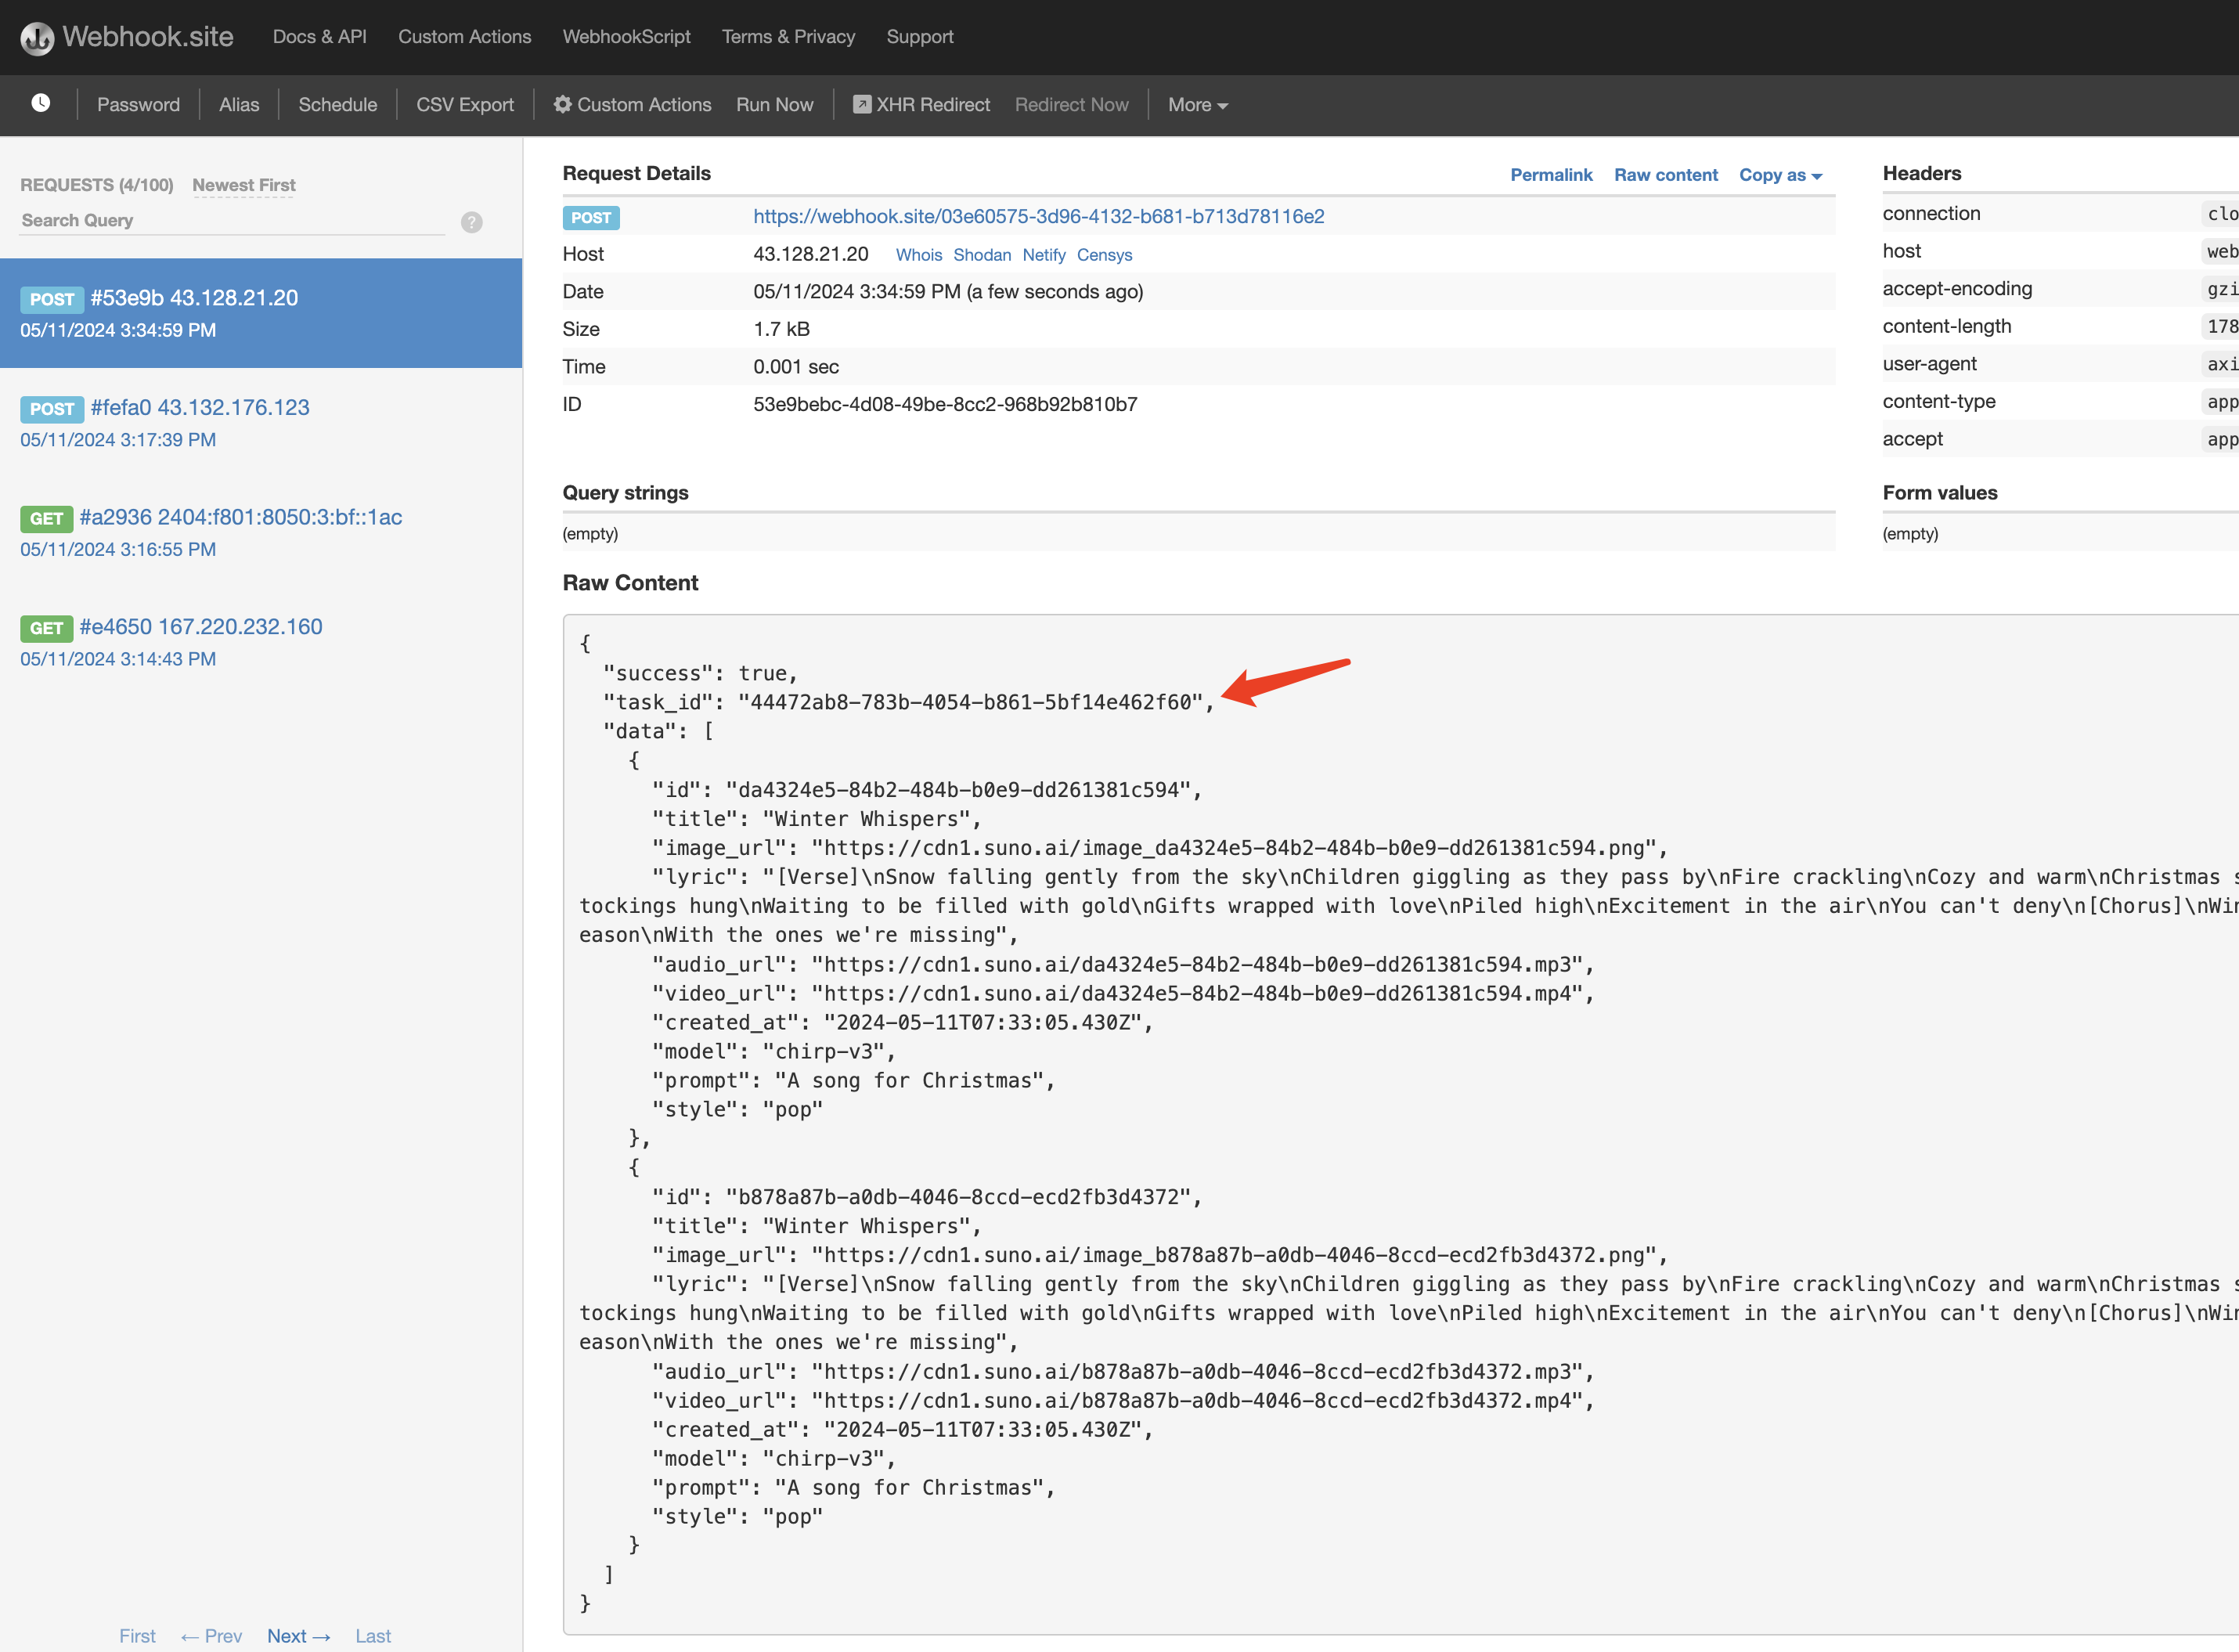 內容如下:
task_id 欄位,其他的欄位都和上文類似,透過該欄位即可實現任務的關聯。
當然我們也可以透過串流呼叫來取得結果,我們只需要將請求標頭裡面的accept值設定為application/x-ndjson即可,下面用一個範例輸入作為示範:
task_id 依序推送處理中狀態與最終結果;上方僅保留首次與終態兩筆真實回應,省略重複的中間更新。
錯誤處理
如果發生錯誤,您將得到類似如下的錯誤訊息:error.code、error.message 的列表:
說明:不同上游帳號的額度與錯誤訊息文字可能有所差異。通常chirp-v3-5/chirp-v4的style限制較低(200),chirp-v4-5及以上通常支援至 1000;當命中舊版上游時,可能出現Tags too long.或style must be less than or equal 120等相容文字。 | 狀態碼 |error.code|error.message| | ------ | ----------------------------- | ------------------------------------------------------------------------------------------ | | 400 |bad_request|歌曲 ID 不存在或已被下架。| | 400 |bad_request|提示詞過長。| | 400 |bad_request|標籤過長。| | 400 |bad_request|上傳的音訊與現有作品相符。| | 400 |bad_request|instrumental 必須為布林值| | 400 |bad_request|標題過長。| | 400 |bad_request|主題過長。| | 400 |bad_request|style 必須小於或等於 120| | 400 |bad_request|custom 必須為布林值| | 400 |bad_request|延長音訊時需要 audio_id| | 400 |bad_request|延長音訊時需要 continue_at| | 400 |bad_request|continue_at 必須為大於 0 的數字| | 400 |bad_request|延長音訊且 instrumental 為 false 時需要 lyric| | 400 |bad_request|產生音訊時需要 prompt| | 400 |bad_request|產生自訂音訊時需要 lyric| | 403 |forbidden|提示詞可能格式錯誤| | 403 |forbidden|提示詞可能受著作權保護| | 403 |forbidden|提示詞包含不當內容| | 403 |forbidden|歌曲描述已被內容審核標記| | 403 |forbidden|歌曲描述包含藝人名稱| | 403 |forbidden|標籤包含藝人名稱| | 403 |forbidden|歌詞包含受著作權保護的內容| | 403 |forbidden|歌曲描述包含製作人標籤| | 403 |forbidden|通用 openAI 錯誤| | 403 |forbidden|提示詞已被內容審核標記| | 500 |api_error|無法根據歌曲描述產生歌詞| | 500 |api_error|工作因未知錯誤而失敗| | 500 |api_error|系統中沒有可用的工作節點| | 500 |api_error|服務維護中,已暫停產生| | 500 |api_error|該帳戶可能已離線| | 500 |suno_processing_unavailable|音樂處理無法使用。請攜帶追蹤 ID 聯絡支援團隊。| | 500 |suno_model_unavailable|所選模型無法用於此操作。請攜帶追蹤 ID 聯絡支援團隊。| | 500 |suno_processing_failed|音樂處理未傳回音訊。請攜帶追蹤 ID 聯絡支援團隊。| | 504 |timeout|等待音訊產生時逾時|