

Begränsningarna förSuno stöder nulyricochstylei tabellen ovan är de övre gränserna i anpassat läge (därcustomärtrue). I det icke-anpassade inspirationsläget (därcustomärfalse) fyller man bara iprompt, vars längdgräns är 500 tecken (samma för alla modeller).
chirp-v6, chirp-v6-wild och chirp-v6-mini. Vi rekommenderar att använda chirp-v6; gamla modellnamn förblir kompatibla.
Suno tillhandahåller dock officiellt inget API. AceDataCloud erbjuder en uppsättning API:er för Suno, som simulerar integrering med Suno officiellt och kan snabbt och smidigt generera den musik som önskas.
Ansökan och användning
För att använda Suno Audios Generation API går du först till Ace Data Cloud-konsolen för att hämta din API-token och spara den som reserv. Om du ännu inte har loggat in eller registrerat dig kommer du automatiskt att omdirigeras till inloggningssidan, där du uppmanas att registrera dig och logga in. När detta är klart återgår du automatiskt till den aktuella sidan.
En API-token kan anropa alla plattformens tjänster, och du behöver inte ansöka separat för varje tjänst. Vid första ansökan får du en kostnadsfri kvot, så att du kan prova gratis; när kvoten inte räcker till kan du fylla på ett gemensamt saldo i konsolen.
📘 Fullständig dokumentation: Suno Audios Generation API →
Grundläggande användning
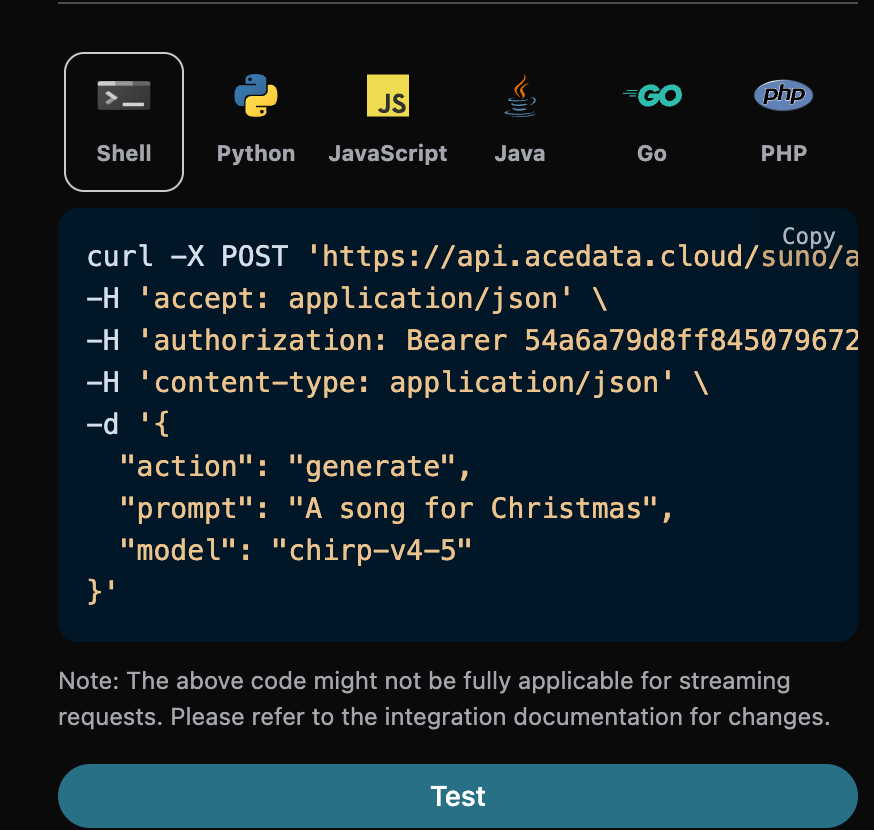
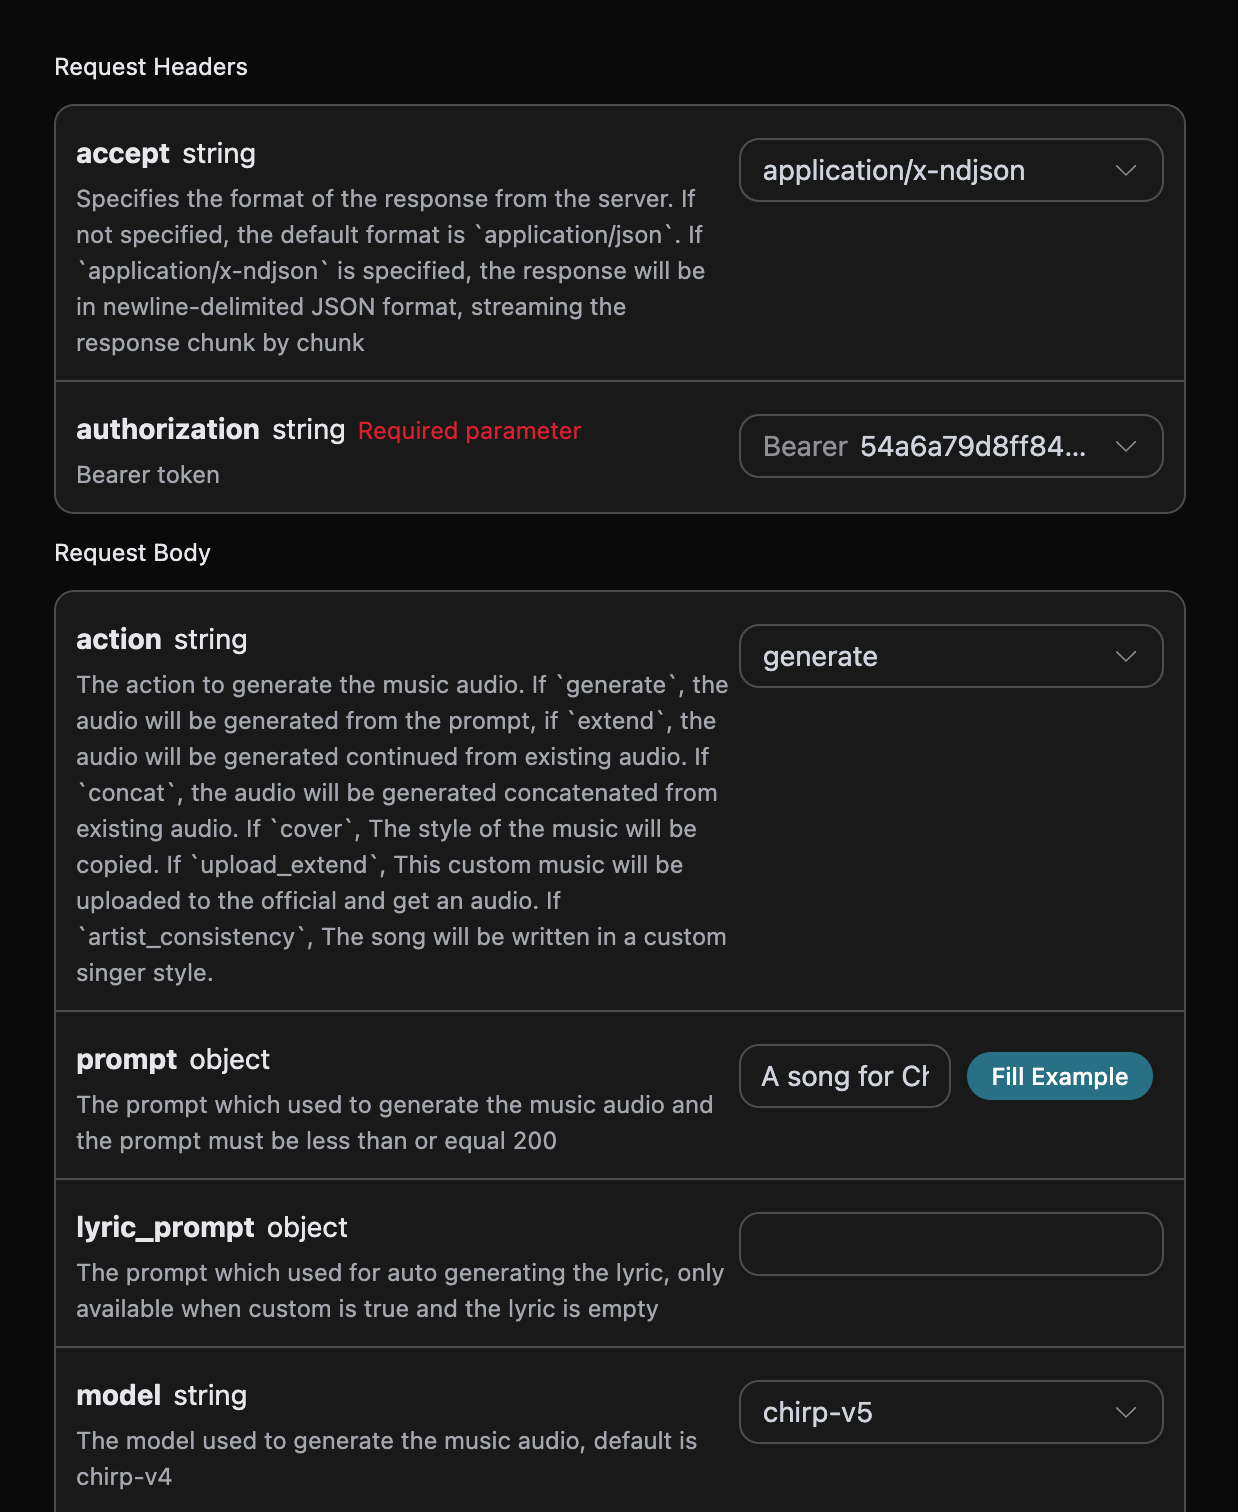
Vilken typ av låtar du vill ha kan anges med valfri text. Om jag till exempel vill generera en låt om jul kan jag angea song for Christmas, som visas i bilden:
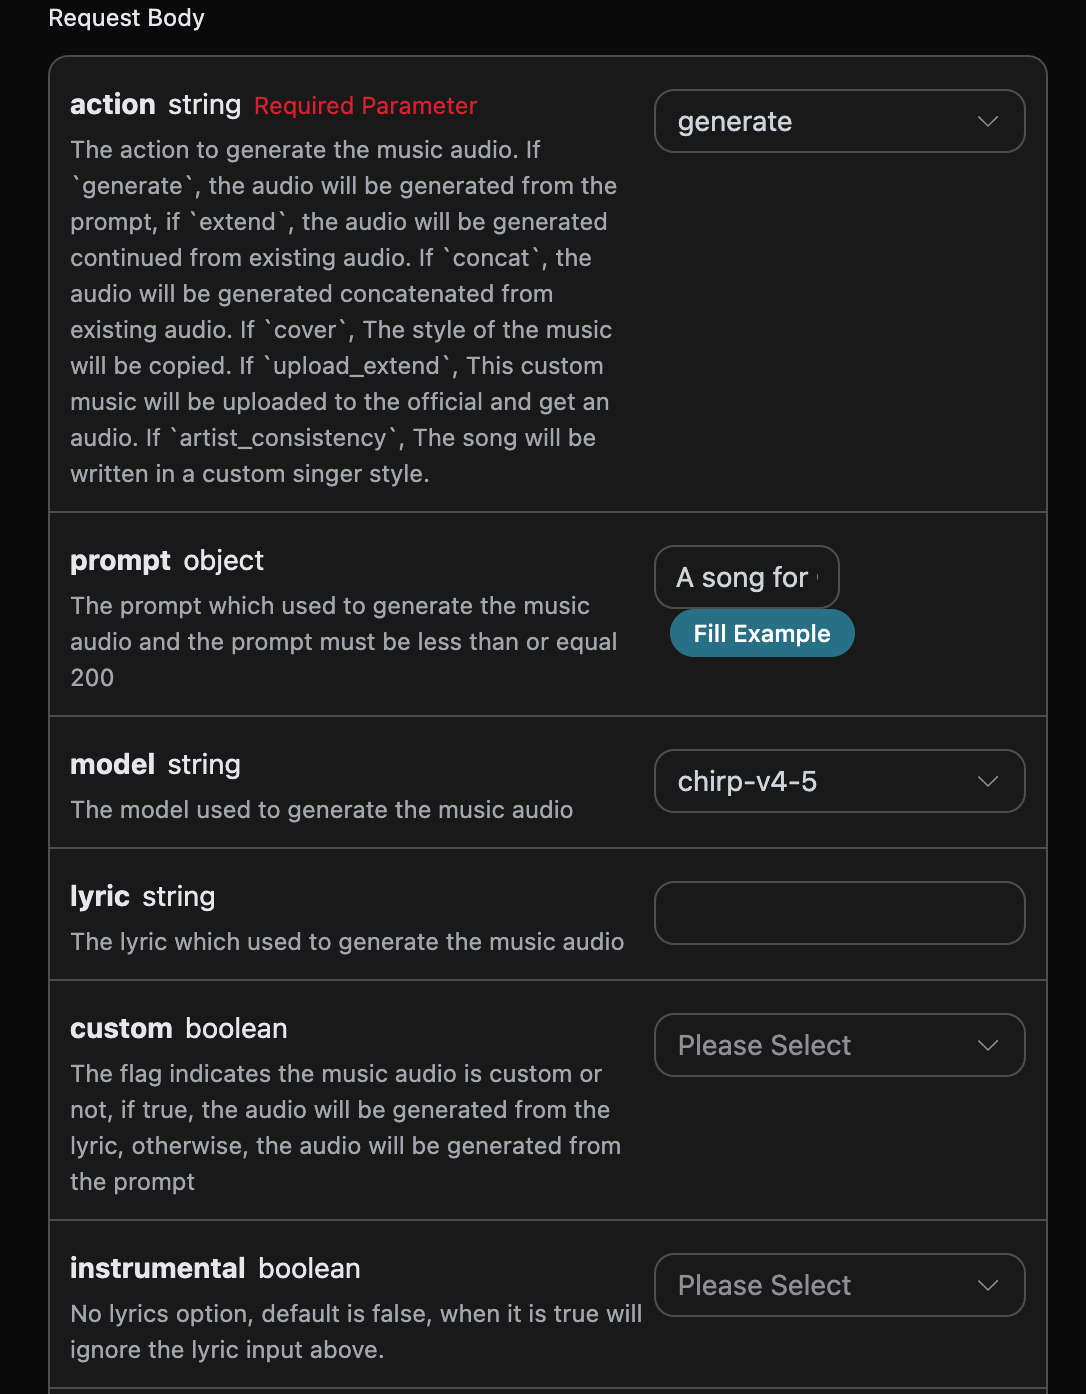
accept: vilket format på svarsresultatet som ska tas emot; här angesapplication/json, alltså JSON-format.authorization: nyckeln för att anropa API:et, som kan väljas direkt i rullgardinsmenyn efter ansökan.
action: Typ av ljuduppgift, standardvärdet ärgenerate. Stöder åtgärder som generering, fortsättning, coverversioner, sammanfogning, separering av spår, tillägg av ljudspår, extrahering av angivet ljudspår, generering av ljudeffekter och justering av hastighet, som alla anropas viaPOST /suno/audios.prompt: Sunos officiella prompt för inspirationsläge (gäller närcustomärfalse), högst 500 tecken.model: Modellen för denna musikgenereringsuppgift. v6-serien omfattarchirp-v6,chirp-v6-wildochchirp-v6-mini; äldre modellnamn är fortsatt kompatibla.max_mode: Förbättrat genereringsläge.generateaktiveras endast när bådecustomochmax_modeärtrue, till en kostnad på 1.12 Credits;add_stemkan aktiveras direkt, till en kostnad på 1.344 Credits. När det är avstängt eller utelämnat är kostnaden respektive 0.56 och 0.672 Credits.variety: Intensiteten för variation i genereringsresultaten, med alternativenoff,normal,high,extra,max. Används endast förgenerateochadd_stem; om det skickas för andra action returneras 400.lyric: Textinnehållet för Sunos officiella anpassade läge.chirp-v3-5ochchirp-v4har högst 3000 tecken;chirp-v4-5och senare (inklusivechirp-v5,chirp-v5-5) har högst 5000 tecken.custom: Om anpassat läge ska användas, standardvärdet är:false.instrumental: Alternativet för instrumental musik i Sunos officiella inspirationsläge.title: Musiktiteln för Sunos officiella anpassade läge.chirp-v3-5,chirp-v4har högst 80 tecken;chirp-v4-5och senare har högst 100 tecken.style: Musikstil för Sunos officiella anpassade läge.chirp-v3-5ochchirp-v4har högst 200 tecken;chirp-v4-5och senare (inklusivechirp-v5,chirp-v5-5) har högst 1000 tecken.negative_tags: Musikstilar eller genrer som man vill utesluta från genereringsresultaten i anpassat läge (närcustomärtrue).audio_weight: Påverkningsvikten för ljud- eller röstattribut, intervall 0–1, där även0är ett giltigt värde. Kan användas för åtgärder som generering, fortsättning, coverversioner, tillägg av ljudspår och röstkonsekvens; när det inte finns något referensljud eller några röstattribut kan modellen försvaga eller ignorera detta värde.audio_id: ID för referensmusiken.overpainting_start/overpainting_end: Start- och sluttid för att lägga till sång i befintlig instrumental musik, i sekunder.underpainting_start/underpainting_end: Start- och sluttid för att lägga till ackompanjemang till a cappella, i sekunder.persona_id: Artistens låt-ID.continue_at: Gränsen för fortsättning, i sekunder. Till exempel innebär 213.5 att efterföljande segment genereras från 3 minuter och 33.5 sekunder.lyricochstylestyr endast det nya innehållet efter gränsen och ersätter inte texten eller sången före gränsen i källjudet.style_influence: Stilpåverkan i anpassat läge, intervall 0–1; ju högre värde, desto närmare följer resultatet vanligtvis den valda stilen;0skickas som ett giltigt värde.replace_section_end: Sluttiden för ersättningssegmentet.replace_section_start: Starttiden för ersättningssegmentet.vocal_gender: Styr preferensen för kvinnlig eller manlig röst, kvinnlig röstf, manlig röstm, giltigt för modeller 4.5 och senare; är en preferens och garanteras inte att följas strikt.weirdness: Grad av konstighet i anpassat läge, intervall 0–1; ju högre värde, desto mer kreativt och experimentellt är resultatet vanligtvis;0skickas som ett giltigt värde.duration: Önskad låtlängd, i sekunder, måste vara ett heltal med värde mellan 10 och 360. Denna parameter används för låtgenerering i anpassat läge (närcustomärtrue). Den är en vägledande prompt snarare än en hård begränsning: modellen tar hänsyn till den men garanterar inte att den uppnås. Den faktiska längden på den färdiga produkten avgörs av fältetdurationi svaret och är vanligtvis kortare än det önskade värdet.
Tillämpningsområde för avancerade parametrar
Plattformen validerar parametertyper och värdeintervall, men avvisar inte dessa valfria justeringsalternativ enbart på grund av olika action; den konkreta effekten avgörs av åtgärd, läge och modell.
lyric_prompt: Prompt för att generera låttext, gäller om och endast omcustomärtrueochlyricinte har skickats.callback_url: URL som ska ta emot återkopplingsresultat.async: Valfritt, när det anges somtruereturnerar gränssnittet omedelbarttask_id, utan attcallback_urlbehöver anges, och resultatet hämtas sedan genom polling via motsvarande gränssnitt för uppgiftsfrågor.
- success: Om genereringen lyckades. Om den lyckades är värdet
true, annarsfalse. - data: Är en lista som innehåller detaljerad information om de genererade låtarna.
- state: Låtens genereringsstatus, som huvudsakligen omfattar fyra typer, enligt följande:
- succeeded: Generering lyckades
- pending: I kön
- running: Körs
- error: Misslyckades
- id: Låt-ID
- title: Låtens titel
- image_url: Låtens omslagsbild
- lyric: Låtens text
- audio_url: Låtens slutliga ljudadress. Plattformen returnerar i första hand en Ace Data Cloud CDN-adress; om beständig lagring misslyckas kan den ursprungliga medieadressen returneras, så ladda ner den i tid.
- video_url: Låtens videofil, som är en mp4-video när den öppnas.
- created_at: Tidpunkten för skapandet
- model: Modellen som används, vanligtvis den senaste v3-modellen
- style: Stil
- state: Låtens genereringsstatus, som huvudsakligen omfattar fyra typer, enligt följande:
Anpassad generering
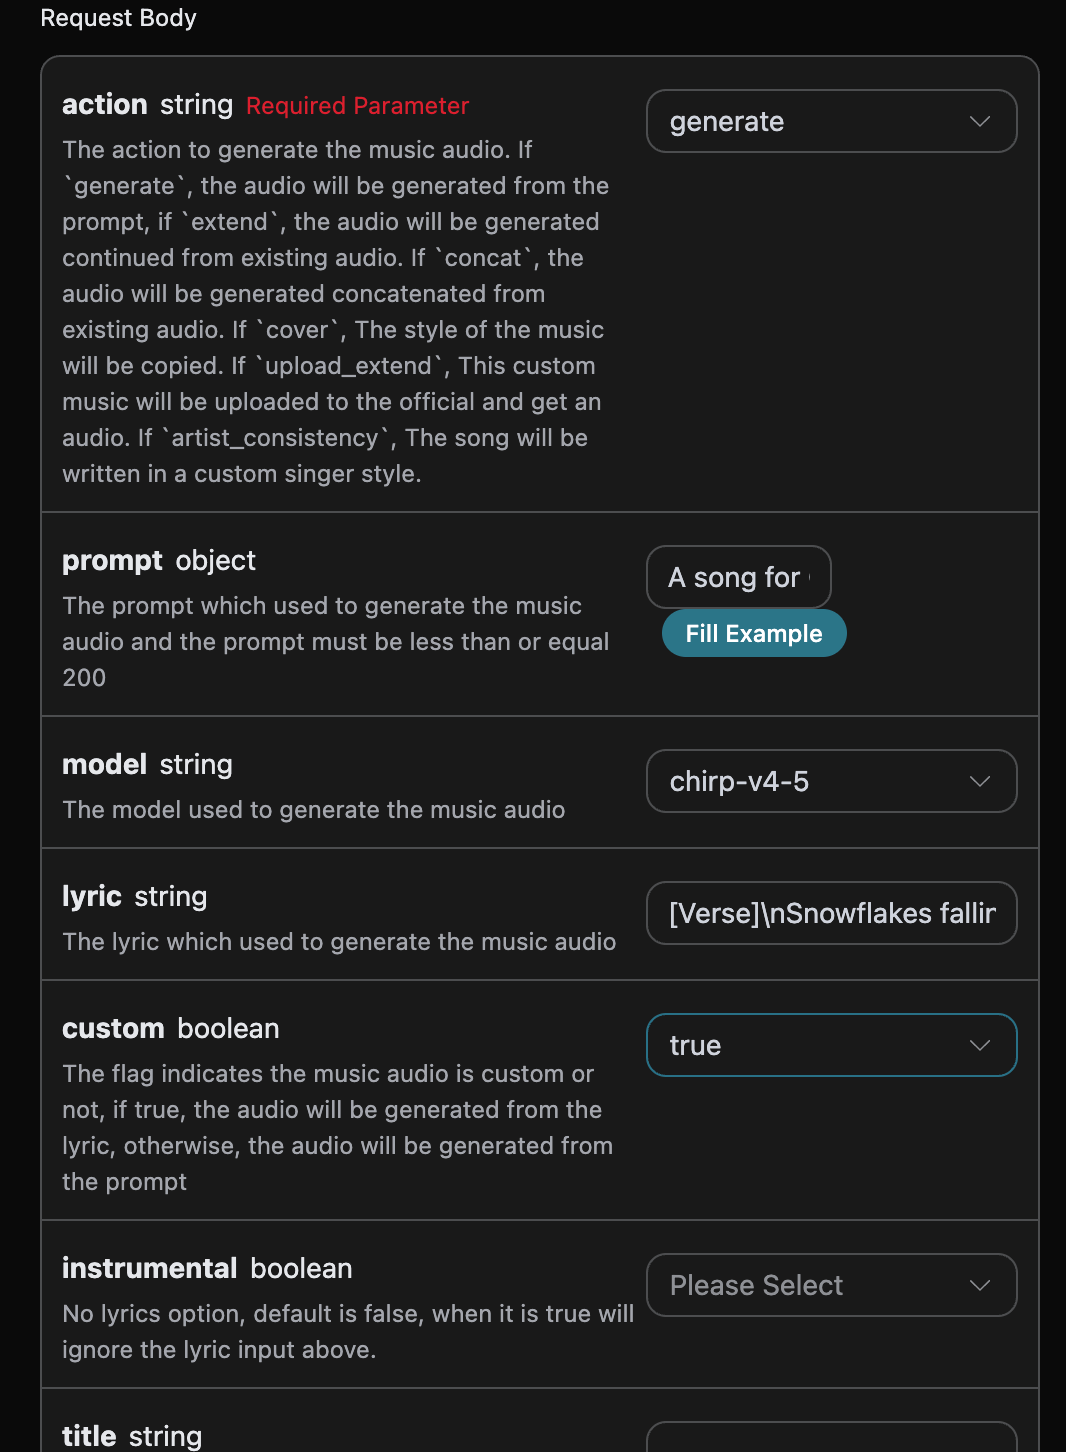
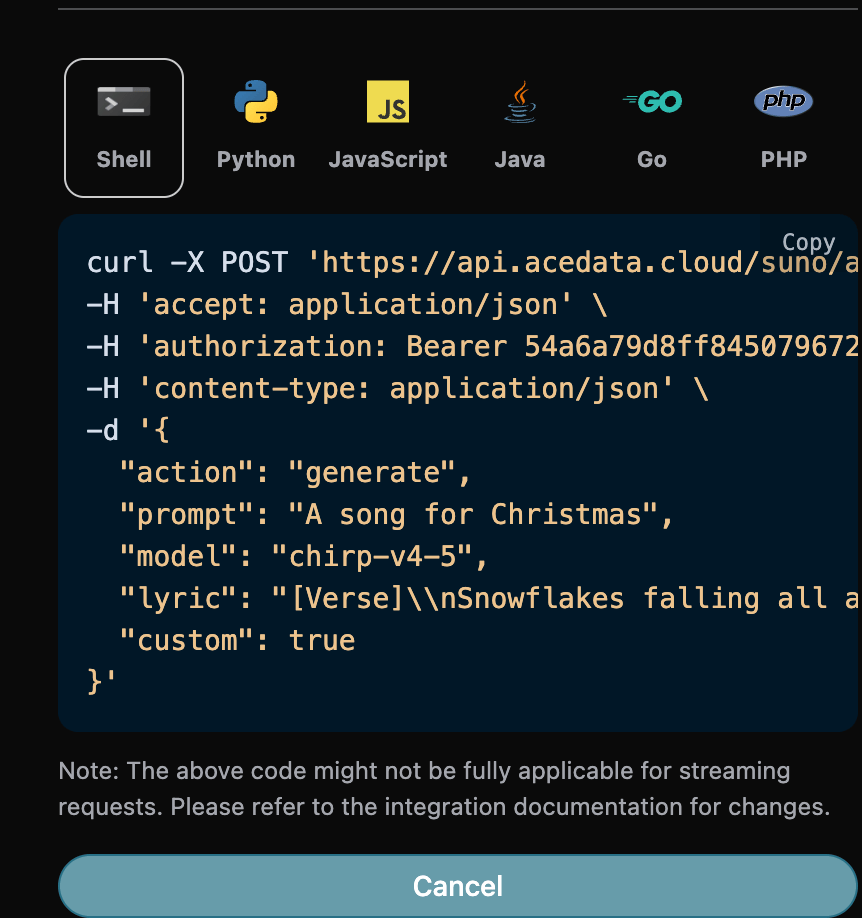
Om du vill anpassa genereringen av låttext kan du ange låttexten: Vid denna tidpunkt kan fältetlyric ta emot innehåll som följande:
Observera att \n i låttexten här är en radbrytning. Om du inte vet hur du genererar låttext kan du använda API:et för låttextgenerering som tillhandahålls av AceDataCloud för att generera låttext via prompt. API:et är Suno Lyrics Generation API.
Därefter behöver vi, för att anpassat generera en låt baserat på låttext, titel och stil, ange följande innehåll:
- lyric: Låttext
- custom: Ange
true, vilket innebär anpassad generering. Denna parameter är som standard false, vilket innebär attpromptanvänds för generering. - title: Låtens titel.
- style: Låtens stil, valfritt.
Funktion för anpassad generering av sångarstil
Om du vill använda en sångarstil för att generera en låt, generera först en låt genom den grundläggande användningen ovan, och slutligen behöver du ställa in denna låt som sångarstil. Därefter behöver du gå till Suno Persona API för att generera en sångarstils-ID-parameterpersona_id baserat på musik-ID:t audio_id som genererats officiellt. De specifika parametrarna visas i bilden nedan:
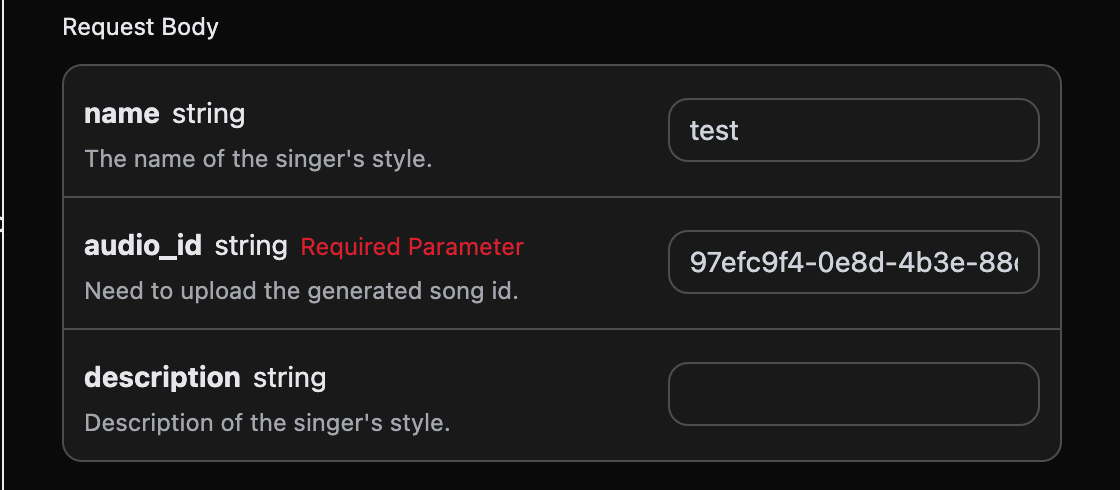
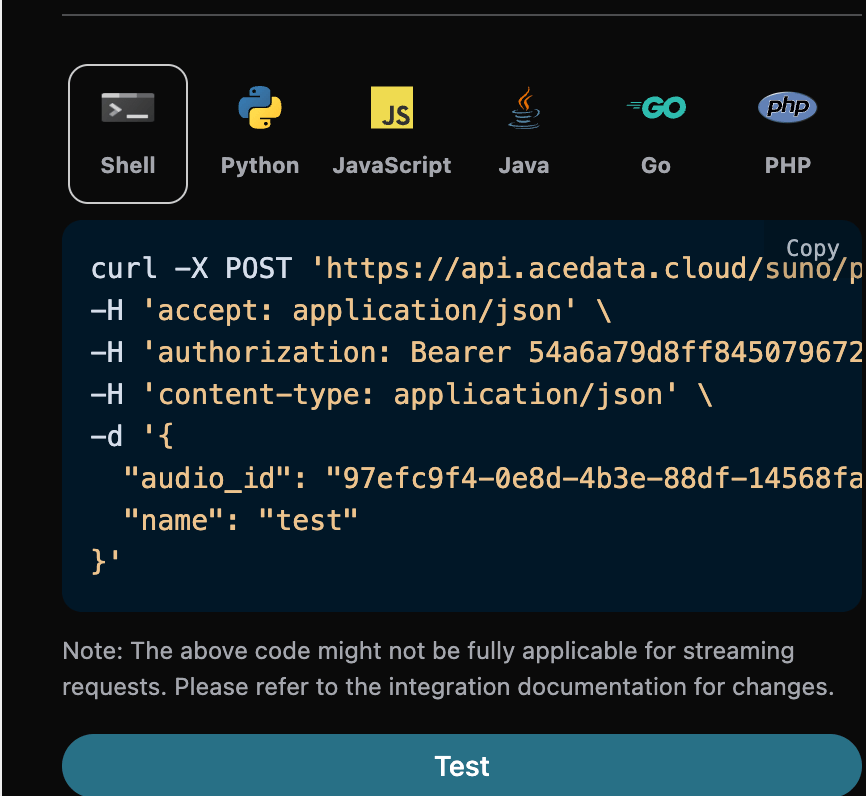
audio_id och persona_id, nämligen 97efc9f4-0e8d-4b3e-88df-14568fa1b11f respektive e0d7319e-aa2a-44cb-b00a-916218d7cb0b, som exempeldata denna gång. Sedan kan du ställa in parametern action till artist_consistency (om det är den nya sångarstilen Persona-v2-vox måste action ställas in till artist_consistency_vox), och ange ID:t för låten som behöver fortsätta genereras samt sångarstils-ID:t. Ett ifyllningsexempel visas nedan:
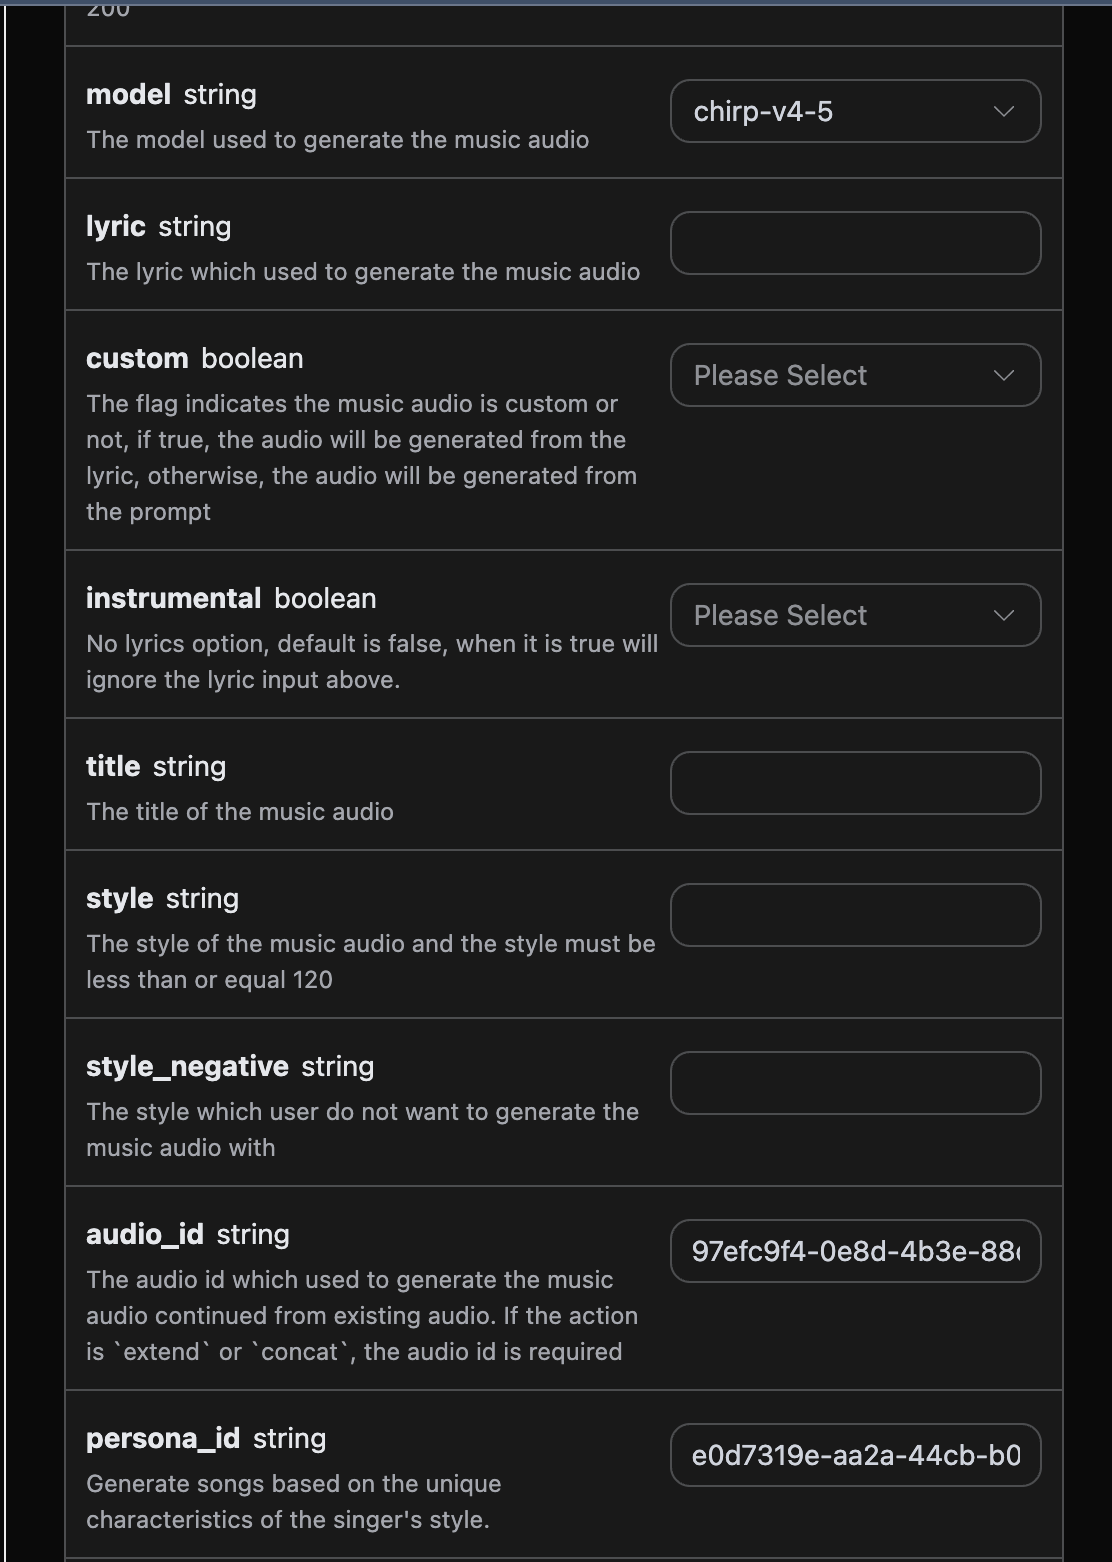
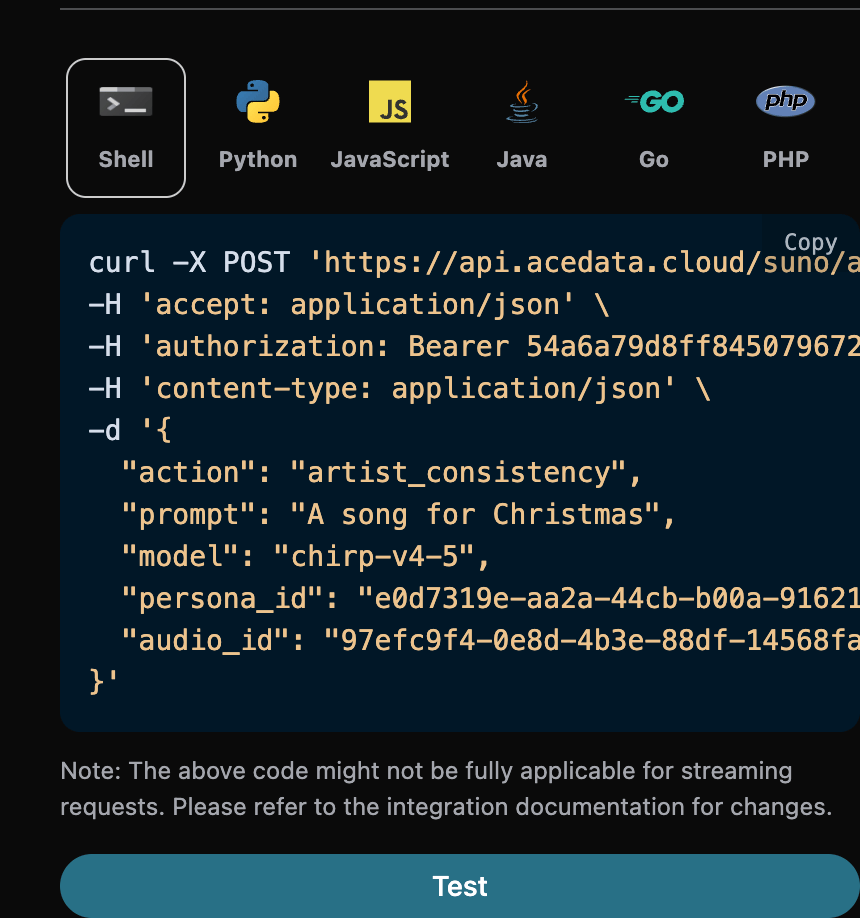
Funktionen för fortsatt generering
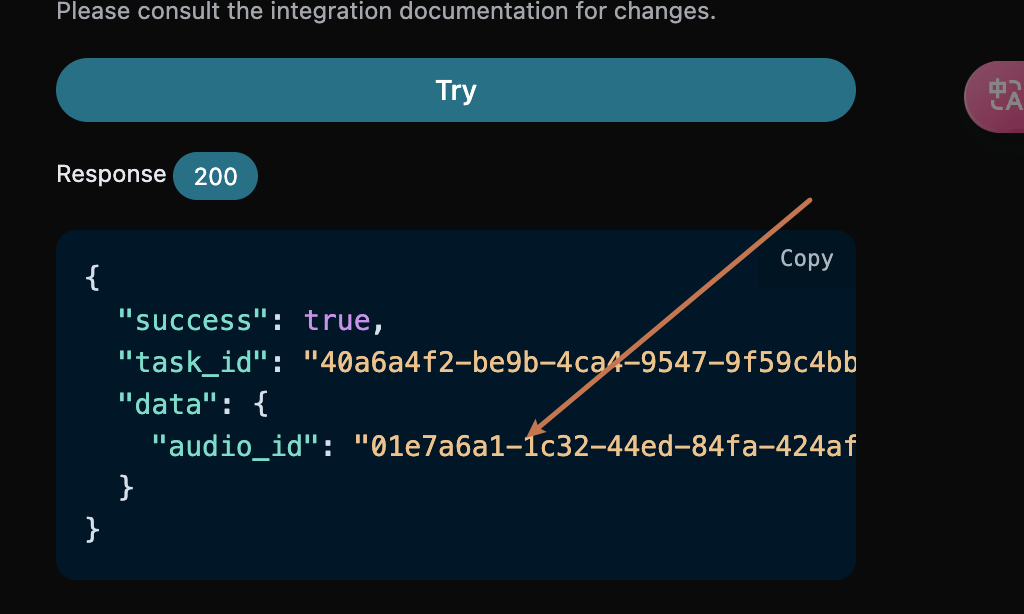
Om du vill fortsätta generera en redan genererad Suno-låt kan du ställa in parameternaction till extend och ange ID:t för låten som behöver fortsätta genereras. Låt-ID:t hämtas enligt den grundläggande användningen. Av ovanstående framgår att låtens ID vid denna tidpunkt är:
Observera att id i texten här är ID:t för den genererade låten. Om du inte vet hur man genererar en låt kan du hänvisa till den grundläggande användningen ovan för att generera en låt.
Om du vill fortsätta generera en låt som du själv har laddat upp kan du ställa in parametern action till upload_extend och ange ID:t för den anpassat uppladdade låten som behöver fortsätta genereras. Låt-ID:t hämtas med Suno Upload Generation API, som visas i bilden nedan:
- lyric: Används endast för att vägleda texten i det nyligen genererade avsnittet efter
continue_atoch ersätter inte texten före denna tidpunkt i källjudet. - custom: Ange
true, vilket innebär anpassad generering. Standardvärdet för denna parameter är false, vilket innebär attpromptanvänds för generering. - style: Låtstil för fortsättningsavsnittet, valfritt.
- continue_at: Gräns för fortsättning, i sekunder. Till exempel innebär 213.5 att efterföljande avsnitt genereras från 3 minuter och 33,5 sekunder.
Ett ifyllningsexempel visas nedan:extendanvänds för att fortsätta skapa vidare efter en befintlig låt och är inte till för att byta text för hela låten. Om du vill använda ny text för hela låten från början ska du användagenerateför att generera på nytt; om du vill omtolka med hänvisning till en befintlig låt kan du användacover. När en helt ny låttext skickas in kommer den ursprungliga texten förecontinue_atfortfarande inte att ersättas.
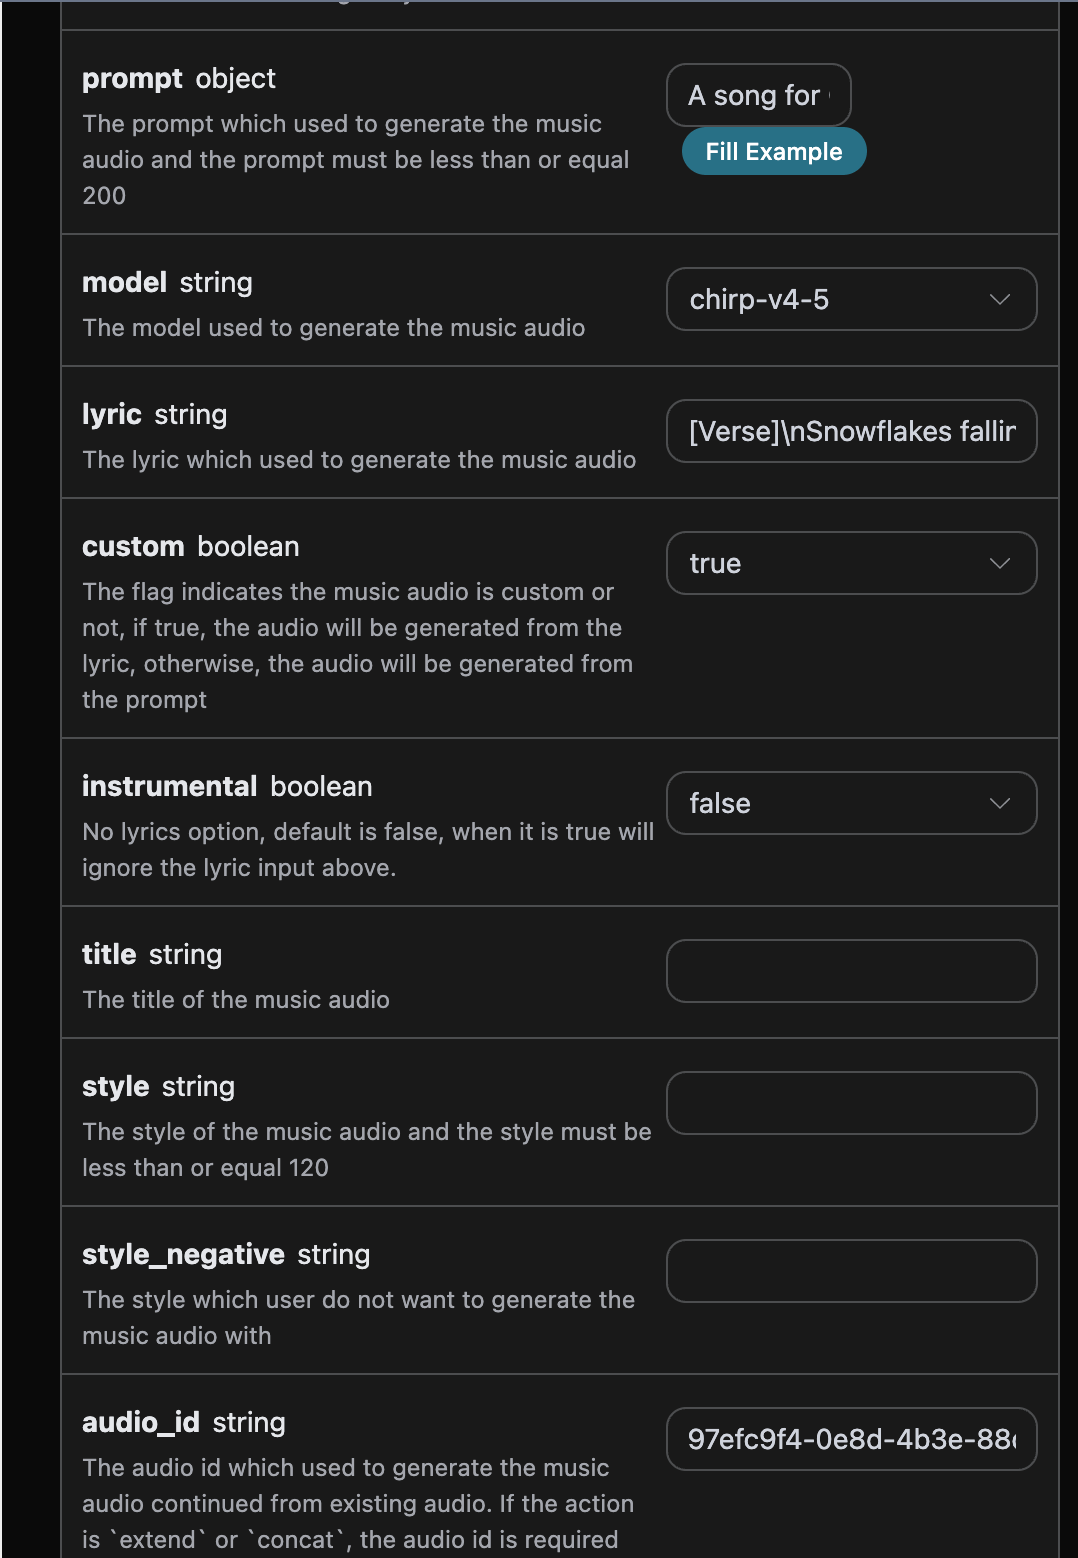
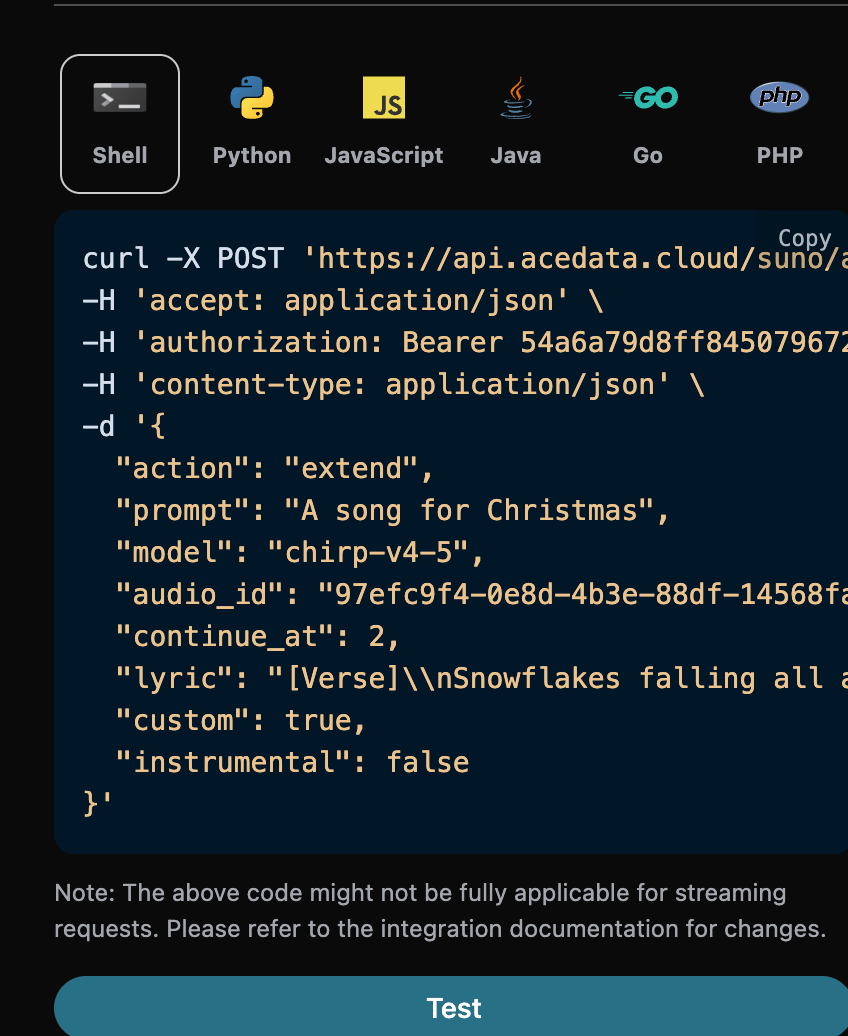
continue_at är 2 sekunder, så endast de första 2 sekunderna tillhör det ursprungliga innehållet före fortsättningsgränsen. Vid fortsatt generering nära slutet av en låt bör detta värde ställas in på den sekund där fortsatt generering förväntas börja, och endast det nya stycket som ska sjungas efter gränsen ska anges i lyric.
Motsvarande Python-kod:
lyric i resultatet returnerar den text som används av denna fortsättningsuppgift. Detta fält är inte en ordagrann transkribering av den färdiga ljudfilen; för extend använder källjudet före continue_at fortfarande den ursprungliga texten, och den nya texten används endast för att styra fortsättningssegmentet.
Hämta hela låten
Det aktuella modellensextend-resultat innehåller vanligtvis redan källjudet före continue_at och det nya innehållet efter gränsen. Bedöm först, utifrån den returnerade ljudfilens faktiska längd och innehåll, om den redan är en komplett låt. Om det som returneras är ett fristående fortsättningssegment, eller om historiken från flera fortsättningar behöver slås samman explicit till en låt, använd sedan sammanfogningsfunktionen:
- action: innehållet är
concat. - audio_id: ID:t för det sista fortsättningssegmentet.
Musikcover
Efter att en låt har fortsatt att genereras baserat på en befintlig låt kan stilen på den returnerade låten vara mindre lämplig. Om du vill göra ett cover på den tidigare genererade låten (det stöds även för anpassat uppladdad musik), behöver du använda metoden för musikcover, där du kan ange följande innehåll:- action: Innehållet är
cover; när du utför en coveråtgärd på anpassat uppladdad musik måste innehållet anges som:upload_cover. - audio_id: ID:t för den tidigare genererade låten.
Ersätt segment
När en separat sekundär bearbetning behöver utföras för att ersätta ett låtsegment efter att låten har genererats, kan ett visst segment av låten ersättas.⚠️ Observera:Parametrarna beskrivs enligt följande:replace_section_result_modeär som standardfull_song: systemet sammanfogar 2 nygenererade kandidater var för sig och returnerar 2 fullständiga låtar. Om endast kandidater för ersättningssegment som ännu inte har sammanfogats behövs, ange uttryckligencandidatesoch välj sedan en kandidat för att anropa musiksammanfogning.
- action: Innehållet är
replace_section. - audio_id: ID:t för den ursprungliga låten (källåten som ersätts).
- model: Modell för låtgenerering.
- lyric: Den fullständiga ersatta låttexten (inklusive det ersatta segmentet och dess kontext, i överensstämmelse med innehållet i
prompt). - prompt: Den nya låttexten för segmentet som behöver ersättas.
- style: Låtens stil, valfritt.
- replace_section_start: Starttiden (sekunder) för det ersatta segmentet i originallåten.
- replace_section_end: Sluttiden (sekunder) för det ersatta segmentet i originallåten.
- replace_section_result_mode: Returläge, standardvärdet är
full_song.full_songsammanfogar 2 kandidater var för sig och returnerar 2 fullständiga låtar;candidatesreturnerar 2 kandidatssegment som ännu inte har sammanfogats.
Steg ett: Starta en uppgift för att ersätta segment
Om ID:t för den ursprungligen genererade låten till exempel är: 18db7ed0-2b8a-41db-91c1-b0781dcca0d4 (med en längd på 94,12 sekunder), och du vill ersätta refrängen från sekund 30 till sekund 60 med ny låttext, kan du ange parametrarna enligt följande:replace_section_result_mode sätts till candidates returneras 2 ännu ej sammanfogade ersättningssegment, med samma struktur som i exemplet nedan:
candidates är längden på de två returnerade ljudspåren (45,16 sekunder, 33,8 sekunder) mycket kortare än originallåten (94,12 sekunder). De är ersättningssegment som innehåller lite kontext och är inte hela låtar. Du kan välja en kandidat du är nöjd med och fortsätta att sammanfoga den manuellt. Standardläget full_song slutför däremot två sammanfogningar och returnerar direkt 2 kompletta låtar.
Returnera kompletta låtar direkt
Om du vill få kompletta låtar direkt kan du i steg ett angereplace_section_result_mode som full_song. Gränssnittet sammanfogar de två kandidaterna var för sig och returnerar 2 kompletta låtar; då behöver du inte längre anropa concat.
Steg två: sammanfoga ersättningssegmentet tillbaka till originallåten
För det valda segmentet ovan (till exempel364f9d8b-ca25-463b-9a5e-d0b7139e2d6a), starta en concat-uppgift enligt metoden i avsnittet Musiksammanfogning:
duration återställts till hela låtens längd (105,28 sekunder, ungefär lika med originallåtens längd), och audio_url pekar på den färdiga hela låten efter ersättningen. Detta slutför processen för sekundär skapande: “generera → ersätt segment → sammanfoga hela låten”.
Separation av sång och musik
När sekundär skapande kräver separata åtgärder för komp och sång efter att en låt har genererats, kan rent musikaliskt komp och a cappella-sång separeras. Då kan följande innehåll anges:- action: innehållet är
stems. - audio_id: ID:t för den tidigare genererade låten.
Separation av sång och musik för alla spår
När det efter att en låt har genererats krävs en separation av sång och musik för alla spår, kan följande innehåll anges:- action: innehållet är
all_stems. - audio_id: ID:t för den tidigare genererade låten.
Lägg till ljudspår
add_stem genererar ett mål-instrument- eller röstspår för det angivna ljudet och anropas via POST /suno/audios.
- Obligatoriskt:
action,audio_id,stem_type. - Valfritt:
model,prompt,title,style,negative_tags,weirdness,style_influence,audio_weight,max_mode,variety. - Debitering: normalt läge 0.672 Credits; när
max_modeärtrueär det 1.344 Credits.
Extrahera ljudspår
extract_stem extraherar målljudspåret från det angivna ljudet och returnerar samtidigt en kompletterande version där detta ljudspår har tagits bort, genom anrop via POST /suno/audios.
- Obligatoriskt:
action,audio_id,stem_type. - Valfritt:
audio_format, det nuvarande offentliga tvåkanalskontraktet stöder endastmp3. - Debitering: 1.12 Credits.
data i svaret i slutligt tillstånd behåller en platt ljudlista, och stem_sets anger relationen mellan målljudspåret och det kompletterande ljudspåret:
Generera ljudeffekter
sounds genererar engångs- eller loopbara ljudeffekter baserat på textbeskrivningar och anropas via POST /suno/audios.
- Obligatoriskt:
action,sound,sound_type. - Valfritt:
model,bpm,key,audio_format;audio_formatstöder för närvarande endastmp3. sound_type:one-shotellerloop.- Debitering: 0.112 Credits.
Justera ljudhastighet
adjust_speed justerar uppspelningshastigheten för det angivna ljudet och anropas via POST /suno/audios.
- Obligatoriskt:
action,audio_id,speed_multiplier,title. - Valfritt:
keep_pitch. speed_multiplier: intervall 0.25–4.- Debitering: 0.28 Credits.
Avancerade parametrar för anpassad generering
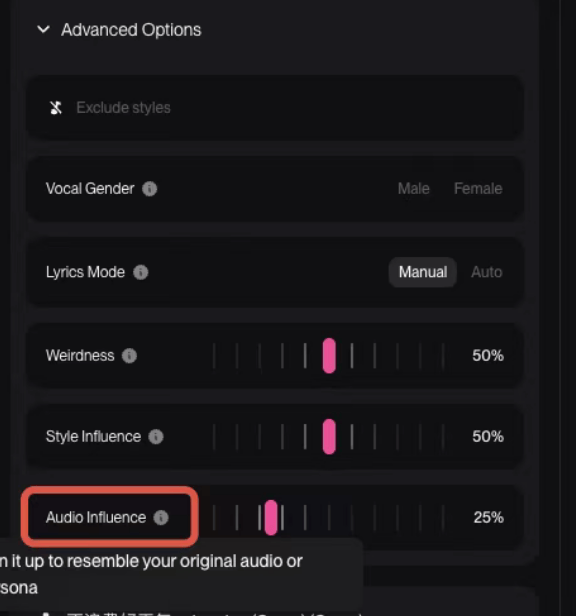
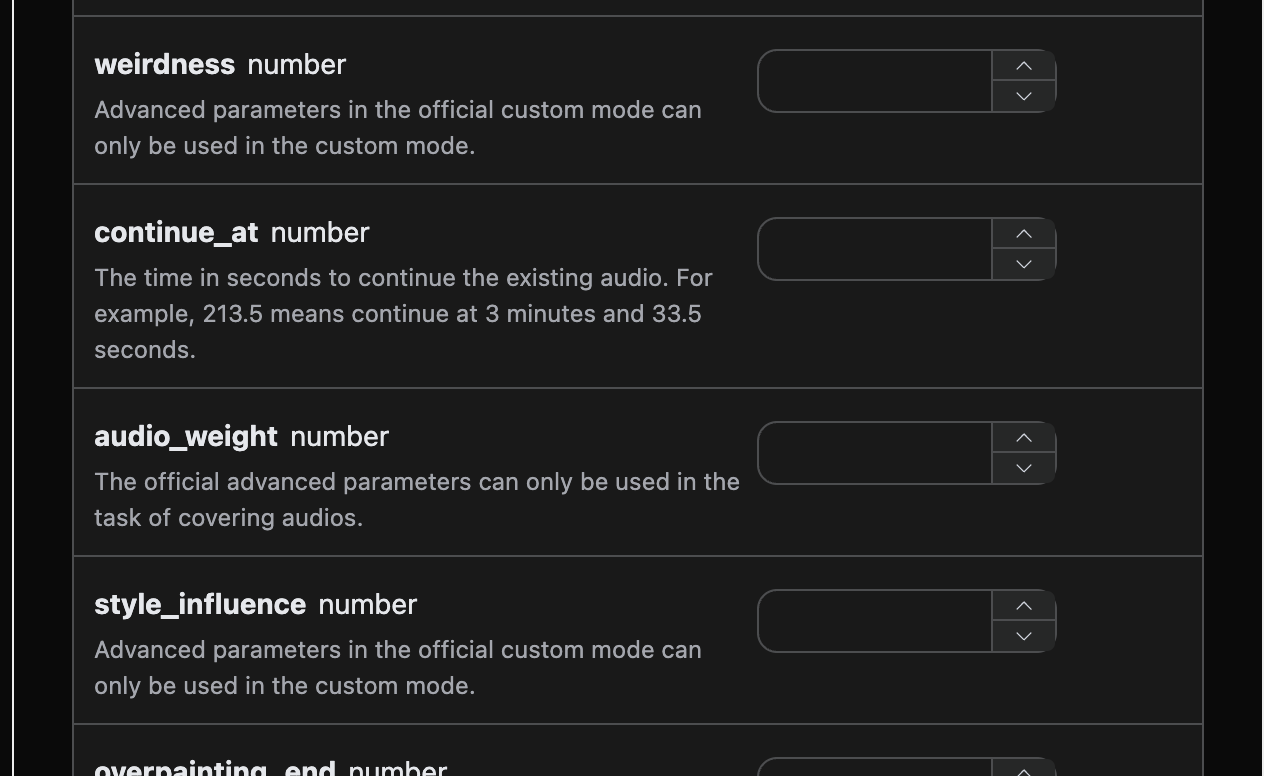
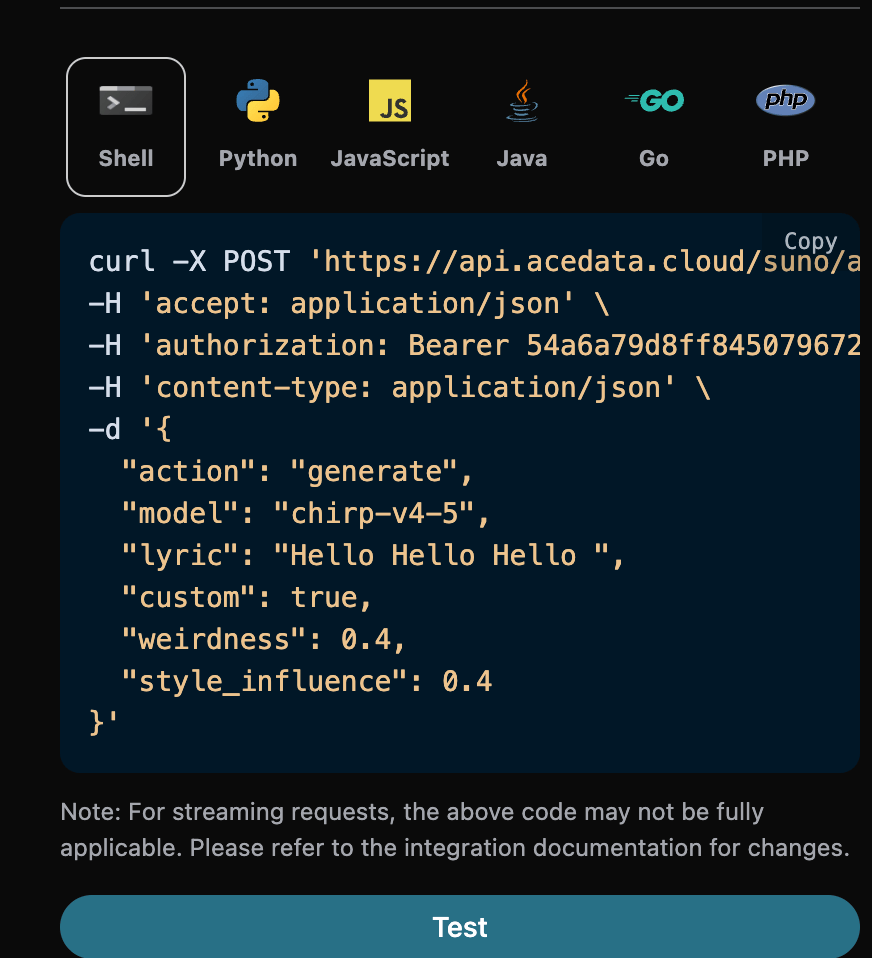
Officiellt tillåts användning av de avancerade parametrarnaweirdness==>Weirdness, style_influence==>Style Influence, audio_weight==>Audio Influence för generering i anpassat läge, vilket motsvarar följande officiella exempel:
Kontrollera låtlängd
Som standard bestäms längden på den genererade låten av modellen själv, vanligtvis mellan 30 sekunder och 4 minuter. Om en längre eller kortare slutprodukt behövs kan den önskade längden anges via parameternduration, enheten är sekunder och värdet är ett heltal mellan 10 och 360.
Denna parameter används för låtgenerering i anpassat läge (custom är true). Det bör särskilt förklaras att duration är en riktgivande antydan, inte en hård begränsning: modellen kommer att hänvisa till detta värde när den skapar, men garanterar inte att uppnå det. I praktiska tester är den faktiska längden vanligtvis tydligt kortare än det förväntade värdet, och längden på de två låtar som returneras av samma förfrågan kan också skilja sig flera gånger om. Även för helt identiska förfrågningar kan längden som erhålls vid flera inskick skilja sig mycket. Använd därför inte detta som exakt längdkontroll; om verksamheten kräver en fast längd, beskär eller försök igen själv efter att slutprodukten har erhållits.
Motsvarande Python-kod:
duration i begäran är den förväntade längden, medan fältet duration för varje låt i svarets data är den låtens faktiska längd. De har samma namn men olika betydelser, och den faktiska längden garanteras inte vara lika med det förväntade värdet. Textlängden är en av de främsta faktorerna som påverkar den färdiga produktens längd; om du behöver en längre färdig produkt rekommenderas det att du samtidigt tillhandahåller mer fullständiga låttexter.
Gränssnittet validerar att duration måste vara ett heltal mellan 10 och 360; det är fortfarande bara ett genereringsmål, inte en garanti för den färdiga produktens längd.
Add Insterumental-funktion
I augusti 2025 lanserade suno den nya Add Insterumental-funktionen. Först behöver du ladda upp en a cappella-låt utan ackompanjemang, så att suno kan hjälpa dig att lägga till musik. Du kan först gå till Suno Upload API för att ladda upp en a cappella-låt utan ackompanjemang. Motsvarande åtgärd visas i bilden nedan: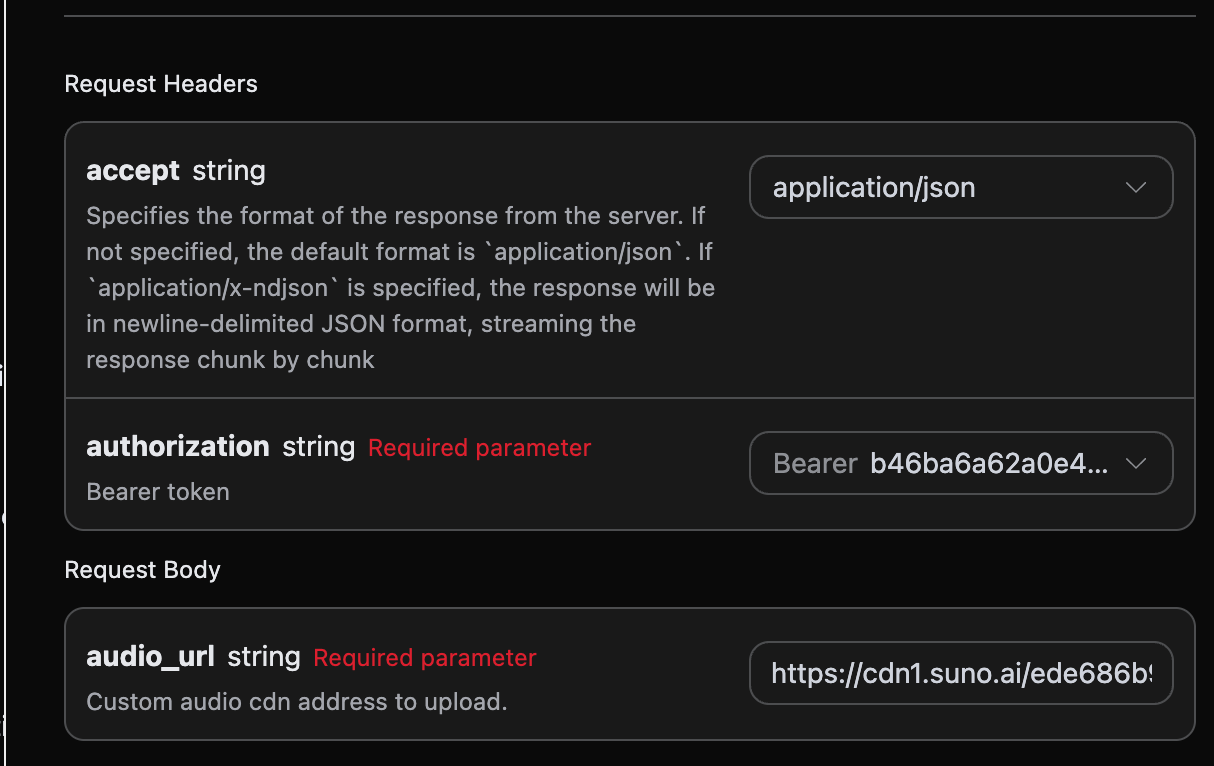
audio_id efter uppladdningen. Det specifika resultatet visas i bilden nedan:
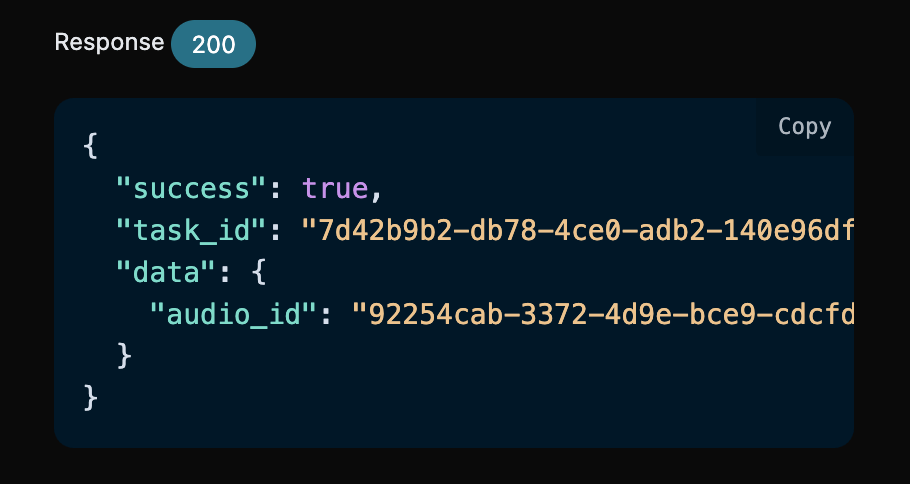
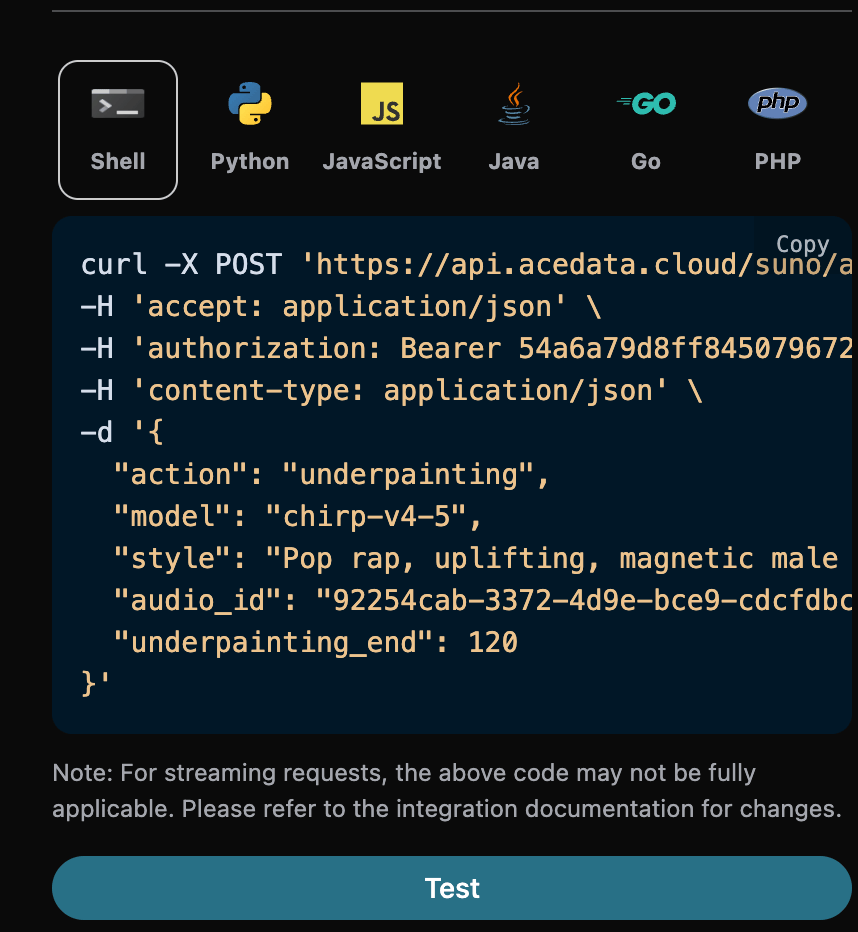
audio_id: 92254cab-3372-4d9e-bce9-cdcfdbc39070, och sedan behöver vi även fylla i följande parametrar:
- action: innehållet är
underpainting. - underpainting_start: starttiden för att lägga till ackompanjemang till den uppladdade låten, standardvärdet är 0.
- underpainting_end: sluttiden för att lägga till ackompanjemang till den uppladdade låten, måste vara mindre än låtens totala längd.
- audio_id: ID för den uppladdade a cappella-låten utan ackompanjemang.
- style: stilen på ackompanjemanget, det är bäst att inte använda låttext eftersom det är ackompanjemang.
Add Vocals-funktion
I augusti 2025 lanserade suno den nya Add Vocals-funktionen. Först behöver du ladda upp ett rent instrumentalt stycke, så att suno kan skriva text och skapa sång med mänsklig röst. Du kan först gå till Suno Upload API för att ladda upp en a cappella-låt utan ackompanjemang. Motsvarande åtgärd visas i bilden nedan:
audio_id efter uppladdningen. Det specifika resultatet visas i bilden nedan:
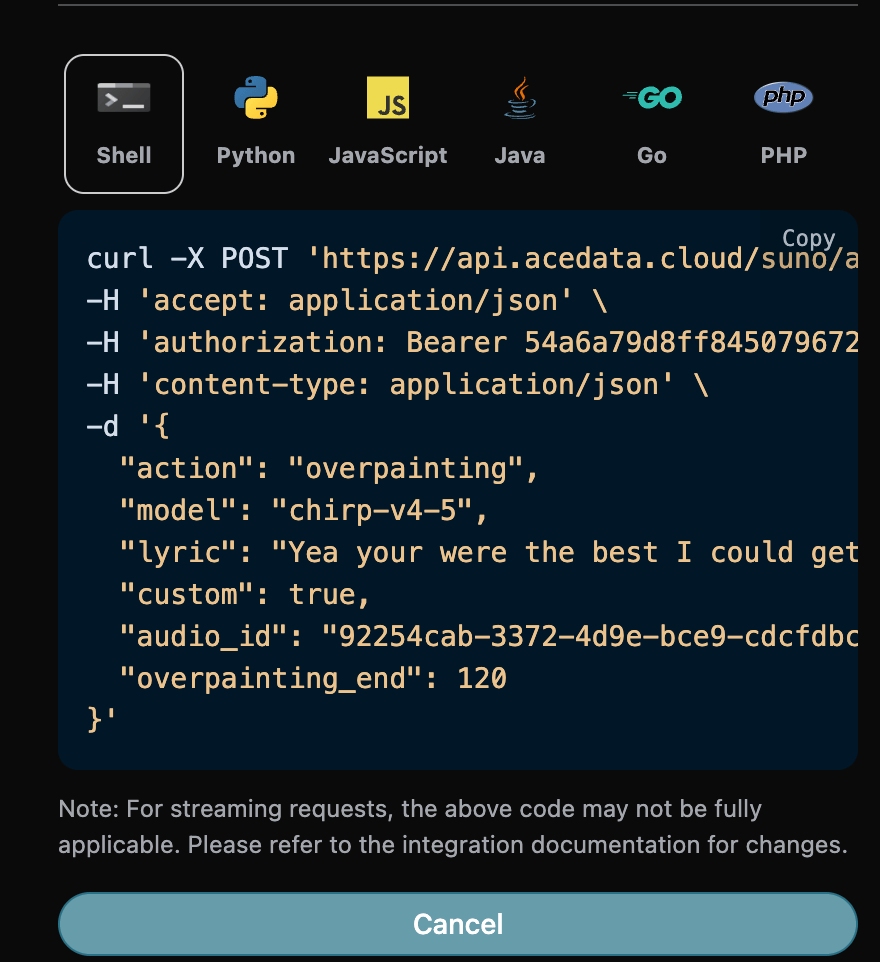
audio_id: 92254cab-3372-4d9e-bce9-cdcfdbc39070, och sedan behöver vi även fylla i följande parametrar:
- action: innehållet är
overpainting. - overpainting_start: starttiden för att lägga till sång till den uppladdade låten, standardvärdet är 0.
- overpainting_end: sluttiden för att lägga till sång till den uppladdade låten, måste vara mindre än låtens totala längd.
- audio_id: ID för den uppladdade a cappella-låten utan ackompanjemang.
- custom: i detta läge måste anpassat läge användas för att fylla i låttexten.
- lyric: låttexten som fylls i under anpassat läge.
- style: stilen på ackompanjemanget.
Remaster-funktion
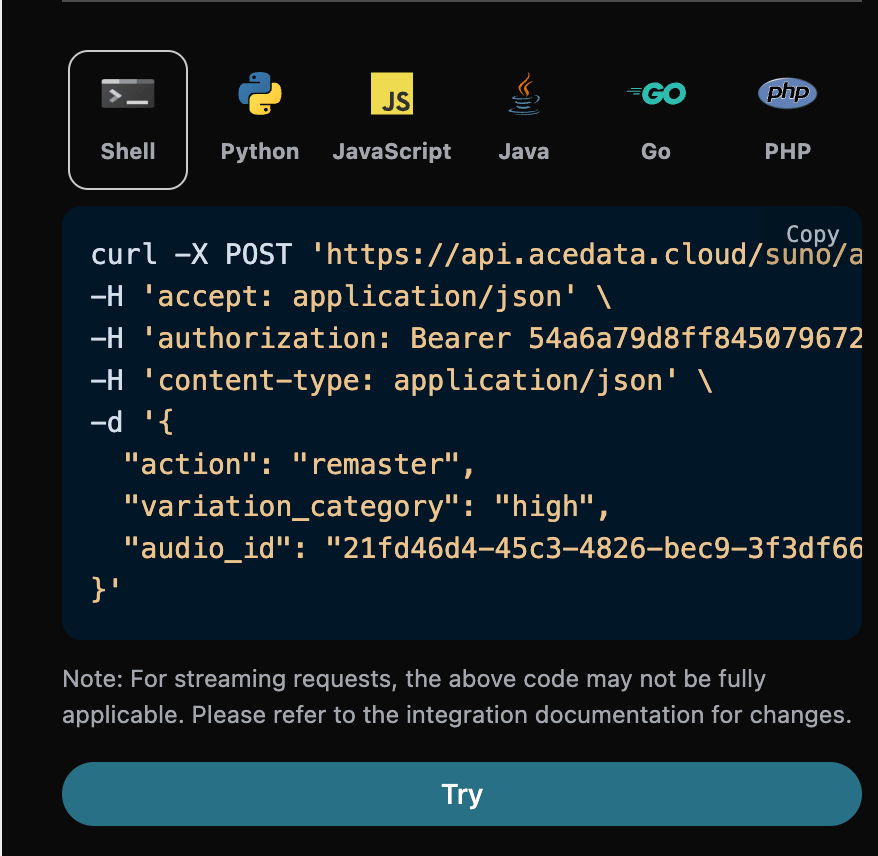
I december 2025 lanserade suno den nya Remaster-funktionen. Denna funktion kan generera låtar på nytt och kan inte användas mellan konton. Därefter behöver vi fylla i följande parametrar:- action:innehållet är
remaster。 - audio_id:ID:t för låten som behöver genereras på nytt。
- model:stöder endast v4.5+、v5。
- variation_category:stöds endast i versioner över v5, och har endast 3 värden: high normal subtle。
Mashup-funktion för generering av mixad musik
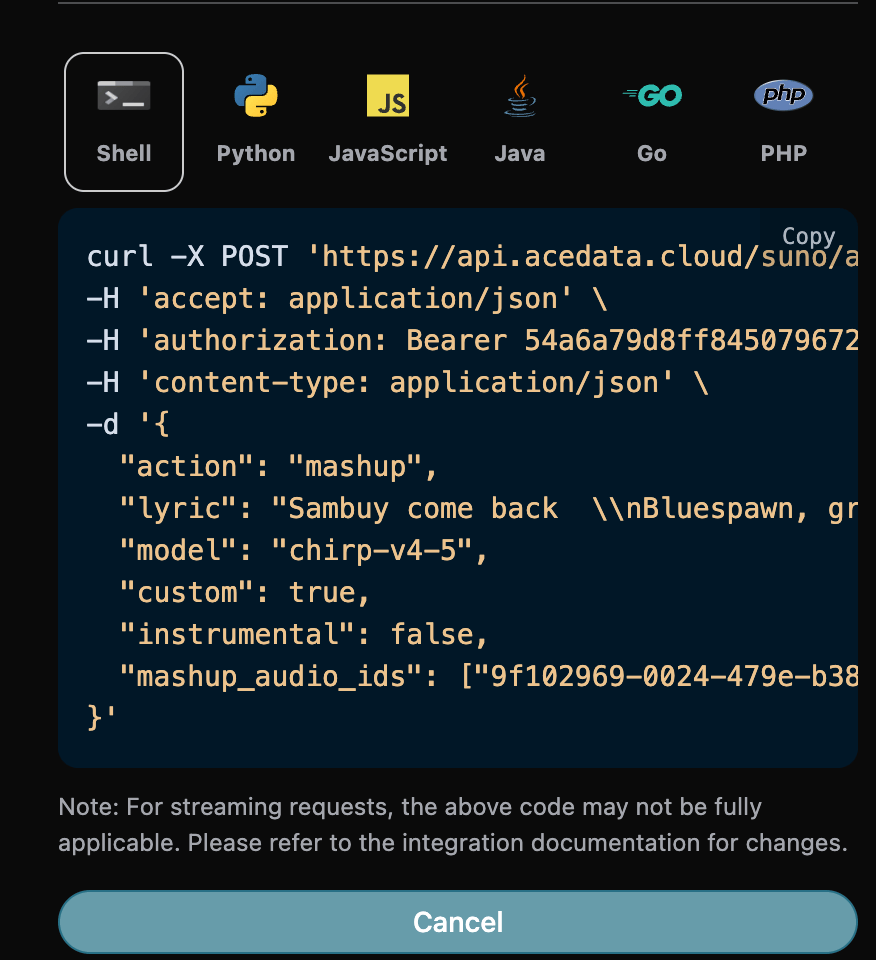
I december 2025 lanserade suno den nya Mashup-funktionen. Denna funktion kan generera låtar utifrån två referenslåtar. Därefter behöver vi fylla i följande parametrar:- action:innehållet är
mashup。 - mashup_audio_ids:ID:n för de två referenslåtarna。 Efter ifyllning genereras följande kod automatiskt:
Samples provtagning för att generera låtar
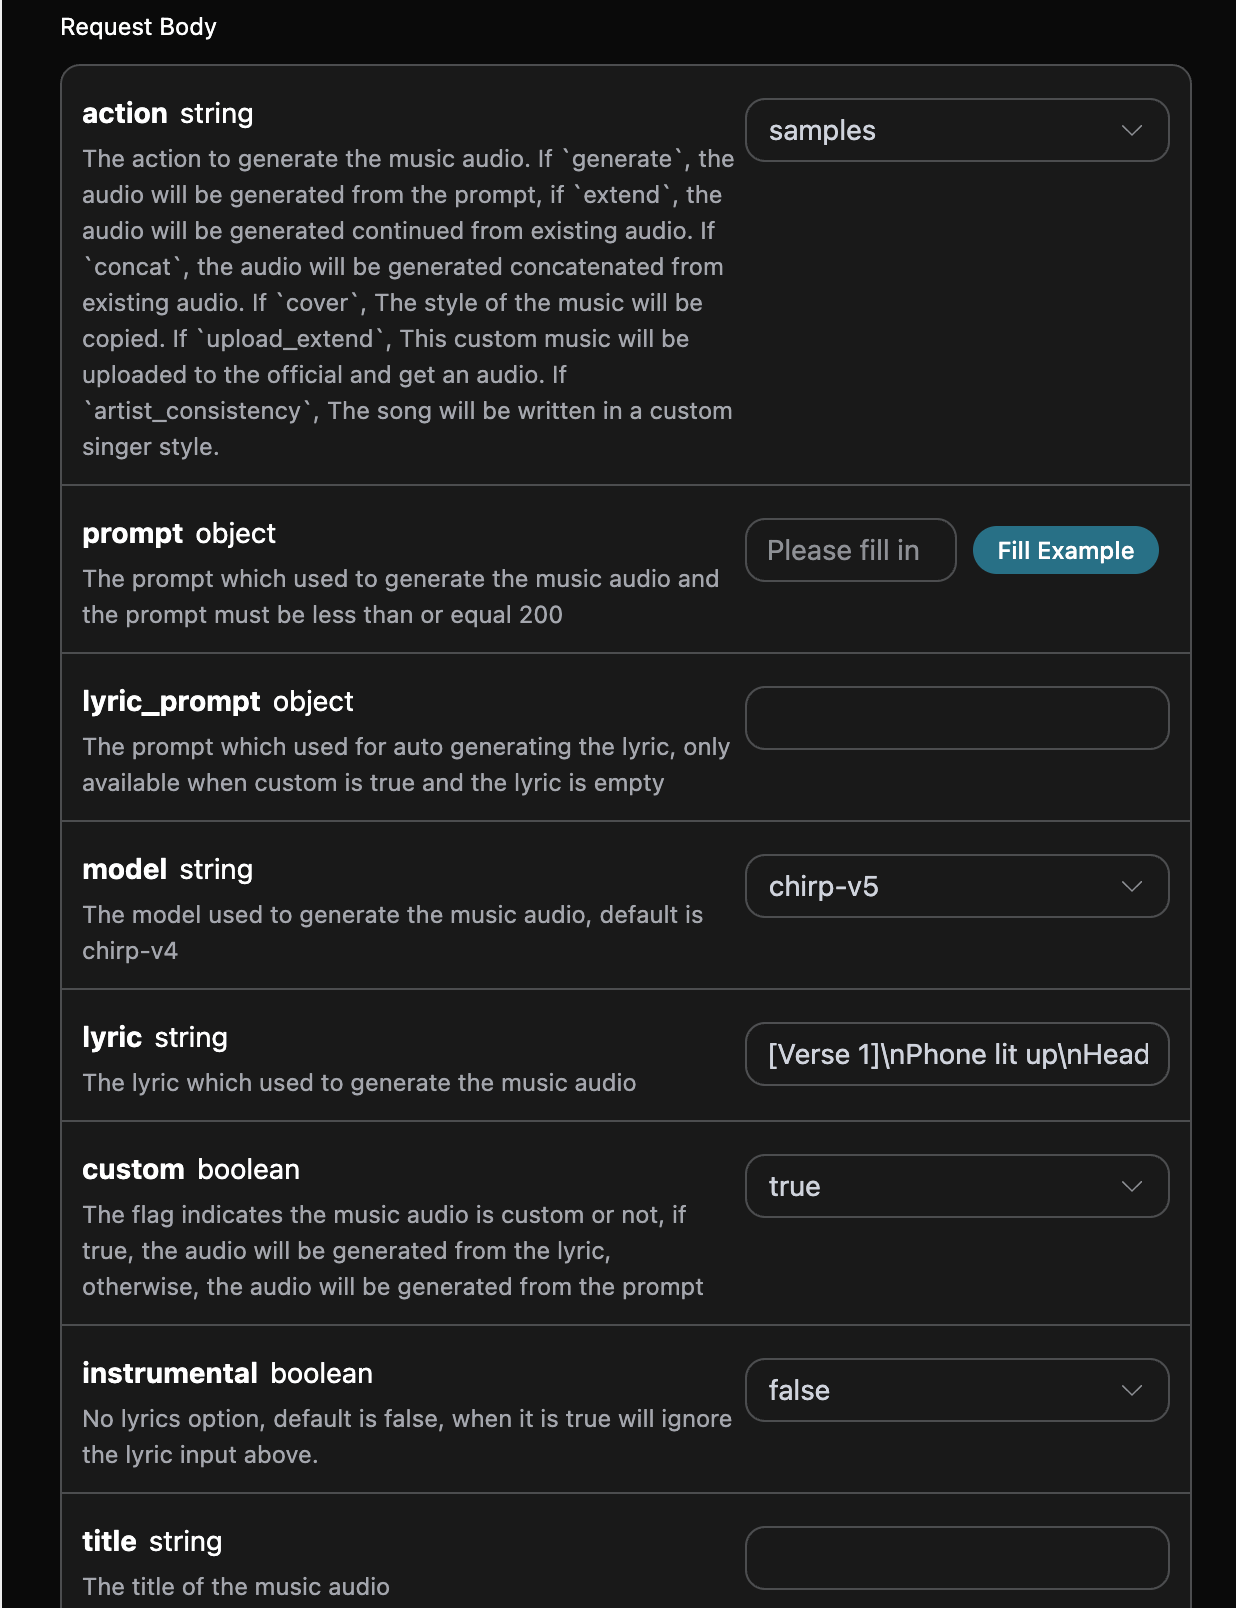
samples här avser provtagning av ett enskilt ljudintervall: välj start- och sluttid från ett befintligt ljud och använd detta segment som samplingsmaterial för skapande. Det skiljer sig från Inspo-funktionen för inspirationsskapande som använder 1 till 4 kompletta referensljudsegment längre ned. Följande parametrar behöver fyllas i:
- action: innehållet är
samples. - samples_start: provtagningens starttid.
- samples_end: provtagningens sluttid.
- audio_id: ID:t för referenslåten som ska provtas.
Inspo-funktionen för inspirationsskapande
Inspo-funktionen för inspirationsskapande kan generera ny musik baserat på 1 till 4 kompletta referensljudfiler och stöder att dra och släppa eller ladda upp ljud som inspirationskälla. API:t använder den befintligainspo-åtgärden: klienten tillhandahåller en offentligt tillgänglig ljud-URL, och tjänsten slutför automatiskt förberedelsen av referensljud och skapandet, utan att klienten separat behöver läsa in låttext, stil eller längd och sedan sätta ihop begäran. Den skiljer sig från intervallsampling ovan och även från Cover, som återskapar originalets stil. Vid användning behöver följande parametrar fyllas i:
- action: Innehållet är
inspo. - audio_urls: En lista med URL:er för referensljud; 1 till 4 offentligt tillgängliga ljudadresser måste tillhandahållas.
- model: Modellen som används;
chirp-v6rekommenderas. - prompt: Låttext eller kreativ ledtext (valfritt).
Obs: Referensljudet måste vara en offentligt tillgänglig ljudfil. Om referensljudet exakt matchar en känd inspelning i plattformens musikbibliotek kan Suno neka generering på grund av upphovsrättskontroll. Det rekommenderas att använda eget ljud eller ljud genererat av Suno som inspirationskälla.Motsvarande Python-kod:
chirp-v5, medan chirp-v6 rekommenderas för det aktuella begäransexemplet, och svarsstrukturen är densamma:
Asynkron återuppringning
Eftersom det tar relativt lång tid för Suno att generera musik, ungefär 1–2 minuter, kommer HTTP-begäran att fortsätta hålla anslutningen om API:t inte svarar under en längre tid, vilket leder till ytterligare förbrukning av systemresurser. Därför erbjuder detta API även stöd för asynkrona återuppringningar. Det övergripande flödet är: när klienten initierar en begäran anges dessutom ett fältcallback_url. Efter att klienten har initierat API-begäran returnerar API:t omedelbart ett resultat som innehåller fältet task_id, vilket representerar ID:t för den aktuella uppgiften. När uppgiften är slutförd skickas resultatet av den genererade musiken i form av POST JSON till den callback_url som klienten har angett, vilket också inkluderar fältet task_id, så att uppgiftsresultaten kan kopplas samman via ID:t.
Nedan använder vi ett exempel för att förstå hur den konkreta processen fungerar.
Först är Webhook-återuppringningen en tjänst som kan ta emot HTTP-begäranden, och utvecklaren bör ersätta den med URL:en till sin egen uppsatta HTTP-server. För att underlätta demonstrationen används här en offentlig Webhook-exempelwebbplats https://webhook.site/. Öppna webbplatsen för att få en Webhook-URL, som visas i figuren:
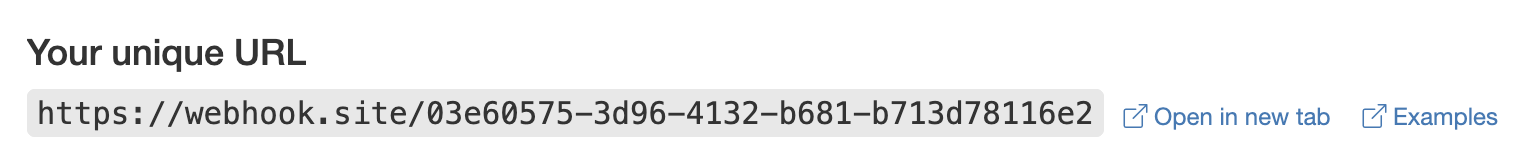 Kopiera denna URL så kan den användas som Webhook. Exemplet här är https://webhook.site/03e60575-3d96-4132-b681-b713d78116e2.
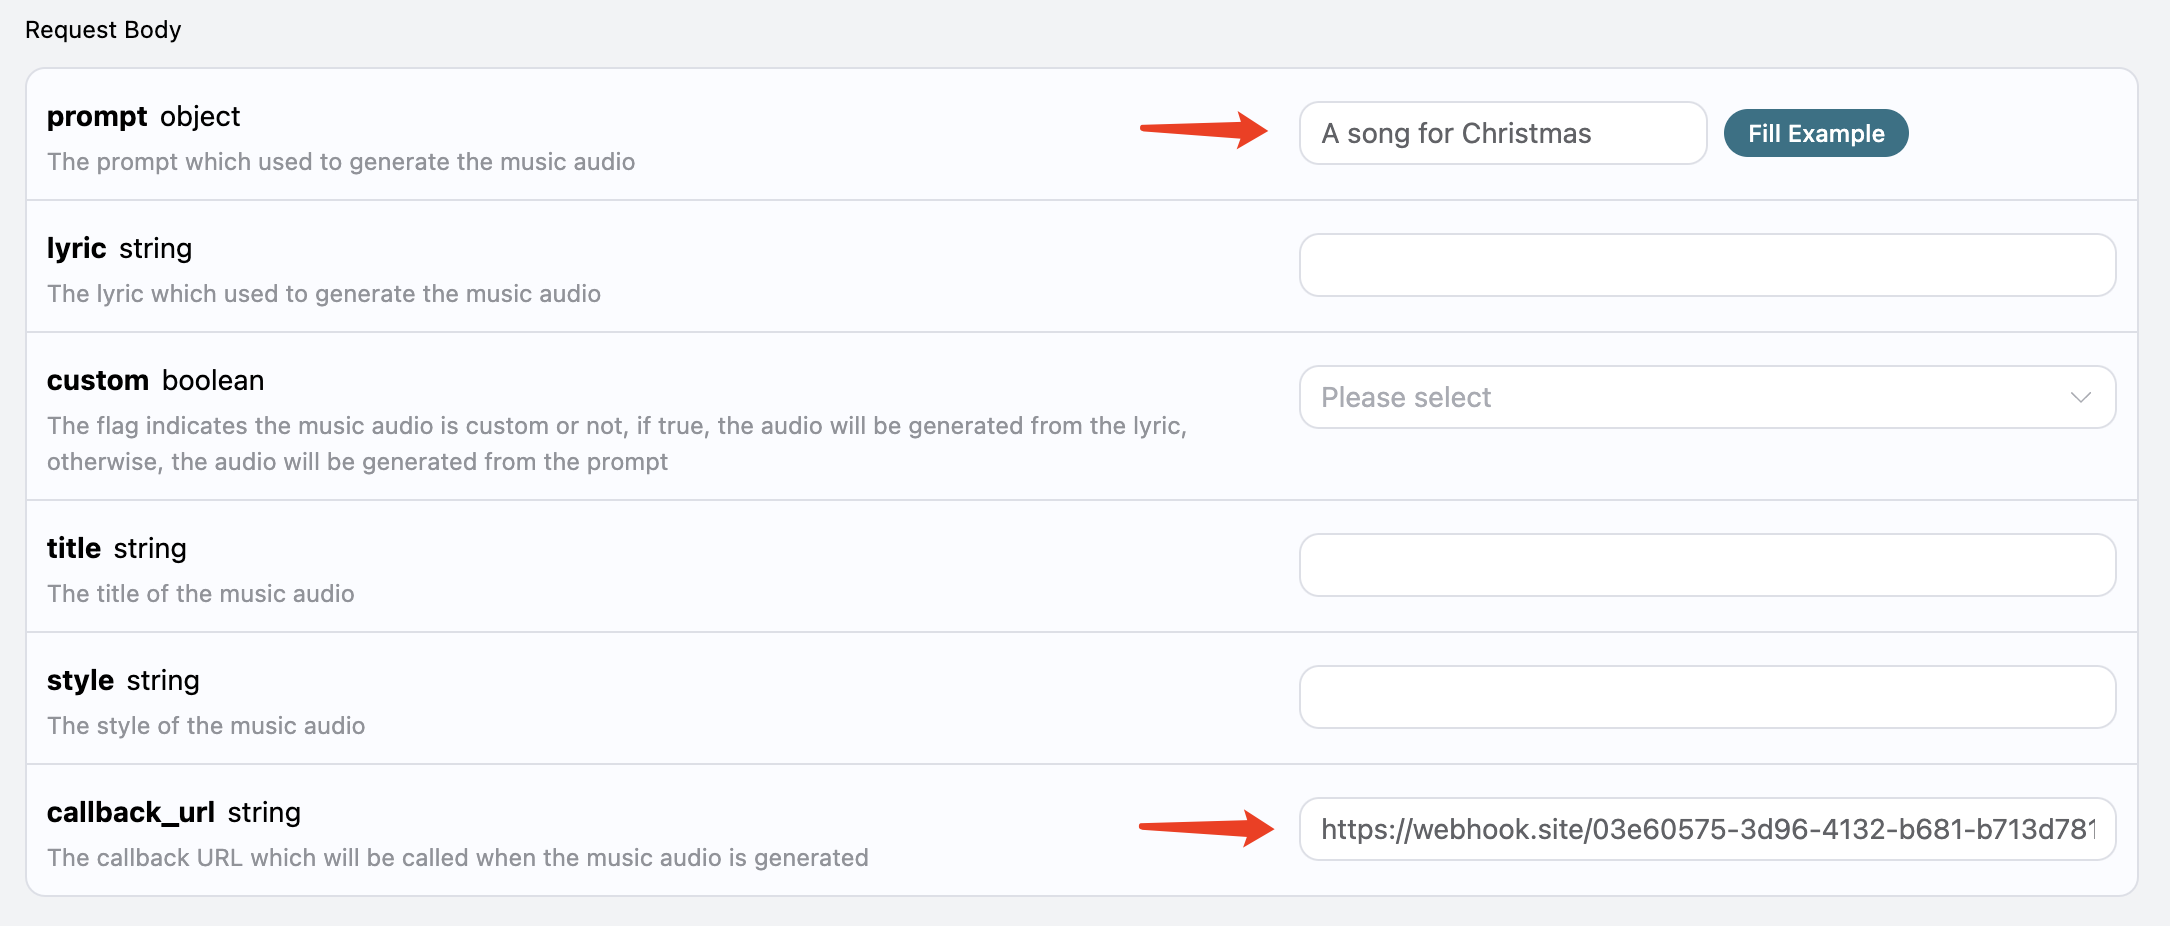
Därefter kan vi ange fältet
callback_url som ovanstående Webhook-URL och samtidigt fylla i prompt, som visas i figuren:
 Klicka på kör, så kan du se att ett resultat erhålls omedelbart, enligt följande:
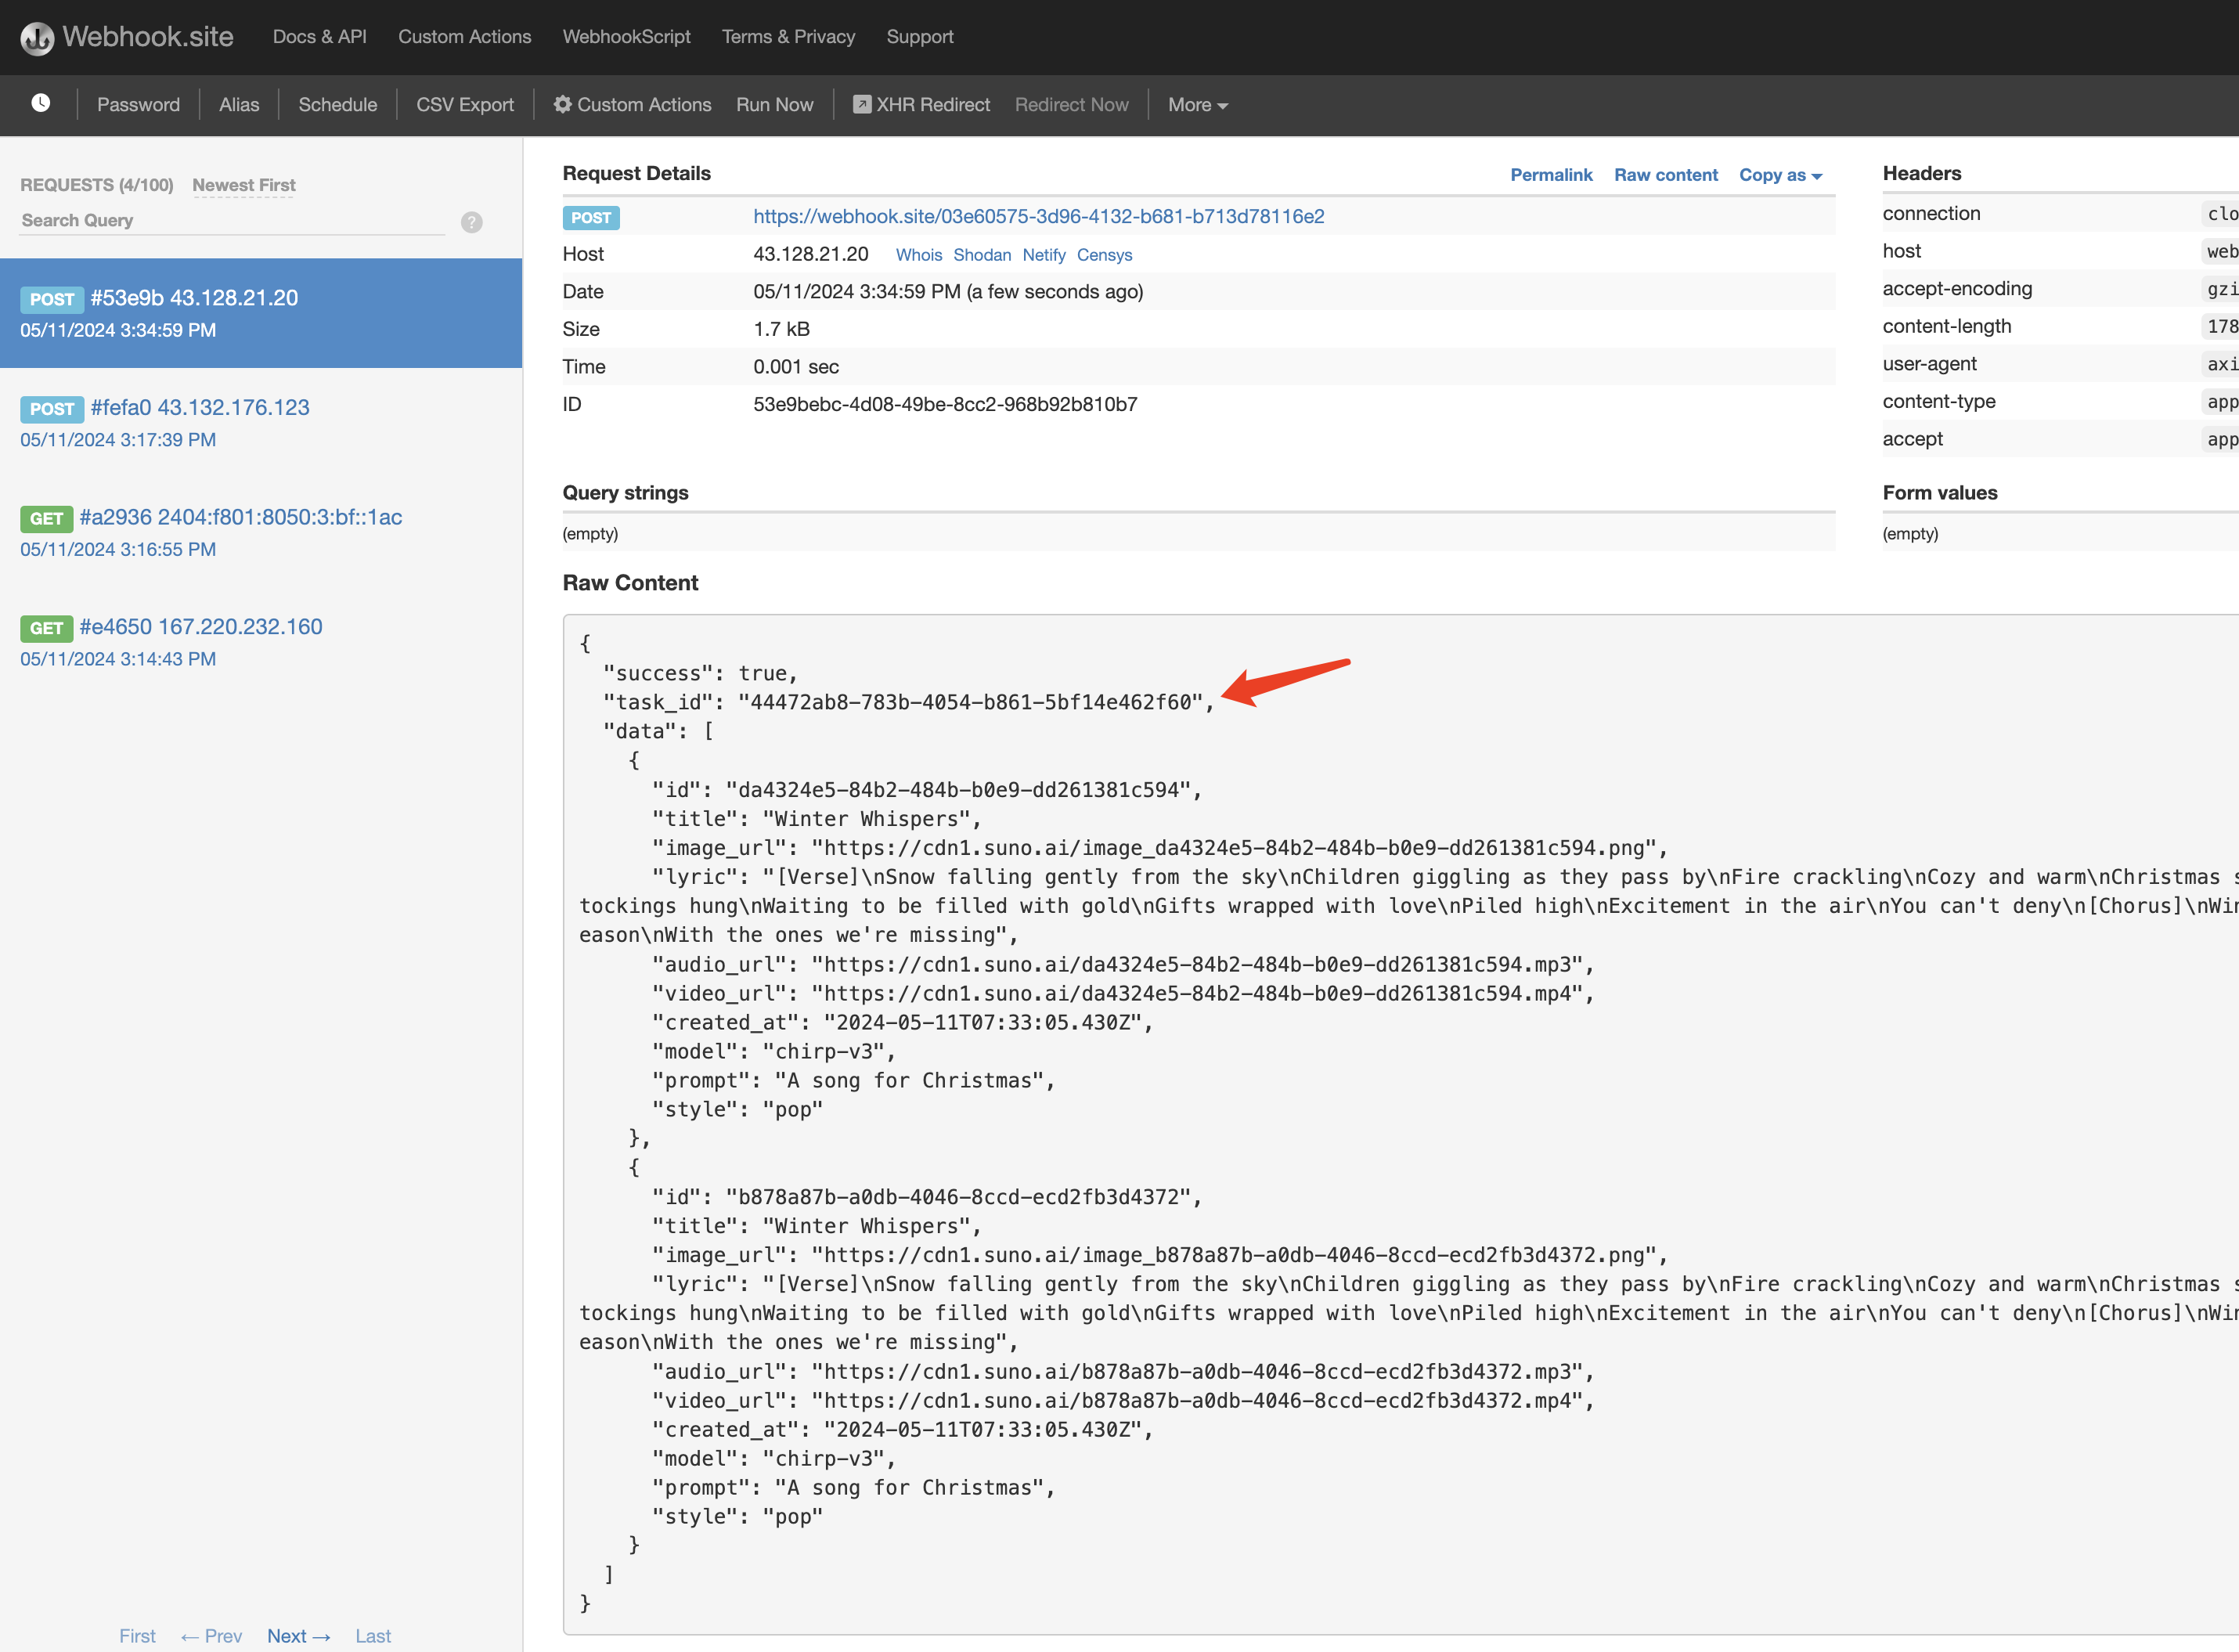 Innehållet är följande:
task_id, och de övriga fälten liknar de ovan. Uppgiftskoppling kan uppnås genom detta fält.
Vi kan naturligtvis även hämta resultatet genom strömmande anrop. Vi behöver bara ställa in värdet för accept i begärandehuvudet till application/x-ndjson. Nedan används en exempelindata som demonstration:
task_id; ovan har endast de första och sista två verkliga svaren behållits, medan upprepade mellanliggande uppdateringar har utelämnats.
Felhantering
Om ett fel uppstår får du ett felmeddelande som liknar följande:error.code, error.message:
Obs: Olika uppströmskontons gränser och felmeddelanden kan skilja sig åt. Vanligtvis harchirp-v3-5/chirp-v4lägre begränsningar förstyle(200), medanchirp-v4-5och senare vanligtvis stöder upp till 1000; när en äldre uppströmskälla används kan kompatibilitetsmeddelanden somTags too long.ellerstyle must be less than or equal 120förekomma. | Statuskod |error.code|error.message| | --------- | ------------- | --------------------------------------------------------------- | | 400 |bad_request|Sång-id:t finns inte eller har tagits offline.| | 400 |bad_request|Prompten är för lång.| | 400 |bad_request|Taggarna är för långa.| | 400 |bad_request|Uppladdat ljud matchar ett befintligt konstverk.| | 400 |bad_request|instrumental måste vara ett booleskt värde| | 400 |bad_request|Titeln är för lång.| | 400 |bad_request|Ämnet är för långt.| | 400 |bad_request|style måste vara mindre än eller lika med 120| | 400 |bad_request|custom måste vara ett booleskt värde| | 400 |bad_request|audio_id krävs vid utökning av ljud| | 400 |bad_request|continue_at krävs vid utökning av ljud| | 400 |bad_request|continue_at måste vara ett tal större än 0| | 400 |bad_request|lyric krävs vid utökning av ljud och när instrumental är falskt| | 400 |bad_request|prompt krävs vid generering av ljud| | 400 |bad_request|lyric krävs vid generering av anpassat ljud| | 403 |forbidden|Prompten är troligen felaktigt formulerad| | 403 |forbidden|Prompten är troligen upphovsrättsskyddad| | 403 |forbidden|Prompten innehöll olämpligt material| | 403 |forbidden|Sångbeskrivningen flaggades för moderering| | 403 |forbidden|Sångbeskrivningen innehöll artistnamn| | 403 |forbidden|Taggarna innehöll artistnamn| | 403 |forbidden|Låttexten innehöll upphovsrättsskyddat material| | 403 |forbidden|Sångbeskrivningen innehöll producenttagg| | 403 |forbidden|Generiskt openAI-fel| | 403 |forbidden|Prompten flaggades för moderering| | 500 |api_error|Det går inte att generera låttext från sångbeskrivningen| | 500 |api_error|jobbet misslyckades med okänt fel| | 500 |api_error|ingen tillgänglig arbetare i systemet| | 500 |api_error|tjänsten underhålls, generering pausad| | 504 |timeout|tidsgränsen överskreds medan ljudgenerering väntade|