

ОграниченияSuno теперь поддерживаетlyricиstyleв таблице выше являются верхними пределами в пользовательском режиме (customимеет значениеtrue). В непользовательском режиме вдохновения (customимеет значениеfalse) заполняется толькоprompt, а его максимальная длина составляет 500 символов (одинаково для всех моделей).
chirp-v6, chirp-v6-wild и chirp-v6-mini. Рекомендуется использовать chirp-v6; старые названия моделей продолжают поддерживаться.
Однако официальный Suno не предоставляет API, поэтому AceDataCloud предоставляет набор API Suno, имитирующий официальную интеграцию Suno, что позволяет удобно и быстро генерировать нужную музыку.
Получение и использование
Чтобы использовать Suno Audios Generation API, сначала получите ваш API Token в консоли Ace Data Cloud и сохраните его для дальнейшего использования. Если вы ещё не вошли в систему или не зарегистрировались, вы будете автоматически перенаправлены на страницу входа, где вам будет предложено зарегистрироваться и войти в систему; после завершения вы автоматически вернётесь на текущую страницу.
Один API Token позволяет вызывать все сервисы платформы, не нужно подавать отдельную заявку для каждого сервиса. При первом получении предоставляется бесплатный лимит для бесплатного ознакомления; при недостатке лимита можно пополнить универсальный баланс в консоли.
📘 Полная документация: Suno Audios Generation API →
Базовое использование
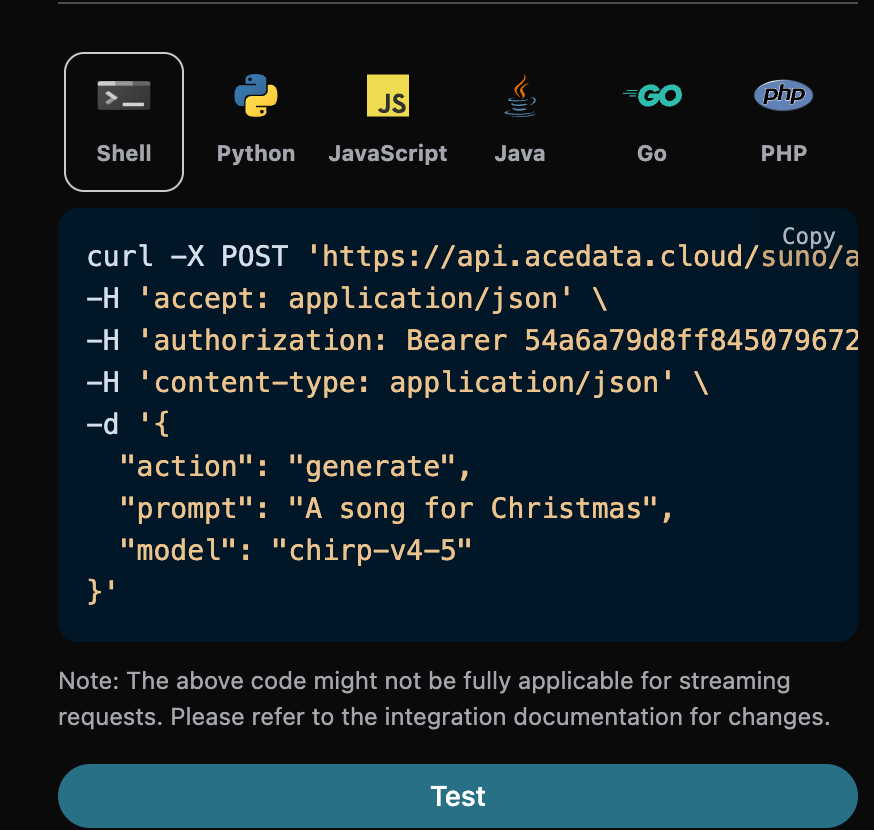
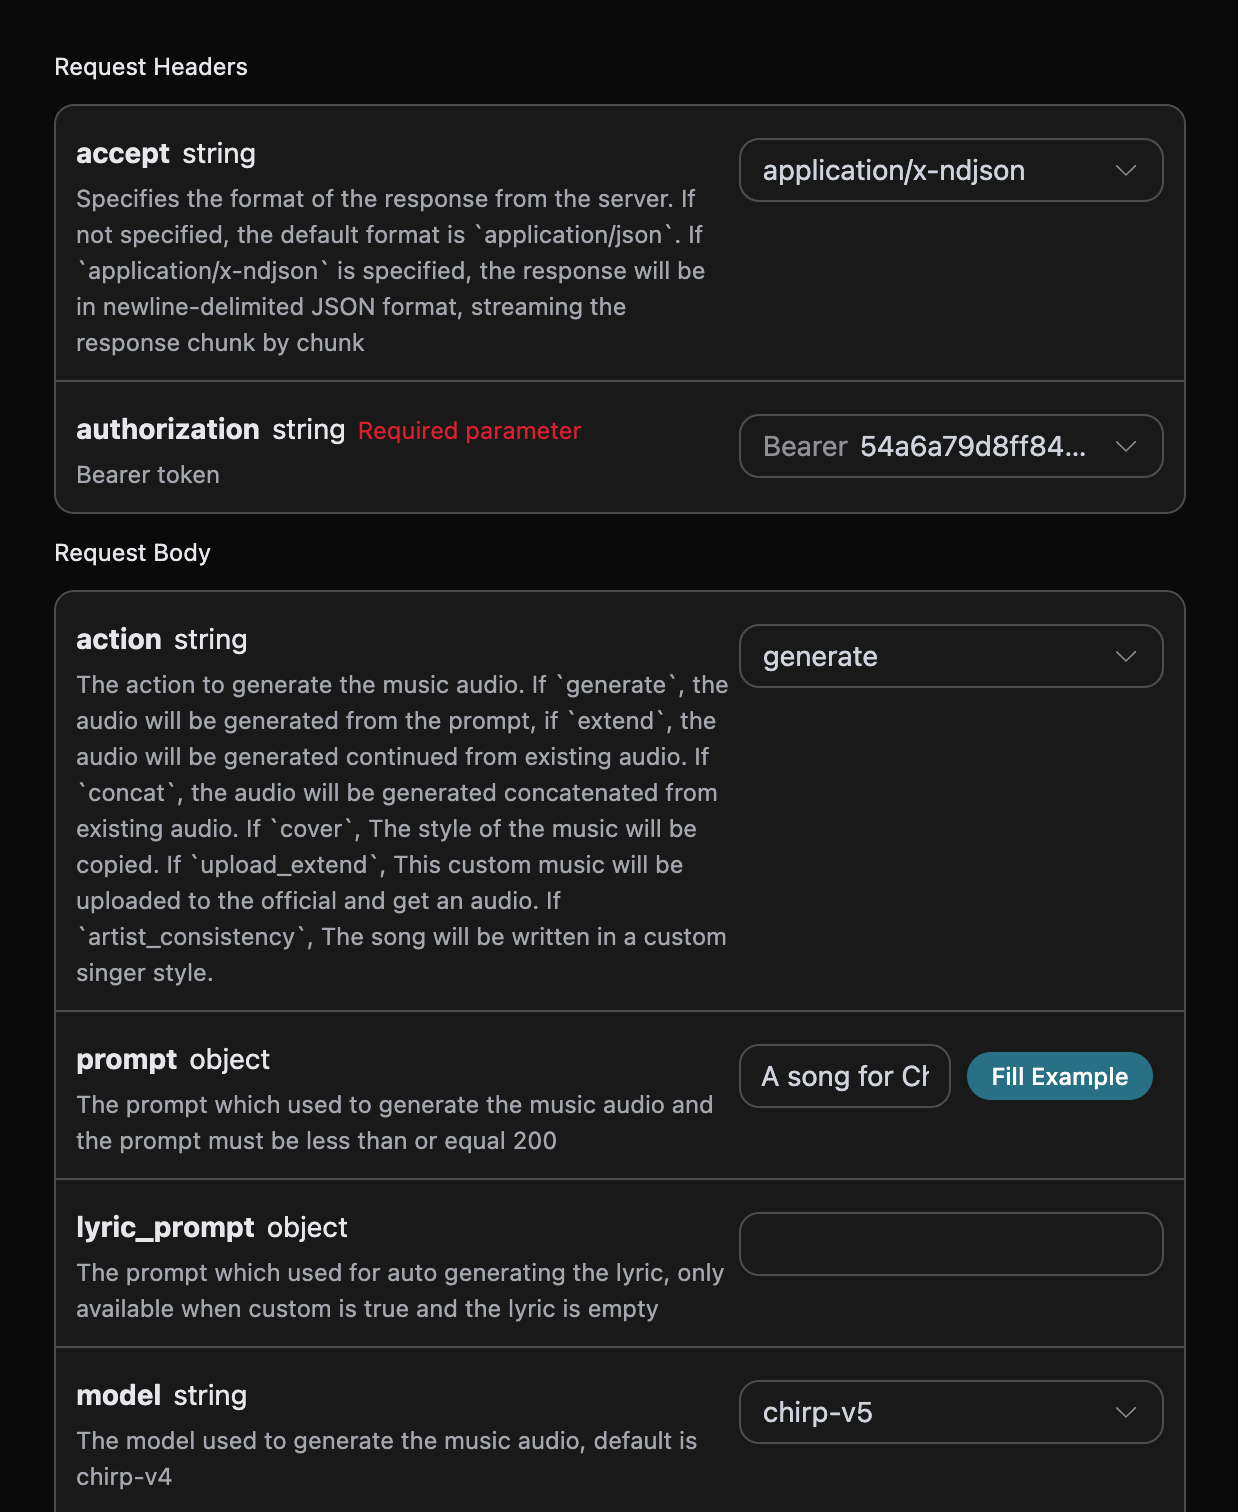
Можно вводить любой текст о том, какие песни вы хотите, например, если я хочу сгенерировать песню о Рождестве, можно ввестиa song for Christmas, как показано на рисунке:
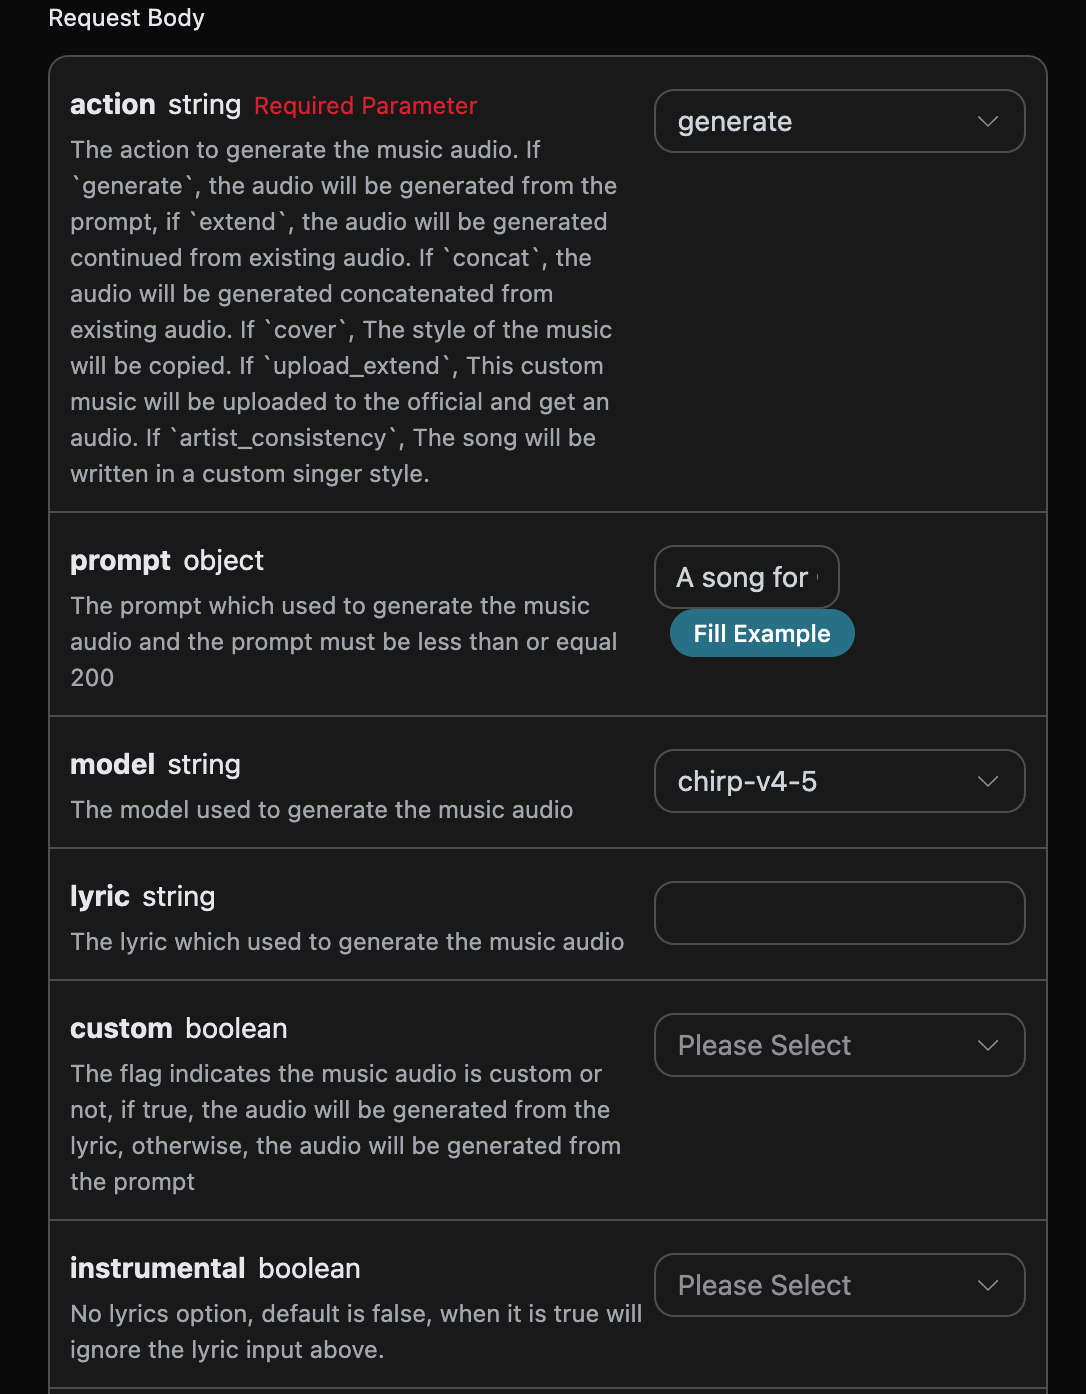
accept: в каком формате вы хотите получить результат ответа; здесь указаноapplication/json, то есть формат JSON.authorization: ключ для вызова API, после получения можно напрямую выбрать его из выпадающего списка.
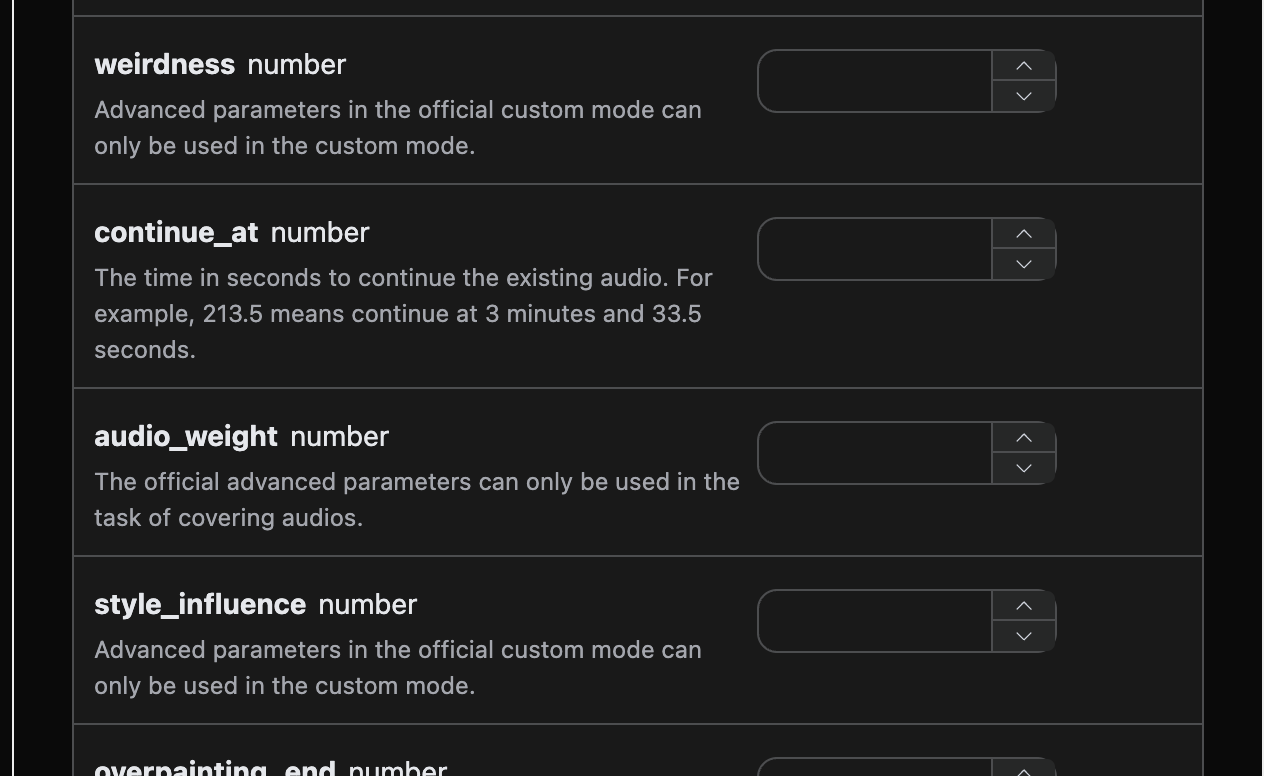
action: тип аудиозадачи, по умолчаниюgenerate. Поддерживает операции генерации, продолжения, кавера, объединения, разделения на дорожки, добавления аудиодорожек, извлечения указанных аудиодорожек, генерации звуковых эффектов и регулировки скорости и т. д.; все вызываются черезPOST /suno/audios.prompt: подсказка режима вдохновения Suno (действует, когдаcustomимеет значениеfalse), максимум 500 символов.model: модель для этой задачи генерации музыки. Серия v6 включаетchirp-v6,chirp-v6-wildиchirp-v6-mini; старые названия моделей продолжают поддерживаться.max_mode: усиленный режим генерации.generateвключается только когда иcustom, иmax_modeимеют значениеtrue, стоимость составляет 1.12 Credits;add_stemможно включить напрямую, стоимость составляет 1.344 Credits. При отключении или пропуске значения составляют соответственно 0.56 и 0.672 Credits.variety: интенсивность разнообразия результатов генерации, доступныoff,normal,high,extra,max. Используется только дляgenerateиadd_stem; передача для других action вернёт 400.lyric: текст песни в пользовательском режиме Suno. Дляchirp-v3-5иchirp-v4максимум 3000 символов; дляchirp-v4-5и выше (включаяchirp-v5,chirp-v5-5) максимум 5000 символов.custom: использовать ли пользовательский режим, по умолчанию:false.instrumental: опция инструментальной музыки в режиме вдохновения Suno.title: название музыки в пользовательском режиме Suno. Дляchirp-v3-5,chirp-v4максимум 80 символов; дляchirp-v4-5и выше максимум 100 символов.style: музыкальный стиль пользовательского режима Suno. Дляchirp-v3-5иchirp-v4максимум 200 символов; дляchirp-v4-5и выше (включаяchirp-v5,chirp-v5-5) максимум 1000 символов.negative_tags: музыкальные стили или жанры, которые нужно исключить из результатов генерации в пользовательском режиме (когдаcustomимеет значениеtrue).audio_weight: вес влияния аудио- или голосовых характеристик, диапазон 0-1,0также является допустимым значением. Может использоваться для операций генерации, продолжения, кавера, добавления аудиодорожек и согласованности голоса и т. д.; при отсутствии эталонного аудио или голосовых характеристик модель может ослабить или проигнорировать это значение.audio_id: ID эталонной музыки.overpainting_start/overpainting_end: время начала и окончания добавления вокала к существующей инструментальной музыке, в секундах.underpainting_start/underpainting_end: время начала и окончания добавления аккомпанемента к а капелла, в секундах.persona_id: ID песни исполнителя.continue_at: граница продолжения, в секундах. Например, 213.5 означает начало генерации последующего фрагмента с отметки 3 минуты 33.5 секунды.lyricиstyleнаправляют только новое содержимое после границы и не заменяют текст или вокал до границы в исходном аудио.style_influence: влияние стиля в пользовательском режиме, диапазон 0-1; чем больше значение, тем обычно точнее соответствие выбранному стилю;0передаётся как допустимое значение.replace_section_end: конечное время заменяемого фрагмента.replace_section_start: начальное время заменяемого фрагмента.vocal_gender: управляет предпочтением женского или мужского вокала: женский голосf, мужской голосm; действует для моделей 4.5 и выше; является параметром предпочтения и не гарантирует строгого соблюдения.weirdness: степень необычности в пользовательском режиме, диапазон 0-1; чем больше значение, тем обычно более креативен и экспериментален результат;0передаётся как допустимое значение.duration: желаемая длительность песни в секундах, должна быть целым числом в диапазоне от 10 до 360. Этот параметр используется для генерации песен в пользовательском режиме (когдаcustomимеет значениеtrue). Это ориентир, а не жёсткое ограничение: модель учитывает его, но не гарантирует достижения, фактическая длительность готового результата определяется полемdurationв ответе и обычно короче желаемой.
Область применения расширенных параметров
Платформа проверяет типы параметров и диапазоны значений, но не отклоняет эти необязательные параметры регулировки только из-за различий в action; конкретный эффект определяется операцией, режимом и моделью.
lyric_prompt: prompt для генерации текста песни, действует тогда и только тогда, когдаcustomимеет значениеtrueиlyricне передан.callback_url: URL, на который требуется отправить результат обратным вызовом.async: необязательно; когда установлено значениеtrue, интерфейс немедленно возвращаетtask_id, предоставлятьcallback_urlне требуется, после чего результат можно получить путём опроса соответствующего интерфейса запроса задач.
- success:успешно ли выполнено создание, если успешно —
true, иначе —false - data:это список, содержащий подробную информацию о созданных песнях.
- state:статус создания песни, в основном включает четыре вида, конкретно следующие:
- succeeded:создание успешно
- pending:в очереди
- running:выполняется
- error:ошибка
- id:ID песни
- title:название песни
- image_url:обложка песни
- lyric:текст песни
- audio_url:адрес итогового аудио песни. Платформа в приоритетном порядке возвращает адрес Ace Data Cloud CDN; при сбое сохранения может быть возвращён исходный адрес медиафайла, пожалуйста, своевременно скачайте его.
- video_url:видеофайл песни, при открытии представляет собой mp4-видео.
- created_at:время создания
- model:используемая модель, как правило, новейшая модель v3
- style:стиль
- state:статус создания песни, в основном включает четыре вида, конкретно следующие:
Пользовательское создание
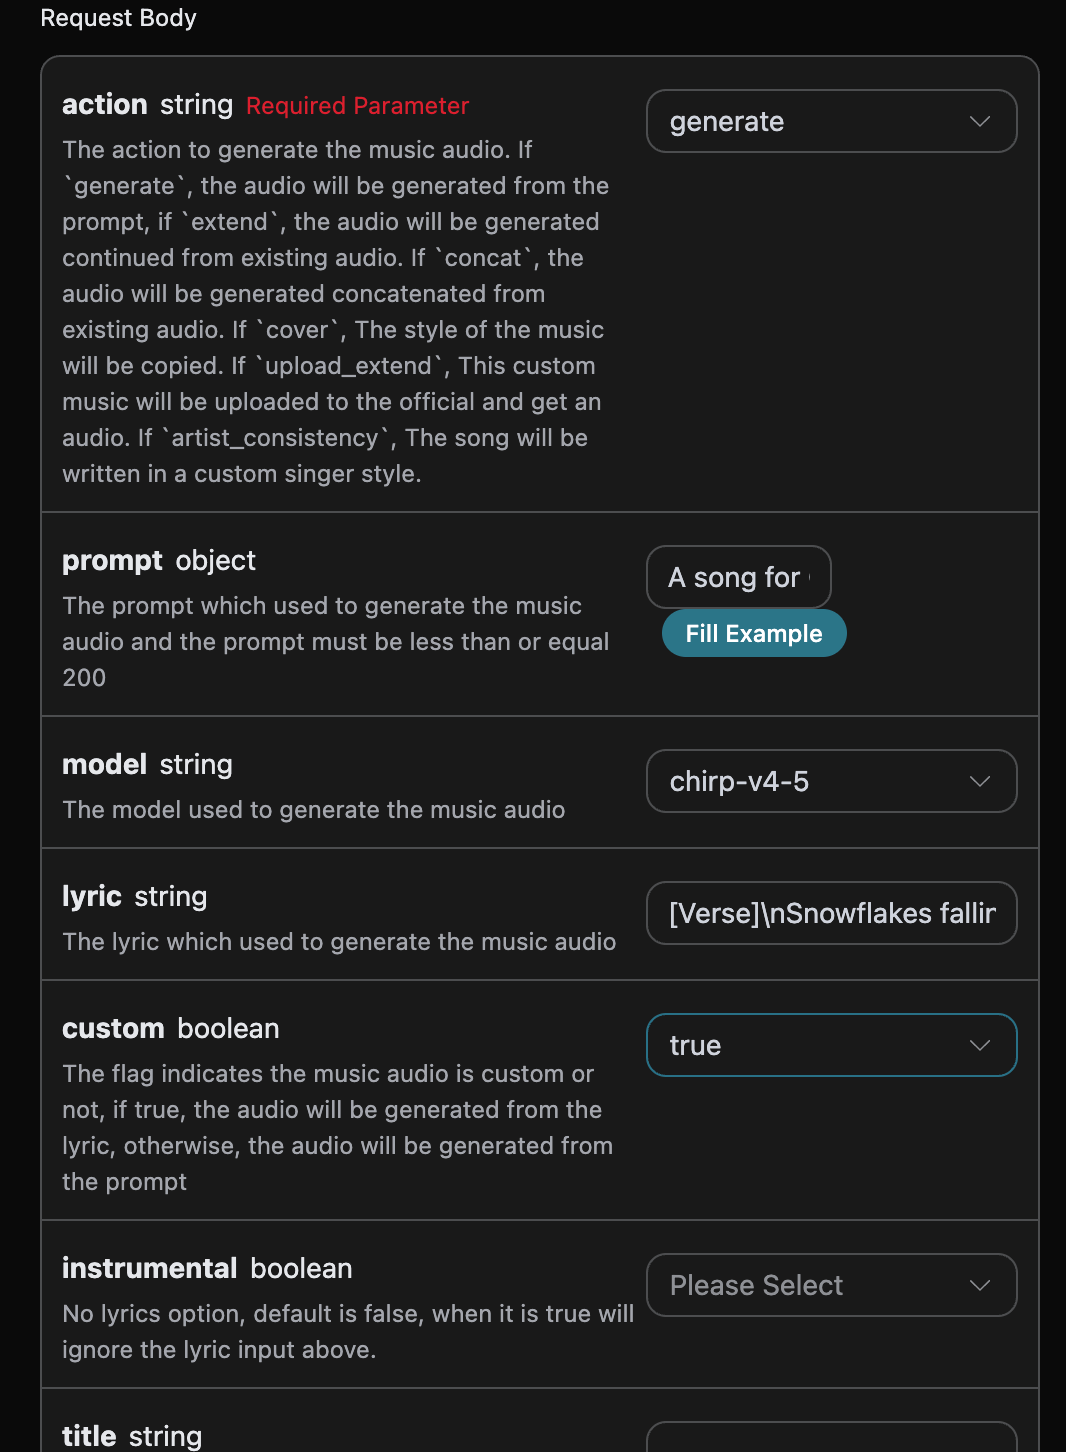
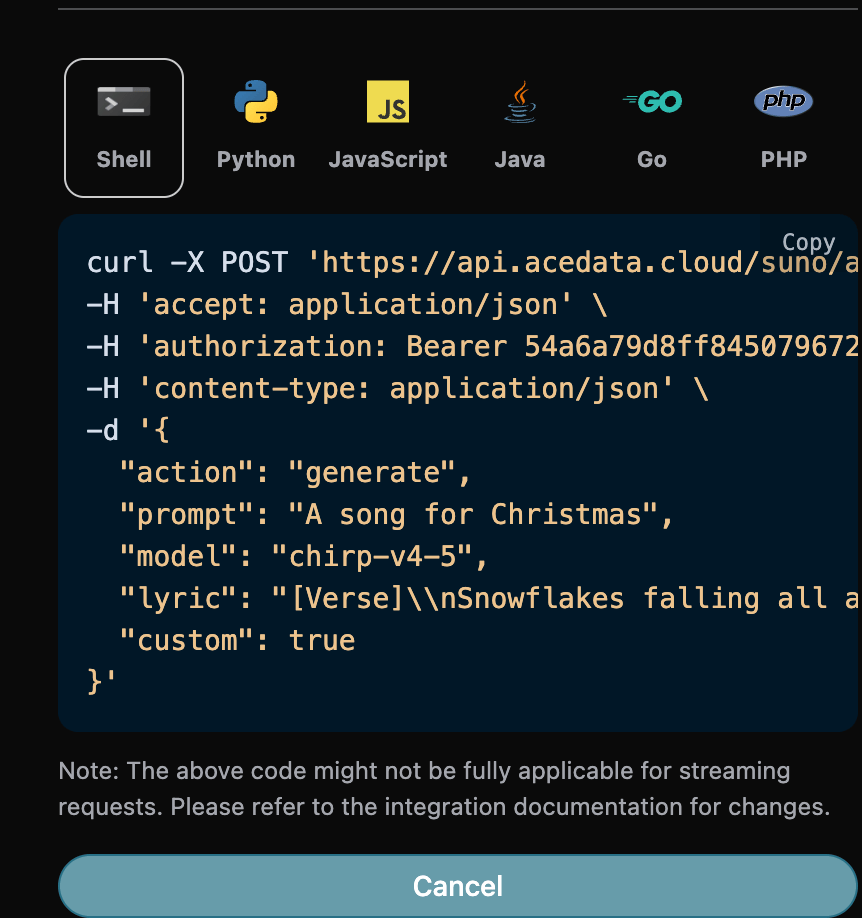
Если вы хотите пользовательски создать текст песни, можно ввести текст песни: В этот момент в полеlyric можно передать содержимое, подобное следующему:
Обратите внимание, что \n в тексте песни здесь — это символ переноса строки. Если вы не знаете, как создавать текст песни, можно использовать API генерации текстов песен, предоставляемый AceDataCloud, для создания текста песни через prompt; API: Suno Lyrics Generation API。
Далее, чтобы пользовательски создать песню на основе текста песни, названия и стиля, можно указать следующее содержимое:
- lyric:текст песни
- custom:укажите
true, что означает пользовательское создание; по умолчанию этот параметр имеет значение false, что означает создание с использованиемprompt. - title:название песни.
- style:стиль песни, необязательно.
Функция создания в пользовательском стиле певца
Если вы хотите использовать стиль певца для генерации песни, сначала сгенерируйте песню с помощью базового использования, описанного выше, в итоге необходимо настроить эту песню как стиль певца, затем нужно перейти в Suno Persona API, чтобы на основе официального ID сгенерированной музыкиaudio_id создать параметр ID стиля певца persona_id, конкретные параметры показаны на рисунке ниже:
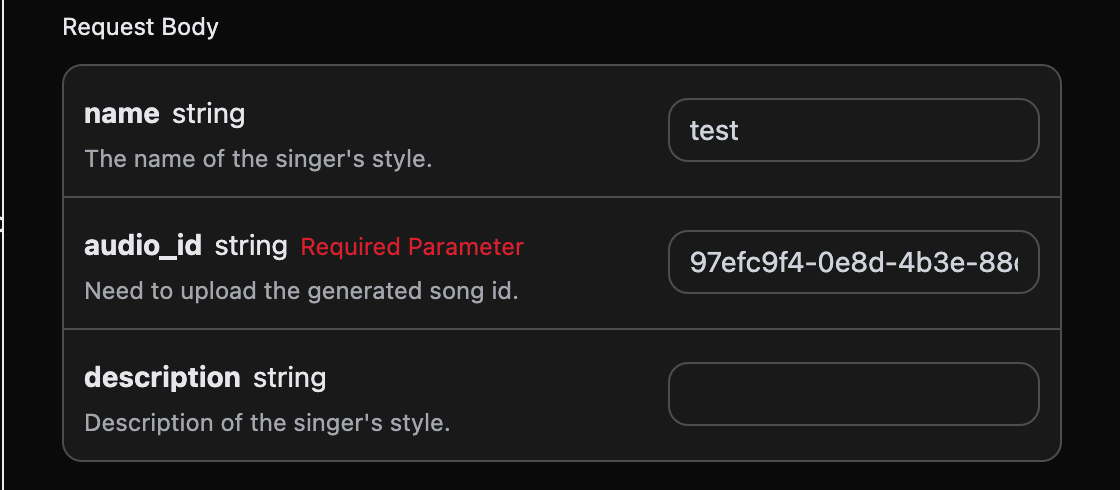
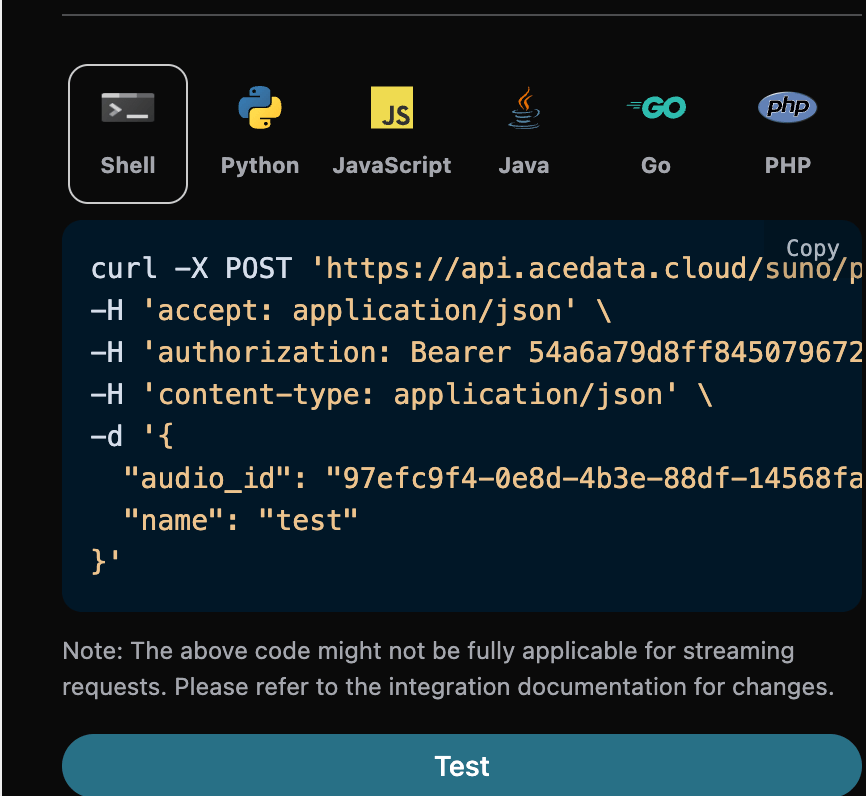
audio_id и persona_id, а именно 97efc9f4-0e8d-4b3e-88df-14568fa1b11f и e0d7319e-aa2a-44cb-b00a-916218d7cb0b, в качестве примеров данных в этот раз. Затем можно установить для параметра action значение artist_consistency (если это новая версия стиля певца Persona-v2-vox, action необходимо установить в artist_consistency_vox), а также ввести ID песни, генерацию которой нужно продолжить, и ID стиля певца; пример заполнения приведён ниже:
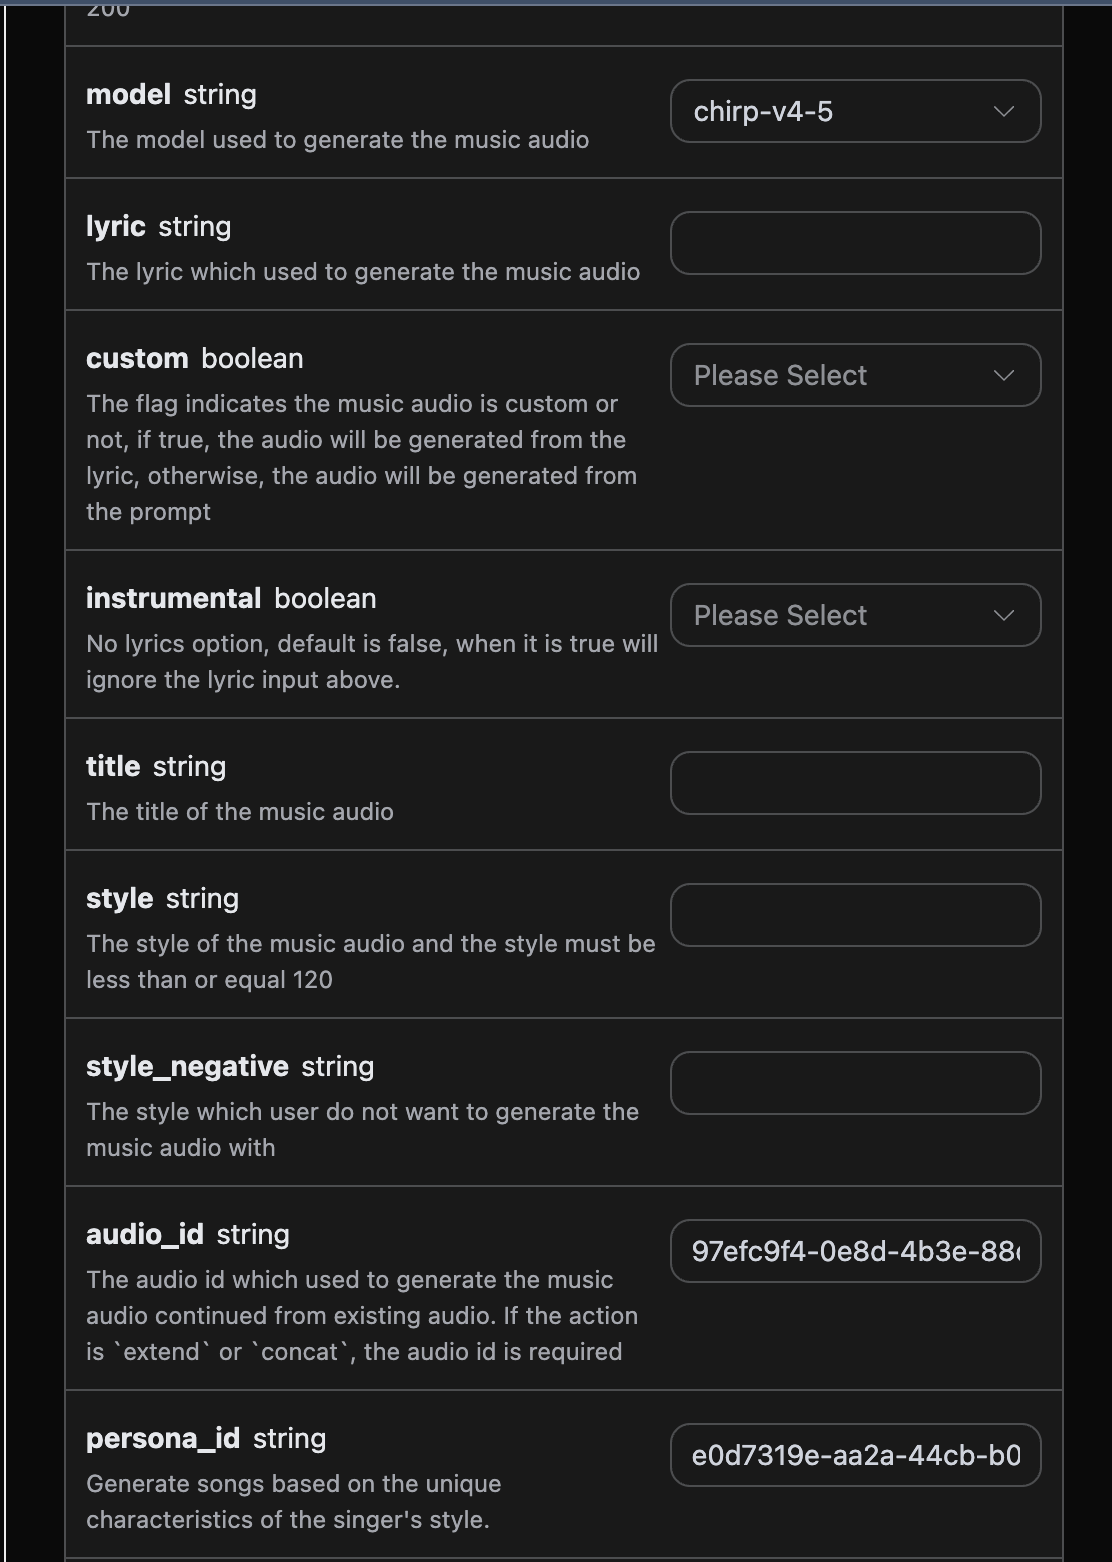
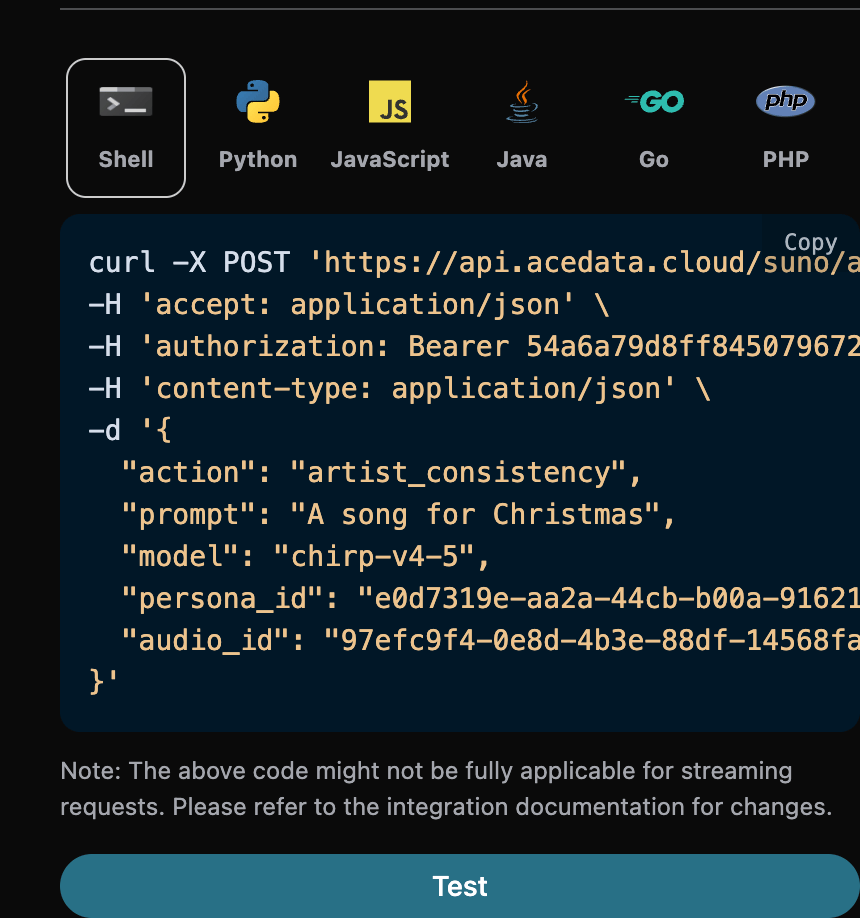
Функция продолжения генерации
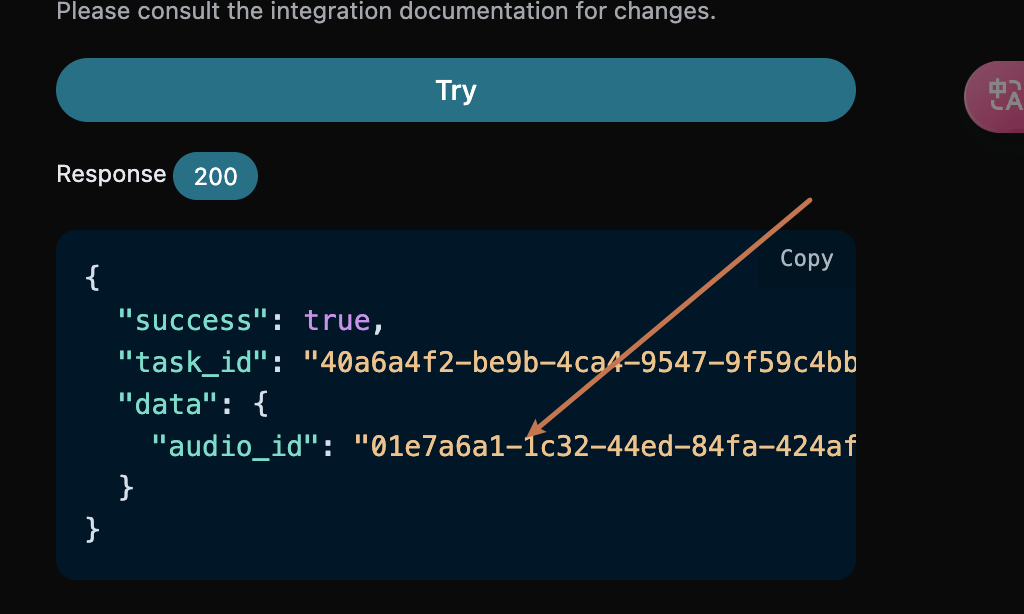
Если вы хотите продолжить генерацию уже созданной песни Suno, можно установить для параметраaction значение extend и ввести ID песни, генерацию которой нужно продолжить. ID песни получается через базовое использование; как видно из приведённого выше, в этот момент можно увидеть, что ID песни следующий:
Обратите внимание, что id в тексте песни здесь является ID песни после генерации; если вы не знаете, как генерировать песни, вы можете обратиться к базовому использованию выше для генерации песни.
Если вы хотите продолжить генерацию песни, загруженной вами самостоятельно, можно установить для параметра action значение upload_extend и ввести ID пользовательской загруженной песни, генерацию которой нужно продолжить. ID песни получается с помощью Suno Upload Generation API, как показано на рисунке ниже:
- lyric:используется только для направления текста нового генерируемого фрагмента после
continue_at, не заменяет текст в исходном аудио до этой временной точки. - custom:установите значение
true, что означает пользовательскую генерацию; по умолчанию этот параметр имеет значение false, что означает генерацию с использованиемprompt. - style:стиль песни для продолжаемого фрагмента, необязательно.
- continue_at:граница продолжения, в секундах. Например, 213.5 означает начало генерации последующего фрагмента с отметки 3 минуты 33.5 секунды.
Пример заполнения приведён ниже:extendиспользуется для продолжения создания уже существующей песни, а не для замены текста всей песни. Если вы хотите использовать новый текст для всей песни с самого начала, используйтеgenerateдля повторной генерации; если вы хотите переисполнить песню с опорой на существующую, можно использоватьcover. При передаче нового текста целой песни исходный текст доcontinue_atвсё равно не будет заменён.
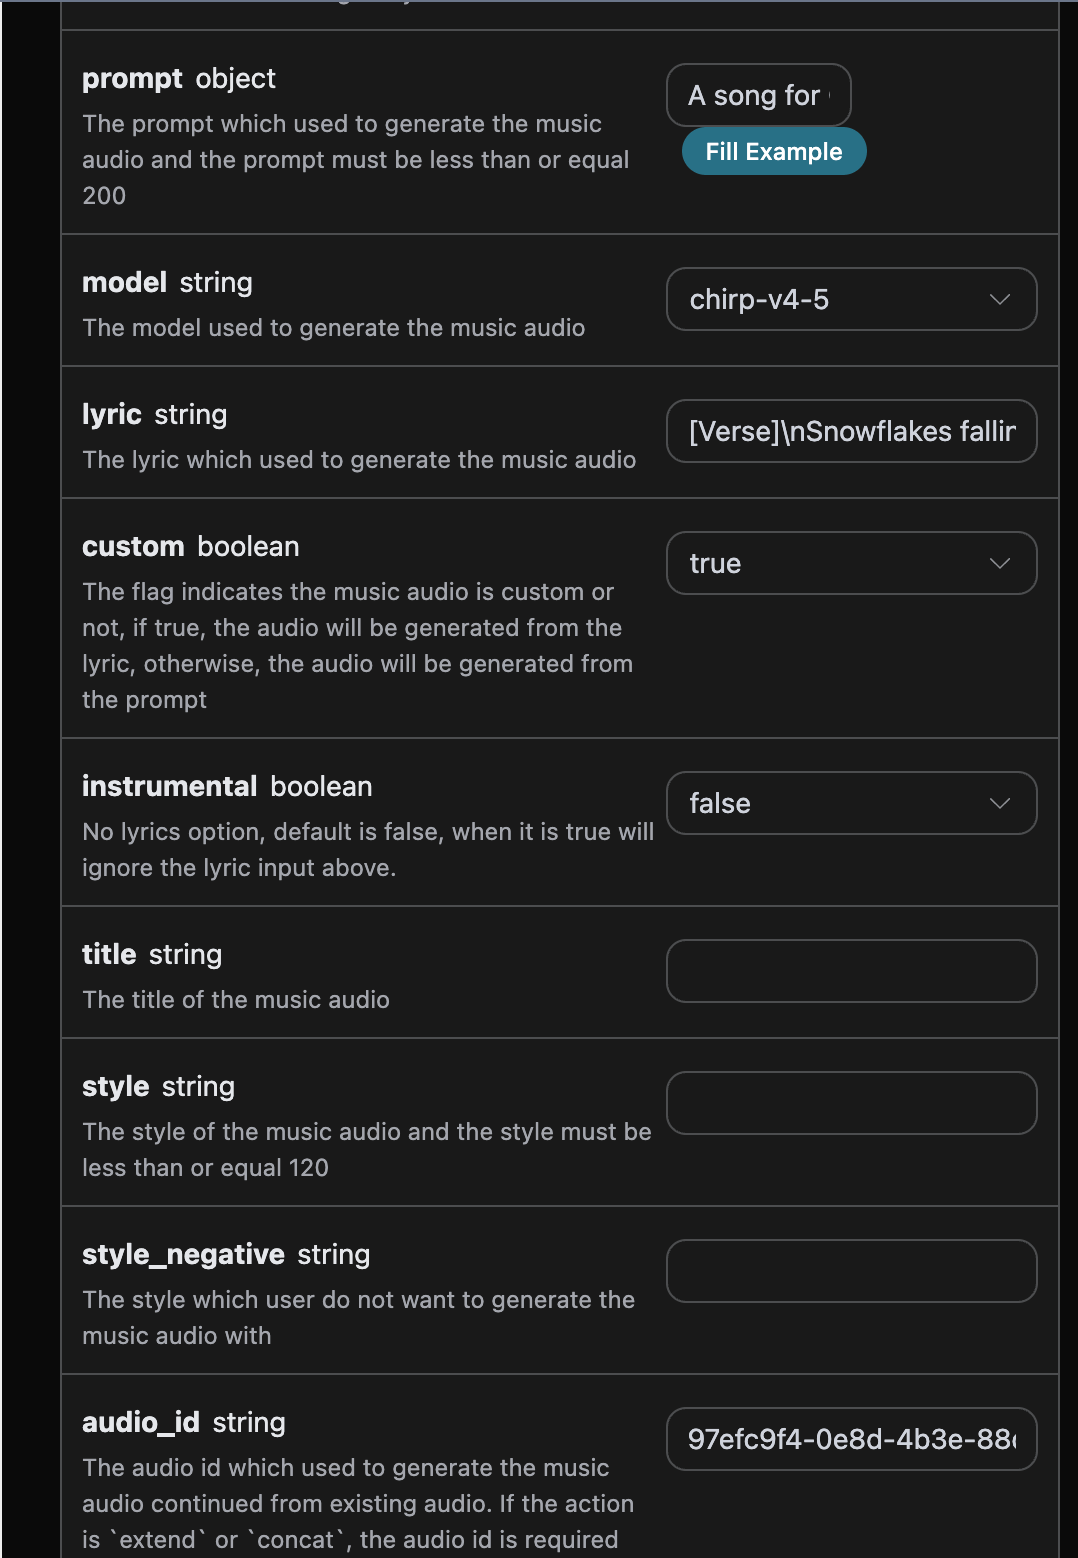
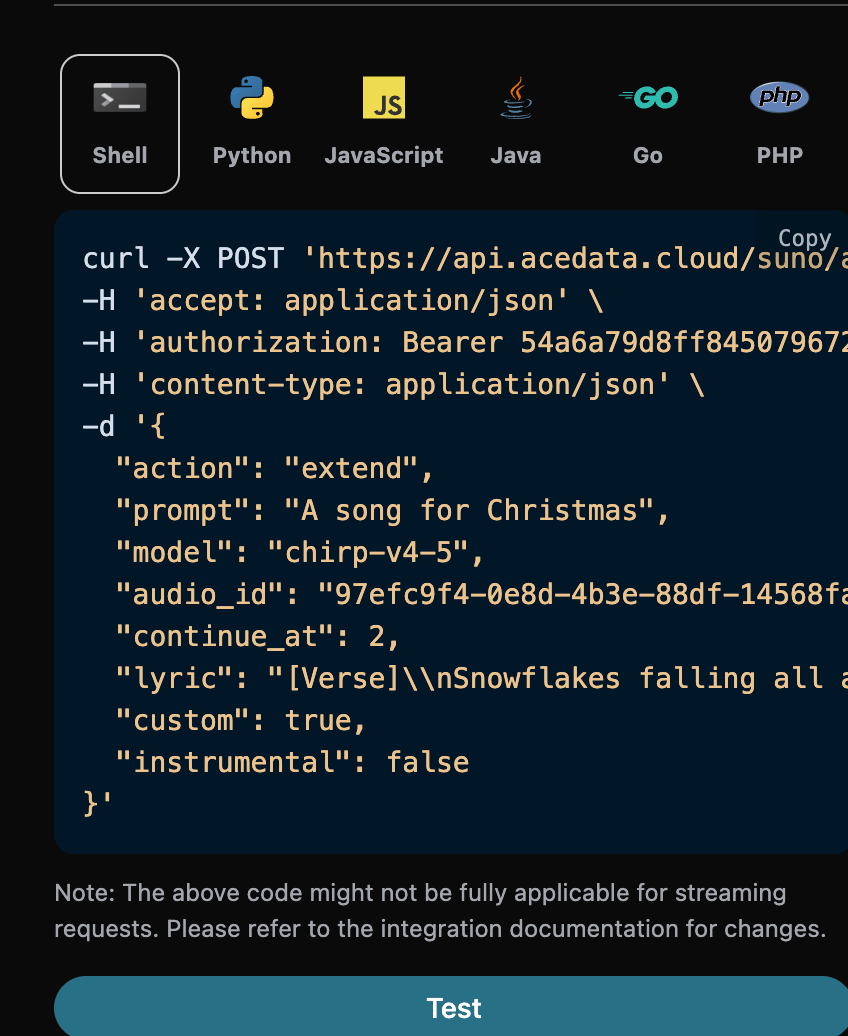
continue_at равен 2 секундам, поэтому только первые 2 секунды относятся к исходному содержимому до границы продолжения. При фактическом продолжении вблизи конца песни это значение следует установить на секунду, с которой ожидается начало продолжения, и предоставлять в lyric только новый фрагмент, который должен исполняться после границы.
Соответствующий код Python:
lyric в результате возвращает текст песни, использованный для этой задачи продолжения. Это поле не является дословной расшифровкой полного готового аудио; для extend исходное аудио до continue_at по-прежнему использует исходный текст песни, а новый текст песни используется только для направления фрагмента продолжения.
Получение полной песни
Результатextend текущей модели обычно уже содержит исходное аудио до continue_at и новое содержимое после границы, поэтому сначала определите по фактической длительности и содержимому возвращённого аудио, является ли оно уже полной песней. Если возвращается отдельный фрагмент продолжения или необходимо явно объединить историю нескольких продолжений в одну песню, затем используйте функцию склейки:
- action: значение —
concat. - audio_id: ID последнего фрагмента продолжения.
Кавер-версия музыки
После продолжения генерации песни на основе исходной песни стиль возвращённой песни может оказаться не совсем подходящим. Если необходимо сделать кавер-версию ранее сгенерированной песни (также поддерживается пользовательская загруженная музыка), нужно использовать метод создания кавер-версии музыки, в котором можно указать следующее содержимое:- action:значение
cover; при выполнении операции создания кавер-версии пользовательской загруженной музыки обязательно необходимо указать значение:upload_cover。 - audio_id:ID ранее сгенерированной песни。
Замена фрагмента
Если после генерации песни необходимо выполнить вторичное создание с отдельной операцией замены фрагмента песни, можно выполнить замену определённого фрагмента песни.⚠️ Внимание:значениеОписание параметров следующее:replace_section_result_modeпо умолчанию —full_song:система отдельно склеит 2 новых сгенерированных кандидата и вернёт 2 полные песни. Если нужны только ещё не склеенные кандидаты заменяемых фрагментов, явно установите значениеcandidates, затем выберите кандидата и вызовите Склейку музыки。
- action:значение
replace_section。 - audio_id:ID исходной песни (исходной песни, в которой производится замена)。
- model: Модель генерации песни。
- lyric: Полный текст песни после замены (включая заменяемый фрагмент и его контекст, соответствует содержимому в
prompt)。 - prompt:Новый текст песни для фрагмента, который необходимо заменить。
- style:Стиль песни, необязательно。
- replace_section_start:Время начала заменяемого фрагмента в исходной песне (секунды)。
- replace_section_end:Время окончания заменяемого фрагмента в исходной песне (секунды)。
- replace_section_result_mode:Режим возврата, по умолчанию
full_song。full_songотдельно склеивает 2 кандидата и возвращает 2 полные песни;candidatesвозвращает 2 ещё не склеенных фрагмента-кандидата。
Шаг 1: Запуск задачи замены фрагмента
Например, если ID исходной сгенерированной песни:18db7ed0-2b8a-41db-91c1-b0781dcca0d4 (длительность 94.12 секунды), и требуется заменить припев с 30-й по 60-ю секунду новым текстом песни, то параметры можно задать следующим образом:replace_section_result_mode в значение candidates, будут возвращены 2 ещё не склеенных заменяющих фрагмента со структурой, идентичной примеру ниже:
candidates длительность двух возвращаемых аудиозаписей (45,16 секунды и 33,8 секунды) значительно меньше, чем у исходной песни (94,12 секунды). Они являются заменяющими фрагментами, содержащими небольшое количество контекста, и не являются полной песней. Можно выбрать удовлетворяющего кандидата и продолжить ручную склейку. Режим full_song по умолчанию выполнит две склейки и сразу вернёт 2 полные песни.
Непосредственный возврат полной песни
Если требуется сразу получить полную песню, на первом шаге можно установитьreplace_section_result_mode в значение full_song. Интерфейс отдельно склеит двух кандидатов и вернёт 2 полные песни; в этом случае дополнительно вызывать concat не нужно.
Шаг 2: склейка заменяющего фрагмента обратно с исходной песней
Для выбранного выше фрагмента (например,364f9d8b-ca25-463b-9a5e-d0b7139e2d6a) создайте задачу concat способом, описанным в разделе Склейка музыки:
duration уже восстановлена до полной длины песни (105,28 секунды, примерно равна длине оригинальной композиции), а audio_url указывает на всю песню после завершения замены. На этом завершается процесс вторичного создания: «генерация → замена фрагмента → объединение полной композиции».
Разделение вокала и музыки
Когда после генерации песни требуется вторичное создание с отдельной обработкой аккомпанемента и вокала, можно разделить чистый музыкальный аккомпанемент и вокал а капелла. Для этого можно указать следующее содержимое:- action: значение —
stems. - audio_id: ID ранее сгенерированной песни.
Разделение вокала и музыки по всем дорожкам
Когда после генерации песни требуется выполнить разделение вокала и музыки по всем дорожкам, можно указать следующее содержимое:- action: значение —
all_stems. - audio_id: ID ранее сгенерированной песни.
Добавление аудиодорожки
add_stem генерирует целевую инструментальную или голосовую дорожку для указанного аудио, вызывается через POST /suno/audios.
- Обязательные:
action、audio_id、stem_type。 - Необязательные:
model、prompt、title、style、negative_tags、weirdness、style_influence、audio_weight、max_mode、variety。 - Тарификация: обычный режим — 0.672 Credits; когда
max_modeимеет значениеtrue— 1.344 Credits。
Извлечение аудиодорожки
extract_stem извлекает целевую аудиодорожку из указанного аудио, одновременно возвращая комплементарную версию после удаления этой аудиодорожки, вызывается через POST /suno/audios.
- Обязательные:
action、audio_id、stem_type。 - Необязательный:
audio_format, текущий публичный контракт с двумя каналами поддерживает толькоmp3。 - Тарификация: 1.12 Credits。
data сохраняет плоский список аудио, а stem_sets обозначает соответствие между целевой аудиодорожкой и комплементарной аудиодорожкой:
Генерация звуковых эффектов
sounds генерирует одноразовые или циклические звуковые эффекты на основе текстового описания, вызывается через POST /suno/audios.
- Обязательные:
action、sound、sound_type。 - Необязательные:
model、bpm、key、audio_format;audio_formatв настоящее время поддерживает толькоmp3。 sound_type:one-shotилиloop。- Тарификация: 0.112 Credits。
Настройка скорости аудио
adjust_speed настраивает скорость воспроизведения указанного аудио через вызов POST /suno/audios.
- Обязательные:
action,audio_id,speed_multiplier,title. - Необязательный:
keep_pitch. speed_multiplier: диапазон 0.25–4.- Стоимость: 0.28 Credits.
Расширенные параметры пользовательской генерации
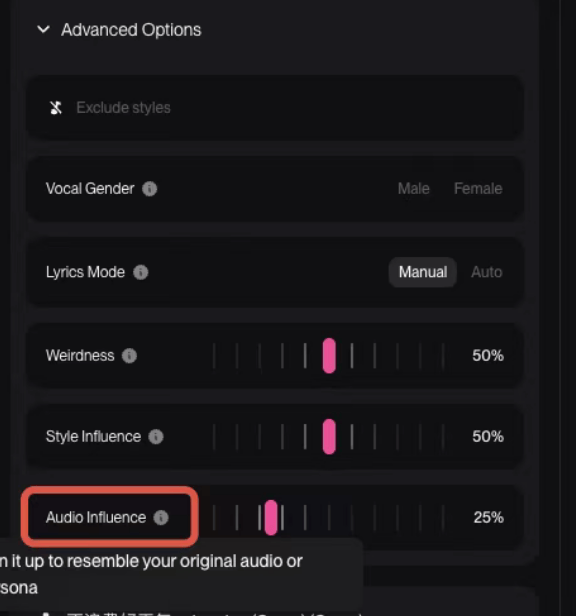
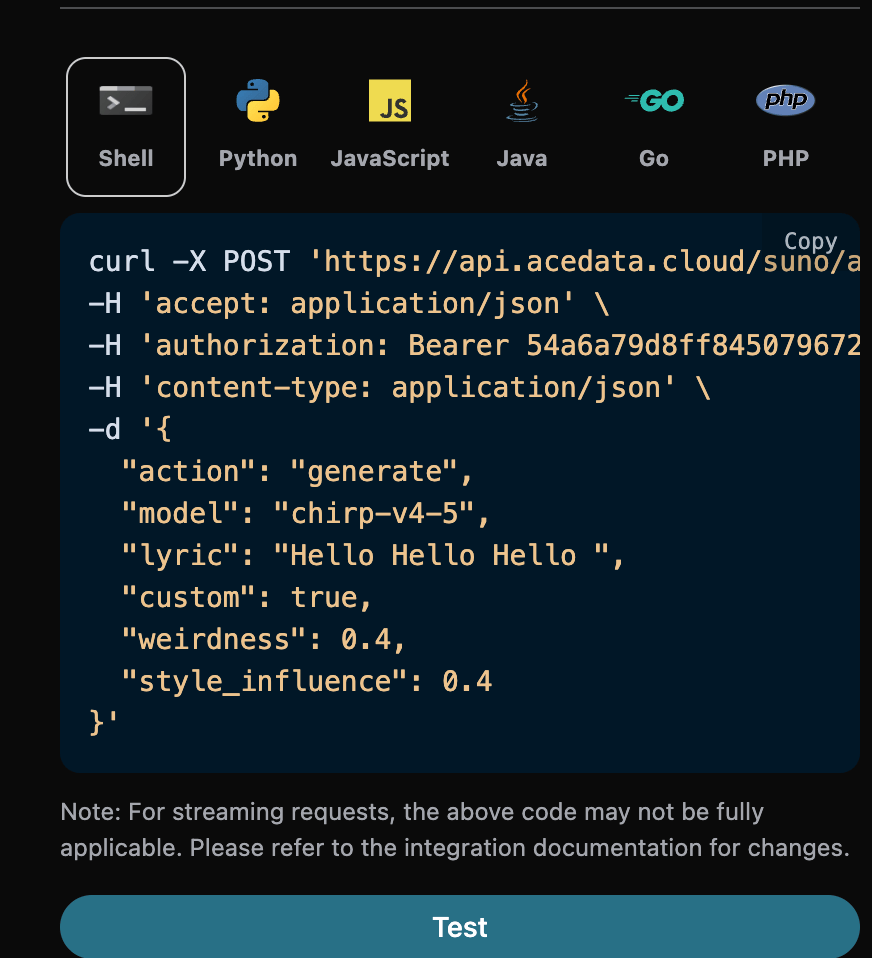
Официально разрешено использовать расширенные параметрыweirdness==>Weirdness, style_influence==>Style Influence, audio_weight==>Audio Influence для генерации в пользовательском режиме, соответствующие официальные примеры приведены ниже:
Управление длительностью песни
По умолчанию длительность генерируемой песни определяется самой моделью и обычно составляет от 30 секунд до 4 минут. Если требуется более длинный или более короткий готовый результат, можно указать желаемую длительность через параметрduration, единица измерения — секунды, допустимы целые значения от 10 до 360.
Этот параметр используется для генерации песен в пользовательском режиме (custom имеет значение true). Следует особо отметить, что duration — это ориентирующая подсказка, а не жёсткое ограничение: модель будет учитывать это значение при создании, но не гарантирует его достижения; на практике фактическая длительность обычно значительно меньше ожидаемого значения, а длительность двух песен, возвращённых одним и тем же запросом, также может различаться в несколько раз. Даже при полностью одинаковых запросах длительность, полученная при многократной отправке, может значительно различаться. Поэтому не следует использовать его как точное управление длительностью; если в бизнес-логике требуется фиксированная длительность, после получения готового результата самостоятельно обрежьте его или повторите попытку.
Соответствующий код Python:
duration в запросе является ожидаемой длительностью, тогда как поле duration каждой песни в ответе data является фактической длительностью данной песни. Названия у них одинаковые, но значения различаются; фактическая длительность не гарантированно равна ожидаемому значению. Длина текста песни является одним из основных факторов, влияющих на длительность готового результата; если требуется более длинный результат, рекомендуется также предоставить более полный текст песни.
Интерфейс проверяет, что duration должно быть целым числом от 10 до 360; это всё ещё лишь цель генерации, а не гарантия длительности готового результата.
Функция Add Insterumental
В августе 2025 года Suno представил новую функцию Add Insterumental. Сначала необходимо загрузить песню а капелла без озвучки, чтобы Suno помог вам добавить музыкальное сопровождение. Сначала можно загрузить песню а капелла без музыкального сопровождения через Suno Upload API, соответствующие действия показаны на рисунке ниже: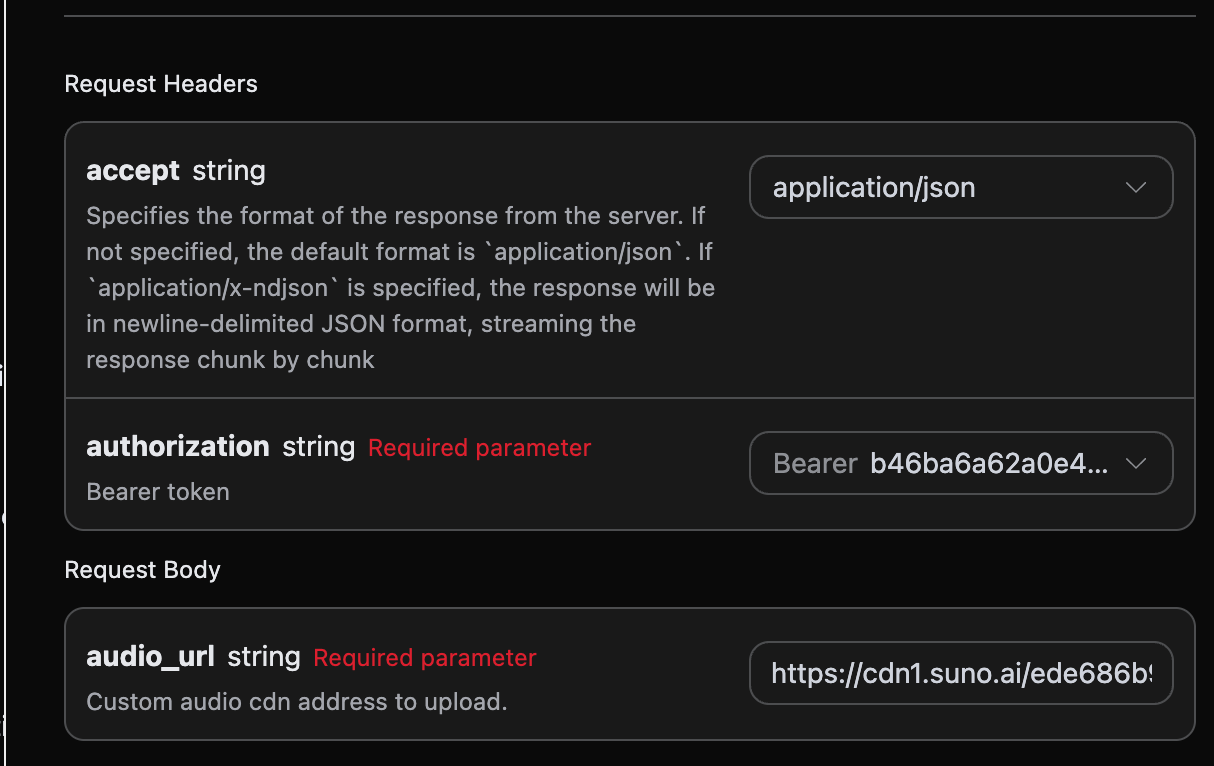
audio_id после загрузки, конкретный результат показан на рисунке ниже:
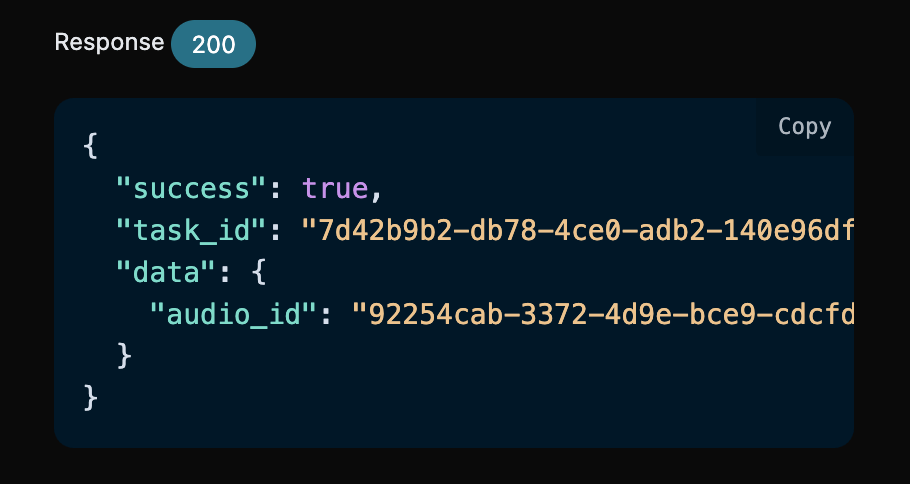
audio_id: 92254cab-3372-4d9e-bce9-cdcfdbc39070, затем нам также необходимо заполнить следующие параметры:
- action: значение —
underpainting. - underpainting_start: время начала добавления сопровождения к загруженной песне, значение по умолчанию — 0.
- underpainting_end: время окончания добавления сопровождения к загруженной песне, должно быть меньше общей длительности песни.
- audio_id: ID загруженной песни а капелла без озвучки.
- style: стиль сопровождения, лучше не использовать текст песни, ведь это озвучка.
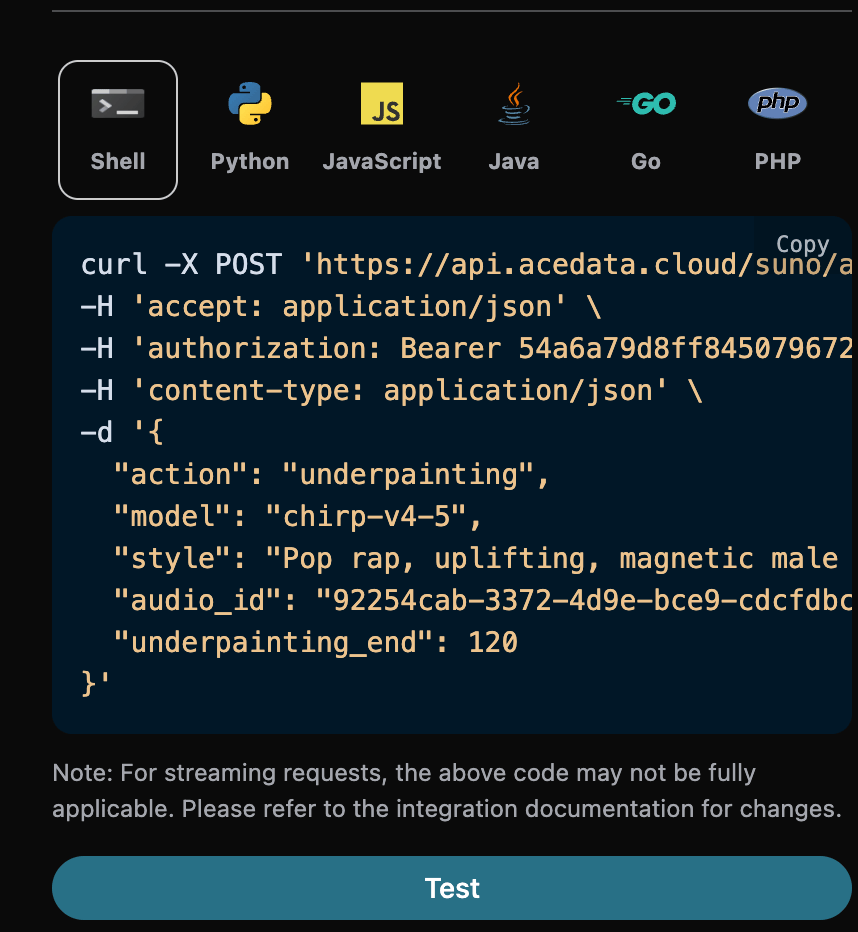
Функция Add Vocals
В августе 2025 года Suno представил новую функцию Add Vocals. Сначала необходимо загрузить инструментальную музыку, чтобы Suno написал текст и создал вокальное исполнение. Сначала можно загрузить песню а капелла без музыкального сопровождения через Suno Upload API, соответствующие действия показаны на рисунке ниже:
audio_id после загрузки, конкретный результат показан на рисунке ниже:
audio_id: 92254cab-3372-4d9e-bce9-cdcfdbc39070, затем нам также необходимо заполнить следующие параметры:
- action: значение —
overpainting. - overpainting_start: время начала добавления вокала к загруженной песне, значение по умолчанию — 0.
- overpainting_end: время окончания добавления вокала к загруженной песне, должно быть меньше общей длительности песни.
- audio_id: ID загруженной песни а капелла без озвучки.
- custom: в этом режиме необходимо использовать пользовательский режим для ввода текста песни.
- lyric: текст песни, введённый в пользовательском режиме.
- style: стиль сопровождения.
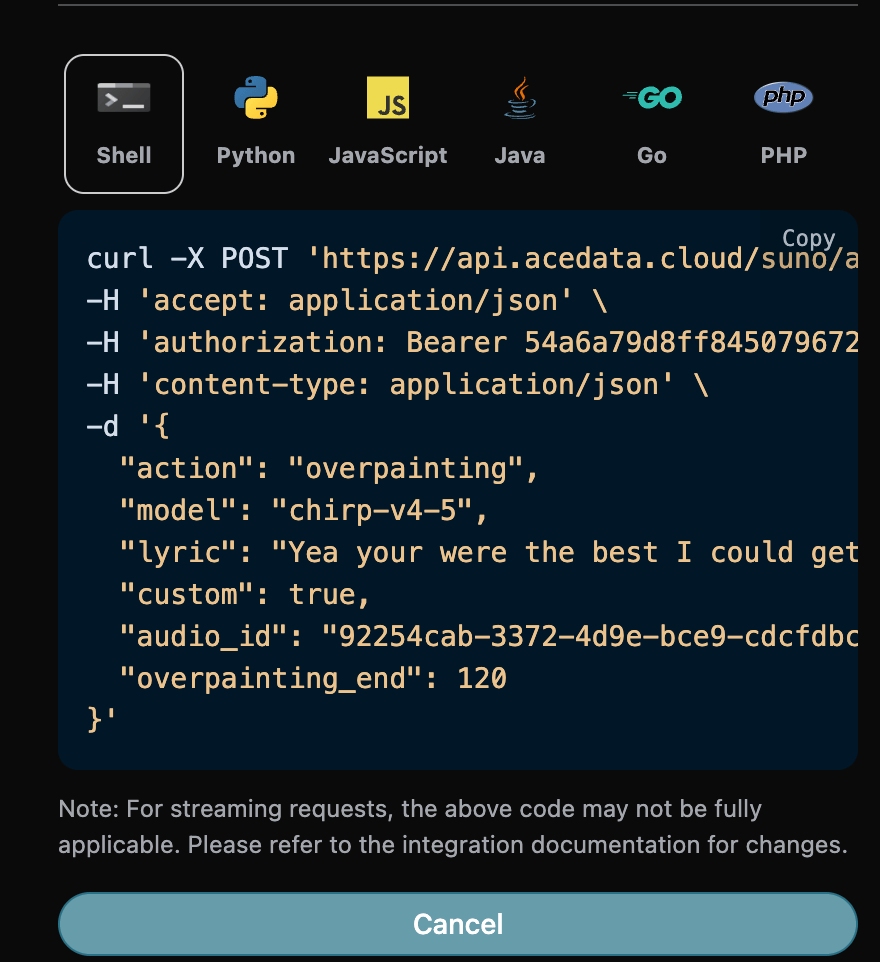
Функция Remaster
В декабре 2025 года suno представил новую функцию Remaster, эта функция может заново генерировать песни, нельзя использовать между аккаунтами, затем нам также нужно заполнить следующие параметры:- action: значение —
remaster. - audio_id: ID песни, которую необходимо сгенерировать заново.
- model: поддерживаются только v4.5+ и v5.
- variation_category: поддерживается только в версиях выше v5, и имеет только 3 значения: high, normal, subtle.
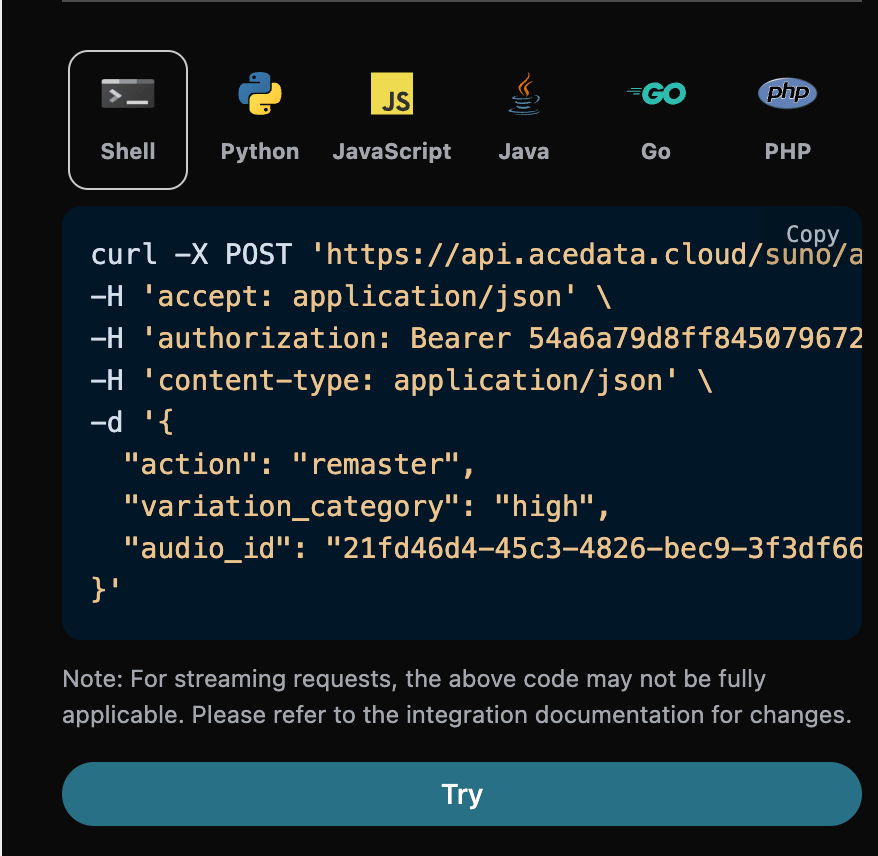
Функция генерации смешанных треков Mashup
В декабре 2025 года suno представил новую функцию Mashup, эта функция может генерировать песню на основе двух эталонных песен, затем нам также нужно заполнить следующие параметры:- action: значение —
mashup. - mashup_audio_ids: ID двух эталонных песен. 填写完毕之后自动生成了代码如下:
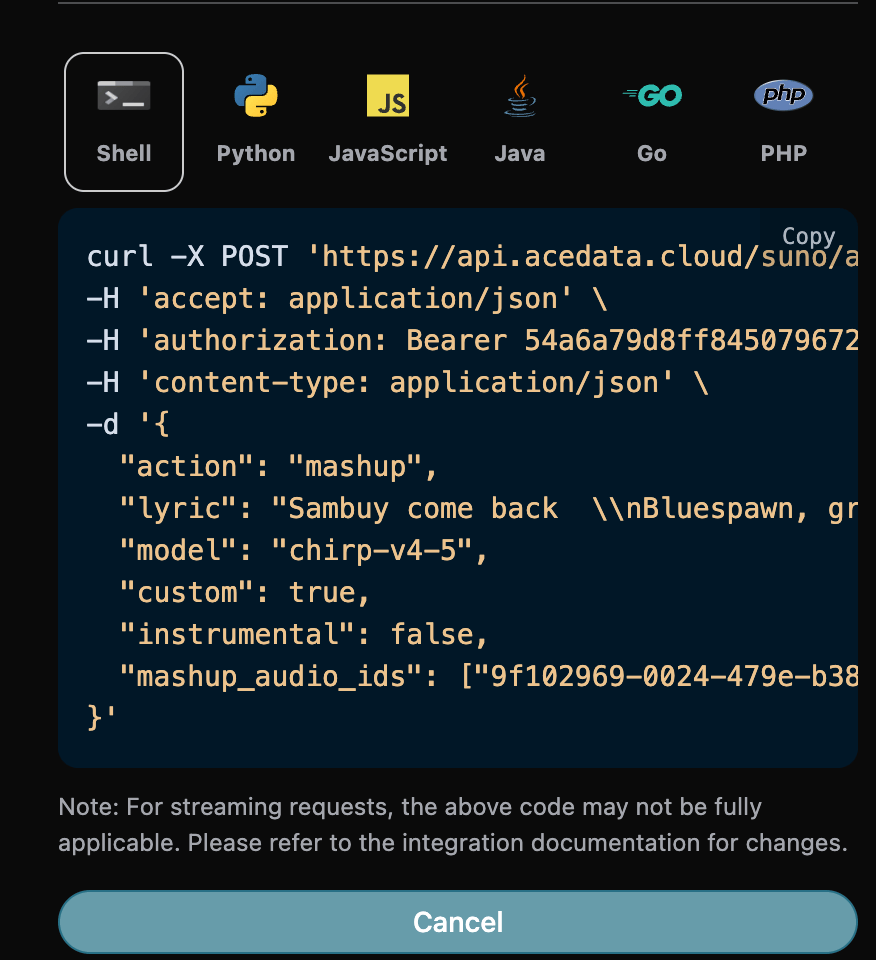
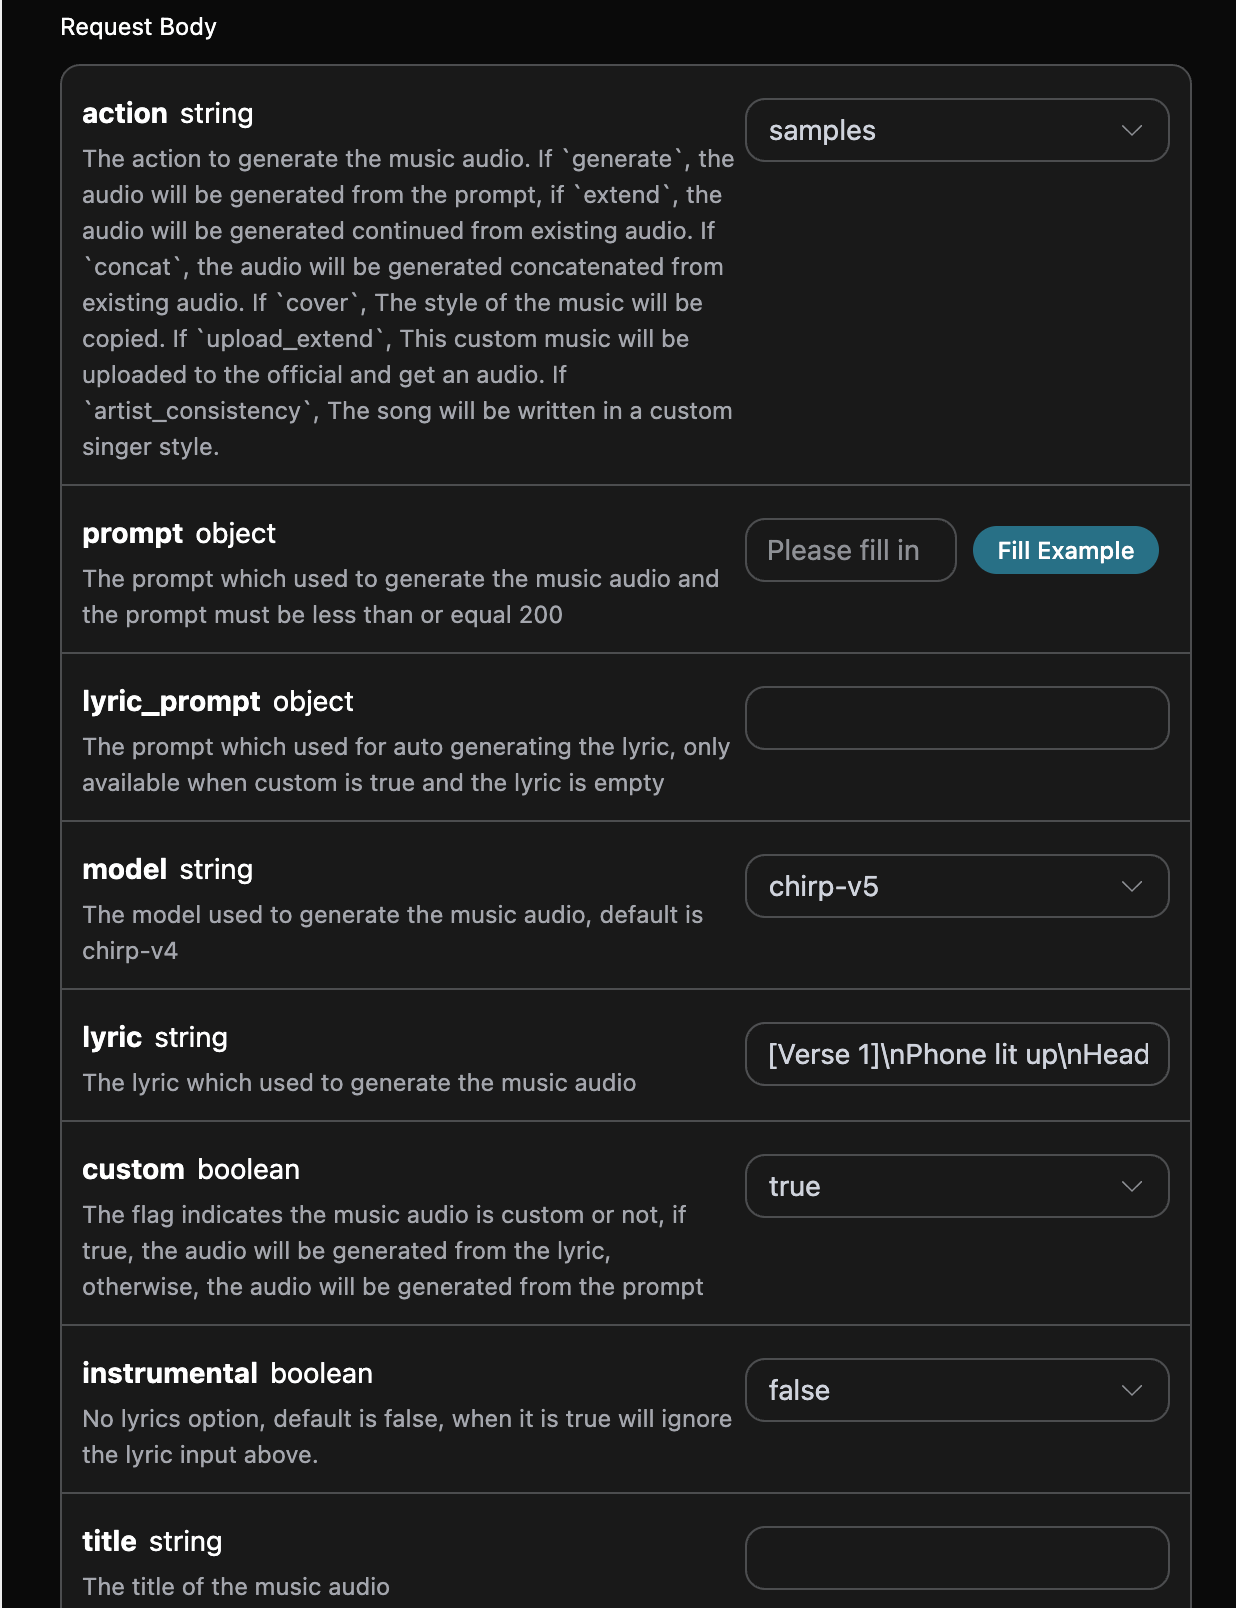
Samples Создание песни на основе сэмпла
Здесьsamples — это выборка одного аудиоинтервала: из существующего аудио выбирается время начала и окончания, и этот фрагмент используется в качестве материала для сэмплирования при создании. Это отличается от функции творческого создания по вдохновению Inspo, использующей от 1 до 4 полных референсных аудиозаписей, описанной ниже. Необходимо заполнить следующие параметры:
- action: значение —
samples. - samples_start: время начала выборки.
- samples_end: время окончания выборки.
- audio_id: ID референсной песни, которую необходимо использовать для выборки.
Функция вдохновляющего творчества Inspo
Функция вдохновляющего творчества Inspo может генерировать новую музыку на основе 1–4 полных эталонных аудиозаписей и поддерживает перетаскивание или загрузку аудио в качестве источника вдохновения. API использует существующее действиеinspo: клиент предоставляет общедоступные URL-адреса аудио, а сервис автоматически выполняет подготовку эталонного аудио и создание композиции; клиенту не требуется отдельно считывать текст, стиль или длительность, а затем собирать запрос. Она отличается как от описанного выше интервального сэмплирования, так и от Cover, воспроизводящего стиль оригинальной песни. При использовании необходимо заполнить следующие параметры:
- action: значение —
inspo. - audio_urls: список URL-адресов эталонного аудио; необходимо предоставить от 1 до 4 общедоступных аудиоадресов.
- model: используемая модель, рекомендуется
chirp-v6. - prompt: текст песни или подсказка для творчества (необязательно).
Примечание: эталонное аудио должно быть общедоступным аудиофайлом. Если эталонное аудио полностью совпадает с известной записью в библиотеке треков платформы, Suno может отклонить генерацию из-за проверки авторских прав; рекомендуется использовать собственное аудио или аудио, сгенерированное Suno, в качестве источника вдохновения.Соответствующий код Python:
chirp-v5, в текущем примере запроса рекомендуется chirp-v6, структура ответа одинакова:
Асинхронный обратный вызов
Поскольку Suno генерирует музыку относительно долго, примерно 1–2 минуты, если API долго не отвечает, HTTP-запрос будет постоянно поддерживать соединение, что приводит к дополнительному потреблению системных ресурсов, поэтому этот API также поддерживает асинхронные обратные вызовы. Общий процесс таков: когда клиент инициирует запрос, он дополнительно указывает полеcallback_url; после того как клиент инициирует API-запрос, API немедленно возвращает результат, содержащий поле task_id, представляющее ID текущей задачи. После завершения задачи результат сгенерированной музыки будет отправлен в виде POST JSON на указанный клиентом callback_url, который также включает поле task_id, благодаря чему результаты задач можно связать по ID.
Ниже мы на примере рассмотрим, как именно это работает.
Сначала, обратный вызов Webhook — это сервис, способный принимать HTTP-запросы, разработчик должен заменить его на URL собственного HTTP-сервера. Здесь для удобства демонстрации используется публичный сайт с примером Webhook https://webhook.site/; открыв этот сайт, можно получить Webhook URL, как показано на рисунке:
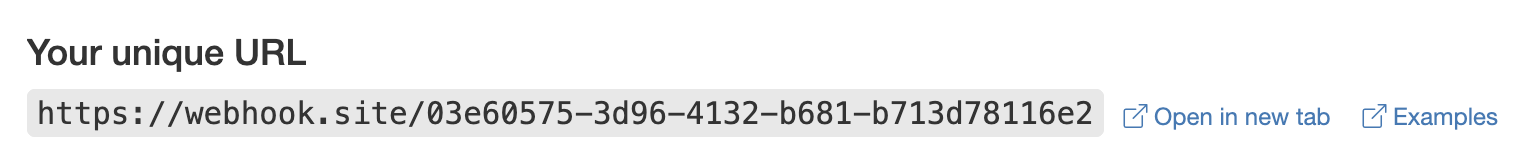 Скопировав этот URL, его можно использовать как Webhook; пример здесь — https://webhook.site/03e60575-3d96-4132-b681-b713d78116e2。
Далее мы можем установить для поля
callback_url указанный выше Webhook URL и одновременно заполнить prompt, как показано на рисунке:
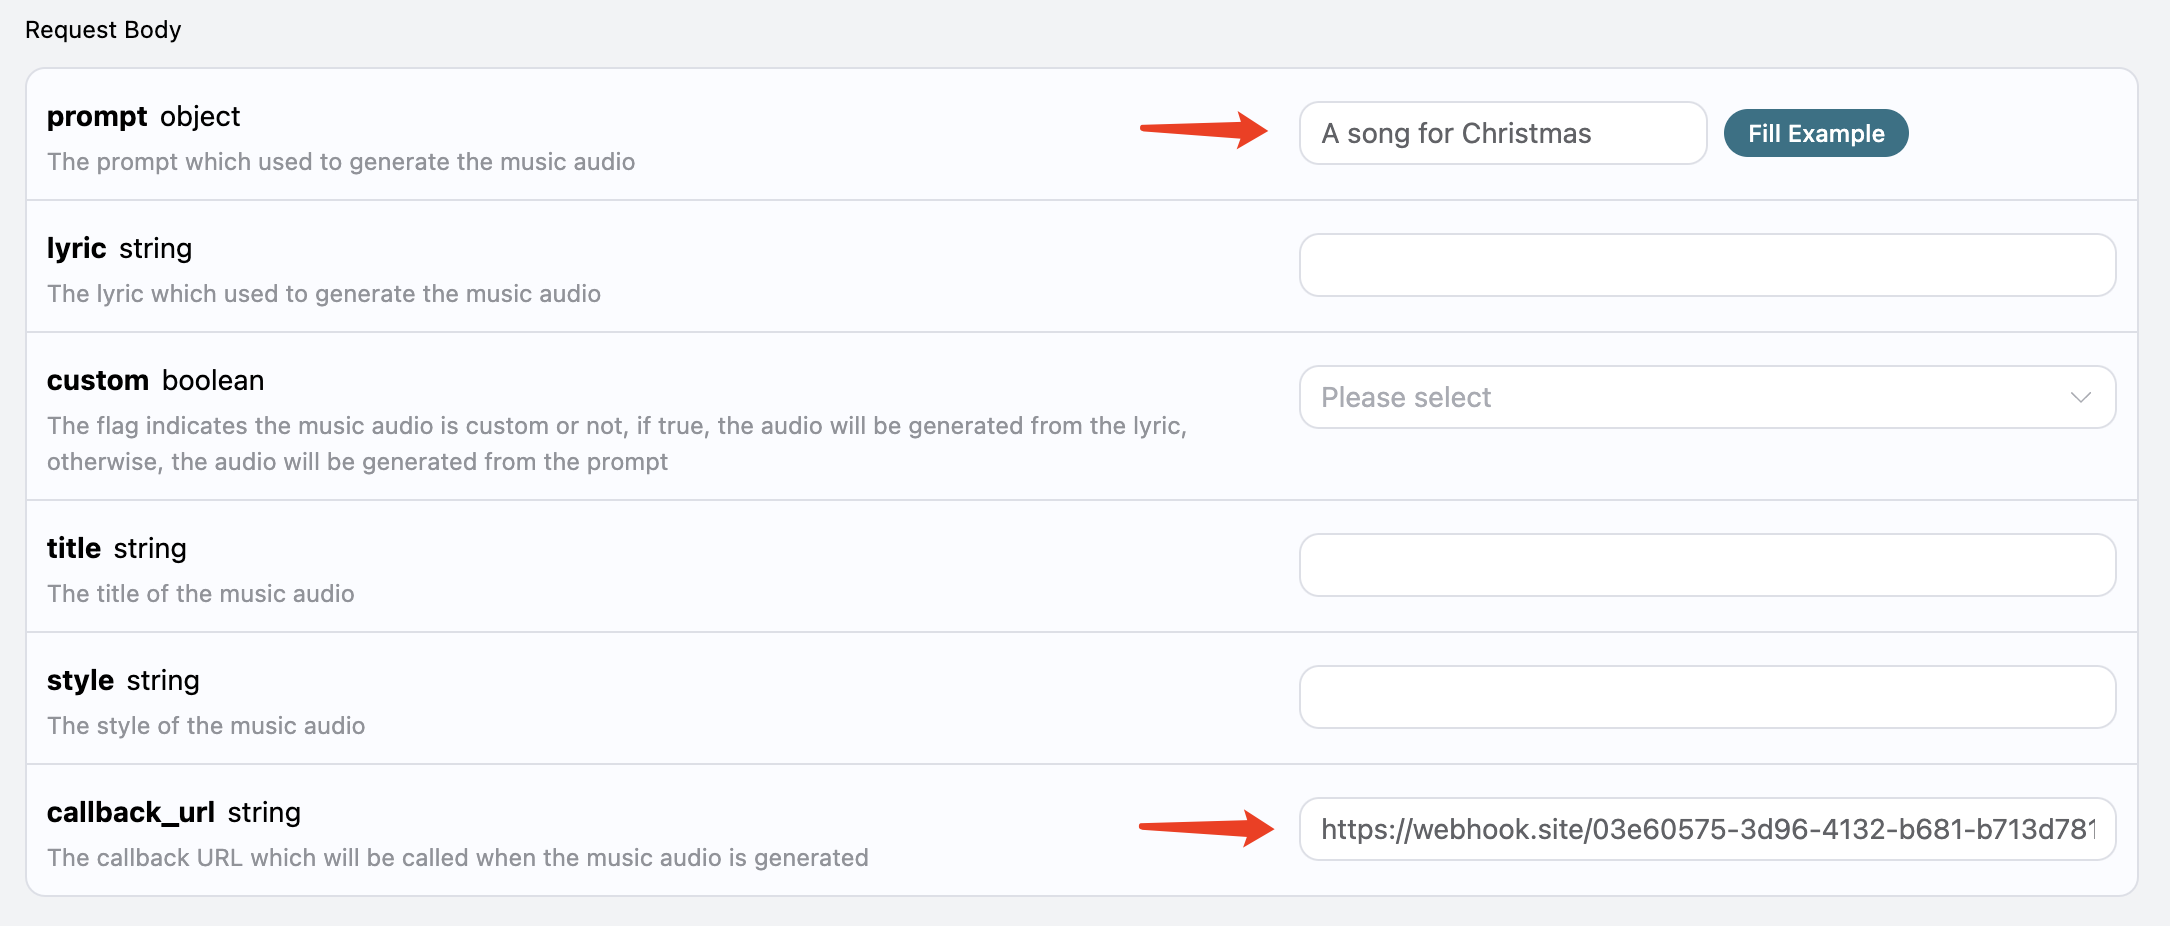 Нажав «Запустить», можно увидеть, что результат будет получен немедленно, как показано ниже:
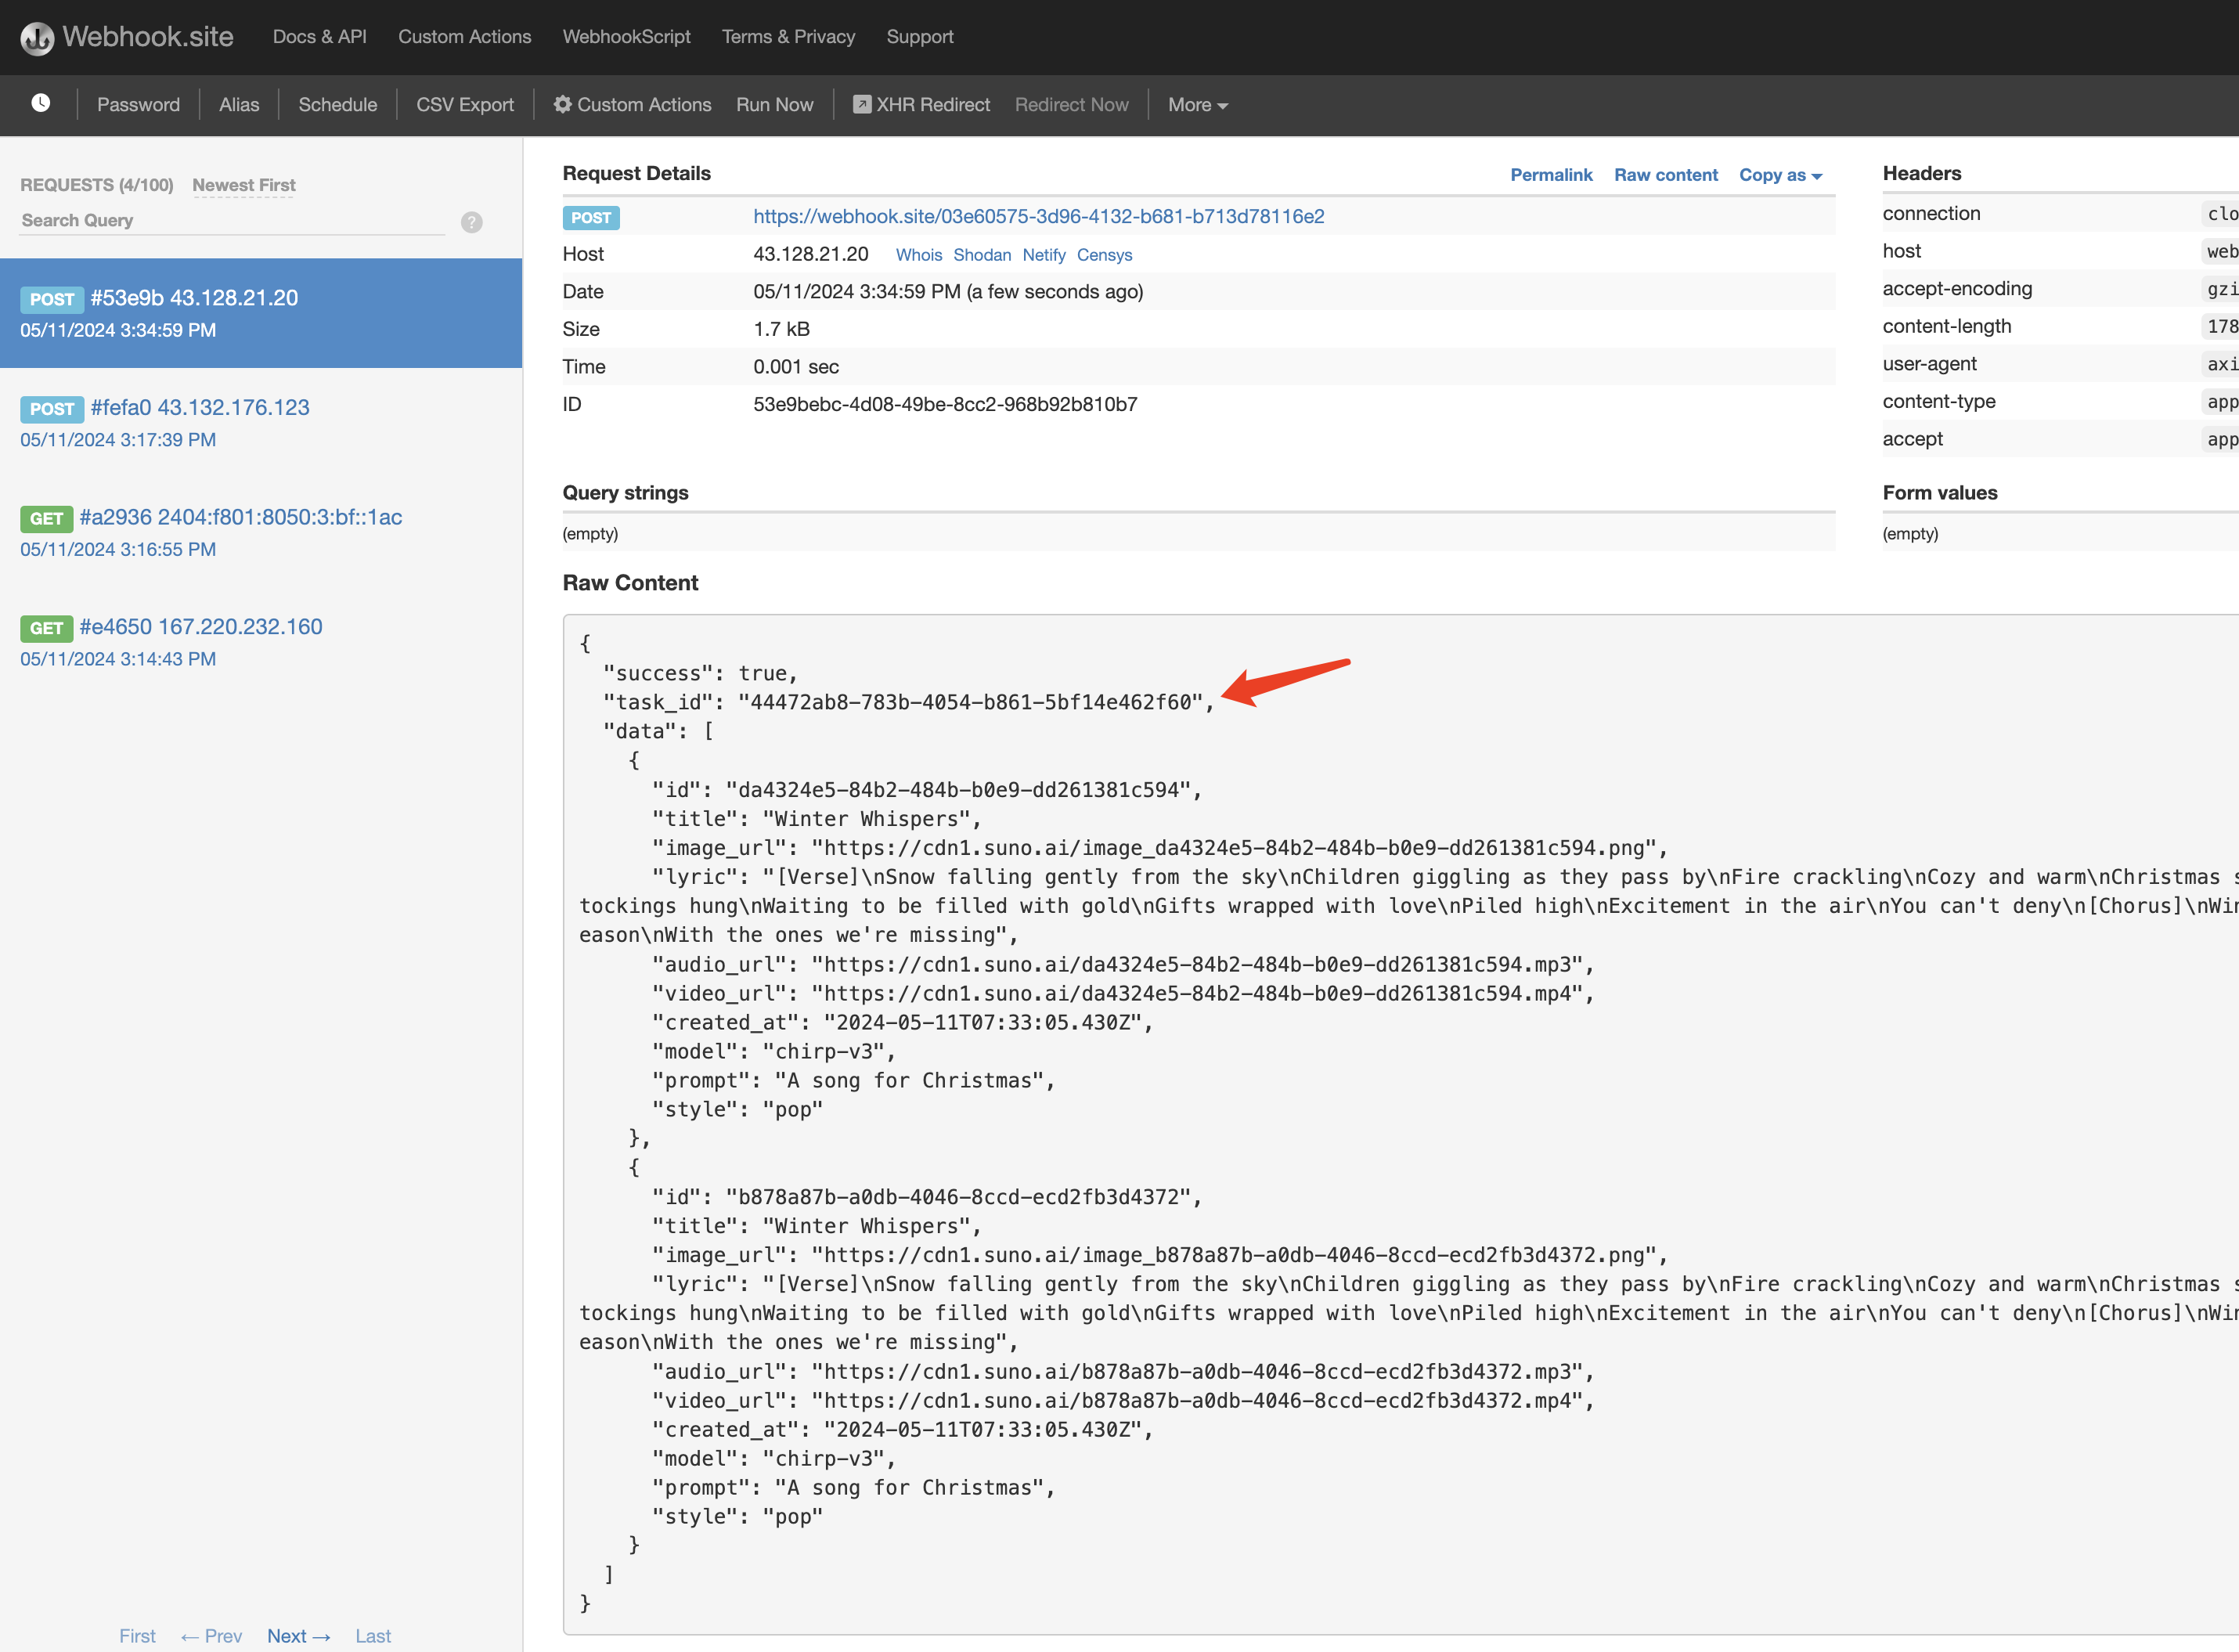 Содержимое следующее:
task_id, а все остальные поля аналогичны описанным выше; с помощью этого поля можно реализовать связь задач.
Конечно, мы также можем получать результаты через потоковый вызов; для этого нужно лишь установить значение accept в заголовке запроса как application/x-ndjson; ниже в качестве демонстрации используется пример ввода:
task_id; выше сохранены только два реальных ответа — первый и финальный, а повторяющиеся промежуточные обновления опущены.
Обработка ошибок
Если произойдёт ошибка, вы получите сообщение об ошибке, подобное следующему:error.code, error.message:
Примечание: лимиты и тексты ошибок для разных аккаунтов вышестоящих провайдеров могут различаться. Обычно уchirp-v3-5/chirp-v4ограничение дляstyleниже (200), тогда какchirp-v4-5и выше обычно поддерживают до 1000; при использовании старого вышестоящего провайдера могут появляться совместимые сообщения, такие какTags too long.илиstyle must be less than or equal 120. | Код состояния |error.code|error.message| | ------------- | ------------- | --------------------------------------------------------------- | | 400 |bad_request|Идентификатор песни не существует или был отключён.| | 400 |bad_request|Промпт слишком длинный.| | 400 |bad_request|Теги слишком длинные.| | 400 |bad_request|Загруженное аудио совпадает с существующим произведением искусства.| | 400 |bad_request|instrumental должен быть логическим значением| | 400 |bad_request|Название слишком длинное.| | 400 |bad_request|Тема слишком длинная.| | 400 |bad_request|style должен быть меньше или равен 120| | 400 |bad_request|custom должен быть логическим значением| | 400 |bad_request|audio_id обязателен при расширении аудио| | 400 |bad_request|continue_at обязателен при расширении аудио| | 400 |bad_request|continue_at должен быть числом больше 0| | 400 |bad_request|lyric обязателен при расширении аудио, когда instrumental имеет значение false| | 400 |bad_request|prompt обязателен при генерации аудио| | 400 |bad_request|lyric обязателен при генерации пользовательского аудио| | 403 |forbidden|Промпт, вероятно, имеет неверный формат| | 403 |forbidden|Промпт, вероятно, защищён авторским правом| | 403 |forbidden|Промпт содержал неподходящий материал| | 403 |forbidden|Описание песни помечено для модерации| | 403 |forbidden|Описание песни содержало имя исполнителя| | 403 |forbidden|Теги содержали имя исполнителя| | 403 |forbidden|Текст песни содержал материал, защищённый авторским правом| | 403 |forbidden|Описание песни содержало тег продюсера| | 403 |forbidden|Общая ошибка openAI| | 403 |forbidden|Промпт помечен для модерации| | 500 |api_error|Невозможно сгенерировать текст песни из описания песни| | 500 |api_error|задача завершилась с неизвестной ошибкой| | 500 |api_error|в системе нет доступных воркеров| | 500 |api_error|сервис находится на обслуживании, генерация приостановлена| | 504 |timeout|тайм-аут во время ожидания генерации аудио|