

Beantragungsprozess
Um die OpenAI Embeddings API zu verwenden, rufen Sie zunächst die Ace Data Cloud-Konsole auf, um Ihren API-Token zu erhalten, und bewahren Sie ihn zur späteren Verwendung auf. Wenn Sie noch nicht angemeldet oder registriert sind, werden Sie automatisch zur Anmeldeseite weitergeleitet, auf der Sie zur Registrierung und Anmeldung eingeladen werden. Nach Abschluss kehren Sie automatisch zu dieser Seite zurück.
Ein API-Token kann alle Dienste der Plattform aufrufen; es ist nicht erforderlich, für jeden Dienst einzeln einen Antrag zu stellen. Bei der ersten Beantragung erhalten Sie ein kostenloses Guthaben, das Sie zum kostenlosen Ausprobieren verwenden können; bei unzureichendem Guthaben können Sie in der Konsole ein allgemeines Guthaben aufladen.
📘 Vollständige Dokumentation: OpenAI Embeddings API →
Grundlegende Verwendung
Als Nächstes können Sie die entsprechenden Inhalte in der Benutzeroberfläche ausfüllen, wie in der Abbildung gezeigt: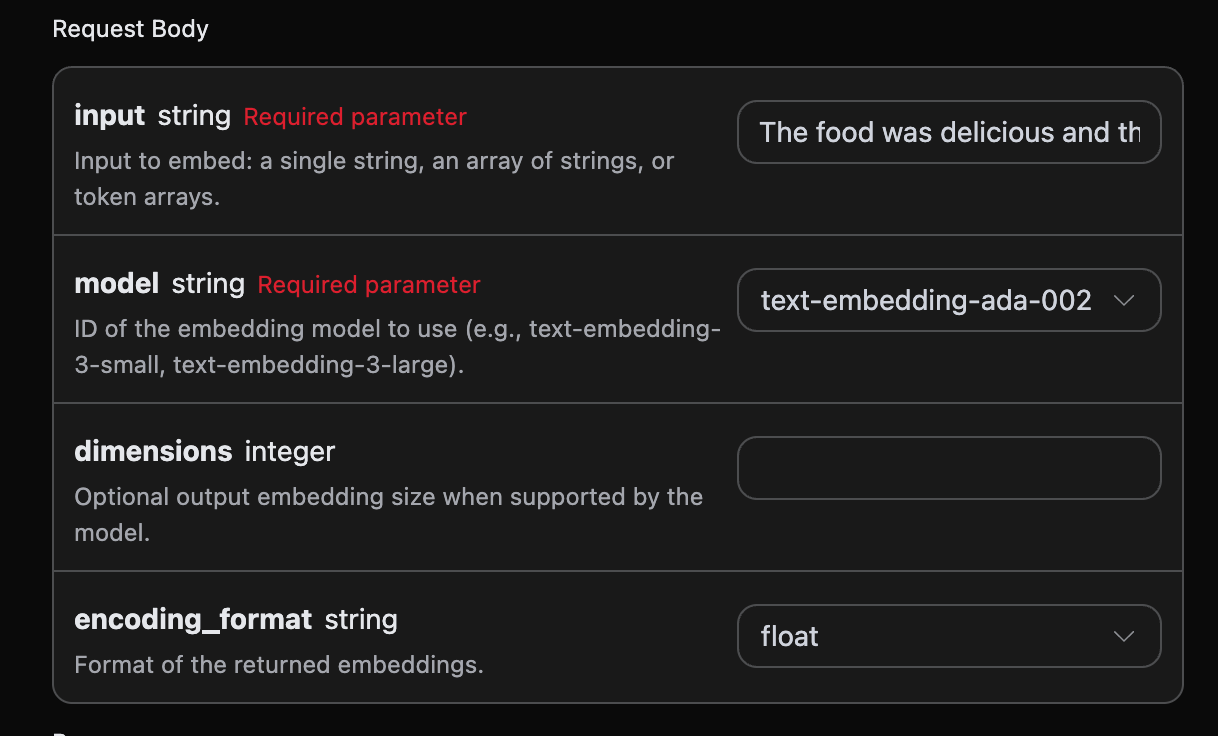
authorization, den Sie direkt in der Auswahlliste auswählen können. Ein weiterer Parameter ist model; model ist die Modellkategorie der offiziellen OpenAI-Website, die wir zur Verwendung auswählen. Die derzeit verfügbaren Modelle sind text-embedding-3-small und text-embedding-3-large. text-embedding-ada-002 wird nicht mehr angeboten; wenn bestehende Vektorindizes dieses alte Modell verwenden, können die Vektoren neuer Modelle nicht direkt gemischt verwendet werden, und der Index muss neu erstellt werden. Der letzte Parameter ist input; input ist der Text, dessen Wortvektoren wir umwandeln müssen.
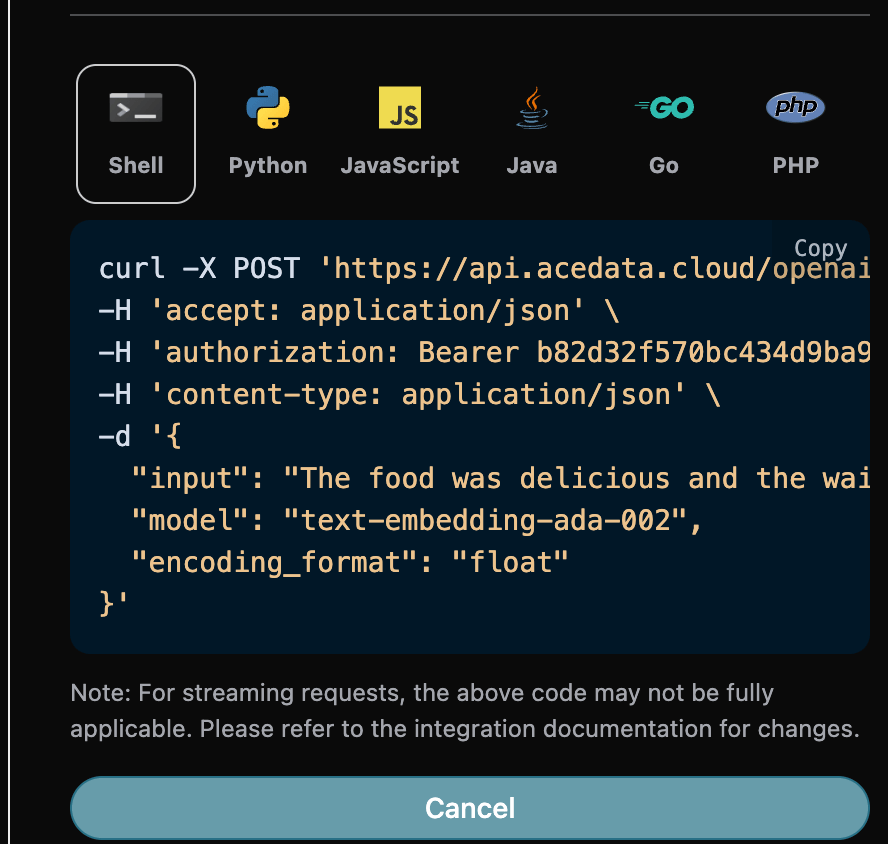
Gleichzeitig können Sie beachten, dass auf der rechten Seite entsprechender generierter Aufrufcode vorhanden ist. Sie können den Code kopieren und direkt ausführen oder direkt auf die Schaltfläche „Try“ klicken, um ihn zu testen.
Optionale Parameter:
dimensions: Schneidet die Vektordimension zu, standardmäßig wird die vollständige Dimension ausgegeben.encoding_format: Rückgabeformat, wahlweisefloatoderbase64.
model, das Modell, das bei dieser Umwandlung von Text in Wortvektoren verwendet wurde.usage, die Token-Informationen, die bei dieser Umwandlung von Text in Wortvektoren verwendet wurden.data, das Ergebnis der Wortvektoren nach der Textumwandlung.
data die spezifischen Informationen zu den Wortvektoren, die dem Text entsprechen, und das darin enthaltene embedding ist das konkrete Ergebnis der generierten Wortvektoren.
Fehlerbehandlung
Wenn bei der Aufrufung der API ein Fehler auftritt, gibt die API den entsprechenden Fehlercode und die entsprechende Information zurück. Zum Beispiel:400 token_mismatched: Bad request, möglicherweise aufgrund fehlender oder ungültiger Parameter.400 api_not_implemented: Bad request, möglicherweise aufgrund fehlender oder ungültiger Parameter.401 invalid_token: Nicht autorisiert, ungültiger oder fehlender Autorisierungs-Token.429 too_many_requests: Zu viele Anfragen, Sie haben das Ratenlimit überschritten.500 api_error: Interner Serverfehler, auf dem Server ist etwas schiefgelaufen.