

GPT-6.1 Sol
Verwenden Siemodel: "gpt-6.1-sol", um dieses Modell auszuwählen. Es unterstützt Streaming-Ausgabe, Funktionsaufrufe, strukturierte Ausgabe und Bildeingabe. In der ersten Woche nach der Freigabe ist es nur für verifizierte ACE-T1+-Inhaber (mindestens 100.000 ACE) oder autorisierte Benutzer verfügbar; die konkrete Freigabezeit richtet sich nach dem Zugriffshinweis in der Konsole.
Die Reasoning-Stufen unterstützen low, medium, high, xhigh und max; none oder minimal werden vorerst nicht unterstützt. Es wird empfohlen, mit reasoning_effort: "low" zu beginnen. Wenn die Eingabe 272.000 Tokens überschreitet, gilt für die gesamte Anfrage die Preisgestaltung für langen Kontext; die Gebühren richten sich nach den aktuellen Preisen in der Konsole.
Antragsprozess
Um die OpenAI Chat Completion API zu nutzen, rufen Sie zunächst die Ace Data Cloud-Konsole auf, um Ihren API-Token zu erhalten und ihn als Reserve aufzubewahren. Wenn Sie sich noch nicht angemeldet oder registriert haben, werden Sie automatisch zur Anmeldeseite weitergeleitet, auf der Sie zur Registrierung und Anmeldung eingeladen werden; nach Abschluss kehren Sie automatisch zur aktuellen Seite zurück.
Ein API-Token kann alle Dienste der Plattform aufrufen, ohne dass Sie ihn für jeden Dienst einzeln beantragen müssen. Bei der ersten Beantragung wird ein kostenloses Guthaben verschenkt, das kostenlos ausprobiert werden kann; wenn das Guthaben nicht ausreicht, können Sie in der Konsole ein allgemeines Guthaben aufladen.
📘 Vollständige Dokumentation: OpenAI Chat Completion API →
Grundlegende Nutzung
Anschließend können Sie die entsprechenden Inhalte in der Oberfläche ausfüllen, wie in der Abbildung gezeigt: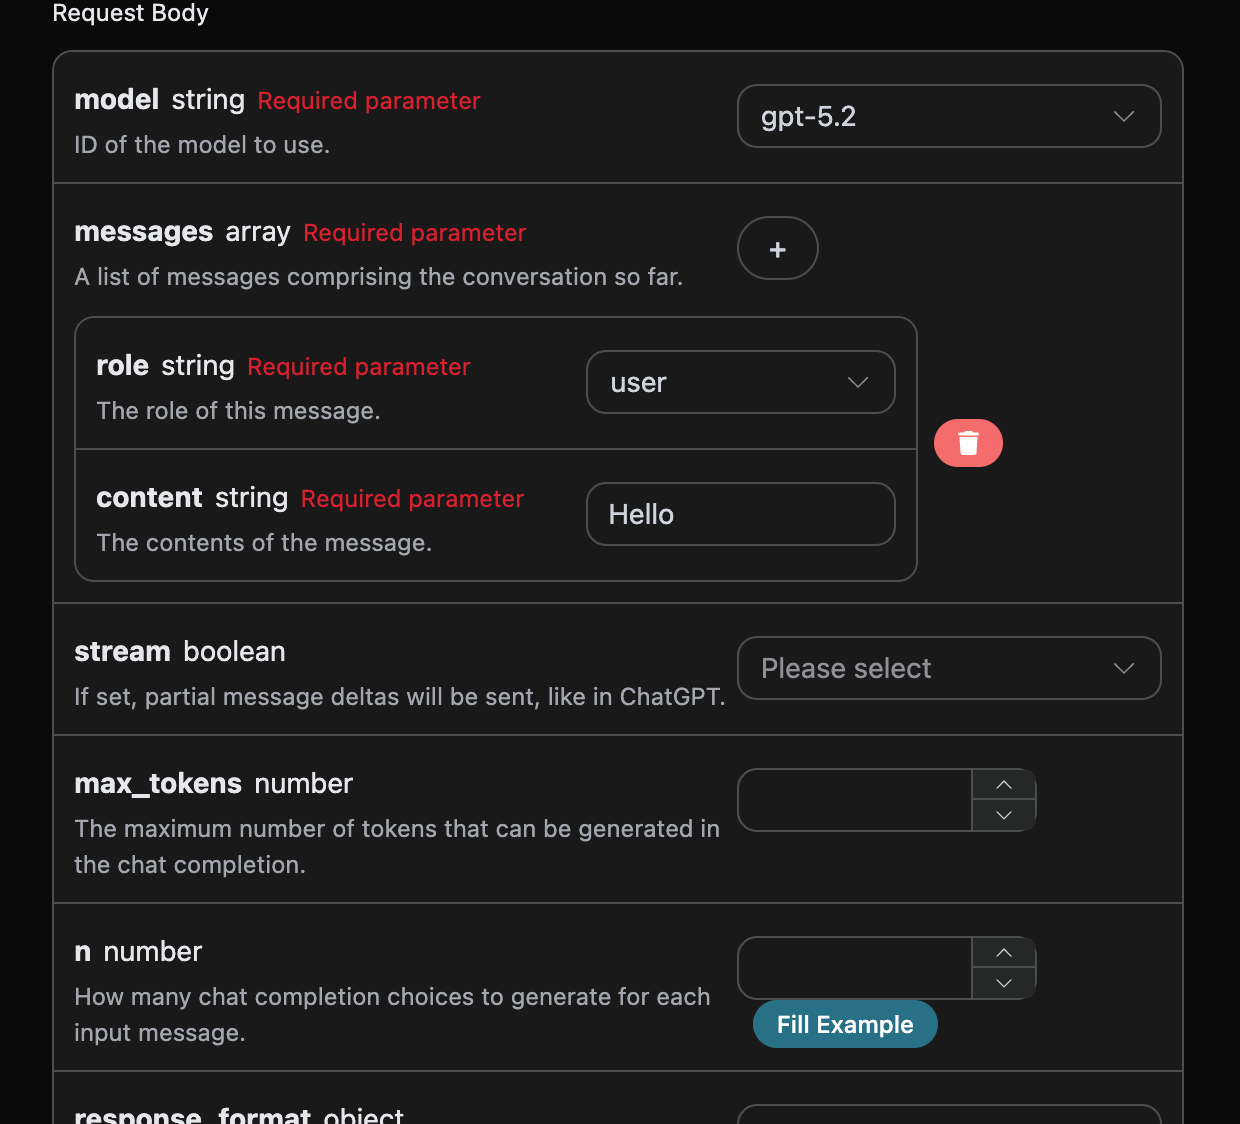
authorization, der direkt in der Dropdown-Liste ausgewählt werden kann. Ein weiterer Parameter ist model; model ist die Modellkategorie der offiziellen OpenAI-ChatGPT-Website, deren Nutzung wir auswählen. Hier haben wir hauptsächlich 20 Modelle; Details finden Sie bei den von uns bereitgestellten Modellen. Der letzte Parameter ist messages; messages ist das Array der von uns eingegebenen Fragewörter. Es ist ein Array und bedeutet, dass mehrere Fragewörter gleichzeitig hochgeladen werden können. Jedes Fragewort enthält role und content, wobei role die Rolle des Fragestellers darstellt. Wir bieten drei Identitäten an, nämlich user, assistant, system. Das andere, content, ist der konkrete Inhalt unserer Frage.
Gleichzeitig können Sie beachten, dass auf der rechten Seite entsprechender Aufrufcode generiert wird. Sie können den Code kopieren und direkt ausführen oder direkt auf die Schaltfläche „Try“ klicken, um ihn zu testen.
Häufig verwendete optionale Parameter:
max_tokens: Begrenzt die maximale Anzahl von Tokens für eine einzelne Antwort.temperature: Zufälligkeit der Generierung, zwischen 0 und 2; je größer der Wert, desto stärker die Streuung.n: Wie viele Kandidatenantworten auf einmal generiert werden.response_format: Einstellung des Rückgabeformats.
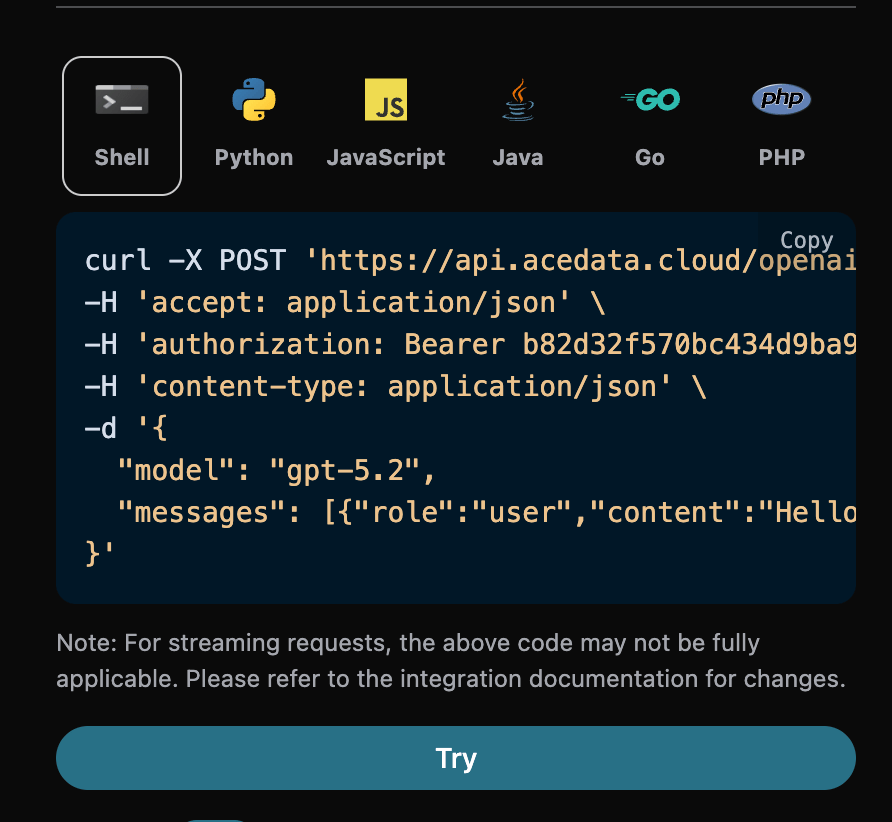
id: Die ID der generierten Dialogaufgabe, die zur eindeutigen Kennzeichnung dieser Dialogaufgabe verwendet wird.model: Das ausgewählte Modell der offiziellen OpenAI-ChatGPT-Website.choices: Die Antwortinformationen, die ChatGPT für die Fragewörter liefert.usage: Statistische Informationen über die Tokens dieses Frage-Antwort-Paars.
choices die Antwortinformationen von ChatGPT; das darin enthaltene choices ist ChatGPT, wie in der Abbildung gezeigt.
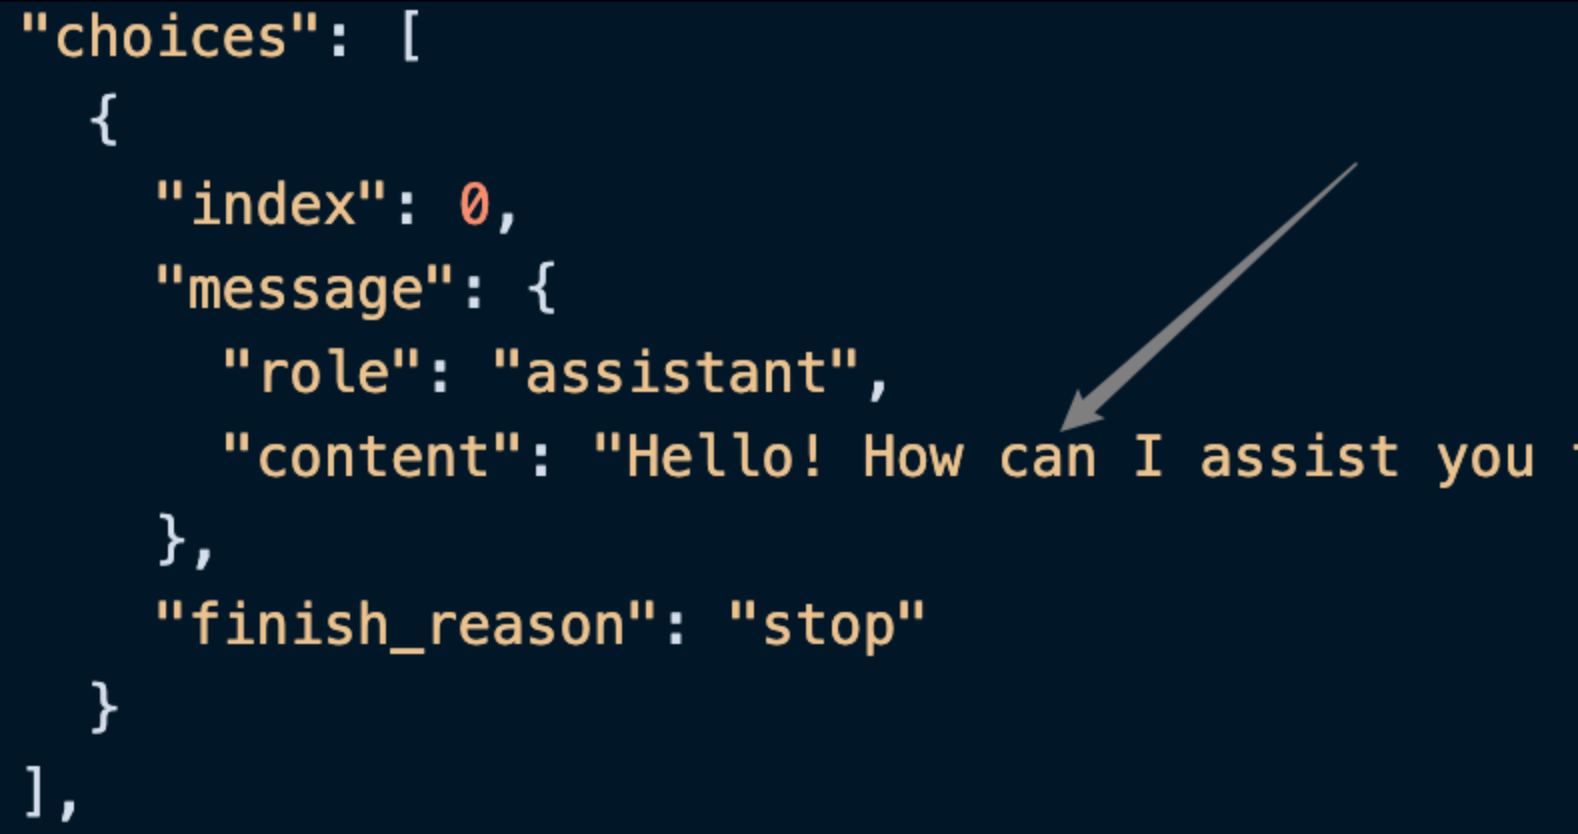
content in choices den konkreten Inhalt der ChatGPT-Antwort enthält.
Streaming-Antwort
Diese Schnittstelle unterstützt auch Streaming-Antworten, was für die Anbindung von Webseiten sehr nützlich ist und es Webseiten ermöglichen kann, einen Effekt der zeichenweisen Anzeige zu erzielen. Wenn Sie die Antwort als Stream zurückgeben möchten, können Sie den Parameterstream im Anfrage-Header ändern und auf true setzen.
Die Änderung ist wie in der Abbildung gezeigt; allerdings muss der Aufrufcode entsprechend geändert werden, um Streaming-Antworten zu unterstützen.
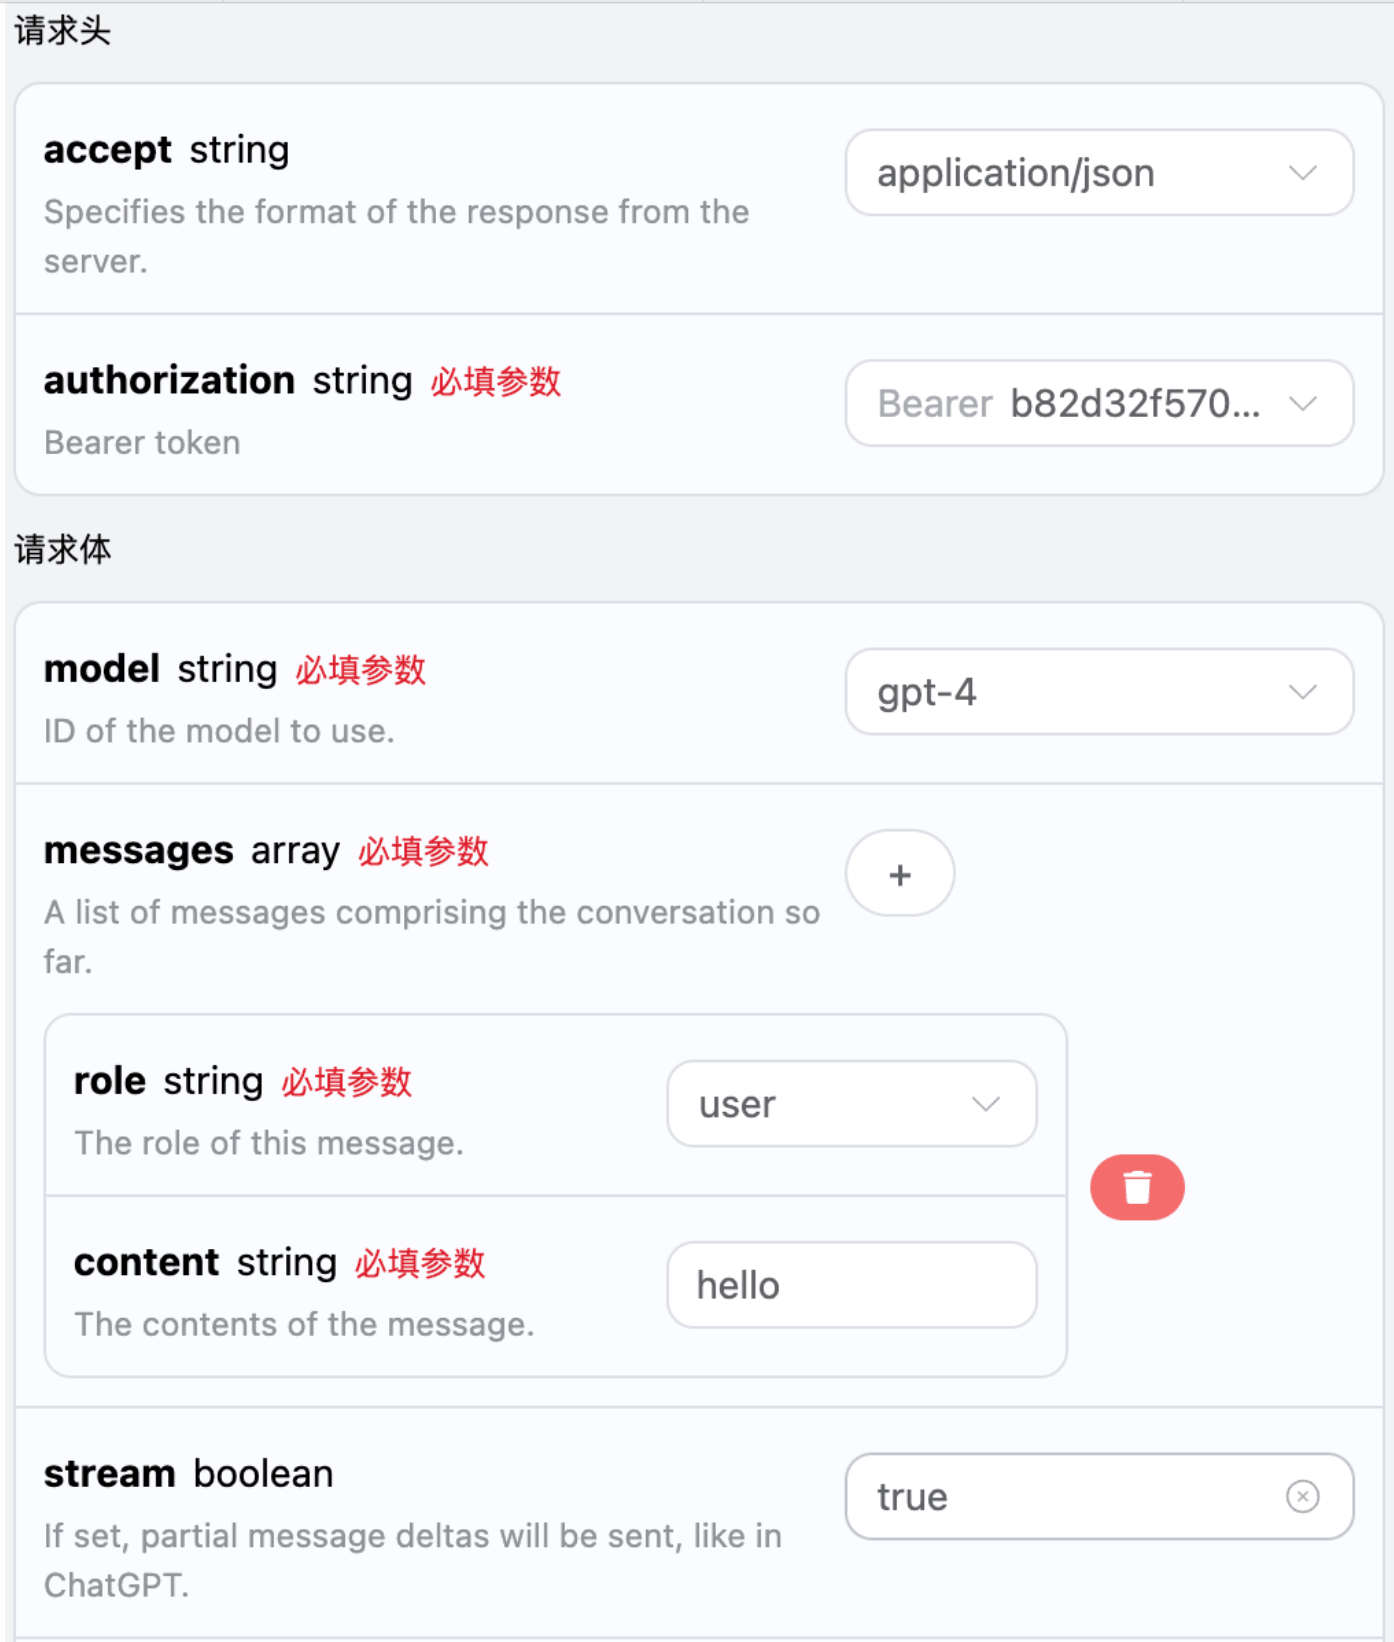
stream auf true geändert wurde, gibt die API die entsprechenden JSON-Daten zeilenweise zurück; auf Codeebene müssen wir entsprechende Änderungen vornehmen, um die zeilenweisen Ergebnisse zu erhalten.
Python-Beispielaufrufcode:
data-Einträge. Die choices innerhalb von data sind der neueste Antwortinhalt, was mit dem zuvor vorgestellten Inhalt übereinstimmt. choices sind neu hinzugefügte Antwortinhalte, die Sie anhand der Ergebnisse in Ihr System integrieren können. Gleichzeitig wird das Ende der Streaming-Antwort anhand des Inhalts von data bestimmt. Wenn der Inhalt [DONE] ist, bedeutet dies, dass die Streaming-Antwort vollständig beendet wurde. Das zurückgegebene data-Ergebnis enthält mehrere Felder, die wie folgt vorgestellt werden:
id, die ID der für diesen Dialog generierten Aufgabe, die zur eindeutigen Kennzeichnung dieser Dialogaufgabe verwendet wird.model, das ausgewählte Modell der offiziellen OpenAI-ChatGPT-Website.choices, die Antwortinformationen, die ChatGPT auf den Frageterm gibt.
Mehrere Gesprächsrunden
Wenn Sie die Funktion für mehrere Gesprächsrunden integrieren möchten, müssen Sie mehrere Frageterme in das Feldmessages hochladen. Ein konkretes Beispiel für mehrere Frageterme ist in der folgenden Abbildung dargestellt:
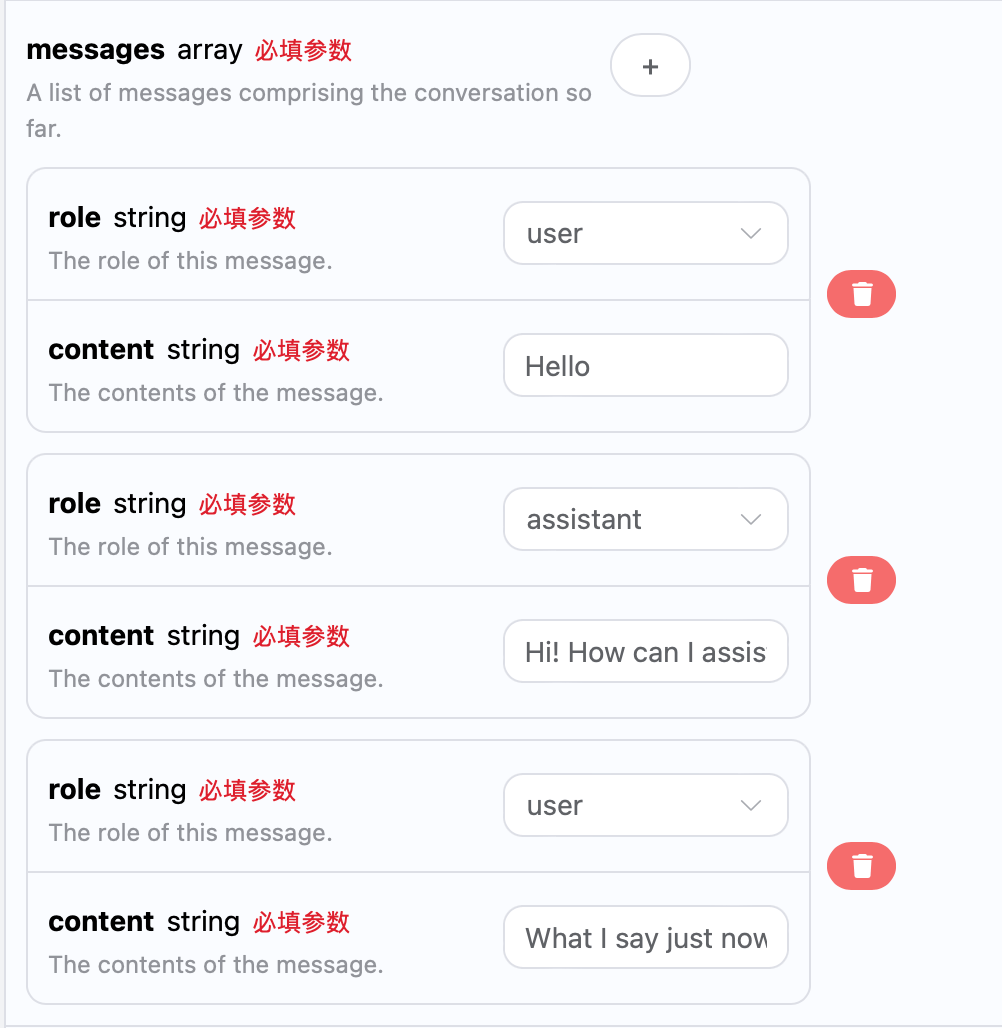
choices enthaltenen Informationen mit dem Inhalt der grundlegenden Verwendung überein. Dies enthält den konkreten Inhalt der Antwort von ChatGPT auf mehrere Gespräche, sodass entsprechende Fragen anhand mehrerer Gesprächsinhalte beantwortet werden können.
Anbindung von OpenAI-Python
Die OpenAI Chat Completion API bleibt mit der offiziellen OpenAI-Schnittstelle kompatibel und kann direkt mit dem offiziellen SDK OpenAI-Python angebunden werden. Dieser Artikel wird die Verwendung kurz vorstellen.- Zunächst muss eine lokale
Python-Umgebung eingerichtet werden; dieser Prozess kann über eine Google-Suche gefunden werden. - Laden Sie die Entwicklungsumgebung herunter und installieren Sie sie, beispielsweise den VSCode-Editor.
- Konfigurieren Sie die
OpenAI-Umgebungsvariablen.
- Erstellen Sie im Projektordner eine Datei mit dem Namen
.envund speichern Sie sie. - Inhalt der
.env-Datei:
sk-xxx durch Ihren eigenen Key. OPENAI_BASE_URL ist die Proxy-Schnittstelle für den Zugriff auf OpenAI.
- Installieren Sie die vom Projekt benötigten Pakete
- Erstellen Sie eine Beispiel-Quellcodedatei
index.py; der konkrete Inhalt lautet wie folgt:
Modelle mit Internetzugriff
Die Modelle gpt-3.5-browsing und gpt-4-browsing unterscheiden sich von anderen Modellen. Sie können anhand von Eingabeaufforderungen Internetsuchen durchführen und die Ergebnisse der Internetsuche entsprechend angepasst an Sie zurückgeben. Dieser Artikel wird die Internetfunktion anhand eines konkreten Beispiels demonstrieren. Anschließend können Sie die entsprechenden Inhalte auf der Oberfläche der OpenAI Chat Completion API ausfüllen, wie in der Abbildung gezeigt: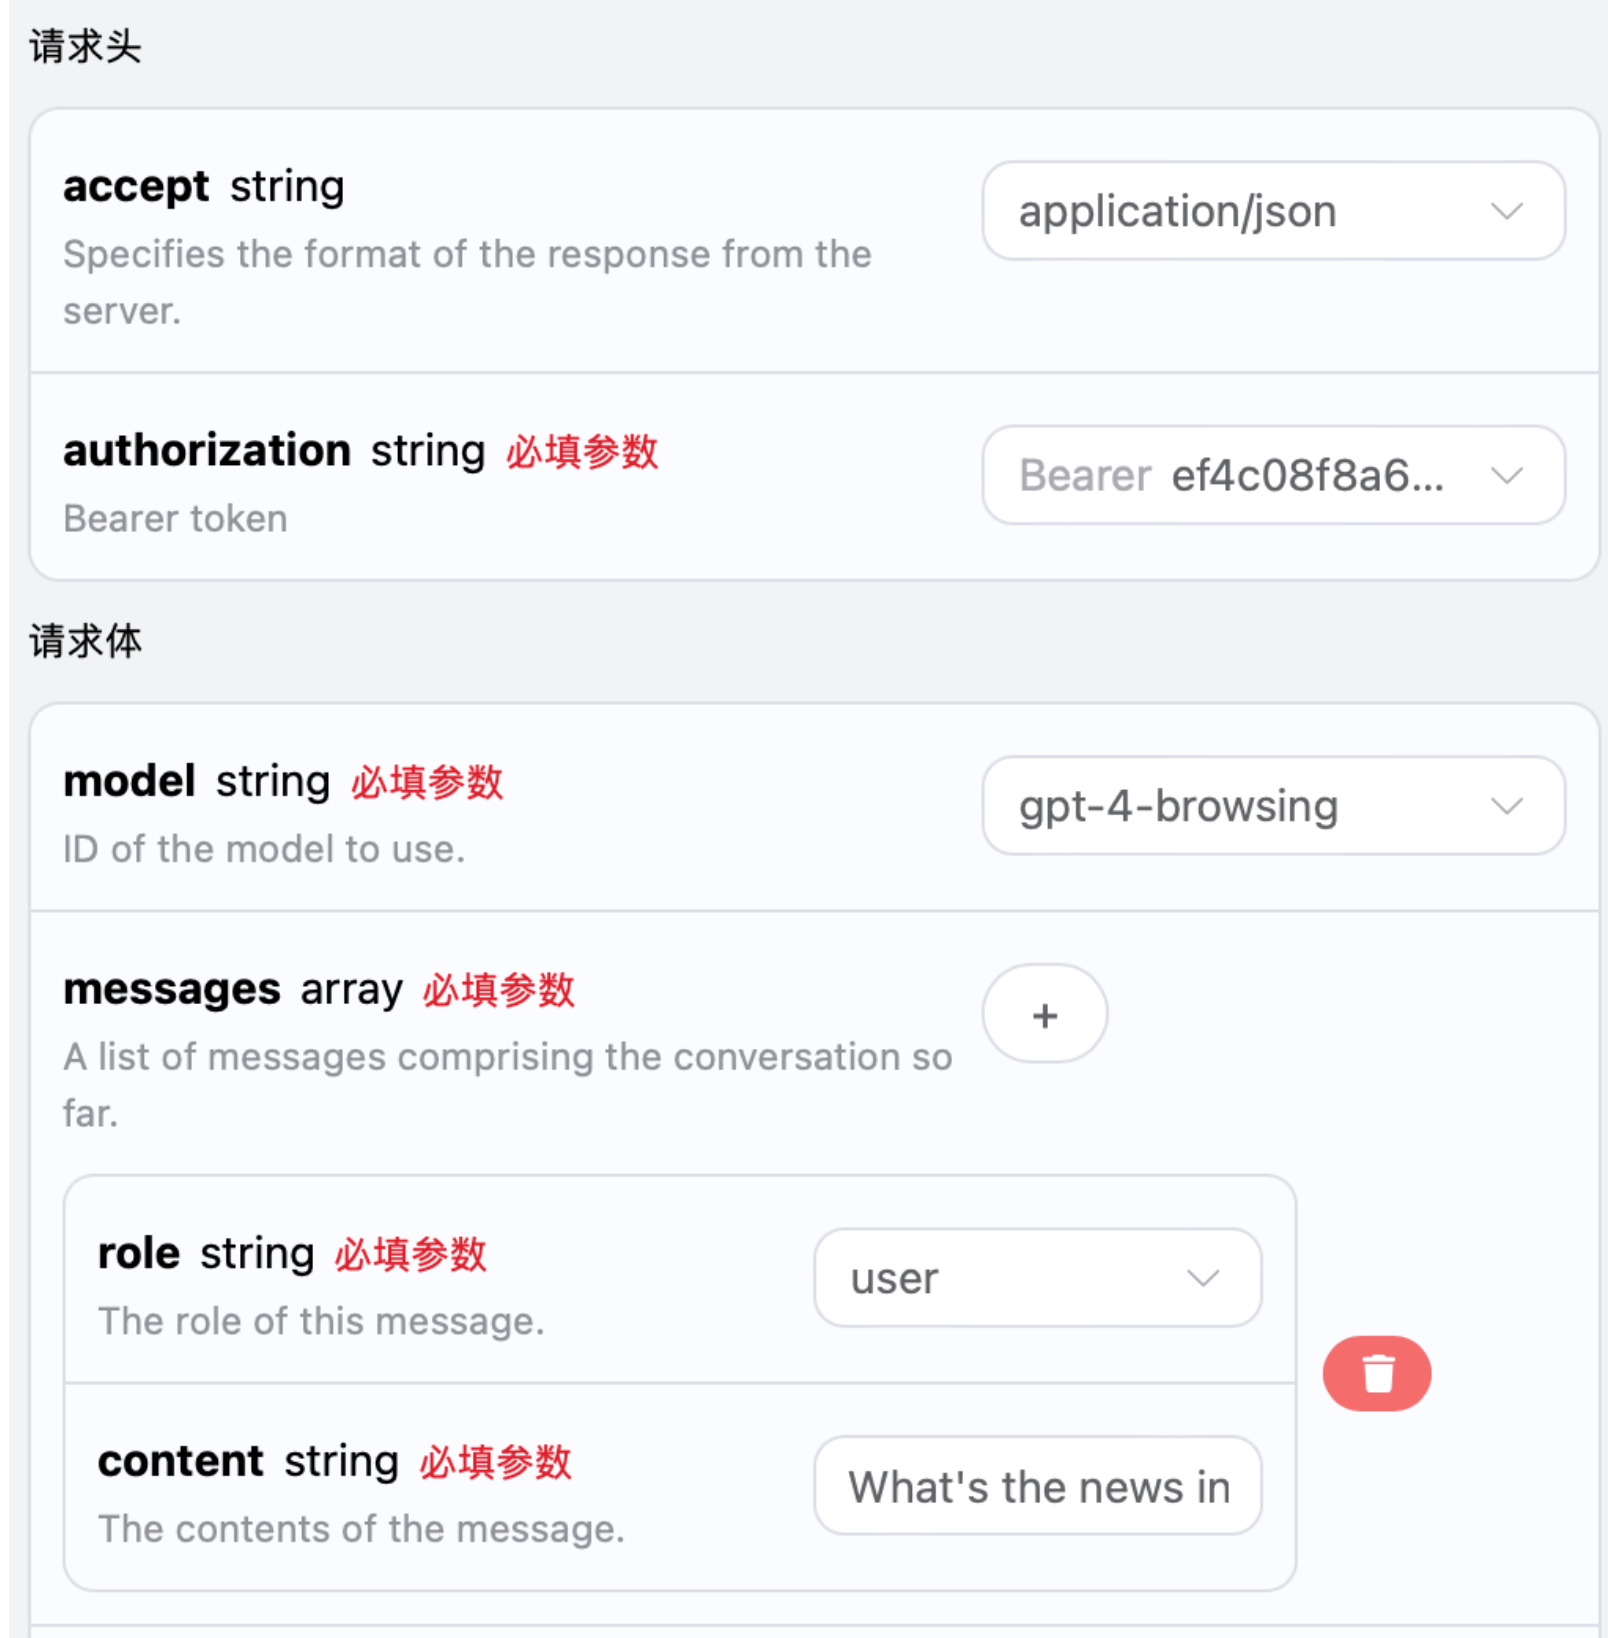
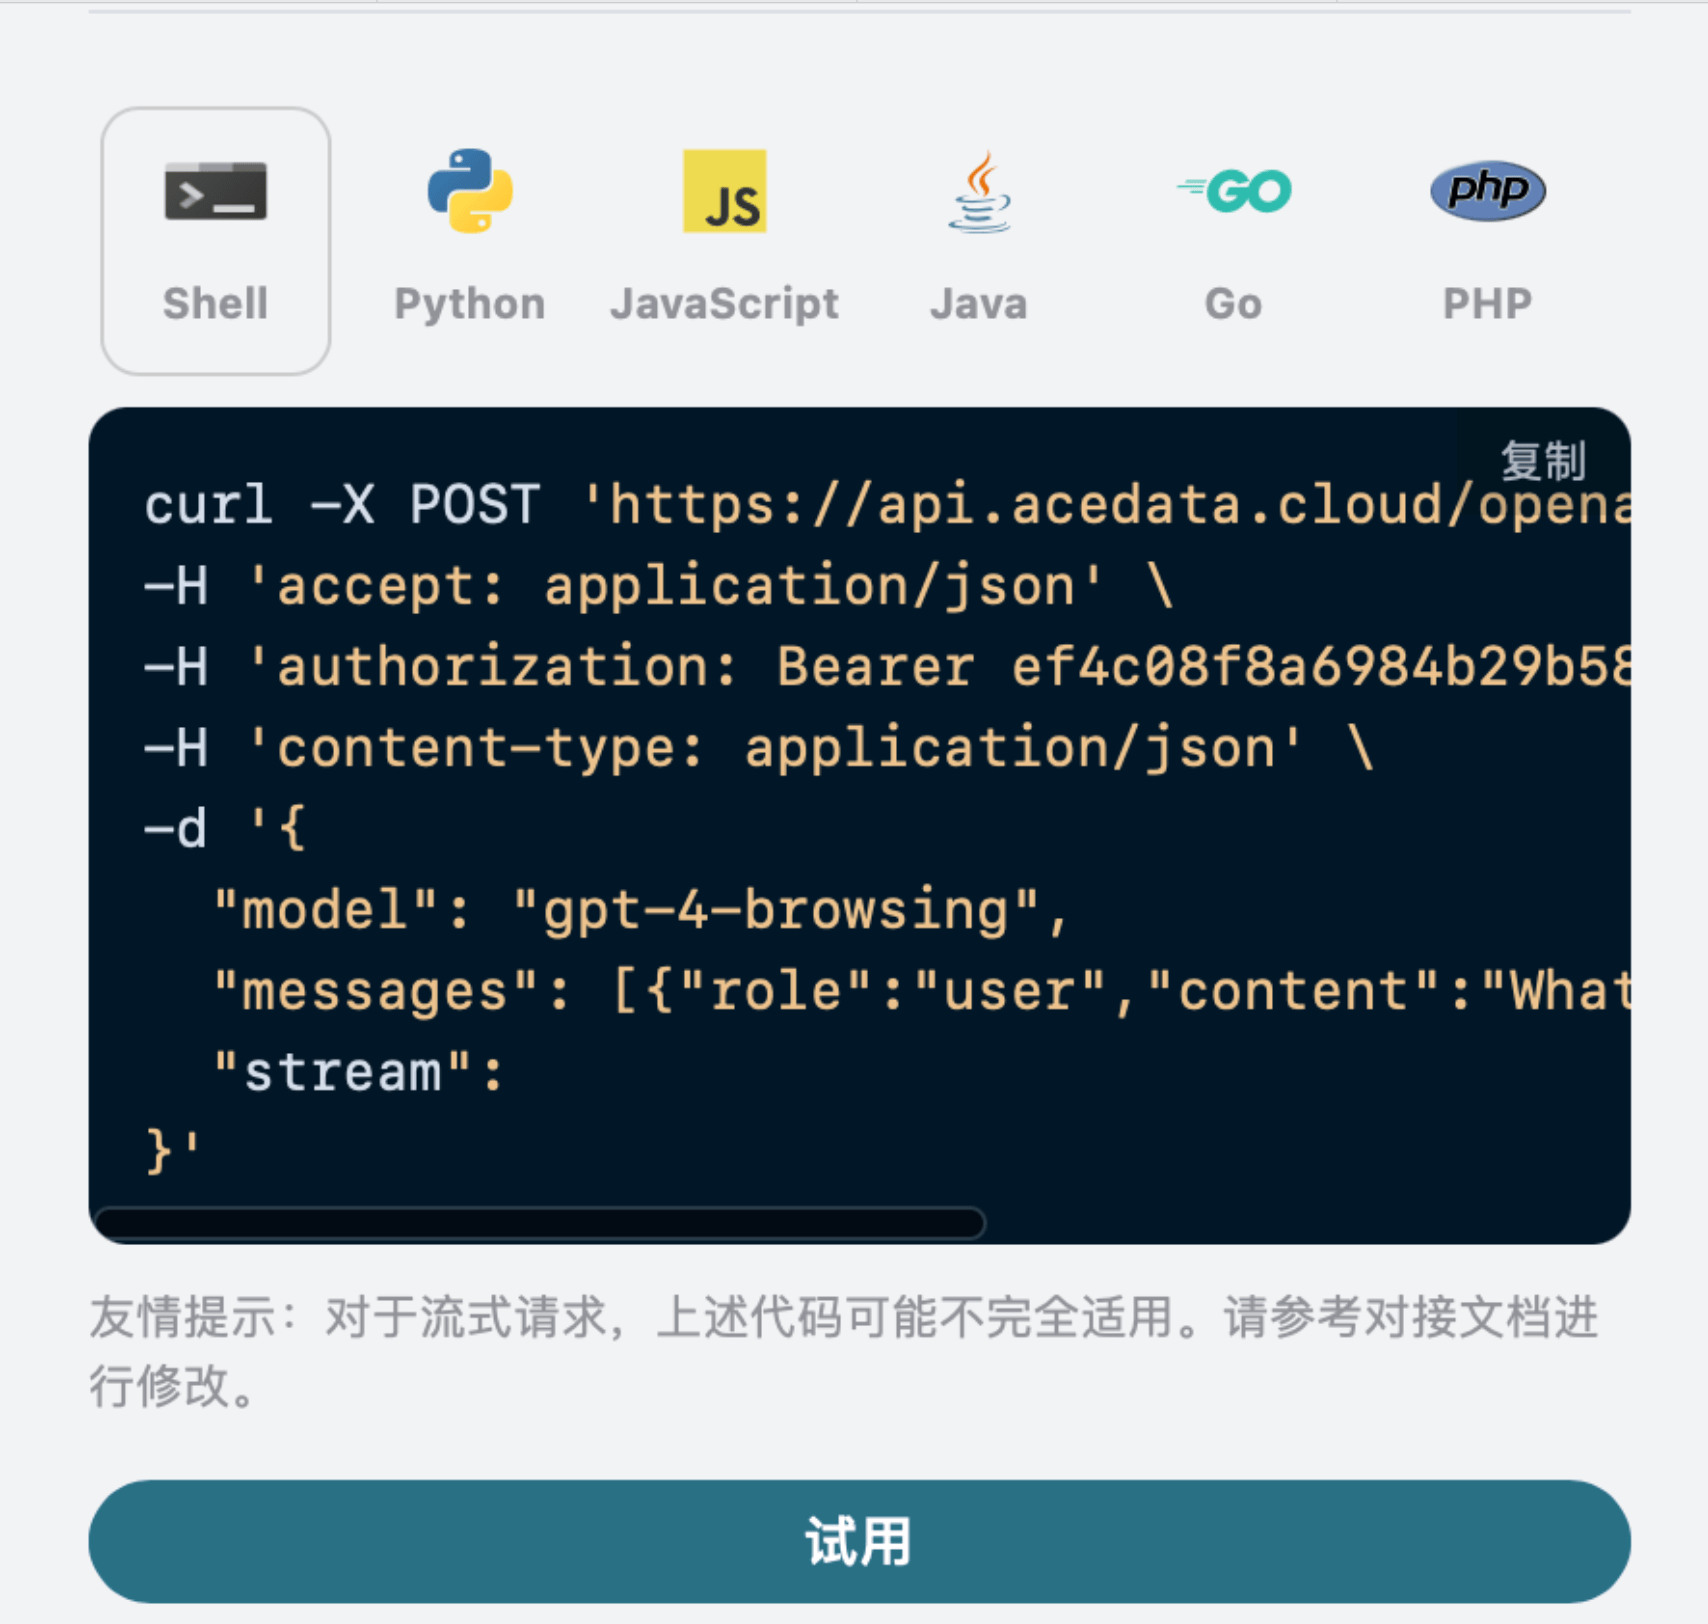
choices auf den nach der Internetabfrage erhaltenen Ergebnissen und enthalten auch entsprechende Links. Die Antwortinformationen in choices müssen mit markdown-Syntax gerendert werden, um das beste Erlebnis zu erhalten. Schließlich zeigt dies auch den großen Vorteil der Internetfunktion unseres Modells.
Visuelles Modell
gpt-4o ist ein von OpenAI entwickeltes multimodales großes Sprachmodell, das auf Grundlage von GPT-4 um visuelle Verständnisfähigkeiten erweitert wurde. Dieses Modell kann Text- und Bildeingaben gleichzeitig verarbeiten und ermöglicht modalitätsübergreifendes Verstehen und Generieren. Die Textverarbeitung mit dem gpt-4o-Modell stimmt mit dem oben beschriebenen Inhalt zur grundlegenden Verwendung überein. Im Folgenden wird kurz vorgestellt, wie die Bildverarbeitungsfähigkeit des Modells verwendet wird. Die Bildverarbeitungsfähigkeit des gpt-4o-Modells wird hauptsächlich durch das Hinzufügen einestype-Feldes auf Grundlage des ursprünglichen content-Inhalts verwendet. Über dieses Feld kann erkannt werden, ob Text oder ein Bild hochgeladen wird, um so die Bildverarbeitungsfähigkeit des gpt-4o-Modells zu nutzen. Im Folgenden wird hauptsächlich beschrieben, wie diese Funktion über Curl und Python auf zwei Arten aufgerufen wird.
- Curl-Skriptmethode
- Python-Skriptmethode
GPT-4o-Bildgenerierungsmodell
Bilder anhand von Referenzbildern generieren
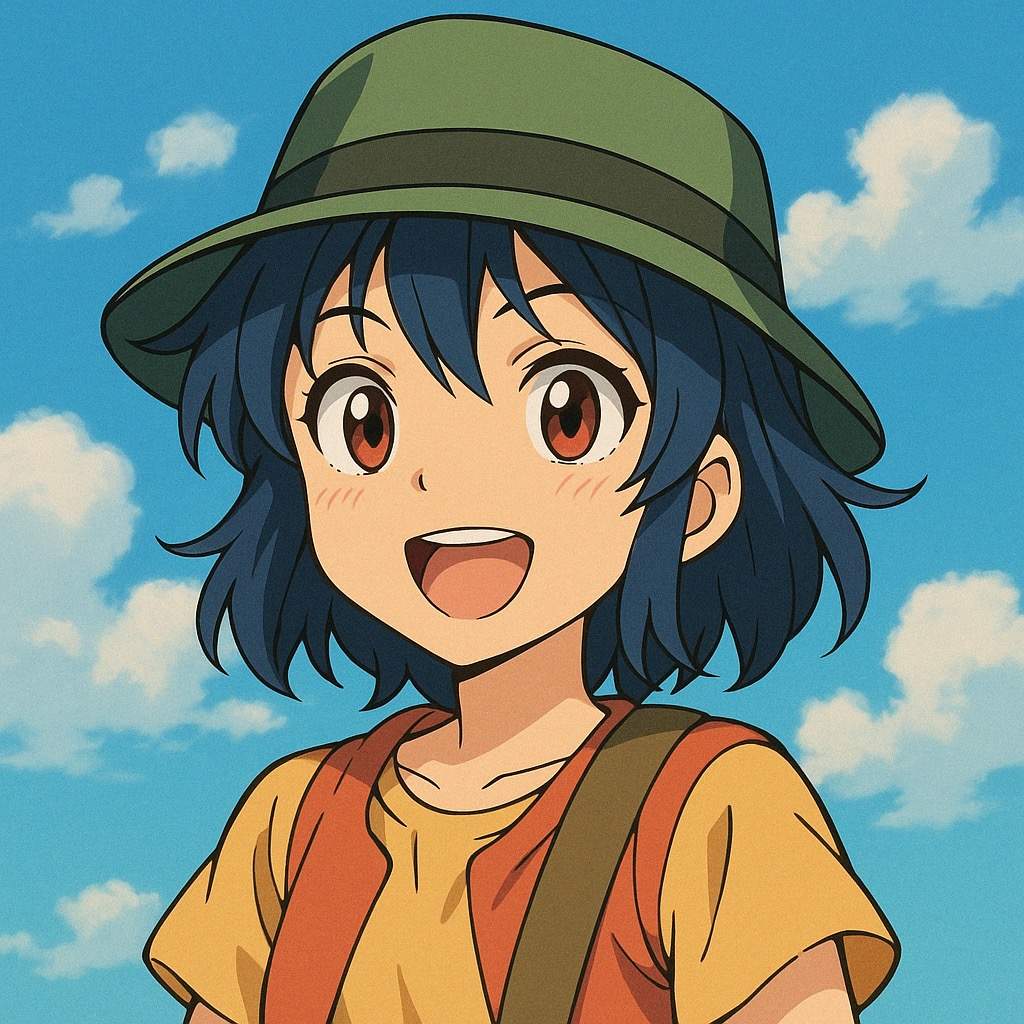
Nachfolgend ist ein Beispiel für die Generierung eines Bildes in einem benutzerdefinierten Stil anhand eines Bildes. Sehen wir uns zunächst das von uns eingegebene Bild an, wie in der folgenden Abbildung dargestellt: Es ist zu sehen, dass das Referenzbild ein Bild einer realen Person ist. Wir können es in einen anderen Stil umwandeln, beispielsweise in ein Bild im Anime-Stil. Das konkrete Anfragebeispiel:
message.content in choices das vollständig generierte Dialogergebnis. Das Bild ist darin im Markdown-Format enthalten (der Bildlink ist eine temporäre Adresse, bitte laden Sie ihn rechtzeitig herunter und speichern Sie ihn). Es ist zu sehen, dass das generierte Bild tatsächlich im Anime-Stil ist, konkret wie in der folgenden Abbildung dargestellt:
Bilder nur aus Text generieren
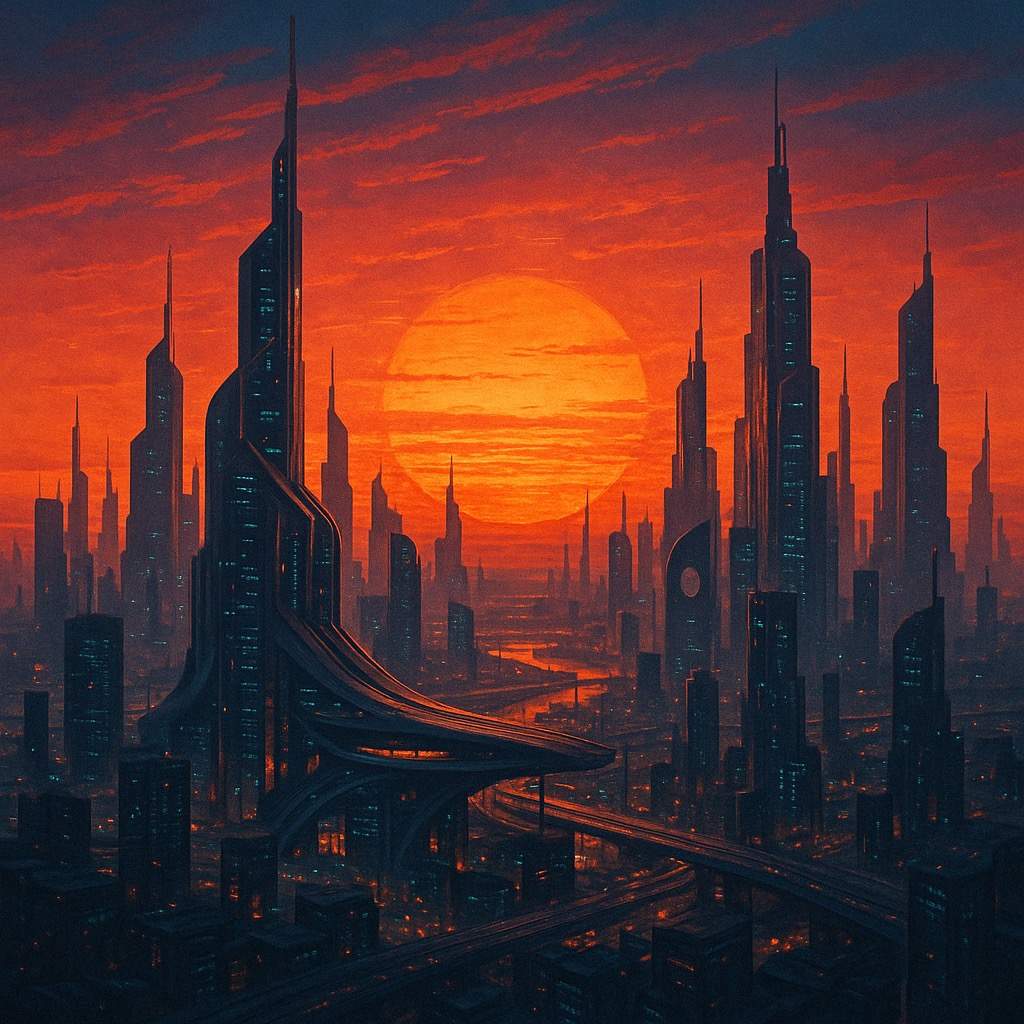
Wir können es mithilfe eines Prompt-Worts ein Bild generieren lassen und es uns im dialogorientierten Ergebnis zurückgeben. Nachfolgend verwenden wirErstelle ein Bild eines Sonnenuntergangs in einer zukünftigen Stadt als Beispiel, das konkrete Beispiel wie folgt:
Ein Bild aus mehreren Bildern generieren
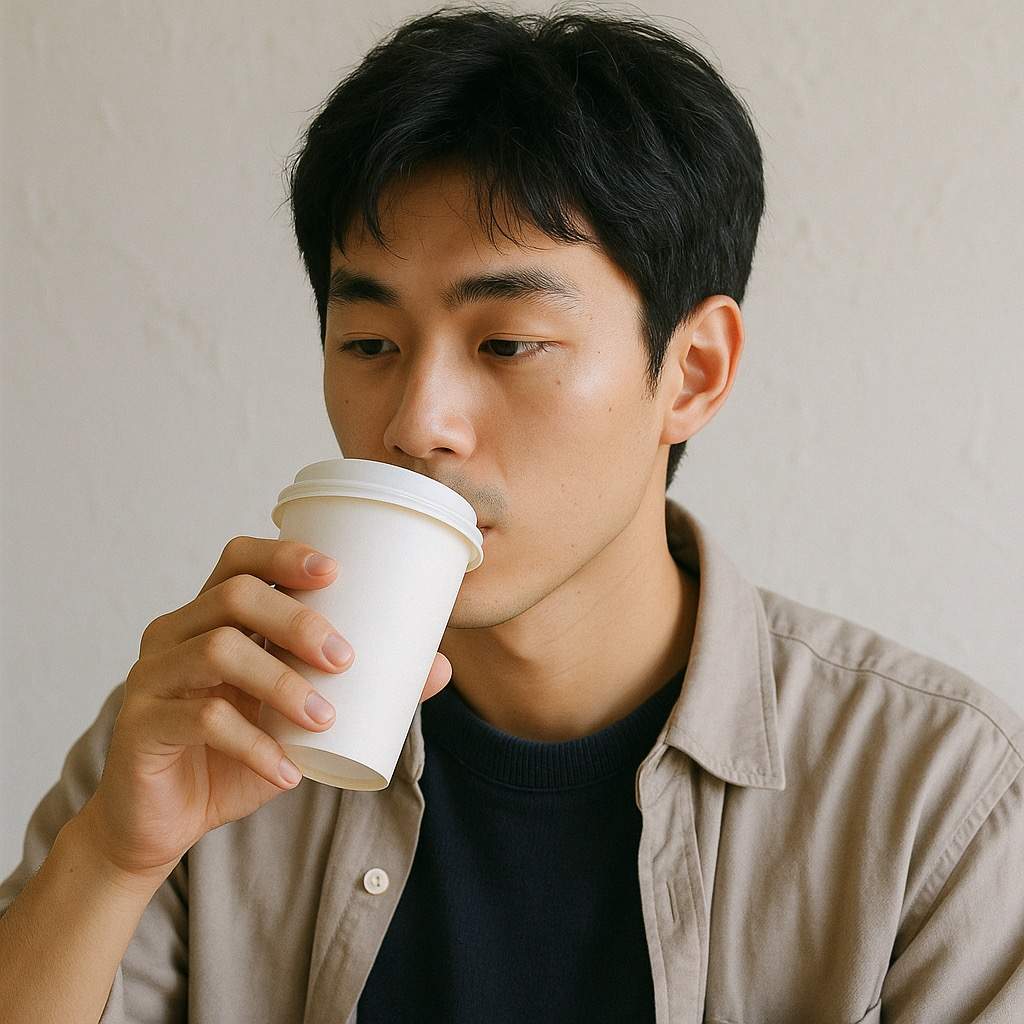
Wir können auch mehrere Referenzbilder verwenden, um ein Bild zu generieren. Beispielsweise können wir ein Bild eines gutaussehenden Mannes und ein Kaffeebild verwenden und mithilfe dieser beiden Bilder ein Bild eines gutaussehenden Mannes beim Kaffeetrinken generieren. Nachfolgend sind die konkreten Referenzbilder: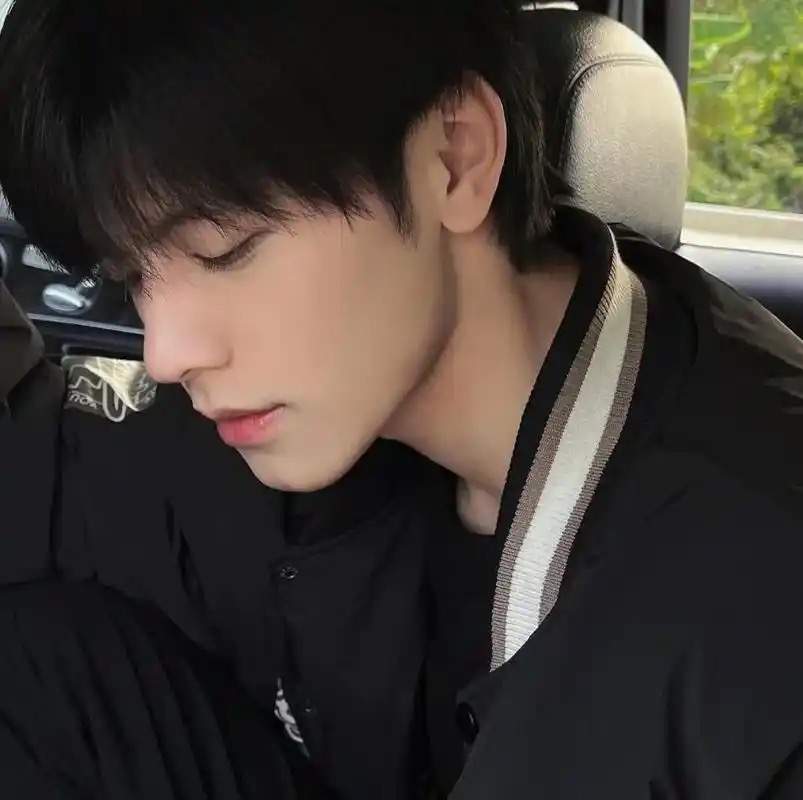
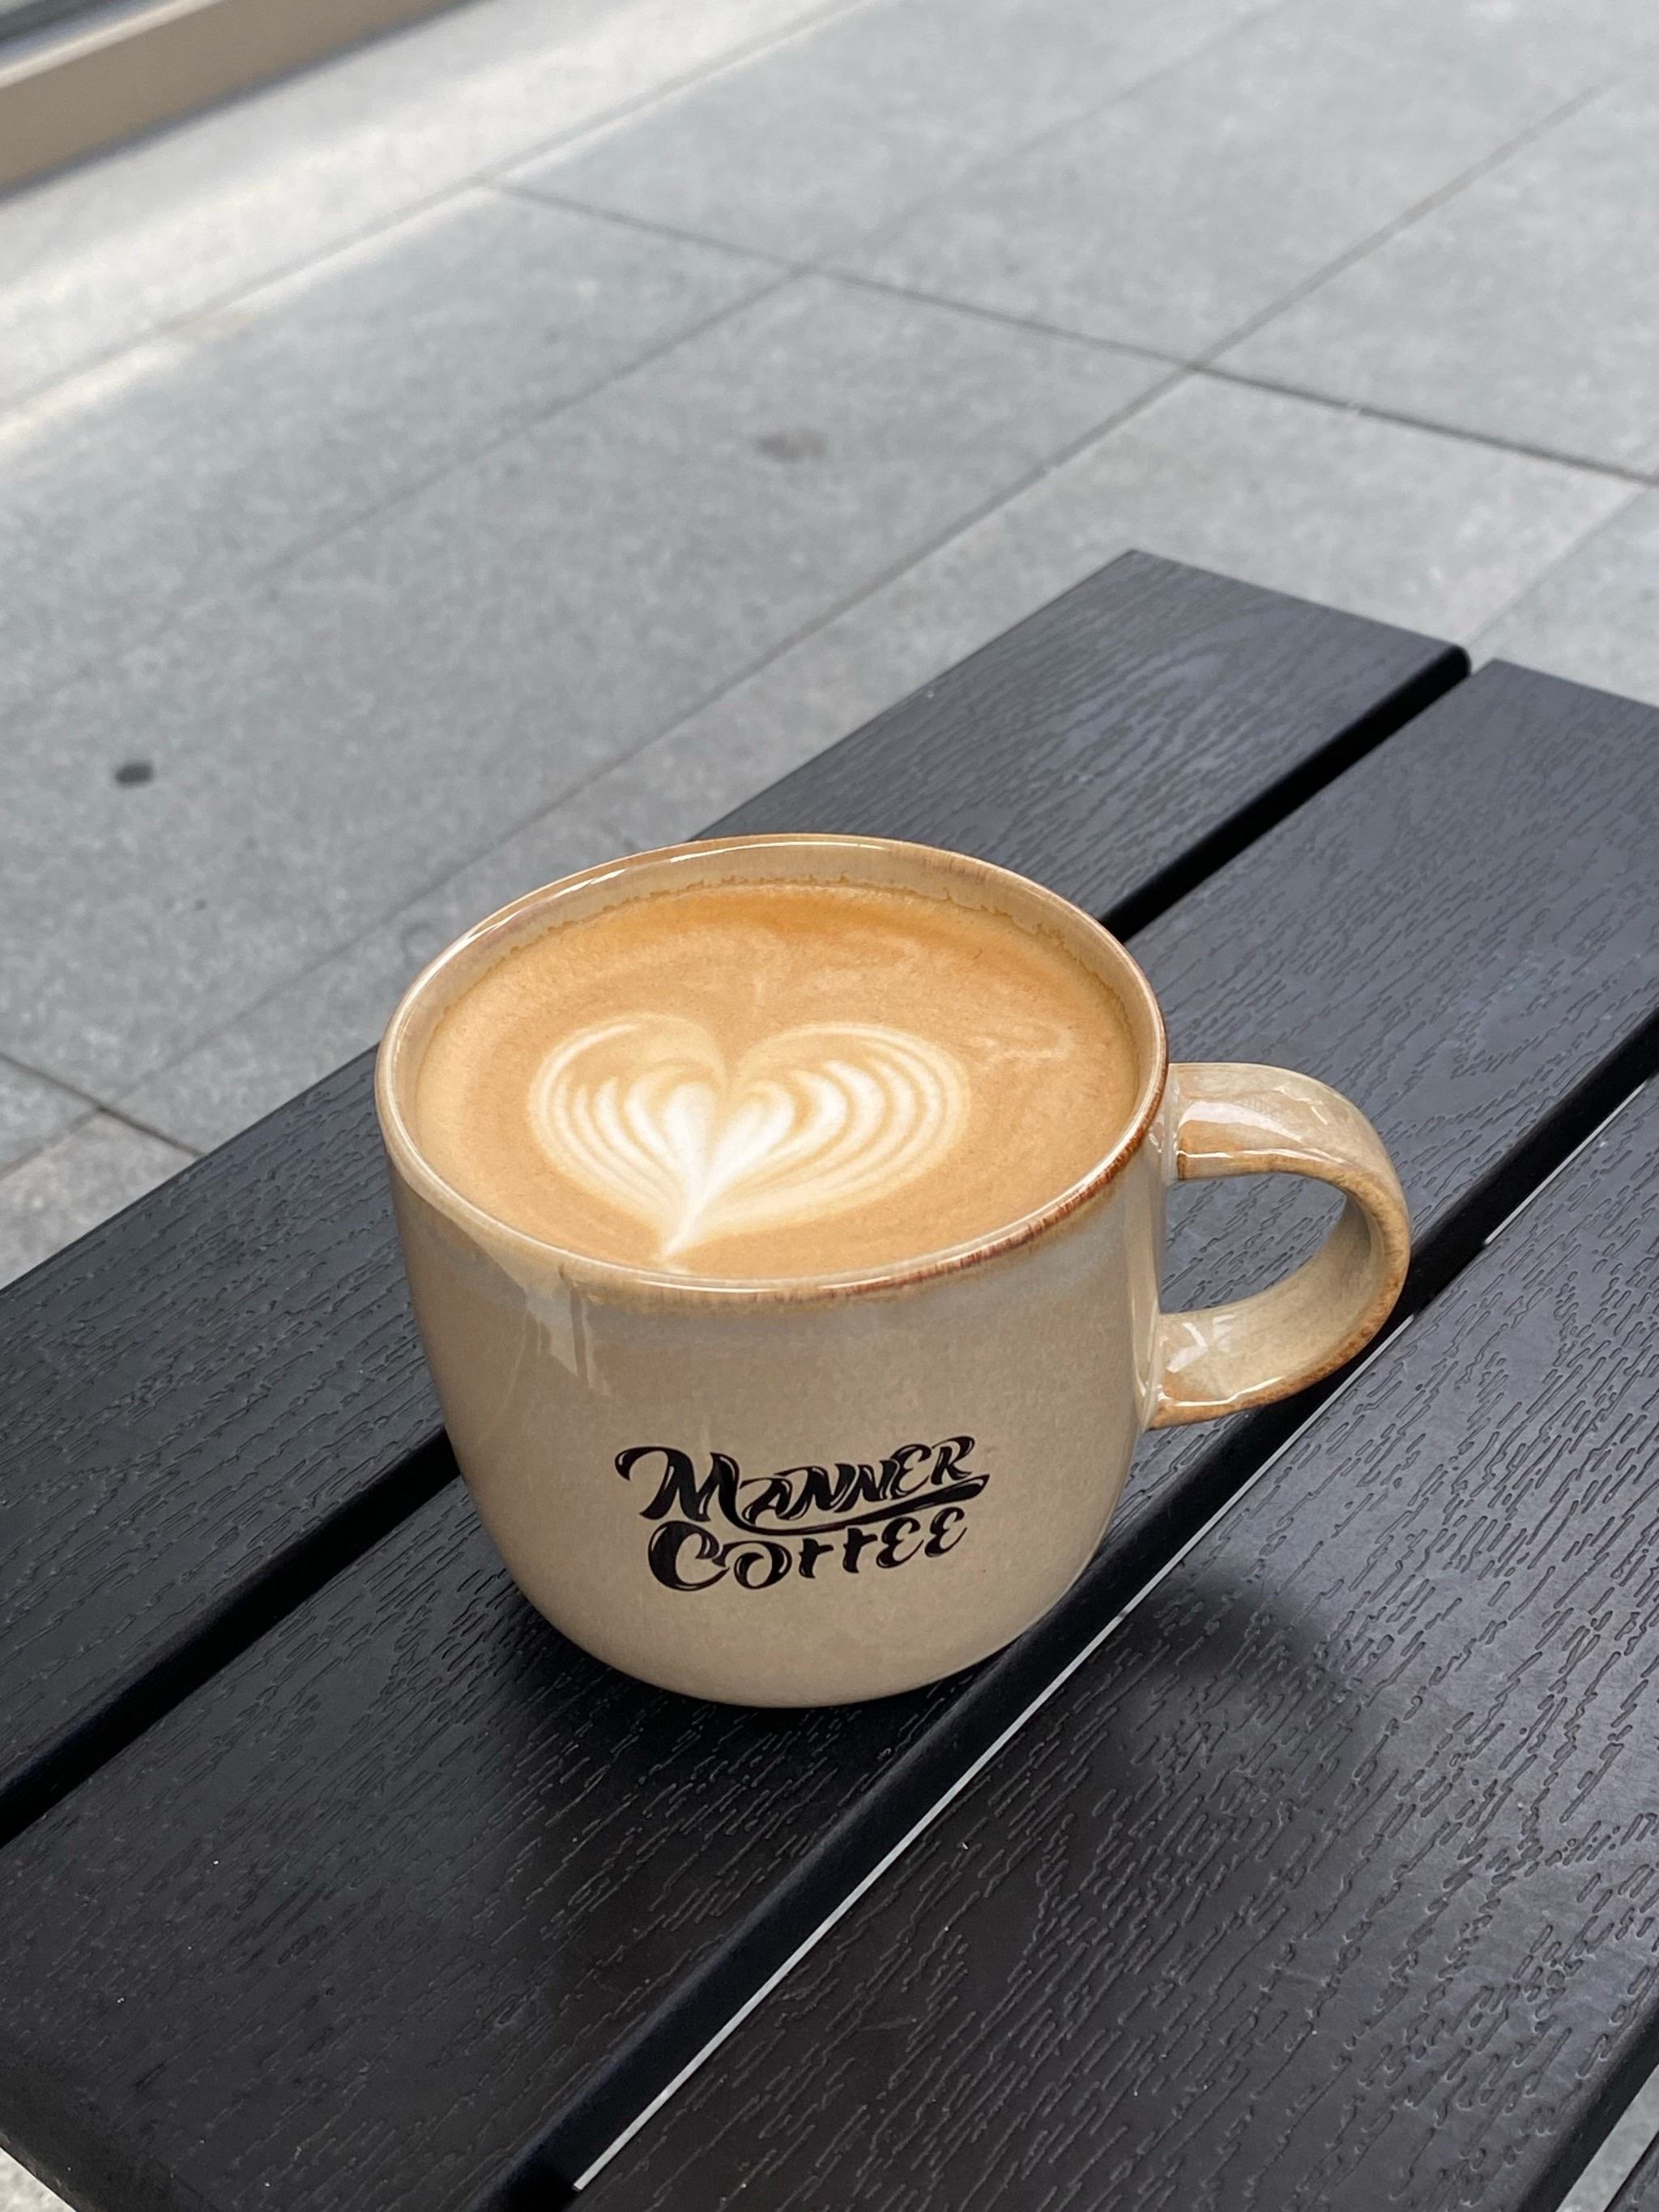
Generiere einen Jungen, der Kaffee hält und ihn gleich trinken wird als Beispiel, das konkrete Beispiel wie folgt:
Fehlerbehandlung
Wenn bei der API-Aufrufung ein Fehler auftritt, gibt die API den entsprechenden Fehlercode und die Informationen zurück. Zum Beispiel:400 token_mismatched: Ungültige Anfrage, möglicherweise aufgrund fehlender oder ungültiger Parameter.400 api_not_implemented: Ungültige Anfrage, möglicherweise aufgrund fehlender oder ungültiger Parameter.401 invalid_token: Nicht autorisiert, ungültiges oder fehlendes Autorisierungstoken.429 too_many_requests: Zu viele Anfragen, Sie haben das Ratenlimit überschritten.500 api_error: Interner Serverfehler, auf dem Server ist etwas schiefgelaufen.