

위 표의Suno는 현재lyric및style제한은 사용자 정의 모드(custom이true)에서의 상한입니다. 사용자 정의가 아닌 영감 모드(custom이false)에서는prompt만 입력하며, 길이 상한은 500자입니다(모든 모델 동일).
chirp-v6, chirp-v6-wild 및 chirp-v6-mini를 지원합니다. chirp-v6 사용을 권장하며, 이전 모델 이름도 계속 호환됩니다.
그러나 Suno 공식은 API를 제공하지 않으며, AceDataCloud는 Suno의 API 세트를 제공하여 Suno 공식 연동을 시뮬레이션하고, 원하는 음악을 편리하고 빠르게 생성할 수 있습니다.
신청 및 사용
Suno Audios Generation API를 사용하려면 먼저 Ace Data Cloud 콘솔에서 API Token을 발급받아 예비용으로 보관하세요. 아직 로그인하거나 등록하지 않았다면 로그인 페이지로 자동 이동하여 등록 및 로그인을 안내하며, 완료 후 현재 페이지로 자동 돌아옵니다.
하나의 API Token으로 플랫폼의 모든 서비스를 호출할 수 있으며, 서비스별로 별도 신청할 필요가 없습니다. 최초 신청 시 무료 크레딧이 제공되어 무료로 체험할 수 있으며, 크레딧이 부족할 경우 콘솔에서 범용 잔액을 충전할 수 있습니다.
📘 전체 문서: Suno Audios Generation API →
기본 사용
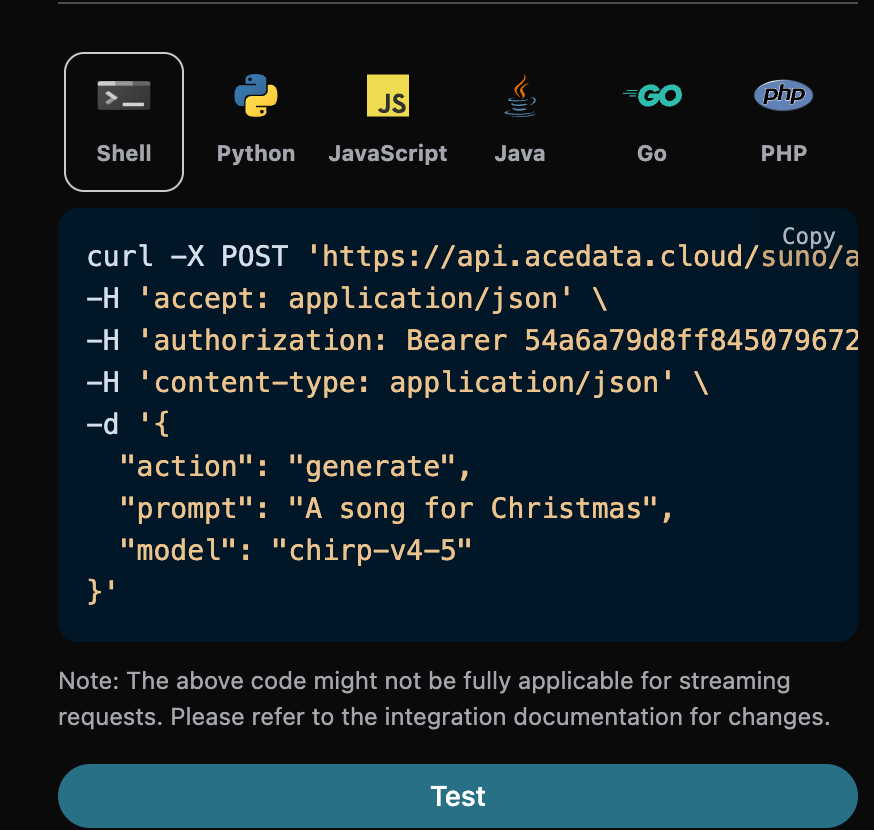
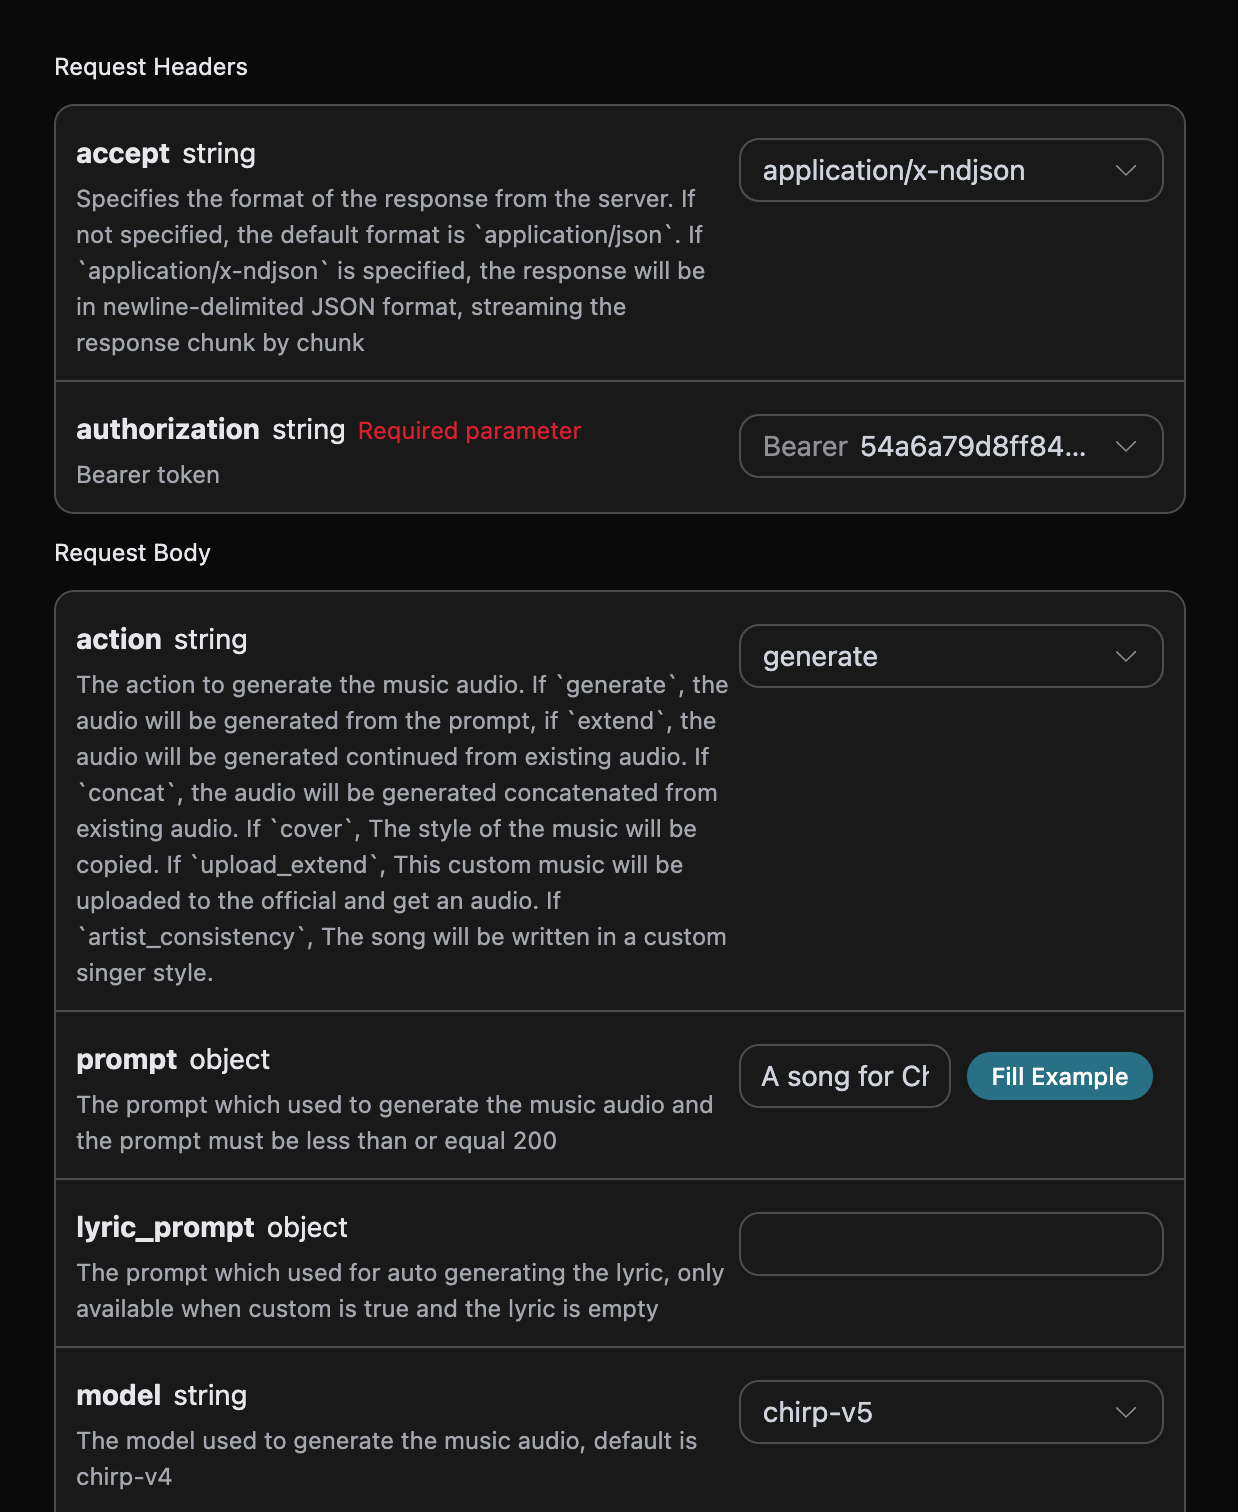
어떤 노래를 생각하든 임의의 문단을 입력할 수 있습니다. 예를 들어 크리스마스에 관한 노래를 생성하고 싶다면a song for Christmas를 입력하면 되며, 그림과 같습니다:
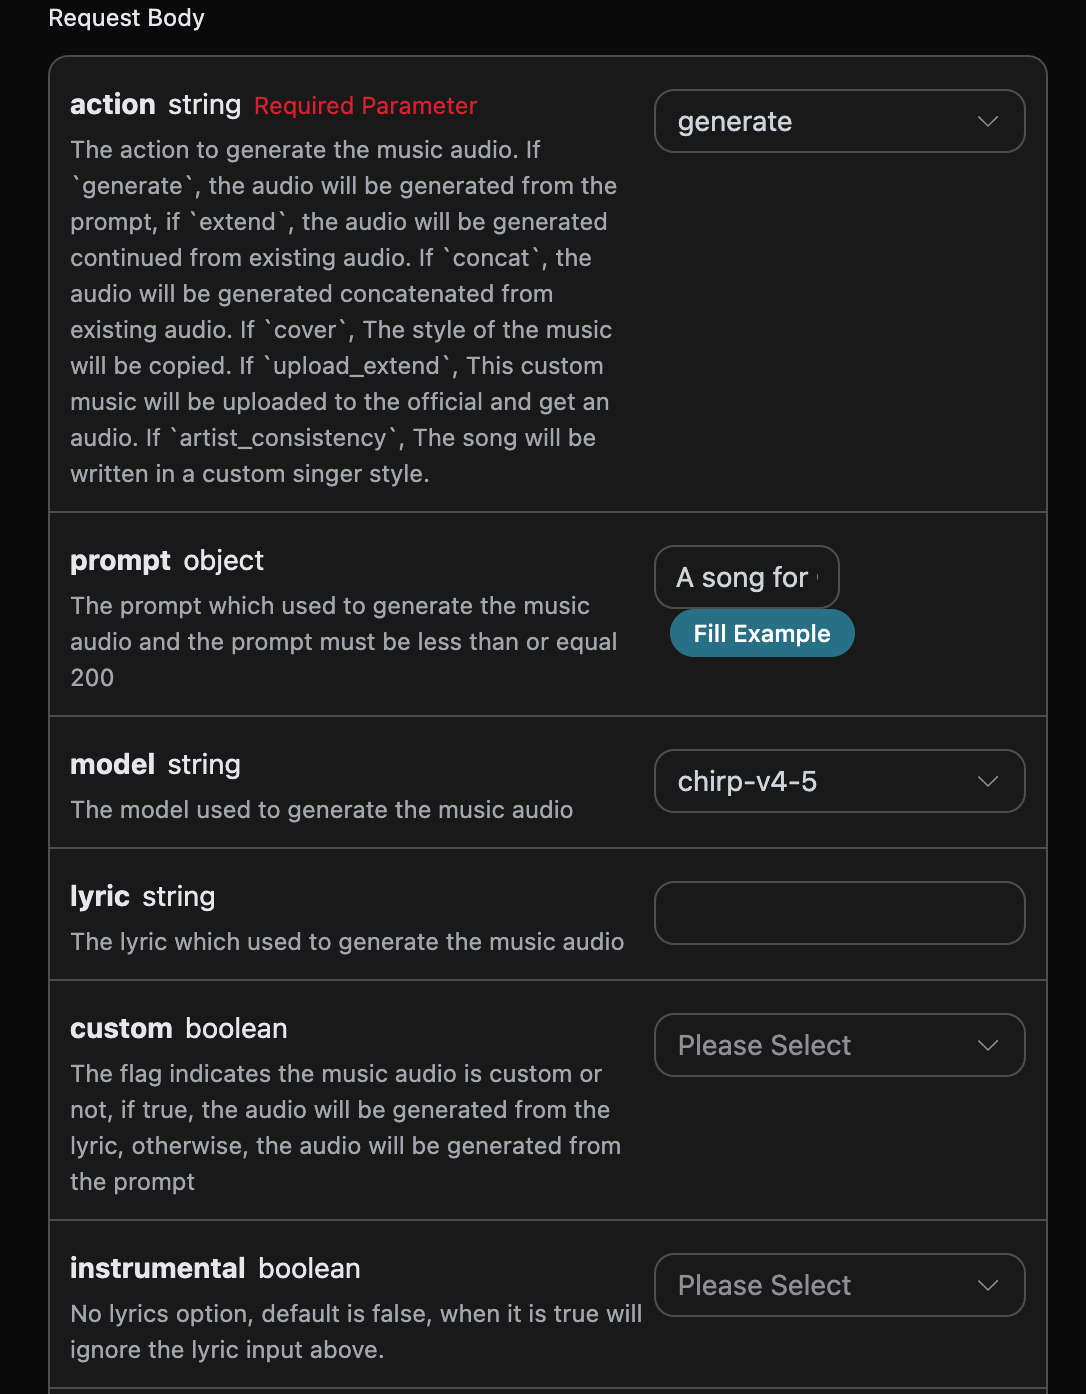
accept: 어떤 형식의 응답 결과를 받을지 지정하며, 여기서는application/json, 즉 JSON 형식으로 입력합니다.authorization: API를 호출하는 키이며, 신청 후 직접 드롭다운에서 선택할 수 있습니다.
action: 오디오 작업 유형이며, 기본값은generate입니다. 생성, 이어쓰기, 커버, 연결, 스템 분리, 오디오 트랙 추가, 지정 오디오 트랙 추출, 음향 효과 생성 및 속도 조정 등의 작업을 지원하며, 모두POST /suno/audios를 통해 호출합니다.prompt: Suno 공식 영감 모드 프롬프트(custom이false일 때 적용)이며, 최대 500자입니다.model: 이번 음악 생성 작업의 모델입니다. v6 시리즈에는chirp-v6,chirp-v6-wild,chirp-v6-mini가 포함되며, 이전 모델 이름도 계속 호환됩니다.max_mode: 강화 생성 모드입니다.generate는custom과max_mode가 모두true일 때만 활성화되며, 비용은 1.12 Credits입니다.add_stem은 직접 활성화할 수 있으며, 비용은 1.344 Credits입니다. 비활성화하거나 생략할 경우 비용은 각각 0.56 및 0.672 Credits입니다.variety: 생성 결과의 다양성 강도로,off,normal,high,extra,max중에서 선택할 수 있습니다.generate및add_stem에만 사용되며, 다른 action에서 전달하면 400이 반환됩니다.lyric: Suno 공식 사용자 지정 모드의 가사 내용입니다.chirp-v3-5및chirp-v4는 최대 3000자이며,chirp-v4-5이상(chirp-v5,chirp-v5-5포함)은 최대 5000자입니다.custom: 사용자 지정 모드를 사용할지 여부이며, 기본값은:false입니다.instrumental: Suno 공식 영감 모드의 순수 음악 옵션입니다.title: Suno 공식 사용자 지정 모드의 음악 제목입니다.chirp-v3-5,chirp-v4는 최대 80자이며,chirp-v4-5이상은 최대 100자입니다.style: Suno 공식 사용자 지정 모드 음악 스타일입니다.chirp-v3-5및chirp-v4는 최대 200자이며,chirp-v4-5이상(chirp-v5,chirp-v5-5포함)은 최대 1000자입니다.negative_tags: 사용자 지정 모드(custom이true)에서 생성 결과에서 제외하고 싶은 음악 스타일 또는 장르입니다.audio_weight: 오디오 또는 음성 특징의 영향 가중치이며, 범위는 0-1이고0도 유효한 값입니다. 생성, 이어쓰기, 커버, 오디오 트랙 추가 및 음성 일관성 등의 작업에 사용할 수 있으며, 참조 오디오 또는 음성 특징이 없을 경우 모델이 이 값을 약화하거나 무시할 수 있습니다.audio_id: 참조 음악의 ID입니다.overpainting_start/overpainting_end: 기존 순수 음악에 보컬을 추가하는 시작 및 종료 시간이며, 단위는 초입니다.underpainting_start/underpainting_end: 아카펠라에 반주를 추가하는 시작 및 종료 시간이며, 단위는 초입니다.persona_id: 아티스트의 노래 ID입니다.continue_at: 이어쓰기 경계이며, 단위는 초입니다. 예를 들어, 213.5는 3분 33.5초 지점부터 후속 구간 생성을 시작함을 의미합니다.lyric과style은 경계 이후의 새 콘텐츠만 안내하며, 소스 오디오에서 경계 이전의 가사나 보컬을 대체하지 않습니다.style_influence: 사용자 지정 모드에서의 스타일 영향력이며, 범위는 0-1입니다. 값이 클수록 일반적으로 선택한 스타일에 더 부합하며,0도 유효한 값으로 전달됩니다.replace_section_end: 교체 구간의 최종 시간입니다.replace_section_start: 교체 구간의 시작 시간입니다.vocal_gender: 남성/여성 보컬 선호를 제어하며, 여성 보컬은f, 남성 보컬은m이고, 4.5 이상 모델에서 유효합니다. 선호 항목이므로 엄격한 준수가 보장되지는 않습니다.weirdness: 사용자 지정 모드에서의 기이함 정도이며, 범위는 0-1입니다. 값이 클수록 일반적으로 더 창의적이고 실험적이며,0도 유효한 값으로 전달됩니다.duration: 기대하는 노래 길이이며, 단위는 초이고 정수여야 하며, 값 범위는 10에서 360입니다. 이 매개변수는 사용자 지정 모드(custom이true)의 노래 생성에 사용됩니다. 이는 하드 제약이 아닌 경향성 프롬프트입니다. 모델이 이를 참고하지만 달성을 보장하지 않으며, 실제 결과물 길이는 응답의duration필드를 기준으로 하고 일반적으로 기대값보다 짧습니다.
고급 매개변수 적용 범위
플랫폼은 매개변수 유형과 값 범위를 검증하지만, action이 다르다는 이유만으로 이러한 선택적 조절 항목을 거부하지는 않습니다. 구체적인 효과는 작업, 모드 및 모델에 따라 결정됩니다.
lyric_prompt: 가사 생성을 위한 prompt이며,custom이true이고lyric이 전달되지 않았을 때에만 적용됩니다.callback_url: 결과 콜백이 필요한 URL입니다.async: 선택 사항이며,true로 설정하면 인터페이스가 즉시task_id를 반환합니다.callback_url을 제공할 필요가 없으며, 이후 해당 작업 조회 인터페이스를 통해 폴링하여 결과를 가져옵니다.
- success:생성 성공 여부이며, 성공하면
true, 그렇지 않으면false입니다. - data:생성된 노래의 상세 정보를 포함하는 목록입니다.
- state: 노래 생성 상태이며, 주로 다음 네 가지를 포함합니다:
- succeeded:생성 성공
- pending:대기열에 있음
- running:실행 중
- error:실패
- id:노래 ID
- title:노래 제목
- image_url:노래의 커버 이미지
- lyric:노래 가사
- audio_url:노래의 최종 오디오 주소입니다. 플랫폼은 Ace Data Cloud CDN 주소를 우선 반환하며, 영구 저장에 실패할 경우 원본 미디어 주소를 반환할 수 있으므로 즉시 다운로드하세요.
- video_url:노래의 비디오 파일이며, 열면 mp4 비디오입니다.
- created_at:생성 시간
- model:사용된 모델이며, 일반적으로 최신 v3 모델입니다.
- style:스타일
- state: 노래 생성 상태이며, 주로 다음 네 가지를 포함합니다:
사용자 지정 생성
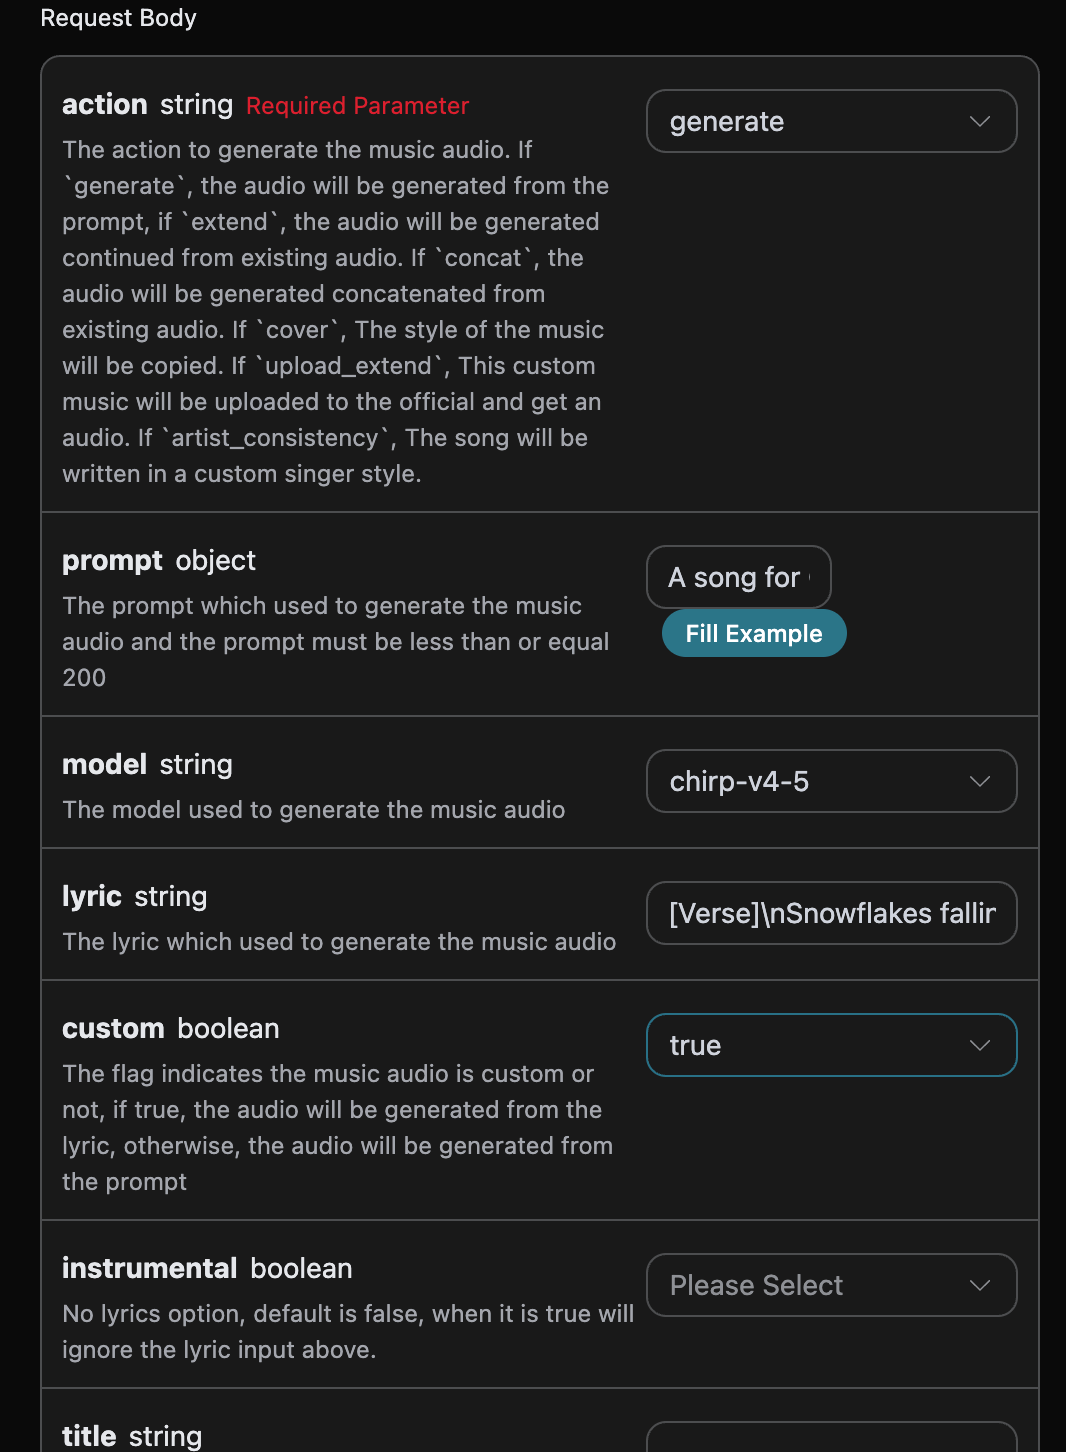
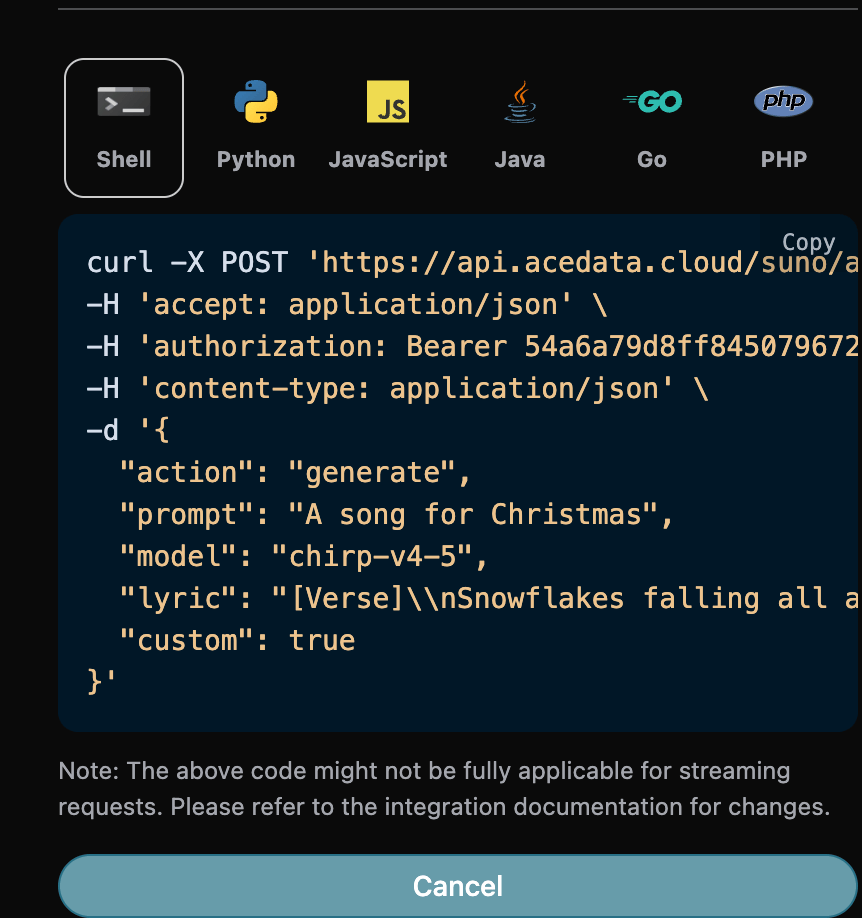
가사를 사용자 지정하여 생성하려면 가사를 입력할 수 있습니다: 이때lyric 필드에는 다음과 유사한 내용을 전달할 수 있습니다:
참고로, 여기 가사에서 \n은 줄바꿈 문자입니다. 가사를 생성하는 방법을 모른다면 AceDataCloud에서 제공하는 가사 생성 API를 사용하여 prompt를 통해 가사를 생성할 수 있으며, API는 Suno Lyrics Generation API입니다.
다음으로 가사, 제목, 스타일에 따라 노래를 사용자 지정 생성하려면 다음 내용을 지정할 수 있습니다:
- lyric:가사 텍스트
- custom:
true로 입력하며, 사용자 지정 생성을 의미합니다. 이 매개변수의 기본값은 false이며,prompt를 사용하여 생성함을 의미합니다. - title:노래 제목입니다.
- style:노래 스타일이며, 선택 사항입니다.
사용자 지정 가수 스타일 생성 기능
가수 스타일을 사용하여 노래를 생성하려면, 먼저 위의 기본 사용법을 통해 노래를 생성합니다.마지막으로 이 노래를 가수 스타일로 설정해야 하며, 이후 Suno Persona API에 들어가 공식적으로 생성된 음악 ID
audio_id를 기반으로 가수 스타일의 id 매개변수 persona_id를 생성해야 합니다. 구체적인 매개변수는 아래 그림과 같습니다:
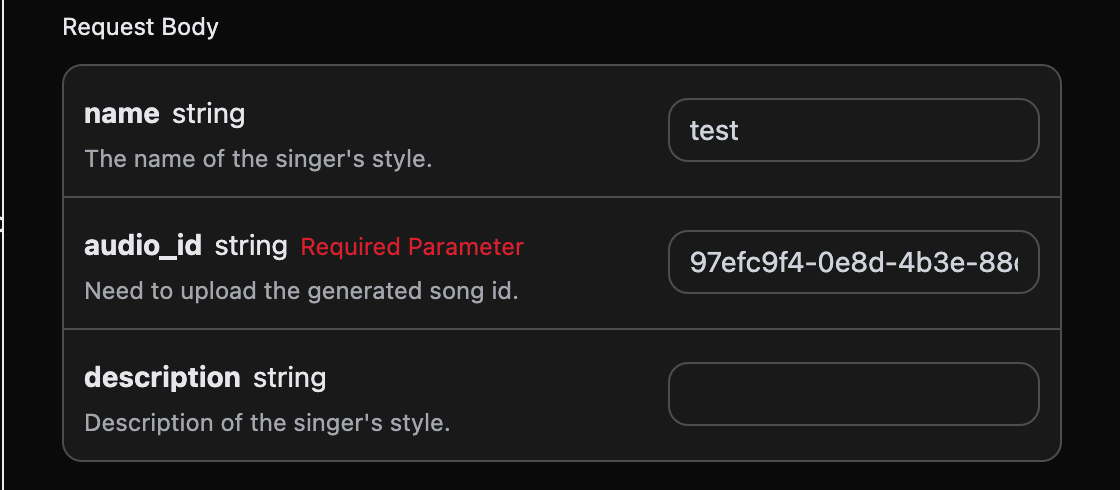
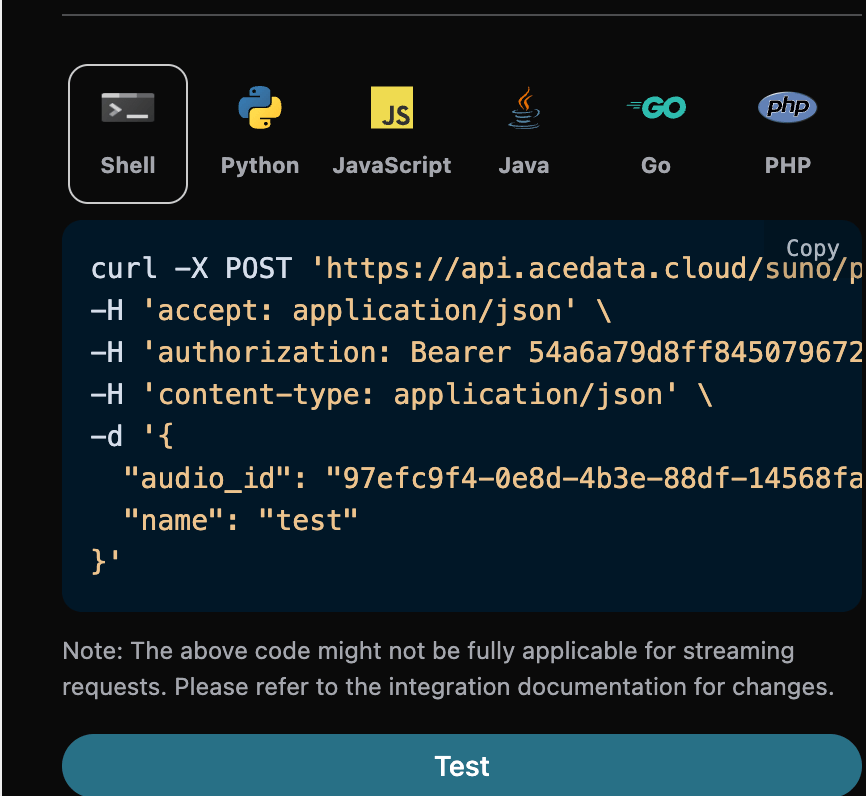
audio_id와 persona_id를 각각 97efc9f4-0e8d-4b3e-88df-14568fa1b11f, e0d7319e-aa2a-44cb-b00a-916218d7cb0b로 하여 이번 예제 데이터로 사용합니다. 그런 다음 매개변수 action을 artist_consistency로 설정할 수 있으며(새 버전의 가수 스타일 Persona-v2-vox인 경우, action은 반드시 artist_consistency_vox로 설정해야 합니다), 계속 생성해야 하는 노래의 ID와 가수 스타일 ID를 입력합니다. 작성 예시는 다음과 같습니다:
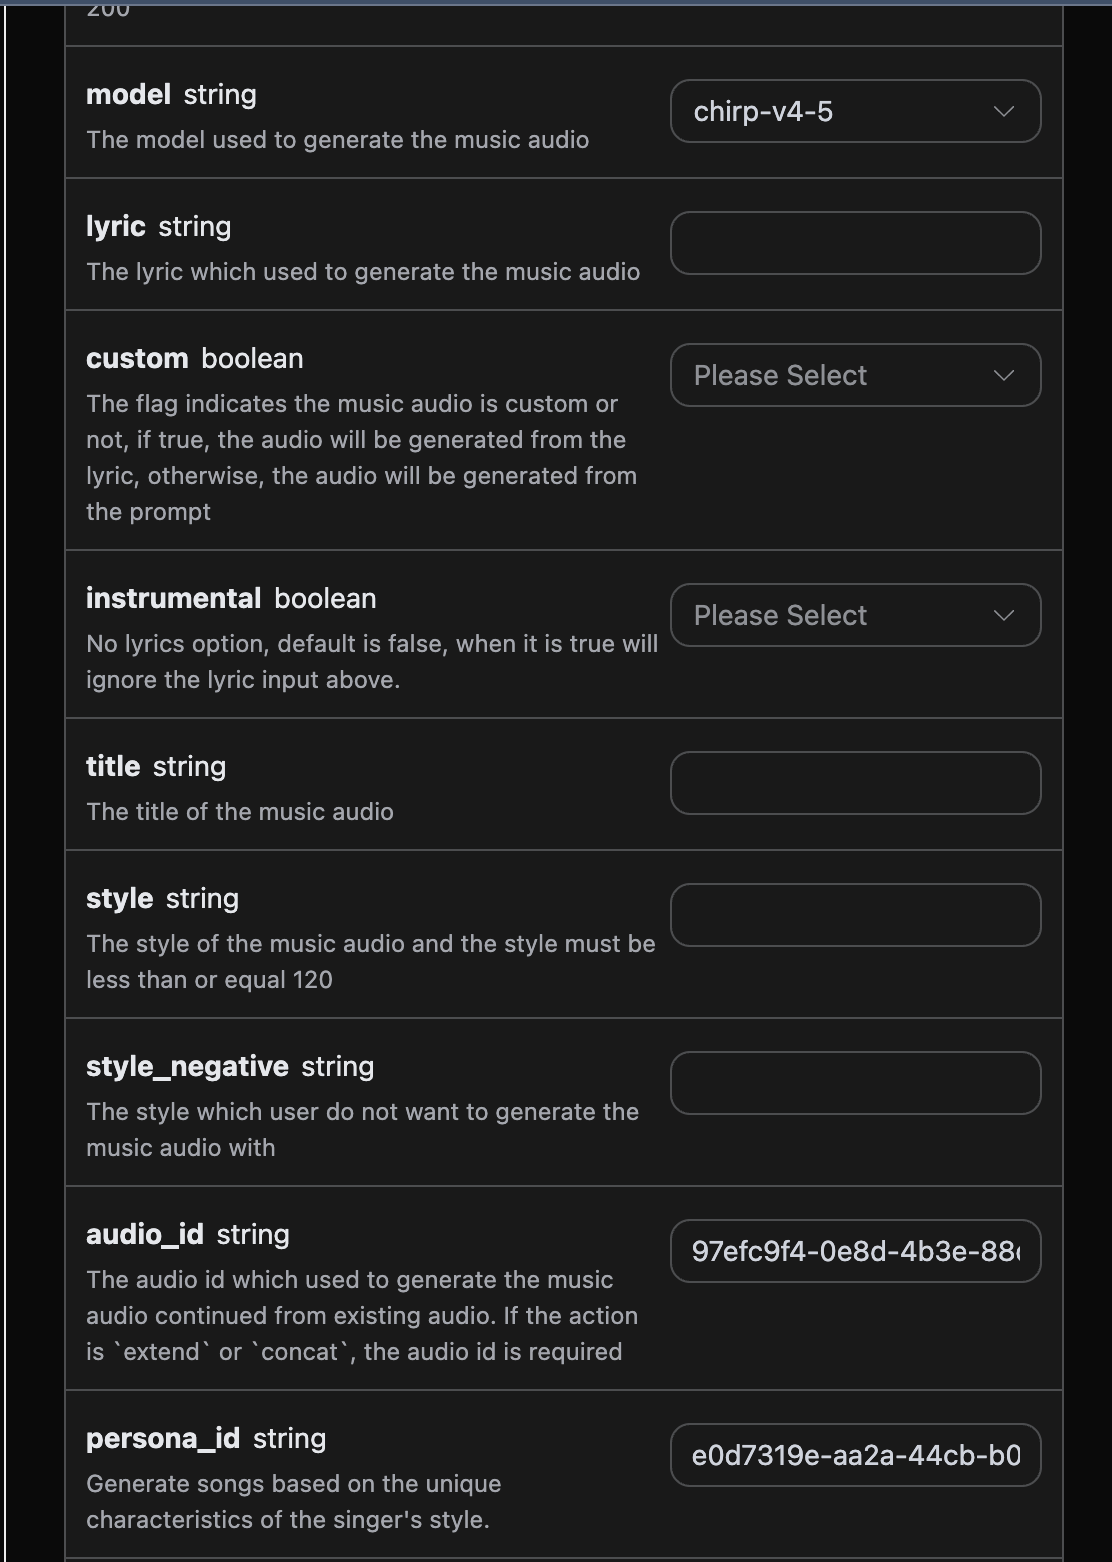
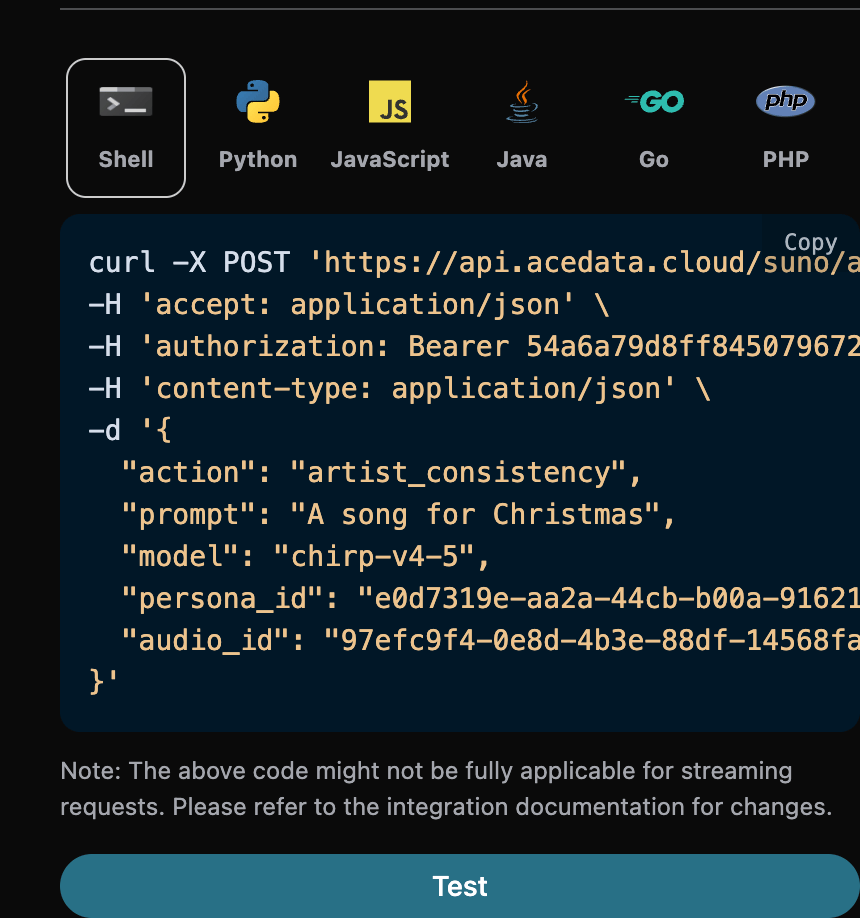
계속 생성 기능
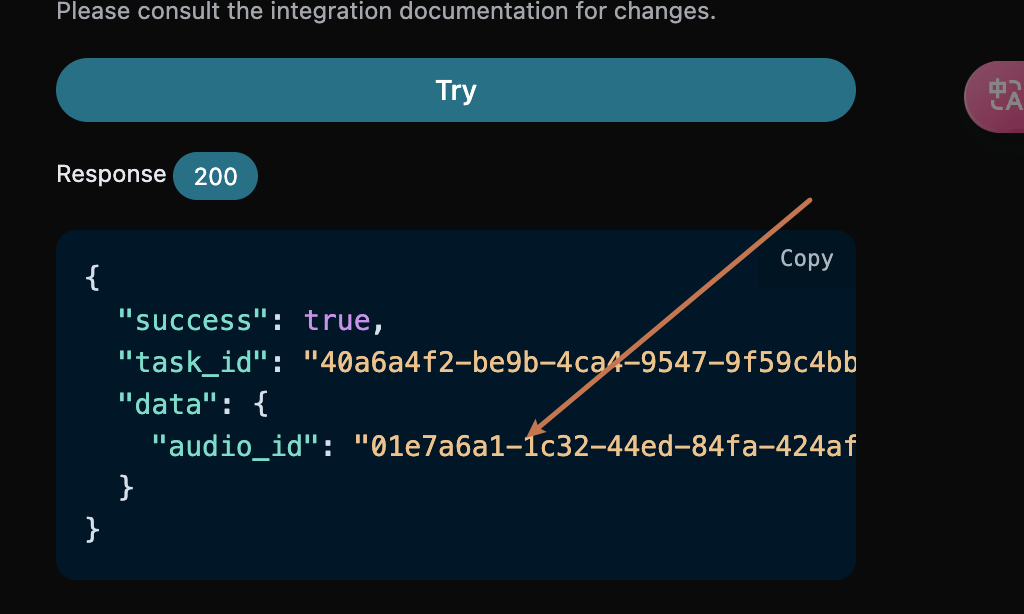
이미 생성된 Suno 노래를 계속 생성하려면 매개변수action을 extend로 설정하고, 계속 생성해야 하는 노래의 ID를 입력할 수 있습니다. 노래 ID는 기본 사용법에 따라 획득하며, 위의 내용에서 이때 노래의 ID는 다음과 같음을 알 수 있습니다:
참고로 여기의 가사 중 id는 생성 후 노래의 ID입니다. 노래를 생성하는 방법을 모르는 경우, 위의 기본 사용법을 참고하여 노래를 생성할 수 있습니다.
직접 업로드한 노래를 계속 생성하려면 매개변수 action을 upload_extend로 설정하고, 계속 생성해야 하는 사용자 지정 업로드 노래의 ID를 입력할 수 있습니다. 노래 ID는 Suno Upload Generation API를 사용하여 획득하며, 아래 그림과 같습니다:
- lyric:
continue_at이후 새로 생성되는 구간의 가사를 안내하는 용도로만 사용되며, 원본 오디오에서 해당 시점 이전의 가사를 대체하지 않습니다. - custom:
true로 작성하면 사용자 지정 생성을 의미하며, 이 매개변수의 기본값은 false로,prompt를 사용하여 생성함을 의미합니다. - style: 이어 쓸 구간의 노래 스타일이며, 선택 사항입니다.
- continue_at: 이어 쓰기 경계이며, 단위는 초입니다. 예를 들어, 213.5는 3분 33.5초 지점부터 후속 구간을 생성함을 의미합니다.
작성 예시는 다음과 같습니다:extend는 기존 노래를 이어서 뒤로 창작하는 용도이며, 노래 전체의 가사를 바꾸는 것이 아닙니다. 노래 전체를 처음부터 새 가사로 만들고 싶다면generate를 사용하여 다시 생성하십시오. 기존 노래를 참고하여 다시 연주하고 싶다면cover를 사용할 수 있습니다. 새로운 전체 가사를 전달하더라도,continue_at이전의 원래 가사는 여전히 대체되지 않습니다.
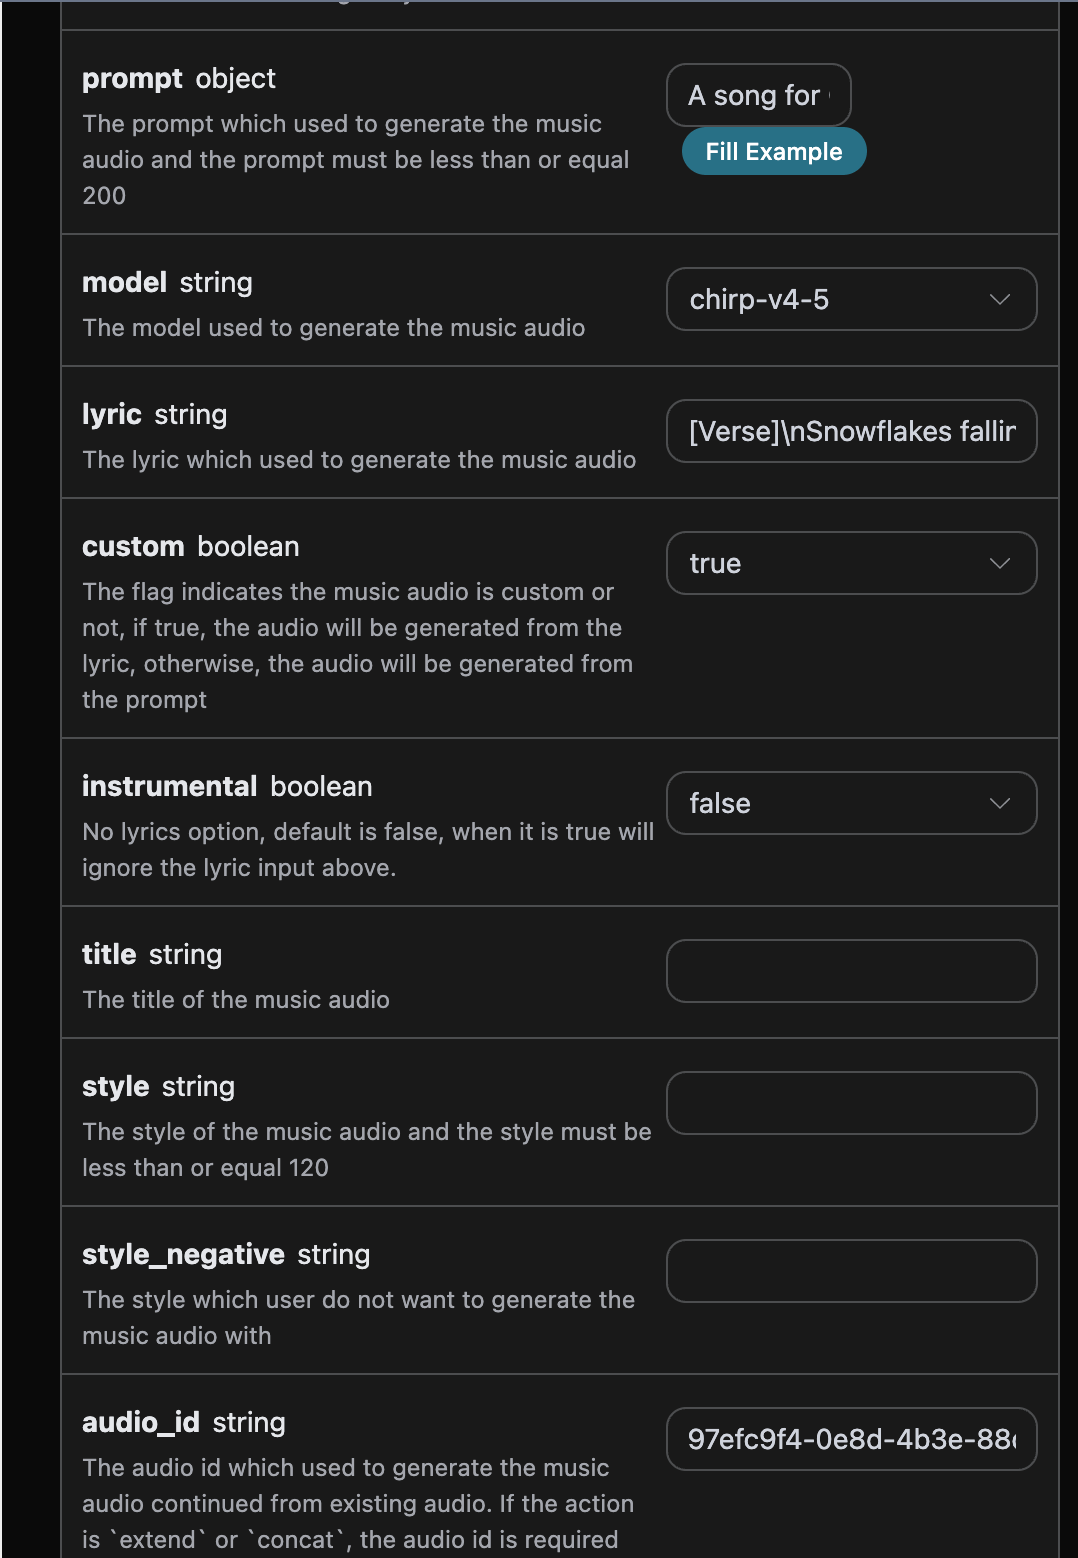
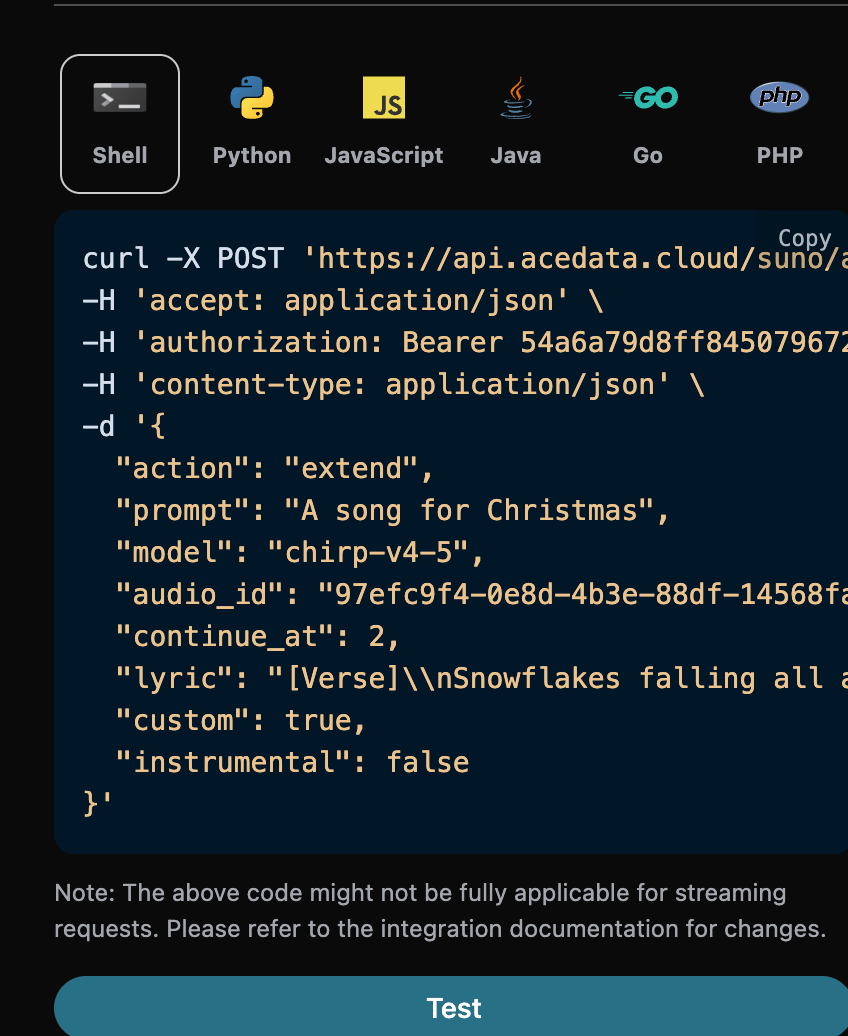
continue_at은 2초이므로 처음 2초만 이어쓰기 경계 이전의 원본 내용에 해당합니다. 실제로 곡의 끝부분에 가까운 지점에서 이어쓰기할 때는 이 값을 이어쓰기를 시작할 것으로 기대하는 초 수로 설정하고, lyric에는 경계 이후에 부를 새 구절만 제공해야 합니다.
해당 Python 코드:
lyric은 이번 이어쓰기 작업에 사용된 가사 텍스트를 반환하는 것을 알 수 있습니다. 이 필드는 완성된 전체 오디오의 축자 전사가 아닙니다. extend의 경우 continue_at 이전의 원본 오디오는 여전히 원래 가사를 사용하며, 새 가사는 이어쓰기 구간을 안내하는 데만 사용됩니다.
완성된 노래 가져오기
현재 모델의extend 결과에는 일반적으로 continue_at 이전의 원본 오디오와 경계 이후의 새 내용이 이미 포함되어 있으므로, 먼저 반환된 오디오의 실제 길이와 내용을 기준으로 이미 완성된 노래인지 판단해야 합니다. 반환된 것이 독립적인 이어쓰기 조각이거나 여러 번의 이어쓰기 이력을 명시적으로 하나의 노래로 병합해야 하는 경우에만 연결 기능을 사용합니다:
- action: 내용은
concat입니다. - audio_id: 마지막 이어쓰기 조각의 ID입니다.
음악 커버
기존 노래를 기반으로 계속 노래를 생성한 후 반환된 노래의 스타일이 적절하지 않을 수 있습니다. 이전에 생성한 노래(사용자가 직접 업로드한 음악도 지원)의 커버가 필요하다면 음악 커버 방법을 사용하면 되며, 다음 내용을 지정할 수 있습니다:- action: 내용은
cover이며, 사용자가 직접 업로드한 음악에 커버 작업을 수행하는 경우 반드시 내용으로upload_cover를 지정해야 합니다. - audio_id: 이전에 생성한 노래의 ID.
0a1e1b10-c36a-41c9-9bfb-b26d9d25db98인 경우, 다음과 같이 매개변수를 설정할 수 있습니다:
구간 교체
노래를 생성한 후 노래 구간을 교체하는 별도의 작업으로 2차 창작을 해야 하는 경우, 노래의 특정 구간을 교체할 수 있습니다.⚠️ 주의:매개변수 설명은 다음과 같습니다:replace_section_result_mode의 기본값은full_song입니다. 시스템은 새로 생성된 2개의 후보를 각각 이어 붙이고, 완전한 노래 2곡을 반환합니다. 아직 이어 붙이지 않은 교체 구간 후보만 필요한 경우, 명시적으로candidates로 설정한 후 후보를 선택하여 음악 이어 붙이기를 호출하십시오.
- action: 내용은
replace_section입니다. - audio_id: 원본 노래(교체되는 소스 노래)의 ID입니다.
- model: 노래 생성 모델입니다.
- lyric: 교체 후의 전체 가사(교체된 구간 및 그 컨텍스트를 포함하며,
prompt의 내용과 일치). - prompt: 교체해야 하는 해당 구간의 새 가사입니다.
- style: 노래의 스타일이며, 선택 사항입니다.
- replace_section_start: 원곡에서 교체되는 구간의 시작 시간(초)입니다.
- replace_section_end: 원곡에서 교체되는 구간의 종료 시간(초)입니다.
- replace_section_result_mode: 반환 모드이며, 기본값은
full_song입니다.full_song은 2개의 후보를 각각 이어 붙여 완전한 노래 2곡을 반환하고,candidates는 아직 이어 붙이지 않은 후보 구간 2개를 반환합니다.
1단계: 구간 교체 작업 시작
예를 들어 이전에 생성된 노래의 ID가18db7ed0-2b8a-41db-91c1-b0781dcca0d4(길이 94.12초)이고, 30초부터 60초까지의 후렴을 새 가사로 교체하려는 경우, 다음과 같이 매개변수를 설정할 수 있습니다:
replace_section_result_mode를 candidates로 설정하면, 아직 이어 붙이지 않은 교체 구간 2개를 반환하며 구조는 아래 예시와 같습니다:
candidates 모드에서 반환되는 두 오디오의 길이(45.16초, 33.8초)는 원곡(94.12초)보다 훨씬 짧습니다. 이들은 소량의 컨텍스트를 포함한 교체 구간이며, 전체 노래가 아닙니다. 만족스러운 후보를 선택하여 계속 수동으로 이어 붙일 수 있습니다. 기본 full_song 모드는 두 번의 이어 붙이기를 완료하여 전체 노래 2곡을 직접 반환합니다.
전체 노래 직접 반환
전체 노래를 직접 얻으려면 1단계에서replace_section_result_mode를 full_song으로 설정할 수 있습니다. 인터페이스는 두 후보를 각각 이어 붙여 전체 노래 2곡을 반환합니다. 이 경우 concat을 다시 호출할 필요가 없습니다.
2단계: 교체 구간을 원곡에 다시 이어 붙이기
위에서 선택한 구간(예:364f9d8b-ca25-463b-9a5e-d0b7139e2d6a)에 대해 음악 이어 붙이기 섹션의 방법에 따라 concat 작업을 시작합니다:
duration은 이미 완전한 곡 길이(105.28초, 원곡 길이와 거의 동일)로 복원되었으며, audio_url이 가리키는 것은 교체가 완료된 전체 곡입니다. 이로써 “생성 → 세그먼트 교체 → 전체 곡 연결”의 2차 창작 프로세스가 완료됩니다.
보컬 및 반주 분리
곡 생성 후 반주와 보컬을 별도로 조작하는 2차 창작이 필요한 경우, 순수 음악 반주와 아카펠라 보컬을 분리할 수 있습니다. 다음 내용을 지정하면 됩니다:- action: 내용은
stems입니다. - audio_id: 이전에 생성한 곡의 ID입니다.
전체 트랙 보컬 및 반주 분리
곡 생성 후 전체 트랙 보컬 및 반주 분리 작업이 필요한 경우, 다음 내용을 지정하면 됩니다:- action: 내용은
all_stems입니다. - audio_id: 이전에 생성한 곡의 ID입니다.
오디오 트랙 추가
add_stem은 지정된 오디오에 대상 악기 또는 보컬 트랙을 생성하며, POST /suno/audios를 통해 호출합니다.
- 필수:
action,audio_id,stem_type. - 선택:
model,prompt,title,style,negative_tags,weirdness,style_influence,audio_weight,max_mode,variety. - 과금: 일반 모드 0.672 Credits,
max_mode가true일 때 1.344 Credits.
오디오 트랙 추출
extract_stem은 지정된 오디오에서 대상 오디오 트랙을 추출하는 동시에, 해당 트랙을 제거한 보완 버전을 반환하며, POST /suno/audios를 통해 호출합니다.
- 필수:
action,audio_id,stem_type. - 선택:
audio_format, 현재 공개 듀얼 채널 규약은mp3만 지원합니다. - 과금: 1.12 Credits.
data는 평면 오디오 목록을 유지하며, stem_sets는 대상 오디오 트랙과 보완 오디오 트랙의 대응 관계를 나타냅니다:
음향 효과 생성
sounds는 텍스트 설명에 따라 일회성 또는 반복 가능한 음향 효과를 생성하며, POST /suno/audios를 통해 호출합니다.
- 필수:
action,sound,sound_type. - 선택:
model,bpm,key,audio_format;audio_format은 현재mp3만 지원합니다. sound_type:one-shot또는loop.- 과금: 0.112 Credits.
오디오 속도 조정
adjust_speed는 지정한 오디오의 재생 속도를 조정하며, POST /suno/audios를 통해 호출합니다.
- 필수:
action,audio_id,speed_multiplier,title. - 선택 사항:
keep_pitch. speed_multiplier: 범위 0.25–4.- 과금: 0.28 Credits.
사용자 지정 생성의 고급 파라미터
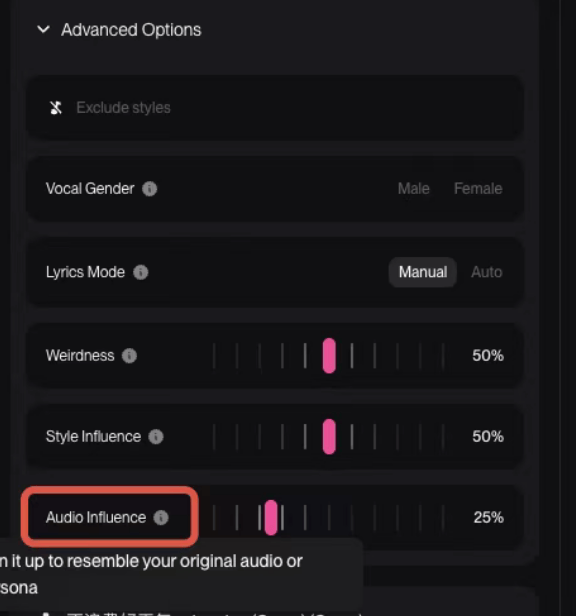
공식적으로 사용자 지정 모드에서 고급 파라미터weirdness==>Weirdness, style_influence==>Style Influence, audio_weight==>Audio Influence를 사용하여 생성할 수 있으며, 이에 해당하는 공식 예시는 다음과 같습니다:
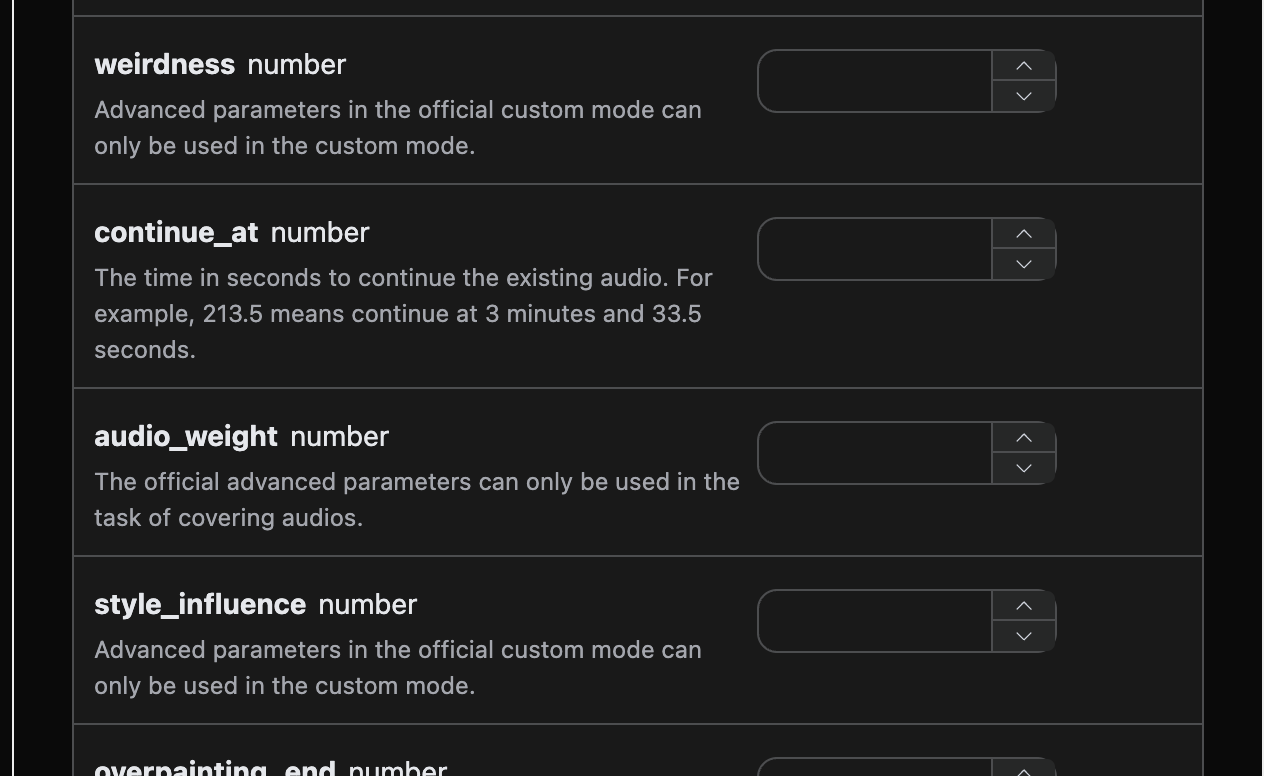
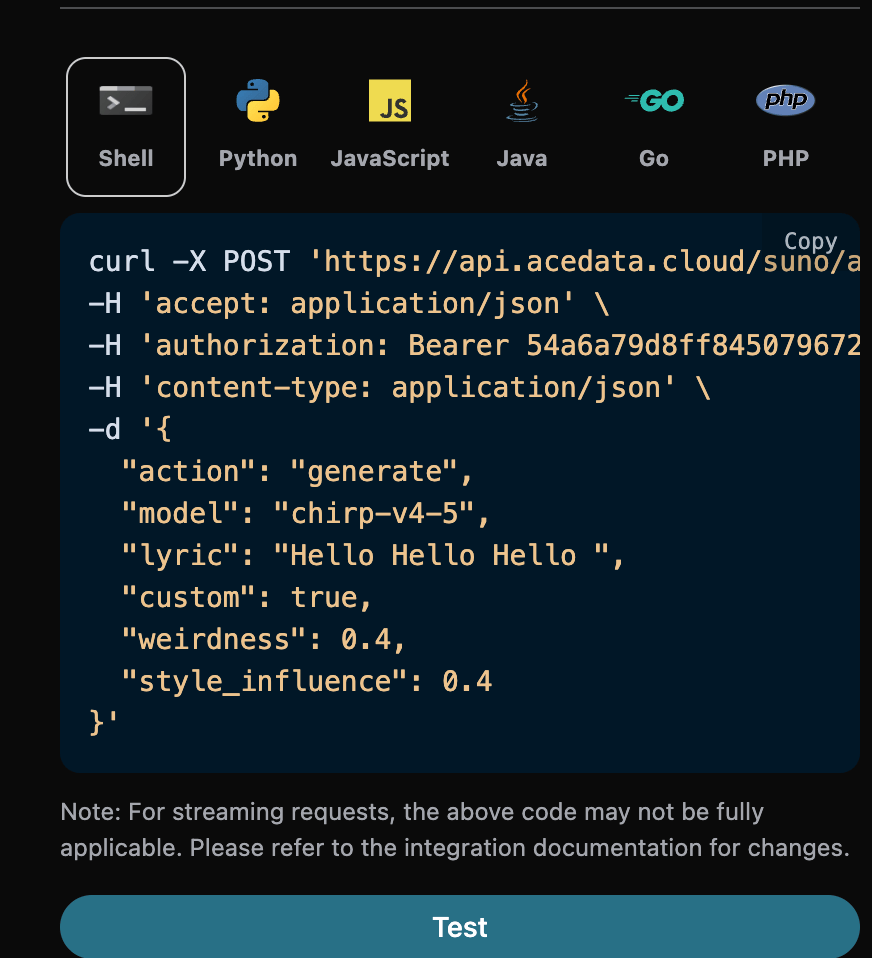
노래 길이 제어
기본적으로 생성되는 노래의 길이는 모델이 자체적으로 결정하며, 일반적으로 30초에서 4분 사이입니다. 더 길거나 짧은 결과물이 필요한 경우duration 파라미터를 통해 원하는 길이를 지정할 수 있으며, 단위는 초이고 값은 10에서 360 사이의 정수입니다.
이 파라미터는 사용자 지정 모드(custom이 true인 경우)의 노래 생성에 사용됩니다. 특히 설명할 점은 duration이 강제 제약이 아닌, 경향성 힌트라는 것입니다: 모델은 생성 시 이 값을 참고하지만, 도달을 보장하지 않으며, 실제 테스트에서 실제 길이는 보통 기대값보다 현저히 짧고 동일한 요청에서 반환되는 두 노래의 길이도 몇 배 차이 날 수 있습니다. 완전히 동일한 요청이라도 여러 번 제출하여 얻는 길이에는 큰 차이가 있을 수 있습니다. 따라서 이를 정확한 길이 제어로 사용하지 말고, 비즈니스상 고정 길이가 필요한 경우 결과물을 받은 후 직접 잘라내거나 재시도하십시오.
해당 Python 코드:
duration은 기대 길이이고, 응답 data에서 각 곡의 duration 필드는 해당 곡의 실제 길이라는 것입니다. 두 이름은 같지만 의미는 다르며, 실제 길이가 기대값과 같다고 보장되지 않습니다. 가사 길이는 완성본 길이에 영향을 미치는 주요 요인 중 하나이므로, 더 긴 완성본이 필요하다면 더 완전한 가사를 함께 제공하는 것을 권장합니다.
인터페이스는 duration이 10에서 360 사이의 정수여야 하는지 검증합니다. 이는 여전히 생성 목표일 뿐이며, 완성본 길이를 보장하지는 않습니다.
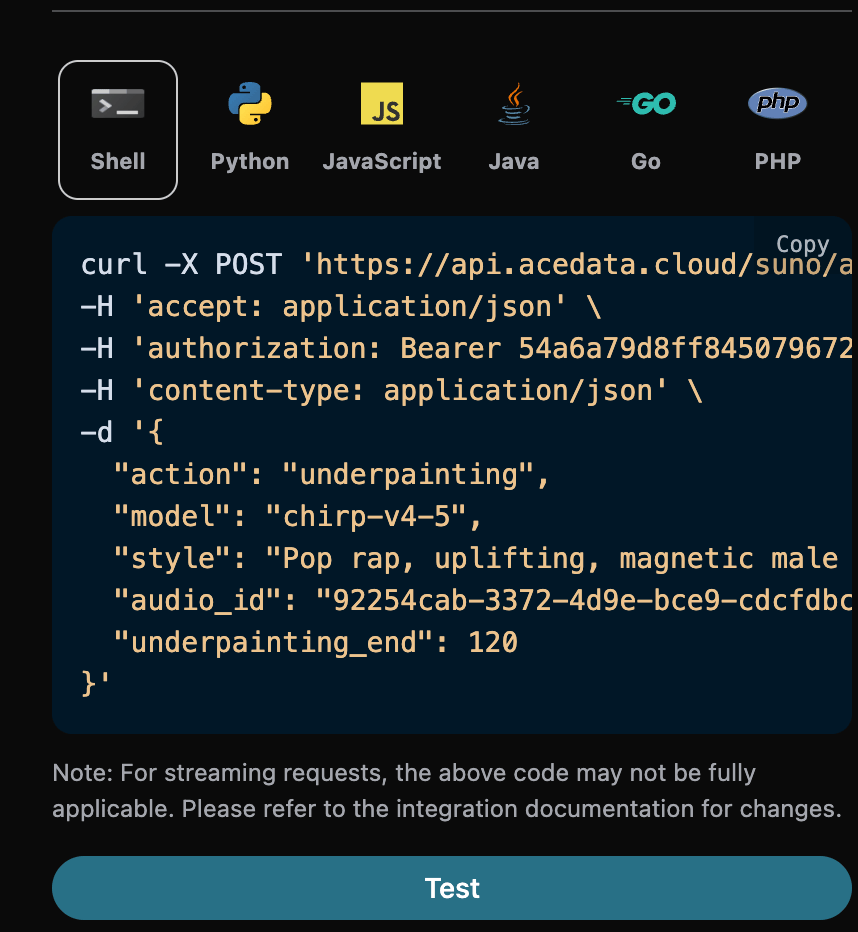
Add Insterumental 기능
2025년 8월 suno에 새로운 Add Insterumental 기능이 출시되었습니다. 먼저 무반주 무보컬 노래 한 곡을 업로드해야 하며, suno가 반주를 추가하도록 할 수 있습니다. 먼저 Suno Upload API에서 무반주 무보컬 노래 한 곡을 업로드할 수 있으며, 해당 작업은 아래 그림과 같습니다: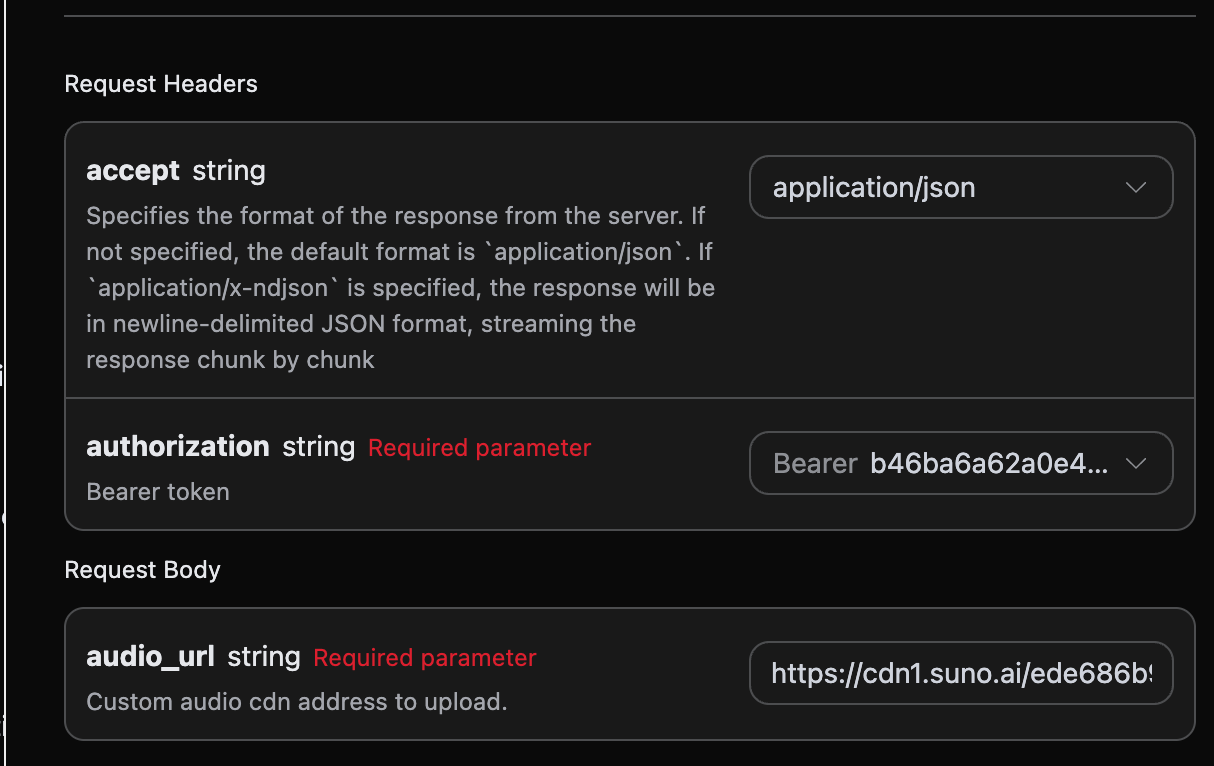
audio_id를 기록해야 하며, 구체적인 결과는 아래 그림과 같습니다:
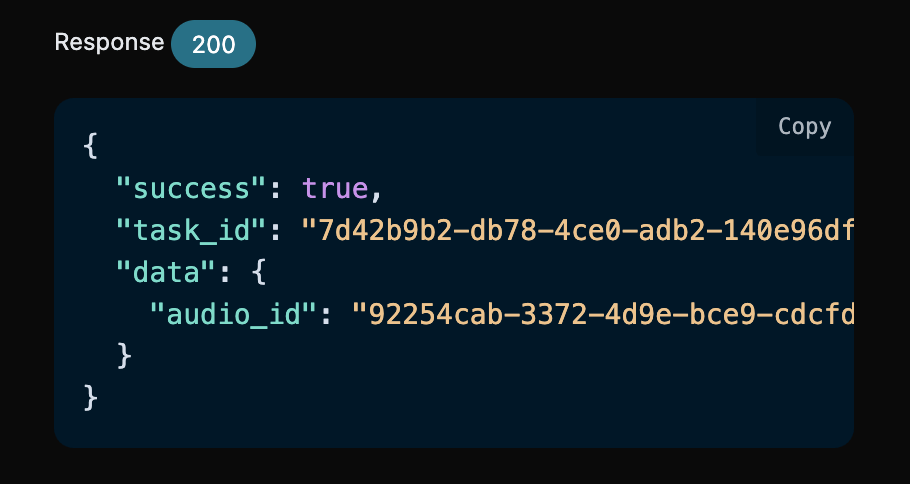
audio_id 하나를 얻었습니다: 92254cab-3372-4d9e-bce9-cdcfdbc39070. 그런 다음 아래 매개변수도 입력해야 합니다:
- action: 값은
underpainting입니다. - underpainting_start: 업로드한 노래에 반주를 추가하는 시작 시간이며, 기본값은 0입니다.
- underpainting_end: 업로드한 노래에 반주를 추가하는 종료 시간이며, 노래의 총 길이보다 작아야 합니다.
- audio_id: 업로드한 무반주 무보컬 노래의 ID입니다.
- style: 반주의 스타일이며, 반주이므로 가사를 사용하지 않는 것이 좋습니다.
Add Vocals 기능
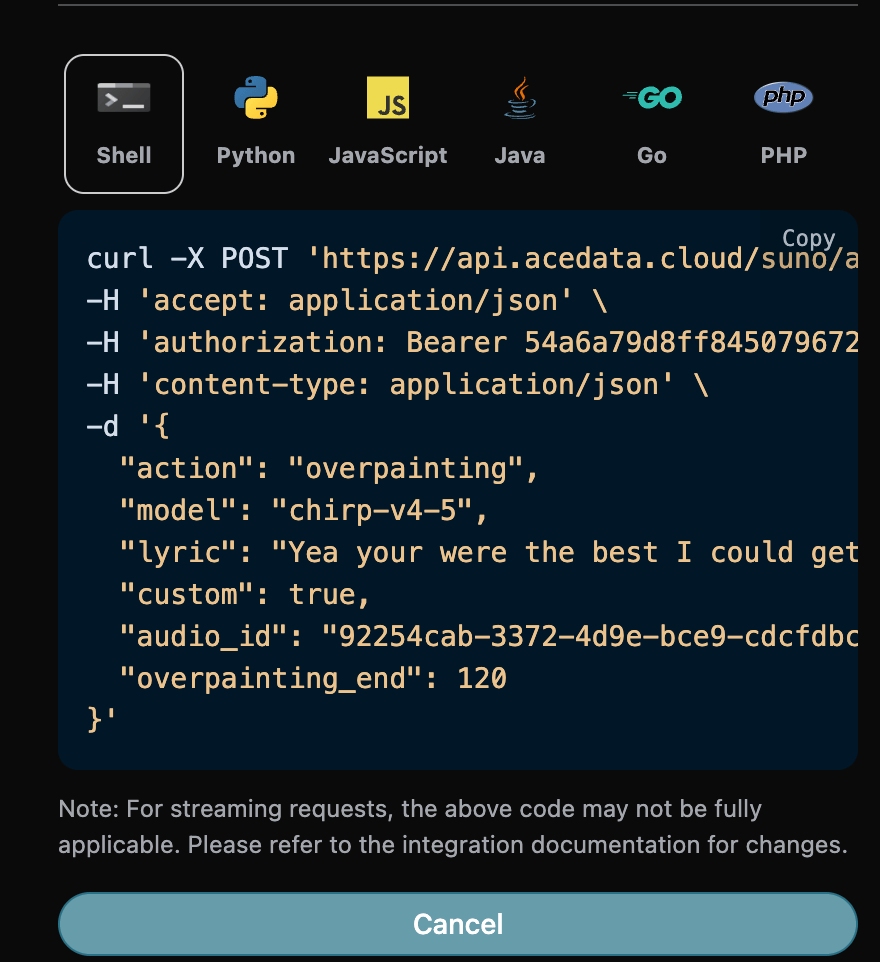
2025년 8월 suno에 새로운 Add Vocals 기능이 출시되었습니다. 먼저 순수 음악 한 곡을 업로드해야 하며, suno가 가사를 작성하고 보컬 노래를 생성하도록 할 수 있습니다. 먼저 Suno Upload API에서 무반주 무보컬 노래 한 곡을 업로드할 수 있으며, 해당 작업은 아래 그림과 같습니다:
audio_id를 기록해야 하며, 구체적인 결과는 아래 그림과 같습니다:
audio_id 하나를 얻었습니다: 92254cab-3372-4d9e-bce9-cdcfdbc39070. 그런 다음 아래 매개변수도 입력해야 합니다:
- action: 값은
overpainting입니다. - overpainting_start: 업로드한 노래에 보컬을 추가하는 시작 시간이며, 기본값은 0입니다.
- overpainting_end: 업로드한 노래에 보컬을 추가하는 종료 시간이며, 노래의 총 길이보다 작아야 합니다.
- audio_id: 업로드한 무반주 무보컬 노래의 ID입니다.
- custom: 이 모드에서는 반드시 사용자 정의 모드를 사용하여 가사를 입력해야 합니다.
- lyric: 사용자 정의 모드에서 입력하는 가사입니다.
- style: 반주의 스타일입니다.
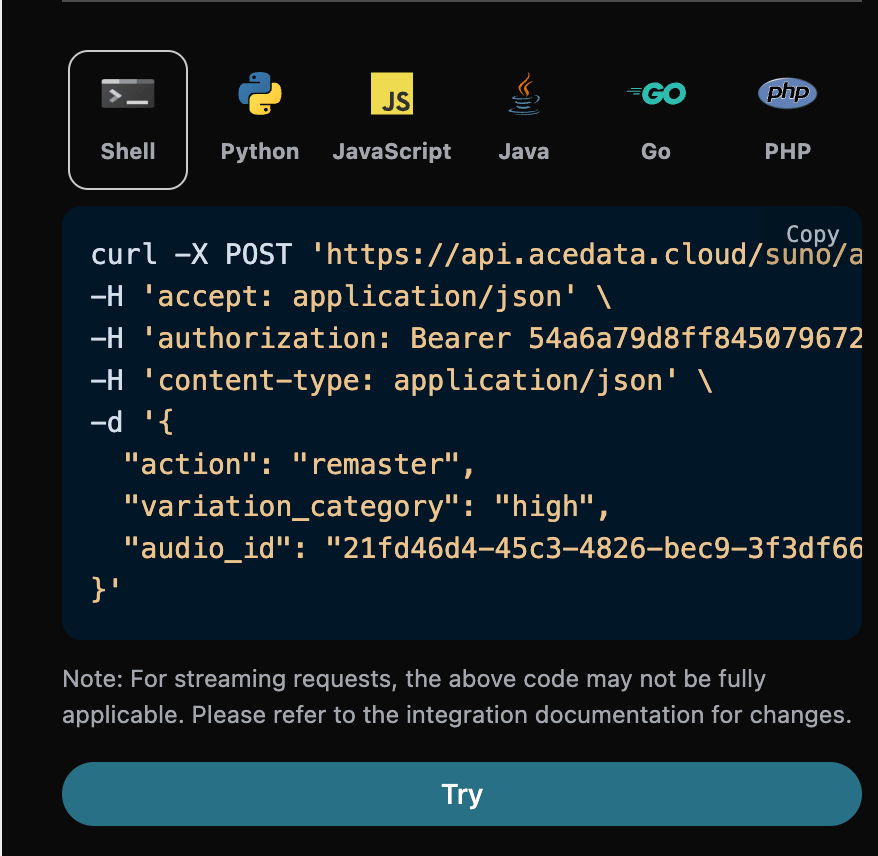
Remaster 기능
2025년 12월 Suno에서 새롭게 Remaster 기능을 출시했습니다. 이 기능은 노래를 다시 생성할 수 있으며, 계정 간 사용은 불가능합니다. 또한 다음과 같은 매개변수를 입력해야 합니다:- action: 내용은
remaster입니다. - audio_id: 다시 생성해야 하는 노래 ID입니다.
- model: v4.5+, v5만 지원합니다.
- variation_category: v5 이상 버전에서만 지원하며, 값은 high, normal, subtle 세 가지뿐입니다.
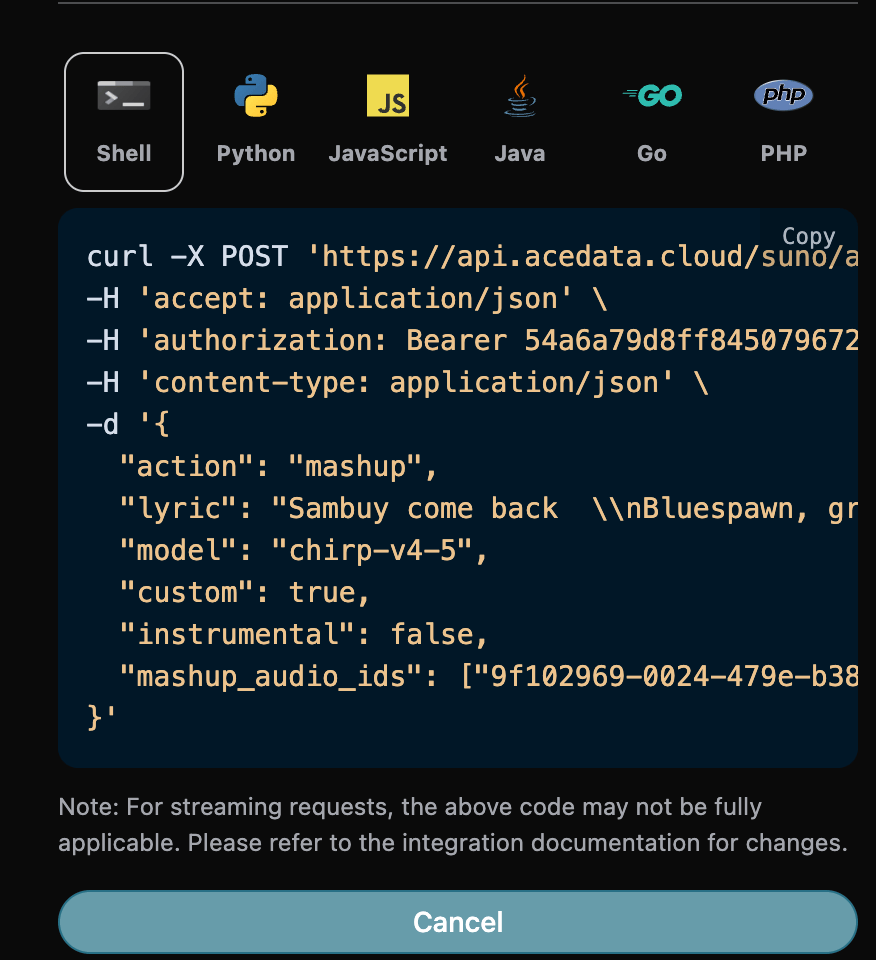
Mashup 믹스곡 생성 기능
2025년 12월 Suno에서 새롭게 Mashup 기능을 출시했습니다. 이 기능은 두 개의 참고 노래를 기반으로 노래를 생성할 수 있으며, 또한 다음과 같은 매개변수를 입력해야 합니다:- action: 내용은
mashup입니다. - mashup_audio_ids: 두 개의 참고 노래 ID입니다. 작성 완료 후 다음과 같이 코드가 자동 생성됩니다:
Samples 샘플링으로 곡 생성
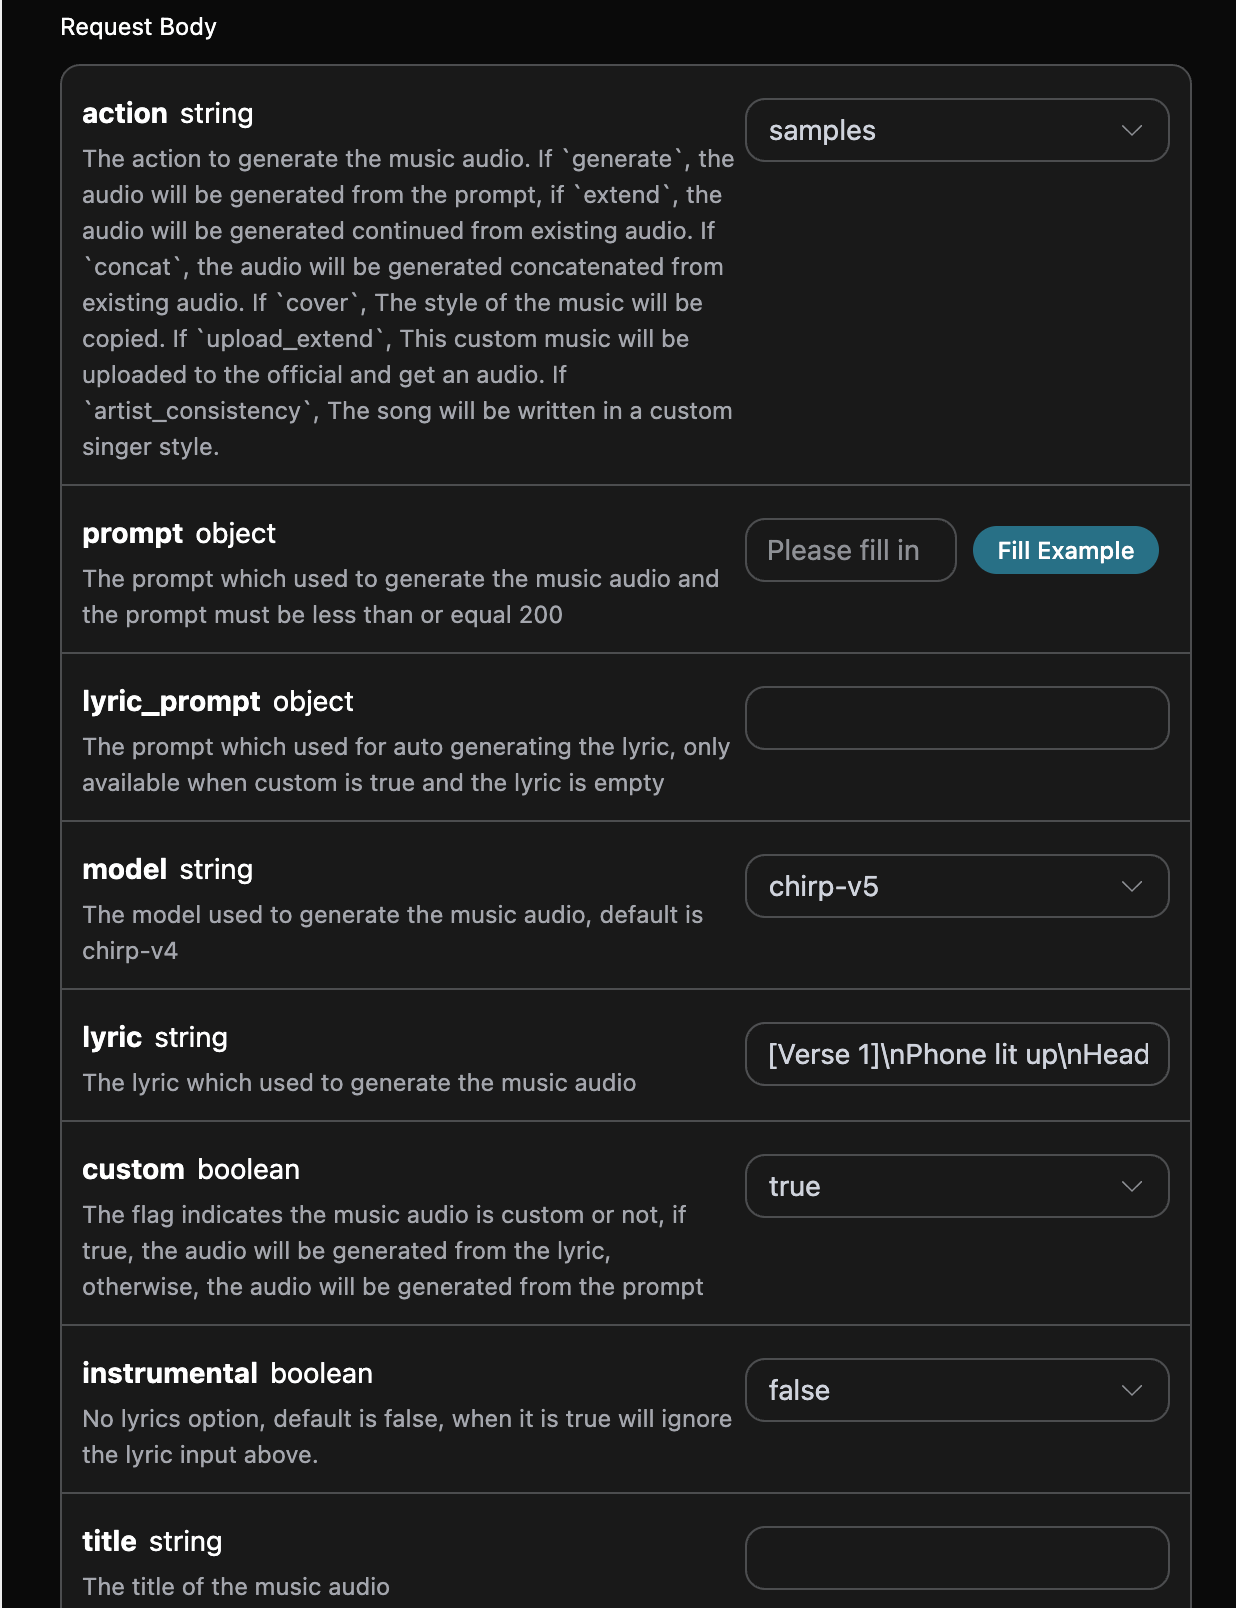
여기서의samples는 단일 오디오 구간 샘플링입니다. 기존 오디오에서 시작 및 종료 시간을 선택하고, 해당 구간을 샘플 소재로 사용하여 창작합니다. 이는 아래에서 1~4개의 완전한 참조 오디오 구간을 사용하는 Inspo 영감 창작 기능과는 다릅니다. 다음 매개변수를 입력해야 합니다:
- action: 내용은
samples입니다. - samples_start: 샘플링 시작 시간입니다.
- samples_end: 샘플링 종료 시간입니다.
- audio_id: 샘플링할 참조 곡의 ID입니다.
Inspo 영감 창작 기능
Inspo 영감 창작 기능은 1~4개의 완전한 참고 오디오를 바탕으로 새로운 음악을 생성할 수 있으며, 오디오를 드래그 앤 드롭하거나 업로드하여 영감 소스로 사용할 수 있습니다. API는 기존의inspo action을 사용합니다. 클라이언트가 공개적으로 접근 가능한 오디오 URL을 제공하면 서비스가 참고 오디오 준비와 창작을 자동으로 완료하므로, 클라이언트가 가사, 스타일 또는 길이를 각각 읽어 요청을 조합할 필요가 없습니다. 이는 위의 구간 샘플링과도 다르고, 원곡 스타일을 복제하는 Cover와도 다릅니다. 사용할 때는 다음 매개변수를 입력해야 합니다:
- action: 내용은
inspo입니다. - audio_urls: 참고 오디오 URL 목록으로, 공개적으로 접근 가능한 오디오 주소를 1~4개 제공해야 합니다.
- model: 사용하는 모델이며,
chirp-v6를 권장합니다. - prompt: 가사 또는 창작 프롬프트(선택 사항).
안내: 참고 오디오는 공개적으로 접근 가능한 오디오 파일이어야 합니다. 참고 오디오가 플랫폼 음원 라이브러리의 알려진 녹음과 완전히 일치하는 경우, Suno는 저작권 검증으로 인해 생성을 거부할 수 있으므로 자체 소유 오디오 또는 Suno가 생성한 오디오를 영감 소스로 사용하는 것을 권장합니다.해당 Python 코드:
chirp-v5를 사용했으며, 현재 요청 예시는 chirp-v6를 권장합니다. 반환 구조는 동일합니다:
비동기 콜백
Suno가 음악을 생성하는 데 걸리는 시간이 비교적 길며, 약 1~2분이 필요합니다. API가 장시간 응답하지 않을 경우 HTTP 요청은 계속 연결 상태를 유지하게 되어 추가적인 시스템 리소스가 소모됩니다. 따라서 본 API는 비동기 콜백도 지원합니다. 전체 과정은 다음과 같습니다. 클라이언트가 요청을 시작할 때 추가로callback_url 필드를 지정합니다. 클라이언트가 API 요청을 시작한 후 API는 즉시 현재 작업 ID를 나타내는 task_id 필드 정보를 포함한 결과를 반환합니다. 작업이 완료되면 생성된 음악 결과는 POST JSON 형식으로 클라이언트가 지정한 callback_url로 전송되며, 여기에도 task_id 필드가 포함되어 있어 ID를 통해 작업 결과를 연결할 수 있습니다.
아래 예시를 통해 구체적으로 어떻게 작업하는지 알아보겠습니다.
먼저, Webhook 콜백은 HTTP 요청을 수신할 수 있는 서비스이며, 개발자는 이를 직접 구축한 HTTP 서버의 URL로 교체해야 합니다. 여기서는 시연의 편의를 위해 공개 Webhook 예제 사이트 https://webhook.site/ 를 사용합니다. 해당 사이트를 열면 아래 그림과 같이 Webhook URL을 얻을 수 있습니다.
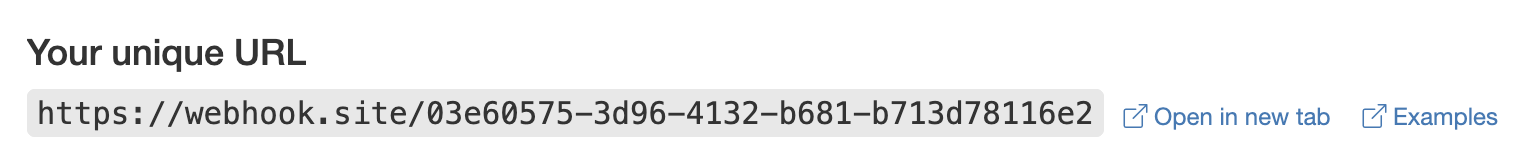 이 URL을 복사하면 Webhook으로 사용할 수 있으며, 여기서의 예시는 https://webhook.site/03e60575-3d96-4132-b681-b713d78116e2 입니다.
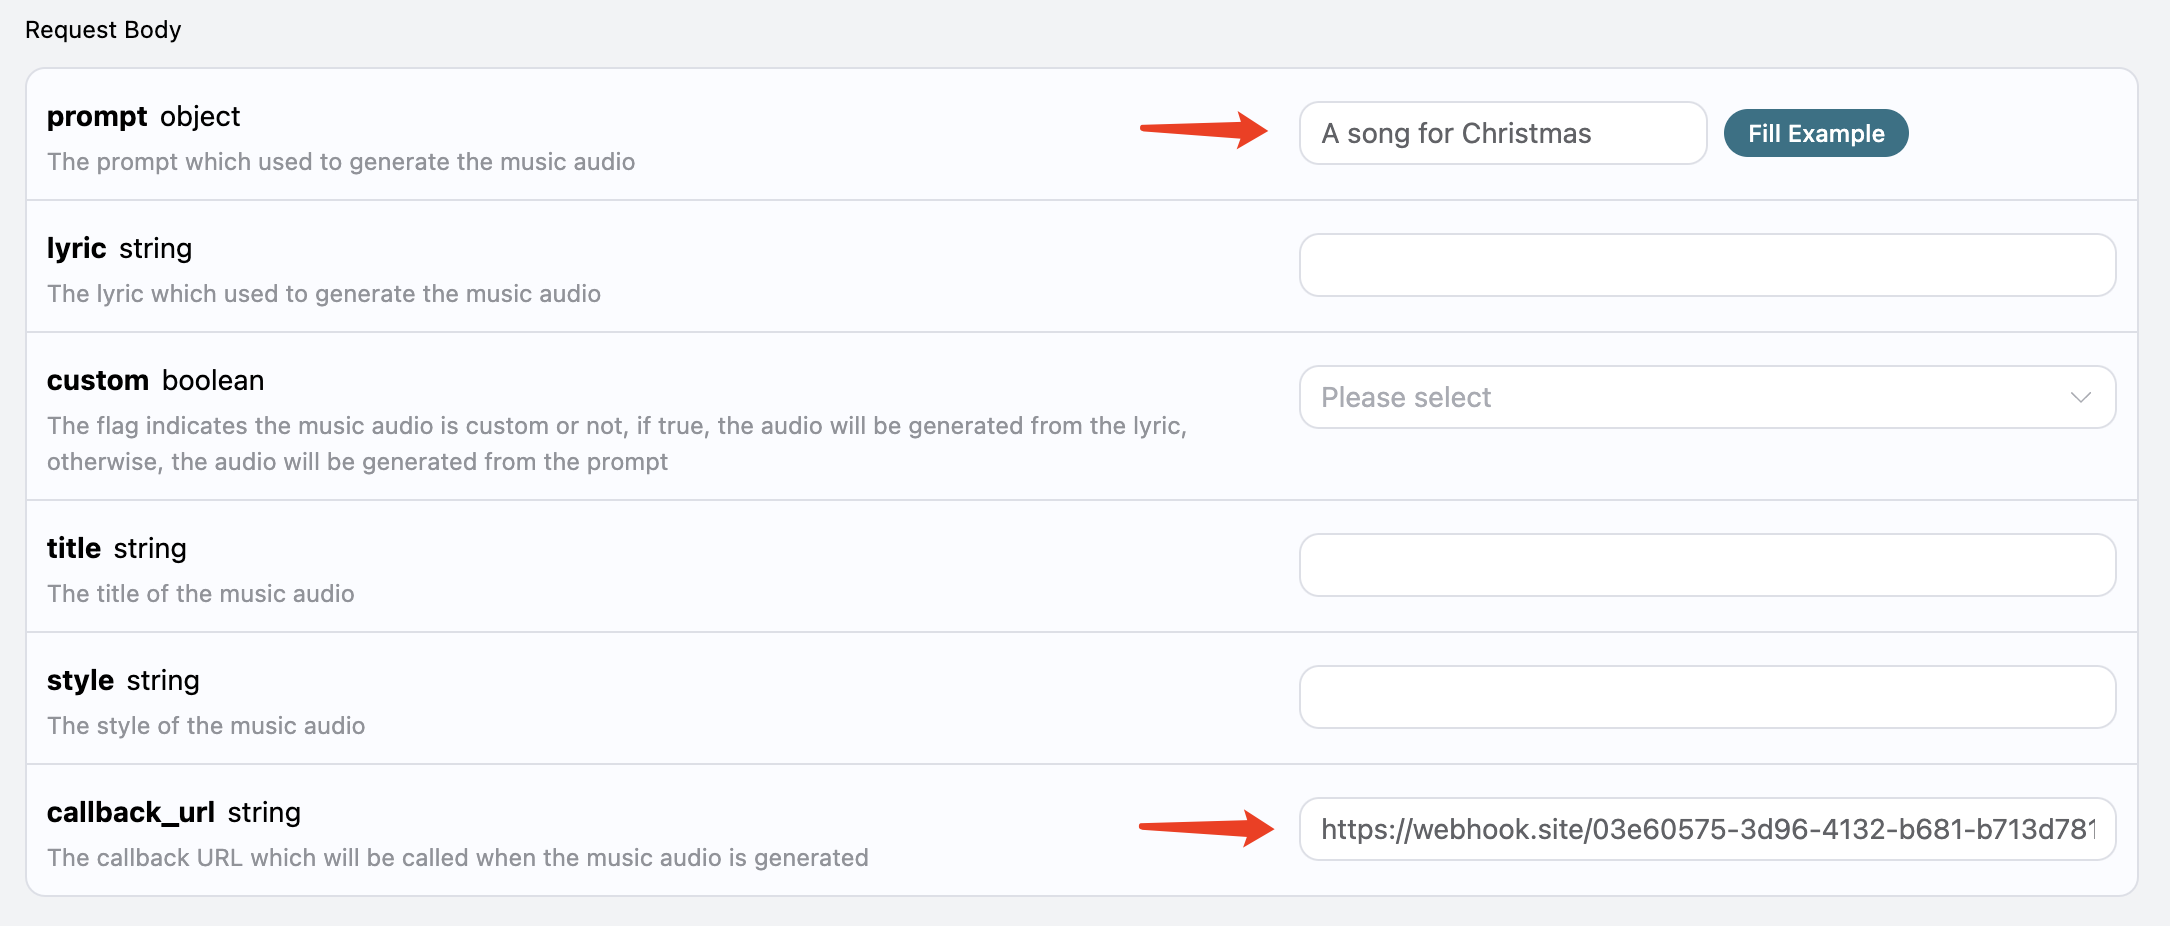
다음으로,
callback_url 필드를 위 Webhook URL로 설정하고, 동시에 prompt를 입력할 수 있습니다. 아래 그림과 같습니다.
 실행을 클릭하면 아래와 같이 즉시 결과를 얻을 수 있습니다.
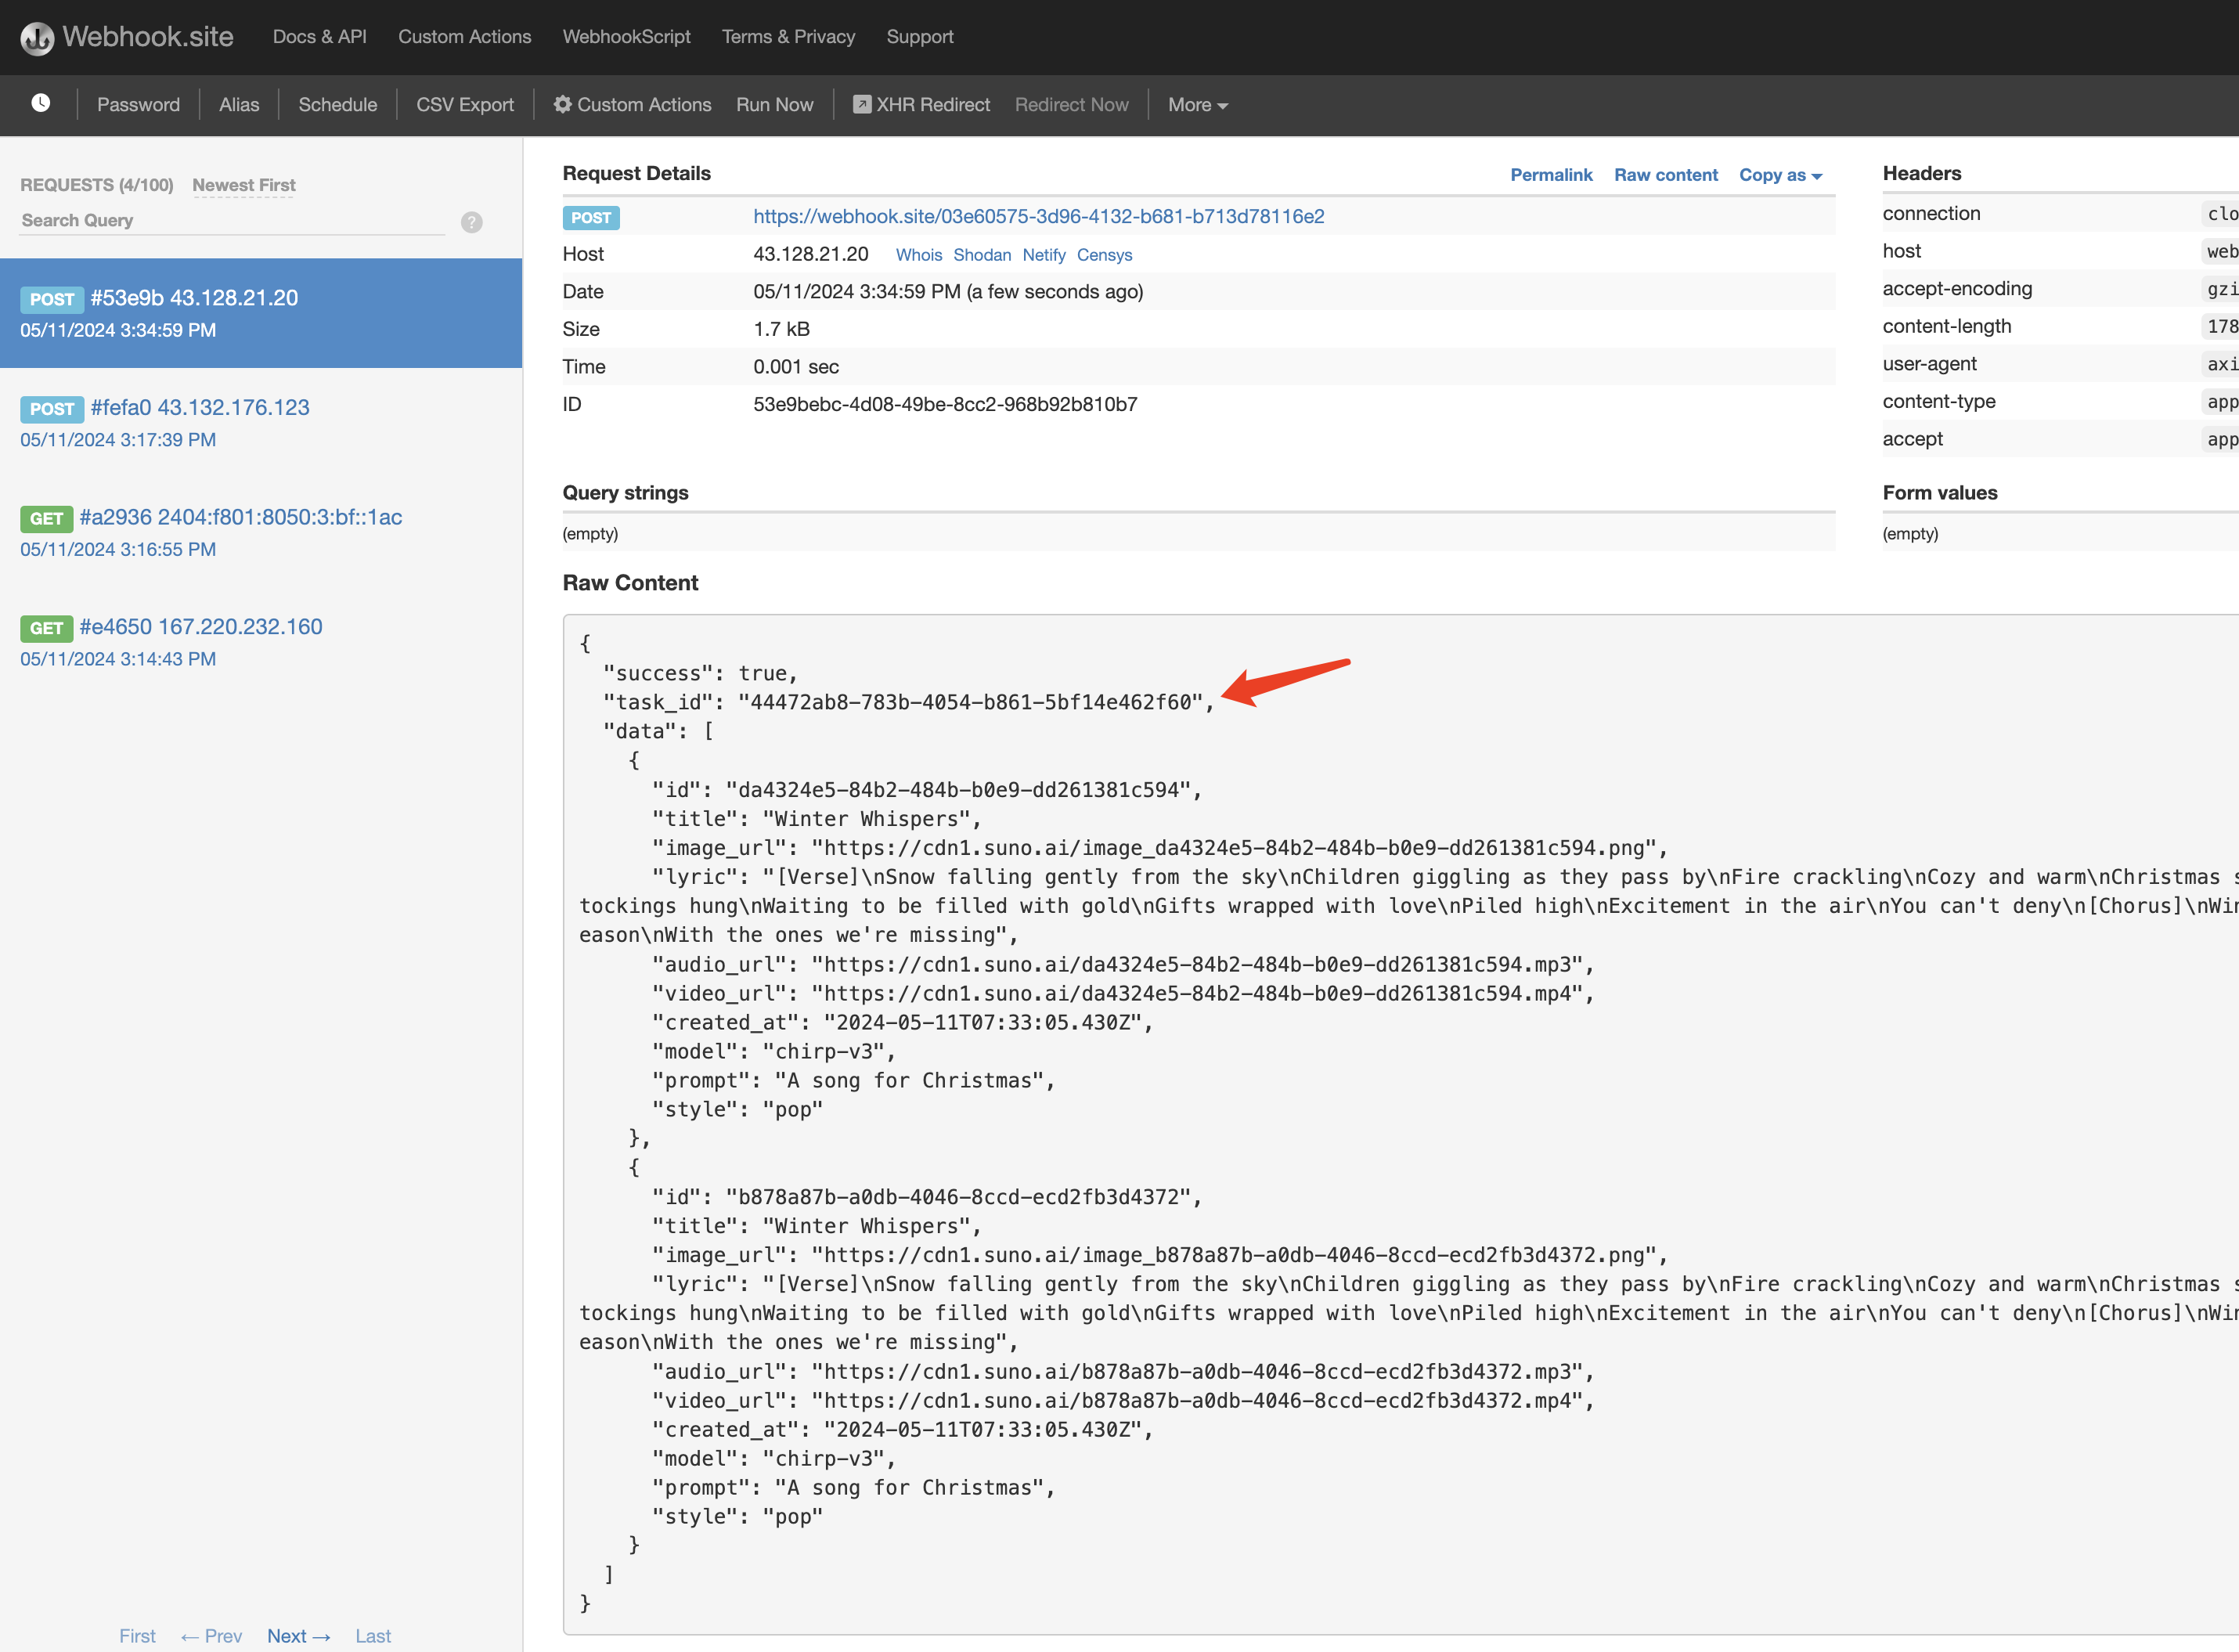 내용은 다음과 같습니다.
task_id 필드가 있는 것을 확인할 수 있으며, 다른 필드는 위와 유사합니다. 이 필드를 통해 작업 연결을 구현할 수 있습니다.
물론 스트리밍 호출을 통해서도 결과를 얻을 수 있습니다. 요청 헤더의 accept 값을 application/x-ndjson로 설정하기만 하면 됩니다. 아래에서는 예시 입력을 사용하여 시연합니다.
task_id에 대해 처리 중 상태와 최종 결과를 순차적으로 푸시합니다. 위에서는 최초 및 최종 상태의 실제 응답 두 개만 유지하고, 반복되는 중간 업데이트는 생략했습니다.
오류 처리
오류가 발생하면 다음과 유사한 오류 정보를 받게 됩니다:error.code, error.message의 목록입니다:
참고: 서로 다른 업스트림 계정의 한도와 오류 문구에는 차이가 있을 수 있습니다. 일반적으로chirp-v3-5/chirp-v4의style제한은 더 낮으며(200),chirp-v4-5이상은 보통 최대 1000까지 지원합니다. 이전 업스트림에 해당할 경우Tags too long.또는style must be less than or equal 120등의 호환 문구가 나타날 수 있습니다. | 상태 코드 |error.code|error.message| | ----------- | ------------- | --------------------------------------------------------------- | | 400 |bad_request|노래 ID가 존재하지 않거나 오프라인 처리되었습니다.| | 400 |bad_request|프롬프트가 너무 깁니다.| | 400 |bad_request|태그가 너무 깁니다.| | 400 |bad_request|업로드된 오디오가 기존 예술 작품과 일치합니다.| | 400 |bad_request|instrumental은 불리언이어야 합니다| | 400 |bad_request|제목이 너무 깁니다.| | 400 |bad_request|주제가 너무 깁니다.| | 400 |bad_request|style은 120 이하이어야 합니다| | 400 |bad_request|custom은 불리언이어야 합니다| | 400 |bad_request|오디오를 연장할 때 audio_id가 필요합니다| | 400 |bad_request|오디오를 연장할 때 continue_at이 필요합니다| | 400 |bad_request|continue_at은 0보다 큰 숫자여야 합니다| | 400 |bad_request|오디오를 연장하고 instrumental이 false일 때 lyric이 필요합니다| | 400 |bad_request|오디오를 생성할 때 prompt가 필요합니다| | 400 |bad_request|사용자 지정 오디오를 생성할 때 lyric이 필요합니다| | 403 |forbidden|프롬프트 형식이 잘못되었을 가능성이 높습니다| | 403 |forbidden|프롬프트에 저작권이 있을 가능성이 높습니다| | 403 |forbidden|프롬프트에 부적절한 자료가 포함되어 있습니다| | 403 |forbidden|노래 설명이 검토 대상으로 표시되었습니다| | 403 |forbidden|노래 설명에 아티스트 이름이 포함되어 있습니다| | 403 |forbidden|태그에 아티스트 이름이 포함되어 있습니다| | 403 |forbidden|가사에 저작권이 있는 자료가 포함되어 있습니다| | 403 |forbidden|노래 설명에 프로듀서 태그가 포함되어 있습니다| | 403 |forbidden|일반 OpenAI 오류| | 403 |forbidden|프롬프트가 검토 대상으로 표시되었습니다| | 500 |api_error|노래 설명으로부터 가사를 생성할 수 없습니다| | 500 |api_error|알 수 없는 오류로 작업에 실패했습니다| | 500 |api_error|시스템에 사용 가능한 워커가 없습니다| | 500 |api_error|서비스가 유지보수 중이며 생성이 일시 중지되었습니다| | 504 |timeout|오디오 생성 대기 중 시간 초과|