

GPT-6.1 Sol
Utilizzaremodel: "gpt-6.1-sol" per selezionare questo modello. Supporta output in streaming, chiamate di funzione, output strutturato e input di immagini. Nella prima settimana dall’apertura, è disponibile solo per i possessori verificati di ACE T1+ (almeno 100.000 ACE) o per gli utenti autorizzati; l’orario specifico di apertura è soggetto al messaggio di accesso nella console.
I livelli di ragionamento supportano low, medium, high, xhigh e max, mentre none o minimal non sono temporaneamente supportati. Si consiglia di iniziare con reasoning: {"effort": "low"}. Quando l’input supera 272.000 token, l’intera richiesta è soggetta al prezzo del contesto lungo, e il costo è soggetto al prezzo corrente nella console.
Processo di richiesta
Per utilizzare l’API OpenAI Responses, innanzitutto vai alla console Ace Data Cloud per ottenere il tuo API Token e conservalo come riserva. Se non hai ancora effettuato l’accesso o la registrazione, verrai automaticamente reindirizzato alla pagina di accesso che ti inviterà a registrarti e ad accedere; al termine, tornerai automaticamente alla pagina corrente.
Un solo API Token può chiamare tutti i servizi della piattaforma, senza necessità di richiederne uno separatamente per ogni servizio. Alla prima richiesta verrà assegnato un credito gratuito, che consente una prova gratuita; quando il credito è insufficiente, puoi ricaricare il saldo universale nella console.
📘 Documentazione completa: OpenAI Responses API →
Utilizzo di base
Successivamente, puoi compilare i contenuti corrispondenti nell’interfaccia, come mostrato nell’immagine: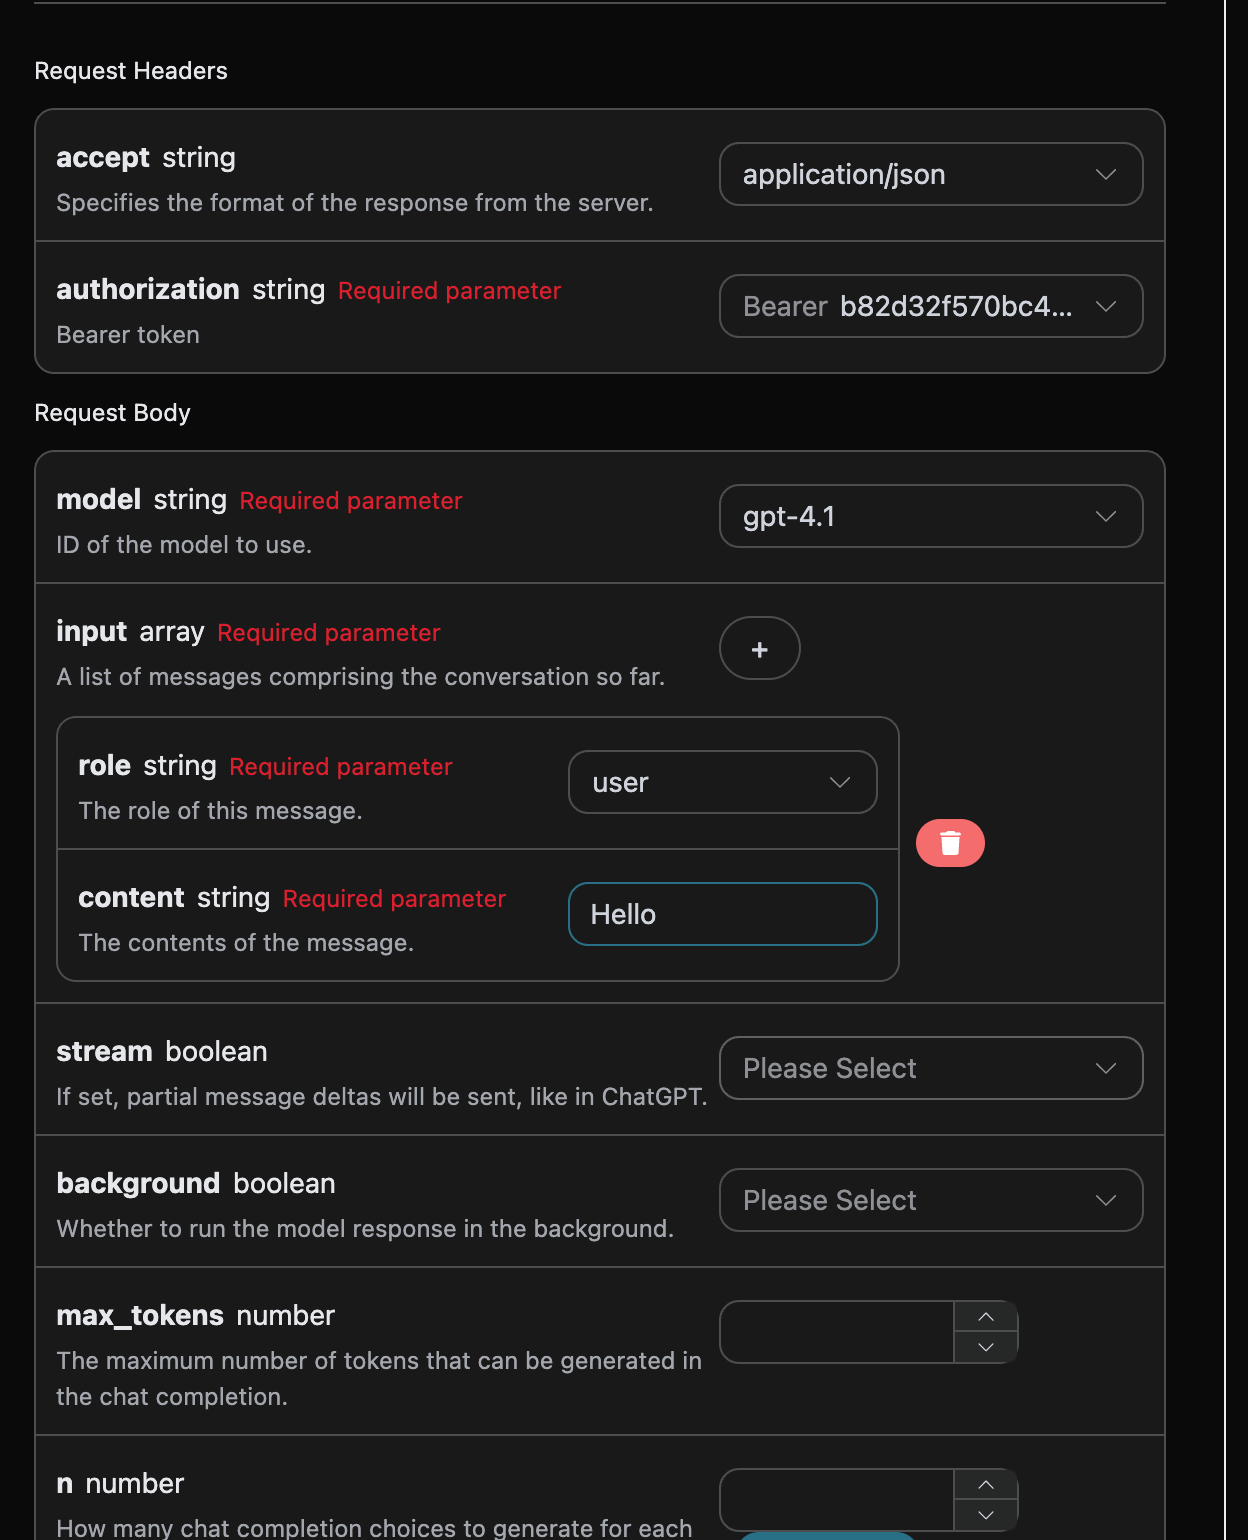
authorization, che può essere selezionato direttamente nell’elenco a discesa. Un altro parametro è model; model è la categoria del modello del sito ufficiale OpenAI ChatGPT che scegliamo di utilizzare. Qui abbiamo principalmente 20 modelli, per i dettagli puoi consultare i modelli che forniamo. L’ultimo parametro è input; input è l’array di prompt che inseriamo, è un array e indica che possono essere caricati contemporaneamente più prompt. Ogni prompt contiene role e content, dove role indica il ruolo del richiedente. Forniamo tre identità, ovvero user, assistant, system. L’altro, content, è il contenuto specifico della nostra domanda.
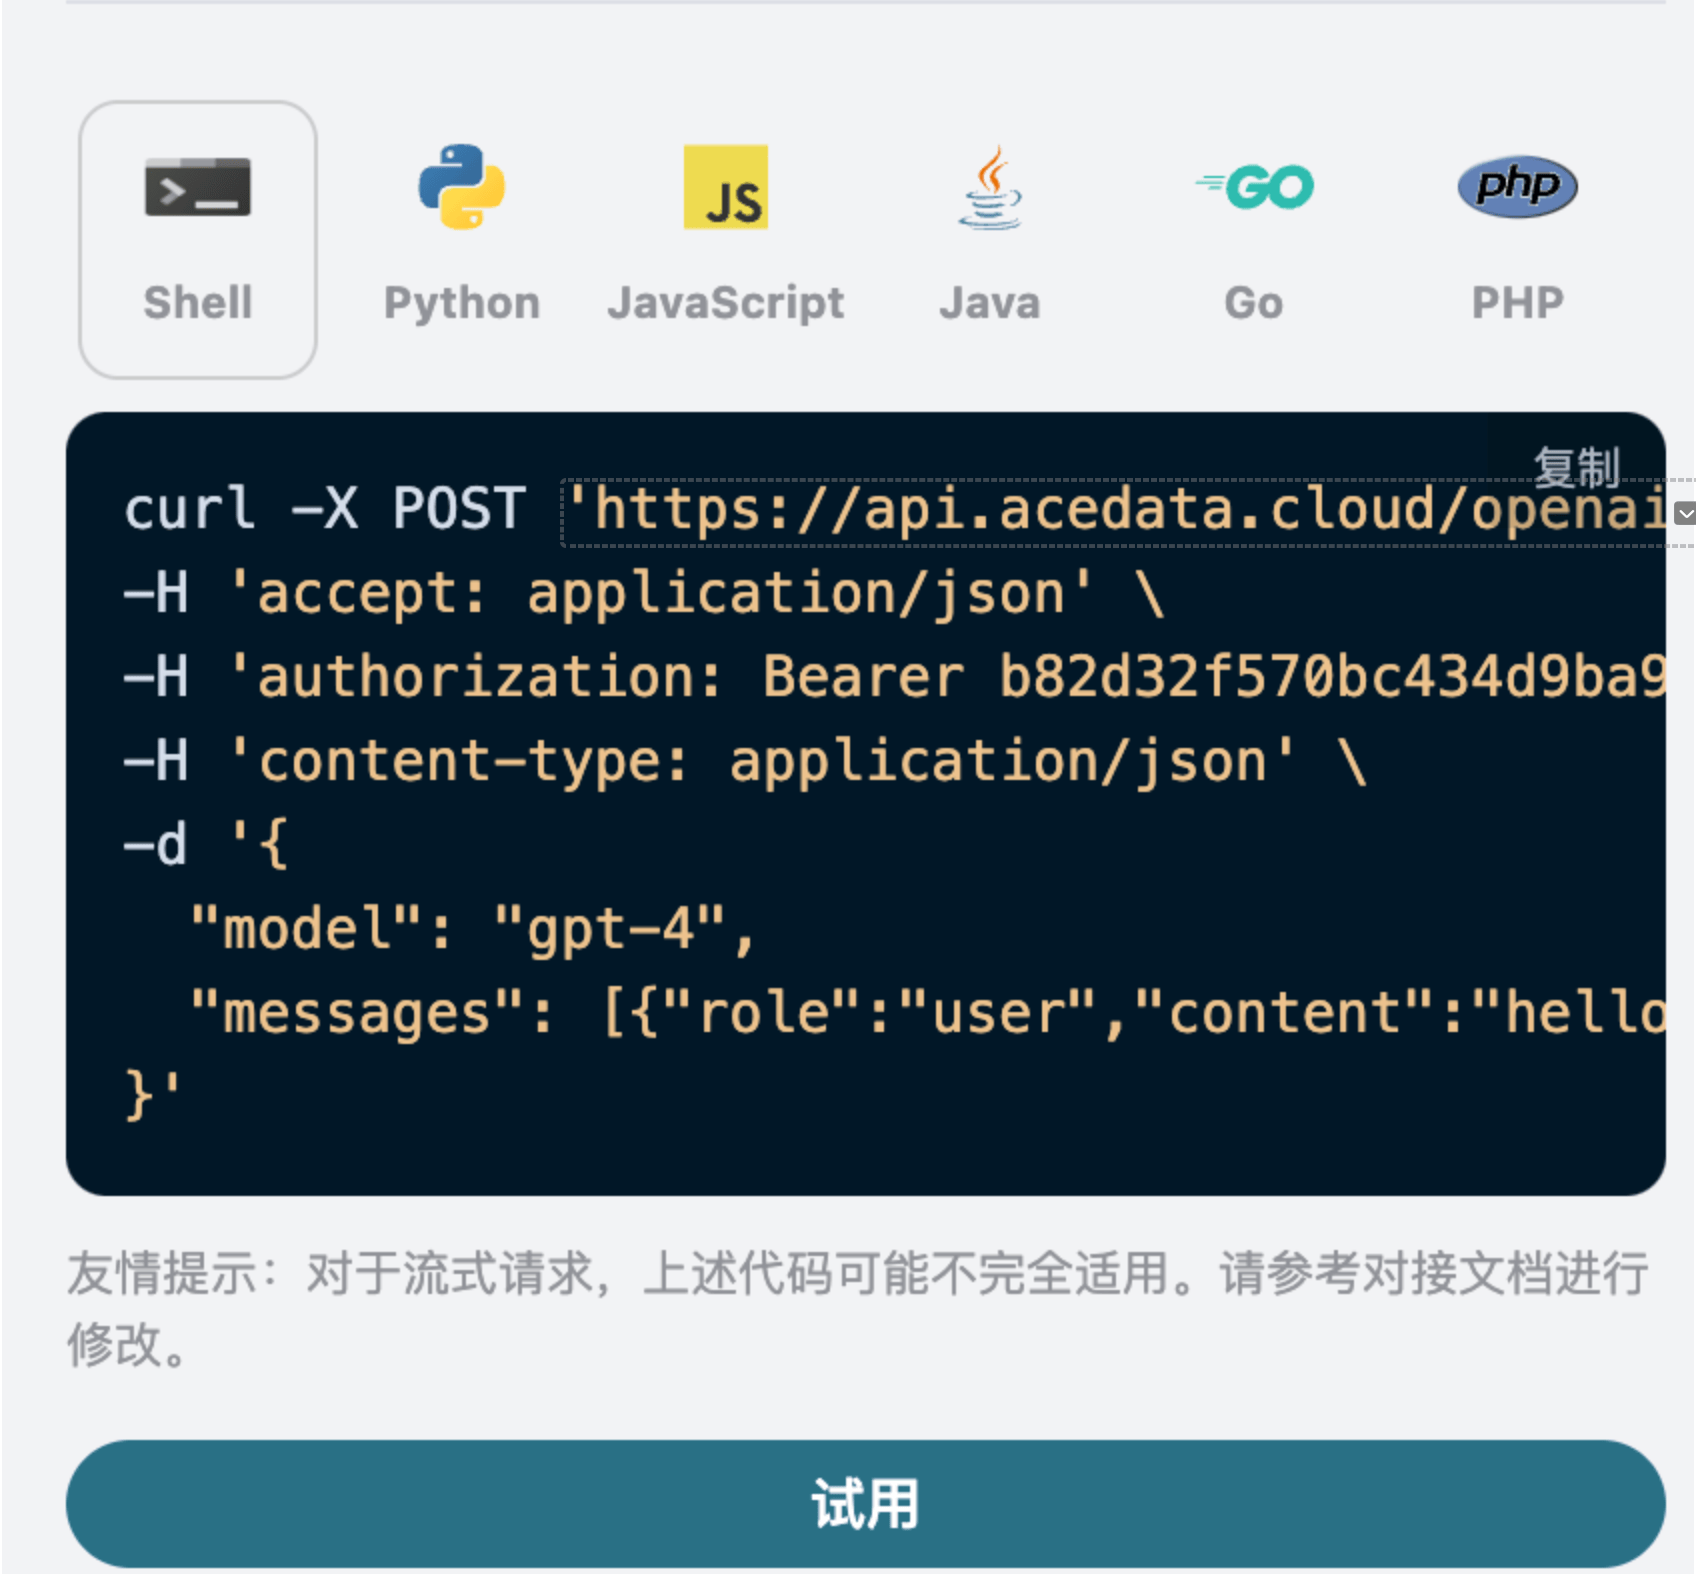
Allo stesso tempo, puoi notare che sulla destra viene generato il codice di chiamata corrispondente; puoi copiare il codice ed eseguirlo direttamente, oppure fare direttamente clic sul pulsante «Try» per testarlo.
Parametri opzionali comuni:
max_tokens: limita il numero massimo di token per una singola risposta.temperature: casualità della generazione, tra 0 e 2; maggiore è il valore, maggiore è la dispersione.n: quante risposte candidate generare alla volta.response_format: impostazione del formato di risposta.tools: definizione di chiamate di funzioni/strumenti.background: se eseguire in modo asincrono in background.
id, l’ID generato per questa attività di conversazione, utilizzato per identificare univocamente questa attività di conversazione.model, il modello del sito ufficiale OpenAI ChatGPT selezionato.output, le informazioni di risposta fornite da ChatGPT al prompt.usage: le informazioni statistiche sui token per questa sessione di domande e risposte.
output contiene le informazioni di risposta di ChatGPT, e l’output al suo interno è ChatGPT, come si può vedere nell’immagine.
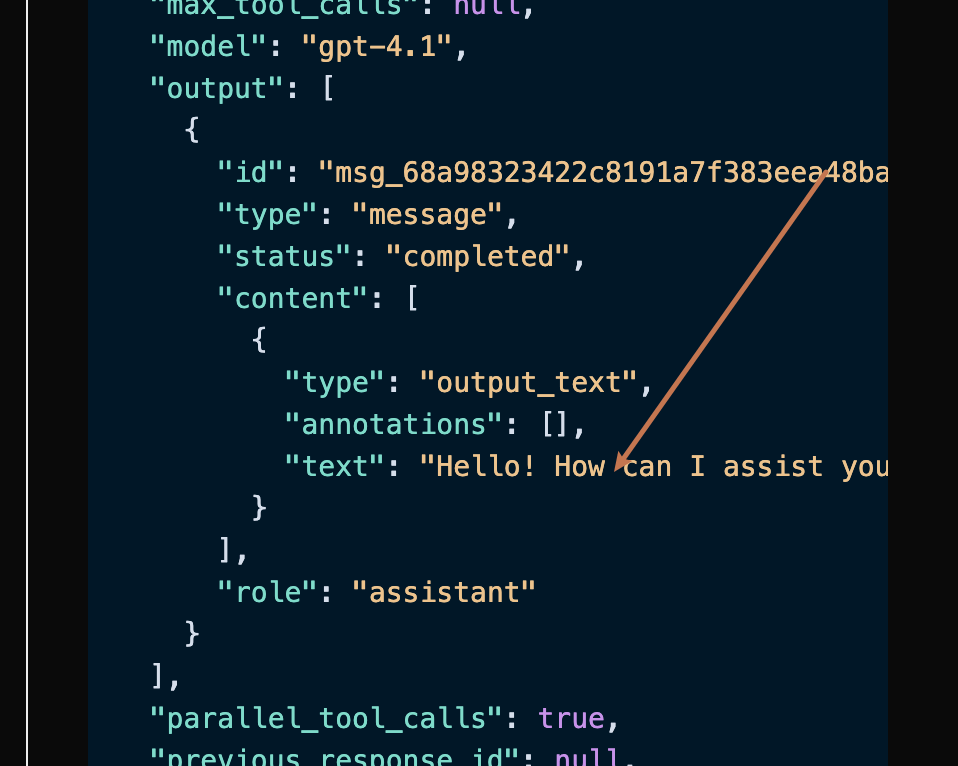
content all’interno di output contiene il contenuto specifico della risposta di ChatGPT.
Risposta in streaming
Questa interfaccia supporta anche le risposte in streaming, che sono molto utili per l’integrazione con le pagine web e consentono alle pagine web di ottenere un effetto di visualizzazione carattere per carattere. Se desideri restituire risposte in streaming, puoi modificare il parametrostream nell’intestazione della richiesta impostandolo su true.
La modifica è mostrata nell’immagine, tuttavia il codice di chiamata deve essere modificato di conseguenza per supportare le risposte in streaming.
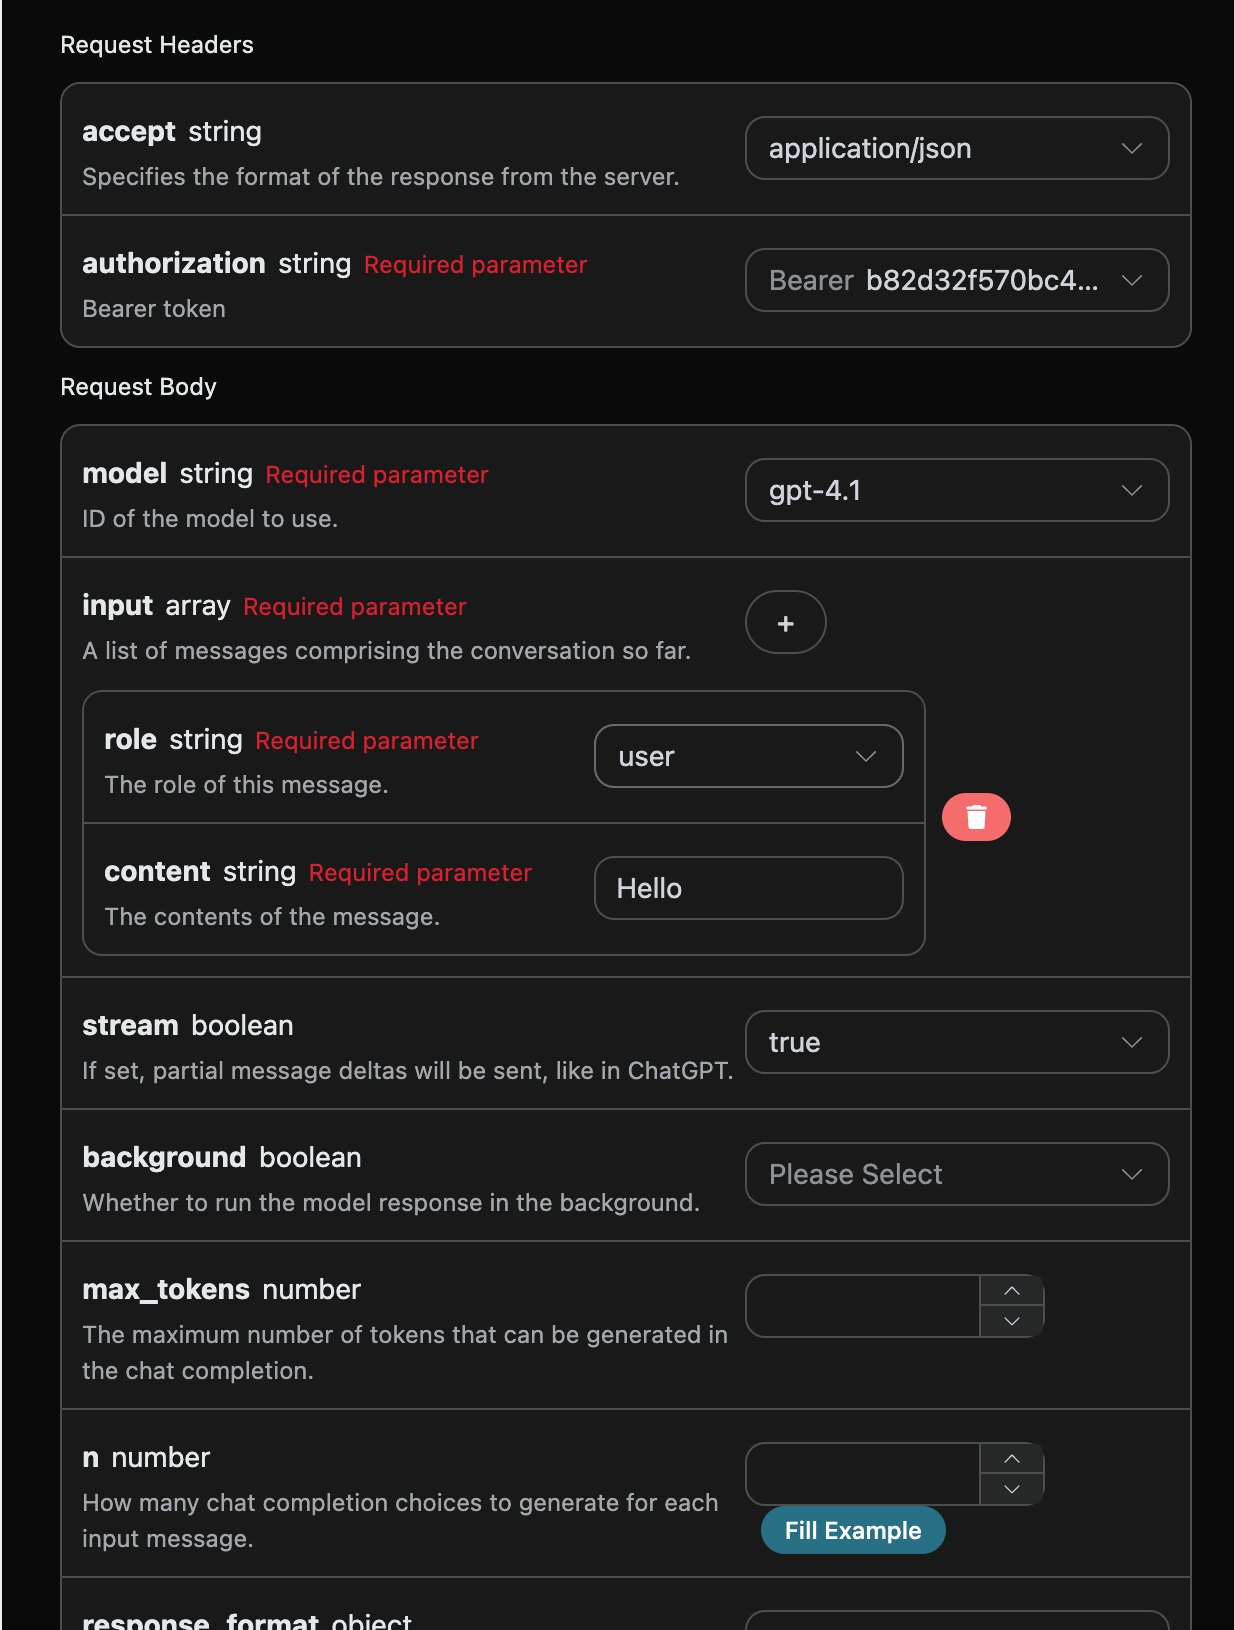
stream in true, l’API restituirà i dati JSON corrispondenti riga per riga; a livello di codice, dobbiamo apportare le modifiche corrispondenti per ottenere risultati riga per riga.
Codice di chiamata di esempio Python:
data, e il delta all’interno di data corrisponde al contenuto della risposta più recente, coerentemente con quanto introdotto sopra. delta è il contenuto della risposta aggiunto di recente, e potete integrarlo nel vostro sistema in base al risultato. La risposta in streaming utilizza response.completed o response.incomplete come stato terminale; l’usage nello stato terminale è l’utilizzo finale di token per questa richiesta ed è anche la base per la fatturazione.
Se il client interrompe la connessione prima dell’arrivo dello stato terminale, questa richiesta verrà registrata come chiusa dal client (499) e non verrà fatturata utilizzando una stima locale dei token; se la connessione termina normalmente ma non viene ricevuto lo stato terminale e l’usage finale, questa richiesta verrà registrata come risposta incompleta (502) e, allo stesso modo, non verrà fatturata utilizzando una stima dei token. In caso di queste due situazioni, avviate nuovamente la richiesta.
Il risultato data restituito contiene diversi campi, descritti di seguito:
item_id, l’ID del compito di conversazione generato questa volta, utilizzato per identificare univocamente questo compito di conversazione.type, il tipo del compito Responses di questa conversazione generato questa volta.model, il modello OpenAI ChatGPT ufficiale selezionato.delta, le informazioni di risposta fornite da ChatGPT alla richiesta.
Conversazione a più turni
Se desiderate integrare la funzionalità di conversazione a più turni, dovete caricare più richieste nel campoinput; un esempio specifico di più richieste è mostrato nella figura seguente:
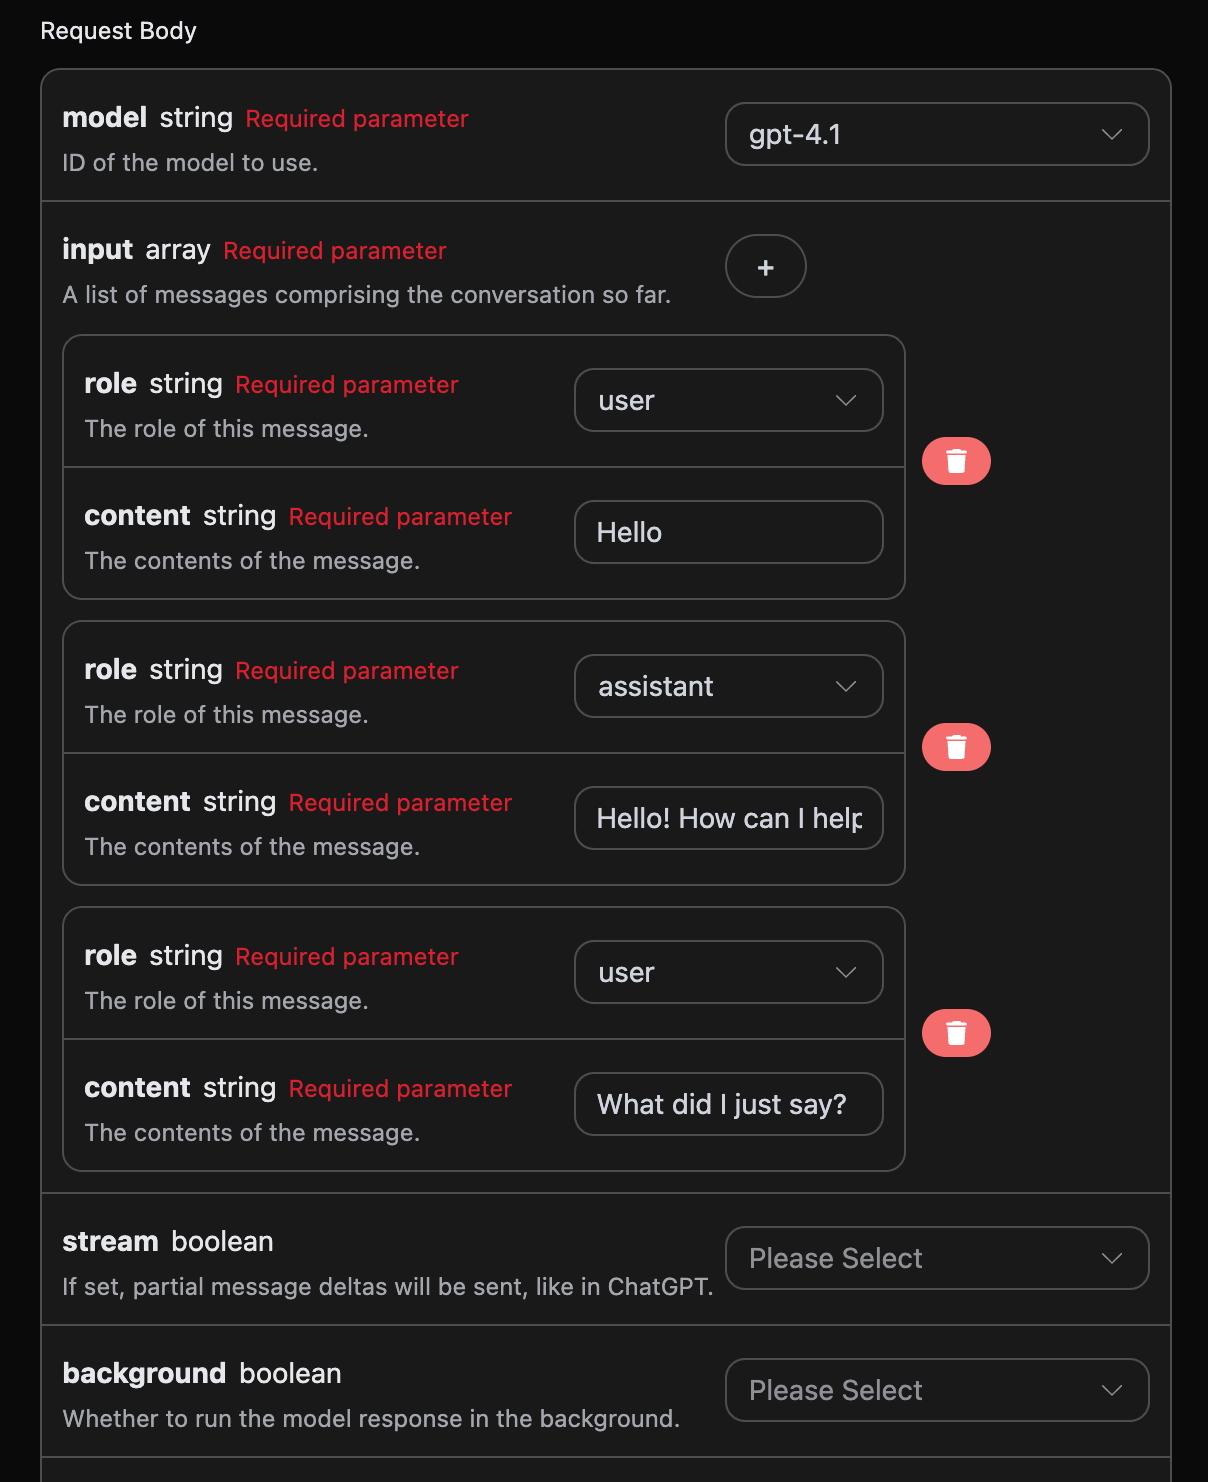
output sono coerenti con il contenuto dell’utilizzo di base; questo contiene il contenuto specifico delle risposte di ChatGPT a più conversazioni, consentendo così di rispondere alle domande corrispondenti in base ai contenuti di più conversazioni.
Modello visivo
gpt-4o è un grande modello linguistico multimodale sviluppato da OpenAI, che aggiunge capacità di comprensione visiva sulla base di GPT-4. Questo modello può elaborare contemporaneamente input di testo e immagini, realizzando la comprensione e la generazione multimodale.-H ‘accept: application/json’
-H ‘authorization: Bearer {token}’
-H ‘content-type: application/json’
-d ’{ “model”: “gpt-4.1”, “input”: [ { “role”: “user”, “content”: [ {“type”: “input_text”, “text”: “what is in this image?”}, { “type”: “input_image”, “image_url”: “https://cdn.acedata.cloud/e724d7f13d.png” } ] } ] }’
Creazione del modello di elaborazione dei file
Esempio di richiesta:Gestione degli errori
Quando si chiama l’API, se si verifica un errore, l’API restituirà il codice e le informazioni di errore corrispondenti. Ad esempio:400 token_mismatched:Richiesta non valida, probabilmente a causa di parametri mancanti o non validi.400 api_not_implemented:Richiesta non valida, probabilmente a causa di parametri mancanti o non validi.401 invalid_token:Non autorizzato, token di autorizzazione non valido o mancante.429 too_many_requests:Troppe richieste, hai superato il limite di frequenza.500 api_error:Errore interno del server, qualcosa è andato storto sul server.