

Processus de demande
Pour utiliser l’API Claude Chat Completion, commencez par obtenir votre API Token dans la console Ace Data Cloud, et conservez-le pour une utilisation ultérieure. Si vous n’êtes pas encore connecté ou inscrit, vous serez automatiquement redirigé vers la page de connexion afin de vous inviter à vous inscrire et à vous connecter ; une fois terminé, vous reviendrez automatiquement sur la page actuelle.
Un seul API Token permet d’appeler tous les services de la plateforme, sans avoir besoin d’en demander un séparément pour chaque service. Lors de la première demande, un quota gratuit est offert pour une expérience gratuite ; lorsque le quota est insuffisant, vous pouvez recharger le solde général dans la console.
📘 Documentation complète : Claude Chat Completion API →
Utilisation de base
Ensuite, vous pouvez renseigner le contenu correspondant dans l’interface, comme illustré ci-dessous :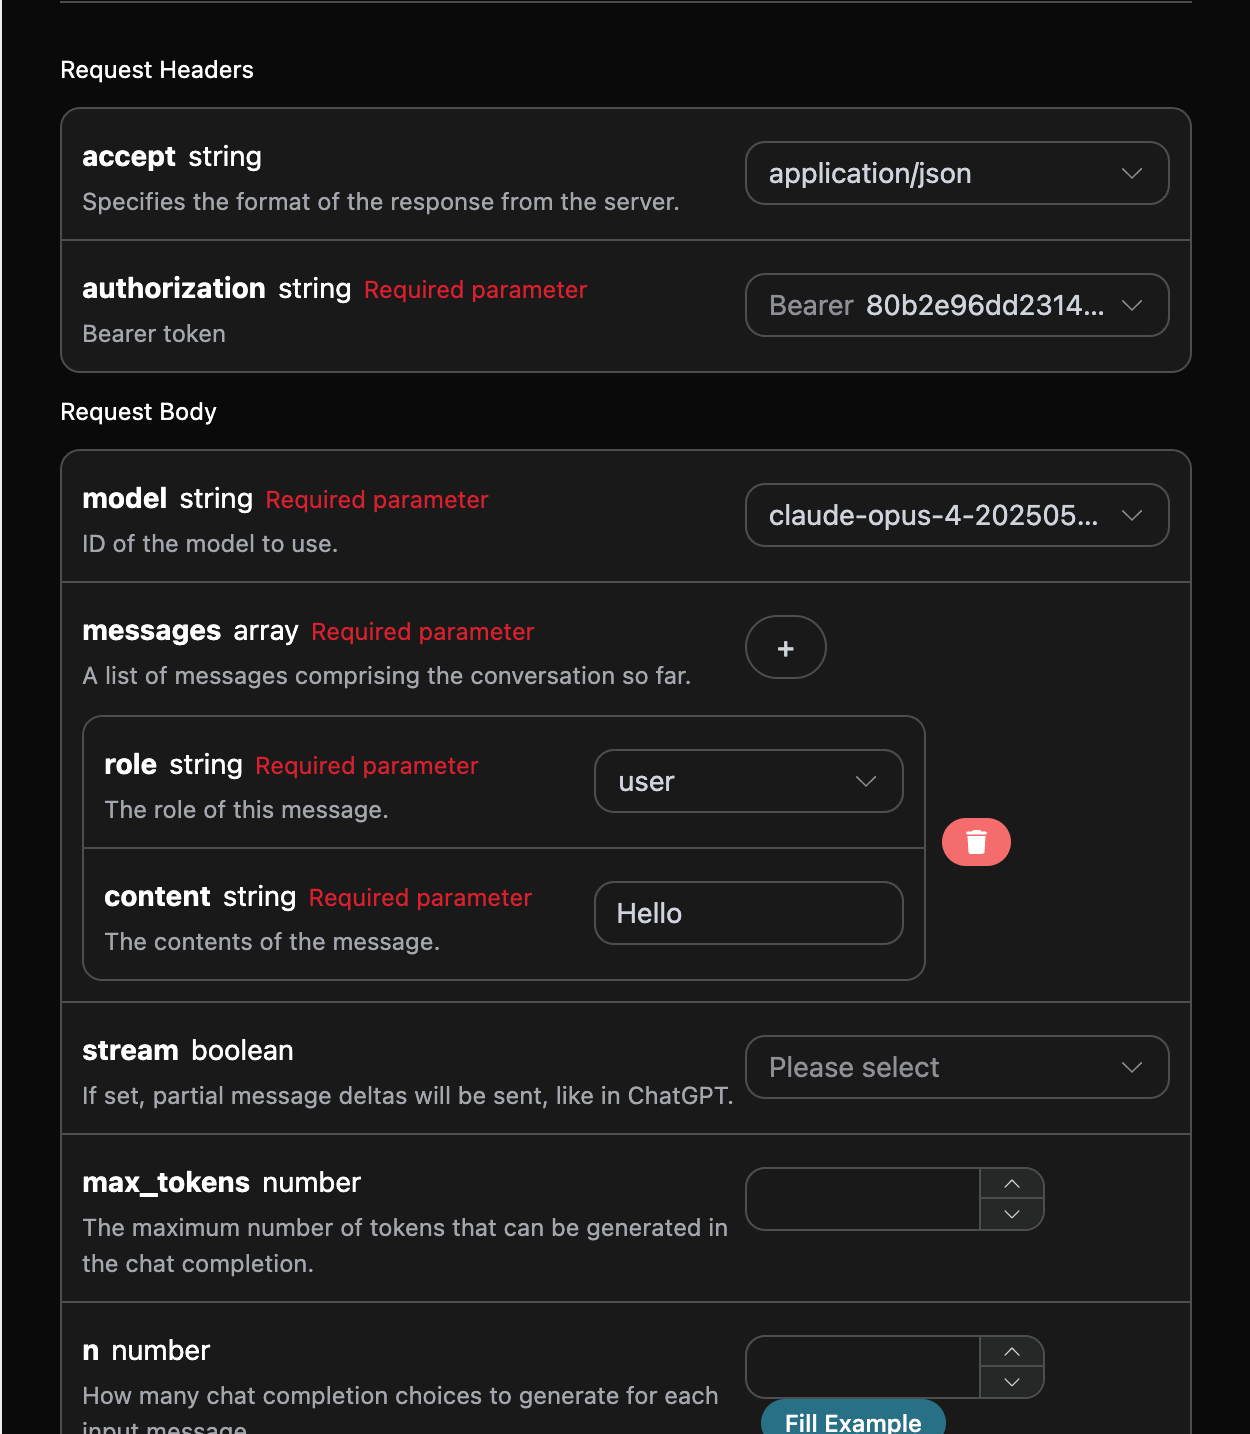
authorization, qu’il suffit de sélectionner directement dans la liste déroulante. Un autre paramètre est model, pour lequel il est recommandé d’utiliser le dernier modèle phare claude-fable-5-1 ; l’ancien claude-fable-5 peut toujours continuer à être appelé. Le dernier paramètre est messages, qui est un tableau d’invites ; chaque élément contient role et content ; role prend en charge user, assistant, system, et content est le contenu spécifique. Claude Fable 5.1 prend en charge un contexte de 1 million de Token et une sortie maximale de 128K Token.
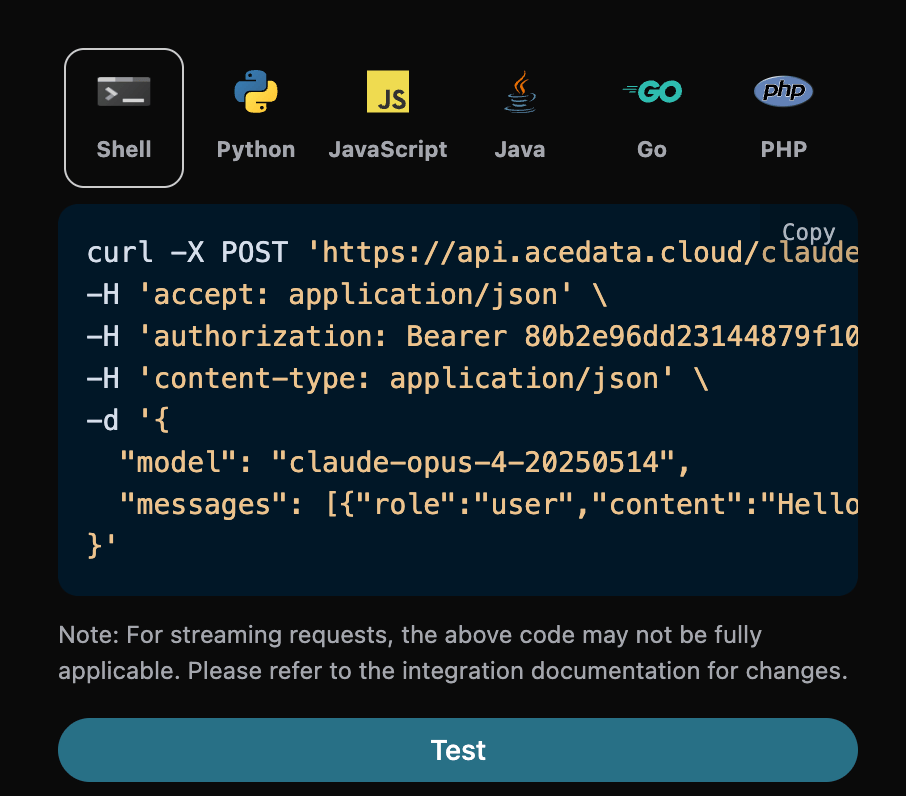
En même temps, vous pouvez remarquer à droite la génération du code d’appel correspondant ; vous pouvez copier le code et l’exécuter directement, ou cliquer directement sur le bouton « Try » pour effectuer un test.
Paramètres optionnels courants :
max_tokens: limite le nombre maximal de token pour une seule réponse.temperature: caractère aléatoire de la génération, entre 0 et 2 ; plus la valeur est élevée, plus le résultat est divergent.n: nombre de réponses candidates générées à la fois.response_format: paramètre du format de retour.
id, l’ID généré pour cette tâche de dialogue, utilisé pour identifier de manière unique cette tâche de dialogue.model, le modèle Claude officiel sélectionné.choices, les informations de réponse fournies par Claude pour l’invite.usage: les informations statistiques sur les token pour cette session de questions-réponses.
usage.prompt_tokens est le volume total d’entrée ; prompt_tokens_details.cached_tokens et prompt_tokens_details.cache_write_tokens enregistrent respectivement les détails de lecture et d’écriture du cache. completion_tokens_details.reasoning_tokens est un sous-ensemble de completion_tokens ; ne les additionnez pas à nouveau lors du calcul du total ou des frais. Les réponses non streamées peuvent également renvoyer un objet usage.cost, dans lequel amount est la consommation réelle de quota, currency est l’unité de mesure, et list_amount est le montant avant remise (le cas échéant).
Le nom de champ compatible avec Chat est reasoning_tokens ; l’API Messages native utilise output_tokens_details.thinking_tokens. Le wire schema des deux protocoles est différent, les clients ne doivent pas mélanger les noms de champs.
Parmi eux, choices contient les informations de réponse de Claude, et les choices qu’il contient sont les informations spécifiques de la réponse de Claude, comme le montre l’illustration.
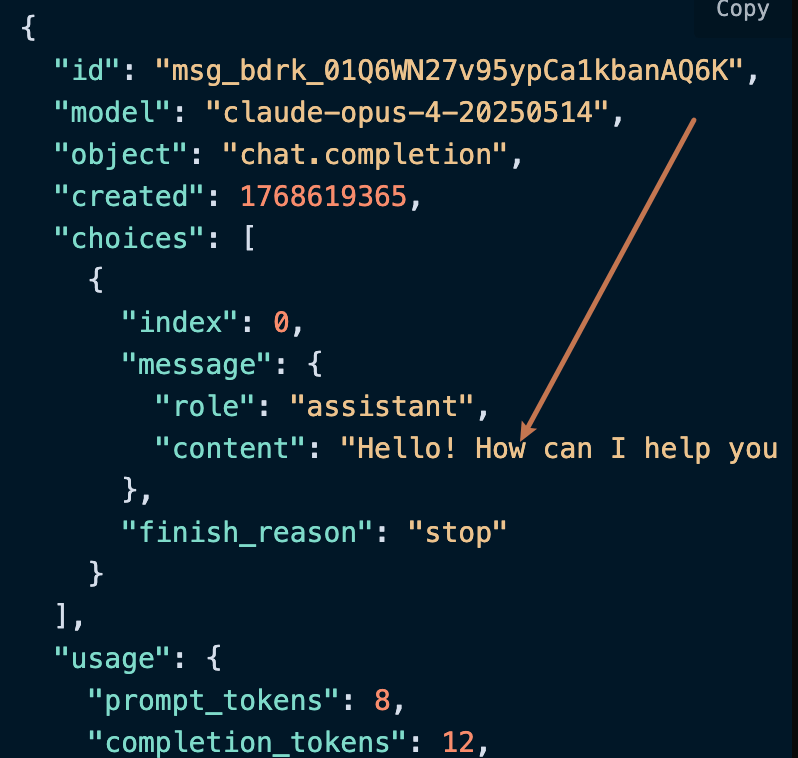
content dans choices contient le contenu spécifique de la réponse de Claude.
Réponse en streaming
Cette interface prend également en charge les réponses en streaming, ce qui est très utile pour l’intégration web et permet à la page web de réaliser un effet d’affichage mot par mot. Si vous souhaitez renvoyer une réponse en streaming, vous pouvez modifier le paramètrestream dans l’en-tête de requête, en le définissant sur true.
La modification est illustrée ci-dessous, mais le code d’appel doit être modifié en conséquence pour prendre en charge les réponses en streaming.
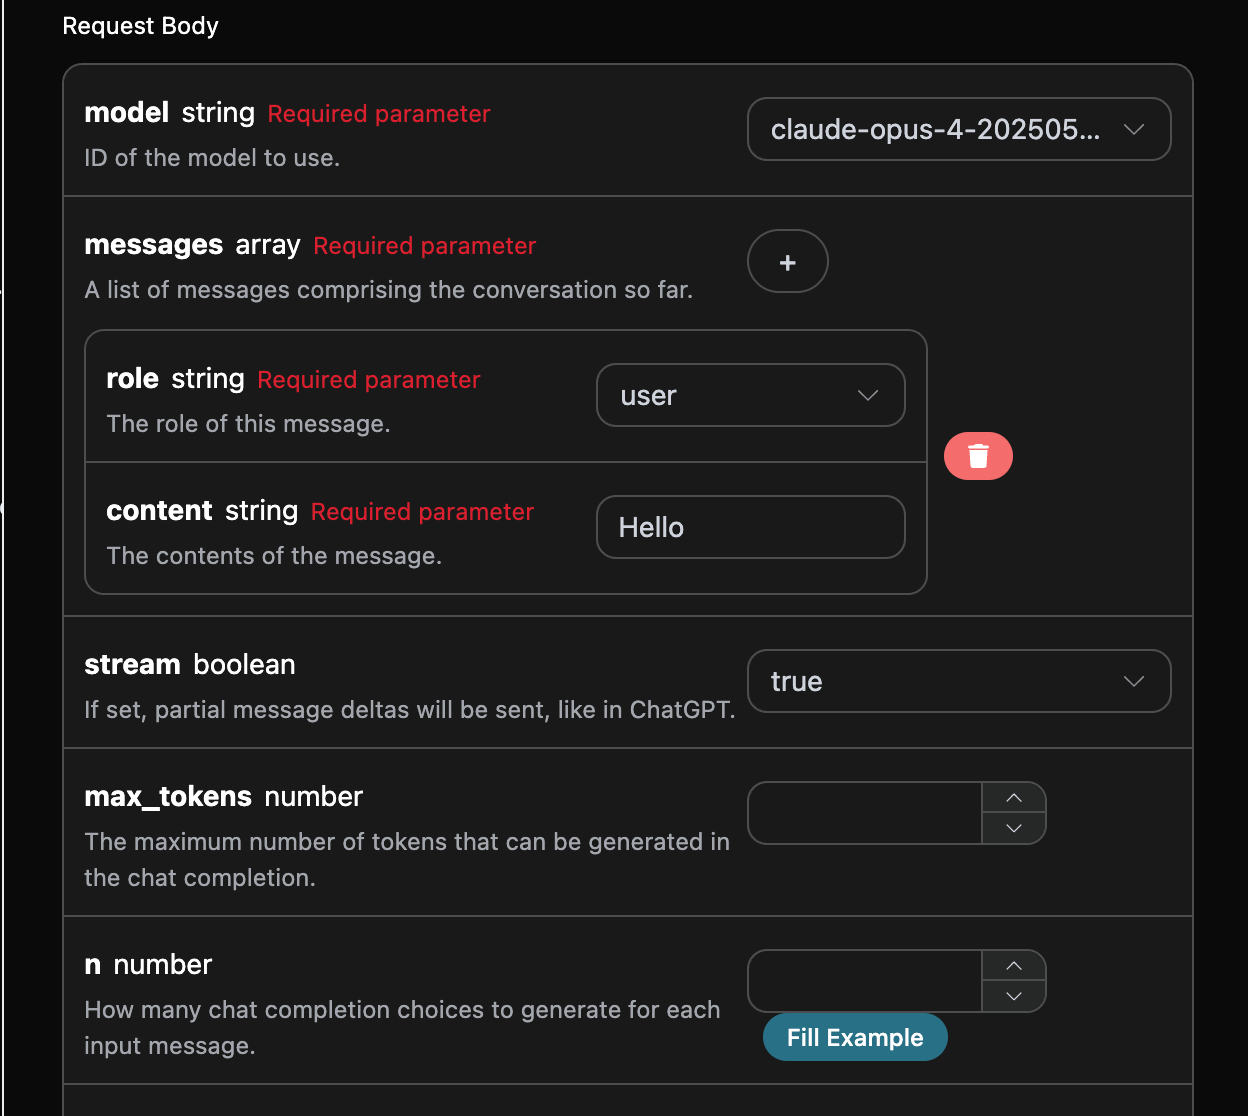
stream en true, l’API renverra les données JSON correspondantes ligne par ligne ; au niveau du code, nous devons effectuer les modifications correspondantes afin d’obtenir les résultats ligne par ligne.
Exemple de code d’appel Python :
data dans la réponse, et que les choices dans les data correspondent au contenu de réponse le plus récent, ce qui est cohérent avec le contenu présenté ci-dessus. Les choices correspondent au nouveau contenu de réponse, vous pouvez les intégrer à votre système en fonction du résultat. En même temps, la fin de la réponse en streaming est déterminée en fonction du contenu de data ; si le contenu est [DONE], cela indique que la réponse en streaming est entièrement terminée. Le résultat data retourné comporte plusieurs champs, présentés ci-dessous :
id, l’ID généré pour cette tâche de conversation, utilisé pour identifier de manière unique cette tâche de conversation.model, le modèle Claude sélectionné sur le site officiel.choices, les informations de réponse fournies par Claude à la requête.
Conversation multi-tours
Si vous souhaitez intégrer une fonctionnalité de conversation multi-tours, vous devez envoyer plusieurs requêtes dans le champmessages. Un exemple concret de plusieurs requêtes est présenté dans l’image ci-dessous :
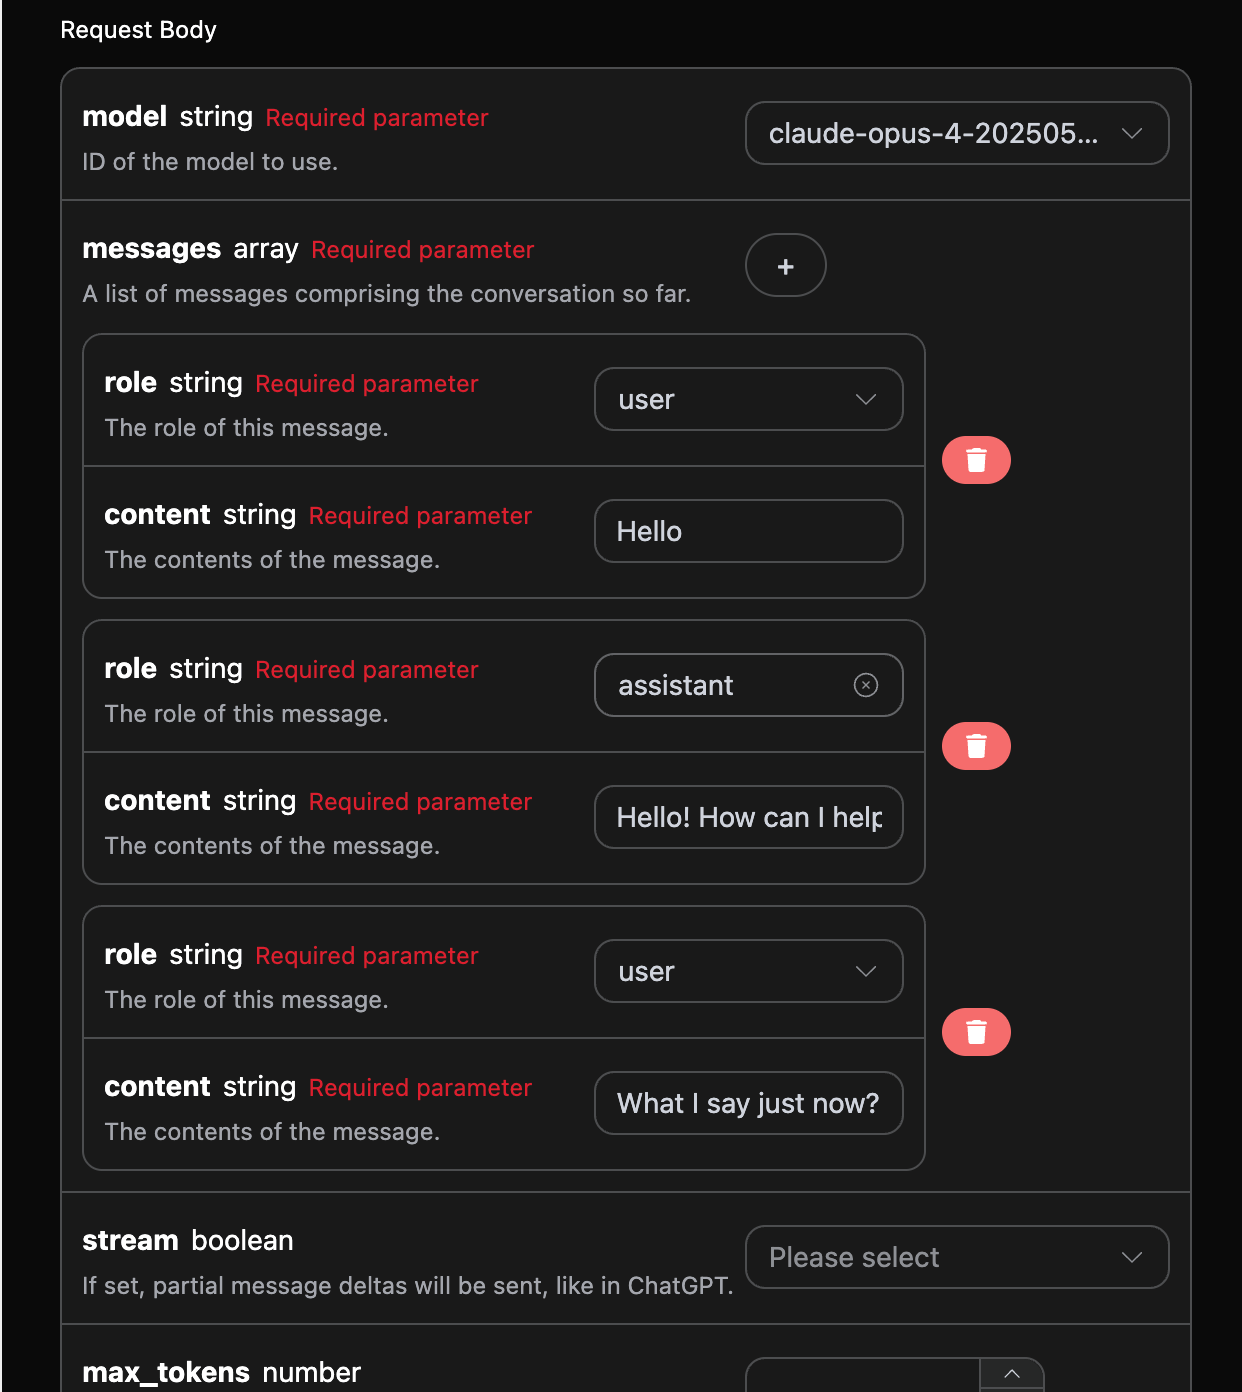
choices sont cohérentes avec le contenu de l’utilisation de base. Cela contient le contenu spécifique de la réponse de Claude à plusieurs conversations, ce qui permet de répondre aux questions correspondantes en fonction de plusieurs contenus de conversation.
Réflexion approfondie
Les modèles Claude de nouvelle génération peuvent effectuer un raisonnement selon la stratégie par défaut du modèle, sans nécessiter d’être déclenchés via le suffixe de modèle-thinking. Les réponses compatibles avec Chat utilisent le champ usage compatible OpenAI completion_tokens_details.reasoning_tokens. Les reasoning_tokens sont déjà inclus dans les completion_tokens, ne les additionnez pas une seconde fois. Le raisonnement et le corps visible partagent la limite supérieure des tokens de sortie, donc lorsque max_tokens est faible, le corps peut être vide ou tronqué ; dans ce cas, veuillez augmenter le budget de sortie, ou sélectionner un effort de raisonnement plus faible lorsque le modèle utilisé le prend en charge.
Si vous avez besoin de thinking natif, de output_config.effort, de blocs de contenu thinking et du renvoi de signature, veuillez utiliser /v1/messages. Le champ usage correspondant à Messages est output_tokens_details.thinking_tokens, ne le mélangez pas avec le completion_tokens_details.reasoning_tokens de Chat-compatible.
Modèles visuels
claude-sonnet-4-20250514 est un grand modèle de langage multimodal développé par Claude, il ajoute des capacités de compréhension visuelle sur la base de claude-4. Ce modèle peut traiter simultanément des entrées textuelles et des images, réalisant une compréhension et une génération multimodales. Le traitement de texte utilisant le modèle claude-sonnet-4-20250514 est cohérent avec le contenu d’utilisation de base ci-dessus, nous allons brièvement présenter ci-dessous comment utiliser les capacités de traitement d’images du modèle. L’utilisation des capacités de traitement d’images du modèle claude-sonnet-4-20250514 consiste principalement à ajouter un champtype sur la base du contenu content d’origine, ce champ permet de savoir si le contenu envoyé est du texte ou une image, afin d’utiliser les capacités de traitement d’images du modèle claude-sonnet-4-20250514, nous décrivons principalement ci-dessous deux méthodes d’appel de cette fonctionnalité : Curl et Python.
- Méthode par script Curl
- Méthode par script Python
Gestion des erreurs
Lors de l’appel de l’API, si vous rencontrez une erreur, l’API renverra le code d’erreur et les informations correspondants. Par exemple :400 token_mismatched: Mauvaise requête, probablement en raison de paramètres manquants ou non valides.400 api_not_implemented: Mauvaise requête, probablement en raison de paramètres manquants ou non valides.401 invalid_token: Non autorisé, jeton d’autorisation non valide ou manquant.429 too_many_requests: Trop de requêtes, vous avez dépassé la limite de débit.500 api_error: Erreur interne du serveur, quelque chose s’est mal passé sur le serveur.