

ОбмеженняSuno тепер підтримуєlyricіstyleу таблиці вище є верхніми межами в користувацькому режимі (customдорівнюєtrue). У некористувацькому режимі натхнення (customдорівнюєfalse) заповнюється лишеprompt, а його максимальна довжина становить 500 символів (однаково для всіх моделей).
chirp-v6, chirp-v6-wild і chirp-v6-mini. Рекомендовано використовувати chirp-v6; назви старих моделей і надалі сумісні.
Проте офіційно Suno не надає API, AceDataCloud надає набір API Suno, що імітує інтеграцію з офіційним Suno та дає змогу зручно й швидко генерувати потрібну музику.
Подання заявки та використання
Щоб використовувати Suno Audios Generation API, спочатку перейдіть до консолі Ace Data Cloud, щоб отримати свій API Token і зберегти його для подальшого використання. Якщо ви ще не увійшли або не зареєструвалися, вас буде автоматично перенаправлено на сторінку входу, де вам буде запропоновано зареєструватися та увійти, після завершення вас буде автоматично повернуто на поточну сторінку.
Один API Token дає змогу викликати всі сервіси платформи, не потрібно подавати заявку окремо для кожного сервісу. Під час першого подання заявки буде надано безкоштовний ліміт, який можна використати для безкоштовного ознайомлення; коли ліміту недостатньо, можна поповнити універсальний баланс у консолі.
📘 Повна документація: Suno Audios Generation API →
Базове використання
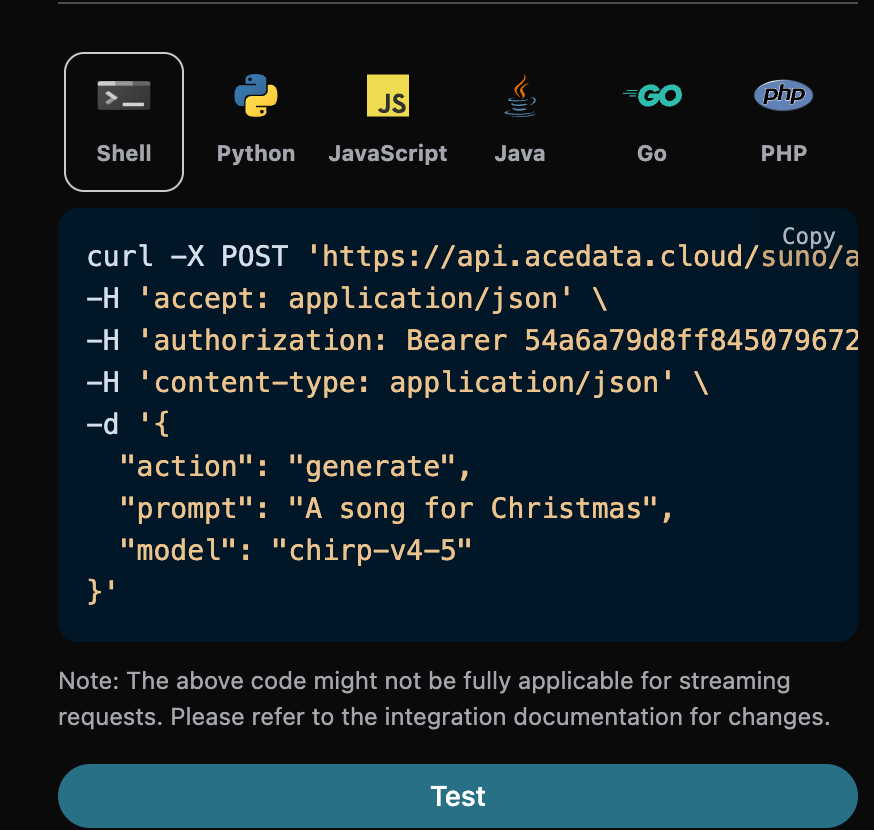
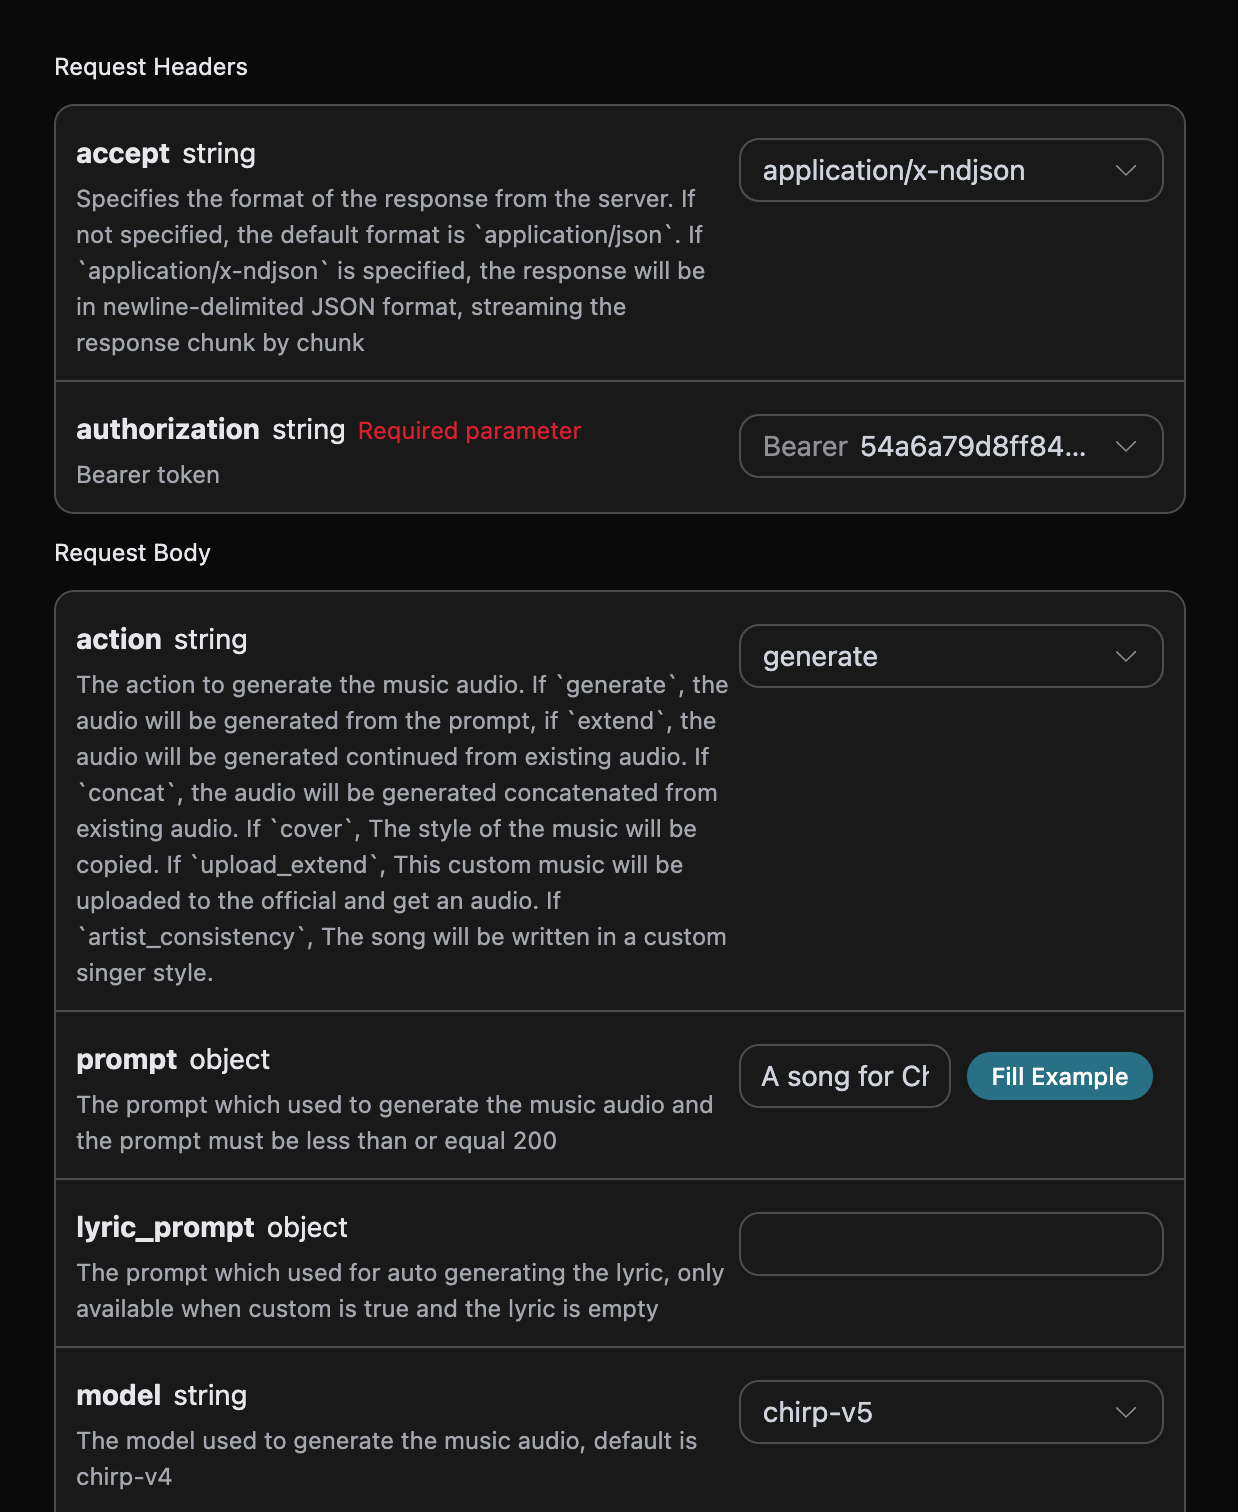
Які пісні ви хочете, можете довільно ввести текст, наприклад, якщо я хочу згенерувати пісню про Різдво, можна ввестиa song for Christmas, як показано на зображенні:
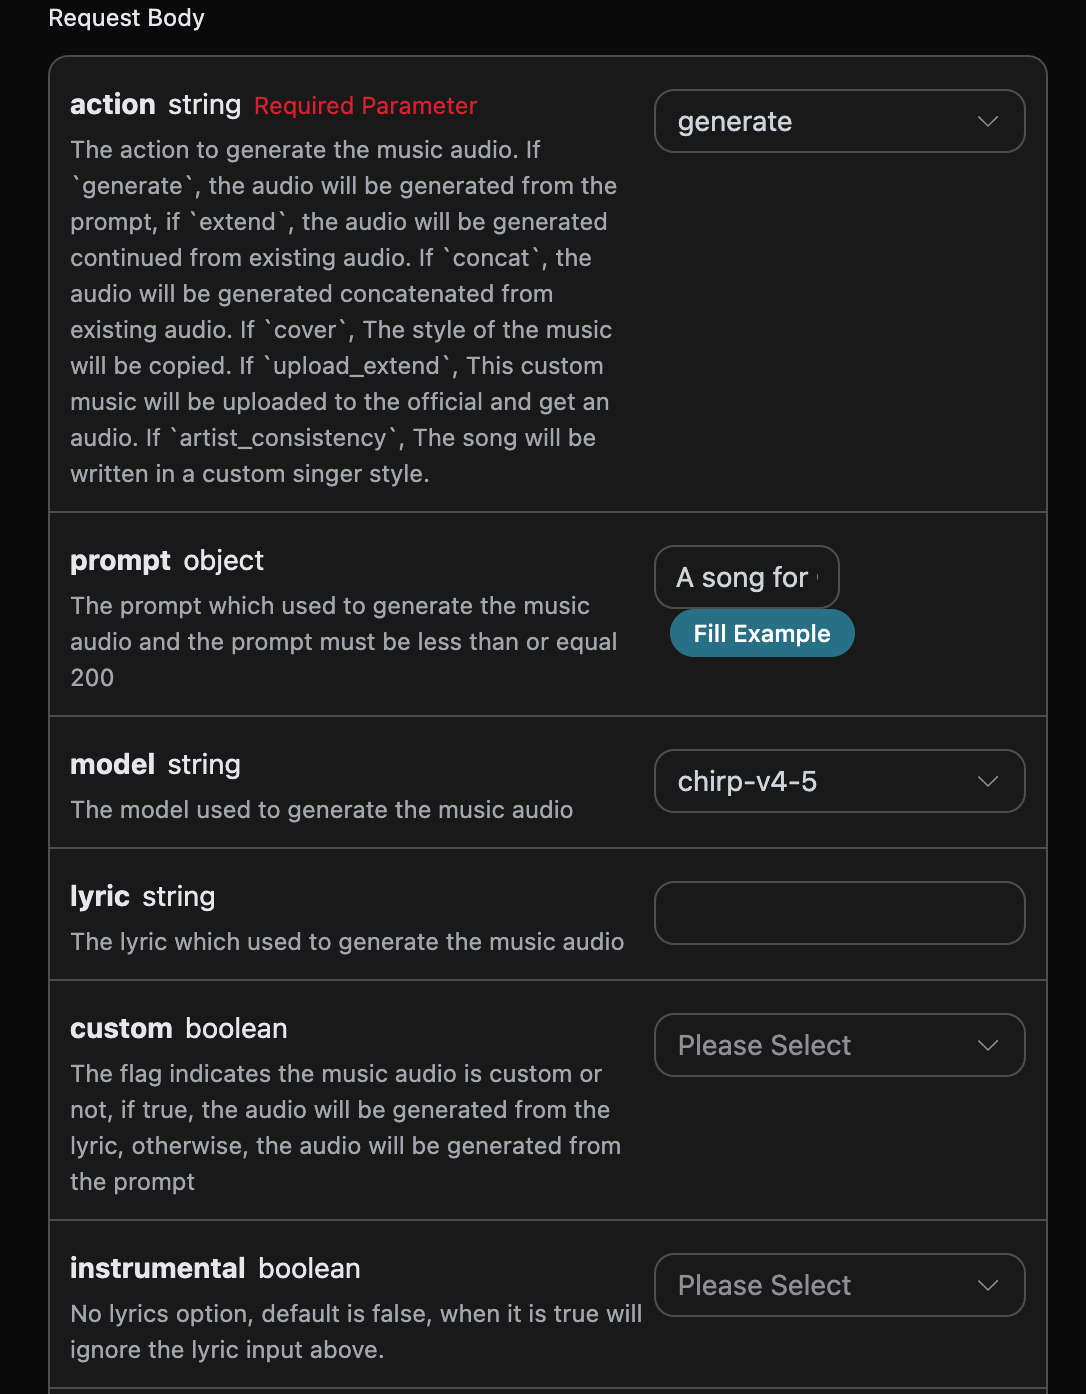
accept: у якому форматі ви хочете отримати результат відповіді, тут зазначеноapplication/json, тобто формат JSON.authorization: ключ для виклику API, після подання заявки його можна безпосередньо вибрати зі спадного списку.
action: тип аудіозавдання, за замовчуванням —generate. Підтримує такі операції, як генерація, продовження, кавер, з’єднання, поділ на доріжки, додавання аудіодоріжки, вилучення вказаної аудіодоріжки, генерація звукових ефектів і налаштування швидкості тощо; усі вони викликаються черезPOST /suno/audios.prompt: підказка для режиму натхнення Suno (діє, колиcustomмає значенняfalse), максимум 500 символів.model: модель для цього завдання генерації музики. Серія v6 міститьchirp-v6,chirp-v6-wildіchirp-v6-mini; старі назви моделей залишаються сумісними.max_mode: режим посиленої генерації. Дляgenerateувімкнений лише тоді, коли іcustom, іmax_modeмають значенняtrue, вартість — 1.12 Credits; дляadd_stemможе бути увімкнений безпосередньо, вартість — 1.344 Credits. У разі вимкнення або пропуску вартість становить відповідно 0.56 і 0.672 Credits.variety: інтенсивність різноманітності результатів генерації, доступні значення:off,normal,high,extra,max. Використовується лише дляgenerateіadd_stem, передавання для інших action поверне 400.lyric: текст пісні для користувацького режиму Suno. Дляchirp-v3-5іchirp-v4— максимум 3000 символів; дляchirp-v4-5і вище (включно зchirp-v5,chirp-v5-5) — максимум 5000 символів.custom: чи використовувати користувацький режим, за замовчуванням:false.instrumental: опція інструментальної музики для режиму натхнення Suno.title: назва музики для користувацького режиму Suno. Дляchirp-v3-5,chirp-v4— максимум 80 символів; дляchirp-v4-5і вище — максимум 100 символів.style: музичний стиль для користувацького режиму Suno. Дляchirp-v3-5іchirp-v4— максимум 200 символів; дляchirp-v4-5і вище (включно зchirp-v5,chirp-v5-5) — максимум 1000 символів.negative_tags: музичні стилі або жанри, які потрібно виключити з результатів генерації в користувацькому режимі (колиcustomмає значенняtrue).audio_weight: вага впливу аудіо або голосових характеристик, діапазон 0-1;0також є допустимим значенням. Може використовуватися для таких операцій, як генерація, продовження, кавер, додавання аудіодоріжки та узгодженість голосу; за відсутності еталонного аудіо або голосових характеристик модель може послабити або проігнорувати це значення.audio_id: ID еталонної музики.overpainting_start/overpainting_end: час початку й завершення додавання вокалу до наявної інструментальної музики, в секундах.underpainting_start/underpainting_end: час початку й завершення додавання акомпанементу до акапельного виконання, в секундах.persona_id: ID пісні виконавця.continue_at: межа продовження, у секундах. Наприклад, 213.5 означає почати генерацію наступного фрагмента з позначки 3 хвилини 33.5 секунди.lyricіstyleспрямовують лише новий вміст після межі й не замінюють текст або вокал до межі у вихідному аудіо.style_influence: вплив стилю в користувацькому режимі, діапазон 0-1; що більше значення, то зазвичай точніше відповідність вибраному стилю;0передається як допустиме значення.replace_section_end: кінцевий час фрагмента для заміни.replace_section_start: початковий час фрагмента для заміни.vocal_gender: керує перевагою жіночого або чоловічого голосу: жіночий голос —f, чоловічий —m; діє для моделей 4.5 і вище; це параметр переваги, суворе дотримання не гарантується.weirdness: рівень дивності в користувацькому режимі, діапазон 0-1; що більше значення, то зазвичай більше креативності та експериментальності;0передається як допустиме значення.duration: очікувана тривалість пісні, у секундах, має бути цілим числом у діапазоні від 10 до 360. Цей параметр використовується для генерації пісень у користувацькому режимі (колиcustomмає значенняtrue). Це орієнтовна підказка, а не жорстке обмеження: модель враховуватиме її, але не гарантує досягнення, фактична тривалість готового результату визначається полемdurationу відповіді та зазвичай є коротшою за очікуване значення.
Область застосування розширених параметрів
Платформа перевіряє типи параметрів і діапазони значень, але не відхиляє ці необов’язкові параметри налаштування лише через відмінність action; конкретний ефект визначається операцією, режимом і моделлю.
lyric_prompt: prompt для генерації тексту пісні, діє тоді й лише тоді, колиcustomмає значенняtrueіlyricне передано.callback_url: URL, на який потрібно надіслати результат зворотним викликом.async: необов’язково; якщо встановитиtrue, інтерфейс негайно повертаєtask_id, без потреби надаватиcallback_url, після чого результат отримується шляхом опитування через відповідний інтерфейс запиту завдань.
- success:чи було створення успішним, якщо успішним —
true, інакше —false - data:це список, який містить детальну інформацію про створені пісні.
- state: статус створення пісні, переважно містить чотири типи, конкретно такі:
- succeeded:створення успішне
- pending:у черзі
- running:виконується
- error:помилка
- id:ID пісні
- title:назва пісні
- image_url:зображення обкладинки пісні
- lyric:текст пісні
- audio_url:кінцева адреса аудіо пісні. Платформа пріоритетно повертає адресу Ace Data Cloud CDN; якщо збереження не вдасться, може бути повернуто оригінальну адресу медіа, будь ласка, своєчасно завантажте.
- video_url:відеофайл пісні, після відкриття є mp4-відео.
- created_at:час створення
- model:використовувана модель, зазвичай це найновіша модель v3
- style:стиль
- state: статус створення пісні, переважно містить чотири типи, конкретно такі:
Користувацьке створення
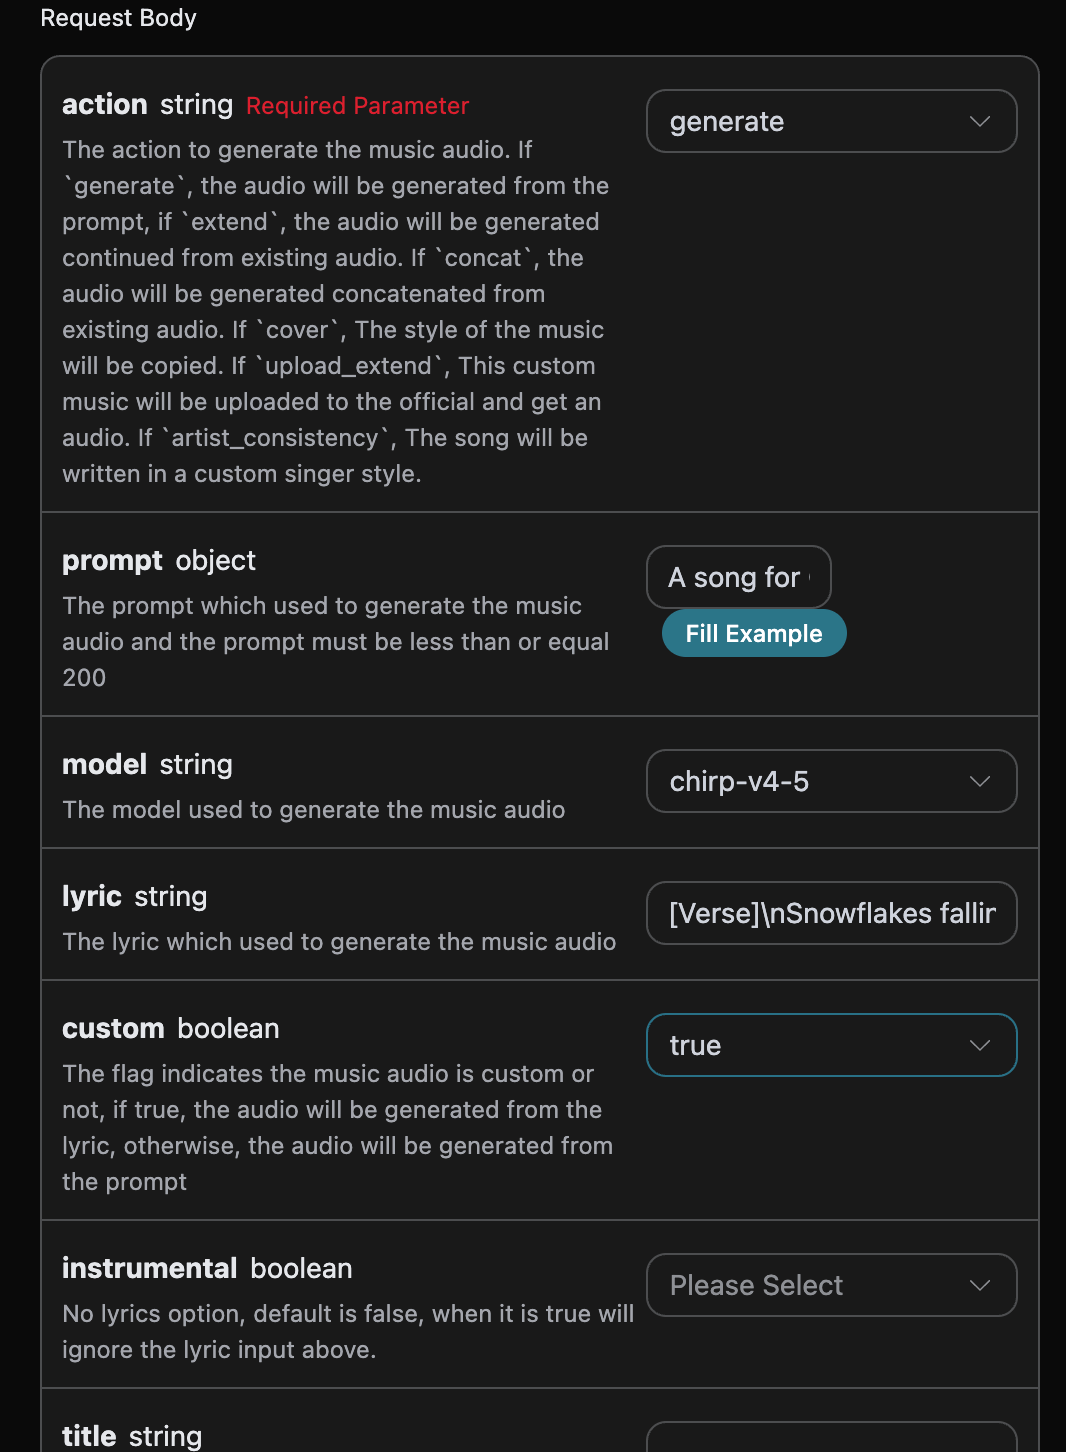
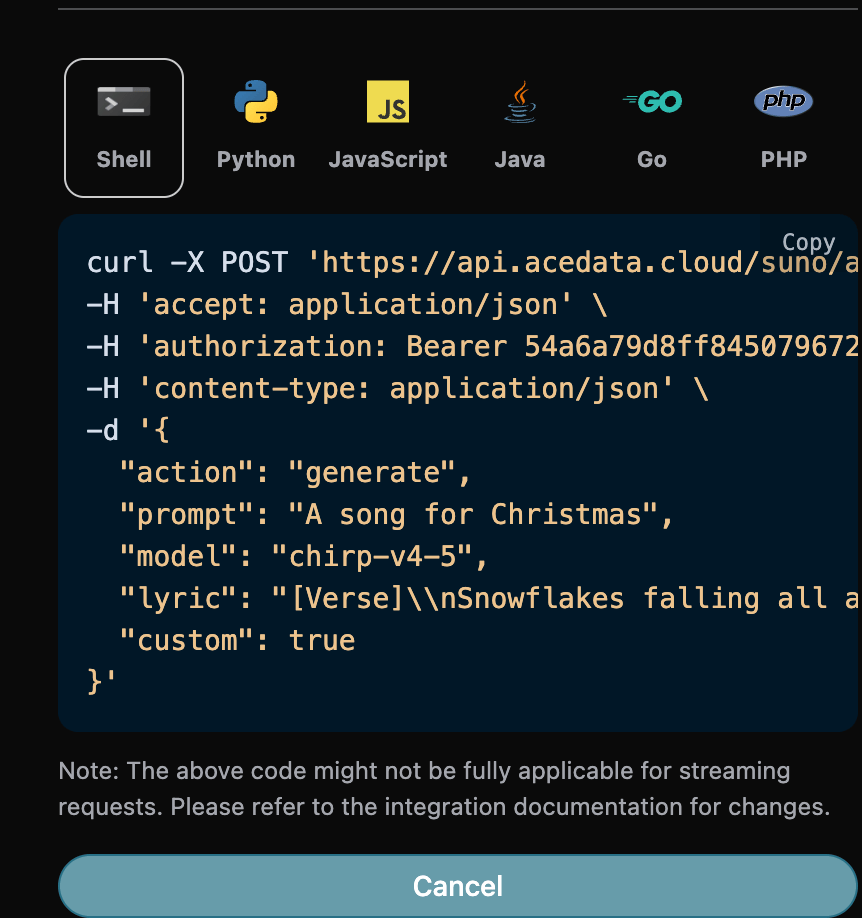
Якщо ви хочете користувацьки створити текст пісні, можна ввести текст: У цей момент у полеlyric можна передати приблизно такий вміст:
Зверніть увагу, що \n у тексті пісні тут є символом нового рядка. Якщо ви не знаєте, як створити текст пісні, можете скористатися API генерації текстів пісень, наданим AceDataCloud, щоб створити текст за допомогою prompt; API: Suno Lyrics Generation API.
Далі, щоб користувацьки створити пісню на основі тексту, назви та стилю, можна вказати такий вміст:
- lyric:текст пісні
- custom:вказати
true, що означає користувацьке створення; параметр за замовчуванням має значення false, що означає створення за допомогоюprompt. - title:назва пісні.
- style:стиль пісні, необов’язково.
Функція користувацького створення стилю співака
Якщо ви хочете використовувати стиль співака для генерації пісні, спочатку згенеруйте пісню за допомогою базового використання вище, і зрештою потрібно встановити цю пісню як стиль співака, потім потрібно перейти до Suno Persona API, щоб на основі офіційно згенерованого музичного IDaudio_id створити параметр ID стилю співака persona_id, конкретні параметри показані на зображенні нижче:
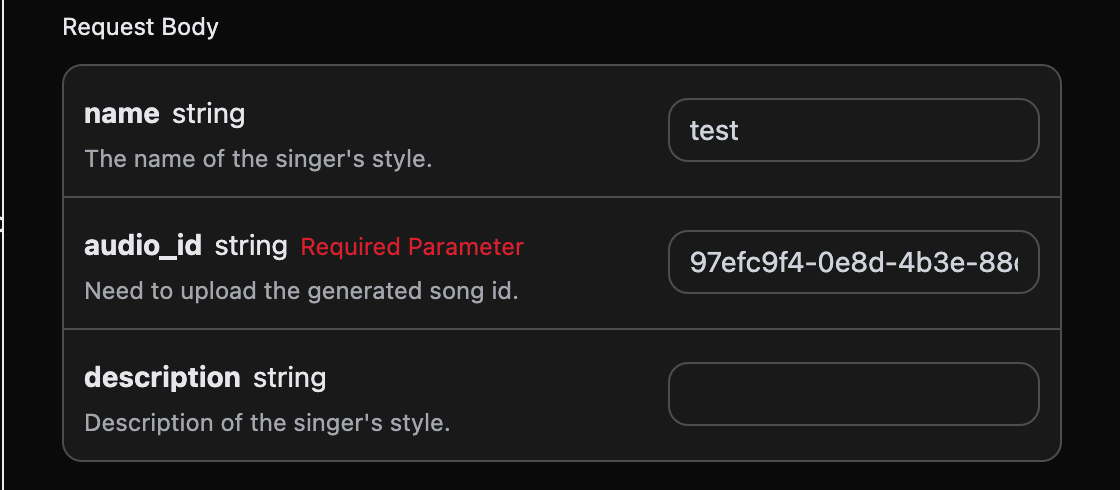
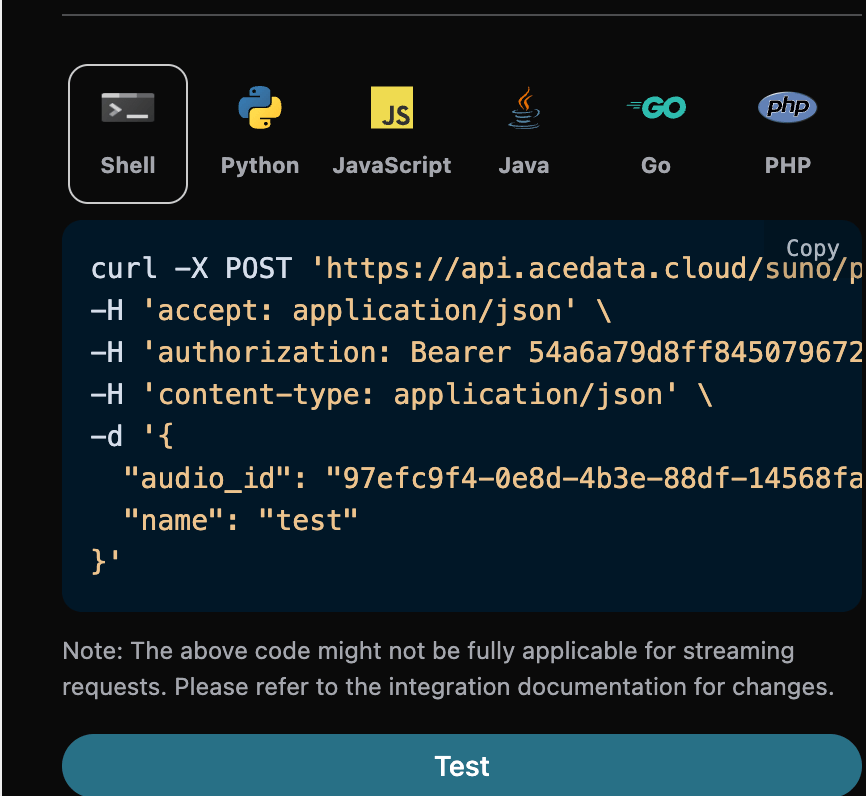
audio_id і persona_id, а саме 97efc9f4-0e8d-4b3e-88df-14568fa1b11f і e0d7319e-aa2a-44cb-b00a-916218d7cb0b, як приклад даних цього разу. Потім можна встановити параметр action як artist_consistency (якщо це нова версія стилю співака Persona-v2-vox, action потрібно встановити як artist_consistency_vox), а також ввести ID пісні, яку потрібно продовжити генерувати, і ID стилю співака, приклад заповнення наведено нижче:
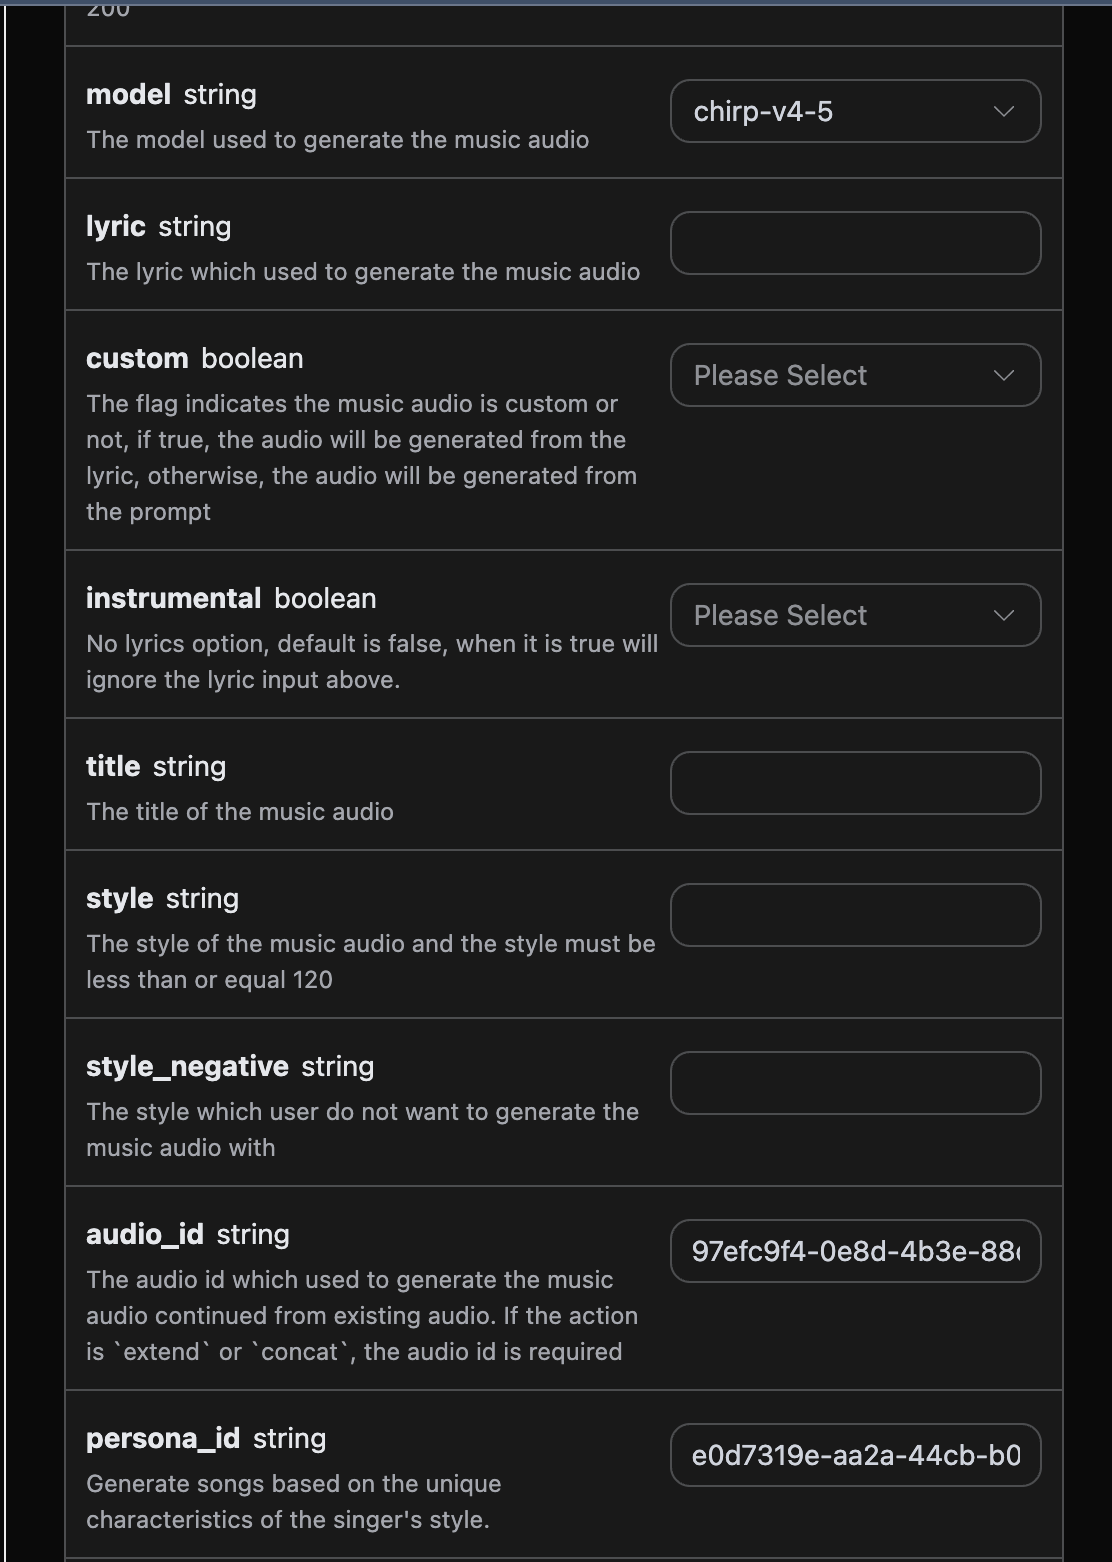
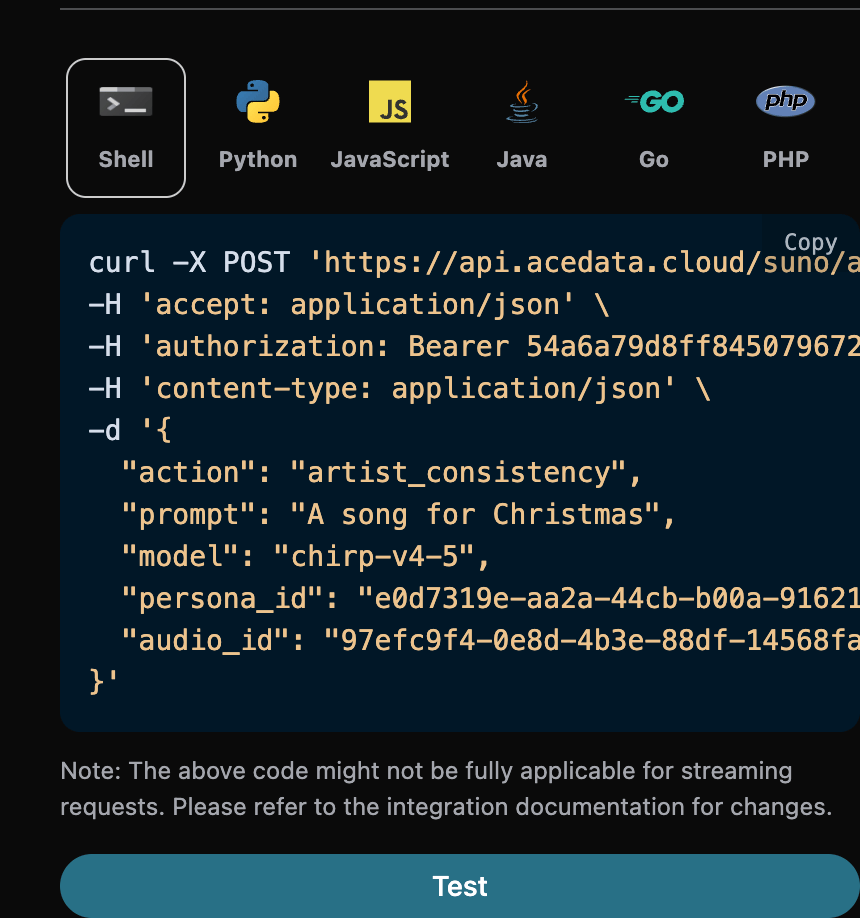
Функція продовження генерації
Якщо ви хочете продовжити генерацію вже згенерованої пісні Suno, можна встановити параметрaction як extend і ввести ID пісні, яку потрібно продовжити генерувати; ID пісні отримується відповідно до базового використання, з наведеного вище можна дізнатися, що в цей момент ID пісні має вигляд:
Зверніть увагу, тут id у тексті пісні є ID згенерованої пісні; якщо ви не знаєте, як генерувати пісню, можете звернутися до базового використання вище для генерації пісні.
Якщо ви хочете продовжити генерацію для пісні, завантаженої вами власноруч, можна встановити параметр action як upload_extend і ввести ID власноруч завантаженої пісні, яку потрібно продовжити генерувати; ID пісні отримується за допомогою Suno Upload Generation API, як показано на зображенні нижче:
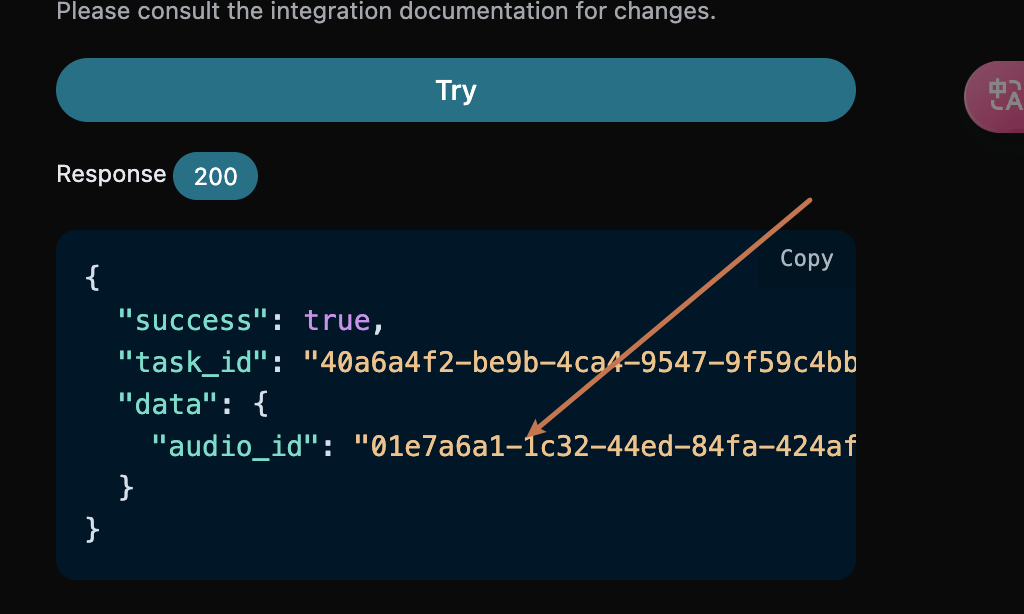
- lyric: використовується лише для спрямування тексту пісні новозгенерованого фрагмента після
continue_at, не замінює текст пісні в оригінальному аудіо до цієї часової точки. - custom: заповнення значенням
trueозначає користувацьку генерацію, за замовчуванням цей параметр має значення false, що означає генерацію з використаннямprompt. - style: стиль пісні фрагмента продовження, необов’язковий.
- continue_at: межа продовження, одиниця вимірювання — секунди. Наприклад, 213.5 означає початок генерації наступного фрагмента з 3 хвилин 33,5 секунди.
Приклад заповнення наведено нижче:extendвикористовується для продовження творчої роботи над наявною піснею, а не для заміни тексту всієї пісні. Якщо ви хочете використати новий текст для всієї пісні від початку, використовуйтеgenerateдля повторної генерації; якщо ви хочете переосмислити пісню, спираючись на наявну, можна використатиcover. Під час передавання цілого нового тексту пісні оригінальний текст доcontinue_atусе одно не буде замінений.
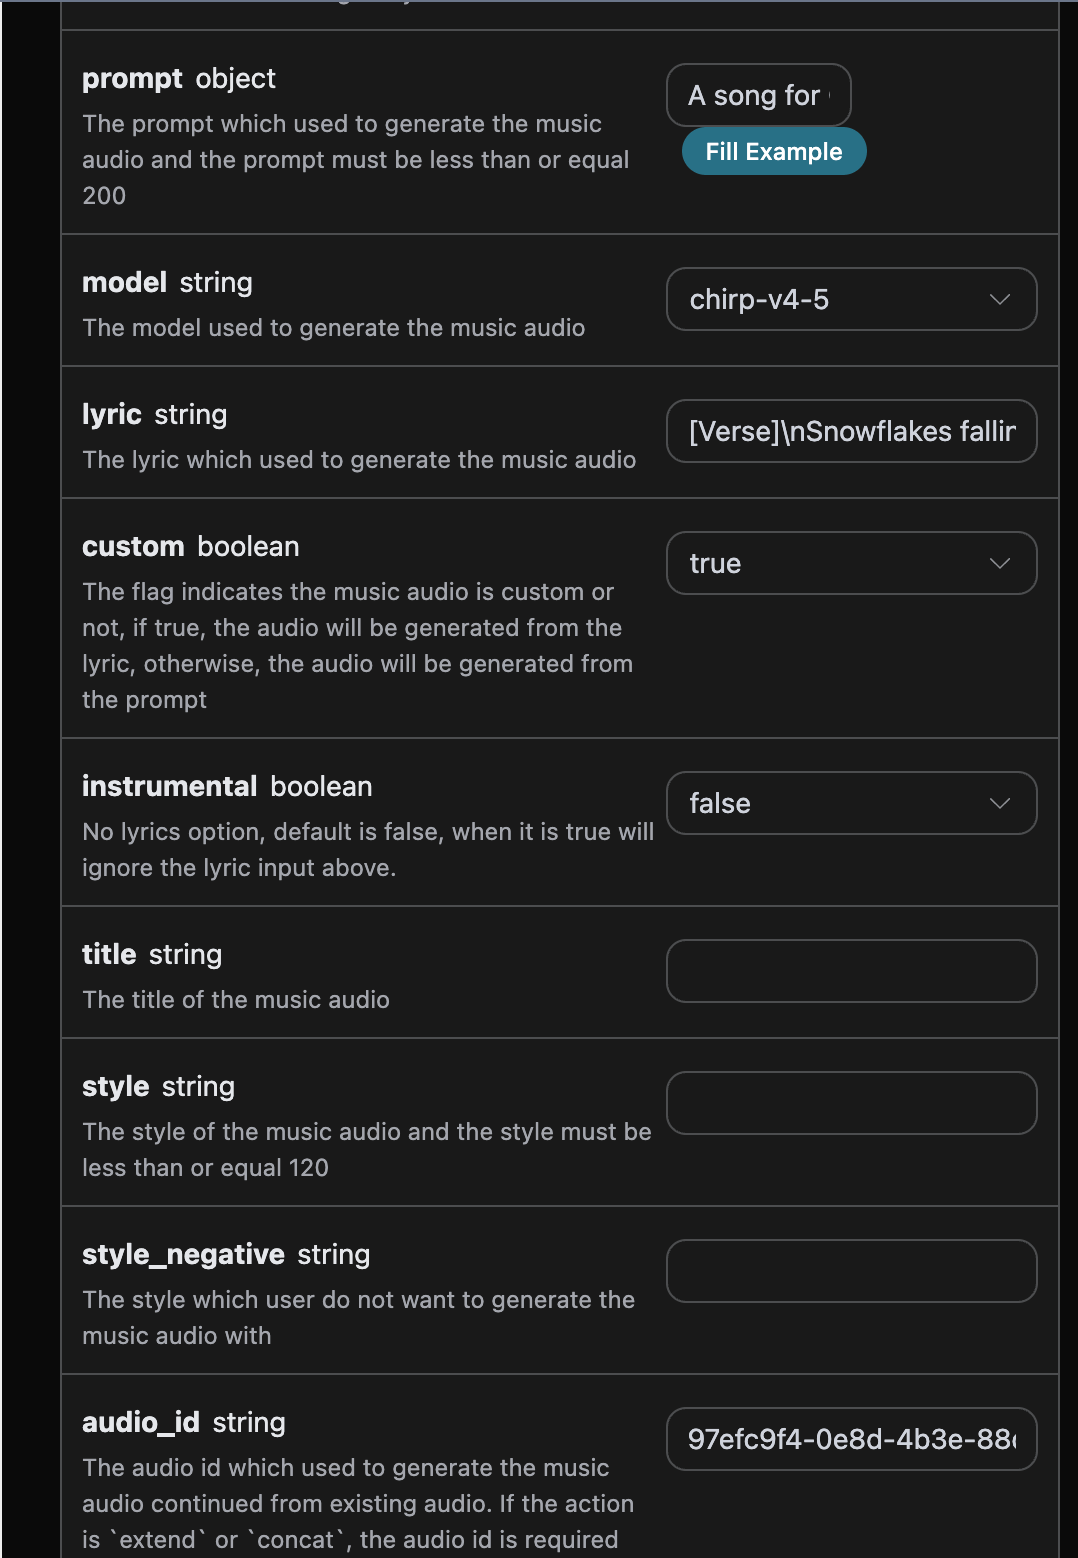
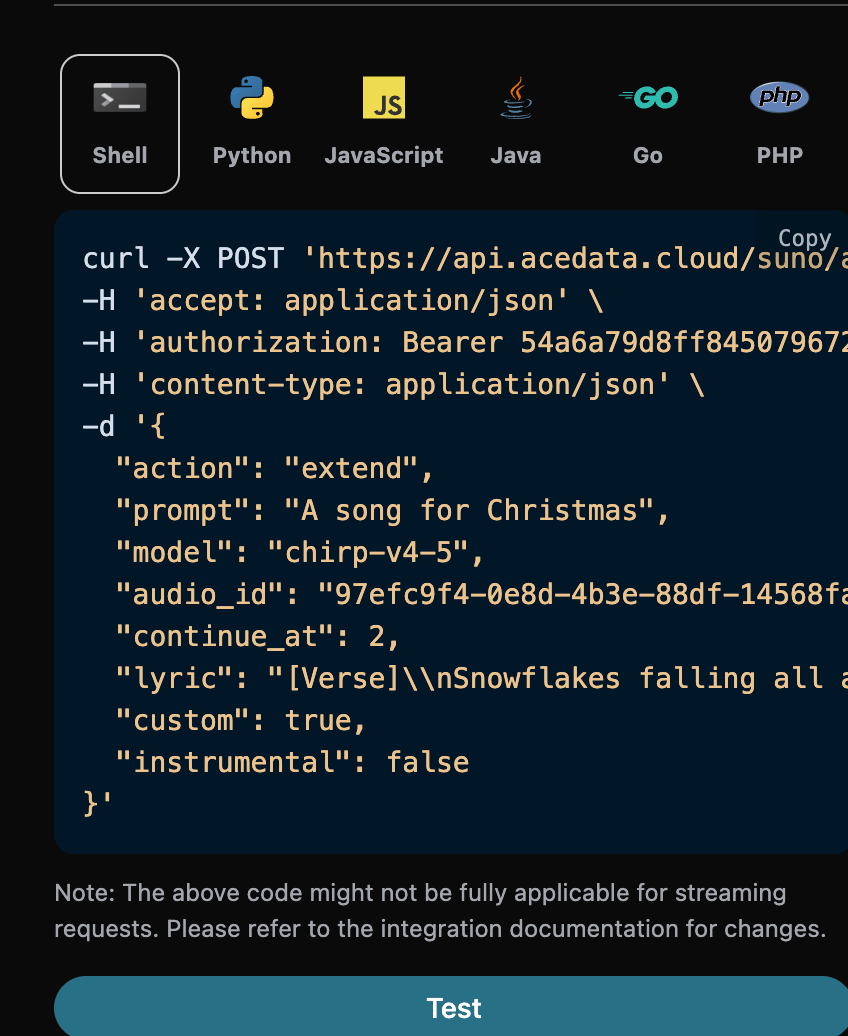
continue_at дорівнює 2 секундам, тому лише перші 2 секунди належать до вихідного вмісту до межі продовження. Під час фактичного продовження ближче до кінця пісні це значення слід встановити на секунду, з якої очікується початок продовження, і в lyric надавати лише новий фрагмент, який має виконуватися після межі.
Відповідний код Python:
lyric у результаті повертає текст пісні, використаний для цього завдання продовження. Це поле не є дослівною транскрипцією повного готового аудіо; для extend вихідне аудіо до continue_at все ще використовує оригінальний текст, а новий текст використовується лише для спрямування фрагмента продовження.
Отримання повної пісні
Результатextend поточної моделі зазвичай уже містить вихідне аудіо до continue_at і новий вміст після межі; спочатку визначте за фактичною тривалістю та вмістом поверненого аудіо, чи є воно вже повною піснею. Якщо повертається окремий фрагмент продовження або якщо потрібно явно об’єднати історію кількох продовжень в одну пісню, тоді використовуйте функцію з’єднання:
- action:значення
concat。 - audio_id:ID останнього фрагмента продовження。
Кавер-версія музики
Коли після продовження генерації пісні на основі оригінальної пісні стиль повернутої пісні може бути не надто підходящим. Якщо потрібно створити кавер-версію раніше згенерованої пісні (також підтримується користувацька завантажена музика), потрібно використовувати метод кавер-версії музики, тоді можна вказати такий вміст:- action: значення —
cover; коли виконується операція створення кавер-версії для користувацької завантаженої музики, необхідно вказати значення:upload_cover. - audio_id: ID раніше згенерованої пісні.
Заміна фрагмента
Коли після генерації пісні потрібне вторинне творче редагування з окремою операцією заміни фрагмента пісні, можна виконати операцію заміни певного фрагмента пісні.⚠️ Увага:Опис параметрів такий:replace_section_result_modeза замовчуванням має значенняfull_song: система окремо з’єднає 2 новостворені варіанти та поверне 2 повні пісні. Якщо потрібні лише ще не з’єднані варіанти замінених фрагментів, явно встановіть значенняcandidates, а потім виберіть варіант і викличте з’єднання музики.
- action: значення —
replace_section. - audio_id: ID оригінальної пісні (вихідної пісні, у якій виконується заміна).
- model: модель генерації пісні.
- lyric: повний текст пісні після заміни (включно із заміненим фрагментом і його контекстом, узгоджений із вмістом у
prompt). - prompt: новий текст пісні для фрагмента, який потрібно замінити.
- style: стиль пісні, необов’язковий.
- replace_section_start: час початку заміненого фрагмента в оригінальній пісні (секунди).
- replace_section_end: час завершення заміненого фрагмента в оригінальній пісні (секунди).
- replace_section_result_mode: режим повернення, за замовчуванням —
full_song.full_songокремо з’єднує 2 варіанти та повертає 2 повні пісні;candidatesповертає 2 ще не з’єднані фрагменти-варіанти.
Крок 1: Запустіть завдання із заміни фрагмента
Наприклад, якщо ID раніше згенерованої пісні: 18db7ed0-2b8a-41db-91c1-b0781dcca0d4 (тривалість 94,12 секунди), і потрібно замінити приспів із 30-ї до 60-ї секунди новим текстом, тоді можна встановити параметри так:replace_section_result_mode на candidates, буде повернуто 2 ще не зібрані замінні фрагменти зі структурою, ідентичною наведеному нижче прикладу:
candidates тривалість двох повернених аудіо (45,16 секунди та 33,8 секунди) є значно меншою за оригінальну пісню (94,12 секунди); це замінні фрагменти, що містять невелику кількість контексту, і не є цілими піснями. Можна вибрати задовільного кандидата й продовжити ручне збирання. Режим full_song за замовчуванням виконає два збирання та безпосередньо поверне 2 повні пісні.
Безпосереднє повернення повних пісень
Якщо ви хочете безпосередньо отримати повні пісні, на кроці один можна встановитиreplace_section_result_mode на full_song. Інтерфейс окремо збере двох кандидатів і поверне 2 повні пісні; у такому разі більше не потрібно викликати concat.
Крок два: зібрати замінний фрагмент назад в оригінальну пісню
Для вибраного вище фрагмента (наприклад,364f9d8b-ca25-463b-9a5e-d0b7139e2d6a) запустіть завдання concat відповідно до методу з розділу Збирання музики:
duration вже відновлено до повної тривалості пісні (105.28 секунди, приблизно дорівнює тривалості оригінальної композиції), а audio_url вказує на всю пісню після завершення заміни. На цьому завершується процес вторинної творчості «генерація → заміна фрагмента → зшивання всієї композиції».
Розділення вокалу та музики
Коли після генерації пісні потрібно виконати вторинну творчість з окремими операціями над акомпанементом і вокалом, можна розділити чистий музичний акомпанемент і вокал без акомпанементу. Можна вказати такий вміст:- action: значенням є
stems. - audio_id: ID раніше згенерованої пісні.
Розділення вокалу та музики на всі доріжки
Коли після генерації пісні потрібно виконати операцію розділення вокалу та музики на всі доріжки, можна вказати такий вміст:- action: значенням є
all_stems. - audio_id: ID раніше згенерованої пісні.
Додавання аудіодоріжки
add_stem генерує цільову інструментальну або голосову доріжку для вказаного аудіо, викликається через POST /suno/audios.
- Обов’язкові:
action、audio_id、stem_type。 - Необов’язкові:
model、prompt、title、style、negative_tags、weirdness、style_influence、audio_weight、max_mode、variety。 - Тарифікація: у звичайному режимі 0.672 Credits; коли
max_modeмає значенняtrue— 1.344 Credits。
Витягування аудіодоріжки
extract_stem витягує цільову аудіодоріжку із вказаного аудіо, одночасно повертаючи доповнювальну версію після видалення цієї аудіодоріжки, викликається через POST /suno/audios.
- Обов’язкові:
action、audio_id、stem_type。 - Необов’язковий:
audio_format, поточний публічний контракт із двома каналами підтримує лишеmp3。 - Тарифікація: 1.12 Credits。
data у відповіді в кінцевому стані зберігає плоский список аудіо, а stem_sets позначає відповідність між цільовою аудіодоріжкою та доповнювальною аудіодоріжкою:
Генерація звукових ефектів
sounds генерує одноразові або циклічні звукові ефекти на основі текстового опису, викликається через POST /suno/audios.
- Обов’язкові:
action、sound、sound_type。 - Необов’язкові:
model、bpm、key、audio_format;audio_formatнаразі підтримує лишеmp3。 sound_type:one-shotабоloop。- Тарифікація: 0.112 Credits。
Налаштування швидкості аудіо
adjust_speed налаштовує швидкість відтворення вказаного аудіо через виклик POST /suno/audios.
- Обов’язкові:
action,audio_id,speed_multiplier,title. - Необов’язкові:
keep_pitch. speed_multiplier: діапазон 0.25–4.- Вартість: 0.28 Credits.
Розширені параметри для користувацької генерації
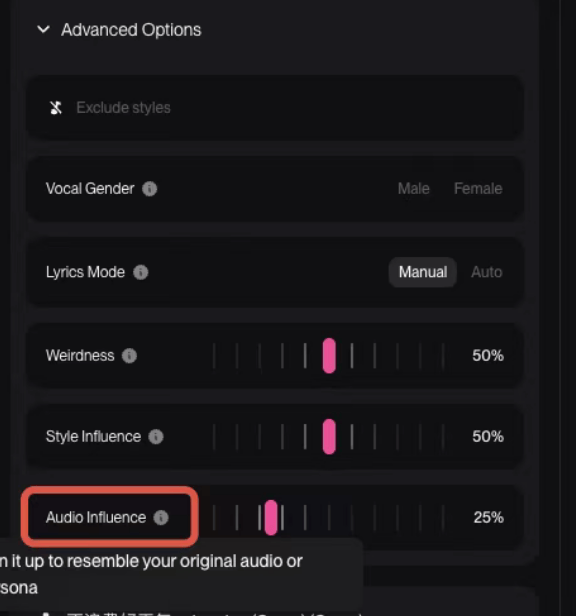
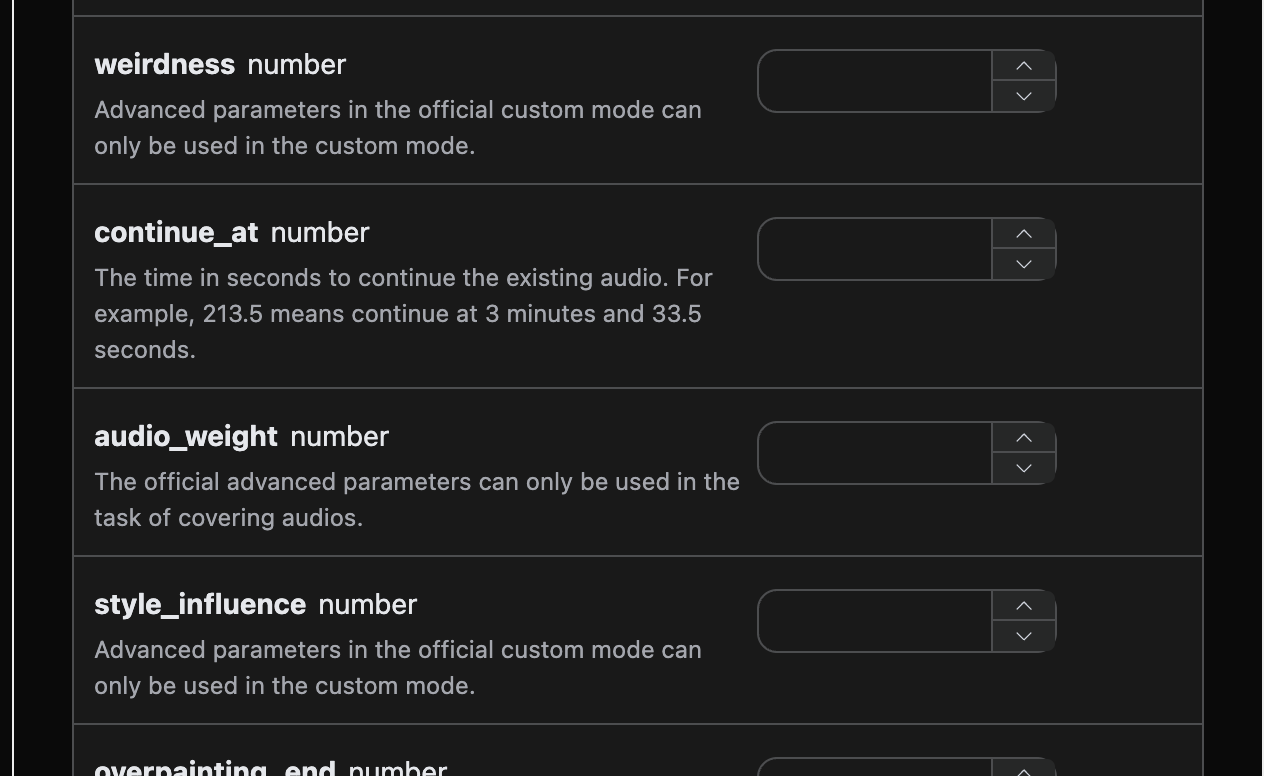
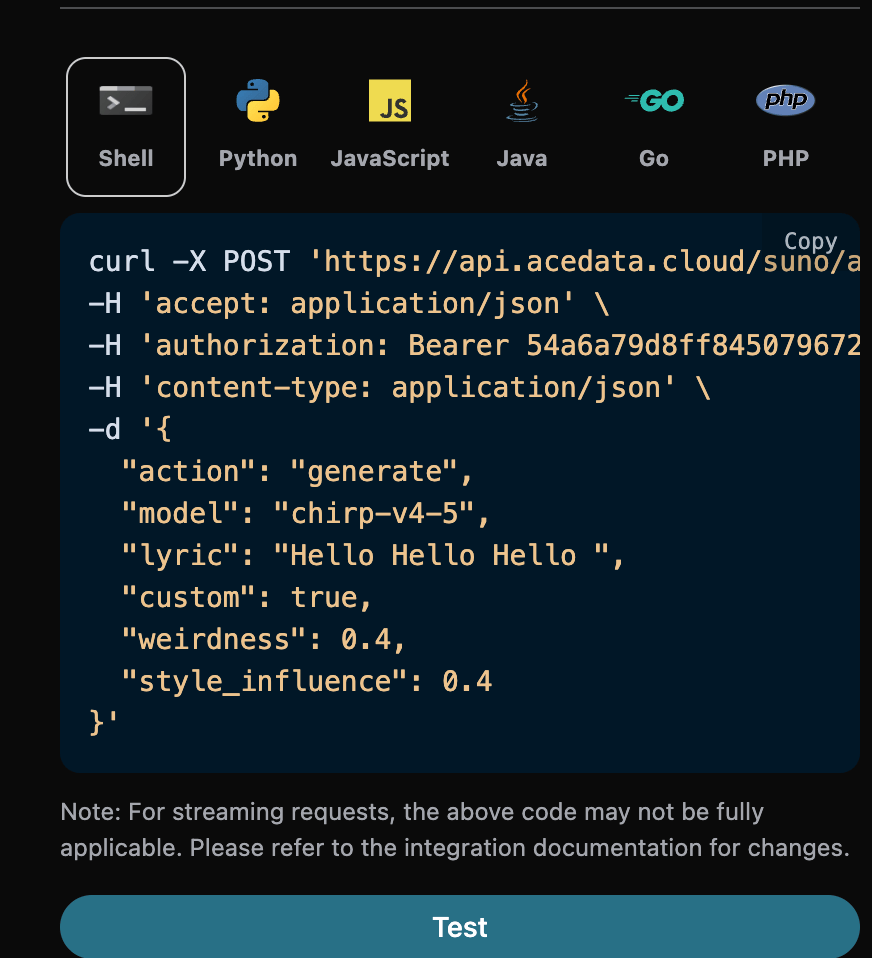
Офіційно дозволено використовувати в користувацькому режимі розширені параметриweirdness==>Weirdness, style_influence==>Style Influence, audio_weight==>Audio Influence для генерації, що відповідає таким офіційним прикладам:
Керування тривалістю пісні
За замовчуванням тривалість згенерованої пісні визначається самою моделлю, зазвичай від 30 секунд до 4 хвилин. Якщо потрібен довший або коротший готовий результат, можна вказати бажану тривалість за допомогою параметраduration, одиниця вимірювання — секунди, значенням є ціле число від 10 до 360.
Цей параметр використовується для генерації пісень у користувацькому режимі (custom дорівнює true). Особливо слід зазначити, що duration є схильнісною підказкою, а не жорстким обмеженням: модель враховуватиме це значення під час створення, але не гарантує його досягнення; у практичних тестах фактична тривалість зазвичай помітно коротша за очікуване значення, а тривалість двох пісень, повернутих одним запитом, також може відрізнятися в кілька разів. Навіть для абсолютно однакових запитів тривалість, отримана після кількох відправлень, також може мати великі відмінності. Тому не використовуйте його як точне керування тривалістю; якщо для бізнесу потрібна фіксована тривалість, після отримання готового результату самостійно обріжте його або повторіть спробу.
Відповідний код Python:
duration у запиті — це очікувана тривалість, тоді як поле duration кожної пісні у відповіді data — це фактична тривалість цієї пісні. Їхні назви однакові, але значення різні; фактична тривалість не гарантується рівною очікуваному значенню. Довжина тексту пісні є одним з основних факторів, що впливають на тривалість готового результату; якщо потрібен довший готовий результат, рекомендується одночасно надати повніший текст пісні.
Інтерфейс перевіряє, що duration має бути цілим числом від 10 до 360; це все ще лише ціль генерації, а не гарантія тривалості готового результату.
Функція Add Insterumental
У серпні 2025 року suno представив нову функцію Add Insterumental. Спочатку потрібно завантажити пісню а капела без озвучення, щоб suno допоміг вам додати музичний супровід. Спочатку можна перейти до Suno Upload API, щоб завантажити пісню а капела без музичного супроводу; відповідні дії показано на зображенні нижче: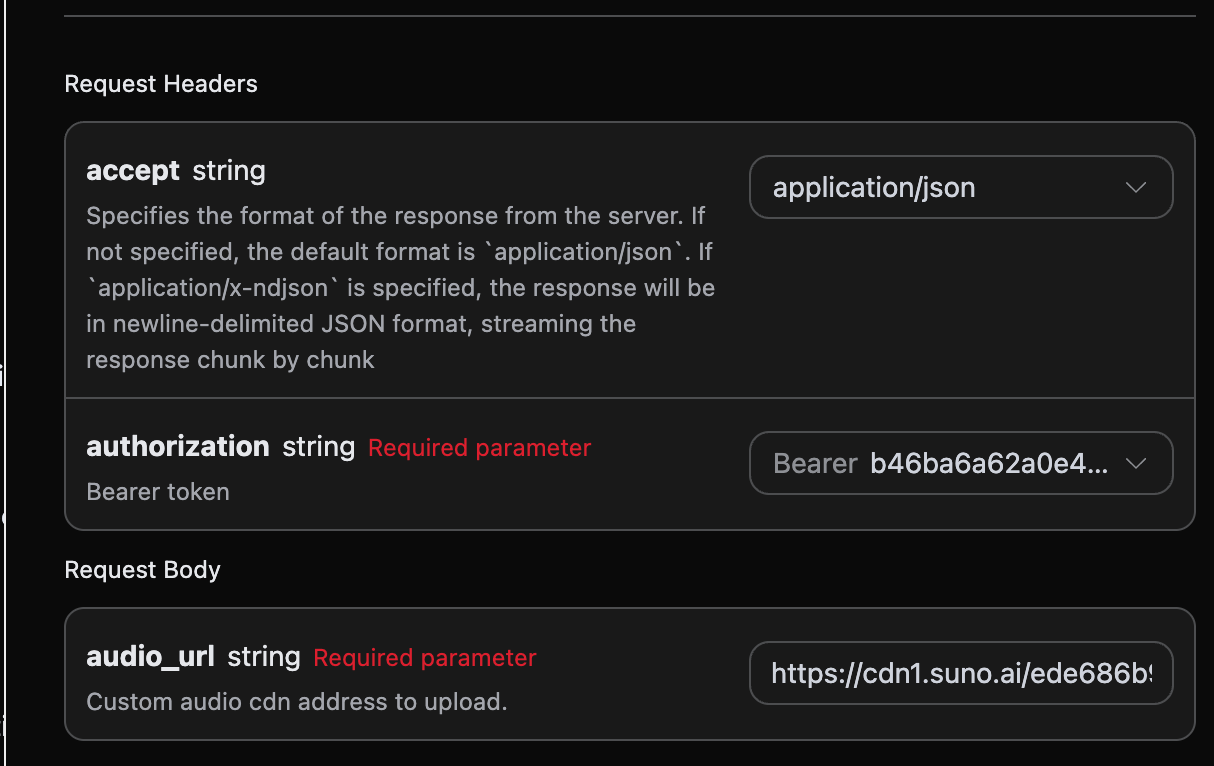
audio_id після завантаження, конкретний результат показано на зображенні нижче:
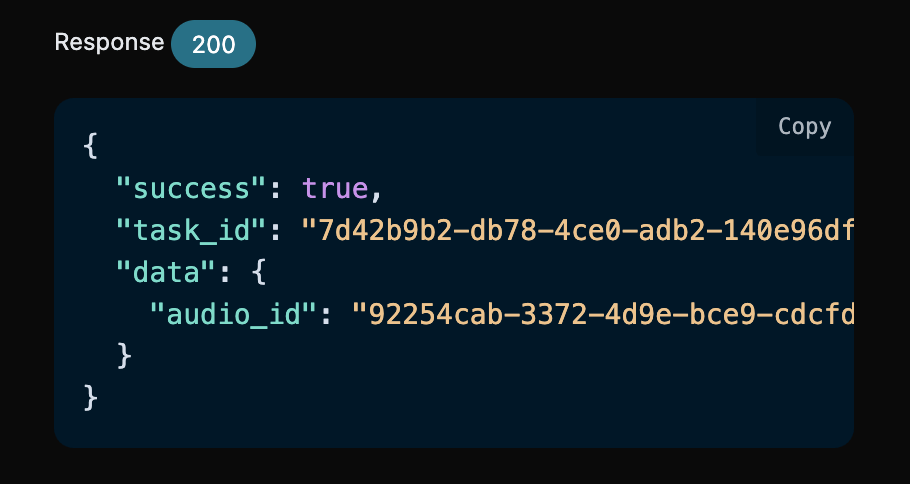
audio_id: 92254cab-3372-4d9e-bce9-cdcfdbc39070, після чого нам також потрібно заповнити такі параметри:
- action: значення —
underpainting. - underpainting_start: початковий час додавання акомпанементу до завантаженої пісні, значення за замовчуванням — 0.
- underpainting_end: кінцевий час додавання акомпанементу до завантаженої пісні, має бути меншим за загальну тривалість пісні.
- audio_id: ID завантаженої пісні а капела без озвучення.
- style: стиль акомпанементу, бажано без тексту пісні, адже це озвучення.
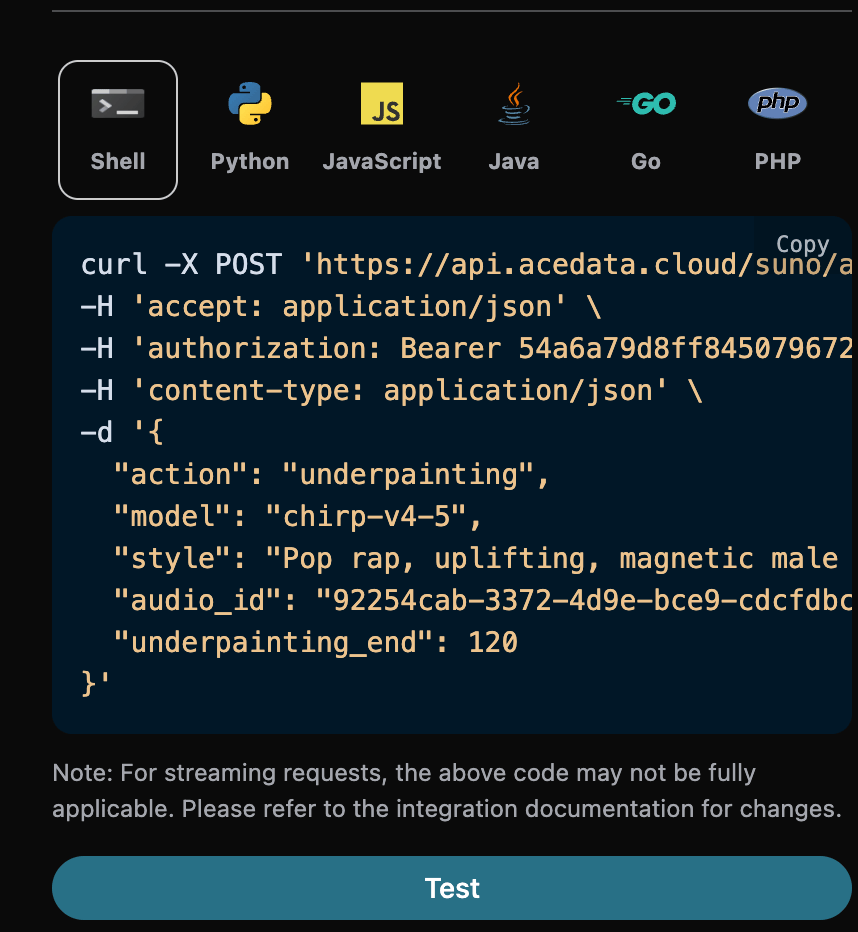
Функція Add Vocals
У серпні 2025 року suno представив нову функцію Add Vocals. Спочатку потрібно завантажити інструментальну музику, щоб suno написав текст і створив вокальне виконання. Спочатку можна перейти до Suno Upload API, щоб завантажити пісню а капела без музичного супроводу; відповідні дії показано на зображенні нижче:
audio_id після завантаження, конкретний результат показано на зображенні нижче:
audio_id: 92254cab-3372-4d9e-bce9-cdcfdbc39070, після чого нам також потрібно заповнити такі параметри:
- action: значення —
overpainting. - overpainting_start: початковий час додавання вокалу до завантаженої пісні, значення за замовчуванням — 0.
- overpainting_end: кінцевий час додавання вокалу до завантаженої пісні, має бути меншим за загальну тривалість пісні.
- audio_id: ID завантаженої пісні а капела без озвучення.
- custom: у цьому режимі для введення тексту пісні необхідно використовувати користувацький режим.
- lyric: текст пісні, введений у користувацькому режимі.
- style: стиль акомпанементу.
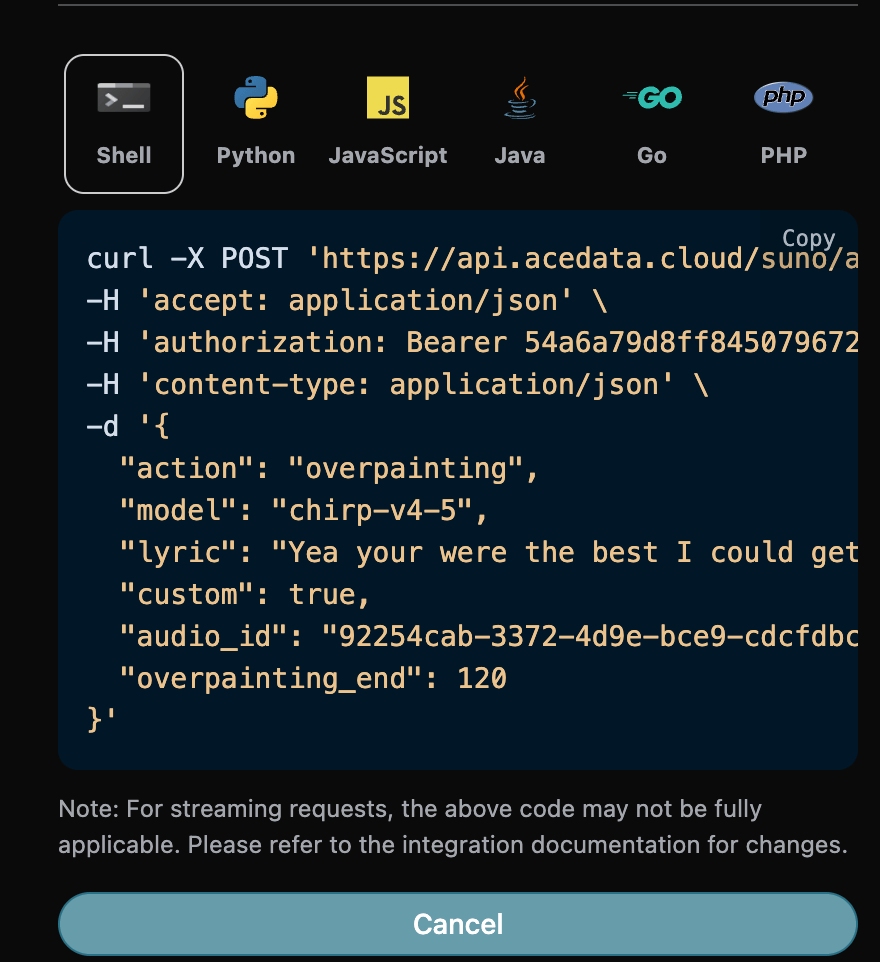
Функція Remaster
У грудні 2025 року Suno випустив нову функцію Remaster, ця функція може повторно генерувати пісні, не можна між обліковими записами, і тоді нам також потрібно заповнити такі параметри:- action:значення
remaster。 - audio_id:ID пісні, яку потрібно повторно згенерувати。
- model:підтримуються лише v4.5+、v5。
- variation_category:підтримується лише у версіях v5 і вище, і має лише 3 значення: high normal subtle。
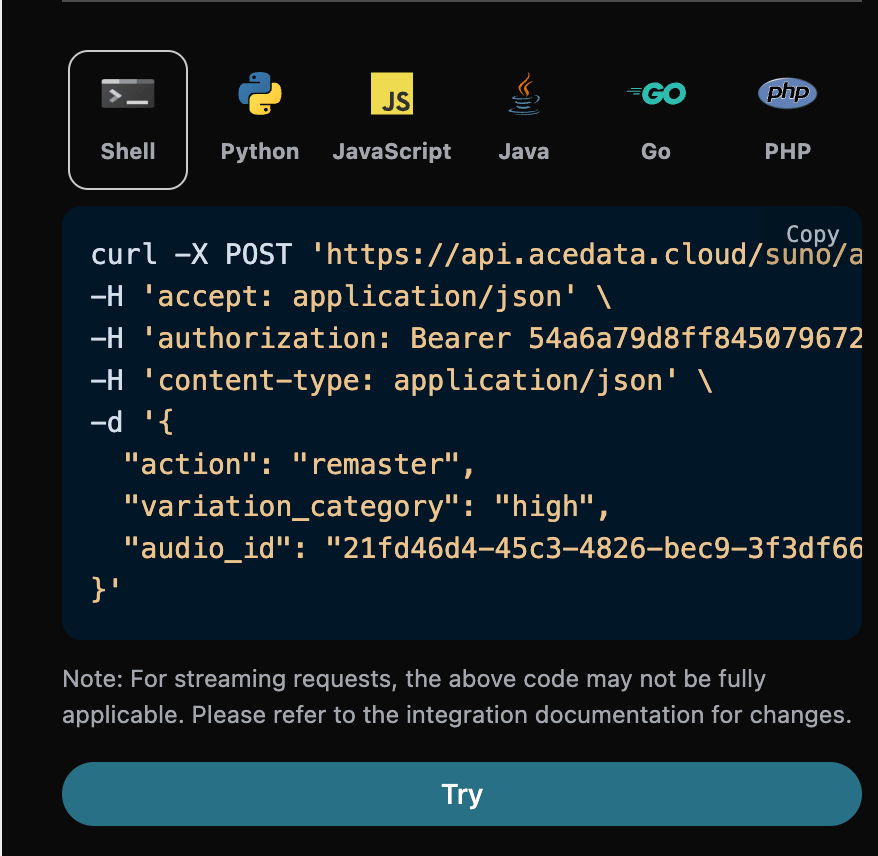
Функція генерації міксу Mashup
У грудні 2025 року Suno випустив нову функцію Mashup, ця функція може генерувати пісні на основі двох референсних пісень, і тоді нам також потрібно заповнити такі параметри:- action:значення
mashup。 - mashup_audio_ids:ID двох референсних пісень。 Після заповнення автоматично згенеровано такий код:
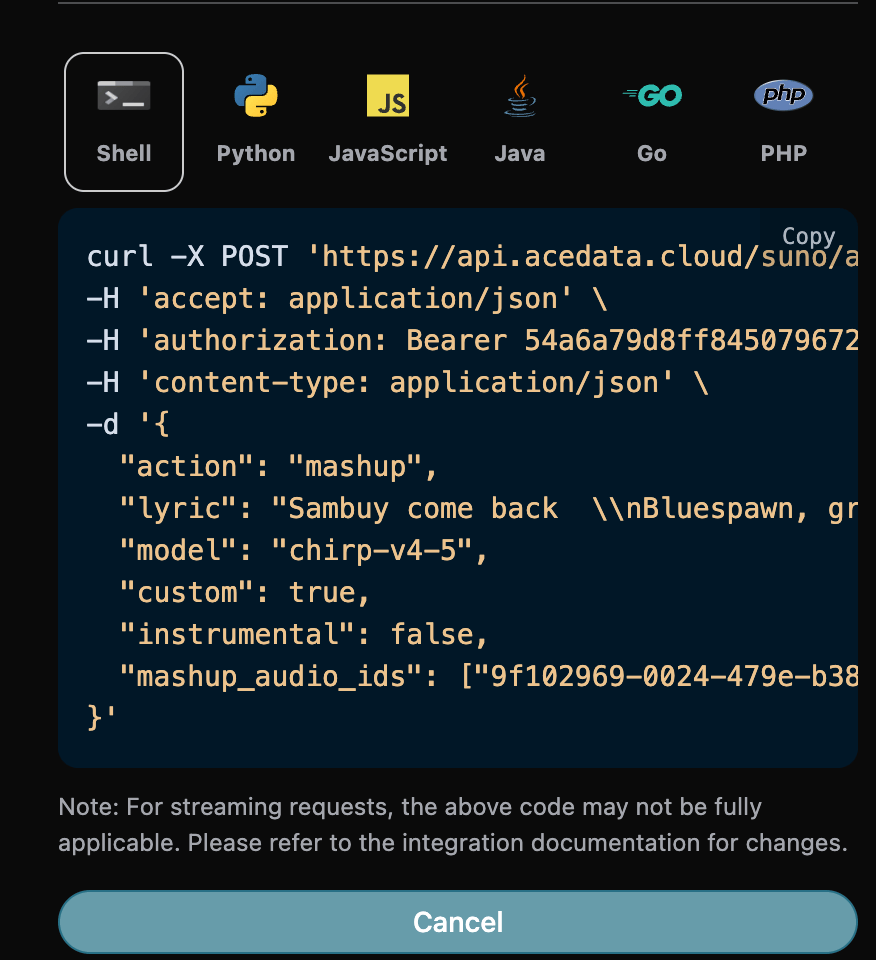
Генерація пісень із семплюванням Samples
Тутsamples — це семплювання одного аудіоінтервалу: з уже наявного аудіо вибирається час початку та завершення, а цей фрагмент використовується як семпл для творчості. Це відрізняється від функції творчості на основі натхнення Inspo, описаної нижче, яка використовує від 1 до 4 повних референсних аудіо. Потрібно заповнити такі параметри:
- action: значення —
samples. - samples_start: час початку семплювання.
- samples_end: час завершення семплювання.
- audio_id: ID референсної пісні, з якої потрібно взяти семпл.
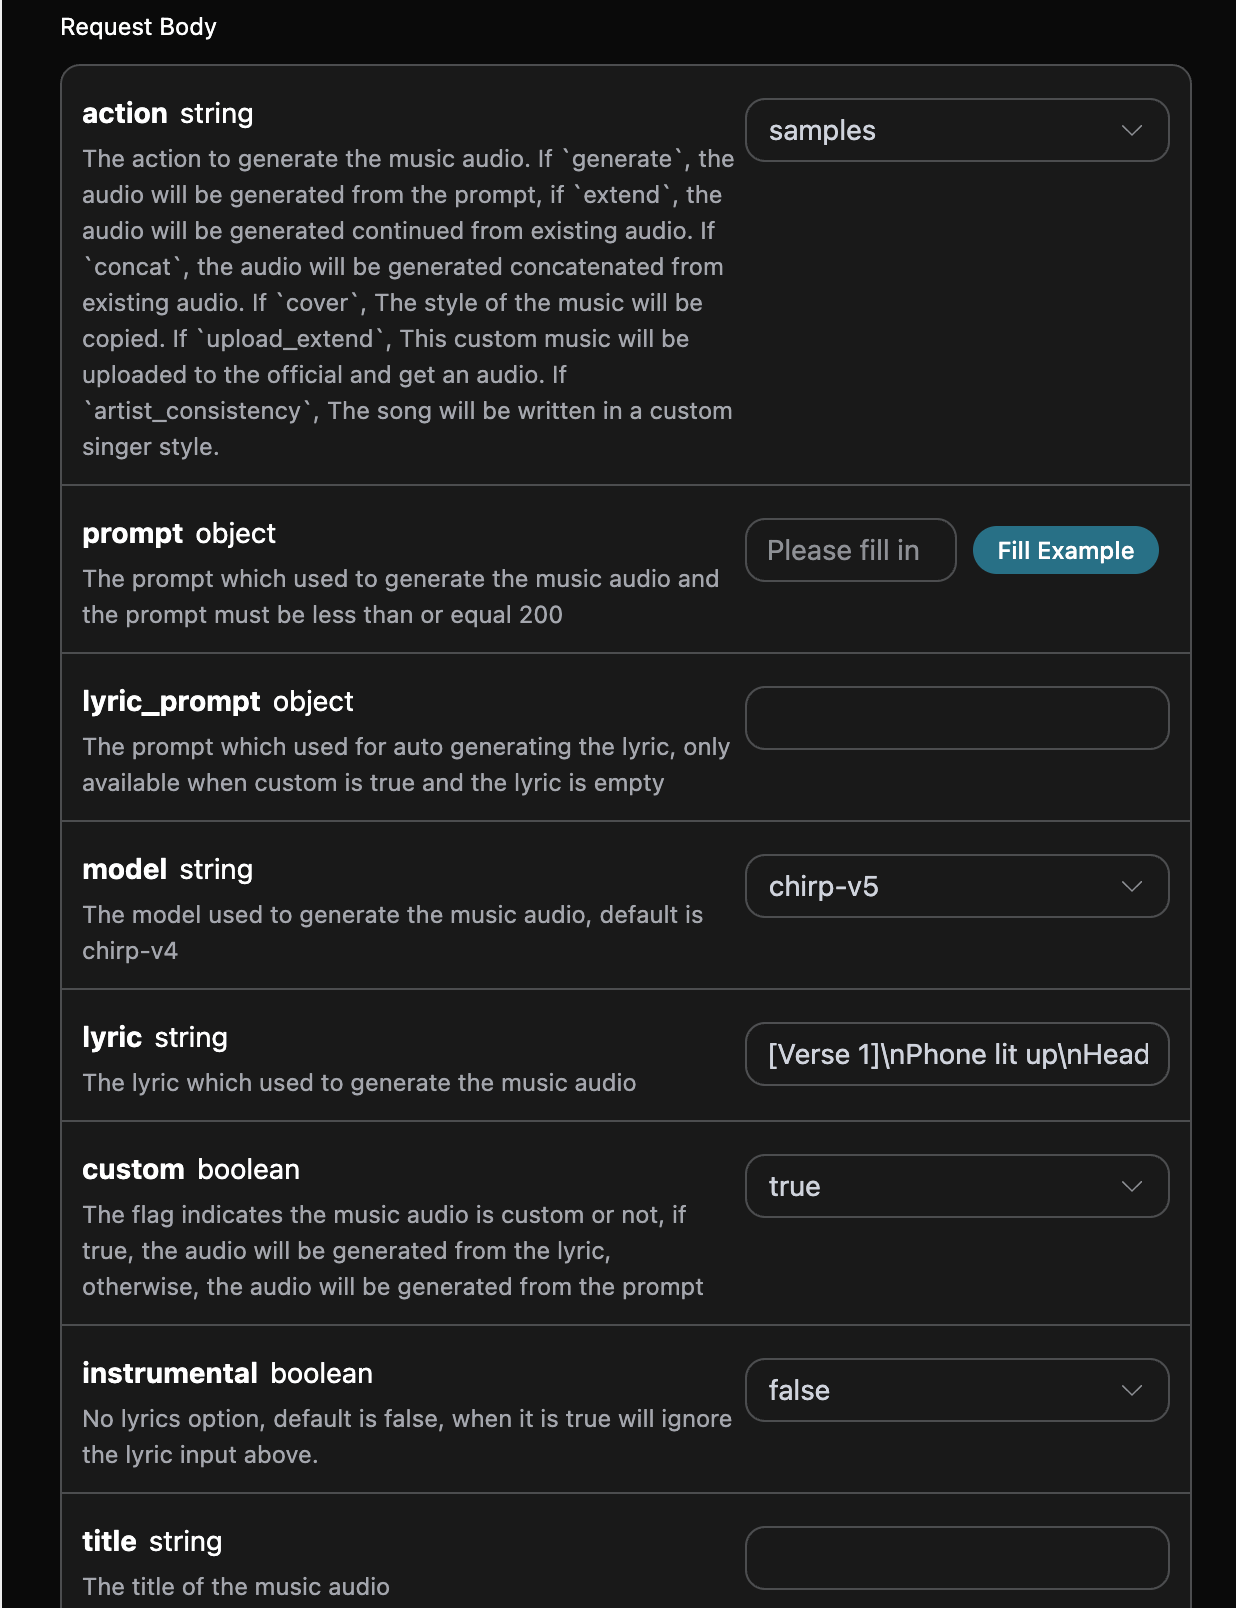
Функція творчості на основі натхнення Inspo
Функція творчості на основі натхнення Inspo може генерувати нову музику на основі 1–4 повних референсних аудіозаписів і підтримує перетягування або завантаження аудіо як джерела натхнення. API використовує наявну діюinspo: клієнт надає загальнодоступні URL-адреси аудіо, а сервіс автоматично виконує підготовку референсного аудіо та створення, без потреби клієнту окремо зчитувати текст, стиль або тривалість, а потім формувати запит. Вона відрізняється від описаного вище семплування за проміжком, а також від Cover, що відтворює стиль оригінальної пісні. Під час використання потрібно заповнити такі параметри:
- action: значення
inspo. - audio_urls: список URL-адрес референсних аудіо; потрібно надати від 1 до 4 загальнодоступних аудіоадрес.
- model: використовувана модель, рекомендовано
chirp-v6. - prompt: текст пісні або підказка для створення (необов’язково).
Примітка: референсне аудіо має бути загальнодоступним аудіофайлом. Якщо референсне аудіо повністю збігається з відомим записом у музичній бібліотеці платформи, Suno може відмовити в генерації через перевірку авторських прав; рекомендується використовувати власне аудіо або аудіо, згенероване Suno, як джерело натхнення.Відповідний код Python:
chirp-v5, у прикладі поточного запиту рекомендовано chirp-v6, структура відповіді однакова:
Асинхронний зворотний виклик
Оскільки Suno генерує музику відносно довго, приблизно 1–2 хвилини, якщо API тривалий час не відповідає, HTTP-запит постійно підтримуватиме з’єднання, що призводить до додаткового споживання системних ресурсів, тому цей API також підтримує асинхронні зворотні виклики. Загальний процес такий: коли клієнт надсилає запит, він додатково вказує полеcallback_url; після того як клієнт надсилає API-запит, API негайно повертає результат, який містить поле task_id, що представляє ID поточного завдання. Після завершення завдання результат генерації музики буде надіслано у форматі POST JSON на вказаний клієнтом callback_url, де також міститиметься поле task_id, тож результати завдань можна буде пов’язати за ID.
Нижче ми на прикладі розглянемо, як саме це виконати.
Спочатку Webhook-зворотний виклик — це сервіс, здатний приймати HTTP-запити, розробник має замінити його на URL власного розгорнутого HTTP-сервера. Тут для зручності демонстрації використовується публічний сайт прикладу Webhook https://webhook.site/; відкривши цей сайт, можна отримати Webhook URL, як показано на зображенні:
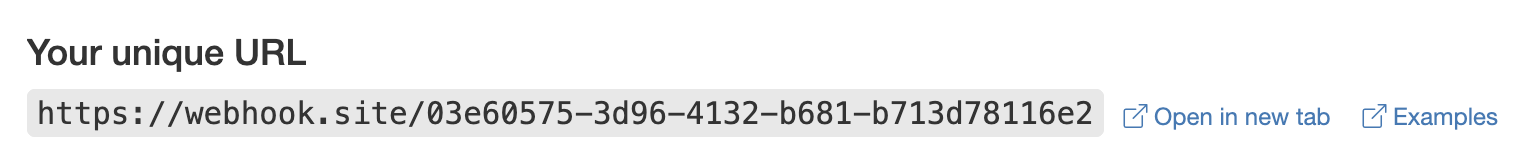 Скопіювавши цей URL, його можна використовувати як Webhook; приклад тут — https://webhook.site/03e60575-3d96-4132-b681-b713d78116e2。
Далі ми можемо встановити для поля
callback_url вищезазначений Webhook URL і одночасно заповнити prompt, як показано на зображенні:
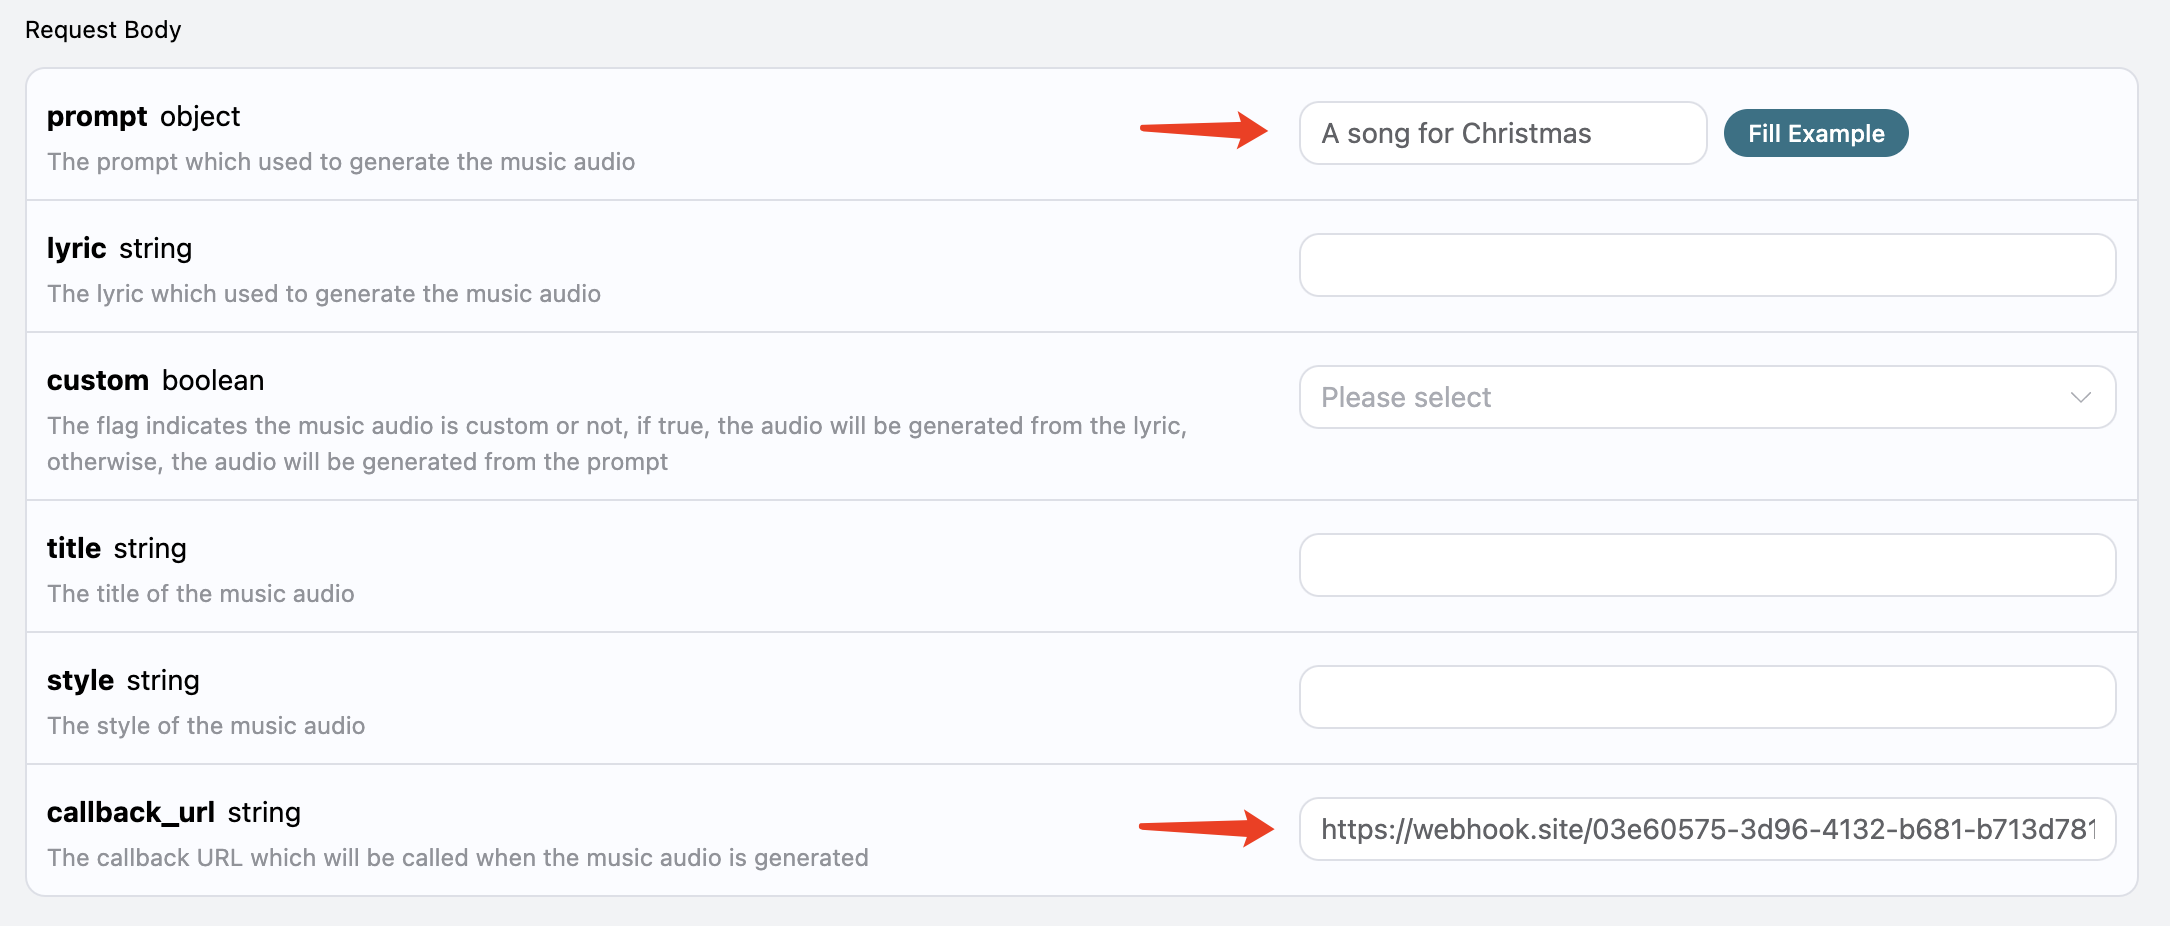 Натиснувши запуск, можна побачити, що результат буде отримано негайно, як показано нижче:
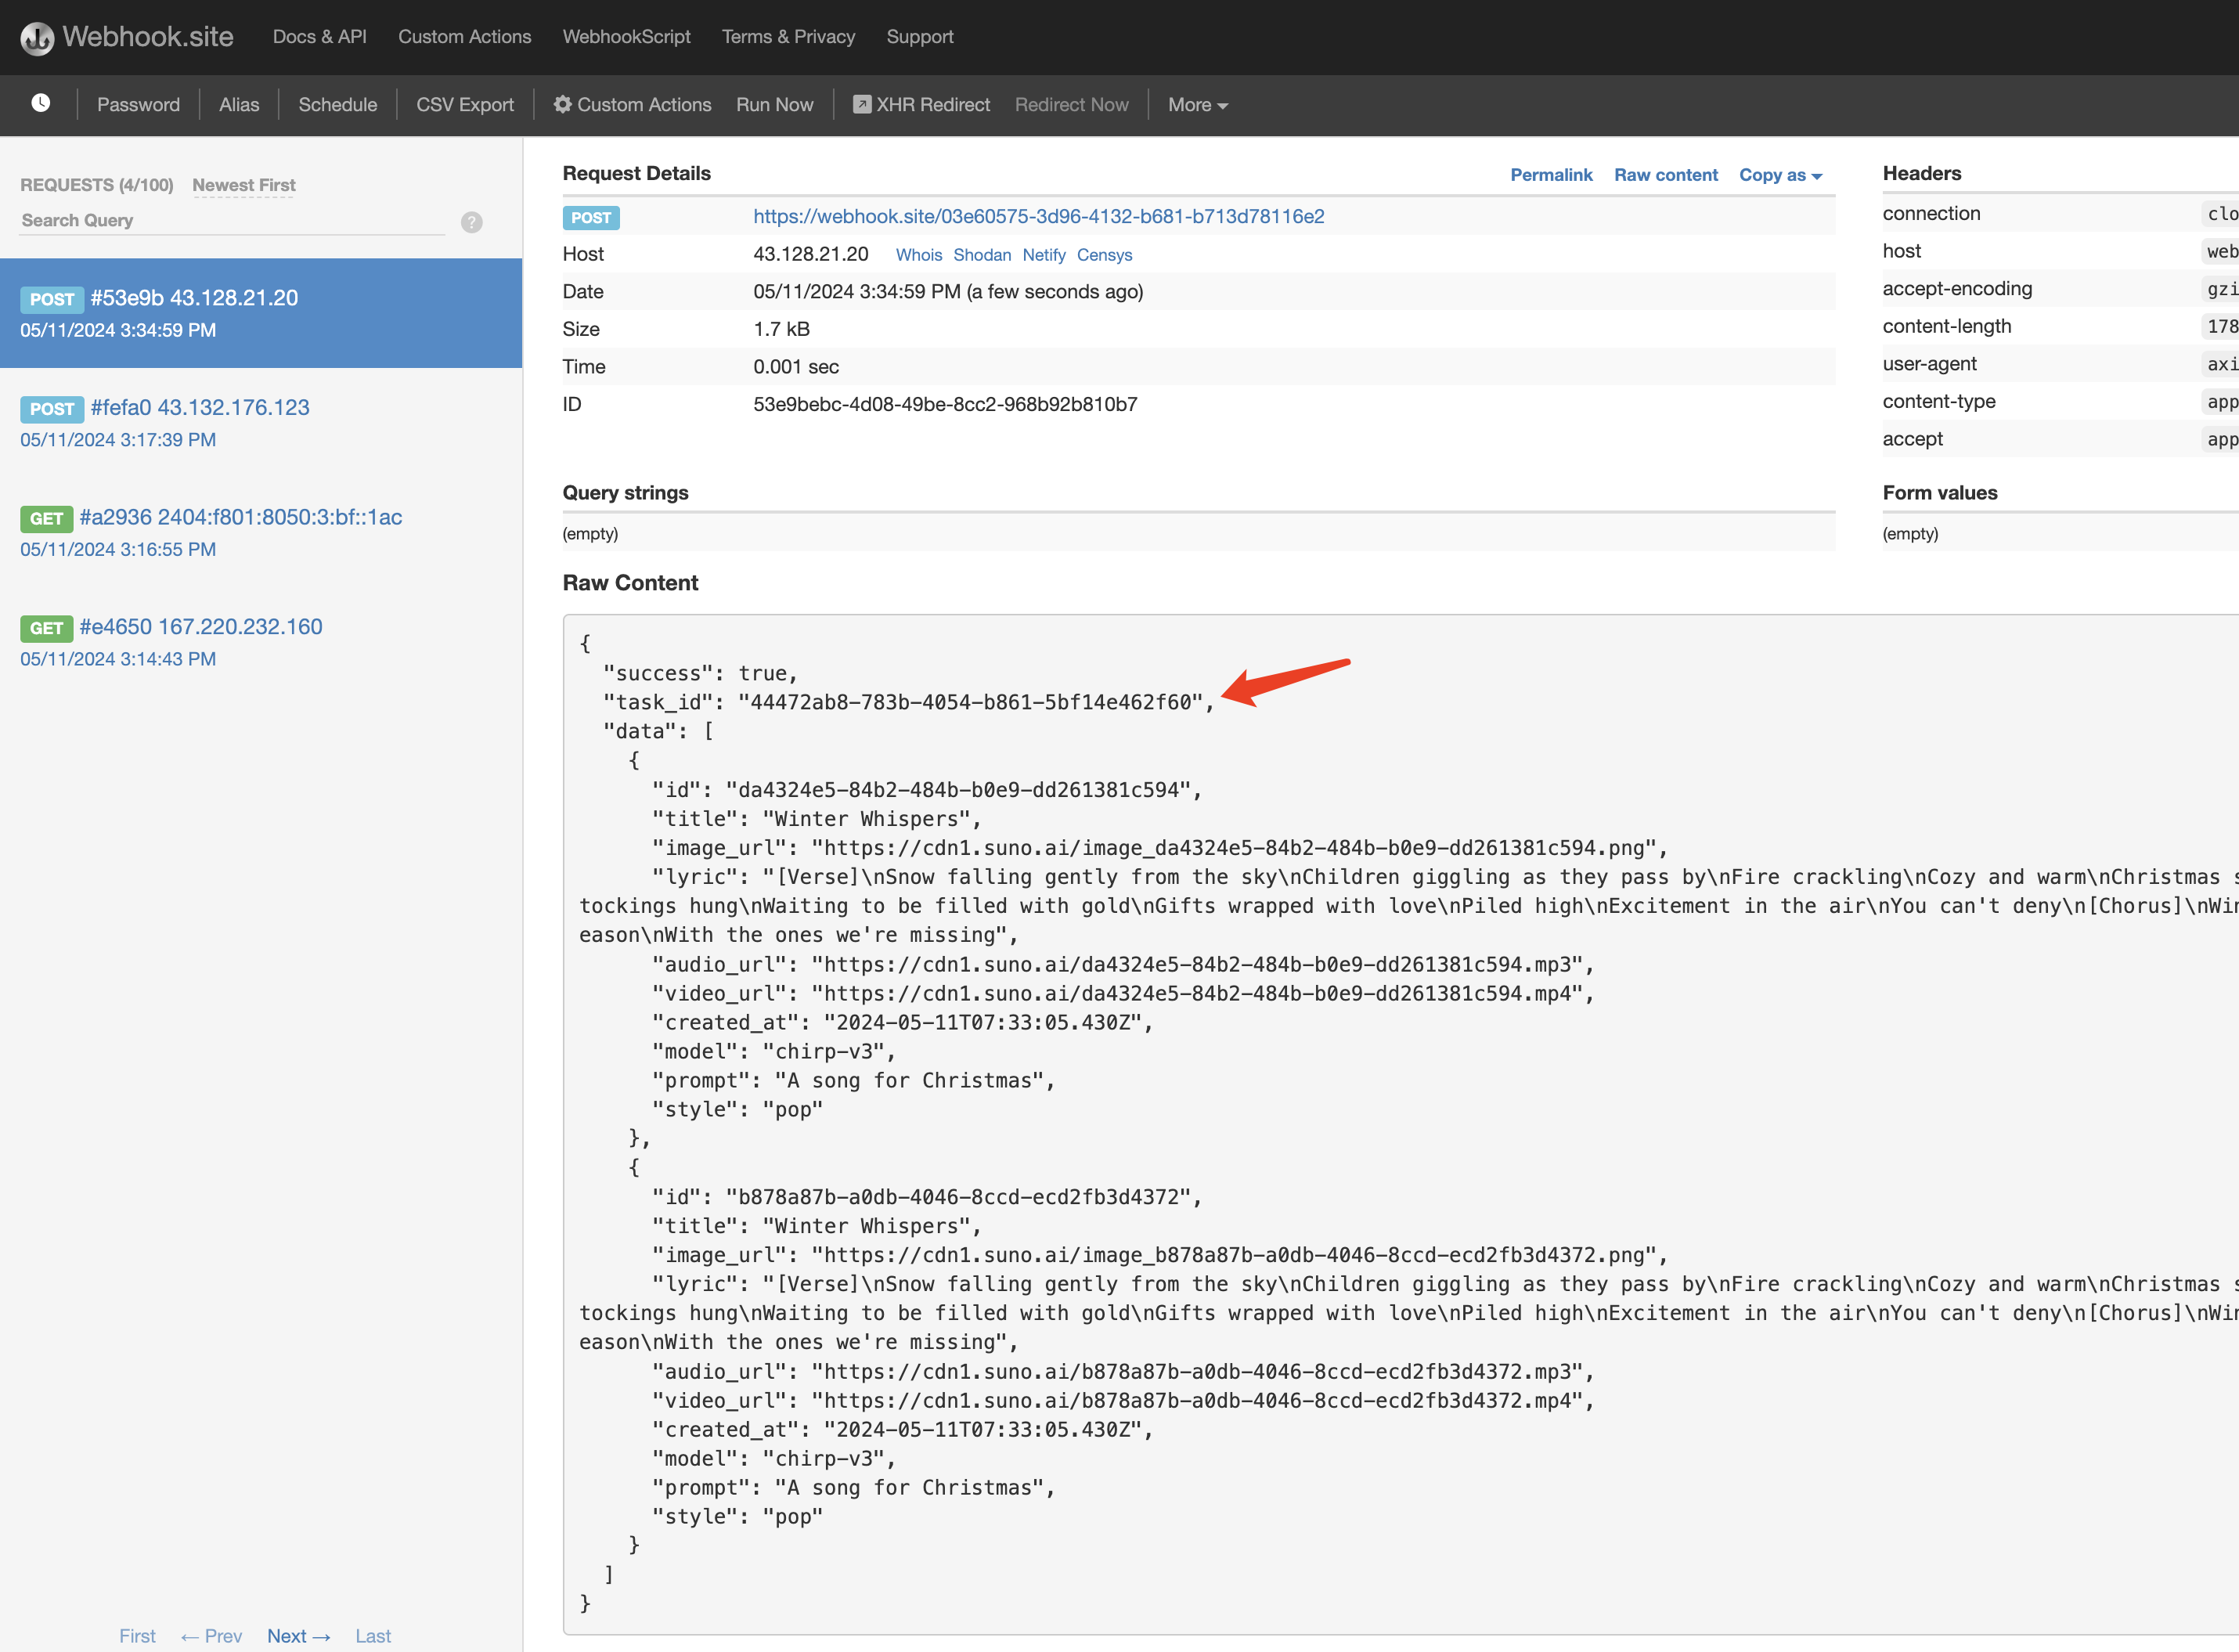 Вміст такий:
task_id, а всі інші поля схожі на наведені вище; за допомогою цього поля можна реалізувати пов’язування завдань.
Звичайно, ми також можемо отримати результат через потоковий виклик; нам потрібно лише встановити значення accept у заголовку запиту на application/x-ndjson, нижче для демонстрації використано приклад вхідних даних:
task_id; вище збережено лише дві фактичні відповіді — першу та кінцеву, а повторювані проміжні оновлення пропущено.
Обробка помилок
Якщо станеться помилка, ви отримаєте повідомлення про помилку, подібне до такого:error.code, error.message:
Примітка: ліміти та формулювання помилок для різних облікових записів висхідних постачальників можуть відрізнятися. Зазвичайchirp-v3-5/chirp-v4мають нижчий ліміт дляstyle(200), тоді якchirp-v4-5і вище зазвичай підтримують до 1000; у разі використання старого висхідного постачальника можуть з’являтися сумісні повідомлення на кшталтTags too long.абоstyle must be less than or equal 120. | Код статусу |error.code|error.message| | ----------- | ------------- | --------------------------------------------------------------- | | 400 |bad_request|Ідентифікатор пісні не існує або її було переведено в офлайн.| | 400 |bad_request|Запит надто довгий.| | 400 |bad_request|Теги надто довгі.| | 400 |bad_request|Завантажене аудіо збігається з наявним твором мистецтва.| | 400 |bad_request|instrumental має бути булевим значенням| | 400 |bad_request|Назва надто довга.| | 400 |bad_request|Тема надто довга.| | 400 |bad_request|style має бути меншим або дорівнювати 120| | 400 |bad_request|custom має бути булевим значенням| | 400 |bad_request|audio_id є обов'язковим під час розширення аудіо| | 400 |bad_request|continue_at є обов'язковим під час розширення аудіо| | 400 |bad_request|continue_at має бути числом, більшим за 0| | 400 |bad_request|lyric є обов'язковим під час розширення аудіо, коли instrumental має значення false| | 400 |bad_request|prompt є обов'язковим під час генерування аудіо| | 400 |bad_request|lyric є обов'язковим під час генерування користувацького аудіо| | 403 |forbidden|Імовірно, запит має неправильний формат| | 403 |forbidden|Імовірно, запит захищений авторським правом| | 403 |forbidden|Запит містив неприйнятний матеріал| | 403 |forbidden|Опис пісні позначено для модерації| | 403 |forbidden|Опис пісні містив ім'я виконавця| | 403 |forbidden|Теги містили ім'я виконавця| | 403 |forbidden|Текст пісні містив матеріал, захищений авторським правом| | 403 |forbidden|Опис пісні містив тег продюсера| | 403 |forbidden|Загальна помилка openAI| | 403 |forbidden|Запит позначено для модерації| | 500 |api_error|Не вдалося згенерувати текст пісні з опису пісні| | 500 |api_error|завдання завершилося з невідомою помилкою| | 500 |api_error|у системі немає доступних воркерів| | 500 |api_error|сервіс перебуває на технічному обслуговуванні, генерування призупинено| | 504 |timeout|час очікування під час очікування генерування аудіо вичерпано|