

GPT-6.1 Sol
Użyjmodel: "gpt-6.1-sol", aby wybrać ten model. Obsługuje wyjście strumieniowe, wywoływanie funkcji, ustrukturyzowane wyjście i wejście obrazów. W pierwszym tygodniu od udostępnienia jest dostępny wyłącznie dla zweryfikowanych posiadaczy ACE T1+ (co najmniej 100 000 ACE) lub autoryzowanych użytkowników; szczegółowy czas udostępnienia zależy od komunikatu o dostępie w konsoli.
Poziomy rozumowania obsługują low, medium, high, xhigh i max, tymczasowo nie obsługują none ani minimal. Zaleca się rozpoczęcie od reasoning_effort: "low". Gdy dane wejściowe przekroczą 272 000 tokenów, do całego żądania ma zastosowanie cena za długi kontekst, a opłata zależy od aktualnej ceny w konsoli.
Proces składania wniosku
Aby korzystać z OpenAI Chat Completion API, najpierw przejdź do konsoli Ace Data Cloud, aby uzyskać swój API Token i zachować go na później. Jeśli nie jesteś jeszcze zalogowany lub zarejestrowany, nastąpi automatyczne przekierowanie na stronę logowania, która zaprosi Cię do rejestracji i zalogowania się, a po zakończeniu automatycznie powrócisz na obecną stronę.
Jeden API Token umożliwia wywoływanie wszystkich usług platformy, bez konieczności osobnego składania wniosku dla każdej usługi. Przy pierwszym wniosku otrzymasz bezpłatny limit, który pozwala na darmowe wypróbowanie; gdy limit jest niewystarczający, możesz doładować uniwersalne saldo w konsoli.
📘 Pełna dokumentacja: OpenAI Chat Completion API →
Podstawowe użycie
Następnie można w interfejsie wypełnić odpowiednią treść, jak pokazano na ilustracji: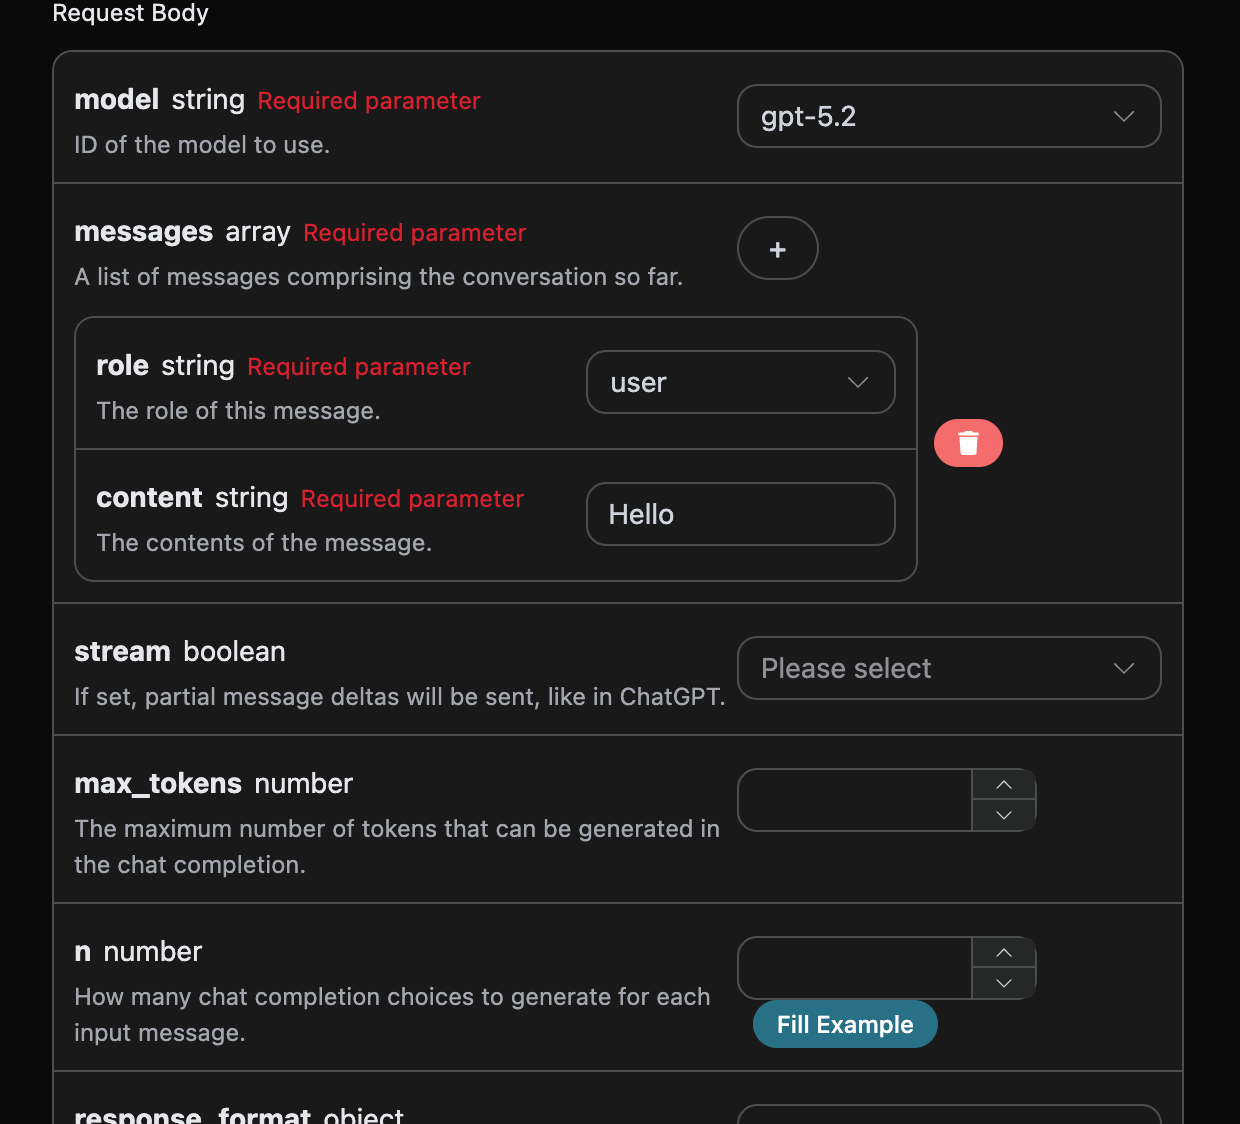
authorization, które można bezpośrednio wybrać z listy rozwijanej. Kolejnym parametrem jest model, model oznacza kategorię modelu z oficjalnej strony OpenAI ChatGPT, którą wybieramy do użycia, tutaj mamy głównie 20 rodzajów modeli, szczegóły można zobaczyć w udostępnianych przez nas modelach. Ostatnim parametrem jest messages, messages to tablica wpisywanych przez nas promptów, jest to tablica, co oznacza, że można jednocześnie przesłać wiele promptów, każdy prompt zawiera role i content, gdzie role oznacza rolę osoby zadającej pytanie, udostępniamy trzy tożsamości, odpowiednio user, assistant, system. Kolejny content to konkretna treść naszego pytania.
Jednocześnie można zauważyć, że po prawej stronie generowany jest odpowiedni kod wywołania, można skopiować kod i uruchomić go bezpośrednio, można również bezpośrednio kliknąć przycisk „Try”, aby przeprowadzić test.
Często używane opcjonalne parametry:
max_tokens: ogranicza maksymalną liczbę tokenów pojedynczej odpowiedzi.temperature: losowość generowania, między 0 a 2, im większa wartość, tym większe rozproszenie.n: ile kandydackich odpowiedzi wygenerować jednocześnie.response_format: ustawienie formatu zwracanych danych.
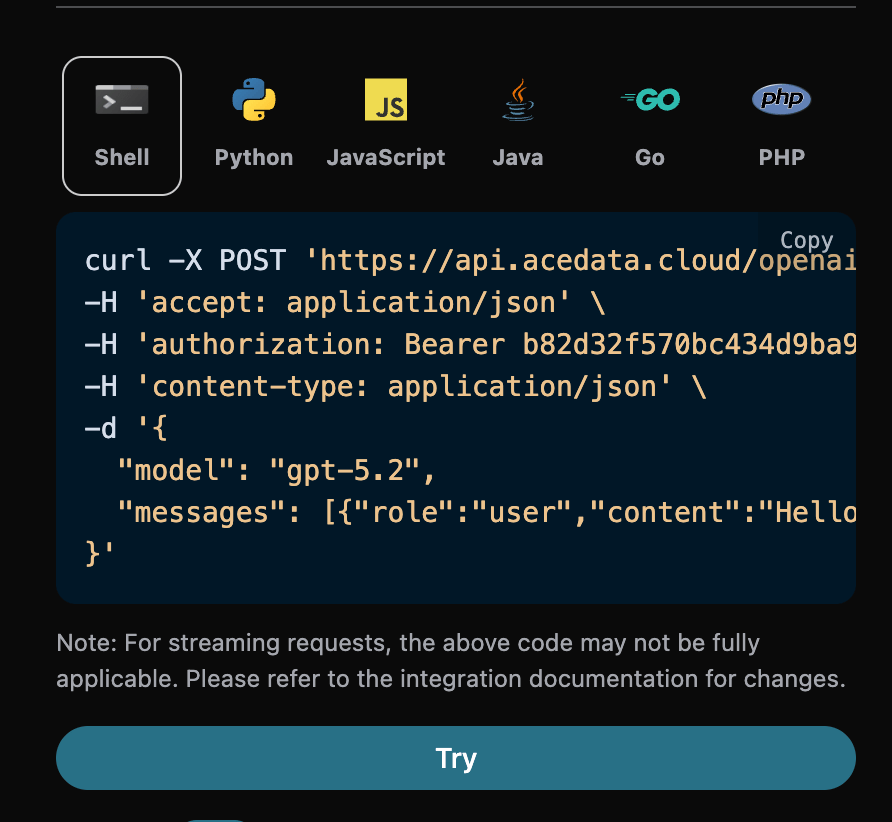
id, ID wygenerowanego zadania tej konwersacji, używane do jednoznacznej identyfikacji tego zadania konwersacji.model, wybrany model z oficjalnej strony OpenAI ChatGPT.choices, informacje o odpowiedzi udzielonej przez ChatGPT na prompt.usage: informacje statystyczne dotyczące tokenów dla tej pary pytań i odpowiedzi.
choices zawiera informacje o odpowiedzi ChatGPT, choices w nim to ChatGPT, można to zobaczyć, jak pokazano na ilustracji.
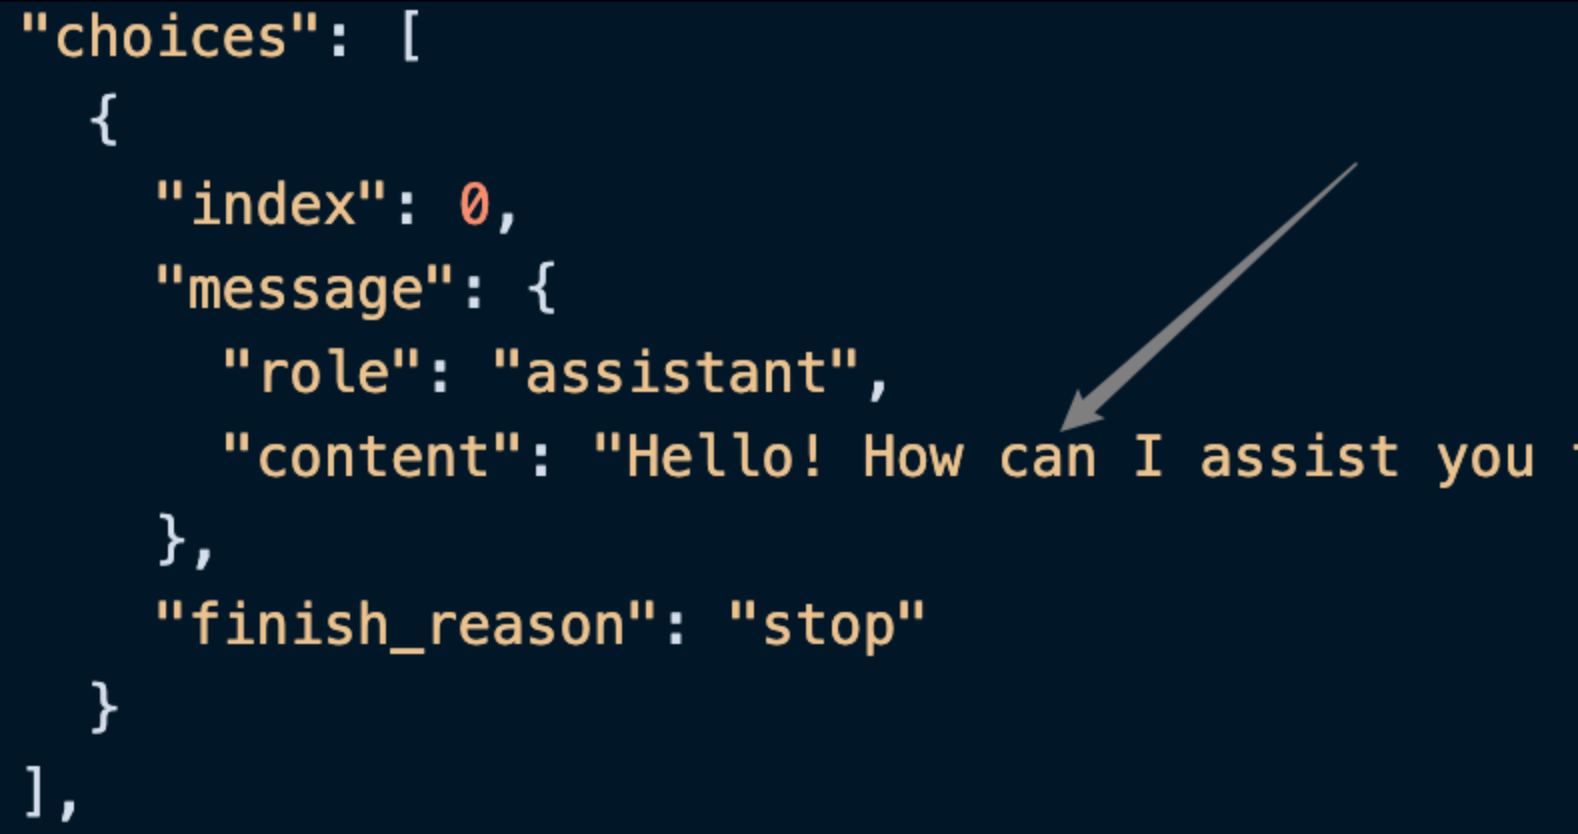
content w choices zawiera konkretną treść odpowiedzi ChatGPT.
Odpowiedź strumieniowa
Ten interfejs również obsługuje odpowiedzi strumieniowe, co jest bardzo przydatne przy integracji ze stronami internetowymi i może pozwolić stronie uzyskać efekt wyświetlania znak po znaku. Jeśli chcesz zwracać odpowiedź strumieniowo, możesz zmienić parametrstream w nagłówku żądania na true.
Modyfikacja jest pokazana na ilustracji, jednak kod wywołania musi zostać odpowiednio zmieniony, aby obsługiwać odpowiedź strumieniową.
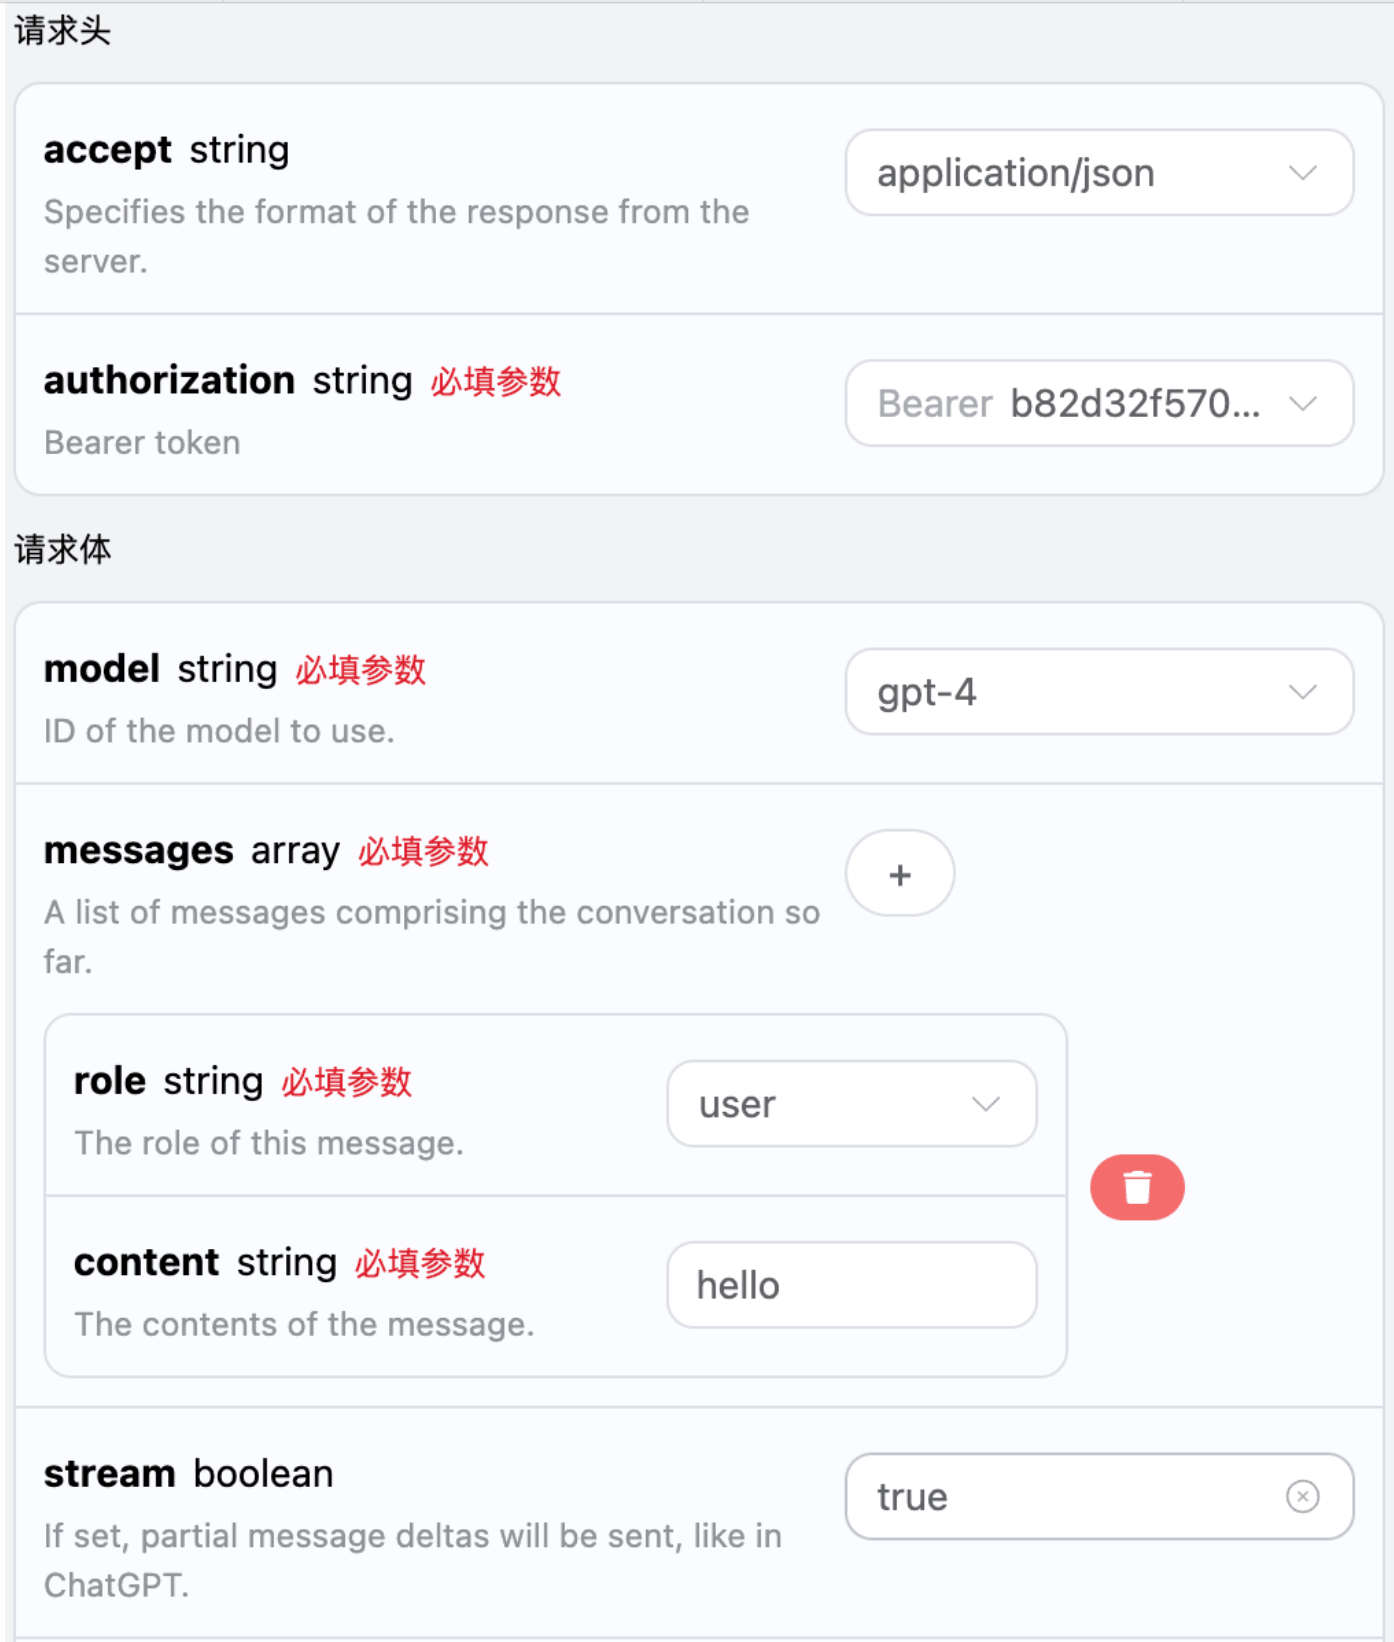
stream na true, API będzie zwracać odpowiednie dane JSON wiersz po wierszu, na poziomie kodu musimy wprowadzić odpowiednie modyfikacje, aby uzyskać wyniki wiersz po wierszu.
Przykładowy kod wywołania Python:
data, a choices w data to najnowsza treść odpowiedzi, zgodna z treścią przedstawioną powyżej. choices to nowo dodana treść odpowiedzi, którą można wykorzystać do integracji z własnym systemem. Jednocześnie zakończenie odpowiedzi strumieniowej jest określane na podstawie treści data; jeśli treść ma wartość [DONE], oznacza to, że odpowiedź strumieniowa została całkowicie zakończona. Zwracany wynik data zawiera wiele pól, które opisano poniżej:
id— ID wygenerowanego zadania tej rozmowy, używane do jednoznacznej identyfikacji tego zadania rozmowy.model— wybrany model z oficjalnej strony OpenAI ChatGPT.choices— informacje o odpowiedzi udzielonej przez ChatGPT na zapytanie.
Rozmowa wieloetapowa
Jeśli chcesz zintegrować funkcję rozmowy wieloetapowej, musisz przesłać wiele zapytań w polumessages; konkretny przykład wielu zapytań pokazano na poniższym obrazku:
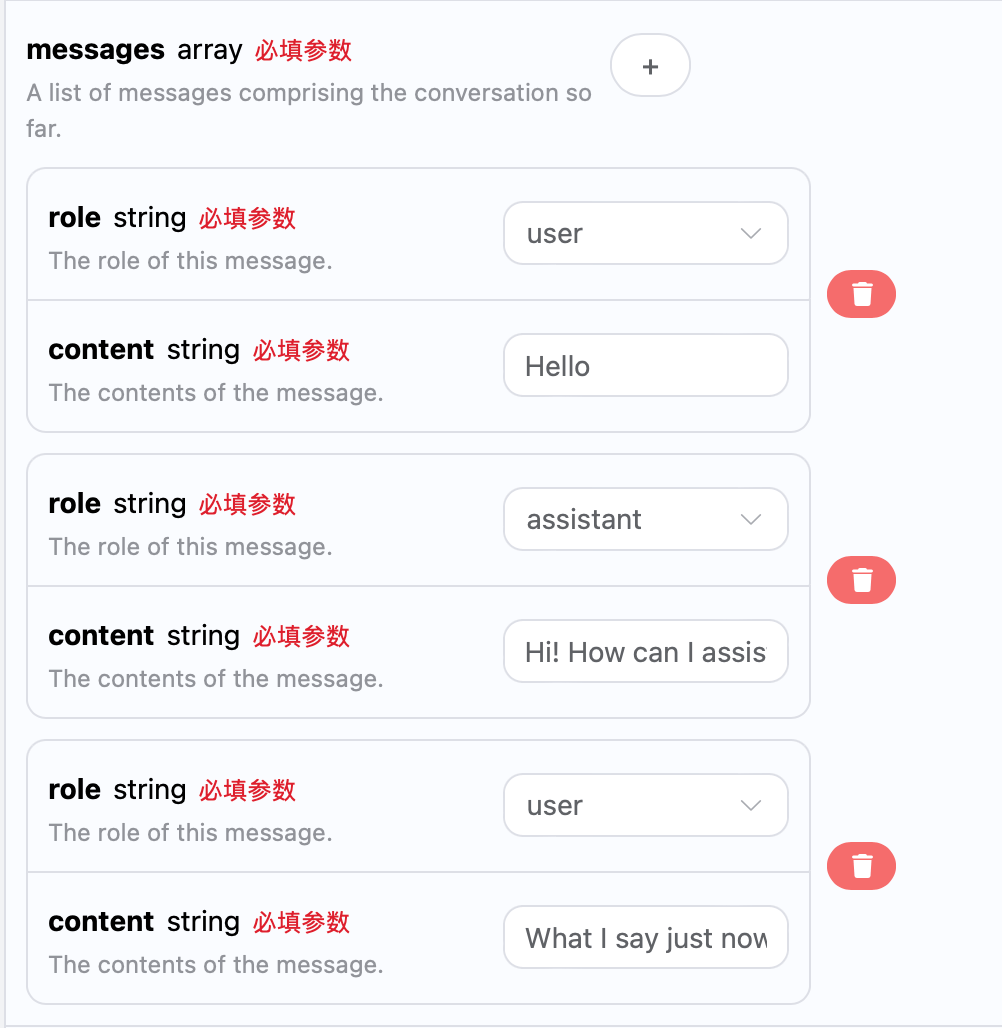
choices są zgodne z treścią podstawowego użycia; obejmuje to konkretną treść odpowiedzi ChatGPT na wiele rozmów, dzięki czemu można odpowiadać na odpowiednie pytania na podstawie treści wielu rozmów.
Integracja z OpenAI-Python
OpenAI Chat Completion API zachowuje kompatybilność z oficjalnym interfejsem OpenAI i może być bezpośrednio integrowane za pomocą oficjalnego SDK OpenAI-Python; w tym artykule krótko przedstawimy sposób użycia.- Najpierw należy skonfigurować lokalne środowisko
Python; ten proces można wyszukać w Google. - Pobierz i zainstaluj środowisko programistyczne, na przykład edytor VSCode.
- Skonfiguruj zmienne środowiskowe
OpenAI.
- W folderze projektu utwórz plik o nazwie
.envi zapisz go. - Zawartość pliku
.env:
sk-xxx własnym kluczem. OPENAI_BASE_URL to pośredniczący interfejs dostępu do OpenAI.
- Zainstaluj pakiet zależności projektu
- Utwórz przykładowy plik kodu źródłowego
index.py, którego konkretna zawartość jest następująca:
Model z dostępem do internetu
Modele gpt-3.5-browsing i gpt-4-browsing różnią się od innych modeli: mogą przeprowadzać wyszukiwanie w internecie na podstawie zapytania i zwracać odpowiednio dostosowane wyniki wyszukiwania internetowego. W tym artykule zademonstrujemy funkcję dostępu do internetu na konkretnym przykładzie. Następnie można wypełnić odpowiednią treść w interfejsie OpenAI Chat Completion API, jak pokazano na ilustracji: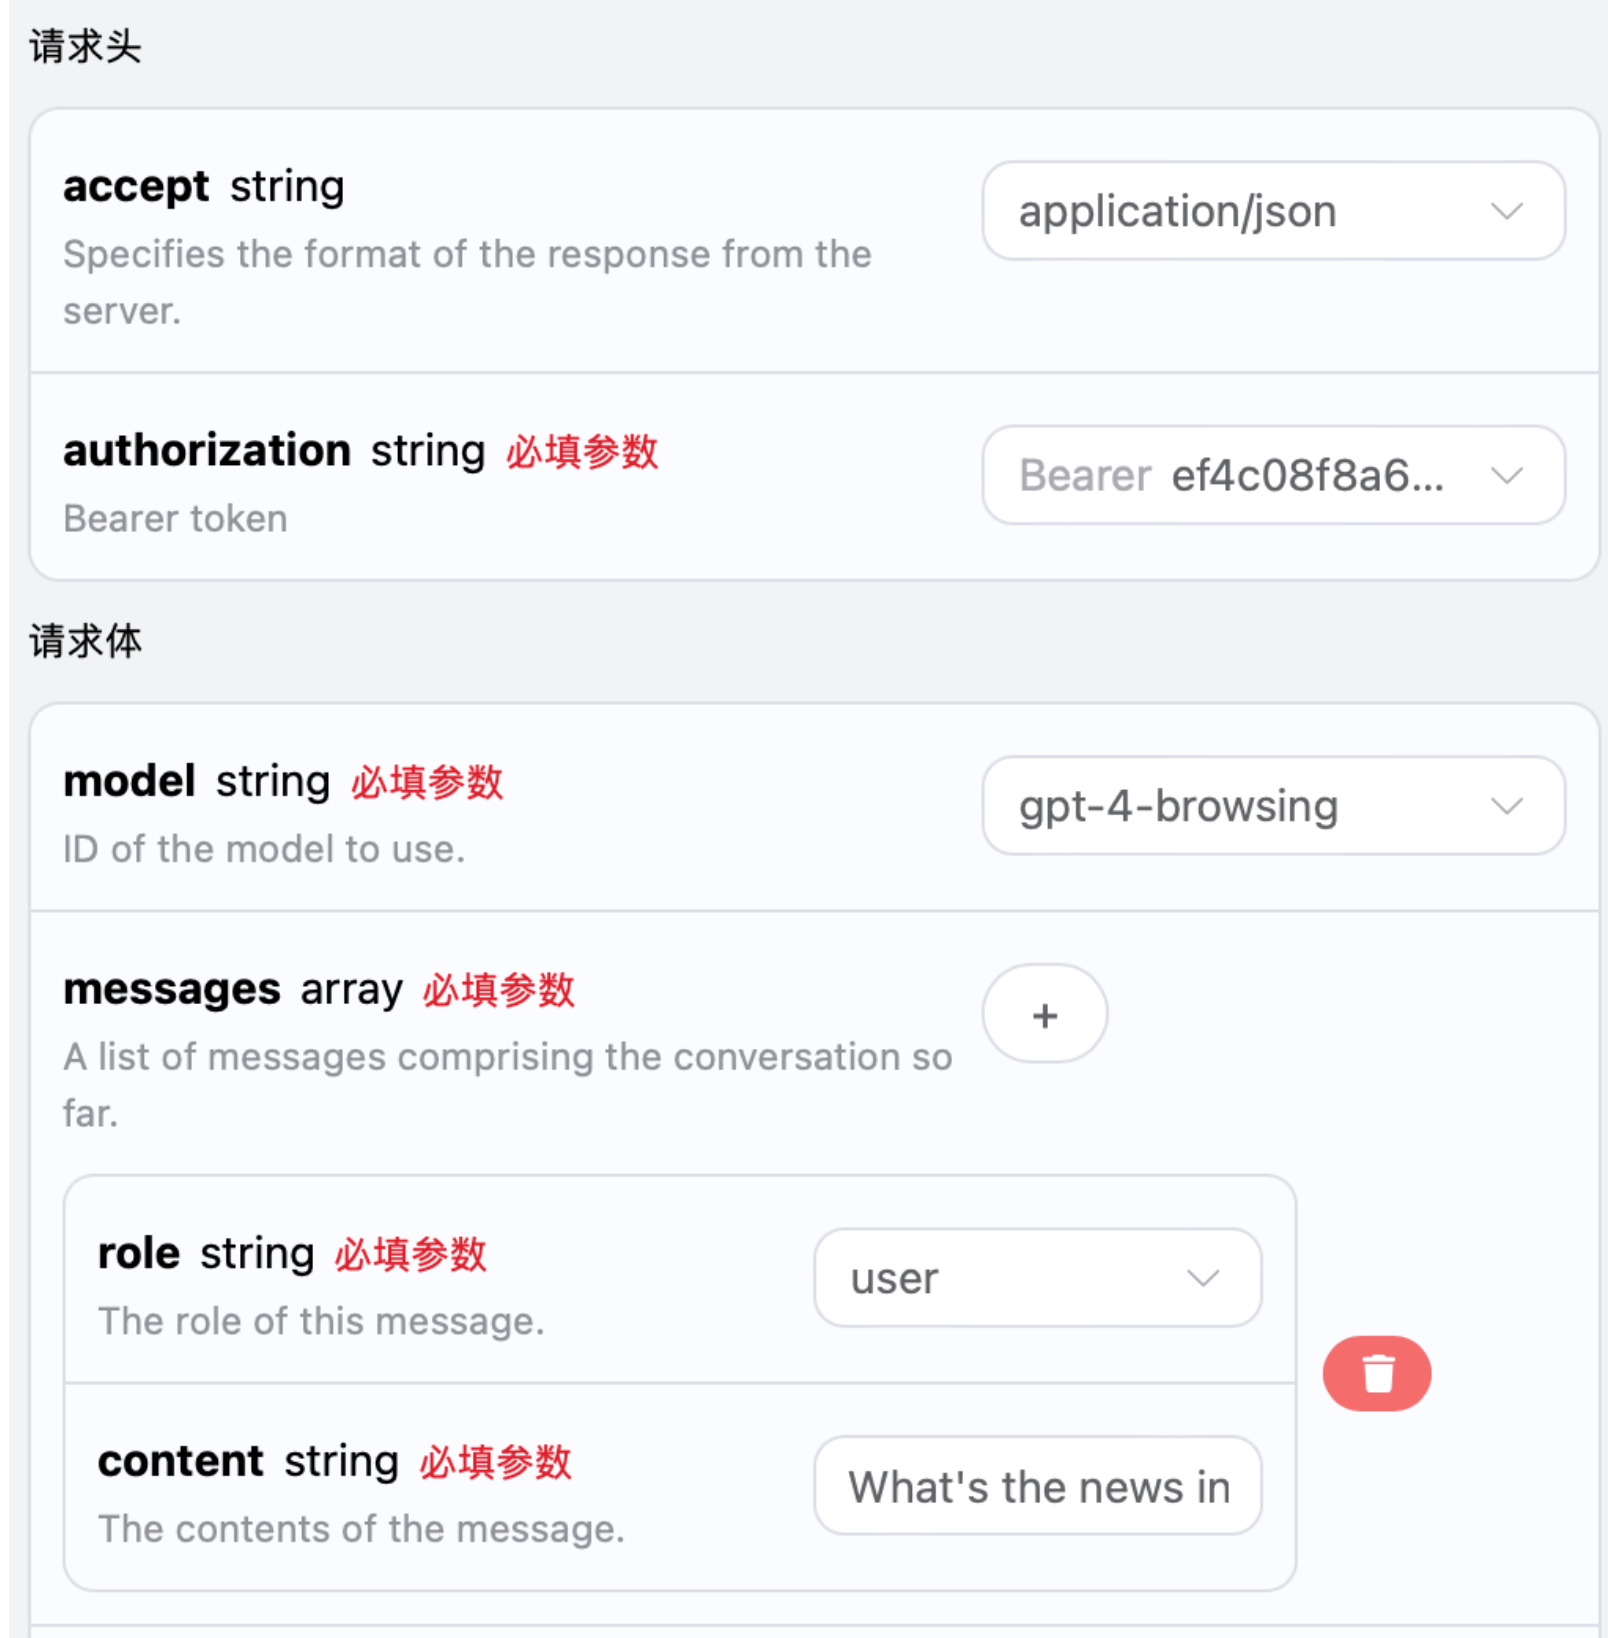
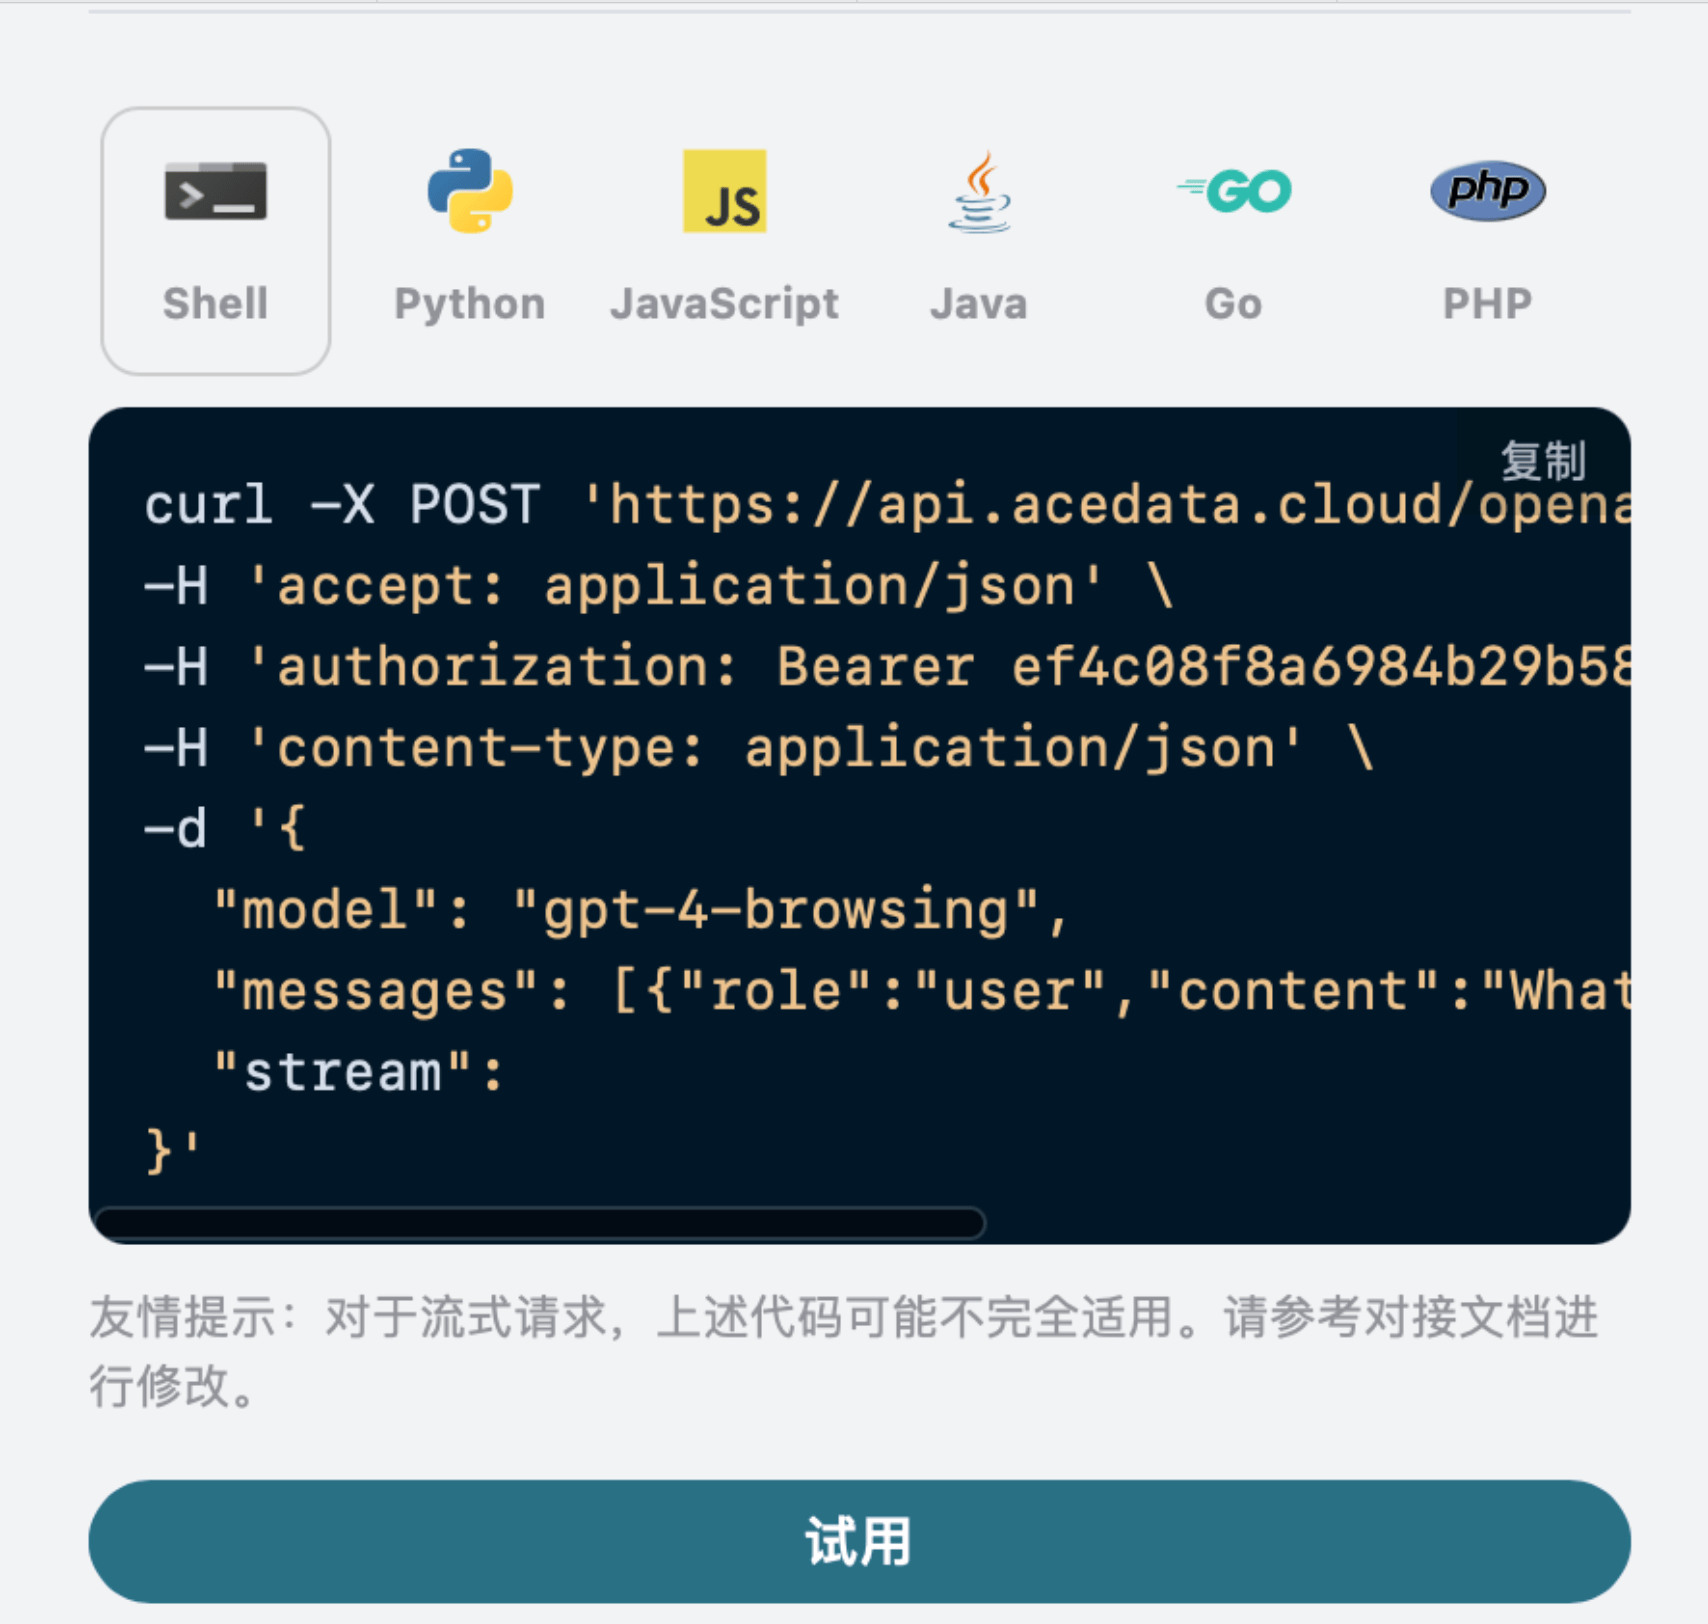
choices zostały uzyskane na podstawie wyszukiwania internetowego i zawierają także odpowiednie linki. Informacje odpowiedzi w choices należy renderować za pomocą składni markdown, aby uzyskać najlepsze doświadczenie; ostatecznie pokazuje to również potężną przewagę funkcji dostępu do internetu naszego modelu.
Model wizyjny
gpt-4o to wielomodalny duży model językowy opracowany przez OpenAI; na bazie GPT-4 dodano do niego zdolność rozumienia obrazu. Model ten może jednocześnie przetwarzać dane wejściowe tekstowe i obrazowe, realizując rozumienie oraz generowanie między modalnościami. Przetwarzanie tekstu przy użyciu modelu gpt-4o jest zgodne z opisanym powyżej podstawowym użyciem; poniżej krótko przedstawimy, jak używać możliwości przetwarzania obrazu przez model. Możliwość przetwarzania obrazu przez model gpt-4o jest używana głównie poprzez dodanie polatype do oryginalnej zawartości content; dzięki temu polu można określić, czy przesyłany jest tekst, czy obraz, a tym samym użyć możliwości przetwarzania obrazu modelu gpt-4o. Poniżej głównie opisano wywołanie tej funkcji na dwa sposoby: za pomocą Curl i Python.
- Metoda skryptu Curl
- Metoda skryptu Python
Model do generowania obrazów GPT-4o
Generowanie obrazu na podstawie obrazu referencyjnego
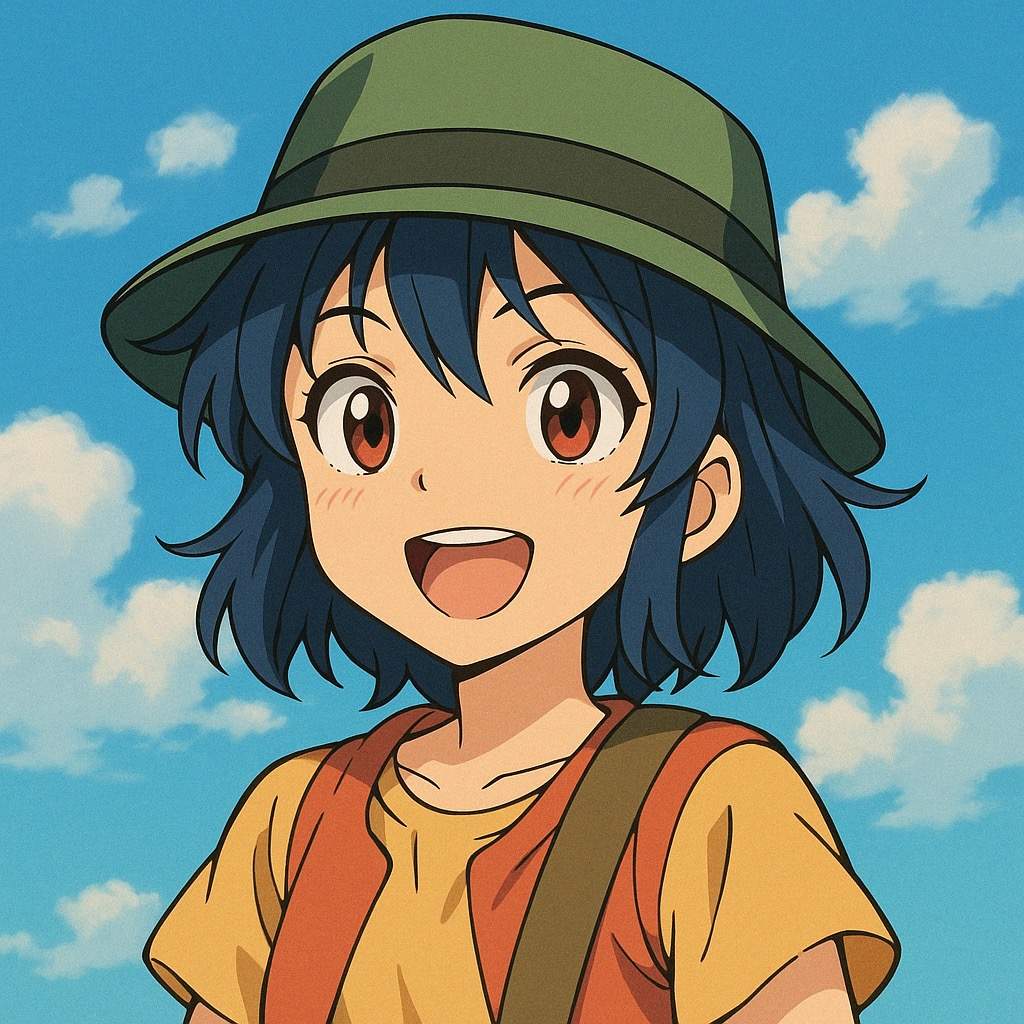
Poniżej znajduje się przykład generowania obrazu w niestandardowym stylu na podstawie obrazu. Najpierw spójrzmy na obraz, który wprowadzamy, jak pokazano poniżej: Można zauważyć, że obraz referencyjny jest zdjęciem prawdziwej osoby. Możemy zmienić jego styl, na przykład przekształcić go w obraz w stylu anime. Konkretny przykładowy request:
message.content w choices to kompletny wygenerowany wynik rozmowy, a obraz jest w nim zawarty w formacie Markdown (link do obrazu jest adresem tymczasowym, prosimy o jego szybkie pobranie i zapisanie). Można zauważyć, że wygenerowany obraz rzeczywiście jest w stylu anime, jak pokazano konkretnie na poniższym obrazie:
Generowanie obrazu wyłącznie na podstawie tekstu
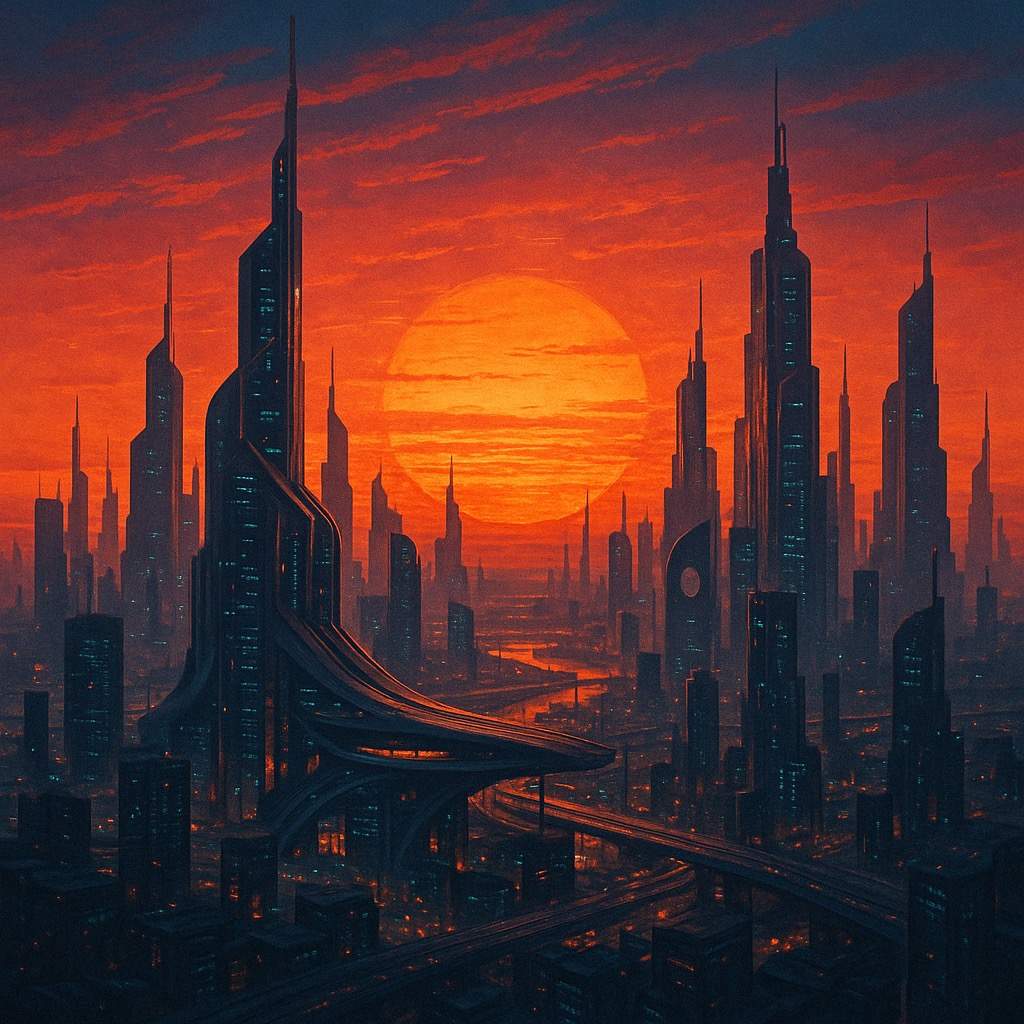
Możemy użyć promptu, aby wygenerował obraz i zwrócił go nam w formie wyniku konwersacyjnego. Poniżej używamyutwórz obraz zachodu słońca w futurystycznym mieście jako przykładu, a konkretny przykład jest następujący:
Generowanie jednego obrazu z wielu obrazów
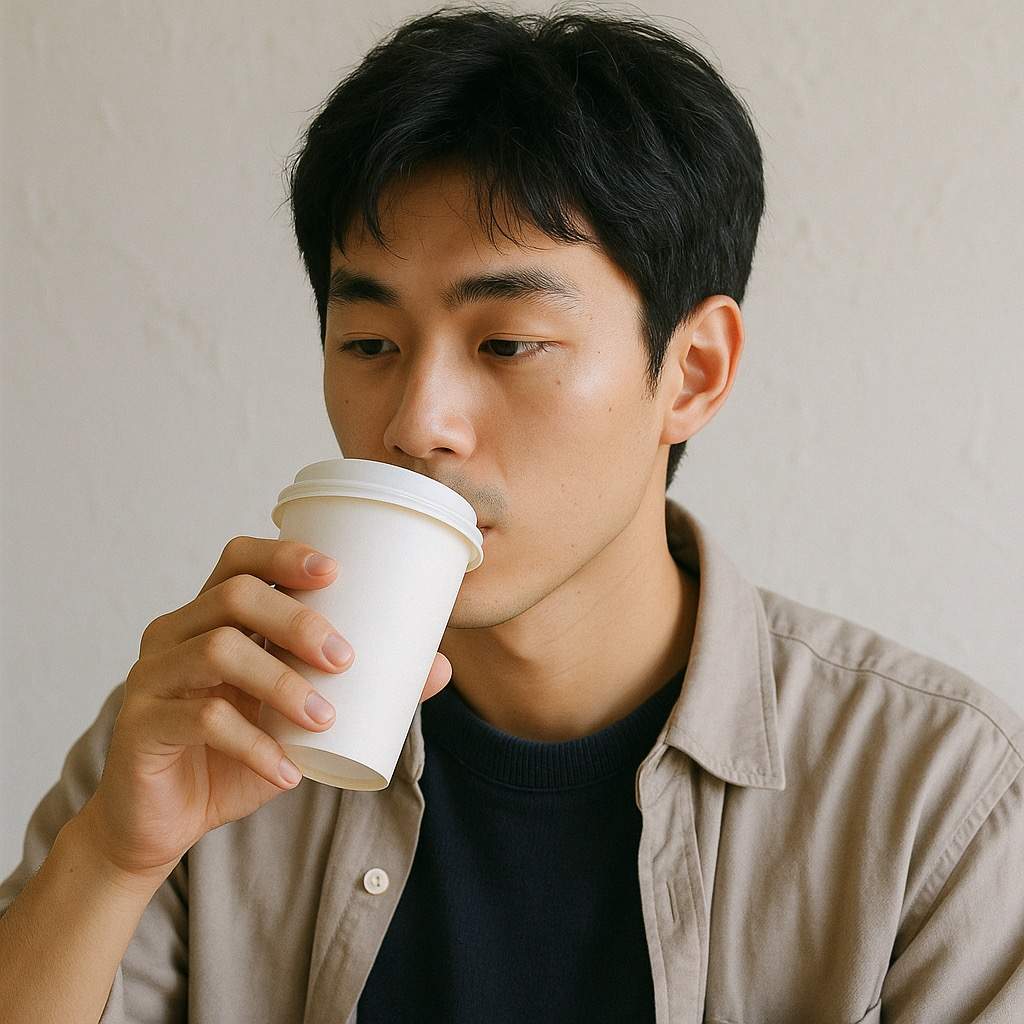
Możemy także użyć wielu obrazów referencyjnych do wygenerowania jednego obrazu, na przykład użyć zdjęcia przystojnego mężczyzny i kawy, aby za pomocą tych dwóch obrazów wygenerować obraz przystojnego mężczyzny pijącego kawę. Poniżej znajdują się konkretne obrazy referencyjne: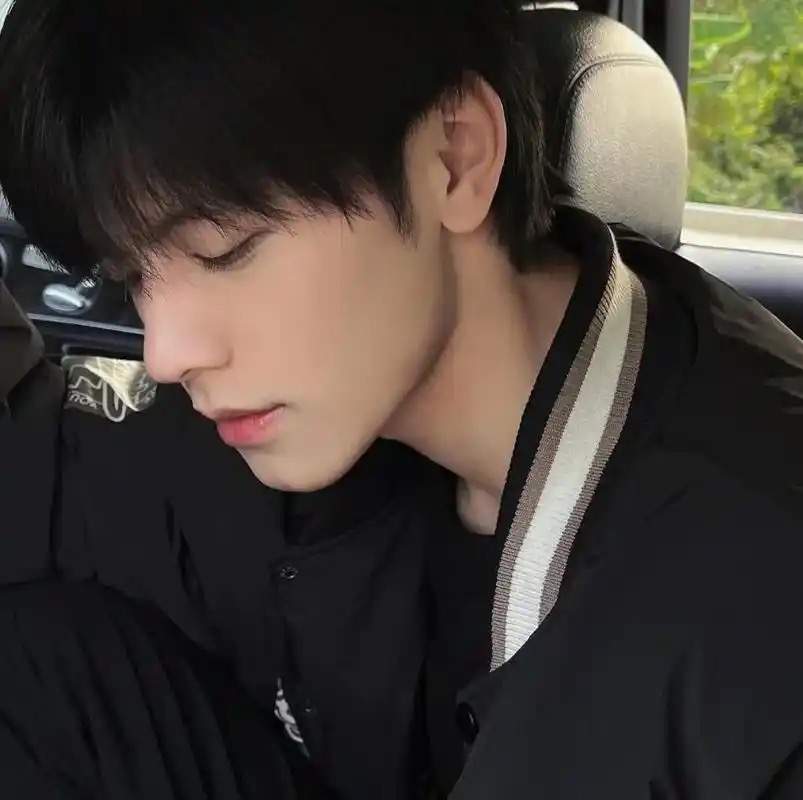
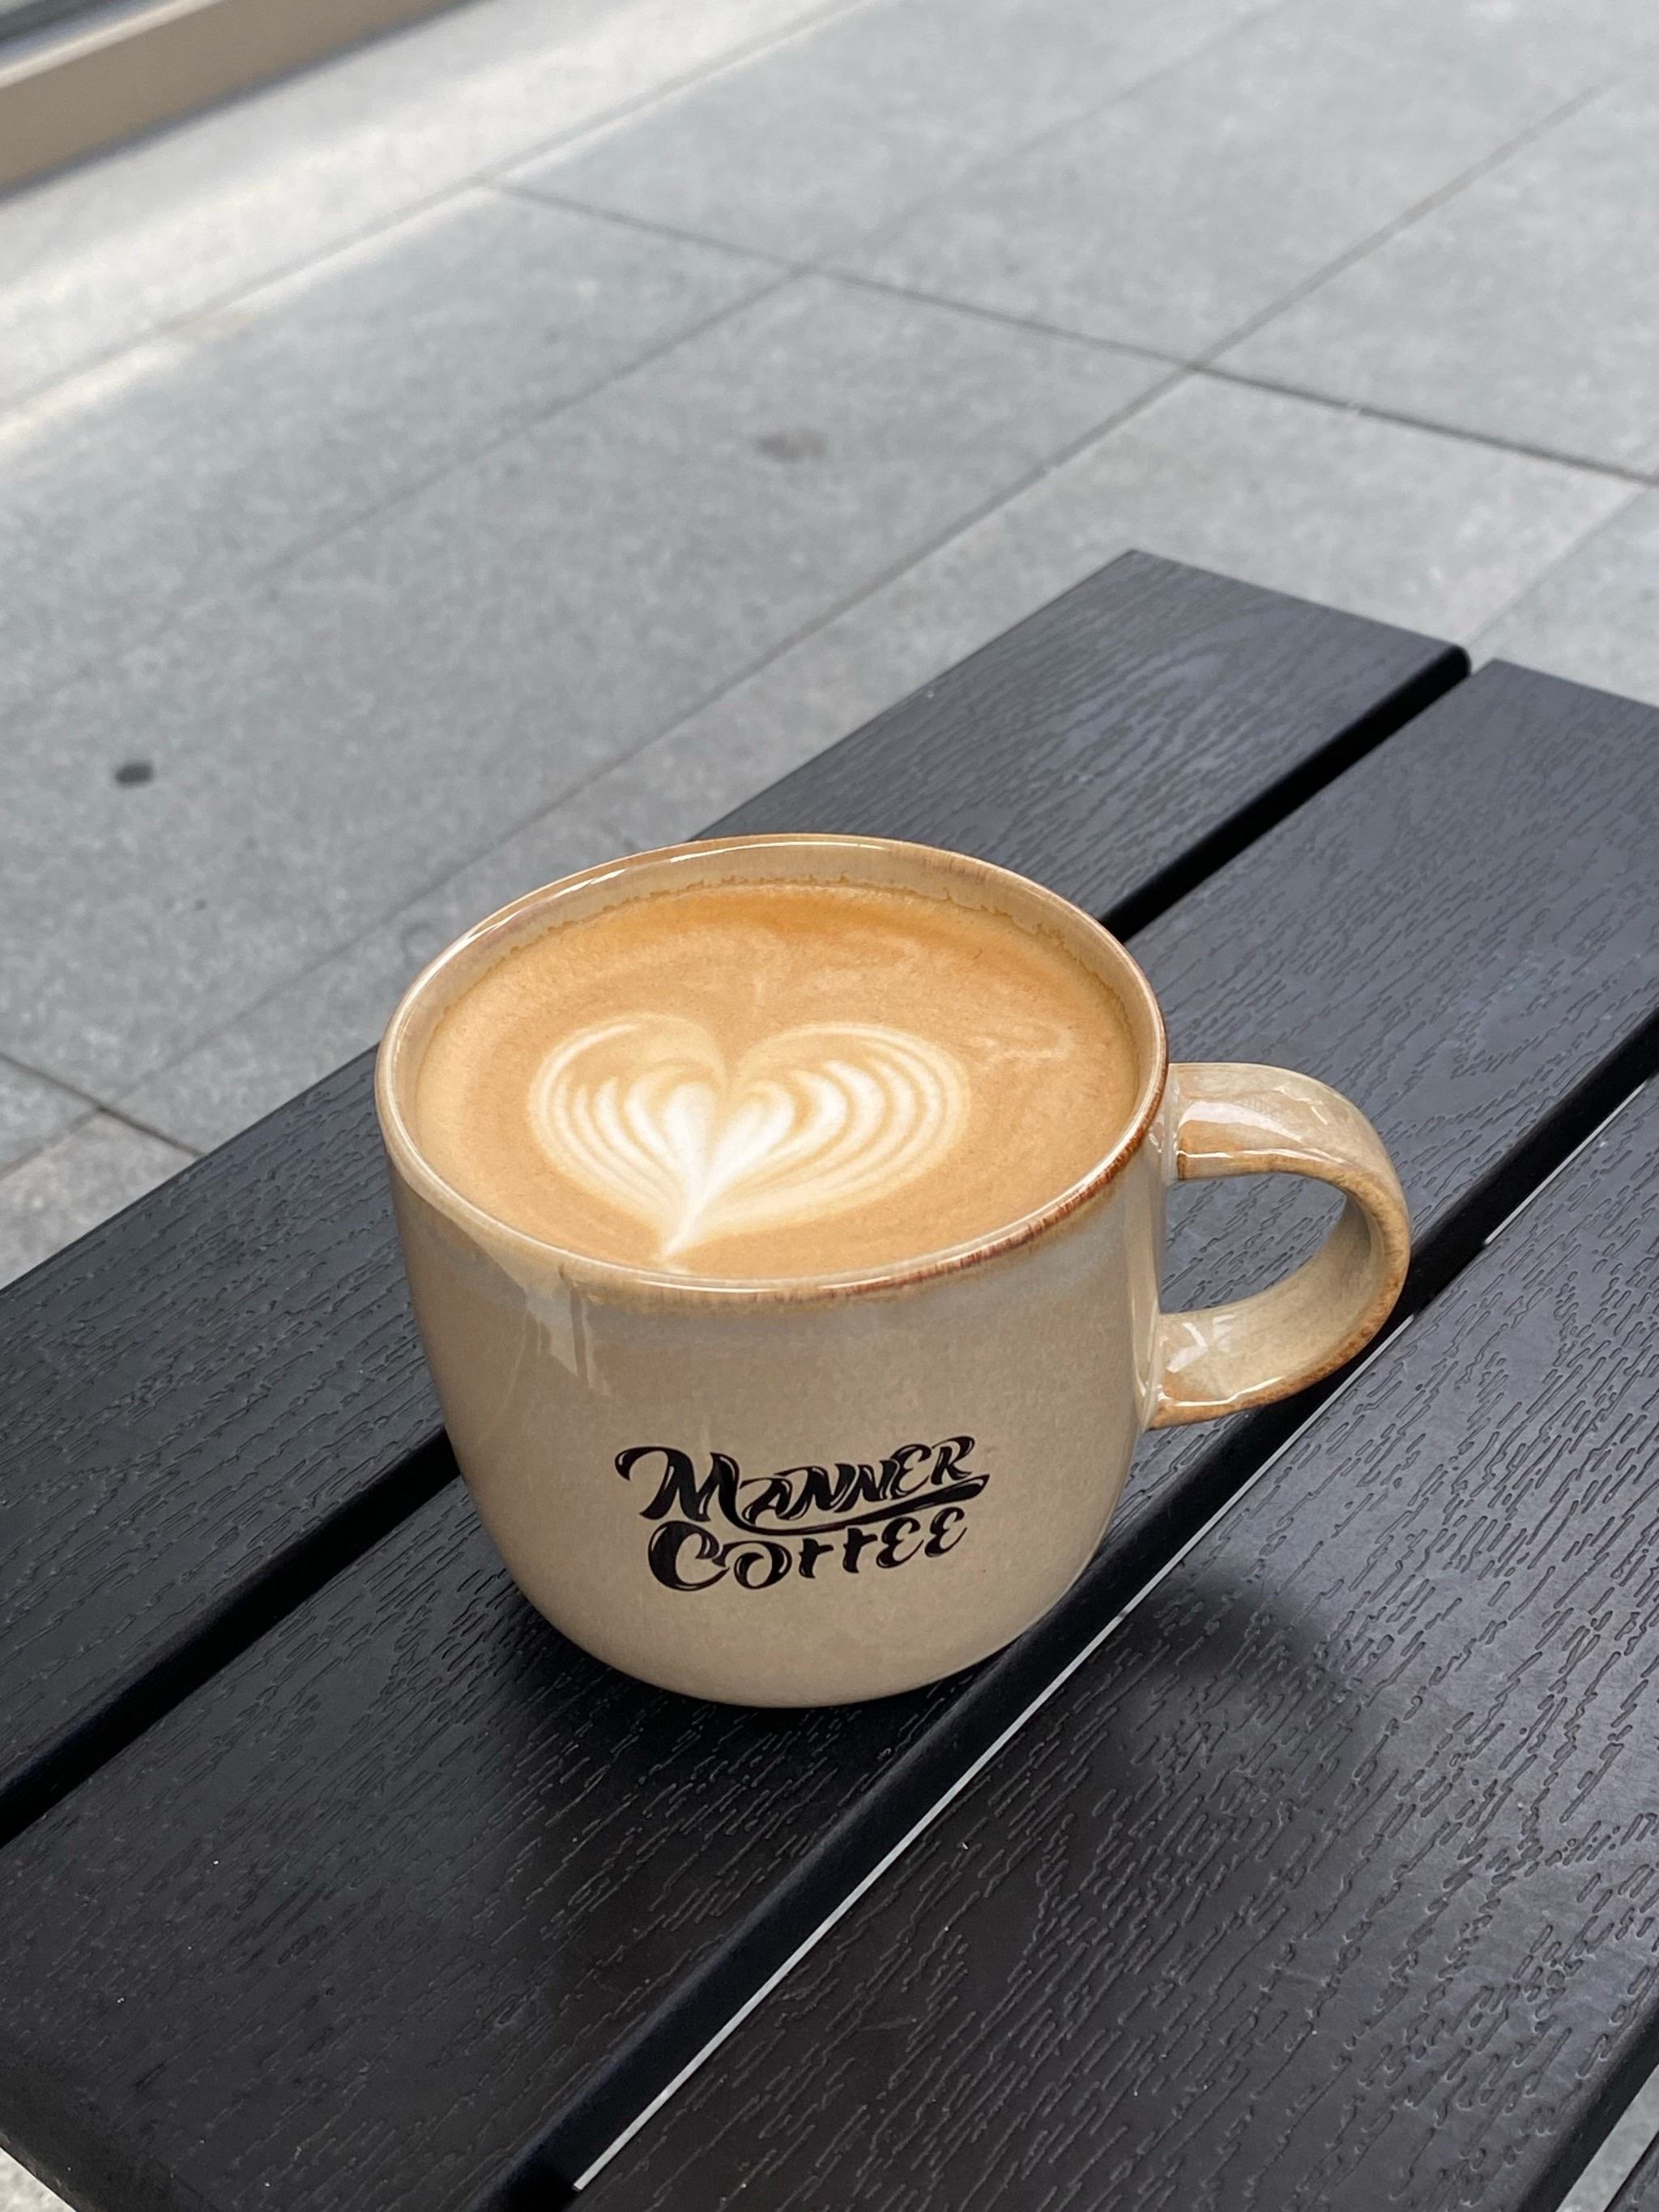
wygeneruj obraz mężczyzny trzymającego kawę i mającego zaraz ją wypić jako przykładu, a konkretny przykład jest następujący:
Obsługa błędów
Podczas wywoływania API, jeśli wystąpi błąd, API zwróci odpowiedni kod błędu i informację. Na przykład:400 token_mismatched:Nieprawidłowe żądanie, prawdopodobnie z powodu brakujących lub nieprawidłowych parametrów.400 api_not_implemented:Nieprawidłowe żądanie, prawdopodobnie z powodu brakujących lub nieprawidłowych parametrów.401 invalid_token:Brak autoryzacji, nieprawidłowy lub brakujący token autoryzacyjny.429 too_many_requests:Zbyt wiele żądań, przekroczono limit częstotliwości.500 api_error:Wewnętrzny błąd serwera, coś poszło nie tak na serwerze.