

GPT-6.1 Sol
Usemodel: "gpt-6.1-sol" para selecionar este modelo. Suporta saída em streaming, chamada de funções, saída estruturada e entrada de imagens. Durante a primeira semana de abertura, estará disponível apenas para detentores verificados de ACE T1+ (pelo menos 100.000 ACE) ou usuários autorizados; o horário específico de abertura está sujeito ao aviso de acesso no console.
Os níveis de raciocínio suportam low, medium, high, xhigh e max; none ou minimal ainda não são suportados. Recomenda-se começar com reasoning_effort: "low". Quando a entrada exceder 272.000 tokens, o preço de contexto longo será aplicado à solicitação inteira; as taxas estão sujeitas ao preço atual no console.
Processo de solicitação
Para usar a API OpenAI Chat Completion, primeiro acesse o Console Ace Data Cloud para obter seu API Token e guarde-o para uso posterior. Se você ainda não estiver conectado ou registrado, será automaticamente redirecionado para a página de login, onde será convidado a se registrar e entrar; após concluir, retornará automaticamente à página atual.
Um único API Token pode chamar todos os serviços da plataforma, sem necessidade de solicitar separadamente para cada serviço. Na primeira solicitação, será concedida uma cota gratuita para experimentação; quando a cota for insuficiente, você poderá recarregar o saldo universal no console.
📘 Documentação completa: OpenAI Chat Completion API →
Uso básico
Em seguida, você pode preencher o conteúdo correspondente na interface, como mostrado na imagem: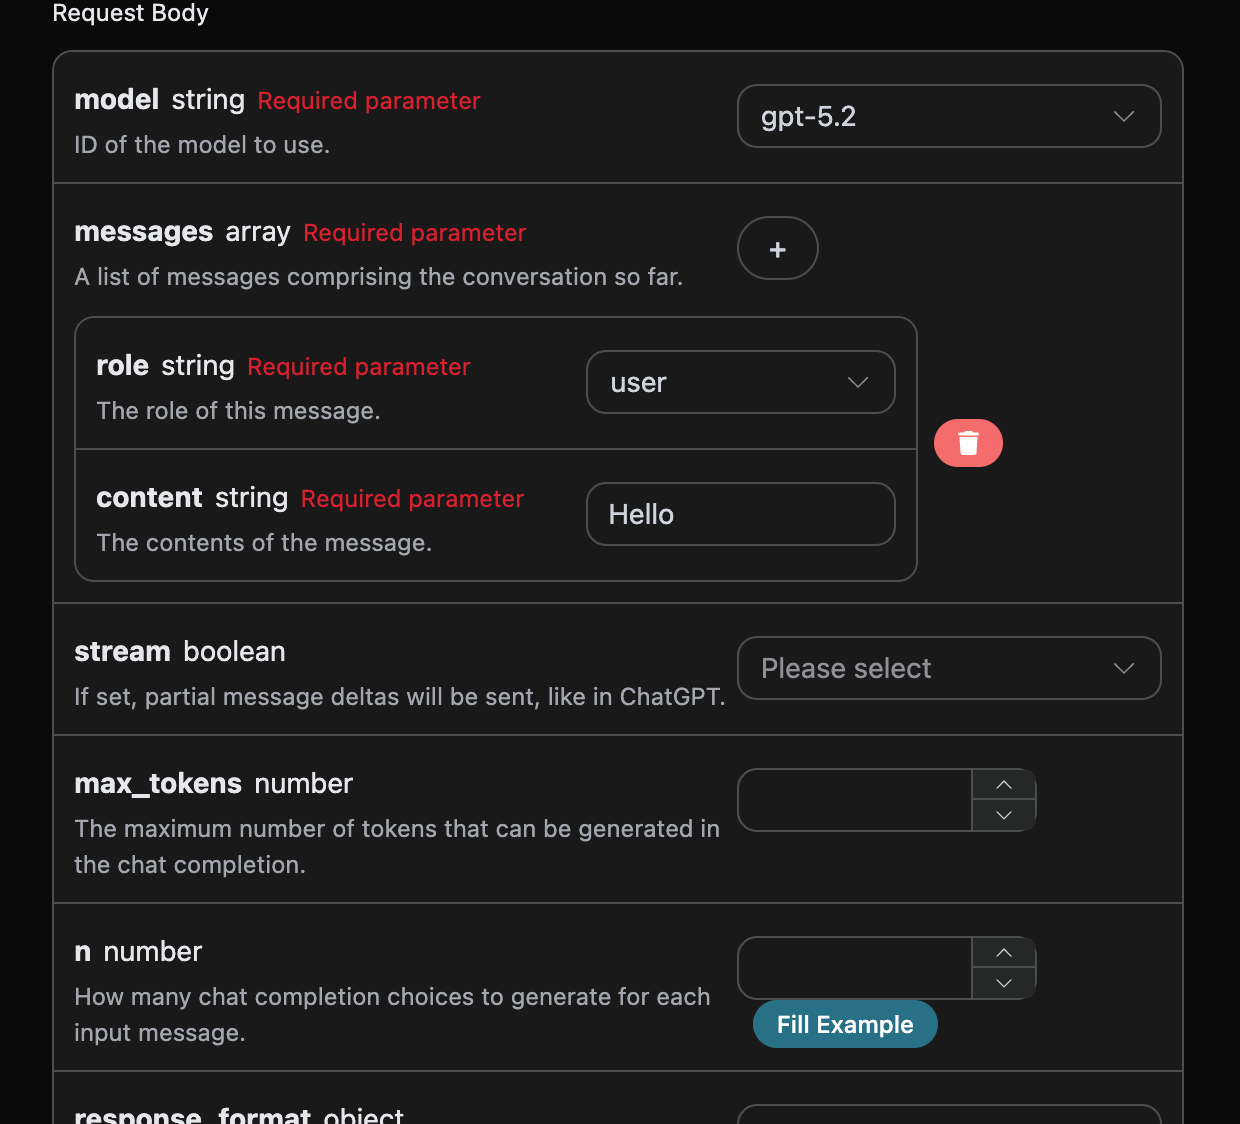
authorization, que pode ser selecionado diretamente na lista suspensa. Outro parâmetro é model; model é a categoria de modelo do site oficial OpenAI ChatGPT que escolhemos usar. Aqui, temos principalmente 20 modelos, e você pode consultar os modelos que fornecemos para mais detalhes. O último parâmetro é messages; messages é o array de prompts que inserimos. Ele é um array, indicando que vários prompts podem ser enviados ao mesmo tempo. Cada prompt contém role e content, onde role representa o papel do solicitante. Fornecemos três identidades: user, assistant e system. O outro, content, é o conteúdo específico da nossa pergunta.
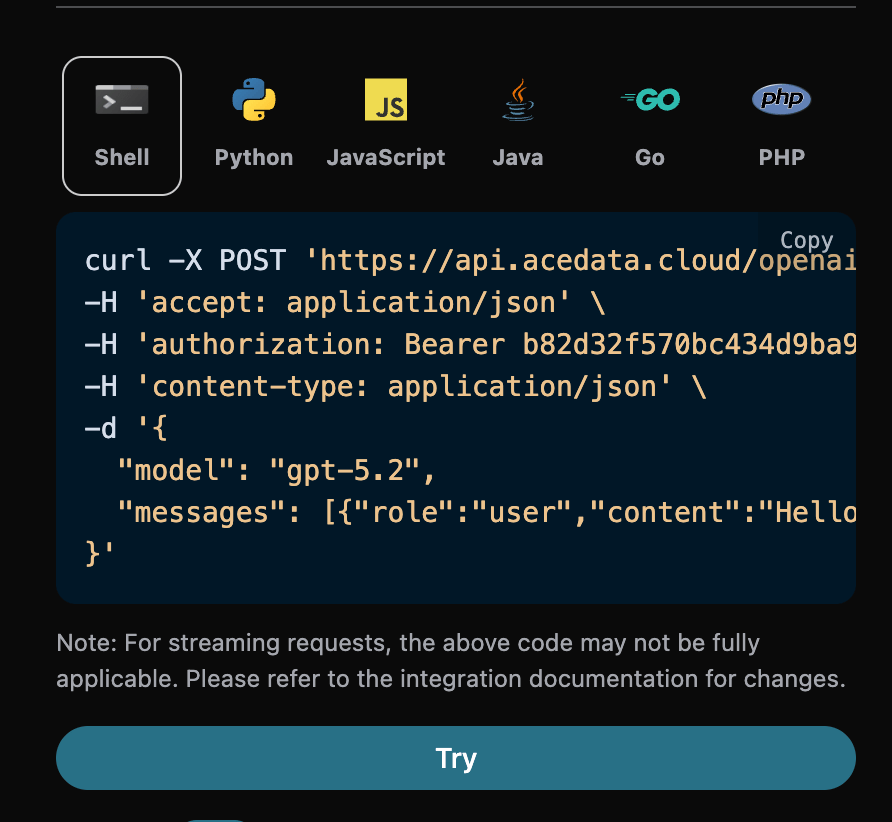
Ao mesmo tempo, você pode observar que há a geração do código de chamada correspondente no lado direito. Você pode copiar o código e executá-lo diretamente, ou clicar diretamente no botão 「Try」 para testar.
Parâmetros opcionais comuns:
max_tokens: limita o número máximo de tokens em uma única resposta.temperature: aleatoriedade da geração, entre 0 e 2; quanto maior o valor, mais divergente.n: quantas respostas candidatas gerar de uma vez.response_format: configuração do formato de retorno.
id, o ID gerado desta tarefa de conversa, usado para identificar exclusivamente esta tarefa de conversa.model, o modelo do site oficial OpenAI ChatGPT selecionado.choices, as informações de resposta fornecidas pelo ChatGPT para o prompt.usage: informações estatísticas sobre tokens para esta sessão de perguntas e respostas.
choices contém as informações de resposta do ChatGPT, e o choices dentro dele é o ChatGPT, como pode ser visto na imagem.
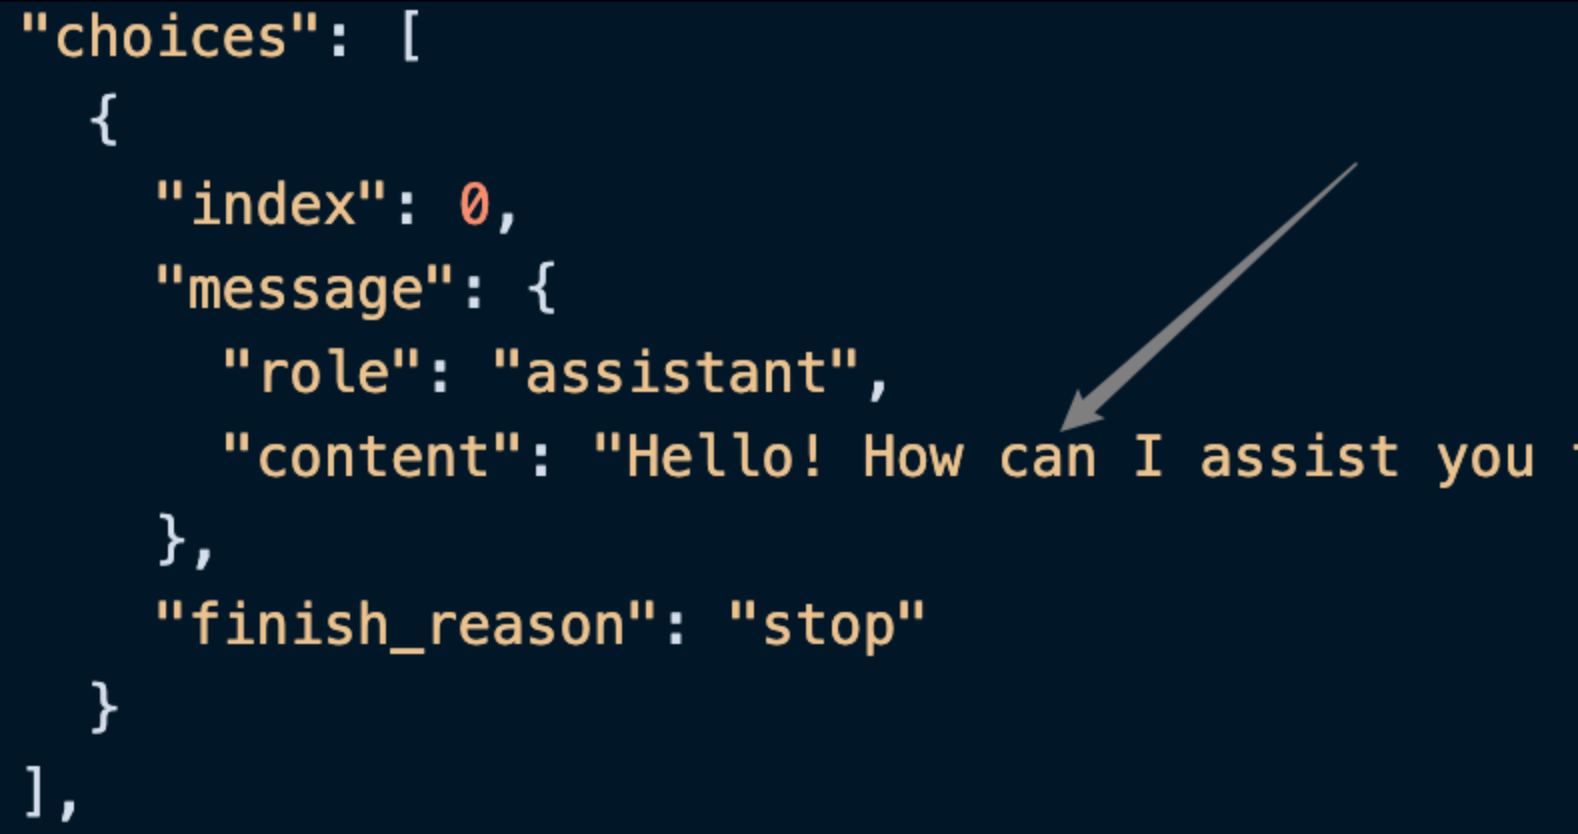
content dentro de choices contém o conteúdo específico da resposta do ChatGPT.
Resposta em streaming
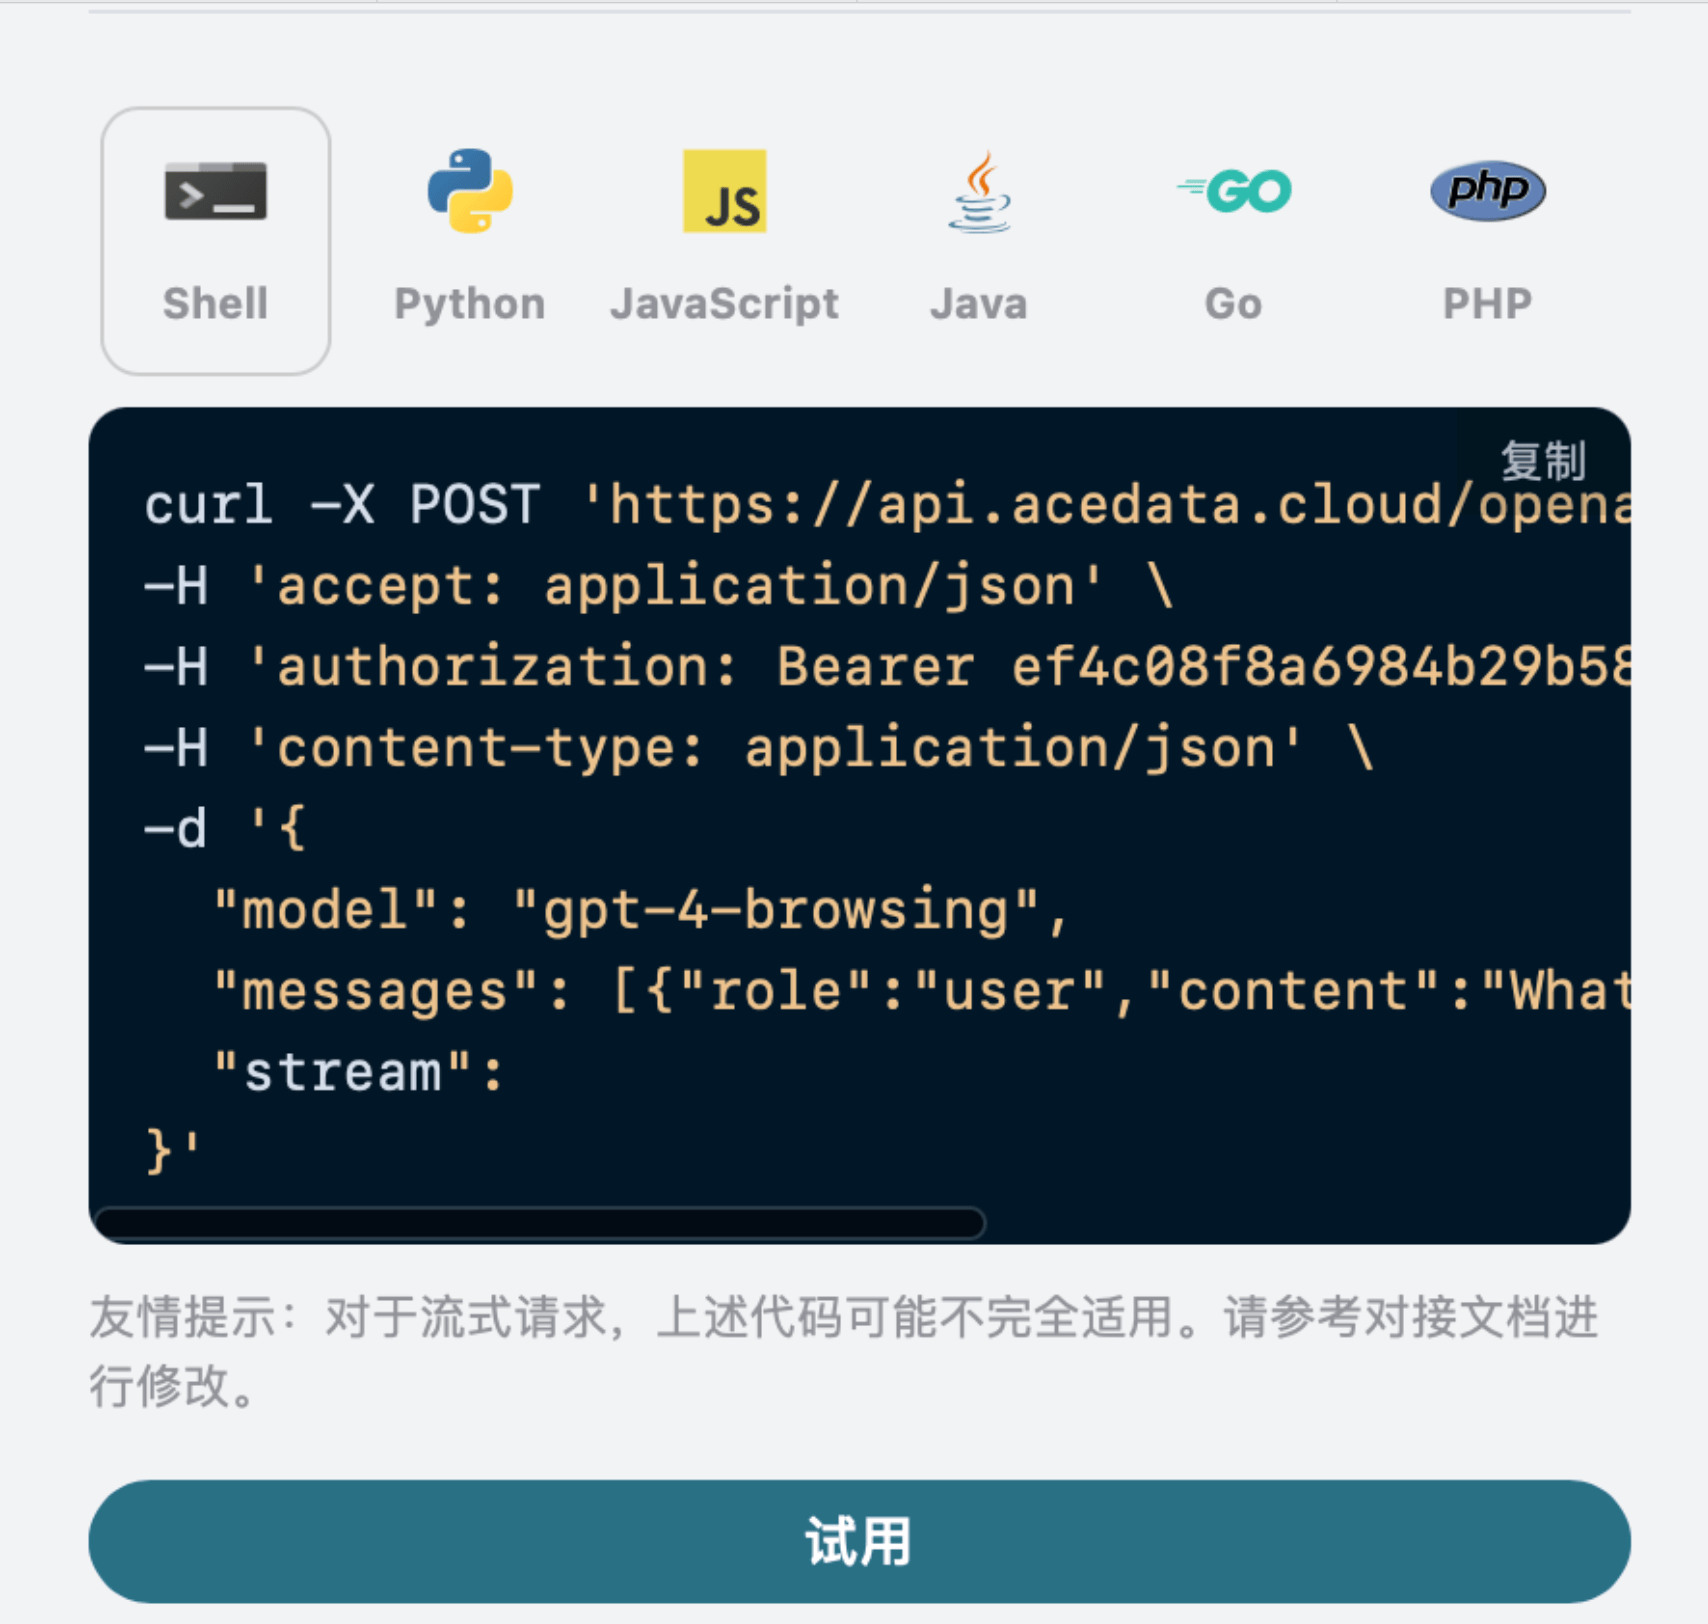
Esta interface também oferece suporte a respostas em streaming, o que é muito útil para integração com páginas web, permitindo que a página web implemente um efeito de exibição palavra por palavra. Se desejar retornar respostas em streaming, você pode alterar o parâmetrostream no cabeçalho da solicitação para true.
A modificação é mostrada na imagem; no entanto, o código de chamada precisa ter as alterações correspondentes para oferecer suporte a respostas em streaming.
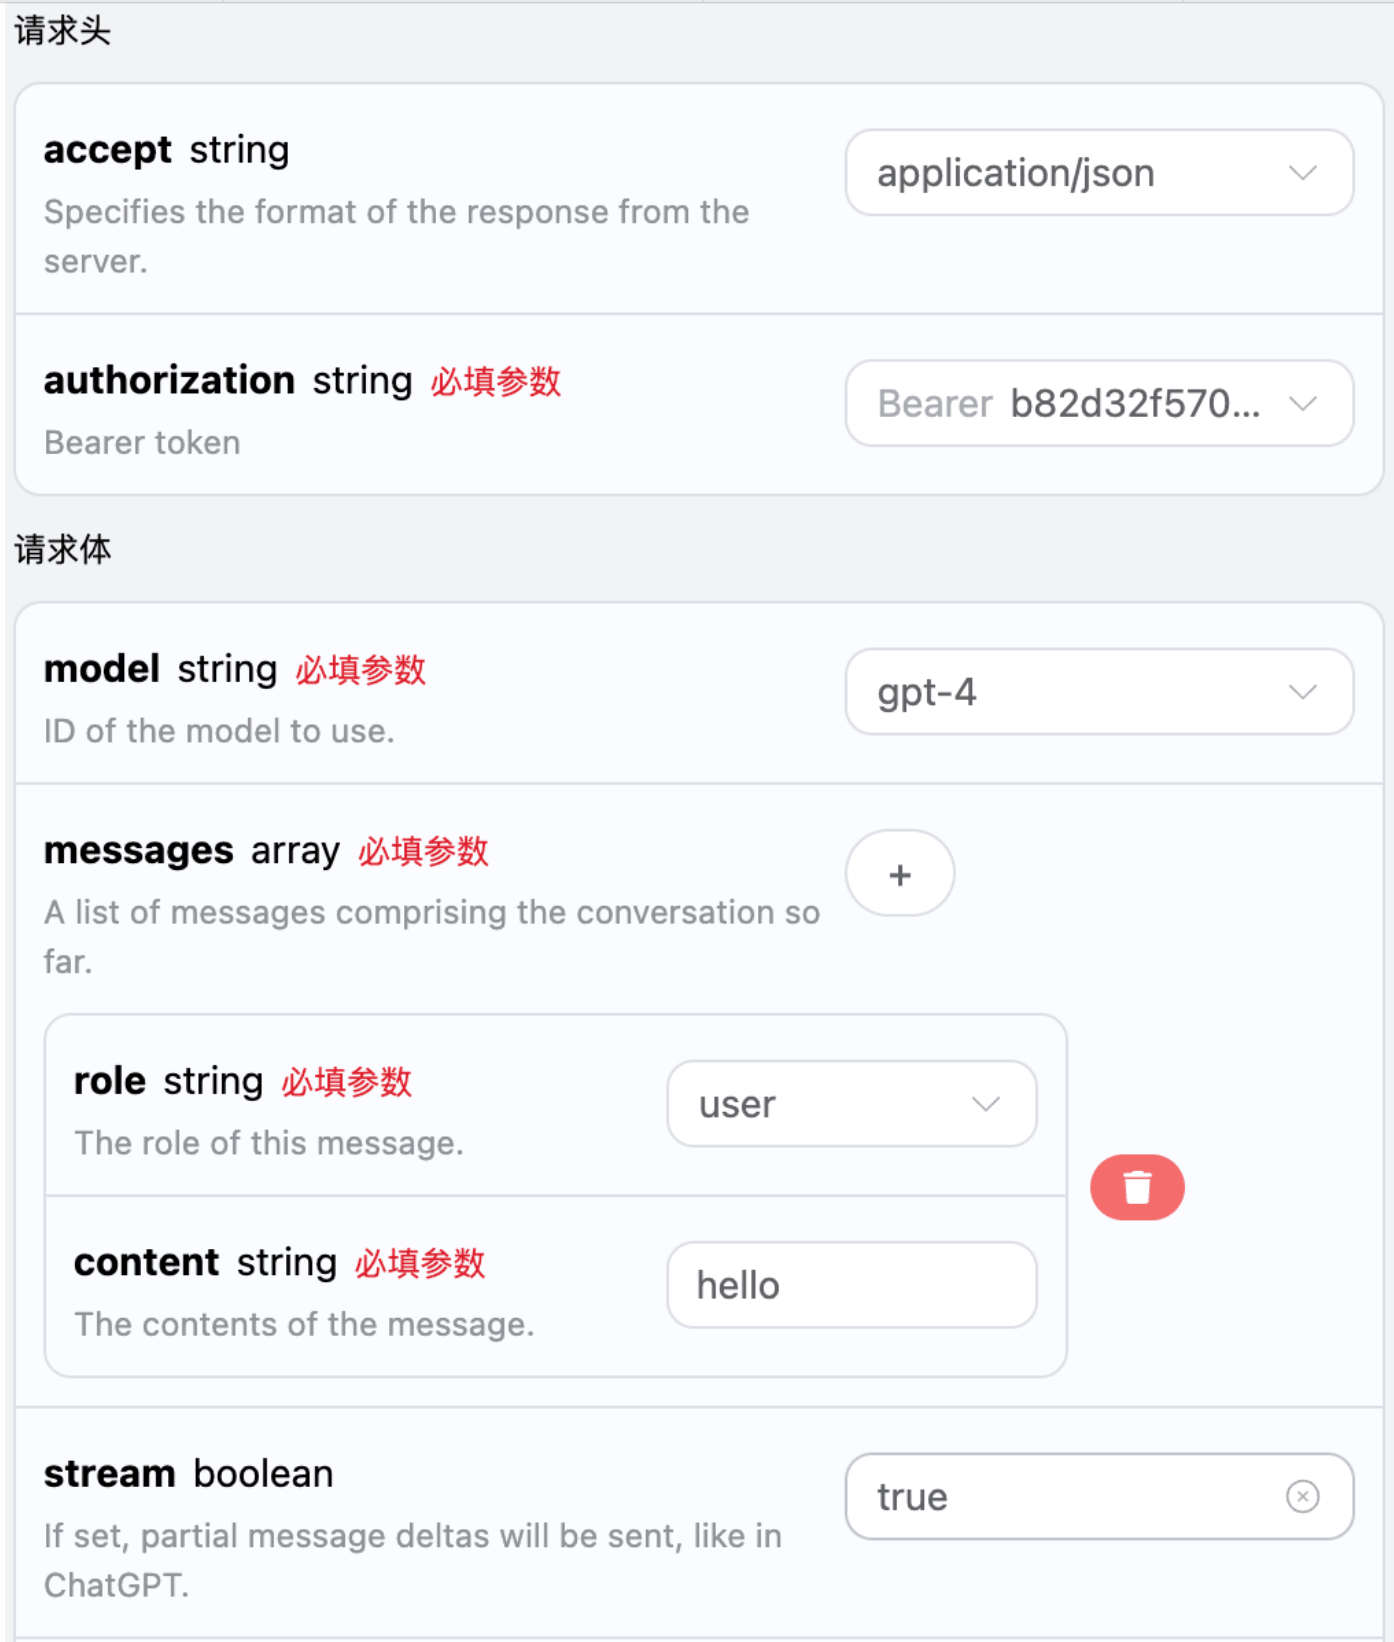
stream para true, a API retornará os dados JSON correspondentes linha por linha. No nível do código, precisamos fazer as modificações correspondentes para obter os resultados linha por linha.
Código de chamada de exemplo em Python:
data na resposta, e os choices dentro de data são o conteúdo mais recente da resposta, consistente com o conteúdo apresentado acima. choices é o novo conteúdo da resposta, e você pode integrá-lo ao seu sistema de acordo com o resultado. Ao mesmo tempo, o fim da resposta em fluxo é determinado com base no conteúdo de data; se o conteúdo for [DONE], isso indica que a resposta em fluxo foi completamente finalizada. O resultado data retornado possui vários campos, apresentados a seguir:
id, o ID da tarefa desta conversa gerada, usado para identificar exclusivamente esta tarefa de conversa.model, o modelo selecionado no site oficial do OpenAI ChatGPT.choices, as informações de resposta fornecidas pelo ChatGPT para a pergunta.
Conversa com múltiplas rodadas
Se você quiser integrar a funcionalidade de conversa com múltiplas rodadas, será necessário enviar várias perguntas no campomessages; um exemplo específico de várias perguntas é mostrado na imagem abaixo:
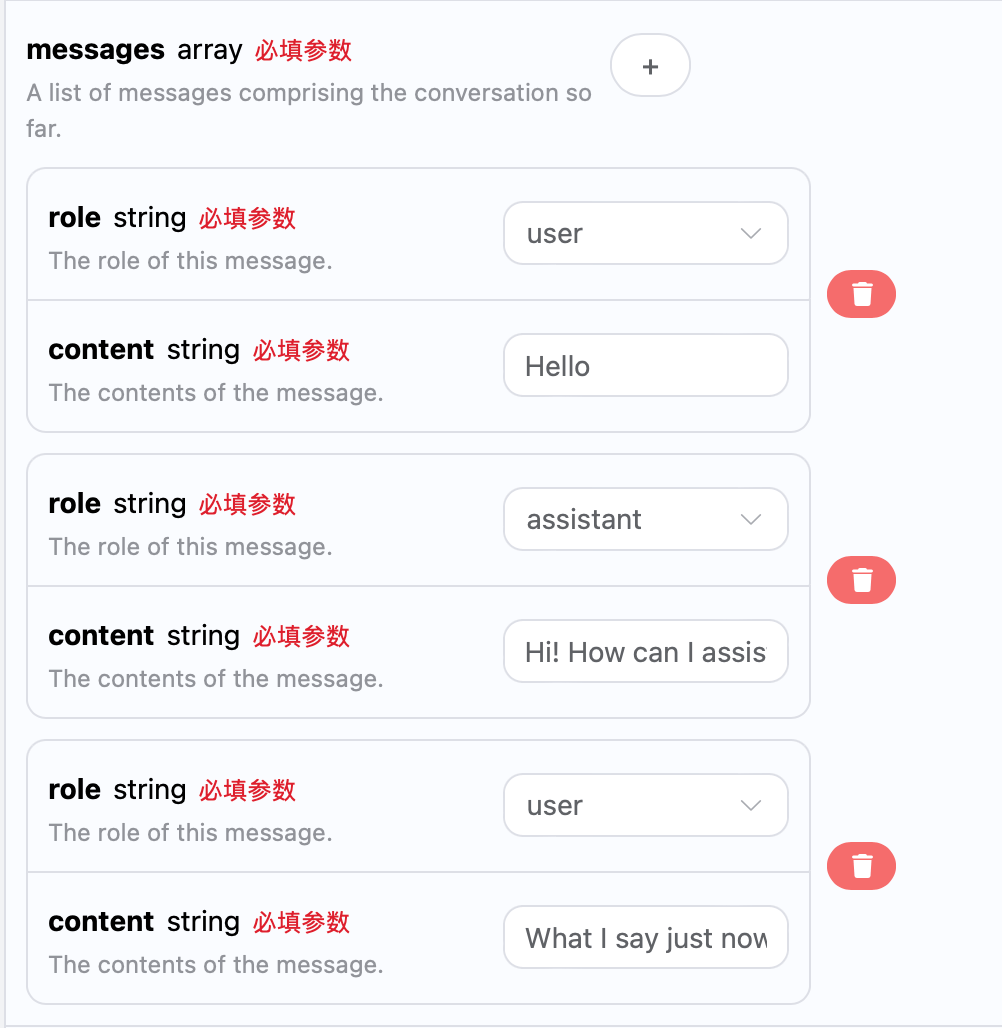
choices são consistentes com o conteúdo do uso básico, e isso contém o conteúdo específico da resposta do ChatGPT para várias conversas, permitindo assim responder às perguntas correspondentes com base em vários conteúdos de conversa.
Integração com OpenAI-Python
A API OpenAI Chat Completion mantém compatibilidade com a interface oficial da OpenAI, sendo possível integrar diretamente usando o SDK oficial OpenAI-Python. Este artigo apresentará brevemente a forma de uso.- Primeiro, é necessário configurar um ambiente local de
Python; esse processo pode ser pesquisado no Google. - Baixe e instale o ambiente de desenvolvimento, por exemplo, o editor VSCode.
- Configure as variáveis de ambiente da
OpenAI.
- Na pasta do projeto, crie e salve um arquivo chamado
.env - Conteúdo do arquivo
.env:
sk-xxx pela sua própria chave. OPENAI_BASE_URL é a interface de proxy para acessar a OpenAI.
- Instale os pacotes de dependência do projeto
- Crie um arquivo de código-fonte de exemplo
index.py, cujo conteúdo específico é o seguinte:
Modelos com acesso à internet
Os modelos gpt-3.5-browsing e gpt-4-browsing são diferentes dos outros modelos: eles podem realizar pesquisas na internet com base nas palavras de consulta e retornar os resultados da pesquisa na internet com os ajustes apropriados. Este artigo demonstrará a funcionalidade de acesso à internet por meio de um exemplo específico. Em seguida, é possível preencher o conteúdo correspondente na interface da API OpenAI Chat Completion, como mostrado na imagem: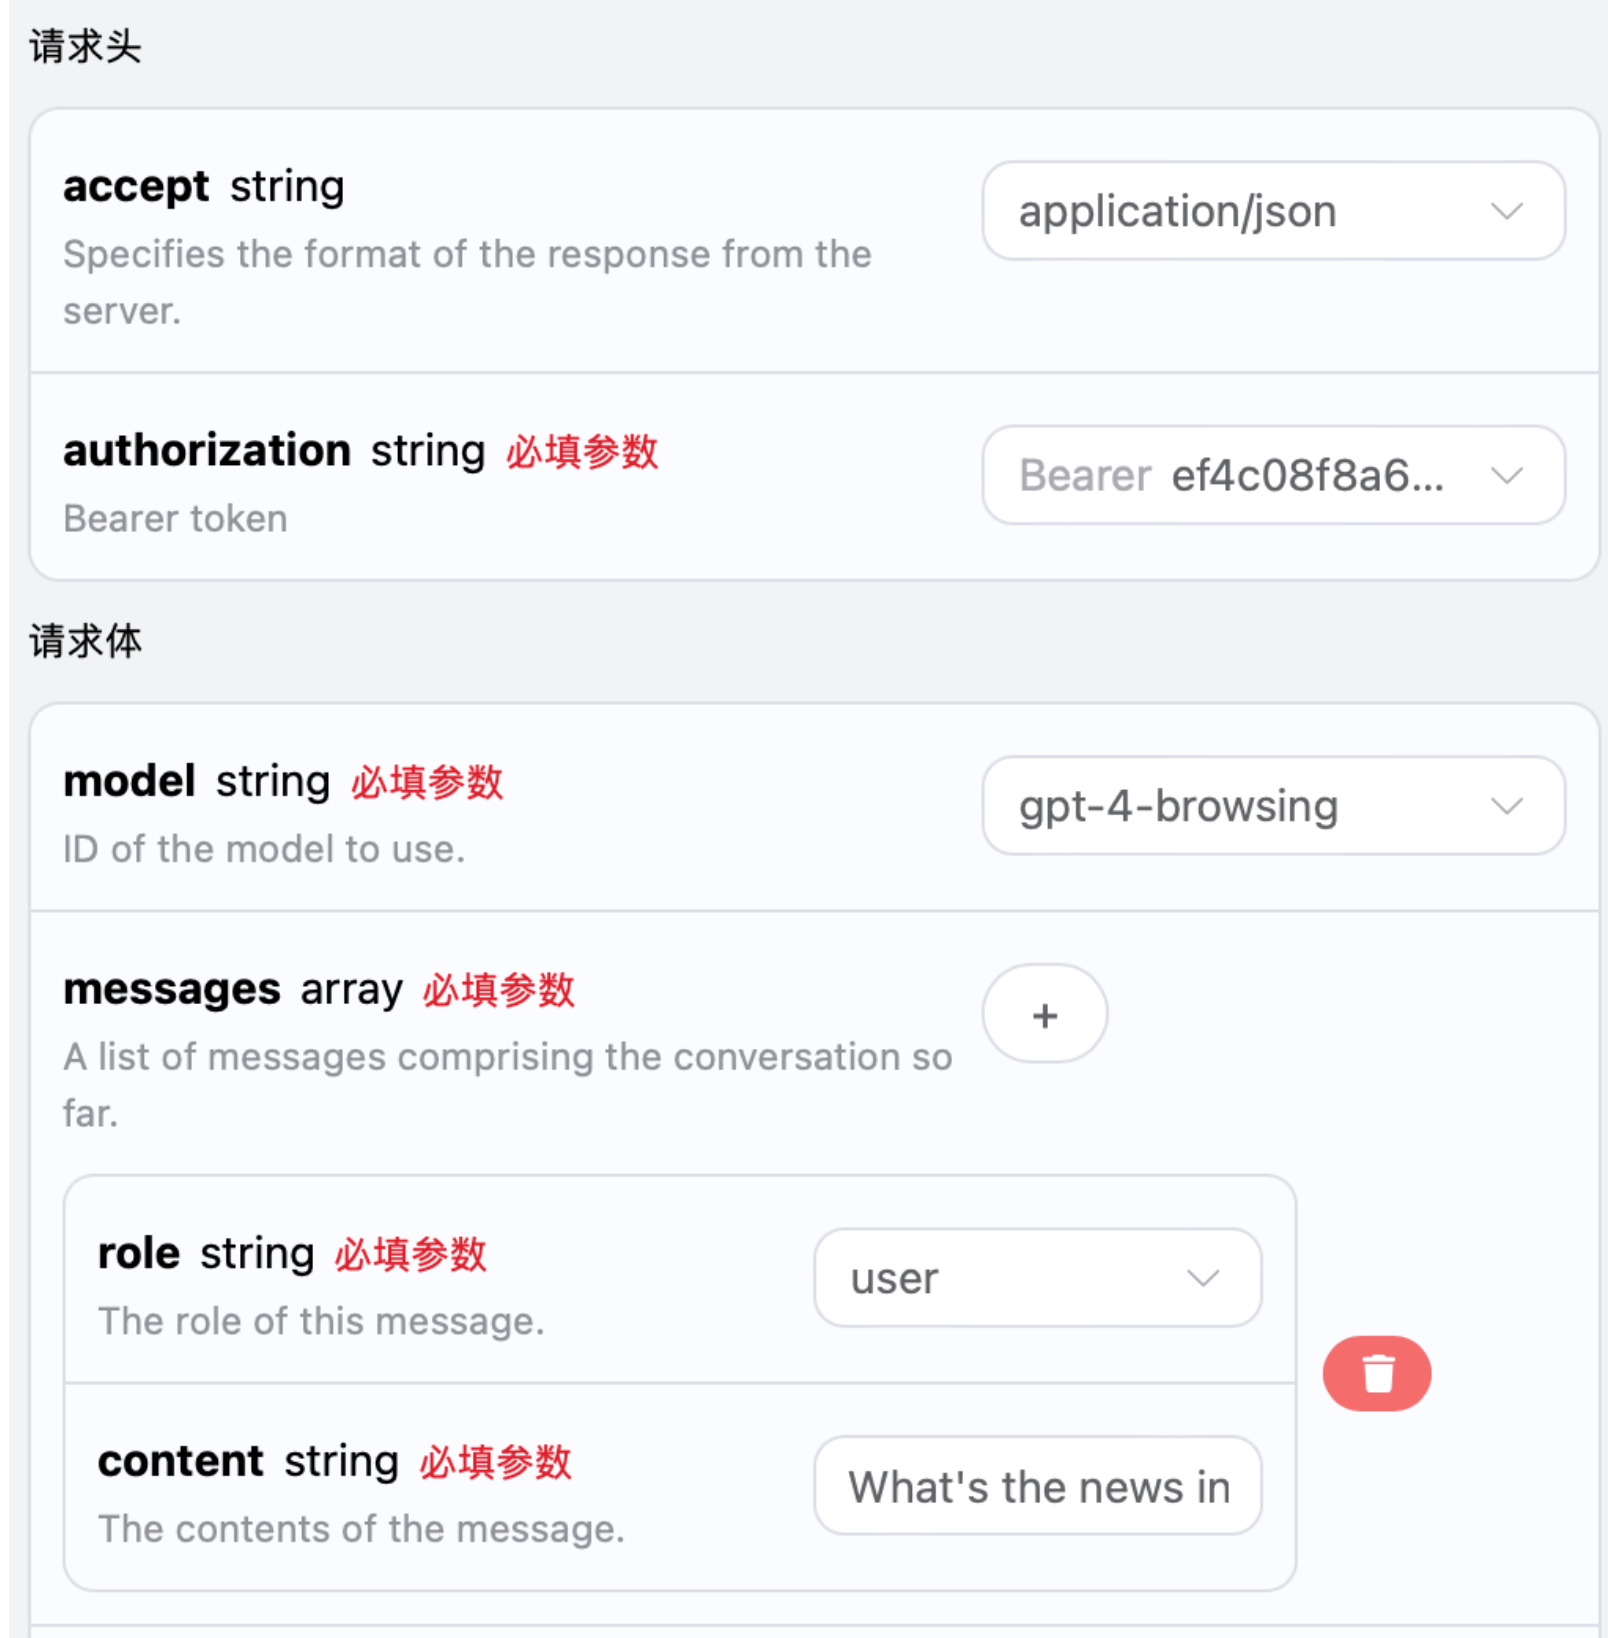
choices foram obtidas com base em consultas na internet e também são fornecidos links relacionados. As informações de resposta em choices devem ser renderizadas por meio da sintaxe markdown para obter a melhor experiência; por fim, isso também demonstra a grande vantagem da funcionalidade de acesso à internet do nosso modelo.
Modelo visual
gpt-4o é um grande modelo de linguagem multimodal desenvolvido pela OpenAI, que adiciona capacidade de compreensão visual com base no GPT-4. Este modelo pode processar simultaneamente entradas de texto e imagem, realizando compreensão e geração multimodais. O processamento de texto usando o modelo gpt-4o é consistente com o conteúdo de uso básico acima. A seguir, será apresentado brevemente como usar a capacidade de processamento de imagens do modelo. A capacidade de processamento de imagens do modelo gpt-4o é usada principalmente adicionando um campotype com base no conteúdo original de content. Por meio desse campo, é possível saber se o que foi enviado é texto ou imagem, utilizando assim a capacidade de processamento de imagens do modelo gpt-4o. A seguir, será explicado principalmente como chamar essa funcionalidade por meio de Curl e Python.
- Método de script Curl
- Método de script Python
Modelo de geração de imagens GPT-4o
Gerar imagens com base em uma imagem de referência
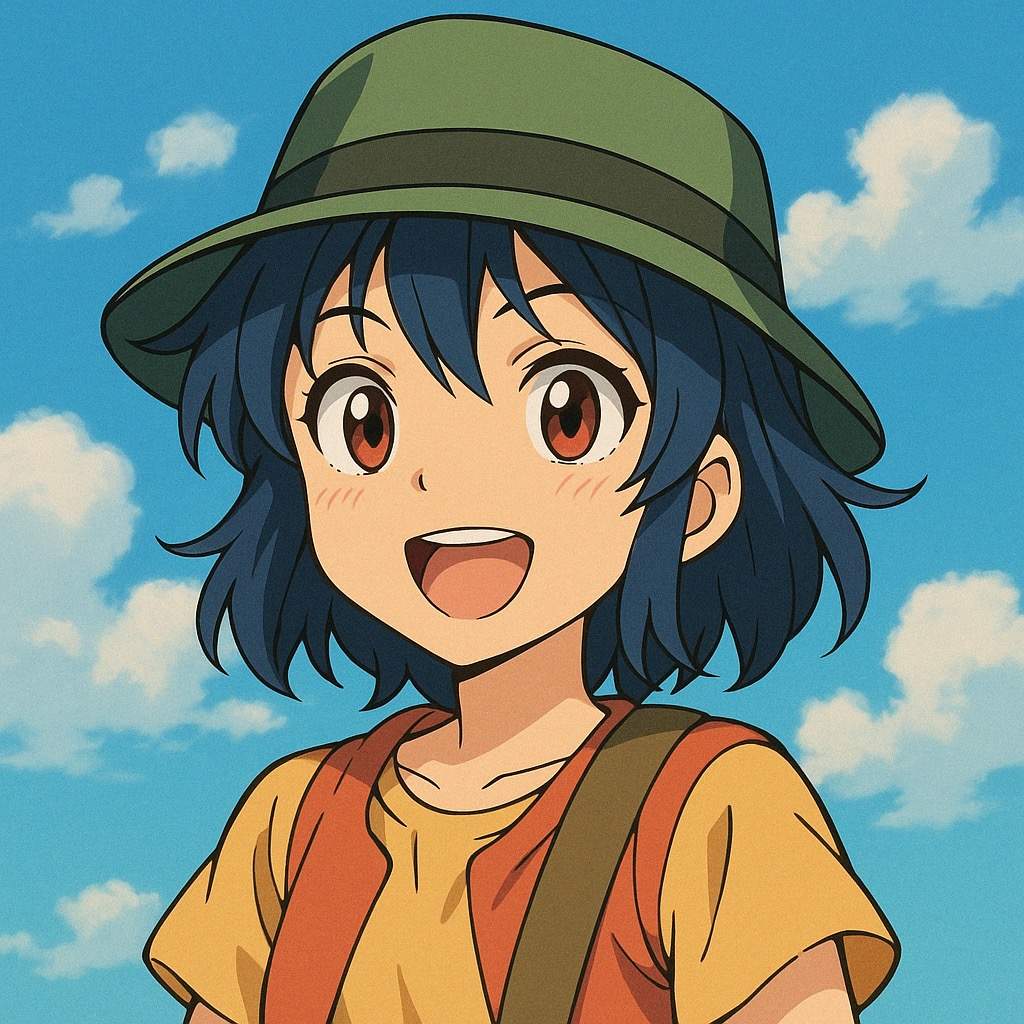
Abaixo está um exemplo de geração de uma imagem de estilo personalizado com base em uma imagem. Primeiro, vamos observar a imagem que inserimos, conforme mostrado abaixo: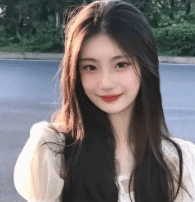 Pode-se ver que a imagem de referência é uma imagem de uma pessoa real. Podemos fazê-la mudar para um estilo diferente, por exemplo, transformá-la em uma imagem de estilo anime. O exemplo específico de solicitação é:
message.content dentro de choices é o resultado completo da conversa gerada, e a imagem está incluída nele no formato Markdown (o link da imagem é um endereço temporário, faça o download e salve-a a tempo). Pode-se ver que a imagem gerada é de fato no estilo anime, especificamente como mostrado abaixo:
Gerar imagem apenas com texto
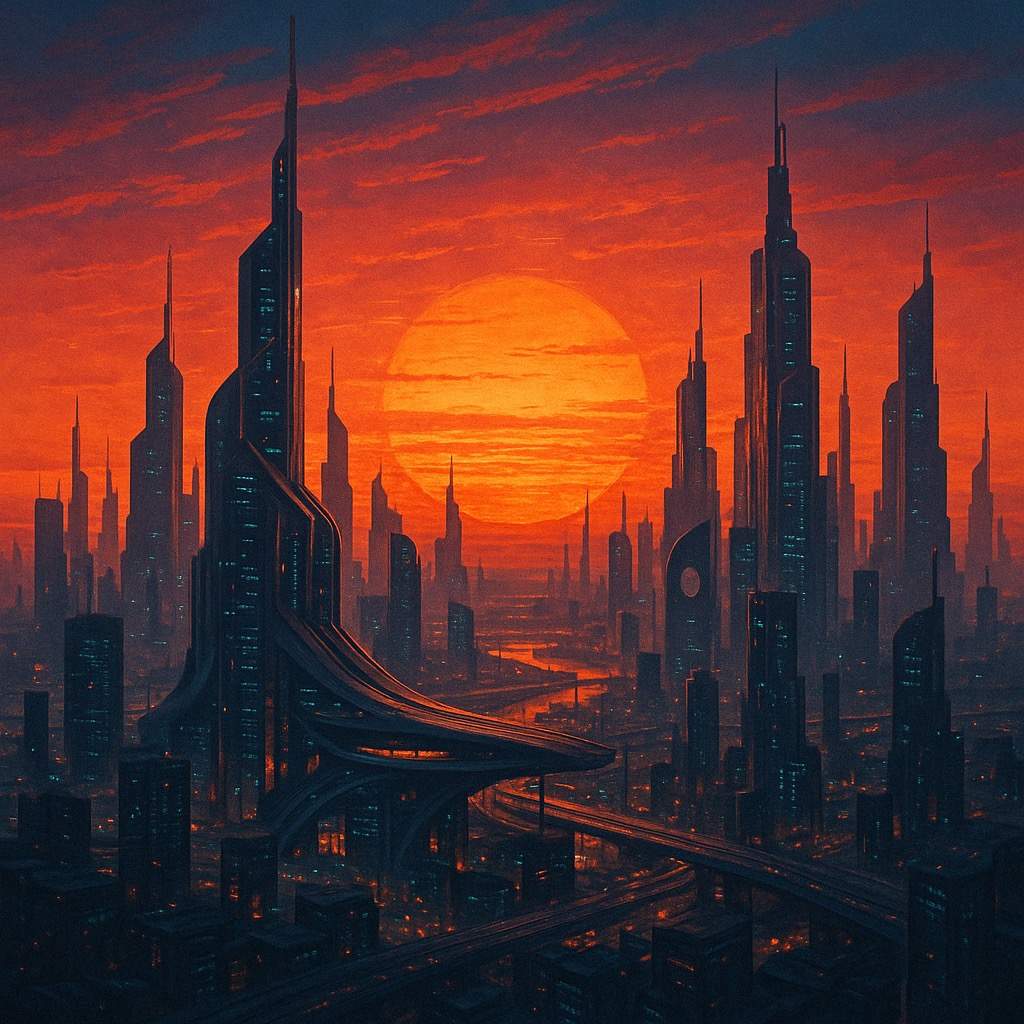
Podemos usar um prompt para gerar uma imagem e retorná-la para nós como resultado conversacional. A seguir, usaremos创建一张未来城市日落的图片 como exemplo. O exemplo específico é:
Gerar uma imagem a partir de várias imagens
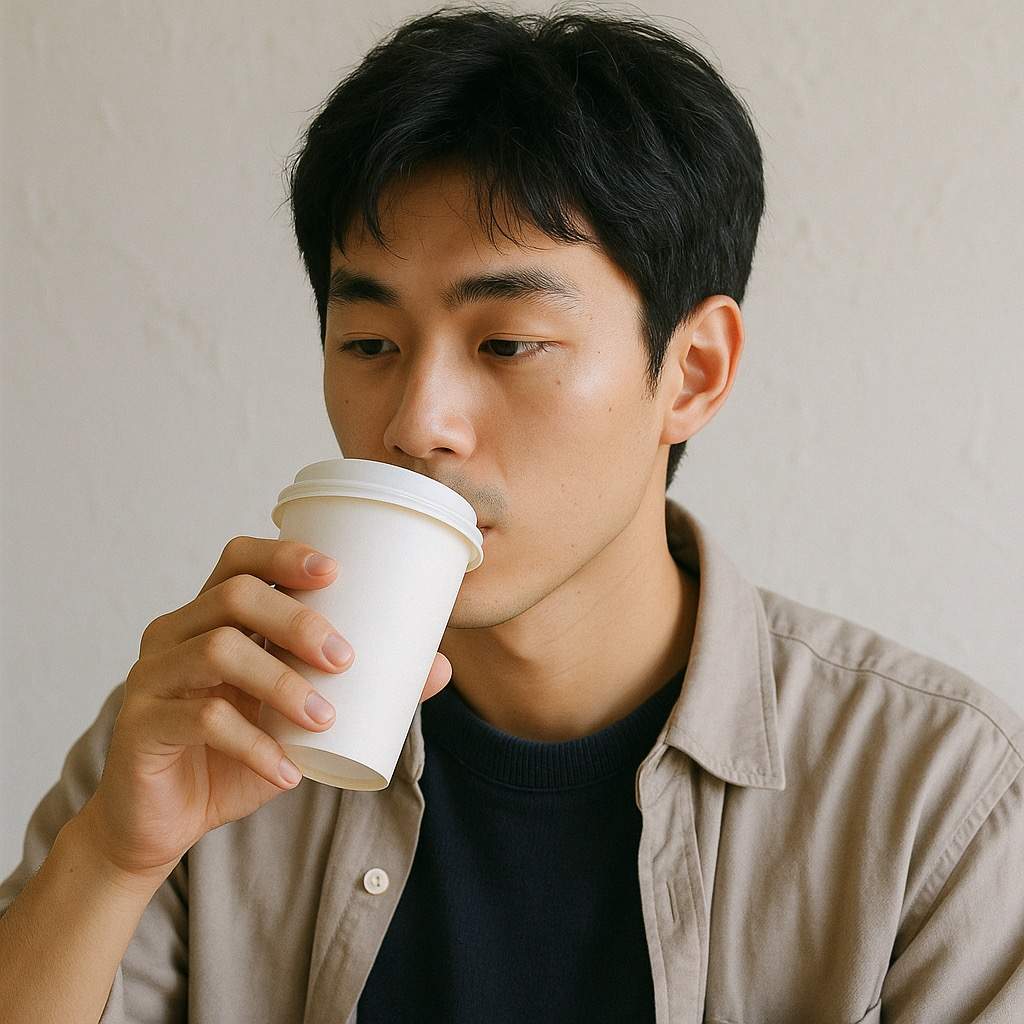
Também podemos usar várias imagens de referência para gerar uma imagem. Por exemplo, usando uma imagem de um homem bonito e uma imagem de café, podemos usar essas duas imagens para gerar uma imagem de um homem bonito tomando café. Abaixo estão as imagens de referência específicas: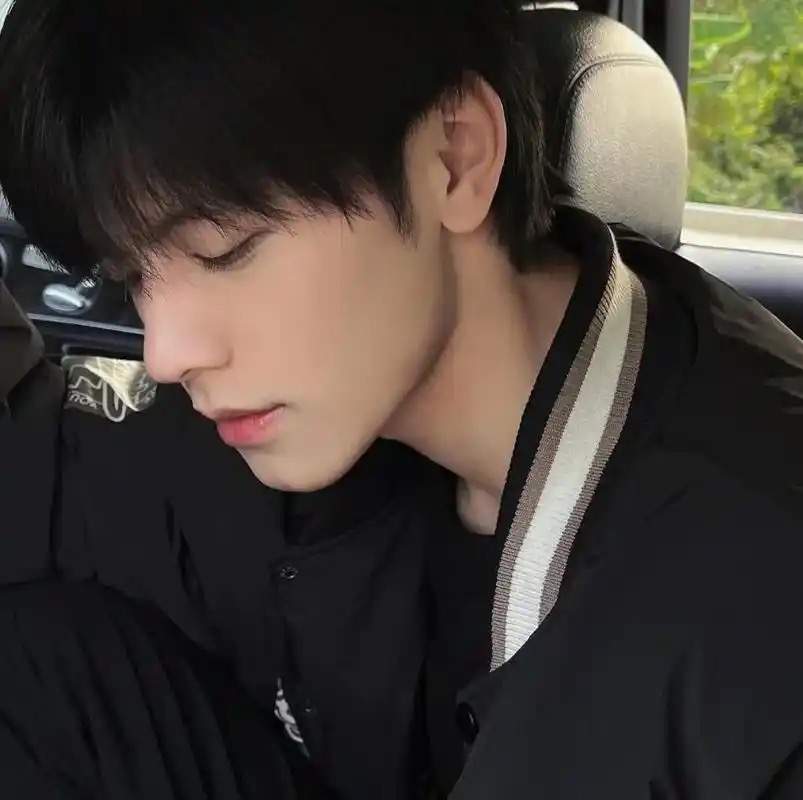
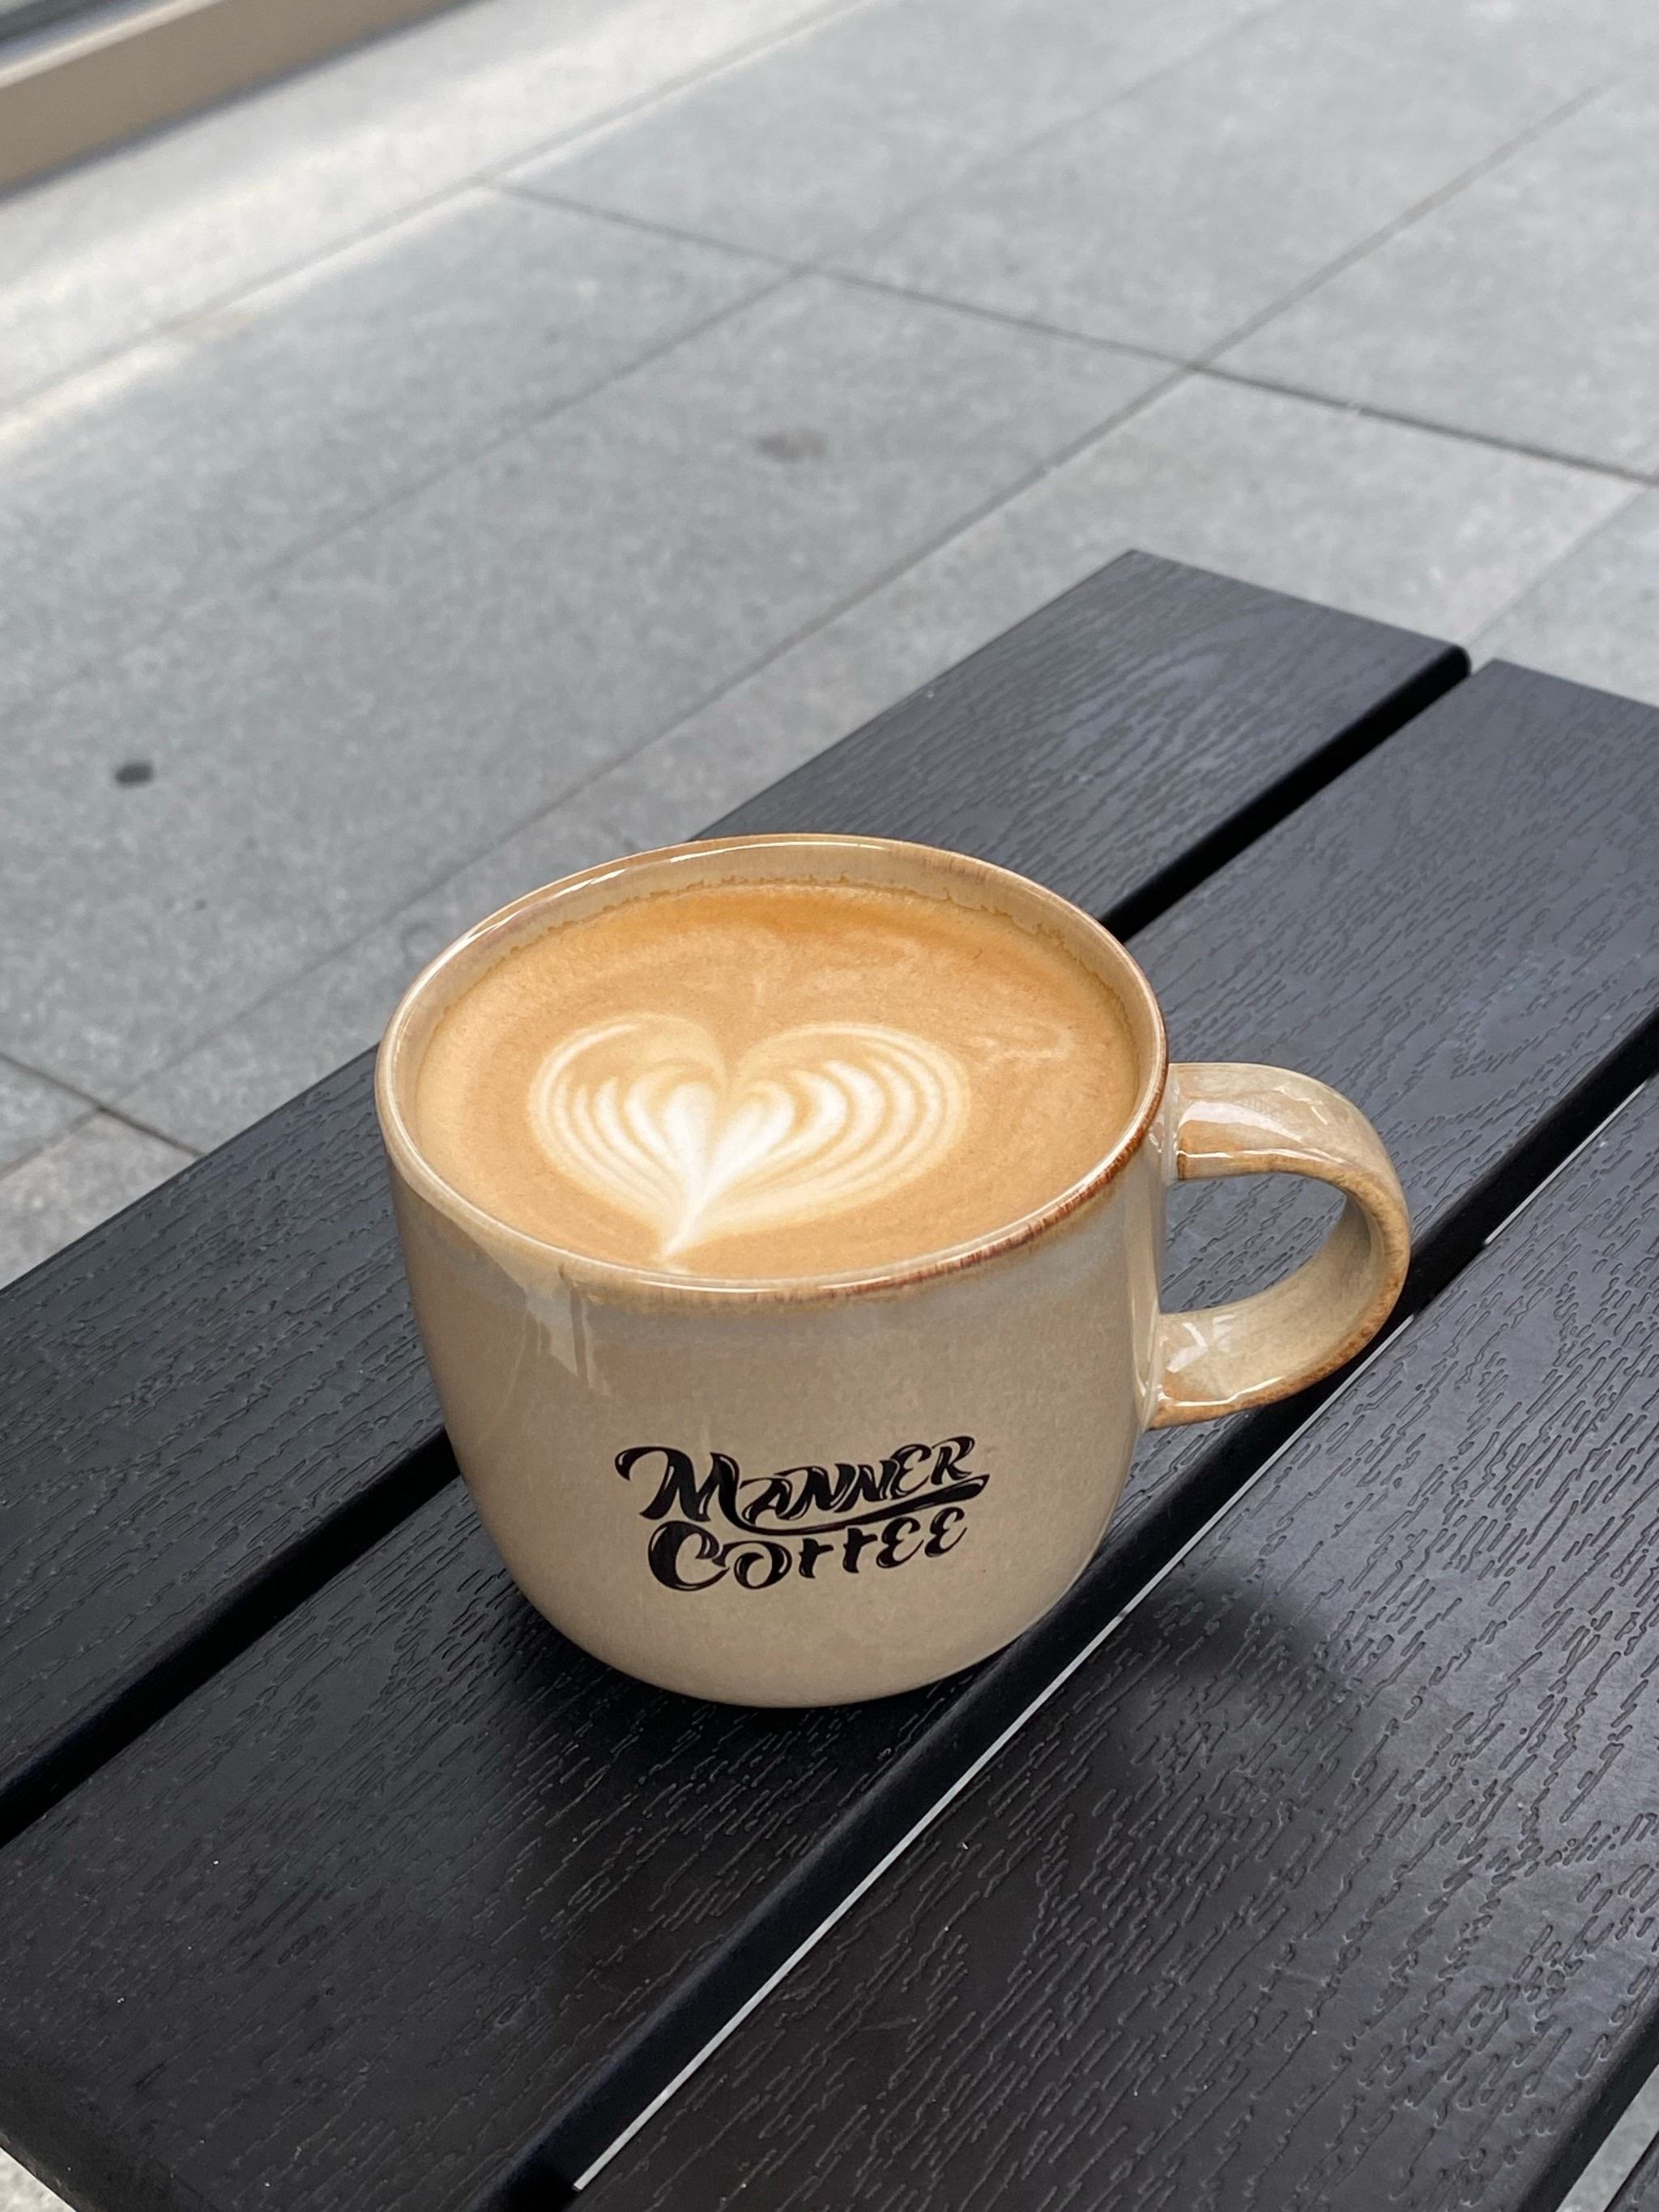
生成男生举着咖啡,并且马上要喝的样子 como exemplo. O exemplo específico é:
Tratamento de erros
Ao chamar a API, caso ocorra um erro, a API retornará o código de erro e as informações correspondentes. Por exemplo:400 token_mismatched: Bad request, possivelmente devido a parâmetros ausentes ou inválidos.400 api_not_implemented: Bad request, possivelmente devido a parâmetros ausentes ou inválidos.401 invalid_token: Não autorizado, token de autorização inválido ou ausente.429 too_many_requests: Solicitações em excesso, você excedeu o limite de taxa.500 api_error: Erro interno do servidor, algo deu errado no servidor.