Saltar para o conteúdo principal
O Google Gemini é um sistema de conversa de IA muito poderoso. Basta inserir um prompt para que ele gere respostas fluentes e naturais em apenas alguns segundos. O Gemini pode fornecer uma assistência inteligente surpreendente, melhorando significativamente a eficiência de trabalho e a criatividade humanas. Este documento apresenta principalmente o processo de uso das operações da API Gemini Chat Completion. Com ela, podemos usar facilmente a funcionalidade de conversa oficial do Gemini.

Processo de solicitação

Para usar a API Gemini Chat Completion, primeiro acesse o Console Ace Data Cloud para obter seu API Token e guarde-o para uso posterior. Se você ainda não estiver conectado ou registrado, será automaticamente redirecionado para a página de login, onde será convidado a se registrar e entrar. Após concluir, você retornará automaticamente à página atual. Um único API Token pode chamar todos os serviços da plataforma, sem necessidade de solicitar um separadamente para cada serviço. Na primeira solicitação, serão concedidos créditos gratuitos para uma experiência sem custo; quando os créditos forem insuficientes, você poderá recarregar o saldo universal no console.
📘 Documentação completa: Gemini Chat Completion API →

Uso básico

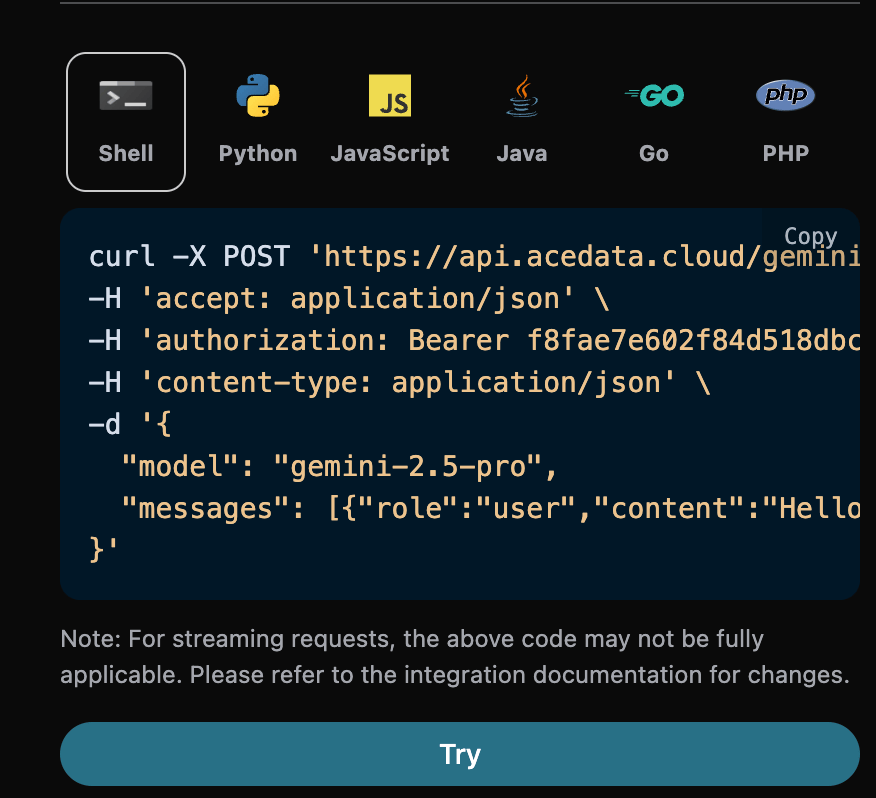
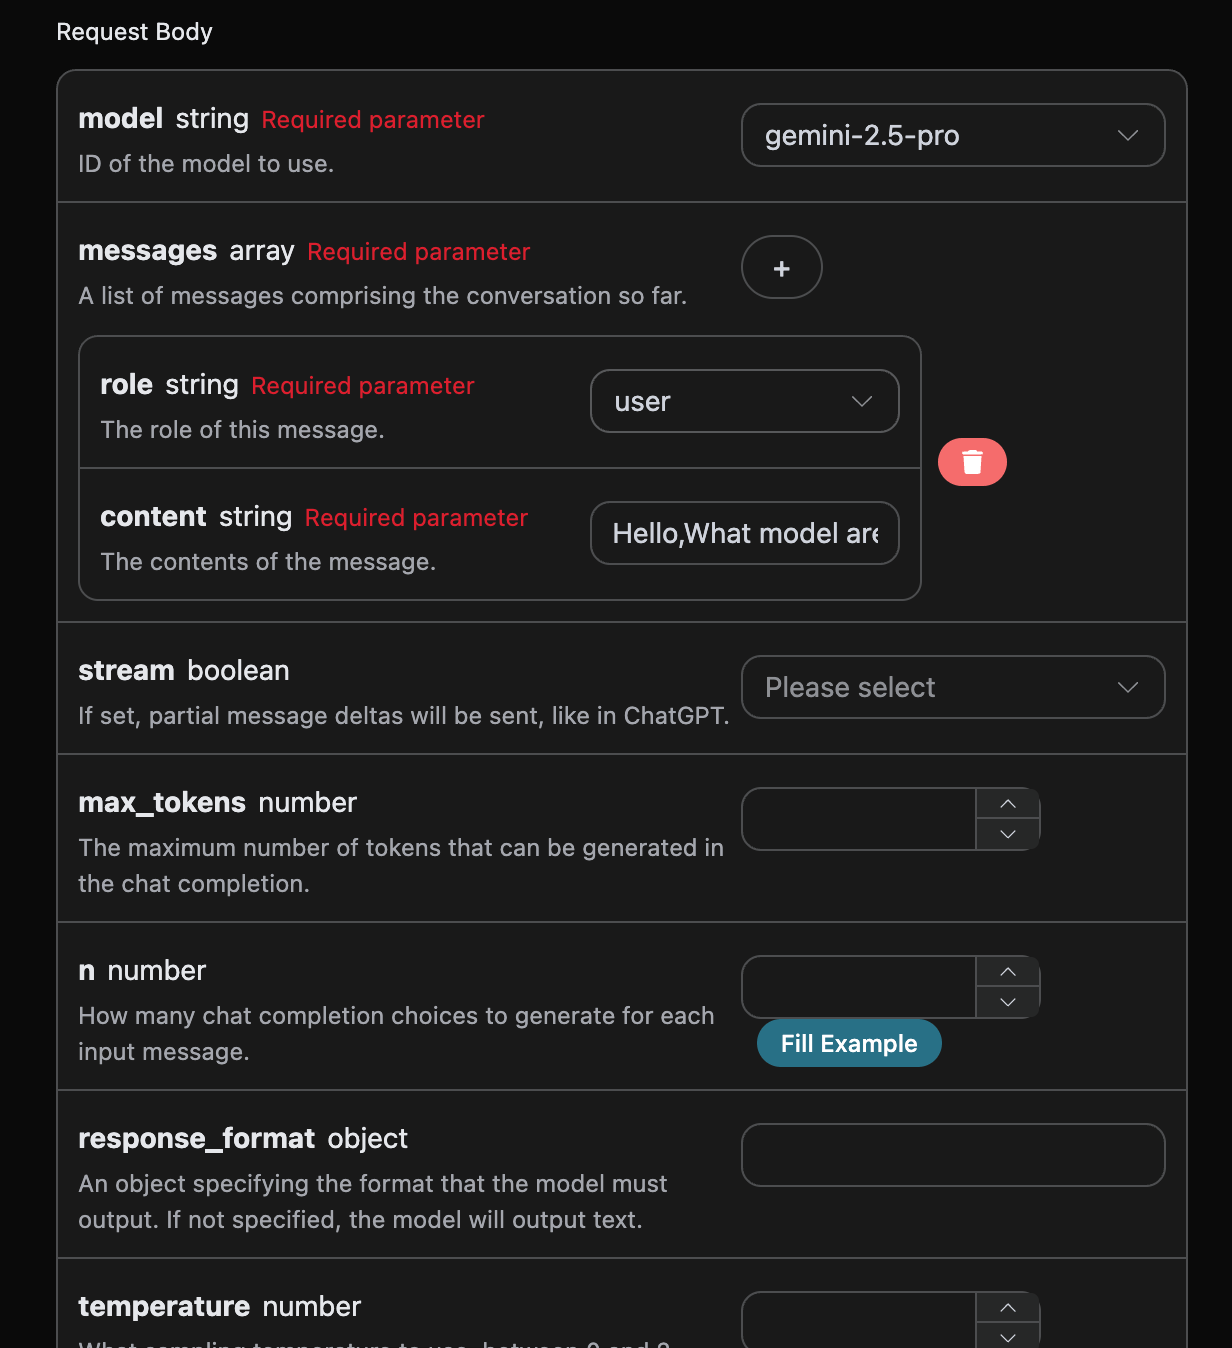
Em seguida, você pode preencher o conteúdo correspondente na interface, como mostrado na imagem:

Ao usar esta interface pela primeira vez, precisamos preencher pelo menos três conteúdos. Um deles é authorization, que pode ser selecionado diretamente na lista suspensa. Outro parâmetro é model; model é a categoria de modelo do site oficial do Gemini que escolhemos usar, e os modelos disponíveis devem seguir a enumeração model na documentação da interface. O último parâmetro é messages; messages é o array de prompts que inserimos. Ele é um array, indicando que é possível enviar vários prompts ao mesmo tempo. Cada prompt contém role e content, em que role representa o papel do questionador. Fornecemos três identidades: user, assistant e system. O outro, content, é o conteúdo específico da nossa pergunta. Ao mesmo tempo, você pode observar que há um código de chamada correspondente gerado no lado direito. Você pode copiar o código e executá-lo diretamente, ou clicar diretamente no botão 「Try」 para testar.

Dica: o flash da série gemini-3.x é um modelo de raciocínio e consumirá primeiro reasoning tokens; defina max_tokens como 512 ou mais, caso contrário poderá retornar apenas conteúdo vazio. gemini-3.8-flash é o modelo Flash atualmente recomendado, suporta até 1 milhão de Tokens de contexto, entrada de imagem, chamadas de ferramentas e respostas em streaming; atualmente é chamado por meio da interface Chat Completions.
Após a chamada, veremos que o resultado retornado é o seguinte:
O resultado retornado possui vários campos, apresentados a seguir:
  • id, o ID gerado para esta tarefa de conversa, usado para identificar exclusivamente esta tarefa de conversa.
  • model , o modelo oficial do Gemini selecionado.
  • choices, as informações de resposta fornecidas pelo Gemini para o prompt.
  • usage : as informações estatísticas de token para esta sessão de perguntas e respostas.
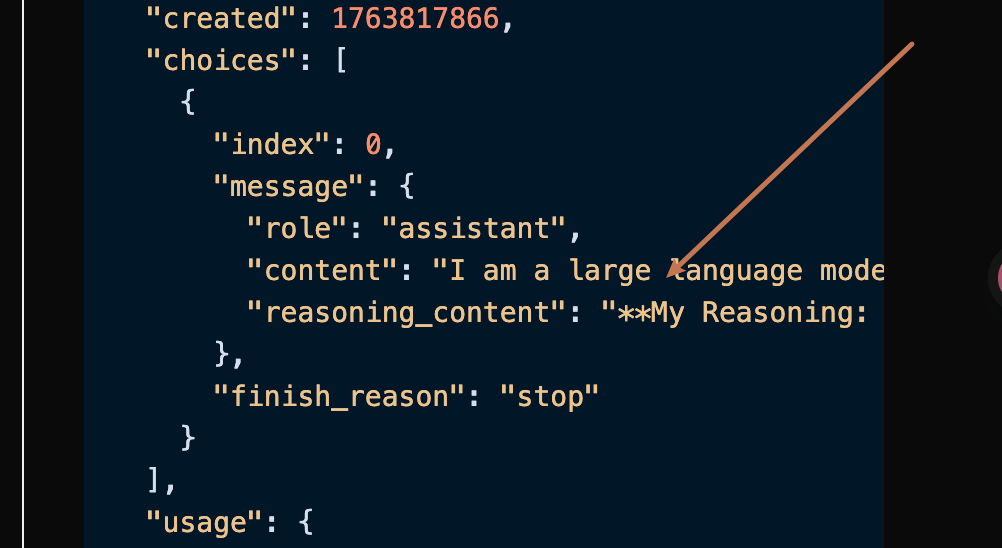
Entre eles, choices contém as informações de resposta do Gemini, e o choices dentro dele contém as informações específicas da resposta do Gemini, como pode ser visto na imagem.

É possível ver que o campo content dentro de choices contém o conteúdo específico da resposta do Gemini.

Compreensão de imagens (entrada multimodal)

O Gemini é um modelo multimodal nativo e pode diretamente “ver imagens”. Para enviar uma imagem, altere o content de uma mensagem de string para um array de blocos de conteúdo e coloque simultaneamente blocos text e blocos image_url no array — isso é totalmente consistente com o OpenAI e com o formato compatível com OpenAI do Gemini oficial. image_url.url suporta duas formas de escrita:
  • URI data: em base64 (recomendado, mais estável): o formato é data:<tipo de mídia>;base64,<dados>, por exemplo, data:image/jpeg;base64,/9j/4AAQ.... O tipo de mídia (MIME) já está escrito no prefixo data:, portanto não é necessário e não existe um campo media_type separado.
  • URL de imagem publicamente acessível: por exemplo, https://cdn.acedata.cloud/4hfydw.jpg.
Tipos de imagem compatíveis: png, jpeg, webp, heic, heif. Código de chamada de exemplo em Python (data URI em base64):
Também é possível enviar diretamente uma URL de imagem acessível publicamente:
💡 image_url aceita apenas o campo url (o valor pode ser uma URL de imagem ou um URI data: em base64), bem como o campo opcional detail. Não envie media_type — esse é o campo de imagem do Anthropic Claude e não faz parte do formato image_url do OpenAI / Gemini.

Resposta em streaming

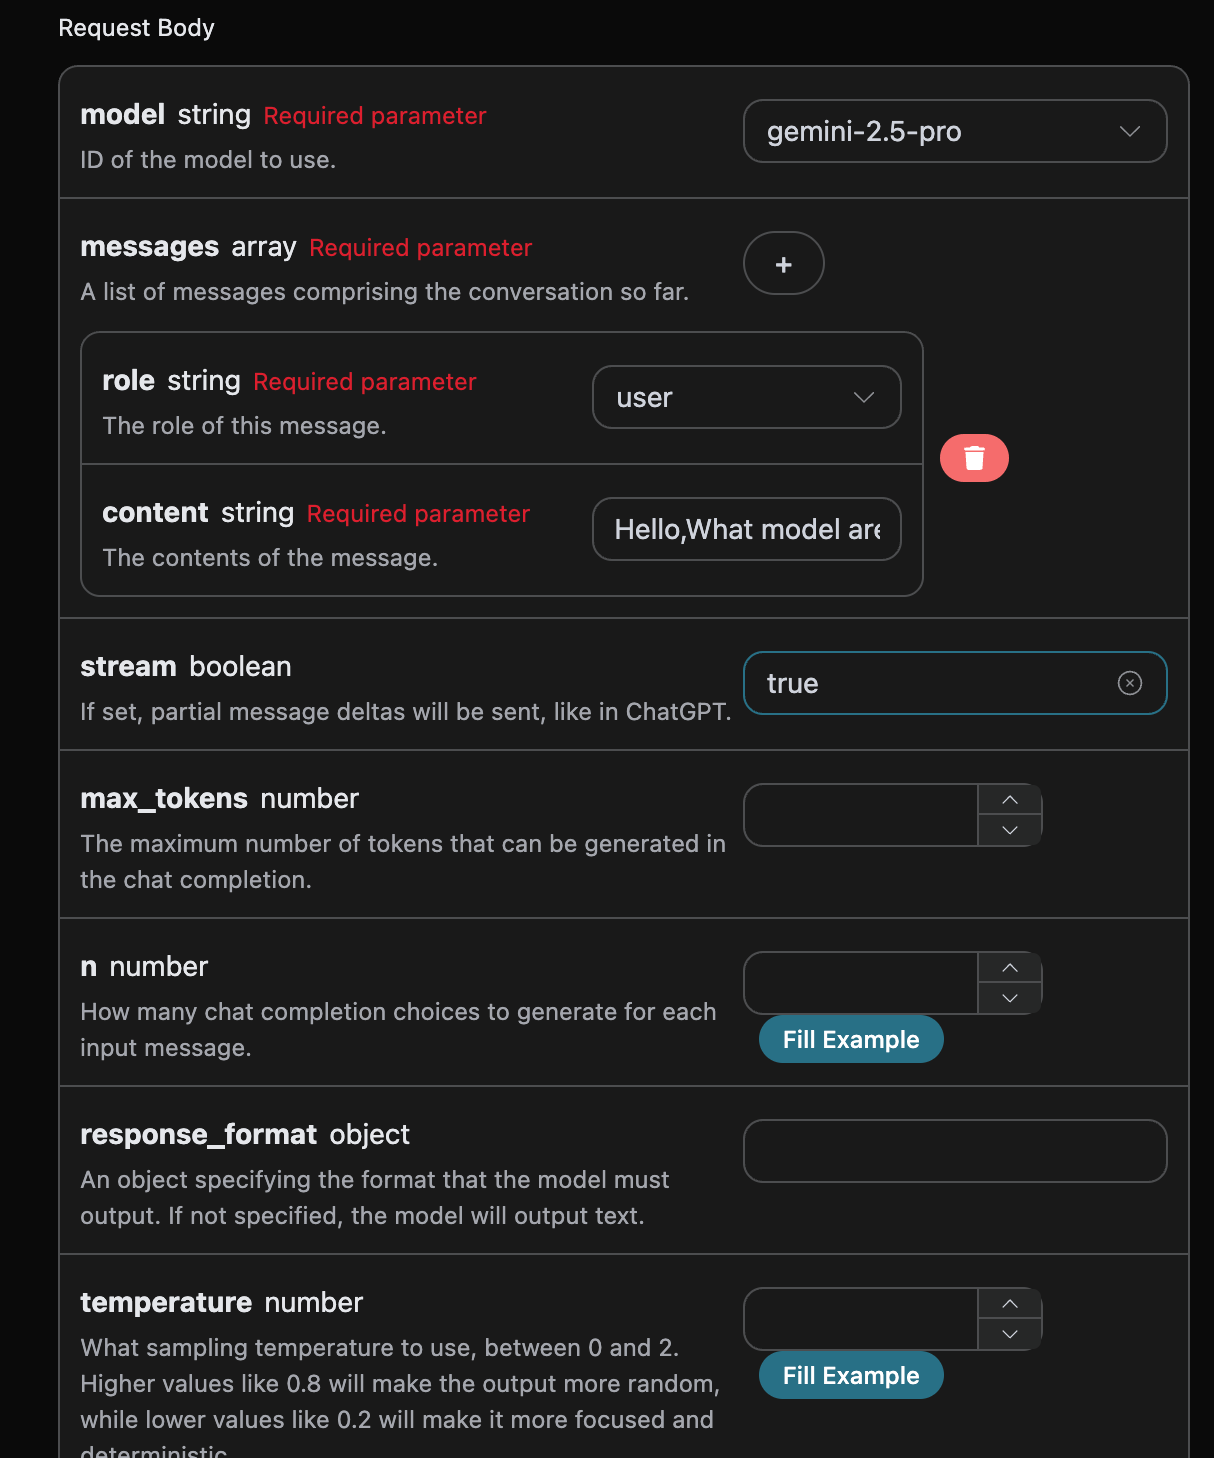
Esta interface também oferece suporte a respostas em streaming, o que é muito útil para integração com páginas web, permitindo que a página implemente um efeito de exibição palavra por palavra. Se quiser retornar a resposta em streaming, você pode alterar o parâmetro stream no cabeçalho da solicitação para true. A modificação é mostrada na imagem, mas o código de chamada precisa ter as alterações correspondentes para oferecer suporte à resposta em streaming.

Após modificar stream para true, a API retornará os dados JSON correspondentes linha por linha. No nível do código, precisamos fazer as modificações correspondentes para obter os resultados linha por linha. Código de exemplo de chamada em Python:
O resultado da saída é o seguinte:
Como pode ser visto, há muitos data na resposta, e choices dentro de data é o conteúdo mais recente da resposta, consistente com o conteúdo apresentado acima. choices é o conteúdo de resposta adicionado, e você pode integrá-lo ao seu sistema de acordo com o resultado. Ao mesmo tempo, o término da resposta em streaming é determinado com base no conteúdo de data; se o conteúdo for [DONE], isso indica que a resposta em streaming foi completamente encerrada. O resultado data retornado contém vários campos, apresentados a seguir:
  • id, gera o ID desta tarefa de conversa, usado para identificar exclusivamente esta tarefa de conversa.
  • model , o modelo oficial do Gemini selecionado.
  • choices, as informações de resposta fornecidas pelo Gemini para a pergunta.
JavaScript também é suportado, por exemplo, o código de chamada em fluxo do Node.js é o seguinte:
Código de exemplo em Java:
Outras linguagens podem ser adaptadas separadamente, o princípio é o mesmo.

Conversa com múltiplas rodadas

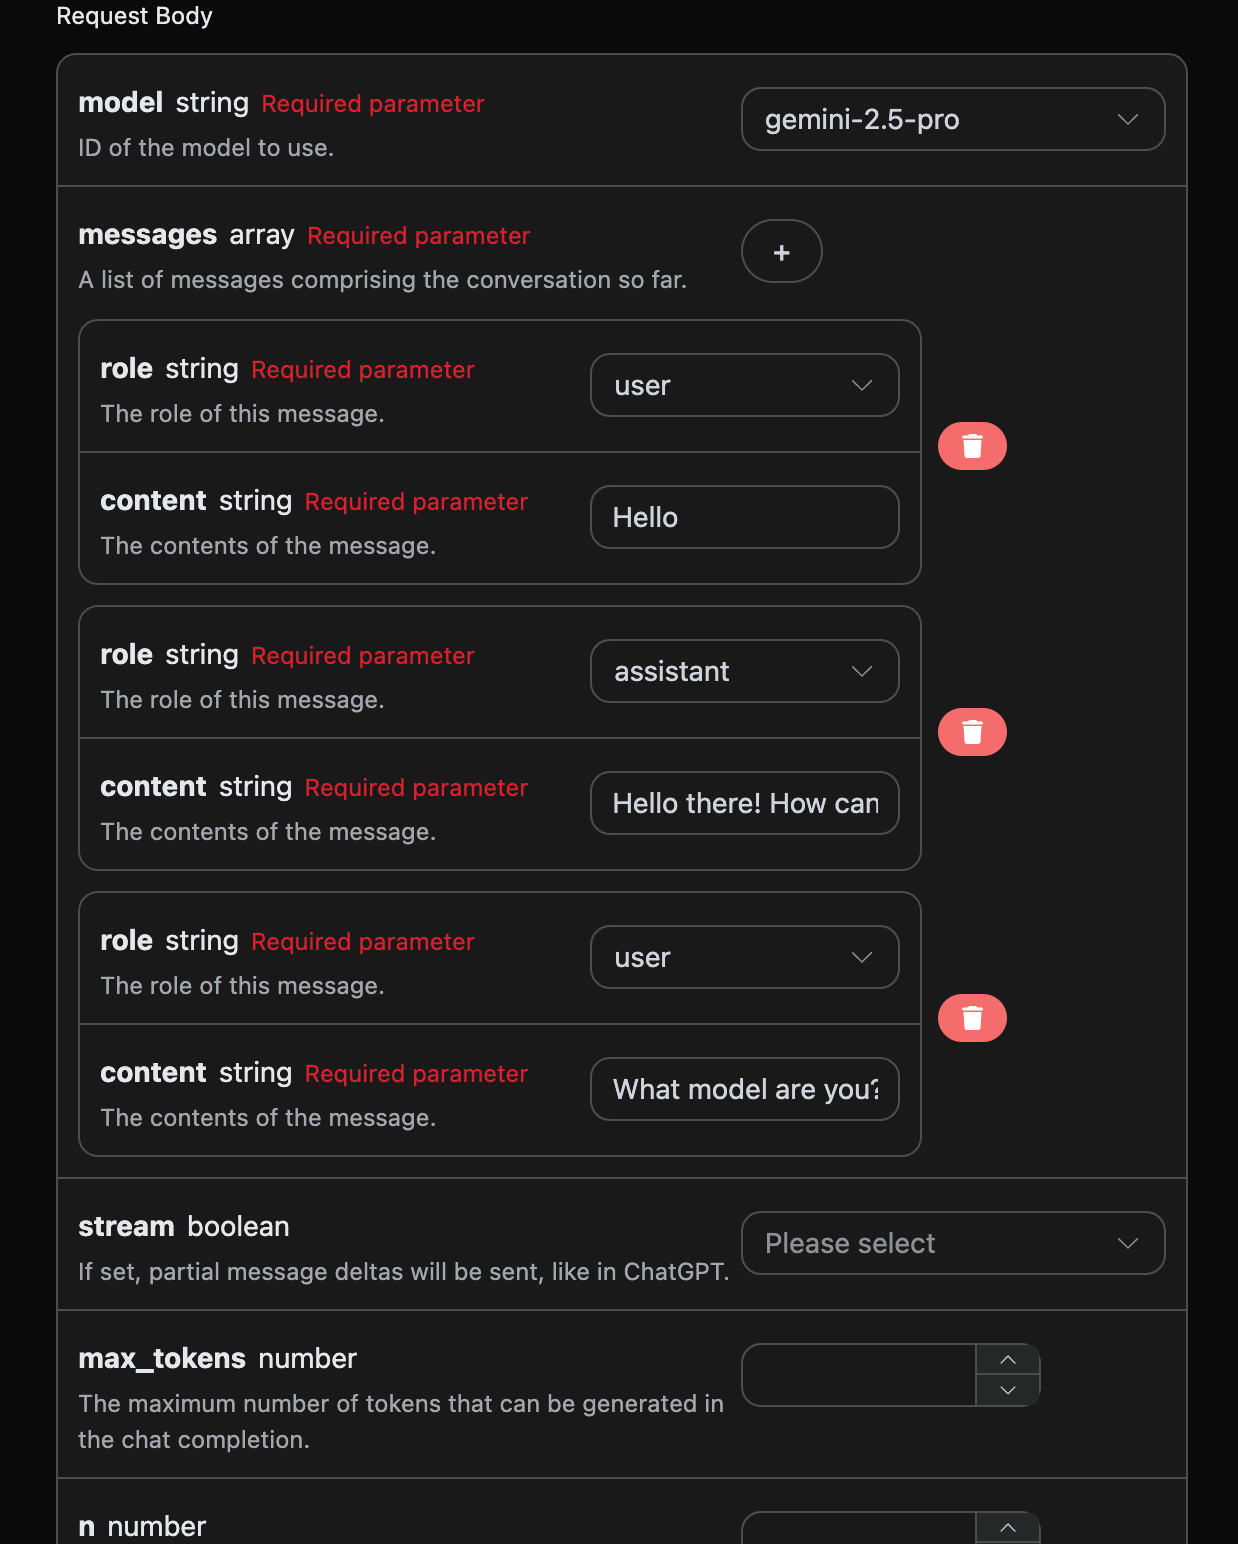
Se você quiser integrar a funcionalidade de conversa com múltiplas rodadas, será necessário enviar várias perguntas no campo messages; um exemplo específico de várias perguntas é mostrado na imagem abaixo:

Código de chamada de exemplo em Python:
Ao enviar várias perguntas, é possível implementar facilmente uma conversa com múltiplas rodadas, podendo obter a seguinte resposta:
Pode-se ver que as informações contidas em choices são consistentes com o conteúdo de uso básico; isso inclui o conteúdo específico da resposta do Gemini para várias conversas, permitindo assim responder às perguntas correspondentes com base em vários conteúdos de conversa.

Modelo multimodal Gemini-3.0

Exemplo de solicitação:
Resultado de exemplo:
É claro que você também pode enviar, por exemplo, links de vídeo; a entrada específica é a seguinte:
Resultado de exemplo:
Como pode ser visto acima, o modelo Gemini 3.0 pode oferecer suporte à compreensão multimodal.

Modelo multimodal Gemini-3.1

gemini-3.1-pro-preview é o ID oficial atual do modelo Gemini 3.1 Pro, oferecendo suporte a entradas multimodais como texto, imagens e vídeos, sendo adequado para tarefas complexas de raciocínio, programação e compreensão. Exemplo de solicitação:
O Gemini 3.1 Pro também oferece suporte à compreensão de vídeos:
O formato de retorno é consistente com o Gemini 3.0 Pro; consulte a explicação na seção do modelo multimodal Gemini-3.0 acima para mais detalhes.

Tratamento de erros

Ao chamar a API, se ocorrer um erro, a API retornará o código e as informações de erro correspondentes. Por exemplo:
  • 400 token_mismatched: Solicitação inválida, possivelmente devido a parâmetros ausentes ou inválidos.
  • 400 api_not_implemented: Solicitação inválida, possivelmente devido a parâmetros ausentes ou inválidos.
  • 401 invalid_token: Não autorizado, token de autorização inválido ou ausente.
  • 429 too_many_requests: Solicitações demais, você excedeu o limite de taxa.
  • 500 api_error: Erro interno do servidor, algo deu errado no servidor.

Exemplo de resposta de erro

Conclusão

Através deste documento, você já aprendeu como usar a API Gemini Chat Completion para implementar facilmente a funcionalidade de conversação do Gemini oficial. Esperamos que este documento possa ajudá-lo a integrar e usar melhor essa API. Caso tenha alguma dúvida, entre em contato com nossa equipe de suporte técnico a qualquer momento.