

申請手順
OpenAI Embeddings API を使用するには、まず Ace Data Cloud コンソール で API Token を取得し、控えておいてください。 まだログインまたは登録していない場合は、ログインページに自動的にリダイレクトされ、登録とログインを求められます。完了すると自動的に現在のページに戻ります。
1 つの API Token でプラットフォームのすべてのサービスを呼び出すことができ、サービスごとに個別に申請する必要はありません。 初回申請時には無料クレジットが付与され、無料で体験できます。クレジットが不足した場合は、コンソール で共通残高をチャージできます。
📘 完全なドキュメント:OpenAI Embeddings API →
基本的な使用方法
続いて、画面上で対応する内容を入力できます。図のとおりです: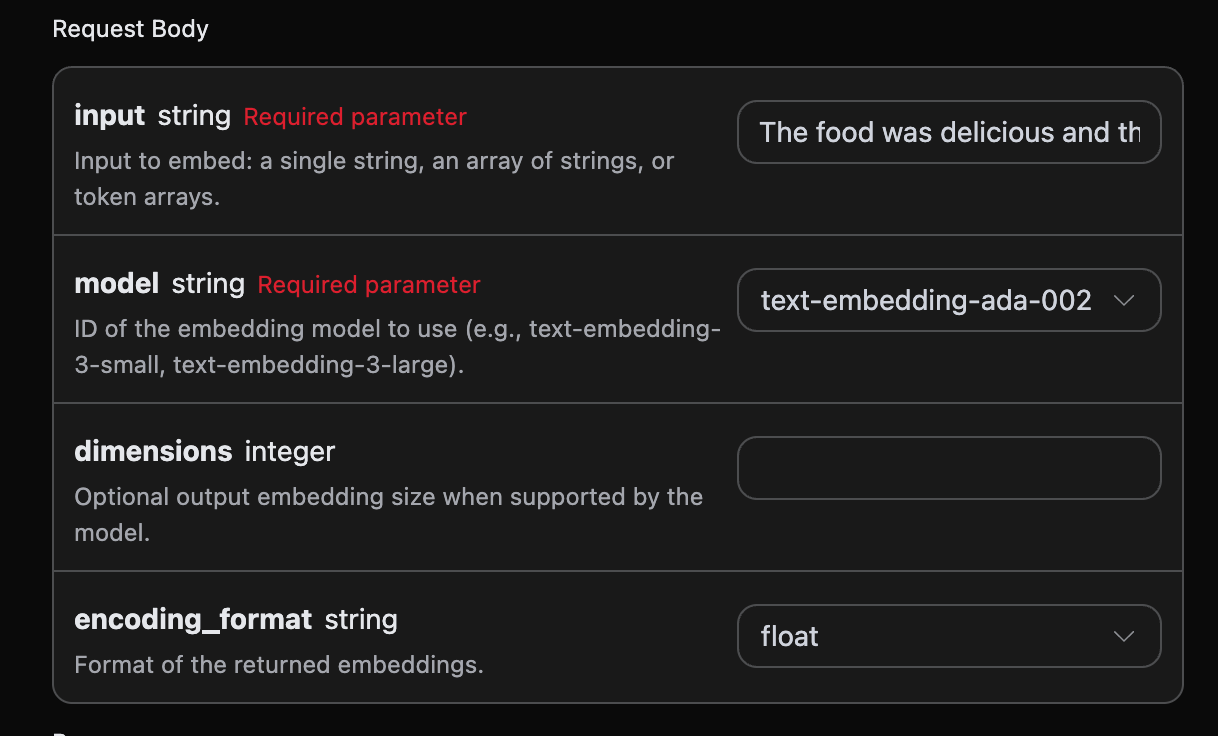
authorization で、ドロップダウンリストから直接選択できます。もう 1 つのパラメータは model です。model は OpenAI 公式サイトのモデルカテゴリから選択して使用するもので、現在利用可能なモデルは text-embedding-3-small と text-embedding-3-large です。text-embedding-ada-002 は提供を終了しています。既存のベクトルインデックスでこの旧モデルを使用している場合、新しいモデルのベクトルを直接混在させることはできず、インデックスを再作成する必要があります。最後のパラメータは input で、input は単語ベクトルに変換する必要があるテキストです。
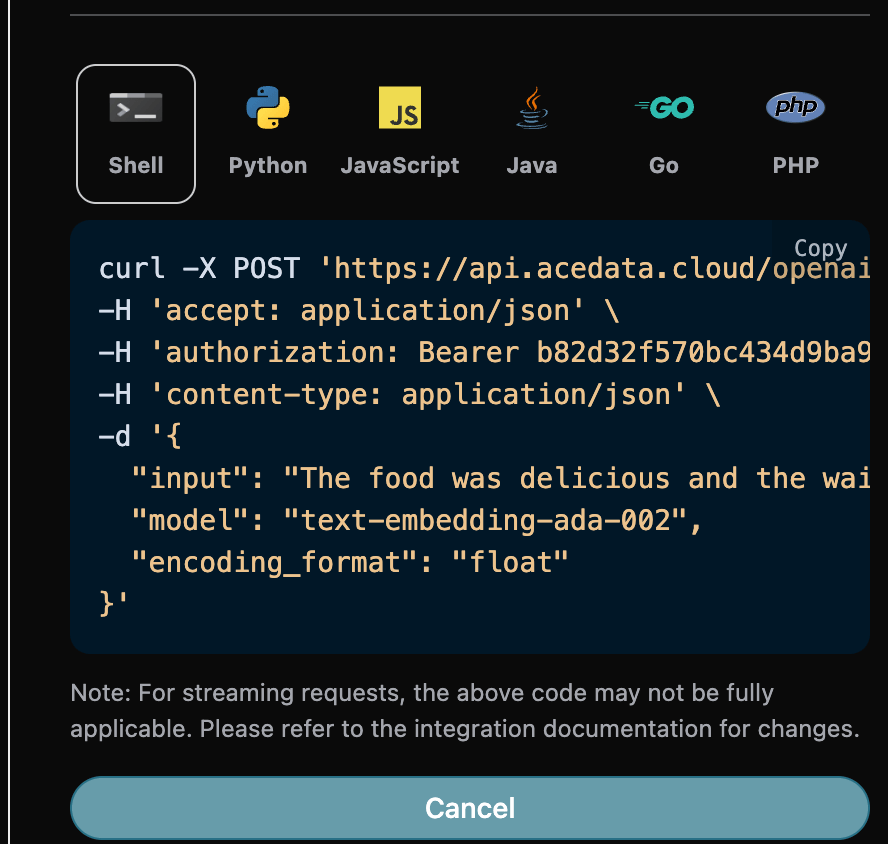
同時に、右側には対応する呼び出しコードが生成されていることに気付くでしょう。コードをコピーして直接実行することも、「Try」ボタンを直接クリックしてテストすることもできます。
オプションパラメータ:
dimensions:ベクトル次元を切り詰めます。デフォルトでは完全な次元を出力します。encoding_format:返却形式。floatまたはbase64を選択できます。
model、今回テキストを単語ベクトルに変換する際に使用したモデル。usage、今回テキストを単語ベクトルに変換する際に使用した token 情報。data、テキスト変換後の単語ベクトル結果。
data にはテキストに対応する単語ベクトルの詳細情報が含まれており、その中の embedding が生成された単語ベクトルの具体的な結果です。
エラー処理
API 呼び出し時にエラーが発生した場合、API は対応するエラーコードと情報を返します。例:400 token_mismatched:不正なリクエスト。パラメータの欠落または無効が原因である可能性があります。400 api_not_implemented:不正なリクエスト。パラメータの欠落または無効が原因である可能性があります。401 invalid_token:認証されていません。認証トークンが無効または欠落しています。429 too_many_requests:リクエストが多すぎます。レート制限を超えています。500 api_error:内部サーバーエラー。サーバー側で問題が発生しました。