

Procedura di richiesta
Per utilizzare la Claude Chat Completion API, per prima cosa vai alla console Ace Data Cloud per ottenere il tuo API Token, da conservare come riserva. Se non hai ancora effettuato l’accesso o non ti sei registrato, verrai automaticamente reindirizzato alla pagina di accesso che ti inviterà a registrarti ed effettuare l’accesso; al termine tornerai automaticamente alla pagina corrente.
Un solo API Token può chiamare tutti i servizi della piattaforma, senza dover fare richiesta separatamente per ciascun servizio. Alla prima richiesta verrà assegnato un credito gratuito, che consente di provare il servizio gratuitamente; quando il credito è insufficiente, puoi ricaricare il saldo generico nella console.
📘 Documentazione completa: Claude Chat Completion API →
Utilizzo di base
Successivamente puoi compilare i contenuti corrispondenti nell’interfaccia, come mostrato nell’immagine: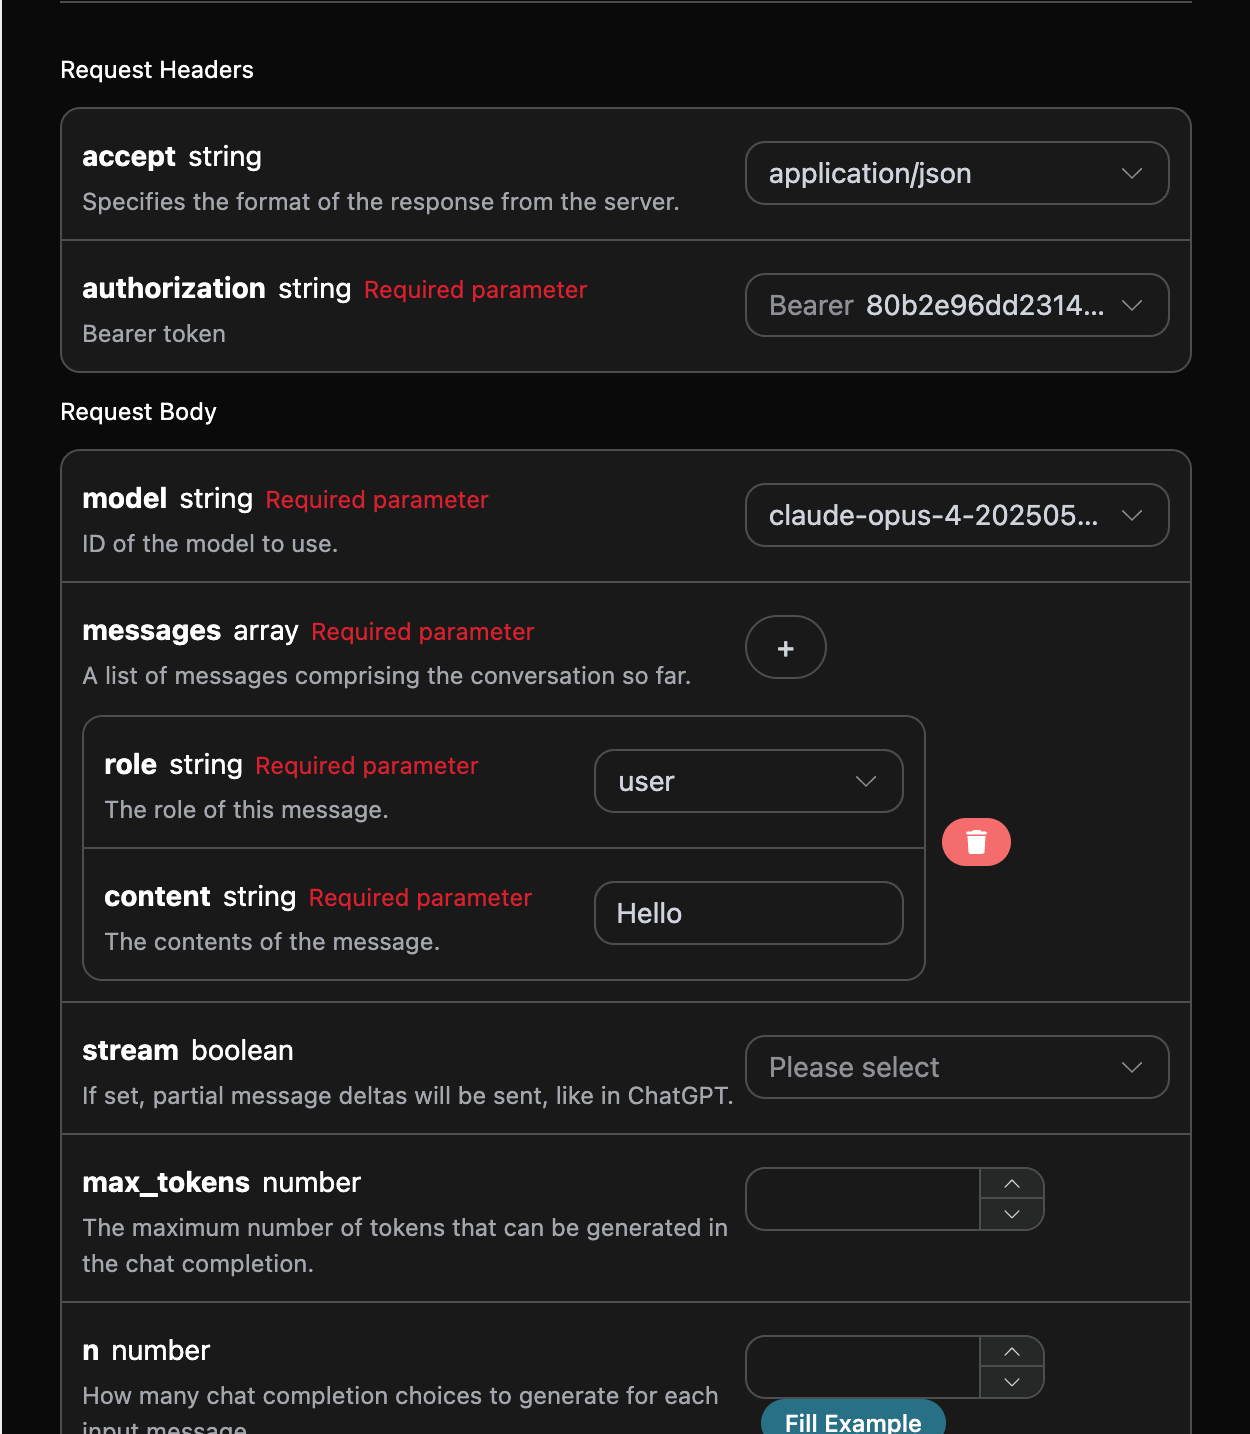
authorization, che può essere selezionato direttamente nell’elenco a discesa. Un altro parametro è model, per il quale si consiglia di utilizzare l’ultimo modello di punta claude-fable-5-1; il precedente claude-fable-5 può comunque continuare a essere chiamato. L’ultimo parametro è messages, che è un array di prompt; ogni elemento contiene role e content; role supporta user, assistant, system, mentre content è il contenuto specifico. Claude Fable 5.1 supporta un contesto di 1 milione di Token e un output massimo di 128K Token.
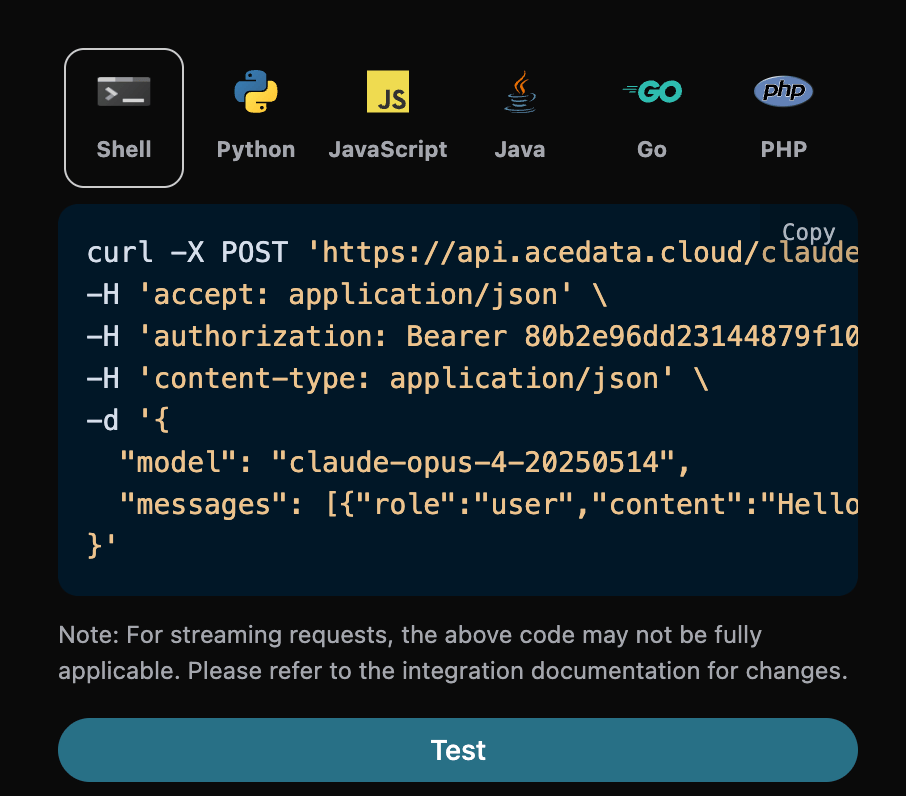
Allo stesso tempo puoi notare che sulla destra è presente la generazione del codice di chiamata corrispondente; puoi copiare il codice ed eseguirlo direttamente, oppure fare clic direttamente sul pulsante «Try» per effettuare un test.
Parametri opzionali comuni:
max_tokens: limita il numero massimo di token per una singola risposta.temperature: casualità della generazione, tra 0 e 2; maggiore è il valore, più divergente sarà.n: quante risposte candidate generare in una volta.response_format: impostazione del formato di ritorno.
id, l’ID generato per questa attività di conversazione, utilizzato per identificare univocamente questa attività di conversazione.model, il modello del sito ufficiale Claude selezionato.choices, le informazioni di risposta fornite da Claude al prompt.usage: informazioni statistiche sui token per questa sessione di domande e risposte.
usage.prompt_tokens è il totale dell’input; prompt_tokens_details.cached_tokens e prompt_tokens_details.cache_write_tokens registrano rispettivamente i dettagli di lettura e scrittura della cache. completion_tokens_details.reasoning_tokens è un sottoinsieme di completion_tokens; quando si calcola il totale o il costo, non aggiungerlo nuovamente. Le risposte non in streaming possono anche restituire l’oggetto usage.cost, dove amount è il consumo effettivo di credito, currency è l’unità di misura e list_amount è l’importo prima dello sconto (se presente).
Il nome del campo compatibile con Chat è reasoning_tokens; la Messages API nativa utilizza output_tokens_details.thinking_tokens. Lo schema wire dei due protocolli è diverso e il client non deve mescolare i nomi dei campi.
Tra questi, choices contiene le informazioni di risposta di Claude; il suo choices contiene le informazioni specifiche della risposta di Claude, come si può vedere nell’immagine.
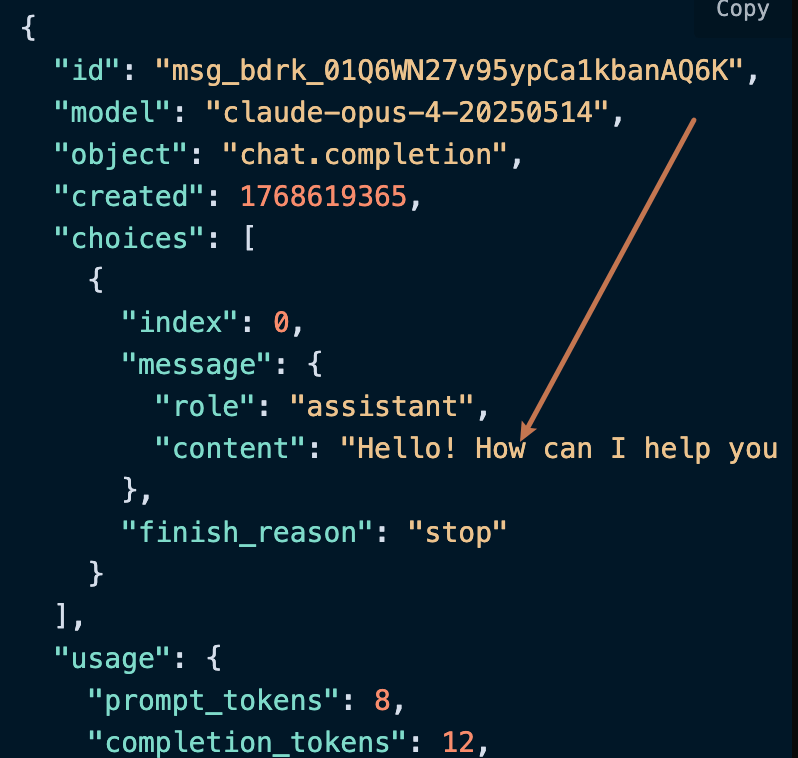
content in choices contiene il contenuto specifico della risposta di Claude.
Risposta in streaming
Questa interfaccia supporta anche risposte in streaming, il che è molto utile per l’integrazione web e permette alla pagina web di ottenere un effetto di visualizzazione parola per parola. Se desideri restituire la risposta in streaming, puoi modificare il parametrostream nell’header della richiesta, impostandolo su true.
La modifica è mostrata nell’immagine; tuttavia, il codice di chiamata deve essere modificato di conseguenza per supportare la risposta in streaming.
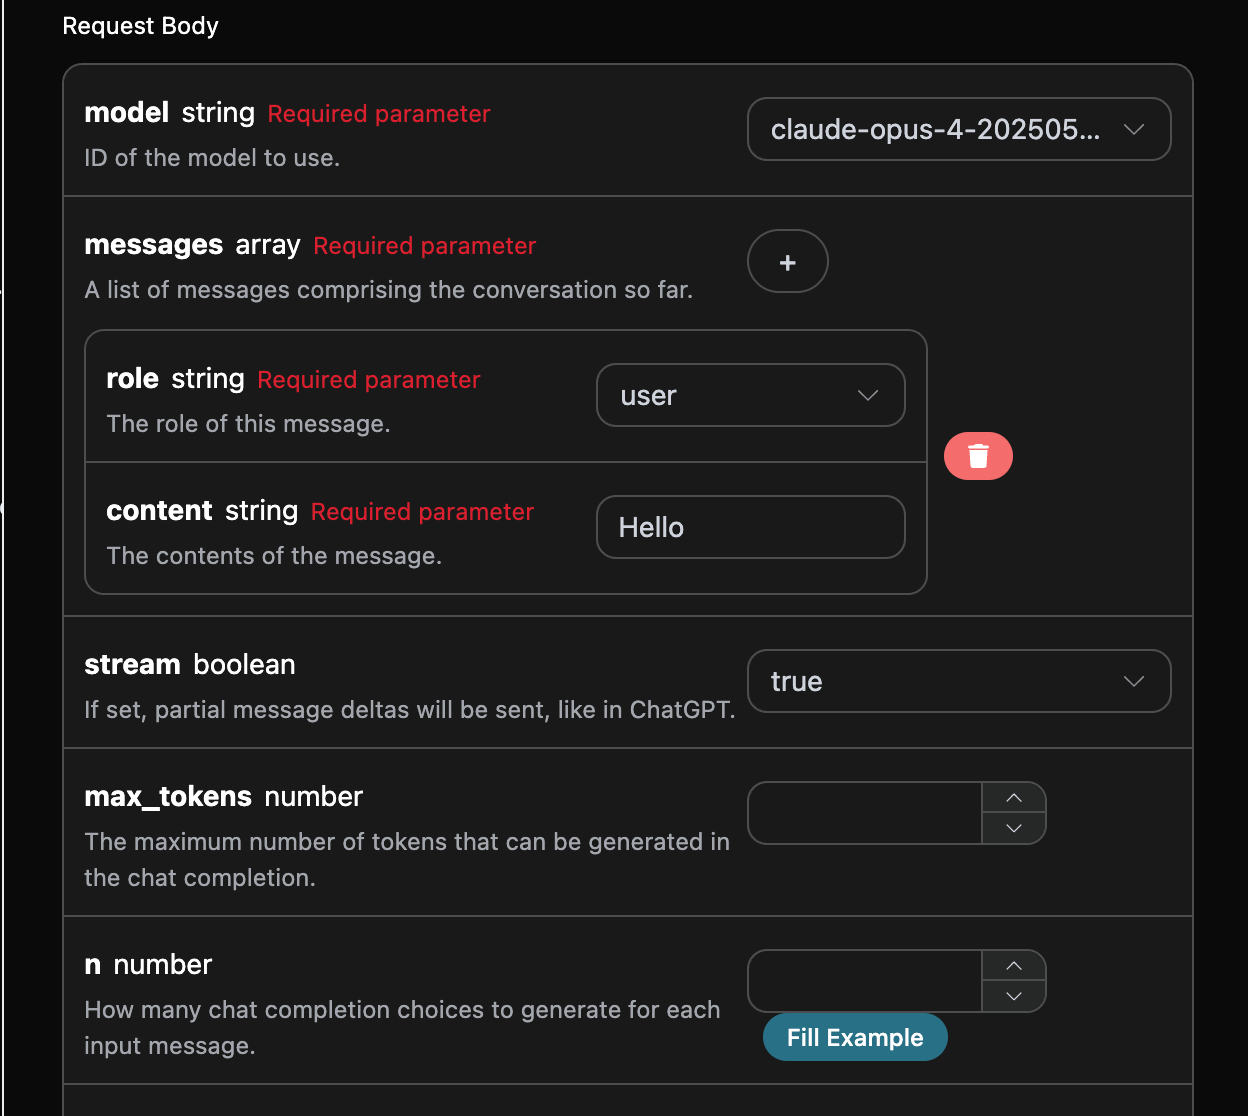
stream in true, l’API restituirà riga per riga i dati JSON corrispondenti; a livello di codice dobbiamo apportare le modifiche corrispondenti per ottenere i risultati riga per riga.
Codice di esempio di chiamata Python:
data; i choices all’interno di data rappresentano il contenuto più recente della risposta, coerente con quanto descritto sopra. choices contiene il nuovo contenuto della risposta e puoi integrarlo nel tuo sistema in base al risultato. Allo stesso tempo, la fine della risposta in streaming viene determinata in base al contenuto di data: se il contenuto è [DONE], significa che la risposta in streaming è completamente terminata. Il risultato data restituito contiene più campi, descritti di seguito:
id, l’ID dell’attività di conversazione generata, utilizzato per identificare univocamente questa attività di conversazione.model, il modello Claude selezionato sul sito ufficiale.choices, le informazioni di risposta fornite da Claude alla parola della domanda.
Conversazione multi-turno
Se desideri integrare la funzionalità di conversazione multi-turno, devi caricare più parole della domanda nel campomessages; un esempio specifico di più parole della domanda è mostrato nella figura seguente:
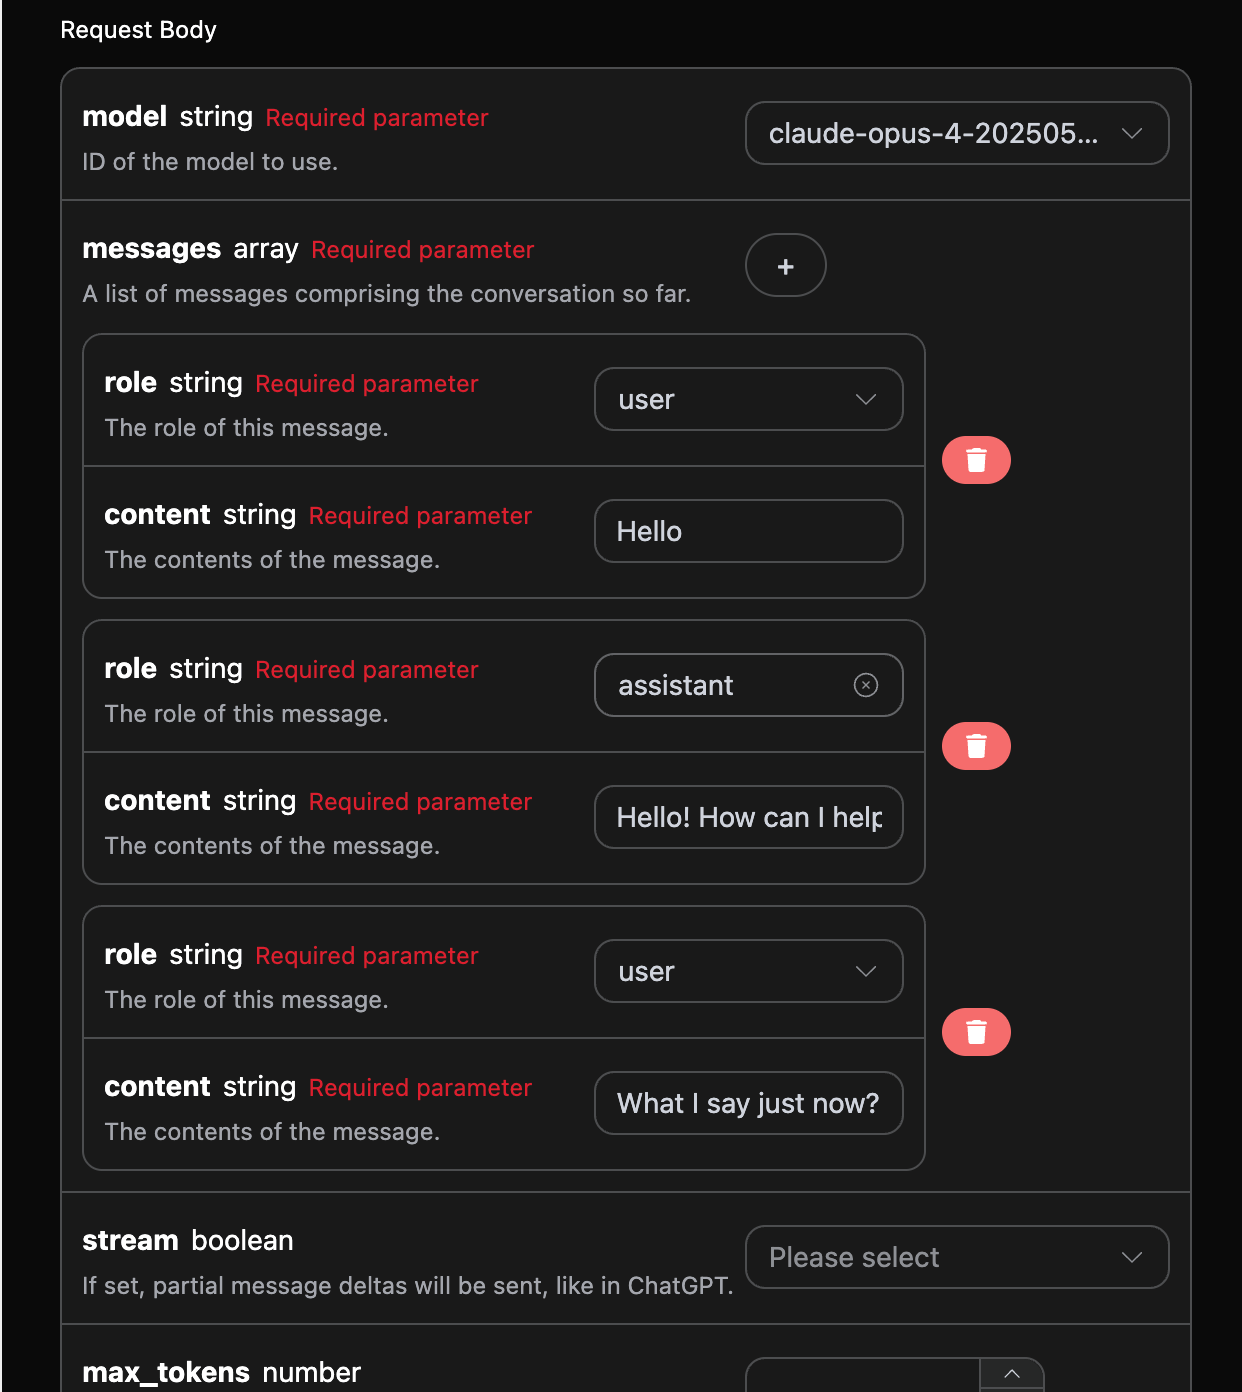
choices sono coerenti con il contenuto dell’uso di base; questo include il contenuto specifico delle risposte di Claude a più conversazioni, così è possibile rispondere alle domande corrispondenti in base a più contenuti di conversazione.
Ragionamento approfondito
I modelli Claude di nuova generazione potrebbero effettuare il ragionamento secondo la strategia predefinita del modello, senza necessità di attivarlo tramite il suffisso del modello-thinking. Le risposte compatibili con Chat utilizzano il campo usage compatibile con OpenAI completion_tokens_details.reasoning_tokens. reasoning_tokens è già incluso in completion_tokens, non sommarlo nuovamente. Il ragionamento e il testo visibile condividono il limite massimo dei token di output, pertanto quando max_tokens è ridotto il testo potrebbe risultare vuoto o troncato; in tal caso aumenta il budget di output oppure, se il modello utilizzato lo supporta, seleziona un minore impegno di ragionamento.
Se sono necessari thinking nativo, output_config.effort, blocchi di contenuto thinking e la restituzione della firma, utilizza /v1/messages. Il campo usage corrispondente a Messages è output_tokens_details.thinking_tokens, non confonderlo con completion_tokens_details.reasoning_tokens di Chat-compatible.
Modello visivo
claude-sonnet-4-20250514 è un modello linguistico di grandi dimensioni multimodale sviluppato da Claude, che aggiunge capacità di comprensione visiva sulla base di claude-4. Questo modello può elaborare contemporaneamente input di testo e immagini, realizzando comprensione e generazione multimodali. L’elaborazione del testo utilizzando il modello claude-sonnet-4-20250514 è coerente con i contenuti di utilizzo di base descritti sopra; di seguito verrà brevemente illustrato come utilizzare la capacità di elaborazione delle immagini del modello. La capacità di elaborazione delle immagini del modello claude-sonnet-4-20250514 viene utilizzata principalmente aggiungendo un campotype al contenuto content originale; tramite questo campo è possibile sapere se ciò che viene caricato è testo o un’immagine, utilizzando così la capacità di elaborazione delle immagini del modello claude-sonnet-4-20250514. Di seguito verranno principalmente descritti due modi per richiamare questa funzionalità, tramite Curl e Python.
- Metodo script Curl
- Metodo script Python
Gestione degli errori
Durante la chiamata dell’API, se si verifica un errore, l’API restituirà il codice e il messaggio di errore corrispondenti. Ad esempio:400 token_mismatched: Richiesta non valida, probabilmente a causa di parametri mancanti o non validi.400 api_not_implemented: Richiesta non valida, probabilmente a causa di parametri mancanti o non validi.401 invalid_token: Non autorizzato, token di autorizzazione non valido o mancante.429 too_many_requests: Troppe richieste, hai superato il limite di frequenza.500 api_error: Errore interno del server, si è verificato un problema sul server.