

Процес подання заявки
Щоб використовувати OpenAI Embeddings API, спочатку перейдіть до консолі Ace Data Cloud, щоб отримати ваш API Token і зберегти його для подальшого використання. Якщо ви ще не увійшли або не зареєструвалися, вас автоматично буде перенаправлено на сторінку входу із запрошенням зареєструватися та увійти, після завершення вас буде автоматично повернуто на поточну сторінку.
Один API Token може викликати всі сервіси платформи, немає потреби подавати окрему заявку для кожного сервісу. Під час першого подання заявки буде надано безкоштовний ліміт, який можна безкоштовно випробувати; коли ліміту недостатньо, можна поповнити загальний баланс у консолі.
📘 Повна документація: OpenAI Embeddings API →
Базове використання
Далі можна заповнити відповідний вміст в інтерфейсі, як показано на зображенні: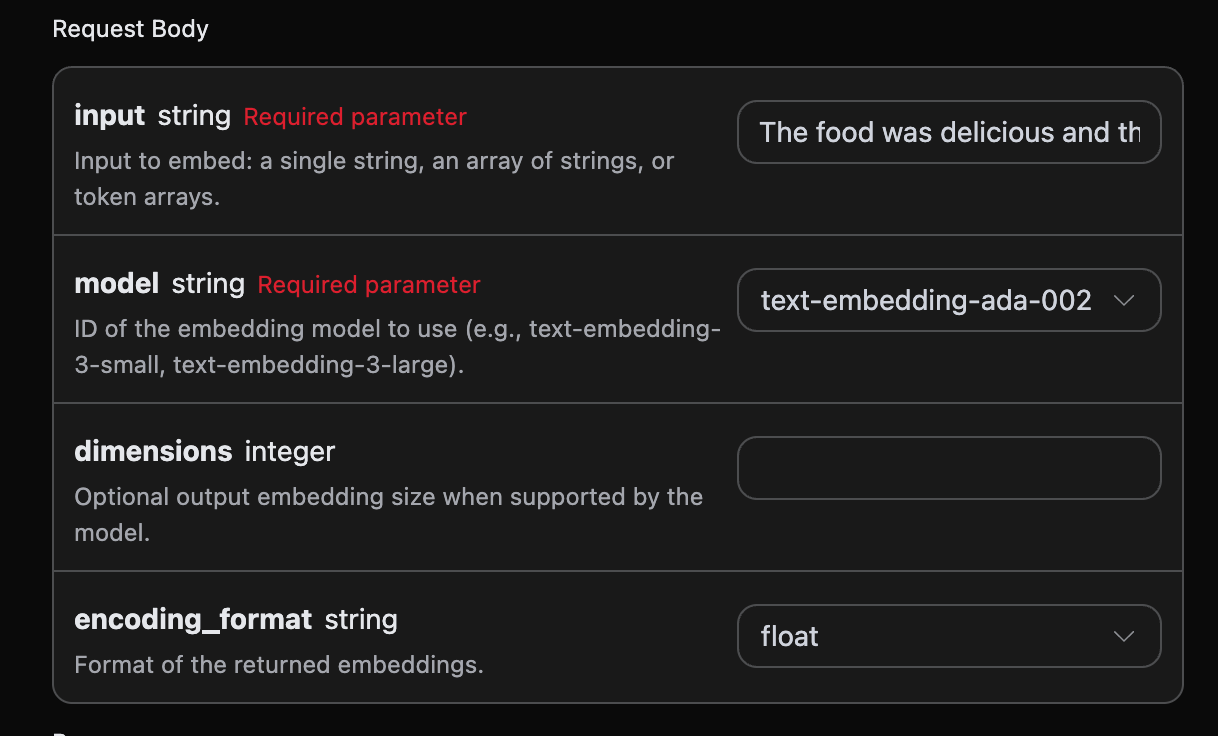
authorization, його можна безпосередньо вибрати у розкривному списку. Інший параметр — model, model — це категорія моделі з офіційного сайту OpenAI, яку ми обираємо для використання; наразі доступні моделі text-embedding-3-small і text-embedding-3-large. text-embedding-ada-002 більше не надається; якщо наявний векторний індекс використовує цю стару модель, не можна безпосередньо змішувати вектори нової моделі, потрібно повторно створити індекс. Останній параметр — input, input — це текст для векторизації слів, який нам потрібно перетворити.
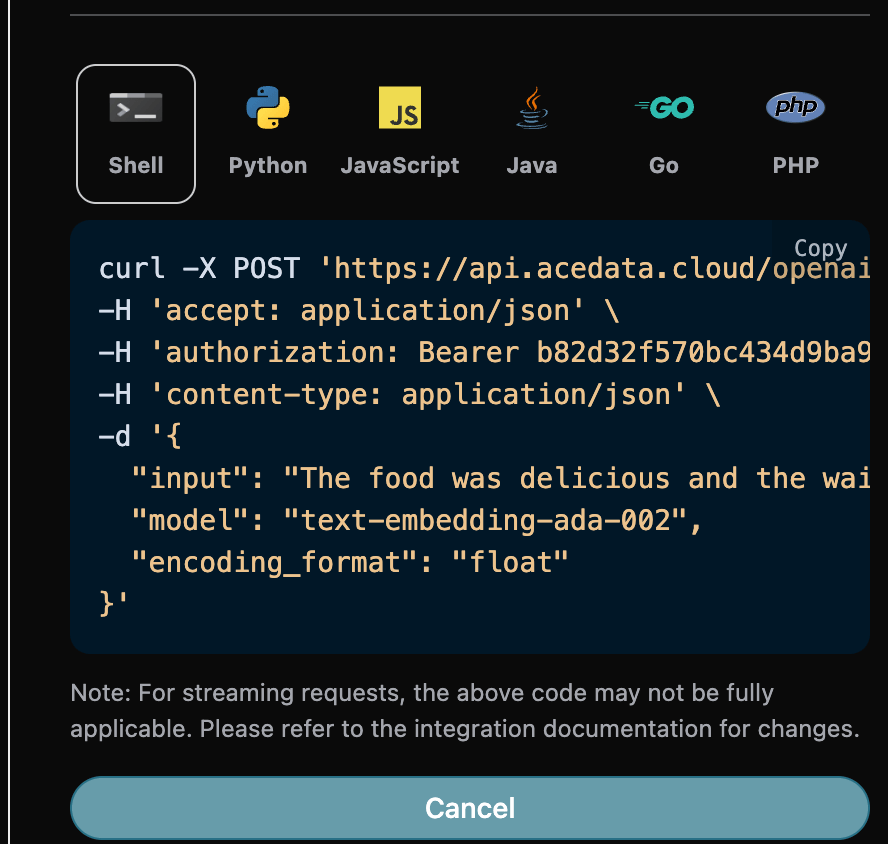
Водночас ви можете помітити, що праворуч є генерація відповідного коду виклику, ви можете скопіювати код і запустити його безпосередньо, або безпосередньо натиснути кнопку «Try» для тестування.
Необов’язкові параметри:
dimensions: обрізання розмірності вектора, за замовчуванням виводиться повна розмірність.encoding_format: формат повернення, доступніfloatабоbase64.
model— модель, використана для цього перетворення тексту у вектор слів.usage— інформація про token, використані для цього перетворення тексту у вектор слів.data— результат вектора слів після перетворення тексту.
data містить конкретну інформацію про вектор слів, що відповідає тексту, а embedding у ньому є конкретним згенерованим результатом вектора слів.
Обробка помилок
Під час виклику API, якщо виникає помилка, API поверне відповідний код помилки та інформацію. Наприклад:400 token_mismatched: Неправильний запит, можливо через відсутні або недійсні параметри.400 api_not_implemented: Неправильний запит, можливо через відсутні або недійсні параметри.401 invalid_token: Неавторизовано, недійсний або відсутній токен авторизації.429 too_many_requests: Забагато запитів, ви перевищили обмеження частоти.500 api_error: Внутрішня помилка сервера, щось пішло не так на сервері.