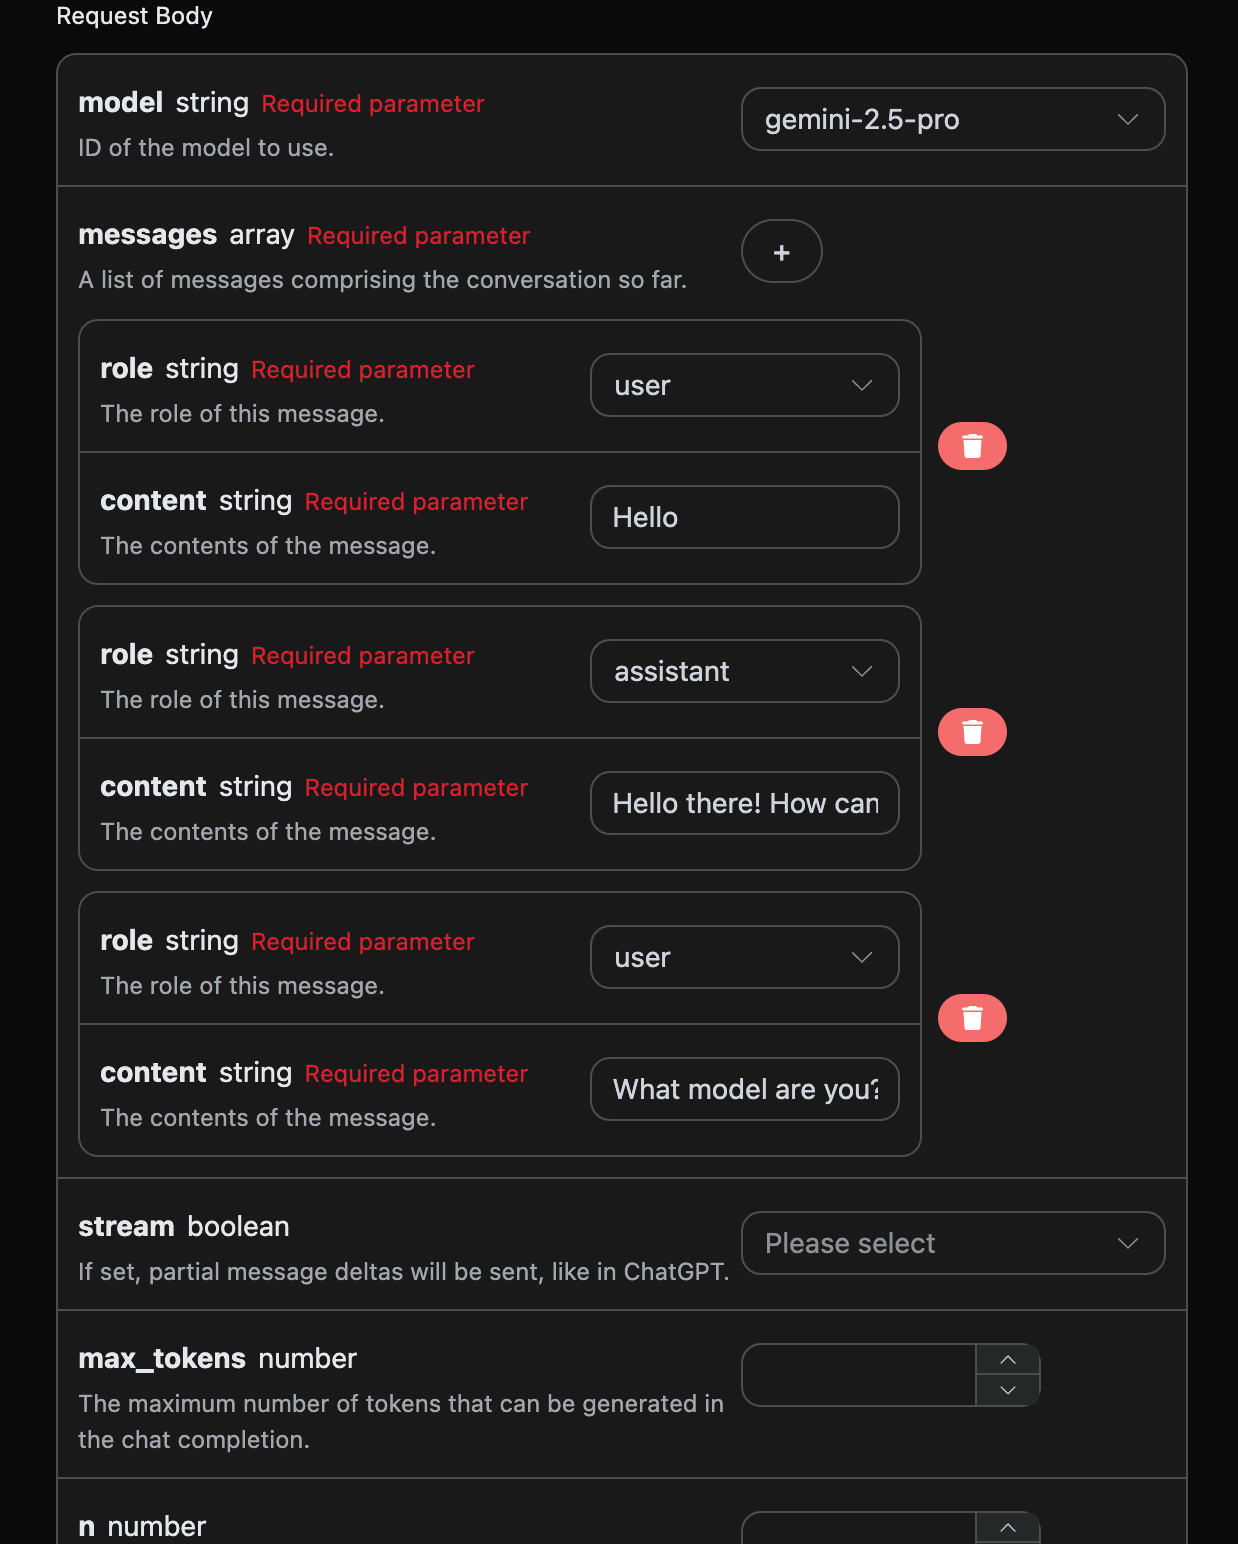
data: {"id": "chatcmpl-20251122214038810722821kNjUTjtr", "object": "chat.completion.chunk", "created": 1763818842, "model": "gemini-2.5-pro", "system_fingerprint": null, "choices": [{"delta": {"content": "", "role": "assistant"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

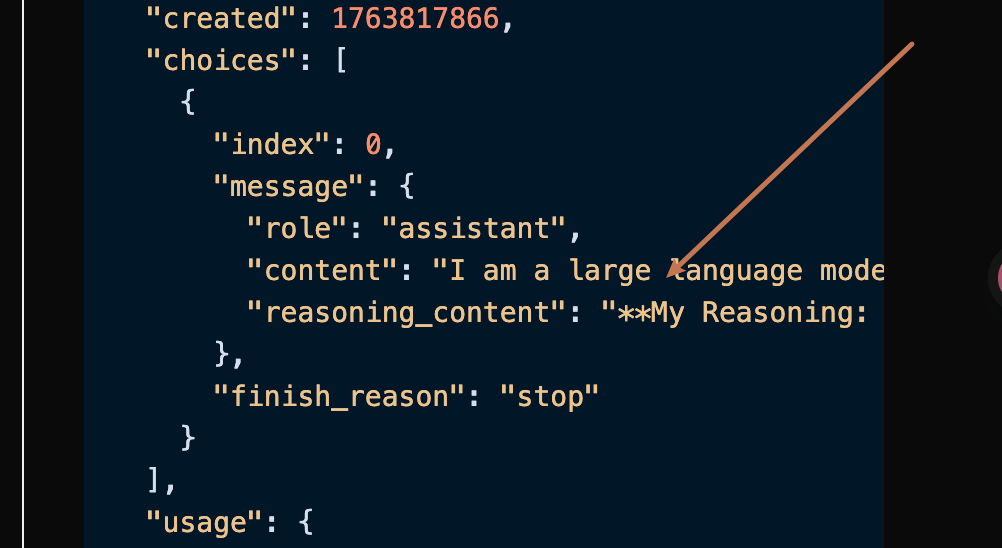
data: {"id": "chatcmpl-20251122214038810722821kNjUTjtr", "object": "chat.completion.chunk", "created": 1763818842, "model": "gemini-2.5-pro", "system_fingerprint": null, "choices": [{"delta": {"reasoning_content": "**Define My Nature**\n\nMy thinking has started. The user wants to know my nature, asking a direct \"what are you?\" The initial step was straightforward: identifying the query. Now, I recall my fundamental identity: I'm a large language model. This is the core truth I aim to convey.\n\n\n"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "chatcmpl-20251122214038810722821kNjUTjtr", "object": "chat.completion.chunk", "created": 1763818842, "model": "gemini-2.5-pro", "system_fingerprint": null, "choices": [{"delta": {"reasoning_content": "**Refining My Response**\n\nI've added the crucial information that I'm trained by Google to the basic \"large language model\" identity. My next step is considering what being a \"large language model\" actually entails, so I can explain my core capabilities. I'm focusing on providing context without going into specific technical details or model names. I want to convey my function in a way the user can easily understand.\n\n\n"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "chatcmpl-20251122214038810722821kNjUTjtr", "object": "chat.completion.chunk", "created": 1763818842, "model": "gemini-2.5-pro", "system_fingerprint": null, "choices": [{"delta": {"reasoning_content": "**Confirming Core Identity**\n\nI'm now solidifying my response. The user's query about my model affiliation needs a focused answer. I've pinpointed that \"trained by Google\" is essential, providing key context. I'm resisting the urge to mention any specific model names, as it's not relevant. The aim is to deliver a direct, accurate statement. My goal remains a clear and concise reply, avoiding technical jargon and getting straight to the relevant point.\n\n\n"}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "chatcmpl-20251122214038810722821kNjUTjtr", "object": "chat.completion.chunk", "created": 1763818842, "model": "gemini-2.5-pro", "system_fingerprint": null, "choices": [{"delta": {"content": "I am a large language model, trained by Google."}, "logprobs": null, "finish_reason": null, "index": 0}], "usage": null}

data: {"id": "chatcmpl-20251122214038810722821kNjUTjtr", "object": "chat.completion.chunk", "created": 1763818842, "model": "gemini-2.5-pro", "system_fingerprint": null, "choices": [{"delta": {}, "logprobs": null, "finish_reason": "stop", "index": 0}], "usage": null}

data: {"id": "chatcmpl-20251122214038810722821kNjUTjtr", "object": "chat.completion.chunk", "created": 1763818842, "model": "gemini-2.5-pro", "system_fingerprint": "", "choices": [], "usage": {"prompt_tokens": 8, "completion_tokens": 527, "total_tokens": 535, "prompt_tokens_details": {"cached_tokens": 0, "text_tokens": 8, "audio_tokens": 0, "image_tokens": 0}, "completion_tokens_details": {"text_tokens": 0, "audio_tokens": 0, "reasoning_tokens": 519}, "input_tokens": 0, "output_tokens": 0, "input_tokens_details": null, "claude_cache_creation_5_m_tokens": 0, "claude_cache_creation_1_h_tokens": 0}}

data: [DONE]


 Якщо ви ще не увійшли в систему або не зареєструвалися, вас буде автоматично перенаправлено на сторінку входу із запрошенням зареєструватися та увійти в систему, після завершення ви автоматично повернетеся на поточну сторінку.
Один API Token може викликати всі сервіси платформи, не потрібно подавати окрему заявку для кожного сервісу. Під час першого подання заявки буде надано безкоштовний ліміт для безкоштовного ознайомлення; коли ліміту недостатньо, ви можете поповнити універсальний баланс у консолі.