

Processo de solicitação
Para usar a API Claude Chat Completion, primeiro acesse o Console Ace Data Cloud para obter seu API Token e guarde-o para uso posterior. Se você ainda não estiver conectado ou registrado, será automaticamente redirecionado para a página de login para se registrar e entrar, e, após a conclusão, retornará automaticamente à página atual.
Um API Token pode chamar todos os serviços da plataforma, sem a necessidade de solicitar separadamente para cada serviço. A primeira solicitação oferece créditos gratuitos, permitindo uma experiência gratuita; quando os créditos forem insuficientes, você poderá recarregar o saldo universal no console.
📘 Documentação completa: Claude Chat Completion API →
Uso básico
Em seguida, você pode preencher o conteúdo correspondente na interface, conforme mostrado na imagem: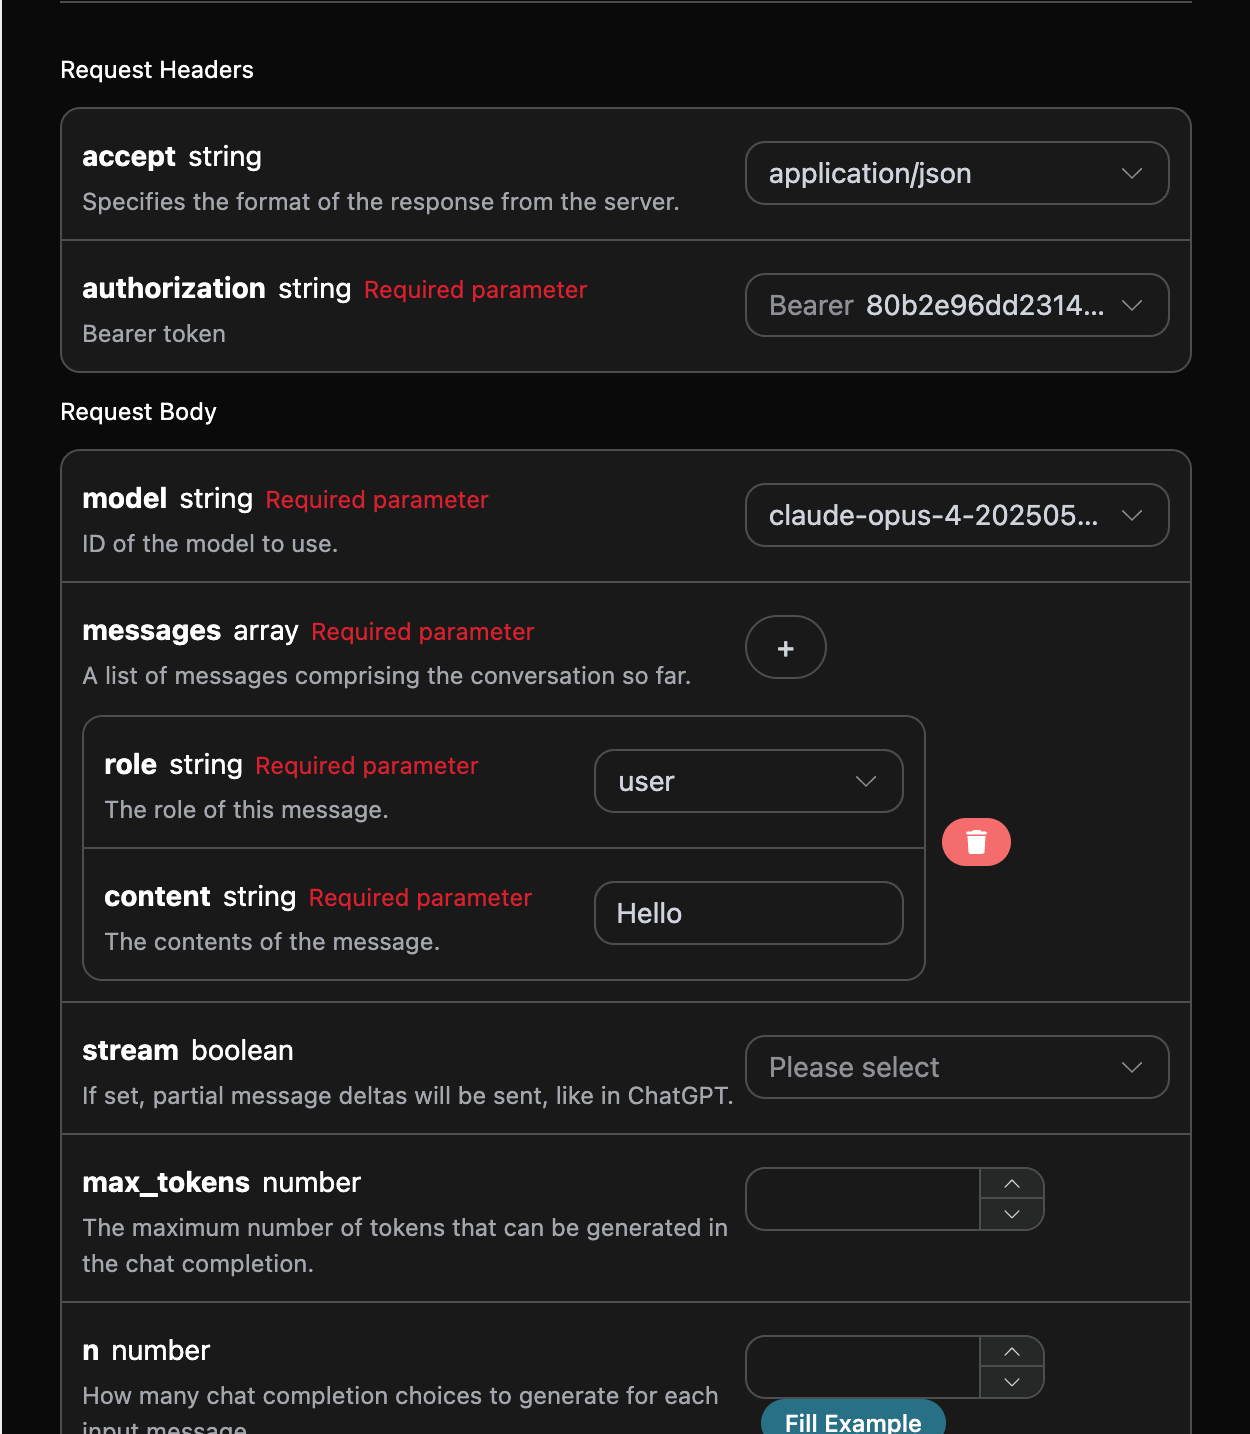
authorization, que pode ser selecionado diretamente na lista suspensa. Outro parâmetro é model, sendo recomendado usar o mais recente modelo principal claude-fable-5-1; o antigo claude-fable-5 ainda pode continuar sendo chamado. O último parâmetro é messages, que é um array de prompts de pergunta, e cada elemento contém role e content; role suporta user, assistant, system, e content é o conteúdo específico. Claude Fable 5.1 suporta contexto de 1 milhão de Tokens e saída máxima de 128K Tokens.
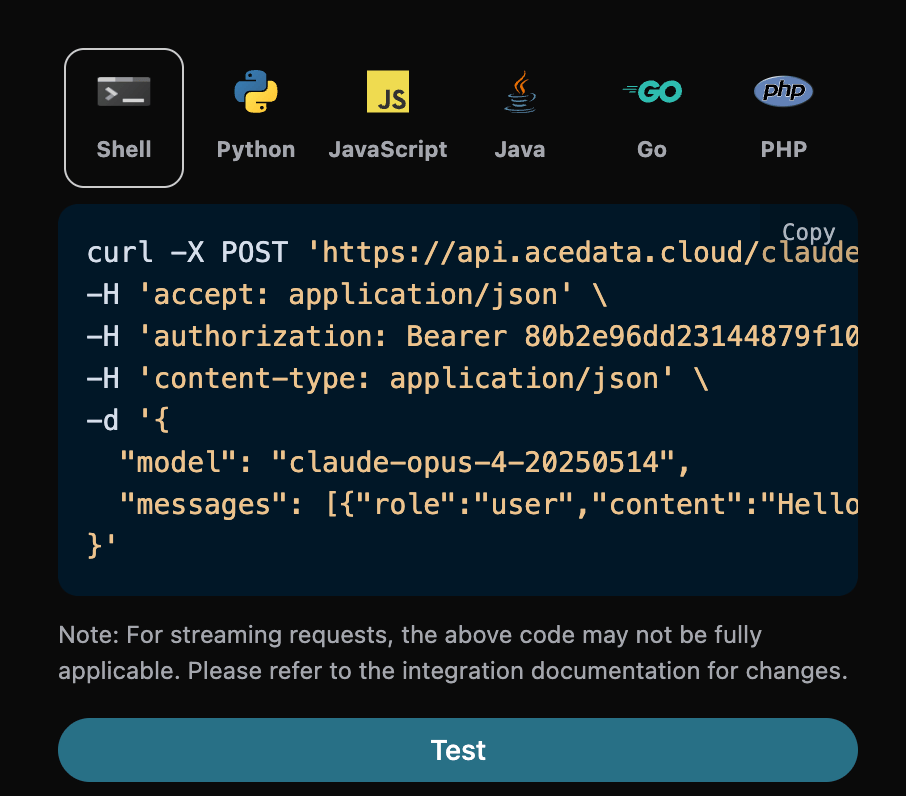
Ao mesmo tempo, você pode observar que há geração do código de chamada correspondente à direita. Você pode copiar o código e executá-lo diretamente, ou clicar diretamente no botão «Try» para testar.
Parâmetros opcionais comuns:
max_tokens: limita o número máximo de tokens em uma única resposta.temperature: aleatoriedade da geração, entre 0 e 2; quanto maior o valor, mais disperso será.n: quantas respostas candidatas gerar de uma vez.response_format: configuração do formato de retorno.
id, o ID da tarefa de conversa gerada desta vez, usado para identificar exclusivamente esta tarefa de conversa.model, o modelo Claude oficial selecionado.choices, as informações de resposta fornecidas pelo Claude para o prompt de pergunta.usage: informações estatísticas sobre tokens para esta sessão de perguntas e respostas.
usage.prompt_tokens é o total de entrada; prompt_tokens_details.cached_tokens e prompt_tokens_details.cache_write_tokens registram, respectivamente, os detalhes de leitura e gravação de cache. completion_tokens_details.reasoning_tokens é um subconjunto de completion_tokens; não os some novamente ao calcular o total ou o custo. Respostas não stream também podem retornar o objeto usage.cost, no qual amount é o consumo real de créditos, currency é a unidade de medida, e list_amount é o valor antes do desconto (se houver).
O nome do campo compatível com Chat é reasoning_tokens; a API Messages nativa usa output_tokens_details.thinking_tokens. O wire schema dos dois protocolos é diferente, e o cliente não deve misturar os nomes dos campos.
Entre eles, choices contém as informações de resposta do Claude, e os choices dentro dele são as informações específicas da resposta do Claude, como pode ser visto na imagem.
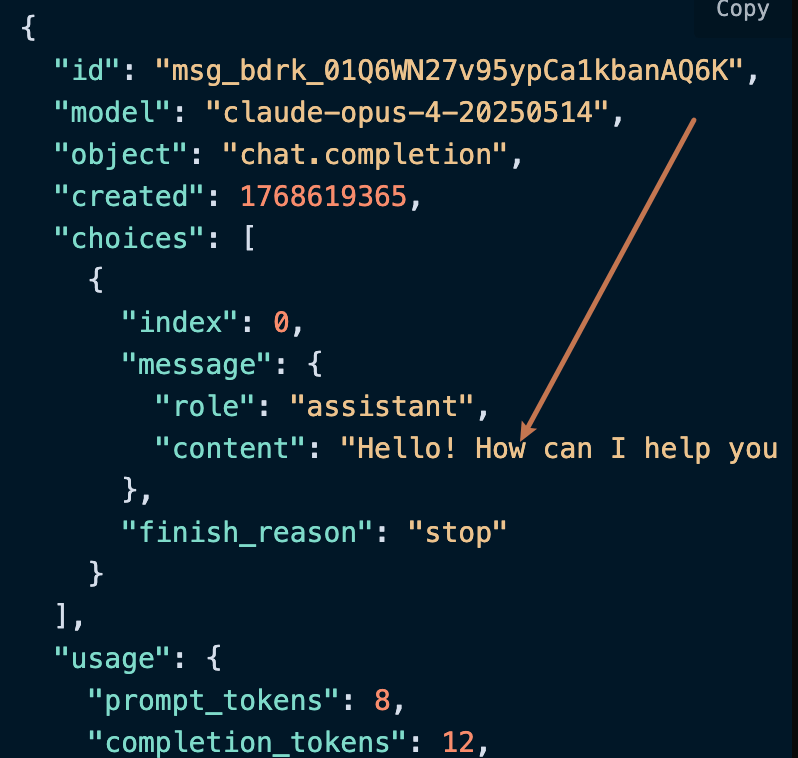
content dentro de choices contém o conteúdo específico da resposta do Claude.
Resposta em streaming
Essa interface também oferece suporte a respostas em streaming, o que é muito útil para integração com páginas web, permitindo que a página web implemente o efeito de exibição caractere por caractere. Se desejar retornar respostas em streaming, você pode alterar o parâmetrostream no cabeçalho da solicitação para true.
A modificação é mostrada na imagem, mas o código de chamada precisa ser alterado correspondentemente para oferecer suporte à resposta em streaming.
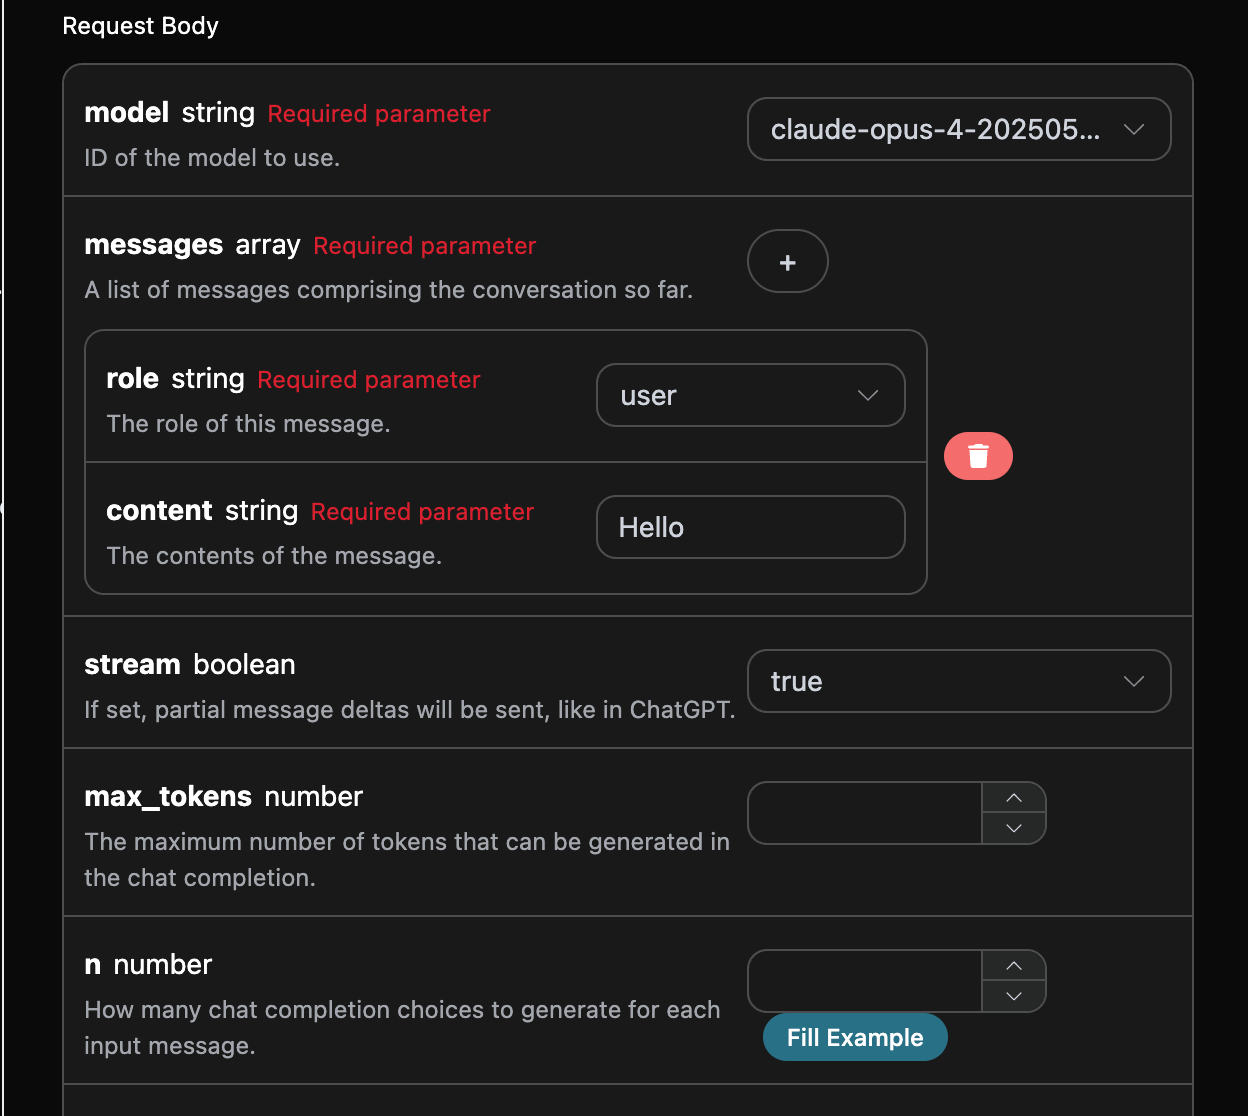
stream para true, a API retornará os dados JSON correspondentes linha por linha. No nível do código, precisamos fazer as modificações correspondentes para obter os resultados linha por linha.
Código de chamada de exemplo em Python:
data na resposta, e os choices dentro de data são o conteúdo mais recente da resposta, consistente com o conteúdo apresentado acima. choices é o novo conteúdo da resposta, e você pode integrá-lo ao seu sistema com base nos resultados. Ao mesmo tempo, o fim da resposta em streaming é determinado pelo conteúdo de data; se o conteúdo for [DONE], isso indica que a resposta em streaming foi totalmente concluída. O resultado data retornado possui vários campos, apresentados a seguir:
id, o ID da tarefa desta conversa gerada, usado para identificar exclusivamente esta tarefa de conversa.model, o modelo oficial do Claude selecionado.choices, as informações de resposta fornecidas pelo Claude para a pergunta.
Conversa com múltiplas rodadas
Se você quiser integrar a funcionalidade de conversa com múltiplas rodadas, precisará enviar várias perguntas no campomessages; exemplos específicos de várias perguntas são mostrados na imagem abaixo:
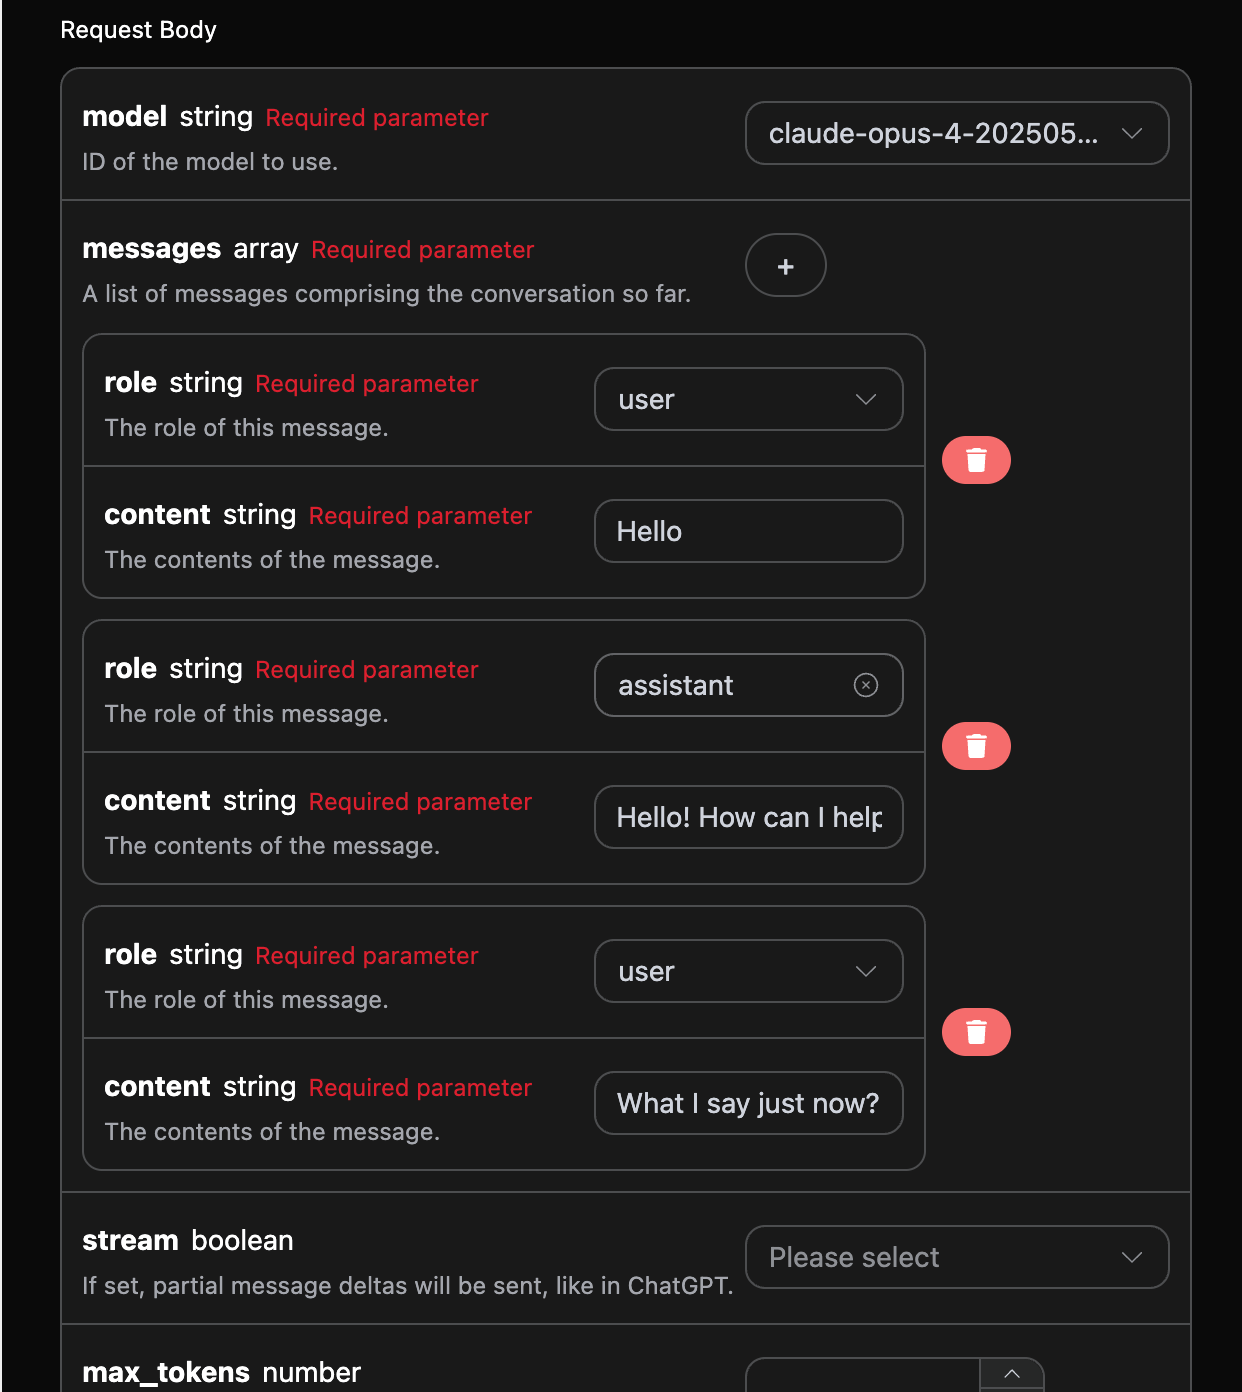
choices são consistentes com o conteúdo do uso básico; isso contém o conteúdo específico da resposta do Claude para várias conversas, permitindo assim responder às perguntas correspondentes com base em vários conteúdos de conversa.
Pensamento profundo
Os modelos Claude de nova geração podem realizar raciocínio de acordo com a estratégia padrão do modelo, sem a necessidade de acioná-lo por meio do sufixo de modelo-thinking. As respostas compatíveis com Chat usam o campo de usage compatível com OpenAI completion_tokens_details.reasoning_tokens. reasoning_tokens já está incluído em completion_tokens, não o some novamente. O raciocínio e o corpo visível compartilham o limite de tokens de saída, portanto, quando max_tokens for pequeno, o corpo pode ficar vazio ou ser truncado; nesse caso, aumente o orçamento de saída ou, quando o modelo utilizado oferecer suporte, escolha um nível menor de esforço de raciocínio.
Se precisar de thinking nativo, output_config.effort, blocos de conteúdo thinking e retorno de assinatura, use /v1/messages. O campo usage correspondente a Messages é output_tokens_details.thinking_tokens; não o misture com completion_tokens_details.reasoning_tokens compatível com Chat.
Modelos visuais
claude-sonnet-4-20250514 é um modelo multimodal de linguagem de grande porte desenvolvido pela Claude, que adiciona capacidades de compreensão visual com base no claude-4. Este modelo pode processar simultaneamente entradas de texto e imagem, alcançando compreensão e geração multimodais. O processamento de texto usando o modelo claude-sonnet-4-20250514 é consistente com o conteúdo básico de uso acima; a seguir, será apresentada brevemente a forma de usar a capacidade de processamento de imagens do modelo. A capacidade de processamento de imagens usando o modelo claude-sonnet-4-20250514 é obtida principalmente adicionando um campotype com base no conteúdo content original. Por meio desse campo, é possível saber se o que foi enviado é texto ou imagem, usando assim a capacidade de processamento de imagens do modelo claude-sonnet-4-20250514. A seguir, é descrito principalmente como chamar essa funcionalidade usando Curl e Python.
- Método de script Curl
- Método de script Python
Tratamento de erros
Ao chamar a API, se ocorrer um erro, a API retornará o código e as informações de erro correspondentes. Por exemplo:400 token_mismatched:Solicitação inválida, possivelmente devido a parâmetros ausentes ou inválidos.400 api_not_implemented:Solicitação inválida, possivelmente devido a parâmetros ausentes ou inválidos.401 invalid_token:Não autorizado, token de autorização inválido ou ausente.429 too_many_requests:Muitas solicitações, você excedeu o limite de taxa.500 api_error:Erro interno do servidor, algo deu errado no servidor.