

Proces składania wniosku
Aby korzystać z Claude Chat Completion API, najpierw przejdź do konsoli Ace Data Cloud, aby uzyskać swój API Token i zachować go na później. Jeśli nie jesteś jeszcze zalogowany lub zarejestrowany, zostaniesz automatycznie przekierowany na stronę logowania, która zaprosi Cię do rejestracji i logowania, a po zakończeniu automatycznie wrócisz na bieżącą stronę.
Jeden API Token umożliwia wywoływanie wszystkich usług platformy, bez potrzeby osobnego składania wniosku dla każdej usługi. Przy pierwszym wniosku otrzymasz darmowy limit, który pozwala na bezpłatne wypróbowanie; gdy limit jest niewystarczający, możesz doładować uniwersalne saldo w konsoli.
📘 Pełna dokumentacja: Claude Chat Completion API →
Podstawowe użycie
Następnie możesz wypełnić odpowiednią zawartość w interfejsie, jak pokazano na ilustracji: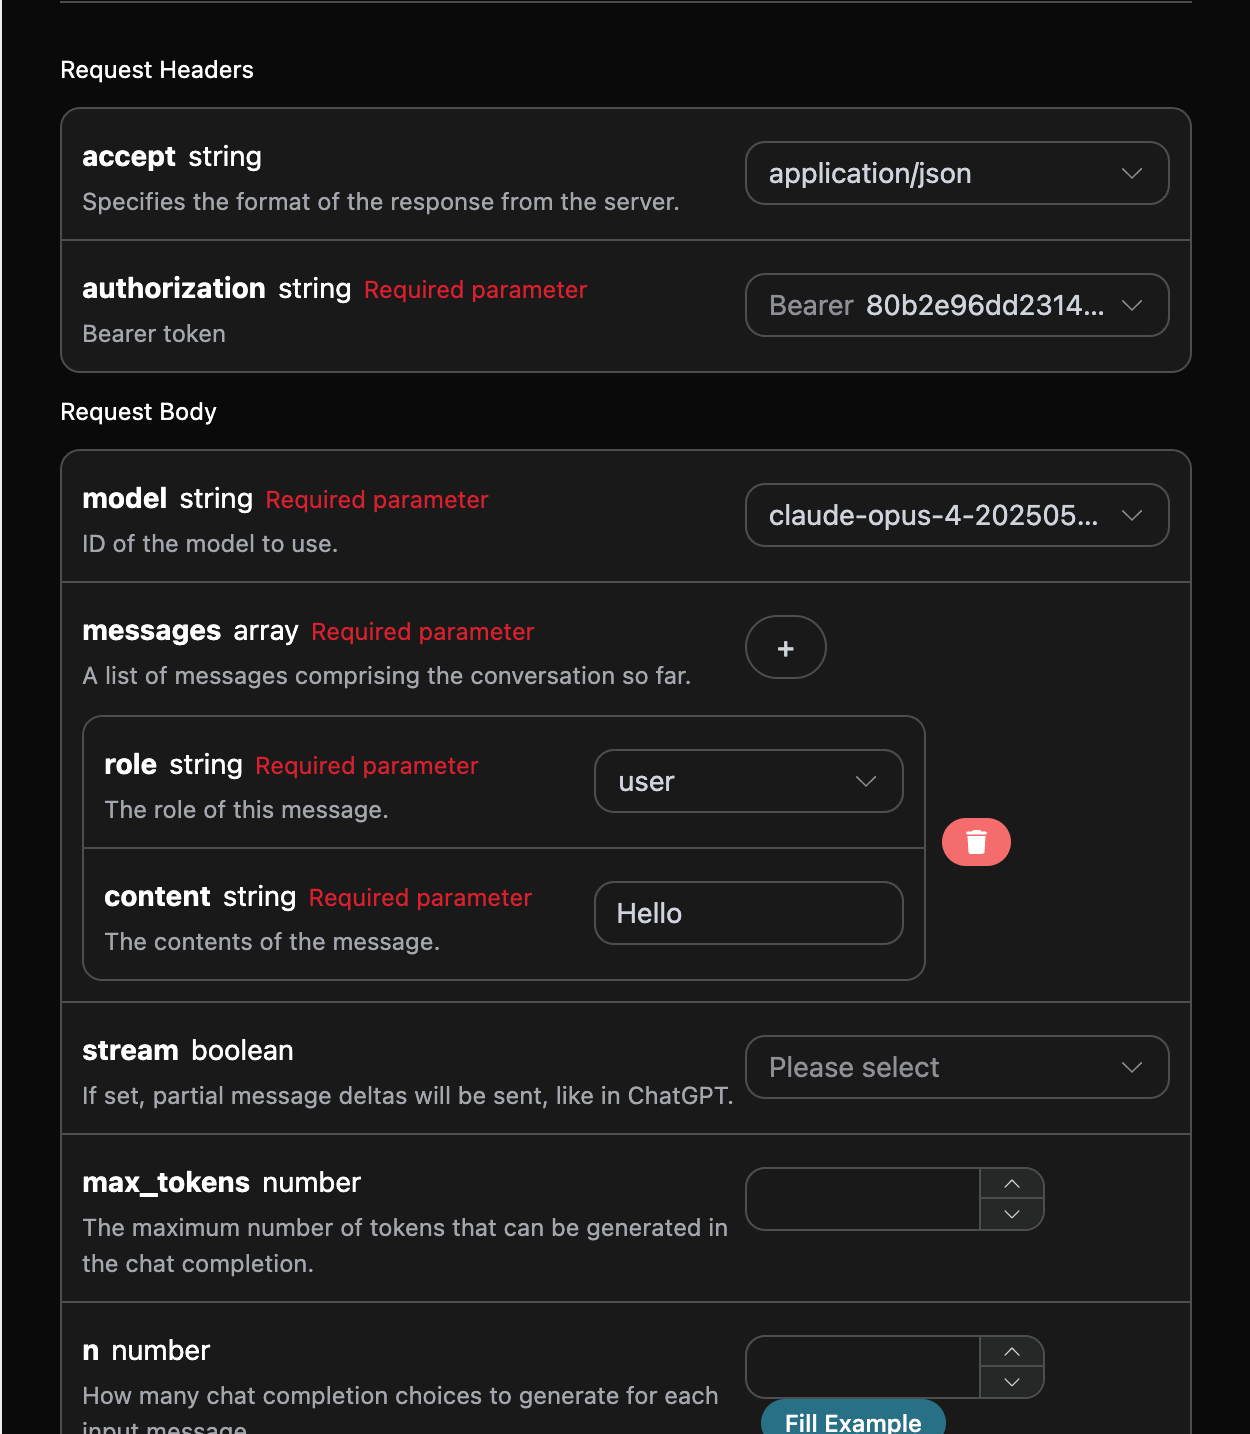
authorization, który można bezpośrednio wybrać z listy rozwijanej. Kolejny parametr to model, zalecane jest użycie najnowszego flagowego claude-fable-5-1; poprzedni claude-fable-5 nadal może być wywoływany. Ostatni parametr to messages, jest to tablica promptów, każdy element zawiera role i content; role obsługuje user, assistant, system, a content to konkretna treść. Claude Fable 5.1 obsługuje kontekst 1 miliona Tokenów i maksymalny wynik 128K Tokenów.
Jednocześnie możesz zauważyć, że po prawej stronie generowany jest odpowiedni kod wywołania; możesz skopiować kod i uruchomić go bezpośrednio, a także bezpośrednio kliknąć przycisk „Try”, aby przeprowadzić test.
Często używane opcjonalne parametry:
max_tokens: ogranicza maksymalną liczbę tokenów w pojedynczej odpowiedzi.temperature: losowość generowania, między 0 a 2, im większa wartość, tym bardziej rozbieżny wynik.n: ile kandydatów odpowiedzi wygenerować jednorazowo.response_format: ustawienie formatu zwracanego wyniku.
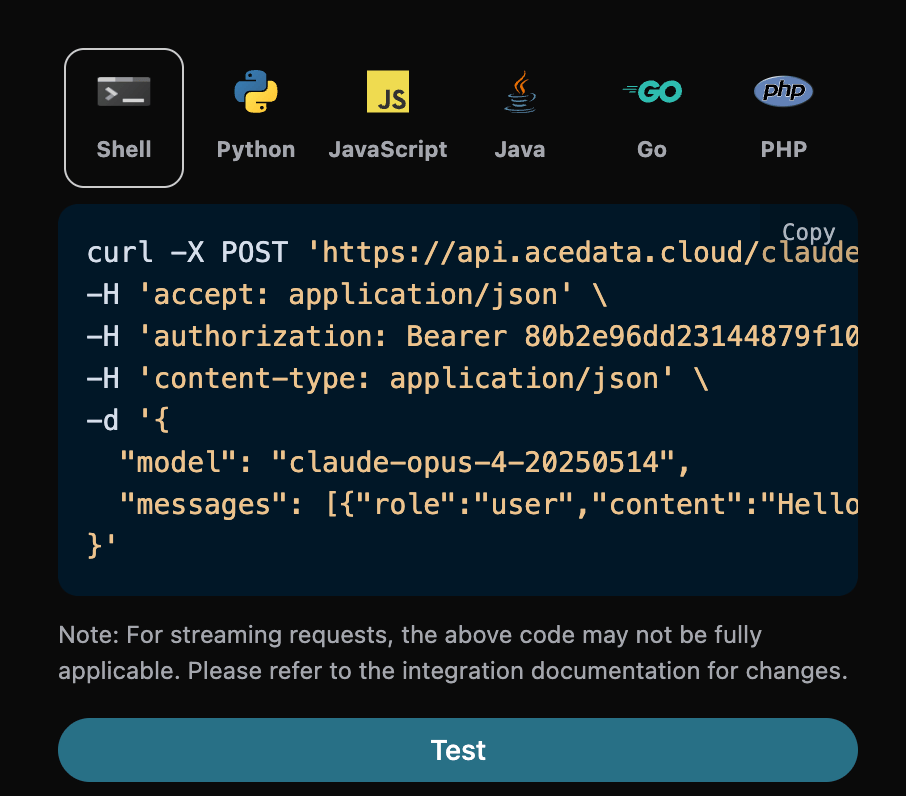
id, ID wygenerowanego zadania tej konwersacji, używane do jednoznacznego identyfikowania tego zadania konwersacji.model, wybrany model Claude z oficjalnej strony.choices, informacje o odpowiedzi udzielonej przez Claude na prompt.usage: informacje statystyczne dotyczące tokenów dla tej sesji pytań i odpowiedzi.
usage.prompt_tokens to całkowita ilość danych wejściowych; prompt_tokens_details.cached_tokens i prompt_tokens_details.cache_write_tokens rejestrują odpowiednio szczegóły odczytu i zapisu pamięci podręcznej. completion_tokens_details.reasoning_tokens jest podzbiorem completion_tokens; podczas obliczania łącznej liczby lub kosztu nie należy dodawać go ponownie. Odpowiedzi niestrumieniowe mogą również zwracać obiekt usage.cost, w którym amount oznacza faktyczne zużycie limitu, currency jest jednostką rozliczeniową, a list_amount jest kwotą przed rabatem (jeśli występuje).
Nazwa pola zgodna z Chat to reasoning_tokens; natywny Messages API używa output_tokens_details.thinking_tokens. Wire schema obu protokołów jest różny, dlatego klient nie powinien mieszać nazw pól.
Wśród nich choices zawiera informacje o odpowiedzi Claude, a choices w nim to konkretne informacje o odpowiedzi Claude, co można zobaczyć, jak pokazano na ilustracji.
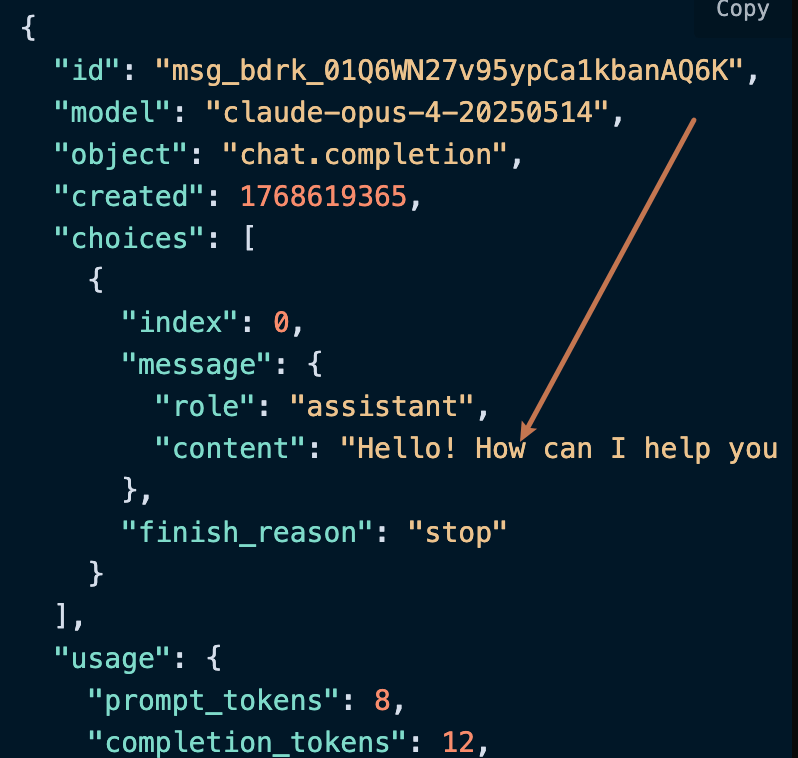
content w choices zawiera konkretną treść odpowiedzi Claude.
Odpowiedź strumieniowa
Ten interfejs obsługuje również odpowiedzi strumieniowe, co jest bardzo przydatne przy integracji ze stroną internetową i pozwala stronie osiągnąć efekt wyświetlania znak po znaku. Jeśli chcesz zwracać odpowiedź strumieniowo, możesz zmienić parametrstream w nagłówku żądania na true.
Modyfikacja jest pokazana na ilustracji, jednak kod wywołania wymaga odpowiednich zmian, aby obsługiwać odpowiedź strumieniową.
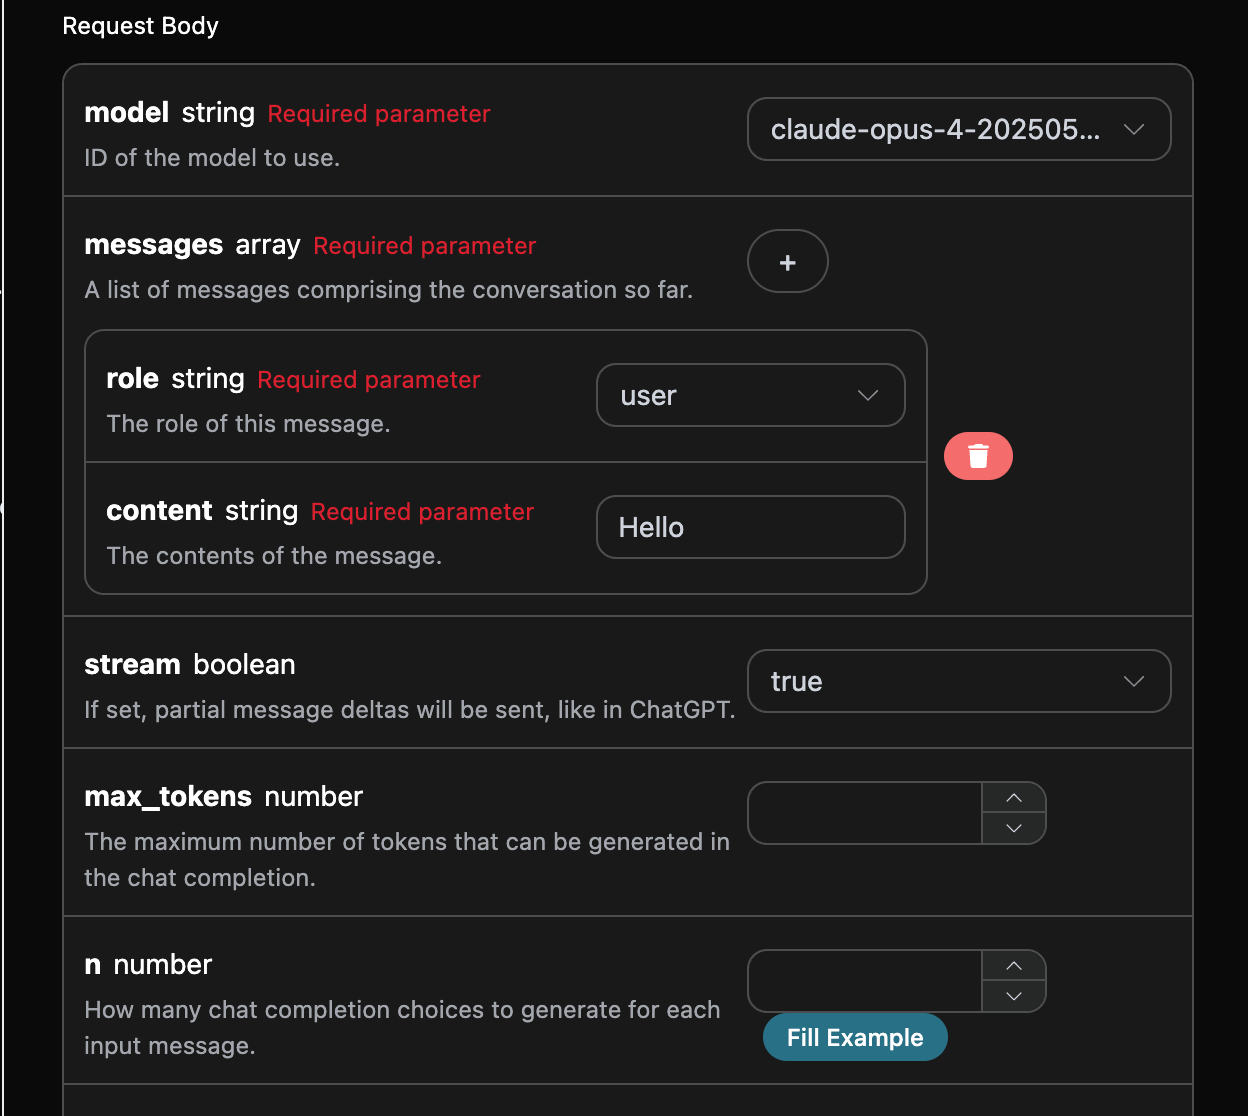
stream na true, API będzie zwracać odpowiednie dane JSON wiersz po wierszu, a na poziomie kodu musimy wprowadzić odpowiednie modyfikacje, aby uzyskać wyniki wiersz po wierszu.
Przykładowy kod wywołania w Pythonie:
data, a choices w data to najnowsza treść odpowiedzi, zgodna z treścią przedstawioną powyżej. choices to nowo dodana treść odpowiedzi, którą można zintegrować ze swoim systemem na podstawie wyników. Jednocześnie zakończenie odpowiedzi strumieniowej jest określane na podstawie zawartości data; jeśli jej zawartością jest [DONE], oznacza to, że odpowiedź strumieniowa została całkowicie zakończona. Zwrócony wynik data zawiera wiele pól, opisanych poniżej:
id— ID wygenerowanego zadania tej rozmowy, używane do jednoznacznej identyfikacji tego zadania rozmowy.model— wybrany model Claude z oficjalnej strony.choices— informacje o odpowiedzi udzielonej przez Claude na zapytanie.
Rozmowa wieloturowa
Jeśli chcesz zintegrować funkcję rozmowy wieloturowej, musisz przesłać wiele zapytań w polumessages; konkretny przykład wielu zapytań przedstawiono na poniższym obrazku:
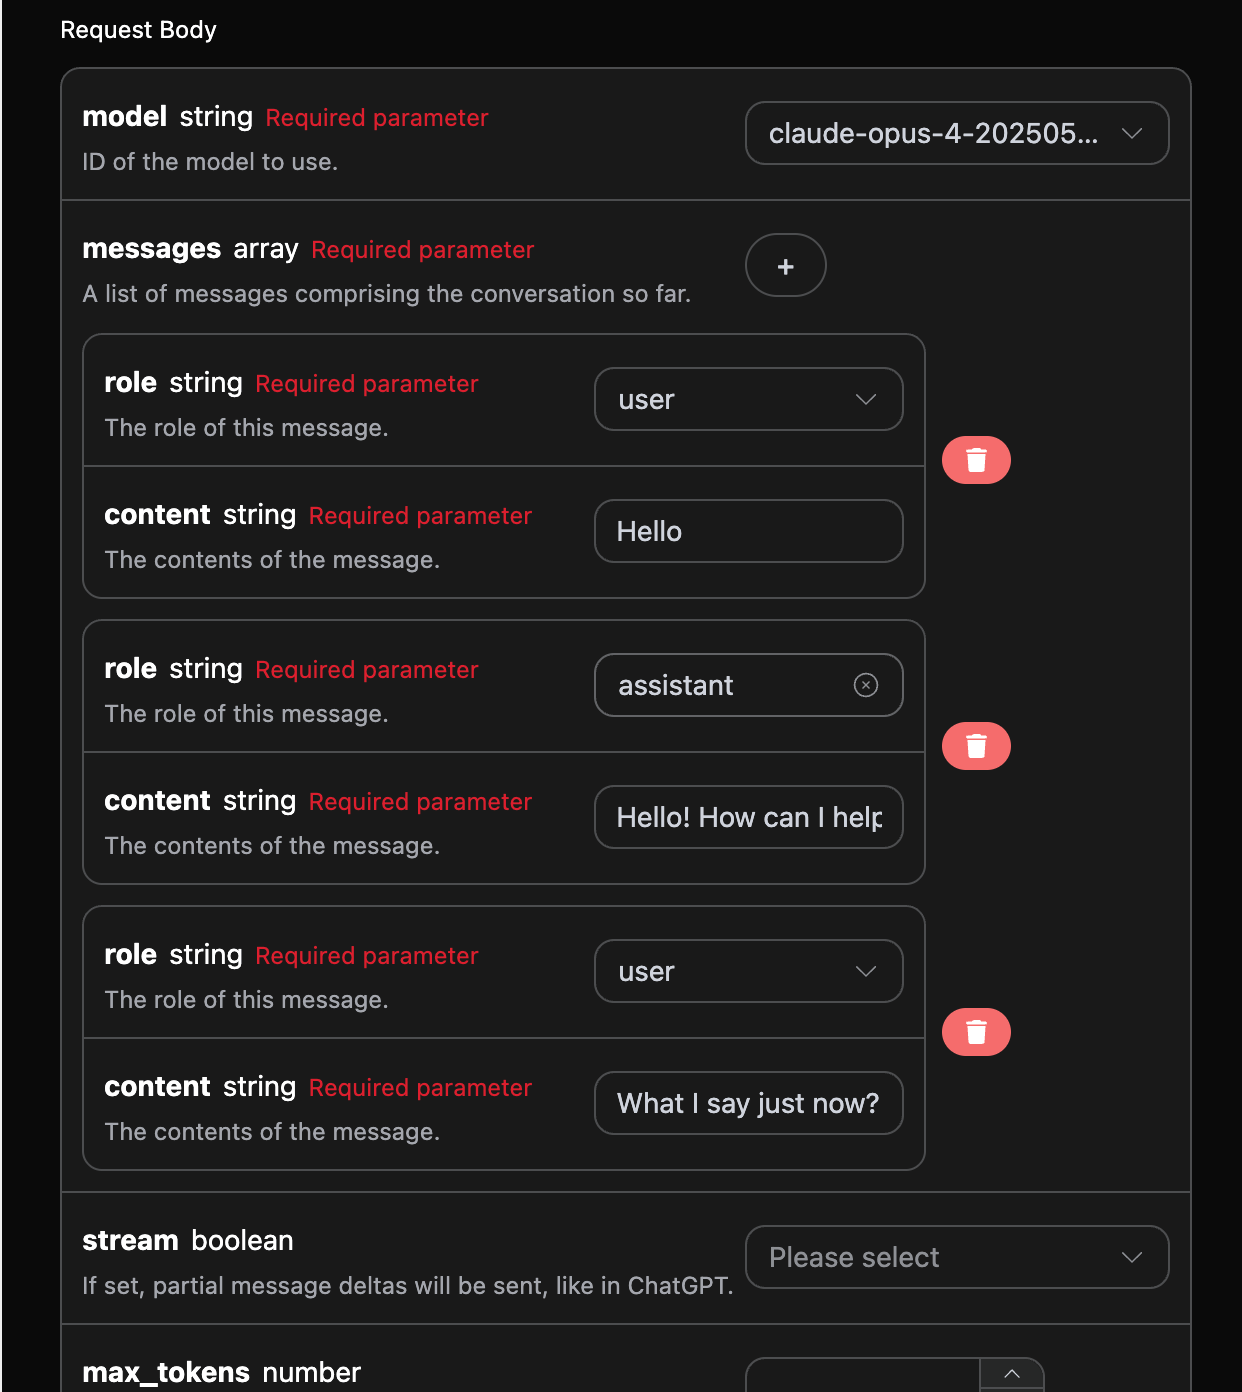
choices są zgodne z treścią podstawowego użycia; zawiera to szczegółową treść odpowiedzi Claude na wiele rozmów, dzięki czemu można odpowiadać na odpowiednie pytania na podstawie treści wielu rozmów.
Głębokie rozumowanie
Modele Claude nowej generacji mogą prowadzić rozumowanie zgodnie z domyślną strategią modelu, bez konieczności wyzwalania go przez sufiks modelu-thinking. Odpowiedzi zgodne z Chat używają kompatybilnego z OpenAI pola usage completion_tokens_details.reasoning_tokens. reasoning_tokens jest już zawarte w completion_tokens, nie należy ich dodawać ponownie. Rozumowanie i widoczna treść główna współdzielą limit tokenów wyjściowych, dlatego przy małej wartości max_tokens treść główna może być pusta lub obcięta; w takim przypadku należy zwiększyć budżet wyjściowy lub, jeśli używany model to obsługuje, wybrać niższy nakład rozumowania.
Jeśli potrzebne są natywne thinking, output_config.effort, bloki treści thinking oraz zwrot podpisów, należy użyć /v1/messages. Odpowiadające Messages pole usage to output_tokens_details.thinking_tokens, nie należy mieszać go z completion_tokens_details.reasoning_tokens dla Chat-compatible.
Modele wizyjne
claude-sonnet-4-20250514 to multimodalny duży model językowy opracowany przez Claude, który na bazie claude-4 zwiększa możliwości rozumienia obrazu. Model ten może jednocześnie przetwarzać wejścia tekstowe i obrazowe, realizując rozumienie i generowanie między modalnościami. Przetwarzanie tekstu przy użyciu modelu claude-sonnet-4-20250514 jest zgodne z podstawowym sposobem użycia opisanym powyżej, poniżej zostanie krótko przedstawione, jak używać możliwości przetwarzania obrazu przez model. Możliwość przetwarzania obrazu przez model claude-sonnet-4-20250514 jest realizowana głównie poprzez dodanie polatype do pierwotnej zawartości content; dzięki temu polu można określić, czy przesyłany jest tekst czy obraz, a następnie użyć możliwości przetwarzania obrazu modelu claude-sonnet-4-20250514. Poniżej opisano głównie wywołanie tej funkcji na dwa sposoby: za pomocą Curl i Python.
- Metoda skryptu Curl
- Metoda skryptu Python
Obsługa błędów
Podczas wywoływania API, jeśli wystąpi błąd, API zwróci odpowiedni kod błędu i informacje. Na przykład:400 token_mismatched:Nieprawidłowe żądanie, prawdopodobnie z powodu brakujących lub nieprawidłowych parametrów.400 api_not_implemented:Nieprawidłowe żądanie, prawdopodobnie z powodu brakujących lub nieprawidłowych parametrów.401 invalid_token:Brak autoryzacji, nieprawidłowy lub brakujący token autoryzacyjny.429 too_many_requests:Zbyt wiele żądań, przekroczono limit szybkości.500 api_error:Wewnętrzny błąd serwera, coś poszło nie tak po stronie serwera.