> ## Documentation Index
> Fetch the complete documentation index at: https://docs.acedata.cloud/llms.txt
> Use this file to discover all available pages before exploring further.
# Guía de integración de la API de generación de video MiniMax H3
> Minimax API guide - Ace Data Cloud
Este artículo presenta la integración y el uso de la API de generación de video MiniMax H3. Esta interfaz admite generación de video a partir de texto, control de fotograma inicial y final, y generación de video con referencias multimodales, utilizando una estructura V2 multimodal `content` unificada para crear tareas.
## Proceso de solicitud
Para usar la API de generación de video MiniMax H3, primero ve a la [consola de Ace Data Cloud](https://platform.acedata.cloud/console/applications) para obtener tu API Token y guardarlo como respaldo.

Si aún no has iniciado sesión o te has registrado, se te redirigirá automáticamente a la página de inicio de sesión para invitarte a registrarte e iniciar sesión; al finalizar, volverás automáticamente a la página actual.
**Un único API Token permite llamar a todos los servicios de la plataforma, sin necesidad de solicitar uno por separado para cada servicio.** La primera solicitud incluirá créditos gratuitos para que puedas probarlo sin costo; cuando los créditos sean insuficientes, puedes recargar saldo general en la [consola](https://platform.acedata.cloud/console/coin).
> 📘 Documentación completa: [API de generación de video MiniMax H3 →](https://platform.acedata.cloud/documents/minimax-videos-integration)
Se recomienda guardar el Token como una variable de entorno, no escribirlo en el código fuente ni confirmarlo en el repositorio de versiones:
```bash theme={null}
export ACEDATACLOUD_API_KEY="YOUR_API_KEY"
```
## Resumen de la interfaz
* **Base URL**:`https://api.acedata.cloud`
* **Endpoint**:`POST /minimax/videos`
* **Método de autenticación**:llevar `authorization: Bearer {token}` en el HTTP Header
* **Encabezados de solicitud**:
* `accept: application/json`
* `content-type: application/json`
* **Modelo (model)**:`MiniMax-H3`
* **Estructura de entrada**:texto, imágenes, videos y audio se pasan de forma unificada mediante `content`
* **Modo de salida**:por defecto espera de forma síncrona a que finalice la generación y devuelve el `task` completo; al pasar `async: true` o `callback_url`, devuelve inmediatamente `task_id` y `trace_id`
* **Consulta de resultados**:obtén el estado y el video final mediante la [API de consulta de tareas MiniMax H3](https://platform.acedata.cloud/documents/minimax-tasks-integration)
* **Callback asíncrono**:opcional, recibe el resultado final de la tarea mediante `callback_url`
No necesitas pasar `action` para seleccionar el modo de generación; la interfaz determinará automáticamente el uso según los tipos de materiales y `role` en `content`.
## Escenarios adecuados
| Escenario | Combinación de entrada | Usos habituales |
| - | - | - |
| Generación de video a partir de texto | Texto | Creatividad publicitaria, previsualización de guiones gráficos, videos cortos, tomas de ambiente |
| Generación de video a partir de imagen de fotograma inicial | Texto + imagen de fotograma inicial | Hacer que imágenes de productos, carteles, fotos de personas o ilustraciones cobren vida de forma natural |
| Video de fotograma final / inicial y final | Texto + fotograma final, o texto + fotograma inicial + fotograma final | Controlar inicio y final, transiciones, cambios de crecimiento y comparaciones de antes y después |
| Generación de video con referencias multimodales | Texto + imágenes / videos / audio de referencia | Mantener la coherencia de personajes y productos, reproducir movimientos, movimientos de cámara, timbre o ritmo de edición |
## Flujo de llamada
Cuando no se pasa `async` por defecto, `/minimax/videos` esperará a que finalice la generación y devolverá directamente el `task` completo. Cuando necesites liberar la conexión inmediatamente, pasa `async: true` o `callback_url`:
1. Guarda `task_id` y `trace_id` de la respuesta inmediata.
2. Cuando no haya callback configurado, llama a `/minimax/tasks` aproximadamente cada 10 segundos para consultar.
3. Cuando `task.status` cambie a `succeeded`, obtén el video desde `task.content.url`.
4. Cuando el estado sea `failed` o `cancelled`, detén el sondeo y lee `task.error`.
## Parámetros de solicitud de nivel superior
| Parámetro | Tipo | Obligatorio | Valor predeterminado | Descripción |
| - | - | - | - | - |
| `model` | string | Sí | - | Fijado como `MiniMax-H3` |
| `content` | object\[] | Sí | - | Arreglo de contenido multimodal, debe contener un elemento `text` no vacío |
| `resolution` | string | Sí | - | `768P` o `2K` |
| `duration` | integer | Sí | - | Duración de generación, entero de 4-15 segundos |
| `ratio` | string | Obligatorio condicionalmente | `adaptive` | `adaptive`、`21:9`、`16:9`、`4:3`、`1:1`、`3:4`、`9:16` |
| `async` | boolean | No | `false` | Cuando es `true`, devuelve inmediatamente el identificador de tarea y obtiene el resultado mediante la interfaz de tareas |
| `callback_url` | string | No | - | URL pública de callback para recibir el resultado final de la tarea; tras proporcionarla se activa automáticamente el modo asíncrono |
Las reglas de `ratio` dependen del flujo de trabajo:
* **Generación de video a partir de texto**:obligatorio y no puede ser `adaptive`.
* **Video de fotograma inicial, fotograma final o inicial y final**:la relación de aspecto la determina la imagen de entrada; se recomienda omitirlo o pasar `adaptive`.
* **Generación de video con referencias multimodales**:puede omitirse, el valor predeterminado es `adaptive`; también puedes especificar explícitamente una proporción fija.
La interfaz no acepta campos heredados o de compatibilidad, como `prompt`, `image_urls`, `audio_urls`, `messages` y `first_frame_image`. Cuando recibas errores relacionados con este tipo de parámetros, elimina los campos antiguos y migra a `content`; por ejemplo, cambia `"prompt": "一只猫挥手"` por `"content": [{"type": "text", "text": "一只猫挥手"}]`。No envíes simultáneamente los dos formatos, nuevo y antiguo.
## Parámetros de elementos de contenido content
Cada elemento de contenido debe tener `type`, y los demás campos se determinan según el tipo:
| `type` | Campo de datos | `role` | Descripción |
| - | - | - | - |
| `text` | `text` | No se pasa | Cada solicitud debe contener un elemento de texto no vacío, con un máximo de 7000 caracteres |
| `image_url` | `image_url.url` | `first_frame` | Imagen de fotograma inicial; cuando solo hay una imagen y se omite `role`, también se procesa como fotograma inicial |
| `image_url` | `image_url.url` | `last_frame` | Imagen de fotograma final; puede usarse por separado o combinarse con `first_frame` para controlar el inicio y el final |
| `image_url` | `image_url.url` | `reference_image` | Referencia de sujeto, personaje, producto, vestimenta, escena o estilo |
| `video_url` | `video_url.url` | `reference_video` | Referencia de movimiento, movimiento de cámara, actuación o estructura de edición |
| `audio_url` | `audio_url.url` | `reference_audio` | Referencia de timbre, diálogo, música o ritmo |
Las direcciones de medios admiten tres formas:
* URL HTTPS de acceso público, recomendada para archivos grandes.
* `mm_file://{file_id}`, hace referencia a archivos ya cargados o a resultados existentes.
* URI de datos Base64 del tipo de medio correspondiente. Base64 aumenta el tamaño aproximadamente en un tercio; asegúrate de que todo el cuerpo de la solicitud no supere los 64 MB.
## Especificaciones de materiales y límites de cantidad
| Material | Format | Single-file limit | Dimensions / Duration | Quantity limit |
| - | - | - | - | - |
| Image | JPG, JPEG, PNG, WEBP, HEIC, HEIF | No more than 30 MB | Both width and height must be 256-5760 px; aspect ratio 0.4-2.5 | Up to 1 first frame, up to 1 last frame, up to 9 reference images |
| Video | MP4, MOV; H.264/AVC or H.265/HEVC; audio track AAC or MP3 | No more than 50 MB | Each clip 2-15 seconds, total no more than 15 seconds; both width and height must be 256-5760 px; aspect ratio 0.4-2.5; 23.976-60 fps | Up to 3 reference videos |
| Audio | WAV, MP3 | No more than 15 MB | Each clip 2-15 seconds, total no more than 15 seconds | Up to 3 reference audios |
Images, videos, and audio in multimodal reference scenarios total no more than 12 files. First/last frame scenarios and reference material scenarios are mutually exclusive: once `reference_image`, `reference_video`, or `reference_audio` is used, `first_frame` or `last_frame` can no longer be used, and vice versa.
## Production-level capability showcase
The following are not concept images or placeholder materials, but real reference inputs and actual video outputs from official MiniMax H3 production-level capability samples. The three groups of cases respectively cover brand shorts, live-action narratives, and fashion e-commerce, suitable for evaluating the model's most critical capabilities in commercial production.
| Capability | Key observations |
| - | - |
| Character and face consistency | Whether facial features, hairstyle, makeup, and character temperament remain stable after multi-shot transitions |
| Facial performance | Gaze, micro-expressions, emotional tension, and natural head movements in close-up shots |
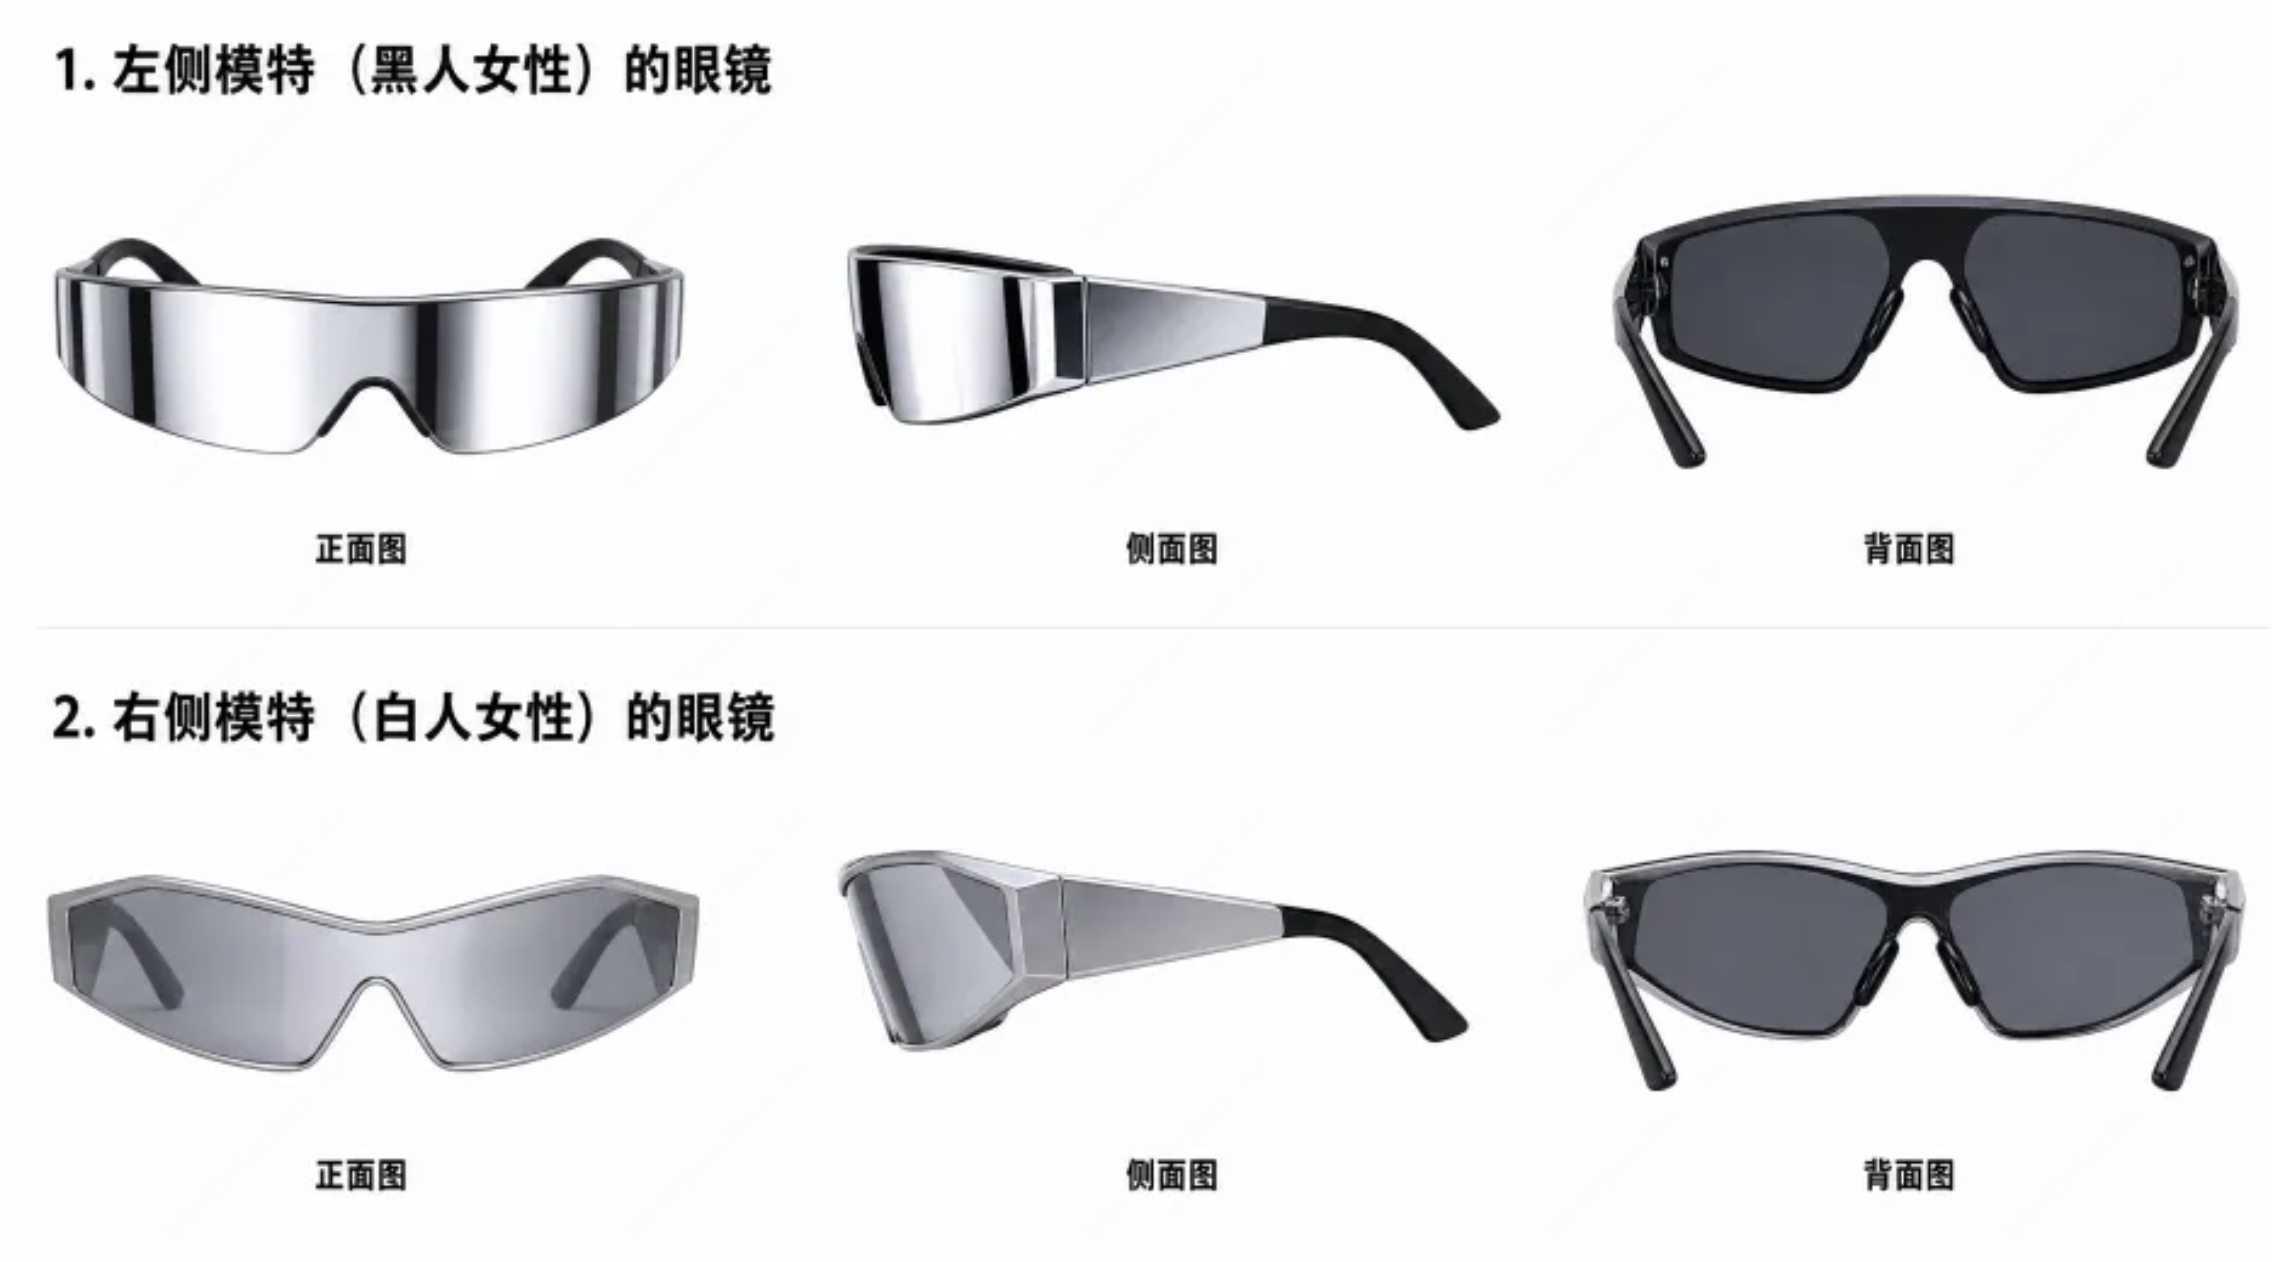
| Product structure preservation | Contours, materials, wearing relationships, and mirror reflections of products such as glasses and handbags |
| Brand visual execution | Whether scene atmosphere, film grain, color, Logo, and editing rhythm are unified |
| Cinematic narrative | Whether changes in shot scale, character blocking, camera movement, rhythm, and sound can form a complete sequence |
Here, “face capability” refers to character appearance consistency, facial details, and performance control in video generation, not identity recognition, face comparison, or face-swapping interfaces.
### High-end brand short: unifying characters, products, and brand assets
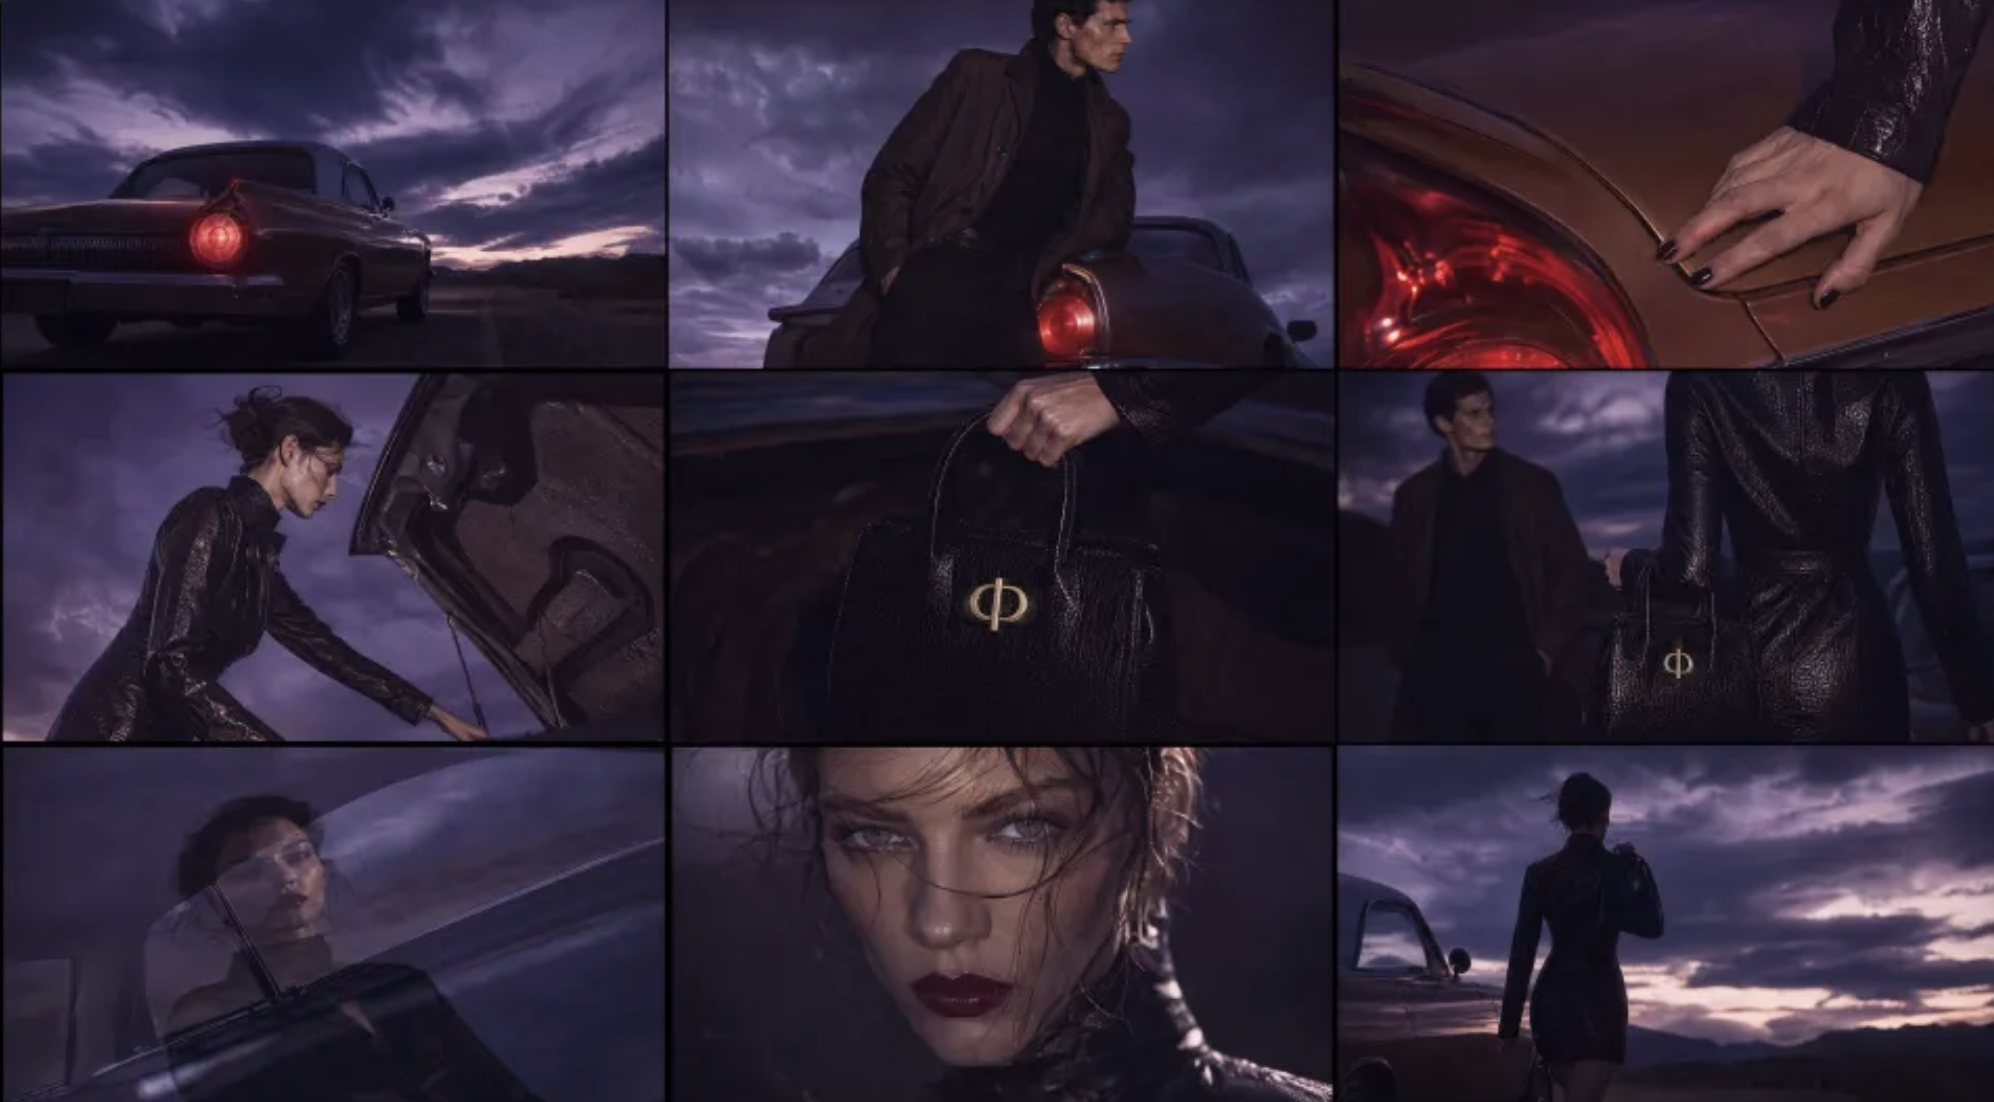
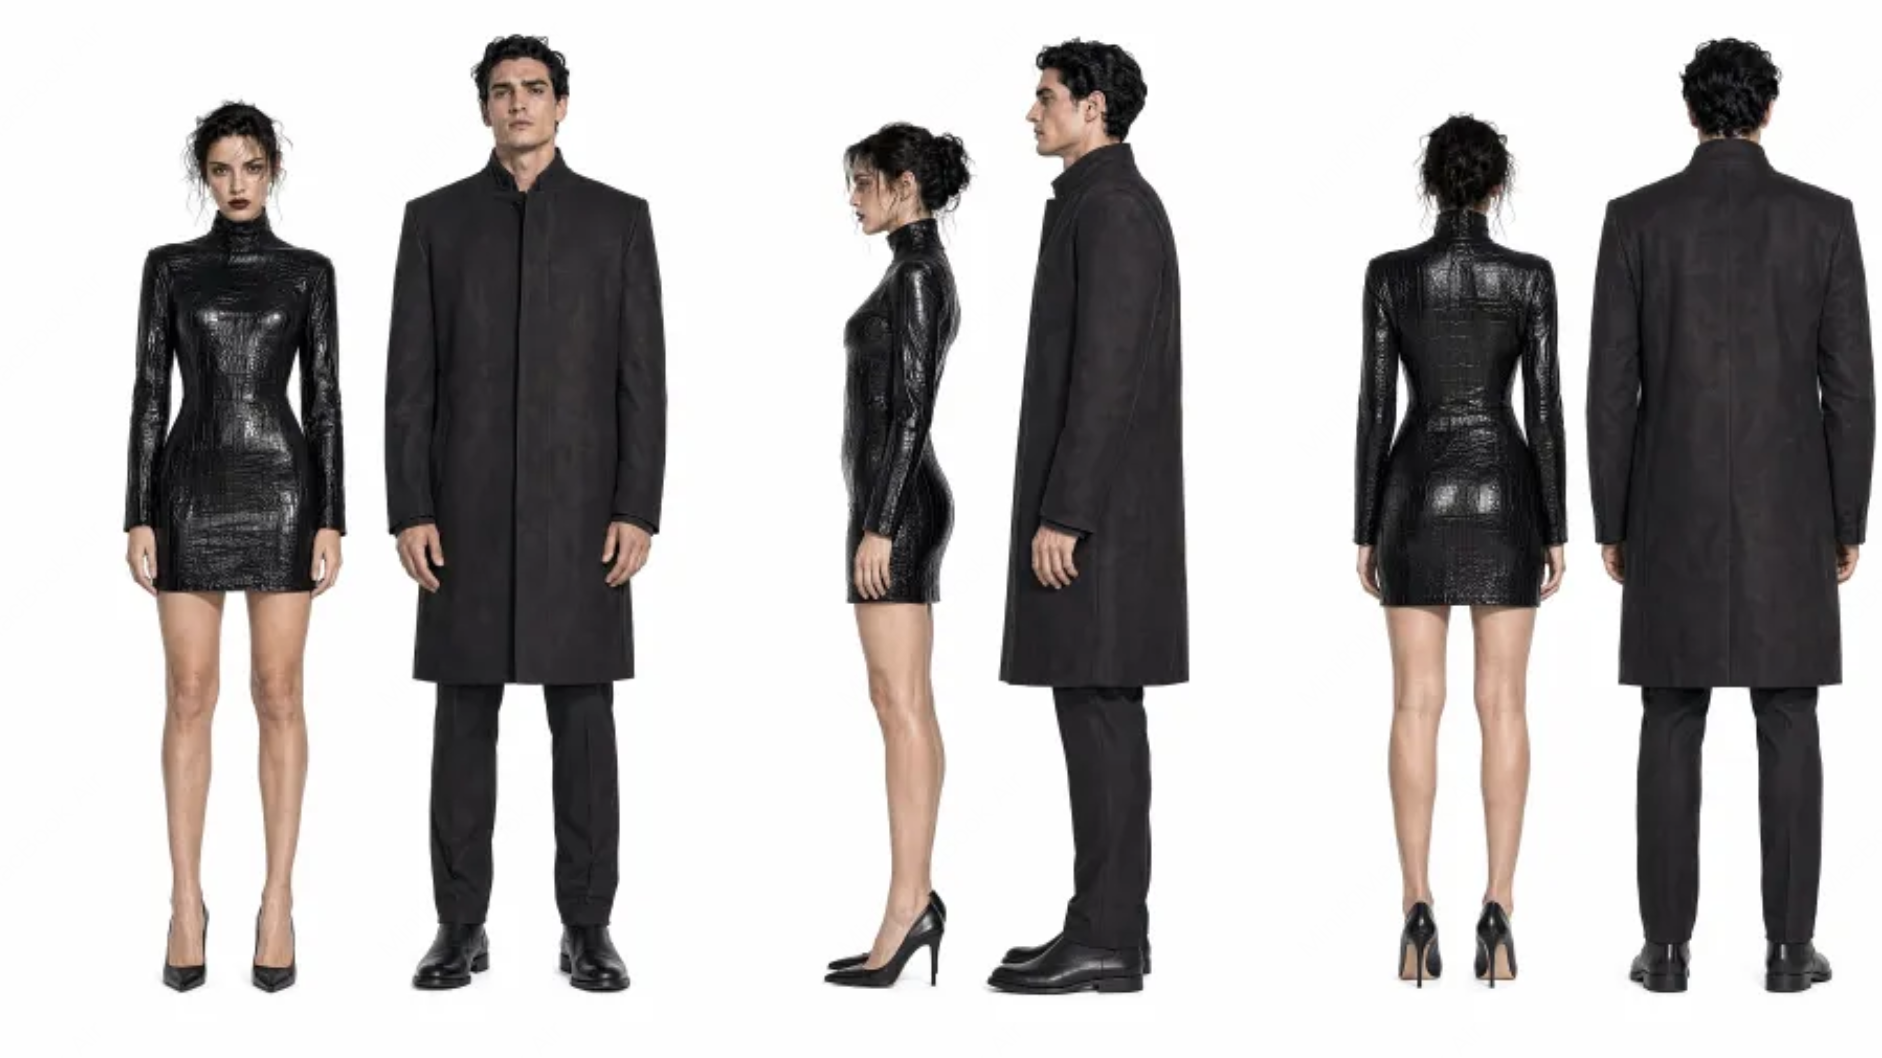
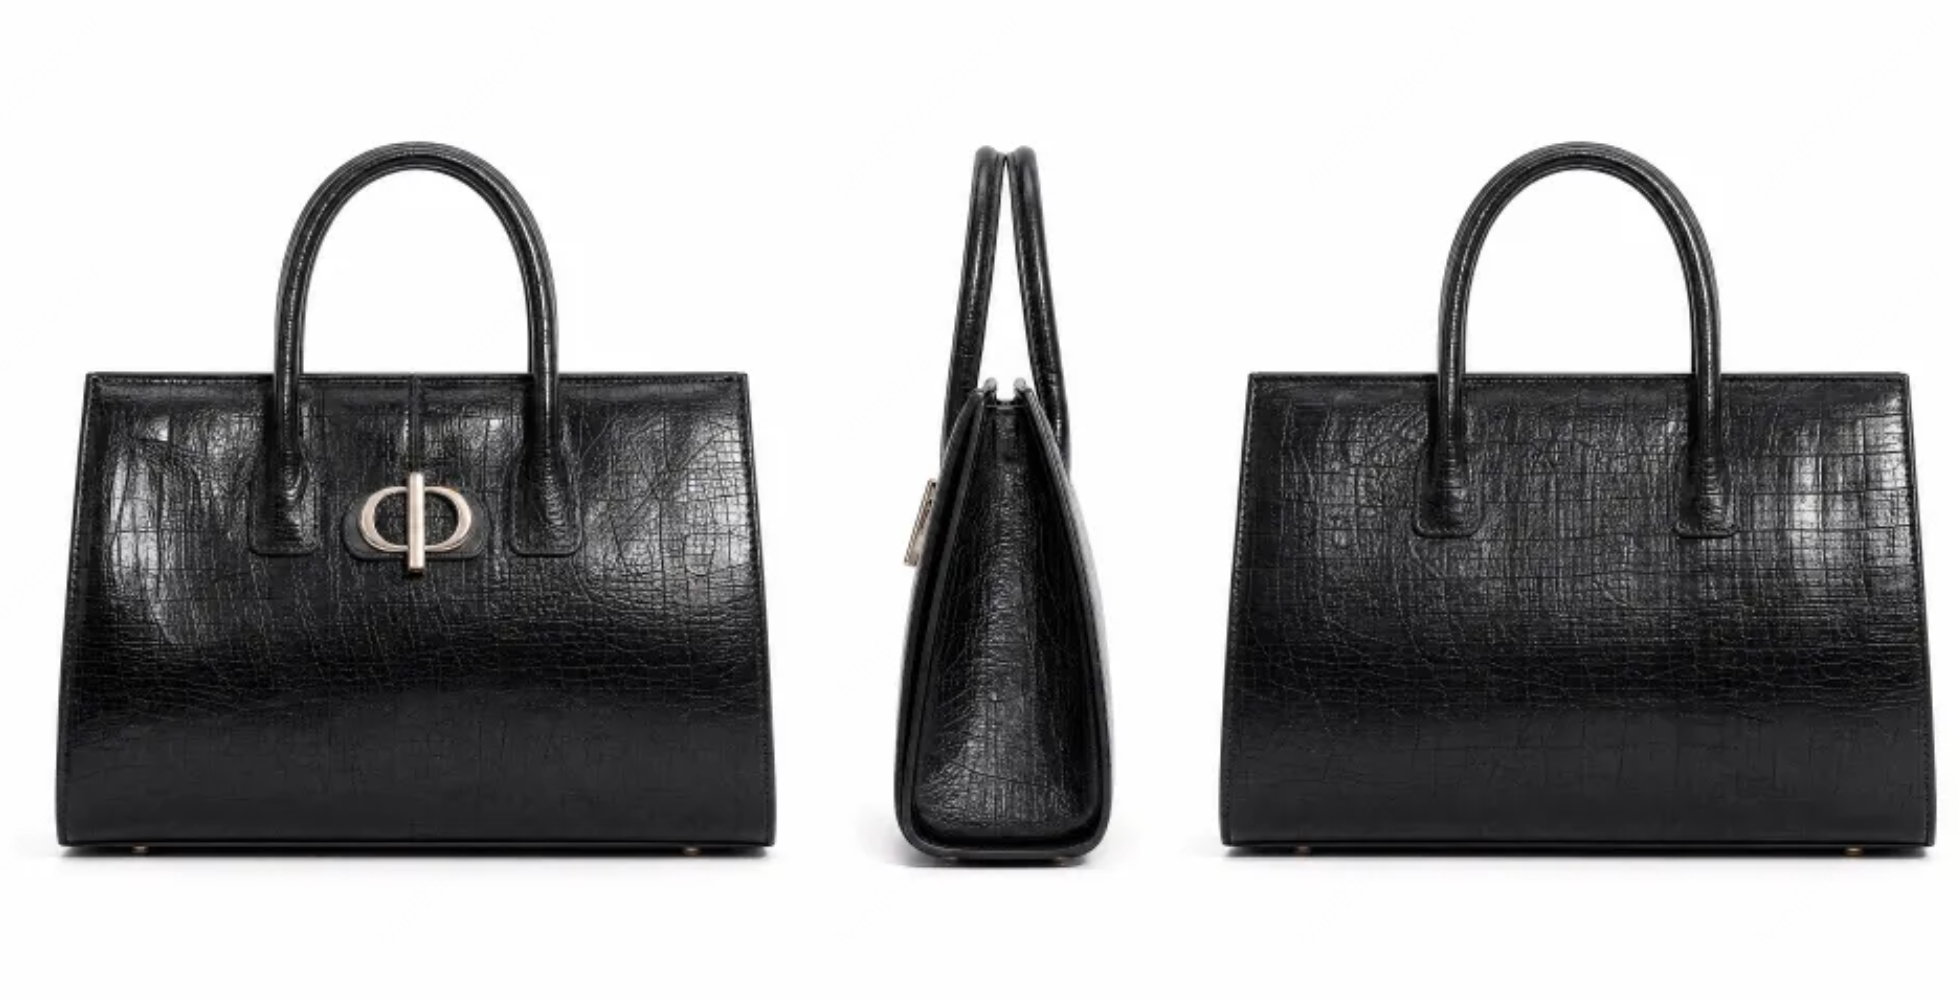
**Production goal:** 16:9 premium fashion brand film. Establish a cool atmosphere with a desert highway and a vintage car, maintain the female lead's appearance and the structure of the black handbag, and naturally incorporate the brand Logo at the end. This case focuses on testing cross-shot character consistency, product preservation, cinematic texture, and brand closing capability.
| Atmosphere and scene reference | Character reference |
| - | - |
|  |
 |
| Handbag product reference | Brand Logo reference |
| - | - |
|
 |
 |
[Open or download the brand short directly](https://cdn.acedata.cloud/uploads/6845b11d-1a58-4478-afd8-29e7e117772a)
The corresponding `content` organization method:
```json theme={null}
{
"model": "MiniMax-H3",
"content": [
{
"type": "text",
"text": "15 秒、16:9 高级时装品牌片。荒漠公路旁停着复古汽车,女主从后备箱取出黑色手袋,与男主短暂对视后独自离开。保持人物、手袋与品牌视觉一致;冷峻高级,电影颗粒,剪辑利落,结尾自然呈现品牌 Logo。"
},
{
"type": "image_url",
"image_url": { "url": "https://cdn.acedata.cloud/uploads/6e65f865-f1c2-4f80-8b51-9a98d4d930b1" },
"role": "reference_image"
},
{
"type": "image_url",
"image_url": { "url": "https://cdn.acedata.cloud/uploads/88d89cc3-e6cb-42b4-ab4c-1bbbf6c9f7c8" },
"role": "reference_image"
},
{
"type": "image_url",
"image_url": { "url": "https://cdn.acedata.cloud/uploads/e91f7fff-f8e3-4da5-b882-87edbc3c9473" },
"role": "reference_image"
},
{
"type": "image_url",
"image_url": { "url": "https://cdn.acedata.cloud/uploads/b68dac43-fb14-42b5-bf8b-fd4d65506520" },
"role": "reference_image"
}
],
"resolution": "2K",
"duration": 15,
"ratio": "16:9"
}
```
### Live-action vertical short drama: face consistency and emotional performance
**Objetivo de producción:** Avance de minidrama romántico oscuro de 15 segundos, 9:16. Bloquea la apariencia de los personajes mediante las imágenes de referencia del protagonista y la protagonista, y restringe el espacio mediante la imagen de referencia del castillo antiguo; utiliza planos medios-cortos y primeros planos faciales para representar el enfrentamiento de miradas, el miedo, la contención y la sensación de peligro. Este caso es adecuado para observar la estabilidad de los rasgos faciales reales, las microexpresiones, las relaciones de mirada y la actuación continua.
| Referencia del protagonista y la protagonista | Referencia de la escena del castillo antiguo |
| - | - |
|
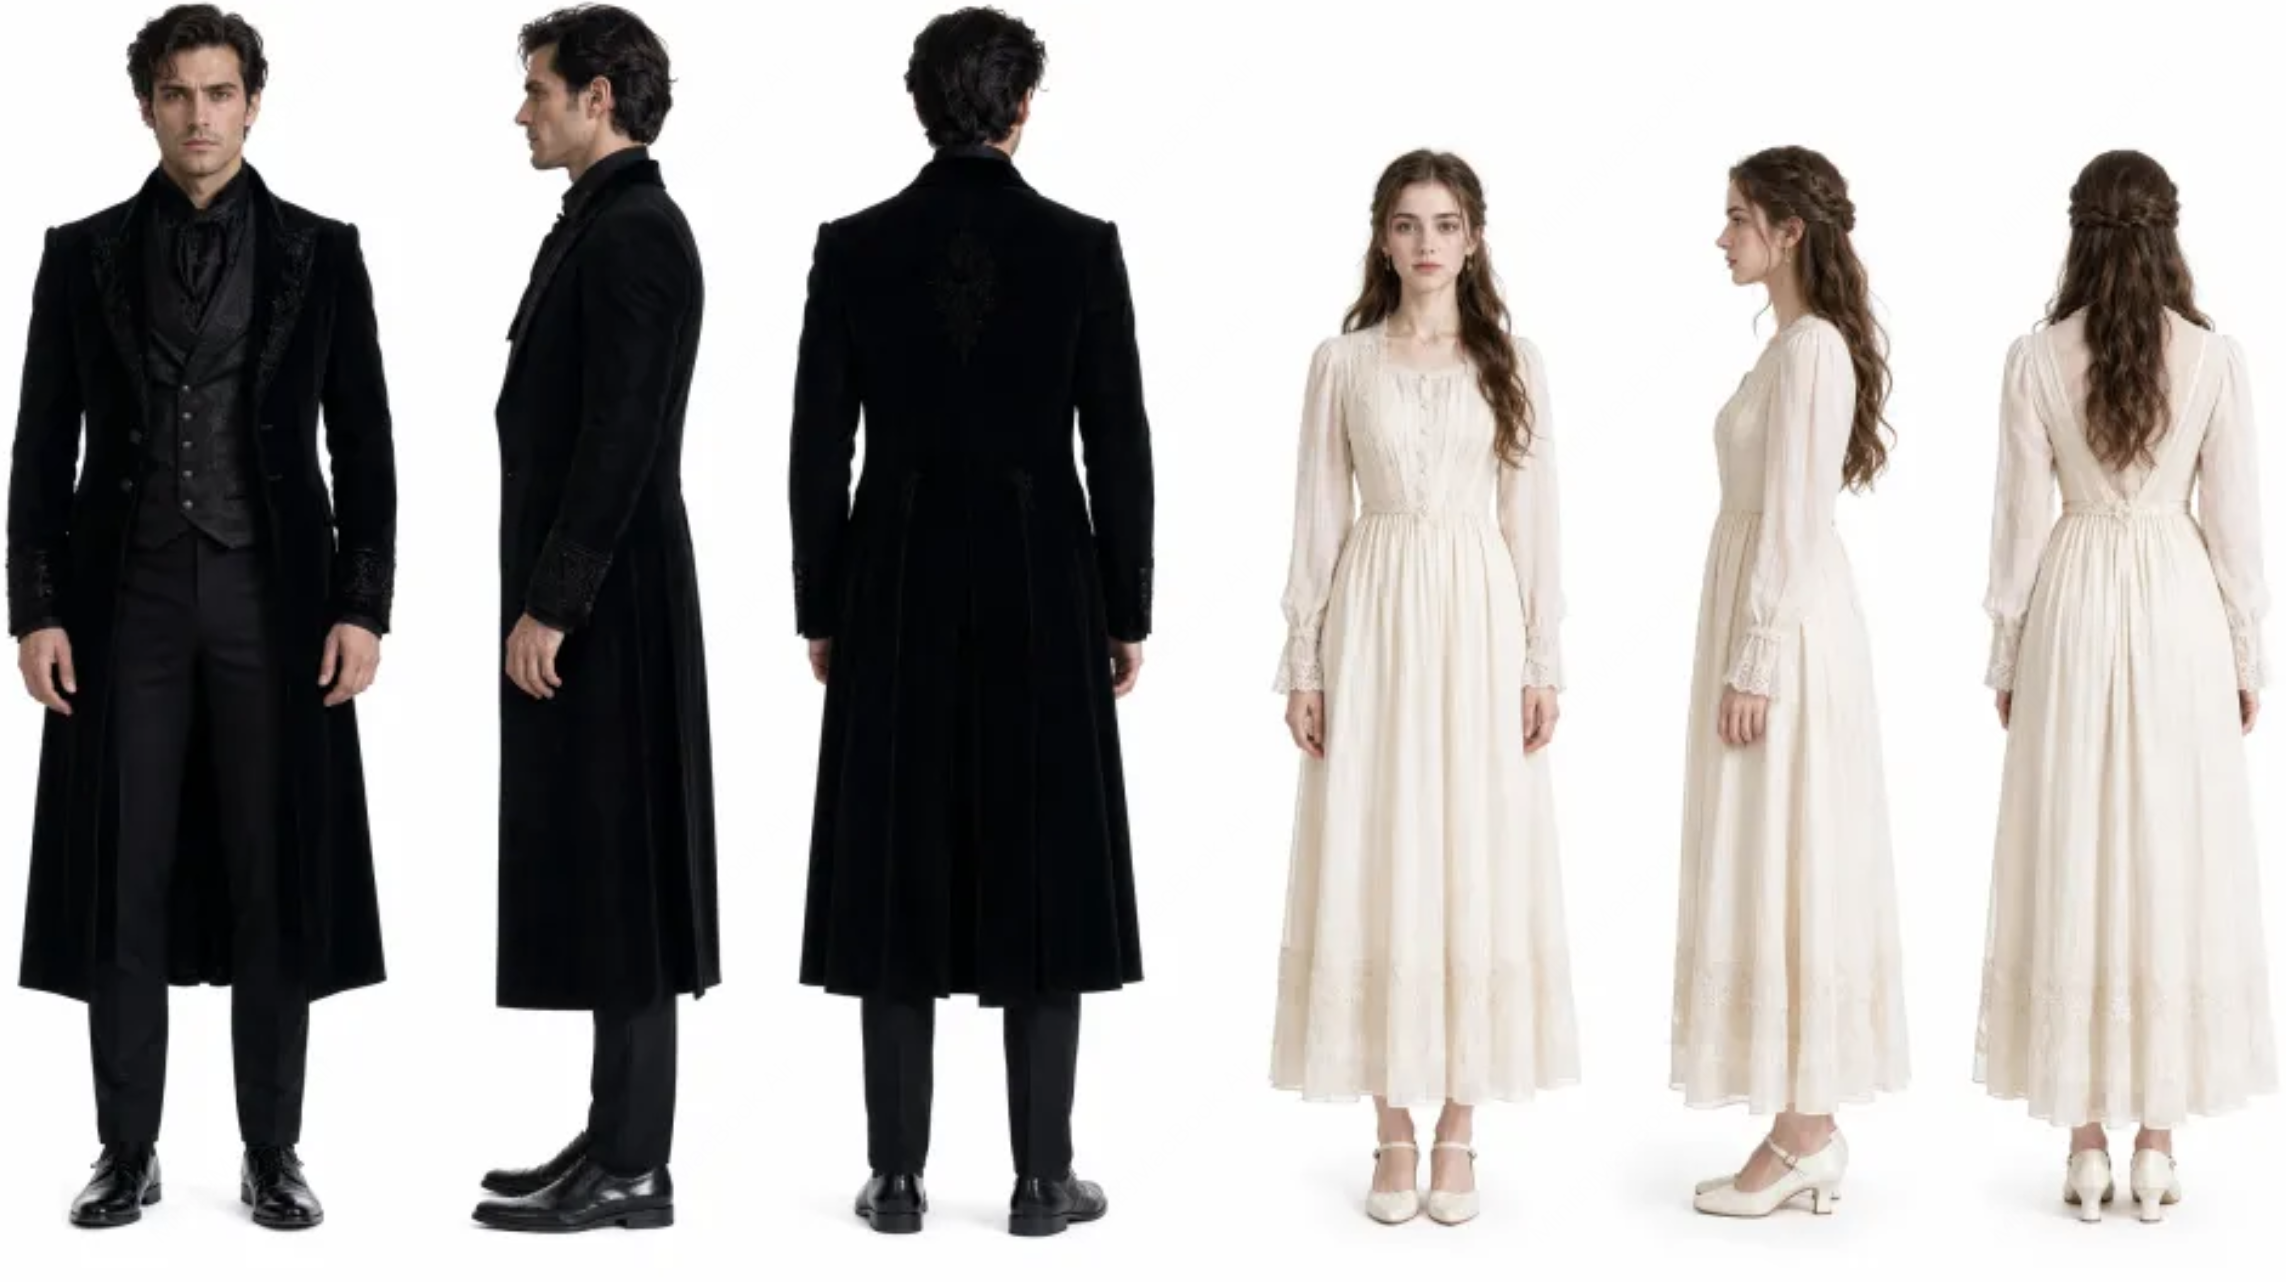 |
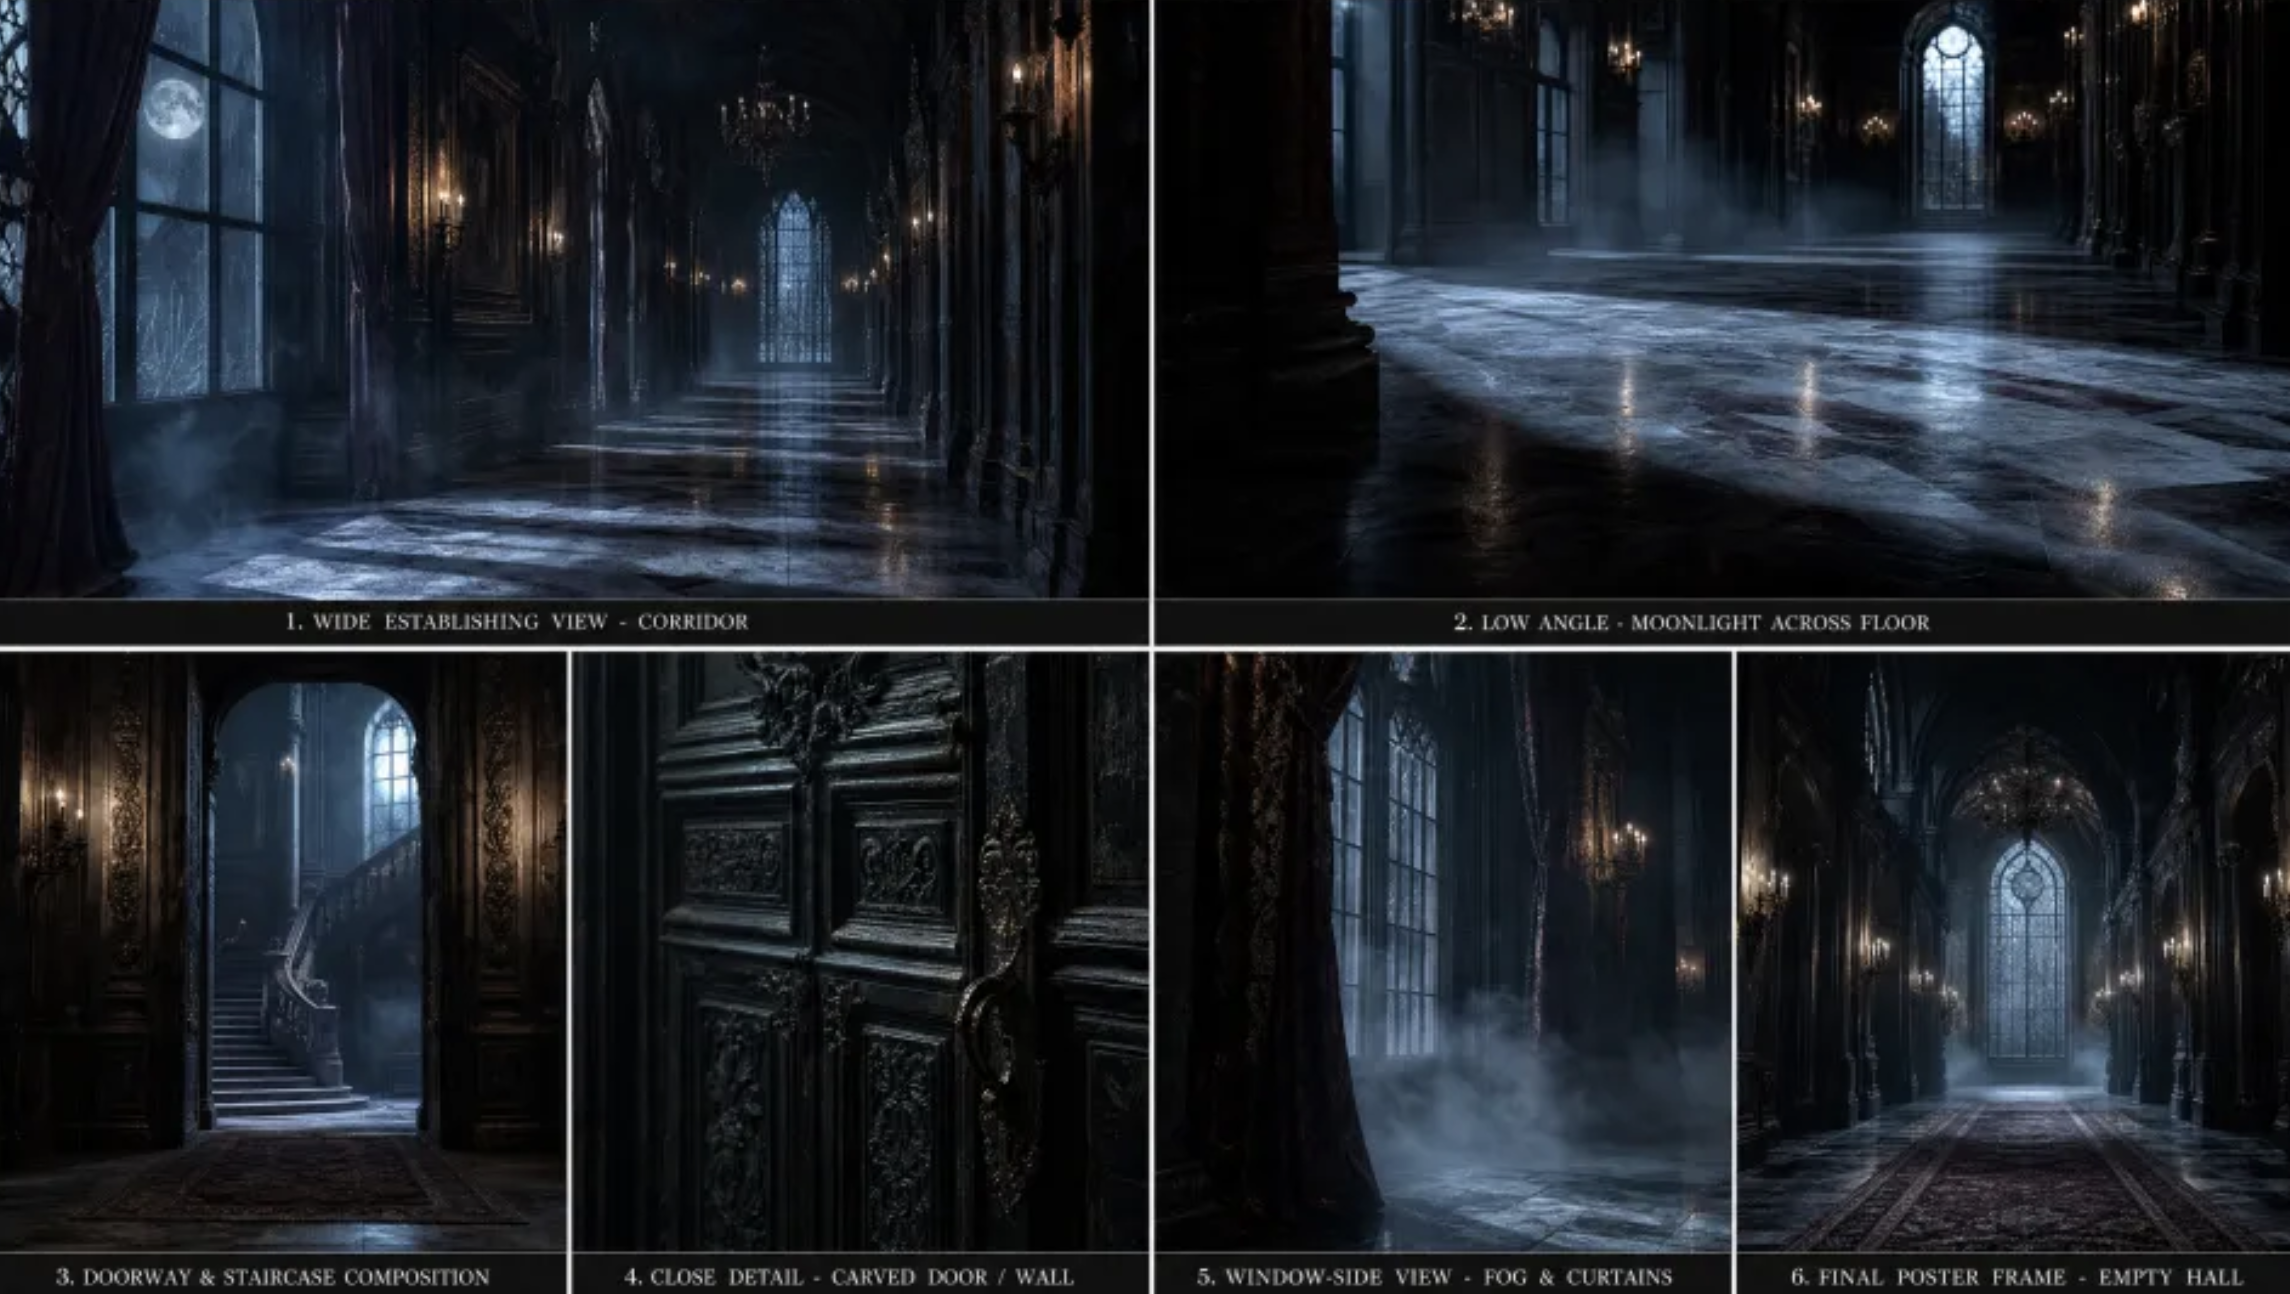 |
[فتح مباشرة أو descargar el minidrama real](https://cdn.acedata.cloud/uploads/0f3e9bf2-5073-46f4-9a2d-7d8d912391cf)
El prompt debe especificar claramente la relación entre los personajes, las emociones y el tipo de plano, en lugar de limitarse a describir una «conversación entre un hombre y una mujer»:
```text theme={null}
15 秒、9:16 真人暗黑浪漫短剧预告。女主误入禁忌古堡,唤醒沉睡的吸血鬼贵族;
他危险而克制地靠近,她恐惧但不屈服。保持两位角色的五官、发型与服装一致,
以中近景和面部特写表现眼神对峙与情绪张力,暗色电影光线,节奏紧凑。
```
### Anuncio de gafas de moda: conservación de detalles faciales y estructura del producto
**Objetivo de producción:** Anuncio de gafas de moda de alta gama, 9:16. La imagen de cuerpo entero del personaje se encarga de la figura y la forma de caminar, la imagen de referencia facial se encarga de los rasgos y el maquillaje, y la imagen del producto se encarga de las curvas envolventes, los reflejos de las lentes, las patillas y el contorno de ojo de gato. Este caso pone a prueba simultáneamente los primeros planos faciales, la consistencia entre varias personas, la relación de uso y la estructura geométrica del producto.
| Referencia de modelo y estilismo | Referencia de detalles faciales | Referencia del producto de gafas |
| - | - | - |
|
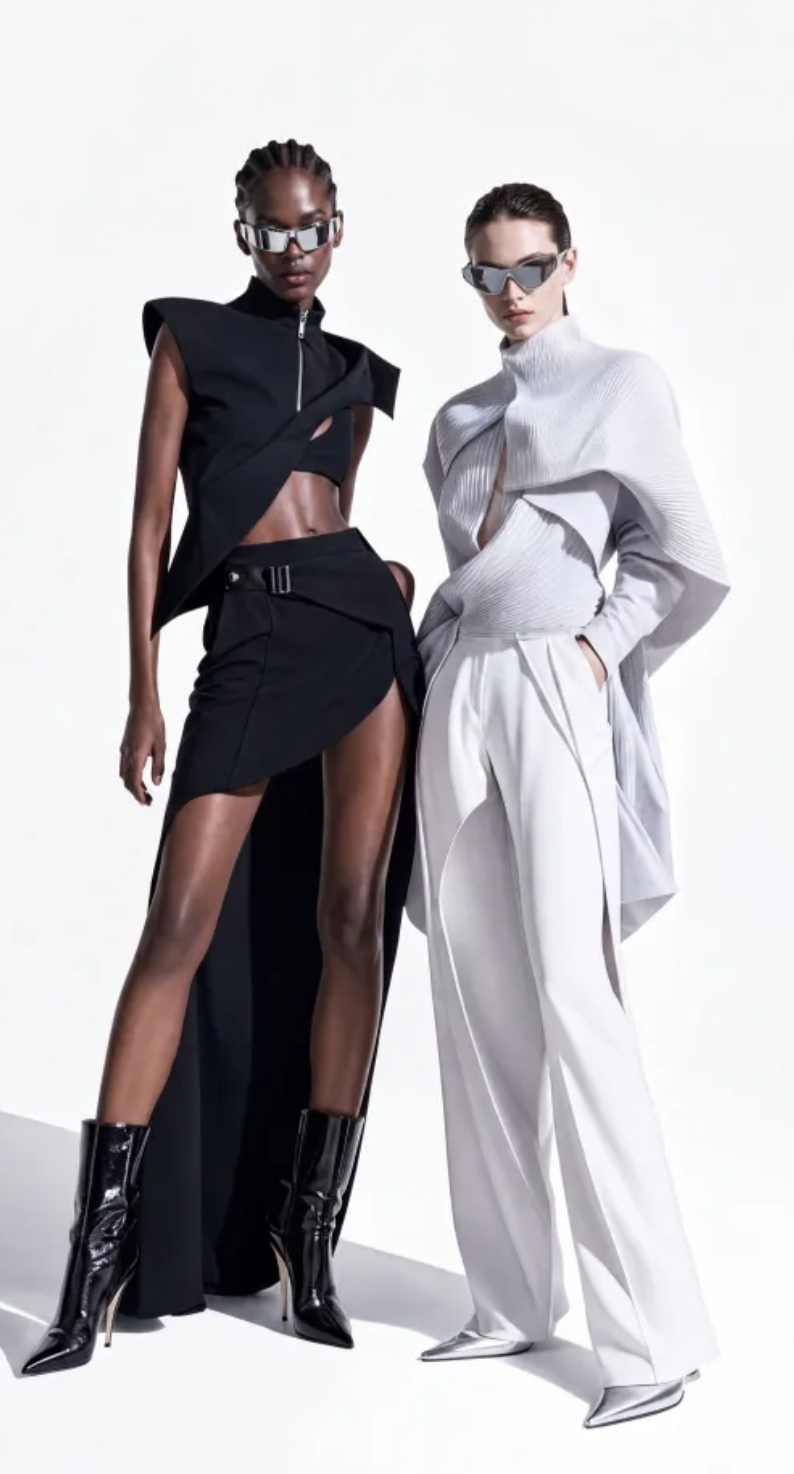 |
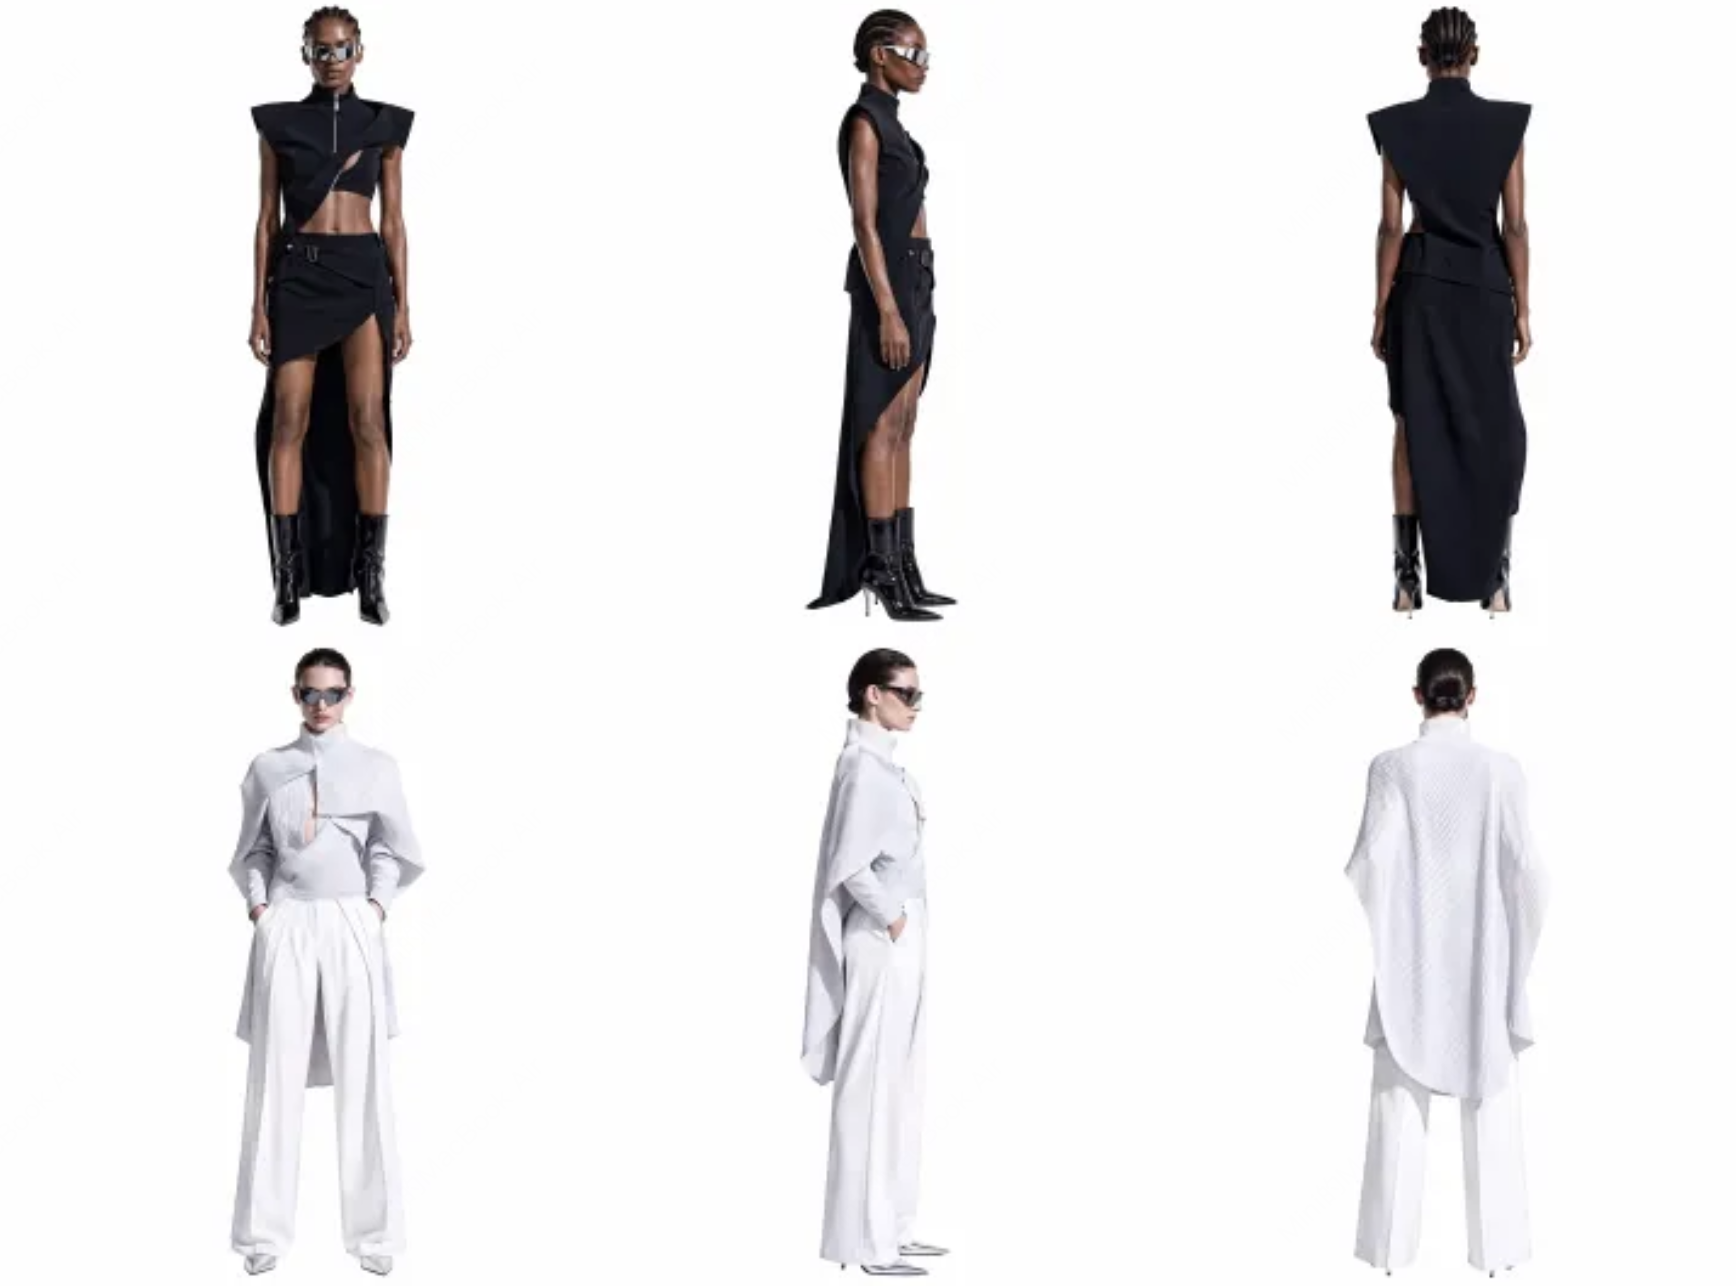 |
 |
[فتح directamente o descargar el anuncio de gafas de moda](https://cdn.acedata.cloud/uploads/55715089-b6bd-4ef6-a3c2-e762a672f751)
En los anuncios de productos, el prompt debe separar y especificar claramente las responsabilidades de las referencias de personas y de productos: los materiales de personajes restringen el rostro, el maquillaje, la figura y el temperamento; los materiales de producto restringen el contorno, el material, los reflejos y la posición de uso. Esto es más estable que escribir de forma general «generar un anuncio de gafas».
## Texto a vídeo
Cuando solo hay un elemento de texto, se trata de texto a vídeo. Es adecuado para generar imágenes directamente a partir de una idea, guion o descripción de planos. El prompt puede organizarse en el orden de «sujeto + acción + escena + cámara + iluminación + sonido».
```bash theme={null}
curl -X POST 'https://api.acedata.cloud/minimax/videos' \
-H "Authorization: Bearer $ACEDATACLOUD_API_KEY" \
-H 'Content-Type: application/json' \
-d '{
"model": "MiniMax-H3",
"content": [
{
"type": "text",
"text": "15 秒电影级香水广告:清晨海岸的黑色礁石上,透明香水瓶被薄雾与海浪环绕。微距展现瓶身水珠和玻璃折射,镜头从产品特写缓慢拉升到广阔海面;银蓝色调,真实自然光,高级克制,结尾定格产品。"
}
],
"resolution": "2K",
"duration": 15,
"ratio": "16:9"
}'
```
El modo síncrono predeterminado devolverá la tarea completa una vez finalizada la generación:
```json theme={null}
{
"task": {
"id": "f5977217-ed2c-40da-adbe-93d08235618f",
"model": "MiniMax-H3",
"status": "succeeded",
"content": { "url": "https://cdn.acedata.cloud/minimax/f5977217.mp4" },
"resolution": "2K",
"duration": 15,
"ratio": "16:9"
}
}
```
Si se añade `"async": true` a la solicitud, la interfaz devuelve inmediatamente:
```json theme={null}
{
"task_id": "f5977217-ed2c-40da-adbe-93d08235618f",
"trace_id": "trace_7f8c2b1a"
}
```
## Imagen de primer fotograma a vídeo
Marca la imagen como `first_frame`, y el modelo comenzará a generar a partir de esa imagen. Es adecuado para animar de forma natural carteles, imágenes de productos, ilustraciones de diseño de personajes y obras fotográficas.
```json theme={null}
{
"model": "MiniMax-H3",
"content": [
{
"type": "text",
"text": "人物自然呼吸并看向窗外,衣角被微风吹动,镜头缓慢推进"
},
{
"type": "image_url",
"image_url": {
"url": "https://cdn.acedata.cloud/b1c82e4937.png"
},
"role": "first_frame"
}
],
"resolution": "2K",
"duration": 5,
"ratio": "adaptive"
}
```
## Vídeo de fotograma final y de primer y último fotograma
Proporcionar solo `last_frame` permite que el modelo genere de forma natural hasta la imagen especificada; proporcionar simultáneamente `first_frame` y `last_frame` permite controlar claramente el punto de inicio y el punto final. Es adecuado para transiciones, cambios de forma, procesos de crecimiento o comparaciones de productos antes y después.
```json theme={null}
{
"model": "MiniMax-H3",
"content": [
{
"type": "text",
"text": "女孩从童年自然成长为青年,时间流逝平滑,人物始终位于画面中央"
},
{
"type": "image_url",
"image_url": { "url": "YOUR_FIRST_FRAME_URL" },
"role": "first_frame"
},
{
"type": "image_url",
"image_url": { "url": "YOUR_LAST_FRAME_URL" },
"role": "last_frame"
}
],
"resolution": "2K",
"duration": 5,
"ratio": "adaptive"
}
```
El tamaño y la relación de aspecto del primer y último fotograma deben ser lo más coherentes posible, y las diferencias en la posición del sujeto, la composición y la iluminación no deben ser demasiado grandes; así será más fácil obtener una transición natural.
## Generación de video con referencias multimodales
Los materiales de referencia se pueden usar en combinación: las imágenes de referencia controlan la apariencia de personajes o productos, los videos de referencia controlan las acciones y el movimiento de cámara, y los audios de referencia controlan el tono de voz de los diálogos, la música o el ritmo de edición. En el prompt se debe indicar claramente qué debe controlar cada tipo de material, evitando subir materiales sin proporcionar su relación.
```json theme={null}
{
"model": "MiniMax-H3",
"content": [
{
"type": "text",
"text": "保持参考人物的五官、发型与服装一致,按照参考视频中的表演动作完成时尚短片;镜头节奏跟随参考音频,近景突出自然面部表情"
},
{
"type": "image_url",
"image_url": { "url": "YOUR_CHARACTER_IMAGE_URL" },
"role": "reference_image"
},
{
"type": "video_url",
"video_url": { "url": "YOUR_PERFORMANCE_VIDEO_URL" },
"role": "reference_video"
},
{
"type": "audio_url",
"audio_url": { "url": "YOUR_AUDIO_URL" },
"role": "reference_audio"
}
],
"resolution": "2K",
"duration": 5,
"ratio": "adaptive"
}
```
## Notificación de devolución de llamada
Al pasar `callback_url` se habilita automáticamente el modo asíncrono: la interfaz de creación devuelve inmediatamente `task_id` y `trace_id`, y envía mediante POST el resultado final a esa dirección después de que la tarea se complete; la estructura es coherente con la respuesta de consulta de tareas.
Los estados finales en la devolución de llamada son `succeeded`, `failed` o `cancelled`. Incluso si se utiliza una devolución de llamada, también se recomienda guardar `task_id`, para poder consultar activamente o compensar las notificaciones omitidas.
## Errores comunes
| Código de estado HTTP | Significado | Recomendación de tratamiento |
| - | - | - |
| `400` | Error de parámetros o combinación de materiales no válida | Compruebe los campos obligatorios, `role`, la cantidad y el formato de los materiales |
| `401` | Token ausente o no válido | Compruebe `Authorization: Bearer ...` |
| `402` | Saldo o cuota insuficiente | Añada saldo general en la consola |
| `422` | No superó la comprobación de seguridad de contenido | Ajuste el prompt o los materiales y vuelva a enviarlo |
| `429` | Solicitudes demasiado frecuentes | Reintente con retroceso exponencial; se recomienda un intervalo de aproximadamente 10 segundos para el sondeo de tareas |
| `500` | Servicio temporalmente no disponible | Conserve la información de la solicitud y vuelva a intentarlo más tarde |
`task.status: succeeded` en la respuesta síncrona indica que el video se ha generado; la confirmación asíncrona solo representa que la tarea ha entrado en la cola. Solo se cobrará cuando la tarea se complete correctamente; consultar las tareas es gratuito y no generará cargos duplicados.
### H3 Max
`MiniMax-H3-Max` admite 480P o 768P, y duraciones enteras de 5 a 15 segundos. La entrada de audio no tiene coste adicional, las primeras 2 imágenes son gratuitas y las que excedan se cobran por imagen; los videos de referencia se cobran según la duración real de entrada. Este modelo no admite 2K.
This documentation is built and hosted on [Mintlify](https://mintlify.com), a developer documentation platform.